AskStream:流式视频理解中不确定性下的主动提问——何时问与问什么 AskStream: When and What to Ask Proactively under Uncertainty in Streaming Video Understanding
首个为流式视频理解引入ask动作的多轮基准,评估模型面对不确定性时何时提问、问什么、何时作答
前置知识
流式视频理解
与传统离线范式看完整段视频再作答不同,流式范式要求模型边接收视频帧边理解:只能利用当前时刻之前已观察到的内容,持续维护记忆并实时与用户交互。模型按固定帧率接收输入,在每个时间步都要判断当下是继续等待更多证据还是立刻给出回应。
本文全部问题设定都建立在流式约束之上:信息随时间逐步到达,因此'何时行动'本身成为核心评价维度。
主动范式
主动范式把视频交互从'怎么答'扩展到'何时答':模型持续监控视频流,自主判断证据是否充分,过早回答缺证据、过晚回答误时机。已有工作如 ProactiveVideoQA、ProReady-QA 用时间戳或时间窗标注答案时机,但动作空间只有 wait 和 answer 两个选择。
AskStream 的出发点正是给旧范式补上第三个动作 ask,只有理解 wait/answer 二元范式的局限,才能看懂新增 ask 的意义。
POMDP(部分可观测马尔可夫决策过程)
一种决策建模框架:智能体无法观察环境的完整状态,只能基于不完整的观测历史做决策。本文把缺失的视频证据、未知的用户意图与偏好建模为潜在状态,模型在每个决策点依据已见视频、当前查询和历史交互,从 WAIT、ASK、ANSWER 三个动作中选择其一。
这是论文对任务的形式化建模方式,理解它能准确把握'不确定性'一词在本文中到底指什么。
多模态大语言模型(MLLM)
以大语言模型为底座、接入视觉编码器的模型,能同时处理文本、图像与视频,是当前视频理解的主力架构。本文评测对象既包括 Gemini-3.8 Flash、GPT-5.6-Sol、Claude Sonnet 5 等闭源模型,也包括 AURA、TimeChat-Online 等具备流式主动能力的开源模型。
'离线模型强、流式模型弱'的核心实验结论都是针对这类模型得出的,是结论的适用边界。
时机感知评估
不仅判断动作内容对不对,还判断动作发生的时间是否落在标注的有效窗口内。本文的时间得分 $T(t;[s,e))=\mathbb{I}[s \le t < e]\left(1-\frac{t-s}{e-s}\right)$ 要求动作落在窗口 $[s,e)$ 内,且随时间位置线性衰减:早动比晚动扣分少,从而同时惩罚过早、过晚和内容错误。
Ask-F1 指标的核心构造,不看懂它就无法理解 52.18%、7.22% 这些数字的真正含义。
研究动机
现有主动视频理解范式有一个隐含假设:回答查询所需的全部信息最终都会出现在视频流里,模型只需在 wait(继续观察)和 answer(作答)之间选择。但真实世界中信息常常不完整:视频侧可能关键实体被模糊、视角被遮挡,用户侧可能问题含糊、前提错误或偏好未知。论文用一个实验量化了后果:把关键实体打码时模型准确率只有 42.3%,主动请求清晰证据后升至 62.3%,逼近全清晰输入的 63.1%,而喂入错误证据几乎没有收益。在这种设定下,只会 wait/answer 的模型要么永远等不到证据而卡死,要么强行编造高幻觉的回答——比如用户问'请移开杯子'而镜头里根本没有杯子。
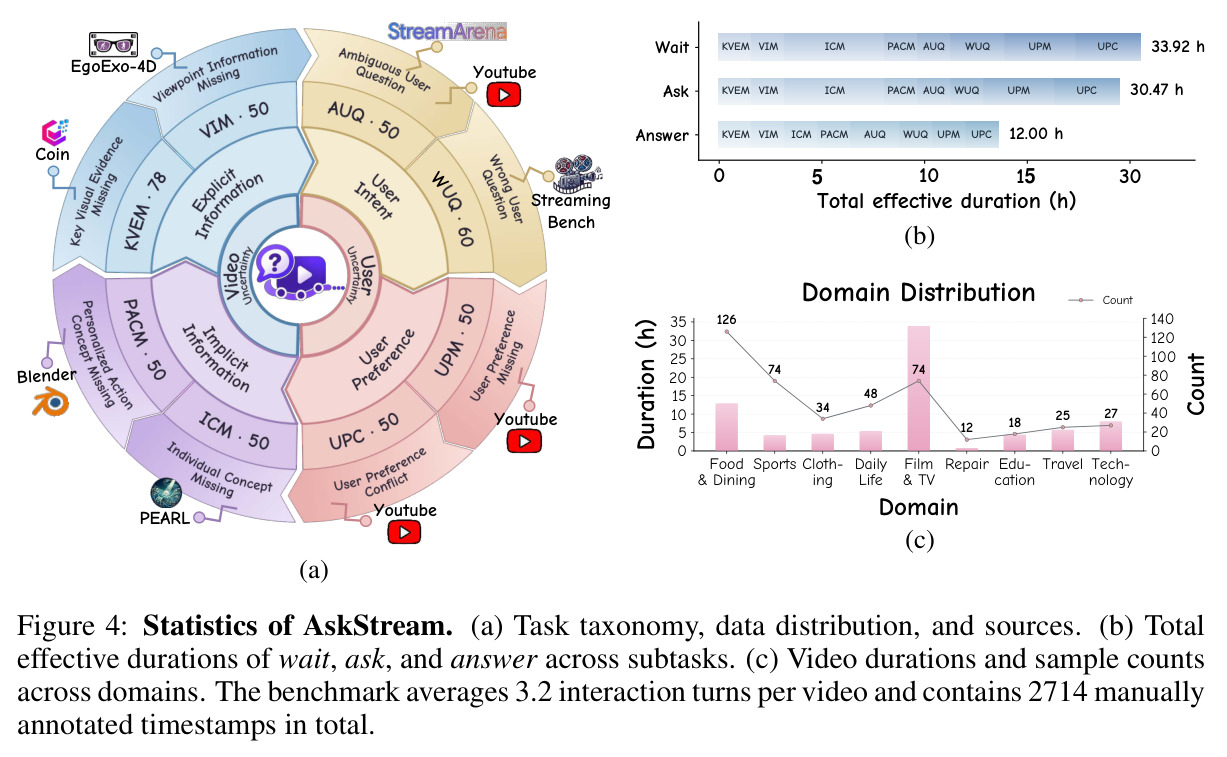
本文的目标是论文要把主动范式重新定义为一个包含 wait、ask、answer 三个动作的决策问题,并构建首个同时覆盖视频不确定性与用户不确定性的多轮流式视频基准 AskStream:438 个视频、1,401 个问题、4 大类 8 个子任务、2,714 个帧级人工标注时间窗,视频时长从 16.72 秒跨到 118 分钟、覆盖 9 个领域。同时提出 Ask-F1 指标,联合评估'何时问/何时答'的时机正确性与'问什么/答什么'的内容正确性,并在选择题与开放题两种设定下系统评测离线与流式模型,量化当前模型在'主动获取缺失信息'上的真实水平。
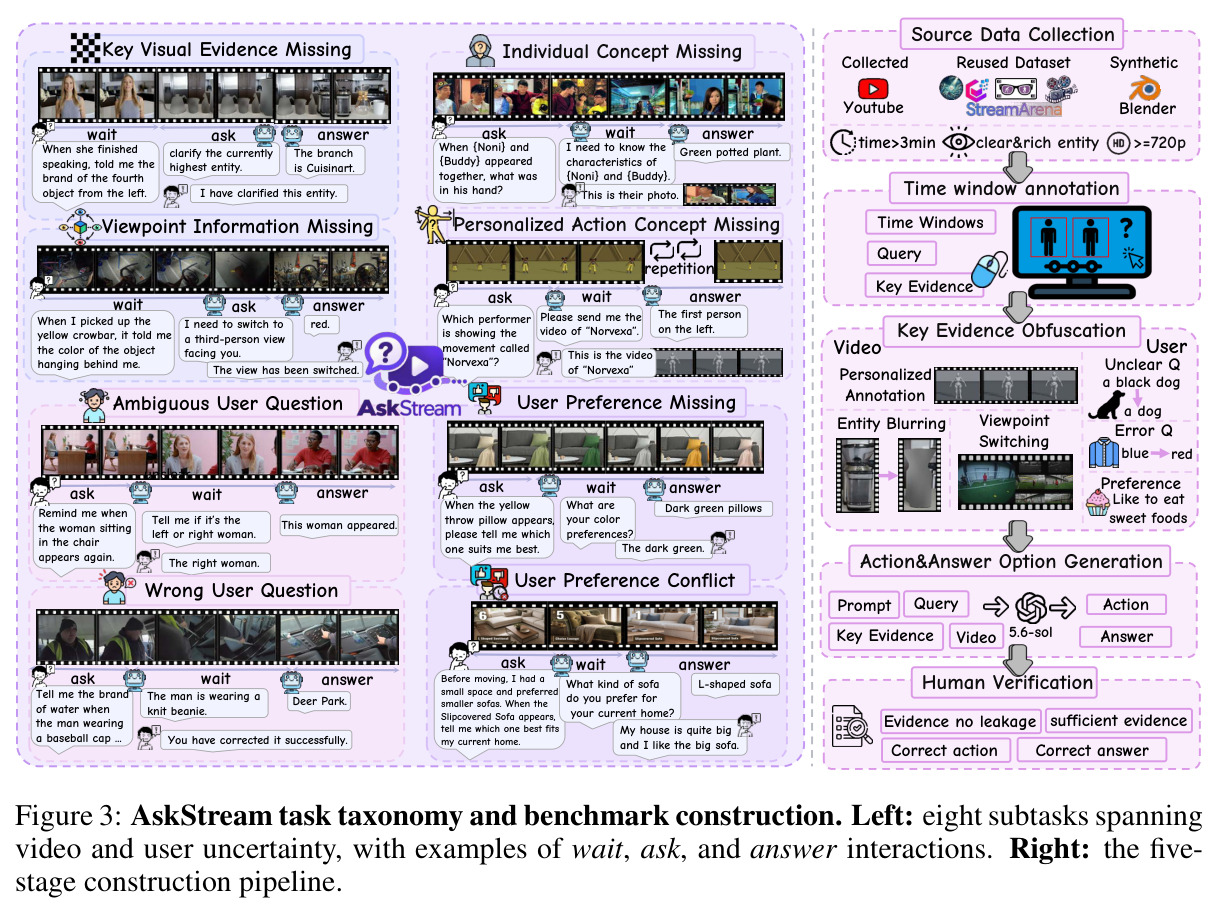
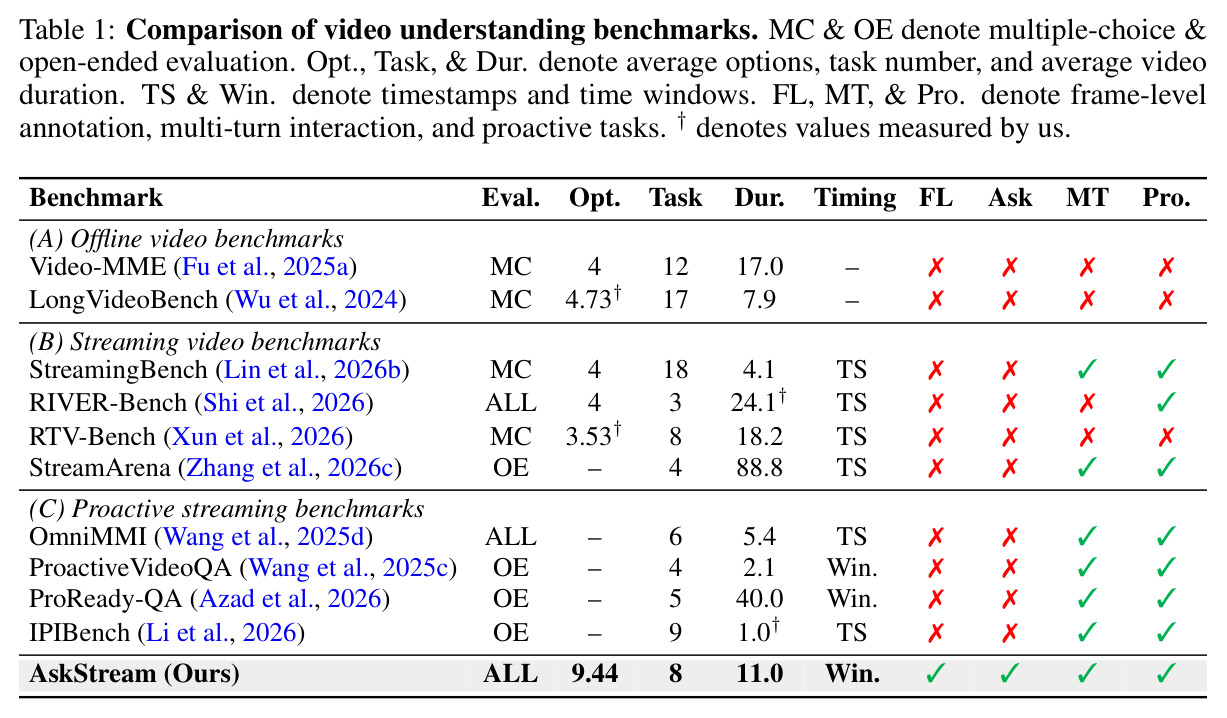
与已有工作不同的是,已有基准的空档很清晰:OVO-Bench、ProactiveVideoQA、IPIBench 等主动基准只标注时间戳或答案窗口,动作空间里没有 ask;而支持提问的 ClearVQA、ProactiveBench 只处理静态图像,且不区分不确定性来源。AskStream 的独特切入有三点:一是首次在流式视频里把 ask 作为一等动作纳入多轮交互;二是把不确定性系统分成视频侧(显式证据缺失/隐式个性化概念缺失)与用户侧(意图/偏好)四类八个子任务;三是用帧级时间窗而非单点时间戳标注 wait、ask、answer 三类窗口,让'何时问'本身第一次成为可量化评价的对象。
核心方法
直觉上,AskStream 模拟的是一个合格的'视频助手'该有的行为:当镜头拍不到答案(关键物体被模糊)、或问题本身有歧义('哪个女人?')时,与其硬答或干等,不如开口向用户要信息。技术路线上,论文把每个交互事件建模为 POMDP:事件 $i$ 从查询 $q_i$ 到达持续到下一个查询到来,模型每秒可做一次动作决策,动作空间为 WAIT、ASK、ANSWER。不确定性可能开局就能识别(先 ask 再等证据),也可能要观察一段才能发现(先 wait 再 ask),因此设计了两种时间窗标注类型。评测通过自研的 StreamHarness 分层记忆框架为离线模型模拟流式输入,并用 Ask-F1 汇总时机与内容的联合正确率。最强离线模型也只拿到 52.18% 的 Ask-F1,说明该问题远未解决。
核心创新是把'问'变成显式可评价的动作,并为此配齐三件套:状态定义、时间监督与度量指标。与已有工作的本质区别在于:以往主动基准只监督'何时答',本文额外监督'何时问'与'问什么'。具体地,每个事件标注两类窗口——类型 I(先等后问):不确定性需观察后才能识别,只标 $W^i_{wait}=[q_i,s_i)$ 与 $W^i_{answer}=[s_i,e_i)$,合法的 ASK 须落在答案窗内;类型 II(先问后等):不确定性开局即存在,标注 $W^i_{ask}\subseteq[q_i,s_i)$ 与答案窗,实际等待起点由模型的 ASK 时刻动态决定。在此之上,Ask-F1 用时间衰减得分 $T(t;[s,e))=\mathbb{I}[s \le t < e](1-\frac{t-s}{e-s})$ 对 ASK 与 ANSWER 分别打分,再以 $\frac{2 S_{ask} S_{ans}}{S_{ask}+S_{ans}}$ 的调和平均汇总,使提前抢问、问错内容、答错时机都无处遁形。
方法步骤详情
基准构建走五阶段流水线。第一步收集视频:来自 YouTube、EgoExo-4D、Coin、StreamingBench、PEARL 等已有数据集,并用 Blender 合成部分场景,共 438 个视频、9 个领域。第二步人工标注:在自建标注网页上标注用户查询、wait/ask/answer 三类帧级时间窗、关键实体与回答所需证据,总计 2,714 个时间窗,平均每视频 3.2 轮交互。第三步视频处理:用 Grounded SAM 2 分割跟踪实体做选择性高斯模糊(构造 KVEM 子任务)、PySceneDetect 辅助切分,并制造视角切换、篡改错误前提、隐藏或修改个性化概念与偏好。第四步用 GPT-5.6 Sol 生成动作与答案选项。第五步人工逐条核验:确保缺少缺失信息时无法唯一确定答案、提供后即可确定,且候选集恰有一个正确项。评测侧,StreamHarness 保留最近 10 帧(1fps)为短期记忆,每 10 帧压缩为一条中期记忆,每 4 条中期合并为 1 个长期块、最多 8 块;模型每秒一次决策,容差 ±1 秒,开放题用 Gemini-3.8 Flash 作裁判。
技术新颖性
新颖性体现在四个层面。任务层面:首次把流式视频交互从 wait/answer 二元动作扩展为含 ask 的三元动作空间,并形式化为 POMDP。数据层面:首个区分不确定性来源的基准——显式视频(KVEM 关键视觉证据缺失、VIM 视角信息缺失)、隐式视频(ICM 个体概念缺失、PACM 个性化动作概念缺失)、用户意图(AUQ 模糊问题、WUQ 错误前提)、用户偏好(UPM 偏好缺失、UPC 偏好冲突)共八个子任务。标注层面:帧级时间窗(wait 33.92 小时、ask 30.47 小时、answer 12.00 小时有效时长)远比以往基准的时间戳精细。度量层面:Ask-F1 与 StreamHarness 都是为新任务配套设计的新工具,而非已有指标的简单挪用。
实验结果
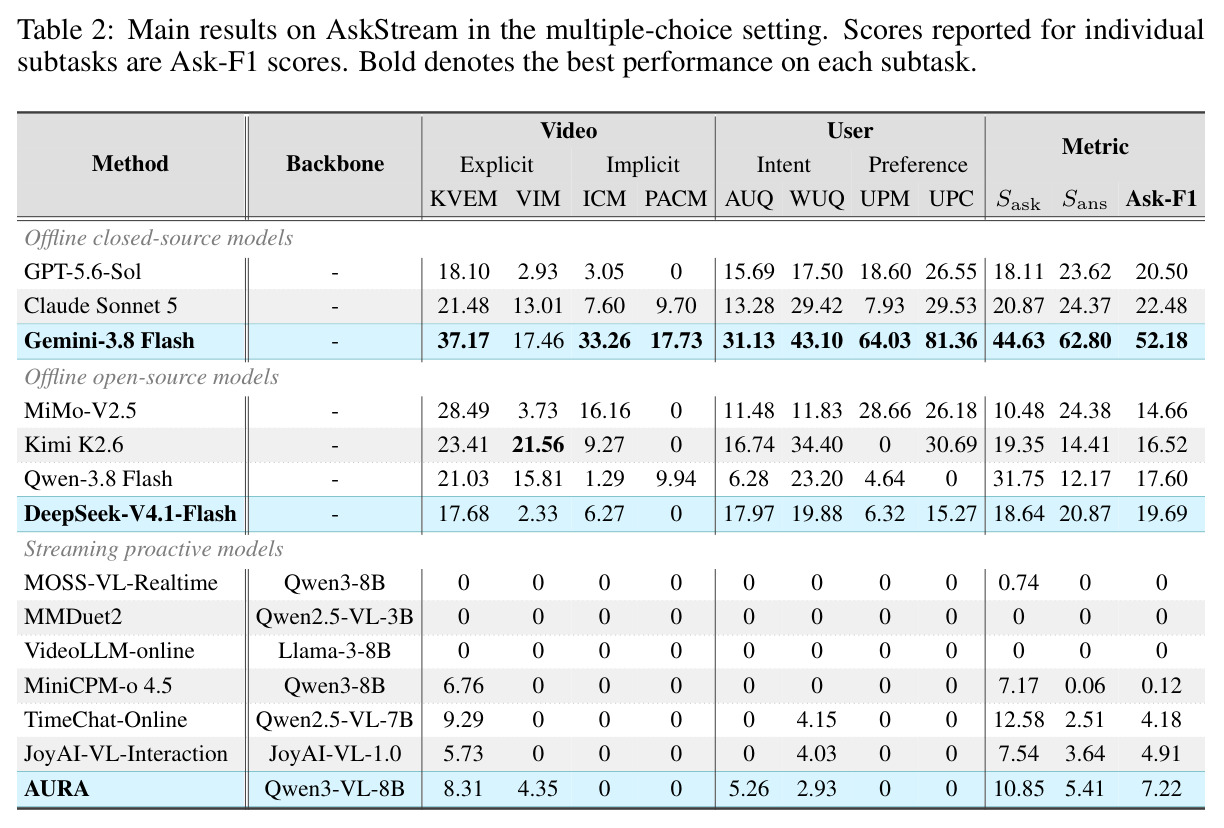
核心结论是'离线模型勉强及格、流式主动模型近乎全崩,瓶颈在 ASK'。选择题设定下,Gemini-3.8 Flash 以 52.18% 的 Ask-F1 居首(UPC 81.36%、UPM 64.03%、WUQ 43.10%、KVEM 37.17%、VIM 仅 17.46%);GPT-5.6-Sol 仅 20.50%、Claude Sonnet 5 为 22.48%;开源侧 DeepSeek-V4.1-Flash 19.69%、Qwen-3.8 Flash 17.60%、Kimi K2.6 16.52%。流式模型惨烈:AURA 7.22% 已是最好,JoyAI-VL-Interaction 4.91%、TimeChat-Online 4.18%,MOSS-VL-Realtime、MMDuet2、VideoLLM-online 全为 0。强模型的 $S_{ask}$(44.63)显著低于 $S_{ans}$(62.80),错误分析显示 early ASK 是各模型最主要错误类型。Oracle 消融给出最关键证据:在 KVEM 上只提供'何时问'的神谕就把 Ask-F1 从 37.17% 提到 58.30%(+21.13),全部神谕 +43.83%;跨轮记忆对用户不确定性帮助大(AUQ +4.40、UPM +5.38)而对视频不确定性几乎无效;ASK 预算从 1 增到 16 后在约 52.35% 饱和。
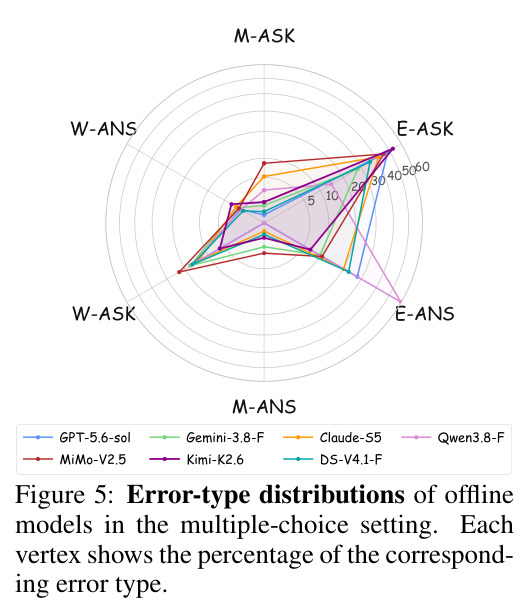
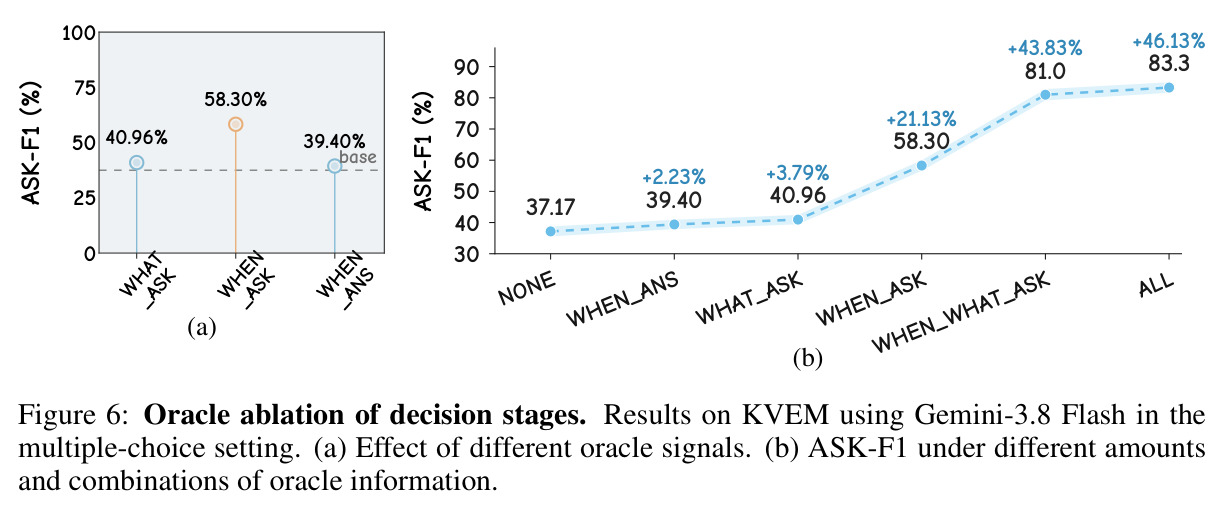
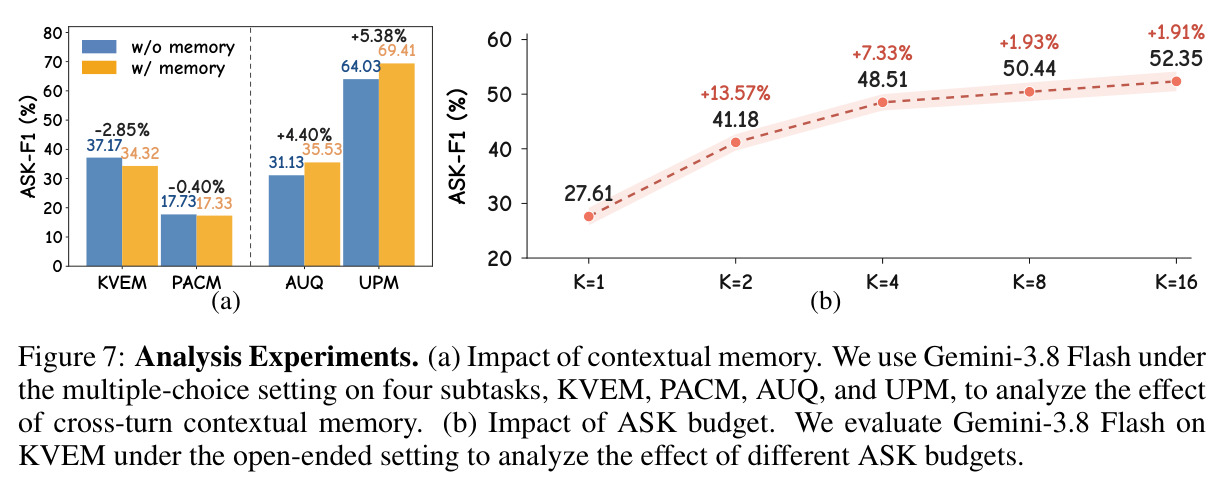
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 流式视频主动提问(8 子任务汇总,选择题设定) | Ask-F1 | Gemini-3.8 Flash 52.18%(被测最强) | 最佳流式主动模型 AURA 7.22% | 离线最强比流式最强高 44.96 个百分点 |
| KVEM 关键视觉证据缺失 | Ask-F1 | 37.17%(Gemini-3.8 Flash) | 注入 WHEN_ASK 神谕后 58.30% | 神谕提升 +21.13 个百分点 |
| UPC 用户偏好冲突 | Ask-F1 | 81.36%(Gemini-3.8 Flash) | Claude Sonnet 5 29.53% | +51.83 个百分点 |
| 证据充分性消融 | 答案准确率 | 请求关键证据后 62.3% | 模糊输入 42.3% | +20.0 个百分点(全清晰输入为 63.1%) |
| ASK 预算消融(KVEM 开放题) | Ask-F1 | 预算 1 增至 16,约 52.35% 饱和 | 单次 ASK(K=1) | 多次提问有效但增益有限 |
局限与改进
作者承认与可观察的局限:主设定每轮只允许一次 ASK 与一次 ANSWER,虽补充了预算实验但未探索多轮追问策略;开放题评测依赖 Gemini-3.8 Flash 当裁判,内容正误判断可能偏向特定措辞;±1 秒容差与线性衰减的时机得分是人为设定,换参数结论可能变化。我的补充观察:流式模型全线 0 分部分源于它们从未被训练过 ASK 动作,动作空间不匹配导致'毁灭性'对比,未必完全反映能力上限;438 个视频、1,401 题规模不大,时长从 16.72 秒跨到 118 分钟且领域分布不均(Daily Life 126 个,Food & Dining 等领域极少);选项由 GPT-5.6 Sol 生成再人工核验,生成偏差可能残留;论文未给出任何改进方法或训练基线,基准与解法之间的桥还没有搭。
独立分析的弱点
独立分析几个弱点。其一,时机监督本质是人类标注者的'理想时机',与各模型的最优时机未必一致:不同感知能力的模型识别不确定性所需的最短观察时长不同,统一窗口可能惩罚更高效或更谨慎的策略,改进方向是引入自适应窗宽或基于模型校准的容差。其二,Ask-F1 的时机得分设计为窗内线性递减,隐含'越早越好'的偏好,但这只在异常告警等场景成立;对偏好澄清类任务,过早提问本就该罚,改进方向是按子任务定制时机效用函数。其三,用同档闭源模型(Gemini-3.8 Flash)做开放题裁判存在自偏置与裁判能力上限问题,可用多裁判共识或人工抽查校准。其四,StreamHarness 的分层压缩(10 帧并 1 条中期记忆、4 条中期并 1 个长期块)是启发式规则,摘要质量直接影响决策,应对比不同记忆压缩策略的敏感性。其五,流式模型 0 分缺少失败归因——是输出格式不匹配还是真的不会问,应提供接口适配层后再评测。
未来方向
作者方向上可延伸的:把 oracle 实验的结论转成方法——让模型显式估计证据充分度或不确定性来触发 ASK(如置信度校准、估算'问 vs 等'的期望收益);引入多轮追问与对话式澄清,突破单轮单问导致的约 52.35% 预算饱和;把跨轮记忆对用户不确定性的增益(AUQ +4.40、UPM +5.38)产品化为带用户画像的长期记忆模块。基于成果可延伸的:训练侧用强化学习把 Ask-F1 直接作为奖励,让流式模型学会 wait/ask/answer 三元动作策略;扩展到音频流、具身机器人与远程操作指导等更真实的不确定性场景;研究'问'的隐私与打扰成本,引入提问代价的权衡建模;以及将八个子任务作为诊断集,系统分析模型规模、架构与不确定性识别能力之间的关系。
复现评估
复现友好度中等偏上。论文页面标注提供 Website、Code 与 Data,基准数据(438 视频、1,401 题、2,714 时间窗)若如约开源,跑评测本身主要靠 API 调用:离线侧需 GPT-5.6-Sol、Gemini-3.8 Flash、Claude Sonnet 5 等闭源 API 加若干开源权重模型;流式侧需 GPU 跑 VideoLLM-online、AURA、TimeChat-Online 等 7B 量级模型,单卡 24GB 级别基本可覆盖;开放题裁判依赖 Gemini API,会产生持续费用。真正的门槛在于自建同类标注:帧级时间窗人工标注成本高昂(仅 ask 窗有效时长就达 30.47 小时),还需 Blender 合成与 Grounded SAM 2、PySceneDetect 处理流水线。总体判断:跑通评测容易,复现数据构建难,若要训练新方法则需自备训练设施。
论文图表
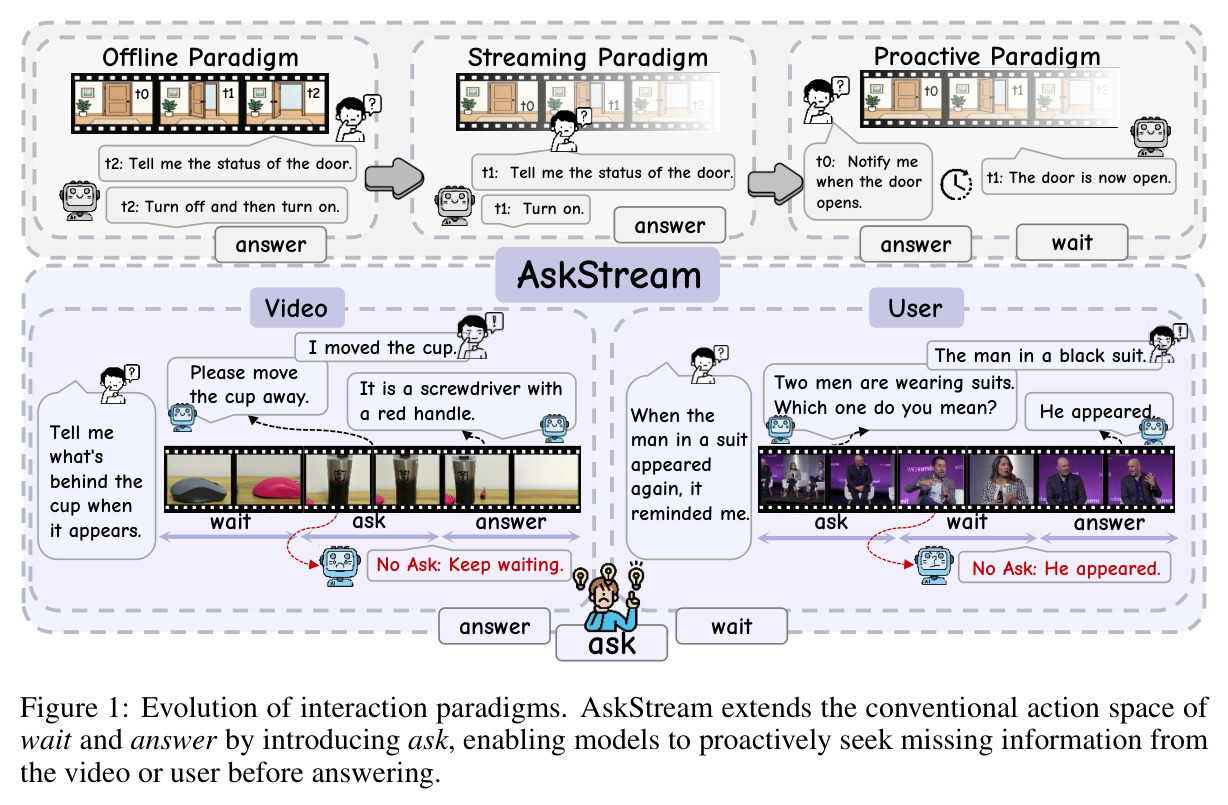
上半部分展示离线、流式、主动三种交互范式的演化;下半部分用'门开了通知我'和'请移开杯子'两个具体例子对比:只会 wait/answer 的模型要么无限干等、要么幻觉作答,而 AskStream 引入 ask 后,模型会反问'你指的是哪位男士'并索要缺失信息后再回答。
一图看懂论文要解决的问题与新增的动作空间,是理解全文设定与动机的入口。
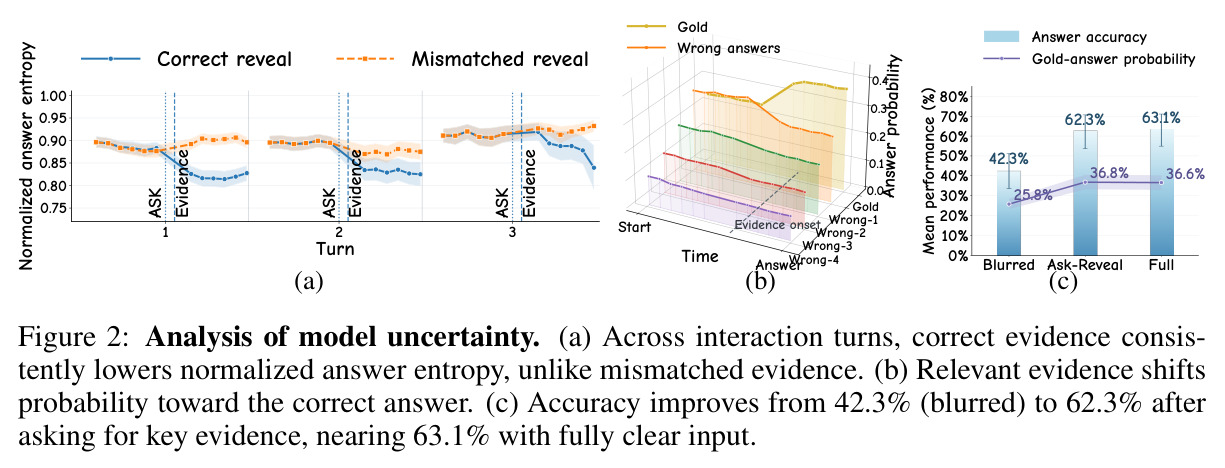
三联图:(a) 跨交互轮次,正确证据持续降低归一化答案熵,不匹配的证据几乎无效果;(b) 相关证据把概率质量推向正确答案;(c) 准确率从模糊输入的 42.3% 升至请求关键证据后的 62.3%,逼近全清晰输入的 63.1%。
这是'主动提问有用'的定量动机实验,直接支撑把 ask 纳入动作空间的必要性论证。