监督可见状态:流式视频中表征与视图选择的解耦 Supervising the Visible State: Separating Representation from View Selection in Streaming Video
可见状态监督补答案级监督之欠规范,测试时因果视图搜索按需扩展证据
前置知识
流式视频理解
模型在时刻 $T$ 只能观测到视频前缀 $V_{\le T}$,在受限上下文与计算预算下回答提问,与假设能看到完整录像的离线模型相对。评测在外生中断时间点 $T_e$ 提问,典型基准为 StreamingBench 与 OVO-Bench,前者考实时感知与因果推理,后者考回溯、前向与幻觉检测。
本文所有问题设定、视图构造与因果性约束都建立在流式设定上:任何视图只允许使用时间戳 $\tau_i \le T_e$ 的帧,这是 TVS 合法性的前提。
可见状态(visible state)
一个有界因果视图所确立的时间内容:哪些事件发生了、以何顺序、发生多少次、哪些对象关系发生了变化、以及已有证据是否足以确定答案。本文将其行为化定义——不引入任何架构内部状态,而是通过共享读出 $G_\theta$ 能从视图表征 $z_e$ 支持的时间预测族来度量。
它是 ViSS 监督目标的设计原则,也是把本文与只组织上下文的 context-centric 方法区分开的核心概念。
状态欠规范(state under-specification)
答案级监督的系统性歧义:动作做 1 次和做 3 次的历史会得到相同的动作识别标签,事件顺序不同或对象关系不同的历史也可能共享同一答案,因此损失函数不约束模型保留计数、顺序或关系信息,这些区分处于无人监督状态。
这是本文识别出的核心问题;ViSS 的五个探针族正是为把欠规范的时间区分重新纳入监督而设计的。
因果视图与视图策略
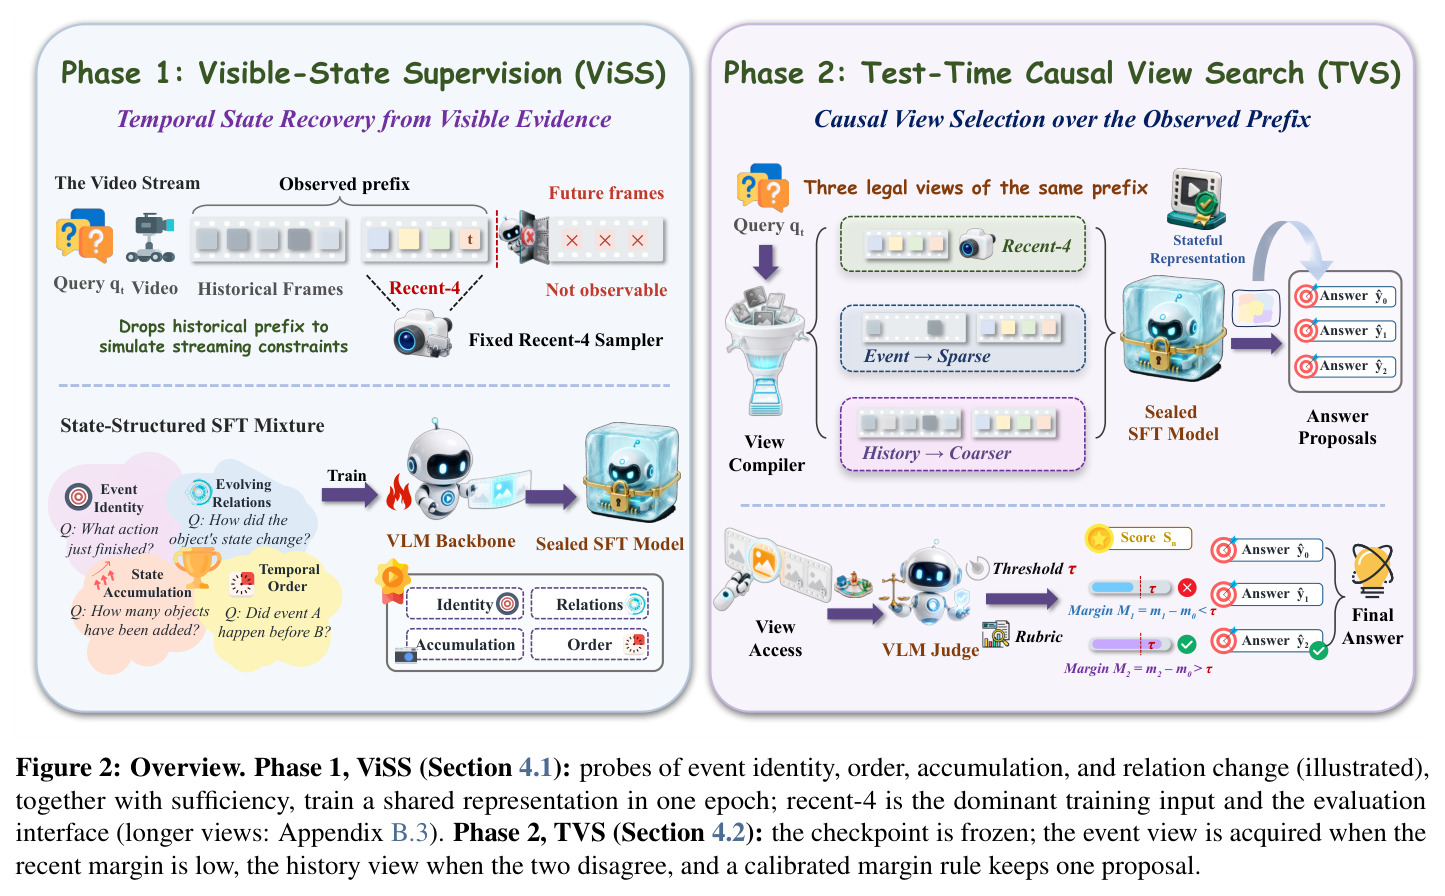
因果视图 $g$ 是对已观测前缀 $P_e(T_e)$ 的有预算渲染,只含 $\tau_i \le T_e$ 的源帧且保持时间顺序;视图策略 $\pi$ 决定顺序获取哪些视图,受唯一源帧预算 $B_f$ 与模型调用次数预算 $B_c$ 约束。本文的三个视图为 recent-4、稀疏事件视图(按视觉变化排序的早期帧)与紧凑历史视图。
TVS 是在冻结模型上搜索视图策略的方法,理解视图的形式定义与预算约束才能理解其获取与承诺规则。
置信 margin
模型答案的置信度量:首答案位置上全词表前两大概率之差 $m$。TVS 用它驱动全部决策——recent 视图 margin 低于 $\tau_a$ 时获取事件视图;recent 与事件提案不一致时获取历史视图;新提案 $k$ 仅当 $m_{e,k} - m_{e,j} > \tau_c$(校准后的 $\tau_c$ 为负)时才替换保留提案 $j$。
margin 是 TVS 唯一的决策信号,两个阈值在源不相交 holdout 上各校准一次后跨基准固定,是其工程关键。
strict replay 与 oracle 差距归因
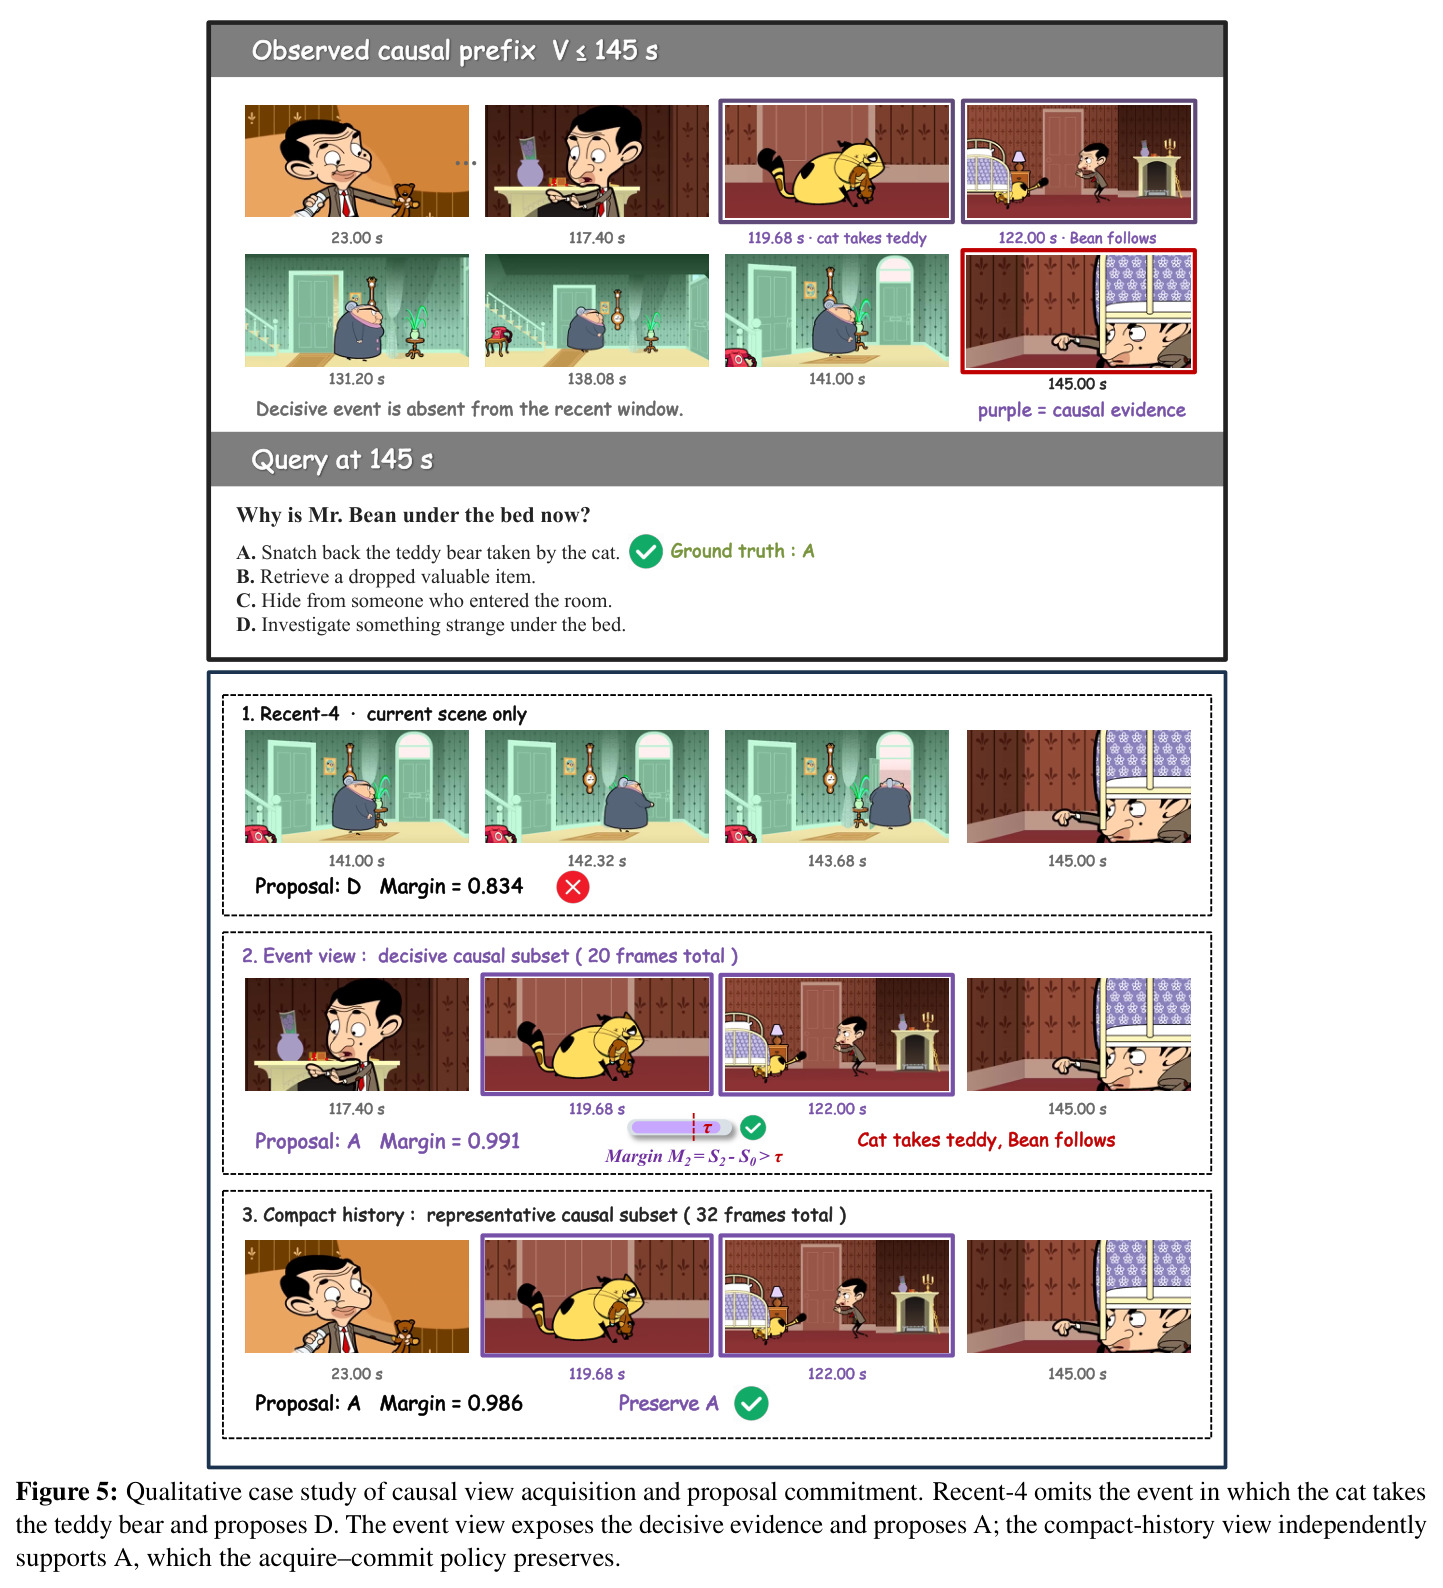
诊断协议:对冻结检查点重放全部三个视图的提案(仅为诊断,不用于推理),构造三视图 oracle——只要任一视图产出正确提案即算对;再把 oracle 与 TVS 的逐查询差距归因到获取错过(acquisition miss)、接受拒绝(acceptance miss)与替换错误(replacement error)三类。
论文用它定位剩余误差的主因是'曾持正确答案后被替换'(66.9%/71.9%),直接指明下一个研究瓶颈在承诺稳定性。
研究动机
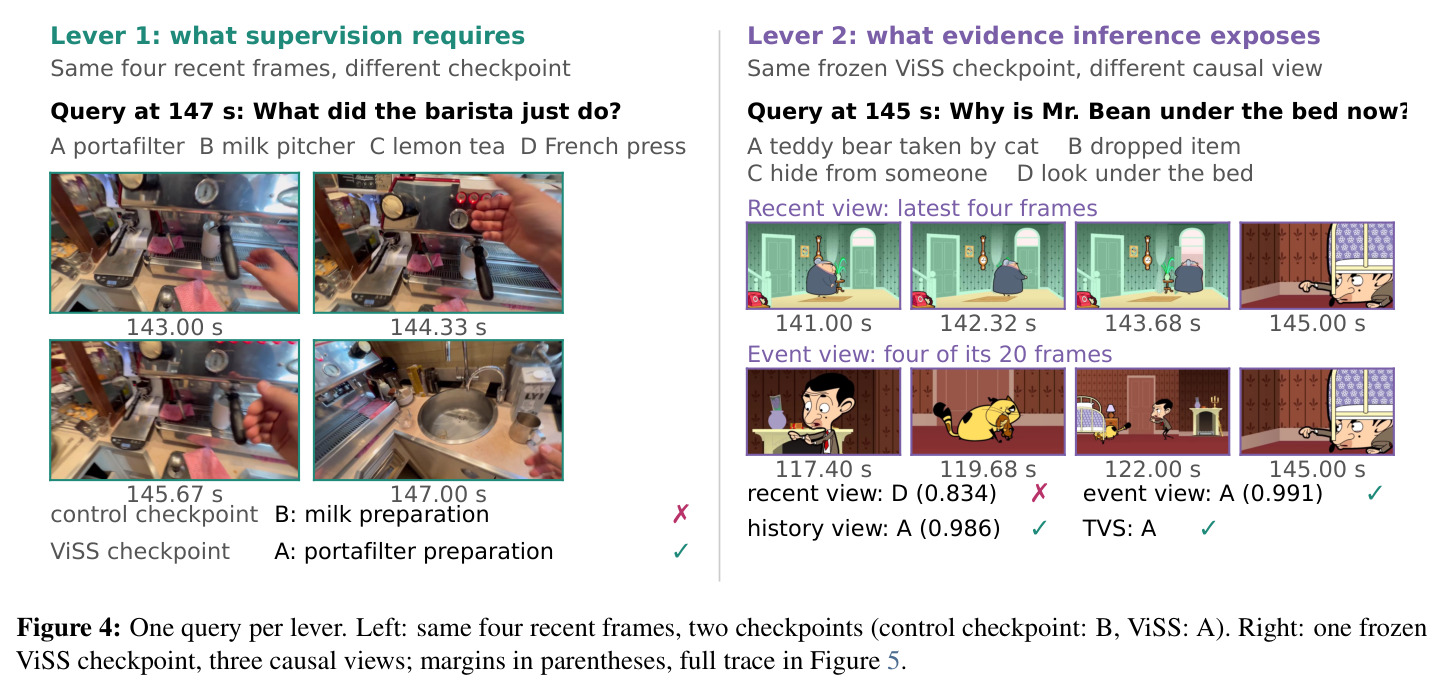
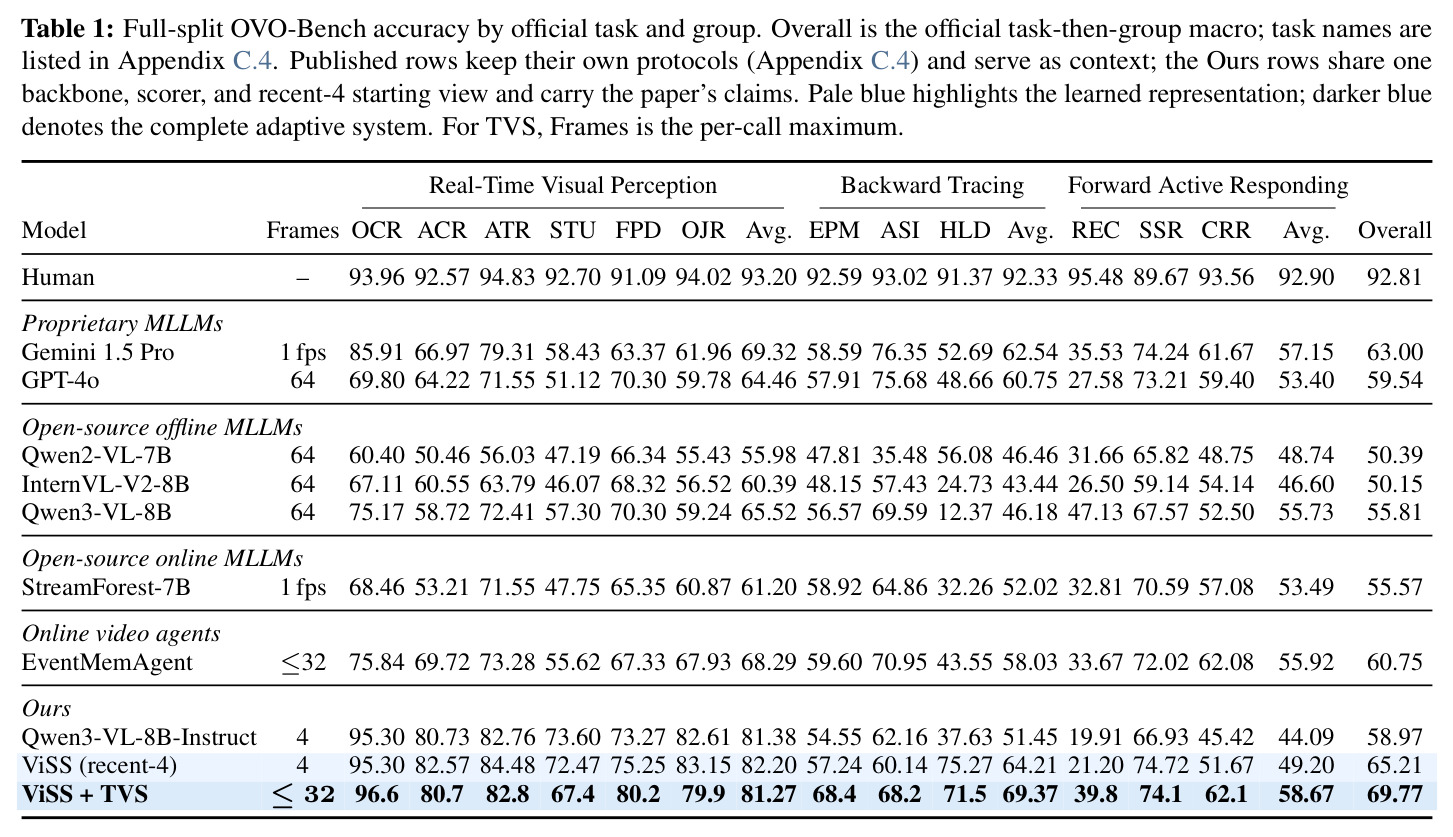
流式视频理解要求模型在时刻 $T$ 仅凭已观测前缀 $V_{\le T}$ 在受限上下文与计算下回答提问,无法像离线模型那样看到完整录像。现有方法大多聚焦 context-centric:用 token 压缩、持久记忆或事件检索来组织不断增长的视觉上下文;而 SimpleStream 表明一个现成 VLM 只读 4 帧近因帧就能匹敌许多复杂系统。但本文指出更根本的缺陷在监督层面:答案级监督存在'状态欠规范'——俯卧撑计数问题中,做 1 次与做 3 次的历史得到相同动作标签,监督不要求模型数数;事件顺序、对象关系变化同理。基准数据证实了这一点:基线 Qwen3-VL-8B 用 recent-4 在 OVO-Bench 幻觉检测 HLD 上仅 37.63、重复计数 REC 仅 19.91,恰是时间区分最被需要的地方。同时,即便表征再有状态性,也只能基于其视图暴露的证据:4 帧近因帧根本不包含召回与计数所需的历史。
本文的目标是本文要在同一 8B 骨干(Qwen3-VL-8B-Instruct)、同一评测协议与同一 recent-4 起始视图下,分离并分别优化两个独立杠杆。其一是表征:设计 Visible-State Supervision(ViSS),让训练目标显式要求模型保留事件身份、顺序、累积、关系变化与答案充分性这些时间区分,弥补答案级监督的欠规范。其二是证据获取:在冻结模型的前提下,用 Test-Time Causal View Search(TVS)在推理时按需从 recent-4 扩展到稀疏事件视图和紧凑历史视图,把推理算力花在确实需要更多证据的查询上。最终目标是在 StreamingBench 与 OVO-Bench 上以远少于穷举视图选择的处理帧数达到已发表系统的最佳精度(86.33 与 69.77),并通过受控干预量化每个杠杆各自的贡献。
与已有工作不同的是,本文的独特切入是把'监督什么'与'看什么'这两个长期纠缠的因素显式拆开并用受控实验分别测量:$\Delta_{rep} = S(\theta^\star, \pi_0) - S(\theta_0, \pi_0)$ 固定 recent-4 视图只换检查点,$\Delta_{access} = S(\theta^\star, \pi_{TVS}) - S(\theta^\star, \pi_0)$ 冻结检查点只换视图策略。此前的流式后训练工作(大规模多任务指令、因果时间注意力、强化学习奖励等)把时间后训练与目标表述混在一起,无法回答增益来自哪里;context-centric 工作只动上下文不动监督。此外,本文用 strict replay——对冻结检查点重放三个视图的全部提案——把剩余误差逐查询归因到获取失败还是'替换了已正确的答案',并给出 66.9%/71.9% 的量化结论,这种错误归因粒度是以往工作没有的。
核心方法
方法分两阶段,直觉是:流式模型的可见状态——事件是否发生、顺序、次数、关系变化、证据是否充分——决定它能回答什么,所以先训练模型保留这些区分,再在推理时按需扩大它看到的证据。阶段一 ViSS 在 Qwen3-VL-8B-Instruct 上做一次 epoch 的 SFT(冻结视觉塔,两块 H100 上 98 分钟),数据是 7,677 例源锚定探针混合:3,594 例源对齐通用视频样本、2,172 例基于 RepCount 的重复计数探针、1,012 例长前缀状态探针、116 例'证据不足'充分性样本、783 例教师提议的回溯/序列/计数探针;损失为 assistant 目标 token 的掩码似然 $\mathcal{L}_{ViSS}(\theta) = -\sum_i \alpha_i \sum_{j \in A_i} \log p_\theta(y_{i,j} \mid x_i, q_i, y_{i, \tau_c$ 决定是否替换保留答案;每次调用至多 32 帧,三调用路径至多 56 帧。
核心创新有三。第一是提出并正面解决'状态欠规范':当训练目标是由视图内证据唯一决定的区分性探针时(命题 1,附录 F),损失最小化的表征必须保留相应时间区分;同时联合要求五个探针族使需求互补而非任务特化——身份目标可以在不恢复次数或位置的情况下被满足,而计数与排序目标使这些区分成为必要,充分性目标则在证据不充分时惩罚轻率承诺。这与已有答案级 SFT 的本质区别在于目标结构本身。第二是把证据获取做成测试时搜索而非架构改动:三个问题无关的因果视图共享因果端点 $T_e$、保持时间顺序,由首答案位置的 margin(全词表前两大概率之差)驱动级联获取,无需训练检索器。第三是校准的负 $\tau_c$ 承诺规则:接受新提案不必有比保留答案更高的原始 margin,修正了不同视图间 margin 分布不可直接比较的问题;与投票式采样不同,TVS 在视图间按 margin 比较提案而非简单取舍。
方法步骤详情
步骤一,数据构造:优先从源标注直接构造探针;标注缺失的能力由多模态教师从源像素与时间戳提议候选问答,全程在构建防火墙后(排除基准媒体、问题、答案、任务元数据、学生预测与评测反馈)。候选须经源与时间戳检查、语义稳定性检查——两种选项置换 $\pi_a, \pi_b$ 下答案须映射回同一目标 $\pi_a^{-1}(\tilde y_{\pi_a i}) = \pi_b^{-1}(\tilde y_{\pi_b i}) = y_i$,审计者不见 $y_i$,不一致记录删除而非改标签——以及源成员、重复问题与重叠检查后准入,得 7,677 例。步骤二,ViSS 训练:输入为因果视图加探针问题,目标为直接答案(排除元数据与 rationale),以固定权重 $\alpha_i$ 优化 assistant-token 掩码似然,从公开初始化 $\theta_0$ 一次 epoch 得 $\theta^\star$。步骤三,TVS 推理:首次调用 recent-4 得答案 $\hat y_{e,0}$ 与 margin $\hat m_{e,0}$;$\hat m_{e,0} < \tau_a$ 时调用事件视图,两提案不一致时调用紧凑历史视图;每调用至多 32 帧,每查询至多 3 次调用;仅当 $m_{e,k} - m_{e,j} > \tau_c$($\tau_c$ 为负)才替换。两阈值在源视频不相交的 holdout 上各校准一次后跨基准固定,不使用基准任务标签或任务特定路由。
技术新颖性
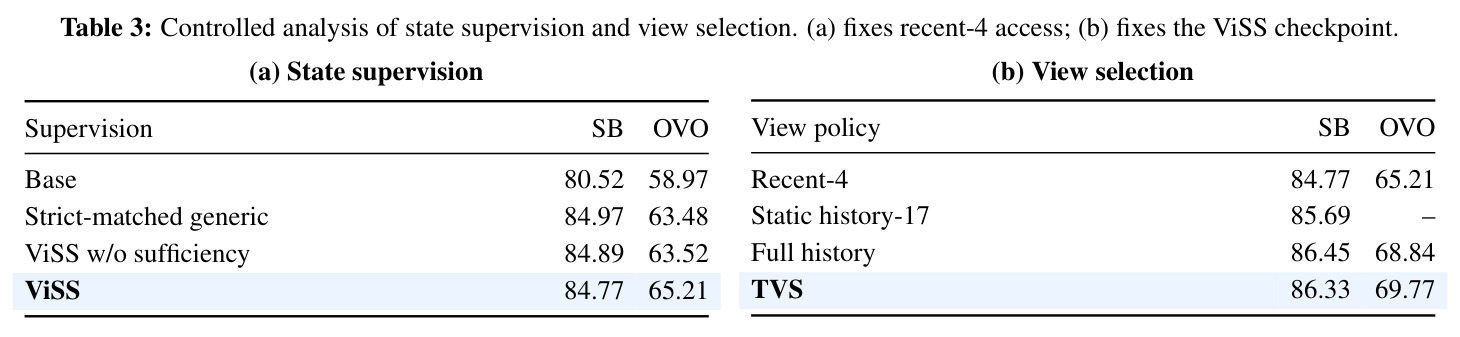
新颖性体现在三个层面。概念层面:'可见状态'是行为化定义的监督级概念——不添加架构状态、不声称唯一内部状态,而是通过共享读出 $G_\theta$ 从 $z_e$ 能支持的时间预测族来评估;'状态欠规范'指出了以往 SFT 数据设计中普遍被忽视的盲点。实验设计层面:受控干预把表征与访问的贡献分解为可相加的两段 $\Delta_{rep} + \Delta_{access}$,并用 strict-matched 对照(匹配 7,677 个训练实例、视觉输入、损失权重、顺序、优化与种子,仅改变问题-目标表述)证明增益来自目标结构而非额外时间后训练——通用时间 SFT 得 +4.51 OVO 点,ViSS 再加 +1.73;跨三个配对种子差距恒为正(均值 +1.72,95% CI [+0.80, +2.60])。系统与诊断层面:TVS 是查询无关视图族加校准获取/承诺的固定策略,其效果因此能与监督分开测量;strict replay 进一步把 66.9%/71.9% 的 oracle 差距归因到替换错误,把'证据获取已基本解决、瓶颈在承诺稳定性'这一结论建立在数据上。
实验结果
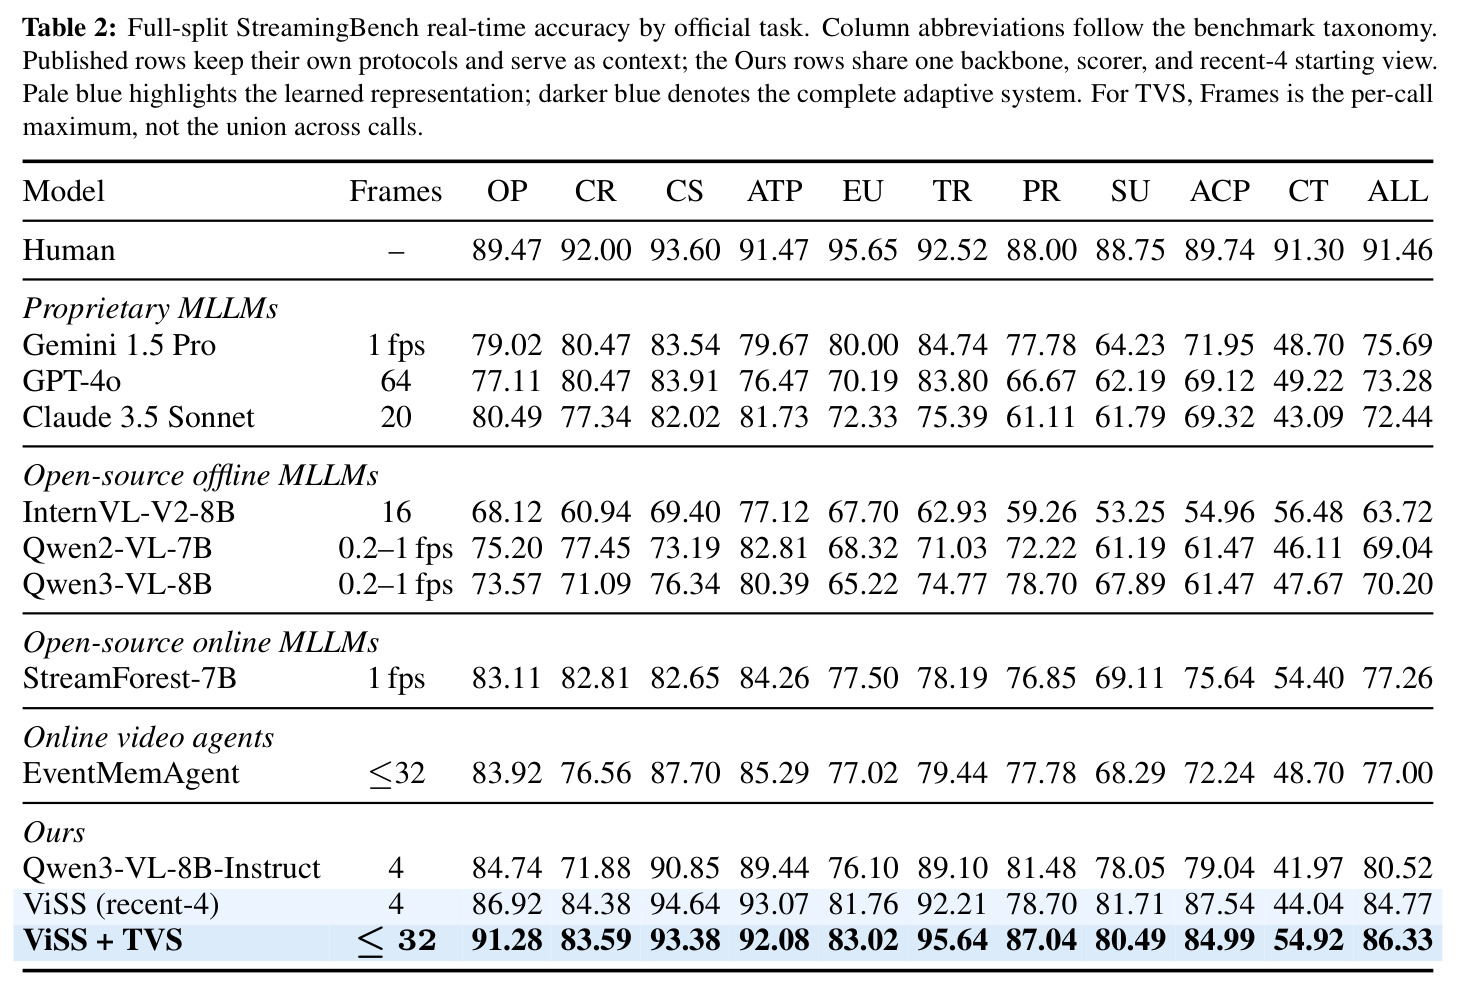
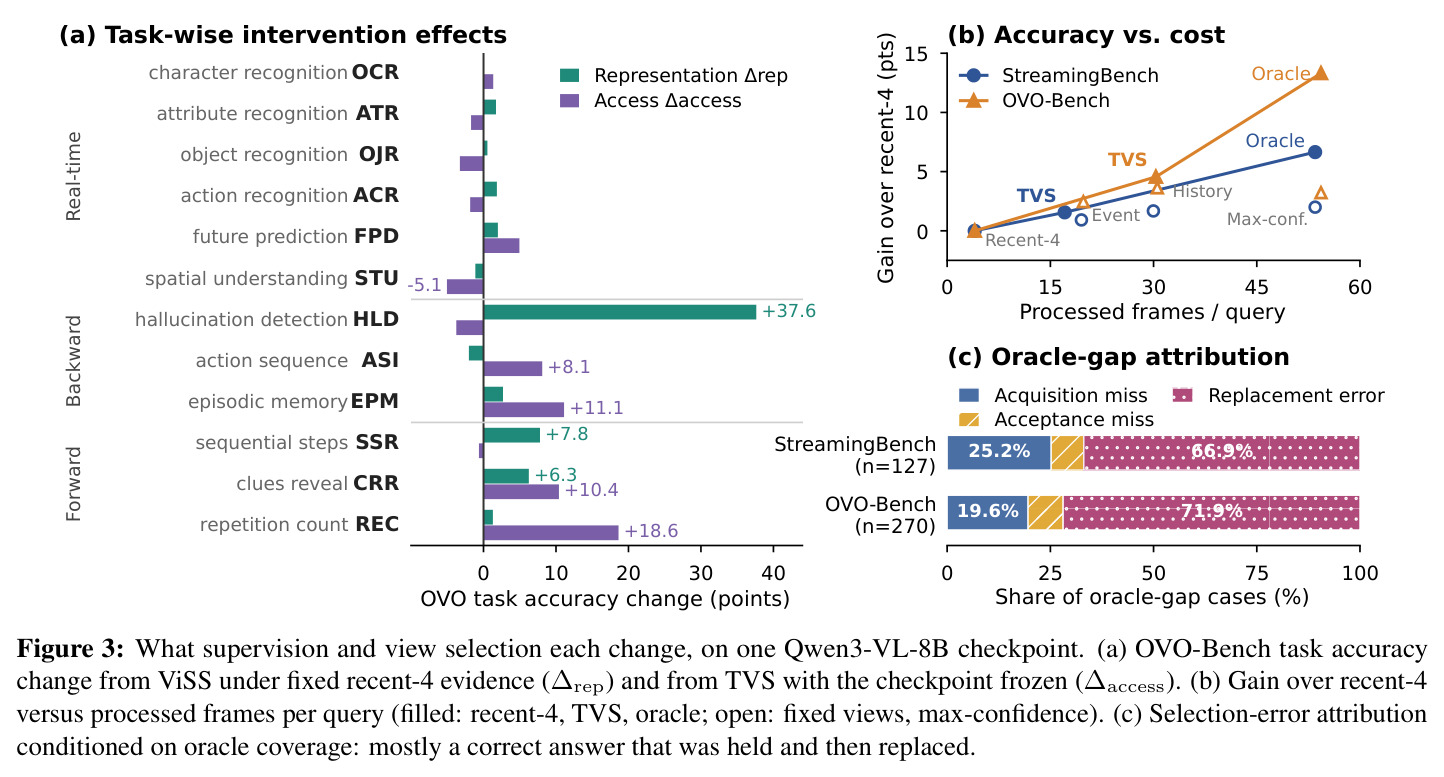
主结果围绕四个研究问题。RQ1(表征):固定 recent-4 下,ViSS 使 StreamingBench 从 80.52 升至 84.77(+4.25)、OVO-Bench 从 58.97 升至 65.21(+6.24),幻觉检测 HLD 从 37.63 翻倍至 75.27;对比 strict-matched 通用时间 SFT(84.97/63.48),ViSS 在 OVO 上再 +1.73、HLD +8.06;三配对种子下 OVO 差距恒正(均值 +1.72,95% CI [+0.80, +2.60]);移除 116 例充分性样本使 OVO 降 1.69、HLD 降 4.30(McNemar $p = 4.5 \times 10^{-5}$)。RQ2(访问):冻结检查点启用 TVS 再加 StreamingBench +1.56 至 86.33、OVO +4.56 至 69.77,合计 +5.81/+10.80,为对比系统中已报告最高分;帧效率上 OVO 用 30.33 帧超过穷举 max-confidence 选择(68.43,54.33 帧)与单次历史调用(68.84),移除获取门控帧数升至 27.26/33.31 而精度不变。RQ3(分工):监督主要改善 HLD 与因果推理(SB 上 CR +12.5、ACP +8.5、EU +5.7),访问主要改善事件召回与前向推理(REC 21.20→39.83、EPM→68.35、ASI→68.24),代价是 HLD 降至 71.51、实时组 82.20→81.27。RQ4(剩余差距):三视图 oracle 达 91.42/78.52(高于 TVS 5.09/8.75);strict replay 将 66.9%(SB,n=127)/71.9%(OVO,n=270)的差距归因于替换错误,获取错过占 25.2%/19.6%;正确提案存在时 TVS 取回 63.3%/71.1%,并保留 96.9%/92.3% 的最初正确 recent 答案。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OVO-Bench 全量(宏平均) | 任务-分组宏平均精度 | 69.77(ViSS+TVS) | 58.97(同骨干 Qwen3-VL-8B recent-4);Gemini 1.5 Pro 63.00;EventMemAgent 60.75 | +10.80(对同骨干) |
| StreamingBench 全量实时 | 字母精确匹配精度 | 86.33(ViSS+TVS) | 80.52(同骨干 recent-4);StreamForest-7B 77.26;Gemini 1.5 Pro 75.69 | +5.81(对同骨干) |
| OVO-Bench 幻觉检测 HLD | 任务精度 | 75.27(ViSS,recent-4) | 37.63(基线 recent-4);67.20(strict-matched 通用 SFT) | +37.64(对基线);+8.06(对严格匹配对照) |
| OVO-Bench 重复计数 REC | 任务精度 | 39.83(ViSS+TVS) | 21.20(ViSS recent-4) | +18.63(TVS 冻结检查点后) |
| ViSS 受控对照(OVO-Bench) | 总体精度 | 65.21(ViSS) | 63.48(strict-matched 通用时间 SFT) | +1.73(95% CI [+0.80, +2.60],三种子均值 +1.72) |
| 测试时帧效率(OVO-Bench) | 每查询处理帧数 | 30.33 帧(69.77) | 54.33 帧(穷举三视图 max-confidence,68.43) | 约 44% 帧节省且精度 +1.34 |
局限与改进
作者明确承认的局限:所有受控结论基于单一 8B 骨干(Qwen3-VL-8B-Instruct)和两个基准,跨规模与跨模型族迁移未验证;TVS 阈值只在一次源不相交 holdout 上校准后固定,跨分布泛化未知;可见状态是行为级概念,未添加架构状态,模型只能基于视图暴露的证据回答;两个干预是分阶段的而非独立——视图的价值取决于读取它的检查点;已发布系统行保留各自协议只能作参考,论文声明只建立在受控行上。诊断是条件性的:strict replay 只覆盖提案集合内的错误,SB 上 56.3%、OVO 上 62.9% 的 recent 视图错误没有任何视图能给出正确提案,这些未被归因分析覆盖。我自己的观察:作者自己报告接受一切不一致提案得 86.53/69.75,说明校准 margin 规则 $\tau_c$ 没有一致的总体收益,其工程价值存疑;实时感知组从 82.20 微降至 81.27 提示更宽证据可能稀释近因注意力;充分性样本仅 116 例且移除实验同时改变训练总量,作者承认这不是孤立的语义效应;TVS 最多 3 次 VLM 调用的推理延迟成本未报告,对真实流式部署是隐患。
独立分析的弱点
弱点一:承诺规则是最大瓶颈但方案最弱——66.9%/71.9% 的 oracle 差距来自替换错误,而校准 margin 规则本身无一致增益(接受一切不一致提案反而得 86.53/69.75)。改进方向:跨视图答案一致性校验、基于 rationale 的一致性比较、或学习一个提案选择器,把'保留已正确答案'作为显式训练目标。弱点二:视图族是查询无关的固定三视图,事件视图按视觉变化排序帧,对需要特定对象或文本证据的查询(OCR、细粒度属性)可能劣于学习式检索;改进方向:把查询嵌入引入帧排序同时保持因果防火墙。弱点三:监督杠杆对 StreamingBench 几乎无额外贡献(相对 strict-matched 对照为 -0.20),增益集中于 OVO 的 HLD 与时间任务,说明可见状态表述的收益依赖基准任务构成;改进方向:探针族与目标能力做更细粒度的对齐分析。弱点四:充分性与教师合成探针数据量小(116/783 例),语义稳定性检查只保证标签稳定、不保证问题真的需要历史(作者自己声明);改进方向:加入'必须历史才能作答'的构造性过滤。弱点五:每查询至多 3 次 8B VLM 调用的延迟成本未报告,56 帧上限对超长视频可能不足;改进方向:蒸馏轻量 gate 模型或缓存 KV 摊薄成本。
未来方向
作者指出的方向:设计更稳定的答案选择机制——把'模型是否保留已获得的正确答案'(承诺稳定性)作为显式目标,这是 strict replay 归因的直接推论;跨规模(>8B)与跨模型族的迁移验证;任务级增益差异的更细分析(监督利于状态保真、访问利于召回与前向但损害部分近因决策)。基于成果可延伸的方向:把 strict replay 的三分类归因框架(获取/接受/替换)推广为测试时诊断协议,用于其他 agent 式推理系统;将 $\tau_a, \tau_c$ 的 holdout 校准扩展到多轮流式会话中的在线校准;把充分性/欠规范探针引入更广泛的多模态 SFT 配方,并研究与 DPO 式偏好优化的交互——例如把'证据不足时拒绝回答'作为偏好目标;探索查询相关的事件视图排序与固定视图族的混合,兼顾检索精度与可测性;把 oracle-gap 归因作为训练信号构造针对性课程,专训'何时改口'的决策。
复现评估
复现条件较好,属中低难度。代码开源(github.com/yihaohu0118/ViSS),项目主页 yihaohu0118.github.io/ViSS,模型权重、处理器、源码与示例配置经 ViSS 资源集合发布;骨干为公开的 Qwen3-VL-8B-Instruct。算力门槛很低:ViSS 是一次 epoch 的 SFT,冻结视觉塔,7,677 例数据在两块 H100 上仅 98 分钟;TVS 零训练,只需校准两个阈值。评测协议完全指定:StreamingBench(2,495 查询)与 OVO-Bench(3,035 查询)全 split、官方 scorer、统一 recent-4 起始视图;附录 B/B.3 给出数据管线与优化配置,所有数值定义于 numbers.tex 并溯源到版本化记录。缺口:训练标注、原始媒体与内部实验记录不随发布;教师合成数据的具体 prompt 细节需查阅附录;基准媒体不重分发,需自行从源数据集(如 RepCount)获取;阈值校准的 holdout 划分细节在附录 A。主要工程量在于忠实重建数据构造管线(防火墙、稳定性检查、选项置换校验)。
论文图表
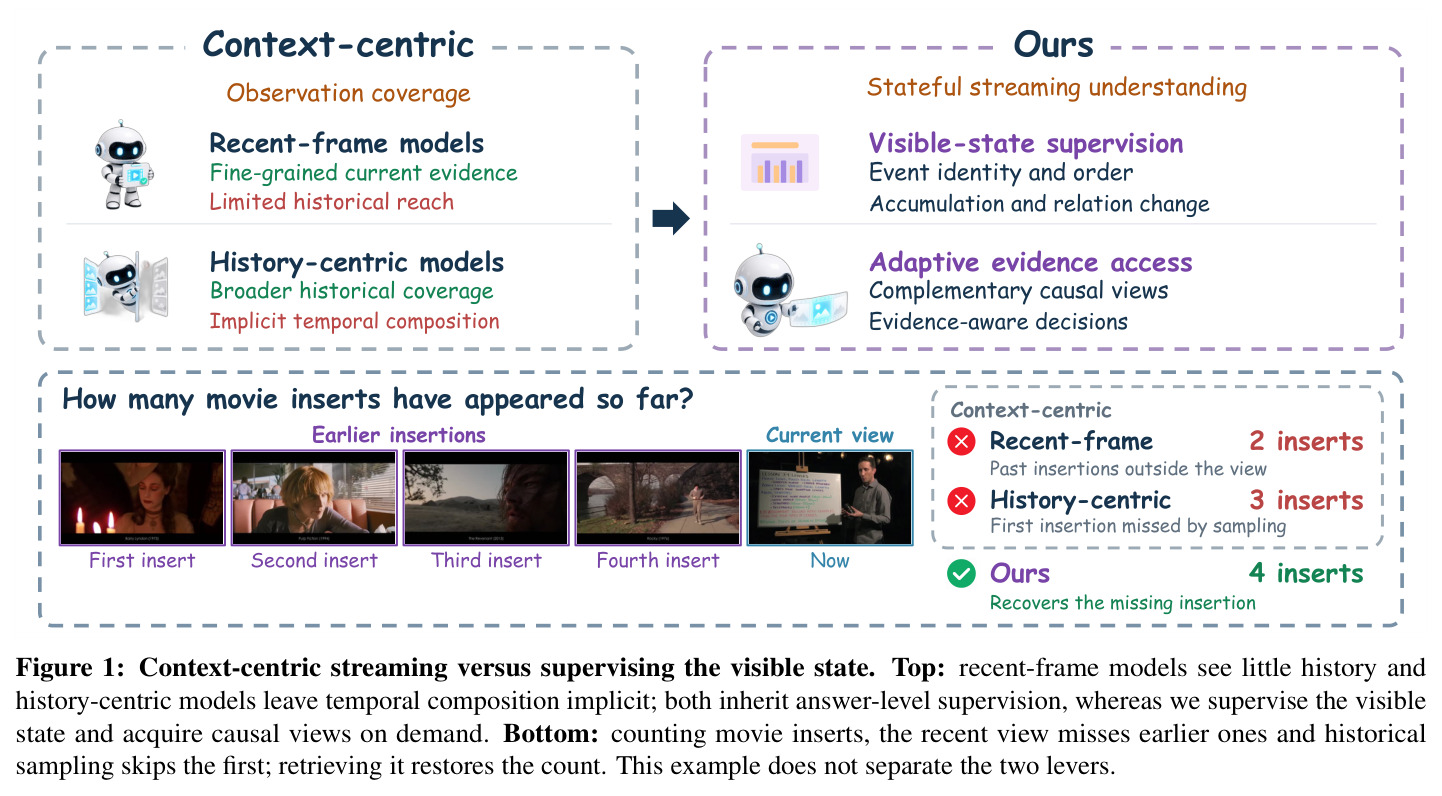
上半部分对比三类范式:context-centric 方法(recent-frame 模型只见近期、history-centric 模型历史覆盖广但时间组合隐式)继承答案级监督;本文方法则做可见状态监督(事件身份与顺序、累积与关系变化)加按需自适应证据获取(互补因果视图、证据感知决策)。下半部分用'到目前为止电影里出现了几个插入镜头'的例子:recent 视图漏掉更早的插入(数出 2),历史采样跳过第一次插入(数出 3),本文方法取回缺失插入数出 4。作者注明该例子并不能区分两个杠杆。
用最直观的计数场景说明答案级监督与上下文组织的双重缺陷,是理解论文动机与两个杠杆定位的入口。