StreamVibe:面向演化用户意图的主动式视频智能体 StreamVibe: Proactive Video Agents for Evolving User Intent
构建意图感知流式视频基准与模型,主动推断、追踪并适应不断演化的用户意图。
前置知识
视觉-语言模型(VLM)
视觉-语言模型是同时接收图像/视频帧与文本输入的多模态大模型,典型结构为视觉编码器加连接器把视觉特征映射到语言模型token空间,再由LLM完成理解与生成。本文的 StreamVibe-VL 就是以约9B级VLM为底座,在连续视频流上做逐秒决策(沉默/响应)并生成帮助性文本。
本文的全部训练方法(SFT、RL)和评测对象都是VLM,理解视觉token与决策token如何在同一序列中混合优化是读懂方法部分的前提。
流式视频理解
流式设定下模型边看边判断:视频以约1 FPS持续到达,模型必须在视频播完之前实时给出响应,而不是像离线VideoQA那样看完整段再回答。响应时机本身成为被评测的对象——太早是 Premature,太晚或不说算 Missed,重复说是 Redundant。
StreamVibe 的任务形式化 $a_t=\pi(c_t)\in\{\text{silence},\text{response}\}$ 是逐时间步的因果决策,与离线问答范式完全不同,不理解流式设定就无法理解为什么时机和状态跟踪是核心难点。
GRPO(组相对策略优化)
GRPO 是 DeepSeek 提出的强化学习算法:对同一prompt采样一组(多个)rollout,用组内奖励的相对优势代替价值网络来计算策略梯度,省去 critic 模型,训练稳定且显存友好,已被广泛用于LLM的RLHF/RLVR阶段。
StreamVibe-VL 的第二阶段训练(Localized Trajectory RL)直接构建在 GRPO 之上,其奖励设计(点级 $R_{align}$ 与轨迹级 $R_{glob}$)只有放在 GRPO 的组内相对比较框架下才能正确理解。
Agent Harness 与持久状态
Harness 指包裹在模型外部的智能体脚手架:负责维护显式的持久状态(如意图列表、任务进度、已发响应记录)、管理记忆的写入与检索、在每步决策前把压缩后的上下文注入模型。模型本体只负责感知和生成,状态管理由外部程序化逻辑完成,二者解耦。
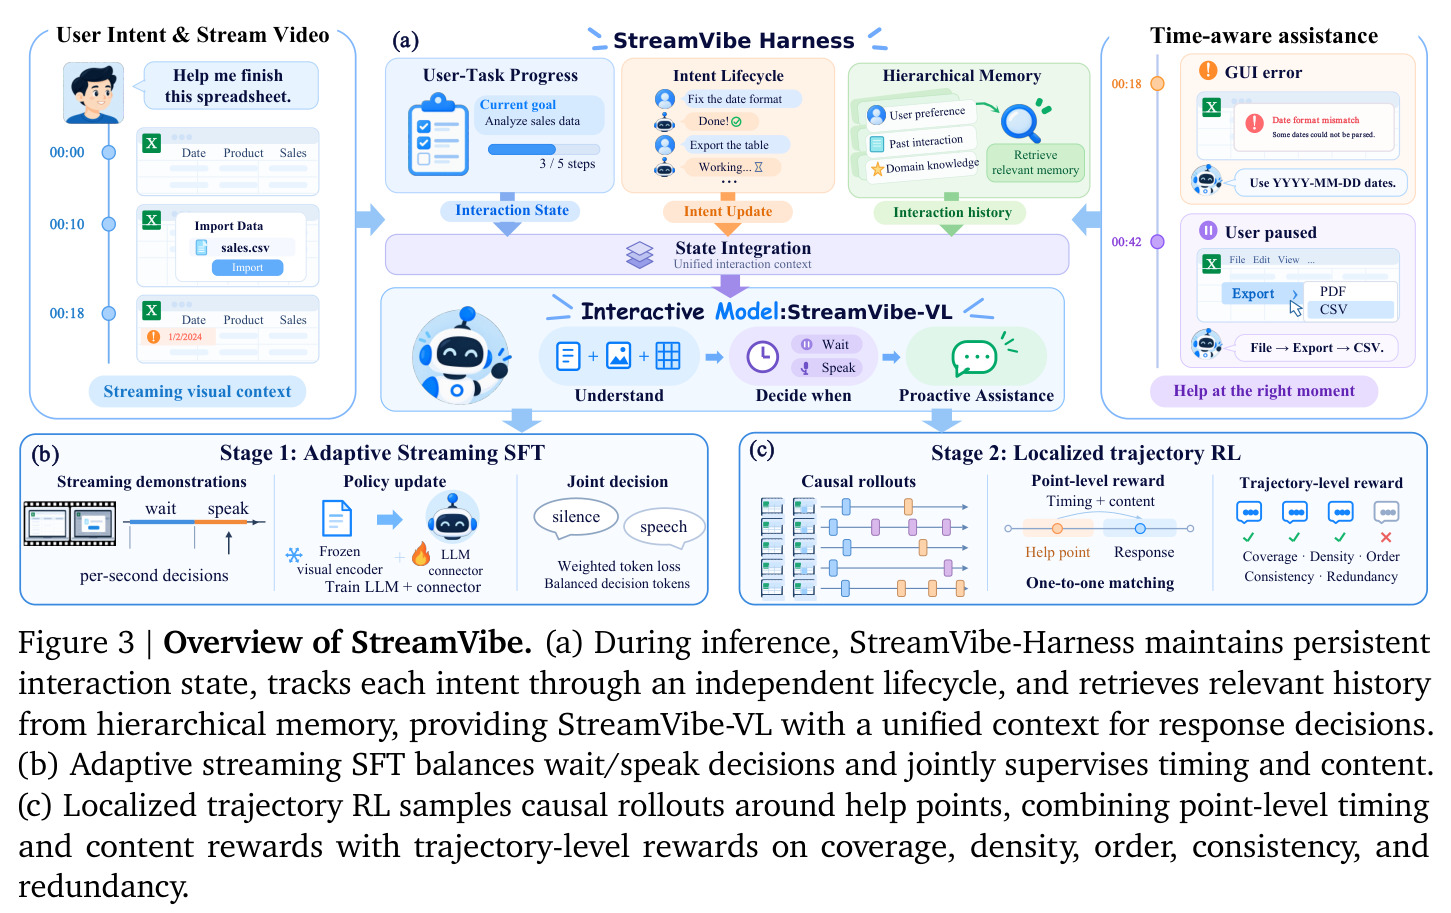
本文的核心发现之一是『会说话的模型』不等于『持续可靠的助手』:StreamVibe-Harness 通过交互状态 $S_t=\langle A_t, P_t, R_t\rangle$ 和分层记忆显式跟踪意图生命周期,这是理解本文三层贡献(bench/model/harness)的关键。
FTS 与 LLM-as-Judge 评测
LLM-as-Judge 指用强模型(本文用 Claude Sonnet 4.6)替代人工对开放式生成回答打分,通常在0-4量表上评估正确性与相关性;配合基于关键词重叠的 Content F1 度量要点覆盖。响应时序则用精确率/召回率/F1/误报率(FPR)在带容差(±2s)的标注时间窗上统计。
本文所有结果表都由『时序四指标 + Answer Score + Content F1』构成,且点级(Pointwise)与轨迹级(Trajectory)两种评测协议的差异正是论文的核心实验设计,需要先懂评测才能读懂结论。
研究动机
视觉-语言模型正从离线的被动理解走向在线的主动交互,但现有主动交互方法存在三个结构性缺陷。其一是过度依赖显式请求:现有系统只响应「进球了通知我」「下载完成提醒我」这类明确指令,完全忽略隐式意图——例如用户在看教程视频时说「帮我盯着这道菜」,或浏览网页时心里想着「下一步该点哪里」,模型既不知道该不该出手、也不知道何时出手。其二是缺乏任务状态跟踪:图1(ii)展示了典型失败——用户请求过、任务其实已完成,但模型基于过时的状态估计(Stale estimate)反复给出重复建议,或在该帮忙时(Help pending)沉默不语;即使像 MMDuet2 这类流式模型能保留很长的交互历史,也维护不出『此刻最新』的任务状态。其三是意图会随交互演化:用户中途可能修订(Revision)原目标、叠加(Composition)新约束、或打断(Interruption)插入即时请求,而现有方法往往继续按最初的意图A响应,无视用户已经转向意图B。这三个缺陷叠加,使得现有范式在真实开放场景中产生大量过早、遗漏、重复、过时的响应。
本文的目标是本文要回答三个研究问题:如何构建一个覆盖隐式与动态意图的主动交互测试床?如何把意图感知交互内化为模型的底层能力而非外部规则?如何在长时程交互中灵活管理上下文以跟踪环境与意图的变化?为此论文设定了三线并行的目标:构建统一基准 StreamVibe-Bench,用 4.1K 评测样本和 85K 训练样本(70K SFT + 15K RL,另有 768K 通用流式视频样本)覆盖显式、隐式、动态三级意图,横跨物理环境(自我中心日常任务)与数字环境(GUI/计算机操作)两类场景,同时支持点级与轨迹级两种评测;在基准之上训练 StreamVibe-VL,让流式视频模型联合学会『何时响应』与『如何响应』;再设计 StreamVibe-Harness,把用户意图维护为可增删改的持久状态,配分层记忆,使模型在持续交互中保持行为一致性。论文的量化目标是从基线上提升响应时机与答案质量,并验证在隐式/动态意图上的增益。
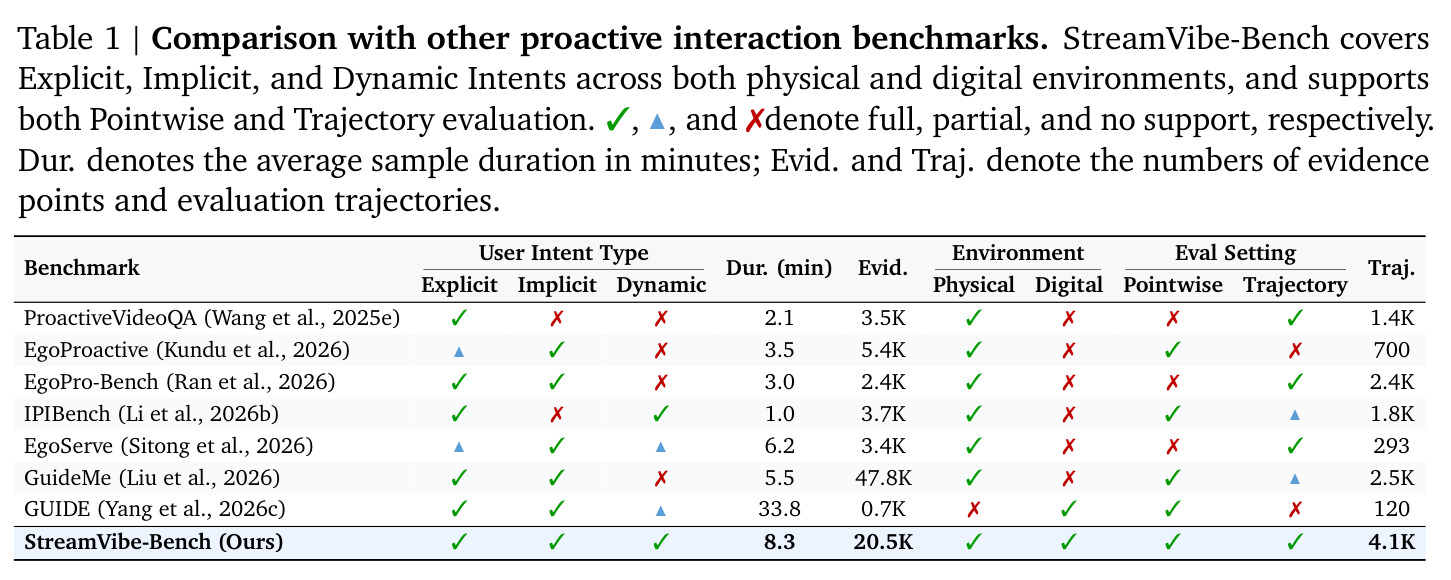
与已有工作不同的是,本文的独特切入角度有三点。第一,它是第一个把『用户意图』本身作为研究对象的主动流式交互工作:此前的主动基准(ProactiveVideoQA、EgoProactive、EgoPro-Bench、IPIBench、EgoServe、GuideMe、GUIDE)各自只覆盖单一意图类型或单一环境(见表1:GUIDE 只有 0.7K 样本、33.8 分钟超长视频;ProactiveVideoQA 只有显式意图),且多为逐点独立评测;StreamVibe-Bench 是唯一同时覆盖三类意图×双环境×点级/轨迹级双评测的基准,平均样本时长 8.3 分钟、含 20,546 个帮助点、共 183.4 小时视频。第二,方法论上把问题拆成『证据接地』与『状态跟踪』两个正交子问题:策略 π 只负责基于当前视觉证据决定何时/如何说话,而维护活跃意图集 $A_t$、任务进度 $P_t$ 的职责交给外部 Harness $\phi$,二者解耦。第三,训练上提出『局部化轨迹RL』:不在整条轨迹上做强化学习,而是在标注帮助点附近构建短因果 rollout,避免全轨迹优化中正确与错误行为混合导致的信用分配稀释。
核心方法
整体方案分三层。第一层是基准构建:从物理环境(自我中心日常活动)和数字环境(GUI 操作录屏)收集任务视频,用 Gemini-3.8-Flash 预清洗并标注候选帮助点,每个帮助点带响应窗口 $[s_j^k, e_j^k]$ 和参考答案;对动态意图额外构造带时间戳的多轮交互(修订/复合/打断),再由四名评审独立验证、只保留全票通过的样本,对齐到 1 FPS 因果流。数据构成为显式意图 600 样本(14.6%)、隐式意图 2000 样本(48.8%,含引导/学习/监控/工具四子类)、动态意图 1500 样本(36.6%,含修订RV/复合CP/打断IT),合计 4100 评测样本、20,546 个帮助点、183.4 小时视频。第二层是模型训练:先做自适应流式 SFT 学会何时/如何响应,再做局部化轨迹 RL 提升决策选择性。第三层是推理时的 Harness:维护交互状态 $S_t=\langle A_t,P_t,R_t\rangle$(活跃意图、任务进度、已发响应),每个意图是独立生命周期实例,分层记忆保留近期细粒度信息、逐步压缩远期内容,每次决策前检索 $m_t=\text{Retrieve}(M_{<t},A_t,P_t)$ 并整合为 $\tilde{c}_t=\phi(c_t,S_t,m_t)$ 交给策略。
核心创新是把持续主动交互形式化为因果流上的证据覆盖决策问题,并用训练与架构两条路径分别攻克:智能体在时刻 t 只能看到 $c_t=\langle V_{\le t}, I_{\le t}, H_{<t}\rangle$,预测 $a_t=\pi(c_t)\in\{\text{silence},\text{response}\}$,只有当它在窗口内用语义正确的回答覆盖意图的证据点时,该意图才算完成。与已有工作的本质区别有三:(i)自适应流式 SFT 对决策 token(沉默/响应)使用随当前批次决策类分布自适应的权重 $\omega_j=\gamma_{B,c^{(j)}}$,平衡不同数据源悬殊的沉默/响应比例、抑制过度沉默或过度响应,文本 token 用固定 $\lambda_{text}$ 保住生成能力,损失为 $\mathcal{L}_{SFT}=-\frac{1}{|\mathcal{Y}|}\sum_{j\in\mathcal{Y}}\omega_j\log\pi_\theta(z_j|c^{(j)},z_{<j})$;(ii)局部化轨迹 RL 只在帮助点附近采样短 rollout,用 GRPO 优化 $R=\lambda R_{align}+(1-\lambda)R_{glob}$($\lambda=0.7$),点级奖励做时序×内容的一对一匹配,轨迹级奖励评估覆盖、密度、顺序、一致性与冗余,避免全轨迹优化的信用分配稀释与堆量刷分;(iii)Harness 把意图作为带生命周期的一等公民状态显式维护(持久型跨事件存活、一次性完成后关闭),只在有充分交互或感知证据时才更新,这与只做历史存取的记忆系统(Mem0 类)根本不同。
方法步骤详情
训练分两阶段。阶段一(自适应流式 SFT):输入 70K 任务样本加 768K 通用流式样本(TimeChat-Online、VideoChat-Flash),输出对齐 1 FPS 的逐秒决策与响应文本;按 $\mathcal{L}_{SFT}=-\frac{1}{|\mathcal{Y}|}\sum_{j\in\mathcal{Y}}\omega_j\log\pi_\theta(z_j|c^{(j)},z_{<j})$ 优化,决策 token 权重 $\gamma$ 随批次决策类分布调整,文本 token 权重 $\lambda_{text}$ 固定。阶段二(局部化轨迹 RL):在每个帮助点 $g$ 附近构造短因果 rollout(冻结视觉编码器,只训 LLM 与连接器),用 GRPO 训练;点级奖励定义时间偏移 $\Delta_{g,p}=t_p-t_g$,时序分 $\tau(\Delta_{g,p})\in[0,1]$ 在非对称窗口内打分,内容分 $\rho(g,p)\in[0,1]$ 由 LLM 评判,乘积做一对一匹配得匹配集 $\mathcal{M}$,聚合时惩罚漏报与过报:$R_{align}=\frac{(1+\alpha)\sum_{(g,p)\in\mathcal{M}}\tau(\Delta_{g,p})\rho(g,p)}{N_{pred}+\alpha N_{gt}}$;轨迹级奖励 $R_{glob}$ 从覆盖、密度、顺序、一致性、冗余五方面评估整段 rollout;最终 $R=\lambda R_{align}+(1-\lambda)R_{glob}$,$\lambda=0.7$,不设格式奖励。推理时 Harness 先增量更新 $S_{t-1}\to S_t$(增/改/终止意图、更新进度),再检索 $m_t$,整合出 $\tilde{c}_t=\phi(c_t,S_t,m_t)$ 交给策略生成,响应后写回状态与记忆。
技术新颖性
技术新颖性体现在四个层面。基准层面:表1显示现有 7 个主动基准无一同时覆盖显式/隐式/动态三类意图(GUIDE 仅部分支持动态、仅 120 条轨迹),无一同时覆盖物理+数字双环境,仅本文同时提供点级与轨迹级评测;StreamVibe-Bench 以 4.1K 轨迹、20.5K 证据点、8.3 分钟平均时长为同类最大。训练层面:自适应决策 token 加权针对流式训练特有的『沉默/响应比例失衡』痛点,区别于一视同仁的普通 SFT;局部化轨迹 RL 把 RL 作用域压缩到帮助点邻域,$R_{align}$ 的分母项 $N_{pred}+\alpha N_{gt}$ 直接惩罚过报、乘法匹配分加一对一匹配防止堆量刷分。架构层面:现有记忆系统只做历史存取与抽象、不跟踪意图与任务进度演化,导致响应漂移;Harness 为每个意图维护独立生命周期实例(状态、相关证据、完成态),且『生命周期只决定哪些意图有效,何时/如何响应仍由策略决定』,职责划分清晰。评测层面:gold history 与 self history 双协议把局部决策能力与自生成历史的污染效应分离,使论文能定量证明持续交互会放大错误(Content F1 下降 45–61%)。
实验结果
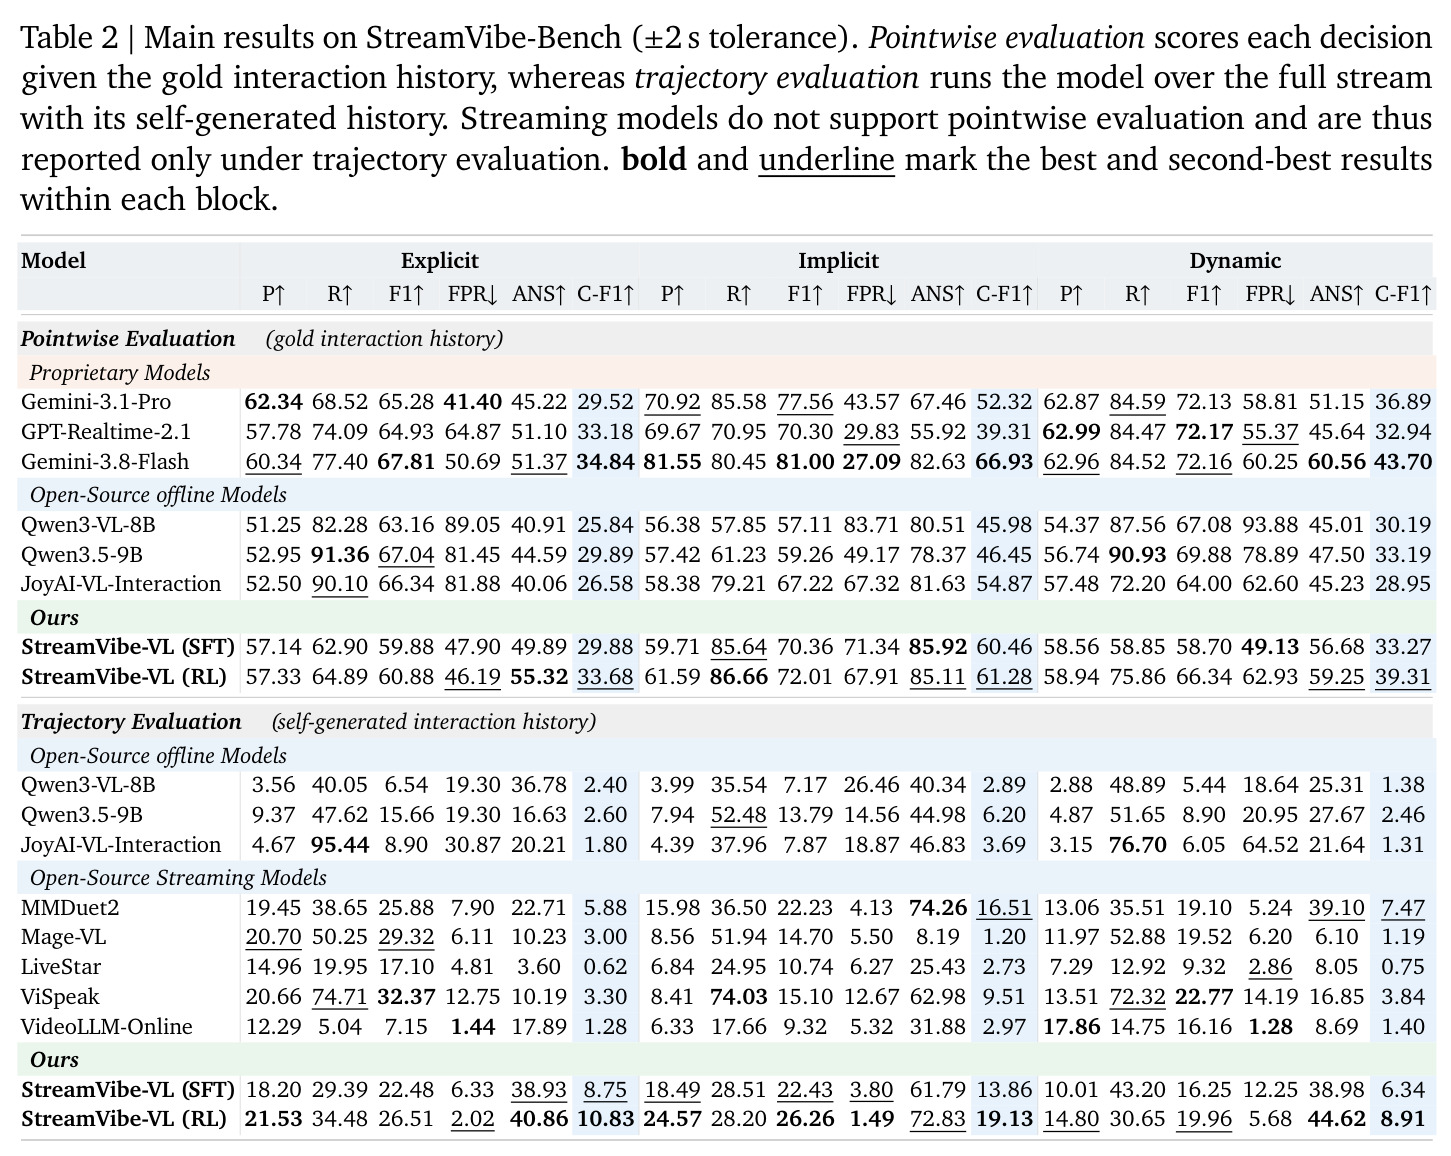
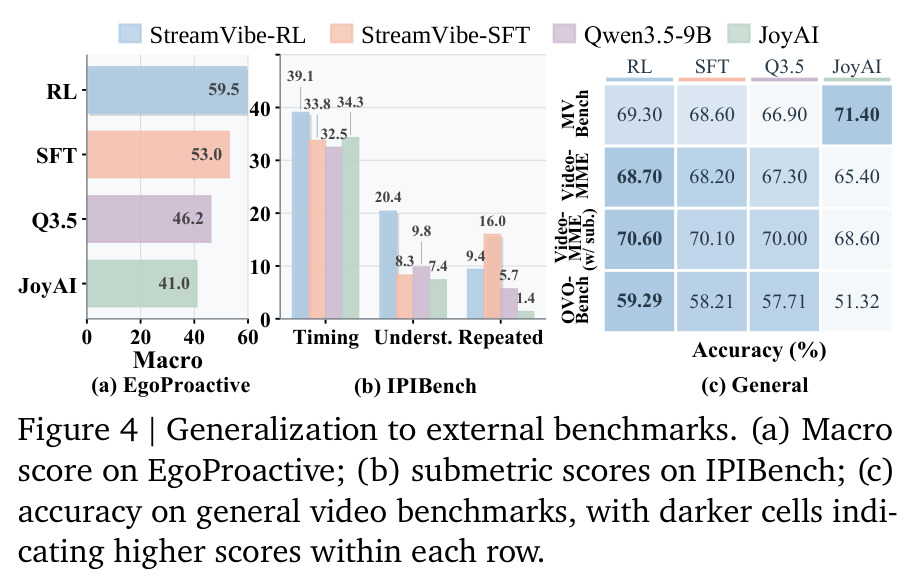
RQ1:点级评测中 StreamVibe-VL (RL) 的 Content F1 达显式 33.68 / 隐式 61.28 / 动态 39.31,超越全部开源模型(Qwen3-VL-8B 隐式仅 45.98),闭源 Gemini-3.8-Flash 隐式 66.93 仍略高;轨迹评测差距更大,RL 版隐式 F1 26.26 / ANS 72.83 / C-F1 19.13 全表最优,Qwen3-VL-8B 显式 F1 仅 6.54,最强流式基线 ViSpeak 显式 F1 达 32.37 但 ANS 仅 10.19(本文 40.86);摘要口径下响应时机与答案质量较基线整体提升 10.7%。通用能力未受损:MVBench 69.30、Video-MME 68.70、OVO-Bench 59.29(JoyAI 仅 51.32)。RQ2:隐式与动态意图显著更难(Timing F1:显式 0.712、隐式 0.552、动态 0.255);Recall 与 near-miss 误报率强正相关(r=0.629);自生成历史替代 gold 历史后 Content F1 整体降 51.2%、个别模型降 61.5%,显式 Timing F1 从点级 0.558 跌至轨迹级 0.123、动态从 0.342 跌至 0.043;Timing F1 随时长从 <1min 的 0.262 跌到 >5min 的 0.041。RQ3:SFT 相对底座显式 Timing +10.1、隐式 +16.4,但动态 Recall 反降 13.9pp;RL 相对 SFT 使 Timing +4.4、FPR −6.0、ANS +3.1;叠加 Harness 后三类意图 FPR 分别 −7.6/−9.3/−13.9,动态意图 Timing +6.7、Content +5.1,整体主动交互性能提升 12.3%。
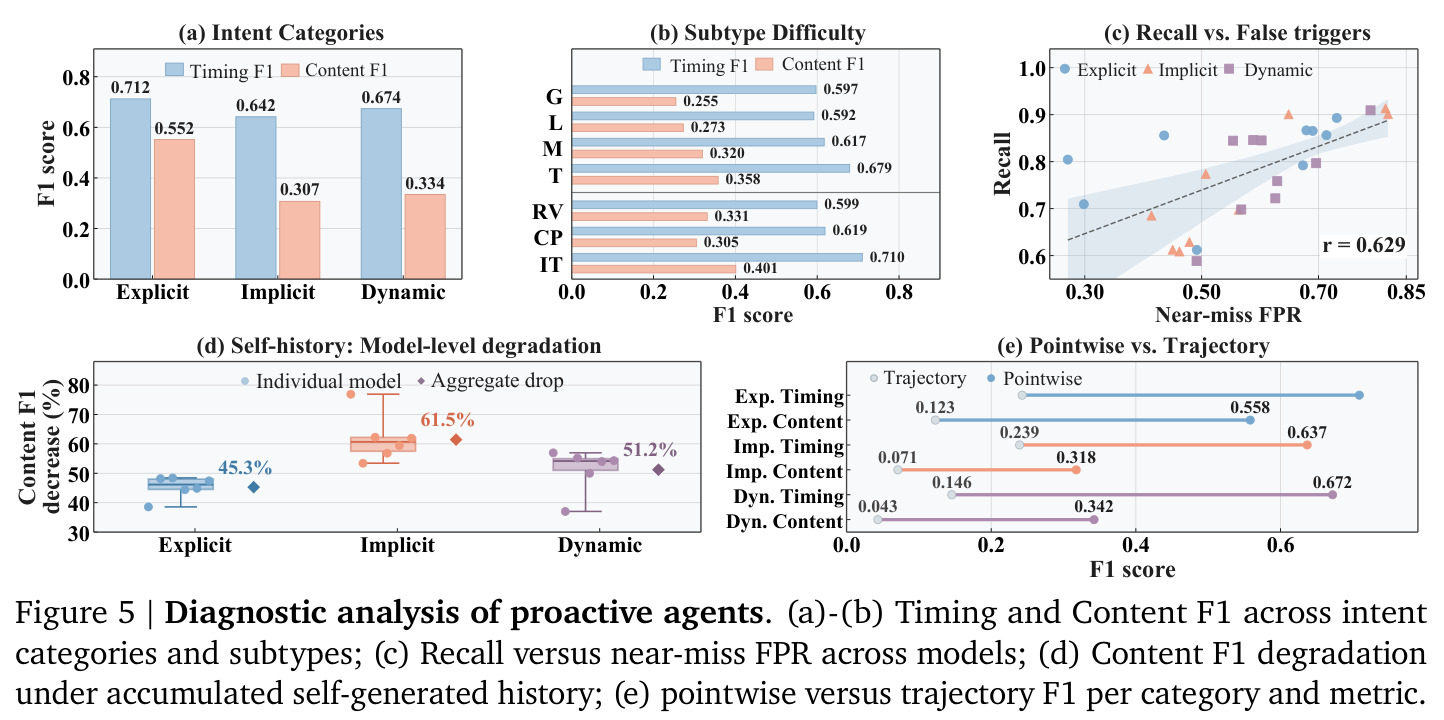
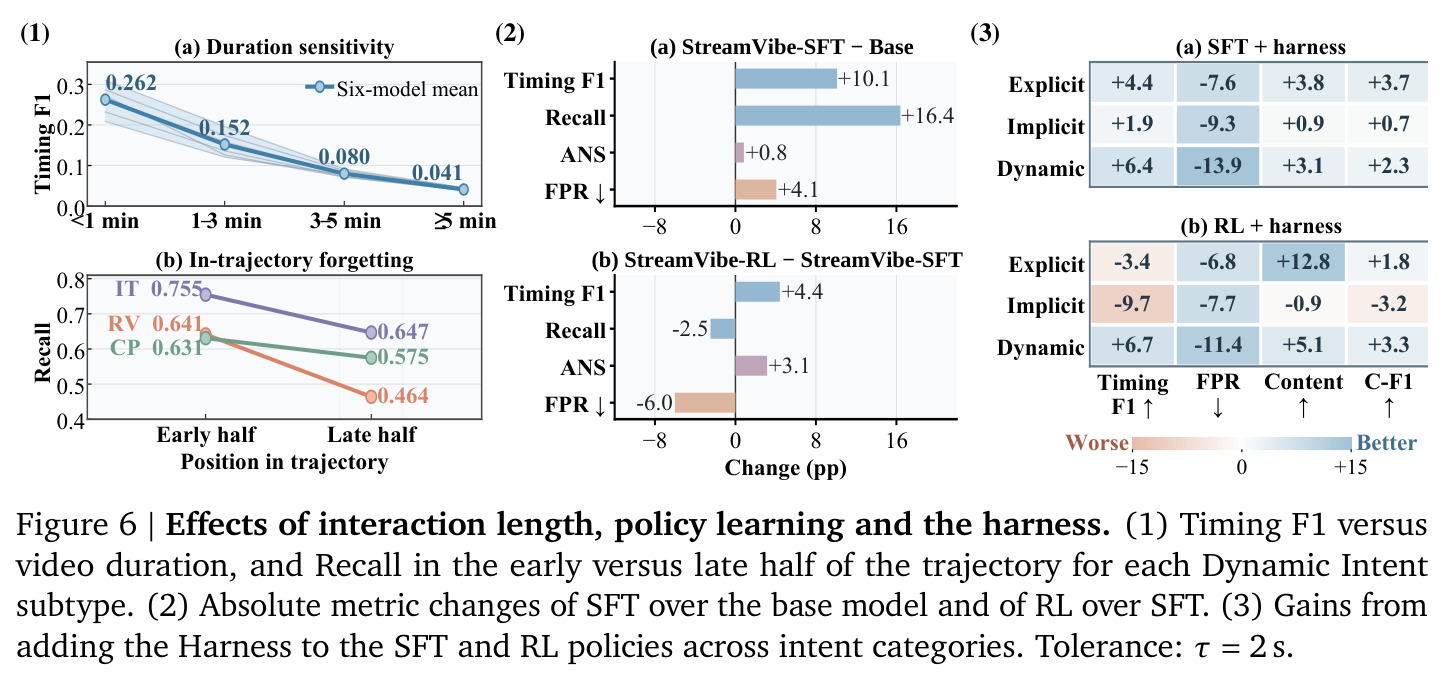
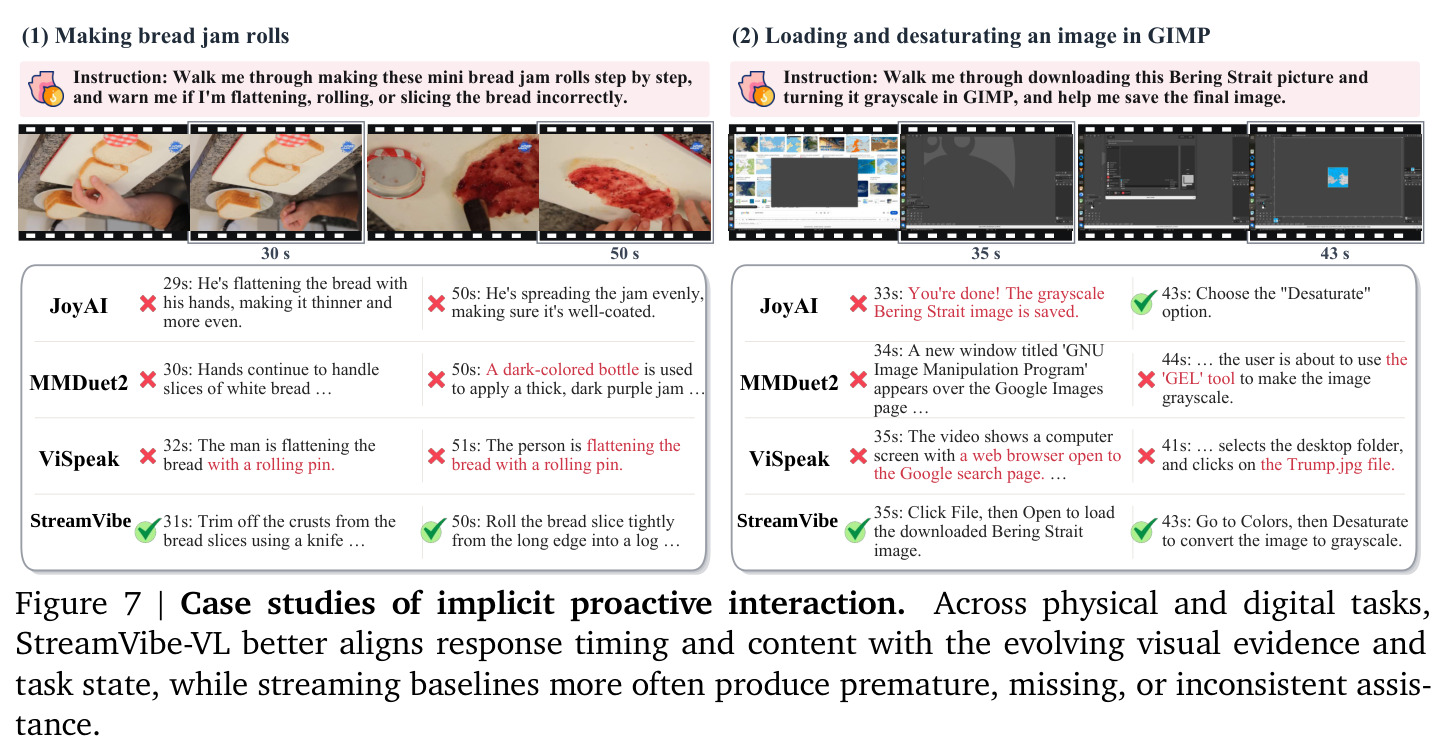
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| StreamVibe-Bench 轨迹评测·隐式意图 | Timing F1 / Answer Score / Content F1 | 26.26 / 72.83 / 19.13(StreamVibe-VL RL) | 最强流式基线 MMDuet2:22.23 / 74.26 / 16.51;ViSpeak:15.10 / 62.98 / 9.51 | Timing F1 +4.03pp,Content F1 +2.62pp,为全表最优组合 |
| StreamVibe-Bench 轨迹评测·显式意图 | Timing F1 / Answer Score | 26.51 / 40.86 | ViSpeak 32.37 / 10.19;Qwen3.5-9B 15.66 / 16.63 | F1 较 Qwen3.5-9B +10.85pp;答案质量较最强流式基线 +30.67pp |
| StreamVibe-Bench 轨迹评测·动态意图 | Content F1 | 8.91(RL) | MMDuet2 7.47;ViSpeak 3.84;Qwen3-VL-8B 1.38 | 较最强基线 +1.44pp,所有模型中最高 |
| StreamVibe-Bench 点级评测·动态意图 | Content F1 / Recall | 39.31 / 75.86(RL) | 同模型 SFT:33.27 / 58.85;Gemini-3.8-Flash:43.70 / 84.52 | RL 较 SFT +6.04pp Content F1、+17.01pp Recall,逼近闭源旗舰 |
| 外部泛化基准 EgoProactive / IPIBench | Macro score / 子指标 | EgoProactive 59.5;IPIBench Timing 41.0 | Qwen3.5-9B 46.2 / 9.8;JoyAI 53.0 / 1.4 | 主动交互能力可迁移到其他实验室基准,领先底座 10pp 以上 |
| 通用视频理解 MVBench / Video-MME / OVO-Bench | Accuracy (%) | 69.30 / 68.70 / 59.29(RL) | Qwen3.5-9B 与 JoyAI 分别为 66.90–71.40 / 65.40–67.30 / 51.32–57.71 | 主动策略训练后通用能力不降反升(OVO-Bench +1.58pp),验证无能力遗忘 |
| 整体主动交互性能(摘要口径) | 响应时机与答案质量 / 持续交互性能 | +10.7%(模型 vs 基线);+12.3%(叠加 Harness) | 现有开源/闭源多模态基线 | 论文报告的两项总增益,分别来自策略学习与状态跟踪 |
局限与改进
作者承认的局限:真实世界中意图演化与环境变化耦合更紧——新观测、任务结果与已有帮助会共同重塑目标与约束,本文未建模这种双向共同演化;评测依赖 ±2 秒容差与 Claude Sonnet 4.6 作共享裁判(0–4 打分),答案质量指标受裁判偏好影响;标注由 Gemini-3.8-Flash 预生成再经四人全票筛除,可能残留系统性偏置。我自己的观察:第一,绝对性能仍低——轨迹级动态意图 Content F1 最高仅 8.91、Timing F1 19.96,距可部署的助手相差一个量级,『提升』更多是相对意义;第二,点级评测依赖 gold history,而真实部署只能用 self history,二者 45–61% 的落差意味着点级结果对实际产品参考有限;第三,RL 奖励 $\rho(g,p)$ 与评测 ANS 同出 LLM 裁判,存在 reward hacking 与循环依赖风险;第四,Harness 增益不均——RL+Harness 在隐式意图上 Timing −9.7、显式 −3.4,说明注入状态会干扰策略的时序判断,缺乏按意图类型自适应启用的门控;第五,1 FPS 对齐对快节奏 GUI 操作可能丢关键帧证据;第六,帮助点『单一窗口+单一参考答案』假设过于刚性,覆盖不了多种合法帮助方式。
独立分析的弱点
独立分析四个具体弱点。其一,轨迹级绝对性能过低且随时长崩溃:Timing F1 从 <1min 的 0.262 跌到 >5min 的 0.041,说明模型没有真正的长时程世界模型,只是局部反应器;改进方向是引入显式的任务进度状态机或可学习的时序衰减记忆,并在训练中加入跨数分钟的远距离信用分配(如时长更长的 RL rollout 课程)。其二,Recall 与误报率强耦合(r=0.629):模型无法判断『确定性不足』,改进方向是对决策 token 输出校准过的置信度,用代价敏感决策(漏报代价 vs 打扰代价可调)替代硬阈值,RL 奖励中也可显式加入置信度校准项。其三,Harness 与策略的接口粗糙:RL+Harness 在隐式意图上 Timing F1 反降 9.7pp,说明注入的状态/记忆文本会干扰模型对视觉证据的时序敏感度;改进方向是让策略学会有条件地查询状态(agentic retrieval),或对 harness 注入内容做注意力门控/蒸馏。其四,评测与奖励的 LLM 裁判单一化:训练奖励 $\rho$、评测 ANS 均出自同一族大模型,存在被优化出裁判偏好的风险;改进方向是引入多裁判集成、人工校准子集,以及基于规则的可验证内容指标(如 GUI 操作序列是否正确执行)。
未来方向
作者明确提出:真实世界的主动交互涉及更丰富的意图演化与用户需求和环境变化之间更紧密的耦合——新观测、任务结果、已有帮助会共同重塑目标与约束,未来应研究这种『意图-环境共同演化』的长时程交互。基于本文成果可延伸的方向:(1)从『说』到『做』——当前智能体只能口头帮助,结合 GUI Agent 的动作执行能力(点击、填写、导出),主动交互可升级为主动代办;(2)多模态意图信号——加入音频、 gaze、触屏轨迹等,缓解仅凭视觉推断隐式意图的不确定性;(3)个性化意图记忆——跨会话积累用户偏好(如『用户喜欢 YYYY-MM-DD 日期格式』),把图3中的 User preference 从演示变为可持续学习的档案;(4)在线持续学习——利用 RL 阶段的奖励信号在部署中持续更新策略,应对意图分布漂移;(5)自适应容差与窗口——按任务节奏动态调整 ±2s 容差和响应窗口,替代统一标注协议;(6)把 Harness 的意图生命周期抽象为通用智能体中间件,迁移到客服、编程助手等非视频场景。
复现评估
复现难度评估:高。论文给出了项目页(stream-vibe.github.io)但正文未明确承诺开源代码或数据发布;183.4 小时的任务视频涉及版权与授权问题,即使开源也难以完整释出。数据构建流水线复杂:需 Gemini-3.8-Flash 做预标注、四名独立评审全票验证、对齐 1 FPS 因果流,人力成本高。训练需要 85K 自建样本(70K SFT + 15K RL)加 768K 第三方通用流式样本(TimeChat-Online、VideoChat-Flash,这两个是公开的,可获取),底座为 9B 级 VLM(从对比表推断为 Qwen3.5-9B),两阶段训练(SFT + GRPO)估计需要多卡高端 GPU(8×H100 级别)数天。评测侧依赖 Claude Sonnet 4.6 作为共享裁判(API 成本)与 Gemini-3.8-Flash 标注。可复现路径建议:先用公开流式基准(OVO-Bench、OVBench)验证底座选择,再按论文 §3.3 的流水线自建小规模(数百样本)子集校验标注协议,最后以论文报告的 $\lambda=0.7$、$\alpha$ 权重和奖励公式($R_{align}$、$R_{glob}$)实现 RL;Harness 部分是纯工程逻辑(状态机+检索),相对容易独立复现。
论文图表
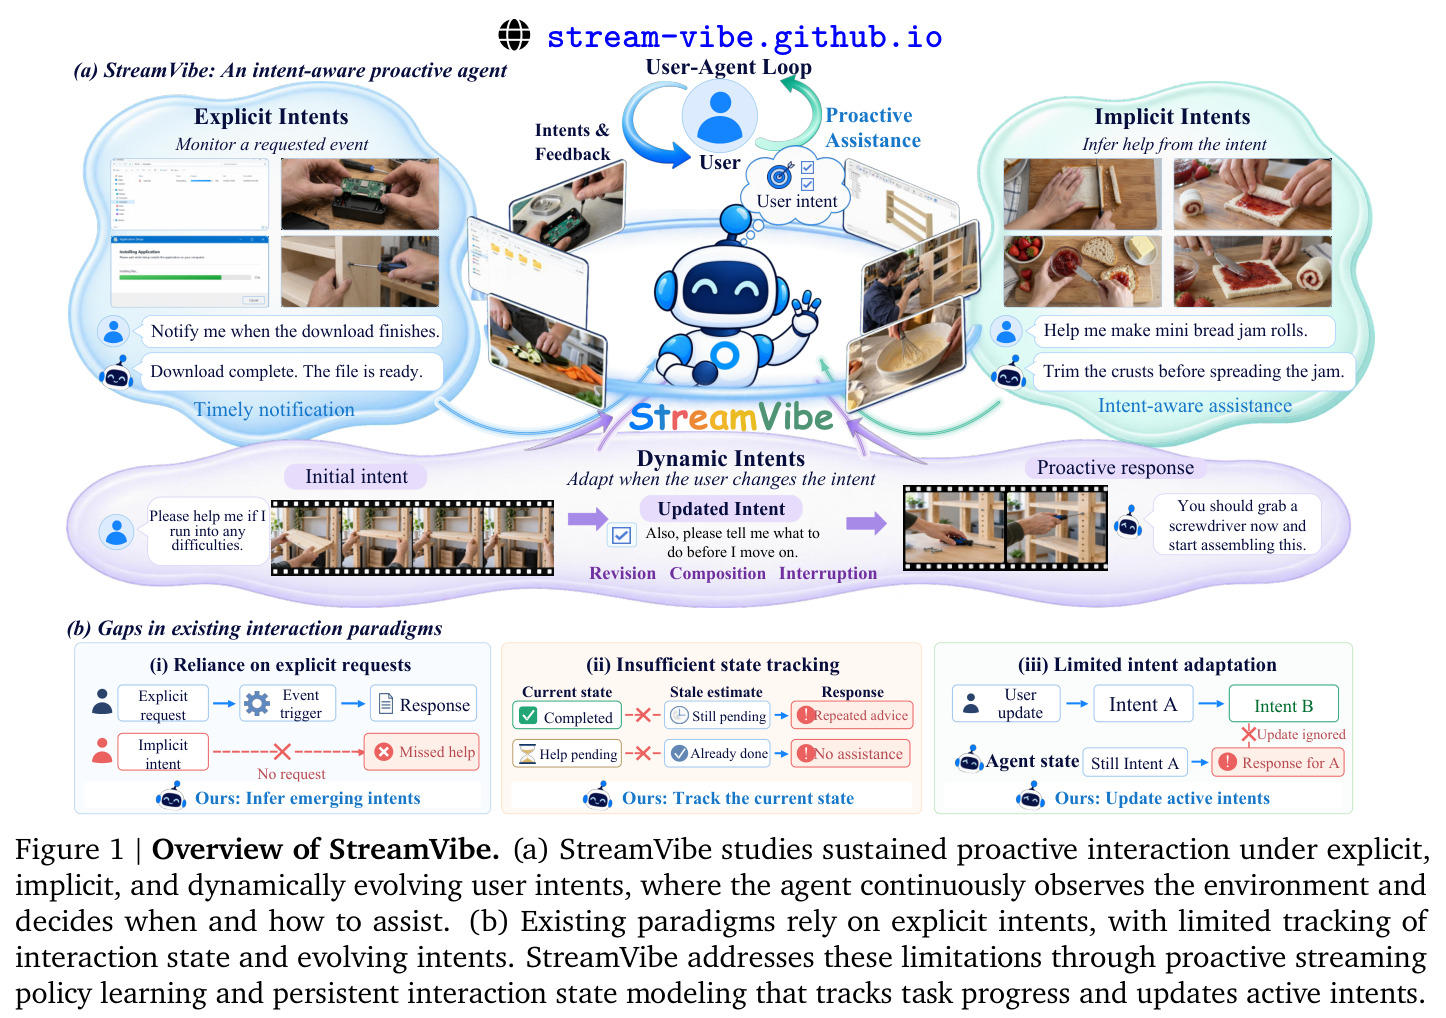
(a) 用三个场景展示 StreamVibe 研究的意图感知主动交互:显式意图(下载完成及时通知)、隐式意图(做果酱面包卷时主动建议先切边再抹酱)、动态意图(修家具中途用户追加请求,从『遇到困难帮我』变为『递螺丝刀开始组装』);(b) 归纳现有范式的三个缺陷:依赖显式请求、状态跟踪不足导致重复/遗漏响应、意图更新被忽略导致按旧意图响应。
这是全文的问题定义图,一眼看清三类意图的区别和现有方法的失败模式,是理解动机部分的最佳入口。
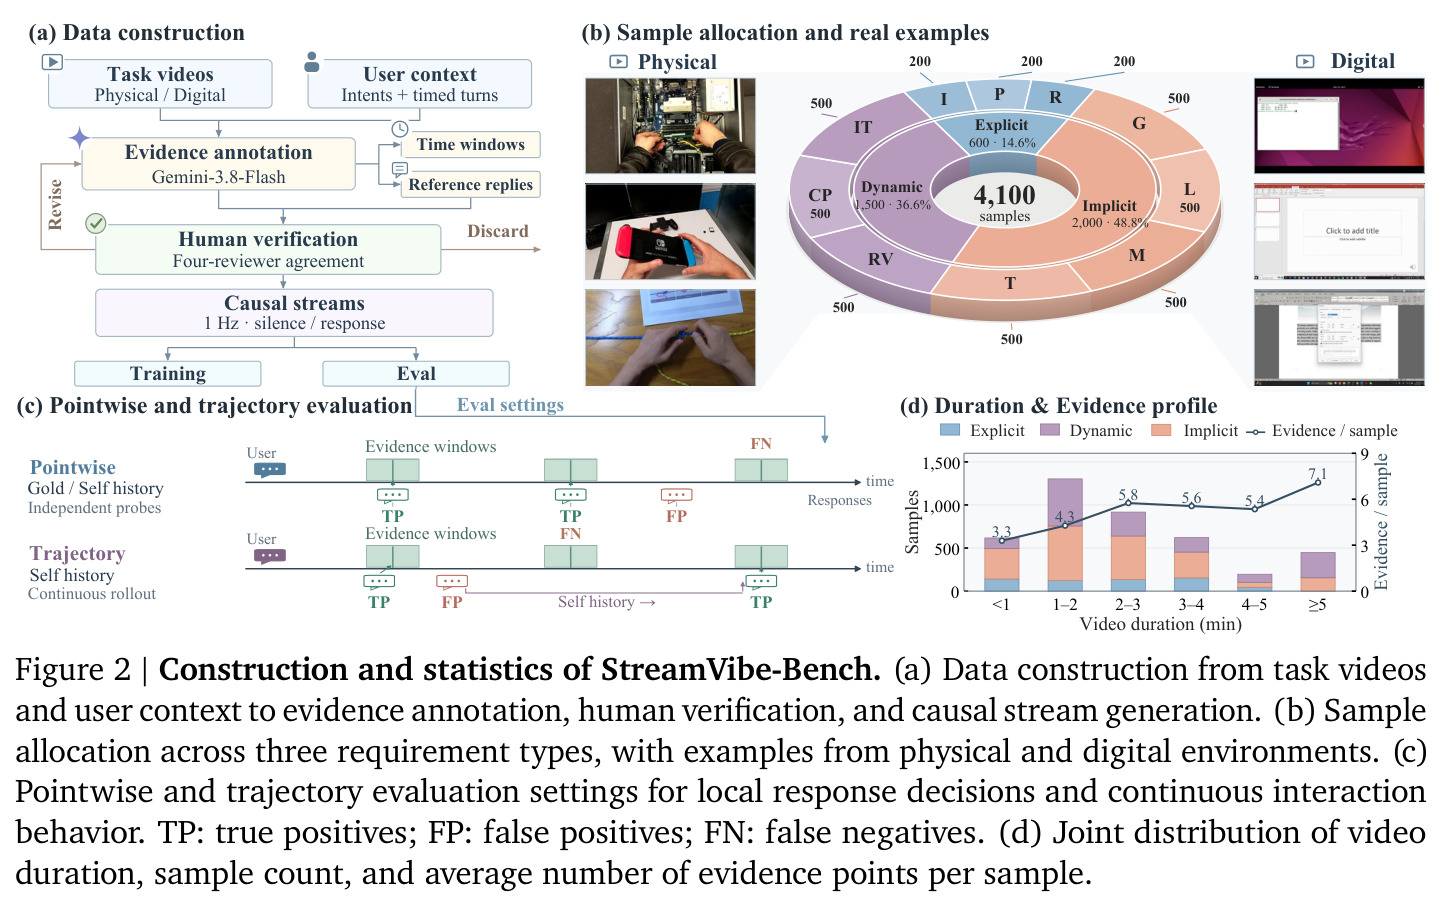
(a) 数据构建流水线:任务视频+用户上下文 → Gemini-3.8-Flash 标注证据与时间窗 → 四评审独立验证 → 1 FPS 因果流;(b) 样本分布:显式 600(14.6%)、隐式 2000(48.8%)、动态 1500(36.6%),共 4100 样本;(c) 点级与轨迹级两种评测设置示意(TP/FP/FN);(d) 视频时长×样本量×每样本证据点数的联合分布(时长 <1min 至 ≥5min,证据点均值 3.3–7.1)。
完整呈现基准的规模、构建质量控制(四评审全票)和评测协议设计,是评估基准可信度的核心依据。