TRACE:流式视频理解的时间审计与条件感知评估 TRACE: Temporal Audit and Condition-aware Evaluation of Streaming Video Understanding
把证据时间有效性、执行条件与运行行为一并审计的流式视频评测框架
前置知识
流式视频理解
指模型像看直播一样逐帧接收视频:一边处理新到的观测,一边保留可能有用的历史信息,并在问题到达或监测条件满足时即时作答。它与离线长视频理解的本质区别在于任意时刻只能看到『已播出』的帧,未来帧被严格屏蔽,因此系统必须自行决定记住什么、何时开口。
TRACE 的全部指标都建立在因果可见与即时响应这两个前提上,不理解流式设定就无法理解为何要区分证据时间、触发窗口与历史维护方式。
因果访问(Causal Access)
评测协议要求模型在回答某一时刻的问题时,只能访问该时刻之前已到达的视频帧,未来帧不可见。StreamingBench、OVO-Bench、RIVER、OVBench 等已把『未来信息不可见』作为基本要求,通常按问题时间戳截断视频前缀来实现。
论文的核心论点之一是:因果访问只是必要而非充分条件——满足它的系统在历史维护、响应触发和评测边界上仍互不可比,这正是 TRACE 要补齐的维度。
主动响应(Proactive Response)
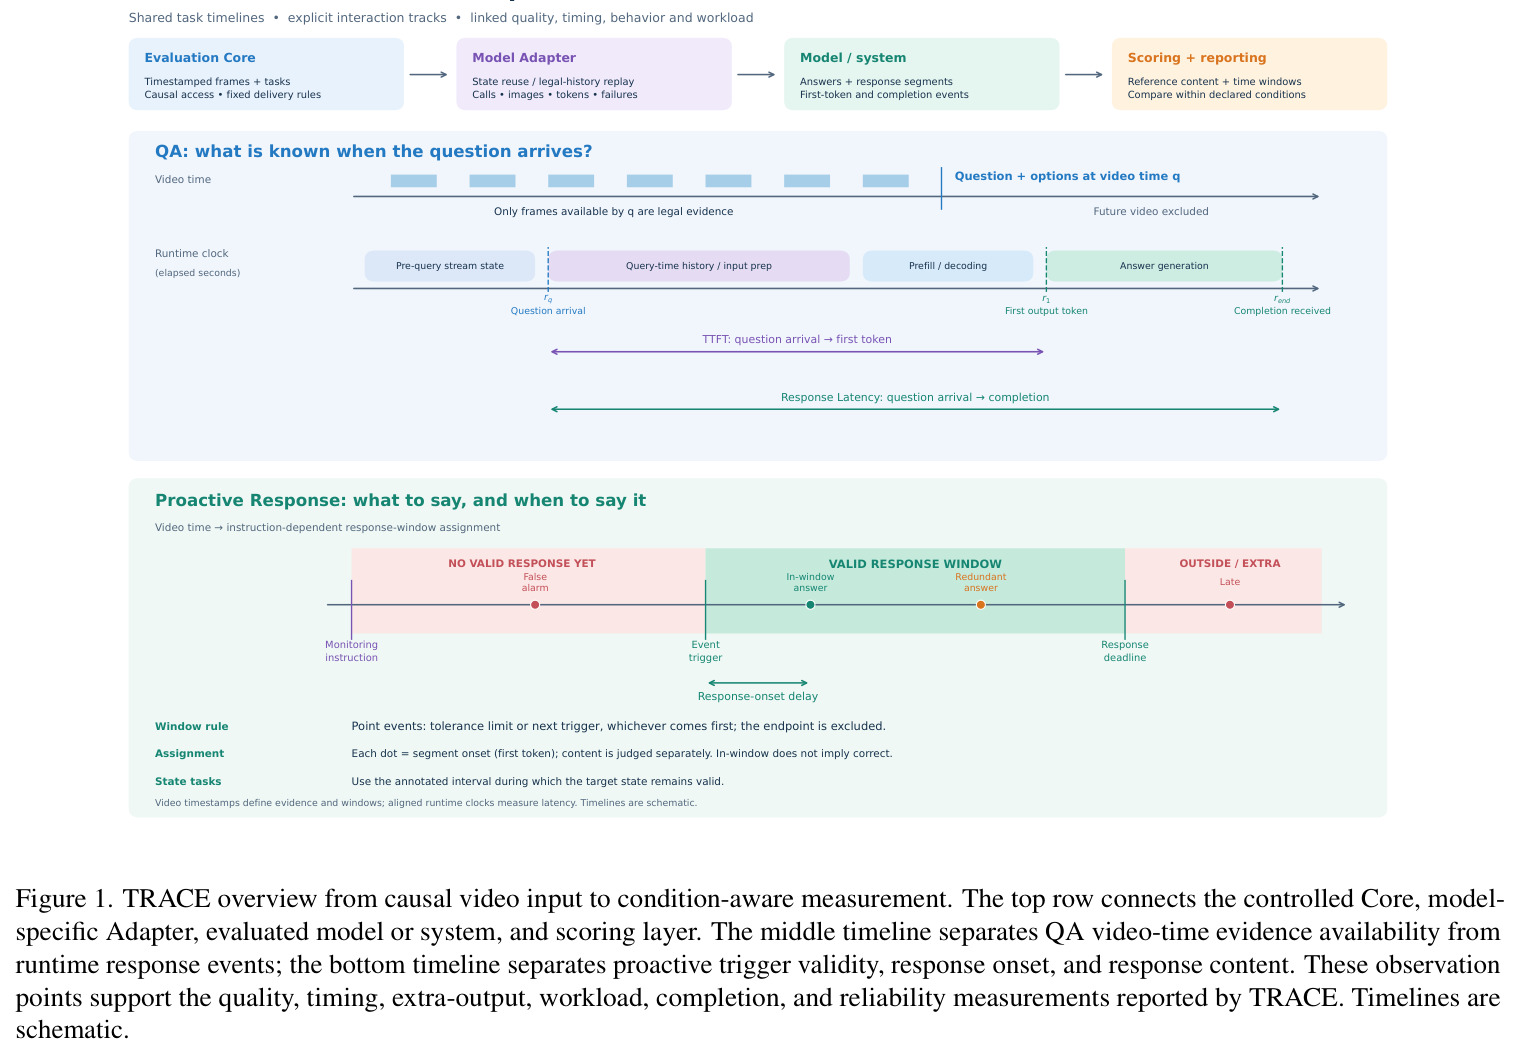
区别于被提问才作答的 QA 模式,模型收到一条监控指令(如『有人开始开门时提醒我』)后须自主决定何时开口。评测为每个触发定义合法响应窗口:对点事件触发 $t_i$,窗口为 $[t_i, \min(t_i+W, t_{i+1}))$(本文主实验取 $W=5$ 秒,端点排除);状态任务则使用状态保持有效的整段区间。
In-window Accuracy、误报率、漏报率全部依赖『何时允许响应』的标注,不理解触发窗口的构造就读不懂主动任务的实验结果。
多模态大语言模型(MLLM)与流式状态
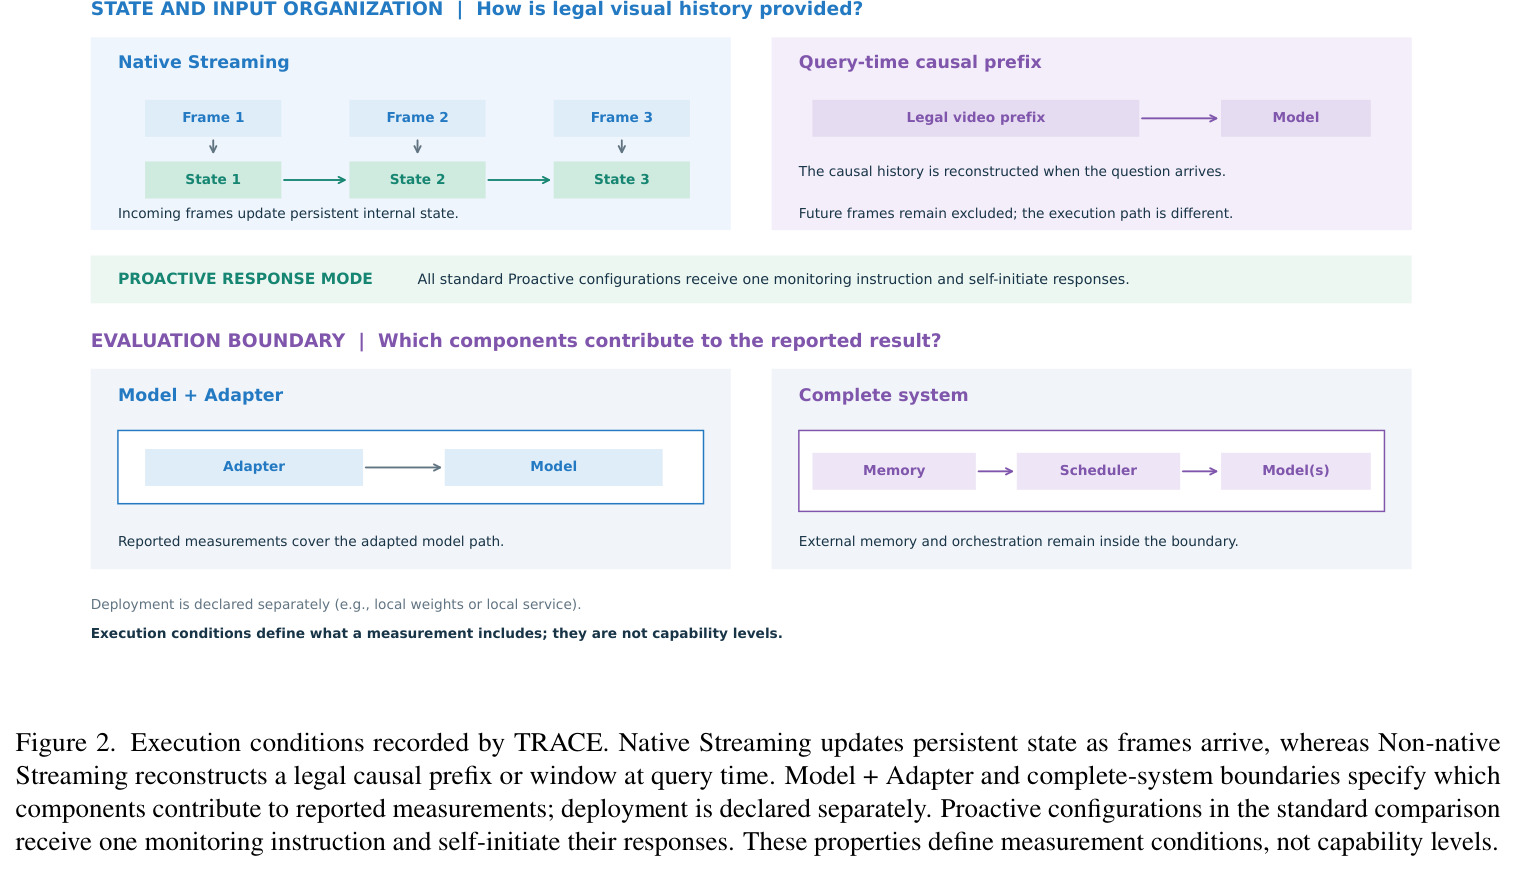
在 LLM 基础上接入视觉(有时含音频)编码器、能对帧序列与文本联合推理的模型。流式 MLLM 还需维护随帧更新的内部视觉状态(持久 KV 缓存、增量记忆),或在查询到来时重放合法历史前缀,两种路线的延迟与开销特性差异很大。
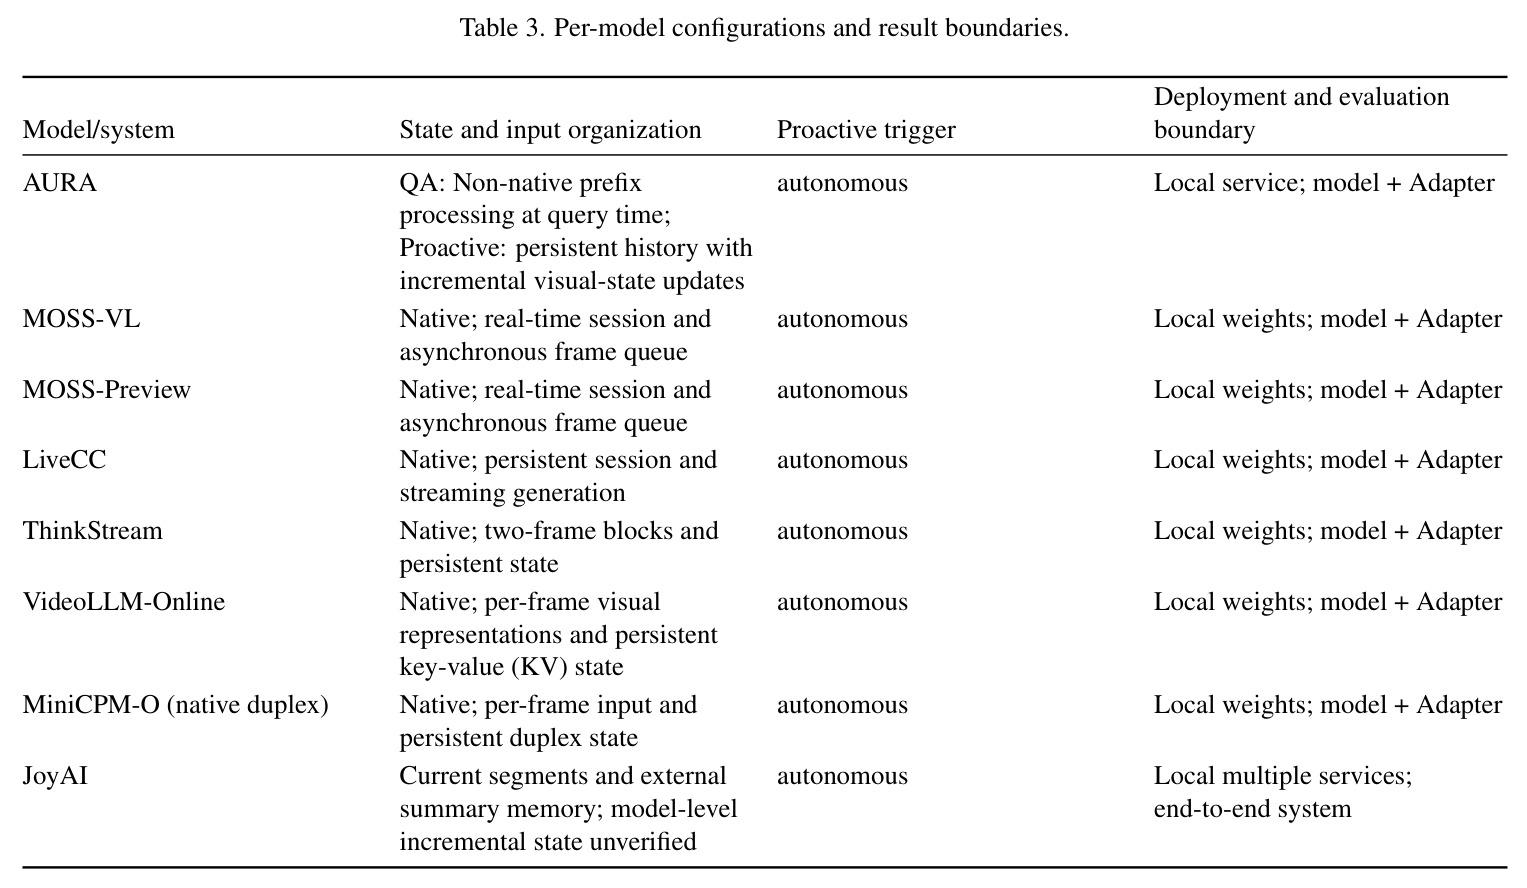
被评测的 8 个系统恰好覆盖不同流式路线,『原生流式 vs 查询时前缀重建』『模型+适配器 vs 完整系统』是论文全部分析展开的坐标系。
TTFT 与响应延迟
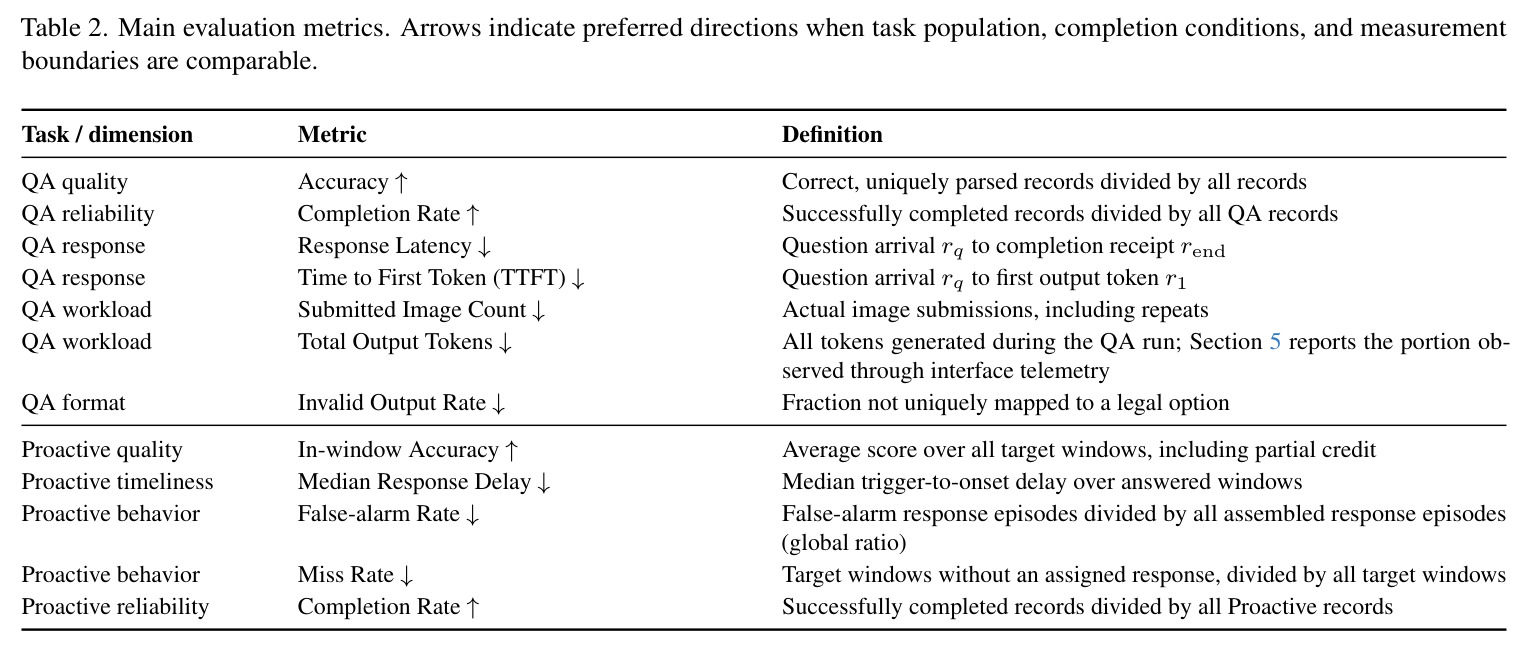
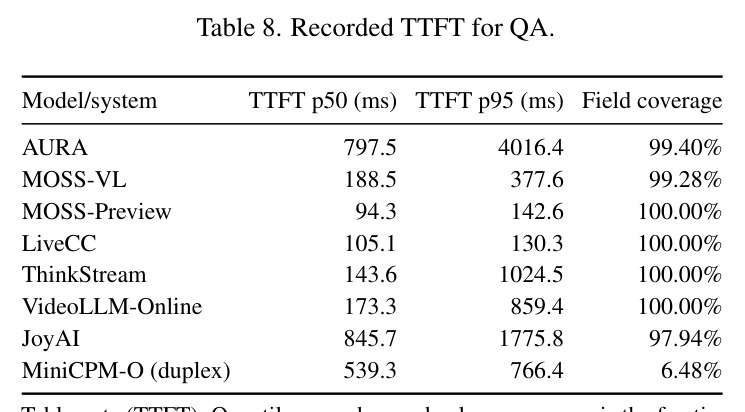
TTFT(Time to First Token)指从问题到达 $r_q$ 到首个输出 token $r_1$ 的时长,$\text{TTFT}=r_1-r_q$;Response Latency 指从 $r_q$ 到完整回答被接收 $r_{\text{end}}$ 的时长,$L_{\text{comp}}=r_{\text{end}}-r_q$。两者都包含查询后的历史重放、输入准备与排队,后者另含整个解码过程。
流式系统对时间敏感,这两个指标把『答得对』与『答得多快』解耦度量,是 TRACE 多维报告中 QA 侧的关键部分。
LLM-as-Judge
用另一个大模型按统一提示词给开放式回答打 0 到 1 的分数并保留部分分。本文对语义类主动任务(SSR/CRR)使用 Qwen3.5-35B-A3B(温度 0、prompt 版本 osb-vlm-judge-v1),并用 36 条人工对照做校准:二值一致率 83.3%(30/36)、Cohen's kappa 0.675、连续分 Pearson 0.830、Spearman 0.877。
顺序步骤识别与线索揭示类主动任务无法用字符串精确匹配评分,必须依赖 Judge,其校准情况直接决定窗口内准确率等核心指标的可信度。
研究动机
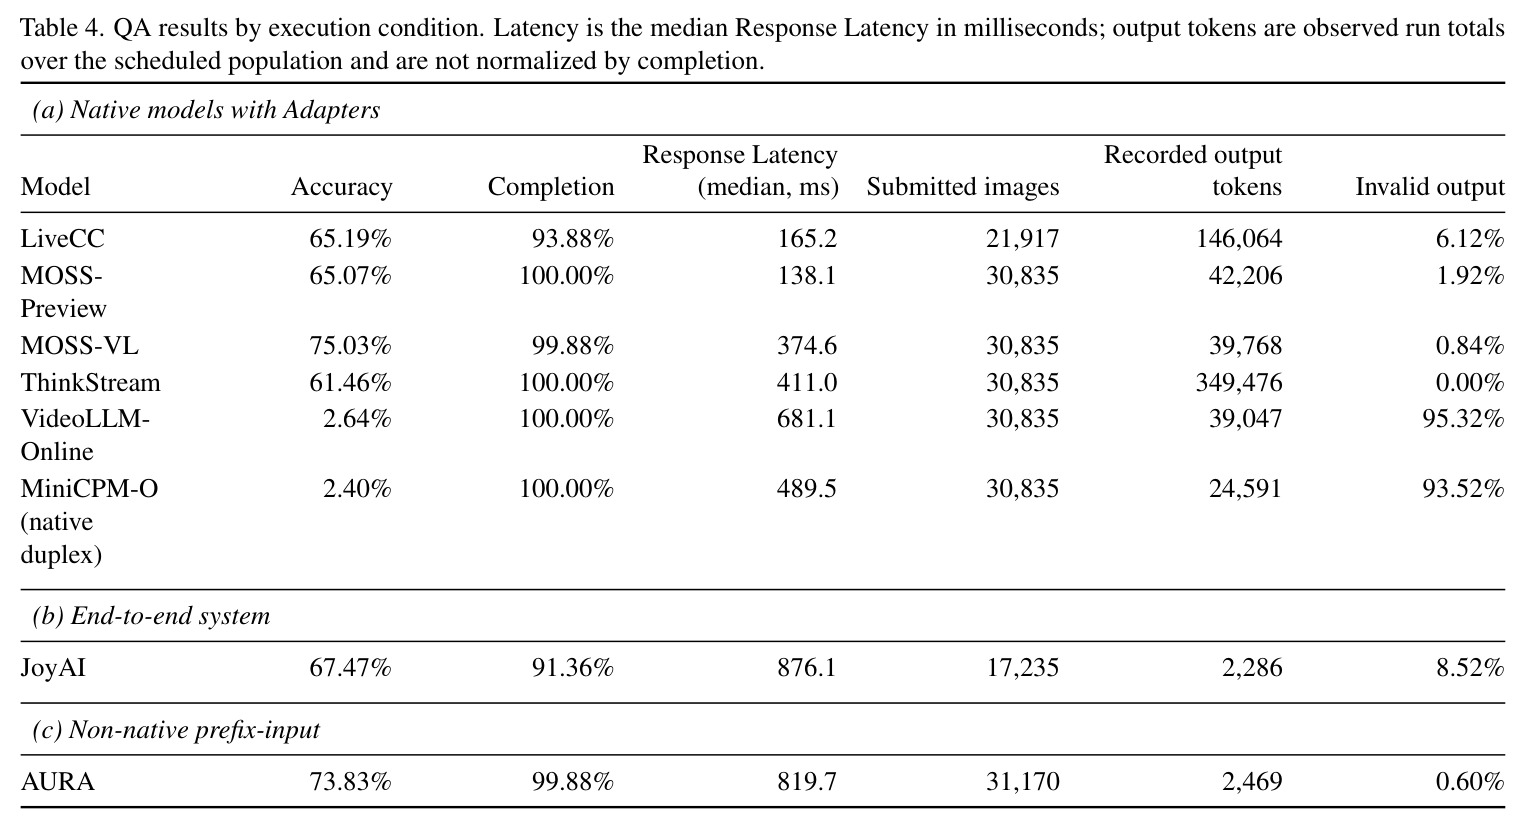
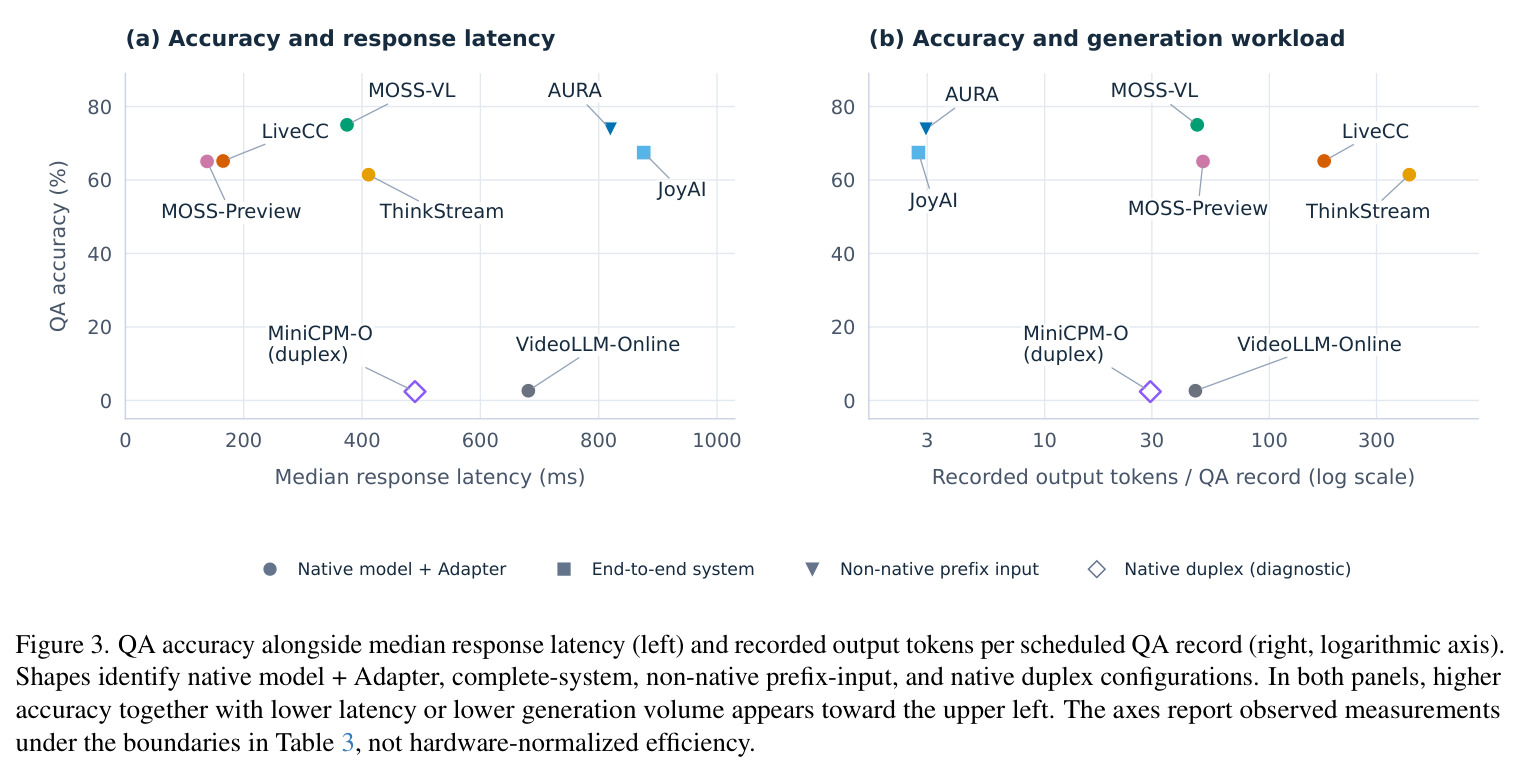
现有评测把流式视频理解当成单一分数任务,掩盖了大量关键信息。离线长视频基准(Video-MME、LongVideoBench、MLVU、EgoSchema、LVBench)在推理前就给出完整视频,无法检验『证据逐帧到达时能否即时处理』。新一代流式基准(StreamingBench、OVO-Bench、RIVER、S-EMBER、OVBench)虽确立了因果可见性(未来帧不可见),但只报告任务分数:不说明支持答案的证据何时生效、系统如何维护或重放视觉历史、由谁决定何时响应、过程中产生多少失败与冗余输出。结果是两个准确率几乎相同的系统,可能在完成率、输出有效性、工作负载和响应时机上截然不同——本文实测 LiveCC 与 MOSS-Preview 的 QA 准确率仅差 0.12 个百分点(65.19% 对 65.07%),但输出 token 数相差约 3.5 倍(146,064 对 42,206)、无效输出率相差 3 倍多(6.12% 对 1.92%)、完成率相差 6 个百分点(93.88% 对 100%)。只看分数会把这些运营层面差异完全隐藏。
本文的目标是本文要把流式视频评测重构为『条件感知的系统级测量问题』:一个流式分数只有在同时说明三件事时才有意义——(1) 时间有效性:支持 QA 答案的视觉证据何时可用、主动响应何时变为合法;(2) 执行条件:视觉历史是增量维护还是查询时重建、主动输出是否自发起、评测边界是『模型+适配器』还是含外部记忆与调度的完整系统;(3) 运营结果:把答案质量与响应时机、多余输出、工作负载、完成率和运行可靠性一起报告。为此作者构建了带时间审计的评测集(标准集 1,240 条记录、517 个视频)、统一的因果 Core–Adapter 执行协议,以及质量/及时性/响应选择行为/工作负载/完成率/可靠性的多维指标体系,并在 8 个公开模型或系统的 8 种配置上实证『相同分数、不同行为』这一论点。
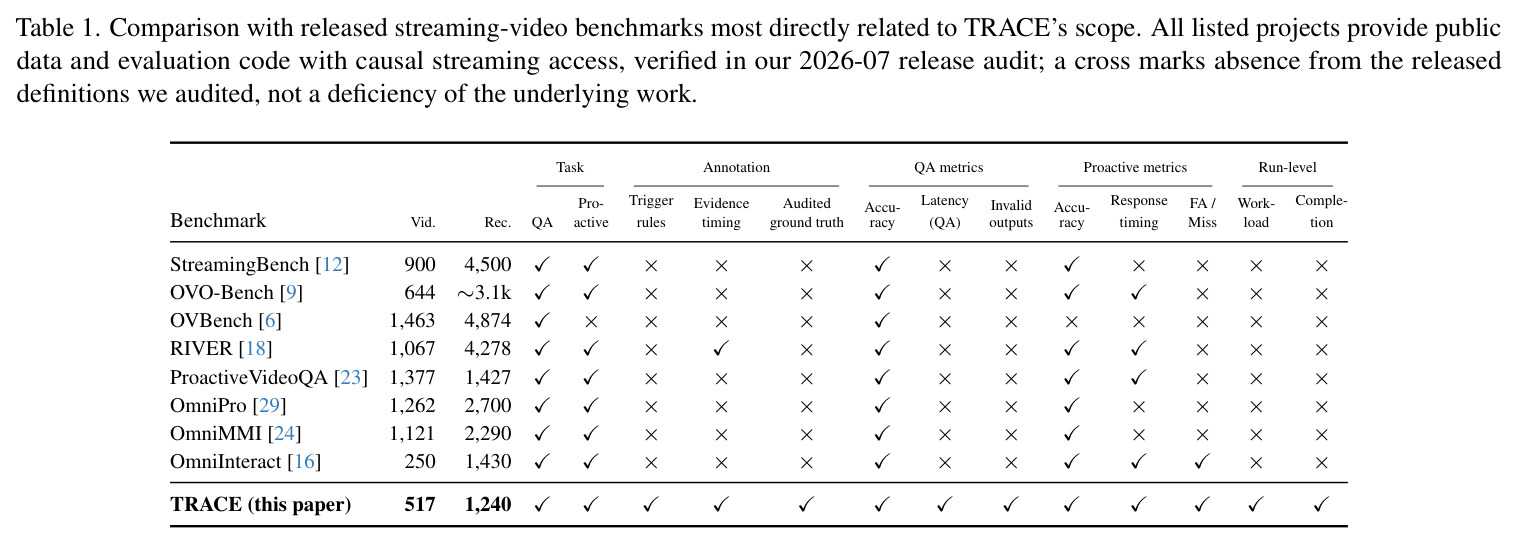
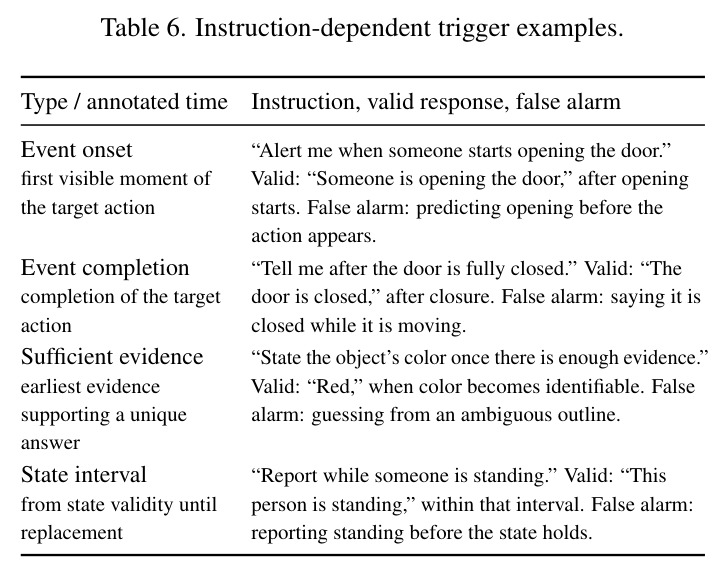
与已有工作不同的是,本文的独特切入点是:不做更大、更多模态的新基准,而是对『已有基准的时间标注与执行协议』本身进行审计与补全。作者从 StreamingBench 和 OVO-Bench 抽取纯视觉任务,逐条重看视频、修订证据时间与触发标注(328 条被编辑、52 条被剔除),并首次给出指令依赖的触发语义:同一动作,指令是『有人开始开门时提醒我』就是事件开始触发,『门完全关上后告诉我』就是事件完成触发,另有『证据足以唯一确定答案』与『状态保持区间』两类。与 Table 1 对比的 8 个已发布基准相比,只有 TRACE 同时具备触发规则、逐题证据时间、复核过的真值、显式误报/漏报诊断以及工作负载/完成率等运行级指标。作者还坚持『不强制统一内部实现』:Core–Adapter 协议只规定合法数据流,把各系统实际的帧提交、历史重放、状态维护和失败原样记录,使执行条件成为可比维度而非能力等级——这与以往把协议选择隐含在实现里的做法有本质区别。
核心方法
直觉上,TRACE 像给每个流式系统做一次『带审计的运行记录』。评测核心(Evaluation Core)按固定规则在统一时间轴上以 1 FPS 实时节奏投喂 RGB 帧,模型只能访问已到达的帧;模型专属的适配器(Adapter)把这条受控数据流接到不同模型上,同时记录每次图像提交、历史重放、丢帧、状态维护、输出与失败;打分层再把『答案对不对』与『何时开始答、答了几次、开销多大、跑没跑完』分开统计。框架由四个组件构成:(1) 时间审计过的任务集,含 QA 证据时间与主动触发标注;(2) 受控 Evaluation Core;(3) 记录实际行为的模型 Adapter;(4) 在声明执行条件下输出质量、及时性、响应选择行为、工作负载、完成率与可靠性的打分器。Figure 1 是框架阅读地图,Figure 2 则定义两类执行条件:状态/输入组织(原生流式 vs 查询时因果前缀重建)与评测边界(模型+适配器 vs 完整系统),并强调这些是测量条件而非能力等级。
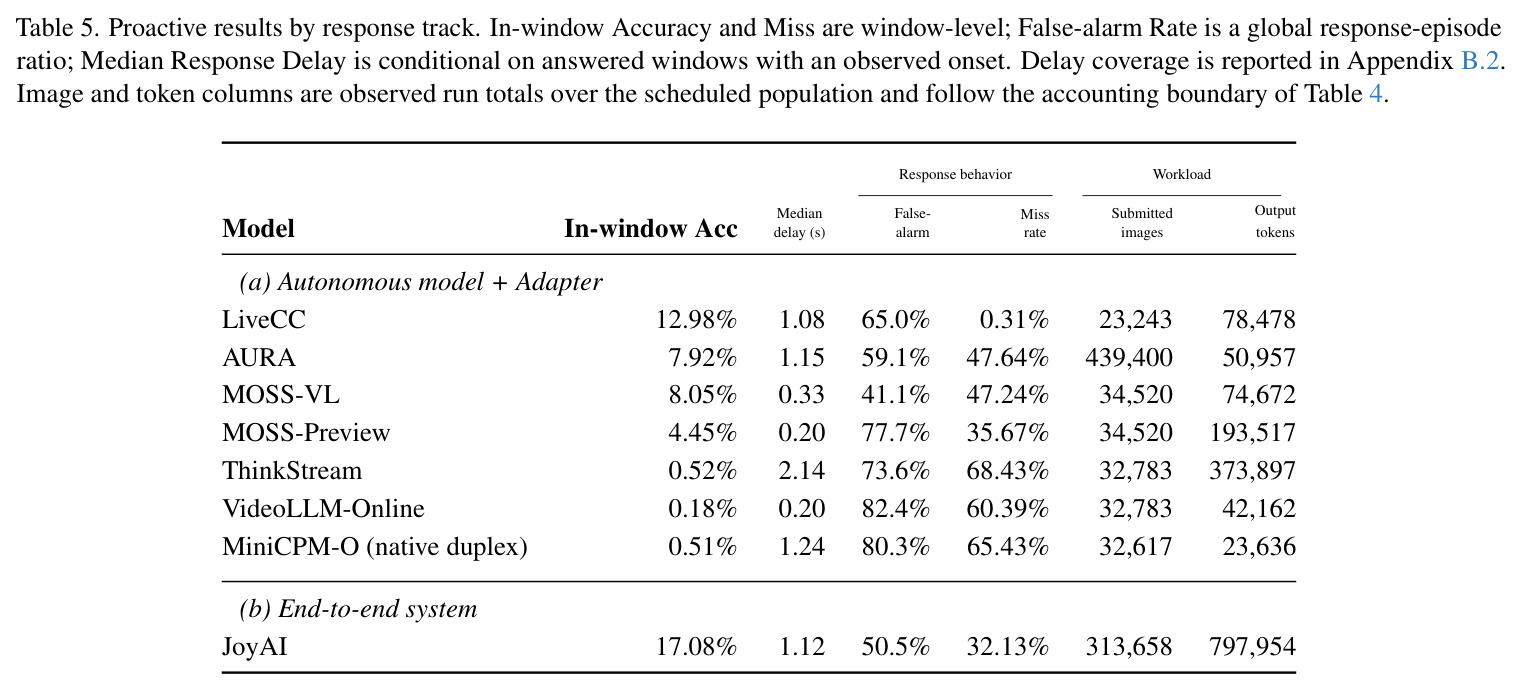
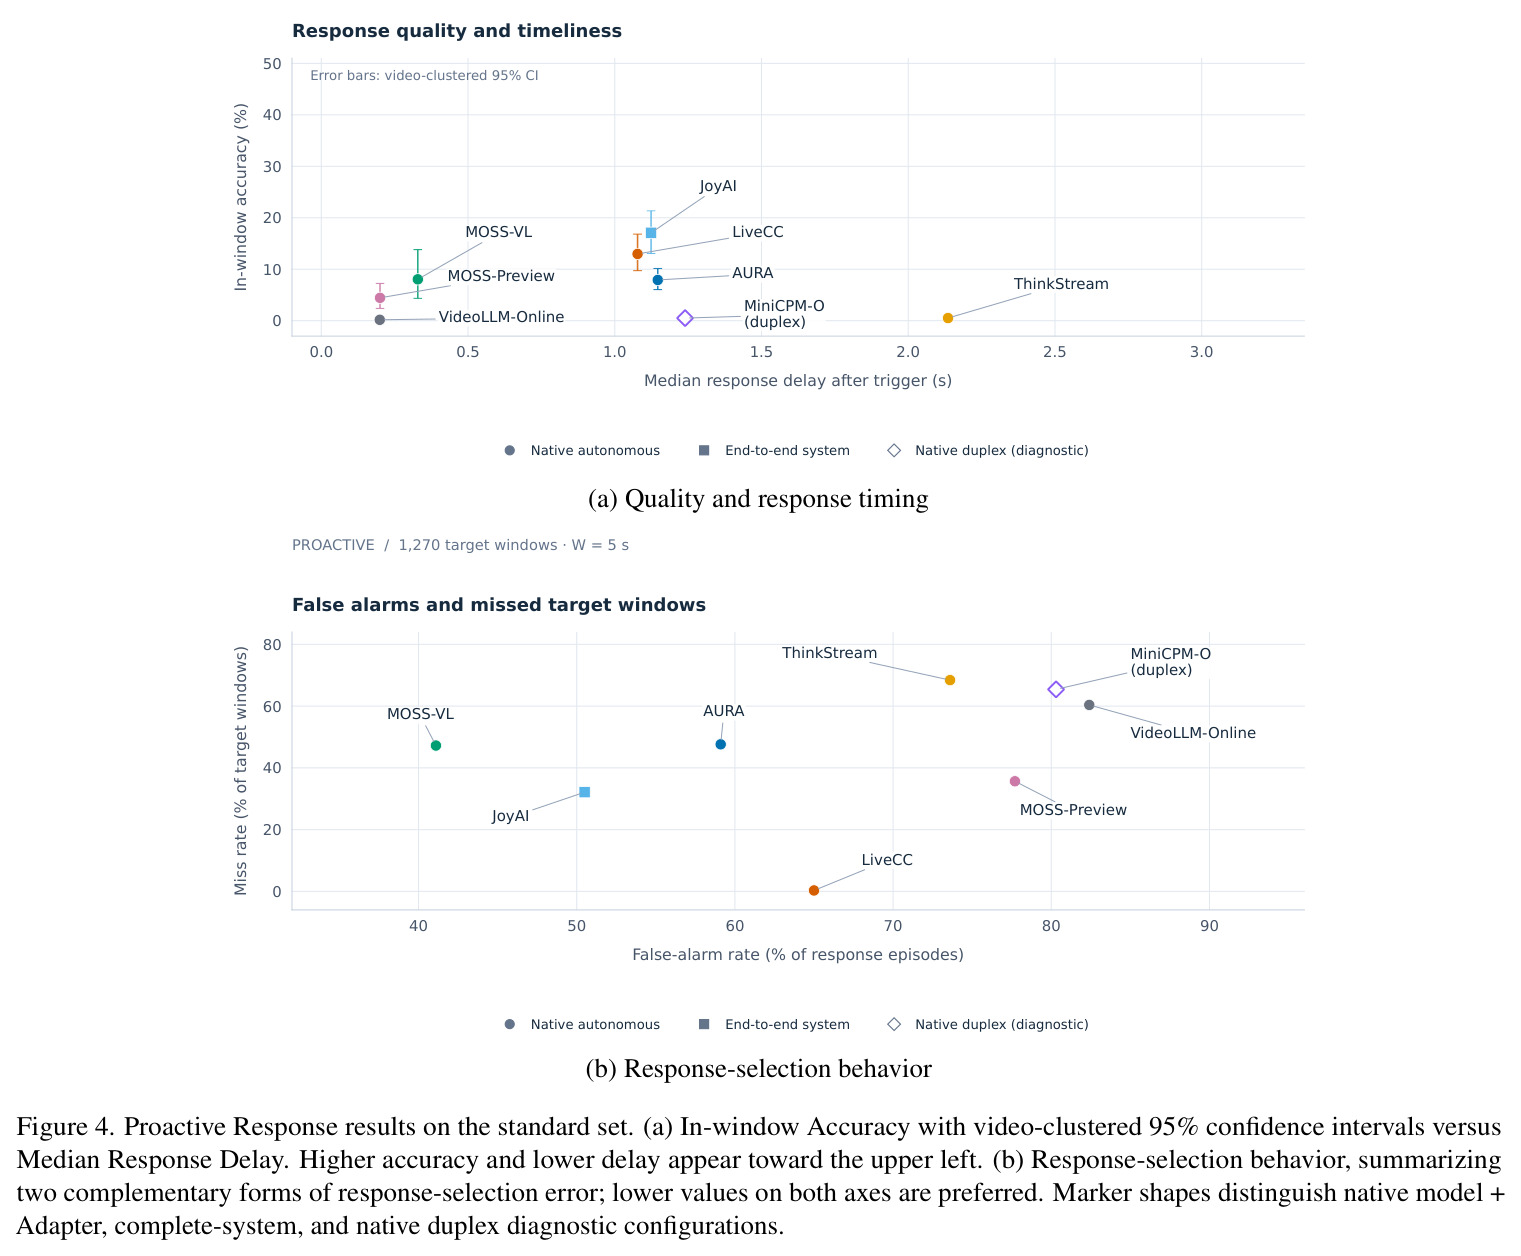
核心创新有三点。第一,把『何时可答』变成被审计的一等公民:QA 标注证据时间——标注员重看视频,标记在问题与选项给定下证据最早支持答案的时刻,且不得晚于问题到达;主动任务标注指令依赖的触发,分事件开始、事件完成、证据充分、状态区间四类。第二,响应按首个输出 token 的发生时间归入响应窗口,内容另行打分:对点事件窗口为 $[t_i, \min(t_i+W, t_{i+1}))$(主实验 $W=5$ 秒),于是窗口内准确率、误报率、漏报率三者互相独立——一个系统可以几乎覆盖所有目标窗口却大量在不该说话时说话(如 LiveCC 漏报仅 0.31% 但误报 65.0%),反之 frequent off-window 输出也不保证覆盖目标窗口。误报率定义为 $\text{FA}=\sum\text{误报响应段}/\sum\text{全部组装响应段}$(全局比例),漏报率按目标窗口计。第三,执行条件(历史组织、触发方式、系统边界、部署方式)被显式声明为报告的一部分而非实现细节,使任何分数都能追溯到它的产生路径。
方法步骤详情
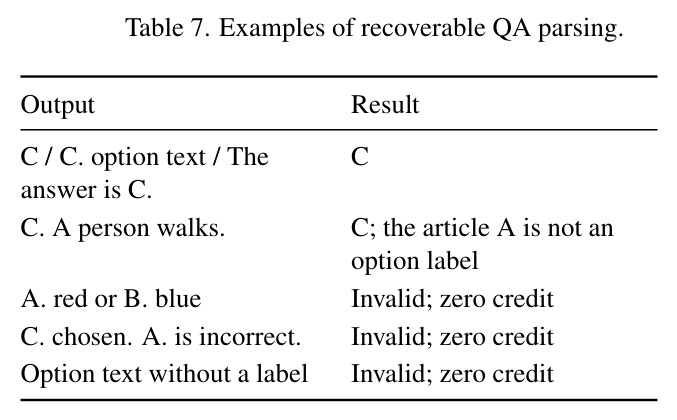
流程分五步。(1) 数据构建:从 StreamingBench 与 OVO-Bench 抽取无需音频/字幕/外部知识的纯视觉任务,统一数据结构。(2) 时间审计:模型辅助筛查视觉可答性、答案唯一性与触发边界风险,标注员复核修正或剔除不可修复记录;发布含 328 条编辑记录(952 个字段修改)与 52 条剔除,其中 325 条涉及时间/触发字段;时间戳中位修订 QA 3.0 秒、主动 2.24 秒(90 分位 58.2 与 20.76 秒)。(3) 标准集:发布版 1,248 条/522 视频;1 FPS 标准集 1,240 条/517 视频(833 QA + 407 主动、1,270 个响应窗口),25 个不超过 1 秒的窗口另列采样压力子集。(4) 执行:Core 实时逐帧投喂并控制指令到达,主动配置只收一条监控指令、自行决定何时响应;适配器记录帧提交、重放、丢帧与失败,失败保留在分母。(5) 打分统计:QA 须解析出唯一合法选项,否则零分并计入无效输出率;SSR/CRR 用 Qwen3.5-35B-A3B Judge,其余精确匹配;置信区间用视频级聚类 2,000 次自助法。
技术新颖性
与相关工作的区别可从三个层面看。数据层面:此前基准把时间戳当作固定元数据,TRACE 证明这不可靠——修订中位数 3.0/2.24 秒、90 分位达 58.2/20.76 秒,而 QA 证据时间决定『合法历史』长度、主动触发决定记分边界,改标注就等于改题目。协议层面:StreamingBench 等只规定因果可见,RIVER、S-EMBER 组织了问题-证据-记忆-响应的时间关系,但没有谁把『适配器记录的实际执行』(帧提交、重放、丢帧、状态维护、失败)与分数绑定发布;TRACE 的 Table 3 在比较任何分数之前先声明每个配置的状态组织、触发方式、部署与评测边界。指标层面:先前工作把响应选择错误折进单一主动分数,OmniInteract 是唯一也给出 FA/Miss 诊断的已发布项目;TRACE 进一步把质量(In-window Accuracy)、及时性(Median Response Delay)、行为(全局误报率、窗口级漏报率)、冗余输出(描述性统计)、工作负载与完成率并列报告,并实证它们互不可预测。这使 TRACE 从『又一张排行榜』变成一套可迁移的评测方法学。
实验结果
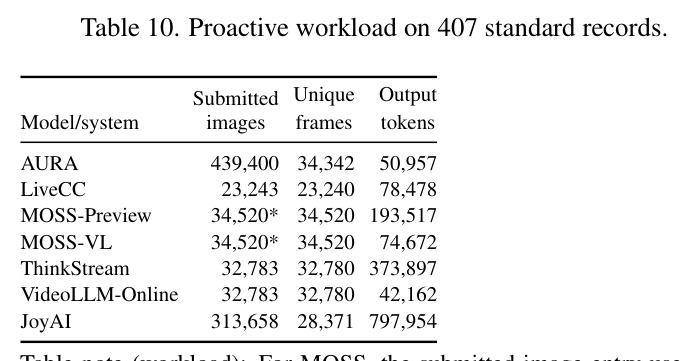
实验覆盖 8 个配置。发现一(审计改变边界):328 条记录被编辑、52 条剔除,325 条涉及时间/触发字段;时间戳中位修订 QA 3.0 秒、主动 2.24 秒,直接改变合法历史与记分窗口。发现二(同分不同行为):QA 上 LiveCC 与 MOSS-Preview 准确率 65.19% 对 65.07%,但完成率 93.88% 对 100%、输出 token 146,064 对 42,206、无效输出 6.12% 对 1.92%;主动任务上 MOSS-VL 与 AURA 准确率 8.05% 对 7.92%,误报率却 41.1% 对 59.1%、延迟 0.33s 对 1.15s;LiveCC 以 12.98% 居模型侧第一且漏报仅 0.31%,但误报高达 65.0%;ThinkStream/VideoLLM-Online 则双高。发现三(条件定义含义):AURA 的 819.7ms 延迟与 31,170 张提交图源于查询时前缀重建;JoyAI 的 17.08% 是含外部记忆与调度的完整系统边界结果;MiniCPM-O 双工 2.40%(93.52% 不可解析)属接口诊断。
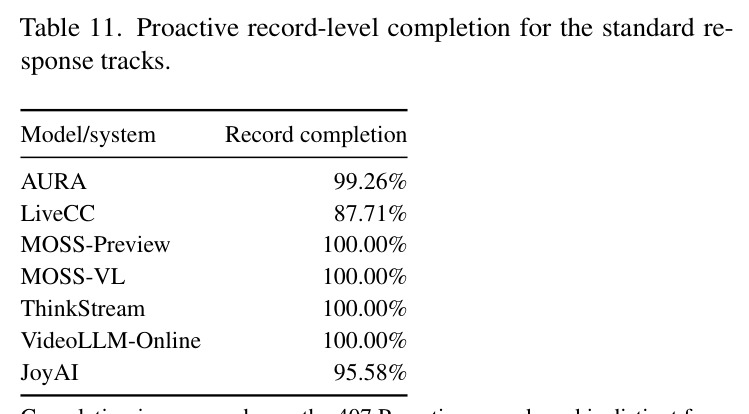
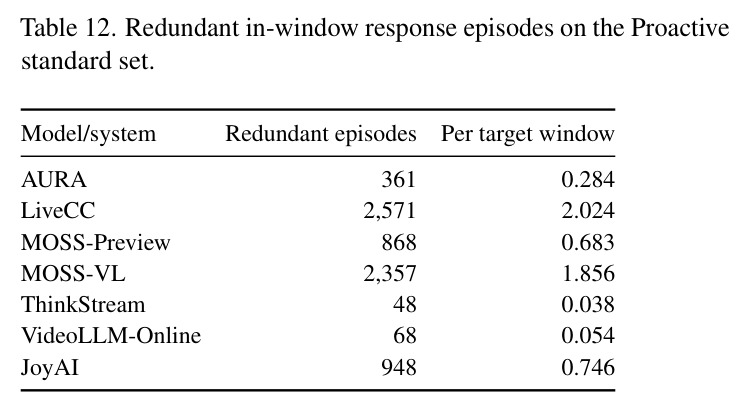
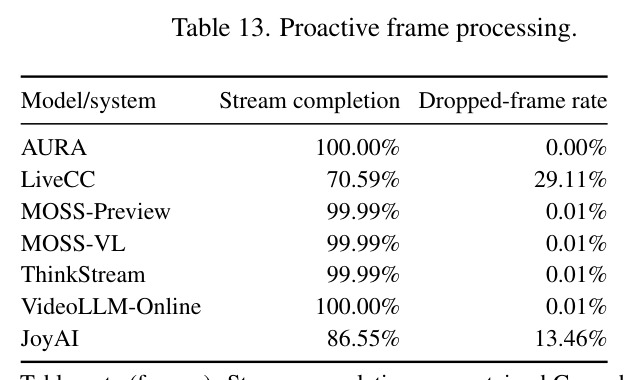
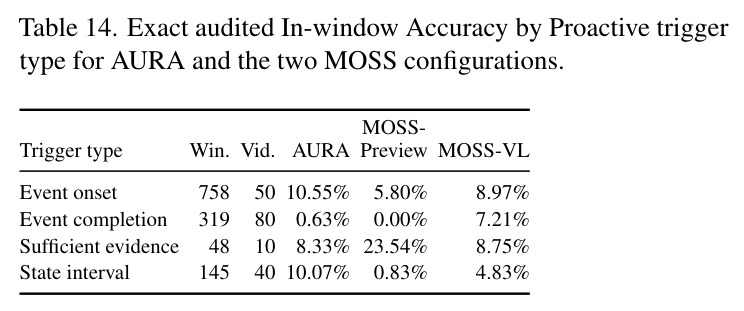
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 流式 QA 准确率(833 条记录) | Accuracy | MOSS-VL 75.03%(完成率 99.88%、无效输出 0.84%) | VideoLLM-Online 2.64%(95.32% 输出无法解析为唯一选项) | +72.39 个百分点 |
| 流式 QA(非原生前缀重建 vs 原生流式) | Accuracy | AURA 73.83%,中位延迟 819.7ms,输出 2,469 token | LiveCC 65.19%(原生流式),中位延迟 165.2ms,输出 146,064 token | +8.64 个百分点(但延迟与历史重建路径不同,不可直接当作效率对比) |
| 主动响应质量(407 条记录、1,270 个目标窗口,W=5s) | In-window Accuracy | JoyAI 17.08%(完整系统边界);模型侧最佳 LiveCC 12.98% | VideoLLM-Online 0.18% | 完整系统 +16.90;模型侧 +12.80 个百分点 |
| 主动响应选择行为 | False-alarm Rate / Miss Rate | MOSS-VL 误报 41.1%(最低);LiveCC 漏报 0.31%(最低) | VideoLLM-Online 误报 82.4%;ThinkStream 漏报 68.43% | 误报 −41.3 个百分点;漏报 −68.12 个百分点 |
| 与已发布流式基准的维度覆盖(Table 1,2026-07 发布审计) | 13 项标注/指标维度覆盖数 | TRACE:13/13 全覆盖(517 视频、1,240 记录) | OmniInteract 9/13(最高);OVBench 仅 3/13 | 唯一同时具备触发规则、逐题证据时间、复核真值、无效输出、FA/Miss、工作负载与完成率的发布评测 |
局限与改进
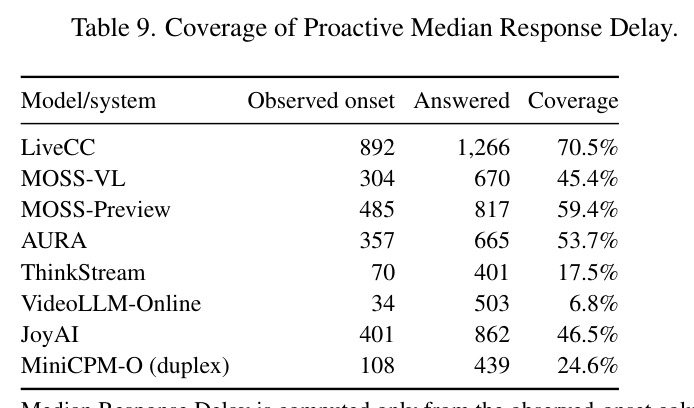
作者承认的局限:结论限于 1 FPS、纯视觉、单指令设定与被测的 8 个模型/系统;主动任务以正向触发为主,误报率定义为『当前无有效窗口且之后仍有机会时开口』,不是无触发视频上的一般假阳性率;部分模型带实现特定问题(ThinkStream 的尾块提交、JoyAI 的完整系统边界、MiniCPM-O 双工口语输出 93.52% 无法解析);标注是辅助性质检而非盲标注,Judge 校准仅 36 样本、单一评审。我补充的观察:(1) 中位响应延迟的观测覆盖率差异巨大(LiveCC 70.5% 对 VideoLLM-Online 仅 6.8%),低覆盖配置的延迟中位数代表性有限;(2) 各配置回答的窗口数悬殊(LiveCC 答 1,266 个、MOSS-VL 仅 670 个、VideoLLM-Online 503 个),低漏报可能部分源于『答得多』,低准确率可能源于『答得少』;(3) 工作负载指标跨词表、跨适配器不可作效率比较,但表格排版仍易被误读为排行榜;(4) 全部主动窗口内准确率都在 18% 以下且无人类上限参照,判定口径可能偏严。
独立分析的弱点
独立来看,本文有四个值得警惕的弱点。第一,规模与多样性有限:517 个视频、单一监控指令、1 FPS,且 8 个配置中有两个(VideoLLM-Online、MiniCPM-O 双工)主要暴露接口/解析失败,真正可比的有效样本偏少,『8 个模型』的统计力有限。改进方向:扩充多指令、多触发密度场景,为口语输出模型提供转写兼容通道后再纳入常规对比。第二,主动指标全线上天(最高 17.08%),缺少人类操作员上限和基于触发密度的随机/期望基线,无法判断低分来自模型弱还是任务与判定过严。改进:引入人类上限与期望值基线校准难度。第三,Judge 只看文本不看视频,无法发现『文本说得通但与画面矛盾』的回答,且校准集仅 36 条、分层非随机、二元一致不能证明连续部分分的校准。改进:扩大校准样本、给 Judge 提供关键帧做视觉一致性检查。第四,误报定义依赖『之后仍有响应机会』,系统在无触发视频上持续胡说不会计入误报率;改进:补充无触发静默率指标。此外,把接口诊断(MiniCPM-O 双工)与常规对比放在同一张表中,虽有声明仍有被断章取义引用的风险。
未来方向
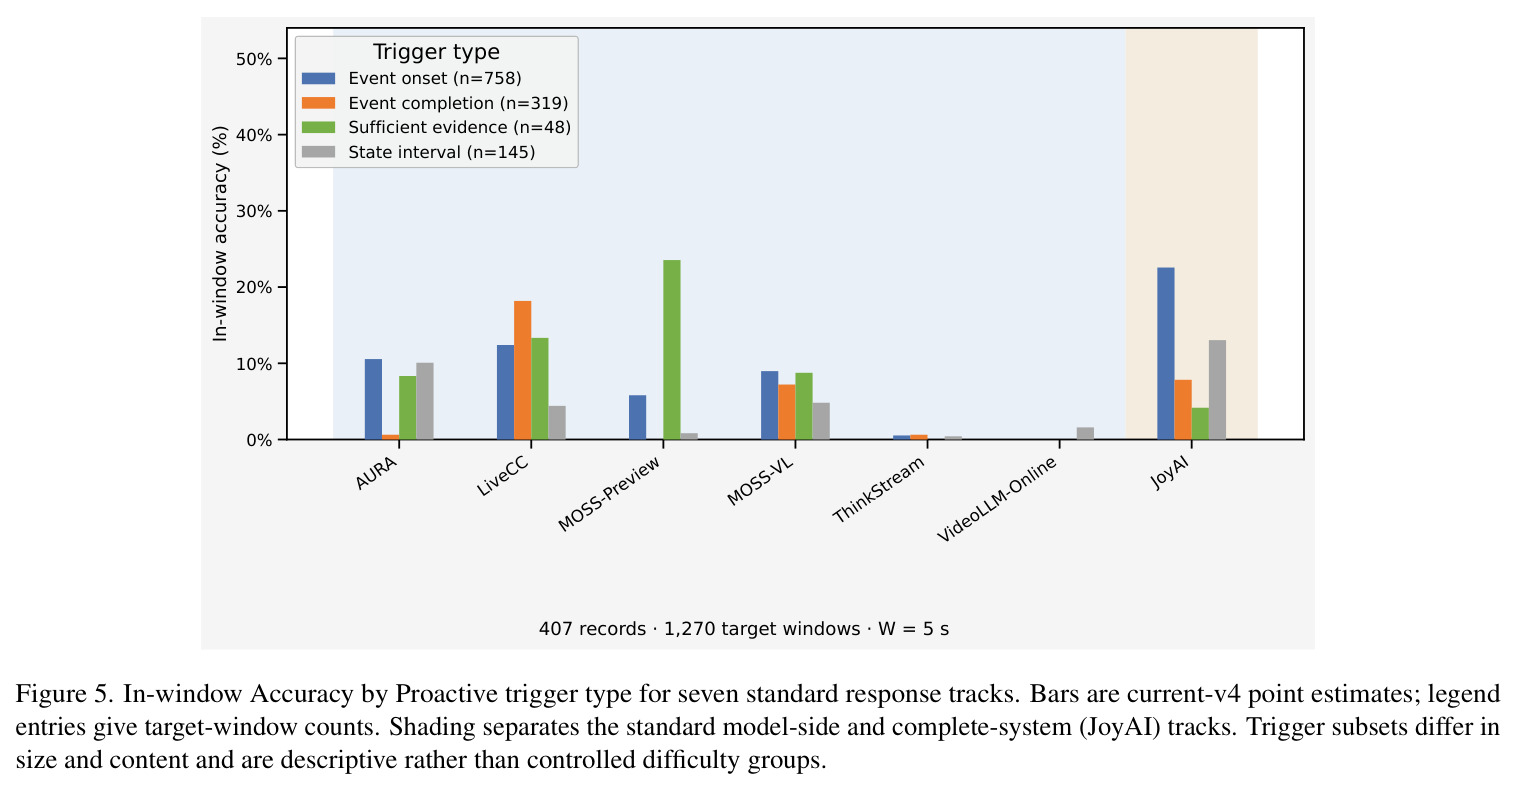
作者提出的方向:(1) 覆盖无触发与负事件,使误报率更贴近真实部署;(2) 提高视觉采样率(1 FPS 无法覆盖快事件,25 个不超过 1 秒的窗口已因此移出标准集);(3) 引入音频与多轮交互,向全双工对话延伸;(4) 长时间持续运行测试——信号已有:JoyAI 流级完成率 86.55%、丢帧 13.46%,LiveCC 完成 70.59%、丢帧 29.11%。基于本文成果还可延伸:(5) 把条件感知报告变成训练信号,用误报/漏报分解构造奖励,缓解 LiveCC 式『高覆盖+高误报』与 ThinkStream 式『双高』失败模式;(6) 建立跨基准的执行条件元数据标准,让已有流式基准分数可按声明条件换算对齐;(7) 把审计流水线(模型筛查+人工复核+变更台账)开源为通用工具;(8) 系统研究查询时前缀重建与原生状态更新的权衡(AURA 对 MOSS-VL:73.83%/819.7ms 对 75.03%/374.6ms);(9) 按触发类型细分评估——Table 14 显示 MOSS-Preview 证据充分类 23.54% 而事件完成类 0%,能力高度不均衡。
复现评估
复现条件较好。基准与代码在 GitHub(github.com/om-ai-lab/trace-bench)开源;任务源自公开的 StreamingBench 与 OVO-Bench,源视频可直接获取;发布内容包括修订后的时间标注、逐记录变更台账(328 条编辑、952 个字段的前后值)、52 条剔除记录及原因、Judge 提示词(osb-vlm-judge-v1)与打分代码、各模型 Adapter 设置与解析后的运行时配置,作者声明不需要内部评审工作区即可复现评测总体。算力方面,本地模型运行在 NVIDIA A100 80GB 上,涉及 8 个模型/系统的权重或服务(JoyAI 为多服务端到端部署,成本最高);1 FPS、517 个短中视频的单次评测量对单机多卡实验室可行。难点在于:需正确实现各模型的流式接口与状态组织(这正是论文强调要记录的部分);Judge 依赖 OpenAI 兼容端点部署 Qwen3.5-35B-A3B;主动评分与窗口指派细节(首 token 归窗、严格窗口、缺失时间戳回退到 Core 接收时间)需要仔细对齐。总体属于『中等工作量、文档充分』的可复现级别。
论文图表