投资者的期末考试:无未来信息的 AI 股票投资研究基准 Investor's Last Exam: Can AI Agents Do Equity Investment Without Seeing the Future?
基于343万版本化文档的股票研究基准,发现顶尖模型研究强、预测弱。
前置知识
前视偏差(Look-ahead Bias)
金融回测与评测中的经典陷阱:在决策时刻使用了当时不可能获得的信息。例如用某季度财报发布后的股价数据来评估『发布前』的预测能力,或检索到内容更新晚于页面标注日期的资料。它会让评测分数虚高,因为模型实际上『偷看了答案』。
本文的全部设计都围绕压制前视偏差展开,理解它才能理解为什么日期过滤不够、必须做版本级截止控制。
信息截止环境(Cutoff Environment)
为智能体设定一个时区感知的截止时间 $t_c$,只有可用时间早于 $t_c$ 的文档版本才可访问。关键区别在于约束层级:检索级只在查询上加日期过滤,系统级则在数据访问、计算、缓存、下载整条工具链上强制执行可用性检查。
ILE 的核心贡献就是把截止从检索级启发式升级为系统级约束,这是理解其与 FinanceGym 等前作差异的关键。
买方股票研究流程(Buy-side Equity Research)
基金经理侧的研究实践:筛选投资机会、构建证据与盈利预测、给出投资建议、持续监控论点。产出物包括可比历史序列、运营预测、盈利桥、估值与隐含预期、论点更新等,质量取决于证据、假设与判断组成的分析链是否自洽。
ILE 的任务分类法直接来自这套交付物体系,不懂研究流程就无法理解任务为什么这样分类和评分。
金融依赖图(Financial Dependency Graph)
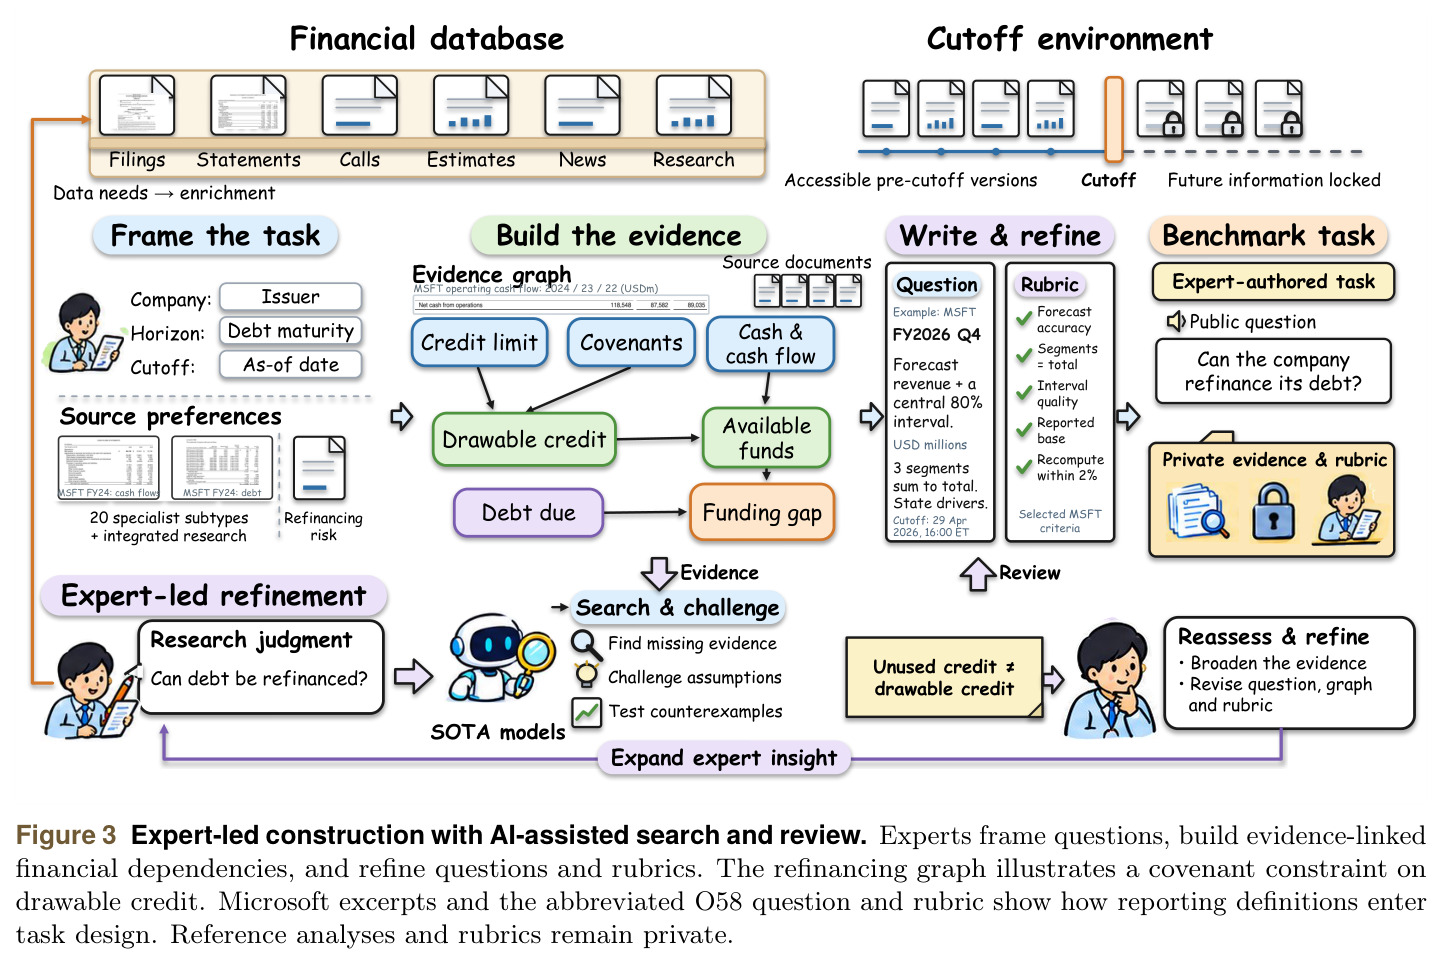
论文提出的任务表示方法:把一道题里的源事实、财务假设、中间计算和投资判断用显式财务关系(会计恒等式、收入桥、同业类比等)连成图,每个事实节点保留发行人、期间、单位、来源版本和位置,评分标准逐条锚定到图上节点。
它让『研究过程』这种难以评分的对象变得可追溯:错一道题可以定位到具体哪个财务依赖出了问题。
LLM-as-Judge 及其偏差
用大模型给开放性答案打分的评测范式。已知存在位置偏差(答案顺序影响打分)、冗长度偏差(更长答案得分更高)和自我增强偏差(模型偏爱自己的输出)。数值标准可用确定性脚本检查,语义标准则必须依赖模型评审。
ILE 的语义评分由 GPT-6 Astra 承担,评审偏差直接影响排行榜,论文在附录 I.3 做了敏感性分析。
研究动机
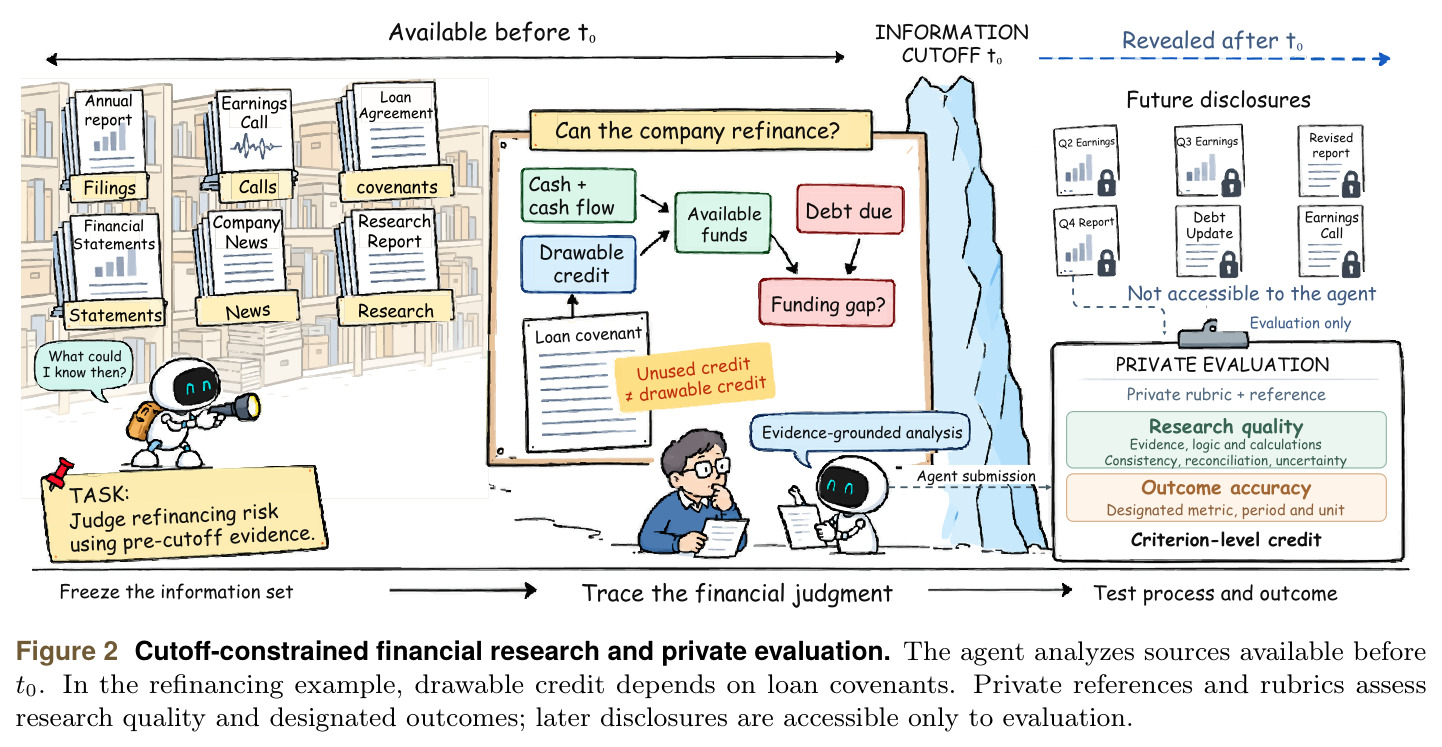
现有金融基准大多只覆盖研究流程的孤立环节:FinanceBench 做文档问答,Finance Agent 与 FinSearchComp 引入智能体检索,FinBench 开始评估预测与结果验证,FinanceGym 结合论点式报告、专家评分标准和按发布日期过滤的网页语料。但按发布日期过滤只是检索层面的启发式手段——页面的发布日期不等于内容真正可用的时间,缺失元数据、页面更新、回顾性报告都可能绕过日期过滤。论文给出了具体证据:在 Tesla 任务 O74 中,GPT-6 Astra 的检索查询明确包含 before:2026-03-24,却返回了一份 7 月 2 日发布、报告 Q2 真实交付量的来源;在公开网页评测中,49/86(57%)的轨迹混入了截止后信息,包括目标季度的微软真实营收。这意味着前视泄露与证据来源不可控,高分无法说明模型是在『当时可知』的信息上做出的判断,也没有基准能同时覆盖来源追溯、截止控制与过程评分。
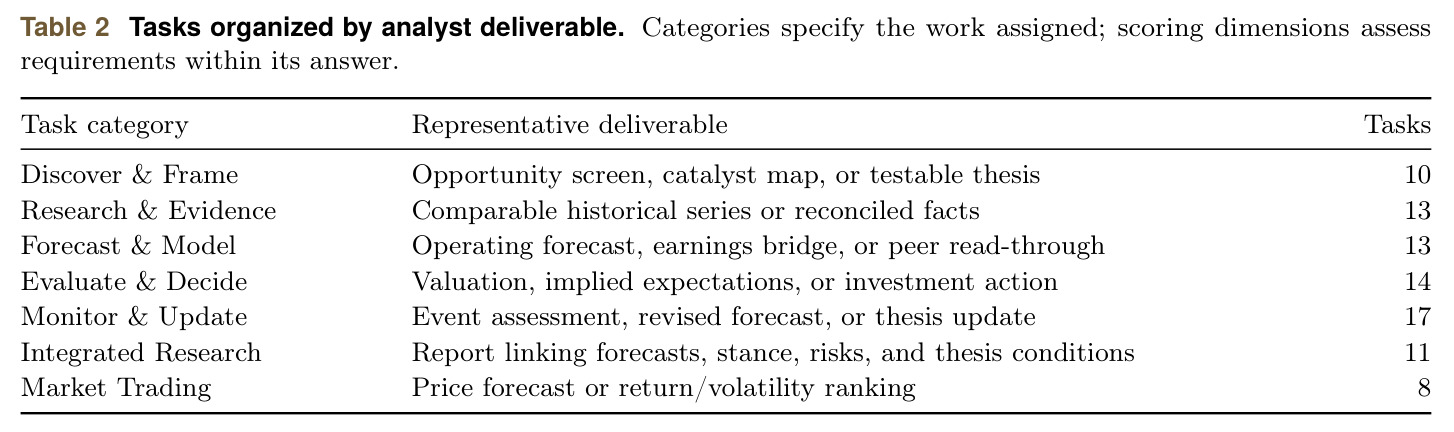
本文的目标是构建 ILE(Investor's Last Exam),评估 AI 智能体能否在严格信息边界内完成完整的分析师工作流——从证据检索、假设建模,到预测、估值和投资决策。具体目标分三块:其一,建立版本化金融数据库(343 万文档版本、1.52 TB、九大来源类别,覆盖中美港等多个市场),让截止约束在数据访问、计算与评分全链路生效;其二,建立由资深买方投资者与基金经理设计、按专业交付物组织的任务分类法(5 大类 20 子类,外加综合研究与市场交易),共 86 个任务;其三,通过金融依赖图把每条评分标准锚定到具体来源、可复现计算或显式财务判断,使错误可定位。评估同时考察研究质量、预测准确性与模拟投资表现三个维度,最终把『证据—假设—判断』链作为评估单元。
与已有工作不同的是,本文的独特切入是把评估单元从孤立能力换成『证据—假设—判断』链。作者团队(买方投资者与基金经理)观察到:研究判断的质量不取决于任何单一能力,而取决于分析链是否自洽、证据是否充分、预测能否经受事后验证——这些属性嵌入真实研究过程,孤立任务无法捕获。与 FinanceGym 等相比,ILE 把截止从检索层日期过滤升级为系统级约束:每个文档版本在采集时就记录可用时间(而非事后推断),共享工具库在 search/read/download/bash 全链路执行授权与可用性检查;评分侧保持信息隔离,参考分析、评分细则和后续披露对智能体保密。金融依赖图则让难以评分的『研究过程』变得可审查、可追溯,这是此前任何金融基准都没有做到的。
核心方法
直觉类比:ILE 像一场『不许看未来』的考试——考生(智能体)只能翻阅截止时间 $t_c$ 之前已公开的资料,答案(后来的财报、真实市场走势)锁在监考老师(评估侧)手里,评分标准也保密。技术路线由三部分组成。第一是版本化语料库:保留每个历史版本、永不覆盖,并为每个版本赋予『可用时间』,只有可用时间早于 $t_c$ 的版本对智能体可见;第二是专业任务分类法:按分析师交付物组织成五大类二十子类,外加综合研究与市场交易,共 86 个任务;第三是专家主导的构造框架:每个任务被构造为金融依赖图,把源事实、财务假设、中间计算和投资判断用显式财务关系(会计恒等式、收入桥、同业 read-through)连接,评分标准逐条锚定到图上节点。评估使用六族共享工具(search、read、download、table_operations、bash、submit_answer),每任务限时 7200 秒、最多 3 次提交,最终答案按加权标准在 0–100 分制上评分。
核心创新是把时间约束做进信息本身,而不是做进查询里。已有方法(如 FinanceGym)按发布日期过滤网页,但页面发布日期不等于内容可用时间,截止后信息仍可能进入检索、计算与评分。ILE 建立了一个持续更新、永不覆盖旧版本的语料库:截至 2026 年 10 月 15 日含 3,430,336 个文档版本、共 1.52 TB,覆盖财报、结构化报表、业绩电话会、投资者材料、发行人事件、分析师预期、研报、机构持仓、新闻九类来源;每个不可变版本记录发布/发布时间、时区与精度,时间戳归一化采用保守可用边界,无法可靠确立可用时间的记录直接排除出任务访问,每次修订单独获得自己的可用时间。这一边界由共享工具库在整条工具链上强制执行:search 只发现合格版本,read 返回其段落与表格,结构化表工具查询后冻结结果以防后续修订污染已取数据,bash 在任务工作区内禁网运行;评估侧信息隔离,预测结算时再匹配目标指标、期间和单位。
方法步骤详情
第一步,构建版本化数据库:持续采集九类来源,每个版本在采集时确立可用时间而非事后推断;无法验证的时间戳先用 SOTA 模型推断并交叉验证,仍不可靠则排除。第二步,专家定任务要素:基于买方研究实践指定实体、期间、交付物和投资判断,交付物直接对应分类依据;缺少所需来源类别时扩展采集、解析与版本追踪。第三步,构造金融依赖图:专家用 search/read 挑选源段落挂到论断和计算上,每个事实保留发行人、期间、单位、来源版本与位置,关系表达财务规则;多个 SOTA 模型辅助搜证、测试假设、提出反例,是否采纳由专家定夺——如再融资案例中,专家在检查贷款契约后补上『授信在该状态下是否可提取』这一决定性依赖。第四步,评分细则校准:每条标准关联证据、可复现计算或显式财务判断,规定权重、容差与部分给分;试答暴露歧义后溯源修订,如 AWS O15 改为中心 80% 区间的准确性—不确定性联合评分。第五步,运行评估:任务得分 $s_i = 100\,\sum_j w_{ij}g_{ij}/\sum_j w_{ij}$($w_{ij}$ 为权重、$g_{ij}\in[0,1]$ 为得分比例),总分 $S = \frac{1}{N}\sum_{i=1}^{N} s_i$ 任务等权;数值标准用确定性检查,语义标准由 GPT-6 Astra 评审;另设严格提交模式,并用 20 个任务构建预测驱动的模拟交易。
技术新颖性
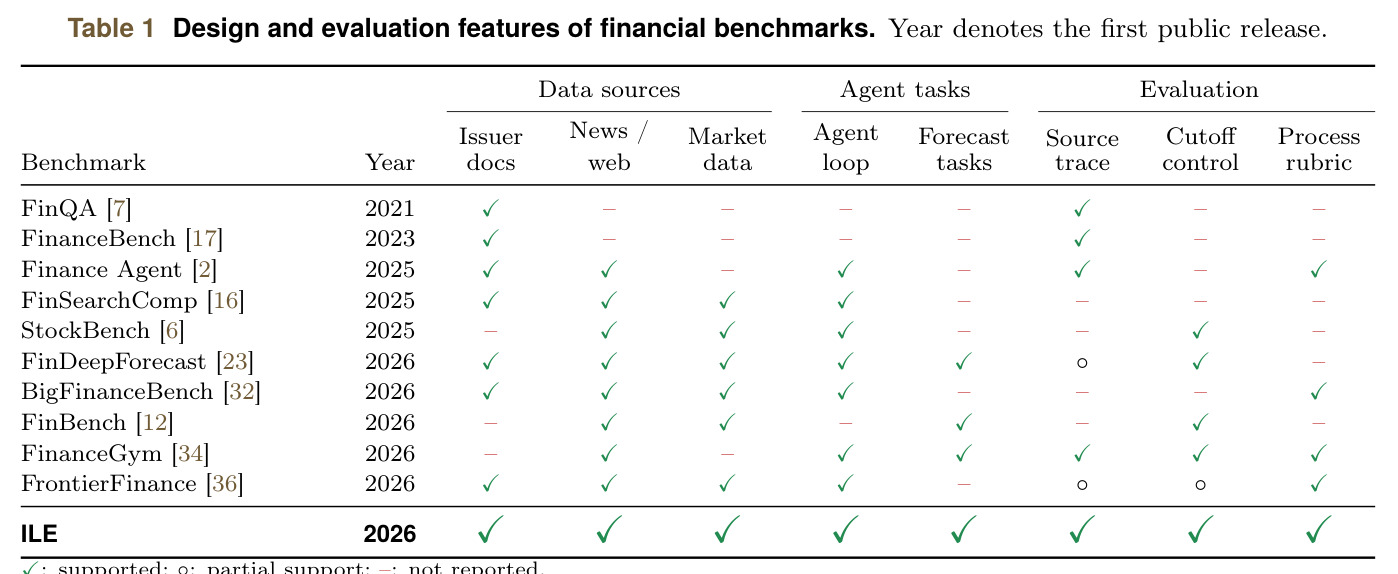
与已有工作的本质区别有三点。第一,评估单元不同:FinQA/FinanceBench 测孤立问答,Finance Agent 测检索,FinBench 测预测,而 ILE 以『证据—假设—判断』链为单位,把七个 rubric 维度(结果、证据、财务逻辑、计算、勾稽、决策一致性、不确定性)与指定结果准确性、模拟投资表现联合评估。第二,截止控制机制不同:FinanceGym 用发布日期过滤网页(检索级启发式),FinDeepForecast 与 FrontierFinance 只有部分来源追溯与截止控制,ILE 用版本级可用性约束覆盖检索、计算与评分全流程——Table 1 中唯一在发行人文档、新闻/网页、市场数据、智能体循环、预测任务、来源追溯、截止控制、过程评分八项上全部打勾的基准。第三,评分可追溯:金融依赖图使每条 rubric 都能定位到具体源文档或计算,错误可归因到某个财务依赖,而非给出一个无法解释的总分。
实验结果
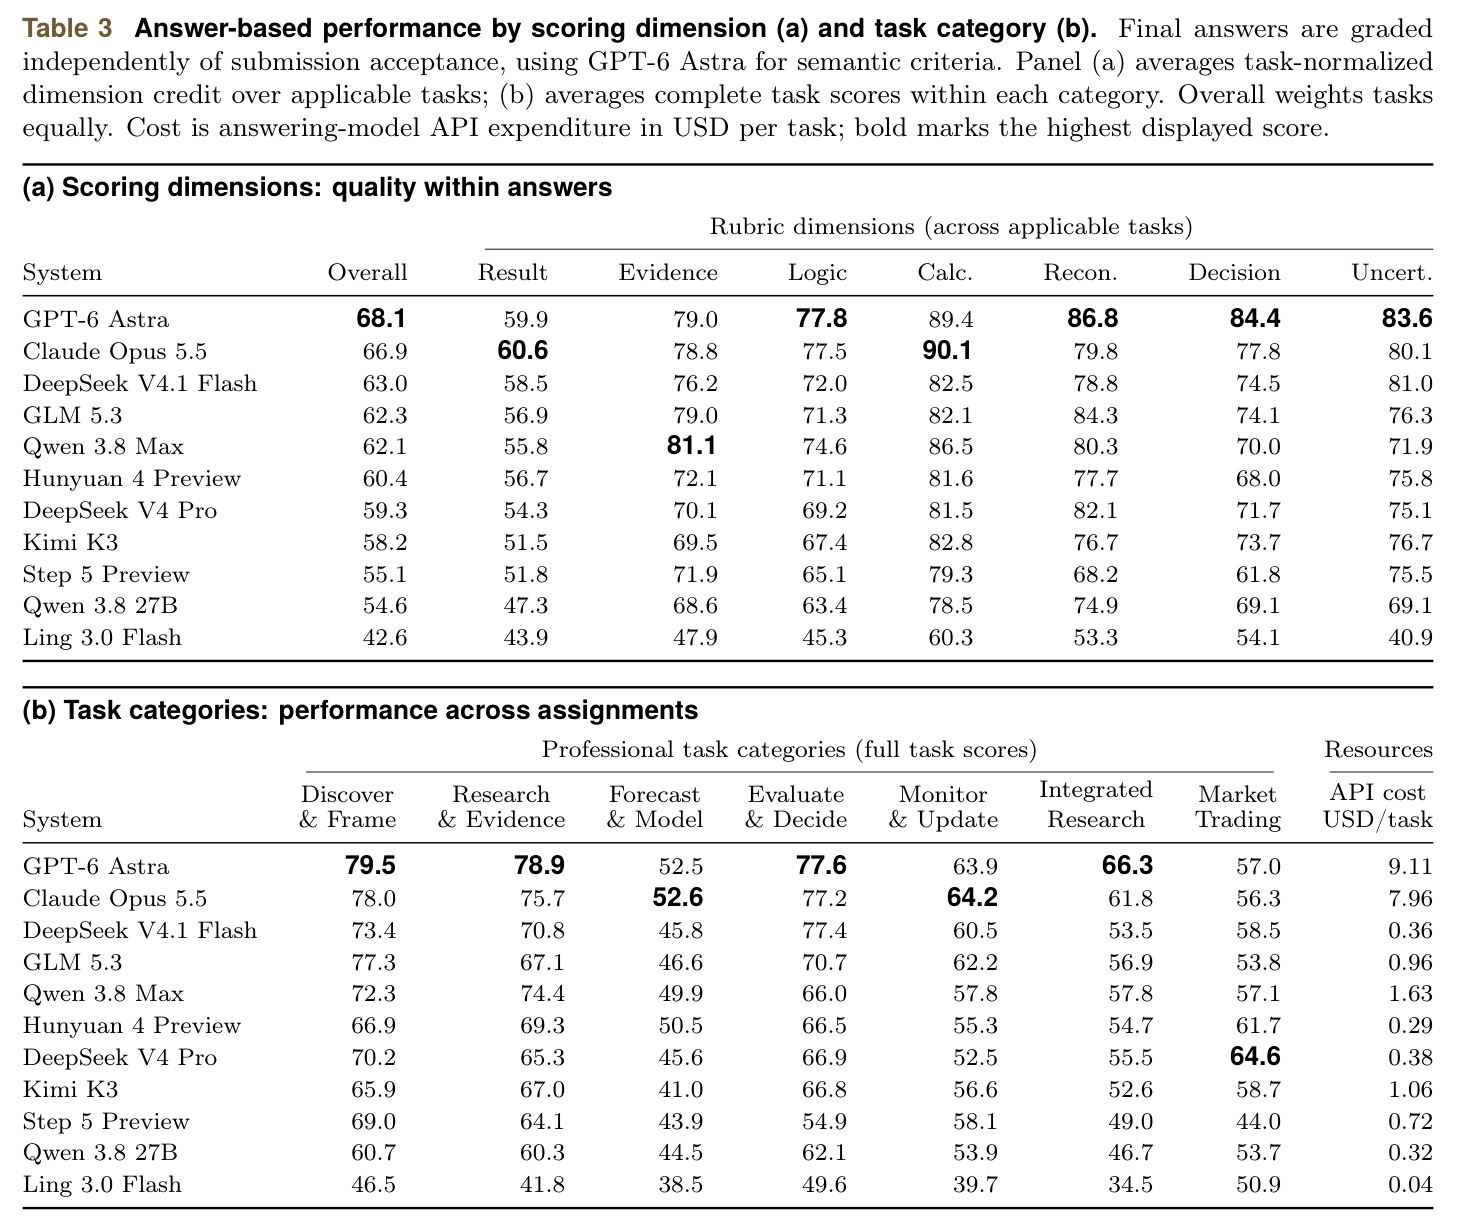
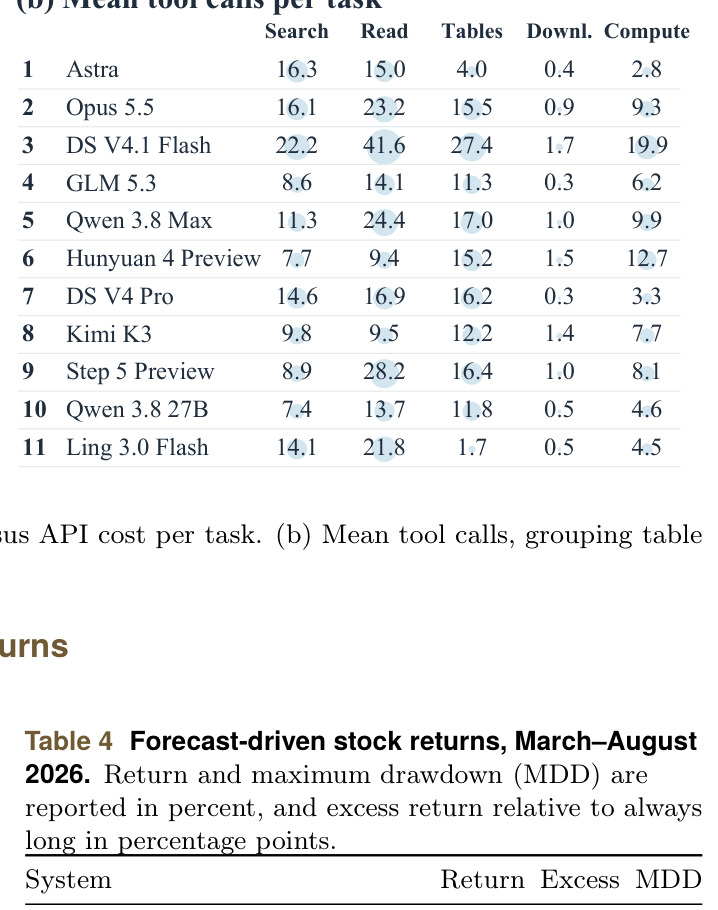
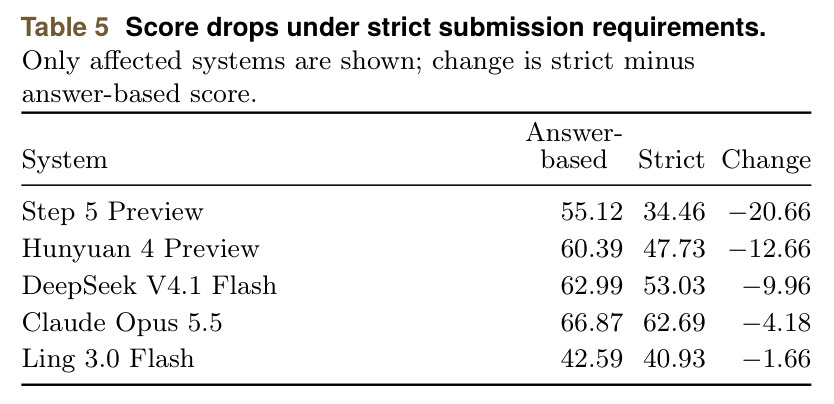
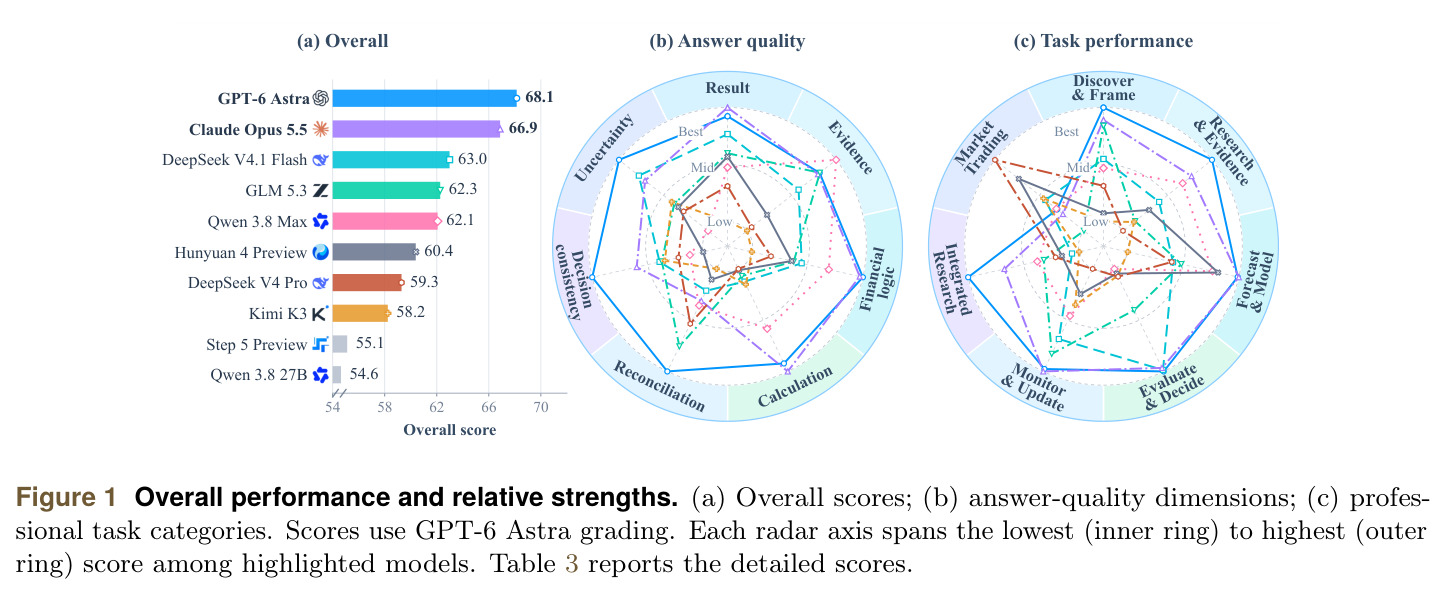
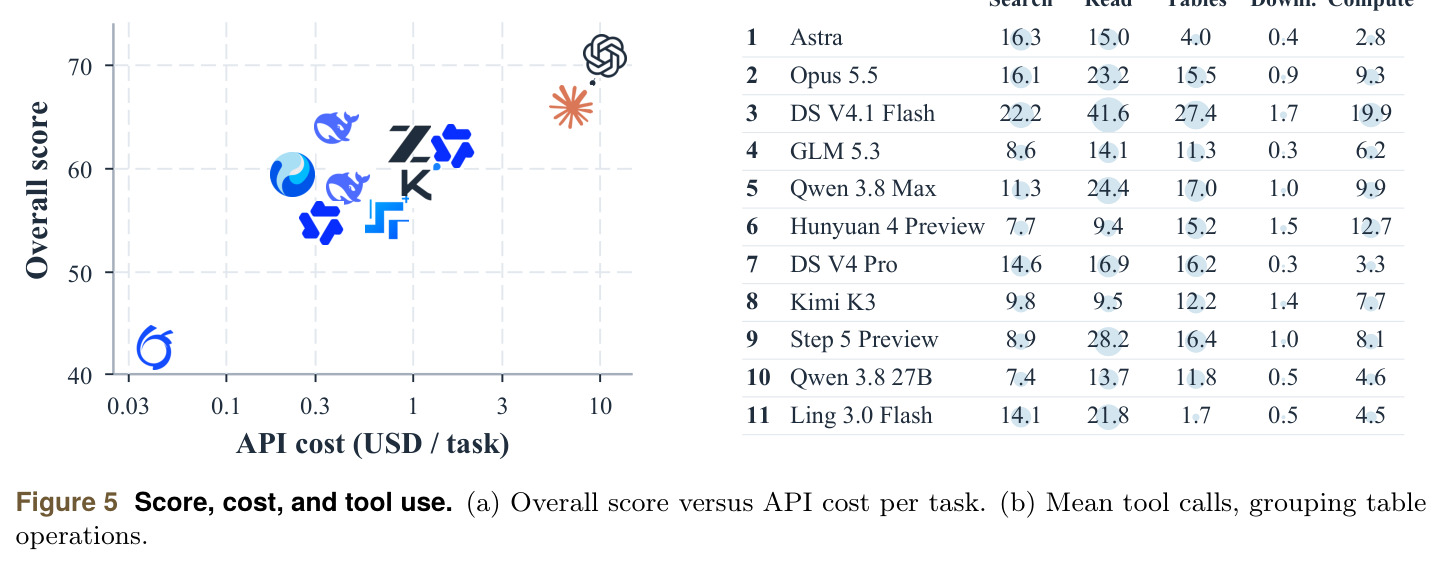
11 个系统在 86 个任务上的核心结论是『研究能力不等于预测能力』。总体上 GPT-6 Astra 以 68.1 领先,Claude Opus 5.5 次之(66.9),DeepSeek V4.1 Flash 63.0,最低的 Ling 3.0 Flash 只有 42.6。但分维度看,Astra 在 Research & Evidence 得 78.9、Evaluate & Decide 得 77.6,而 Forecast & Model 仅 52.5(KPI 预测 41.1、跨公司预测 49.6),预测构建是最明显的短板。按预测结果计分时排名重排:DeepSeek V4.1 Flash 以 40.3 领先(Astra 37.7、Opus 37.6);DeepSeek V4 Pro 以总体第 7 的 59.3 拿下 Market Trading 类第一(64.6,Astra 仅 57.0)。成本差异悬殊:Flash 每任务 0.36 美元得 63.0 分,Opus 多 3.9 分却花 7.96 美元(约 22 倍);智能体行为差异也大,Flash 平均每任务 73.8 轮交互、113.8 次工具调用,远超 Astra。模拟交易(2026 年 3–8 月,20 个任务、11 家公司、13 次披露,相对存档分析师预期做多/做空)中,Hunyuan 4 Preview 以 +8.50% 领先(超额 +7.32),Flash +7.98%、Astra +7.18%,Kimi K3 的 +7.15% 高于研究分更高的 Opus(+6.39%),而『永远做多』仅 +1.18%、『永远做空』−2.27%。严格提交模式下分数大幅下降:Step 5 Preview 55.1→34.5(−20.7),Hunyuan 60.4→47.7,Flash −10.0,Opus 66.9→62.7。案例层面,AEP N27 中 11/11 系统都能恢复 8 个披露输入并勾稽现金流量恒等式,但只有 5/11 算出两个融资缺口(2025 年 2,676→2026 年 3,181 百万美元,扩大 505)、3/11 区分净燃料调整与总收入、5/11 得到有依据的融资结论;Tesla O80 中 3 个系统拿了全部支撑分析的分却在预测结果上得零分。公开网页评测中 Astra 得 68.3 与数据库版 68.1 相当,但 57% 的轨迹含截止后来源——分数相当不等于边界合规。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 86 个股票研究任务总评 | Overall(0–100,任务等权) | GPT-6 Astra 68.1(基准最高分) | Claude Opus 5.5 66.9;最低 Ling 3.0 Flash 42.6 | 领先 Opus 1.2 分,但无模型在任何类别全面领先 |
| Forecast & Model 类(13 个任务) | 类内完整任务均分 | Claude Opus 5.5 52.6 | 总体冠军 GPT-6 Astra 仅 52.5(KPI 预测 41.1) | 总体最强模型在预测类反被反超,暴露核心短板 |
| 预测结果准确性(forecast-outcome 标准) | 结果类标准得分(0–100) | DeepSeek V4.1 Flash 40.3 | GPT-6 Astra 37.7、Claude Opus 5.5 37.6 | 领先约 2.6 分,整体排名发生重排 |
| Market Trading 类(8 个任务) | 类内均分 | DeepSeek V4 Pro 64.6 | GPT-6 Astra 57.0、Opus 56.3 | 总体仅 59.3(第 7 名)的模型拿下类第一 |
| 预测驱动模拟交易(20 个任务,2026 年 3–8 月) | 区间收益率 / 超额收益(%) | Hunyuan 4 Preview +8.50%(超额 +7.32,MDD 2.72) | 永远做多 +1.18%,永远做空 −2.27% | Kimi +7.15% 反超研究分更高的 Opus +6.39% |
| 成本效率 | Overall 分数 / 每任务 API 成本(USD) | DeepSeek V4.1 Flash:63.0 分 / $0.36 | Claude Opus 5.5:66.9 分 / $7.96 | Opus 仅多 3.9 分,成本约为 22 倍 |
| 严格提交模式(必须 submit_answer 成功) | Overall 相对答案默认模式的变化 | Step 5 Preview 降至 34.5(−20.7) | 答案默认模式 Step 5 Preview 55.1 | Hunyuan −12.7、Flash −10.0、Opus −4.2,提交可靠性独立于分析质量 |
局限与改进
作者承认两点局限:一是前沿模型可能在预训练中记住部分历史结果,仅靠版本库无法完全区分参数化记忆与外部检索,需要『反事实/冷启动』实验才能彻底剥离;二是部分任务以真实披露或市场价格结算,正确的中期推理不保证数值命中,外生市场噪声会让严谨分析偏离真实值,只按结果准确率评估会低估研究质量。我的补充观察:语义评分完全依赖 GPT-6 Astra 单一评审,而榜单头部模型本身就是裁判,存在自我偏好风险(附录 I.3 只做了敏感性分析);模拟交易样本很小(20 个任务、13 次披露),±1% 量级的排名差异缺乏统计显著性检验;评分规则在专家校准过程中会变化(如 AWS O15 重写区间评分),同一模型在不同 rubric 版本下分数不可直接比较;另外当前只覆盖股票研究,结论对其他金融决策场景的外推未验证。
独立分析的弱点
第一,记忆污染无法根除:截止时间越久远,历史结局越可能已进入训练语料,模型可能『背答案』而非推理,改进方向正是作者设想的反事实引擎——扰动真实报表、构造虚拟同业,使检索证据与记忆结局不一致。第二,单裁判依赖:主榜单语义分全部出自 GPT-6 Astra,头部模型兼任裁判,应引入多模型共识评审或人类专家抽检校准,并公开评审提示与逐条打分日志。第三,交易模拟样本太小:20 个任务上的排名差异可能纯属运气,应扩充披露事件数量并做 bootstrap 置信区间。第四,rubric 可变性:AWS O15 等案例显示专家修订会改变得分含义,需要冻结基准版本并公布 changelog,否则跨期比较失真。第五,人类基线缺失:没有资深分析师在同任务上的得分,无法判断 68.1 分距离专业水平有多远。第六,7200 秒/任务的配额对不同架构未必等价,Flash 用 73.8 轮长轨迹换分可能只是以时间补推理能力,应报告按等成本约束的对比。
未来方向
作者提出两个方向:一是构建反事实与合成金融场景引擎,扰动真实财务报表并构造虚拟同业公司,迫使智能体仅依赖检索证据推理,从源头隔离参数化记忆;二是重构任务与评估——把专家长任务分解为可组合的微任务图,配合难度加权评分和多模型共识评审协议,对预测类任务改进评估以区分推理失败与随机波动,使 ILE 成为随新市场披露持续扩展的『活基准』。基于成果可延伸的方向还有:把依赖图上的逐条评分转化为可验证奖励信号,用于金融智能体的强化学习训练;把『版本级可用时间』范式移植到法律、医疗等同样存在时间敏感证据的领域评测;建立人类分析师对照基线,并深入研究『研究分与交易收益错位』的机制——为什么证据组织能力无法迁移为预测校准能力。
复现评估
开源情况较好:代码在 GitHub(Prophetlab/Investor-Last-Exam),数据集在 HuggingFace(HenryJ12/InvestorLastExam),项目页 prophet-lab.cn/benchmarks/investor-last-exam-v1 提供文档。复现的主要门槛是基础设施:1.52 TB 的版本化数据库需要本地托管,并实现跨工具链的可用性检查与结果冻结逻辑;完整复现主评测需调用 11 个前沿模型的 API,按论文成本估计每任务 0.04–9.11 美元,86 个任务全量约需数百至上千美元;语义评审还需要 GPT-6 Astra 访问权。对想试用的人,可以下载数据集中的少量任务,用自选模型按 7200 秒、3 次提交的协议运行,难度中等;论文附录 J 给出了提示词与工具 schema,附录 E 给出评分与聚合细节,有利于复现。要完整重建排行榜则需多供应商 API 与大容量存储,难度中高。
论文图表
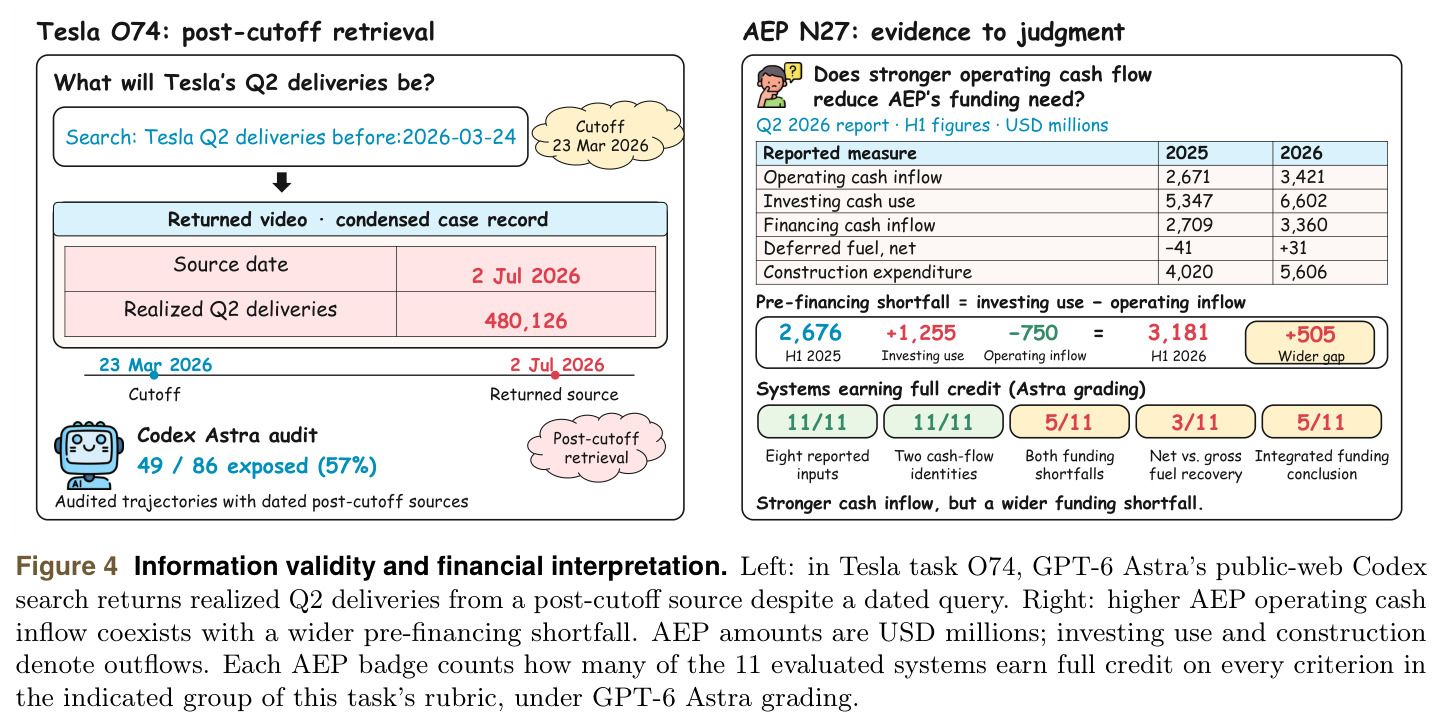
左半:Tesla O74 中 GPT-6 Astra 的公开网页查询虽带 before:2026-03-24 过滤,仍返回 7 月 2 日发布的 Q2 真实交付量,证明日期过滤约束的是查询而非信息;右半:AEP N27 中经营现金流上升(2,671→3,421 百万美元)但融资前缺口反而扩大(2,676→3,181),徽章显示 11 个系统中各评分标准组的满分人数(8 输入 11/11,两个缺口仅 5/11 等)。
左半是『为什么需要系统级截止』的最有力实证,右半是『恢复输入不等于理解依赖』的案例量化,两者分别支撑动机与方法有效性。