Quant-Arena:面向量化交易研究的 LLM 智能体基准 Quant-Arena: Benchmarking LLM Agents for Quantitative Trading Research
首个端到端量化研究基准:九个前沿LLM在A股密封2024年评估,无一跑赢等权市场
前置知识
RankIC(秩信息系数)
RankIC 衡量截面选股信号的预测能力:对每个交易日,计算全部股票的模型得分与次日收益率之间的 Spearman 秩相关系数,再对全年取平均。它反映分数的高低顺序与收益高低顺序的一致程度,绝对值达到 0.03 到 0.05 即被认为有预测力。论文还用其均值除以标准差再乘以 $\sqrt{N_{ann}}$ 得到年化信息比率 A,作为信号稳定性的度量。
论文的核心发现之一是 RankIC 与组合实际收益几乎不相关(Spearman 0.09),理解该指标才能明白排序有技巧与真正赚钱为何脱节。
Level-2 行情数据
Level-2 是证券市场的逐笔级原始数据,包含每一笔委托单、每一笔成交和订单簿快照,比日线 OHLCV 细粒度高几个量级。量化研究者可以从这些原始记录中构造订单流不平衡、撤单率、盘口压力等自定义特征,而不必依赖现成的因子表达式库,是对模型市场微观结构理解能力的直接考察。
Quant-Arena 的输入端正是这类原始数据,模型必须自己从逐笔记录发明特征,这是它与用日线或预定义因子库的其他基准的本质差异。
回测过拟合与多重检验
研究者反复在历史数据上回测并挑选最好结果时,不可避免会选中拟合了历史噪声的策略,导致样本外表现系统性低于回测表现。Bailey 等人 2017 年的工作量化了这种数据窥探偏差:对同一份数据尝试的次数越多,选出的最优策略真实期望越差,回测年化与真实年化之间的落差越大。
Quant-Arena 的协议设计(最多 5 次候选评估、冻结提交、密封评估年)正是为了控制这种偏差,理解它才能理解基准为何如此设计。
夏普比率与最大回撤
夏普比率是风险调整后收益指标,等于收益均值除以收益标准差,衡量每承担一单位波动换来多少收益;本文区分只做多组合的 $\mathrm{SRL}$ 与最高、最低得分十分位多空对冲的 $\mathrm{SRLS}$。最大回撤 MDD 是净值从历史高点跌落的最大幅度,衡量最坏情形下的下行风险,本文报告为负数。
评分公式中 $s_L = g_1(\mathrm{SRL})$ 直接使用这些指标,而 Astra 靠压低回撤与择时空仓取胜是理解实验结果的关键案例。
风格暴露(style exposure)
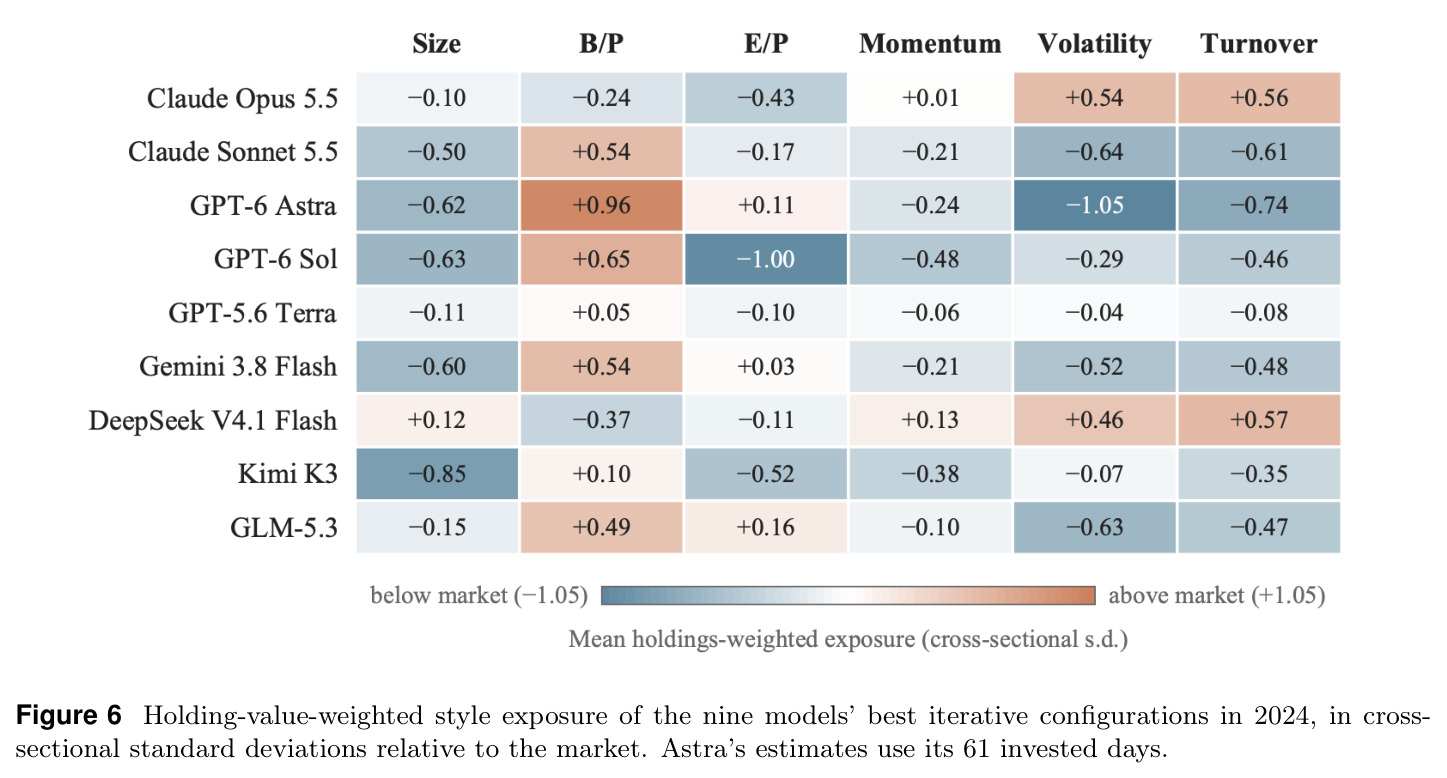
风格暴露衡量组合持仓在市值、账面市值比、盈利市值比、波动率、换手率等已知风格维度上的倾斜程度,通常用持仓加权后相对全市场的截面标准差倍数表示。例如账面市值比 +0.96 意味着组合明显偏向便宜的深度价值股,波动率 -1.05 则表示显著回避高波动股票。
第 3.6 节用它揭示九个模型趋同于小盘、低波、价值倾斜的持仓,并论证风格并不是区分赢家与输家的变量。
研究动机
量化研究是一个提出市场假设、写成可执行信号、历史回测、决定去留的迭代闭环,但现有基准只测量了这个闭环的碎片:AlphaQT-Bench 只评量化代码的正确性与可执行性,AlphaBench 只研究公式化因子的生成、评估与搜索,StockBench 只评智能体在给定市场信息下的逐笔交易决策,AlphaForgeBench 虽扩展到从自然语言生成因子与策略代码并在日线数据上回测,仍要求模型消费预处理后的行情。没有任何基准在真实市场数据上,要求模型从原始逐笔记录自己构造特征、在有限反馈下修正信号、并提交一个冻结策略接受样本外检验。更严重的是,若允许模型反复访问回测结果,多重检验偏差(Bailey 等,2017)会让选出的最佳策略系统性高估真实盈利能力。因此学界始终无法回答:LLM 到底能不能独立完成一整轮量化研究,并产出研究期之外仍然有效的策略。
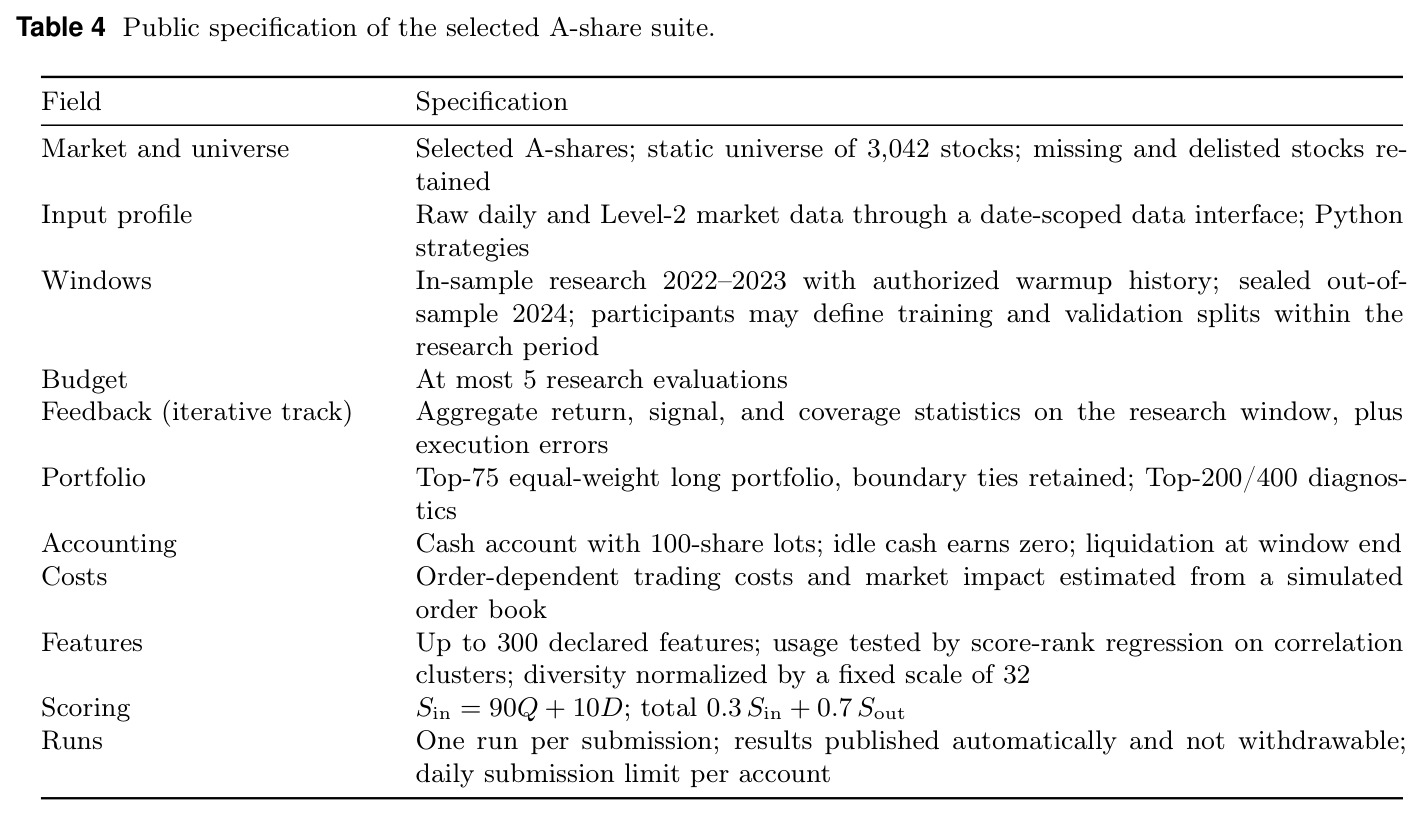
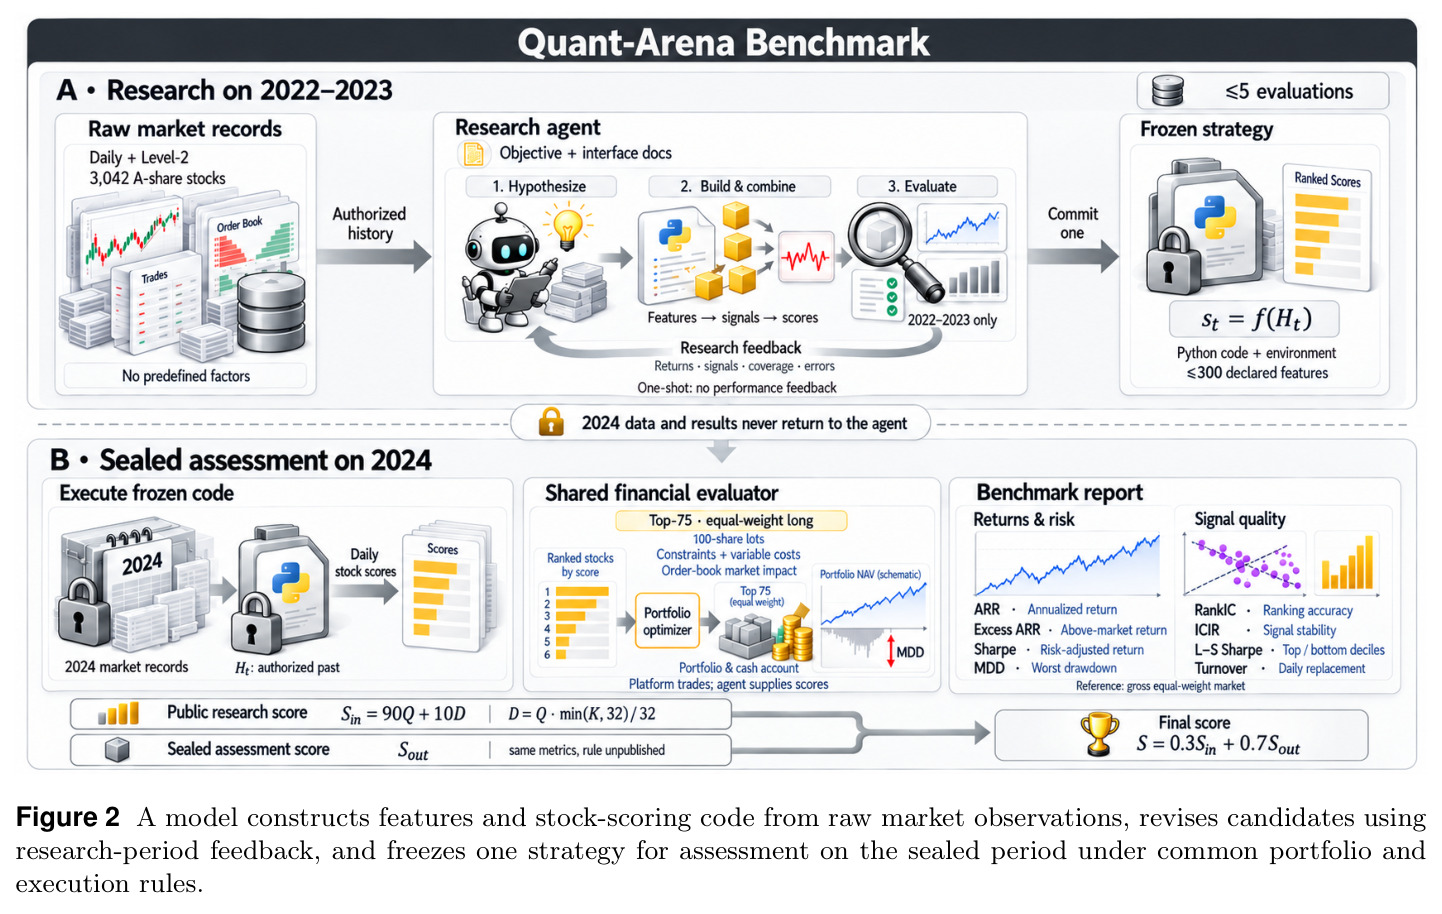
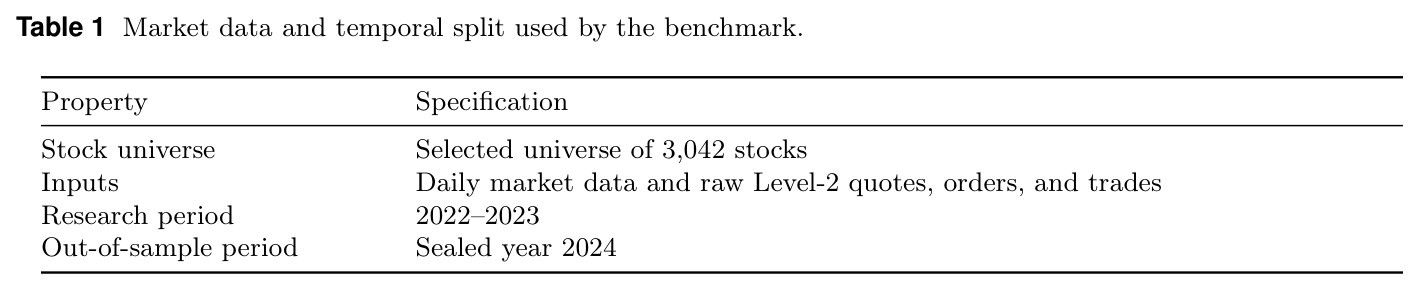
本文的目标是本文构建端到端的量化研究基准与公开排行榜 Quant-Arena。模型面对固定的 3042 只 A 股宇宙、真实 Level-2 逐笔委托、成交与订单簿快照,自行编写 Python 策略程序 $f$,在每个交易日 $t$ 输出全市场股票得分 $s_t = f(\mathcal{H}_t)$;研究期限定 2022 至 2023 年,每个运行最多评估 5 个候选策略,且只能看到聚合的收益与信号质量反馈。研究结束后冻结唯一策略,在模型从未见过的密封年份 2024 上,由统一的现金账户评估器施加 100 股手数约束、订单依赖交易成本与基于模拟订单簿的市场冲击,测量年化收益、超额收益、Sharpe、最大回撤、RankIC 等指标。总评分 $S = 0.3 S_{in} + 0.7 S_{out}$ 以已实现超额收益为主导权重,并向任何模型或智能体框架开放提交,使不同系统的量化研究能力首次可在同一协议下直接比较。
与已有工作不同的是,已有评测的单元各不相同:公式、代码或单笔交易决策,而本文把一次完整的研究运行作为评测单元,特征构造、信号组合、策略选择全部通过最终组合的样本外盈亏来联合评分。独特之处有三:其一,输入端不给预定义因子库,模型直接消费逐笔 Level-2 记录,考察能否从市场事件中自己发明特征;其二,用有界反馈加冻结提交加密封评估的三重机制把数据窥探偏差压到最低,且研究期与评估期的数据访问规则完全一致,杜绝信息泄露;其三,评估器不是简单的日收益核算,而是带手数约束、订单依赖成本和模拟订单簿冲击的现金账户回测,使找到预测信号与把信号变成盈利组合这两种能力被明确区分开。平台还记录全部候选评估轨迹,让模型如何使用反馈本身成为可研究的对象,这是其他基准完全没有的维度。
核心方法
把 Quant-Arena 想象成一场闭卷考试:考前(研究期 2022 至 2023)学生可以做五次模拟考(候选策略回测),看到总分和错题分布(聚合收益与信号统计),但考卷(2024 年)完全密封,进考场前必须交一份定稿答案(冻结的策略源码)。技术上,模型通过受控数据接口访问按日期、标的、字段授权的历史观测(含允许的预热窗口),编写策略程序对每个交易日输出全市场得分;统一评估器把得分转成持有 75 只最高分股票的等权多头组合,在含 100 股手数约束、交易成本与模拟订单簿冲击的现金账户中逐日复利计算净值。评分用平滑单调变换 $g_c(x)=\frac{1}{2}\left(1+\frac{x}{c+|x|}\right)$ 把各指标映射到 (0,1),该函数在 $x=0$ 时等于 0.5,奖励收益但边际递减、惩罚亏损而不截断;质量分 $Q = 0.6 s_R + 0.2 s_L + 0.05(s_{LS}+s_{IC}+s_{ST}+s_{TO})$ 六成权重压在已实现超额收益上,样本内分 $S_{in}=90Q+10D$ 再叠加特征多样性 $D=\min(K,32)/32$,总分为 $S = 0.3 S_{in} + 0.7 S_{out}$。
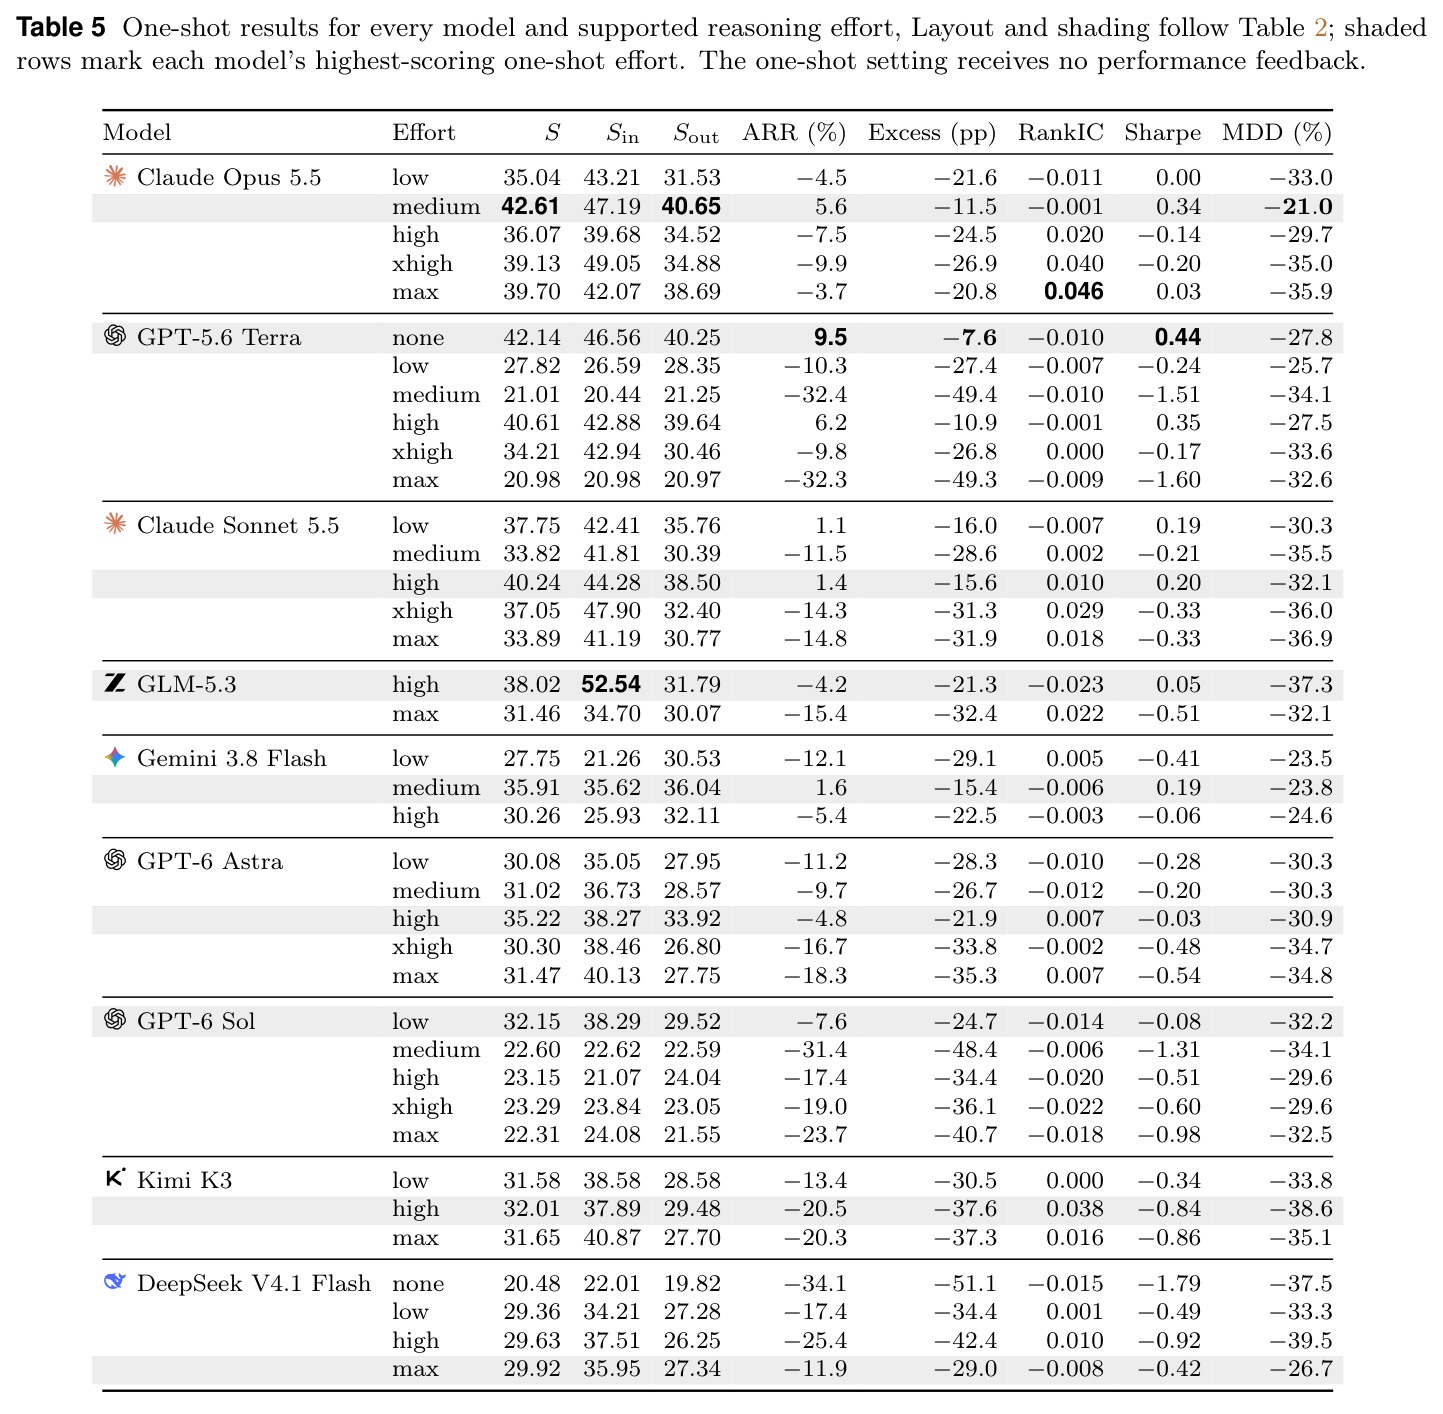
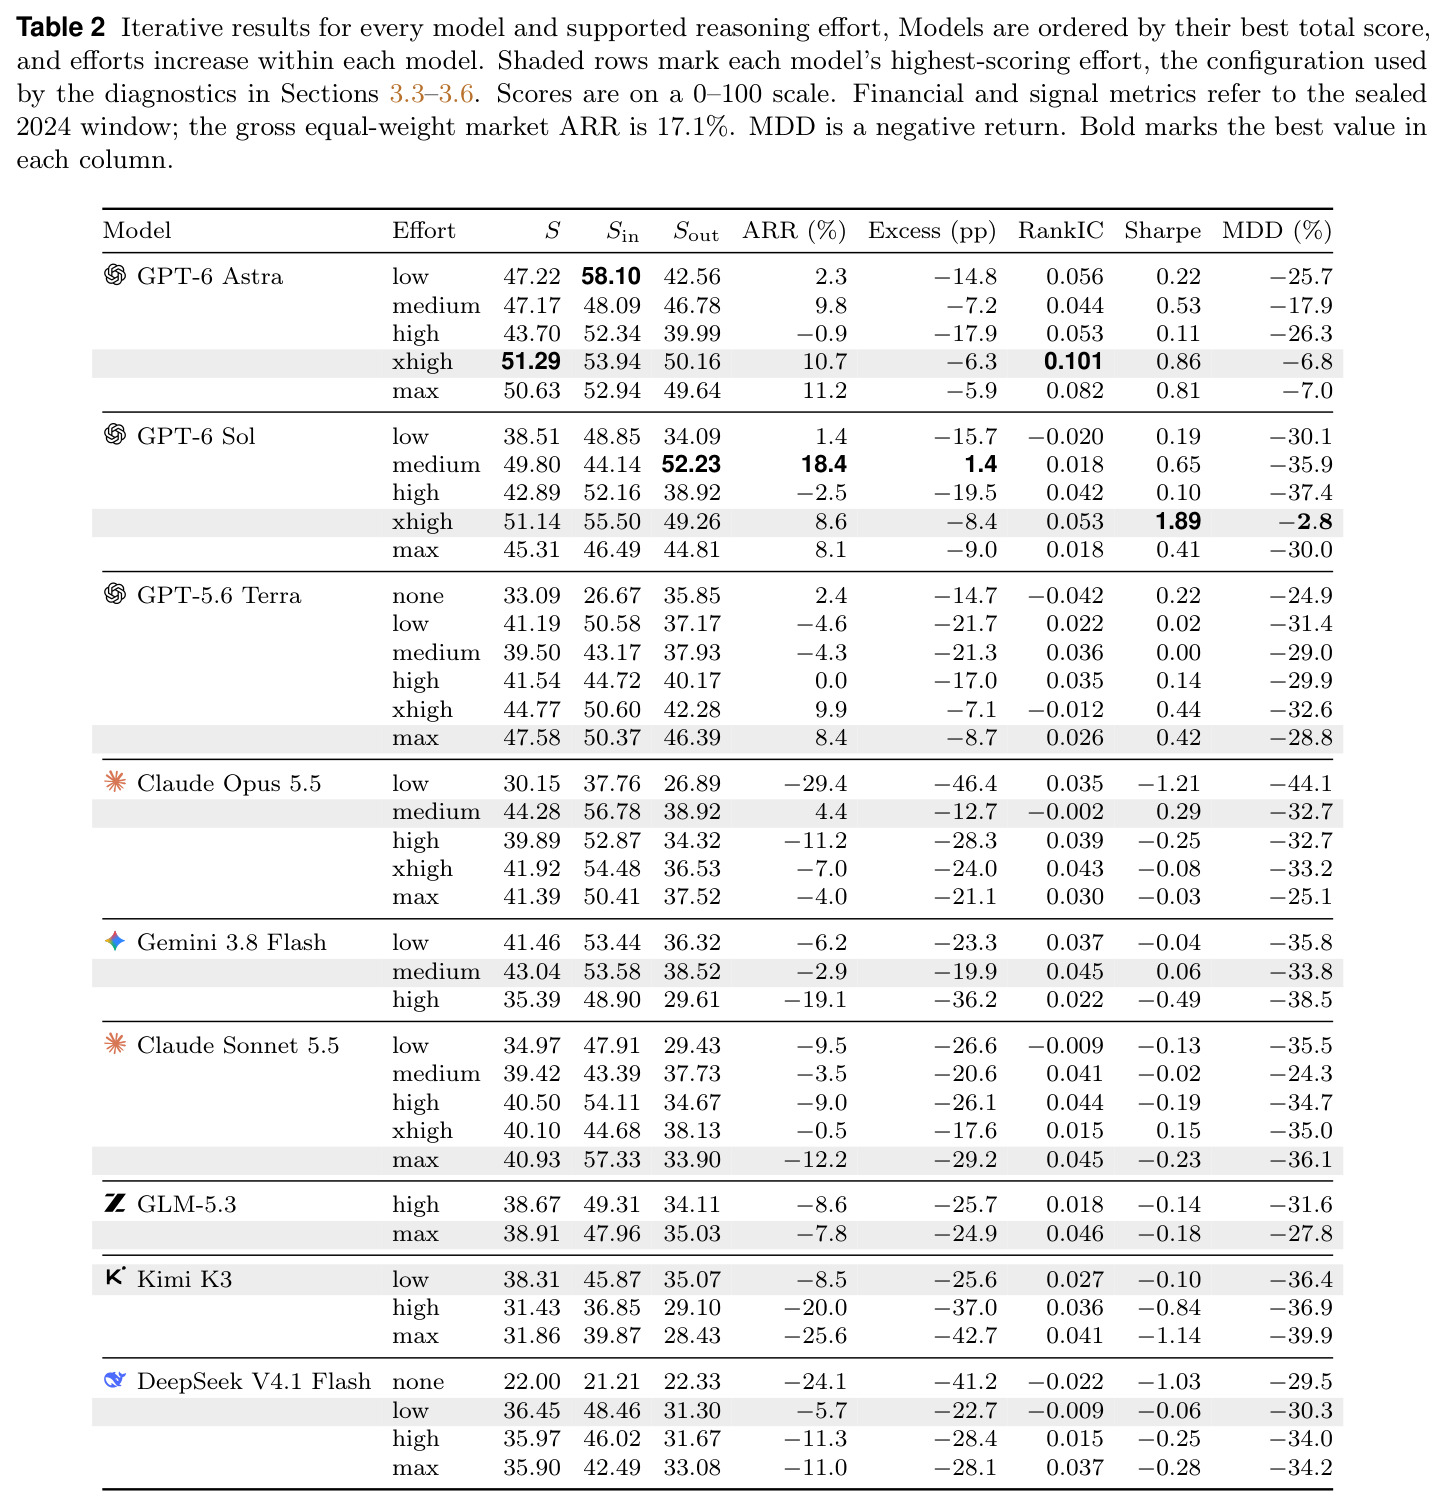
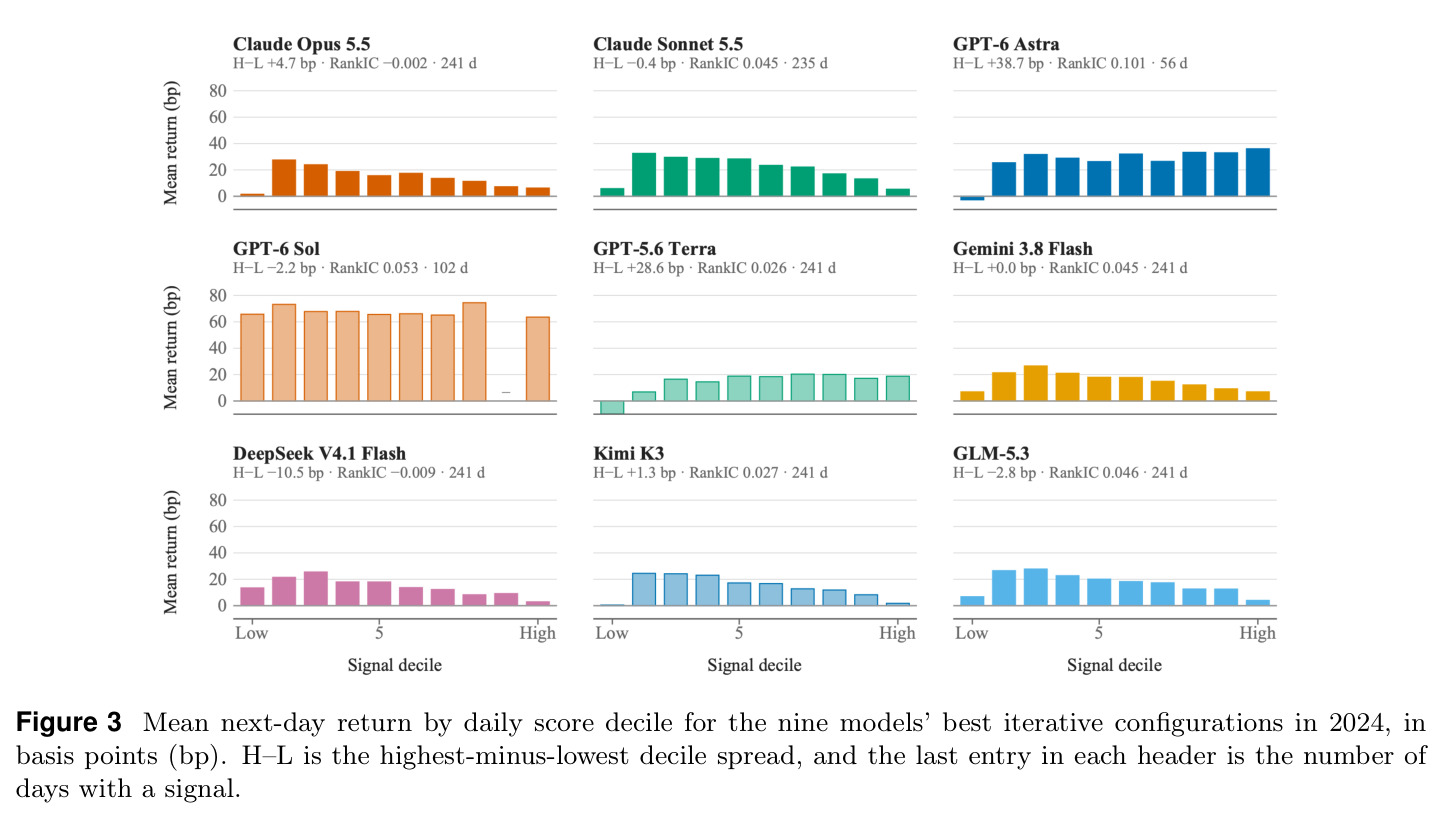
核心创新是把完整研究运行而非公式、代码或单笔决策作为评测单元,并用密封样本外盈亏作为最终裁判。与 AlphaBench 只评因子统计不同,这里 RankIC 0.046 的策略可以年亏 7.8%,RankIC -0.002 的策略反而赚 4.4%,因为组合只买排名前 75 的股票,平均排序技巧不等于头部持仓盈利,这正是端到端评测才能暴露的现象。第二个关键设计是反数据窥探协议:最多 5 次候选回测的有界研究预算、冻结提交、密封的 2024 年评估,配合研究期与评估期完全一致的数据访问规则,把反复回测带来的过拟合空间压到最低,同时记录候选评估轨迹使研究过程本身可分析。第三个特点是成本真实性:市场冲击由模拟订单簿估计,加上手数与订单依赖成本,迫使模型考虑容量与执行,而不是在纸面收益率上空谈,从而把发现信号与兑现盈利两个阶段严格分开评价。
方法步骤详情
流程分五步。第一步输入:模型获得研究目标、数据接口与评估接口文档,数据为固定发布版本的 3042 只 A 股日频行情加原始 Level-2 委托、成交、订单簿快照,保留缺失观测与退市股票。第二步研究(2022 至 2023):模型编写特征构造与打分代码,通过按日期与字段限权的接口取数,最多提交 5 个候选策略回测,反馈仅含聚合收益、信号质量与覆盖度统计、执行错误,模型可自定训练验证切分并迭代修正。第三步冻结:选定唯一策略,源码、执行环境与声明的特征一并封存,特征至多 300 个命名项,按相关性聚类出 K 个有效簇用于多样性计算。第四步密封评估(2024):评估器运行冻结策略生成每日得分,转为 75 只等权多头组合,在现金账户中执行,含 100 股手数、订单依赖成本、模拟订单簿冲击、空仓现金零收益,逐日复利。第五步评分:把年化超额收益 $r$、只做多 Sharpe $\mathrm{SRL}$、多空 Sharpe $\mathrm{SRLS}$、RankIC、信息比率 A、换手率等经 $g_c$ 变换加权得到 $Q$,按 $S_{in}=90Q+10D$ 与未公开规则的 $S_{out}$ 以 3:7 合成总分 $S$。
技术新颖性
与相关工作的具体差异:AlphaQT-Bench 把可执行性、因果安全、功能正确性拆成代码级结果,StockBench 在小股票池上评逐笔决策且只给被动持有参照,AlphaForgeBench 靠大量短任务生成代码,QuantBench 研究传统量化模型的特征与种子,它们都不连接原始数据特征构造、有界研究、冻结策略、密封盈亏的完整链条。本文的技术新颖性体现在四点:第一,从逐笔 Level-2 记录出发的特征构造评测,检验模型对市场事件的理解而非表达式搜索能力;第二,$S_{in}=90Q+10D$ 的评分设计,用 $\min(K,32)/32$ 的多样性项让弱策略无法靠堆砌特征得分,且 $Q$ 中六成权重给已实现超额收益、四个信号项各只占 5%,贴合信号不等于钱的实证事实;第三,密封年评估加未公开的 $S_{out}$ 组合规则,防止针对评分函数反向优化;第四,公开竞技场机制,任何模型或智能体框架可在同一密封协议下提交,形成可持续比较的排行榜。
实验结果
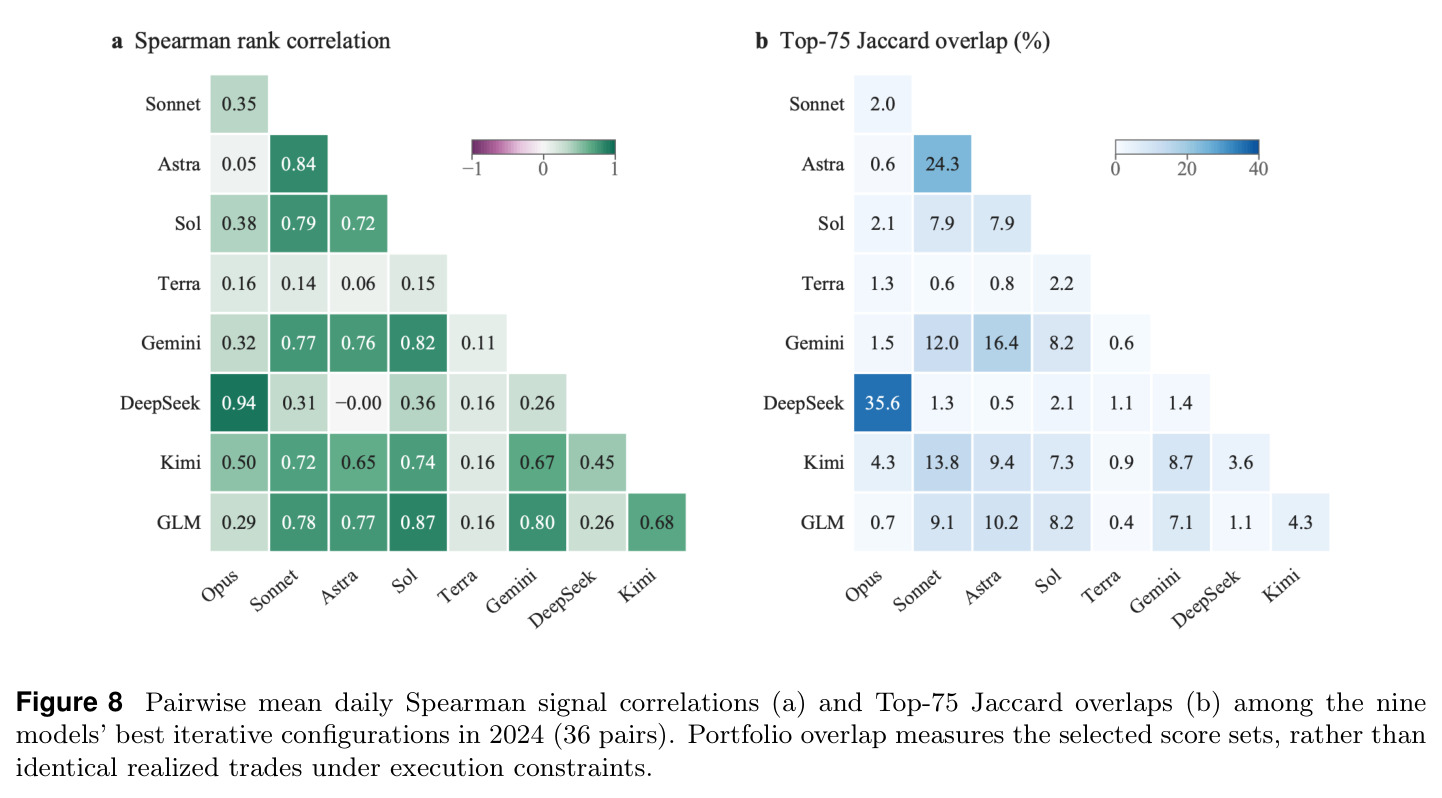
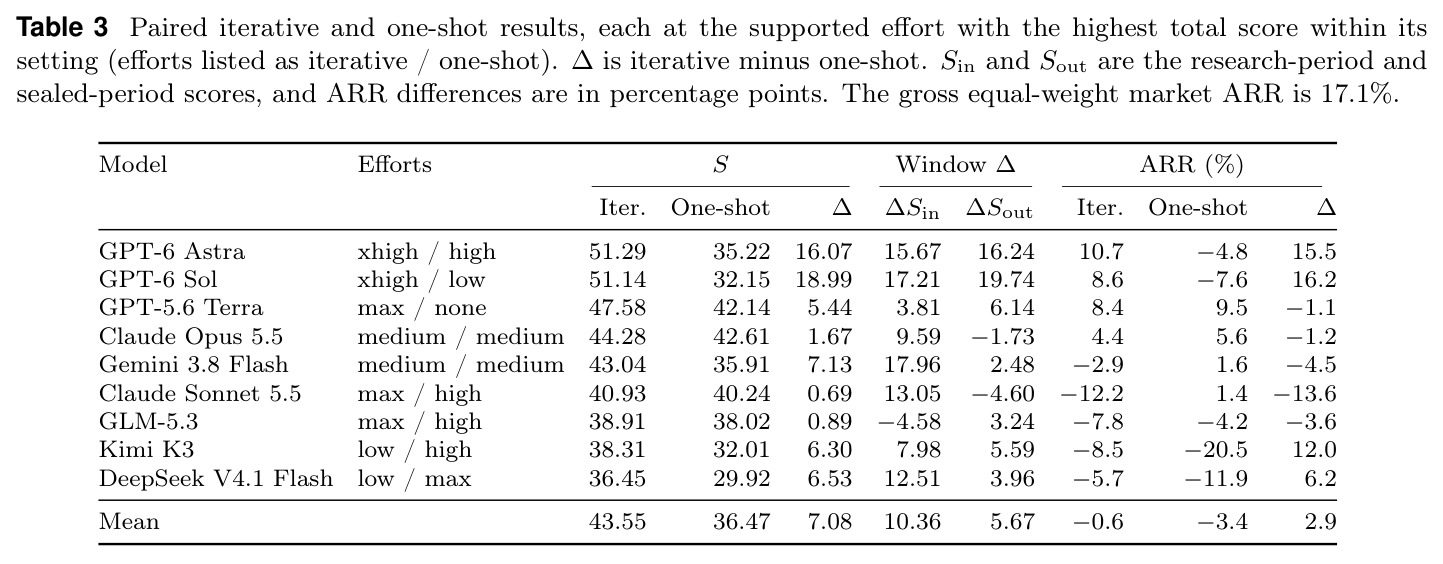
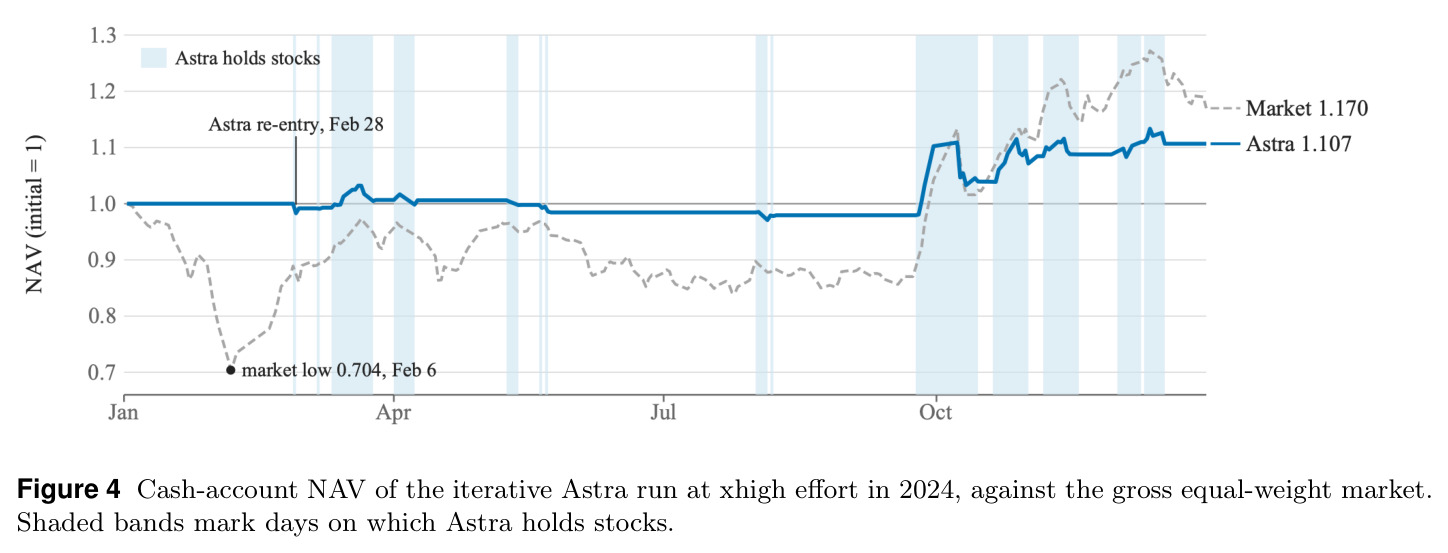
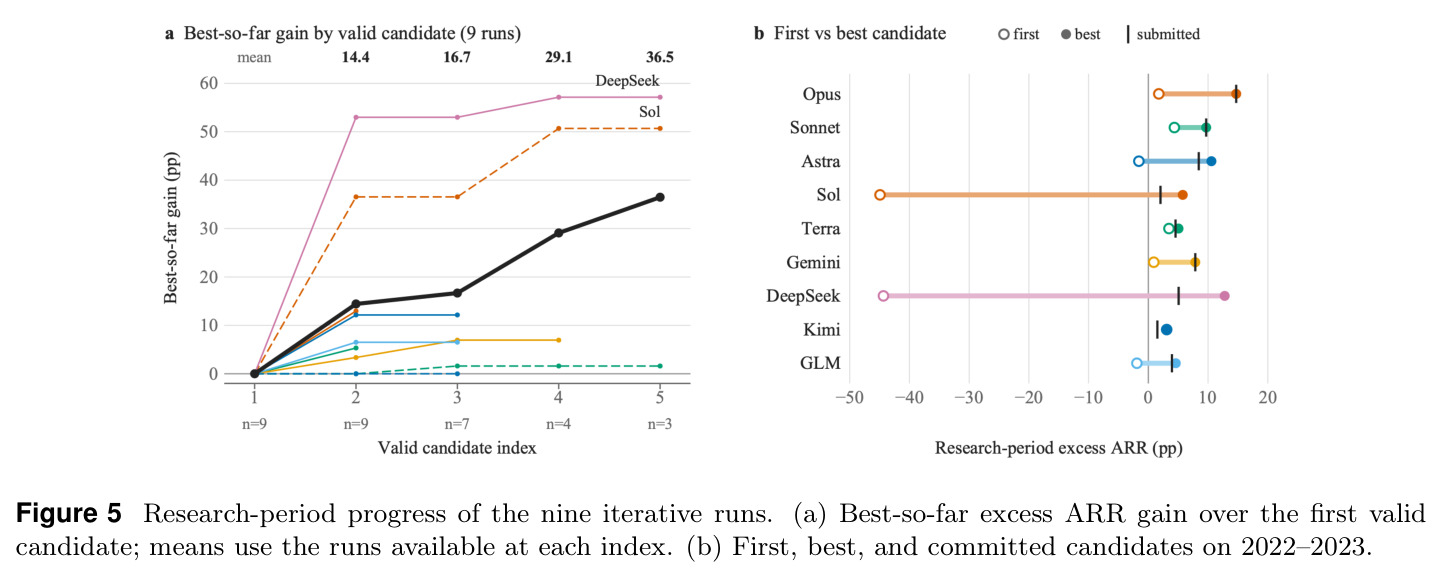
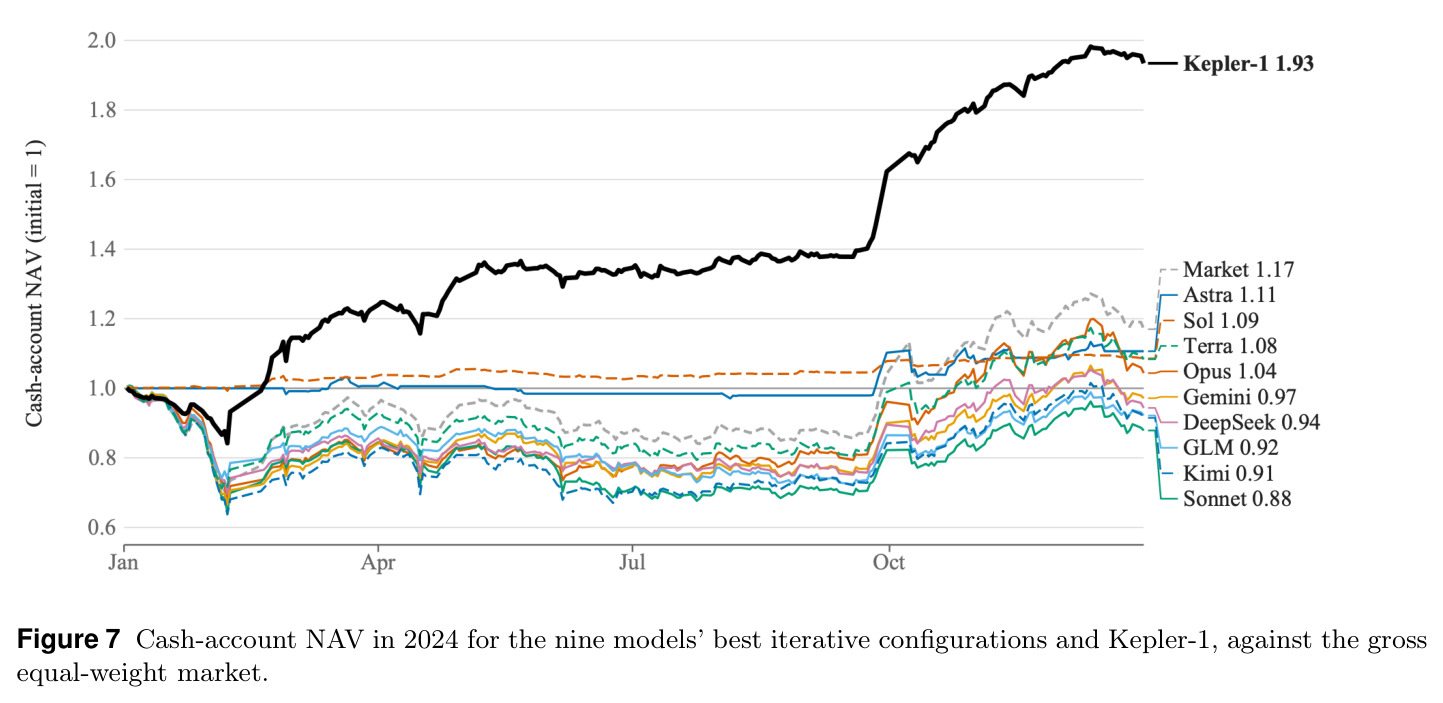
九个前沿模型(Claude Opus 5.5、Claude Sonnet 5.5、GPT-6 Astra、GPT-6 Sol、GPT-5.6 Terra、Gemini 3.8 Flash、DeepSeek V4.1 Flash、Kimi K3、GLM-5.3)共 38 个迭代配置的结论相当残酷:仅 13 个配置 2024 年年化收益为正,唯一跑赢等权市场(17.1%)的是中等推理力度的 GPT-6 Sol(18.4%,超额 +1.4 pp);最佳总分是 Astra xhigh 的 51.29 与 Sol xhigh 的 51.14,而私募策略 Kepler-1 得 77.56,净值 1.93 对市场的 1.17,其 Sharpe 2.98 远超最佳模型的 1.89,尽管 RankIC 0.085 反而低于 Astra 的 0.101。Astra 的领先靠择时而非选股:程序仅当全市场五日与二十日对数收益中位数同时为正时才打分持仓,全年约 75% 交易日空仓,最大回撤仅 -6.8%(其余配置 -17.9% 至 -26.3%),2 月 6 日市场净值触底 0.704 时它恰为 1.000,一二月回撤 -1.7% 对市场的 -29.6%,但代价是只捕捉到 16% 的反弹(Terra 为 73%)。十分位分析揭示脱节原因:六个模型呈驼峰形态,第二或第三十分位日收益最高(24 至 33 bp),最高分位反而回落,H-L 介于 -10.5 到 +4.7 bp;RankIC 与 ARR 在 38 个配置间几乎不相关(Spearman 0.09)。迭代把平均总分从 36.47 提到 43.55(九个模型全部上升,Sol 涨 18.99),但年化收益只有 4/9 模型改善(均值仅 +2.9 pp),研究进展主要来自修复糟糕的首个候选:DeepSeek 和 Sol 从约 -44/-45 pp 起点分别改善 57.1 和 50.7 pp,剔除两者后平均终局增益仅 6.5 pp,九个模型中仅三个提交了自己研究期的最佳候选。风格上 8/9 模型偏小盘、7/9 偏高账面市值比,但风格不能区分赢家输家:Astra(B/M +0.96、波动 -1.05)终值 1.11,Sonnet(+0.54、-0.64)仅 0.88。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 端到端量化研究(密封 2024 年,总分) | 总分 S(0-100) | 最佳 LLM:GPT-6 Astra xhigh 51.29;GPT-6 Sol xhigh 51.14 | 私有策略 Kepler-1:77.56 | Kepler-1 领先最佳模型约 26 分,说明信号到收益的转化能力仍有巨大差距 |
| 2024 年组合盈利能力 | 年化收益 ARR(%)与超额(pp) | GPT-6 Sol medium:ARR 18.4%,超额 +1.4 pp | 费前等权全市场 ARR 17.1% | 38 个迭代配置中唯一跑赢市场的运行;其余 25/38 为负收益 |
| 风险调整后表现(密封 2024) | 只做多 Sharpe(SRL)与最大回撤 MDD | 最佳模型 Sol xhigh:Sharpe 1.89、MDD -2.8%;Astra xhigh:MDD -6.8% | Kepler-1 Sharpe 2.98;等权市场净值 1.17 | Kepler-1 净值 1.93,模型最优仅 1.11(Astra),差距来自转化率而非排序(RankIC 0.085 对 0.101) |
| 迭代研究对比一次性生成 | 平均总分与 ARR 变化 | 迭代 43.55 对一次性 36.47,九个模型总分全部提升(0.69 至 18.99) | 各模型最佳一次性配置均值 36.47 | 平均 +7.08 分,但 ARR 仅 4/9 模型改善、均值 +2.9 pp,且迭代配置在两窗口间掉分更多(12.4 对 7.7) |
局限与改进
作者隐含承认的局限:密封期只有 2024 一个年份(等权市场 +17.1% 的单边上涨年),无一跑赢市场的结论对市场状态依赖很强,换成震荡或熊市年份排名可能重排;$S_{out}$ 的组合规则未公开,虽防过拟合但降低透明度与可审计性;Kepler-1 作为私募策略不披露实现,只能当天花板参照而非可复现基线。我自己的观察有三点:组合规则固定为 75 只等权多头且空仓现金零收益,这天然奖励学会空仓的择时策略(Astra 恰好如此),同时排除了多空、杠杆等合法策略空间,评测信号可能被择时维度稀释;每个配置只跑一次、无重复种子,使得推理力度与得分的关系难以解读(9 个模型中 6 个最佳力度不是最高档,Terra 各档差 14.49 分),无法区分真实差异与策略搜索的高方差;3042 只股票的选定宇宙与固定数据发布意味着容量和执行结论难以外推到全市场实盘环境。
独立分析的弱点
第一,统计功效不足:单个密封年、每配置单次运行,唯一跑赢者 Sol medium 超额只有 +1.4 pp,在年度收益噪声面前不具备显著性;改进方向是滚动多年度密封窗与每配置多次重启报告分布。第二,评分函数可能被反向博弈:$S_{in}$ 公式完全公开而 $S_{out}$ 规则保密,这种不对称虽抑制过拟合,却使排行榜总分对研究期过拟合敏感,迭代配置在两窗口间平均掉 12.4 分(一次性只掉 7.7 分)正是证据;可改为公开规则但只密封数据。第三,等权 75 只的多头约束让空仓择时成为压倒性策略空间,Astra 靠 2 月空仓避开 -29.6% 的下跌即登顶,若所有模型都被引导学择时,选股能力的评测信号会被稀释;建议增设强制满仓对照赛道,把择时与选股分别计分。第四,多样性 $D=\min(K,32)/32$ 依赖对贡献的检测算法与聚类细节,论文未充分描述,可复现性存疑。第五,Astra 全年仅 61 个持仓日,其风格暴露估计与择时结论的样本极小,容易受个别日期主导。
未来方向
作者方向:Quant-Arena 作为公开竞技场接受任意模型与智能体框架提交,后续可系统比较不同 agent harness(工具使用、记忆机制、多智能体协作)在同一密封协议下的研究能力;平台记录的候选评估轨迹可用于训练研究过程奖励模型或过程监督。基于本文成果可延伸的方向:其一,多年度滚动密封窗与多市场(美股、港股、加密货币)扩展,检验结论跨市场状态的稳健性;其二,把 RankIC 与 ARR 几乎不相关(Spearman 0.09)的发现产品化为新的信号评估指标,例如只看前 75 名的头部 RankIC 或十分位 H-L 价差,修正用全截面平均评价头部组合的惯性做法;其三,要求模型显式输出市场状态判断并单独评测择时能力,与选股能力解耦;其四,引入盘中调仓与算法交易执行层,考察容量约束下的真实可部署性;其五,用 Kepler-1 与 38 个配置的轨迹做模仿学习,研究 LLM 能否习得信号到组合的转化能力而非仅是排序能力。
复现评估
基准平台公开(lab.einsia.ai/quant-arena)并接受任意模型或智能体框架提交,评估协议、数据切分(研究 2022 至 2023、密封 2024、3042 只股票宇宙)与评分公式($g_c$、$Q$、$D$、$S_{in}$ 及权重)都在论文中完整给出,协议层面的复现性好。但障碍不小:底层是固定发布的真实 Level-2 逐笔委托、成交与订单簿数据,此类数据采购与存储成本高,外部研究者通常拿不到同版本数据;$S_{out}$ 的组合规则与多样性聚类的贡献检测算法未公开;Kepler-1 是私募策略无法复现;完整重现论文表格需要 9 个商用模型乘以多推理力度的 38 加 38 个配置,API 算力开销可观。对个人研究者的可行路径:用日线或开源 Level-2 子集自建小规模版本复刻协议逻辑,或直接向官方竞技场提交策略参与排名;要完整重现全部实验则需要机构级数据与多模型 API 预算,整体难度中等偏高。
论文图表