EPSBench:面向季度财报盈利预测的LLM智能体基准 EPSBench: Benchmarking LLM Agents for Earnings Forecasting
要求智能体沿利润表逐项引用证据、自底向上预测季度GAAP EPS的智能体基准
前置知识
GAAP 摊薄每股收益(diluted EPS)
美国公司按通用会计准则(GAAP)编制财报,净利润除以摊薄加权平均股数(考虑期权、可转债等潜在稀释)得到摊薄EPS,是公司在利润表里正式报告的数字。它与公司自主调整、剔除一次性项目的非GAAP(adjusted)EPS不同:GAAP口径统一、包含减值与一次性损益、可从申报文件逐项验证。
本文唯一的预测目标和评分真值就是GAAP摊薄EPS。电话会与新闻中大量引用的是非GAAP数字,智能体必须区分口径,否则会把调整后数字当作要预测的量。
利润表驱动因子与会计恒等式 DAG
把利润表表示成有向无环图:叶子是收入、成本率、费用、税、股本等基础科目(由驱动因子设定),中间节点按恒等式逐层组合,如 $\text{EPS}=\text{净利润}/\text{摊薄股数}$。行业科目差异大,schema须按公司定制。
这是EPSBench任务结构的核心:智能体只预测驱动因子,算术交给共享计算器执行DAG,误差因此可以逐科目归因,这是全文所有分析的基础。
价格平减误差(PDE)
$\mathrm{PDE}=|\hat{y}-y|/P$:$\hat{y}$ 为预测EPS,$y$ 为报告EPS,$P$ 为公告前最后一日收盘价。按股价平减避免EPS近零时百分比误差爆炸(如波音共识为−$0.31),是分析师预测研究的惯用做法。
论文所有误差数字(如0.113%、配对差−0.002pp)都以PDE计,理解这个定义是读懂全部结果表格与统计检验的前提。
预测区间、覆盖率与 proper scoring rule
智能体给出80%区间 $[p10,p90]$,覆盖率即落入比例(名义80%)。区间得分 $\mathrm{IS}=(u-l)+\frac{2}{\alpha}[(l-y)_+ +(y-u)_+]$,$\alpha=0.2$,为proper scoring rule:谎报分位数不会改善期望得分。
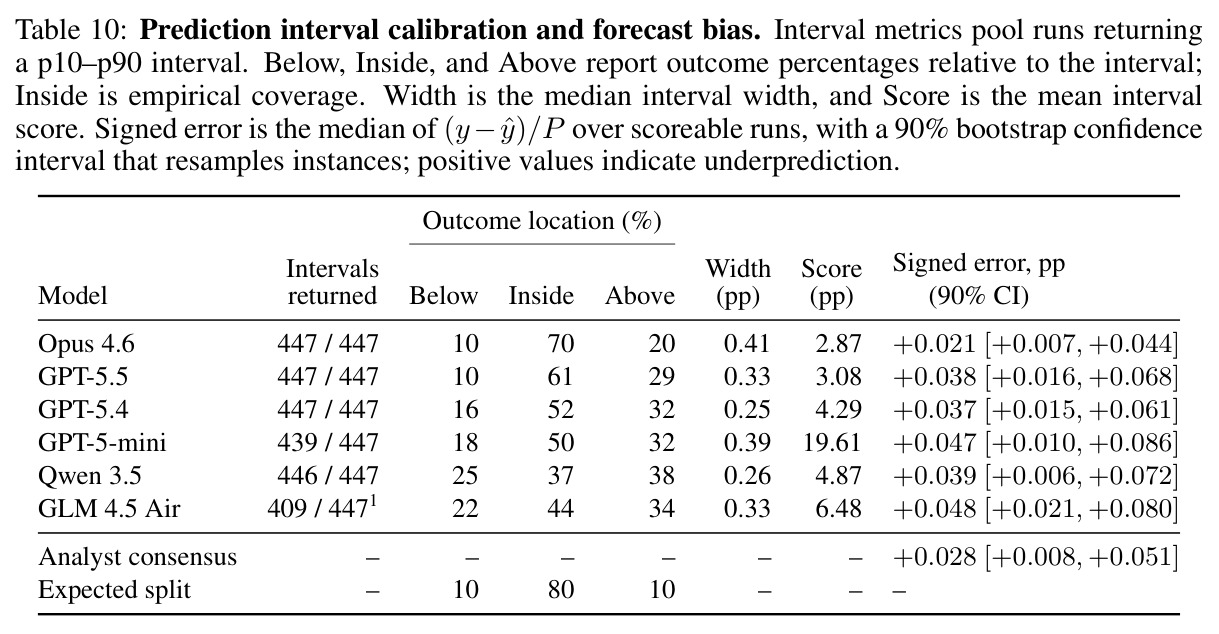
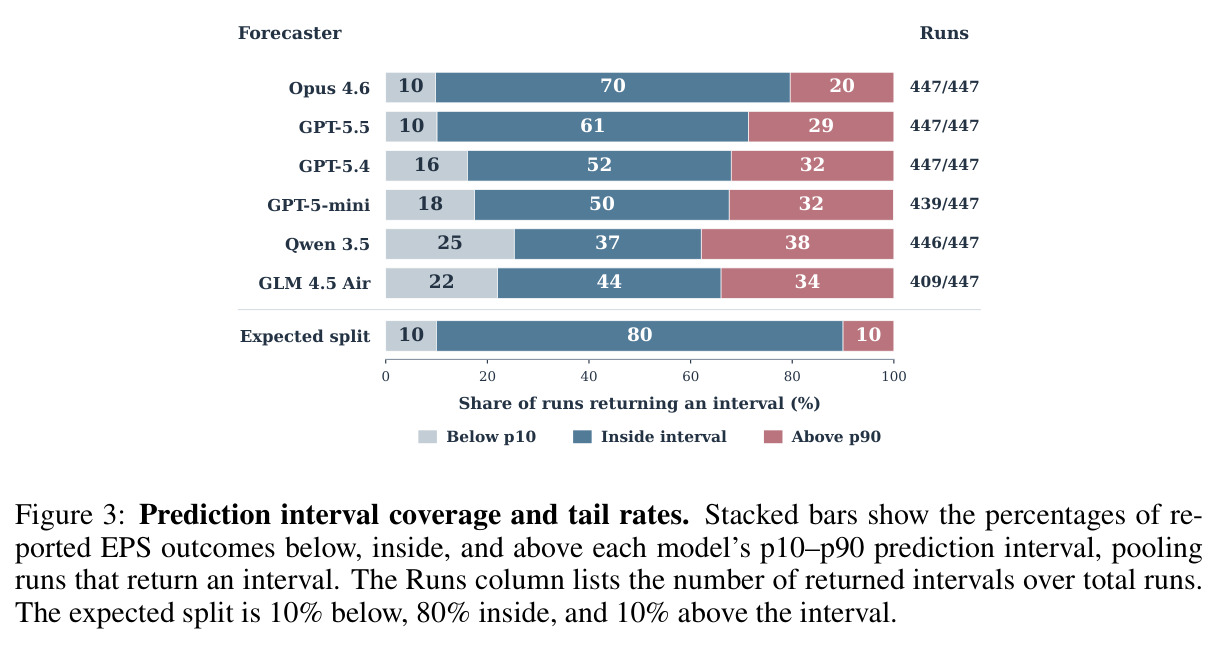
论文关于校准的核心发现——名义80%区间实际只覆盖37–70%且miss偏向上方——完全建立在这套区间评估体系上。
信息截止(point-in-time)评估与记忆污染
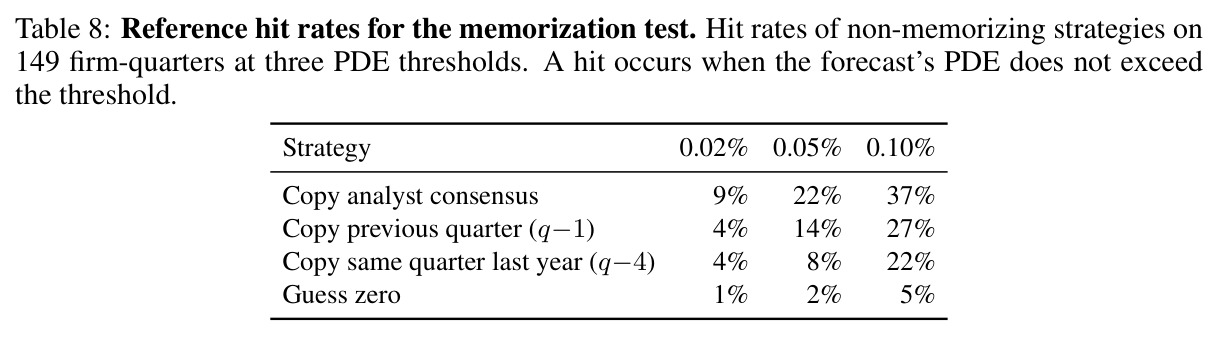
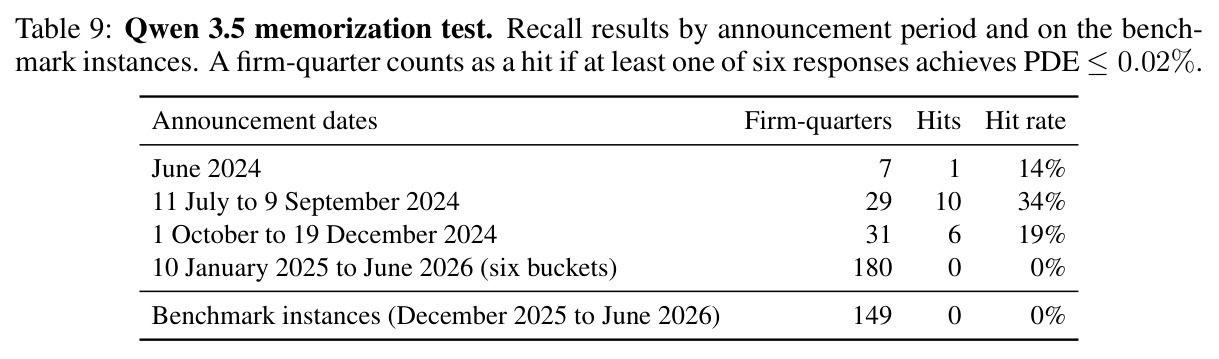
回溯式基准的效度威胁是前瞻偏差:模型训练时见过答案或检索到事后更新的网页。EPSBench在工具层硬性截断——所有证据限制在公告前一日 $\tau$ 前,缺日期文章拒收;对截止未公开的模型做记忆探针:无工具直接问历史EPS,以'抄共识'等无记忆策略命中率作对照。
不理解这套效度设计,就无法判断benchmark分数反映的是真实预测能力还是数据泄漏,这是评估此类论文可信度的关键。
IBES 分析师共识
IBES汇总卖方分析师对季度EPS的估计,均值即'共识',是华尔街的基准预期,'超预期/不及预期'皆以其为参照。本文取截止日 $\tau$ 当天的GAAP共识作日期匹配的专业参照,并注明该比较未控制双方信息可得性。
所有'胜率'与'惊喜方向准确率'都相对于该共识定义,它是判断模型是否达到专业分析师水准的标尺。
研究动机
现有预测类基准与财报预测研究存在三个断层。第一,很多基准只要方向或概率:ForecastBench让模型对未决事件输出概率并与人类超级预测员比较,FinCall-Surprise等只预测盈余方向或'惊喜',都不要求给出量级——而财报决策恰恰需要知道'变动多大'。第二,直接预测EPS数值的基准(FutureX、FinDeepForecast)只看最终数字,模型怎么算出来的全凭自由发挥,误差无法归因:你不知道错在收入估计、成本假设还是税项,也无法比较不同模型的定量假设。第三,回溯式评估有泄漏风险:LLM可能背过财报结果或检索到事后更新的网页(Lopez-Lira等记录的'记忆问题'),且此前几乎没有把LLM点预测与日期匹配的分析师共识做受控配对比较的工作。
本文的目标是构建一个以利润表为骨架的季度财报预测基准:让智能体在与分析师相同的信息约束下(公告前一日为止的10-K/10-Q财报、上季度电话会实录与新闻),对每家公司自底向上估计收入增速、成本率变化、费用、税与股本等驱动因子,逐条引用证据;把算术交给统一的会计计算器按公司特定DAG执行,得到GAAP摊薄EPS点预测,并同时报告80%预测区间。在此共同表示下回答三个问题:哪些模型的点预测误差与IBES共识无可检测差异?模型间差距出现在利润表哪一段、什么类型的季度?模型自己报告的不确定性是否可信、成本几何?
与已有工作不同的是,独特切入是'把评分钉在科目上'。因为算术由固定的会计DAG完成,每个EPS分数都连同其驱动因子取值与证据引用一起留档,误差可以逐层分解到营业收入、非经常项目、税与股本,甚至像波音案例那样追到单一处置收益驱动因子——这不同于只看终值的基准。相比只测方向的基准,它要求量级和证据。方法上,作者用日期匹配的共识做配对比较(实例级配对+10000次bootstrap的90%置信区间)消除实例难度差异;用MCP服务端在索引分片与单篇文章两级强制时间截断,配记忆探针应对泄漏;用proper interval得分与token成本一起堵住'调宽区间或烧算力刷分'的捷径。评估效度设计与任务表示是本文区别于ForecastBench、FinQA、FinanceHarness的核心。
核心方法
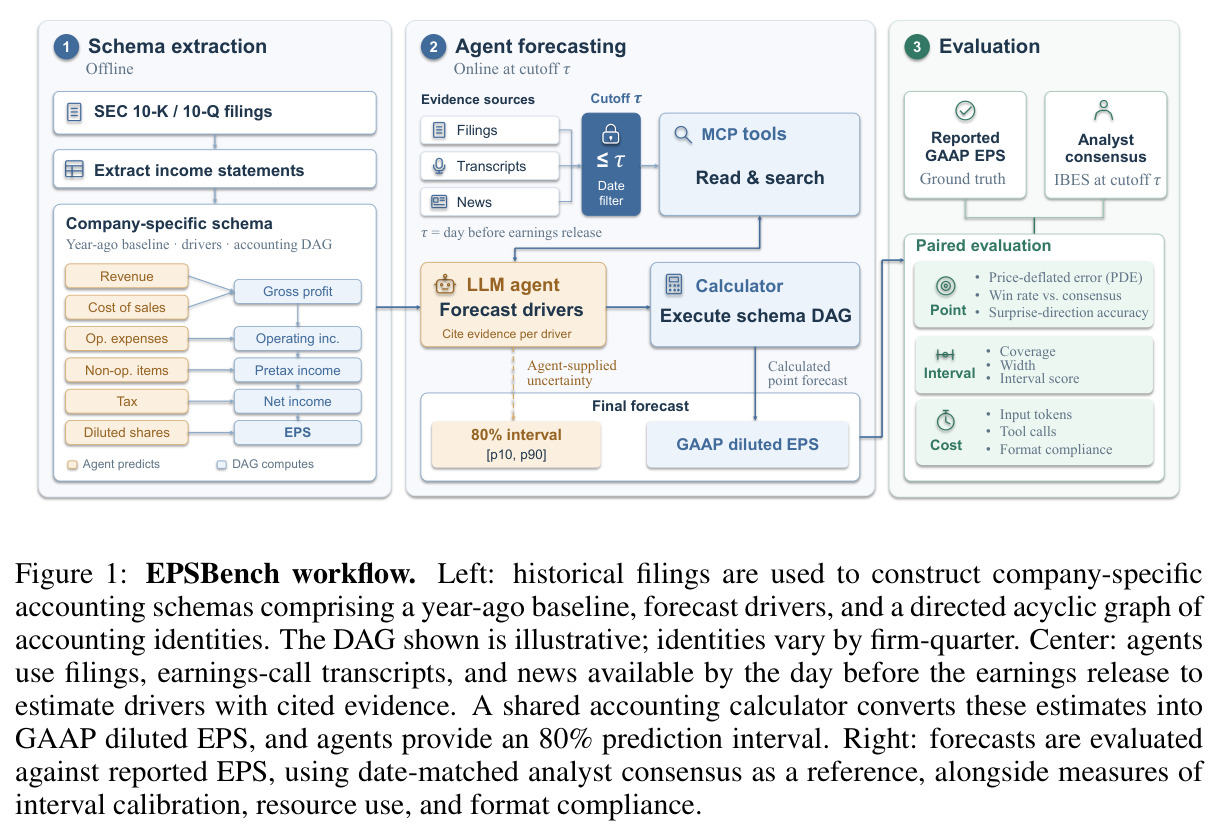
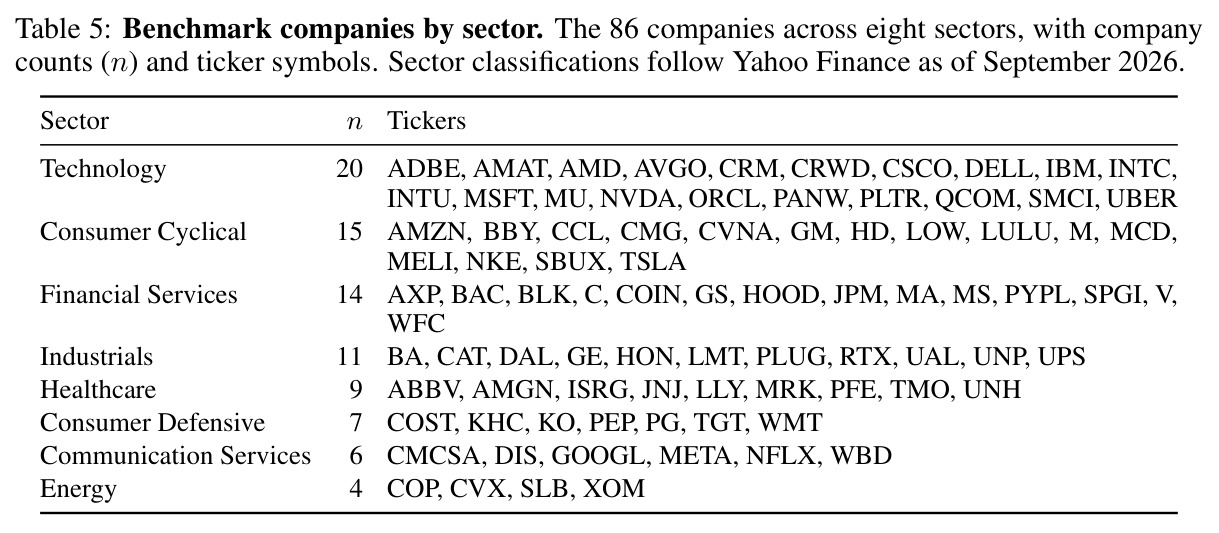
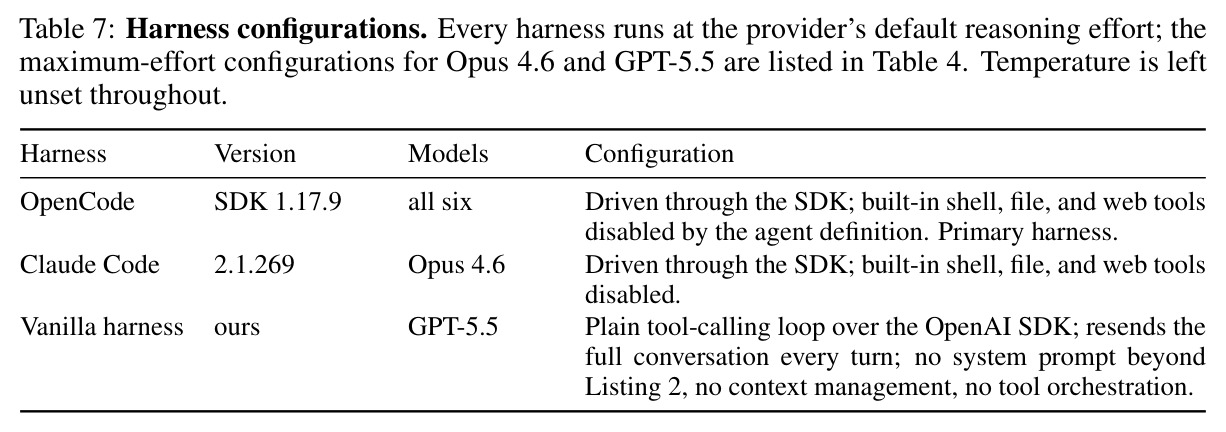
EPSBench含86家美国大公司(中位市值$212B,85/86超$100亿)的149个公司-季度实例,公告日跨2025-12-02至2026-06-24,覆盖八个行业。流程三步(Figure 1)。离线:从SEC 10-K/10-Q提取利润表,为每个公司-季度构建schema——去年同期基线、驱动因子列表、会计恒等式DAG,并在基线上重放DAG验证能否复现当年报告EPS。在线:信息截止 $\tau=\text{公告日}-1$ 天,智能体经6个MCP工具访问财报、电话会实录(Seeking Alpha)与新闻(CC-News经FineWeb式七级过滤、Qwen3-Embedding-8B嵌入、516个按日FAISS分片,每查询返回10篇),估计驱动因子并逐条引用证据,调用共享会计计算器执行DAG得EPS点预测,再补报 $[p10,p90]$ 区间。评估:对照公司报告EPS与IBES共识打分。每配置每实例独立跑3次共447次运行;点预测先取实例内中位数PDE再取跨149实例中位数;配对比较在实例上配对取差,bootstrap重采样实例10000次给出90%置信区间。
核心创新是'分析师式分解 + 共享计算器'。已有基准直接要EPS终值,模型可在思维链里自由心算、无法审计;EPSBench把任务改写为预测一组公司特定的相对量,驱动因子取四种形式之一:同比增长率 $V_q=V_{q-4}(1+g)$(收入、研发等规模科目);相对锚定科目(通常是收入)的基点变化 $V_q=A_q\frac{V_{q-4}}{A_{q-4}}+\delta/10000$(随收入缩放的成本项,$\delta=-20$ 即成本率降0.20个百分点);绝对值(利息、其他支出、税额、股本);以及有效税率覆盖。所有算术由计算器按拓扑序执行DAG完成,系统提示明令禁止直接预测总收入或EPS、禁止手动计算、禁止遇到共识后反推各因子(每字段强制'证据→取值'块)。这样每个预测的每个中间科目都可复现、可归因,分数与假设一一绑定,且会计错误的干扰被彻底排除。
方法步骤详情
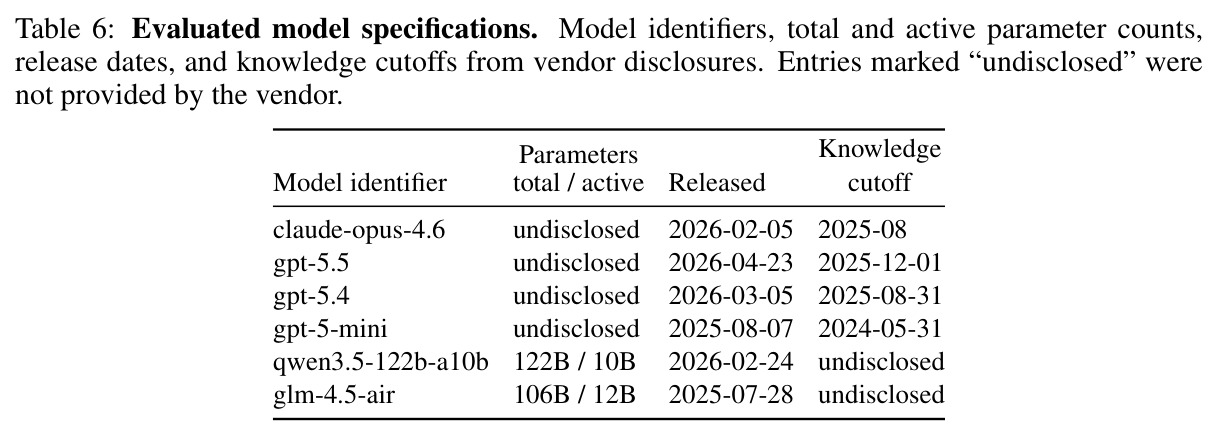
第一步(离线schema构建):o4-mini从10-K/10-Q提取利润表;deepseek-reasoner读取目标季度前四期报表($q-1$至$q-4$)生成基线叶子、公式DAG与驱动因子;GPT-5.4提取税与股本历史参考(最近季/TTM/去年同期的中位数为默认)。验证:把去年同期叶子代入DAG,146/149复现报告EPS误差在一美分内,其余三个在四美分内。第二步(在线预测):提示词给出基线数据、必读材料($q-1$电话会与$q-1$、$q-4$财报)及字段清单;智能体读文档、做新闻检索,每字段写一行'证据→取值'后调用financial_calculate,保持返回EPS为点预测,输出含eps_interval的JSON;单次运行无重试,不可解析记格式失败。第三步(评估):主指标 $\mathrm{PDE}=|\hat{y}-y|/P$;胜率=PDE低于共识的实例占比;惊喜方向准确率;区间按覆盖率、双侧尾部率、宽度与 $\mathrm{IS}=(u-l)+\frac{2}{\alpha}[(l-y)_+ +(y-u)_+]$($\alpha=0.2$)评估。
技术新颖性
新颖性在四层。任务表示层:多阶段LLM流水线为公司定制利润表schema,并用'基线上重放DAG能否复现报告EPS'自动验证——把异质财报格式统一成可执行、可验证的任务规范,先前财报基准没有这种可审计的中间表示。评估层:点与区间联合评估,区间用proper scoring rule防谎报;配对bootstrap移除远大于模型差异的实例难度方差;点、区间、成本、合规四维并列防单一指标刷分。效度层:日期过滤在新闻索引分片与单篇文章两级执行、缺日期即拒收;对截止未公开的Qwen 3.5设计带无记忆对照(抄共识命中率9%)的探针,2024年公告能召回14–34%而149个基准实例零命中。分析层:用DAG中间节点做会计阶段误差分解,用'逐个重置驱动因子、看EPS变化最大'自动定位最大调整因子,再把模型差距与'是否引用具体数字'的行为相连。相比ForecastBench(事件概率)、FinQA(给定文档推理)与FinanceHarness(研报评分),本文首次把数值预测、工具使用与可归因推理链整合进同一个有真值可查的任务。
实验结果
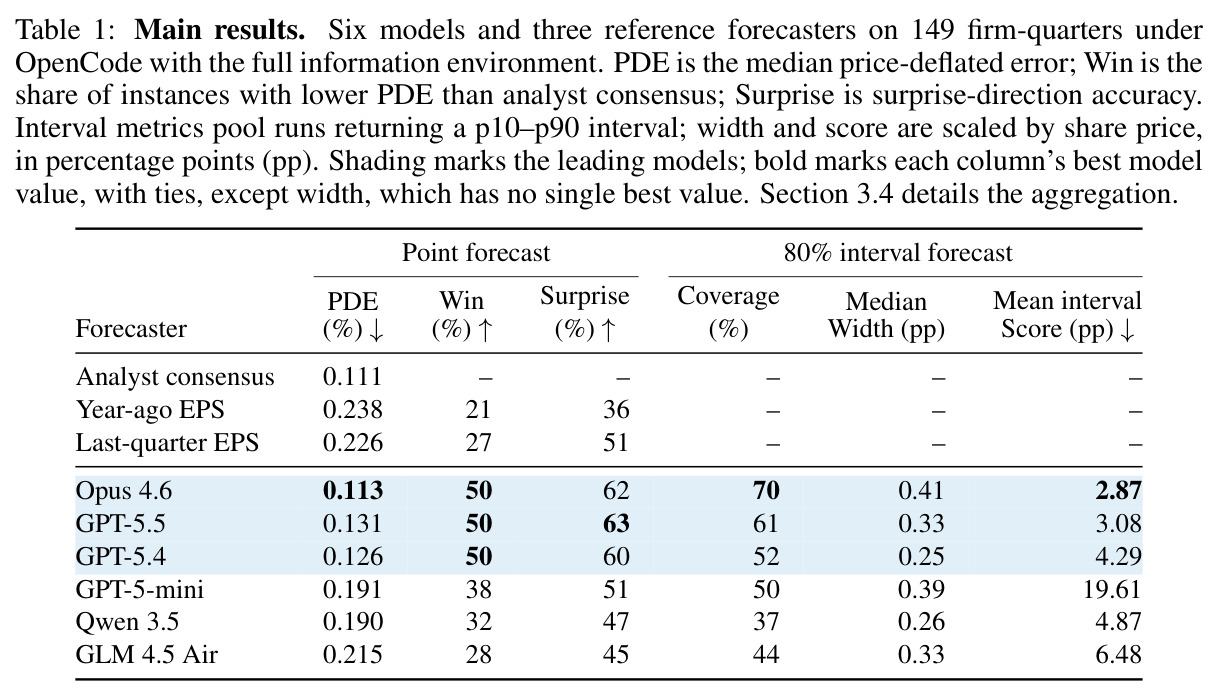
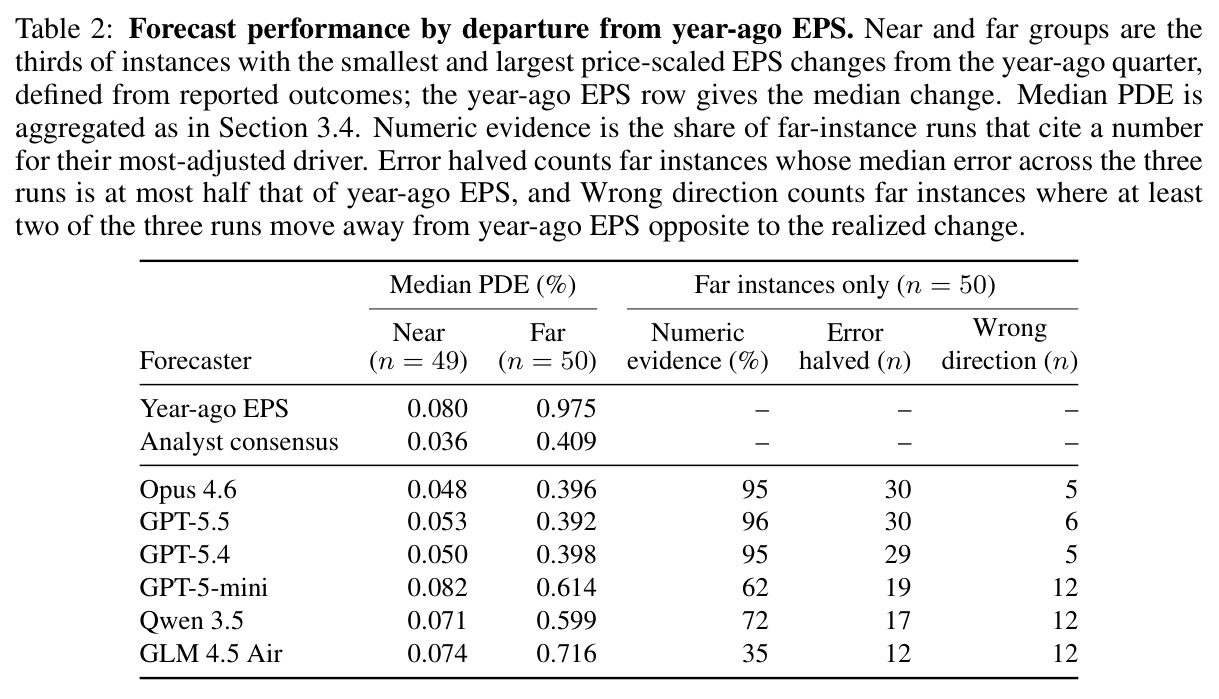
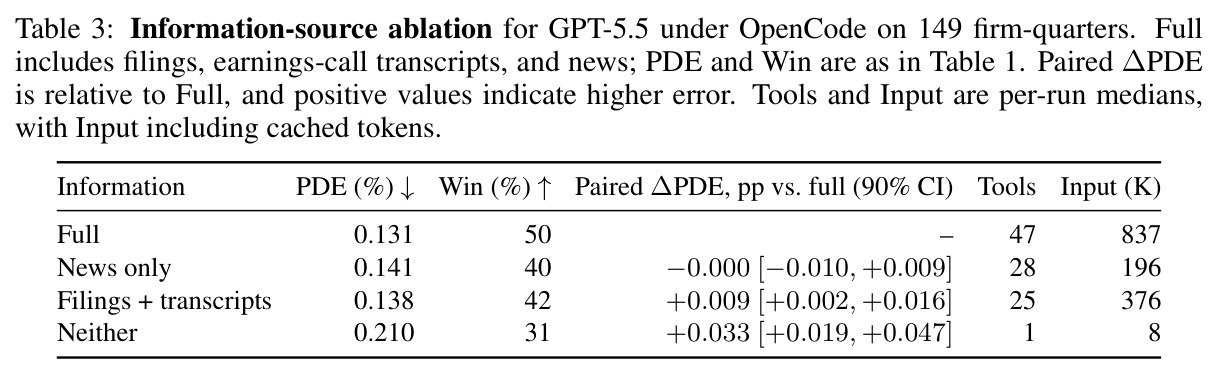
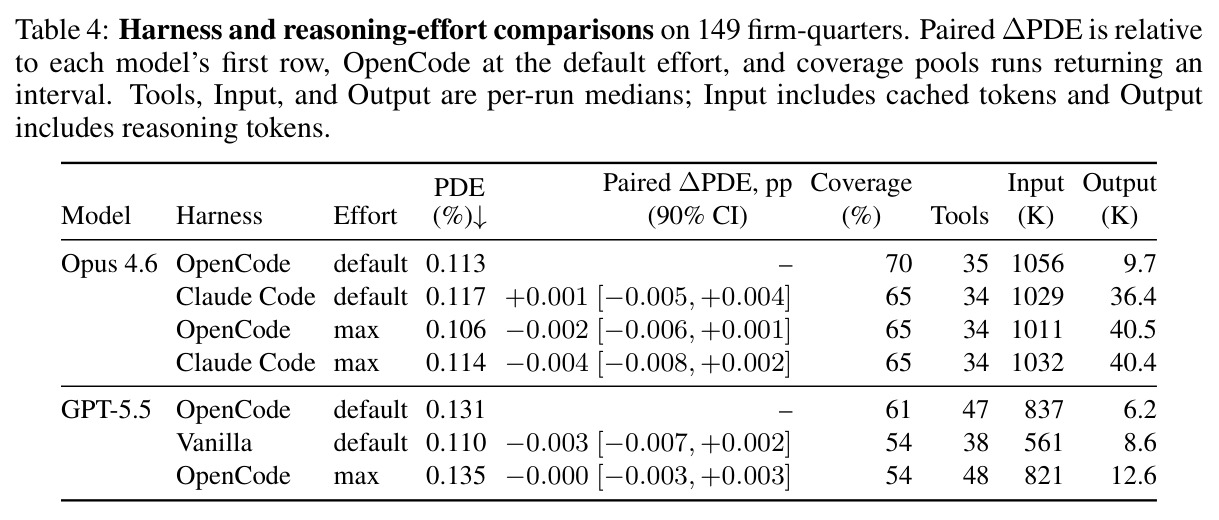
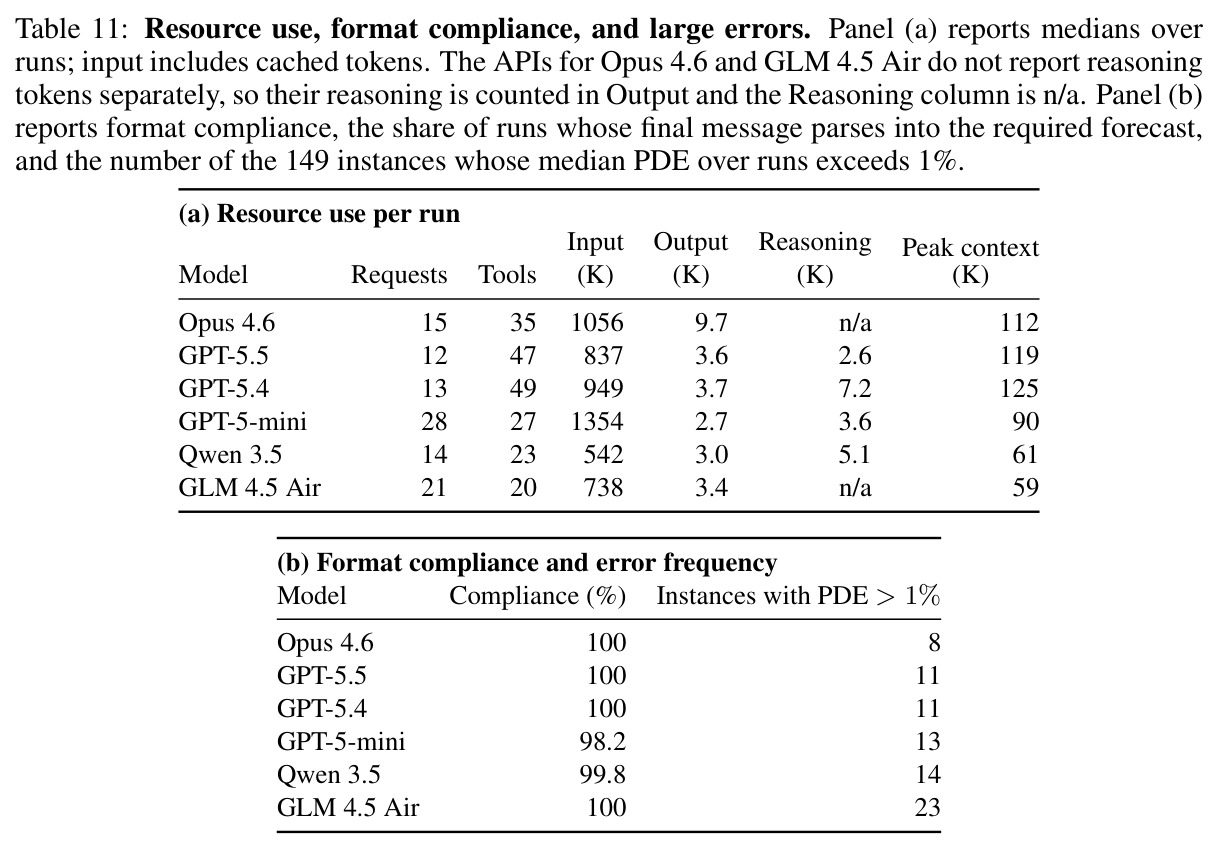
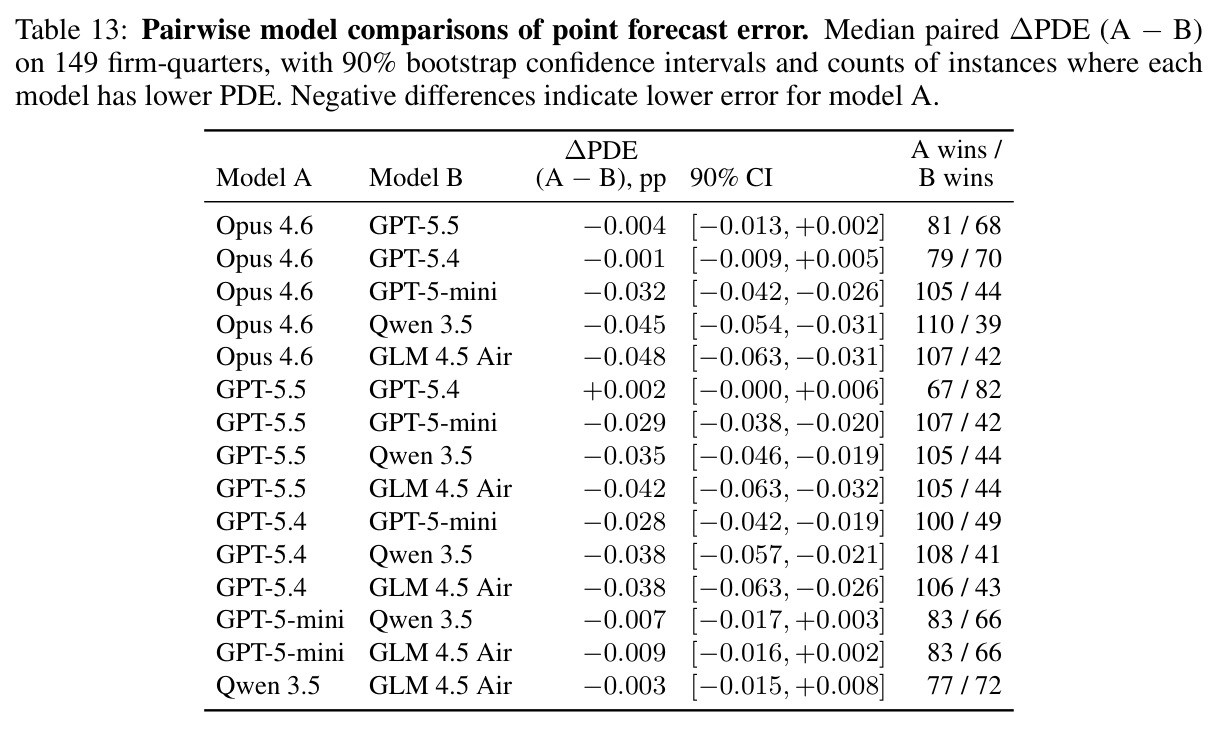
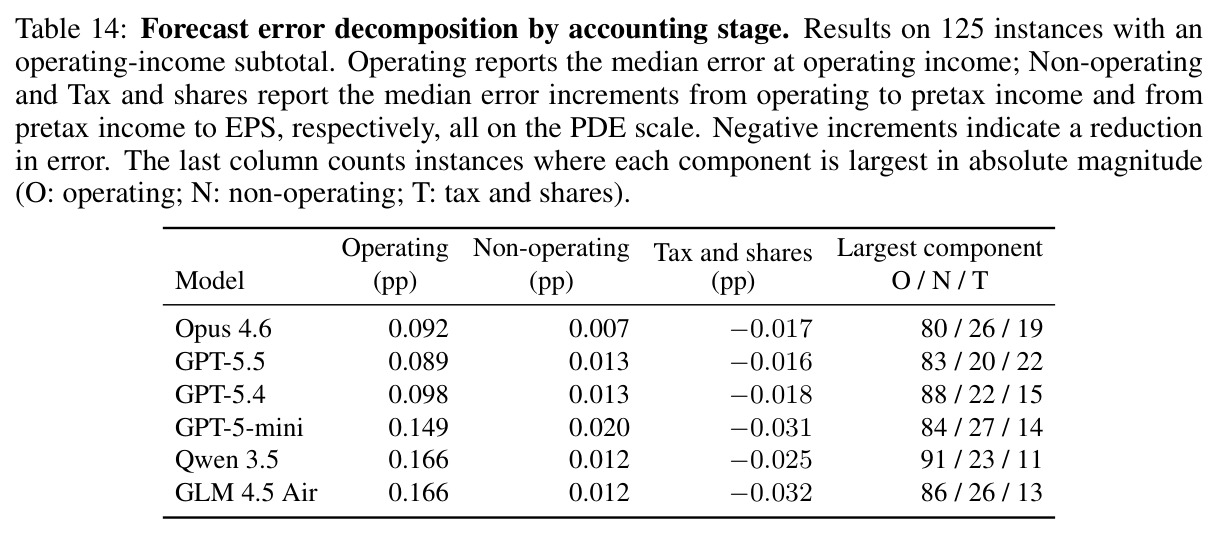
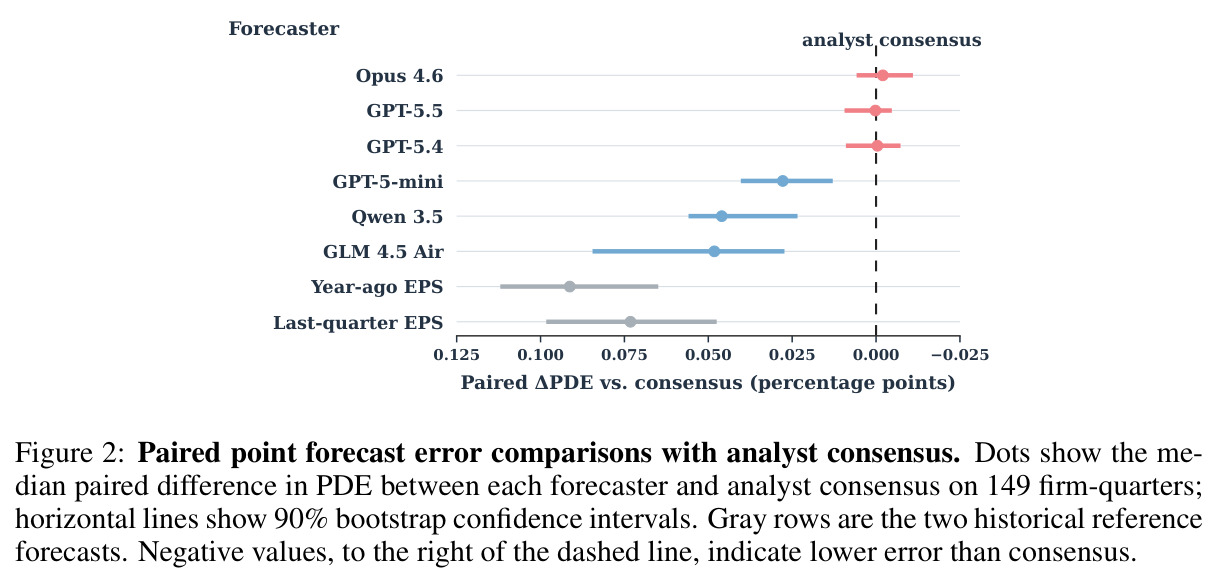
主实验(Table 1、Fig 2):领先组Opus 4.6/GPT-5.5/GPT-5.4的PDE为0.113%/0.131%/0.126%,与共识0.111%无配对差异(CI含零)、各胜50%实例;落后组GPT-5-mini/Qwen 3.5/GLM 4.5 Air为0.190–0.215%、胜率28–38%,显著劣于共识。区间(Fig 3、Table 10):名义80%区间实际覆盖37–70%全不达标,miss偏上(20–38%对10–25%),因符号误差全为正(+0.021~+0.048pp),预测系统性偏低,共识亦偏低(+0.028pp)。差距来源(Table 2、14):50个far实例上领先组0.392–0.398%追平共识0.409%,落后组0.599–0.716%;领先组95–96%运行引用数字证据;差距几乎全在营业利润环节(0.089–0.098对0.149–0.166pp)。消融(Table 3):GPT-5.5仅留新闻误差不变且输入降75%,皆去+0.033pp、胜率50%→31%。记忆测试(Table 9):Qwen 3.5在149实例零命中。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 季度GAAP EPS点预测(149个公司-季度,OpenCode完整信息环境) | PDE中位数(价格平减误差,越低越好) | Opus 4.6 0.113%(领先组0.113–0.131%) | IBES分析师共识 0.111% | 配对差−0.002pp [−0.011,+0.006],统计上与共识无可检测差异;胜率50%;惊喜方向准确率62% |
| 季度GAAP EPS点预测(落后组模型) | PDE中位数 | GPT-5-mini 0.191% / Qwen 3.5 0.190% / GLM 4.5 Air 0.215% | IBES共识 0.111% | 落后0.079–0.104pp,全部配对差异显著为正(劣于共识),胜率仅28–38%,惊喜方向45–51% |
| 相对朴素历史外推的点预测 | PDE中位数 | 六模型 0.113–0.215% | 去年同期EPS 0.238% / 上季度EPS 0.226% | 全部六模型显著优于朴素外推(去年同期EPS胜率仅21%) |
| 80%预测区间校准(447次运行池化) | 经验覆盖率 | 37–70%(Opus 4.6 70%最高,Qwen 3.5 37%最低) | 名义覆盖率 80% | 全部未达标(差10–43pp);超上限miss 20–38%远超名义10%,源于系统性低估 |
| 远离去年同期EPS的far实例(n=50) | PDE中位数 | 领先组0.392–0.398%,误差减半实例29–30/50,数值证据引用率95–96% | 共识0.409%;落后组0.599–0.716%(误差减半12–19,引用率35–72%);去年同期EPS 0.975% | 领先组在大幅变动季度追平共识,落后组差距在此被放大近一倍 |
| 信息源消融(GPT-5.5,149实例×3次) | 配对ΔPDE vs 完整环境(90% CI) | 仅新闻−0.000pp [−0.010,+0.009];仅财报+电话会+0.009pp [+0.002,+0.016];两者皆去+0.033pp [+0.019,+0.047] | 完整环境PDE 0.131%、胜率50% | 新闻与财报/电话会信息大幅冗余(仅新闻时输入降至1/4误差不变);皆去后胜率跌至31% |
| harness与推理强度敏感性(Opus 4.6×4配置、GPT-5.5×3配置) | 配对ΔPDE(90% CI) | −0.004至+0.001pp,五个置信区间均含零 | 各自OpenCode默认推理档 | 点误差几乎不变,但Opus 4.6输出token从9.7K增至40.5K(4.2倍),覆盖率在54–70%间波动 |
局限与改进
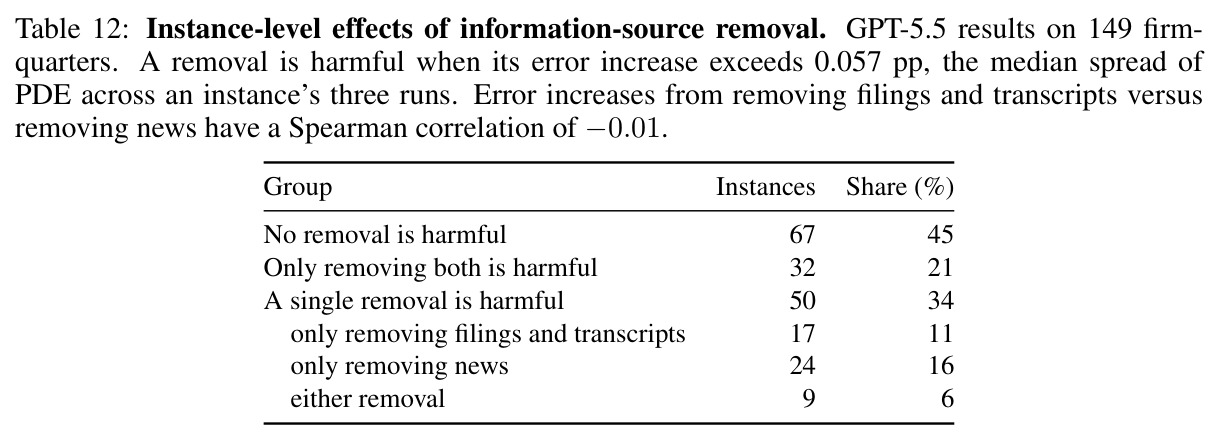
作者承认的:样本仅149实例,CI较宽,'区间含零不证明等价';与共识比较未控制信息可得性——分析师有基准外信息,智能体也可能在新闻遇到共识(提示禁止反推但无法强制);只评GAAP摊薄EPS;新闻有效日期是保守近似,历史可用性无法完美重建;schema由已停服的deepseek-reasoner生成,扩展新季度需换抽取器;仅美国大市值公司。我的观察:一、固定schema限制表达力——提示禁止对schema外一次性项目手动加减,若非常规损益无DAG节点则智能体无法正确表达,部分误差或为schema覆盖而非能力问题(24个实例无营业利润小计可分解);二、PDE按股价平减隐含'误差随股价缩放'假设,对高低价股惩罚不同,影响跨公司聚合;三、区间得分取均值被离群运行主导(GPT-5-mini均值19.61对其他2.87–6.48),单数字掩盖分布;四、每实例3次运行的中位数仍受随机性影响(实例内PDE极差中位数0.057pp);五、提示词高度规范化,既可能压缩harness差异,也使结论依赖特定提示词;六、记忆测试只测Qwen 3.5,同样不披露截止的GLM 4.5 Air未测。
独立分析的弱点
弱点一:能力诊断粗糙——虽定位到营业利润与far实例,但驱动因子级归因仅波音一例,缺'哪类事件(处置、减值、重组费、汇率、一次性税项)最易漏估'的统计;应对全部149×6×3条轨迹做事件类型标注并量化贡献。弱点二:区间靠模型口头报告p10/p90,无校准机制,37–70%覆盖率与系统性低估是LLM普遍短板;可提供历史surprise分布、用conformal校准,或让模型给驱动因子区间再由DAG传播。弱点三:共识污染不可控——新闻含earnings preview,模型可能隐性锚定,应建过滤预览文章的对照条件。弱点四:记忆测试未覆盖同样不披露截止的GLM 4.5 Air,闭源训练数据不可审计的风险悬置。弱点五:任务单次成型无重试,与分析师'草案—修正'流程不符,格式失败直接计损;可引入带预算的多轮自修订。弱点六:行业不均衡(金融14、能源4),银行类净利息收入模式与其他行业schema形态差异大,小行业结论外推性弱,行业间可比性未单独报告。
未来方向
作者提出的:用新抽取模型把基准滚动扩展到未来季度(deepseek-reasoner已停服);发布物支持他人复现与扩展。可延伸:一、区间校准——让模型为每个驱动因子给分位数,经蒙特卡洛或区间算术由DAG传播得EPS区间,或可同修覆盖率不足与系统性低估两症。二、与可回放环境(Forecast-Dojo)及RL结合,用带评分轨迹训练预测智能体,主攻far实例的大幅调整能力,驱动因子记录天然构成dense reward。三、扩展到非GAAP口径、收入/分部级预测、多季度序列与非美市场,检验schema流水线通用性。四、把'引用数字证据率'从相关观察升级为干预实验(强制/禁止数值引用),建立行为—误差因果链。五、评估经济价值:将PDE映射到盈余公告后漂移(PEAD)策略收益,回答'追平共识能否产生alpha'。六、系统研究harness对校准的影响(本文已见Opus覆盖率70%→65%移动),完善agent评估的成本—校准—准确三角。七、让schema支持一次性项目可插拔节点(如已知交易损益字段),检验误差改善幅度。
复现评估
开源良好:GitHub仓库 JadeXu16/epsbench 发布工具服务端、harness适配器、全部提示词、评估脚本、股价、逐实例预测与分数、schema(含逐实例验证,无需重生成);轨迹中transcript文本按Seeking Alpha许可替换为文档ID,附财报抓取脚本与过滤后CC-News索引。数据门槛:财报(EDGAR)与新闻(CC-News)公开,但电话会实录需Seeking Alpha许可、共识需IBES/WRDS学术订阅,且共识数值不随基准发布(只公布是否胜过共识的布尔结果),严格复现对比需自取IBES。算力:纯API调用,每配置447次运行、每运行中位输入0.54–1.35M token(含缓存)、输出3–40K,单配置约数千万至上亿输入token;schema构建还需o4-mini、deepseek-reasoner、GPT-5.4三段流水线(前者已可用,deepseek-reasoner已停服)。难度中等:复跑已发布149实例较直接,摩擦主要是两类商业许可证、harness版本漂移,以及扩展新季度需重建并重新验证抽取流水线。
论文图表
微软2026财年Q3的完整未编辑schema:variables_baseline存2025Q3基线叶子值(产品收入15319.0、服务收入54747.0、研发8198.0、股本7461.0等);formulas定义DAG(总收入→毛利→营业利润→税前→净利→EPS);prediction_schema列出9个预测字段(产品/服务收入yoy、cogs_margin_delta_bps、三项费用yoy、other_expense_abs、income_taxes_abs含默认值、shares_abs含last_q/ttm/q4三个参考值);_validation块记录基线EPS 3.46与目标EPS 4.27。
schema是本文任务的核心数据结构,该实例具体展示驱动因子如何定义、DAG如何从叶子汇到EPS、税与股本参考如何附给智能体,读懂数据结构才能读懂任务与评估。