WorkFactory:将职业意图转化为可执行任务以规模化训练智能体 WorkFactory: Turning Professional Intents into Executable Work for Scalable Agent Training
反向规划信息支持图加探针修复,批量构造可执行职业任务训练出WorkPilot
前置知识
专家轨迹监督微调(SFT)
让教师模型在真实任务环境中执行,记录完整的推理-行动-交付交互轨迹,再用掩码自回归损失 $\mathcal{L}=-\sum_i \log p(y_i|x_i)$ 在轨迹上微调学生模型。这是工作智能体(working agent)后训练的主流做法,训练价值取决于轨迹是否可靠展示了目标职业能力,而轨迹质量又取决于任务环境的信息是否完整一致。
WorkFactory 的全部产出就是这种教师轨迹,理解'什么才算一条好轨迹'(前提完整、工作留给求解者)是理解全文动机与设计的前提。
信息支持图(Information Support Graph)
形如 $G_{\text{info}}=(V_{\text{info}}, V_{\text{carrier}}, E_{\text{info}}, E_{\text{loc}})$ 的结构:$V_{\text{info}}$ 中每个信息单元记录内容、实体与范围,并标注状态为已提供、外部获取、求解者派生或内部构造;$E_{\text{info}}$ 记录关联、变换、证据、约束等支持关系(含多源共同支持一个结果);$E_{\text{loc}}$ 把信息绑定到载体(用户请求、参考工件、外部资源、未来交付物、内部要求)并标注求解者可见性。
它是方法的核心数据结构:环境构建按图物化,修复以图为初始规格,理解它才能理解'前提全给、结论不给'这条边界如何被机器检查。
探针执行(Probe Execution)
让一个隔离的求解者仅凭求解者可见的请求与资源尝试任务,不接触信息支持图、构造计划或先前诊断。探针把报告的问题锚定在被检查来源与工具观察上,识别受影响的操作与交付物,并区分求解者失误与合法的开放选择;只有判定为阻断任务完成的问题才触发修复。
探针相当于任务环境的'单元测试':修复循环由它驱动,8 类硬缺陷发生率统计也以它为统一度量。
GDPval-AA 与 Elo 评分
GDPval 是覆盖真实职业交付物的基准,GDPval-AA 协议下用 Bradley–Terry 模型 $P(i \succ j)=1/(1+10^{-(R_i-R_j)/400})$ 从模型成对比较估计 Elo 分数;官方 v2.1 Elo 与本地两锚点校准估计换算到同一量表,95% 置信区间由任务级 bootstrap 得到。论文中工作智能体对比主要用该量表。
论文头条结果(879→1565 等)都以 Elo 表达,不了解量表来源(官方还是本地估计)就无法正确评估提升幅度与可比性。
选择性拒绝采样
对同一任务生成多个候选输出,依据质量判据保留最优者。WorkFactory 只对初始 rollout 交互轮次最长的 5% 任务,基于成对交付物比较做选择性拒绝采样,其余任务直接保留通过轻量过滤(重复推理、重复工具调用、交付物空心)的初始轨迹。
这是教师轨迹的筛选策略,决定了最终 112,686 条语料的质量分布,也解释了为何长任务需要额外把关。
研究动机
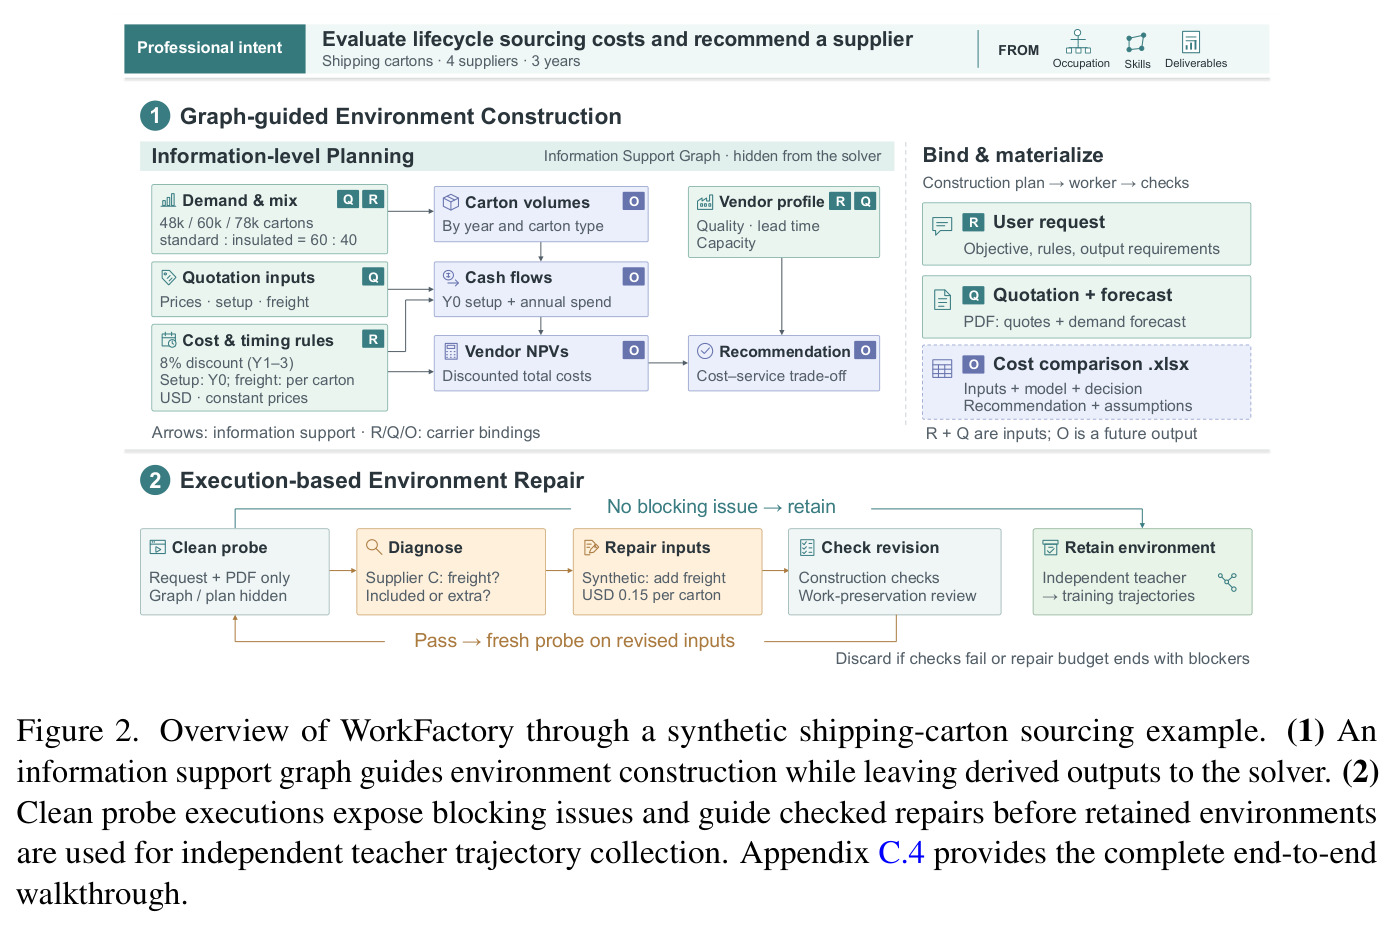
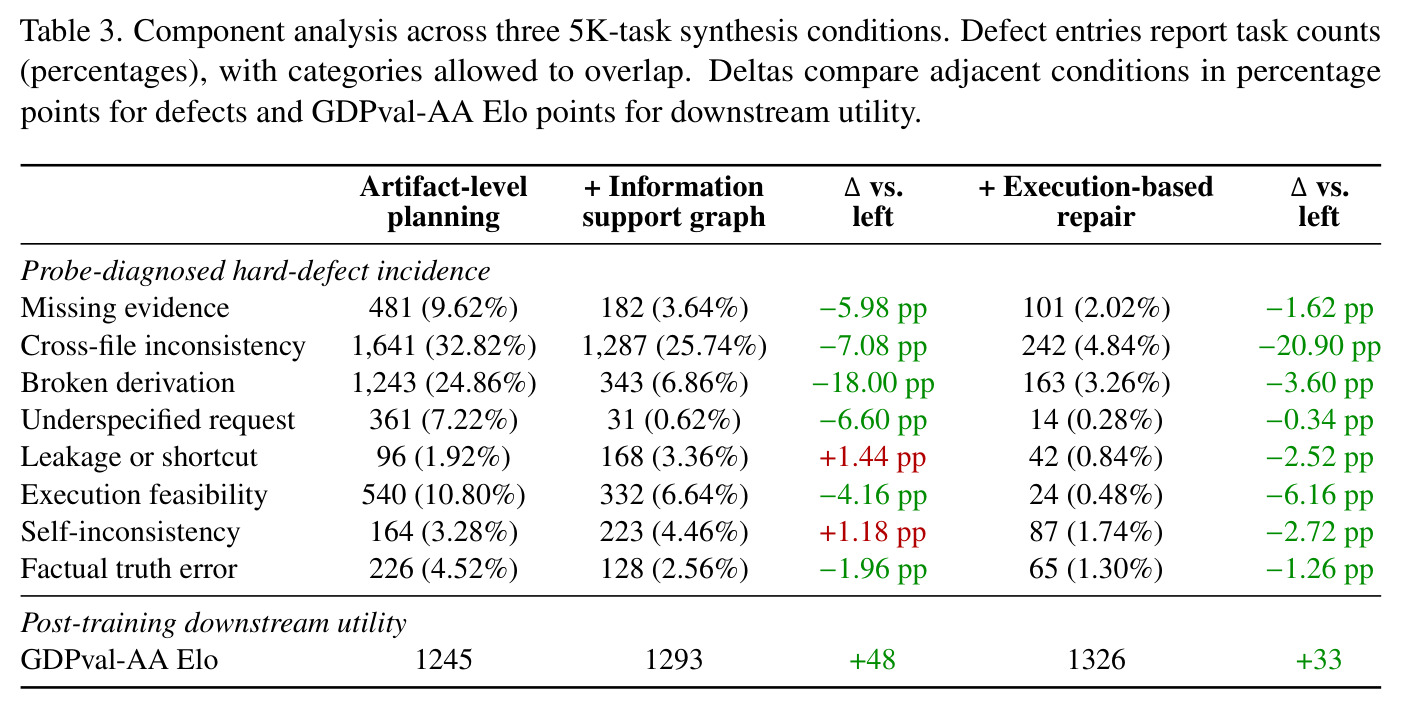
训练能在数字环境中完成职业工作(执行工作流、协调工具、产出交付物)的智能体,依赖大量可执行的专业任务及可靠的专家示范。现有自动任务合成框架(NexForge、Synthetic Computers、WorkGenesis 等)在检索、复用、改写或合成材料时,常出现关键信息缺失或前后不一致:例如供应商选择任务给了需求预测和四家供应商报价单,却没说明某供应商的报价是否含运费,导致生命周期成本无法一致计算比较。后果是教师智能体要么引入无根据假设、要么留下未完成的关键工作,轨迹作为监督信号的效力被削弱。论文用统一探针诊断量化了这一问题:仅用直接工件级规划时,跨文件不一致的硬缺陷发生率高达 32.82%,推导链断裂达 24.86%,缺失证据 9.62%,说明材料化过程系统性地破坏任务前提的完整性。
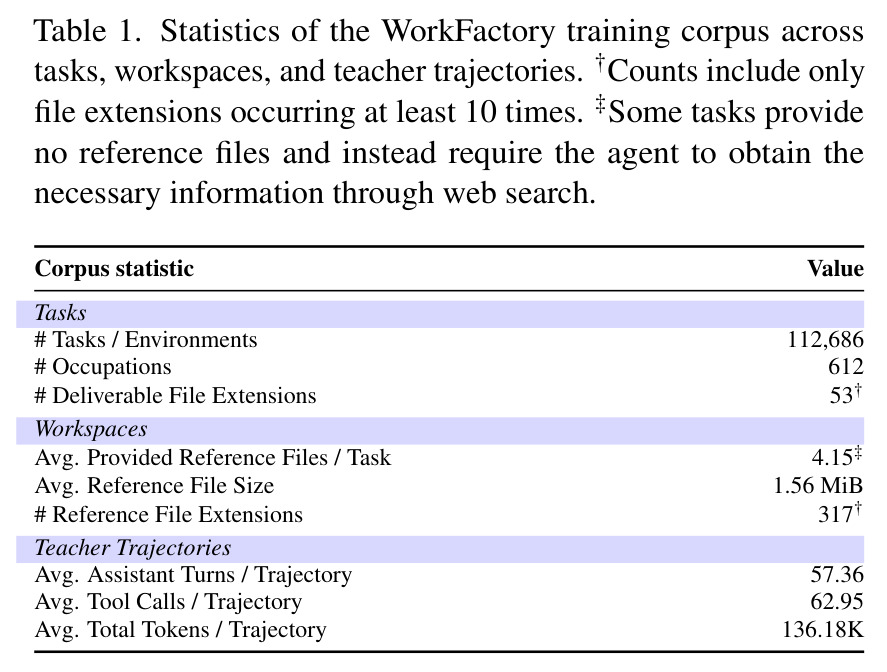
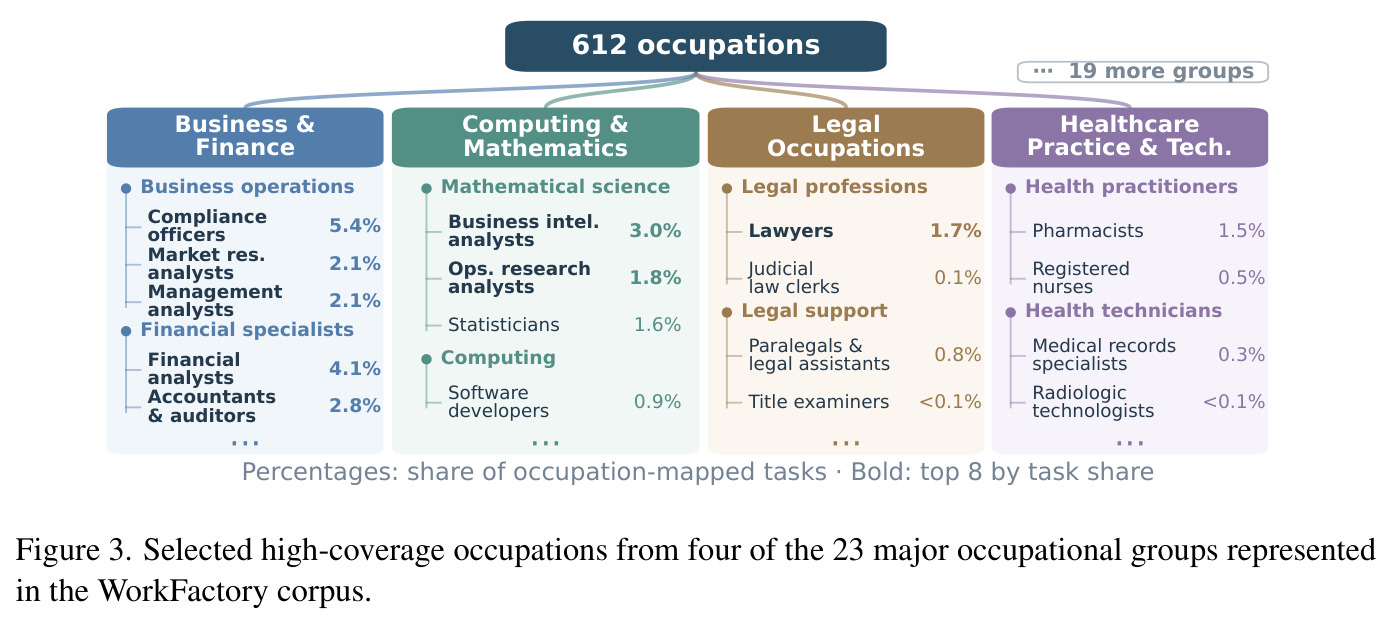
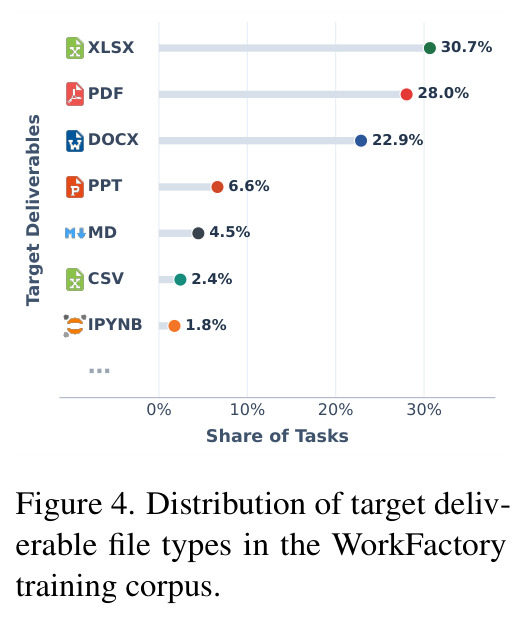
本文的目标是本文的目标是构建一个可扩展的框架,从职业意图出发批量生成'连贯且可执行'的专业任务环境:任务所需全部前提信息必须对求解者可见可得,而中间计算与最终判断必须保留给求解者完成——只有守住这条边界,教师轨迹才能可靠展示目标职业能力。量化目标包括:把任务规模推到 11 万量级并覆盖足够宽的职业面(最终 112,686 个任务、612 个细粒度职业、23 个职业大类、53 种交付文件类型);用采集到的教师轨迹微调 Qwen3.5-4B、Qwen3.6-27B、Qwen3.6-35B-A3B 三个规模得到 WorkPilot 系列,要求在 GDPval-AA、JobBench、Workspace-Bench、OmegaUse-OfficeVal 四个基准上全部超越各自基座,例如 35B-A3B 在 GDPval-AA 上从 879 提升到 1565 Elo。
与已有工作不同的是,与同期工作相比,WorkFactory 的独特切入是'从预期输出反向规划',并用图同时协调信息依赖与信息位置。GraphForge(并行工作)在真实文件工作区上构建证据图来编译任务陈述与证据锚定量规,再用执行反馈修订规格;WorkGenesis 围绕检索文件合成伴随材料,用基于量规的失败归因来修订请求、材料与量规;NexForge 把能力要求翻译成任务指令再用工作区蓝图实例化。WorkFactory 的信息支持图不只连接工件,还显式记录每个输出依赖什么信息、该信息应位于哪个载体、是否对求解者可见,并把派生结果明确保留给求解者;质量把关也不走量规审计路线,而是直接探针求解者可见环境,并硬性约束修复不得改变预期工作本身。
核心方法
WorkFactory 的直觉是把任务环境构建当作一个'信息边界'问题:所有必要前提必须可得,中间与最终结果必须留给求解者,否则教师要么瞎猜要么被喂答案。技术路线分四个阶段:第一,离线地从职业层级、技能文档与真实专业交付物三条路径合成职业意图,经 LLM 审查后进入共享意图库 $\mathcal{L}$;第二,对每个意图,规划器从预期输出反向追踪其背后的计算与判断,再追到所需信息,构建信息支持图 $G_{\text{info}}=(V_{\text{info}}, V_{\text{carrier}}, E_{\text{info}}, E_{\text{loc}})$,其中位置绑定规定信息放在哪个载体、是否求解者可见、内部构造要求保持隐藏;第三,把图翻译成工件级构造计划 $P=(u, \mathcal{A}, \mathcal{D})$(用户请求、工件规格、无环构造依赖),环境工人据此复用、改写或合成工件,程序与 LLM 检查不符则限期重试或丢弃;第四,隔离探针仅凭可见输入执行任务以暴露阻断性缺陷,修复器在不改变预期工作的前提下修补输入,通过全部检查的环境才交给独立教师采集训练轨迹。
核心创新是'信息级规划 + 执行式修复'的双保险机制,本质区别于以往的工件级组装。信息支持图把'每个输出依赖什么'与'信息放在哪'解耦为两类边:$E_{\text{info}}$ 记录关联、变换、证据与约束关系(含多源共同支持一个结果的情形),$E_{\text{loc}}$ 规定载体绑定与可见性。节点标注内容、实体与范围,以及 supplied、外部获取、求解者派生、内部构造四类状态,从而在材料化之前就把边界变成可机检的约束:运输纸箱选址例中,需求预测(4.8 万/6 万/7.8 万箱)、报价与运费规则作为输入提供,而供应商 NPV 与采购推荐保留为求解者的未来输出。效果可量化:5K 任务对照中该规划把推导链断裂从 24.86% 压到 6.86%、请求欠规格从 7.22% 压到 0.62%;随后探针修复再把跨文件不一致从 25.74% 压到 4.84%,说明规划管设计、修复管实现,二者互补。
方法步骤详情
步骤一,多源意图合成:职业层级扩展为情境化角色、技能文档组合成工作流、真实交付物经指令回译推断合理目标,三路候选经 LLM 审查连贯性、职业适当性与真实合理性后入库。步骤二,图引导环境构建:规划器从预期输出反向识别计算与判断、追踪所需信息形成 $V_{\text{info}}$,用 $E_{\text{loc}}$ 绑定载体,输出构造计划;环境工人按计划物化工件,程序与 LLM 检查不符合计划则限期重试或丢弃。步骤三,执行式修复:隔离探针仅凭可见输入尝试任务并诊断阻断性问题(如缺失'供应商 C 运费 0.15 美元/箱'条款),修复器编辑请求与参考文件但保持文件数量、类型与依赖结构;每次修订须过构造检查与 LLM 工作保全审查,通过后跑全新探针,无阻断或预算耗尽即停止。步骤四,教师轨迹采集:GLM-5.3 在干净沙箱中以与探针相同的信息边界独立执行,轻量过滤后对轮次最长的 5% 任务做成对交付物比较的拒绝采样;最终平均每条轨迹 57.36 轮、62.95 次工具调用、136.18K tokens,共 112,686 个任务。
技术新颖性
技术新颖性体现在三点。第一,规划对象从工件上升到信息:图同时编码依赖关系与位置绑定,使'派生结果留给求解者'成为可机检约束而非材料化后的运气,这直接解释了请求欠规格缺陷从 7.22% 骤降到 0.62%。第二,修复以'工作保全'为硬约束:修复器只能补前提(如补上漏掉的运费条款),不能替求解者完成计算,也不能改动核心目标、关键操作与实质交付要求,每次修订都要过 LLM 工作保全审查,从机制上防止修复本身变成答案泄露。第三,以探针执行作为环境的单元测试:缺陷必须锚定在被检来源与工具观察上,并区分求解者失误与合法开放选择,使环境质量可用统一的 8 类硬缺陷发生率量化对照——组件分析据此证明信息级规划与执行修复合计把下游 GDPval-AA Elo 从 1245 提到 1326(+81),把环境质量与训练收益首次系统地连了起来。
实验结果
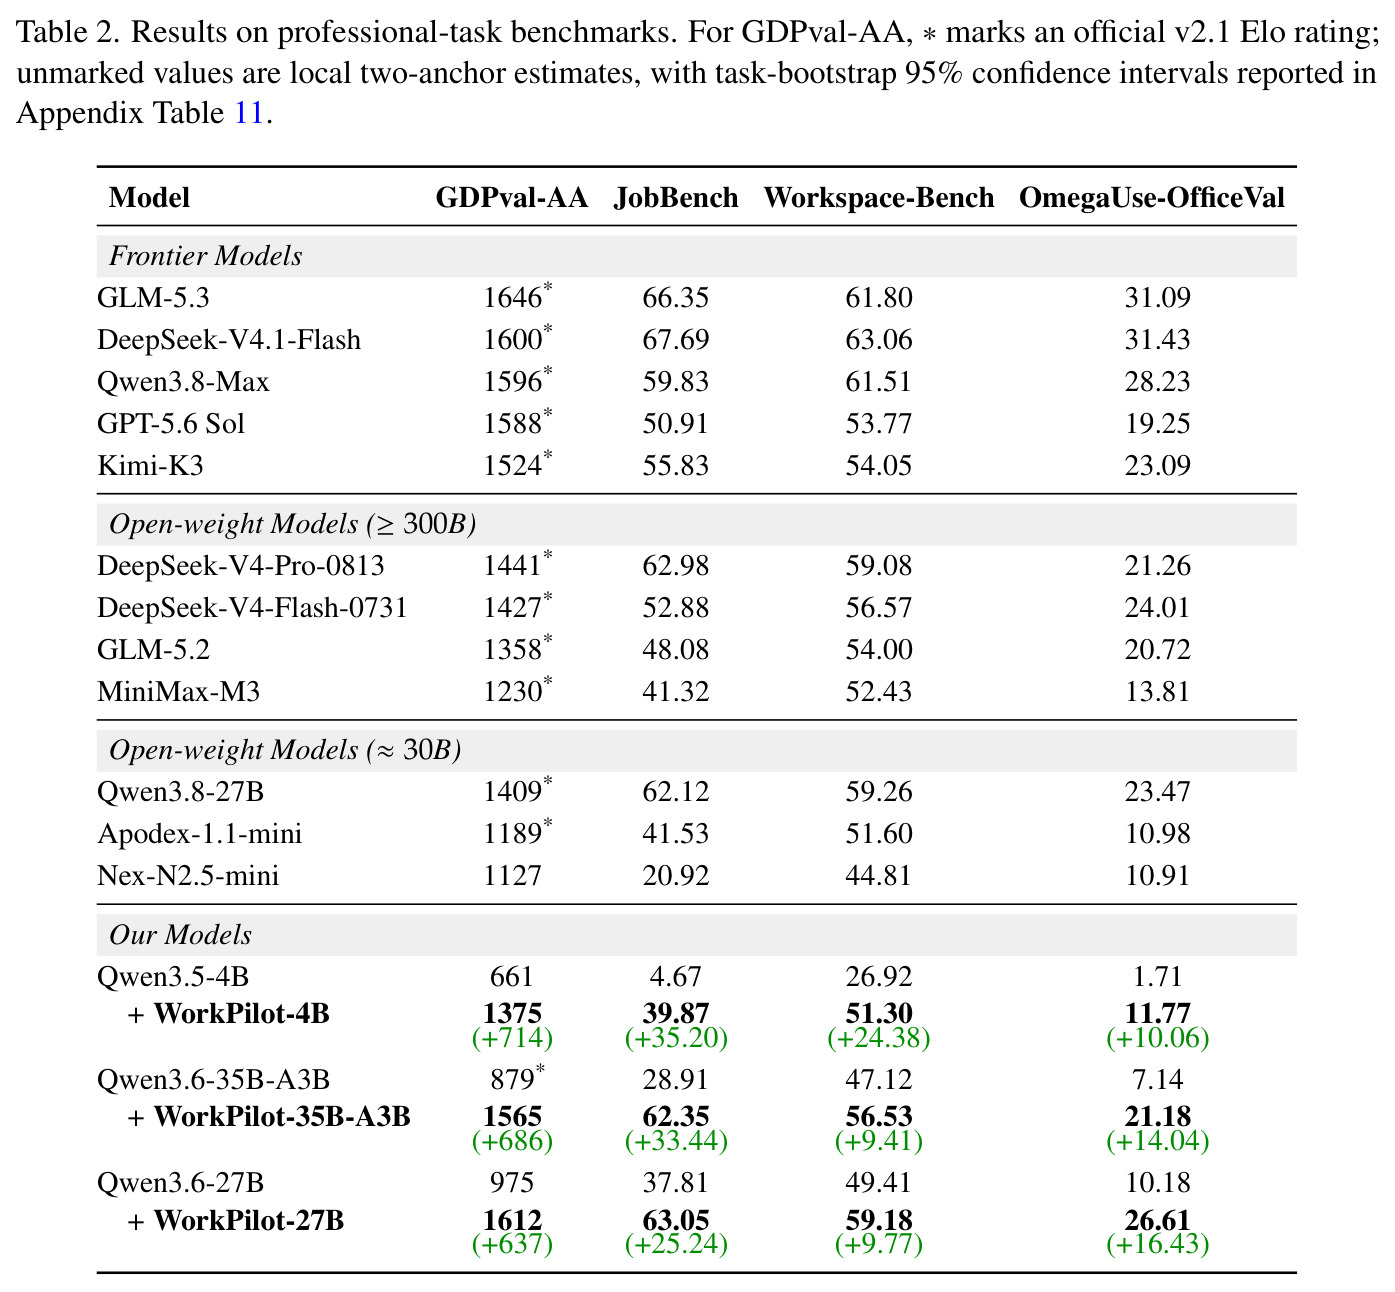
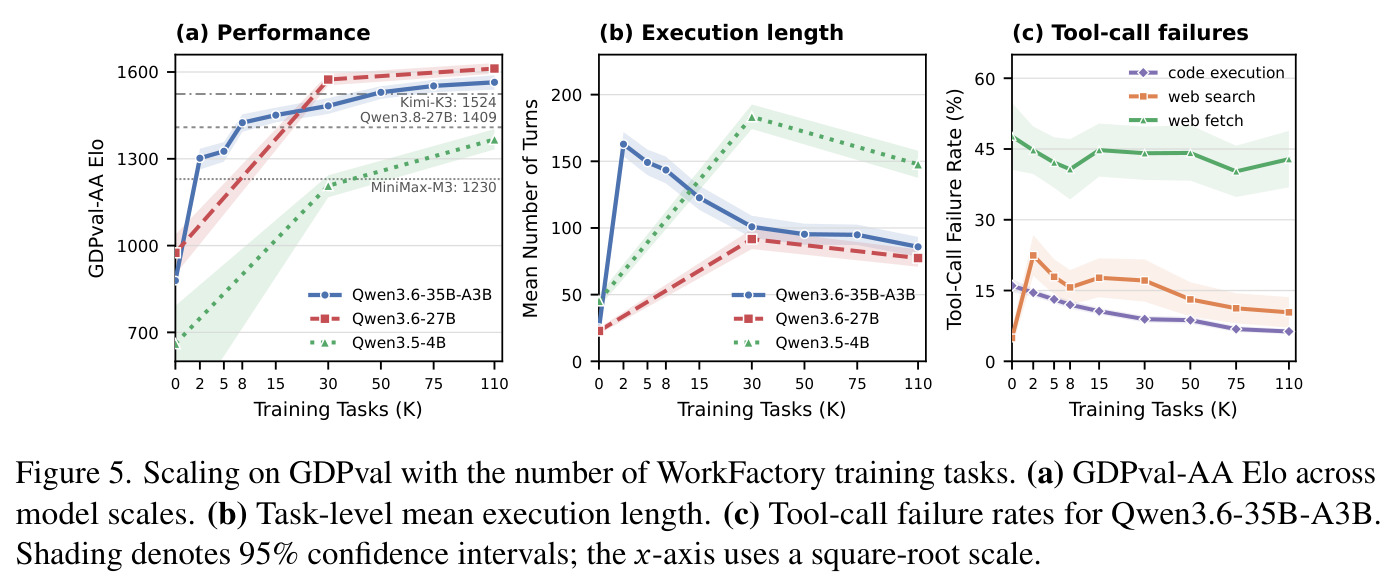
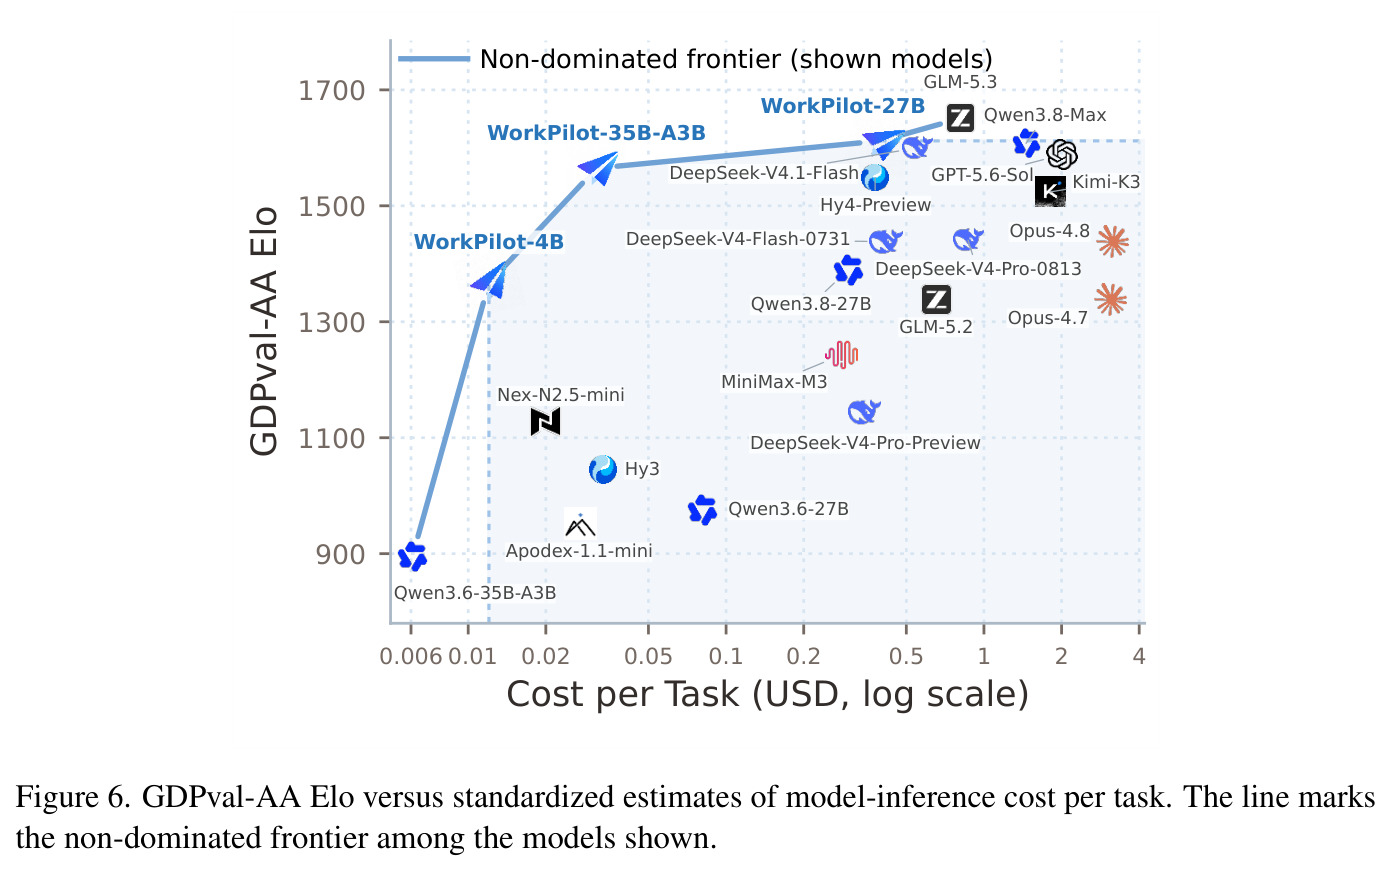
主实验(Table 2):同一语料使三个规模基座全面提升。WorkPilot-35B-A3B 在 GDPval-AA 从 879 升至 1565 Elo(+686),JobBench 28.91→62.35,Workspace-Bench 47.12→56.53,OmegaUse 7.14→21.18;WorkPilot-27B 本地估计 1612 Elo,高于 DeepSeek-V4.1-Flash 12 点、低于 GLM-5.3 34 点,进入前沿区间;WorkPilot-4B 661→1375,超过 Apodex-1.1-mini。扩展性(Figure 5):35B 前 5K 任务贡献 447 Elo,75K→110K 仅 +13;30K 时 35B/27B 已捕获 88%/94% 总增益;执行长度先升后降(24.87→162.88@2K→85.90@110K 轮),250 轮触顶比例 21.9%→2.7%,代码执行失败率 16.0%→6.3%。组件分析(Table 3):规划+修复把跨文件不一致 32.82%→4.84%,下游 Elo 1245→1326。教师选择(30K):GLM-5.3 轨迹得 1483,DeepSeek-V4-Flash 得 1248。成本(Figure 6):三模型均在非支配前沿,每任务约 $0.012/$0.031/$0.396。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GDPval-AA v2.1(真实职业工作,成对比较) | Elo | WorkPilot-35B-A3B 1565 / WorkPilot-27B 1612 / WorkPilot-4B 1375 | Qwen3.6-35B-A3B 879 / Qwen3.6-27B 975 / Qwen3.5-4B 661 | +686 / +637 / +714 |
| JobBench(职业任务执行) | 成功率(%) | 62.35(35B)/ 63.05(27B)/ 39.87(4B) | 28.91 / 37.81 / 4.67 | +33.44 / +25.24 / +35.20 |
| Workspace-Bench-Lite(多工具工作区任务) | 得分(%) | 56.53(35B)/ 59.18(27B)/ 51.30(4B) | 47.12 / 49.41 / 26.92 | +9.41 / +9.77 / +24.38 |
| OmegaUse-OfficeVal(办公软件操作) | 得分(%) | 21.18(35B)/ 26.61(27B)/ 11.77(4B) | 7.14 / 10.18 / 1.71 | +14.04 / +16.43 / +10.06 |
| 组件消融(5K 任务,35B-A3B 下游) | GDPval-AA Elo | 信息级规划 1293 / 加执行修复 1326 | 工件级规划 1245 | +48 / +81(累计) |
局限与改进
作者承认两点局限:一是教师 GLM-5.3 只接受文本输入,导致训练与评估均为纯文本模式,Qwen 骨干的原生视觉与对齐组件闲置,无法考察从视觉证据学习;二是研究停留在教师轨迹的监督微调,尚未利用执行反馈做强化学习。我的补充观察:其一,Table 2 中 1565/1612 等数字多为本地 Bradley–Terry 两锚点估计(裁判为 Gemini 3.1 Pro Preview),只有部分对比模型有官方 v2.1 Elo,跨系统可比性存在裁判偏差风险;其二,扩展曲线与执行长度、工具失败率分析以 35B-A3B 为主,27B/4B 只在 30K 与 110K 两个点采样,'先增后减'的曲线形状是否普适存疑;其三,缺陷发生率由探针求解器自报,探针、修复审查与教师同为 LLM,可能系统性低估残留缺陷;其四,web-fetch 失败率始终停在约 40%–48%,说明部分瓶颈在工具基础设施而非模型能力,堆数据无法解决。
独立分析的弱点
第一,质量评估闭环高度依赖 LLM:探针诊断、工作保全审查、交付物成对比较全部由模型完成,8 类硬缺陷的判定标准主观性较强,且探针与教师同为强模型,可能低估弱模型学生实际面临的可用性问题;改进方向是构建带参考答案的小规模人工核对集,校准探针的查全查准率。第二,组件分析暴露信息级规划的副作用:泄漏/捷径从 1.92% 升到 3.36%、自不一致从 3.28% 升到 4.46%,说明显式依赖会诱导材料化者把本应派生的信息写进请求;可对每次材料化自动检测'输出内容禁令'违规,而非只靠事后探针。第三,75K→110K 仅 +13 Elo,边际收益递减明显,继续堆数据的性价比可能不如把高质量任务转投 RL 或按信息密度做难度分层课程。第四,教师选择实验(1483 vs 1248)显示同一任务集收益差距可达 235 Elo,但论文未解释教师风格哪些维度起作用,缺乏可迁移的教师选型准则。第五,web-fetch 约 40%–48% 的失败率提示环境工具链本身不可靠,值得单独治理。
未来方向
作者明确提出的方向:把轨迹采集与学生训练扩展到多模态职业任务(利用 Qwen 骨干闲置的视觉与对齐组件),以及利用高质量任务和执行反馈训练工作智能体做强化学习而非仅 SFT。可延伸的方向:其一,信息支持图天然标注了'哪些结果应是求解者派生的',可直接转成过程级可验证奖励,接入 RLVR 式训练;其二,执行长度先增后减(24.87→162.88→85.90 轮)暗示存在隐式课程效应,可研究按任务信息密度或依赖深度排序的显式课程学习;其三,教师-学生能力匹配与轨迹改写蒸馏,回答'什么样的教师轨迹最值得学';其四,把探针-修复循环迁移到代码仓库、长程对话等其他环境合成场景,检验 8 类缺陷分类法的泛化性;其五,开源子集可支持复现 5K 规模组件消融,研究缺陷率与下游 Elo 之间的因果强度是否随模型规模变化。
复现评估
开源情况:论文声明任务数据子集与 WorkPilot 三个模型权重在 GitHub(IQuestLab/WorkFactory)公开,但 112,686 全量语料、意图库与完整教师轨迹是否开放未明确,5K 消融的任务清单也未逐条给出。算力与费用门槛高:采集 11 万条平均 136.18K tokens 的教师轨迹依赖 GLM-5.3 API(经 Stirrup 与 Claude Code 两个 harness),加上探针与修复循环的多次执行,推理费用可观;训练三档模型也需多卡集群(共享 SFT 配置见附录 Table 9)。相对可行的复现路径:下载开源子集复现 4B 或 35B-A3B 的监督微调;或在 5K 规模复跑三种合成条件的组件对照;评估侧 GDPval-AA 协议与 Bradley–Terry 两锚点校准方法都有描述,但裁判模型(Gemini 3.1 Pro Preview)与各家 API 价格变动会引入数字层面的复现差异。综合判断属于中等偏难复现:小规模科学结论可验,全量工程管线难以原样重建。
论文图表
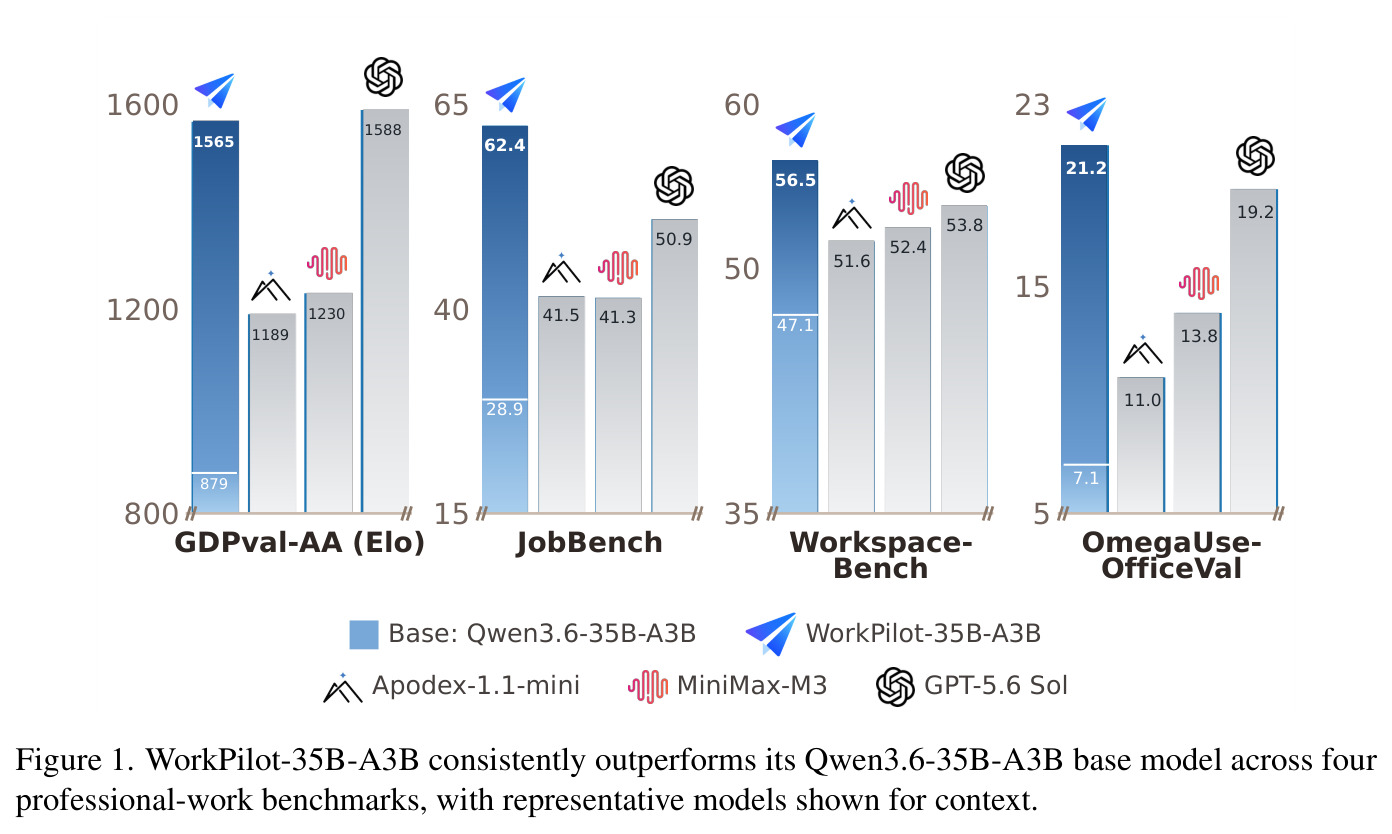
四联柱状图:GDPval-AA Elo(879→1565,附带 GLM-5.3 1646、GPT-5.6 Sol 1588 等参照)、JobBench(28.91→62.35,参照 DeepSeek-V4.1-Flash 67.69)、Workspace-Bench(47.12→56.53)、OmegaUse-OfficeVal(7.14→21.18),并标注 Apodex-1.1-mini、MiniMax-M3 等对比模型。
一图总览核心卖点:同一份数据让 35B-A3B 跨四个基准大幅超越基座并逼近前沿模型,是读者判断论文价值的第一入口。