工作智能体:系统、能力与优化 Work Agents: Systems, Capabilities, and Optimization
以可验证工作结果为中心,系统定义工作智能体框架、五大能力族与模型-执行器联合优化评估路径。
前置知识
基础模型智能体(Foundation-Model Agent)
以大语言等基础模型为决策核心的自主系统:模型接收上下文(任务描述、环境观察、历史交互),输出推理与动作提议,通过调用工具或操作界面改变环境状态,再根据反馈进入下一轮决策。典型循环是「观察—推理—行动」,代表工作 ReAct 将思维链推理与工具调用交错进行。本文把它扩展为「工作智能体」,强调其承担的是被委托的、可验证的数字工作而非单轮问答。
全文的六要素系统观和五大能力族都建立在这一基本循环之上;读者需先理解模型只是决策核心,系统性能还取决于外围机制。
执行器/运行时脚手架(Harness)
围绕模型的运行时支撑系统,负责上下文构造、工具调用、记忆与技能管理、执行控制(重试、恢复、中断续跑)与错误恢复,是模型与工作空间之间的中介。SWE-agent 的面向智能体的仓库操作界面、MemGPT 的分层记忆、OpenHands/Codex/Claude Code 等都是 harness 实例。同一模型配不同 harness 可能得到截然不同的成功率与调用成本。
本文的核心主张是「模型优化、harness 优化、二者联合优化」三分法,不理解 harness 就无法理解它与以往「只训模型」路线的本质区别。
后训练与可验证奖励强化学习(Post-training / RLVR)
后训练泛指预训练之后的监督微调(SFT)、强化学习(RL)、on-policy 蒸馏等阶段。可验证奖励 RL 用可程序化判定的结果(测试通过、数据库终态、工作簿重算值)作为奖励训练策略;由于工作类任务多步依赖、奖励稀疏,还需要里程碑奖励、verifier-to-turn 式信用分配等技术把最终结果归因到中间决策。
第 4 章的实证结论(Nemotron、Mercor/SkyRL、WorkRover 的具体数字)都来自这类后训练流程,需理解 SFT/RL/蒸馏的分工才能读懂各消融实验。
上下文窗口与外部记忆管理
上下文窗口是模型单次推理能容纳的 token 上限;工作类任务的历史(工具输出、观察、中间产物)往往远超窗口或早已失效。记忆管理决定哪些信息留在活跃上下文、哪些转入外部存储按需检索(MemGPT 的移动机制)、哪些沉淀为可复用技能或流程文档(ReasoningBank、ACE 的经验库与技能库)。
工作持续性(work persistence)维度要求跨阶段、跨事件保持责任开放,直接依赖跨会话的状态与记忆机制,是理解第 6 章前沿问题的基础。
LLM-as-a-Judge 与 pass@k 类指标
当产物(报告、幻灯片、代码)难以用规则判定时,用一个模型对照需求、参考材料与评分细则(rubric)打分,即 LLM-as-a-Judge;进一步让评审智能体自己读文件、跑工具取证则称 Agent-as-a-Judge。pass@k 表示 k 次尝试至少一次成功,而 τ-bench 提出的 passk 要求 k 次全部成功,二者严格程度差异巨大。
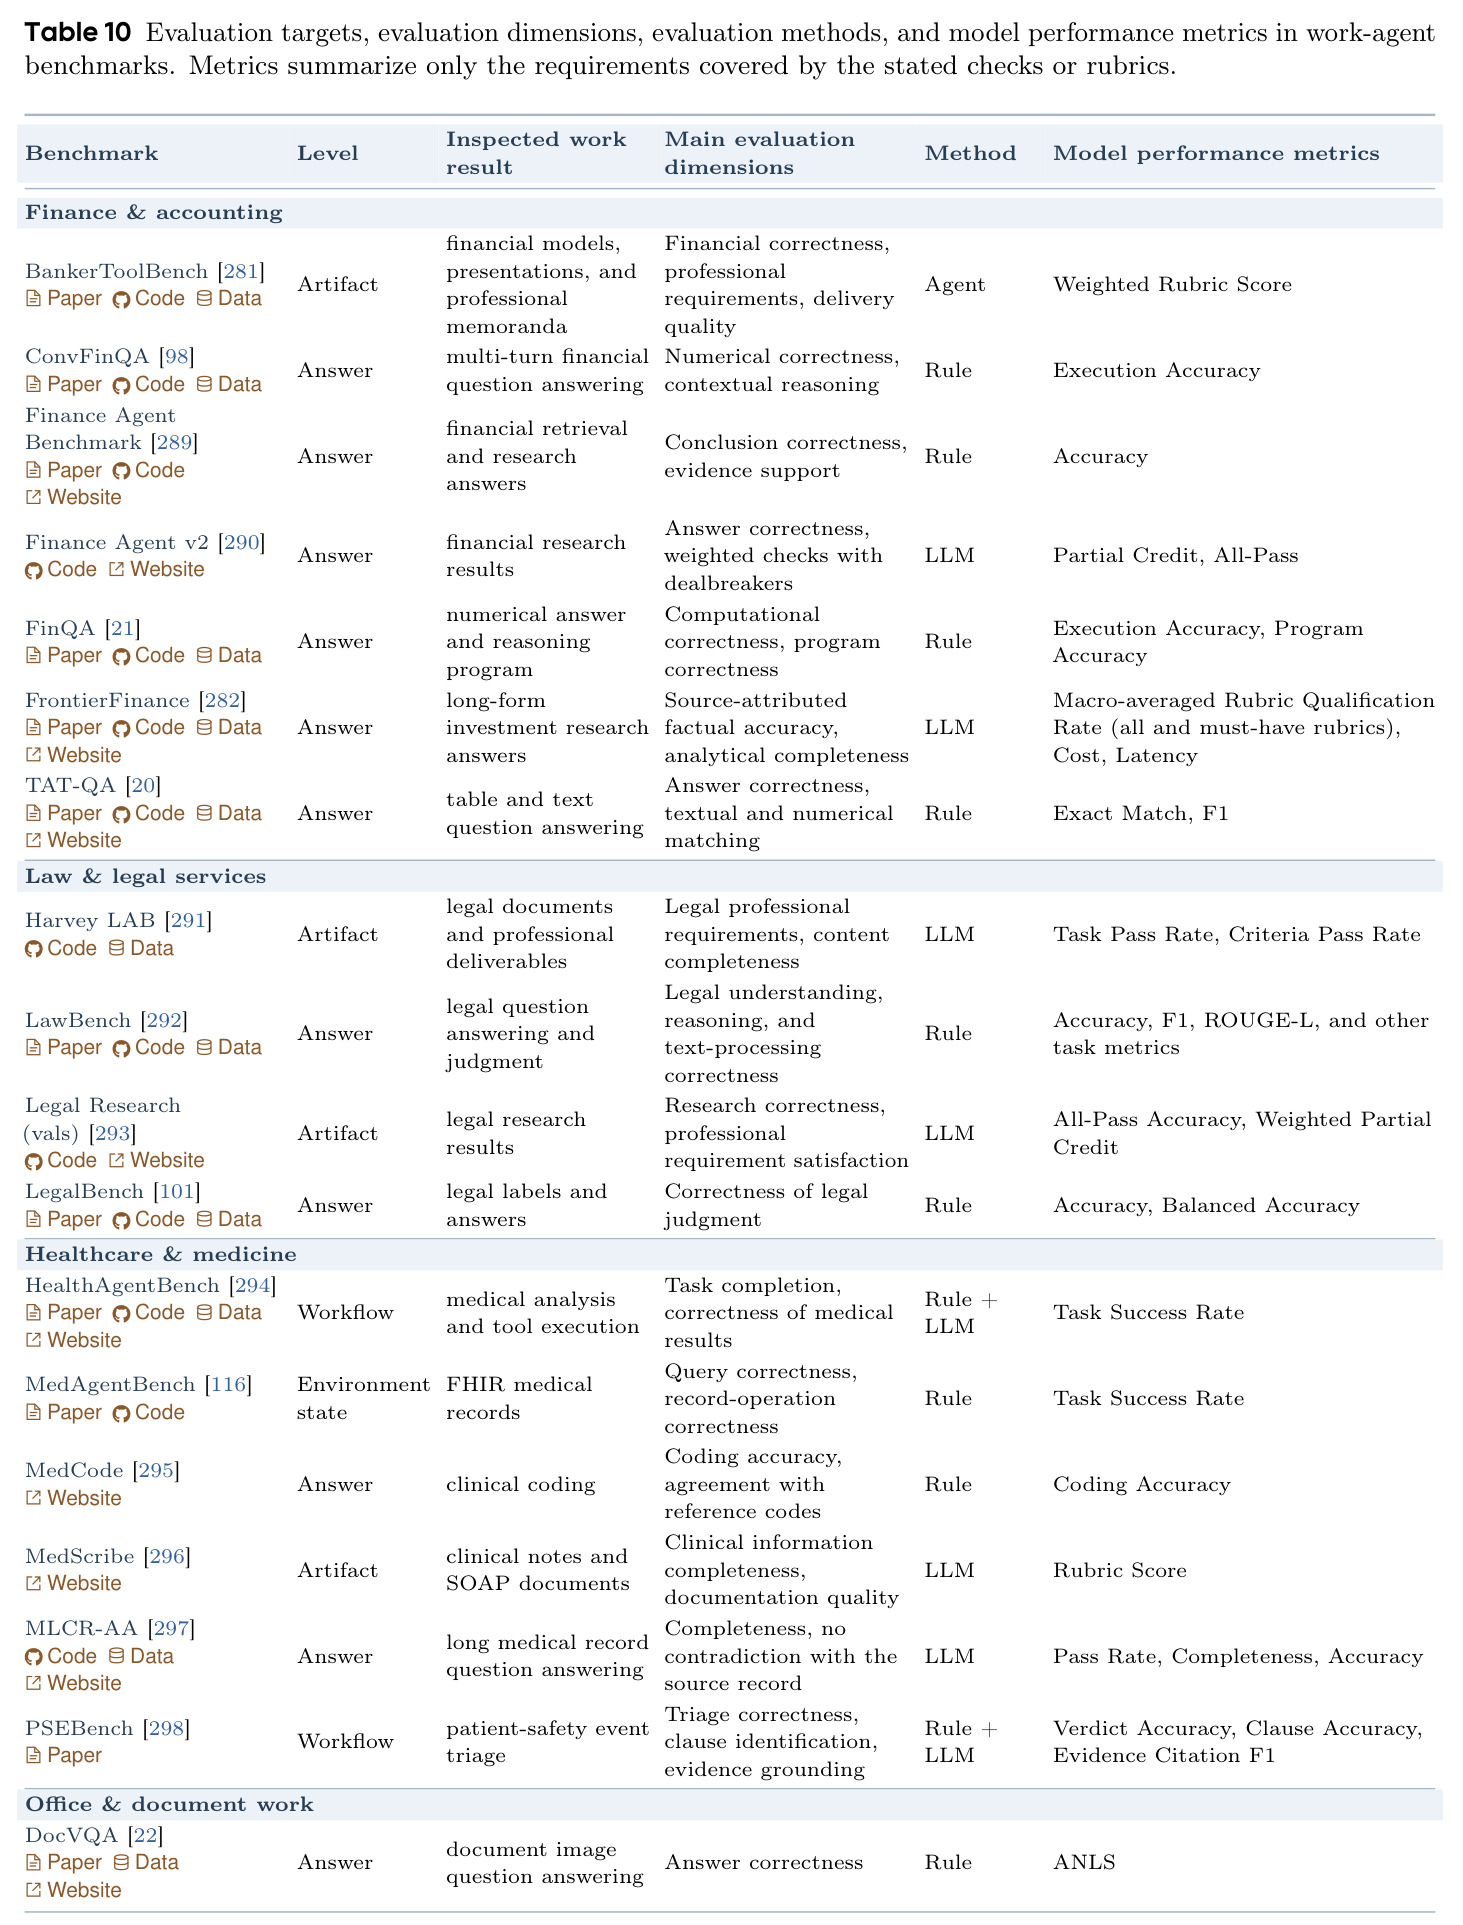
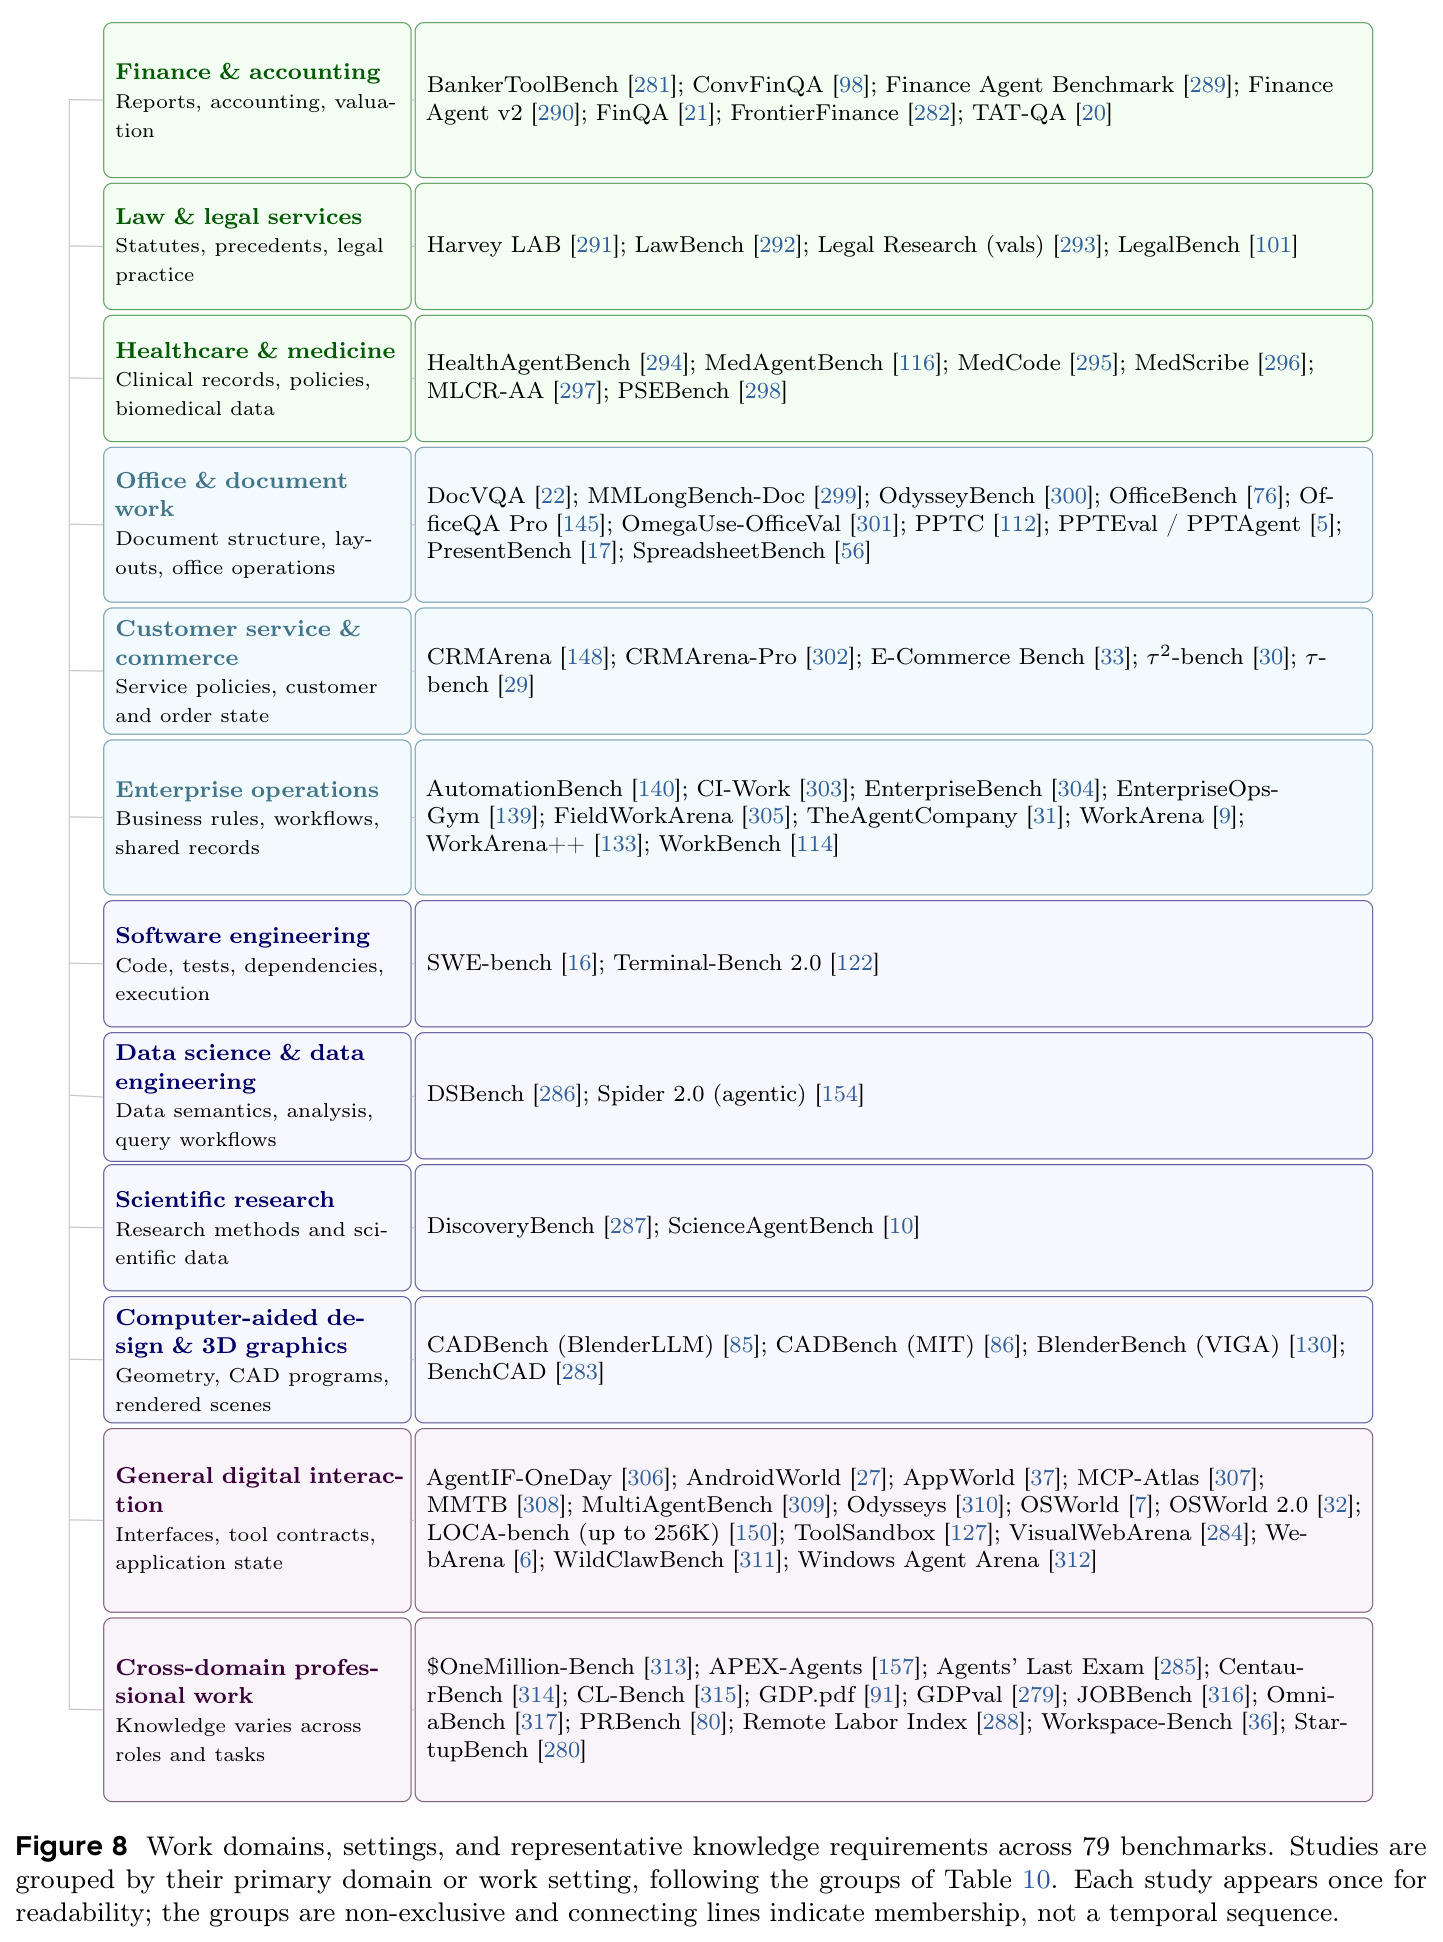
第 5 章按「评估目标—维度—方法—指标」四层拆解 79 个现有基准,掌握这些术语才能读懂其对基准的分类表格。
研究动机
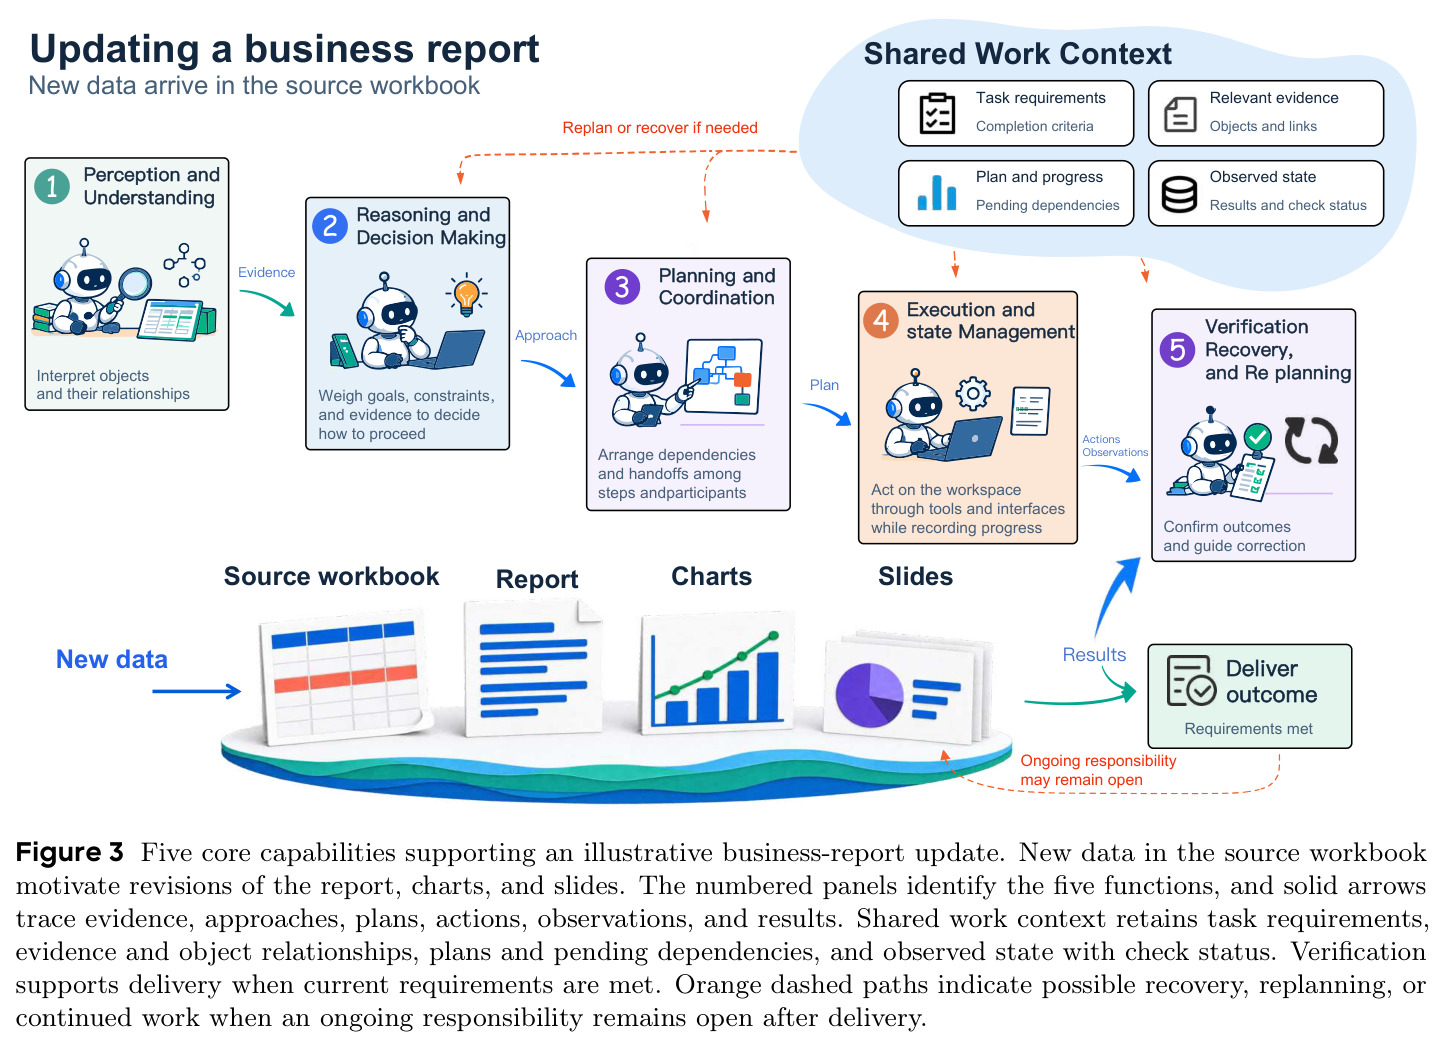
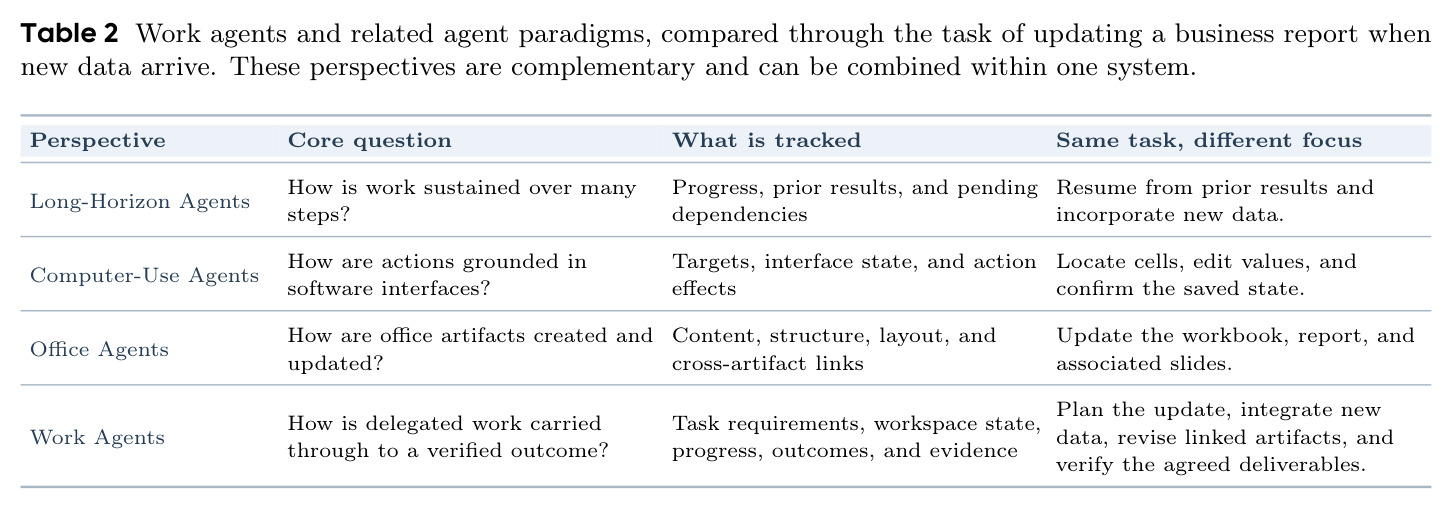
作者指出的核心问题是现有 agent 研究缺乏「工作如何被可靠完成」的统一视角,研究割裂成三条互不相通的线:长程智能体(long-horizon agents)只关心如何跨多步维持执行与状态,用 METR 时间地平线(按人类专家完成任务所需时长衡量任务长度)等指标量化;计算机使用智能体(computer-use agents)只关心如何把任务意图接地到屏幕上的具体操作(如 SeeClick 的视觉定位);办公智能体(office agents,如 SheetCopilot、PPTAgent)只关心某一类产物怎么造。Table 2 用同一个「新数据到达时更新业务报告」任务展示:三者各自追踪的不同侧面(进度恢复、界面定位、产物更新),恰恰是工作智能体视图要拼起来的整体。评估侧的麻烦更实际:HAL、HarnessTax 等分析发现同一模型在不同 harness 下任务成功率接近、API 调用成本却差异巨大,基准分数被默认全部归于模型并不公平;pass@k 与 passk 等指标口径不一,跨基准分数不可直接比较。此外还存在一个普遍的概念混淆:把「执行步数长」等同于「责任未闭合」——一次很长的仓库修复在提交补丁时责任即闭合,而每周只需短运行一次的服务维护却要在整个季度内保持责任开放。
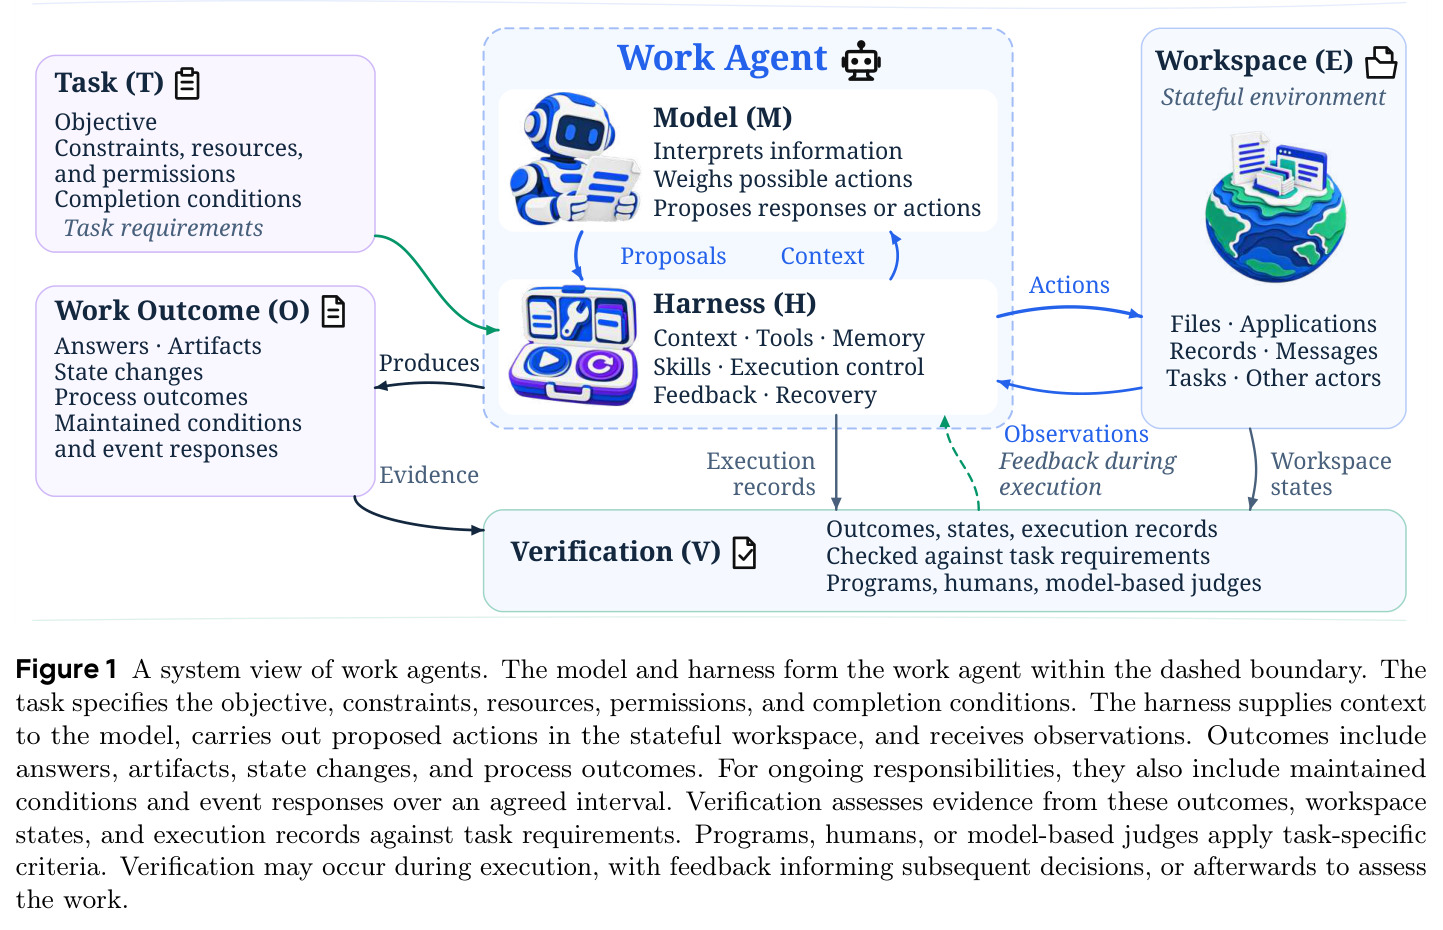
本文的目标是本文要建立一个以数字工作为中心的系统级统一框架,让「理解、优化、评估工作智能体」在同一套语言下进行。具体目标包括五项:(1) 用任务 $T$、模型 $M$、执行器 $H$、工作空间 $E$、工作结果 $O$、验证 $V$ 六个要素定义工作智能体,并形式化闭环执行 $(T, E_0) \xrightarrow{M,H} (\tau_{0:t}, E_t, O_t)$ 与评估 $S_t = \mathcal{V}(T, E_0, \tau_{0:t}, E_t, O_t)$;(2) 引入工作持续性(persistence)与工作开放性(openness)两个互补维度刻画工作条件,按任务范围与组织划分五种工作形态;(3) 归纳感知理解、推理决策、规划协调、执行与状态管理、验证恢复重规划五大能力族,并分析不同条件对其提出的差异化需求;(4) 系统梳理训练环境/数据/奖励设计、模型三阶段优化、harness 优化与二者联合优化;(5) 从工作结果视角重组现有基准、评估方法与指标。最终支撑能交付「可靠、可验证、有实践价值」工作结果的系统研发。
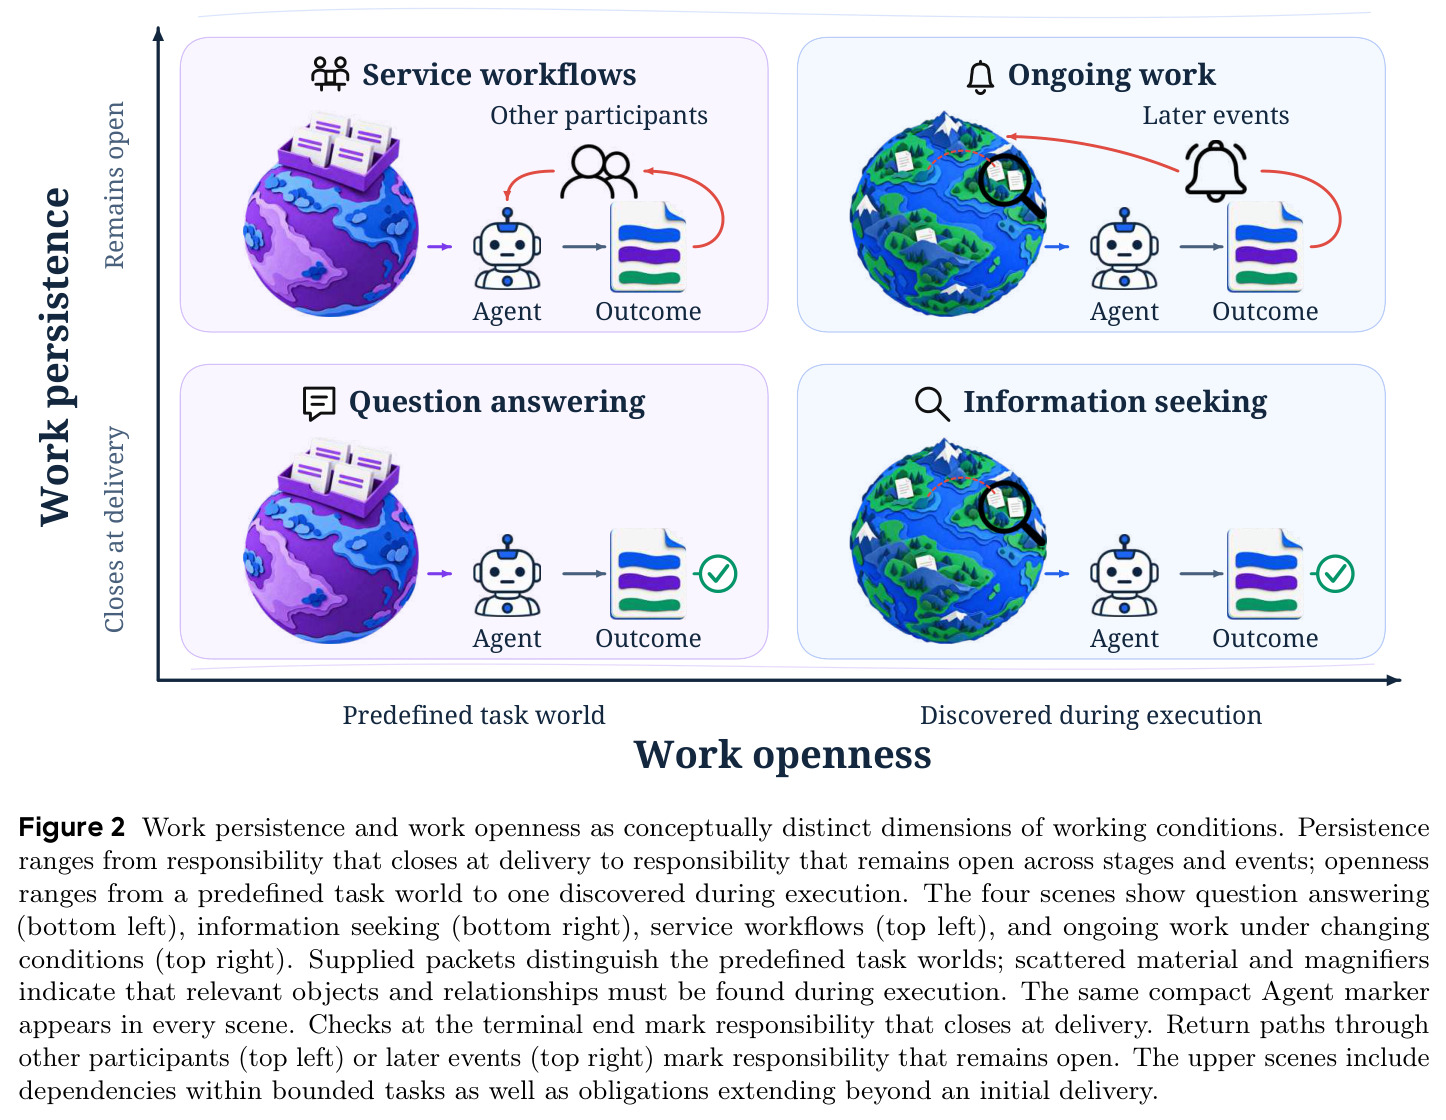
与已有工作不同的是,本文的独特切入角度是「分析单元的转移」:以往研究把智能体性能拆成孤立模型输出或单次工具调用的正确性,而本文把「从初始请求、经执行、到可验证结果」的完整委托过程当作分析对象,强调有状态工作空间(文件、应用、记录、其他协作者相互连接且状态随工作演进)与可验证结果。由此产生两个被忽视的概念区分:其一,工作持续性问的是「责任何时可以闭合」,与任务难度和执行长度正交——答题可能比提交审批表更难推理,但前者交付即闭合、后者要等他人审批;其二,工作开放性问的是「任务世界是预先给定还是执行中发现」——同一仓库修复可能请求里就点名文件、也可能要先自己定位相关文件与权限。作者用这两个维度重新摆放已有研究:SQuAD 类问答(预定义+交付即闭合)、GAIA/Workspace-Bench 类信息检索(执行中发现+交付即闭合)、τ-bench 服务流程(预定义+保持开放)、OSWorld 2.0/VibeLifeBench 类持续工作(发现+保持开放),四个象限都有真实研究对应(Figure 2),说明这两个维度抓住了既有版图的真实结构而非人为分类。
核心方法
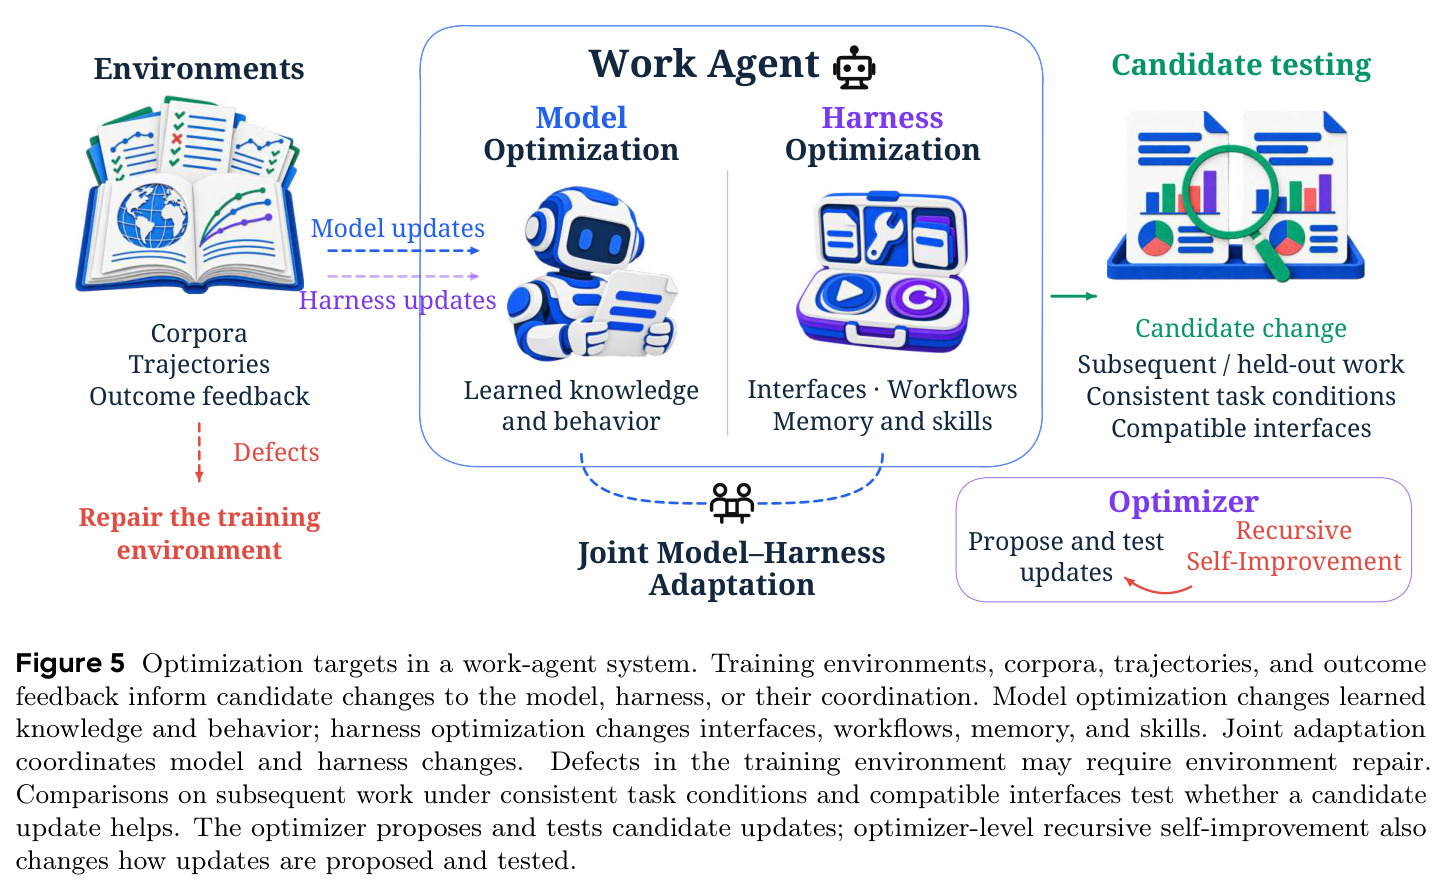
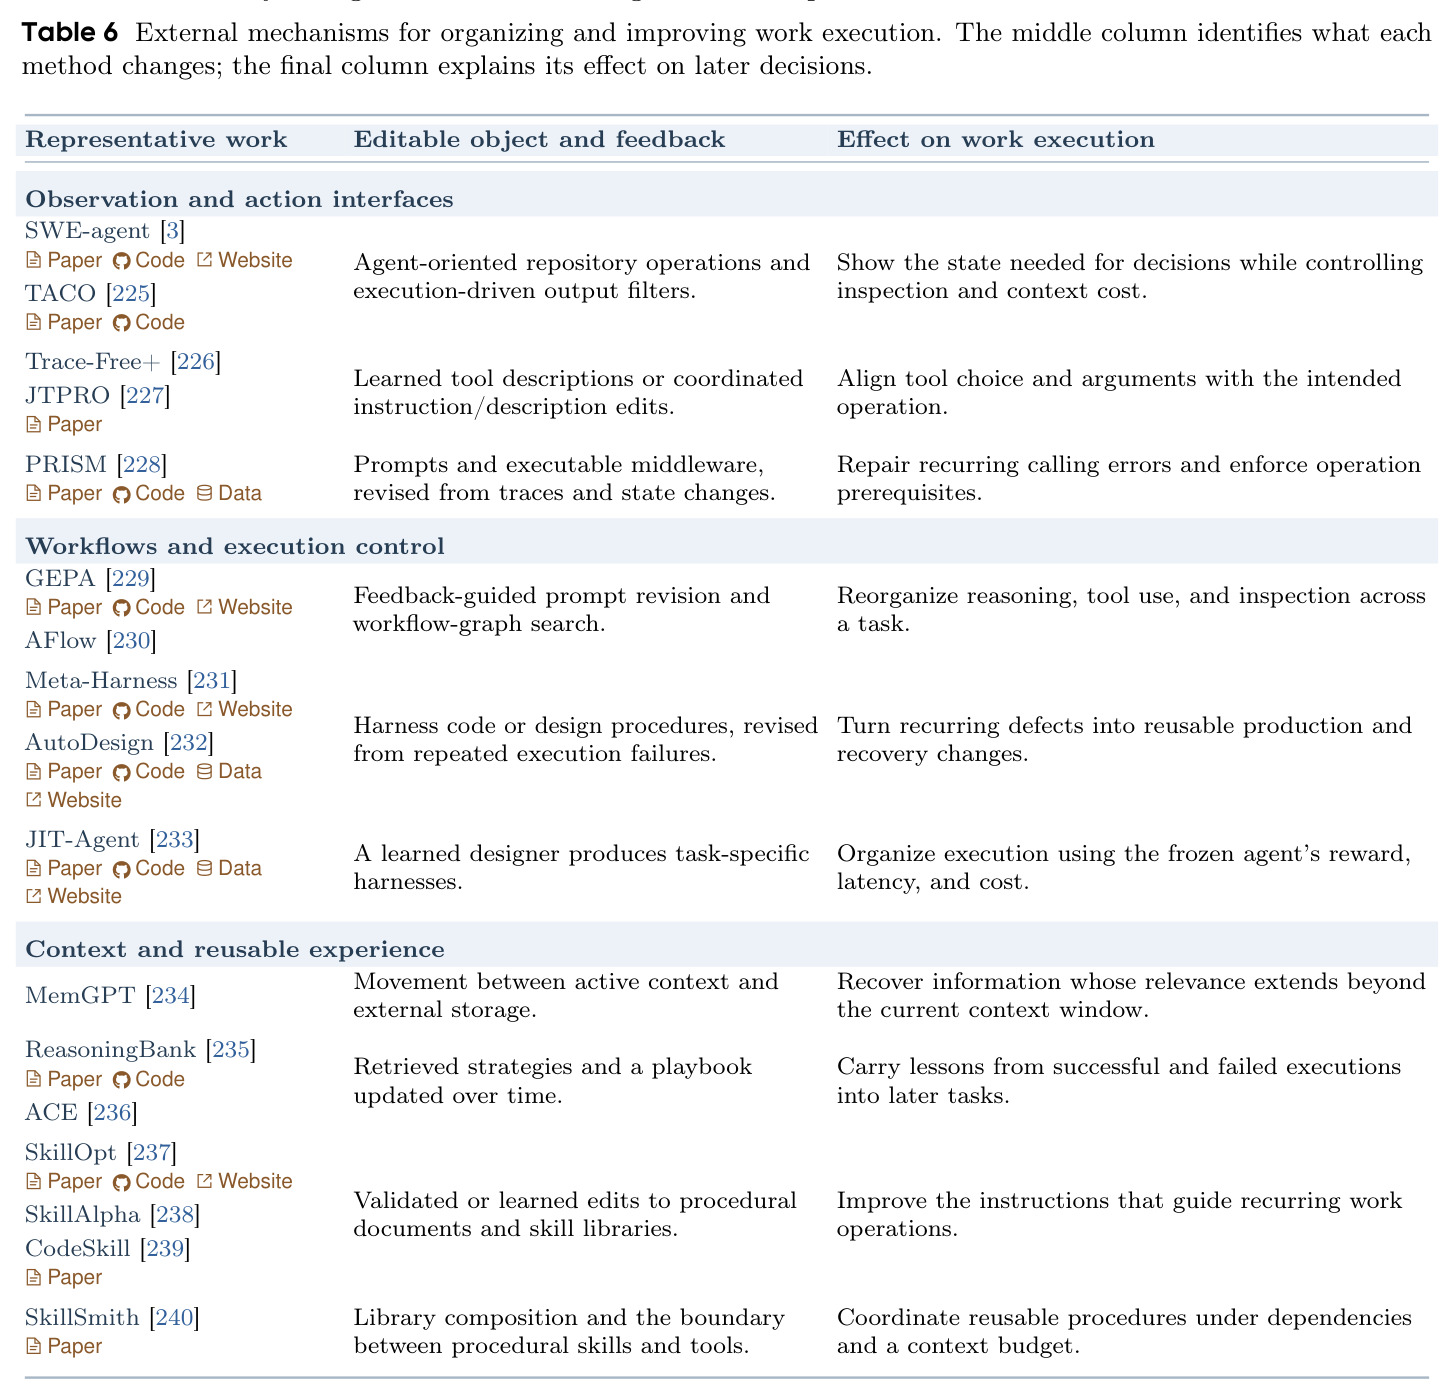
直觉上,本文把智能体当作「接受委托、对结果负责的数字员工」而非问答器:请求方说清要做什么,智能体在由文件、应用、记录、消息、任务与其他协作者组成的工作空间里动手,交付物最终要按任务要求核验。技术路线按「定义→条件→形态→能力→优化→评估→前沿」组织。定义层用六要素刻画系统(Figure 1:模型与 harness 构成智能体本体,任务、工作空间、结果、验证定义其须负责的工作),并给出执行方程 (1) 与评估方程 (2);条件层提出持续性与开放性两个正交维度;形态层把数字工作从对话级(产出信息)、原子动作级(局部改动)、多步级(经中间结果完成目标)、工作流级(跨越功能阶段与交接,流程本身是被委托的)、工作空间级(自行发现相关对象与依赖)逐级扩展(Figure 4 给出 90 个代表工作的时间演化);能力层把工作过程归纳为五大能力族的循环而非流水线(Figure 3),由共享工作上下文串联;优化层把能力归属拆成「模型学得」(预训练/中期训练/后训练,Figure 6)与「harness 提供」(界面/流程/记忆技能,Table 6),并讨论联合优化与自演化(Figure 7);评估层按任务构建四策略、评估目标四层次、判分方法与三类指标组织 79 个基准(Table 9-12)。
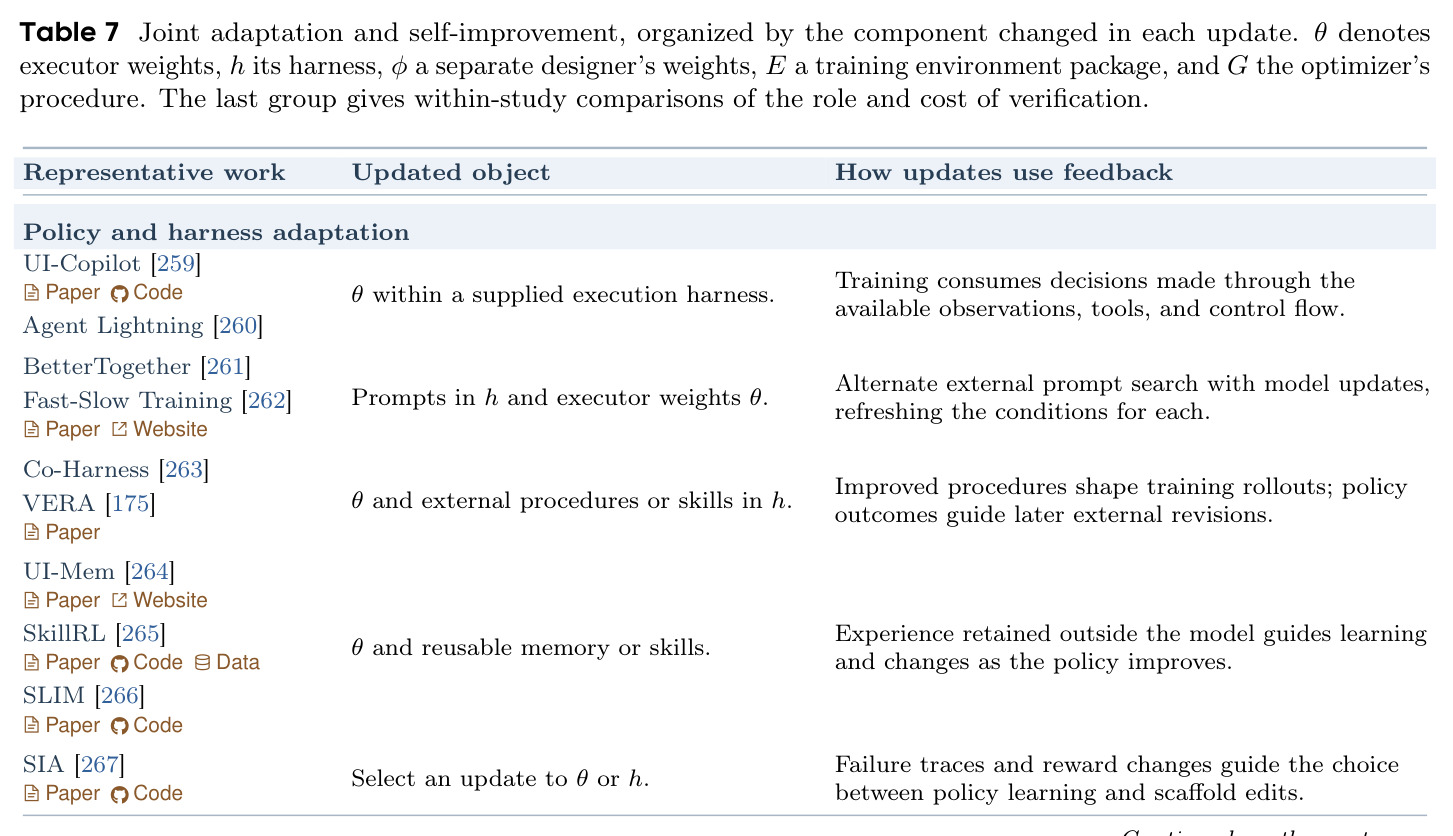
核心创新是「以可验证工作结果为中心的系统观 + 两个正交的工作条件维度」。与已有综述不同,本文首先把模型与运行时 harness 捆绑为一个系统,把任务、工作空间、结果、验证当作系统须负责的外部契约,并在形式上区分执行与评估两种角色(方程 (1) 跑闭环、方程 (2) 对照任务要求检查证据)。其次,work persistence 与 work openness 概念上互相独立:前者决定责任何时闭合(交付即闭合 vs 跨阶段/事件保持开放),后者决定任务世界是否要在执行中查明,二者组合出四种真实场景(Figure 2)。第三,五大能力族被组织成由共享工作上下文(任务需求与完成标准、对象证据与链接、计划与待办依赖、观察状态与检查状态)串联的循环,验证发现的问题被路由回对应能力(缺证据回感知、前提变了回规划、执行错了回执行);执行状态被细分为 attempted(已发出)/accepted(接口已确认)/committed(已体现到目标状态)/verified(已对照需求核验)四级——接口接受不等于任务成功,这对避免重复发送消息等副作用至关重要。第四,优化被显式拆分为模型、harness 与联合三个对象,并提出 $(M_0,H_0)/(M_1,H_0)/(M_0,H_1)/(M_1,H_1)$ 四配置比较协议来回答「一条经验应存进权重、上下文、技能还是控制代码」。
方法步骤详情
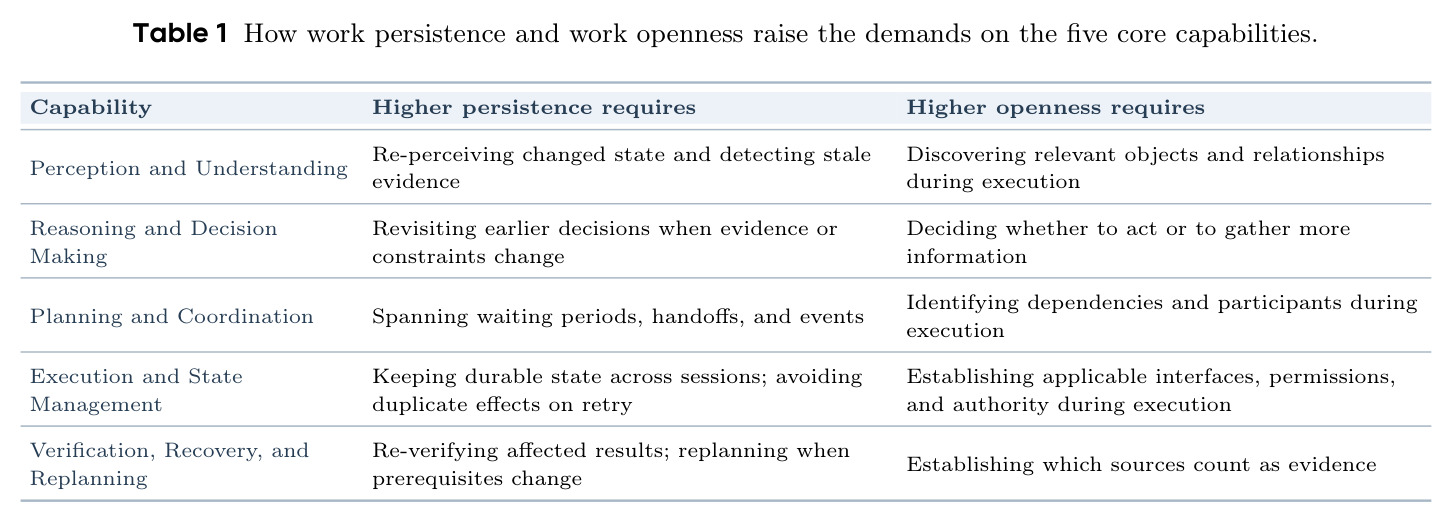
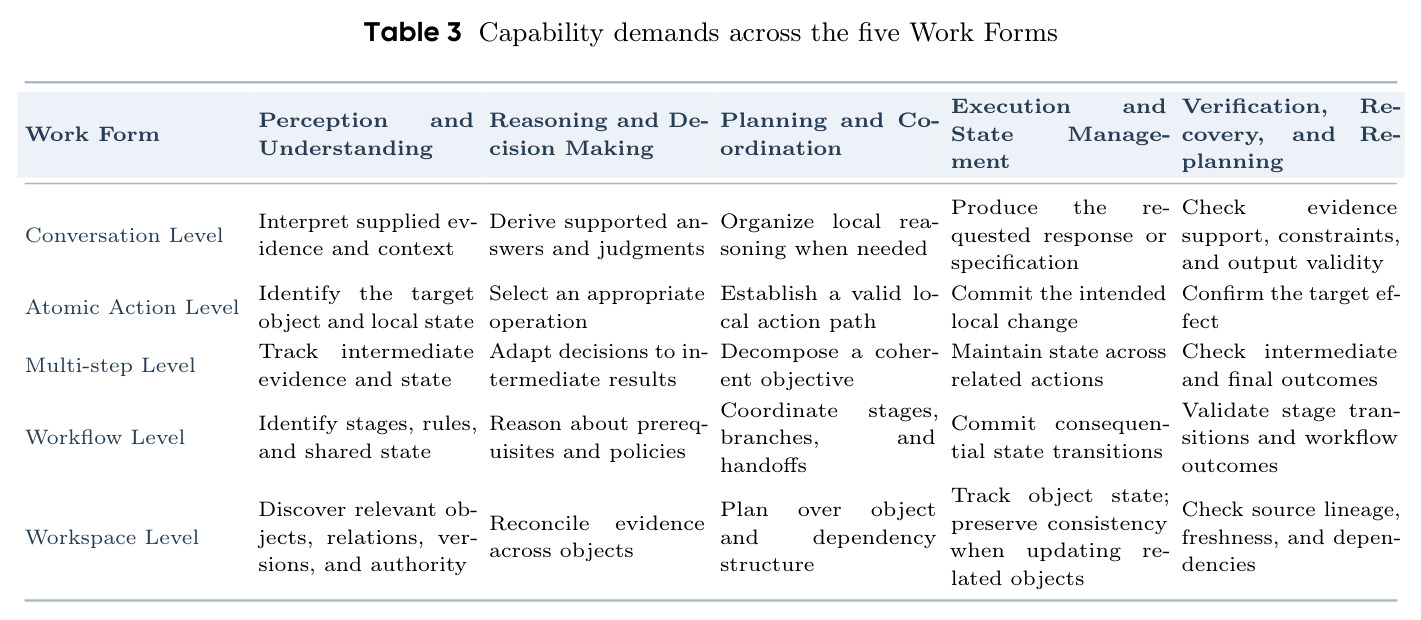
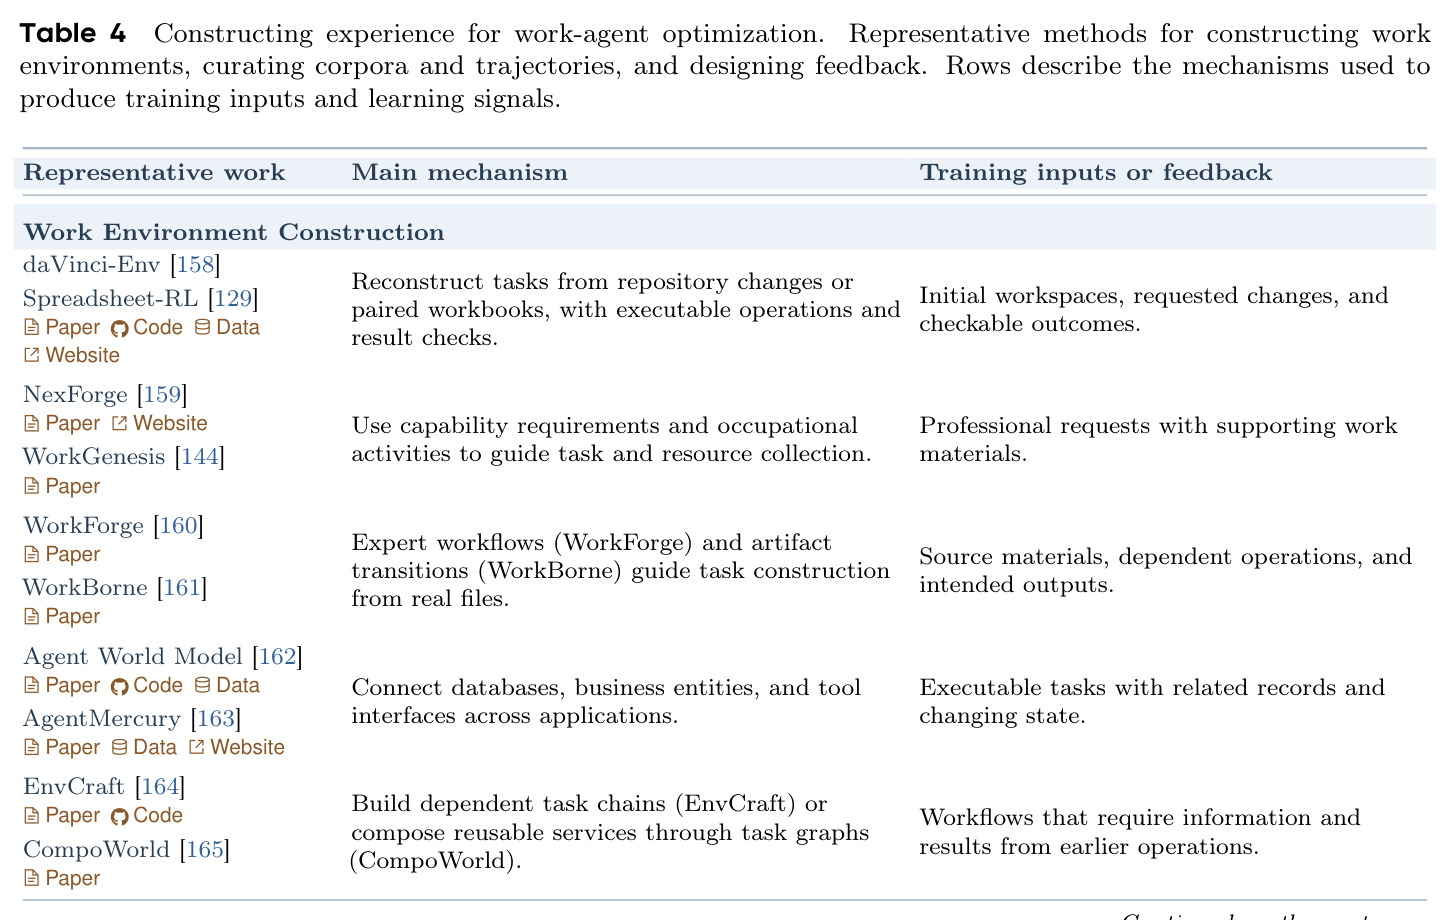
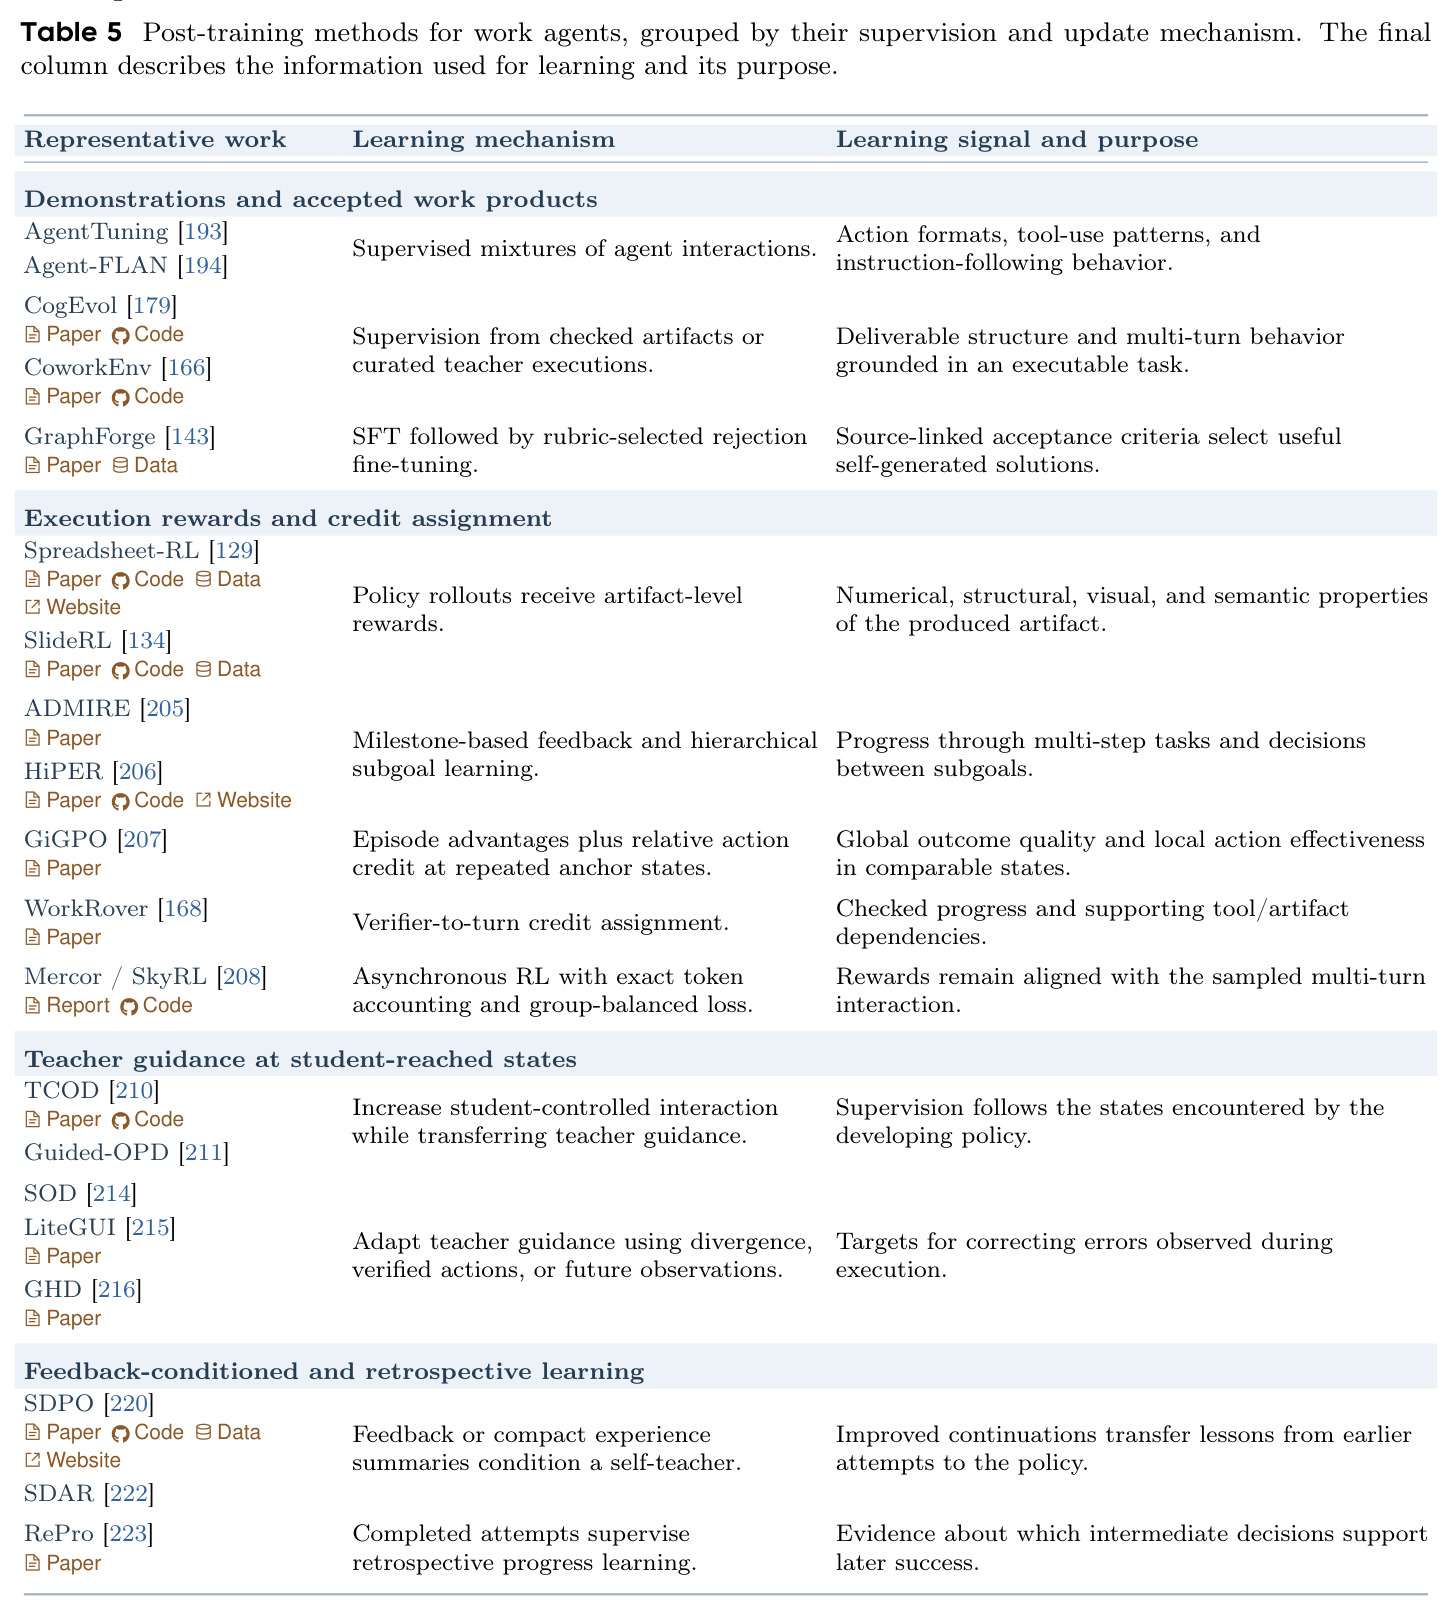
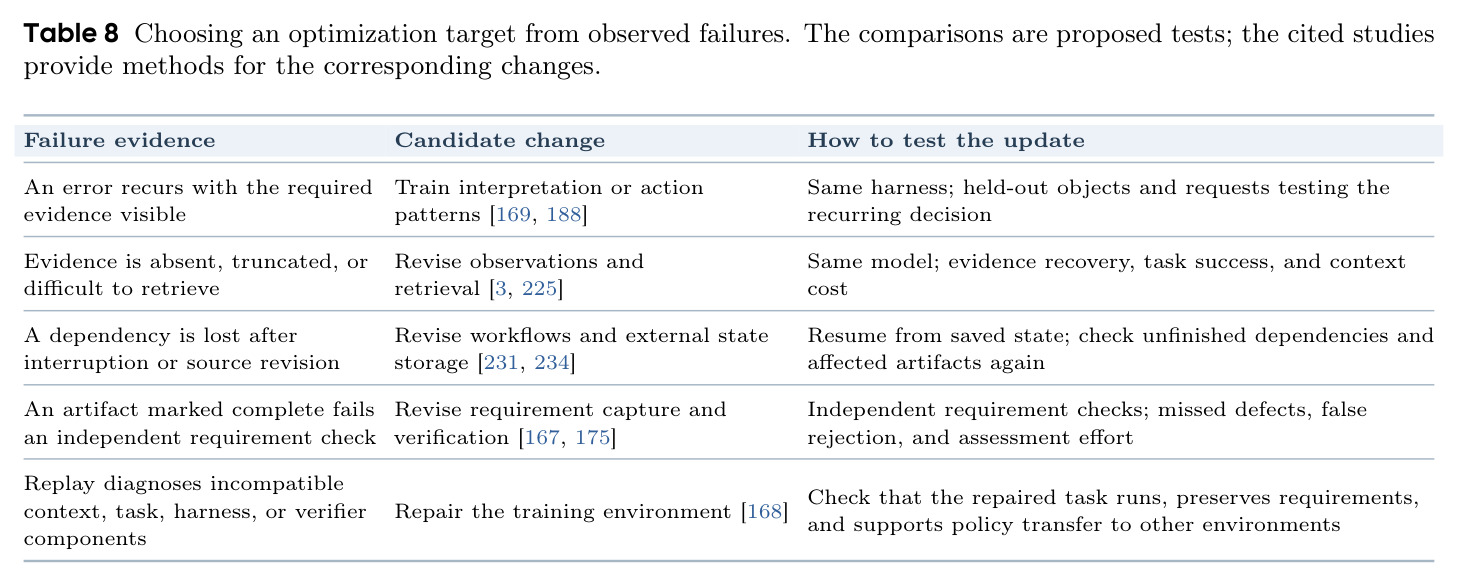
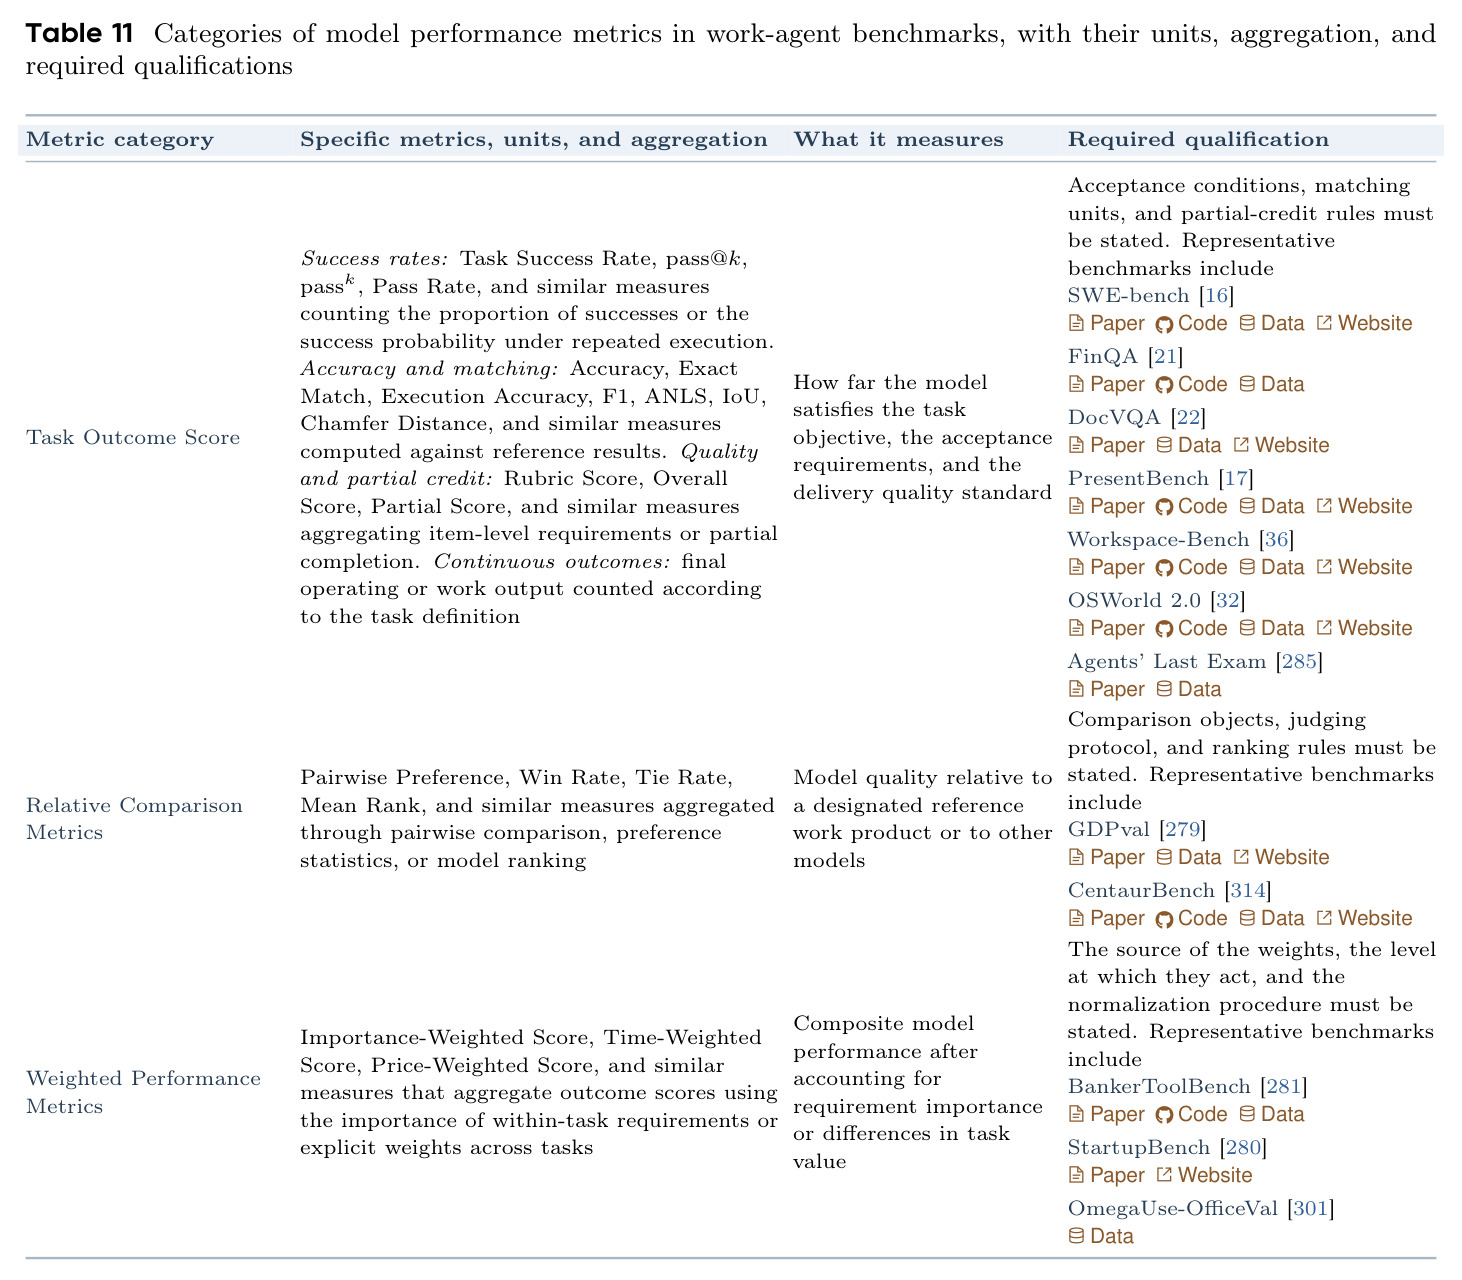
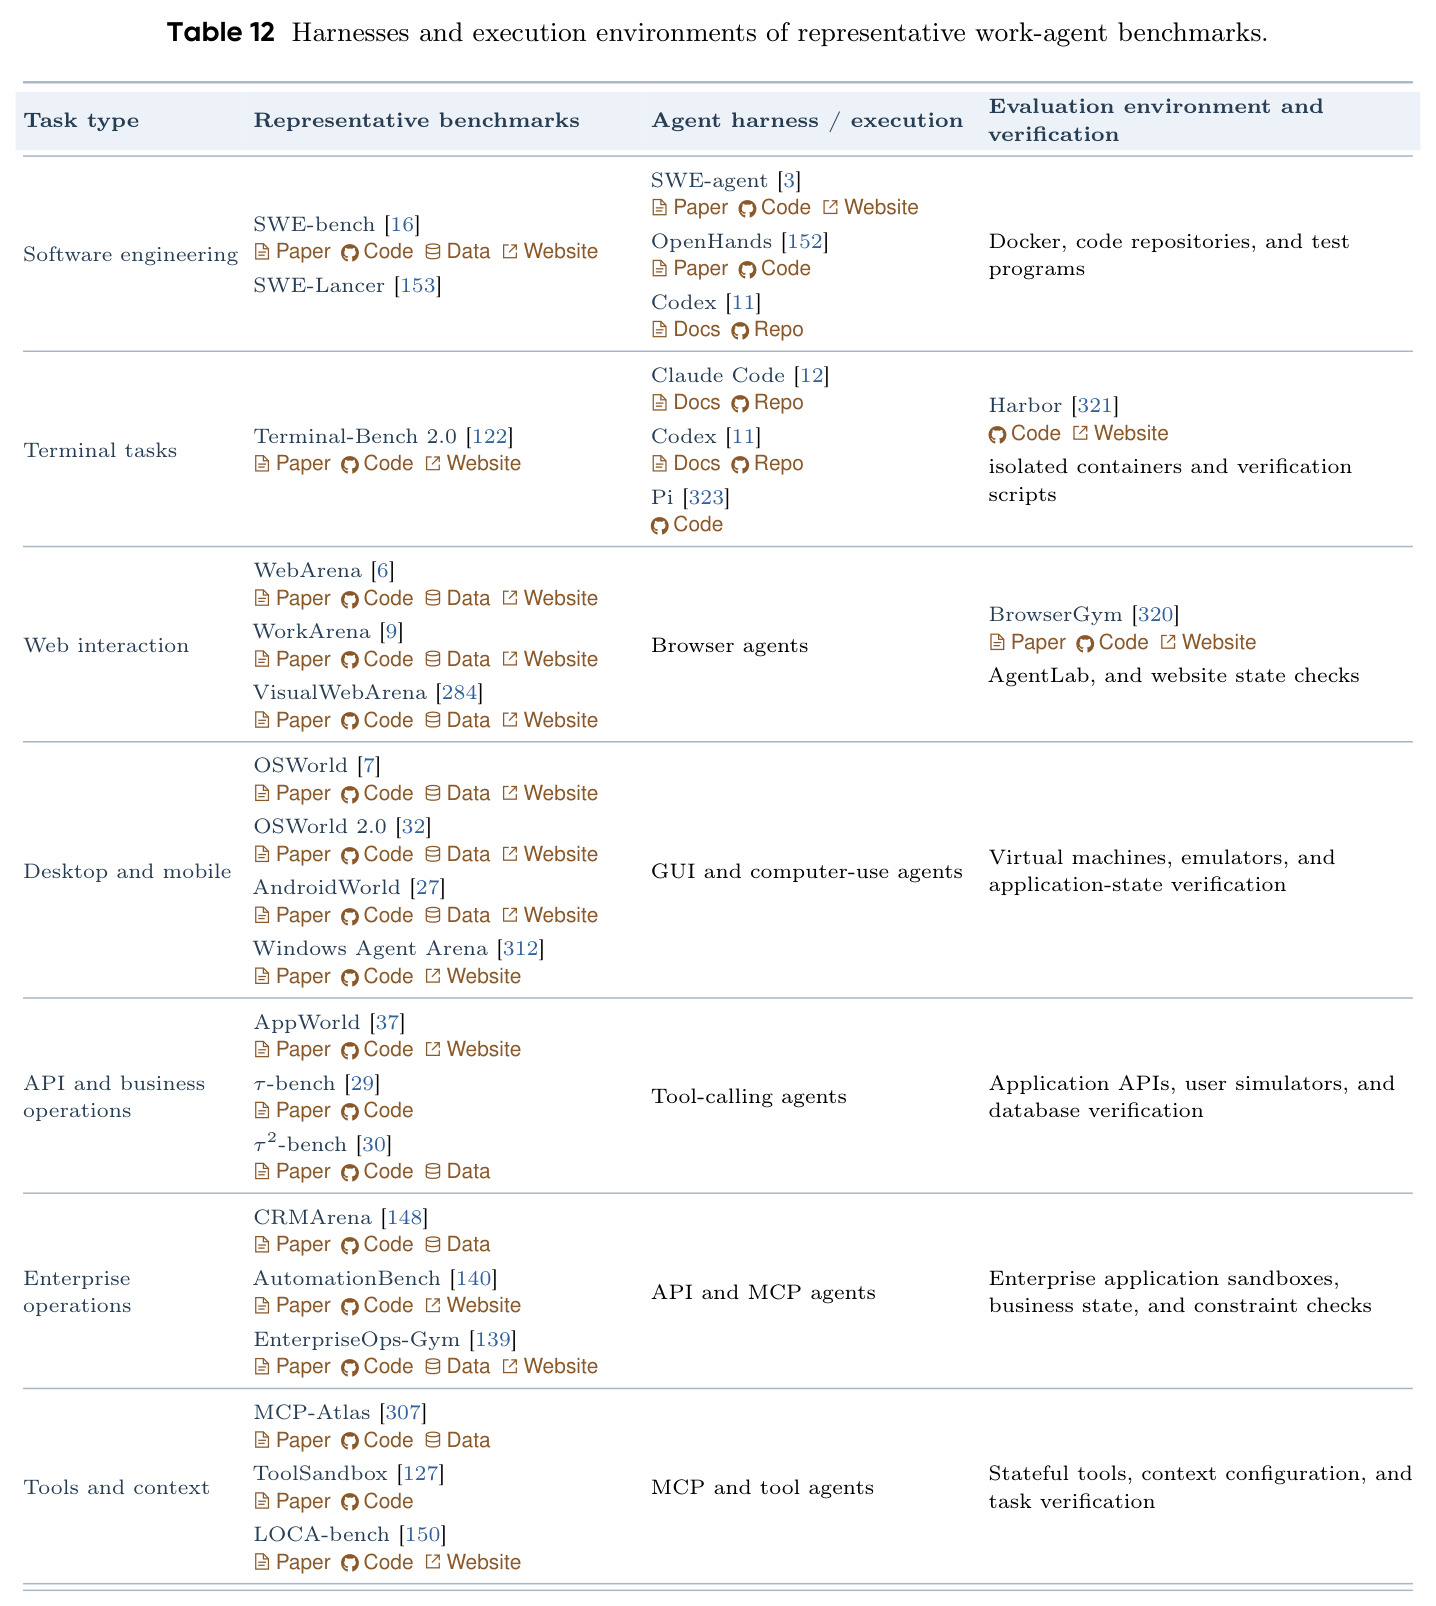
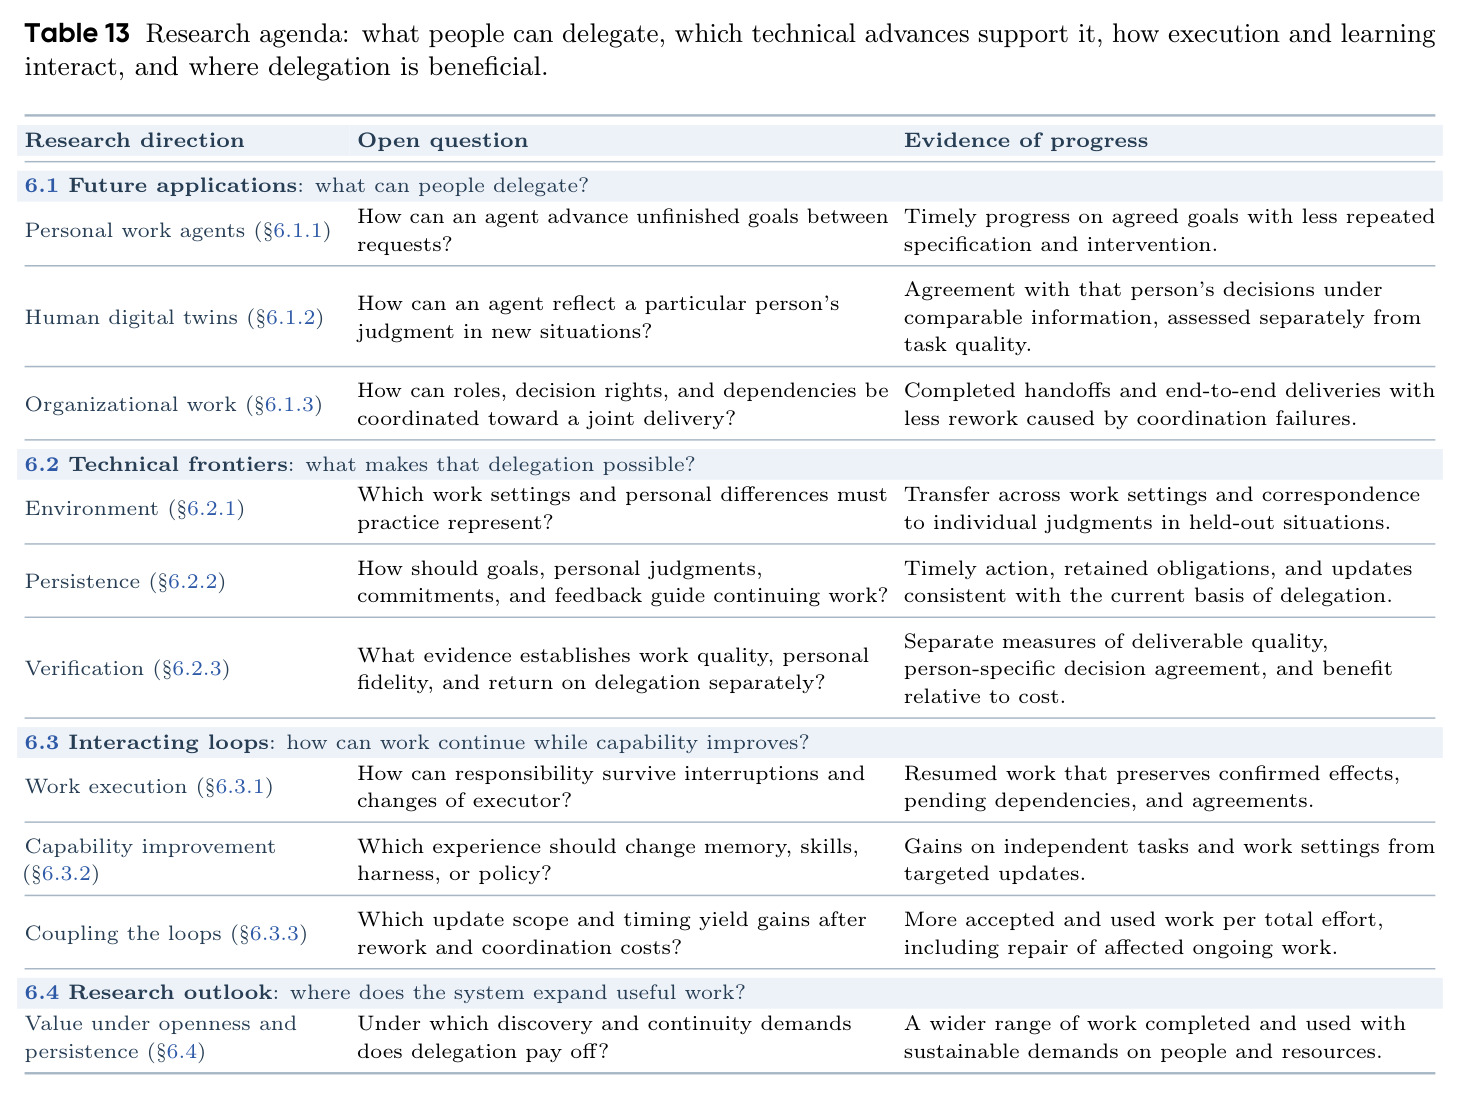
全文论证分六步。第一步(Section 2)定义六要素与方程 (1)(2),引入两维度并归纳五大能力族(Table 1 列出两维度各自抬高哪些能力的要求:高持续性要求重感知变化状态、跨等待期与交接保持计划、跨会话保持持久状态并避免重试副作用、对受影响结果再验证;高开放性要求执行中发现对象关系与权限、决定行动还是先收集信息、确立哪些来源算证据),并与长程/计算机使用/办公三种范式对照(Table 2)。第二步(Section 3)逐级分析五种形态及能力需求(Table 3):对话级如 FinQA 数值推理;原子动作级如 AndroidWorld 检查短信数据库中目标消息;多步级如 OSWorld 由付款记录决定提醒邮件收件人;工作流级如 τ-bench 需用户确认数据库更新、CXBench 分开打分流程合规与最终结果(「假通过」概念);工作空间级如 Workspace-Bench 要求自行发现文件依赖、Spider 2.0 通读 SQL/YAML/Markdown 完成数据转换并检查数据库终态。第三步(Section 4.1)梳理环境构建(daVinci-Env 从仓库重建任务、Spreadsheet-RL 配对工作簿+Excel 运行时、WorkForge 构造 16,665 个任务、WorkBorne 从 1,061 个产物语料产出 7,882 个环境与 15,485 条轨迹、CompoWorld 组合服务、Cowork-Gym 引入有状态用户)、轨迹策展(AgentTrek 教程重放、daVinci-Dev 重建 PR 历史、EnterpriseLab 从 schema 推导工具依赖)与反馈设计(Spreadsheet-RL 重算工作簿、GraphForge 把 rubric 项链接到源证据、CompoWorld 对低通过率标准加权的完成聚焦奖励、VERA 阶段检查与 WorkRover 的 verifier-to-turn 信用分配)。第四步(Section 4.2-4.3)覆盖模型预训练(NTP 损失 $\mathcal{L}_{\text{NTP}}(\theta) = -\mathbb{E}_{x\sim D}\sum_{t=1}^{|x|} \log p_\theta(x_t \mid x_{<t})$,文档结构/GUI 截图数据,Kimi K2 的知识改写)、中期训练(领域知识富集如 GLM-5 把相关文件/issue/PR/commit 组织成序列、交互模式熟悉如 Nemotron 500B token 混合、长上下文如 TrajLong 的状态重建任务)与后训练(SFT、执行奖励 RL、on-policy 蒸馏如 Guided-OPD、回顾学习如 RePro),以及 harness 的观察/动作界面(SWE-agent、TACO、PRISM 中间件)、流程与执行控制(GEPA 反馈式提示精炼、AFlow 工作流图搜索、Meta-Harness 修改 harness 代码、JIT-Agent 学习式设计器)、长上下文/记忆/技能(MemGPT、ReasoningBank、ACE、SkillOpt/SkillRL)。第五步(Section 4.4)讨论 harness 感知的策略训练(Agent Lightning)、联合适配(BetterTogether 交替提示与权重优化、Co-Harness、SIA 用奖励变化决定改 scaffold 还是训策略)与自演化/递归自改进(WorkRover 的 Factorial Compatibility Replay 环境修复、VERSE 让优化器程序本身演化)。第六步(Section 5-6)从结果视角重组评估(Table 8 给出失败证据→优化目标映射)并给出持续委托研究议程(Table 13)。
技术新颖性
与既有 agent 综述相比,新颖性有四点。其一,把「验证」提升为系统的第一等公民要素:结果必须对照任务要求用可观察证据核验(SWE-bench 跑测试、PresentBench 用模型评审执行清单、DeepPresenter 检查渲染幻灯片是三种典型证据形态),并据此提出用故意注入的错误测试 verifier 灵敏度——GraphForge 的损坏审计显示删除整张工作表使目标 rubric 降 0.377,而行级/数值/引用级细微错误变化小于 0.03(0-1 量表),说明验证必须分层设计。其二,持续性维度把「何时可以停」从「跑多久」中解耦,划清了与长程智能体研究的问题边界,也澄清了 METR 时间地平线度量的适用范围。其三,优化三分法明确追问每个能力应放在模型权重、检索上下文、可复用技能还是控制代码里,援引 Component Routing 的结论(界面定位等重复模式宜入权重、状态相关流程与事实宜留上下文),并给出四配置比较协议与「继续协议」(从同一保存工作区恢复)。其四,对递归自改进(RSI)提出可操作的评估设计:固定验收标准、共享资源预算、在保留任务上比较「更新后的优化器与冻结前代」,并强调要区分策略失败与环境缺陷(WorkRover:不一致的验证器该修环境而非继续训模型)。
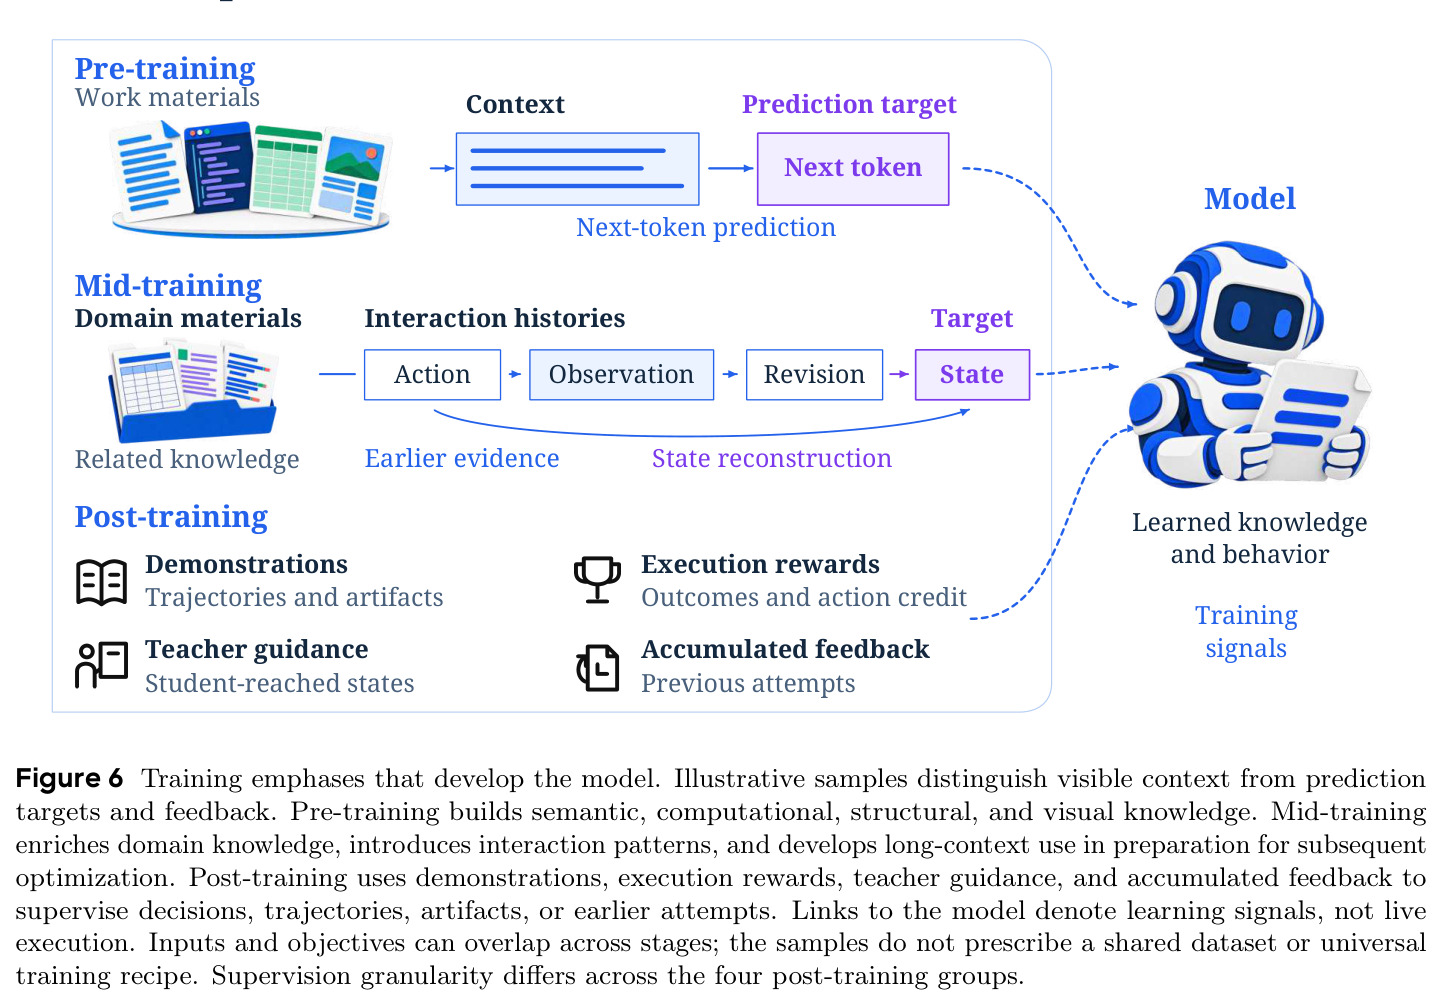
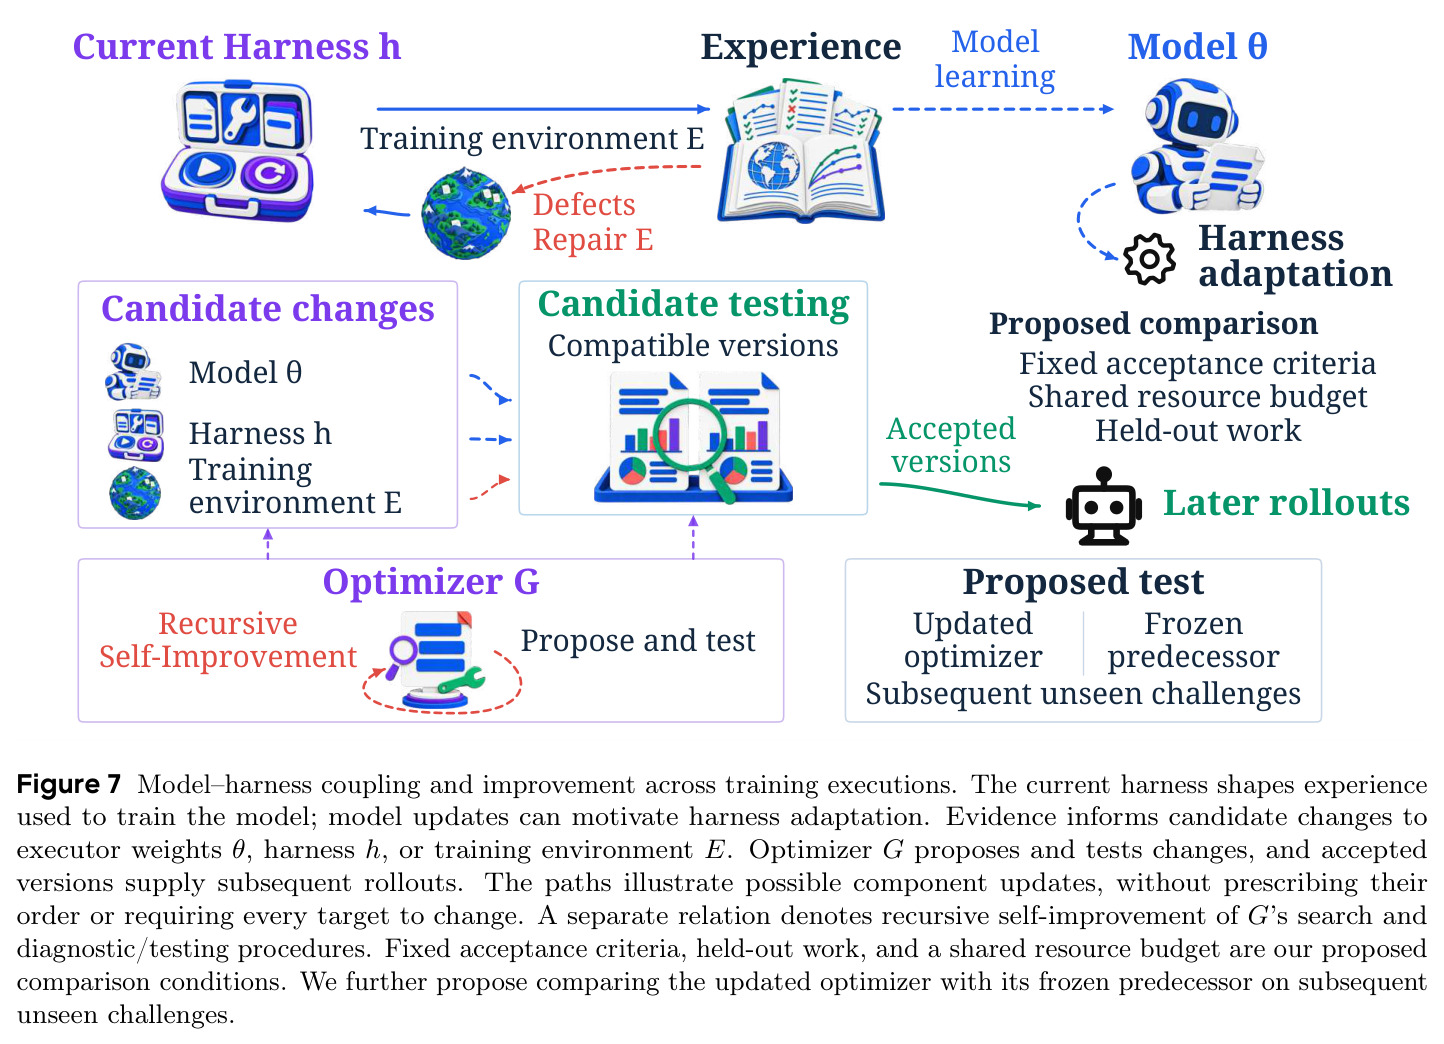
实验结果
本文没有自建实验,其「结果」是对文献实证的系统综合,但包含多个有数字的受控比较,逐一来看。(1) 训练环境组合化:CompoWorld 在相同骨干、相同训练流程与 1K SFT 轨迹下,把单服务环境换成组合服务环境,AutomationBench 成功率从 12.83% 升至 33.33%——跨服务依赖值得显式建模。(2) 数据规模与筛选:WorkForge 训练数据从 1K 增至 16K 轨迹使 ALE 提升 13.0 分、WildClaw 提升 8.4 分;同等 1K 轨迹下「程序+语义」双校验筛选 ALE 22.11,高于纯语义 15.62 与纯程序 14.89;WorkBorne 发现在 1K/3K/5K 轨迹预算下更广的产物覆盖优于更深的状态转移,8K 时两者持平。(3) 反馈设计:CoworkEnv 的教师轨迹 SFT 把 Claw-Eval 均分从 46.6 提到 64.1;VERA 阶段级反馈与 WorkRover 依赖驱动信用分配解决「最终结果不知归因于哪个早期决策」的问题。(4) 模型优化:Kimi K2 的「同一内容十种改写各用一次」比「原文重复十次」SimpleQA 准确率 28.94% 对 23.76%;Nemotron 在 500B token、256K 上下文的中期训练混合(含 10% agent 轨迹、20% 预训练重放)把 SWE-bench Verified Pass@1 从 60.7% 提到 64.5%(固定后续 SFT);其 100B token 消融中屏蔽工具响应(保留为上下文但不作为预测目标)使 Pass@1 从 27.5% 提到 37.8%;TrajLong 在固定 40B token 预算与相同后续 SFT 下,于全部 7 个消融基准胜过原始轨迹训练;函数感知 fill-in-the-middle 在受控 7B 比较中把 SWE-bench Verified+Lite 均值从 13.95 提到 15.60;Mercor/SkyRL 用 1,928 个专家任务与精确 token 记账做 RL,397B 模型在保留集 APEX-Agents Pass@1 从 16.11% 升到 27.29%。(5) 联合优化与自演化:WorkRover 最小修复集环境修复的安全率 70.3% 高于完全再生的 60.7%,且三代修复稳定在 70.3-72.4%;对照「应用全部修复」,其跨任务回归 0.7% 对 7.0%,归一化 token 成本 1.00 对 0.59(更安全但更贵);VERSE 受控比较(测试准确率:基线 39.20、仅可执行验证 39.81、仅优化器自演化 31.79、两者兼用 41.05)表明没有可执行验证时自演化反而有害。(6) 评估侧:79 个基准被按四层评估目标与三类指标归类,MMLongBench-Doc 的 PDF 平均 47.5 页、GDPval 用专家盲评对比模型与人类交付物,作者反复强调分数不可跨基准直接比较。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 训练环境组合化(CompoWorld,AutomationBench 评测) | 任务成功率 | 33.33%(组合服务环境) | 12.83%(单服务环境) | +20.5 个百分点(相同骨干、流程与 1K SFT 轨迹) |
| SWE-bench Verified(Nemotron 中期训练) | Pass@1 | 64.5% | 60.7%(无该中期训练混合) | +3.8 个百分点(固定后续 SFT) |
| SWE-bench Verified(Nemotron 100B token 预测目标消融) | Pass@1(相同 SFT 后) | 37.8%(屏蔽工具响应、保留为上下文) | 27.5% | +10.3 个百分点 |
| APEX-Agents 保留集(Mercor/SkyRL 知识工作 RL 配方) | Pass@1 | 27.29%(397B 模型) | 16.11% | +11.18 个百分点 |
| 训练数据规模(WorkForge) | ALE / WildClaw 分数 | 16K 轨迹:ALE +13.0 分、WildClaw +8.4 分 | 1K 轨迹 | ALE +13.0、WildClaw +8.4 |
| 任务筛选校验(WorkForge 1K 轨迹消融) | ALE 分数 | 22.11(程序+语义双校验) | 15.62(仅语义)/ 14.89(仅程序) | +6.49 / +7.22 分 |
| 教师轨迹 SFT(CoworkEnv,Claw-Eval) | 平均分 | 64.1 | 46.6(无 SFT) | +17.5 |
| 训练环境修复(WorkRover 自然缺陷研究) | 安全修复率 | 70.3%(最小修复集,三代稳定在 70.3-72.4%) | 60.7%(完全再生) | +9.6 个百分点;对照全部修复:回归 0.7% 对 7.0%,token 成本 1.00 对 0.59 |
| 优化器自演化(VERSE 受控研究) | 测试准确率(%) | 41.05(可执行验证 + 优化器自演化) | 39.20(基线)/ 39.81(仅验证)/ 31.79(仅自演化) | +1.85 对基线;证明无验证时自演化有害 |
| 数据改写策略(Kimi K2 早期检查点) | SimpleQA 准确率 | 28.94%(十种改写各用一次) | 23.76%(原文重复十次) | +5.18 个百分点 |
局限与改进
作者承认的局限包括:VERSE 的自演化比较每个条件只跑一次演化,结论是示意性的;文中提出的四配置比较协议、RSI 前后代比较与 continuation protocol 只是提案并未执行;分类学基于 2023-2026 年 90 个代表工作与 79 个基准,属选择性样本。我自己的观察:第一,综述没有给出任何统一量化证据检验自己的框架——两维度、五能力族之间的相关性或对失败的预测力从未被测量;第二,persistence/openness 缺少操作化度量(多少次外部事件算「高持续」?要发现多少对象算「高开放」?),难以自动把新基准映射进框架;第三,经济价值一节实证薄弱,主要依赖间接证据(Change.org 自然实验发现 AI 写作辅助普及后请愿语言变化但平台层面结果未改善、经验开发者研究显示被测 AI 工具反而增加完成时间),agentic ROI 更像概念倡议而非可计算指标;第四,安全、隐私、越权只在零星例子中出现(τ-Knowledge 银行域的卡解锁需查安全锁定并升级到安全团队、CI-Work 的敏感信息泄漏率),对「被委托的员工」这一隐喻而言,权限边界与审计的讨论明显不足;第五,领域迭代极快(文中已引用 2026 年 10 月发布的 Claude Duet),具体条目会快速过时,但框架性主张相对耐用。
独立分析的弱点
独立分析四个弱点。(1) 框架可操作性不足:五能力族与两维度的划分主要靠叙事举例支撑,没有给出判定一个失败属于哪种能力、一个任务处于哪个象限的可计算特征,工程团队很难用它自动诊断自己的系统。改进方向:为每类失败定义可检测信号(如「证据缺失型失败」对应检索日志空命中、「状态不一致型失败」对应 committed 但未 verified 的操作),把 Table 8 的失败-目标映射做成半自动诊断工具。(2) 提出的评估协议成本过高:四配置比较要求在保存工作区上恢复运行,RSI 比较要求保留优化器前后代并在保留任务上对打,中小实验室无法承受。改进方向:先在 7B 级模型与轻量环境(Spreadsheet-RL 类工作簿运行时)上给出最小可行版本,验证协议区分力后再推广。(3) 验证被视为潜在瓶颈但缺乏量化框架:文中指出「执行越快越并行,验证越可能成为瓶颈」,却没有给出验证成本-召回权衡的度量或「哪些检查需重跑、哪些证据仍有效」的调度算法。改进方向:把增量验证形式化为依赖图上的重验证子集选择问题并分析复杂度。(4) 安全与委托边界薄弱:工作空间包含真实业务记录与其他协作者,重复发消息、越权读上游工作簿等错误动作的代价被轻描淡写,也缺少多智能体场景下的责任归属讨论。改进方向:把执行状态四分与权限模型、审计日志结合,定义「委托合同」的形式语言,使越权可静态检出。此外,综述对多智能体失败模式(通信结构、验证缺失导致的级联错误)只引用了少数实证分析,组织工作系统的讨论仍偏概念。
未来方向
作者提出的前沿包括三类应用与三大技术方向。应用上:个人工作智能体(在请求之间推进未完成目标,Claude Duet 已示范检查连接应用、准备简报、用户离开时继续任务并在完成或需决策时通知);人类数字孪生(代表特定人的专业判断,需把工作质量与「个人保真度」分开评估,在保留案例上对照本人的决策);组织工作系统(跨角色协调责任、决策权与相互依赖的贡献,如修订后的销售估计需分析师更新预测、他队确认假设、经理授权发布)。技术上:环境(覆盖 O*NET/GDPval 式职业分布、通过连续活动回合生成带历史与竞争版本的工作空间、支持中断续跑的执行基础设施如 DSec 分离有状态 rollout 与可抢占 GPU 训练、按学习增益分配练习预算);持续性(锚定当前工作的记忆、区分用户偏好/承诺/授权的记忆条目、由未了责任驱动的主动性);验证(工作质量、个人保真、委托回报三者分别取证,StateGuard 式有效性图谱追踪新数据何时使已接受的分析失效)。最后是执行循环与能力改进循环的耦合:更新会沿依赖传播(新预测方法可能改动他队已用的预算估计),需比较不同更新粒度与时机下的净收益,包括「稳定任务模板反而是更优选择」的情形。可延伸方向:把两维度做成可计算标尺并发布标注数据集;工作空间级 provenance 标准;把验证调度作为独立研究问题;安全视角下的委托合同形式化。
复现评估
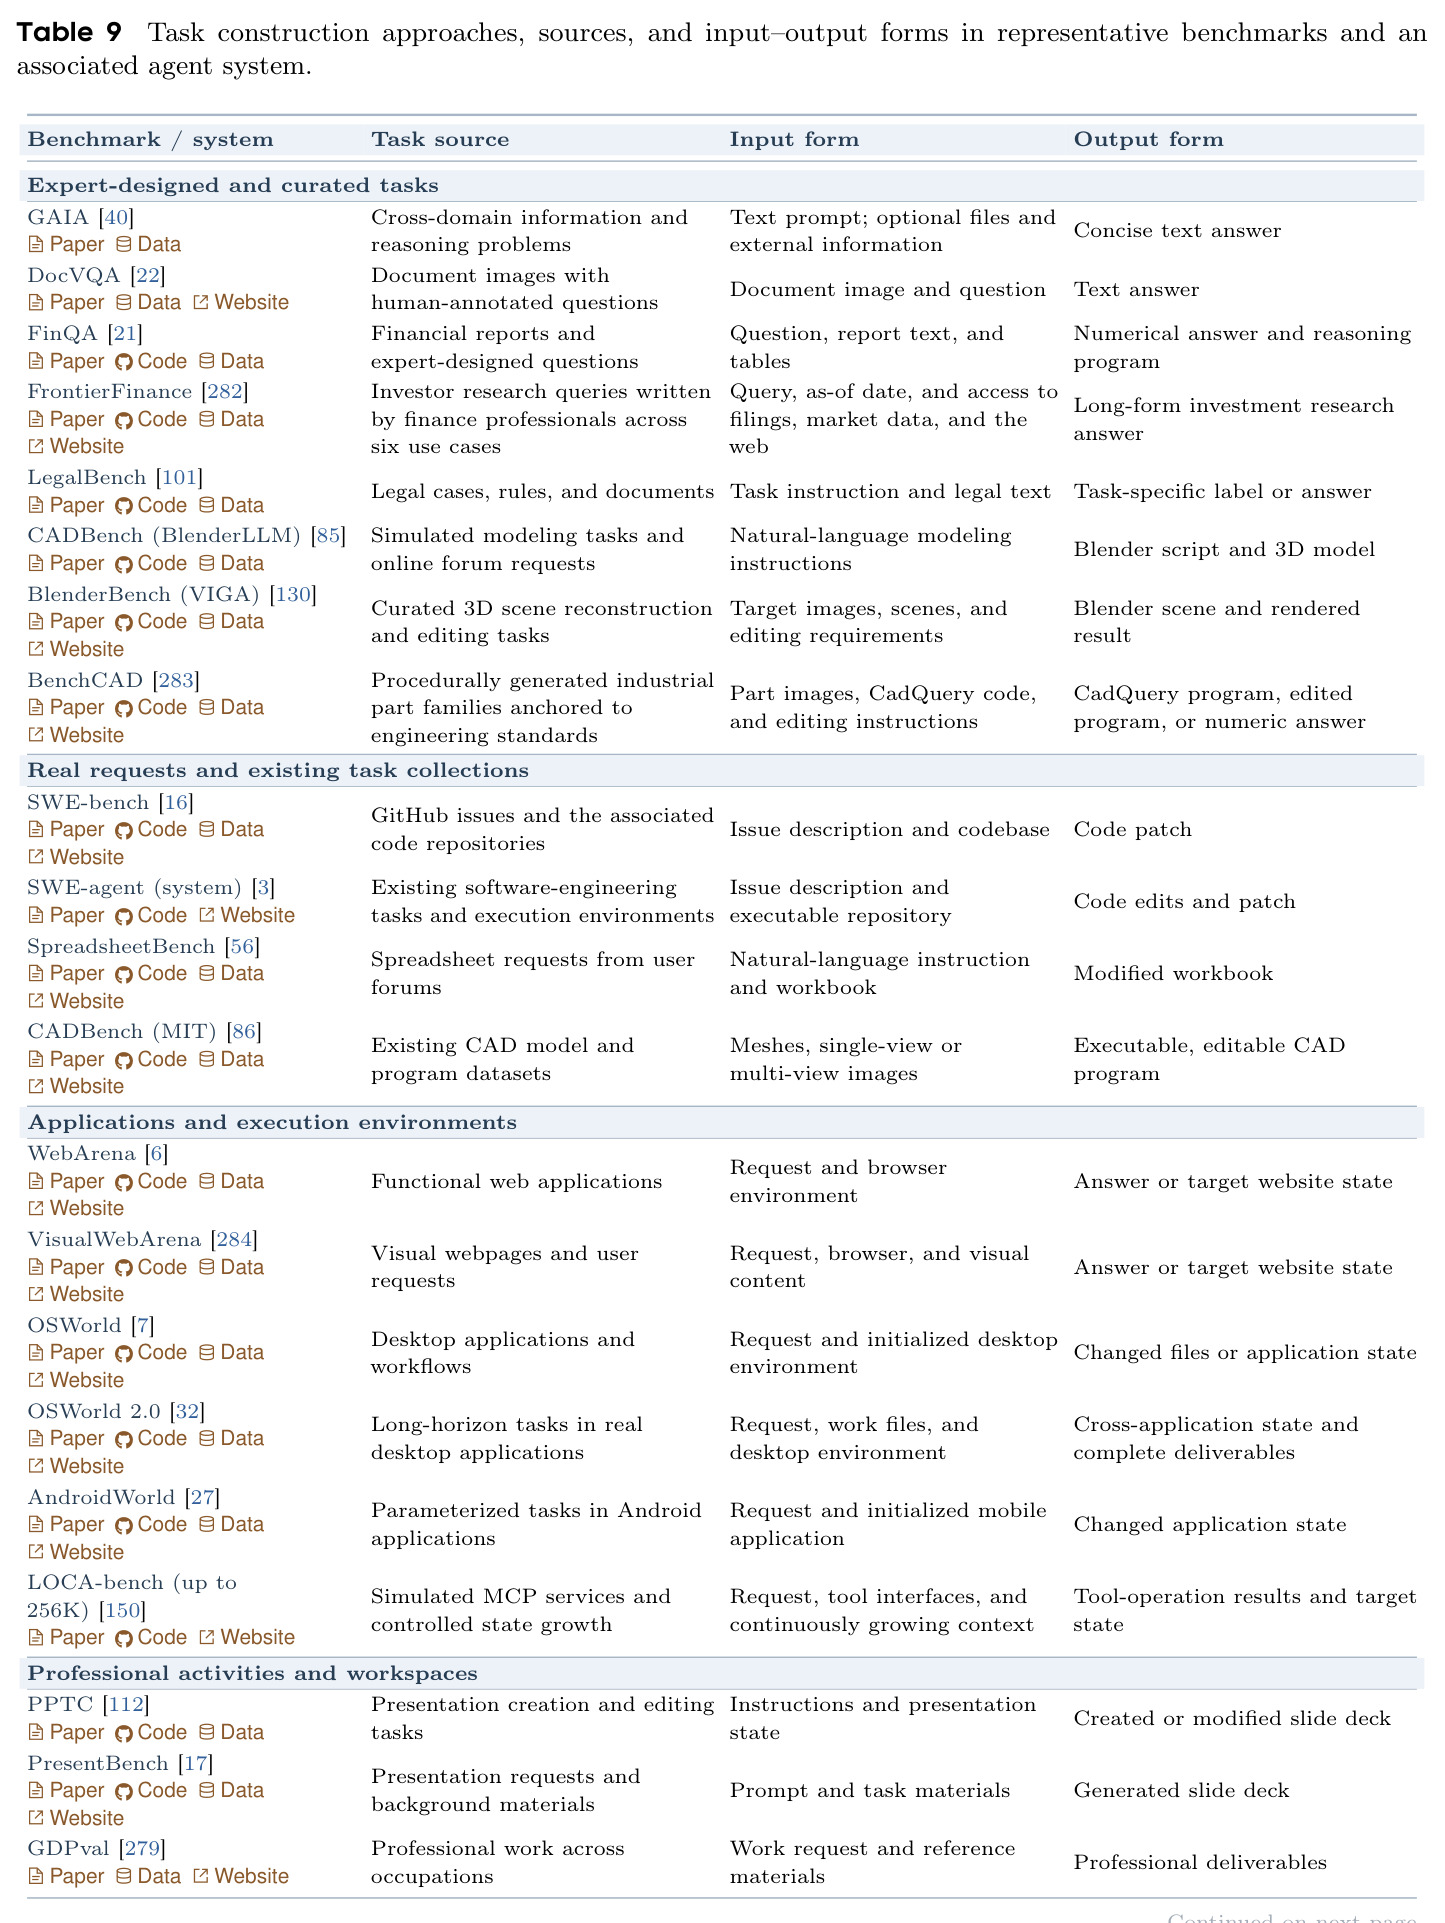
作为综述,本文本身没有可复现实验,但其配套资源对复现他人工作极为有用:论文提供 Awesome Work Agents 列表与项目主页,Table 4-12 对每条引用逐条标注 Paper/Code/Data/Website 链接,SWE-bench、OSWorld、τ-bench、Workspace-Bench、GraphForge、Spreadsheet-RL、Agent Lightning 等主要基准与环境基本开源。复现难度两极分化:文中引用的 397B 模型 RL(Mercor/SkyRL,需 1,928 个专家任务与精确 token 记账基础设施)、500B token 中期训练(Nemotron)属于大厂级算力,需多节点 GPU 集群与工程团队,普通团队无法负担;而 7B 级消融(函数感知 fill-in-the-middle 使 SWE-bench Verified+Lite 均值 13.95→15.60)、40B token 预算的 TrajLong、VERA/WorkRover 的中等规模流程可在单机或小集群复现。对读者的现实建议:把本文当「设计检查清单 + 文献地图」使用成本极低——设计新基准时对照 Table 9 的四类构建策略与 Table 10 的四层评估目标,选择优化目标时对照 Table 8 的失败-目标映射——这不需要任何算力;要复现具体数字则必须回到对应原始论文,本文只提供导航。
论文图表
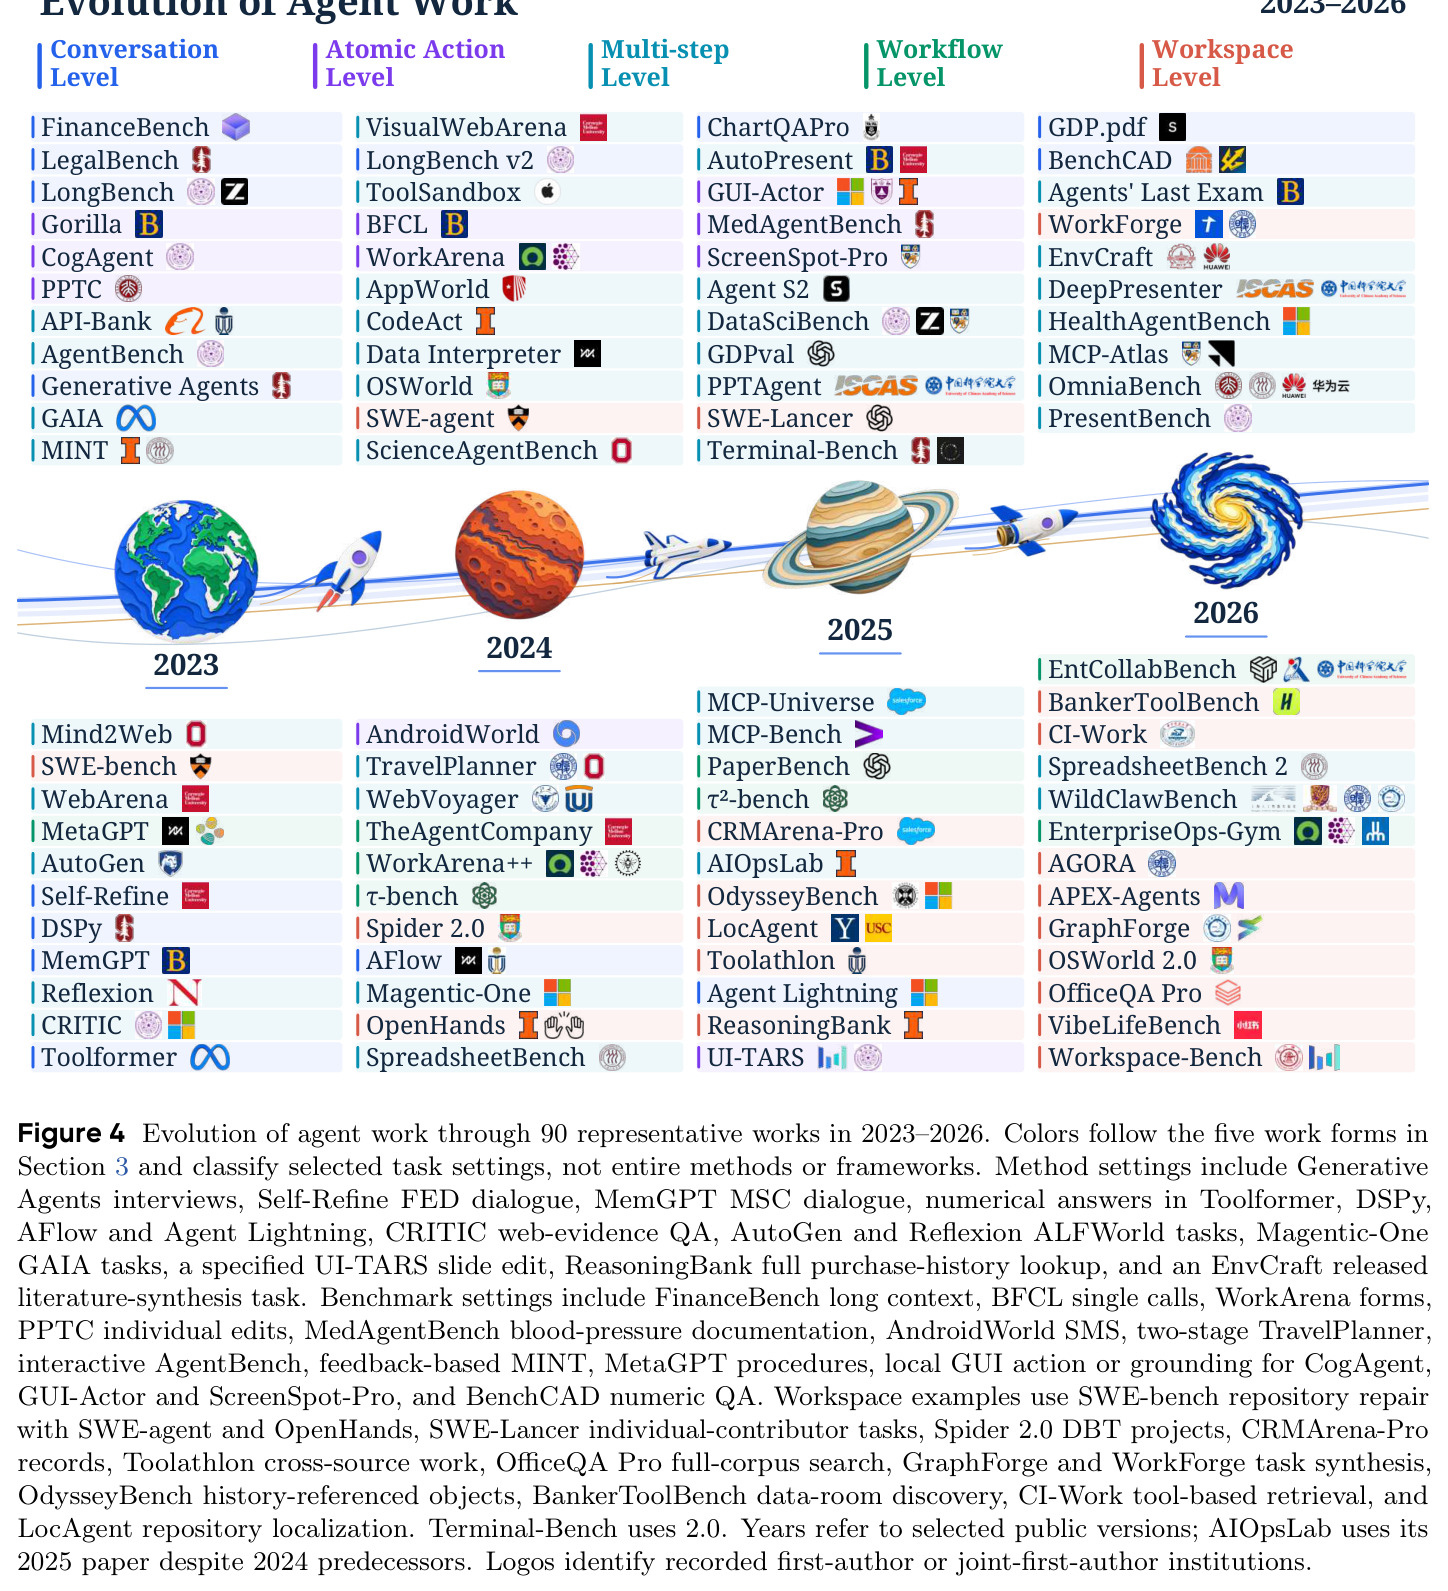
时间线图,按五种工作形态(对话级/原子动作级/多步级/工作流级/工作空间级)着色,把 2023-2026 年 90 个代表性工作排布在时间轴上:从早期 SQuAD、Gorilla、API-Bank 类对话级与工具调用,到 OSWorld、SWE-agent、TravelPlanner 类多步级,再到 τ²-bench、PaperBench、MCP-Universe 类工作流级,最后是 OSWorld 2.0、VibeLifeBench、Workspace-Bench、EntCollabBench 等 2026 年的工作空间级任务。机构 logo 标注一作机构。
一图看清领域重心的逐年上移:任务范围与组织复杂度持续扩大,为「为什么现在需要 work-centric 框架」提供了版图证据。
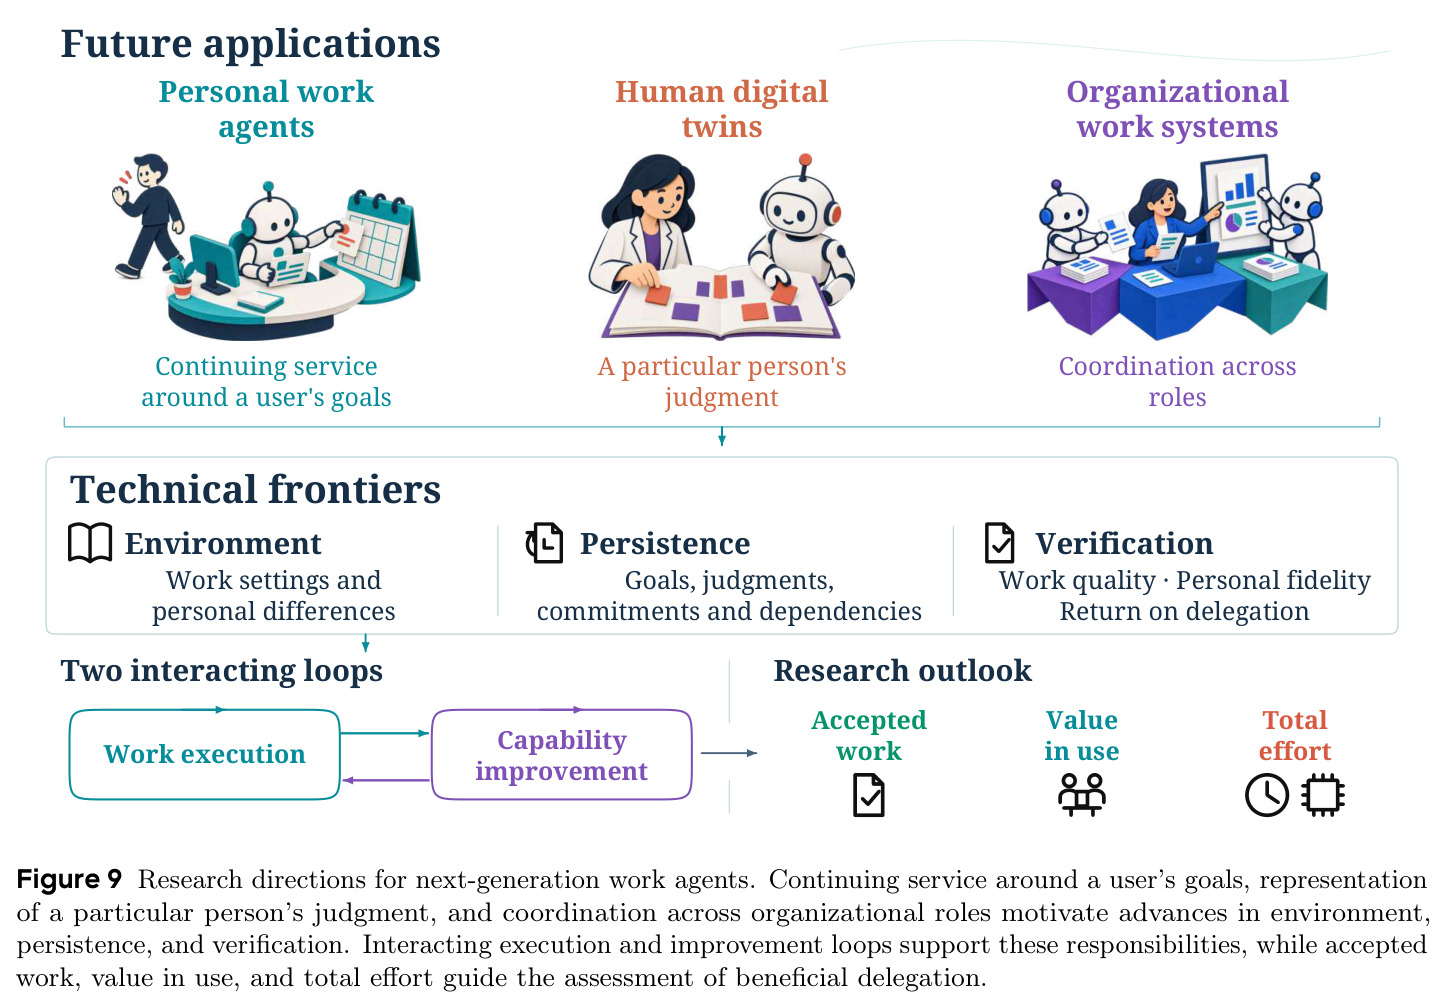
研究方向的层次图:顶层是三类未来应用(个人工作智能体——围绕用户目标持续服务;人类数字孪生——代表特定人的判断;组织工作系统——跨角色协调),中层是三大技术前沿(环境——工作设定与个人差异;持续性——目标、判断、承诺与依赖;验证——工作质量、个人保真与委托回报),底层是两个相互作用的循环(工作执行循环与能力改进循环)和评估委托是否值得的三项证据(被接受的工作、使用中的价值、总投入)。
第 6 章的导航图:把「应用→技术→循环→评估」的研究议程一次性铺开,Table 13 的每个研究问题都能在这张图上找到位置。
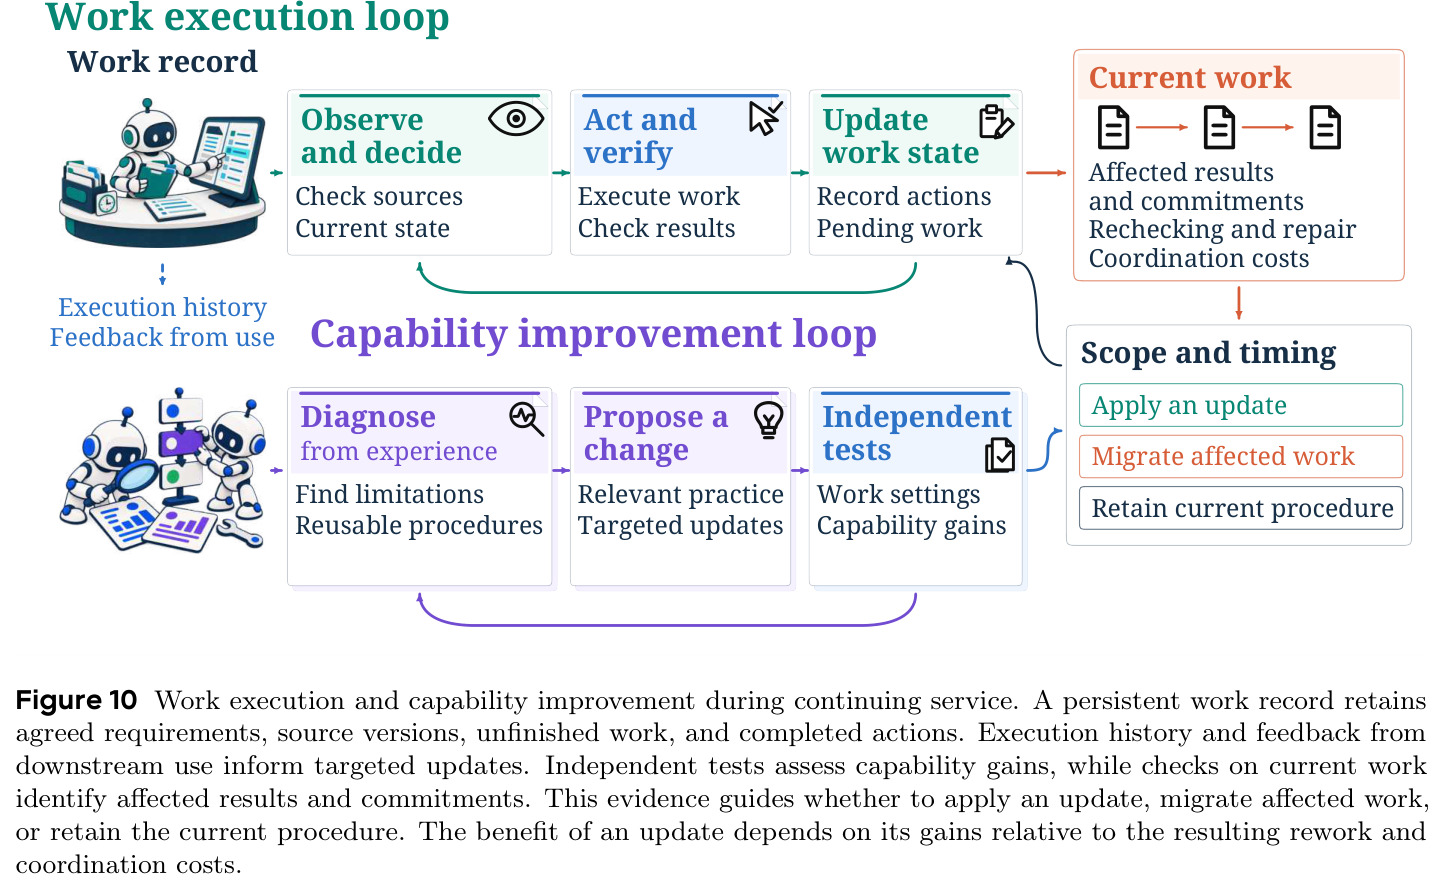
展示持续服务期间的两个循环如何交互:工作执行循环(观察决策→行动验证→更新工作状态)依赖持久工作记录(约定需求、源版本、未完成工作、已完成动作);执行历史与下游使用反馈进入能力改进循环(发现局限→构造相关练习→提出改动→独立测试);上方的作用路径表示更新沿依赖传播——需检查受影响结果与承诺、承担重检与修复、支付协调成本,最终决定是应用更新、迁移受影响工作还是保留现有流程。
解释「边工作边学习」的核心矛盾:一个新流程可能改进未来报告,却改动了他队已使用的估计;这张图给出追踪更新影响范围的机制框架。
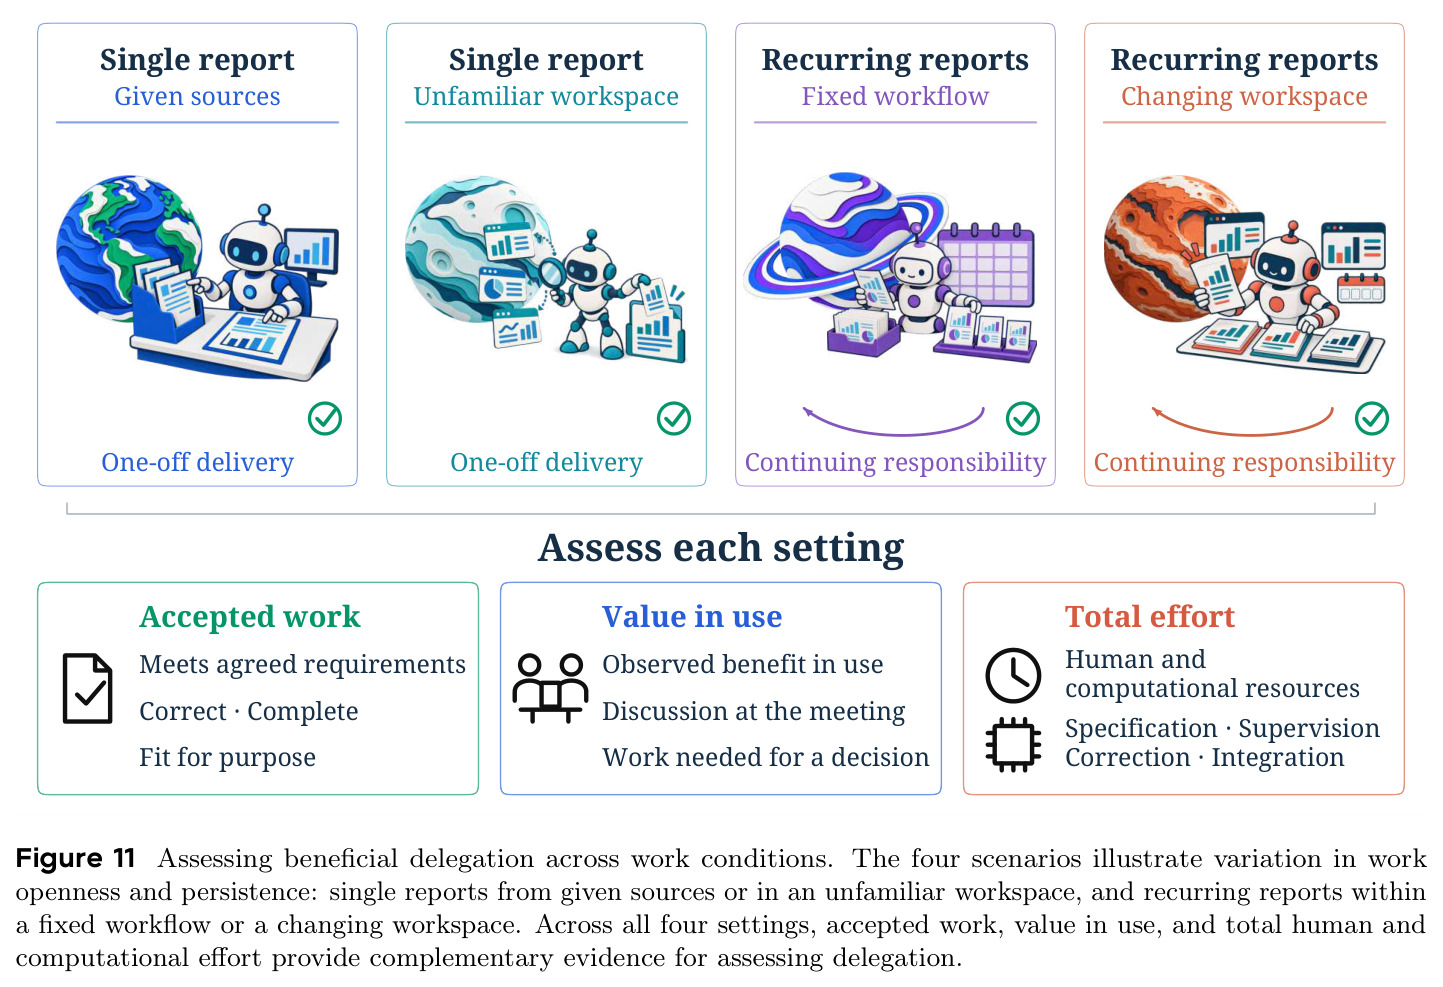
四种场景对比:单一报告+给定来源、单一报告+陌生工作空间、周期性报告+固定流程、周期性报告+变化工作空间,分别对应开放性与持续性的不同组合;对每种场景都要用三项互补证据评估委托是否有益——被接受的工作(正确、完整、合用)、使用中的价值(支撑了会议讨论、减少达成决策所需工作)、总投入(说明、监督、纠正、集成的人力与算力)。
把第 2 章的两维度贯穿到最终研究展望:委托是否有益必须在「开放×持续」的不同组合下分别测量,这是全文评估主张的落点。