GraphForge:以证据图锚定的真实文件工作区合成训练实战智能体 GraphForge: Training Working Agents with Graph-Anchored Workspace Synthesis
用真实文件证据图合成可验证任务,微调出更强的实战智能体
前置知识
工作智能体与脚手架
工作智能体指能长期操作文件系统、数据库和终端,阅读多种格式文件并产出可交付成果的 LLM 代理(如 OpenClaw、Hermes-Agent)。脚手架是包裹模型、提供工具循环与文件访问的运行框架,如 OpenHands、Codex 和 Claude Code;同一模型在不同脚手架下表现不同,因此公平比较必须在同一脚手架内进行。
本文的训练对象就是工作智能体,三个评测基准都依赖特定脚手架,理解脚手架才能读懂实验设置与'跨脚手架迁移'这一结论。
SFT 与拒绝微调(RFT)
SFT(监督微调)直接在教师模型产生的完整轨迹上训练学生模型。RFT(拒绝微调)则让当前模型自己对每个查询采样多条(本文 $K=4$ 条)轨迹,用验证器或评委选出最优者,再在这些被接受的轨迹上继续微调,本质是拒绝采样与微调的结合。
论文的两阶段训练正是先在 2,169 条教师轨迹上做 SFT,再用评分准则从候选池选优做 RFT,这是理解全部实验设计的骨架。
证据图
一种中间数据结构:节点 $v$ 记录某个源文件提供的事实或字段及其在任务中的角色,边 $e$ 记录解读、对比、对账或推导所需的跨文件依赖关系。它不是真值,图上每个断言都必须能从原始文件恢复。任务陈述和评分准则都从该图编译而来。
证据图是 GraphForge 的核心构件,标题中的'图锚定'即指每条评分准则都锚定到图节点集合 $A_k \subseteq V_i$。
O*NET 与 DWA
O*NET 是美国官方职业信息数据库,提供职业、任务陈述及受控词表'详细工作活动'(DWA),并附带任务到 DWA 的官方映射。DWA 相当于标准化的任务类型标签,可用于控制系统性多样性;AI4Work 还为每个任务标注了是否数字可执行(DIGITAL)。
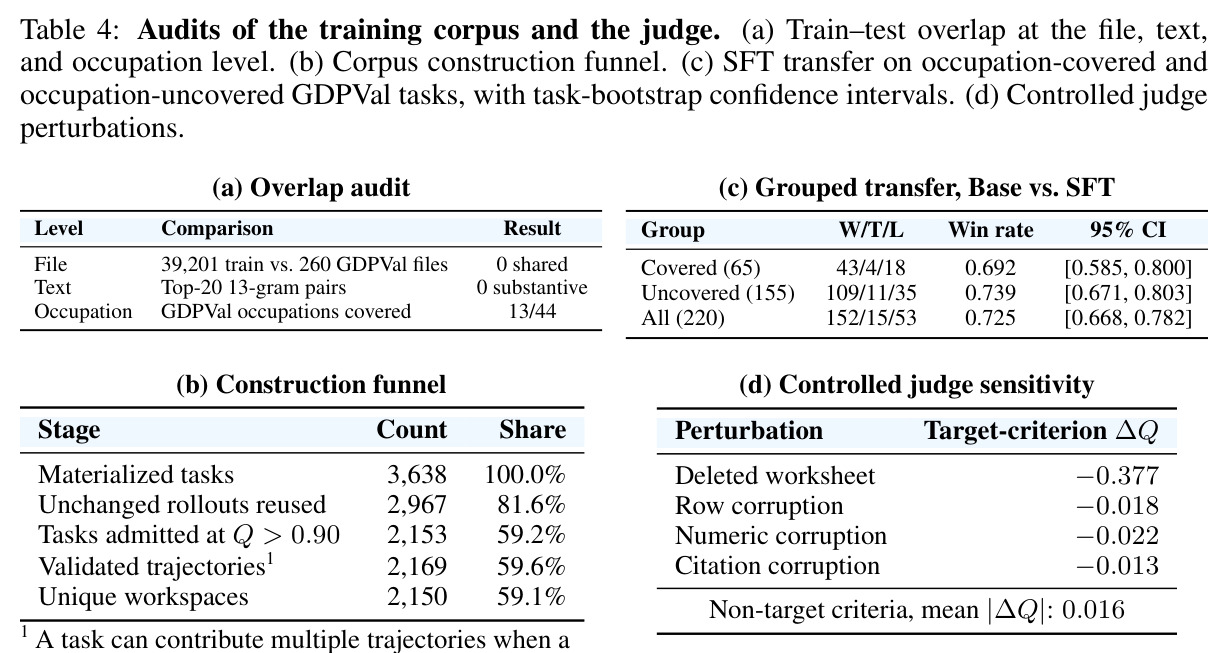
本文种子全部来自 O*NET(246 个职业、891 种 DWA),且 GDPVal 共享该分类体系,这既是多样性控制的基础,也是污染审计的依据。
Bradley–Terry 模型与 Elo 评级
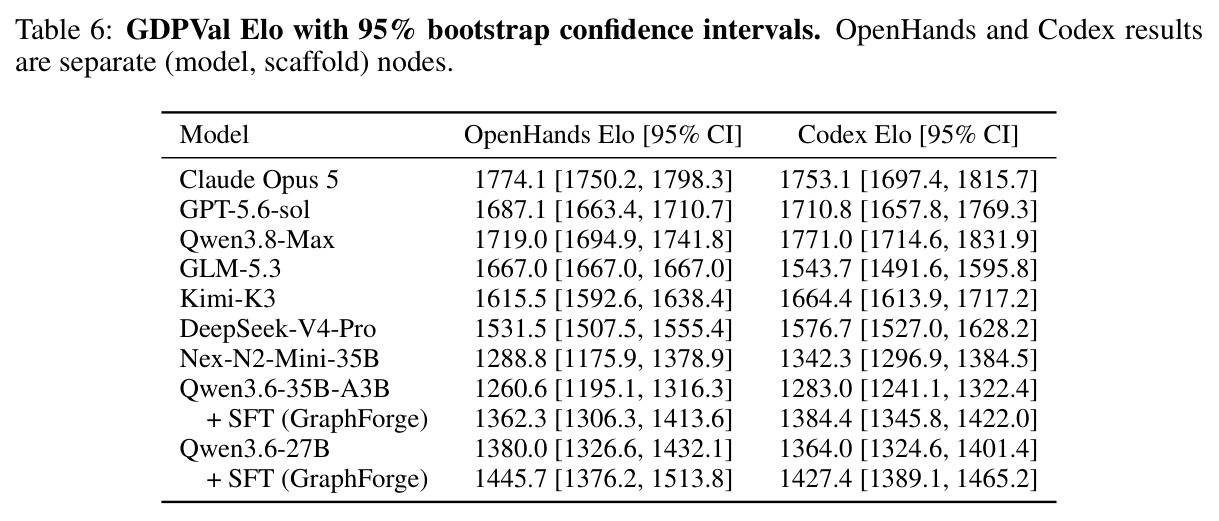
Bradley–Terry 是成对比较统计模型,为每个选手拟合强度参数 $\theta_i$,规定 $Pr(i \succ j)=\sigma(\theta_i-\theta_j)$。Elo 是其常用刻度,400 分差距对应十倍胜率优势,本文用 $Elo_i=1667+\frac{400}{\ln 10}(\theta_i-\theta_{anchor})$ 换算,并以 GLM-5.3(OpenHands)=1667 固定锚点。
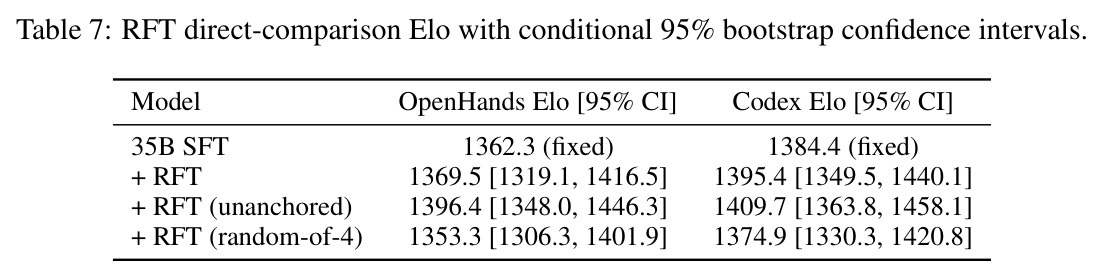
GDPVal 主结果以 Elo 报告,理解锚定方式与 bootstrap 置信区间的含义,才能正确判断论文结论(尤其 RFT 各臂差异)的统计强度。
基于准则的 LLM 评委
用 LLM 按评分准则逐条核查产出并打分的自动评估方式。本文评委额外获得证据锚点(应查哪些文件)与验证说明 $\phi_k$,对每条正向准则给出满足比例 $a_{ik}\in[0,1]$,对有直接证据的违规按负向准则扣分,最终合成加权质量分 $Q_i(\tau)$。
轨迹准入、RFT 轨迹选择和 GDPVal 成对比较全部依赖这一评委机制,其敏感性实验(Table 4d)直接关系到整个框架的可信度。
研究动机
让大模型智能体从对话走向真实办公——阅读多种格式的文件、协调工具并产出可交付成果——需要大量构建在真实文件之上且结果可验证的训练任务,而这类数据合成流水线极为稀缺。现有两条路线各有硬伤:EnvCraft 用模型生成工作区文件并合成 2 万个任务,但合成文件缺乏真实感与多样性,其 Python 状态检查脚本无法读取文档内容,难以发现交付文档中的事实错误;NexForge 把任务建立在真实文件上(约 5.6K 任务),却既没有任务专属评分准则也没有验证器,产出质量完全无法系统检查。此外,放任模型自由发明任务会导致分布塌缩:任务集中于高频职业和泛泛的通用分析类型,多样性失控。如何在真实文件上构建多样任务并为其配备可靠验证准则,成为训练工作智能体的核心瓶颈。
本文的目标是本文的具体目标是构建端到端数据合成框架 GraphForge:从职业种子出发,在真实爬取的文件工作区上自动合成包含任务陈述、交付要求和可验证评分准则的任务规范,再用强教师模型采集长程工具使用轨迹,最终微调出更强的工作智能体。量化目标有三层:其一,覆盖广度——种子取自 O*NET 经数字可执行性过滤后的 246 个职业、16 个行业和 891 种 DWA 任务类型,共 3,419 个职业-任务型对;其二,验证可靠性——每条正向评分准则都锚定到具体源文件集合,评委可据此逐条核查;其三,实际收益——在 GDPVal、Workspace-Bench-Lite 和 SpreadsheetBench II 三个基准上显著超越基座模型,并验证证据锚定信息能为拒绝微调提供有效的轨迹选择信号。
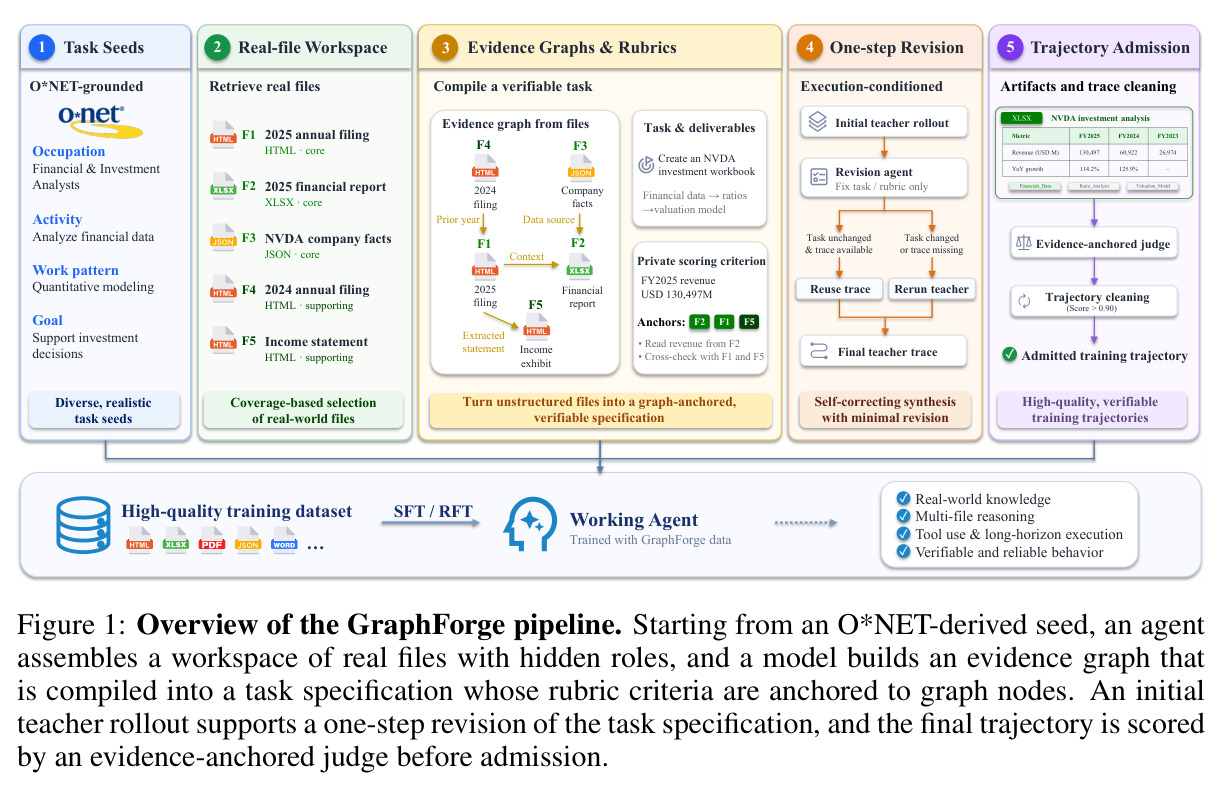
与已有工作不同的是,论文的独特切入是把任务方向与任务内容解耦。种子(职业、DWA 任务型、执行模式、输入文件族)只负责框定方向并以边际覆盖贪心控制多样性,具体任务和全部验证准则都从实例化后的真实文件证据图编译而来,这与 EnvCraft(模型造文件、脚本验证)和 NexForge(真实文件但零验证)形成本质区别。GraphForge 引入证据图 $G_i=(V_i,E_i)$ 作为中间表示,把跨文件依赖编译成任务规范,使每条准则携带证据锚点 $A_k \subseteq V_i$,让'出题'与'判卷'共享同一份文件级依据;再辅以执行条件化的一步修订——先让教师模型试做一遍以暴露歧义,修订代理对照原始文件修复任务与准则——把静态检查无法发现的可执行性问题消灭在采集轨迹之前。
核心方法
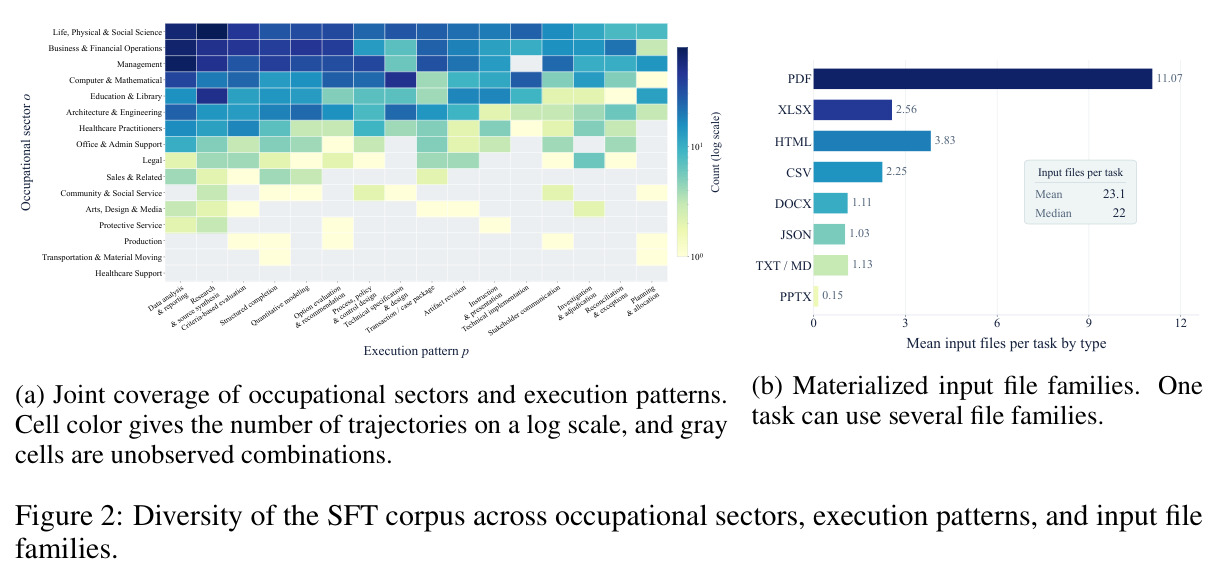
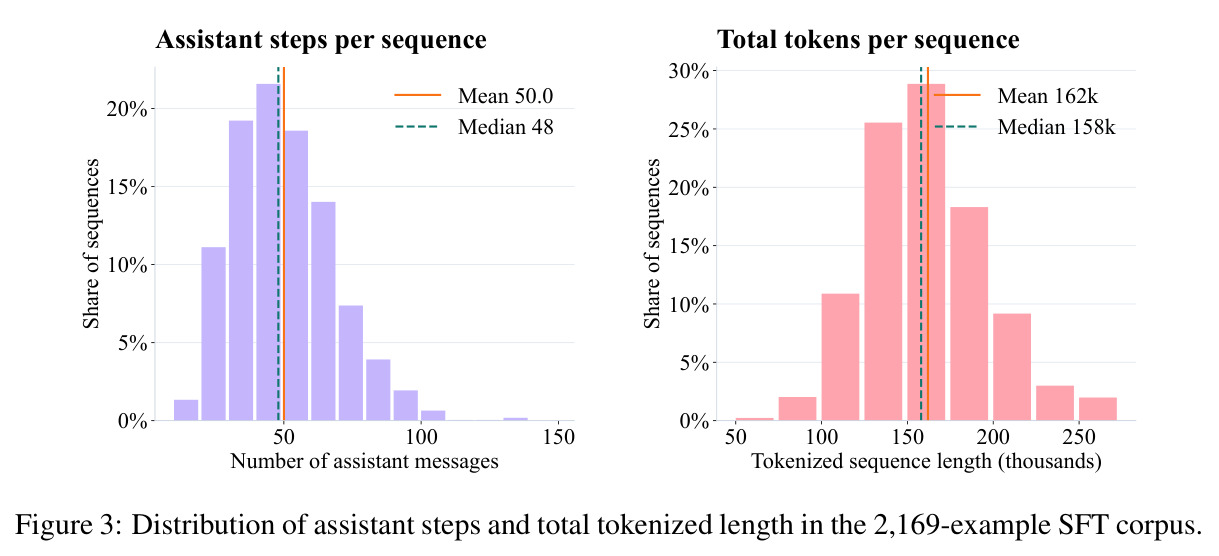
GraphForge 是一条五阶段流水线:O*NET 种子构造 → 真实文件工作区构建 → 证据图与可验证准则 → 执行条件化一步修订 → 工件级准入与轨迹清洗。直觉上先'定向':种子决定职业与任务型,用覆盖增益 $\Delta(s|S)=\sum_{d\in D}\frac{1}{1+n_d(v_d(s))}$ 贪心选取以保证多样性;再'落地':搜索代理为每个种子爬取真实公司案例文件组成工作区(平均每任务 23.1 个输入文件,PDF 出现于 96.7% 的任务);然后'出题与判卷一体':模型在工作区上构建证据图并编译成任务规范;最后'试做—修订—准入':教师先做一遍暴露问题,修订代理修复任务与准则,评委按锚定准则打分,$Q_i(\tau)>0.90$ 才录取。整条流水线由 GLM-5.2 驱动,最终从 3,638 个实例化任务得到 2,169 条 SFT 轨迹,平均每条含 50.0 个助手步骤、约 16.2 万 token,用于微调 Qwen3.6-27B 和 Qwen3.6-35B-A3B。
核心创新有三点。第一,证据图作为任务与验证的共同根基:节点记录源文件及其提供的事实,边记录跨文件依赖,任务陈述与正负准则都从图编译而来,每条正向准则 $c_k=(d_k,r_k,z_k,w_k,A_k,\phi_k)$ 通过锚点 $A_k\subseteq V_i$ 指明验证时要查哪些文件,但不把解题步骤泄漏进题面——工作智能体只看到任务陈述和工作区,看不到隐藏文件角色与节点 ID。第二,执行条件化修订:教师试做产生初始轨迹 $\tau_i^0$,修订代理只返回需改字段;当任务陈述哈希不变($H(q_i^1)=H(q_i^0)$)且初始轨迹存在时直接复用,否则才重跑教师,论文中 81.6% 的任务走了复用路径。第三,加权评分 $Q_i(\tau)=\frac{\sum_{k\in R_i^+}w^+_{ik}a_{ik}-\sum_{j\in R_i^-}\lambda_{ij}v_{ij}}{\sum_{k\in R_i^+}w^+_{ik}}$:正向准则按满足比例加权,负向准则仅在违规有直接证据时扣分。
方法步骤详情
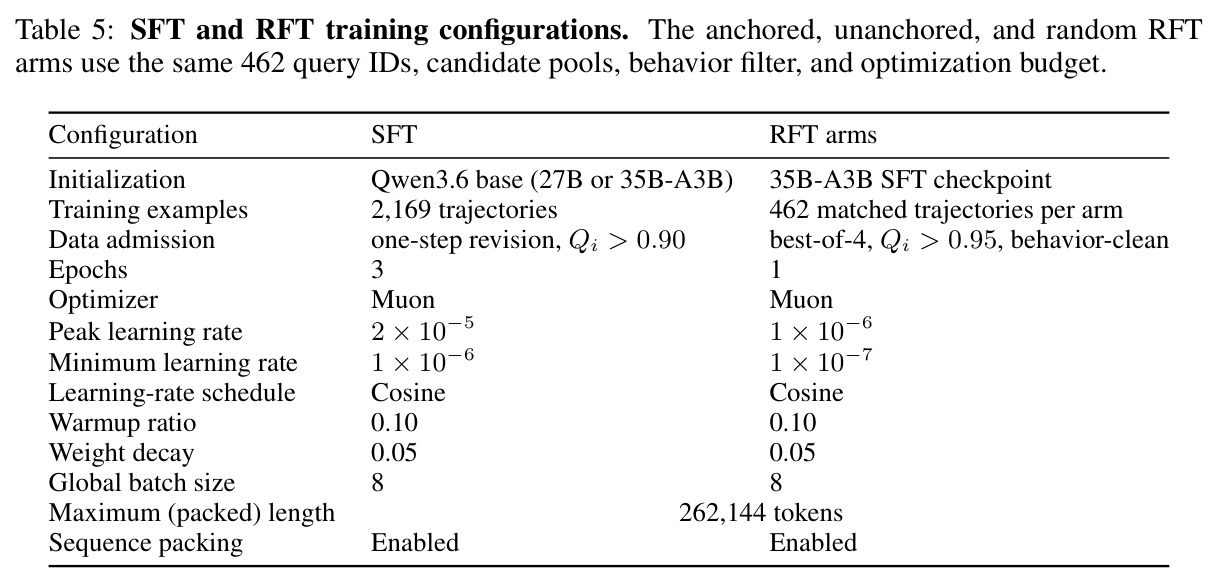
第一步,O*NET 种子:保留 AI4Work 标注为 DIGITAL 的任务并映射到 DWA,得到 246 个职业、16 个行业、891 种任务型和 3,419 个职业-任务型对;种子 $s_i=(o_i,a_i,w_i,p_i,u_i,e^{occ}_i)$ 记录职业、任务型、工作需求、执行模式、输入文件族和职业证据,按覆盖增益贪心选择。第二步,工作区构建:搜索代理为种子实例化一个连贯的真实公开案例,爬取原生格式文件并去重,赋予文件 core/supporting/confuser/ambient 隐藏角色之一。第三步,证据图与规范编译:构建 $G_i=(V_i,E_i)$,编译为任务规范 $C_i=(q_i,D_i,R_i^+,R_i^-;G_i)$。第四步,一步修订:教师先跑出 $\tau_i^0$,修订代理检查可执行性、锚点正确性与验证说明充分性,按哈希规则复用或重跑。第五步,准入与清洗:确定性检查文件名、格式与表格公式,评委按锚点打分算 $Q_i(\tau)$,丢弃退化工具行为。训练用 Muon,3 个 epoch,学习率 $2\times10^{-5}$。
技术新颖性
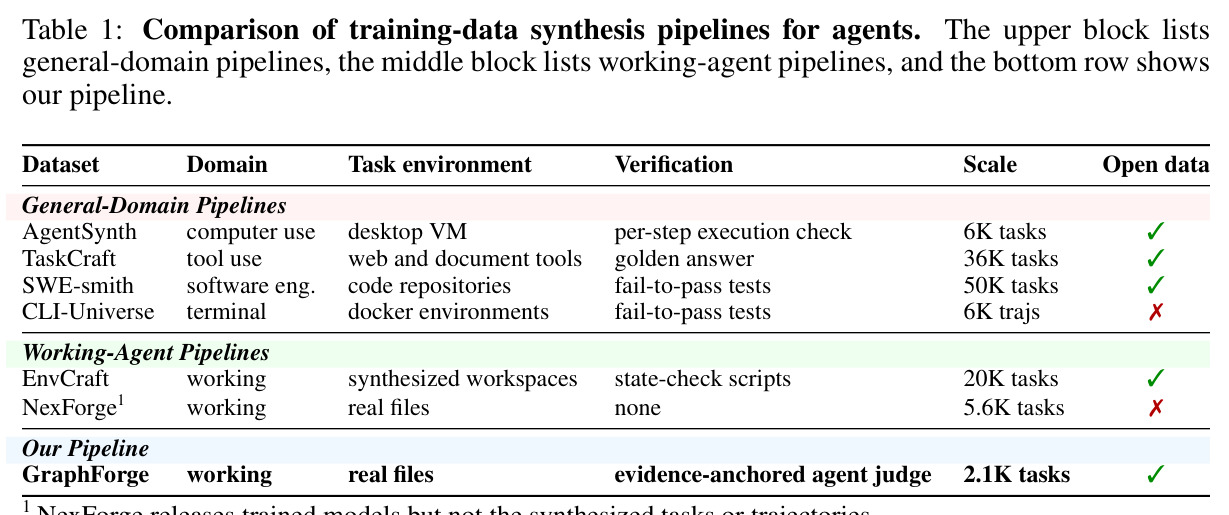
对照论文 Table 1 的谱系可以看清新颖性:通用域流水线(AgentSynth、TaskCraft、SWE-smith、CLI-Universe)依赖可程序化验证的环境(桌面虚拟机、fail-to-pass 测试、黄金答案);工作智能体流水线中,EnvCraft 用合成工作区加状态检查脚本(2 万任务),NexForge 用真实文件但零验证且不开放数据。GraphForge 是唯一同时做到'真实文件 + 证据锚定代理评委 + 数据与模型开源'的工作(2.1K 任务)。技术上,把证据图作为可编译的中间表示、让锚点同时服务准则生成与评审,是出题-判卷一致性的关键设计;执行条件化修订以低成本(81.6% 复用率)保证任务可执行;RFT 消融中'无锚点评委'(只看准则文本、看不到锚点与验证说明)与'随机选一'两条对照臂进一步证明锚定信息本身携带选择信号,而不只是准则文本的功劳。
实验结果
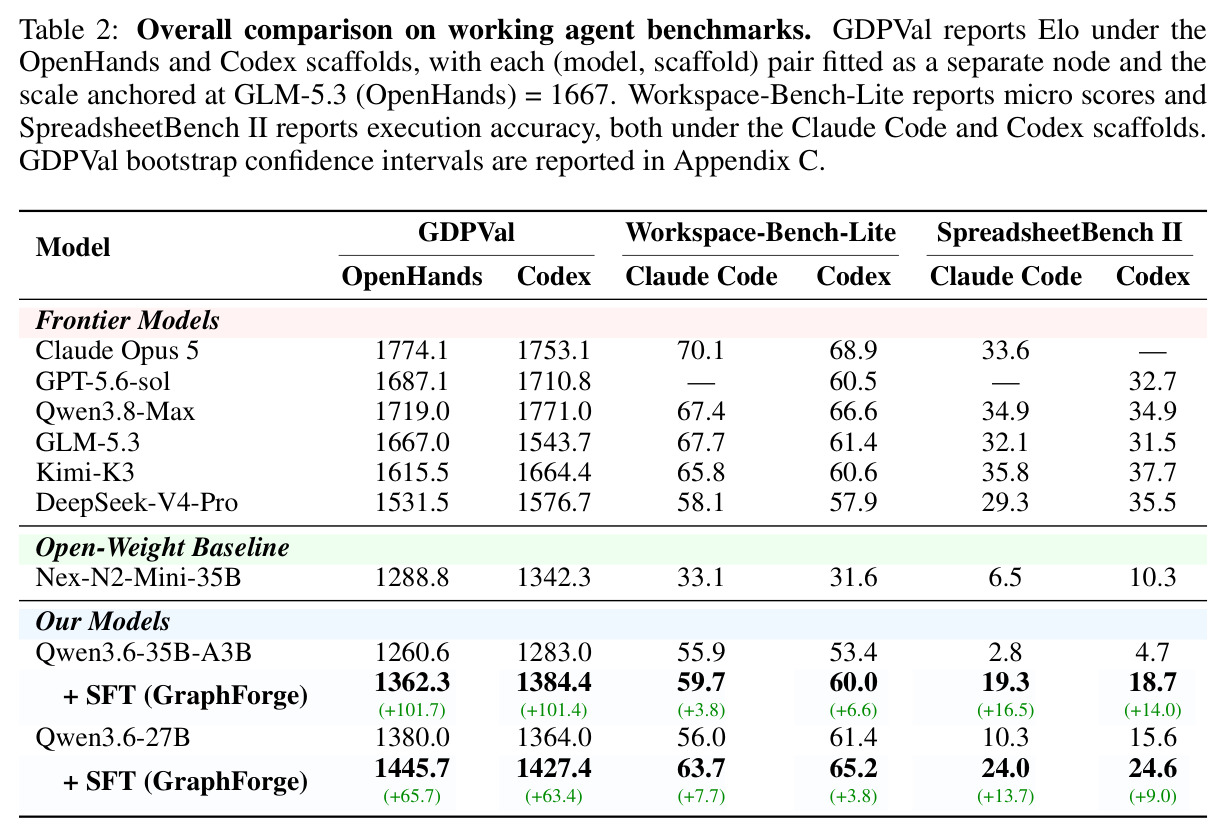
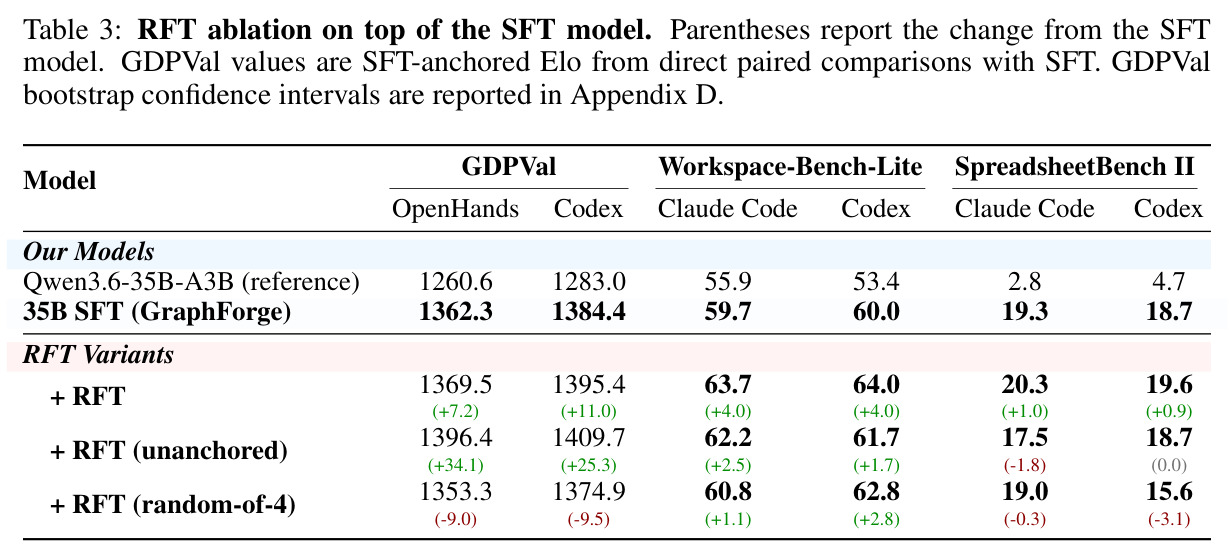
主结果见 Table 2:Qwen3.6-27B 经 SFT 后 GDPVal-AA 在 OpenHands 下达 Elo 1445.7(+65.7)、Codex 下 1427.4(+63.4);Workspace-Bench-Lite 在 Claude Code 下 63.7(+7.7)、Codex 65.2(+3.8);SpreadsheetBench II 在 Claude Code 下 24.0(+13.7)、Codex 24.6(+9.0)。Qwen3.6-35B-A3B 提升更大:GDPVal +101.7/+101.4,SB2 +16.5/+14.0,收益跨三个脚手架成立,说明学到可迁移技能。Table 3 的 RFT 消融显示锚定选择整体最优(GDPVal +7.2/+11.0,WBL +4.0),随机选一最差,无锚点评委点估计更高但置信区间均含 0。Table 4 审计:训练文件与 GDPVal 文件零重合,未覆盖职业任务胜率 0.739 高于覆盖的 0.692,排除记忆;删除评委引用的 worksheet 使目标准则 ∆Q 降 0.377 而非目标仅动 0.016。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| GDPVal-AA(OpenHands 脚手架,220 任务金标子集) | Elo(Bradley–Terry,GLM-5.3 OpenHands 锚定 1667) | Qwen3.6-27B + SFT:1445.7(基座 1380.0);Qwen3.6-35B-A3B + SFT:1362.3(基座 1260.6) | 27B 基座 1380.0;对照 Nex-N2-Mini-35B 1288.8、DeepSeek-V4-Pro 1531.5、GLM-5.3 1667.0、Claude Opus 5 1774.1 | 27B +65.7 Elo,35B-A3B +101.7 Elo |
| GDPVal-AA(Codex 脚手架) | Elo | 27B + SFT:1427.4(基座 1364.0);35B-A3B + SFT:1384.4(基座 1283.0) | 27B 基座 1364.0;Nex-N2-Mini-35B 1342.3 | 27B +63.4 Elo,35B-A3B +101.4 Elo |
| Workspace-Bench-Lite(Claude Code) | micro 分数(pass@1) | 27B + SFT:63.7(基座 56.0);35B-A3B + SFT:59.7(基座 55.9) | 27B 基座 56.0;前沿最高为 Claude Opus 5 的 70.1 | 27B +7.7,35B-A3B +3.8 |
| Workspace-Bench-Lite(Codex) | micro 分数(pass@1) | 27B + SFT:65.2(基座 61.4);35B-A3B + SFT:60.0(基座 53.4) | 27B 基座 61.4 | 27B +3.8,35B-A3B +6.6 |
| SpreadsheetBench II(Claude Code) | 执行准确率(%) | 27B + SFT:24.0(基座 10.3);35B-A3B + SFT:19.3(基座 2.8) | 27B 基座 10.3;前沿最高为 Kimi-K3 的 35.8 | 27B +13.7,35B-A3B +16.5 |
| SpreadsheetBench II(Codex) | 执行准确率(%) | 27B + SFT:24.6(基座 15.6);35B-A3B + SFT:18.7(基座 4.7) | 27B 基座 15.6 | 27B +9.0,35B-A3B +14.0 |
| RFT 消融(GDPVal OpenHands,相对 35B SFT) | SFT 锚定 Elo 差值 | 锚定 RFT +7.2(1369.5);无锚点评委 +34.1(1396.4);随机选一 -9.0(1353.3) | 35B SFT 固定锚 1362.3 | 锚定显著优于随机,但各臂 95% 置信区间均含 0,未统计显著 |
| RFT 消融(Workspace-Bench-Lite Claude Code / SpreadsheetBench II Claude Code) | 相对 SFT 的分数变化 | 锚定:WBL +4.0(63.7)、SB2 +1.0(20.3);无锚点:WBL +2.5、SB2 -1.8;随机:WBL +1.1、SB2 -0.3 | 35B SFT:WBL 59.7、SB2 19.3 | 排序符合设计意图:锚定 > 无锚点 > 随机 |
局限与改进
作者承认三点局限:语料仅 2,169 条轨迹,未研究收益随数据规模的扩展规律;流水线所有组件(合成与评委)都由 GLM-5.2 驱动,更强前沿模型可能抬高数据与评审质量上限;实验只覆盖 Qwen3.6 家族的 27B 与 35B-A3B 两个基座,跨家族迁移未验证。我的补充观察:其一,RFT 三个臂在 GDPVal 上的 bootstrap 置信区间全部包含 0,'锚定优于无锚点'在 GDPVal 上并未统计成立,结论主要靠 WBL 和 SB2 支撑;其二,准入阶段负向准则违反度 $v_{ij}$ 只取二元值,无法刻画部分违反,且 SFT 只保留 $Q_i>0.90$ 的轨迹,大量失败与部分成功轨迹的对比价值未被利用;其三,工作区依赖爬取公共文件,链接失效、版权与隐私合规是长期隐患;其四,语料分布仍不均——数据分析与报告占 14.2%、研究与来源综合占 13.2%,其余执行模式均低于 9%,256 个行业×模式组合只实现了 164 个,头部模式的支配可能限制下游技能覆盖。
独立分析的弱点
第一,评委盲区是最大软肋:Table 4d 中删除整个被引用 worksheet 时目标准则 ∆Q 为 -0.377,但行损坏(-0.018)、数字损坏(-0.022)、引用损坏(-0.013)几乎测不出,而这些受损单元同样属于被引用证据,理想评委应当察觉;改进方向是对锚点字段叠加确定性校验(数值抽取、公式重算、引用比对),让 LLM 评委只负责语义层面。第二,合成者与评委同为 GLM-5.2,存在自我偏好与风格偏置风险,可引入异构评委交叉评审或人工标注校准子集。第三,GDPVal Elo 在 220 任务上方差过大,±30-50 分的差异不可分辨,应扩充评测集或增加跨脚手架桥接比较。第四,Q>0.90 的单边准入丢弃大量失败与部分成功轨迹,这些数据恰可用于 DPO 或偏好对比训练,把负例转化为训练信号。第五,文件爬取的时效性使工作区难以长期复现,建议发布文件哈希清单与快照存档,并在准则中加入对文件版本漂移的鲁棒性检查。
未来方向
作者提出的方向包括:把 GraphForge 扩展到更多任务族和文件类型;研究证据锚定验证与更长程智能体脚手架的交互;用更强前沿模型探索合成与评审的质量上限。基于本文成果还可以延伸:把 $Q_i(\tau)$ 从一次性准入门槛升级为强化学习的稠密奖励信号,做在线策略优化;将证据锚点发展成过程级奖励模型(PRM),按文件-步骤对齐给中间动作打分;把一步修订推广为多轮自我改进循环,让任务规范随执行反馈持续演化;系统研究 confuser 干扰文件的强度调控,以提升智能体抗干扰鲁棒性;在合规脱敏后的企业私有文档上做领域适配,检验框架在真实业务语料上的表现;以及把覆盖增益选择扩展为针对模型弱点分布的自适应采样,让数据合成随训练进程动态再平衡。
复现评估
复现条件总体较好,但有两个外部依赖。开源情况:合成任务、评分准则、轨迹和训练后的模型均发布在 HuggingFace collection groundhogLLM/graphforge;工作区文件因版权只提供源链接而不重分发内容。训练配置完整(Appendix A):Muon 优化器,SFT 峰值学习率 $2\times10^{-5}$、3 个 epoch,RFT 学习率 $1\times10^{-6}$、1 个 epoch,全局 batch 8,打包上限 262,144 token,warmup 0.10,权重衰减 0.05;RFT 三臂共享同样的 462 个查询与优化预算。评测遵循三个基准官方协议,Elo 用 Bradley–Terry 拟合(GLM-5.3 OpenHands 固定 1667),置信区间来自 10,000 次 bootstrap。难点:整条流水线依赖 GLM-5.2 API,重跑合成成本不低;网页爬取有链接失效风险,正文也未给出搜索代理完整提示词;27B 全参微调需要多卡集群,论文未详列硬件时长。若只基于开源轨迹复现 SFT/RFT 训练与评测部分,则完全可行。
论文图表