我们需要LLM来识别信息源为何冲突吗——面向RAG知识冲突分型的决策模型 Do We Need an LLM to Know Why Sources Conflict? Decision Models for Knowledge-Conflict Typing in RAG
11个小型决策模型一次前向即可完成RAG冲突分型,成本为LLM的1/4~1/39,端到端效果不掉。
前置知识
RAG(检索增强生成)
LLM回答问题前先从搜索引擎或文档库取回若干相关网页,把它们作为上下文拼进提示词再作答。这让答案能引用最新、可核查的外部信息,但引入了新风险:不同网页可能给出相互矛盾的答案,模型必须自行取舍。本文场景是搜索增强问答,每个查询平均附带约9.2条搜索结果。
论文的核心问题是“检索到的信息源之间为何冲突”,冲突发生在RAG流水线内部;不熟悉RAG就无法理解冲突分型在整个系统中的位置——检索之后、生成答案之前的关键路径上。
知识冲突五分类与CONFLICTS基准
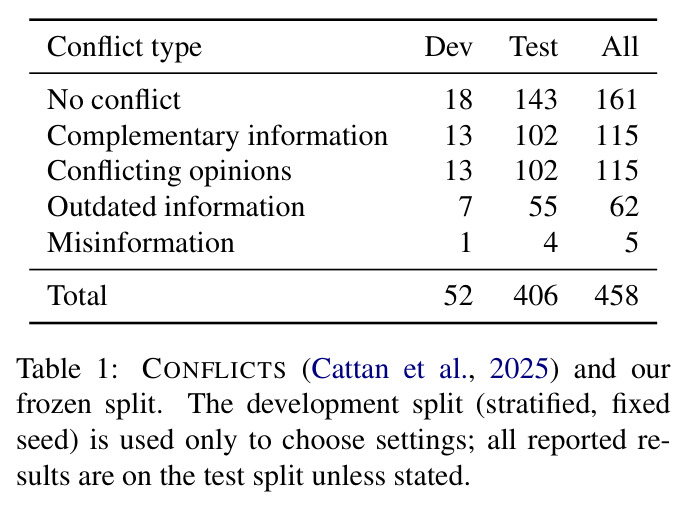
Cattan等人(2025)提出的分类体系:给定查询与其检索结果,冲突分为五类——无冲突(来源实质一致)、互补信息(问题欠明确,多个答案都成立)、对立观点或研究结论(争议性话题)、信息过时(答案随时间变化)、虚假信息(部分来源本身错误)。CONFLICTS包含458条带专家标注的搜索查询,每条附约9.2条Google搜索结果。
本文全部实验都在CONFLICTS上进行,五分类就是任务定义本身;作者逐字沿用原论文的提示词与协议,以便与LLM基线做逐查询配对比较。
类型化决策模型(typed decision models)
一类新模型:输入非结构化上下文和一个“类型化问题”(选择/评分/是否),单次前向传播直接输出各允许选项上的概率分布,不生成文本。以TypeSafe AI的Jev为开端,Perplexity、OpenAI、Liquid AI、微软、Baseten、ScaleDown等相继推出同类托管模型,主打校准好的概率而非生成能力。
本文检验的正是“这一整类模型能否胜任冲突分型”——被评测的11个模型全部属于此类;理解其工作方式(一次请求答多个问题、直接给概率)是读懂方法与级联实验的前提。
校准与期望校准误差(ECE)
校准衡量置信度是否可信:若模型以80%置信给出的预测中约80%正确,则校准良好。ECE把预测按置信度分桶,计算各桶平均置信度与实际准确率之差的加权平均,越小越校准。过度自信(平均最高概率高于准确率)是大模型常见毛病。
论文发现11个模型的ECE从0.031到0.188不等、7个过度自信,且校准好坏与准确率无关;作者据此主张部署选型要在准确率、校准、置信度排序能力三个维度上实测。
置信度门控级联与AUROC
级联是“便宜模型先答,把没把握的样本升级给昂贵模型”的路由策略,源自FrugalGPT与选择性预测研究。其有效性取决于便宜模型的置信度能否给自身错误排序,用AUROC度量(0.5等于随机,1为完美)。本文的阈值取置信度分位数、不需要任何标签,因此不会泄漏测试集。
论文的核心部署方案是“决策模型+置信度门控级联到Gemini 3.8 Flash”,多数模型靠它以25–37%成本追平LLM;AUROC 0.64–0.76这些数字完全依赖这一概念来解读。
McNemar检验与自助法置信区间
比较两个分类器在同一批样本上的准确率需要配对检验:McNemar检验只看两者预测不一致的样本,判断差异是否显著;自助法(bootstrap)通过重采样估计95%置信区间。本文测试集仅406条,准确率的95%区间约±4.8点,小于约5点的差异一般不显著。
论文几乎所有结论(如“8个模型与LLM打平”“级联统计上打平LLM”)都是配对检验意义上的表述;不掌握“打平不等于等价”,就会误读其主要发现与局限。
研究动机
搜索增强LLM用检索到的网页作答,而网页之间经常互相矛盾,且矛盾的原因决定了正确的回应方式:问题欠明确时多个答案都成立、争议话题应中立呈现各方观点、答案随时间变化时应采用最新信息、假来源则应直接忽略——回应错型就会误导用户。Cattan等(2025)把这个问题形式化为五分类任务,发布CONFLICTS基准(458条真实搜索查询,平均附9.2条Google结果,由专家标注冲突类型),并证明把金标准类型喂给生成器能让符合预期行为的答案比例提升约24个百分点(65.7%→88.0%)。但类型预测本身很难:他们测过的最好LLM(Gemini 2.5 Flash)也只有65.3%准确率。更现实的约束是成本与延迟:冲突分型处在每次搜索请求的关键路径上——每个查询要做一次、必须在生成前完成、输出只是5个标签之一——理想分类器必须快到能挂在每个请求前、便宜到能全量运行、且校准到置信度可被下游利用;生成式LLM(每查询1.55秒、$1.66/千次)很难同时满足这三条。
本文的目标是本文要回答一个部署导向的问题:类型化决策模型作为一个类,能否充当RAG流水线中的冲突分型层?为此作者设计了五项实验。(1)普查:在某商业推理网关(Vercel AI Gateway)2026年10月25日列出的全部11个决策模型(来自7家提供商)上,按原论文协议评测——相同输入表示、逐字复制的类别定义与示例——并在完全相同的输入上重跑Gemini 2.5 Flash和更新的Gemini 3.8 Flash,使所有比较都是逐查询配对的。(2)提问方式研究:一道五选一的选择题(flat)对比把分类学分解成5个是否问题的树状方案(tree)。(3)成本-质量级联:用决策模型自身的置信度决定哪些查询升级给LLM。(4)预先设定的诊断:日期依赖、来源顺序敏感性、单个假来源检测。(5)端到端检验:把决策模型给出的类型交给生成器后,答案是否仍达到LLM类型的水准。
与已有工作不同的是,已有工作要么一次只研究一种冲突成因(替换实体、维基百科矛盾、争议问题、时间/地理情境、信息新近性),要么用多智能体辩论、微调检测器、两阶段检测等生成式LLM方案解决冲突,没有工作测试过决策模型这一新模型类。本文的独特切入在于:(a)首次把“多文档间冲突分型”当作决策模型的系统性压力测试,比较对象是同一网关在售的全部11个模型而非单个模型,且通过在相同输入上重跑LLM基线实现配对比较,排除提示词与格式混杂;(b)采用预登记式协议——数据划分、提示词、诊断假设都在接触测试集之前书面冻结并记录文件哈希,之后每次改动先书面指定再运行、且全部报告;(c)不只看准确率,而是把计费成本、延迟、校准(ECE)与置信度排序能力(AUROC)当作一等的部署指标;(d)用端到端实验闭环验证“更便宜的类型不损失答案质量”,而不是停留在分类指标上。
核心方法
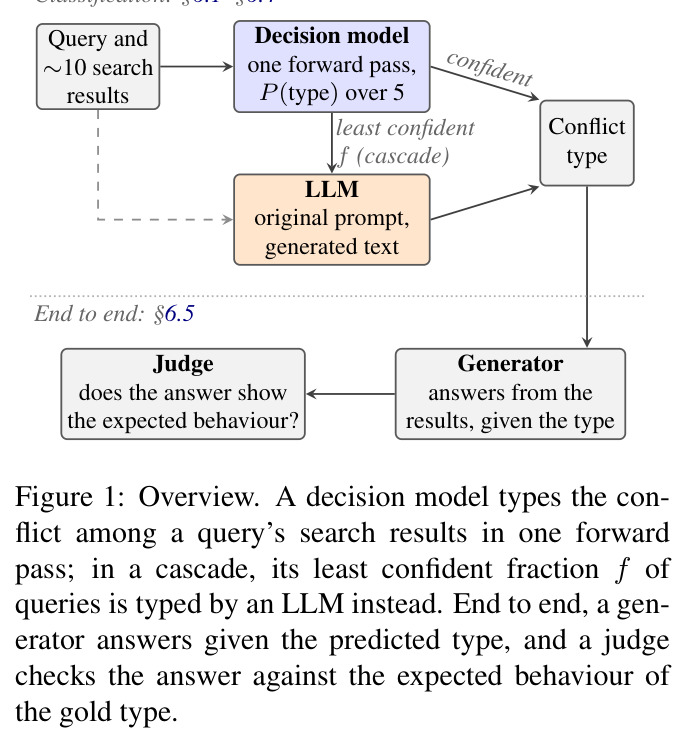
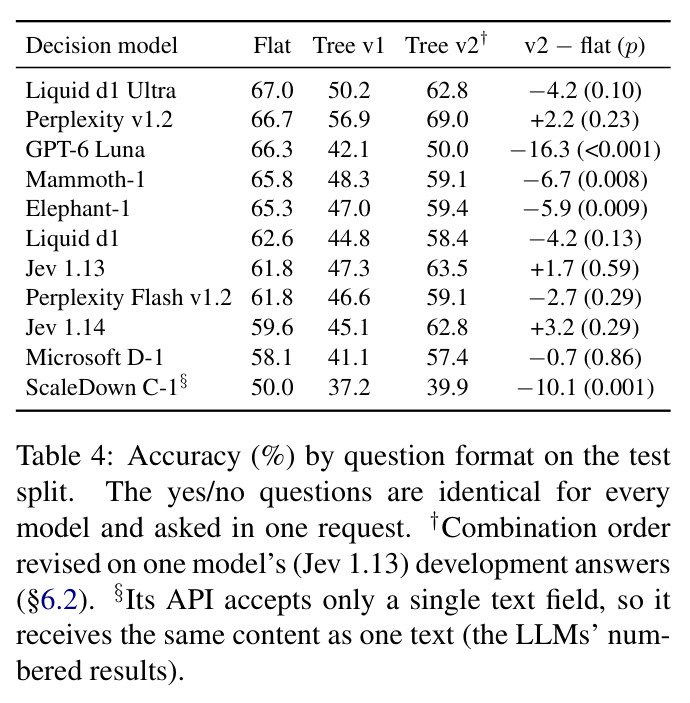
直觉上,冲突分型是“给定查询和约10条搜索结果,从5个固定类别里选一个”的受限分类问题,每次请求只做一次、在生成之前完成——这正是类型化决策模型的设计场景。论文的技术路线(Figure 1)分五步。第一,普查:11个决策模型收到与LLM逐字相同的指令、定义和示例,构成一道五选一选择题(flat),一次前向输出5个类别的概率;Gemini 2.5 Flash按原论文提示词原样重跑(温度0、关闭thinking),另测当前最强的Gemini 3.8 Flash(最低thinking档与默认档);所有系统看到完全相同的输入——每条结果由URL、标题、摘要、发布日期(如有)和512词元相关段落拼接而成,按数据集原序编号。第二,提问方式研究:flat对比tree v1(按分类学顺序分解为differ/compatible/opinion/outdated/misinformation五个是否问题)与tree v2(调整顺序的修复版)。第三,级联:决策模型答完所有查询后,把置信度最低的 $f$ 比例查询交给Gemini 3.8 Flash覆写。第四,三个预设诊断。第五,端到端:Gemini 2.5 Flash作生成器按预测类型作答,LLM裁判核对答案是否符合金标准类型的预期行为。
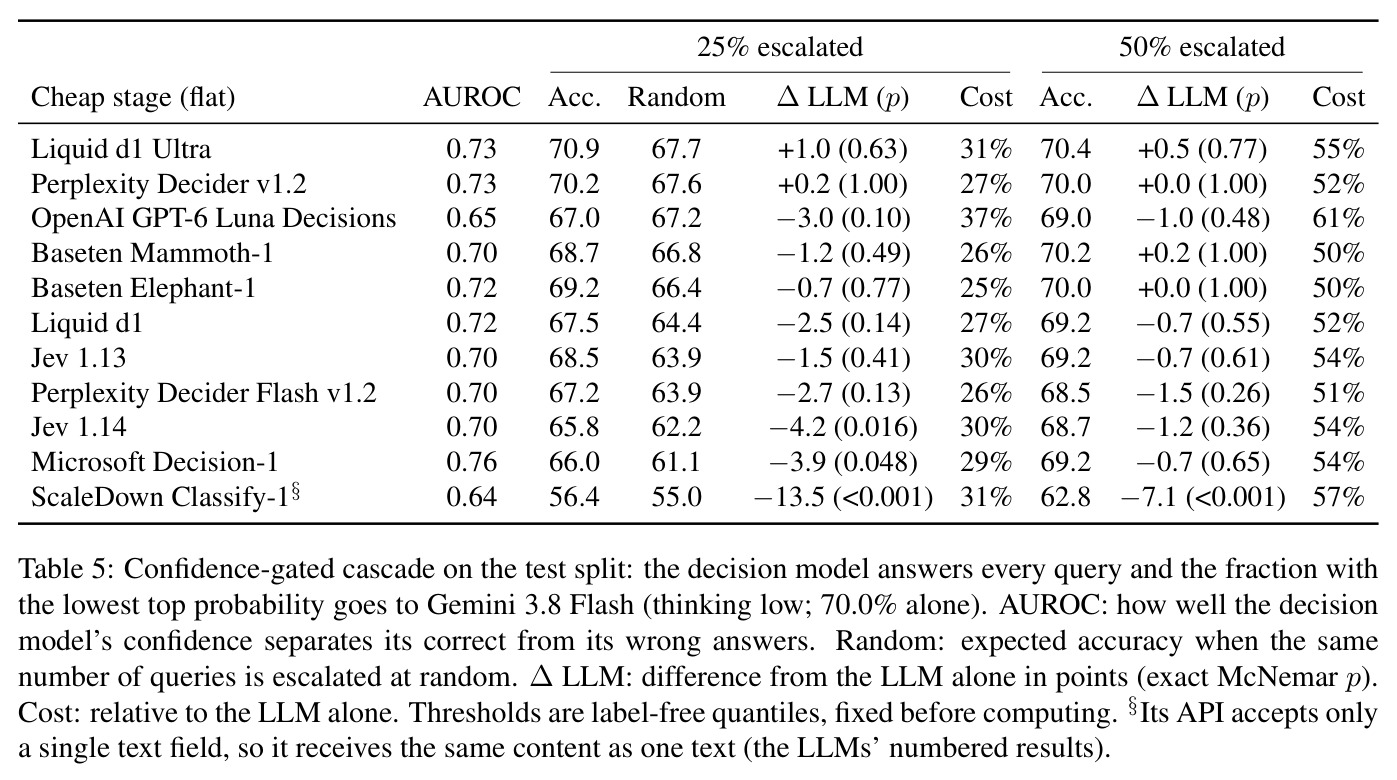
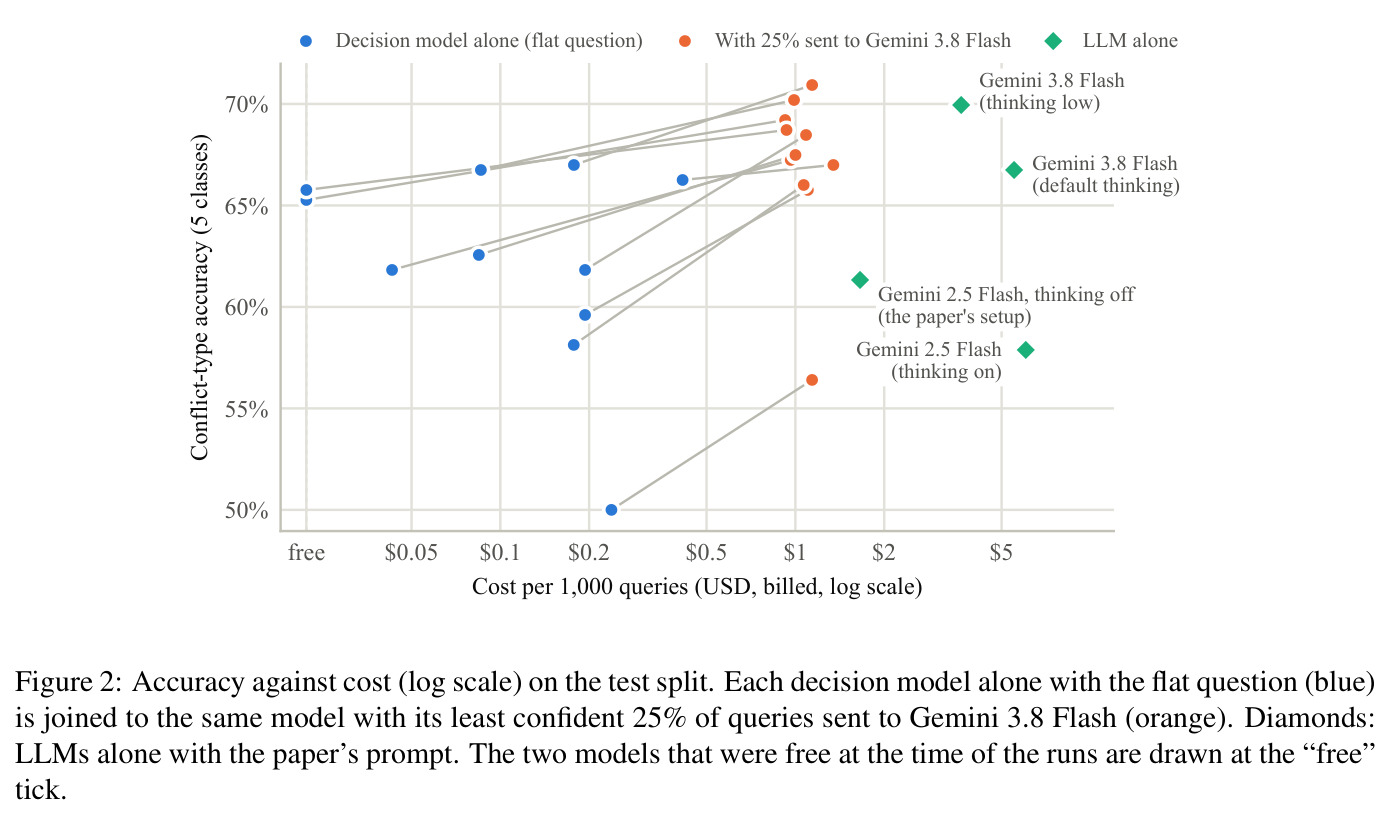
核心创新是把“冲突分型”从LLM生成任务重新框定为决策模型的单次前向分类任务,并证明这一替换在成本上占数量级优势。与已有方法的本质区别有三。其一,此前冲突检测工作(多智能体辩论、微调推理链、两阶段检测器)全部依赖生成式LLM,本文首次系统评测“输出类型概率、不生成文本”的整类模型,发现10/11以4–39倍更低成本追平原论文LLM。其二,一个反直觉的负面结果:把层次分类学分解成5个是否问题(看似更简单)反而让全部11个模型掉分——开发集诊断显示决策模型在批量是否问题上有系统性偏“是”的偏差,而直接的选择题对所有模型都可靠,因此“保持原始提问”才是可靠格式。其三,把决策模型的不确定性变成可执行信号:其置信度能给自身错误排序(AUROC最高0.76),于是“最不确定的25%升级给LLM”即可在8/11模型上统计追平纯LLM,只花25–37%的钱;这把分类器选择问题转化为准确率、校准、排序能力三个独立维度的选型问题。
方法步骤详情
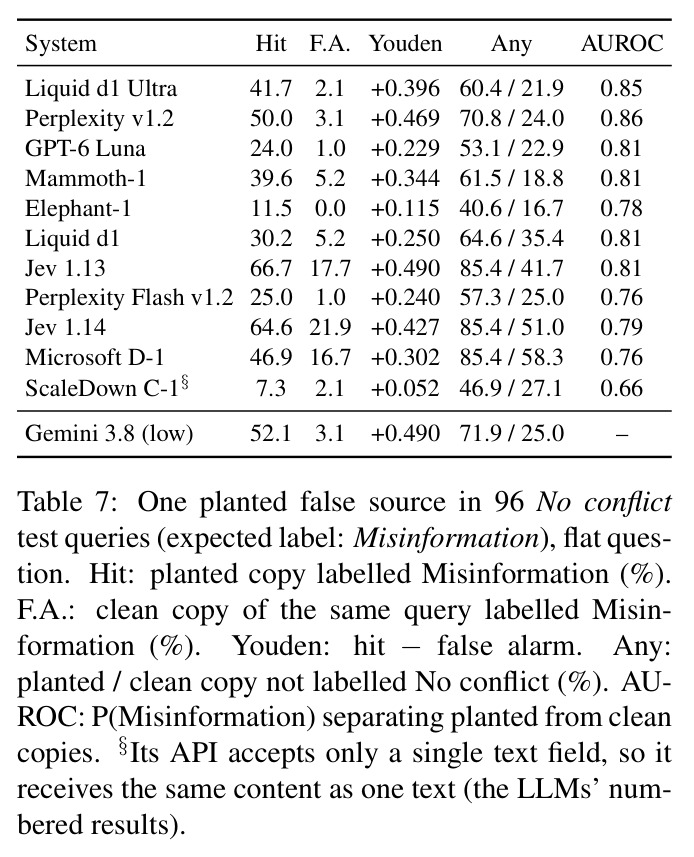
实验流程六步。步骤1(数据):CONFLICTS共458条查询,按固定种子分层抽出52条作开发集(只用于选设置),其余406条为测试集;类别分布严重失衡——无冲突161、互补115、对立观点115、过时62、虚假信息仅5条。步骤2(输入):每条搜索结果拼接URL、标题、摘要、发布日期与512词元相关段落,保留原序并编号,所有系统共用同一输入。步骤3(提问格式):flat是一道五选一选择题,指令与定义逐字复制自Cattan等(2025)源码(代码中有测试保证一字不差);tree v1按分类学顺序问五个是否问题并在代码中组合:$P(\text{No conflict})=1-d$,$P(\text{Complementary})=d\cdot c$,剩余质量 $d(1-c)$ 按成因的是否概率比例分配;tree v2把opinion提到compatible前、把misinformation当作“时间解释不了的事实冲突”:$P(\text{Opinions})=d\cdot o$,$P(\text{Complementary})=d(1-o)c$,$P(\text{Outdated})=d(1-o)(1-c)t$,$P(\text{Misinformation})=d(1-o)(1-c)(1-t)$。步骤4(级联):阈值取置信度分位数、不用标签,$f=25\%$ 与 $50\%$ 在计算前预先固定。步骤5(植入假信息诊断):在96条无冲突测试查询中,用第三方模型GPT-4.1-mini生成貌似合理的错误答案,整词替换进某条含金答案的结果,预期标签变为虚假信息。步骤6(端到端):生成器按无类型与五种类型共生成2,436条答案;LLM裁判判答案是否符合金标准类型的预期行为,并用100条双盲人评验证裁判(标注者一致率92%、$\kappa=0.67$;裁判与多数派一致92%,高于原论文的89%)。统计上全部比较逐查询配对,报10,000次重采样的95%自助区间与双侧精确McNemar检验。
技术新颖性
技术新颖性不在新模型或新算法,而在评测设计与三个发现。第一,普查式配对设计:先前对决策模型的独立评测多针对单个模型(主要是Jev)在通用基准上的表现,本文首次在真实RAG任务上同屏比较一整类11个模型,通过在相同输入上重跑LLM基线实现逐查询配对的McNemar检验,排除提示词与输入格式混杂。第二,预登记协议:划分、提示词、诊断假设在接触测试集前书面冻结并记录哈希,每次后续改动先书面指定再运行、全部报告(附录B的协议记录),这种严谨度在LLM评测论文中罕见。第三,负结果的机制解释:树状分解符合分类学直觉却在11个模型上全败,作者用开发集概率诊断给出原因(compatible问题对opinion话题的均值概率0.69,接近互补类的0.81),并证明在一个模型上拟合的修复(tree v2)无法迁移到其他模型。第四,“硬标签弱、概率强”的分离:植入假信息时模型很少把虚假信息排为首选标签(命中率7.3–66.7%),但虚假信息概率区分真假来源的AUROC达0.66–0.86——说明这类模型的隐式感知强于显式分类,为概率阈值化部署提供了直接依据。
实验结果
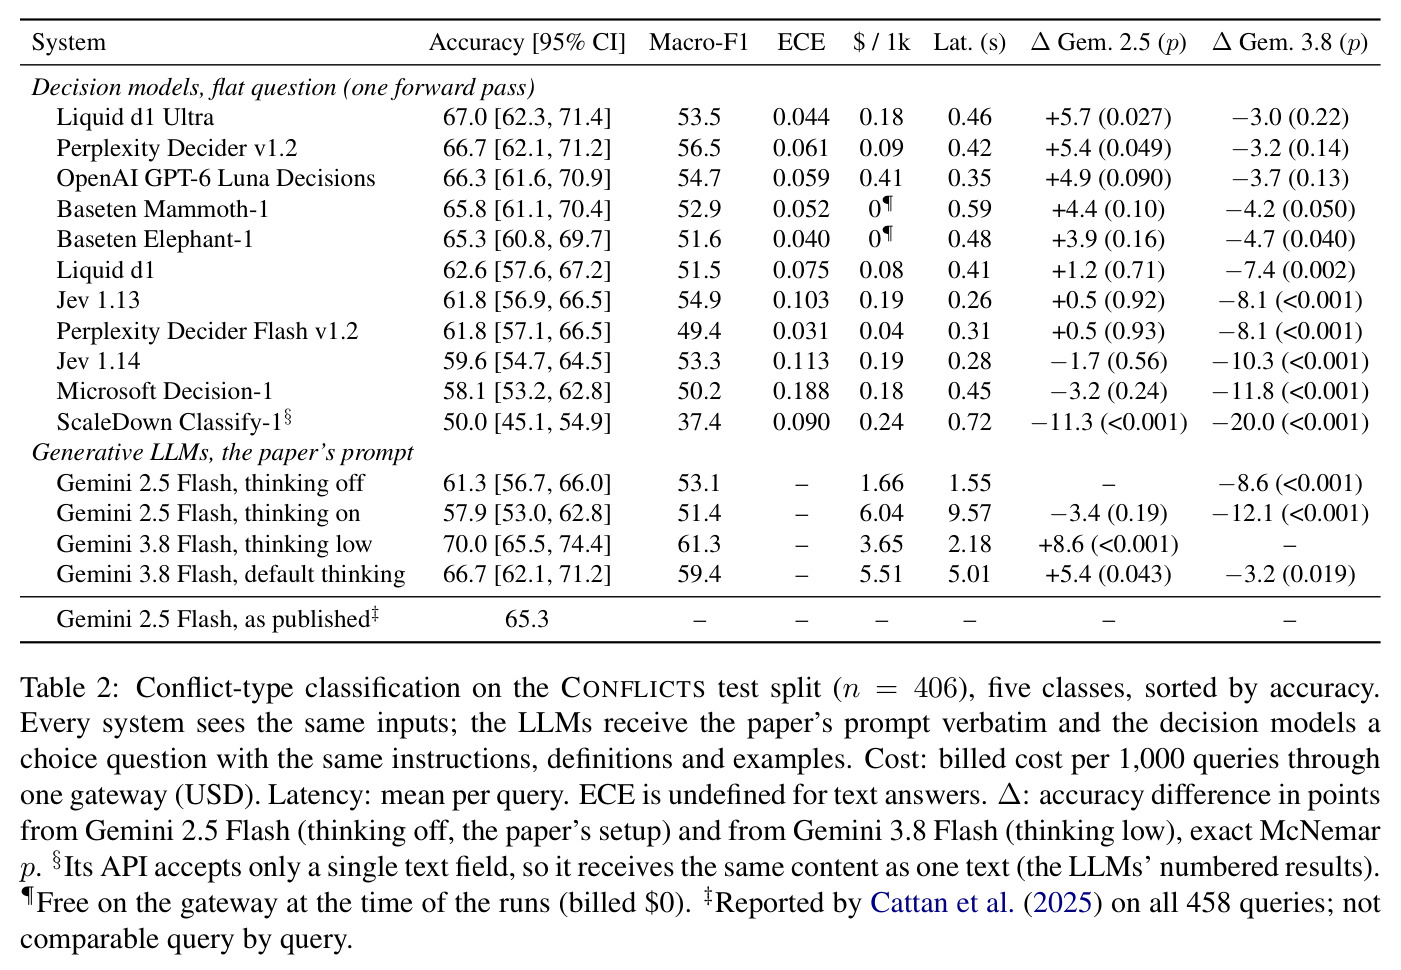
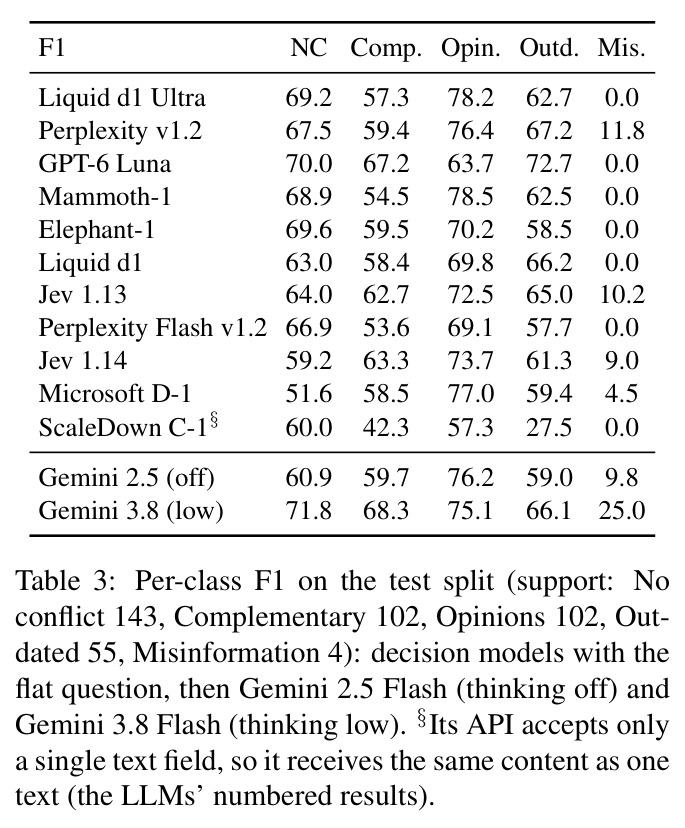
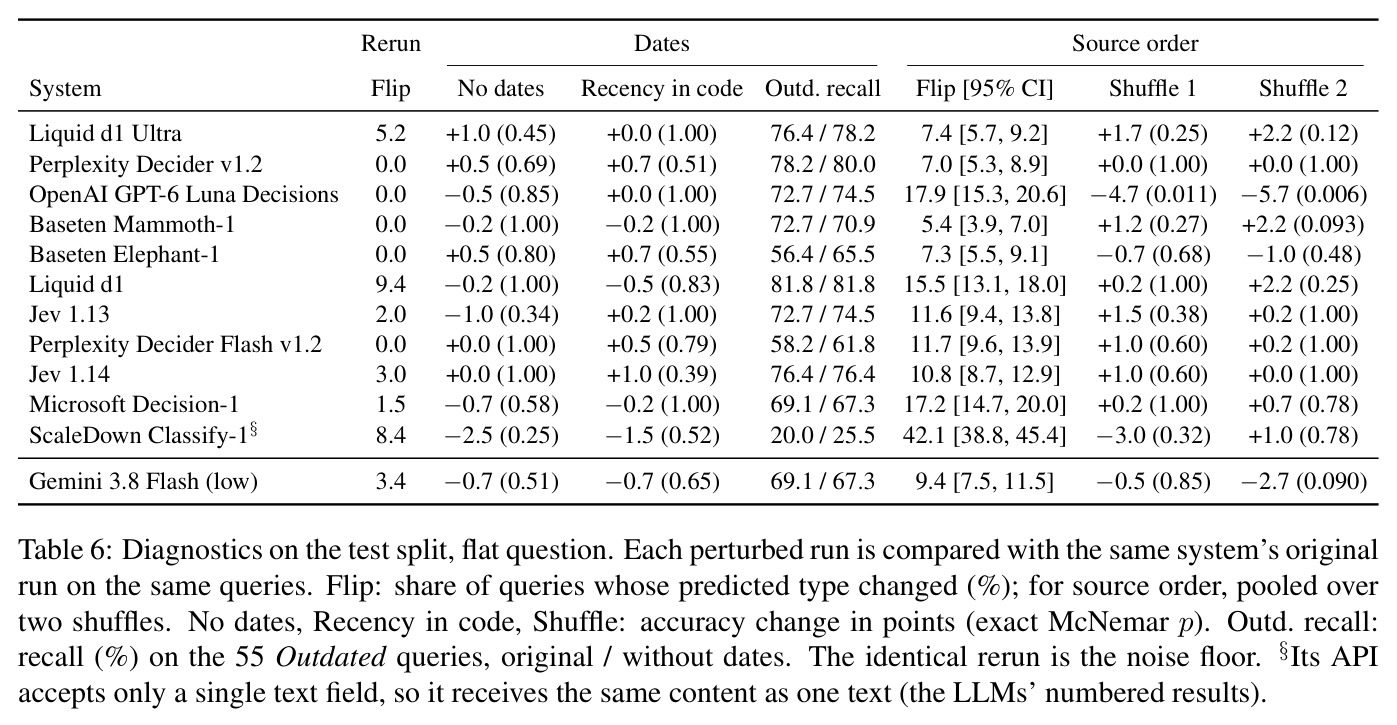
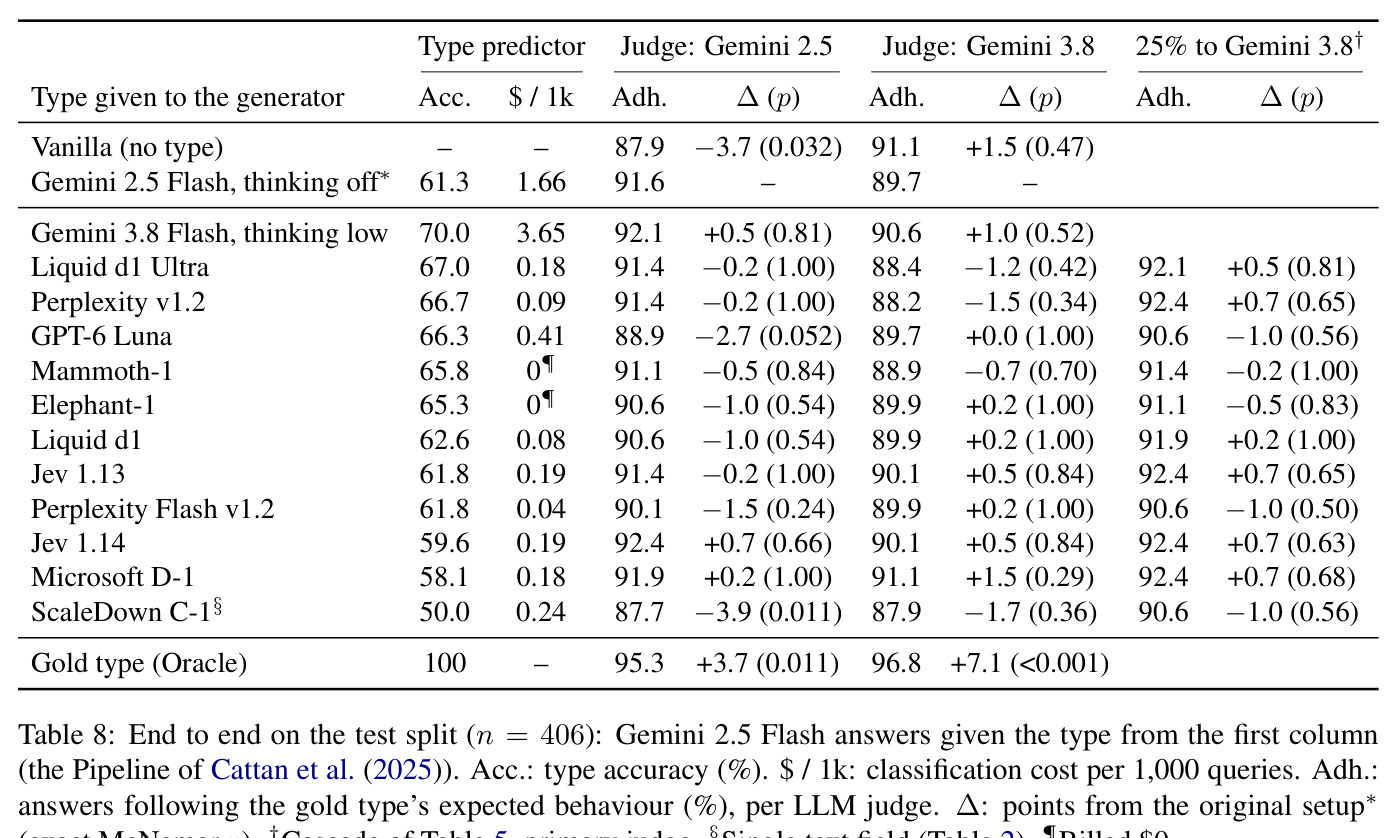
普查(Table 2):11个决策模型用flat问题直接分类,准确率50.0–67.0%(中位数62.6%);Gemini 2.5 Flash重跑得61.3%。配对比较下8个打平、2个显著更好(Liquid d1 Ultra 67.0%,+5.7点,p=0.027;Perplexity Decider v1.2 66.7%,+5.4点,p=0.049)、1个显著更差(ScaleDown Classify-1 50.0%,−11.3点,p<0.001)。成本每千次查询$0.04–$0.41(2款当时免费)对比$1.66,即4–39倍便宜;延迟0.26–0.72秒对比1.55秒,快2.6–6.0倍。当前最强的Gemini 3.8 Flash(最低thinking)达70.0%(+8.6,p<0.001),显著高于8个决策模型,但最好三个(d1 Ultra、Decider v1.2、GPT-6 Luna)落后仅3.0–3.7点且不显著;且更多思考有害:3.8 Flash默认档66.7%(−3.2,p=0.019),2.5 Flash开thinking掉到57.9%。分类细节(Table 3):模型差异集中在过时类(F1从27.5到72.7),虚假信息类(测试仅4条)全灭——没有决策模型F1超过11.8(Gemini 3.8 Flash为25.0)。ECE在0.031–0.188之间且与准确率无关,7/11过度自信。提问方式(Table 4):tree v1在11/11模型上显著更差;tree v2对0个更好、7个打平、4个更差,仅在其拟合的Jev 1.13上打平(63.5%对61.8%,p=0.59)。级联(Table 5):置信度对错误的AUROC为0.64–0.76,升级最不确定的25%给Gemini 3.8 Flash后,8/11级联与纯LLM统计打平、成本仅25–37%,且10/11优于随机升级(最多+4.9点);例外是GPT-6 Luna(AUROC 0.65,级联67.0%≈随机67.2%)。诊断(Tables 6–7):日期完全不重要(22个检验0个显著,模型靠“former”“as of”等内容线索识别过时);打乱来源顺序使预测翻转5.4–42.1%(LLM为9.4%),但很少改变准确率(22个检验仅2个显著,均为GPT-6 Luna的−4.7/−5.7点);植入假信息时硬标签检测差(Youden +0.052–+0.490,8个显著劣于LLM的+0.490),但虚假信息概率的AUROC达0.66–0.86(10/11≥0.75)。端到端(Table 8):金标准类型Oracle 95.3%、Gemini 2.5 Flash类型Pipeline 91.6%(+3.7,p=0.032)、无类型Vanilla 87.9%;10/11决策模型作预测器与Pipeline打平(−3.9到+0.7),仅Classify-1显著差(−3.9,p=0.011);加25%级联后11/11打平;答案召回率不受影响(90.6–93.1%)。注意第二裁判下预测类型不再带来增益(Pipeline 89.7%对Vanilla 91.1%,p=0.47),增益大小依赖裁判选择。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| CONFLICTS五分类(测试集406条) | 五类准确率 | Liquid d1 Ultra 67.0%(最佳决策模型;11模型区间50.0–67.0%,中位数62.6%) | Gemini 2.5 Flash(原论文设置,重跑)61.3% | +5.7点(p=0.027);10/11模型持平或更好,成本仅1/4~1/39 |
| 对比当前前沿LLM | 五类准确率 | 最佳决策模型67.0% | Gemini 3.8 Flash(thinking low)70.0% | −3.0点(不显著,p=0.22);分类成本约1/20($0.18 vs $3.65/千次) |
| 推理成本 | 每千次查询计费(USD) | $0.04–$0.41(Baseten两款当时免费) | Gemini 2.5 Flash $1.66 | 便宜4–39倍 |
| 推理延迟 | 每查询平均墙钟时间(秒) | 0.26–0.72 s | Gemini 2.5 Flash 1.55 s | 快2.6–6.0倍 |
| 置信度门控级联(25%升级给Gemini 3.8 Flash) | 准确率与相对成本 | 8/11模型与纯LLM统计打平,成本25–37%;10/11优于随机升级(最多+4.9点) | Gemini 3.8 Flash单独70.0%(成本100%) | 准确率不掉的前提下省63–75%成本 |
| 植入假信息检测(96条构造查询) | 虚假信息概率的AUROC / 硬标签Youden指数 | AUROC 0.66–0.86(10/11≥0.75);硬标签命中7.3–66.7% | Gemini 3.8 Flash硬标签:命中52.1%,Youden +0.490 | 概率信号远强于硬标签(8/11硬标签显著更差),低阈值可恢复检出 |
| 端到端答案符合预期行为(生成器Gemini 2.5 Flash) | adherence(主裁判) | 决策模型类型91.1–92.4%(级联后90.6–92.4%) | LLM类型Pipeline 91.6%;无类型Vanilla 87.9%;金类型Oracle 95.3% | 10/11打平Pipeline(级联后11/11打平),分类成本降4–39倍 |
局限与改进
作者承认的局限:(i)CONFLICTS太小——406条测试查询下准确率的95%区间约±4.8点,5点以内差异不显著,级联的“打平”也只是接近而非形式上的等价;(ii)标签分布反映查询挑选方式而非真实搜索流量,自然虚假信息只有5条(测试集4条),植入变体只测了一种作弊方式(单一来源中的实体/数值整词替换);(iii)普查只覆盖一个网关在某一天列出的模型,托管模型会不打招呼地变更——部分标识无版本号、两款运行期间免费、Gemini 2.5 Flash重跑在全部458条上只有60.7%(低于发表的65.3%)——提供商也不披露模型大小与训练数据,无法解释模型间差异;(iv)端到端只用一个生成器,LLM裁判看不到检索来源,主裁判还是生成器自己的模型(可能偏袒自己的输出),预测类型的增益大小依赖裁判选择(第二裁判下消失),且未测事实忠实度;(v)部分系统非确定性:相同请求重发最多改变9.4%的预测。我的补充观察:植入假信息由GPT-4.1-mini生成、整词替换,属于相当温和的作弊,真实世界的假信息(整页伪造、多来源协同)可能更难检出;延迟只测了单请求墙钟时间,未测并发负载下的吞吐与排队;Classify-1只能接收单文本字段、输入格式与其他模型不同,其垫底成绩可能部分归因于此;免费定价与成本比较依赖网关定价快照,时效性存疑。
独立分析的弱点
(1)数据规模与类别失衡是硬伤:虚假信息类测试集仅4条,使这个部署中最关键的类别几乎不可评估,macro-F1也随之不稳;改进方向是构建大规模植入式与对抗式假信息测试集(多来源协同造假、伪造权威域名、篡改引用),或用弱监督扩展自然假信息样本。(2)单网关快照带来选择偏差与失效风险:未被网关收录的开源决策模型(如Laya因输入长度限制被排除)与之后发布的新模型都不在比较内;改进方向是补充可本地复现的开源模型基准,并把普查设计成可定期重测的流水线。(3)端到端裁判可能系统性偏袒生成器自己的答案(作者引用了Panickssery等2024的自偏好现象),且裁判看不到来源;改进方向是引入能核查来源的裁判或更大规模人工评估,并补测Cattan等论文的第三个指标——事实忠实度。(4)级联只在“升级到Gemini 3.8 Flash”一种配置下测试,未探索多级级联或按类别自适应阈值——论文自己发现“概率能检出假来源但硬标签不报”,完全可以对植入假信息单独设更低阈值;改进方向是按类型分别选阈值或输出软混合信号。(5)顺序敏感性(最高42.1%翻转)只有现象没有机制解释;改进方向是做注意力归因与位置消融,定位长上下文位置偏差来源并给出修复。(6)决策模型的批量是否问题存在yes偏差且逻辑相干性差(引用文献的发现),tree失败可能与此同源;改进方向是训练时加入概率公理/逻辑一致性约束,再做同样的分解实验验证。
未来方向
作者提出的方向:用能看到检索来源的裁判重新测量预测类型的增益;检验决策模型的概率能否在类型不确定时引导生成器在不同预期行为之间切换(例如把概率作为软加权信号而非硬标签注入提示)。基于其成果可延伸的方向:(1)阈值化假信息过滤——既然 $P(\text{Misinformation})$ 的AUROC达0.66–0.86,可在开发集上为每个模型选阈值,拦截“概率高但首选标签不是”的查询,做成近零成本的假来源过滤器;(2)把五类概率直接写进生成器提示(如“70%过时+30%对立观点”),让回应策略按不确定性加权,而不是非黑即白;(3)把本研究复制到多语言、多模态(图表冲突)和长文档(超过512词元段落)场景,检验flat问题与级联结论是否迁移;(4)在开源模型上微调专用冲突分型决策模型,看能否把过时类F1(目前27.5–72.7)推向Gemini 3.8 Flash的66.1水平,同时保留校准;(5)显式注入时间感知特征(日期规范化、新鲜度排序)验证是否仍无增益,从而确认“内容线索已足够”这一结论的边界;(6)研究托管模型静默更新后的阈值漂移,把级联阈值监控做成持续的MLOps问题。
复现评估
复现条件相当好。代码、提示词、数据划分、缓存响应与逐查询输出全部开源。数据是公开的CONFLICTS基准(458条查询),不需要训练任何模型,全部推理走商业API(Vercel AI Gateway上的11个决策模型+Gemini),算力需求接近零;成本也很低——分类侧最贵单模型约$0.41/千次乘以406条测试查询,端到端生成2,436条答案加裁判调用,总开销应在几十美元量级,一个API密钥加Python环境即可跑通。风险点有三:(1)托管模型非确定性且会静默变更——作者自己重跑Gemini 2.5 Flash只有60.7%(发表于65.3%),相同请求重发也最多翻转9.4%的预测,所以他人复现大概率得到接近但不相同的数字;好在论文所有比较都是同批次配对的,主要结论应当稳健;(2)部分模型无版本号、运行期间免费,成本列会随定价过时;(3)端到端裁判依赖当时的Gemini行为且有随机性。附录B的协议记录(每次改动的书面指定与理由)和冻结的文件哈希使整个实验流程可以逐步核对。总体难度:低到中,分类部分非常容易,端到端部分需按附录提示词重跑裁判。
论文图表