AGO AI 质量门:面向检索增强生成的证据优先发布决策 AGO AI Quality Gate: Evidence-First Release Decisions for Retrieval-Augmented Generation
把 RAG 评测从打分升级为带不确定性量化与裁判验证的可审计发布决策框架
前置知识
RAG(检索增强生成)
让 LLM 回答前先从外部文档库检索相关片段,把检索到的上下文拼进提示词再生成答案的架构,用于把回答锚定在私有或最新语料上。检索虽能缓解但不能消除幻觉:答案仍可能与检索证据矛盾、引用错误来源或在检索失败时凭空编造内容。
本文整个质量门解决的就是企业 RAG 系统发版前"这版能不能上线"的决策问题,adherence(答案是否忠于检索上下文)等核心指标都以 RAG 三元组(上下文相关性、遵从性、答案相关性)为基础。
LLM-as-a-Judge(LLM 裁判)
用一个 LLM 充当裁判,按冻结的评分规则(rubric)给另一个系统的输出打分或判断合规。优点是可扩展且便宜,缺点是可靠性随任务、领域和裁判模型剧烈变化,存在位置、冗长等系统性偏差,且托管模型可能在用户不知情时被供应商更新。
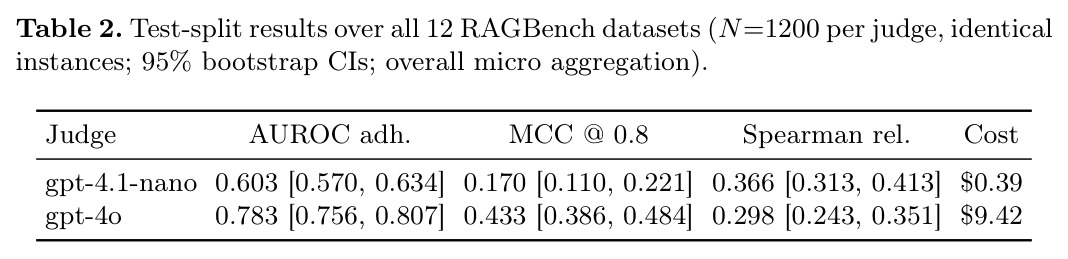
本文最重要的实证发现——gpt-4.1-nano 裁判在 RAGBench 上 AUROC 仅 0.603 却全程输出零协议错误的完美结果——正是关于裁判静默失败,强制元评测协议就是为约束它而设计。
Beta-Binomial 共轭贝叶斯模型
对二元结果(通过/失败)比率建模的标准方法:先验 $p_c \sim \mathrm{Beta}(\alpha_0, \beta_0)$(默认无信息先验 Beta(1,1)),观测到 $n_c$ 例中 $k_c$ 例通过后,后验共轭更新为 $\mathrm{Beta}(\alpha_0+k_c,\ \beta_0+n_c-k_c)$。小样本下后验自然很宽,等尾 95% 可信区间直接反映剩余不确定性。
这是 AGO 统计门的数学核心:把每个分层的通过率变成后验分布,进而计算回归风险 $\rho=P(p_B<p_A-\delta\mid\mathrm{data})$,用概率而非点估计驱动发布决策。
AUROC 与 MCC
AUROC 是阈值无关的排序指标:随机取一正一负样本,模型给正样本更高分的概率,0.5 等于随机水平。MCC(马修斯相关系数)在给定阈值下综合 TP/TN/FP/FN 四种结果,对类别不平衡稳健,随机预测期望为 0。两者互补:前者看判别排序能力,后者看实际部署工作点的表现。
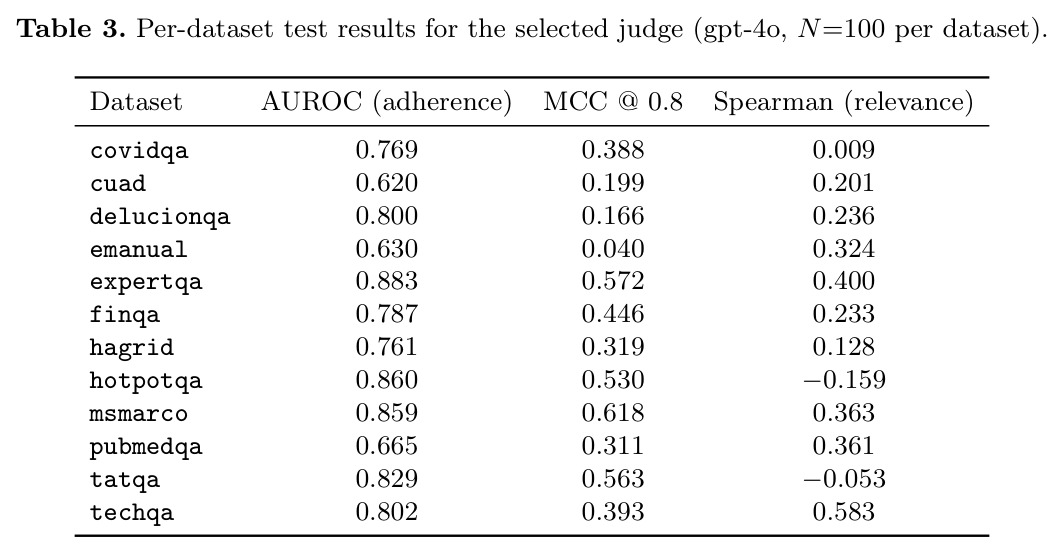
RAGBench 协议用 AUROC 评 adherence 判别力、用 MCC@0.8 评部署阈值下的工作点;论文报告逐数据集 MCC 在 0.040 到 0.618 之间的巨大差异,是"裁判质量必须逐领域测量"的直接证据。
质量门(Quality Gate)
源自 CI/CD 的工程概念:软件版本在进入下一阶段(发布)前必须通过一组自动化检查,不通过则阻断或转人工复核。关键设计维度包括检查失败时的语义(阻断/警告/仅观察)、证据缺失时如何处理、以及每次失败是否附带可解释、可审计的原因。
本文把这一工程概念系统性地引入 RAG 评测,提出四态决策格(promote / manual review / block / not evaluable),核心立场是"分数生产不等于发布决策",这正是标题中 evidence-first 的含义。
Bootstrap 置信区间
对已有样本做有放回重采样(本文用 1000 次、固定种子),每次重采样上重算统计量,用其经验分布的分位数构造 95% 置信区间。无需参数分布假设,特别适合小样本下为 AUROC、MCC 等非对称指标估计不确定性。
论文反复展示置信区间会改变结论:N=300 试点中 nano 的 AUROC 0.563 [0.495, 0.631] 覆盖随机水平,只有全量运行才支持判定,因此元评测协议强制所有一致性统计量附带 bootstrap 置信区间。
研究动机
企业在私有文档上部署 RAG 之后,每次版本升级都要回答同一个运营问题:这一版能否发布。现有评测生态(RAGAs、ARES、TruLens 等框架)只产出分数,把分数直接当决策依据会踩三个坑。其一,证据经常不完整:生产 trace 缺失上下文、模型供应商调用失败、LLM 裁判返回畸形输出,对"有什么就用什么"做平均,会把"测得差"和"根本没测到"混为一谈。其二,真实项目能负担的评测集很小(几十到几百例),且按类别刻意分层、关键案例过采样,此时点通过率严重夸大确定性。其三,测量工具本身未经验证:LLM 裁判存在位置与冗长偏差,大规模研究显示其与人类的一致性随任务和领域剧烈变化,在 A 领域测得的可靠性不能迁移到 B 领域。作者所在咨询公司的约束更严苛:客户数据不能离开内网,评测集小且分层不平衡,而且顾问必须能为他们签署的每一个自动化决策辩护。
本文的目标是构建一个可自托管、可审计的质量门平台,把 RAG 评测从"分数生产"升级为"发布决策"。具体目标有四个:把证据完整性作为一等公民——缺失证据必须以显式缺口(not evaluable)浮出并附影响说明,绝不允许隐式通过;把裁判有效性作为决策前置条件——LLM 裁判必须先通过针对当前部署领域的元评测协议,其分数才能影响门决策;把版本比较升级为概率陈述——用分层 beta-binomial 后验量化回归风险 $\rho$,替代误导性的点估计;把风险偏好参数化——所有阈值、先验、$\delta$ 都放进版本化评测 profile,调整风险偏好意味着改版本化配置而非改隐藏的代码常量,且每个决策都能从(数据集快照、profile 快照、代码版本)三元组复现。
与已有工作不同的是,本文不与 RAGAs、ARES 比拼打分精度,而是补上它们与真实部署之间的缺口:把分数转换成可问责的发布决策。独特切入体现在三层。第一,四态决策格用显式语义处理缺失证据与裁判协议错误——畸形输出绝不强制转换成分数,而是路由到人工复核。第二,把裁判元评测从"可选的最佳实践"变成强制协议:黄金集规模(冒烟级至少 30 例、决策级 100 例以上)、类别平衡(少数类不少于 30%)、双标注者加仲裁、Cohen's $\kappa$、MCC、AUROC、阈值扫描和 bootstrap 置信区间都有硬性规定,验证与裁判配置指纹绑定。第三,评测策略刻意谦逊而严谨:RAGBench 公开基准只检验裁判层,统计门用完全合成的受控模拟检验操作特性,明确声明 RAGBench 不是端到端验证——这种把系统边界拆开验证的写法在应用型论文里少见。
核心方法
直觉上,AGO 把发布决策当成证据审查而非打分。输入是版本化评测数据集 $D=\{x_i\}$ 中的案例 $x=(q, E, K^*, T, S, P)$:问题 $q$、可选期望行为 $E$(参考答案、期望词表 $T$、期望来源 $S$)、可选检索要求 $K^*$、禁用短语 $P$,每个案例带类别与关键性标记。评分分三层:第一层确定性检查——答案存在、必需上下文、来源与文档版本匹配、禁用短语、期望词匹配(带 Unicode/大小写/重音归一化和 profile 版本化同义词组),可复现且不依赖裁判;第二层本地护栏——规则引擎检查 PII、密钥、提示注入、JSON/链接有效性,规则动作为 block/warn/log,超时也产出可见证据;第三层 LLM 裁判——单次温度 0 的约束 JSON 调用可替换的 OpenAI 兼容端点,对 RAG 三元组(上下文相关性 $c$、遵从性 $g$、答案相关性 $r$)打分,分数仅在 $[-0.01, 1.01]$ 内接受并 clamp 到 $[0,1]$,越界即协议错误。逐案例按式(1)四态格决策,run 级按式(2)保守聚合,最后用式(3)的分层 beta-binomial 后验在基线 A 与候选 B 之间比较。
核心是把决策的隐藏假设变成显式输入,体现为三条原则。第一,无隐式通过:缺失证据只能产生 not evaluable 或 manual review,永远不能 promote;固定关键集合 $C$(缺失必需上下文、来源/版本不匹配、禁用短语、PII、密钥、注入、格式违规)是安全底线,优先于 profile 配置——即使误配为 observe-only,命中 $C$ 仍强制 block。第二,用后验替代点估计:每层通过率 $p_c \sim \mathrm{Beta}(\alpha_0, \beta_0)$,观测 $k_c/n_c$ 后得后验 $\mathrm{Beta}(\alpha_0+k_c, \beta_0+n_c-k_c)$,run 级为加权后验均值 $\bar{p}=\sum_c w_c\,\mathbb{E}[p_c\mid\mathrm{data}]$,回归风险 $\rho=P(p_B<p_A-\delta\mid\mathrm{data})$ 由固定种子的 S 次 Monte Carlo 估计,门规则为 $\rho\ge\tau_b$ 阻断、$\rho\ge\tau_r$ 人工复核、否则晋升(默认 $\delta=0.03$、$\tau_b=0.8$、$\tau_r=0.5$)。基线与候选刻意建模为独立——忽略共享案例的正相关会高估方差,使门保守地偏向 review/block。第三,裁判先验证后使用:与 RAGAs/ARES 优化分数的路线相反,AGO 把分数背后的一切(证据齐不齐、裁判可不可信、差多少算回归)摊到决策桌面上。
方法步骤详情
流程六步。①导入与策展:从异构可观测性栈导入 trace,归一化为供应商无关 schema;PII/密钥在成为数据集案例前脱敏;策展时重复、弱案例、覆盖缺口、隐私发现被显式标记,阻断性发现禁止跑门。②配置版本化 profile:阈值、同义词、护栏规则、裁判指令、统计策略(先验 $\alpha_0,\beta_0$、$\delta$、$\tau$)全部版本化,决策可由(数据集快照、profile 快照、代码版本)复现。③裁判元评测:构建领域黄金集(≥30 例冒烟级、≥100 例决策级,每维两类均在且少数类 ≥30%,含边界案例),双标注者独立标注加仲裁;分数在工作阈值二值化后算 raw agreement、Cohen's $\kappa$(单类时报告 undefined)、MCC、AUROC、阈值扫描和 95% bootstrap CI(1000 次重采样);不达标的裁判指标只能以 review-only 运行,验证绑定(模型标识、冻结 rubric、工作阈值),换端点即失效。④执行门:三层评分逐案例产出指标结果,按式(1)得 $dec(x)$——无结果则 not evaluable、命中 $C$ 或 block 模式失败即 block、其余失败转 manual review、否则 promote,按式(2) run 级保守聚合。⑤统计比较:分层(general/domain_specific/critical)计算后验,S=121 个固定种子(4201/4202)后验样本估计 $\rho$ 并与阈值比较。⑥报告:每个决策附失败原因、证据类型、分层不确定性与缺口,内容哈希快照持久化,非晋升案例全部路由顾问复核。
技术新颖性
技术新颖性集中在决策层而非打分层。已有工作把 LLM 畸形输出当作可插补或丢弃的噪声,AGO 定义了严格的协议错误语义——非数值或越界的裁判输出被标记为协议错误、指标置失败并转人工复核,绝不静默清零或 clamp;这种保守性有实证回报:gpt-4.1-nano 在全部 1200 个测试实例上零协议错误、解释流畅,AUROC 却只有 0.603、接近随机——只看操作输出无法发现,只有对标签测量才暴露,证明协议语义设计是有效的失败检测器。统计门把 A/B 比较从"均值差超阈值"升级为后验概率陈述 $\rho=P(p_B<p_A-\delta\mid\mathrm{data})$,独立建模是刻意保守的近似:多一次人工复核只费顾问时间,静默放行回归则是生产事故。其他把审计要求编码进统计语义的细节也颇具匠心:关键集合 $C$ 优先于 profile 的安全底线、无信息先验刻意把证据限制在候选自身、验证绑定裁判配置指纹以应对托管模型静默漂移、每个 run 持久化内容哈希快照。相较之下,RAGAs、ARES、TruLens 提供分数,而"在证据不完整下把分数转换成可问责决策"正是本文填补的空白。
实验结果
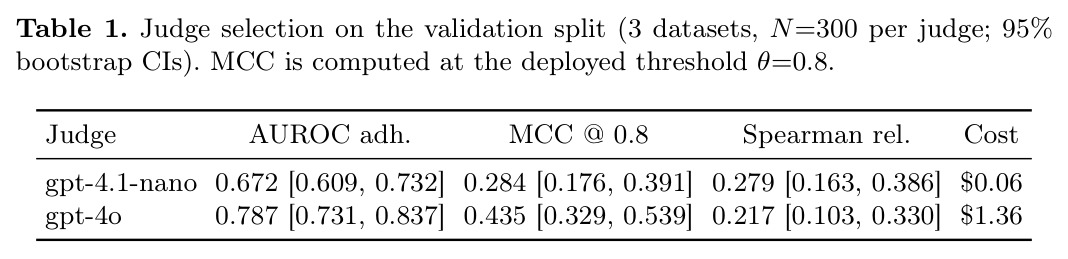
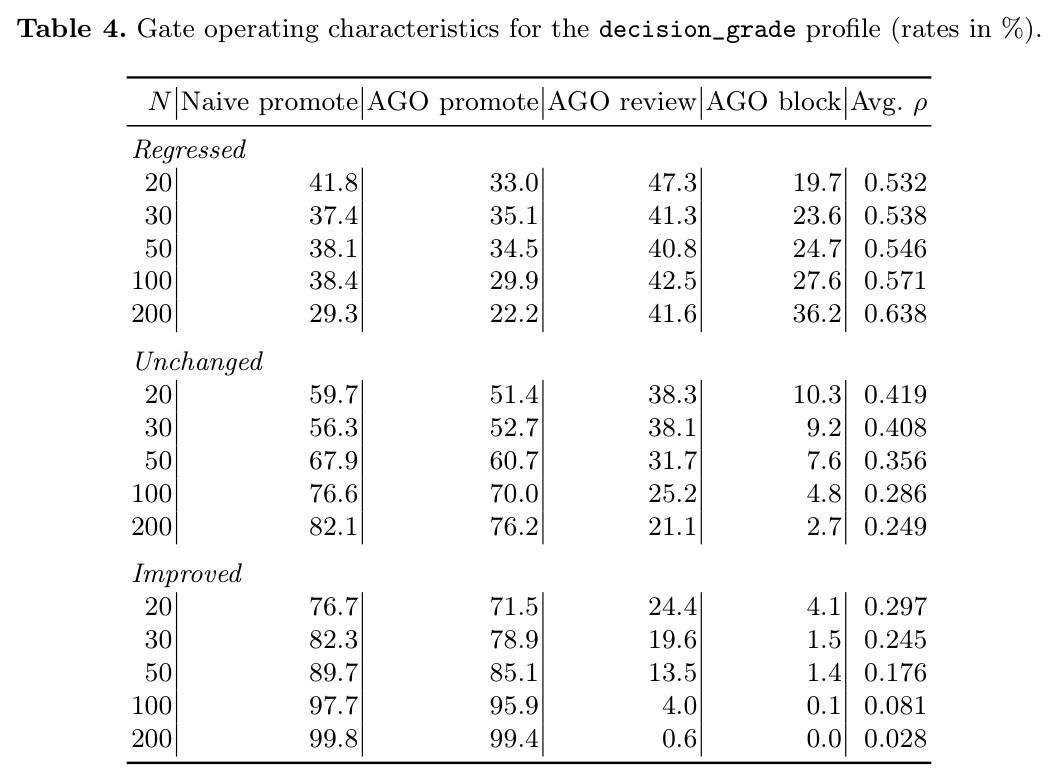
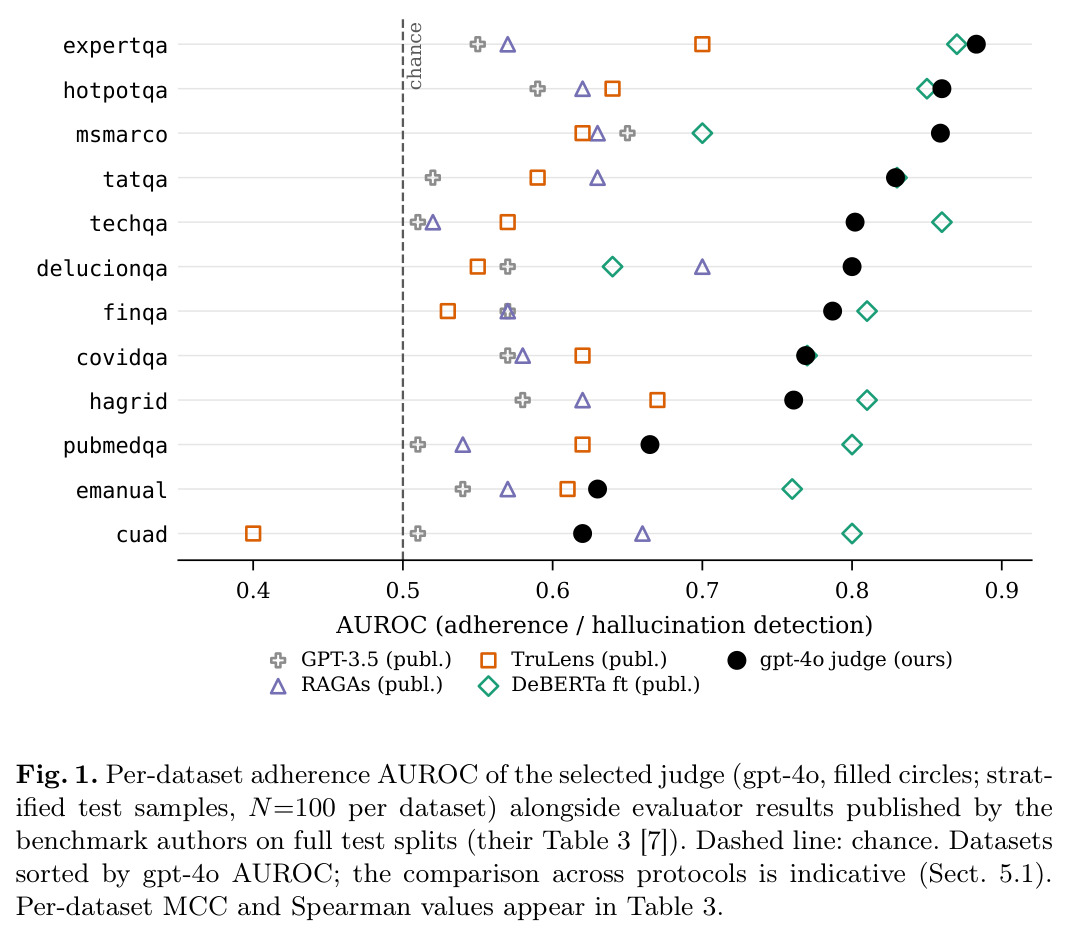
裁判层(RAGBench,12 数据集、每集 100 例固定种子分层样本,测试集每裁判 N=1200、实例相同):验证集(3 数据集 N=300)按预注册 MCC@0.8 准则选出 gpt-4o(0.435 [0.329, 0.539])优于 gpt-4.1-nano(0.284),成本 $1.36 对 $0.06。测试集上 gpt-4o 达 AUROC 0.783 [0.756, 0.807]、MCC 0.433 [0.386, 0.484],比 nano(AUROC 0.603 [0.570, 0.634]、MCC 0.170,成本 $0.39 对 $9.42)高 0.180/0.263,置信区间不重叠;nano 在 0.1–0.9 阈值扫描中 MCC 无一点超过 0.17,排除阈值问题;它全程零协议错误、解释完美流畅,是裁判静默失败的教科书案例。早期 N=300 试点中 nano 的 AUROC 0.563 [0.495, 0.631] 覆盖随机水平,展示没有置信区间的结论多不可靠。gpt-4o 逐数据集 AUROC 从 cuad 的 0.620 到 expertqa 的 0.883,MCC 从 emanual 的 0.040 到 msmarco 的 0.618——前沿裁判在某些领域接近无信息;Spearman 在 hotpotqa(−0.159)、tatqa(−0.053)为负,作者归因于与 TRACe 定义不匹配。对照发表值(跨协议参考):GPT-3.5 均值 0.56、RAGAs 0.60、TruLens 0.59、微调 DeBERTa 0.79,gpt-4o 均值 0.77、微聚合 0.783 落入微调编码器区间。统计门(合成模拟:N=20–200,三层比例 0.50/0.30/0.20,基线通过率 0.90/0.85/0.80,候选每层 ±0.05,每格 1000 次重复,种子 20260709,Beta(1,1),$\delta=0.03$,$\tau_b=0.8$):回归场景 decision_grade($\tau_r=0.4$)不安全晋升 22.2%–35.1% vs 朴素门 29.3%–41.8%,每个 N 更低(N=200:22.2% 对 29.3%,block 36.2%);无变化场景误报 23.8%–48.6%;改进场景晋升 71.5%–99.4%;N=200 时平均 ρ 三场景为 0.638/0.249/0.028。balanced_default($\tau_r=0.5$)回归下晋升 29.8%–43.9%、可比甚至超过朴素门,证明保护力来自更低的 review 阈值而非不同样本。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| RAGBench adherence(幻觉/不遵从)检测,12 数据集微聚合,测试集每裁判 N=1200、实例相同 | AUROC(95% bootstrap CI,1000 次重采样) | gpt-4o 裁判 0.783 [0.756, 0.807] | gpt-4.1-nano 0.603 [0.570, 0.634];已发表基线均值:GPT-3.5 判官 0.56、RAGAs 0.60、TruLens 0.59、微调 DeBERTa 0.79(跨协议参考) | 较低成本裁判 +0.180 AUROC,置信区间不重叠;落入微调编码器区间、高于全部零样本基线 |
| RAGBench adherence 检测 @ 部署阈值 θ=0.8(测试集 N=1200) | MCC | gpt-4o 0.433 [0.386, 0.484] | gpt-4.1-nano 0.170 [0.110, 0.221](全阈值扫描无一超过 0.17) | +0.263,区间不重叠;单次运行成本 $9.42 对 $0.39 |
| 统计门 · 真实回归场景(候选每层通过率 −0.05,N=20–200,每格 1000 次重复) | 不安全晋升率 | decision_grade 22.2%–35.1%(N=200 时 22.2%,block 36.2%) | 朴素门(观测通过率直接比较)29.3%–41.8% | 所有测试样本量下均更低,最高降低约 8.5 个百分点 |
| 统计门 · 无变化 / 改进场景(保护力的代价度量) | 晋升率 | 无变化 51.4%–76.2%(误报即 review+block 为 23.8%–48.6%);改进 71.5%–99.4% | 朴素门:无变化 56.3%–82.1%;改进 76.7%–99.8% | 以每场景约 5–8 个百分点的吞吐为代价换取回归保护,代价被显式量化报告 |
局限与改进
作者承认的局限:RAGBench 只检验裁判层与冻结元评测协议,"不是 AGO 的端到端验证";与已发表基线的对照是跨协议指示性参考(对方用全测试集和更早的 GPT-3.5 后端);relevance 的 Spearman/RMSE 对比因定义不匹配只算探索性;统计门实验基于合成独立二项数据(固定三层、均匀 ±0.05 位移),操作特性只描述所测数据生成过程下的权衡;基线与候选的独立建模是刻意保守而非统计正确。我自己的观察:验证集只有 3 数据集 N=300,裁判选型区间很宽(gpt-4o MCC 下界 0.329 与 nano 上界 0.391 实际重叠,选型稳健性存疑);只测了两个 OpenAI 模型,"裁判质量决定一切"的外推有限;模拟场景对称(所有层同时同幅移动),未测"关键层回归被其他层掩盖"的情形,而加权聚合 $\bar{p}=\sum_c w_c\,\mathbb{E}[p_c\mid\mathrm{data}]$ 恰可能稀释单层回归信号;部署工作流来自单一咨询公司实践,通用性证据不足;balanced_default 数字放在配套 artifact 而非正文;文中 API 定价($0.39/$9.42)会随时间失效。
独立分析的弱点
第一,加权聚合可能掩盖局部回归:run 级质量是 $\bar{p}=\sum_c w_c\,\mathbb{E}[p_c\mid\mathrm{data}]$,若 critical 层掉 15 个百分点而大权重层持平,总体 $\rho$ 可能仍低于 $\tau_b$ 就放行——恰是仿真未覆盖的异质回归情形。改进:作者已提到 stratum-specific $\delta$,可进一步做成"每层独立门 + run 级聚合"双层闸门,任一层超阈即升级。第二,黄金集成本高:决策级验证需 100 例以上双标注加仲裁,中小团队难以为每个部署域负担;可用 LLM 预标注加人审分歧样本的主动学习压缩标注量,或跨客户复用领域相近黄金集构造信息先验。第三,对裁判漂移的响应是被动的:托管模型静默更新触发重测,但发现漂移本身要靠再次元评测;可加轻量持续监控,对冻结参考案例的分数分布做漂移告警。第四,模拟验证过简:独立二项、对称位移、三种 strata 不足以代表真实发版,应加入层内相关(配对数据)、异质回归、非平稳流量权重等场景。第五,not evaluable 语义可能被滥用为逃避评测的出口(证据系统性缺失时整个 run 沦为 manual review),需配套证据覆盖率 SLA 与缺口趋势监控。
未来方向
作者明确提出的方向:配对贝叶斯比较——正确建模基线与候选共享案例的正相关,替代刻意保守的独立假设,减少不必要的 manual review;原生评测剩余 TRACe 维度(utilization 与 completeness 目前裁判不产出);per-case 方差的重复采样分析。基于本文成果可延伸:多裁判集成与仲裁——数据显示 nano 与 4o 单次运行成本相差 24 倍($0.39 对 $9.42),可用便宜裁判预筛、强裁判复核可疑案例,并把元评测协议扩展到集成裁判的有效性验证;在 $\rho$ 之上叠加 SPC 控制图做跨版本连续质量监测,把单次发版决策扩展为过程控制;信息先验与历史版本池化的实证研究(当前无信息先验刻意隔离历史,保持审计链干净);阈值校准自动化——论文证明固定阈值下逐域 MCC 在 0.040 到 0.618 间波动,按黄金集自动搜索每域最优工作阈值的工具是直接增值;以及把四态决策语义推广到 RAG 之外的 LLM 系统发布(agent 工作流、微调模型),检验 evidence-first 原则的普适性。
复现评估
复现难度中等偏可行。有利条件:门级实验完全本地、无外部模型调用(作者明示统计模拟不调用外部服务),随机性全部固定——数据种子 20260709、后验流种子 4201/4202、bootstrap 1000 次固定种子,样本清单(精确实例 ID)持久化,rubric 在测试集评分前冻结且事后未调,因此表 4 模拟和 RAGBench 裁判实验在算法层面应可精确复现;RAGBench 公开(100k 条 TRACe 标注 trace、12 数据集);模拟只需 CPU。不利条件:论文未提供开源代码仓库,平台核心(决策引擎、版本化 profile 系统、护栏规则引擎、内容哈希快照)需自行重建,工程量不小;裁判实验依赖 OpenAI API(按文中计价单次全测试约 $9.42、验证集 $1.36);元评测黄金集需自行标注(每域 ≥30/100 例双标注加仲裁),人力成本高于算力;balanced_default 数字在配套 artifact 而非正文,需先找到该 artifact;确定性检查与同义词归一化细节只有描述性说明,逐位复现确定性层可能有出入。
论文图表