RynnWorld-Latent:以通用潜在动作为条件的跨具身世界模型 RynnWorld-Latent: A Cross-Embodiment World Model Conditioned on Universal Latent Actions
用共享潜在动作接口统一人类、机器人与仿真视频,训练跨具身世界模型并合成机器人训练数据。
前置知识
世界模型(World Model)
给定当前状态和动作序列,预测环境未来如何演变的模型。视频世界模型把「未来状态」直接表示为生成的视频帧:输入初始帧 + 动作,输出动作执行后的视觉 rollout。它可用于策略评估、规划,以及本文的核心用途——合成机器人训练数据。与语言条件视频生成器的区别在于条件信号:世界模型用帧级连续动作,而语言只是任务级描述。
本文的全部架构、损失函数和实验都是围绕「动作条件化的视频预测」展开的,不理解世界模型范式就无法理解 RynnWorld-Latent 在做什么。
潜在动作学习(Latent Action Learning)
不使用机器人原生控制信号,而是从观测帧对之间自监督地推断出紧凑的「动作变量」:编码器观察 $v_{t}$ 与 $v_{t+\Delta t}$,输出一个描述「这两帧之间发生了什么变化」的连续向量。人类手、机器人夹爪、仿真智能体的底层控制信号截然不同,但它们的视觉过渡可以共享运动与交互模式,因此可作为跨具身的共享接口。
本文用冻结的 RynnLAM 输出 608 维 3D-grounded 潜在动作作为唯一预训练条件接口,这是全文区别于其他动作条件世界模型的根本所在。
Rectified Flow(整流流)
一种生成建模训练范式:把干净数据 $X_{data}$ 和高斯噪声 $\epsilon$ 用直线插值 $X_t = t\epsilon + (1-t)X_{data}$ 连接,训练网络预测速度场 $v_t = \epsilon - X_{data}$;推理时从纯噪声($t=1$)沿学习到的速度场积分回到干净数据($t=0$)。相比标准扩散的多步加噪-去噪,路径更直、采样更高效。
RynnWorld-Latent 基于 Cosmos3-Edge 的 rectified flow 参数化,训练损失 $\mathcal{L} = \mathbb{E}\|u_\theta(X_t, t, c, A) - v_t\|^2$ 与 CFG 公式都建立在这一框架上。
因果视频 VAE 与 latent 帧
把原始视频压缩到低维 latent 空间的自编码器,压缩率为 4×16×16:时间上每 4 帧合并为 1 个 latent 帧,空间上每 16×16 像素块对应 1 个 latent token。「因果」指每个 latent 只依赖过去帧,适合自回归生成。本文 81 帧的视频块经压缩变成 $L=21$ 个 latent 帧,首帧作为条件保持干净。
LAM 提取步长(4 帧)恰好等于 VAE 时间压缩因子(4×),这一严格对应是本文「帧对齐局部条件通路」设计的前提,也是理解方法核心创新的关键。
Classifier-Free Guidance(CFG,无分类器引导)
增强条件可控性的技巧:训练时以一定概率随机丢弃条件(让模型同时学会无条件生成),推理时用 $\hat{u} = u_\emptyset + s(u_{cond} - u_\emptyset)$ 把条件和无条件预测外推,$s$ 为引导尺度,$s>1$ 时生成结果更强地服从条件。本文还做了分片丢弃:分别以 0.1 概率丢整体动作、操作切片、相机切片。
论文以 1.15 的引导尺度在动作条件上做 CFG,且训练时的三种 dropout 策略直接支撑推理时的联合/分片引导,是复现时必须注意的细节。
动作重定向与逆运动学(IK)
重定向(retargeting)把一个具身的运动(如人类手部关键点轨迹)映射到另一具身的动作空间;逆运动学则根据末端执行器目标位姿反解关节角度。本文用手部姿态估计得到人手轨迹,经坐标映射、工作空间缩放后,在 MuJoCo 中做基座位姿搜索 + IK 求解,得到目标机器人(如 20-DOF WUJI 灵巧手)的关节命令。
两条数据生成管线(latent-action 合成与数字遥操作)都依赖重定向 + IK 来产出配对的「伪机器人动作」标签,附录 C 的质量门控阈值也全部围绕它设定。
研究动机
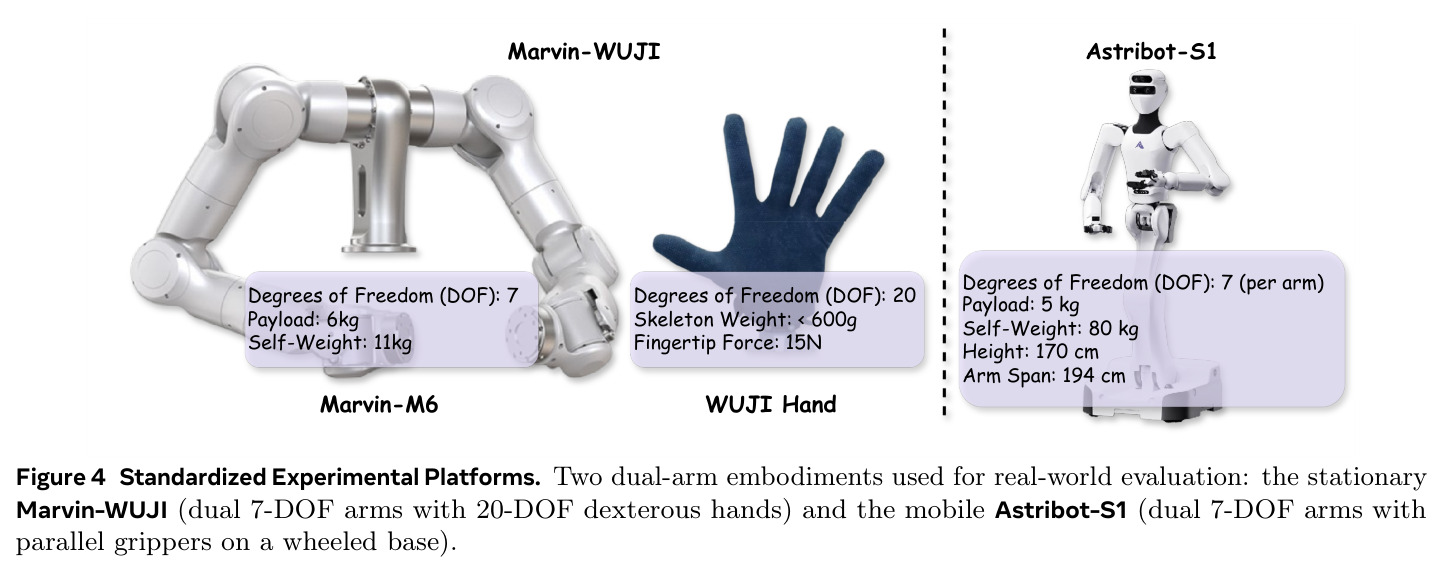
让机器人「预知未来」的世界模型需要动作条件,但动作接口是跨具身学习的最大障碍。不同机器人在运动学空间上完全不兼容:自由度数量、坐标约定、控制频率、硬件限制各不相同——本文的两个真机平台就有 54 自由度的 Marvin-WUJI(双 7-DOF 臂 + 双 20-DOF 灵巧手)和轮式双臂夹爪的 Astribot-S1。直接用原始机器人动作做条件的世界模型难以跨平台扩展。与此同时,大规模人类第一视角视频(EgoDex、EPIC-KITCHENS 等)蕴含丰富的操作动态却没有原生控制标签,仿真数据的动作空间也未必匹配目标机器人。另一个方向——语言条件化的视频生成器——则存在接口错位:「拿起杯子」这类任务级指令只规定结果,不决定精确轨迹;在接触密集的操作中,夹爪闭合时机、接触顺序、相机运动的微小差异会导致截然不同的未来,而且自然语言根本无法表达「保持前段运动不变、提前闭合夹爪」这种时间精确的干预。结果是文本条件模型必须为同一指令表示多条可能轨迹,无法精确控制操作动态。
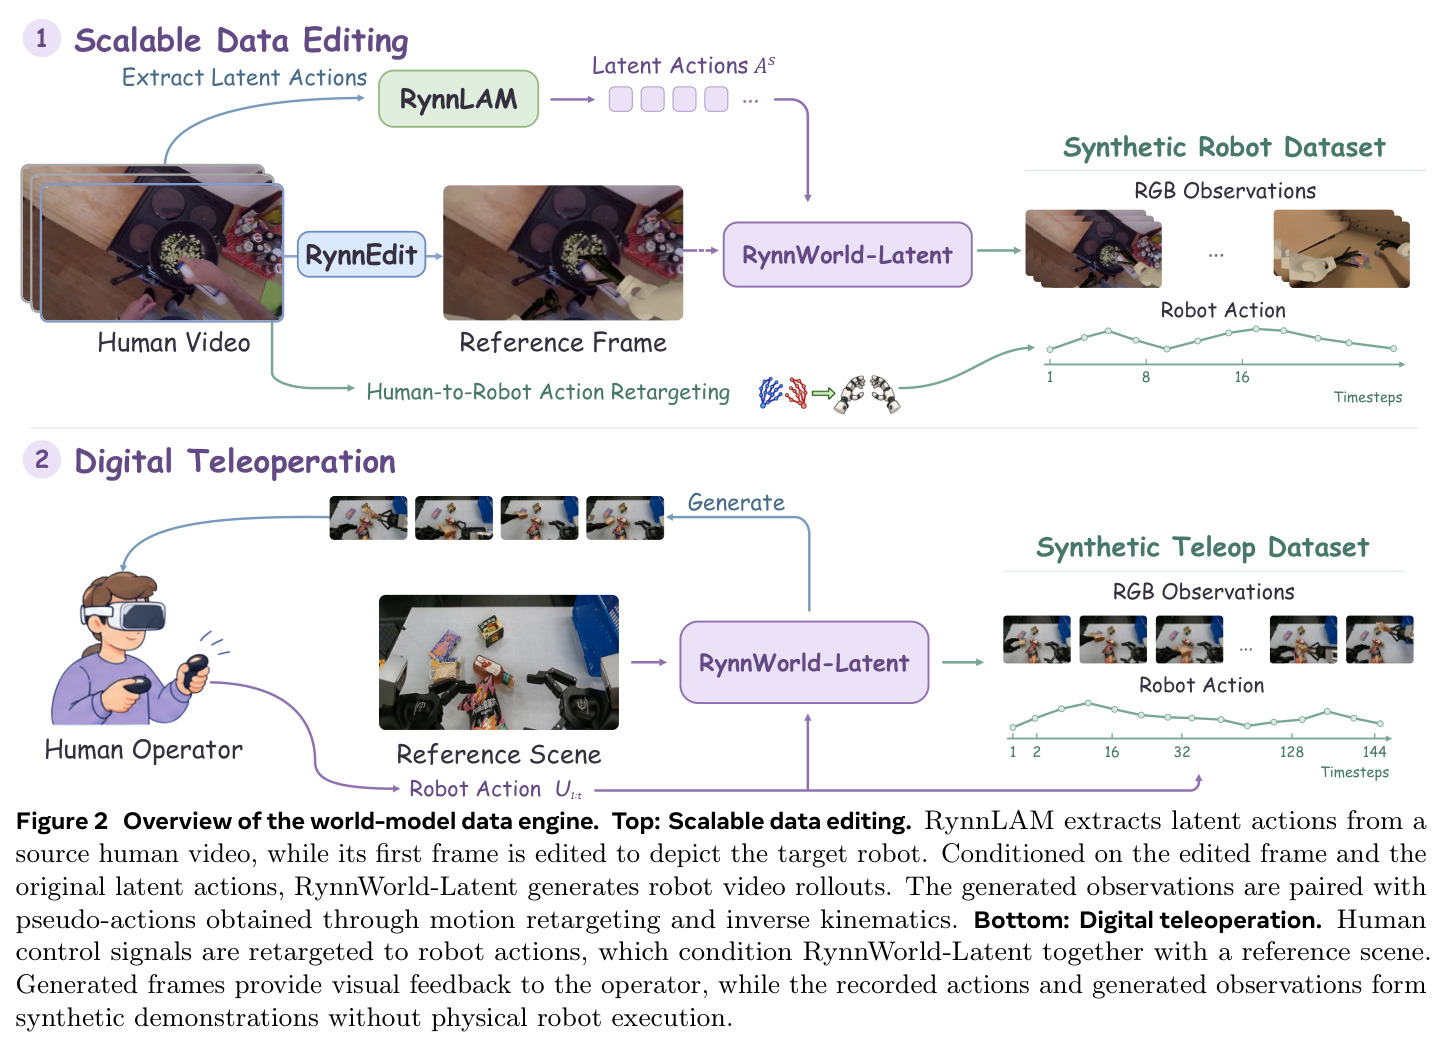
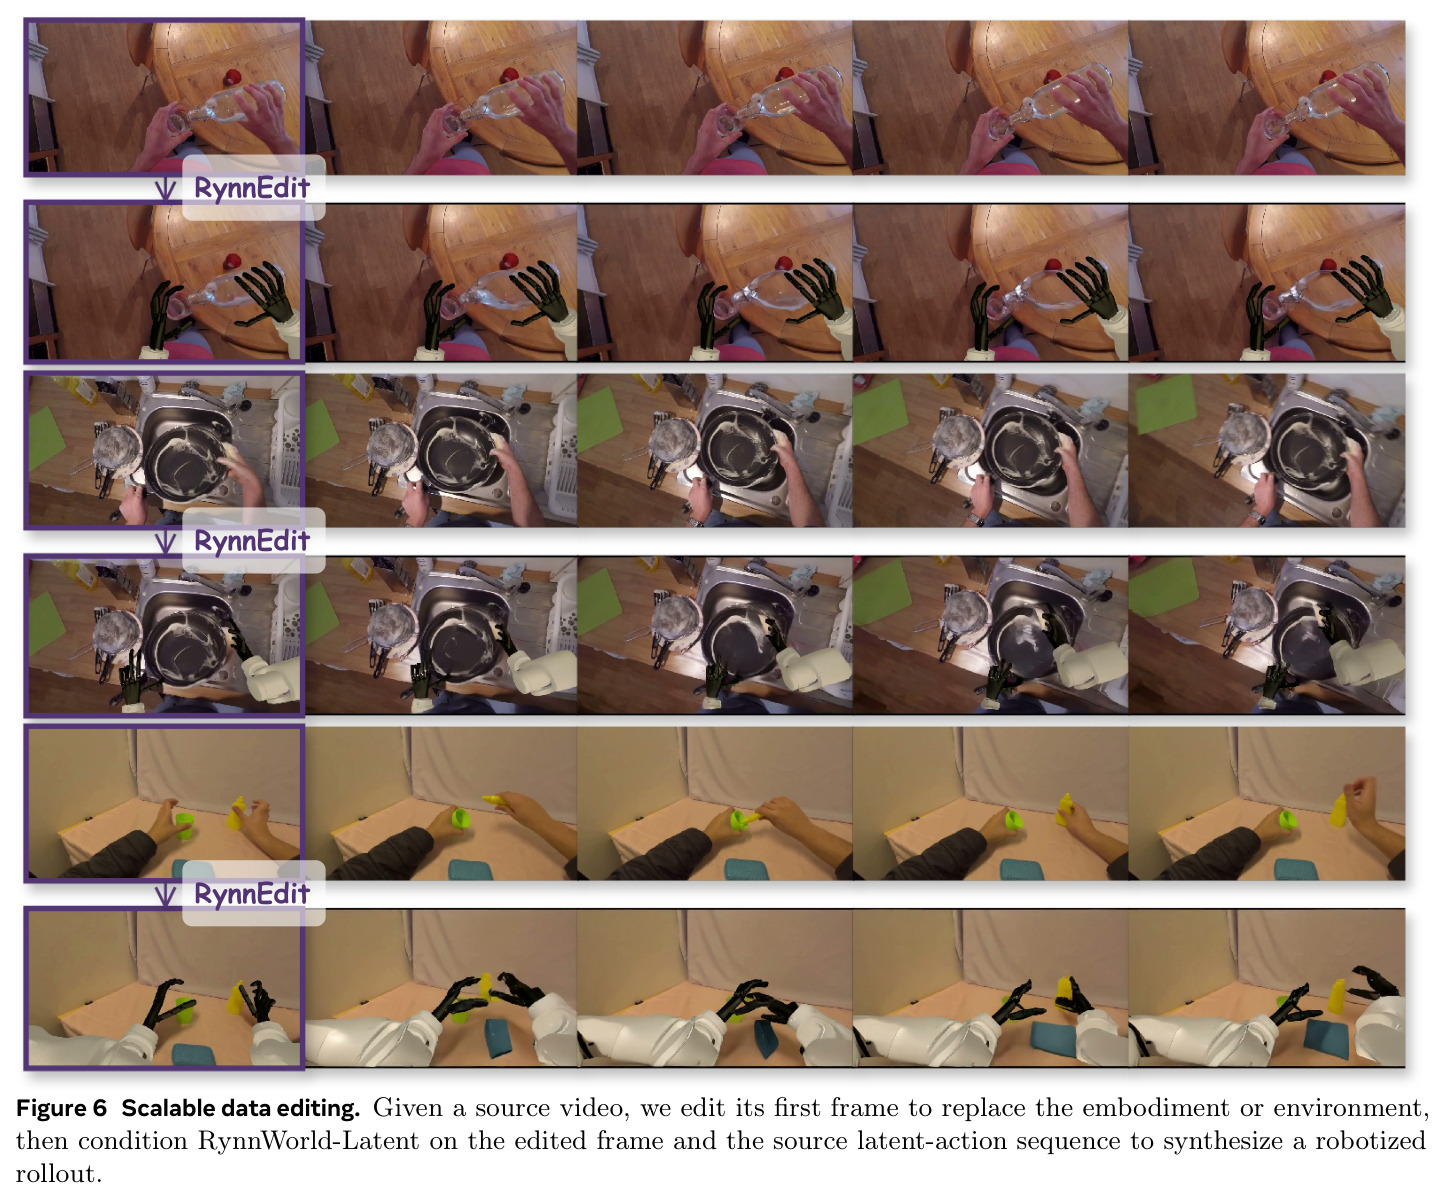
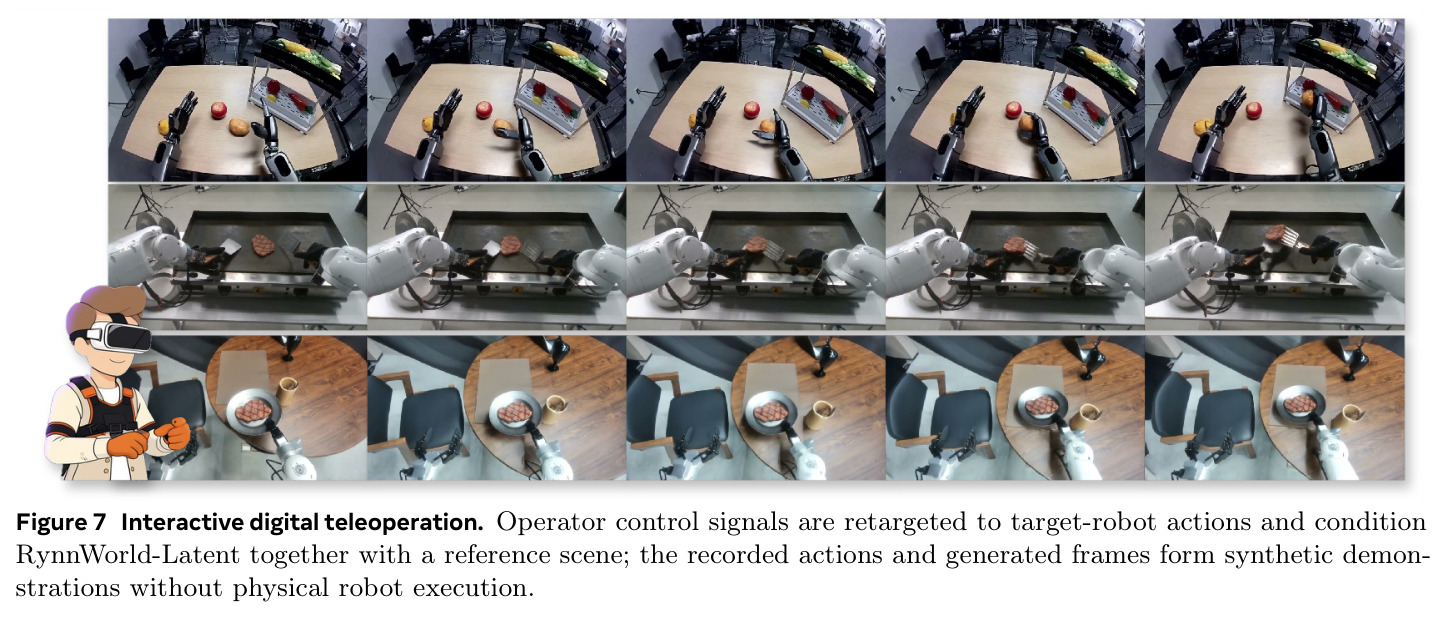
本文的目标是本文目标是构建一个跨具身的动作条件化视频世界模型:给定初始观测帧和一段连续潜在动作序列,预测未来视频,且不依赖文本条件或统一的机器人原生动作空间。更进一步的野心是把它当作「数据生成引擎」用于可扩展的机器人学习——作者明确提出不应只把世界模型看作未来预测器,而是两条数据生产线的核心:(1) 目标机器人适配后支持「交互式数字遥操作」,操作员控制信号映射为目标机器人动作并驱动视频生成,无需物理机器人执行即可产出配对的动作-视频数据;(2) 潜在动作驱动的数据合成,把已有视频的动作序列迁移到编辑后的首帧(替换具身或环境)上生成新 rollout,配合重定向 + 逆运动学得到的伪机器人动作标签供下游 VLA 训练。最终用三个互补视角验证:公开与自建基准上的视频预测保真度、固定初始帧下的定性动作可控性、以及生成数据对下游策略成功率的实际提升。
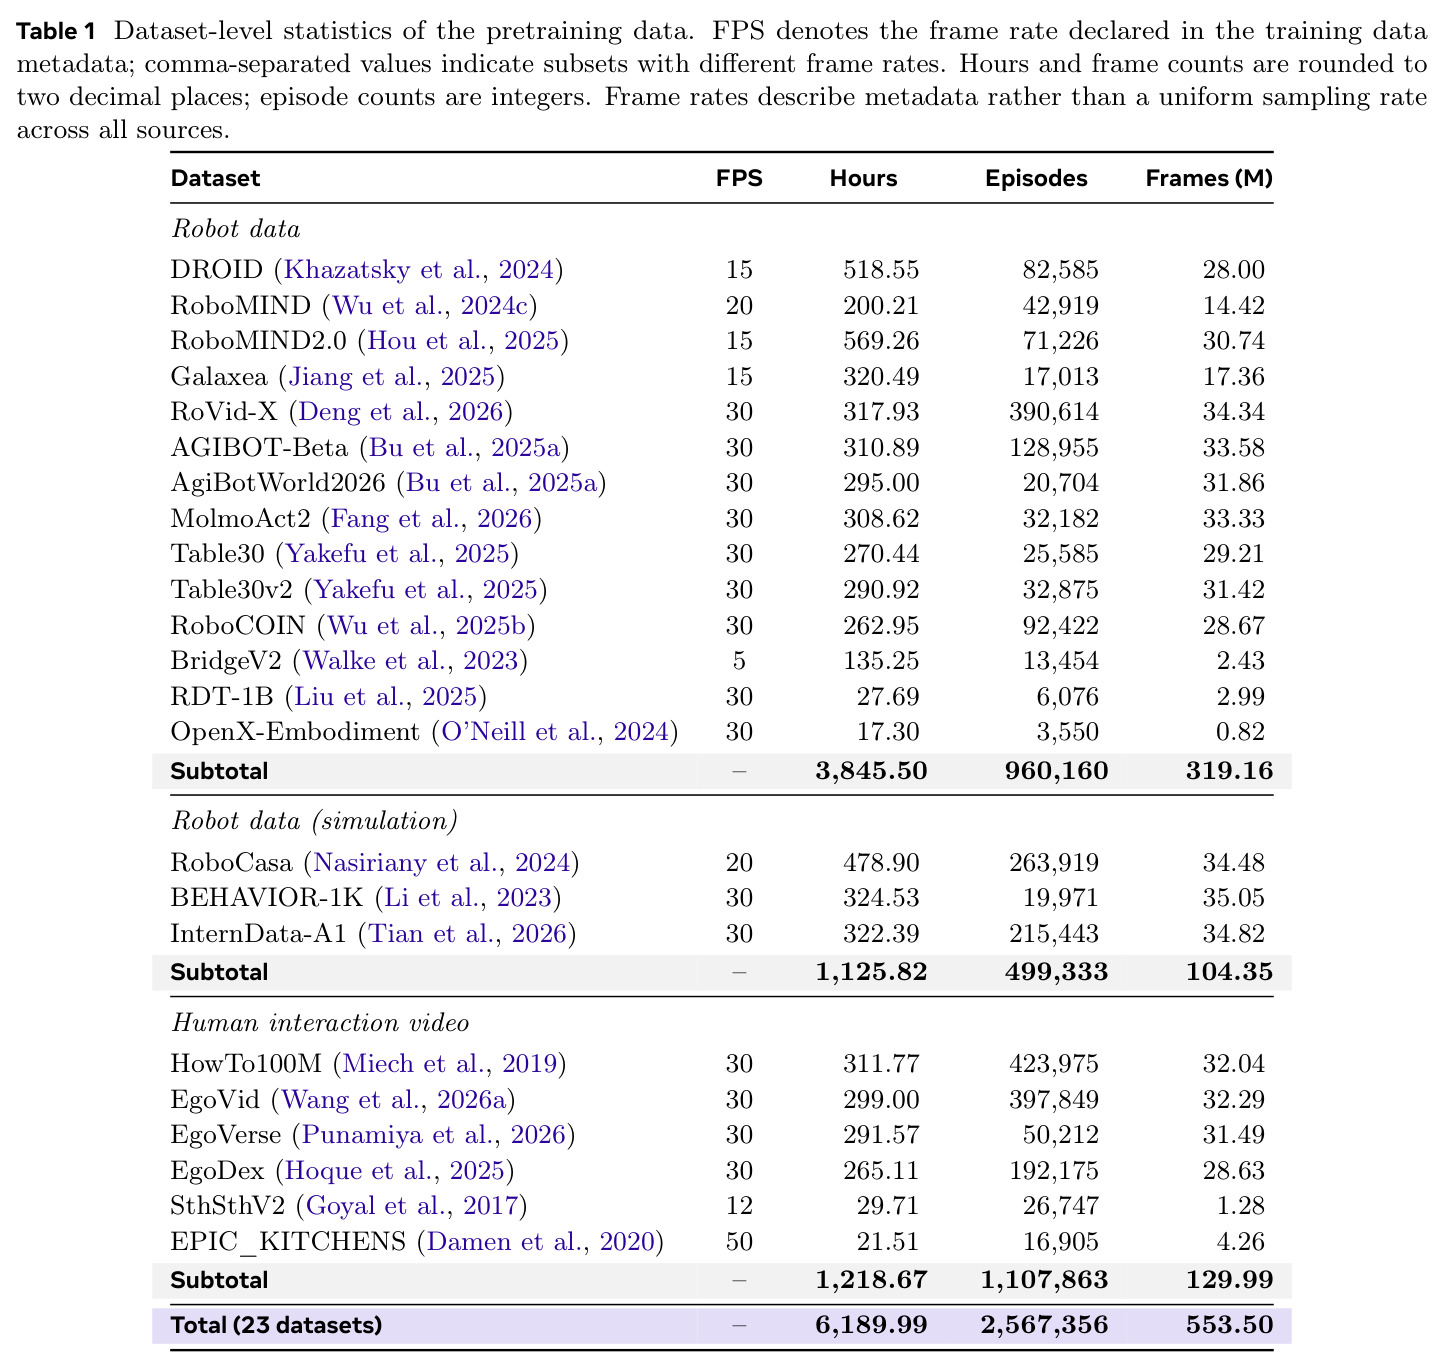
与已有工作不同的是,与已有工作的关键区别在于条件信号的选择:不是为某个机器人做更强的动作编码器,而是把「观测之间发生了什么变化」编码为共享接口。RynnLAM 从视频对中蒸馏出 608 维 3D-grounded 连续潜在动作描述子,人类的手、机器人夹爪、仿真智能体的底层控制信号可以截然不同,但它们的视觉过渡共享运动与交互模式。相比依赖原生控制标注的跨具身方法(如 OpenX-Embodiment 系)或需要显式运动重定向的几何运动表示方法,这条路线让 23 个数据集、约 6189.99 小时、256.7 万条轨迹——含 3845.5 小时真机数据、1125.8 小时仿真和 1218.7 小时人类交互视频——在统一的动作条件目标下联合预训练,完全无需对齐它们的原生控制空间。架构上则利用 RynnLAM 提取步长(4 帧)与视频 VAE 时间压缩因子恰好相等这一对应关系,设计帧对齐的局部条件通路,让每个动作描述子精确 conditioning 它所描述的那个未来视频 latent,这是以往 latent-action 世界模型工作(Genie 离散码、DreamDojo 等)没有做到的。
核心方法
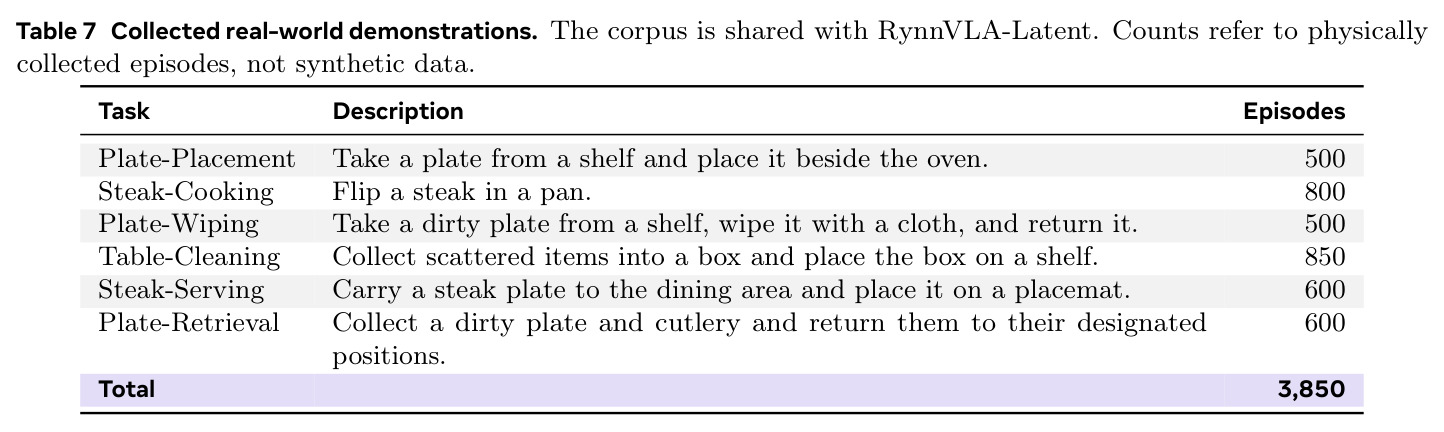
整体分三个阶段。第一阶段是跨具身预训练:把人类第一视角视频、机器人遥操作数据、仿真 rollout 全部用冻结的 RynnLAM 重新标注为共享潜在动作空间,在 Cosmos3-Edge(mixture-of-transformers 视频基础模型,无 adaptive layer norm)上以 rectified flow 去噪视频 latent。形式化地,视频 latent 帧索引 0 到 $L-1$,首帧 $x_0 = c$ 固定为条件,模型学习 $p_\theta(x_{1:L-1} \mid c, A)$,其中 $A = \{z_j\}_{j=1}^{J}$ 是潜在动作序列。一个完整训练块 $T=81$ 帧,经 4×16×16 压缩的因果视频 VAE 得到 $L=21$ 个 latent 帧,$J = L-1 = 20$ 个潜在动作;较短轨迹保留可变长度块 $T \in \{33, 37, \dots, 81\}$,对应 $J \in [8, 20]$。第二阶段是目标机器人后训练:在与 RynnVLA-Latent 共享的 3850 条真机演示(6 个任务)上适配目标具身的视觉外观、相机配置和交互分布,并通过轻量编码器 $E_\psi$ 引入机器人原生动作条件接口。第三阶段是数据生成:后训练后的模型同时支持条件于潜在动作的数据合成和条件于机器人动作的交互式数字遥操作。预训练共 20K 优化步,全局 batch 512,峰值学习率 $2.26 \times 10^{-4}$,480p 分辨率桶训练。
核心创新是「全局动作 token + 身份初始化的帧对齐局部通路」双通道注入。关键洞察:由于 RynnLAM 的提取步长(每 4 帧一个潜在动作)与 VAE 时间压缩因子(4×)严格相等,第 $j$ 个潜在动作与第 $j$ 个未来 latent 帧在时间上精确对应——这允许把动作描述子直接「钉」到它所描述的那个未来帧上,而不是像普通 cross-attention 那样让动作序列弥散到所有帧。具体地,每个动作经 $h_j = W_{act}[z_m^j; z_a^j] + W_{cam} z_c^j$,$\tau_j = h_j + \mathrm{MLP}(h_j)$ 编码为 token(MLP 输出投影零初始化),$\tau_j$ 作为全局 token 参与联合自注意力;同时在第一个 transformer block 之前,对属于未来帧 $j$ 的视觉 token 施加 $q \leftarrow q \odot (1+\gamma_j) + \beta_j + g \odot \tau_j$,其中 $V_j$ 是帧 $j$ 的视觉 token 集合,$(\gamma_j, \beta_j)$ 由零初始化线性头产生,$g$ 是零初始化逐通道门。所有新增的视觉侧通路初始时都是恒等映射,遵循控制增强扩散模型的 zero-init 惯例,训练从预训练生成器平滑出发。这与以往方法的本质区别:不要求动作空间对齐、不要求文本、也不把动作当作弥散的全局条件,而是利用接口层的整数索引对应实现动作-帧精确绑定。
方法步骤详情
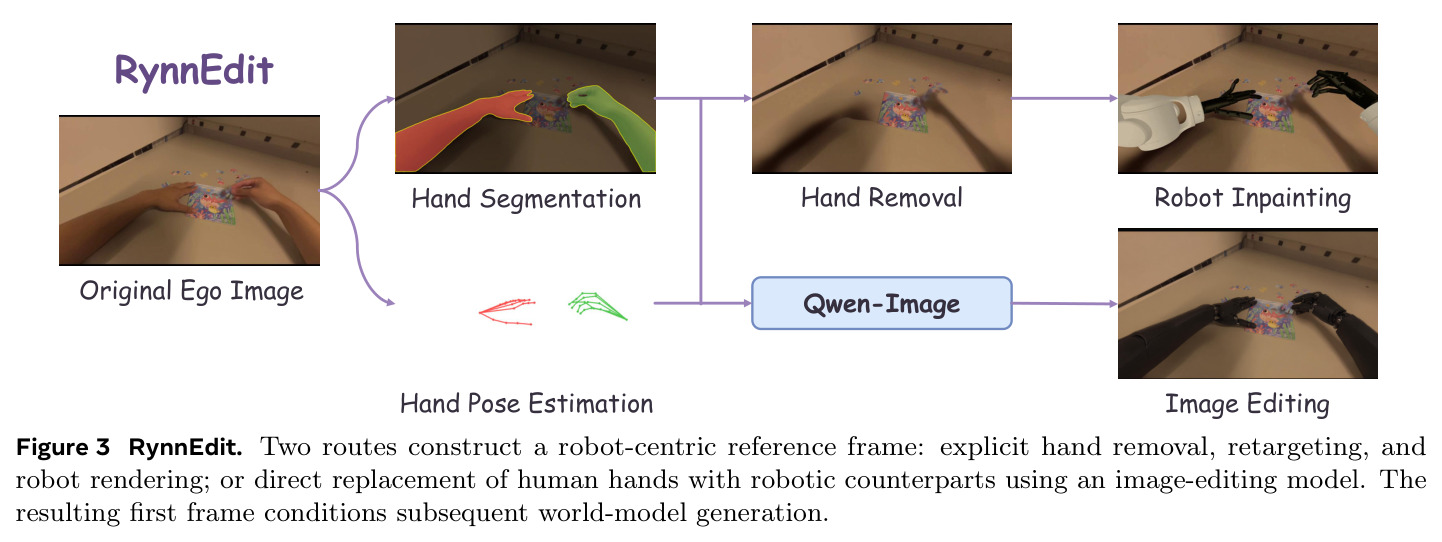
完整流程如下。(1) 潜在动作标注:冻结的 RynnLAM 对每对帧 $(v_{4(j-1)}, v_{4j})$ 输出 $z_j = [z_m^j; z_a^j; z_c^j] \in \mathbb{R}^{608}$——512 维运动 token 特征、64 维全局动作 latent、32 维相机分量,其中 576 维操作相关切片 $[z_m^j; z_a^j]$ 是主条件;每一维用 8000 条轨迹样本估计的 1%/99% 分位数归一化到 $[-1,1]$ 后截断。(2) 条件注入:按式 (3)(4) 编码并注入,条件帧 $c$ 不加调制。(3) 训练:rectified flow 损失 $\mathcal{L} = \mathbb{E}\|u_\theta(X_t, t, c, A) - v_t\|^2$,$X_t = t\epsilon + (1-t)X_{data}$,只有首帧 latent 保持干净作条件;CFG 训练以 0.1 概率丢整段动作、各以 0.1 概率丢操作切片/相机切片,推理引导尺度 1.15,即 $\hat{u} = u_\emptyset + 1.15(u_A - u_\emptyset)$。(4) 目标机器人后训练:3850 条演示按任务 95%/5% 划分后训练/测试(episode 级划分、在 chunking 之前),新增目标特定编码器 $E_\psi(u_j) = \tau_j^u$ 走同一注入通路,用 5× 学习率训练。(5) 数据生成:RynnEdit 管线用 SAM3 手部分割 + 视频修复 + MuJoCo 基座位姿搜索与逆运动学 + 渲染合成(路线一),或 Qwen-Image-Edit 直接把手换成机械手(路线二),构造机器人中心参考帧;再走 latent-action 合成或数字遥操作管线;合成数据按关节限位、运动平滑性、视觉质量、时间一致性、交互合理性过滤,修复区外 PSNR 需 ≥30dB、位置误差 ≤5mm、旋转 ≤5°、指尖方向一致性 ≥0.9。
技术新颖性
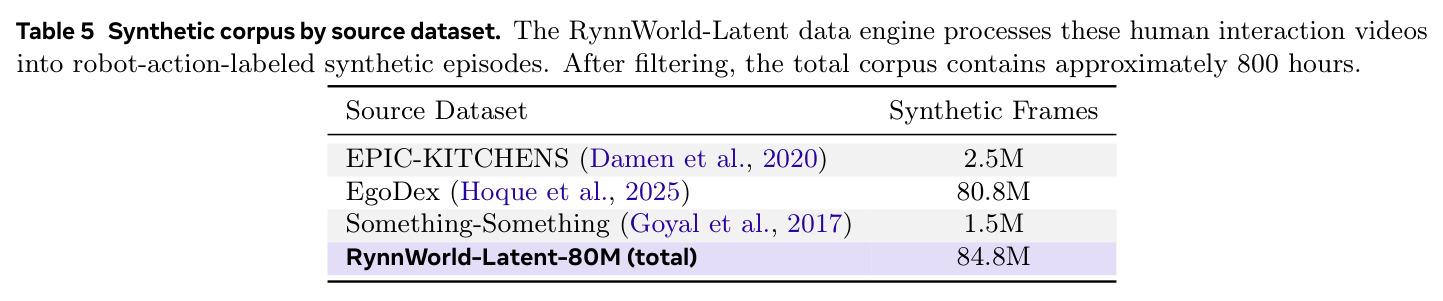
技术新颖性有四点。其一,把世界模型预训练的条件接口从「原生动作空间」彻底解耦为「视觉过渡的潜在描述」,使无控制标签的人类视频首次能与真机、仿真数据在同一动作条件目标下联合训练——相关先行工作(Genie 的离散码、LAPA、DreamDojo 等)要么用离散 latent code,要么仍需额外的控制标注对齐,本文用冻结的 3D-grounded 连续描述子一步到位,且消融证明去掉潜在动作预训练会全面掉点(Marvin-WUJI PSNR 21.86→21.32)。其二,帧对齐局部注入利用了 LAM 步长与 VAE 时间压缩的严格整数对应(4:4),这个设计是本文独有的,消融显示去掉它 Marvin-WUJI 上 PSNR 降 0.72、Astribot-S1 上降 0.88,是两个架构组件中贡献更大的一个。其三,同一模型在同一权重下支持两种条件模式(潜在动作 / 目标机器人动作 $E_\psi(u_j)$),通过分离的轻量编码器桥接,避免为每个新机器人重训整个世界模型。其四,RynnEdit 双路线(显式修复+IK 渲染 vs 端到端图像编辑)加上可审计的质量门控体系,把「世界模型即数据引擎」的愿景落成了 84.8M 帧、约 800 小时(EPIC-KITCHENS 2.5M + EgoDex 80.8M + Something-Something 1.5M 帧)的实际合成语料 RynnWorld-Latent-80M。
实验结果
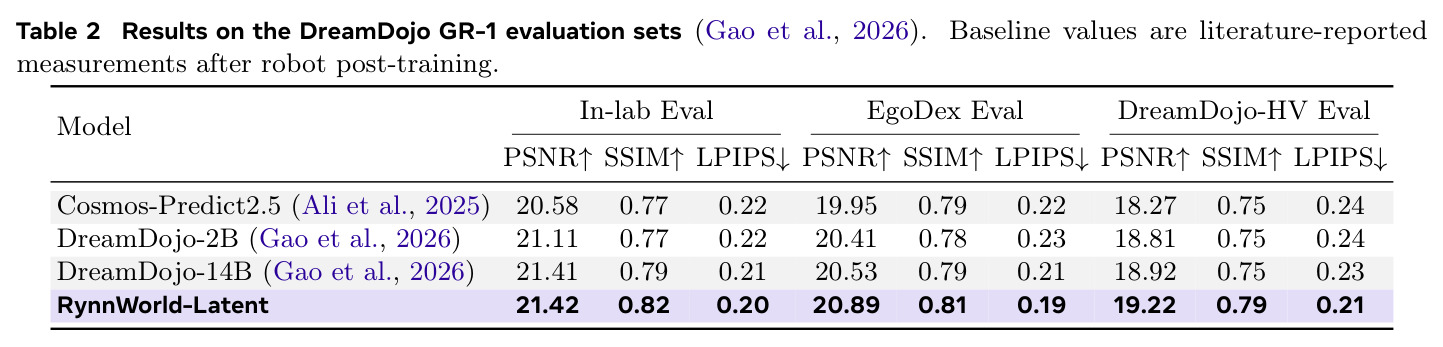
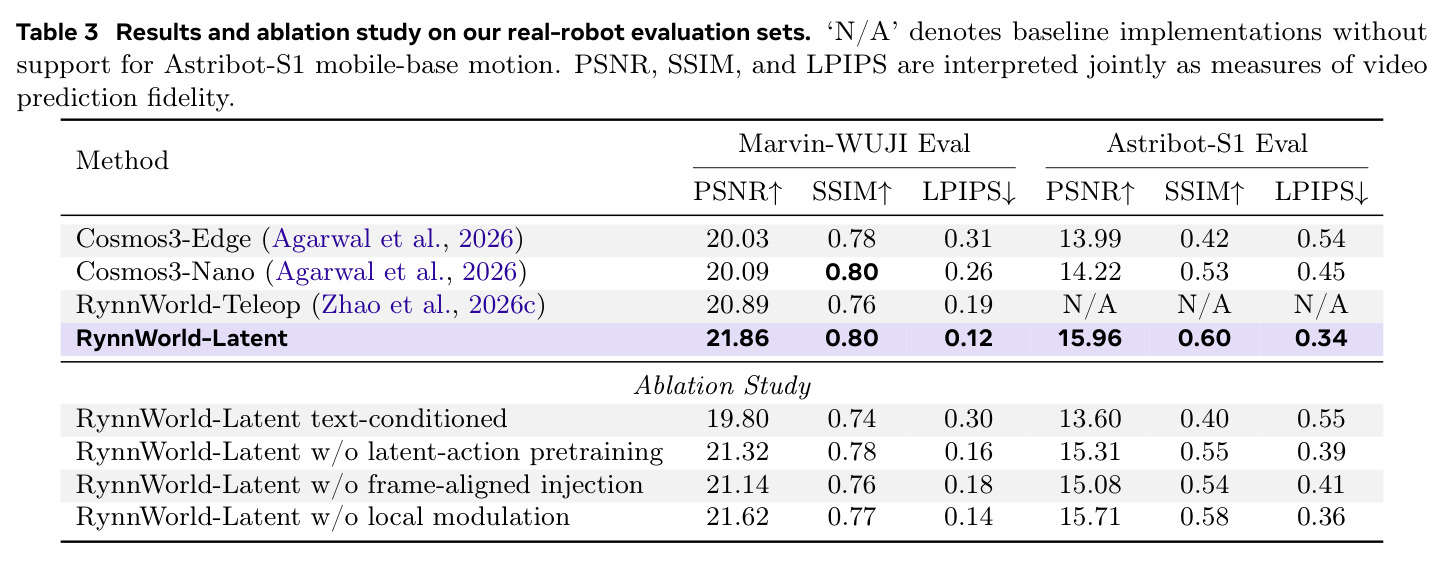
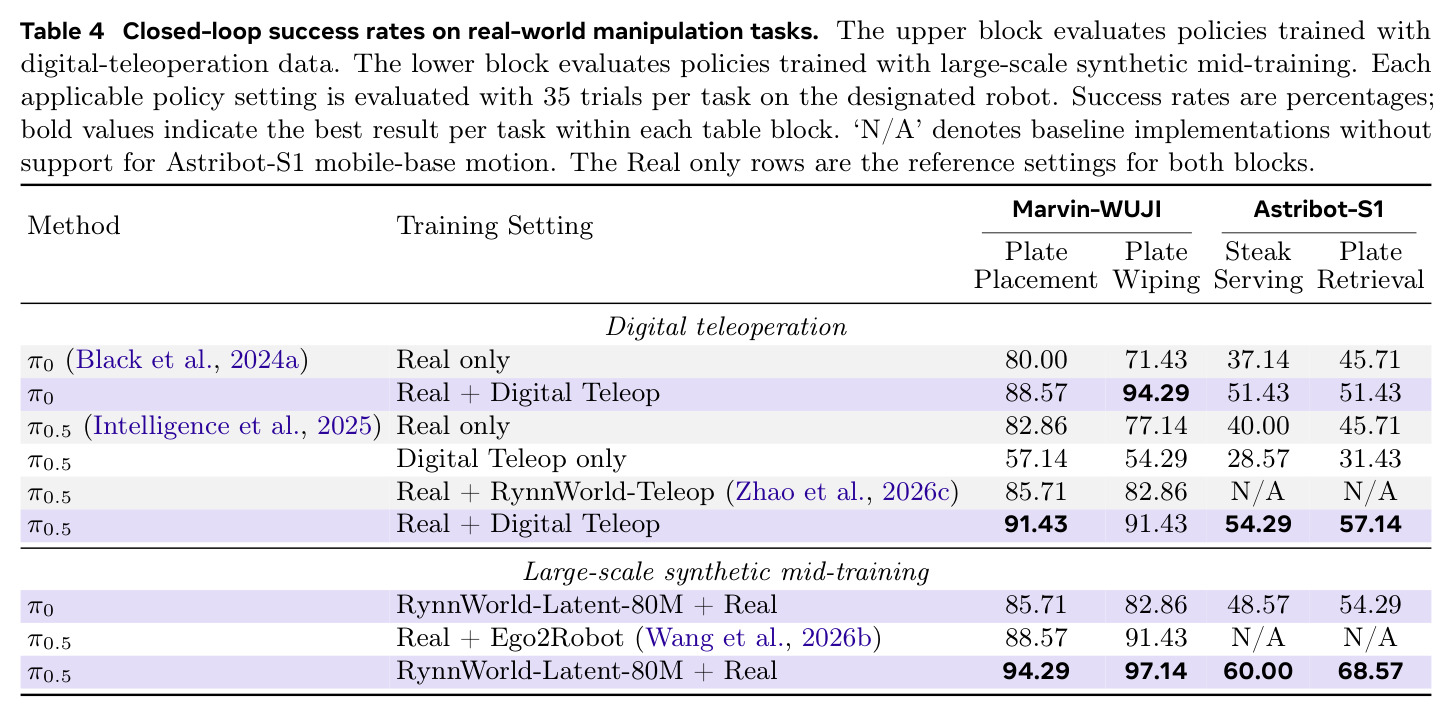
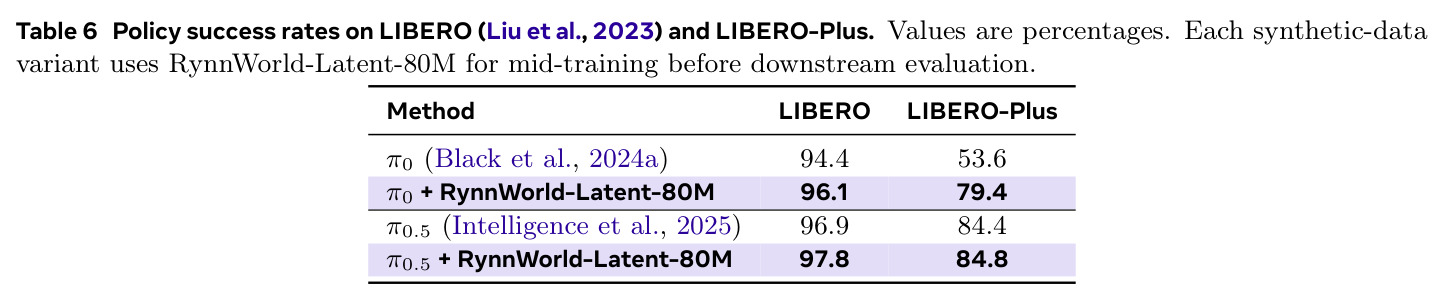
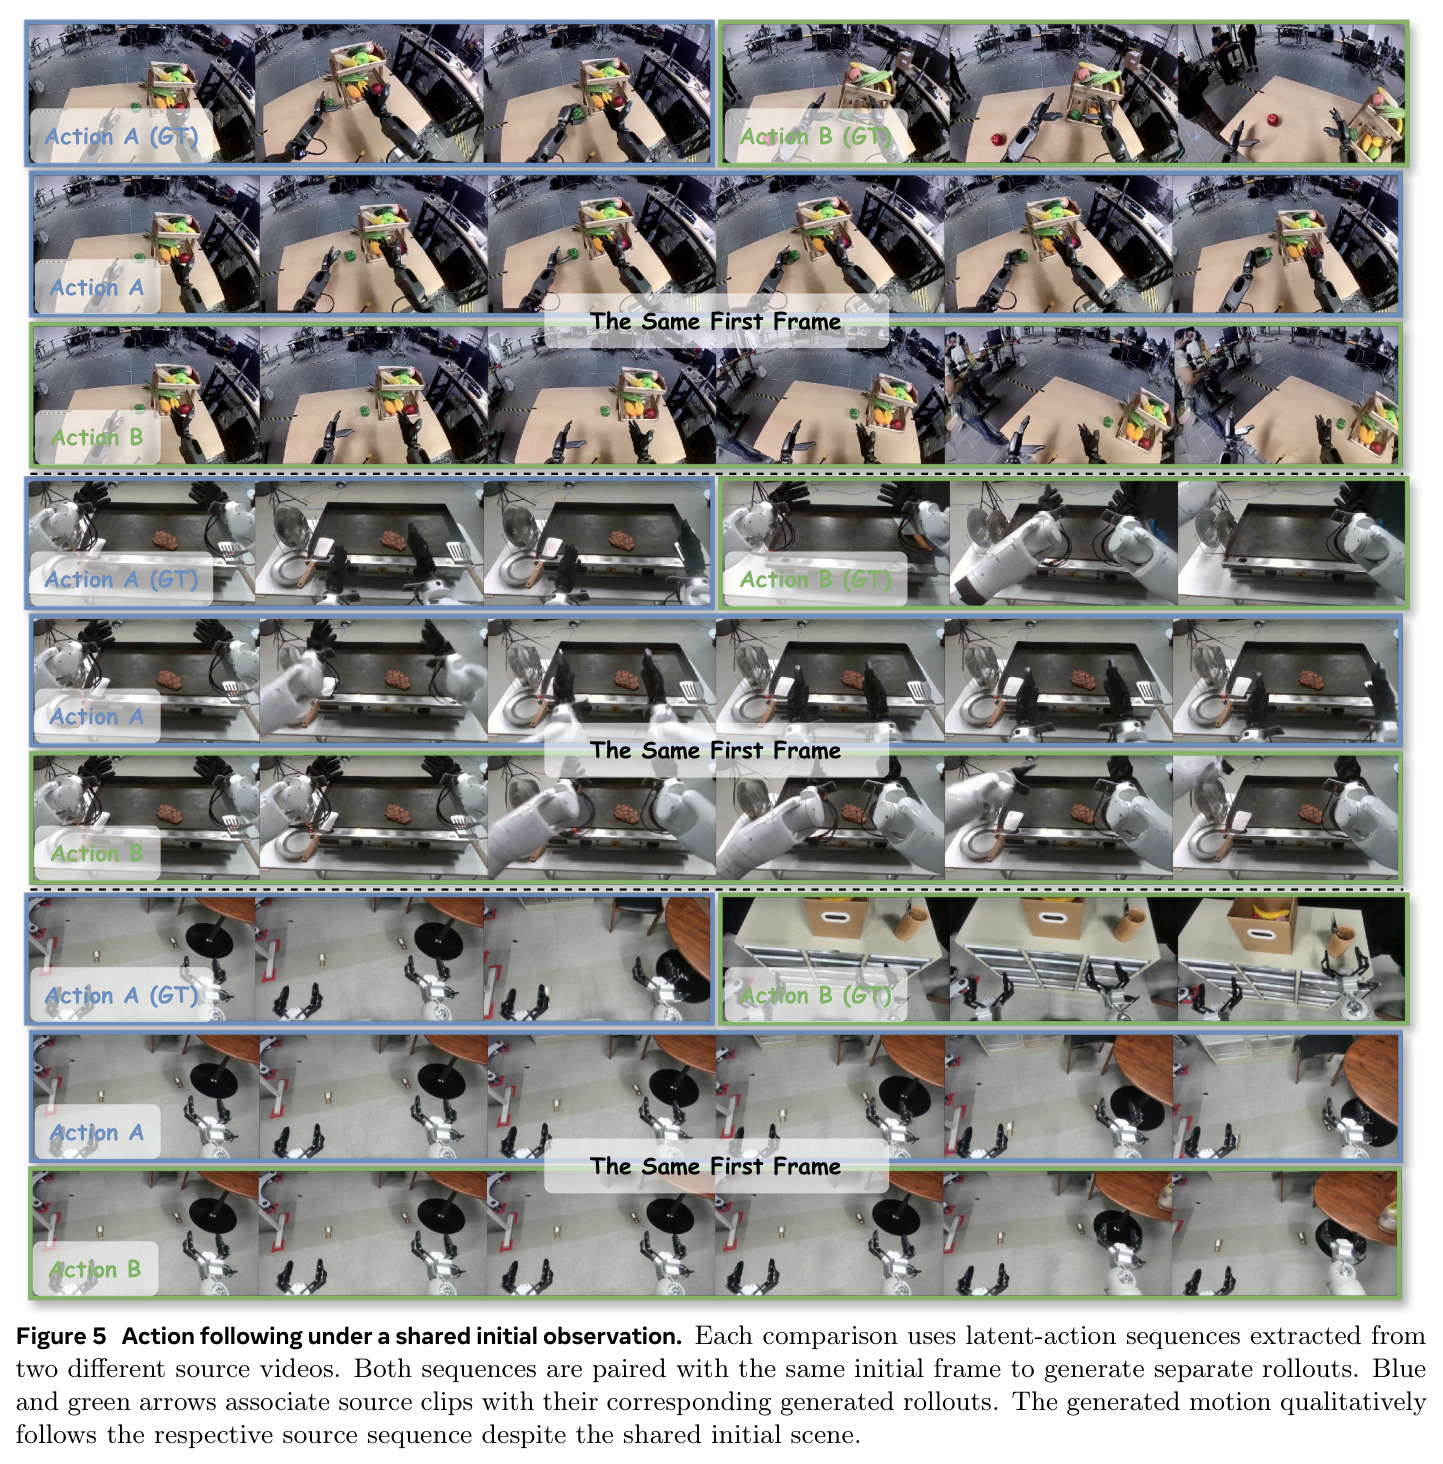
三组实验相互印证。(1) 公开基准(Tab. 2):在 DreamDojo 的三个 GR-1 评测集上全面超过 Cosmos-Predict2.5 与 DreamDojo-2B/14B——In-lab Eval PSNR 21.42 / SSIM 0.82 / LPIPS 0.20(14B 为 21.41/0.79/0.21);EgoDex Eval LPIPS 从 DreamDojo-14B 的 0.21 降至 0.19;DreamDojo-HV Eval PSNR 19.22 vs 18.92,说明人类视频预训练确实迁移到了未见过的物体交互。(2) 自建双平台真机评测(Tab. 3):Marvin-WUJI 上 PSNR 21.86 / SSIM 0.80 / LPIPS 0.12,优于 Cosmos3-Edge(20.03/0.78/0.31)、Cosmos3-Nano(20.09/0.80/0.26)与 RynnWorld-Teleop(20.89/0.76/0.19);Astribot-S1(含移动底盘)上 15.96/0.60/0.34,显著高于两个 Cosmos 基线,RynnWorld-Teleop 因不支持底盘运动记 N/A。消融表明换成文本条件会使 PSNR 跌至 19.80/13.60、LPIPS 涨至 0.30/0.55。(3) 下游策略(Tab. 4/6):数字遥操作数据使 π0.5 四个真机任务全提升——Plate-Placement 82.86%→91.43%、Steak-Serving 40.00%→54.29%、Plate-Retrieval 45.71%→57.14%,且在 Marvin-WUJI 上比 RynnWorld-Teleop 基线高约 5.71/8.57 个百分点;84.8M 帧合成数据 mid-training 使 π0 在 LIBERO-Plus 从 53.6% 跃升至 79.4%(+25.8 个百分点)、LIBERO 从 94.4% 到 96.1%,π0.5 真机 Steak-Serving 达 60.00%(+20.00pp)、Plate-Retrieval 达 68.57%(+22.86pp),并在 Marvin-WUJI 两任务上比 Ego2Robot 基线各高约 5.71 个百分点。定性实验(Fig. 5)显示相同初始帧下不同潜在动作序列能引导出与各自源视频一致的截然不同的运动,证明接口确有控制力。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 动作条件视频预测(DreamDojo EgoDex Eval) | LPIPS↓ | 0.19 | DreamDojo-14B:0.21 | 降低 0.02(约 9.5%),PSNR 20.89 vs 20.53,SSIM 0.81 vs 0.79 |
| 动作条件视频预测(DreamDojo In-lab Eval) | PSNR↑ / SSIM↑ | 21.42 / 0.82 | DreamDojo-14B:21.41 / 0.79 | PSNR 基本持平(+0.01),SSIM +0.03;LPIPS 0.20 vs 0.21 |
| 动作条件视频预测(DreamDojo-HV Eval) | PSNR↑ / LPIPS↓ | 19.22 / 0.21 | DreamDojo-14B:18.92 / 0.23 | PSNR +0.30,LPIPS −0.02 |
| 真机视频预测(Marvin-WUJI 评测集) | PSNR↑ / LPIPS↓ | 21.86 / 0.12 | Cosmos3-Edge:20.03 / 0.31;RynnWorld-Teleop:20.89 / 0.19 | PSNR +1.83(对 Cosmos3-Edge),LPIPS −0.19 |
| 真机视频预测(Astribot-S1 移动平台评测集) | PSNR↑ / LPIPS↓ | 15.96 / 0.34 | Cosmos3-Nano:14.22 / 0.45 | PSNR +1.74,LPIPS −0.11,SSIM +0.07(0.60 vs 0.53) |
| 消融:文本条件 vs 潜在动作(Marvin-WUJI) | PSNR↑ / LPIPS↓ | 21.86 / 0.12(潜在动作) | text-conditioned 变体:19.80 / 0.30 | 帧级动作信息比任务级语言多提升 PSNR 2.06、LPIPS −0.18 |
| 真机闭环策略 Plate-Placement(π0.5 + 数字遥操作) | 成功率(35 次试验) | 91.43% | Real only:82.86%;Real + RynnWorld-Teleop:85.71% | +8.57pp(对 Real only),+5.71pp(对 RynnWorld-Teleop) |
| 真机闭环策略 Plate-Wiping(π0.5 + 数字遥操作) | 成功率(35 次试验) | 91.43% | Real only:77.14% | +14.29pp |
| 真机闭环策略 Steak-Serving(π0.5,80M mid-training + Real) | 成功率(35 次试验) | 60.00% | Real only:40.00% | +20.00pp |
| 真机闭环策略 Plate-Retrieval(π0.5,80M mid-training + Real) | 成功率(35 次试验) | 68.57% | Real only:45.71% | +22.86pp |
| 仿真策略 LIBERO-Plus(π0 mid-training) | 平均成功率 | 79.4% | π0:53.6% | +25.8pp,扰动鲁棒性大幅提升 |
| 仿真策略 LIBERO(π0 mid-training) | 平均成功率 | 96.1% | π0:94.4% | +1.7pp |
局限与改进
作者明确承认四点局限。其一,潜在动作从视觉过渡中推断,可能把相机运动、外观变化也编码进 608 维描述子,因此定性动作跟随和图像级指标(PSNR/SSIM/LPIPS)都不能证明因果识别或物理正确性。其二,合成管线中重定向的机器人命令与生成观测来自两个独立过程(IK 一边、生成器一边),时间对齐和过滤无法保证物理一致性——伪动作终究是伪标签。其三,真机成功率每任务只有 35 次试验,微小的百分点差异不能作统计显著的解读。其四,合成 mid-training 同时增加了数据和优化计算量,二者的贡献没有被现有对比分离。此外我自己的观察:DreamDojo 基线数值取自文献报告,是完整系统级对比(backbone、数据、训练均不同),没有隔离潜在动作接口本身的贡献;真机评测是「held-out demonstrations」而非「held-out tasks」——四个测试任务本身在训练任务中有表示,考察的是对新演示而非新任务的泛化;Astribot-S1 的绝对指标(PSNR 15.96)远低于 Marvin-WUJI(21.86),说明移动底盘带来的场景与视角变化仍很难预测;π0.5 在 LIBERO-Plus 的增益只有 84.4%→84.8%(+0.4pp),合成数据收益高度依赖基础模型;CFG 尺度固定 1.15 无扫描;感知指标与操作物理正确性之间的鸿沟也没有定量桥接。
独立分析的弱点
独立分析几个弱点。(1) 动作-观测一致性无保证:合成数据中机器人动作由 IK/重定向得出、视频由生成器独立产生,训练 VLA 时可能引入系统性偏差;改进方向是复用世界模型自身的动作条件通路做一致性打分(如用模型判断动作-视频匹配度来过滤),或引入可微物理校验器。(2) 长时程漂移:数字遥操作用「最后生成帧作为下一 chunk 条件帧」自回归滚动,误差必然累积,论文未报告任何长时程质量指标;可用周期性关键帧回锚或多 chunk 联合去噪缓解。(3) 首帧编辑成为瓶颈:RynnEdit 的质量直接决定合成 rollout 的视觉合理性,手部修复/替换在复杂遮挡、反光餐具(论文任务恰好大量涉及盘子)上的失败模式没有系统分析;可训练编辑质量评估模型自动在两条管线间路由或拒绝。(4) 评测维度单薄:动作跟随只有定性展示(Fig. 5),缺少动作跟踪的定量误差(如末端执行器轨迹 L2、物体关键点跟踪误差),图像指标无法区分误差来自接触时机还是相机运动——作者自己也承认这一点;建议补充动作跟随的定量协议。(5) 608 维潜在动作不可解释:哪个维度对应抓取、哪个对应相机运动没有分析,这对安全关键的机器人应用是隐患;可做维度探针或线性解耦分析。(6) 真机对比规模小:35 次试验/任务且任务数只有 4,跨平台结论(尤其 Astribot-S1 上 Ego2Robot/RynnWorld-Teleop 均 N/A)缺少同基线可比性。
未来方向
作者提出的方向:长时程一致性、动作-观测对齐、更广泛的跨具身迁移。基于本文成果可延伸的:(1) latent 空间规划——既然世界模型能条件于潜在动作预测未来,可在 latent action 空间做 MPC 或树搜索,再由 LAM 解码/策略执行,绕开动作空间对齐问题;(2) 闭环数据飞轮——用下游策略的失败案例定位世界模型预测薄弱区域,定向合成补充数据,形成「策略弱点→数据合成→再训练」的自动循环;(3) 世界模型数据与策略预训练的联合——84.8M 语料与 RynnVLA-Latent 的策略预训练目标联合训练,检验两类数据的协同效应;(4) 扩展到非操作领域——导航、全身移动操作,检验 32 维相机分量 $z_c$ 在大视角变化下的表现(Astribot-S1 上较低的绝对指标提示这是薄弱点);(5) gen-to-real 物理校准——用少量真机交互数据校准合成数据的接触动力学,缩小生成数据与真实物理之间的新差距;(6) 单一世界模型服务多机器人的跨具身规划——同一潜在动作序列在不同机器人上的 rollout 对比可作为可行性评估器;(7) 把 RynnEdit 和生成 rollout 的质量门控升级为可学习的一致性判别器,减少人工阈值(PSNR≥30dB 等)的依赖。
复现评估
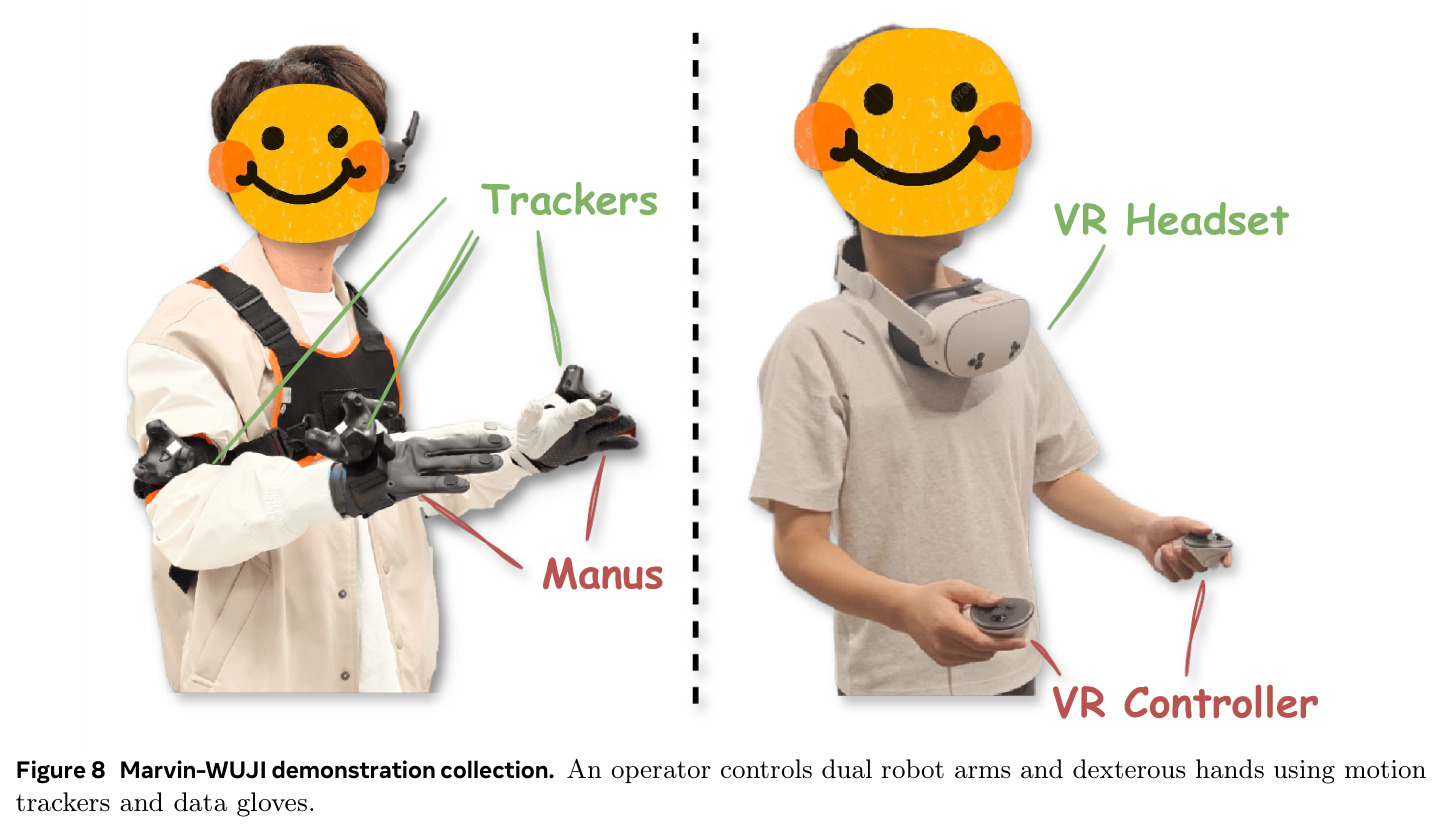
复现条件较好但门槛高。代码开源(github.com/alibaba-damo-academy/RynnWorld-Latent),权重在 HuggingFace(Alibaba-DAMO-Academy/RynnWorld-Latent)和 ModelScope 发布,项目主页提供更多细节。数据侧:23 个预训练数据集均为公开数据集(DROID、RoboMIND、AgiBotWorld2026、EgoDex、EPIC-KITCHENS 等),但需要自行运行 RynnLAM 标注、分位数归一化和过滤管线;84.8M 帧合成语料的再生成依赖 RynnEdit 全家桶(SAM3、Qwen-Image-Edit、MuJoCo、MiniMax-Remover/ProPainter 视频修复)加 Cosmos3-Edge 底座的推理算力。算力方面论文披露了完整训练超参(20K 步、全局 batch 512、AdamW (0.9, 0.99)、峰值 LR $2.26 \times 10^{-4}$、混合分片 FSDP shard degree 8 / replication 4、bf16 + FP32 master weights、EMA $s=0.1$、480p 五个分辨率桶),但未公布 GPU 型号、数量与总 GPU 时,Cosmos3-Edge 底座本身的训练成本也未计入。真机复现最难:需要 Marvin-WUJI(双 TIANJI M6 7-DOF 臂 + 双 WUJI 20-DOF 灵巧手)或 Astribot-S1 平台、5 个 HTC Vive tracker + Manus 数据手套的遥操作硬件、3850 条演示采集。可行的复现路径:下载权重跑推理与定性动作跟随(Fig. 5 级别复现难度低);LIBERO/LIBERO-Plus 的 mid-training 实验用公开 benchmark 可验证;完整真机闭环只适合有同级别硬件与遥操作系统的实验室。
论文图表
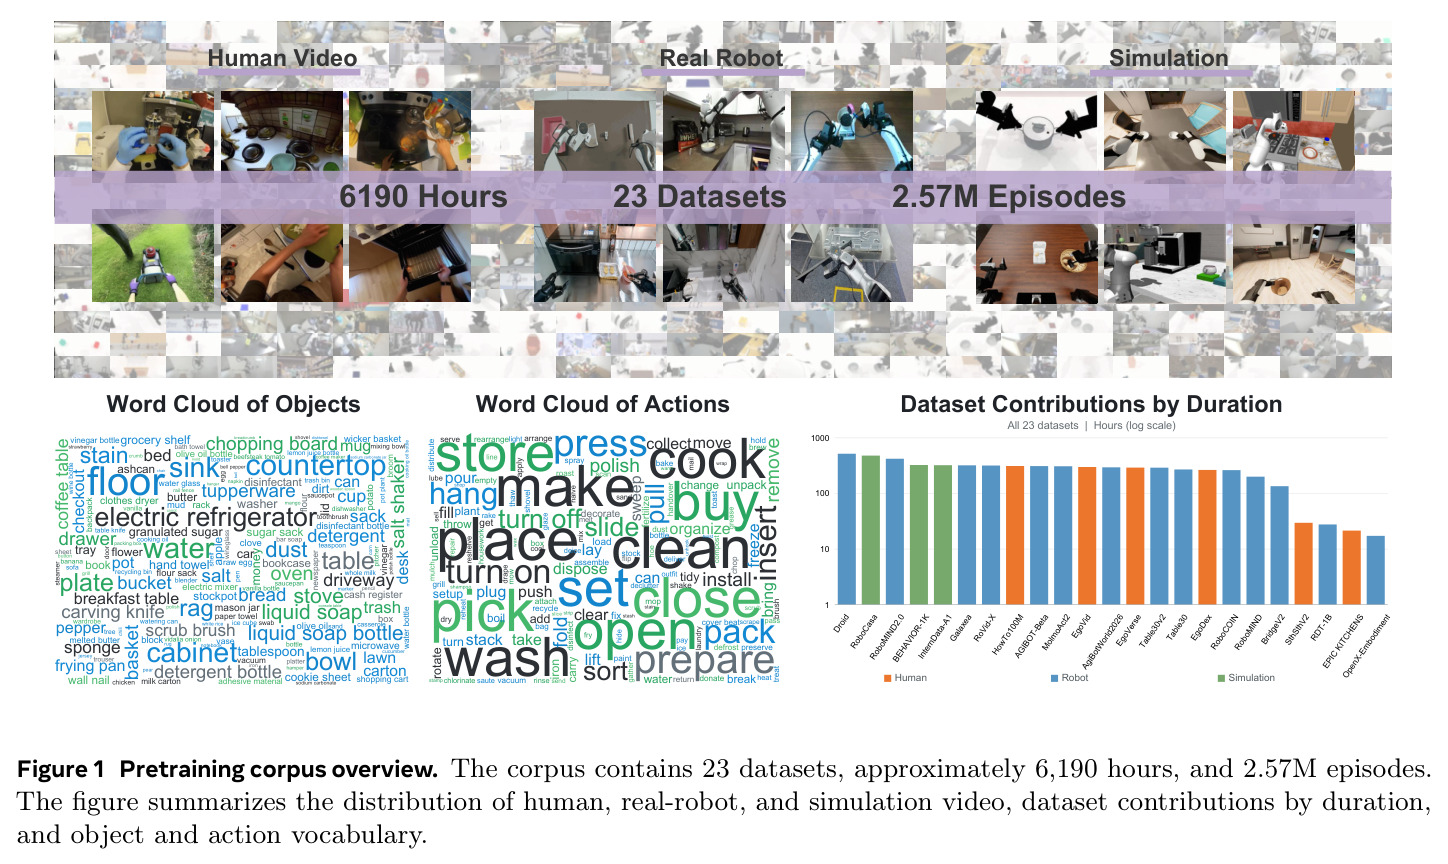
预训练语料总览:23 个数据集、约 6190 小时、257 万条轨迹,按人类视频 / 真机 / 仿真三类展示数据分布、各数据集时长贡献(对数刻度柱状图)以及物体和动作词云。
一眼看清「跨具身联合预训练」的规模与构成:3845.5 小时真机 + 1125.8 小时仿真 + 1218.7 小时人类视频在同一接口下合并,这是本文可扩展性主张的数据基础。