RynnVLA-Latent:以三维接地潜动作扩展机器人操作基础模型 RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
用3D接地潜动作把异构视频变成共享监督,无需原生动作标签预训练出4B级VLA操作策略
前置知识
VLA(视觉-语言-动作)模型
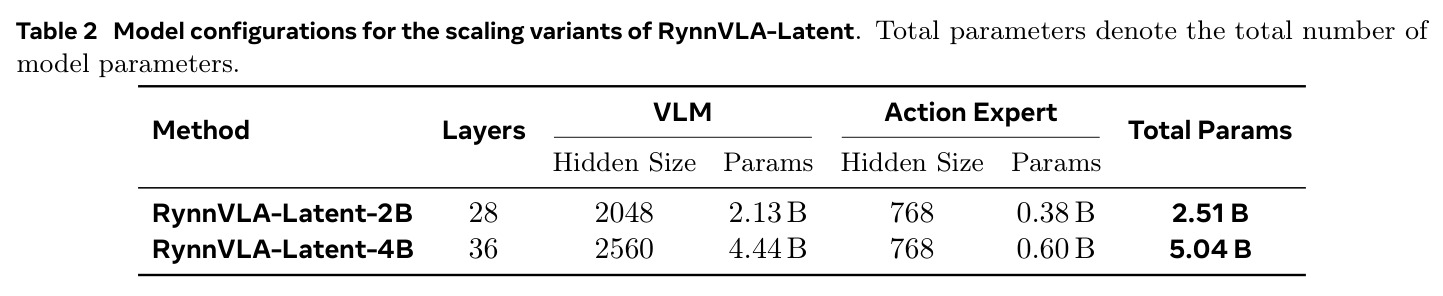
将预训练视觉-语言模型与动作生成模块结合的机器人控制模型:输入多视角图像与语言指令,输出末端执行器或关节动作块。代表路线有 OpenVLA 的离散动作 token 和 π0 的连续动作流生成。本文采用 Mixture-of-Transformers 结构:VLM 主干形成因果前缀,窄动作专家双向注意前缀并生成动作序列。
本文最终产物 RynnVLA-Latent 就是一个 VLA,其两阶段训练(潜动作预训练+本体后训练)与 MoT 架构是贯穿全文的主线。
潜动作(Latent Action)
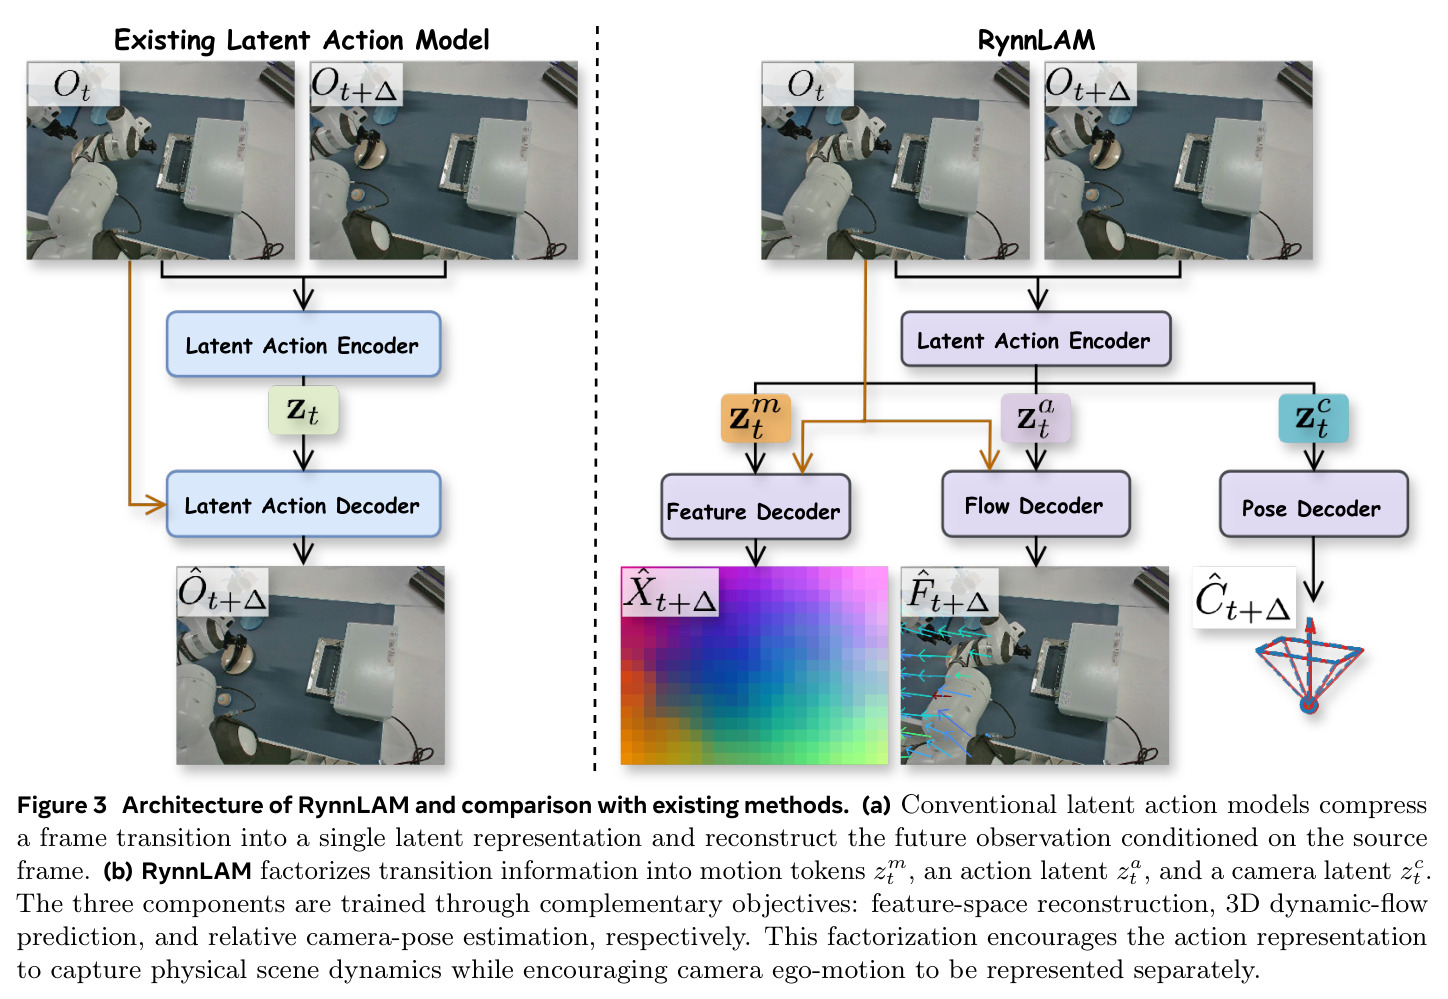
不依赖机器人原生控制标签、从连续视频帧对中提取的动作代理表示:编码器把 $(O_t, O_{t+\Delta})$ 压缩成潜向量,解码器用其重建过渡或预测未来,使动作监督可从任意交互视频自动产生。LAPA 用离散码本,本文 RynnLAM 用连续 608 维描述子 $[z_{mt};z_{at};z_{ct}]$。
潜动作是全文的核心监督接口,理解它才能明白人类/机器人/仿真视频如何统一进同一个预测目标。
流匹配(Flow Matching)
一类生成建模方法:构造噪声与数据的线性插值 $z_\tau=\tau\epsilon+(1-\tau)z$,训练网络预测插值对 $\tau$ 的导数即速度场 $\epsilon-z$,推理时从纯噪声用欧拉积分走到数据端。相比扩散模型步数少、训练稳定,π0 等连续动作模型广泛采用。
RynnVLA-Latent 预训练与后训练共用同一流匹配目标,只把生成目标从 608 维潜动作块换成机器人原生动作块。
3D场景流与相机补偿
场景流是三维空间中每个点的运动向量。本文用单目深度(Depth Anything 3)、相机位姿与现成光流(DPFlow)构造伪标签,并先减去相机自运动,使静态区域动态流趋近于零,从而把物体真实运动与相机移动造成的像素变化区分开。
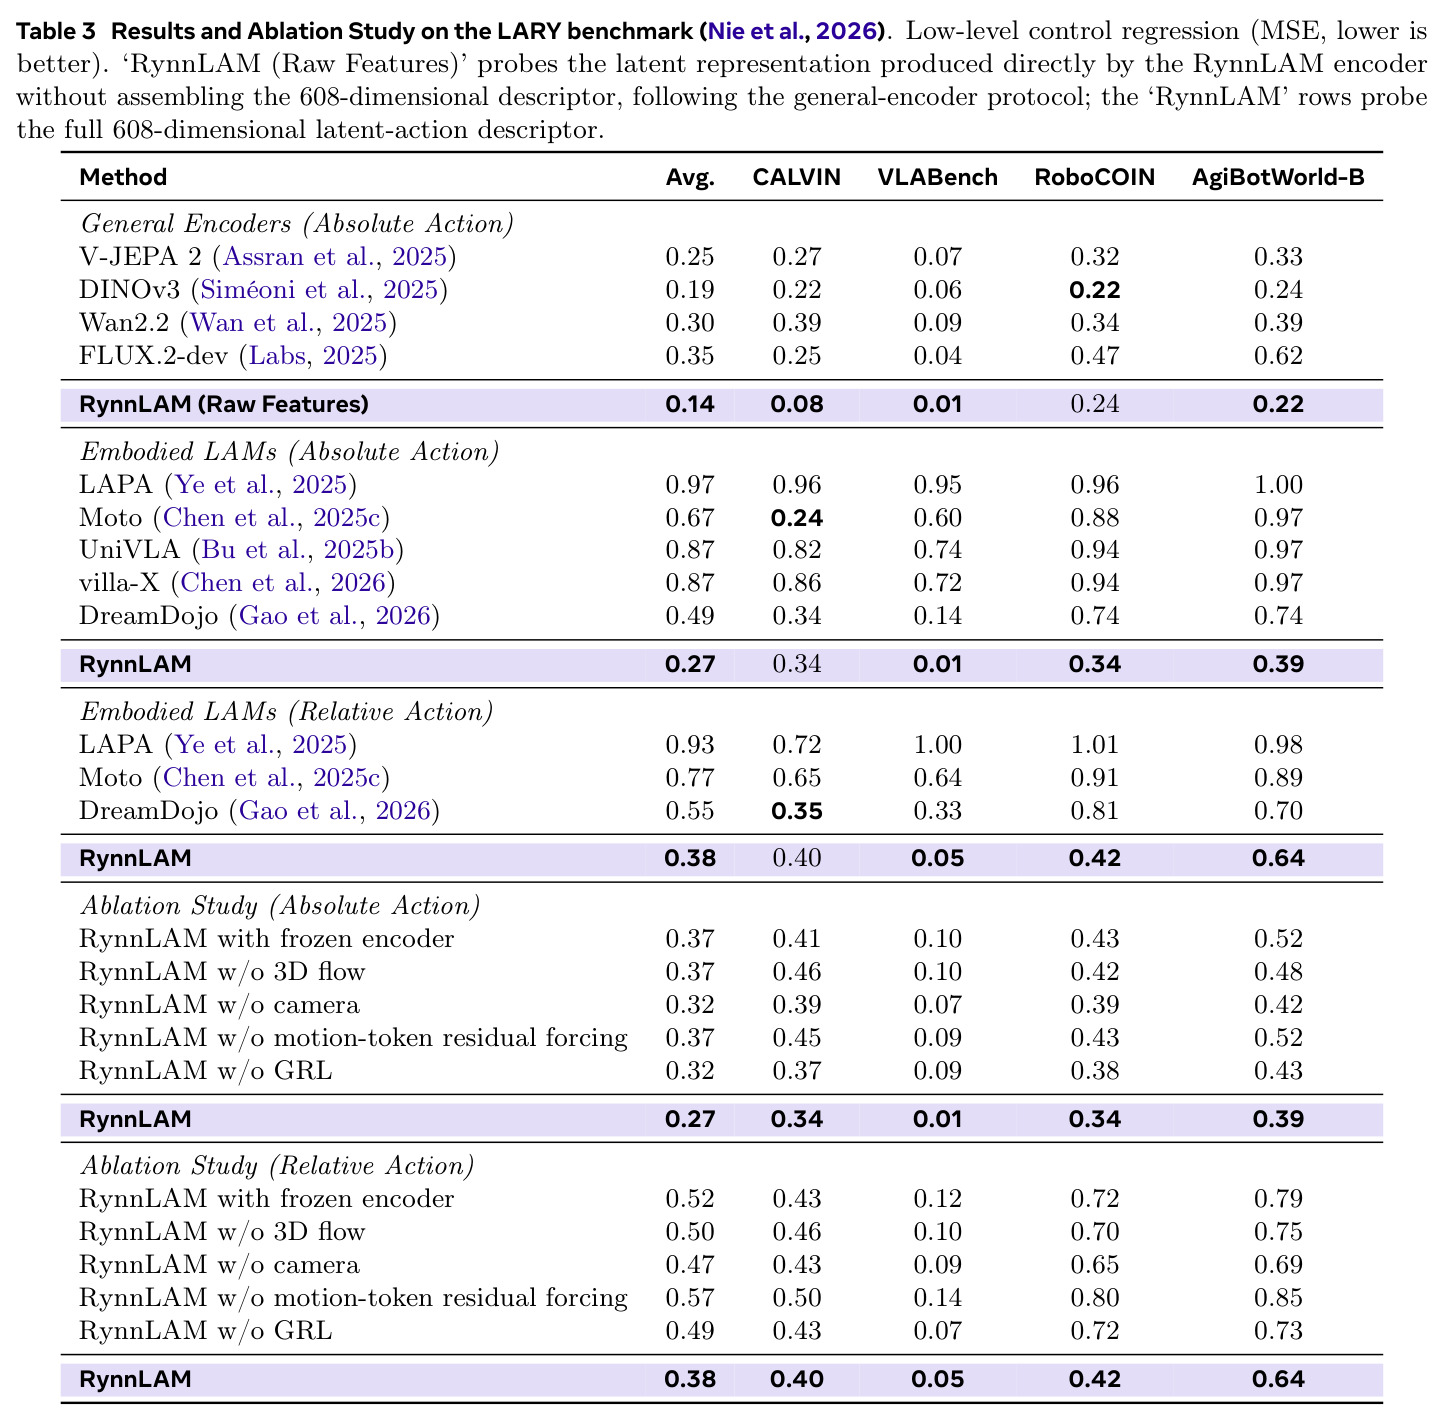
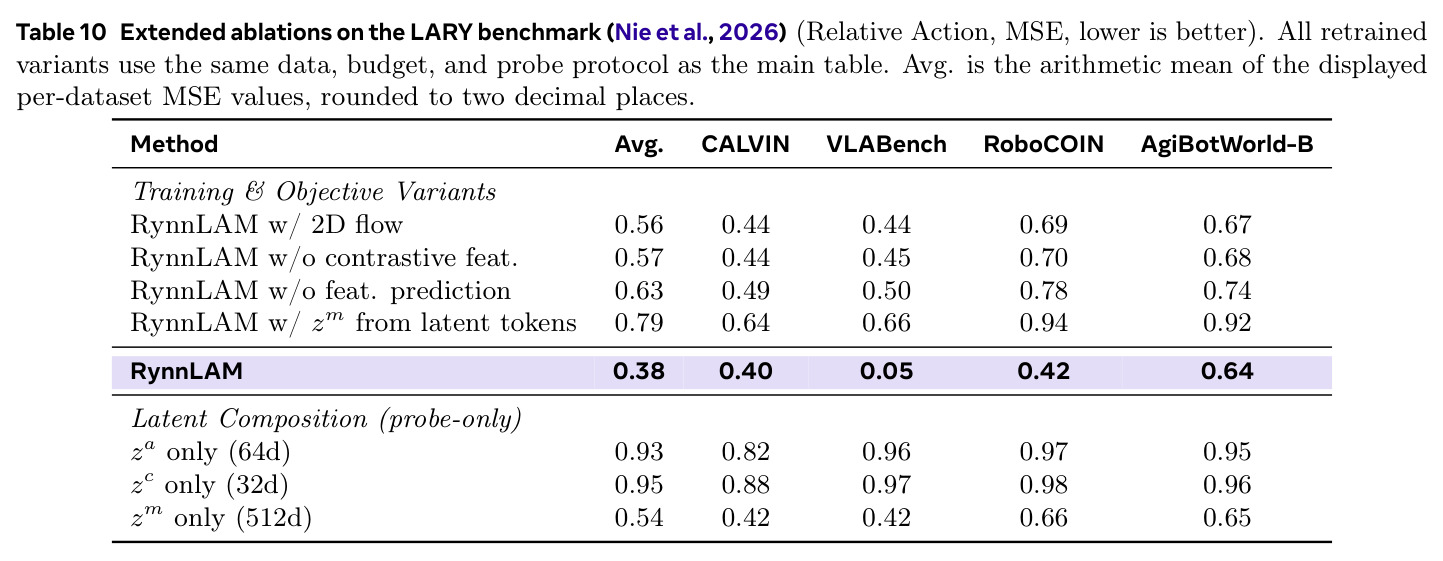
相机补偿的 3D 流监督是 RynnLAM 区别于外观重建式潜动作的关键:消融中去掉 3D 流后相对动作 MSE 从 0.38 升至 0.50,换成 2D 流(0.56)反而更差。
梯度反转层(GRL)
前向传播原样传递输入、反向传播时把梯度取负的可插拔层,用于对抗式解耦:让某解码器故意失败,迫使被反传的表示剔除目标信息。本文用 $\mathcal{L}_{grl}=\|g_{pose}(\mathrm{GRL}(z_{at}))-p^{cam}_t\|^2$ 训练位姿解码器在动作潜向量上失败,把相机自运动挤到专门的 $z_{ct}$。
这是实现操作运动/相机运动分离的低成本手段,对应消融中 w/o GRL 使相对 MSE 从 0.38 升到 0.49。
LARY 冻结表示探针
用轻量 MLP 从冻结表示回归末端执行器轨迹,以 MSE 检验表示是否携带控制信息,覆盖 CALVIN、VLABench(7-DoF Franka)、RoboCOIN(12-DoF 双臂)、AgiBotWorld-Beta(16-DoF G1)。论文额外提出相对动作协议:预测相对首帧的位移,因为绝对坐标在短步长下可部分由当前可见位姿推知。
它是论文验证 608 维描述子控制可预测性的主工具,是解读表 3 与表 10 全部消融数字的基础。
研究动机
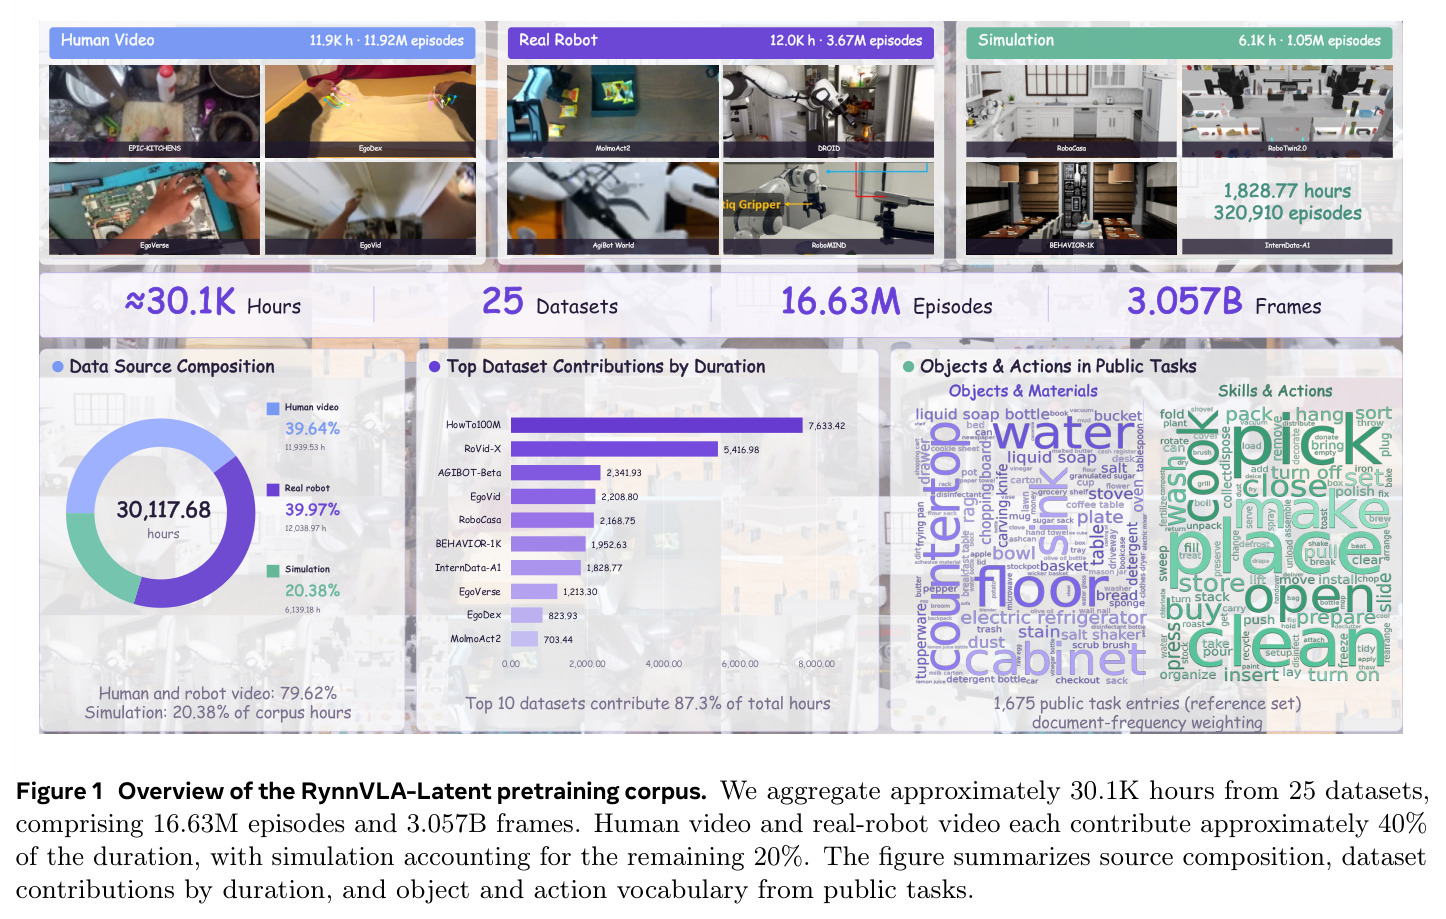
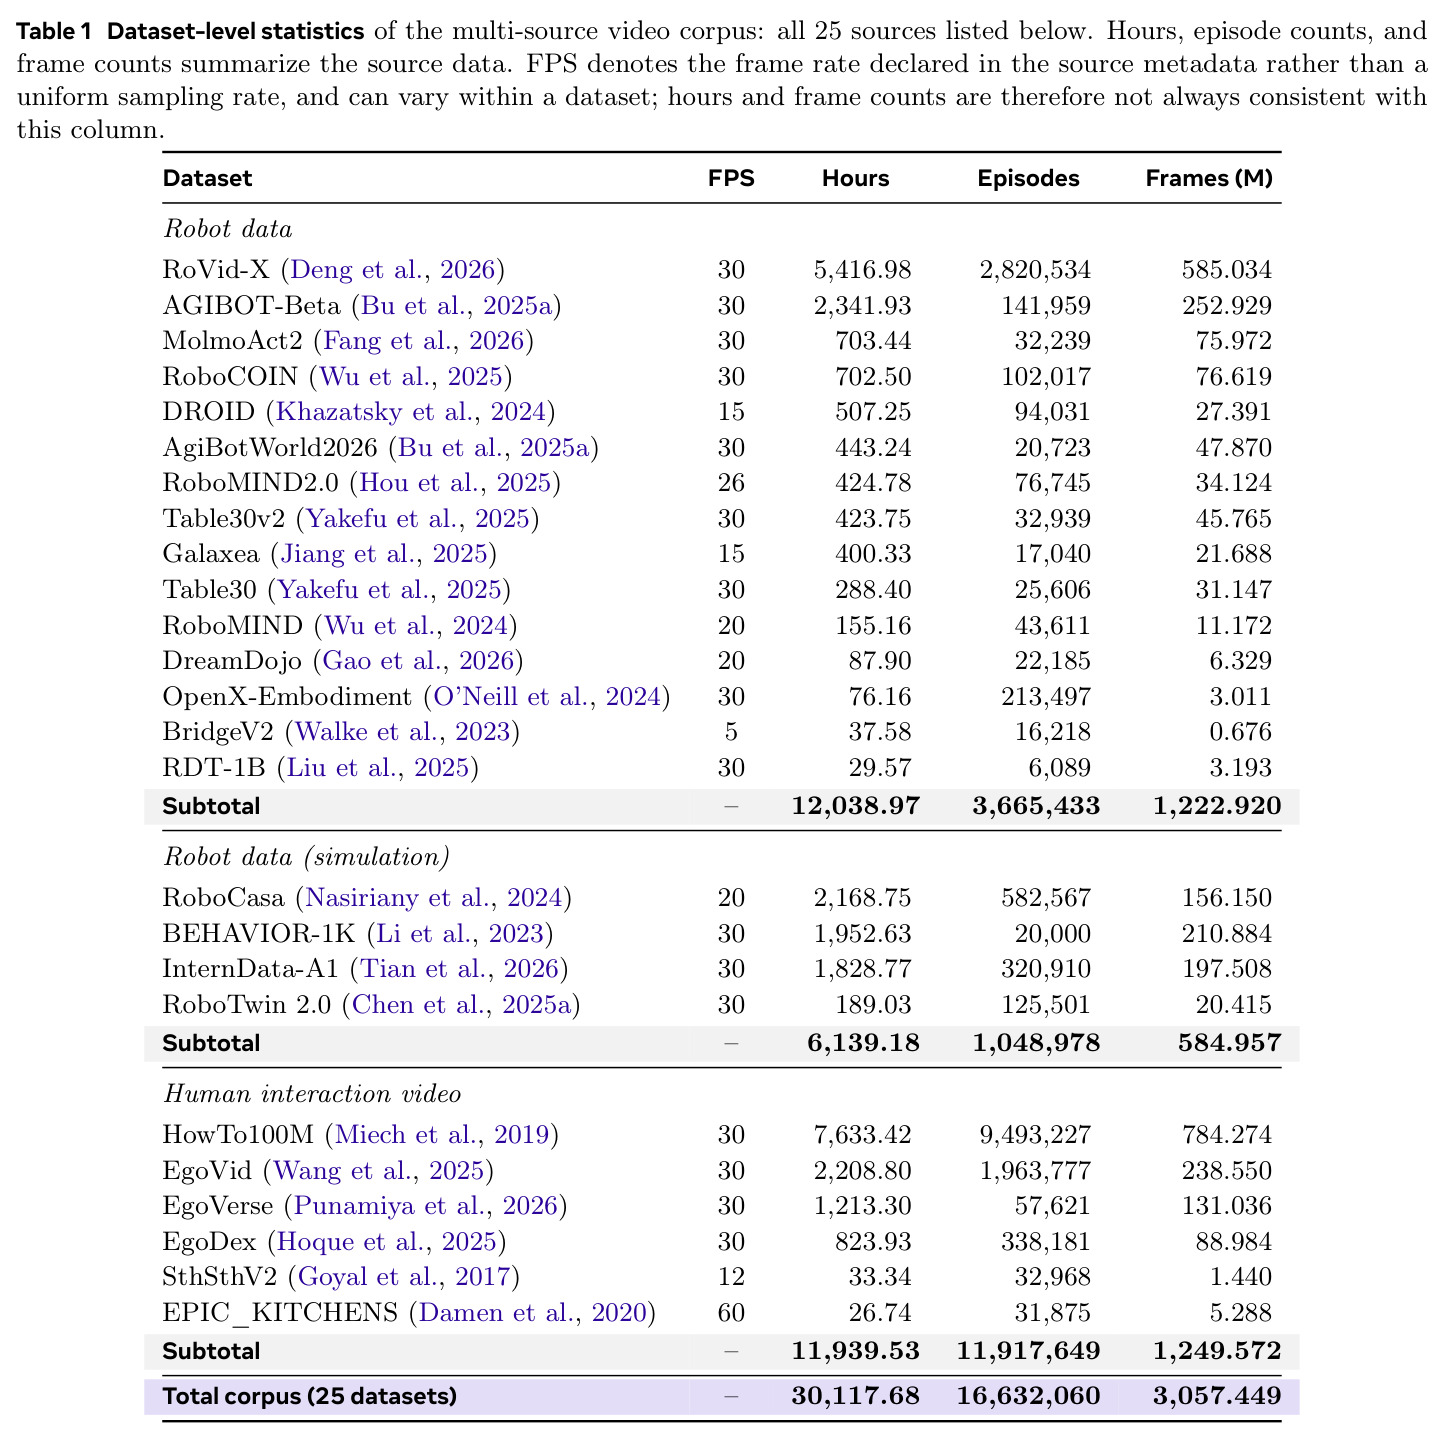
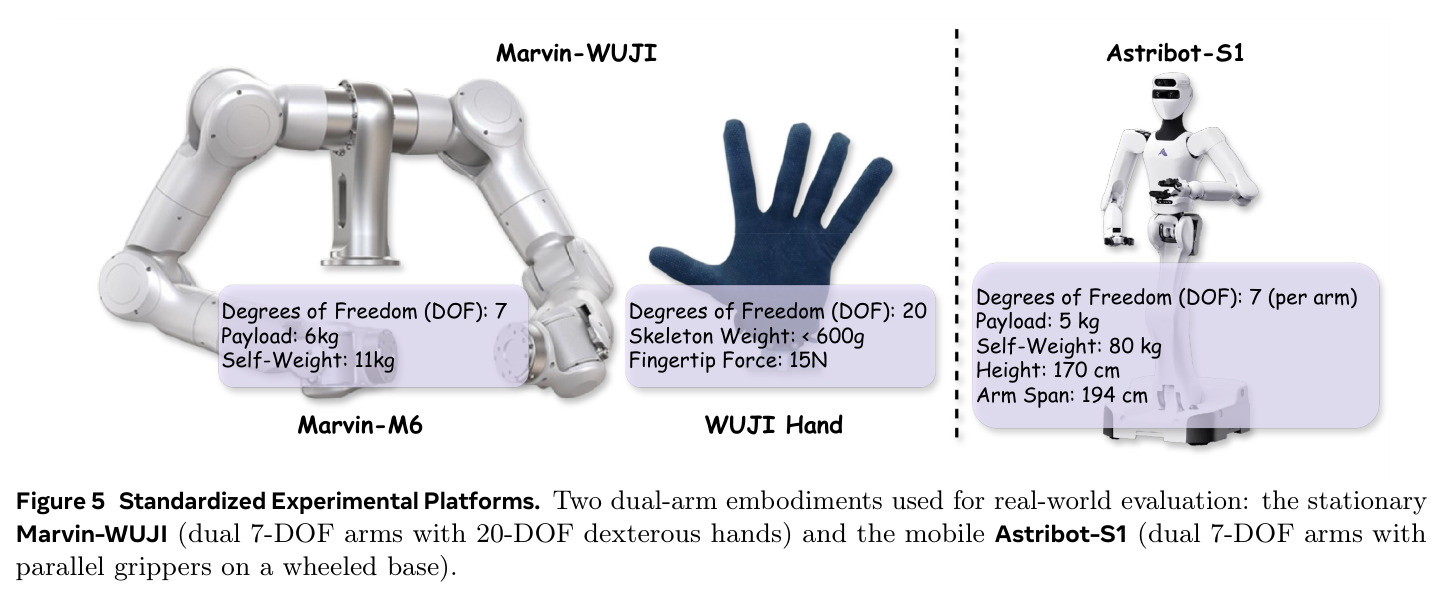
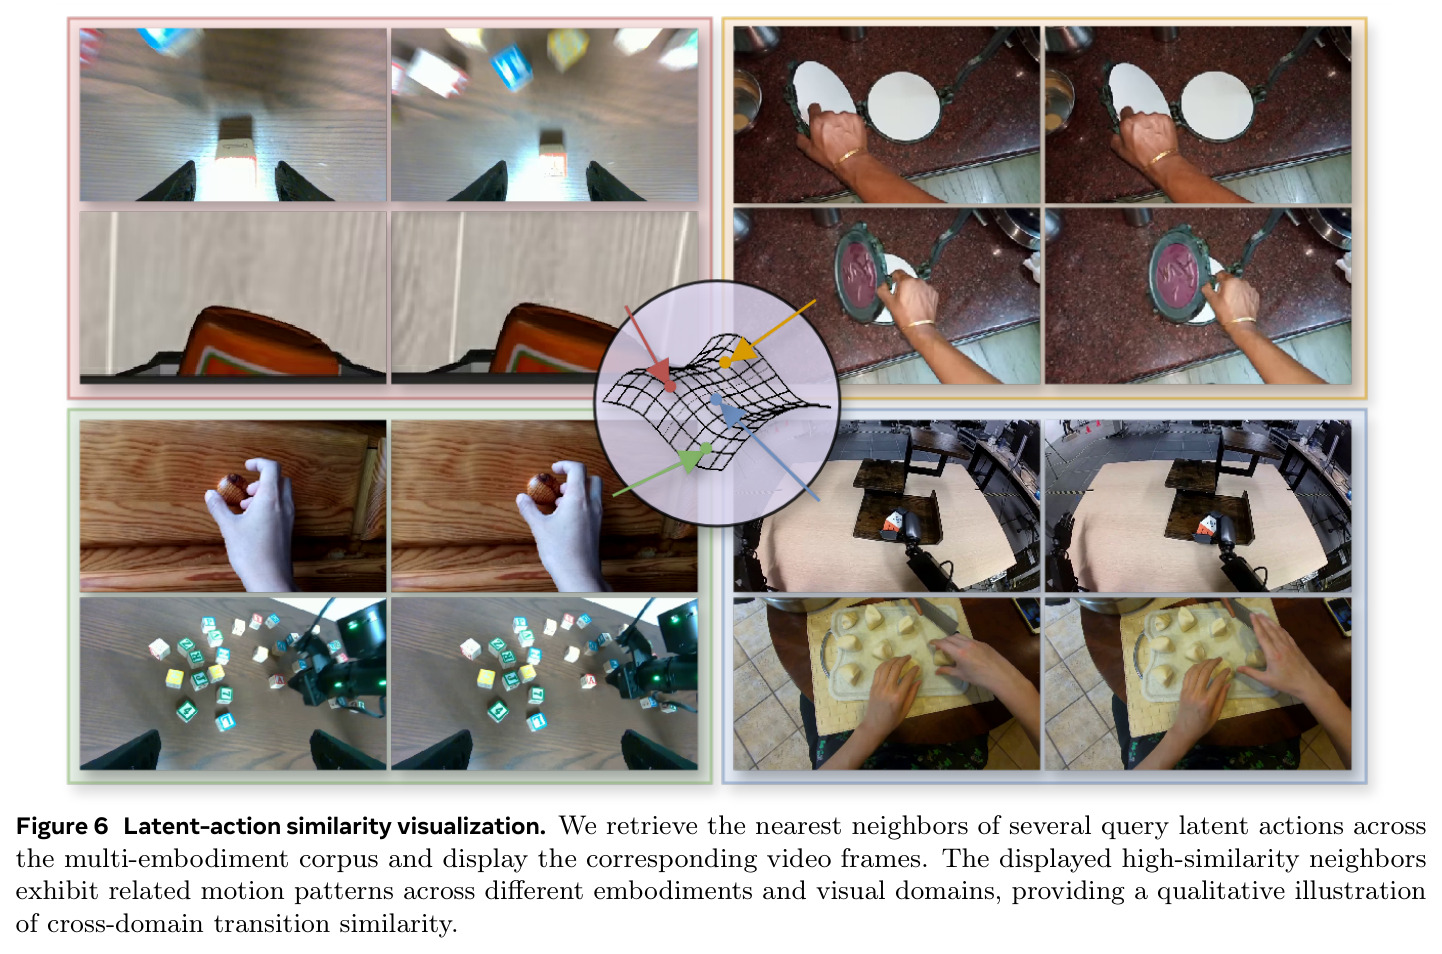
机器人操作策略的规模化预训练卡在监督信号上。原生机器人演示采集昂贵,且不同本体的控制空间在维度、坐标系和语义上互不兼容:7 自由度单臂、双臂加灵巧手(如 Marvin-WUJI 共 54 自由度)、移动双夹爪平台(如 Astribot-S1)的动作向量无法放进统一的预测目标。另一边,人类与网络视频覆盖面广得多——仅 HowTo100M 一个数据源就有 7,633 小时、949 万条片段,超过所有真机数据源之和——但它们完全没有对应的机器人指令,因此最丰富的操作知识来源无法与原生动作预测目标直接混合训练。已有的潜动作方法虽然提供了免动作标签的接口,但视觉变化并不等于控制相关信息:帧间差异混杂了相机自运动、静态外观和与操作无关的变化,一个图像重建得好的潜表示未必能预测低层操作动作——这在 LARY 探针上可直接观察到:LAPA 的平均绝对动作 MSE 高达 0.97,Moto 0.67,都远差于通用语义编码器 DINOv3 的 0.19。
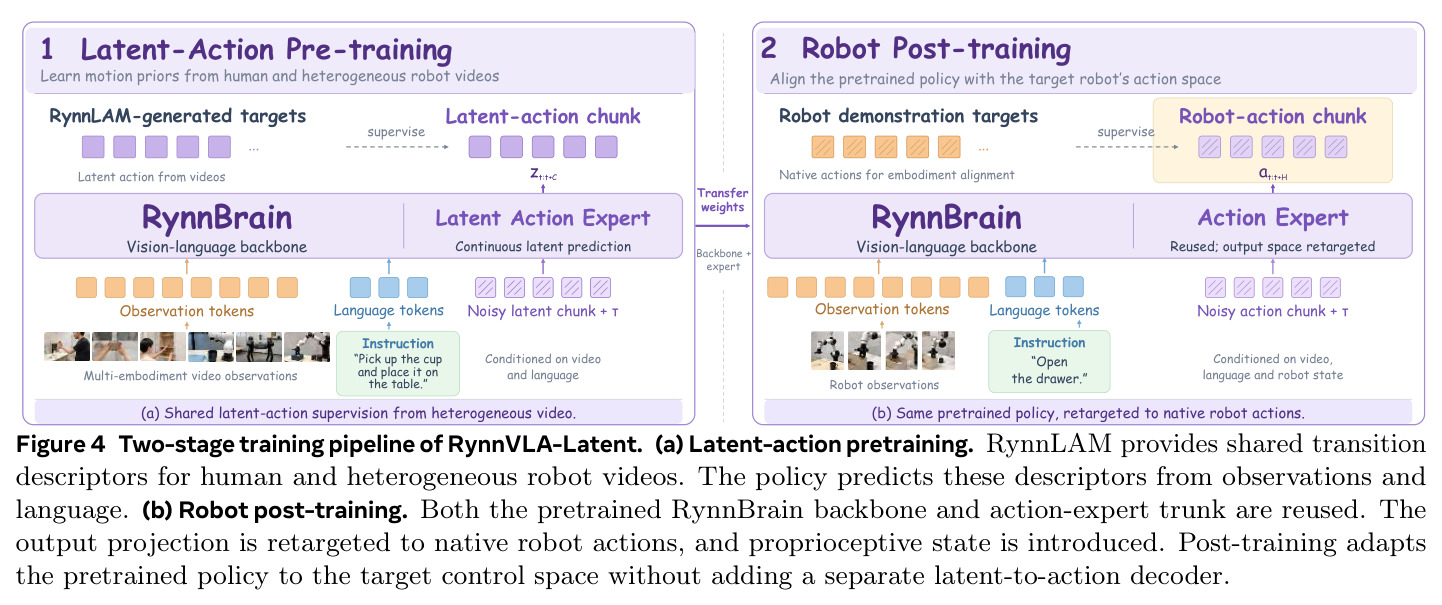
本文的目标是本文目标是构造一个跨本体的共享监督接口,让人类、真机、仿真视频服务于同一个策略预训练目标,并保证该接口确实携带控制相关信息。具体分三层:其一,设计 RynnLAM,把帧对编码为连续、3D 几何接地的潜动作(608 维描述子),用残差未来特征预测、相机补偿的动态 3D 流监督和相机运动解耦,促使表示捕捉控制相关的物理运动而非外观变化;其二,用该编码器离线标注约 30.1K 小时、25 个数据源、3.057B 帧的异构语料,产出 745.52M 个潜动作描述子,并以流匹配预训练 RynnVLA-Latent 策略从观测和语言生成潜动作块;其三,机器人后训练阶段复用预训练主干与动作专家,仅重定向输出投影并引入本体感知,把潜动作目标换成目标机器人原生动作,使昂贵的动作标注只用于最后的本体对齐。最终在 LIBERO、LIBERO-Plus、VLABench、RoboTwin 2.0 和六个真实任务上系统验证这条路线。
与已有工作不同的是,与既有工作的本质差异在于几何接地加相机解耦的切入角度。LAPA、Moto 依赖帧过渡重建或量化码本;UniVLA 在 DINO 特征空间做语言引导的任务中心潜动作;villa-X 引入本体感知前向动力学;DreamDojo 从人类视频学连续代理动作——它们都未显式区分物体运动与相机诱导的视觉变化。RynnLAM 建立在 Depth-Anything-3 之上,先用深度、位姿与光流构造相机补偿后的动态 3D 流伪标签,迫使潜表示描述物理场景运动;再以对比特征扭曲损失防止恒等扭曲捷径(要求扭曲后的源特征更接近目标帧而非未扭曲源帧);并用相机位姿通路加梯度反转把自运动路由进 32 维相机潜向量。作者把问题明确限定为无原生动作与本体感知监督下的几何接地,而非对齐异构原生控制参数化(那是 UniAct、X-VLA 的路线),由此把视频规模的预训练与可执行控制对齐干净地解耦为两个阶段。
核心方法
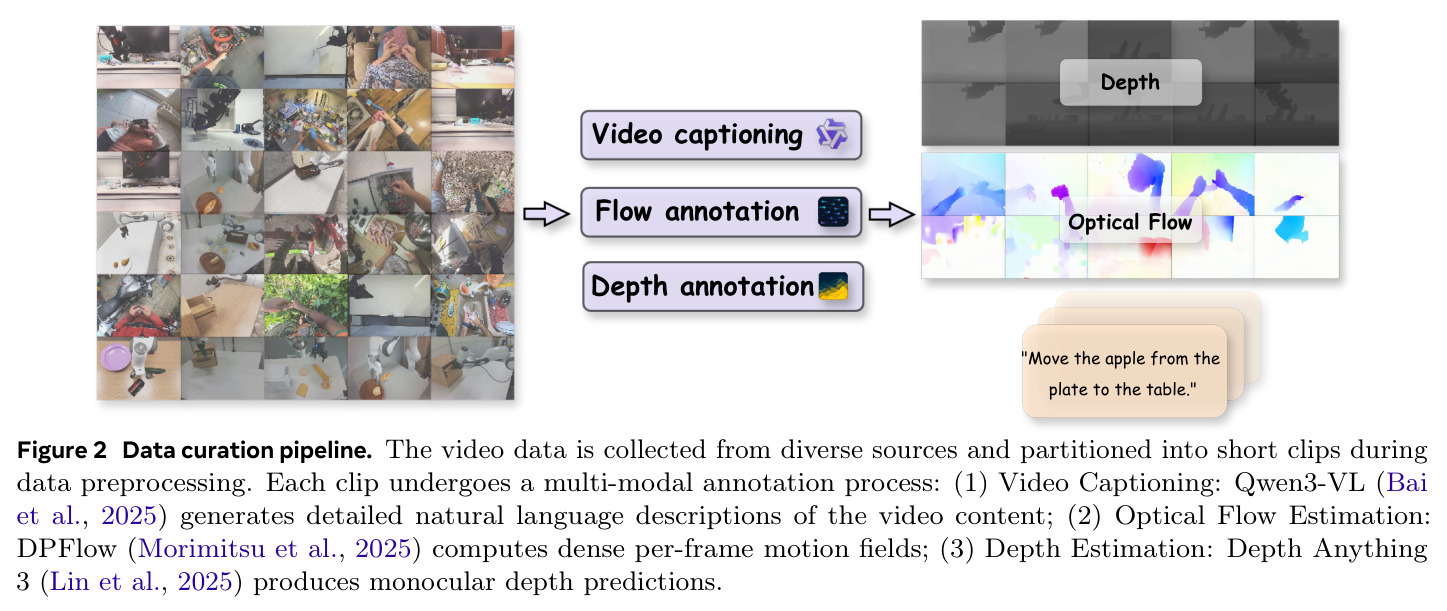
整体思路可概括为:既然异构视频无法共享原生动作,就学一个动作翻译器——任何视频的相邻帧对都编码成统一的潜动作向量,策略先学会看视频说潜动作,部署时再把输出空间换成真实机器人指令。技术路线分三步。第一步,数据装配与预处理:汇总 25 个数据源(人类 11.9K 小时、真机 12.0K 小时、仿真 6.1K 小时),每段视频经 Qwen3-VL 打字幕、DPFlow 算光流、Depth Anything 3 出深度与相机位姿。第二步,训练 RynnLAM:以 Depth-Anything-3 为骨干,把帧对 $(O_t,O_{t+\Delta})$ 编码为 $z_t=[z_{mt};z_{at};z_{ct}]$(8 个 512 维运动 token + 64 维动作 + 32 维相机潜向量),五项损失联合训练,再在 250 分片上并行离线标注,产出 745.52M 描述子。第三步,预训练 RynnVLA-Latent:Mixture-of-Transformers 结构(RynnBrain 主干 + 窄动作专家),流匹配生成 $C=6$ 潜动作块;后训练重定向到原生动作并引入本体感知。
核心创新是分解、几何接地加对抗解耦的潜动作表示。表示被因子化为 $z_t=[z_{mt};z_{at};z_{ct}]$:8 个运动 token 由可学习查询对目标帧特征做注意力得到;读出 token 压缩全局过渡为 64 维动作潜向量与 32 维相机潜向量;编码器对两帧特征做门控时间差分以抑制静态外观。训练要求潜表示支持三件事:其一,残差未来特征预测 $\mathcal{L}_{rec}$,按目标变化幅度归一化的残差误差只监督帧间变化而非绝对外观;其二,回归相机补偿后的动态 3D 场景流 $\mathcal{L}_{flow}$,静态区域补偿后应趋近零流,解码时随机遮蔽部分源 patch token;其三,对比特征扭曲 $\mathcal{L}_{feat}$,以未扭曲源特征为负样本,要求扭曲后特征更接近目标帧,防恒等扭曲捷径。位姿解码器监督 $z_{ct}$ 预测相对 6-DoF 位姿($\mathcal{L}_{pose}$),并用梯度反转让它在 $z_{at}$ 上失败($\mathcal{L}_{grl}$)。与以往重建图像的目标本质不同:这里训练的是控制可预测的物理运动。
方法步骤详情
流程分六步。(1) 数据预处理:5 秒短片生成字幕(Qwen3-VL),DPFlow 估计光流,Depth Anything 3 在 392 像素分辨率输出深度与位姿。(2) RynnLAM 训练:五项损失权重 5、5、5、3、2;阶段一冻结编码器 36K 步,阶段二解冻再训 20K 步。(3) 离线标注:每 4 帧取一对((0,4),(4,8),…)在 250 分片并行处理全部语料,产出 745.52M 个 608 维描述子;按 $C=6$ 组样得 121.06M 训练样本(每 epoch 946K 步)。(4) 策略预训练:MoT 架构(2B 总参 2.51B;4B 总参 5.04B;动作专家宽 768),流匹配预测速度场 $\epsilon-z$($d_z=608$),时间步偏向噪声端采样,观测经 6 个相机槽位输入,源采样 $p_d\propto W_d^{0.7}$。(5) 后训练:同一目标改预测原生动作块,引入本体感知,统一布局并掩蔽未用维度,末端接薄的新投影。(6) 推理:欧拉步从 $\tau=1$ 积分到 $\tau=0$,VLM 前缀缓存复用,整块执行完再规划。
技术新颖性
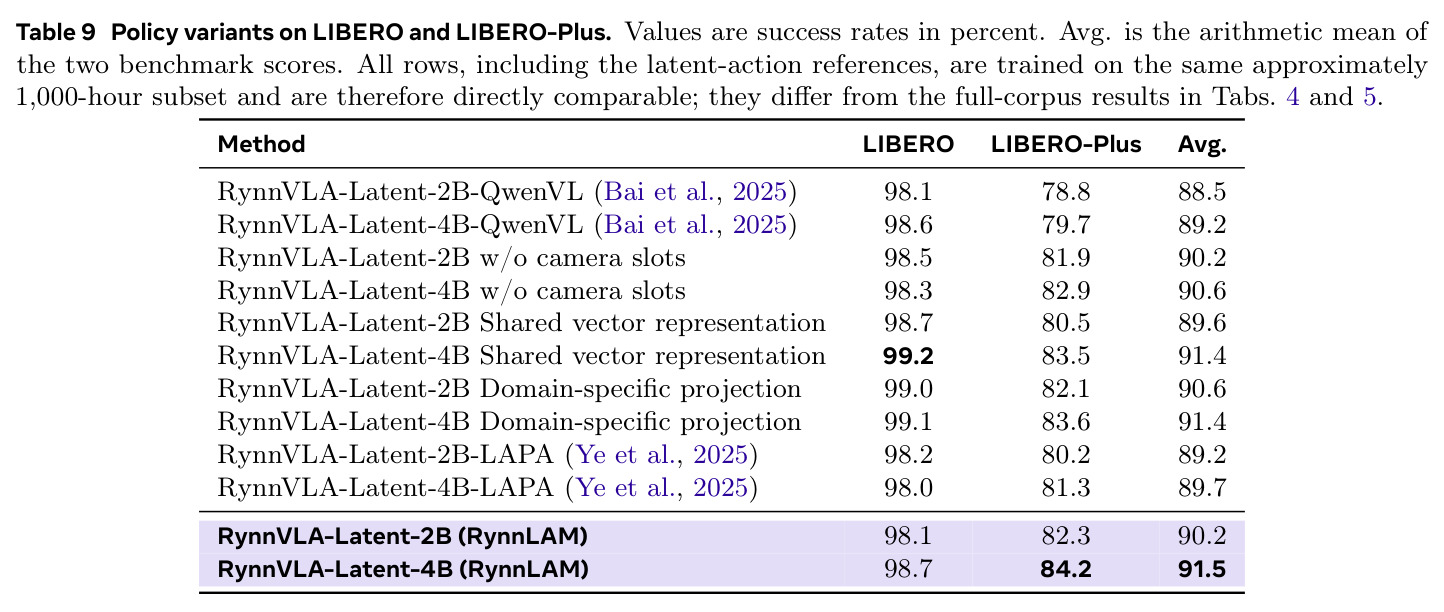
技术新颖性可从四层面看。表示层面:以往潜动作模型以图像或特征重建为唯一压力测试,本文把相机补偿后的动态 3D 流作为潜表示必须满足的几何约束,且消融证明并非随便加运动预测即可——换成 2D 外观流(相对 MSE 0.56)比完全不加流(0.50)还差,只有带相机补偿的 3D 流(0.38)有效,增益来自几何而非额外运动目标。结构层面:运动 token 直接从原始目标帧特征经瓶颈查询而来,若改为从潜 token 压缩(切断直接特征通路),相对 MSE 从 0.38 恶化到 0.79,说明信息通路设计比瓶颈更关键。训练层面:GRL 对抗式路由相机自运动比单纯加相机分支更彻底(w/o camera 0.47,w/o GRL 0.49)。系统层面:预训练与后训练共享同一流匹配目标与读出主干、只换输出投影,避免另配解码器的两套机制;RynnLAM 使人类视频无需动捕伪动作即可参与——在 1000 小时对照子集上,两种显式对齐基线在 LIBERO-Plus 上为 80.5%/82.1%(2B)与 83.5%/83.6%(4B),RynnLAM 路线达 82.3%/84.2%。
实验结果
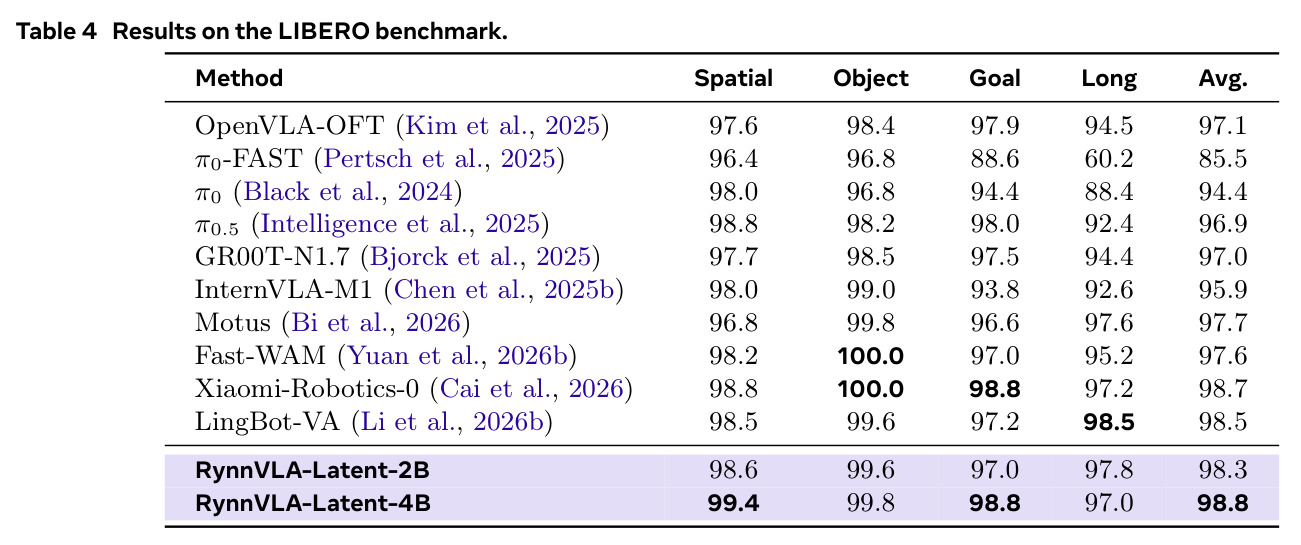
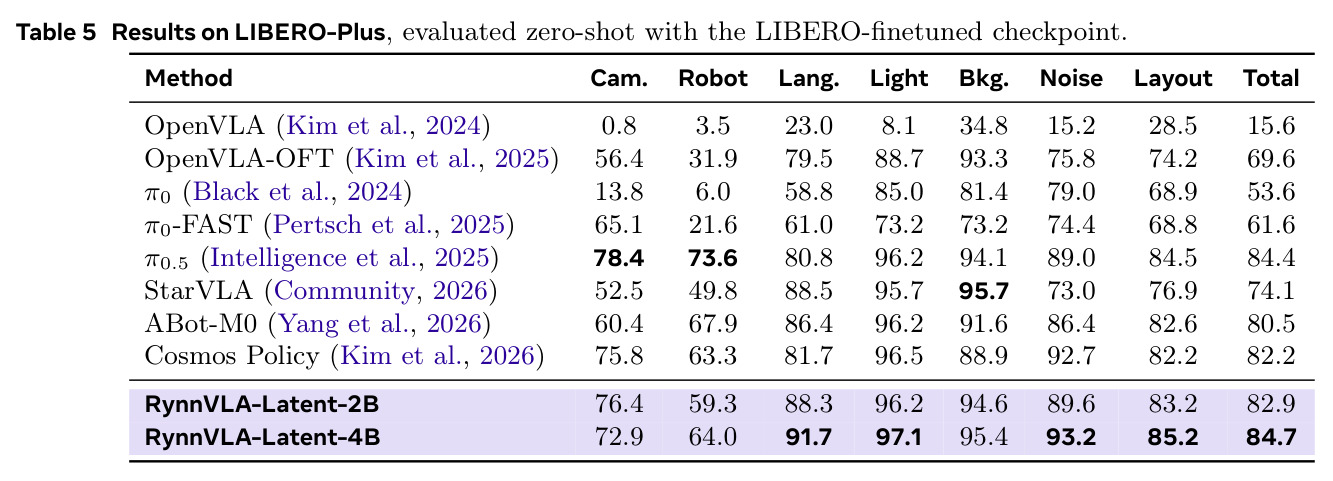
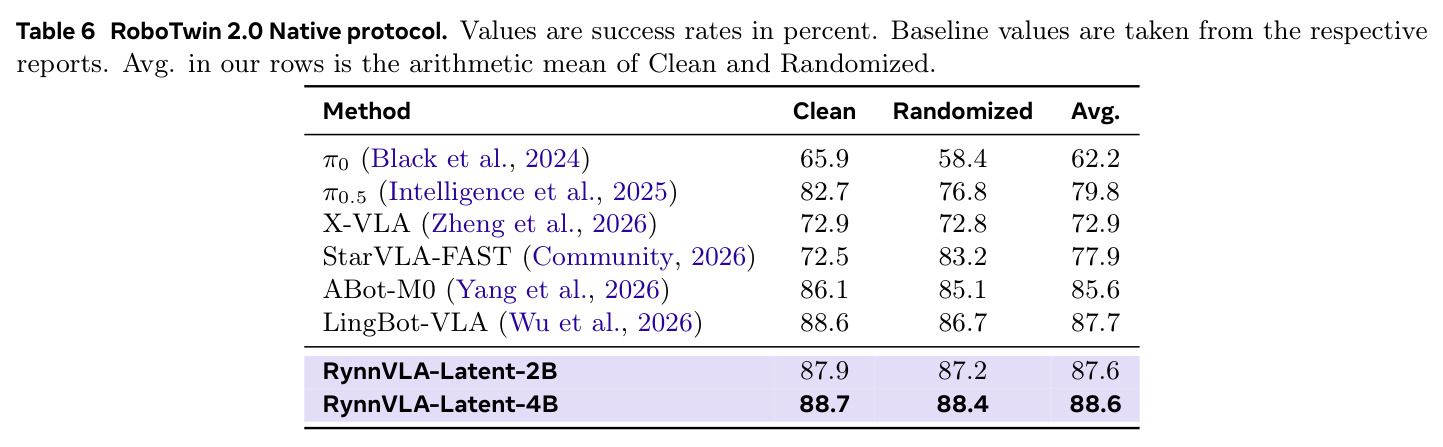
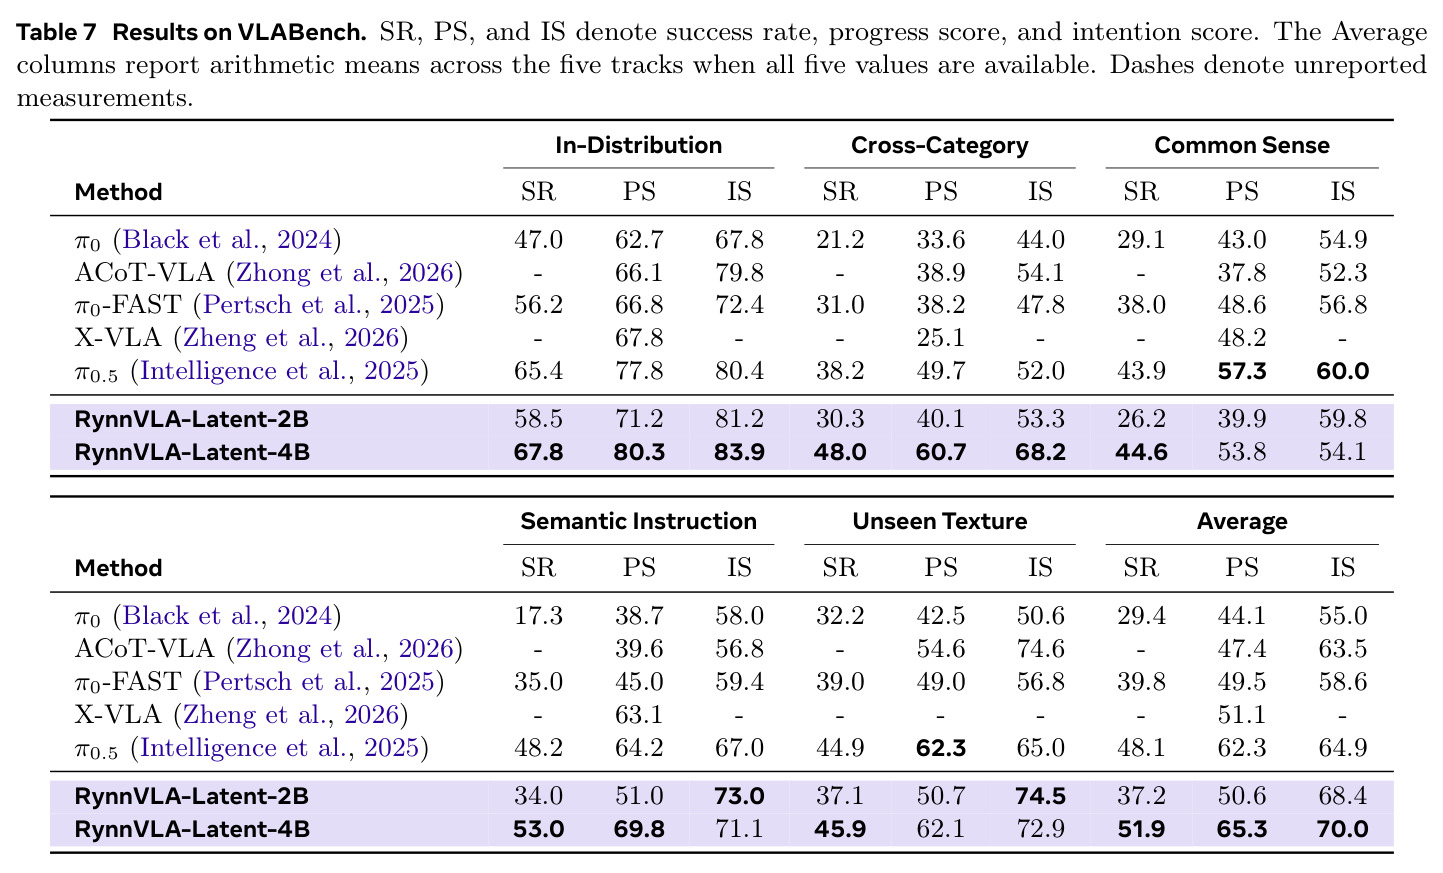
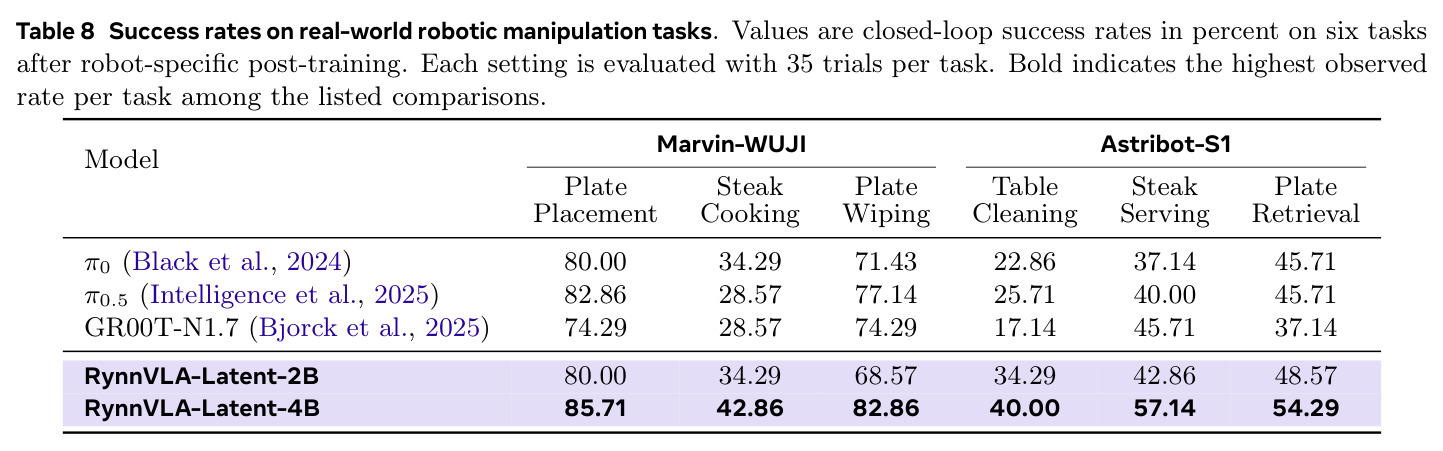
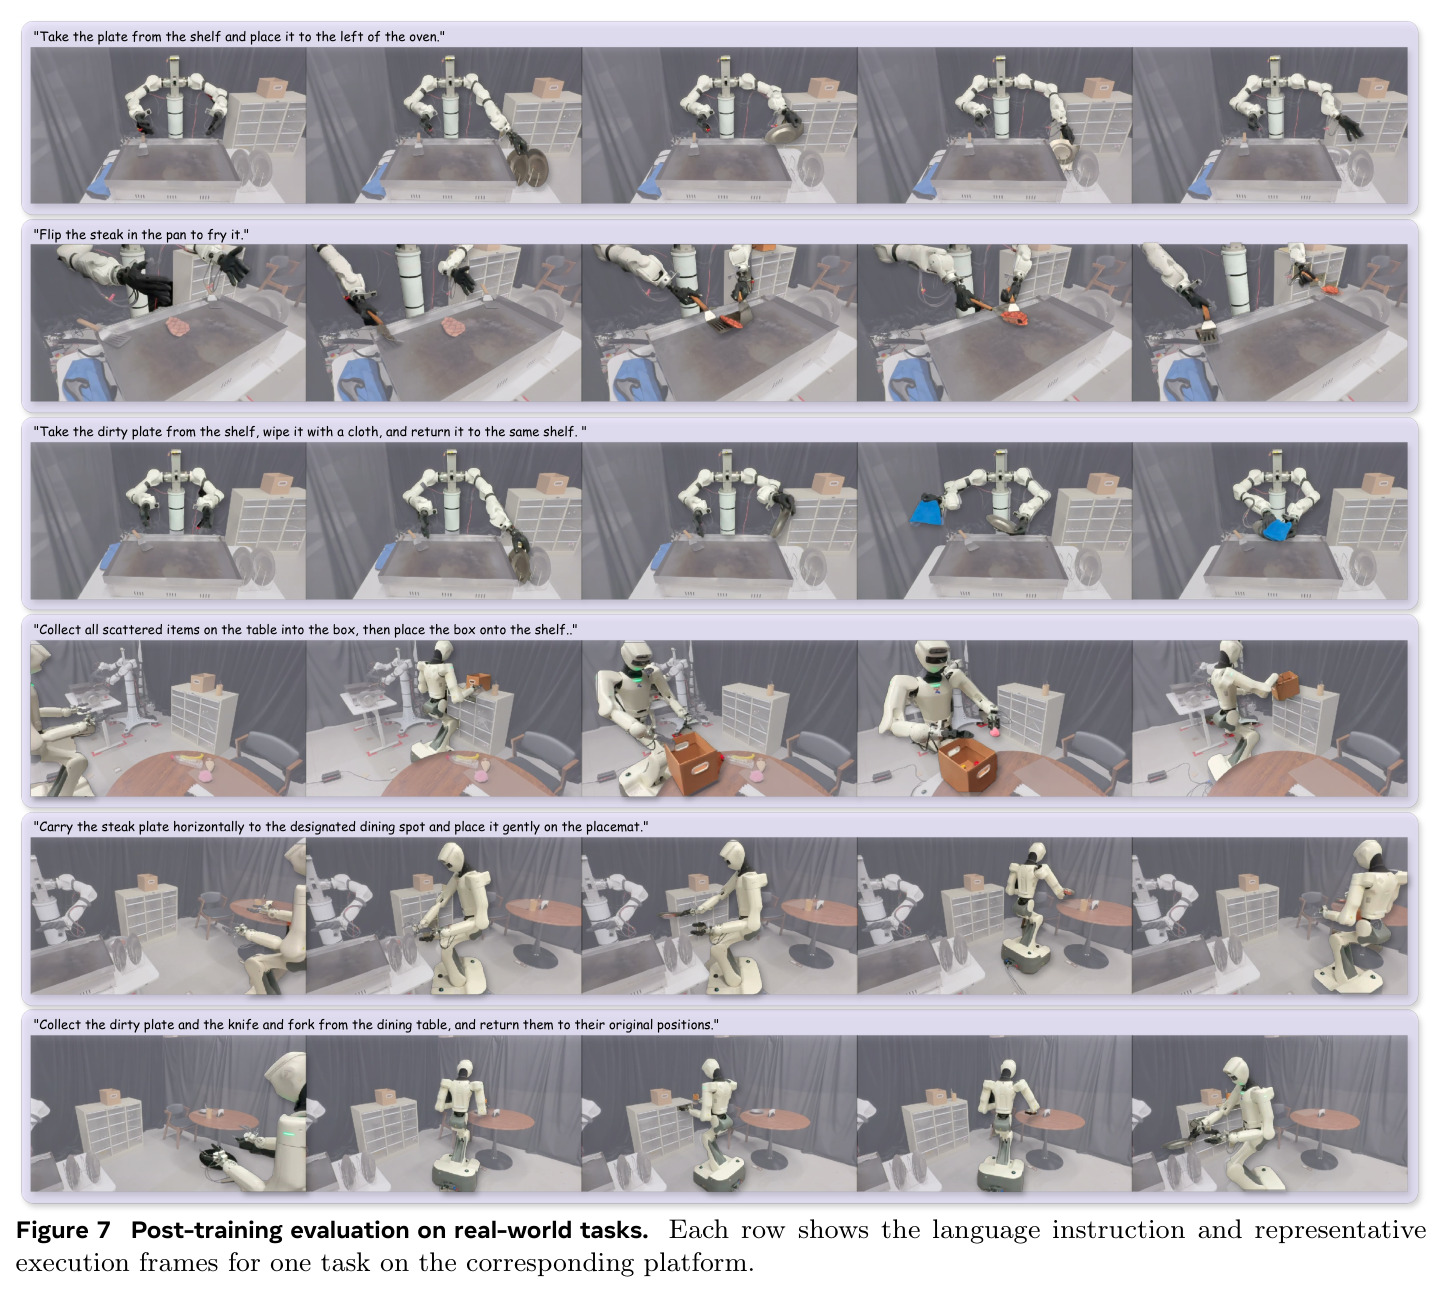
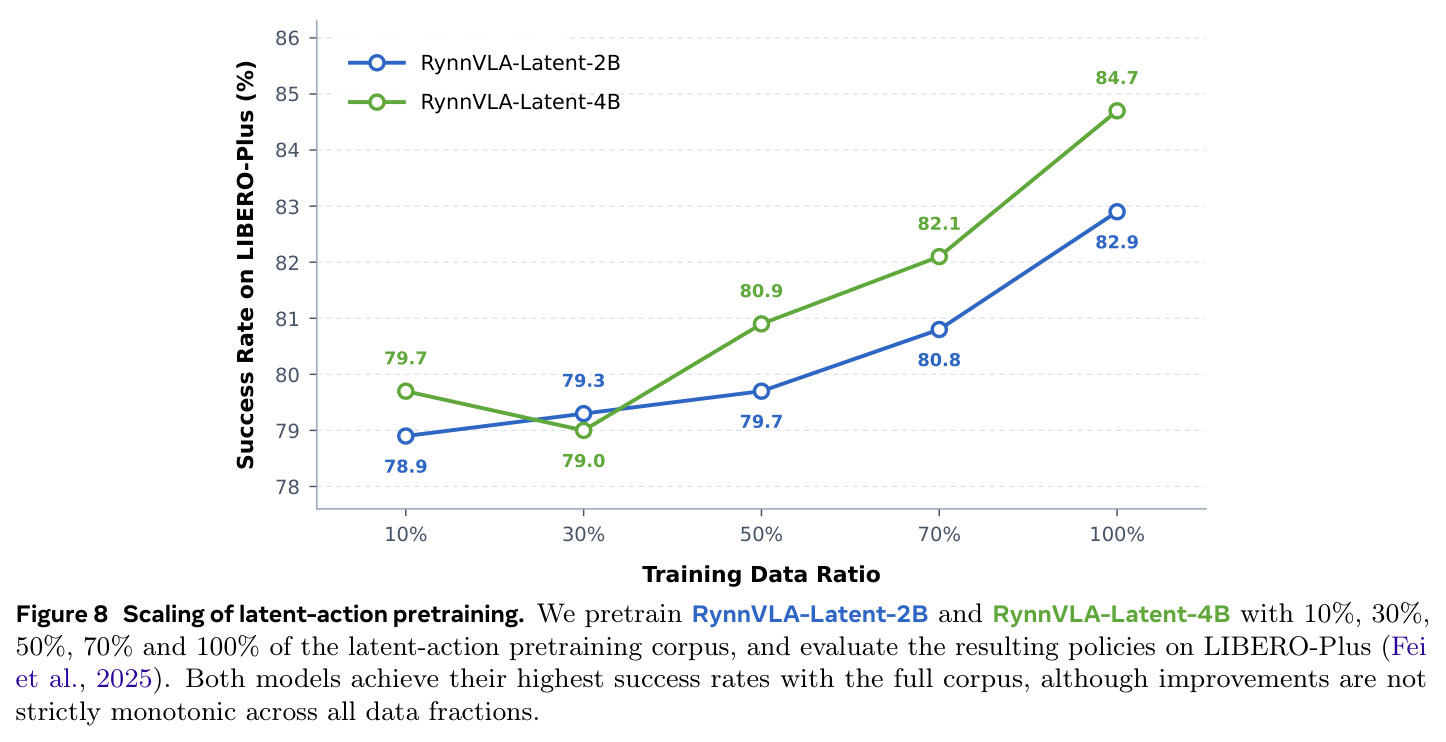
实验按表示、仿真、真机三级展开。表示级:LARY 冻结探针上 608 维描述子相对动作平均 MSE 0.38,为具身 LAM 最低——LAPA 0.93、Moto 0.77、DreamDojo 0.55、UniVLA/villa-X 均 0.87;消融中去除任一组件均恶化,最重为去残差特征预测(0.57)。仿真级:LIBERO 平均成功率 4B 达 98.8%,为表内最高;LIBERO-Plus 免适配 84.7% 超 π0.5 的 84.4%,语言/光照/噪声/布局四项第一,但相机扰动(72.9 对 78.4)落后;RoboTwin 2.0 Native 下 4B 平均 88.6% 超 LingBot-VLA 的 87.7%;VLABench 五轨平均 SR 51.9%,跨类别 SR 48.0% 对 π0.5 的 38.2%,常识轨 PS/IS 仍落后。真机级:六个任务 4B 全部最高,如 Table-Cleaning 40.0% 对 25.71%、Steak-Serving 57.14% 对 40.00%。数据扩展:2B 随语料单调上升,4B 略有波动后回升,两者在全量语料最佳。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LARY 低层控制回归(相对动作) | 平均 MSE(越低越好) | RynnLAM 0.38 | LAPA 0.93 / Moto 0.77 / DreamDojo 0.55 | 较最强基线 DreamDojo 低 0.17 |
| LIBERO(语言条件单臂操作,40 任务 500 轨/套件) | 平均成功率 | RynnVLA-Latent-4B 98.8%(2B 98.3%) | Xiaomi-Robotics-0 98.7% / π0.5 96.9% / OpenVLA-OFT 97.1% | +0.1 个百分点(表内最高) |
| LIBERO-Plus(7 类扰动鲁棒性,零样本评测) | 总成功率 | 4B 84.7%(2B 82.9%) | π0.5 84.4% / Cosmos Policy 82.2% | +0.3 个百分点,语言/光照/噪声/布局四项第一 |
| RoboTwin 2.0 Native(50 个双臂任务) | Clean/Randomized 平均成功率 | 4B 88.6%(88.7/88.4) | LingBot-VLA 87.7%(88.6/86.7)/ ABot-M0 85.6% | +0.9 个百分点,随机化场景领先 1.7 |
| VLABench(语义接地,五轨) | 平均成功率 SR | 4B 51.9%(2B 37.2%) | π0.5 48.1% / π0-FAST 39.8% | +3.8 个百分点,跨类别 SR 48.0% 对 38.2% |
| 六个真机任务(双灵巧手 + 移动双夹爪平台) | 闭环成功率(每任务 35 次) | 4B 六项全部最高:85.71/42.86/82.86/40.00/57.14/54.29% | π0.5:82.86/28.57/77.14/25.71/40.00/45.71% | Table-Cleaning +14.29、Steak-Serving +17.14 个百分点 |
局限与改进
作者承认的局限:深度、位姿、光流均为估计伪标签,几何监督不保证度量级精确运动,也不保证相机与操作信息完全分离;探针只测可预测性,解码流仅作定性解释,不能证明因果层面的动作可辨识性;性能依任务与扰动而异,部署仍需本体特定的动作标注演示;未建立普适缩放律,也未把数据量与优化暴露差异完全隔离。我的补充观察:其一,相机与初始状态扰动是明显短板(LIBERO-Plus 相机 72.9%、机器人状态 64.0% 均低于 π0.5),说明鼓励解耦不等于视角不变;其二,2B 与 4B 并非全面占优——LIBERO Long 套件 2B(97.8%)反超 4B(97.0%),VLABench 上 2B 平均 SR(37.2%)低于 π0.5(48.1%),语义接地依赖骨干规模;其三,RoboTwin Native 协议训练含随机化演示,88.6% 是协议内成绩而非零样本能力;其四,真机 2B 在摆盘(80.0%)与擦盘(68.57%)落后 π0.5,收益集中在 4B 尺度;其五,结论中 RoboTwin 仍低于最强基线的表述与表 6(4B 88.6% 最高)不一致,应以表格为准。
独立分析的弱点
独立分析五个弱点。第一,伪标签链路的误差传播:深度、位姿、光流全来自现成模型,在动态模糊、反光表面(如真机任务里的盘子、锅具)或剧烈运动场景中,相机补偿后的动态流会系统性失真,潜动作随之带噪,可引入多帧一致性校验或对低置信度区域降权。第二,解耦靠对抗鼓励而非结构保证:GRL 只在训练分布内起作用,罕见视角变化时 $z_{at}$ 仍可能混入自运动——LIBERO-Plus 相机扰动仅 72.9% 是直接证据,可用 3D 等变网络或显式点云规范化把视角不变性做进架构。第三,时间粒度固定为 4 帧一对:各数据源 FPS 从 5 到 60 不等,同一 stride 对应的物理时间差差异巨大,慢动作与快动作的单位潜动作语义不一致,可按物理时间采样或学习自适应步长。第四,开环整块执行:推理时六步整块执行完才重新规划,长程接触丰富任务(如擦盘)中途纠错受限,可引入块内基于力或视觉反馈的提前中止与重规划。第五,压缩通路信息效率低:探针显示 64 维全局动作与 32 维相机潜向量单独几乎不含控制信息(MSE 0.93/0.95),信息集中在运动 token(单独 0.54),全局读出机制值得重新设计。
未来方向
作者提出的方向:改进几何一致性与视角鲁棒性;用更少的目标机器人监督完成迁移;把潜动作进一步与可执行控制对齐。基于已有成果可延伸的方向:其一,配套的 RynnWorld-Latent 已证明同一描述子可条件化跨本体视频生成,下一步可做策略与世界模型联合预训练,用潜动作作公共接口,甚至用世界模型回滚来筛选伪标签质量;其二,把 villa-X 式本体感知前向动力学作为可选目标并入 RynnLAM,机器人数据注入真值状态、人类视频退化为纯视觉,构造渐进式接地;其三,探针表明运动 token 承载主要控制信息,可研究策略直接预测运动 token、全局潜向量仅作语义条件的分层输出结构;其四,数据扩展曲线在 4B 上非单调,值得做学习率与源采样权重的数据配比研究,逼近真正的缩放律;其五,预训练与后训练共享流匹配结构,可探索少样本潜-原生动作快速重定向(只训末端投影),把本体适配成本进一步压低;其六,VLABench 语义接地仍弱于 π0.5 的部分指标,可在潜动作上叠加语言对齐对比目标,使动作表示与指令语义空间互通。
复现评估
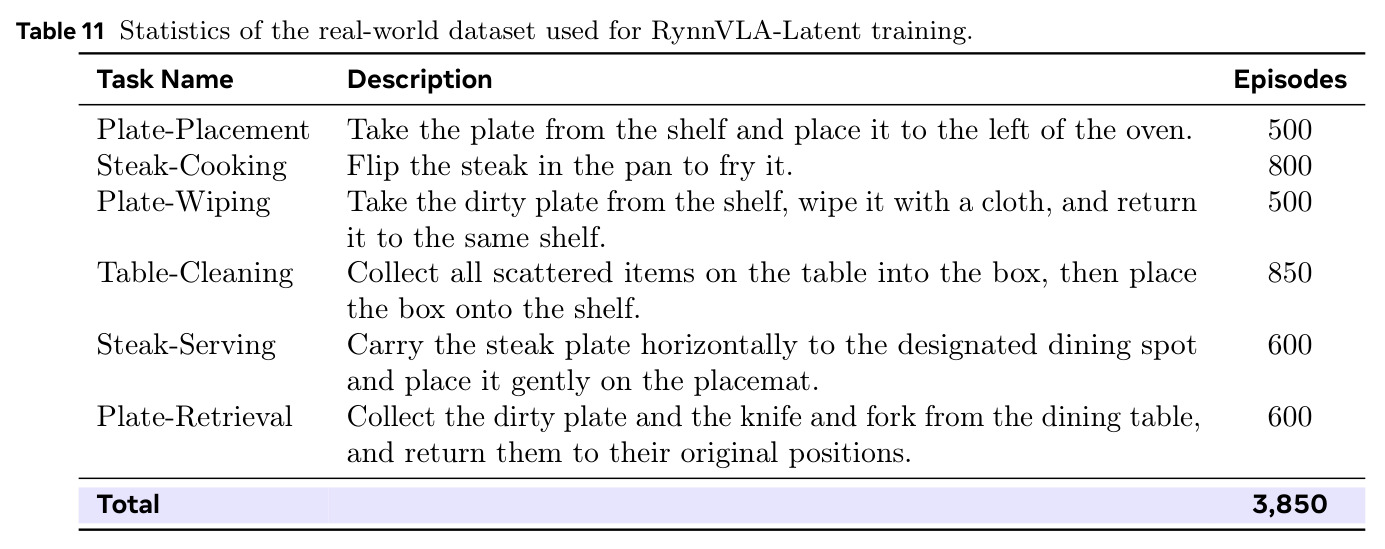
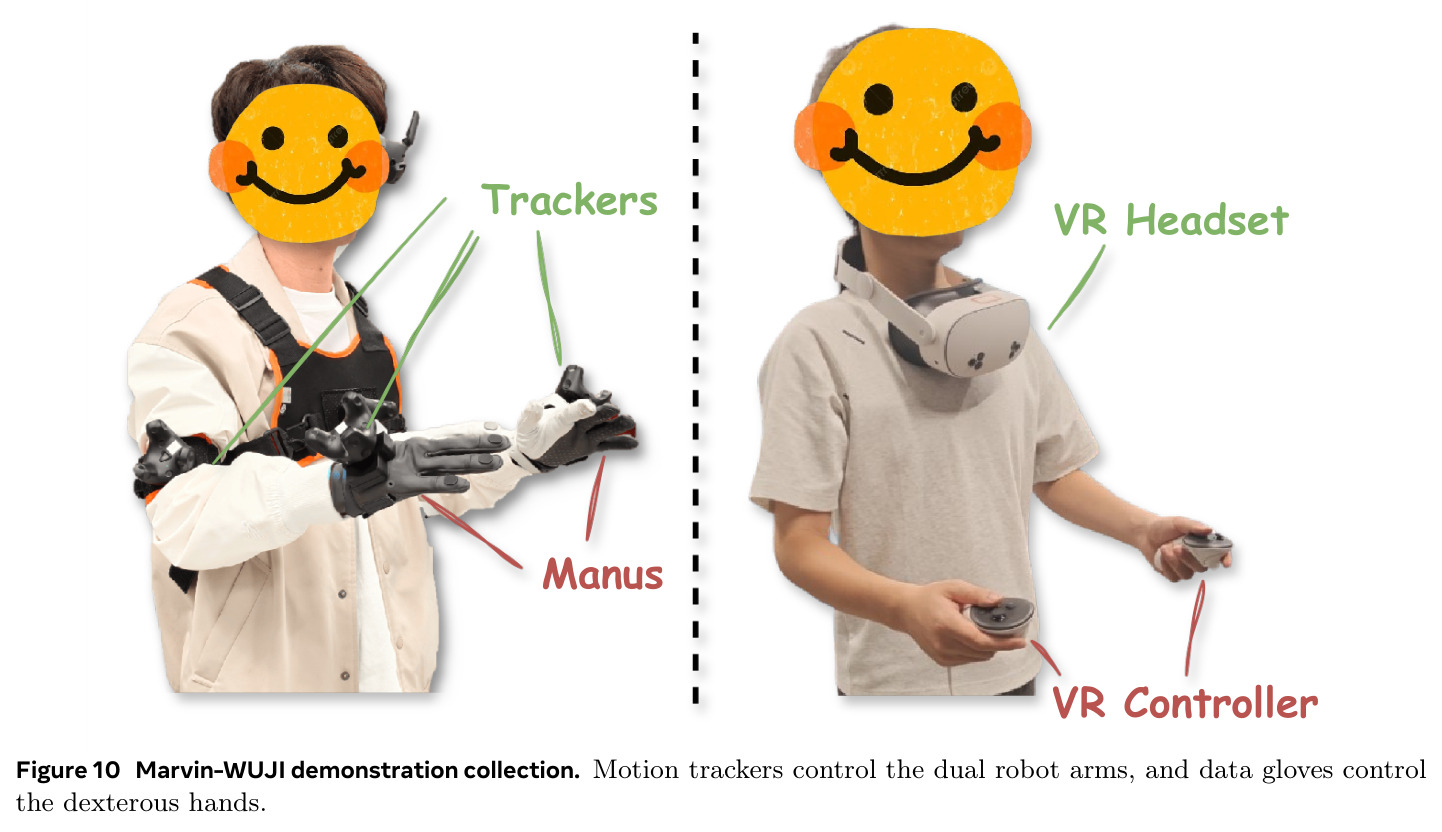
开源情况非常好:GitHub 代码(alibaba-damo-academy/RynnVLA-Latent)、HuggingFace 与 ModelScope 模型集合(含 2B/4B 权重)、项目主页均已公开。数据方面,30.1K 小时语料由 25 个公开数据集聚合而成(HowTo100M、EgoVid、DROID、AgiBot World 等),无需自行采集即可重建;伪标签工具链全部公开可得(Qwen3-VL、DPFlow、Depth Anything 3)。算力门槛是主要障碍:离线标注需在 250 分片上并行处理 3.057B 帧;全量策略训练约 121.06M 样本、每 epoch 约 946K 步,需要多节点 GPU 集群。真机复现需要两套平台(54 自由度灵巧手系统与移动双臂)和 3,850 条遥操作演示,Marvin-WUJI 的遥操作链路(Vive 追踪器、Pinocchio IK、Manus 手套)复刻成本高。综合评估:仿真基准与表 9 的 1000 小时子集对照实验对学术实验室友好,是复现核心主张的最佳切入点;全量预训练与真机评测基本只有工业级资源能完整完成。
论文图表
给定当前观测与指令,策略预测潜动作块,送入冻结的 RynnLAM 流解码器可视化其隐含的 3D 运动,八个示例涵盖超市取物、熨衣、擦白板、放置碗碟、开灶放壶等。
提供策略输出的可解释通道:能看到模型计划让物体如何运动,是连接潜空间与物理动作直觉的桥梁。