LaLa-World:以自然语言动作扩展潜在世界模型 LaLa-World: Scaling Latent World Models with Natural Language Actions
用语言统一动作与视觉变化,单个潜世界模型跨域联合训练,规划与策略推理大幅提速。
前置知识
潜在世界模型(JEPA 式 LWM)
不在像素空间生成未来画面、而在自监督编码器的潜在空间中预测未来表征的世界模型。编码器把观测映射为潜状态 $e_t$,预测器根据历史潜状态与条件输出 $\hat{e}_{t+1}$,训练目标是逼近编码后的真实未来表征,不重建图像、不用奖励。代表工作有 V-JEPA 2-AC、DINO-WM、JEPA-WMs。
本文的主体架构与训练目标就是它,所有规划与策略实验都建立在潜空间 rollout 的高效性之上,理解它与生成式世界模型(像素重建)的本质区别是读懂全文对比的前提。
MPC 规划与交叉熵方法(CEM)
模型预测控制式规划:给定初始观测与目标观测,让世界模型对候选动作序列自回归想象 $H$ 步,以最终潜状态与目标编码的距离 $C=\|\hat{e}_{t+H}-e_{\text{goal}}\|_2^2$ 打分。CEM 反复采样序列、保留低成本精英样本并更新采样分布,逐步逼近最优序列;本文一轮规划约需数千次想象 rollout。
论文所有规划评测(Table 1、Table B 等)都基于该协议,理解成本函数与采样循环才能看懂各基线的比较方式以及效率对比的含义。
生成式世界模型 / 视频生成模型
以像素级生成未来图像或视频为目标的模型(如 Sora 类模型、Cosmos-Predict2),通常以语言为条件,从网络级视频学到广泛的视觉动态知识,其预训练权重可作为策略学习的先验。但用于 MPC 时每个候选序列都要做昂贵的迭代去噪,评估成本远高于潜空间 rollout。
它是本文的对照组(RAEv2 基线)与策略初始化范式(Cosmos Policy)的来源,理解其代价与能力才能理解论文“潜 vs 生成”论证的分量。
自监督视觉编码器(DINOv2/DINOv3、V-JEPA 2)
在海量无标注图像/视频上预训练的 ViT,产出语义与空间结构兼备的 patch 级表征。LWM 通常冻结此类编码器(如 DINOv2-S/14、DINOv3-L/16),在其表征上训练动作条件预测器,既避免表征塌缩又复用预训练知识,编码器选择会显著影响各域规划表现。
本文冻结 DINO 系编码器作为观测编码器,其表征质量直接决定规划上限;视觉编码器消融(Table D)是论文的重要结论之一。
VLA 与世界模型预训练策略
视觉-语言-动作模型在机器人演示上微调 VLM,将观测与语言指令映射为动作块(如 π0、OpenVLA、Cosmos Policy)。新范式是先用视频/世界模型预训练,再微调成同时预测动作与未来观测的统一模型,以复用大规模视频先验并保留想象能力。
本文第 5 章把 LaLa-World 微调成 LaLa-Policy 正属此范式,需要在“只预测动作”与“动作+未来预测”两类基线之间定位其贡献与差异。
研究动机
现有 JEPA 式潜在世界模型(V-JEPA 2-AC、DINO-WM、JEPA-WMs 等)的动作条件预测器几乎都在单一仿真或机器人数据集上训练,动作以数值向量 $c_t \in \mathbb{R}^k$ 表示,其维度与物理含义随域而变:同样是向量 $[2,4]$,在一个域可能编码水平/垂直位移,在另一个域却表示 4 维力,导致共享动力学难以学习,每个域都要单独训练一个模型。与此同时,海量的图像与视频数据天然缺少数值动作标注,无法进入动作条件预测器的训练,使 LWM 的数据规模远小于语言条件化的视频生成模型。此外,控制数据中动作若以固定模板转成语言,模型只见过狭窄的措辞分布,对同义改写脆弱,泛化与鲁棒性都受限。
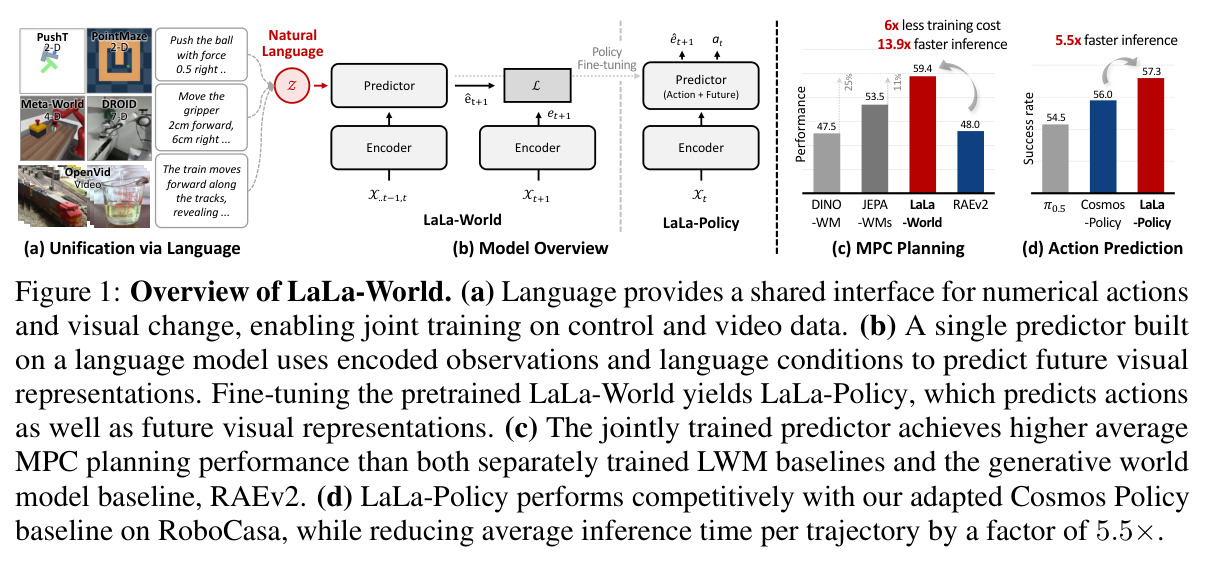
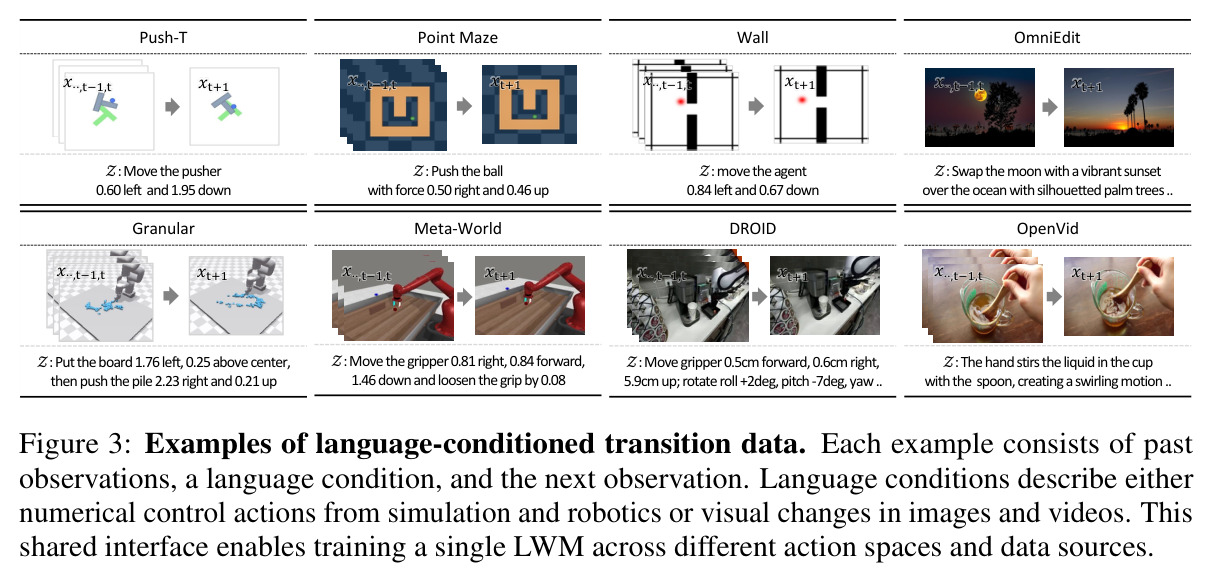
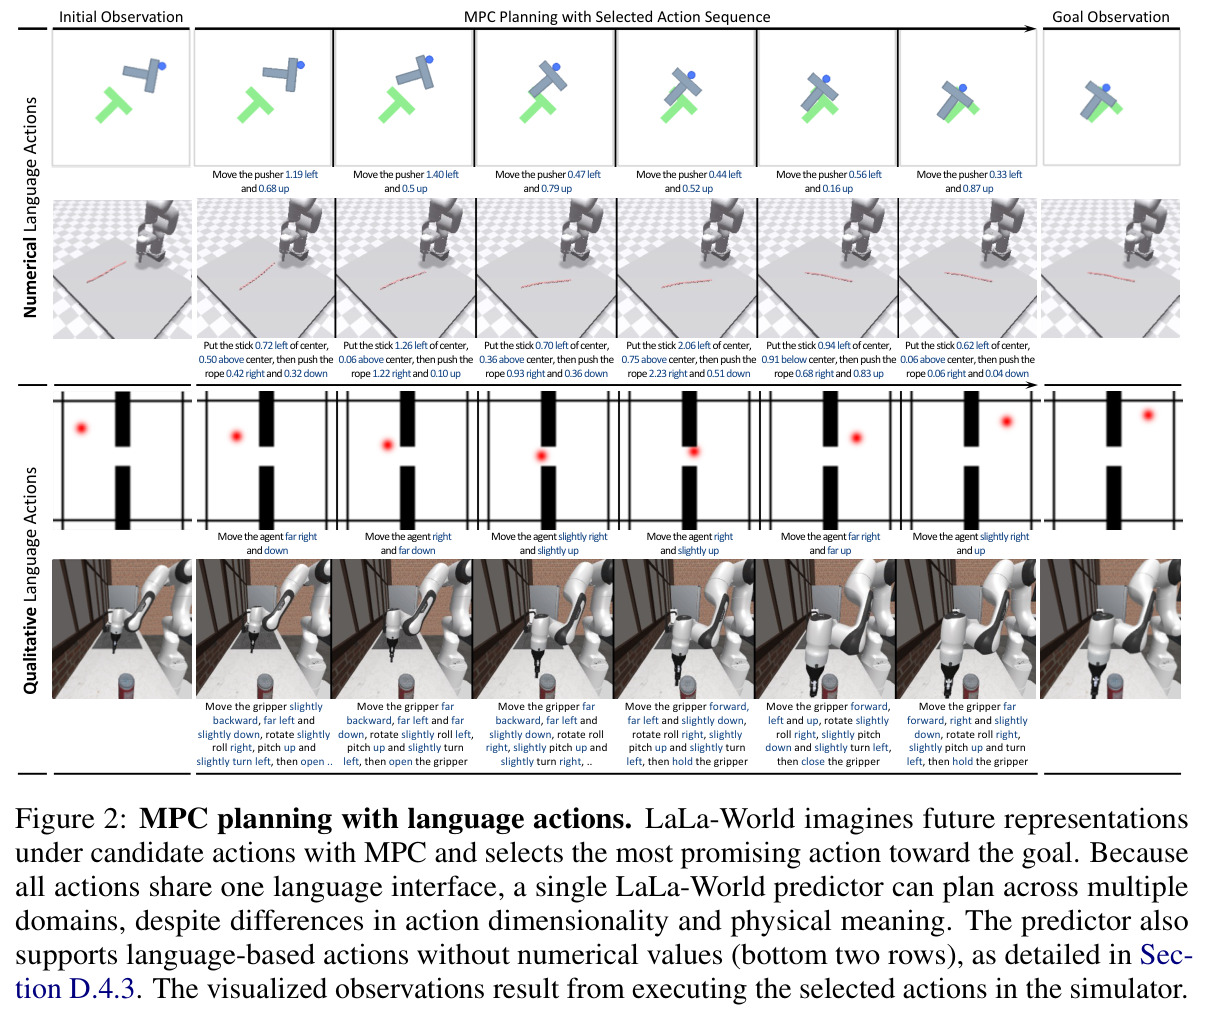
本文的目标是本文目标是构建 LaLa-World——一个语言条件化的潜在世界模型:把 7 个控制数据集(Wall、PointMaze、Push-T、MetaWorld、Rope、Granular、DROID)的数值动作经固定模板转写为保留数值与方向的自然语言,如 “move 2 left and 4 up and push with force 2 downward”,并把 OpenVid-1M 视频的帧间变化描述与 OmniEdit/ShareGPT-4o-Image 的图像编辑指令作为同一形式的条件,让一个约 0.8B 参数的预测器跨异构数据联合训练。在此基础上回答三个问题:联合训练是否优于逐域训练的 LWM;在相同语言条件、训练数据与视觉编码器下,潜在世界模型与生成式世界模型(RAEv2)的规划性能与效率孰优;预训练世界模型能否像 Cosmos Policy 一样微调成高效策略。
与已有工作不同的是,已有两条路线各持一半答案:视频生成模型用语言接口实现了跨域、跨数据源训练,但 MPC 规划要反复评估成千上万条候选动作序列,每次都需像素级生成,代价高昂;JEPA 式 LWM 在潜空间 rollout 高效,却被数值动作接口锁死在单一域,也无法利用无动作标注的图像/视频。本文的独特切入是把视频生成模型的语言接口“移植”进 LWM,同时保持纯潜预测目标(不重建像素、不用奖励监督)。架构上进一步区别于外挂文本编码器的常见做法:直接把预测器建在一个语言模型(Qwen3.5-0.8B)上,文本 token 与视觉 token 在同一骨干内交互,语言理解与动力学预测端到端联合训练。作者指出,这是首次在匹配条件(相同语言条件、训练数据、视觉编码器)下系统比较潜在与生成式世界模型的规划能力。
核心方法
直觉上,语言是描述“动作”与“视觉变化”的公共接口,可让控制轨迹与图像/视频数据进入同一个下一状态预测目标。技术路线分两步。第一步构造语言条件转移数据:把控制转移的跨子步聚合动作经固定模板转成语言句(保留数值与方向),同时提供数值与定性(slightly/far 三档)两种描述;再补充 OpenVid-1M 帧间变化描述(Qwen3-VL 生成)、OmniEdit 与 ShareGPT-4o-Image 的编辑指令三元组。第二步是编码器-预测器架构:冻结的 DINOv2-S/14 或 DINOv3-L/16 把每帧编码为 patch 级潜表征;预测器以 Qwen3.5-0.8B 为骨干,视觉 token 经两层 MLP 投影并附加 3D 位置编码(时间 + 2D 空间),语言条件直接 tokenize 后与视觉 token 拼接,每个目标 patch 挂一个共享可学习 query,一次前向读出 $\hat{e}_{t+1}$,训练目标为 $\mathcal{L} = \|\hat{e}_{t+1} - e_{t+1}\|_2$。模型不使用本体感知状态以保持域无关;另训一个 12 层 transformer 解码器仅用于可视化。训练在 8 张 H100 上进行 20 个 epoch。
核心创新是“预测器本身就是语言模型”。已有 LWM 用 AdaLN(JEPA-WMs)、特征条件化(DINO-WM)或序列条件化(V-JEPA 2-AC)注入数值动作,均无法读文本;视频生成模型则需外挂文本编码器(如 RAEv2 用 Qwen3-0.6B),增加参数与编码开销。LaLa-World 让语言条件以原生文本 token 进入 LLM 骨干,语言理解与未来预测在同一网络内完成,无需独立文本塔。数据侧的配套创新是把“数值动作”与“视觉变化”统一成语言描述,使控制轨迹、视频、图像编辑对共享同一预测目标,从而用一个模型吃到异构数据。第三点是坚守纯潜预测:与 DreamerV3 的重建损失、TD-MPC2 的奖励监督不同,LaLa-World 只匹配未来视觉表征,既保留规划效率,也避免跨域联合训练在像素细节上互相干扰。
方法步骤详情
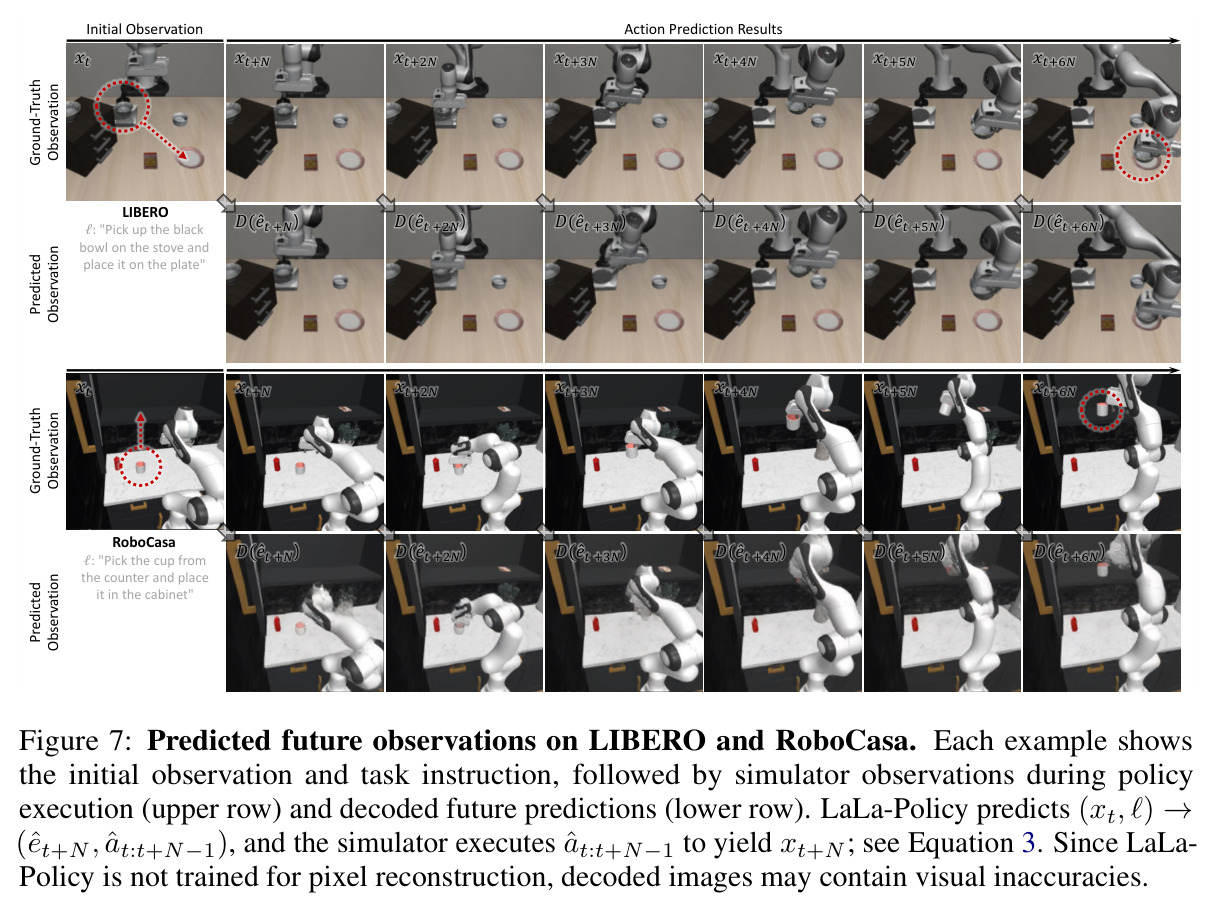
(1) 数据构建:Wall/PointMaze/Push-T/MetaWorld 每转移跨 5 个仿真子步,先聚合求和再转写语言;Rope/Granular 每转移对应一次推动;DROID 用 LeRobot 版本、每 4 帧取 1,从末端位姿与夹爪变化推导动作描述,取 150 万转移(约全集 20%)防止主导混合;每条转移同时配数值与定性两种模板句;视频侧取 102 万条 OpenVid 片段与 34 万编辑对。(2) 编码投影:冻结 DINO 编码器输出 patch 表征,两层 MLP 投影到骨干嵌入维度,附加正弦 3D 位置编码(乘可学习缩放)。(3) 预测训练:上下文帧数 1-3 随机采样,语言、视觉与查询 token 一起进入 Qwen3.5-0.8B,两层 MLP 头一次前向回归 $\hat{e}_{t+1}$,与目标 $e_{t+1}$ 做平方误差。(4) MPC 规划:CEM 采样数值动作序列→模板转语言→自回归 rollout $H$ 步→以 $C=\|\hat{e}_{t+H}-e_{\text{goal}}\|_2^2$ 打分→执行选中前缀→重规划;定性模式下样本先经三档分箱转换再评估。(5) LaLa-Policy 微调:加入动作 query,预测 $(\hat{e}_{t+N}, h_{t:t+N-1})$,GR00T 风格 DiT 动作头从高斯噪声流匹配生成动作块;编码器冻结,预训练预测器与新增策略模块联合训练。
技术新颖性
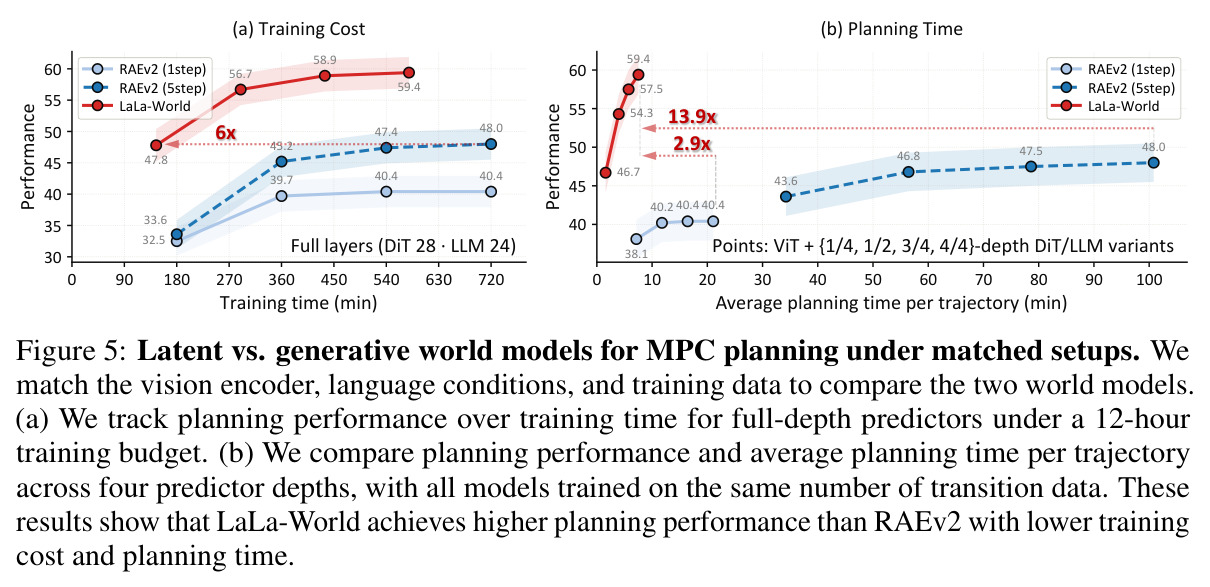
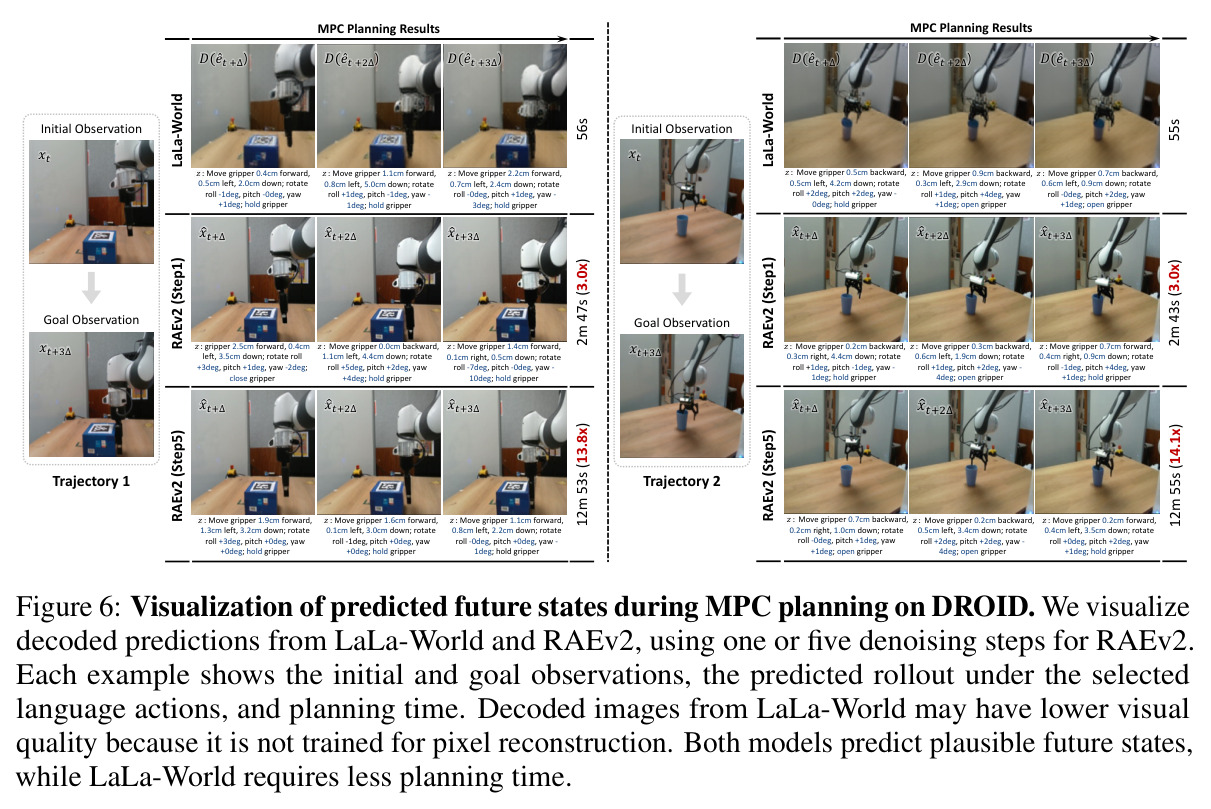
新颖性体现在四点。其一,以语言为动作/变化接口联合训练 LWM 属首次尝试,与把语言当观测或任务描述的 Dynalang 本质不同——这里语言是动作的载体而非额外输入。其二,LLM 直接充当动力学预测器骨干,且消融(Figure E/F)显示语言敏感性同时依赖数据与骨干:Nemotron-1B 的验证损失接近 Qwen3.5-0.8B,但方向词反转时敏感度分数几乎不变,说明低预测损失不代表模型遵循动作语义;3D 位置编码 + 可学习查询的组合语言依赖度最高,MRoPE 或原地读出都会削弱。其三,首次在匹配条件下对比潜在与生成式世界模型:同编码器(DINOv3-L/16)、同语言条件、同数据、同为约 0.8B 预测器,LaLa-World 平均 59.4% 对 RAEv2 的 40.4%/48.0%(1/5 去噪步)。其四,验证了“世界模型预训练→策略初始化”在潜世界模型上同样成立(此前只有 Cosmos Policy 在视频生成模型上证明),并以潜空间联合预测换来 5.5× 推理加速。
实验结果
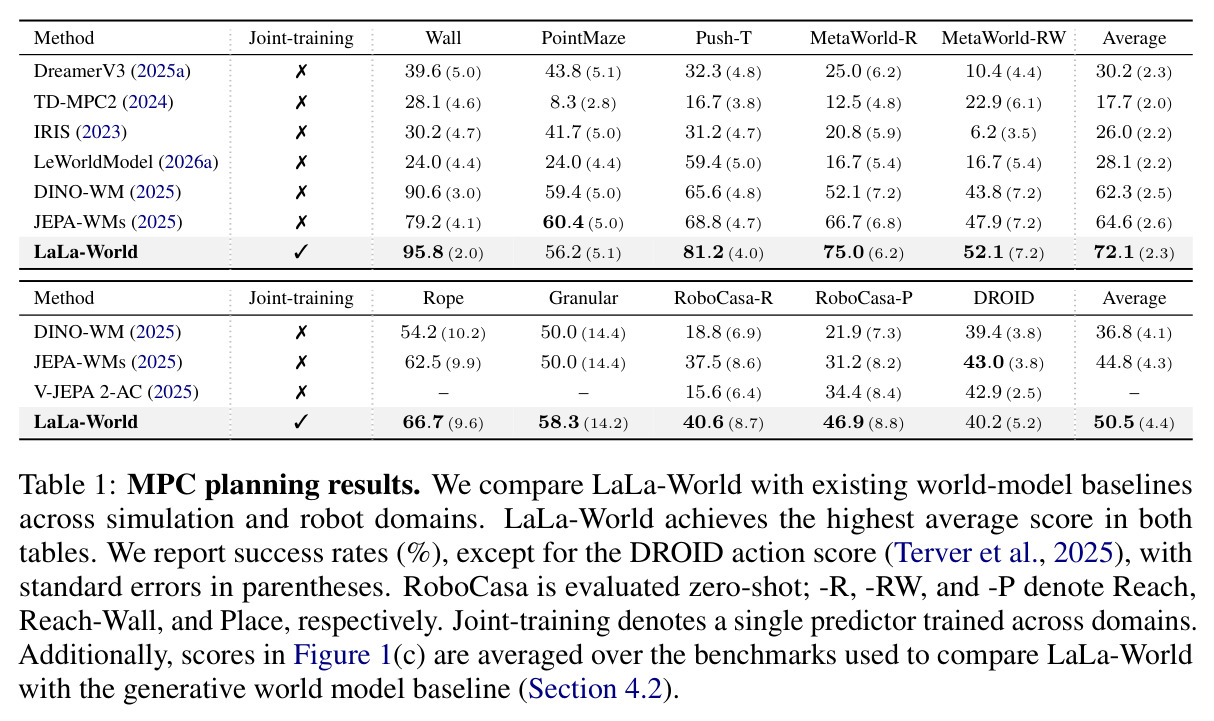
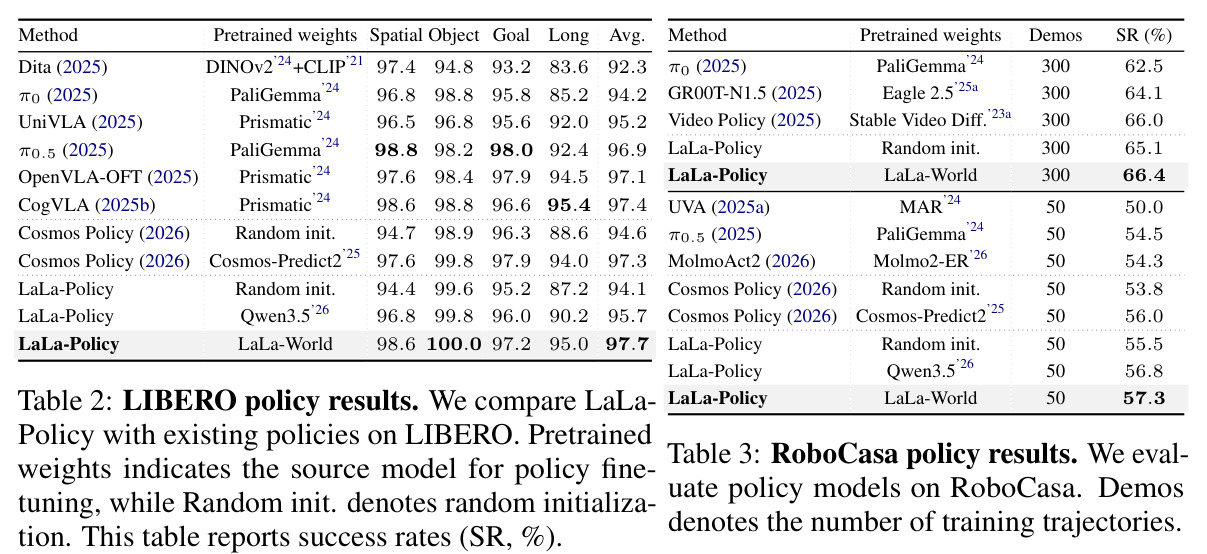
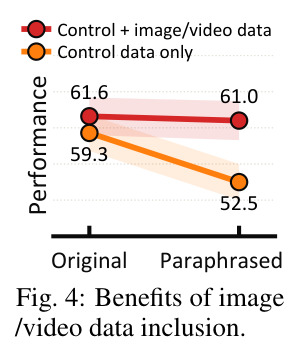
实验覆盖规划、效率与策略三层。第一,MPC 规划(Table 1):单预测器跨域联合训练在五个仿真域平均成功率 72.1%,超最佳基线 JEPA-WMs(64.6%)7.5 个百分点,Push-T 从 68.8% 升至 81.2%;在 Rope/Granular/RoboCasa/DROID 上平均 50.5%(JEPA-WMs 44.8%),RoboCasa 为零样本(Reach 40.6%、Place 46.9%)。第二,加入图像/视频数据:平均分 59.3→61.6,且措辞改写下仅降 0.6 分(61.0),纯控制数据版下降 6.8 分(52.5)。第三,潜 vs 生成(Figure 5):12 小时预算内 LaLa-World 用 2 小时达到 5 去噪步 RAEv2 的 12 小时性能,最终 59.4% vs 48.0%,7 个基准中 6 个胜出;规划快 2.9×/13.9×(vs 1/5 去噪步),训练成本约 1/6。第四,LaLa-Policy:LIBERO 平均 97.7%,超 Cosmos Policy 97.3 与 π0.5 96.9;RoboCasa 50 演示 57.3%(对比 Cosmos-Predict2 初始化 56.0%);推理每轨迹 LIBERO 快 5.2×、RoboCasa 快 5.5×(0.86s vs 4.45s、2.12s vs 11.71s)。第五,附加分析:ImageNet 变换检索 MRR 0.856(空语言对照 0.026);LLM actor 以 90 次 rollout 在 Wall 达 100%(CEM 需 9,000 次);预训练初始化+联合训练平均 60.2%,高于随机初始化 55.6% 与单域训练 54.5%;双编码器把十基准平均提到 63.0%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| MPC 规划(Wall/PointMaze/Push-T/MetaWorld-R/-W 五仿真域平均) | 成功率 (%) | 72.1 | JEPA-WMs 64.6(最佳 LWM 基线) | +7.5 个百分点;Push-T 81.2 vs 68.8 |
| MPC 规划(Rope/Granular/RoboCasa-R/-P/DROID,含零样本) | 成功率 (%)(DROID 为动作分) | 50.5 | JEPA-WMs 44.8;V-JEPA 2-AC(部分域) | +5.7 个百分点;RoboCasa 零样本 40.6/46.9 vs 37.5/31.2 |
| 潜 vs 生成世界模型匹配对比规划(7 基准平均) | 成功率 (%) | 59.4(LaLa-World 全深度) | RAEv2 5 去噪步 48.0 / 1 去噪步 40.4 | +11.4 个百分点;训练成本约 1/6,规划加速 13.9×(vs 5 步)/2.9×(vs 1 步) |
| LIBERO 策略(Spatial/Object/Goal/Long 四套件平均) | 成功率 (%) | 97.7(LaLa-World 初始化) | Cosmos Policy(Cosmos-Predict2 初始化)97.3;π0.5 96.9;CogVLA 97.4 | +0.3~0.8 个百分点,推理每轨迹 0.86s vs 4.45s(5.2×) |
| RoboCasa 策略(24 个厨房任务,50 条人类演示/任务) | 成功率 (%) | 57.3(LaLa-World 初始化) | Cosmos Policy(Cosmos-Predict2 初始化)56.0;π0.5 54.5 | +1.3 个百分点,推理每轨迹 2.12s vs 11.71s(5.5×) |
局限与改进
作者承认的局限:预测器只有单步潜状态监督,未做多步自回归损失,长序列 rollout 能力未验证;MPC horizon 最长 6 步,远后果预见不足;LaLa-Policy 仅在仿真评测,未上真机;训练数据规模远小于 Wan 等视频生成模型,广域数据收益是否随规模持续未知;解码图像存在视觉失真。我自己的观察:其一,编码器完全冻结,Table D 显示首选编码器随基准剧烈波动(DINOv2-S 在 Push-T 81.2% 但 MetaWorld-R 仅 8.3%),暴露表征-动力学错配;其二,动作聚合把 5 个子步求和再均分执行,丢弃步内变化;其三,定性语言动作在 Push-T 崩至 4.2%(数值版 81.2%),幅值粗化在精细操作域代价极大;其四,CEM 每轨迹仍需数千次 rollout,LLM actor 虽省 100× 调用但 GPT-6 Astra 在 RoboCasa-R 仅 17.4%;其五,RAEv2 基线初始化自 ImageNet 生成预训练而非视频级大模型,“潜优于生成”对更强视频基线是否成立存疑。
独立分析的弱点
独立弱点分析:1) 单步监督限制长程想象——候选序列第 5、6 步的预测误差会累积,且每次 rollout 只预测一帧,改进方向是引入多步 rollout 损失或分层预测(粗粒度远期 + 细粒度近期);2) 冻结编码器使潜空间不为控制服务——DINO 特征偏向语义识别而非动力学要素(位置、速度、接触力),可借鉴 LeWorldModel 用 SIGReg 防塌缩做端到端训练,或为世界模型定制预训练目标;3) 语言接口的封闭性——模板词汇固定,加入图像/视频数据后改写鲁棒性仅恢复到 -0.6 分,真实用户或 LLM 输出的措辞多样性更高,可加入指令重写增强与更大规模 caption 数据;4) 规划成本依赖目标图像编码——无目标图的真实任务需要接入奖励/价值模型,作者提出的 best-of-N + 价值预测是可行方向;5) 零样本规划性能有限(RoboCasa-R 40.6%),可沿 V-JEPA 2-AC 路线做 DROID 式定向后训练;6) 评测全部在仿真或离线 DROID 动作分上完成,真机 sim-to-real 差距未量化,语言转写的舍入误差在真机上可能被放大。
未来方向
作者在附录 B 提出六个方向:扩大数据与模型容量并分别消融规模效应;在防塌缩约束下端到端训练视觉表征;把监督从单步扩展到自回归多步序列;延长规划 horizon 以评估远期后果;在真实机器人上验证 LaLa-Policy;为 LaLa-Policy 引入价值/未来状态预测以支持 best-of-N 规划(对齐 Cosmos Policy 的做法)。基于本文成果还可延伸:把“通信式世界建模”(LLM actor 以 90 次 rollout 达到 CEM 9,000 次的效果,调用减少约 100×)发展为分层智能体——LLM 负责提议与修正语言动作,世界模型负责想象打分,形成人可读的规划对话;利用双编码器互补性(63.0% vs 单 DINOv3 的 53.7%)研究多表征融合或表征蒸馏;把图像编辑对扩展为“指令式反事实推理”数据源,训练模型理解非动作类场景变化;以及用 LaLa-Policy 的未来潜预测做执行前安全性检查。
复现评估
复现条件较好。论文提供项目主页与 LaLa-World、LaLa-Policy 代码链接(NAVER AI Lab 出品)。训练数据全部公开:仿真数据与 DROID 来自 DINO-WM/JEPA-WMs 与 LeRobot 发布,OpenVid-1M、OmniEdit、ShareGPT-4o-Image 均开放下载;策略实验直接使用 Cosmos Policy 发布的 LIBERO/RoboCasa 数据。骨干 Qwen3.5-0.8B 与 DINOv2/DINOv3、SigLIP2 均为公开权重,RAEv2 基线用官方 checkpoint 初始化。附录 D 给出完整超参(AdamW、batch 512、峰值学习率 $2\times10^{-4}$、20 epochs)与各基准 CEM 设置,评测协议沿用 JEPA-WMs/DINO-WM。门槛在算力:训练均需 8×H100 80GB,CEM 评测每轨迹需数千次 rollout、基建成本高。个人小规模复现可缩小骨干或退回单域训练,作者的架构消融表明核心结论在缩小配置下仍可观察。
论文图表
LIBERO 四套件成功率:LaLa-Policy(LaLa-World 初始化)97.7%,高于 CogVLA 97.4、OpenVLA-OFT 97.1、Cosmos Policy(Cosmos-Predict2)97.3、π0.5 96.9;同架构随机初始化仅 94.1%、Qwen3.5 初始化 95.7%。
证明世界模型预训练提供了超越随机与通用 LLM 初始化的策略先验,且整体优于现有 VLA。
每轨迹平均推理时间:LIBERO 中 Cosmos Policy 4.45s vs LaLa-Policy 0.86s(5.2×);RoboCasa 中 11.71s vs 2.12s(5.5×)。
量化潜空间策略相对视频生成式策略的推理效率优势,是“不需要像素级生成也能做好策略”论点的直接数据。
两张定位表:(a) 世界模型维度上对比 DINO-WM/JEPA-WMs(数值动作、域内控制数据)、Cosmos-Predict2/RAEv2(语言条件、图像视频数据、VAE/SSL 编码器)与 LaLa-World(语言条件、图像视频+控制数据、SSL ViT);(b) 策略维度上对比 VLA(只预测动作块)、Cosmos Policy(动作块+未来帧)与 LaLa-Policy(动作块+未来潜表征)。
一图看清本文在两条研究线中的坐标与差异化设计,适合作为相关工作定位的总览。
左侧为 ImageNet 训练对:源图、几何变换后的目标视图及语言动作描述(如 “Adjust the view: zoom in 1.54x, then horizontally flip”);右侧为检索评测:对 256 个候选视图按预测潜相似度排序,命中语言指定的目标。
展示静态图像如何经语言变换进入与控制数据相同的训练格式,是数据统一思路的延伸证据。
256 选 1 的变换检索 MRR:LaLa-World 用语言动作达 0.856,而直接用源图潜表征仅 0.024、空语言预测仅 0.026;IWM 公布结果为 0.79-0.85(设置不同)。
受控对照证明预测器确实利用语言内容建模指定的视觉变化,而非依赖视觉规律或数值模式。
流程图:LLM actor(Claude Opus / GPT)读入初始与目标观测,写出 N 条语言动作候选计划;LaLa-World 在潜空间想象每条计划并只返回目标距离成本;LLM 据此修订,K 轮后执行最低成本计划。CEM 每计划需 9,000 次 rollout,LLM actor 仅 90 次(约 100× 减少)。
展示语言接口带来的全新交互范式——LLM 直接替代 CEM 与世界模型对话,是本文最具想象力的应用场景。
LLM actor 与 CEM 的规划对比:Claude Opus 5 在 Wall 以 90 次 rollout 达 100%(CEM 9,000 次 95.8%)、RoboCasa-R 以 80 次达 53.1%(CEM 54,000 次 40.6%);GPT-6 Astra 在 DROID 以 48 次达 44.7%(CEM 4,500 次 40.2%),但 RoboCasa-R 仅 17.4%。
证明 LLM 能以两个数量级更少的想象预算通过语言接口规划,同时揭示精确控制任务上的短板。
(a) 同一目标转移的四种语言条件(数值参考、纯定性、方向反转、幅值互换);(b) 理想敏感度模式;(c) 只用控制数据 vs 加图像/视频数据的敏感度对比;(d) BERT/Gemma/Nemotron/Qwen3.5 四种骨干的敏感度对比。
提出并验证“语言敏感性”度量,揭示低验证损失不等于遵循动作语义,是理解模型是否真正读懂语言的关键分析。
(a) 各语言骨干(含预训练与随机初始化 Qwen3.5)的验证损失曲线:预训练 Qwen3.5 早期收敛更快,最终损失接近;(b) 各种位置编码与读出设计的语言依赖度:3D 输入位置编码 + 可学习查询最高。
支撑默认架构选择的消融证据,说明骨干预训练带来收敛优势、架构细节显著影响语言利用程度。
架构细节图:(a) 默认设计——视觉 token 经 MLP 对齐后加 3D 位置编码,语言 token 与共享可学习查询一起进入骨干,查询输出经预测头映射为未来 patch 表征;(b) 三种消融变体:原生 1D 位置、MRoPE、原地读出状态 token。
清晰交代视觉潜表征与文本 token 如何在同一 LLM 内混合与读出,是复现与理解架构创新的必要图。
六基准平均成功率:预训练 LLM + 联合训练 60.2%,预训练 + 单域训练 54.5%,随机初始化 + 联合训练 55.6%;联合训练在 RoboCasa 零样本上优势明显(40.6/46.9 vs 21.9/31.2)。
分离初始化与训练范围两个因素,证明联合训练本身(而非仅预训练初始化)带来跨域收益。
十基准上的编码器消融:LaLa-World 用 DINOv2-S/14 平均 47.7、DINOv3-L/16 53.7、SigLIP2 37.3,双编码器 DINOv2+DINOv3 达 63.0(对照 Table 1 参考行 61.3);各编码器的优势域明显不同(DINOv2-S 强于 Push-T/Granular,DINOv3-L 强于 PointMaze/MetaWorld)。
揭示视觉表征与世界模型任务的错配问题,双编码器互补性是文中第二好的结果来源,指向未来表征研究方向。
定性 vs 数值语言动作的规划成功率:定性版 Wall 83.3、MetaWorld-R 70.8、MetaWorld-RW 60.4,但 Push-T 仅 4.2、RoboCasa-R 28.1(数值版分别为 95.8、75.0、52.1、81.2、40.6)。
量化“无数值语言规划”的能力边界:粗粒度幅值在部分域可行,但在需要精确幅值的域代价巨大。
措辞改写下的规划表现:只用控制数据训练时五域平均从 59.3 降到 52.5(-6.8),加入图像/视频数据后 61.6 → 61.0(-0.6);表中给出具体替换(move the agent→push the dot、move the gripper→shift the robot hand 等)。
直接证明广域视觉数据让模型不再死记模板措辞,是语言接口泛化性的关键量化证据。
Figure 5 的域级分解:LaLa-World(全深度 LLM 预测器)在 7 个基准中的 6 个上超过 1 步与 5 步去噪的 RAEv2,在 MetaWorld-R 上与 5 步版持平;平均 59.4 vs 40.4/48.0。
确认匹配对比的优势并非由个别域拉动,而是跨域普遍成立的结论。
三种规划协议示意:Wall 一次执行全部 6 步无需重规划;MetaWorld Reach 规划 6 步但每 3 步重规划、轨迹长 20 步;Rope/Granular 规划 5 步每步重规划,每步对应一次推动。
厘清“步/子步/轨迹”与重规划机制,是读懂 MPC 设置与 Table H 的前置图。
(a) 训练数据构造:把 5 个子步动作求和(基线 10 维 → LaLa-World 2 维)再转写语言条件;(b) MPC 执行:CEM 优化聚合动作,执行时除以 5 均分到各子步,丢弃步内变化。
说明语言化带来的动作空间压缩设计与执行近似,是理解训练/规划一致性的必要细节。
(a) 转换规则:按训练数据中各方向最大幅值三等分,映射为 slightly/无修饰/far(如 move 0.4 left→move slightly left);(b) 规划流程:CEM 采样数值动作→转换为定性描述→LaLa-World 潜空间 rollout 打分→模拟器用原始数值执行选中动作。
展示“无数值语言动作规划”的完整机制,说明语言接口可承载粗粒度语义控制。
各数据集规模:Push-T 219.9 万、MetaWorld 116.2 万、DROID 150 万、OpenVid-1M 102.3 万、PointMaze 18.7 万、OmniEdit 29.5 万、Wall 8.6 万、Rope 1.85 万、Granular 1.86 万、ShareGPT-4o-Image 4.6 万,合计约 637 万转移/样本。
给出跨域联合训练的数据配比全貌,是评估数据混合策略与复现训练的关键依据。
十个基准的评测设置:评估轨迹数(12-96)、轨迹长度(3-20)、规划 horizon H(3-6)、每计划执行步数、子步数、CEM 参数(如 30×300×10)与成功判据(位置/角度误差阈值、Chamfer 距离、DROID 动作分等)。
完整披露评测协议,保证与 DINO-WM/JEPA-WMs 可比,是复现规划实验的权威参考表。
架构图:微调自 LaLa-World 的预测器接收编码观测、任务指令与可学习的动作/未来查询,输出未来潜表征 $\hat{e}_{t+N}$ 与条件特征 $h_{t:t+N-1}$;动作生成器(GR00T 风格 DiT)以此为条件从高斯噪声去噪生成动作块。
说明世界模型到策略的转化路径——共享预测器骨干、新增动作头,是第 5 章方法的核心图。