跨模态转向向量在图像与文本生成中双向存在 Cross-modal Steering Vectors Exist Across Both Image and Text Generation
统一多模态模型中,单模态转向向量可零样本双向控制另一模态生成
前置知识
转向向量(Steering Vector)
一种对模型内部表征的线性干预方法:在生成过程中的隐藏状态上 $h'_\ell = h_\ell + \alpha v_\ell$ 加入一个方向向量,其中 $\alpha$ 控制干预的强度与符号。向量通常由对比样本对的激活差均值得到,能在不微调、不改权重的情况下连续调节输出的某种属性(如情绪、正式度、颜色)。
本文全部实验都建立在转向向量之上:作者在一个模态里提取向量,再原封不动加到另一个模态的 token 上,检验跨模态因果控制是否存在。不理解这个干预机制就无法理解 txt→img、img→txt 等四种实验设定。
统一多模态模型(UMM)
在一个共享参数的自回归 Transformer 中同时生成文本 token 与离散图像 token 的模型,训练目标是单一的 next-token 概率 $p_\theta(x)=\prod_{t=1}^{T}p_\theta(x_t|x_{<t})$,图像被离散化为 token 后与文本走同一骨干网络。文中测试了 UniAR(8B,语义化图像 token)、Emu3.5(34B)与 Liquid(7B,后两者的图像 token 面向像素重建)。
只有当文本与图像 token 共享生成权重、可以在同一组层上加向量时,'把文本向量加到图像 token 上'这一操作才有意义;主流扩散模型或权重分离的图文模型无法做这样的实验。
最小对比对(Minimal Pairs)
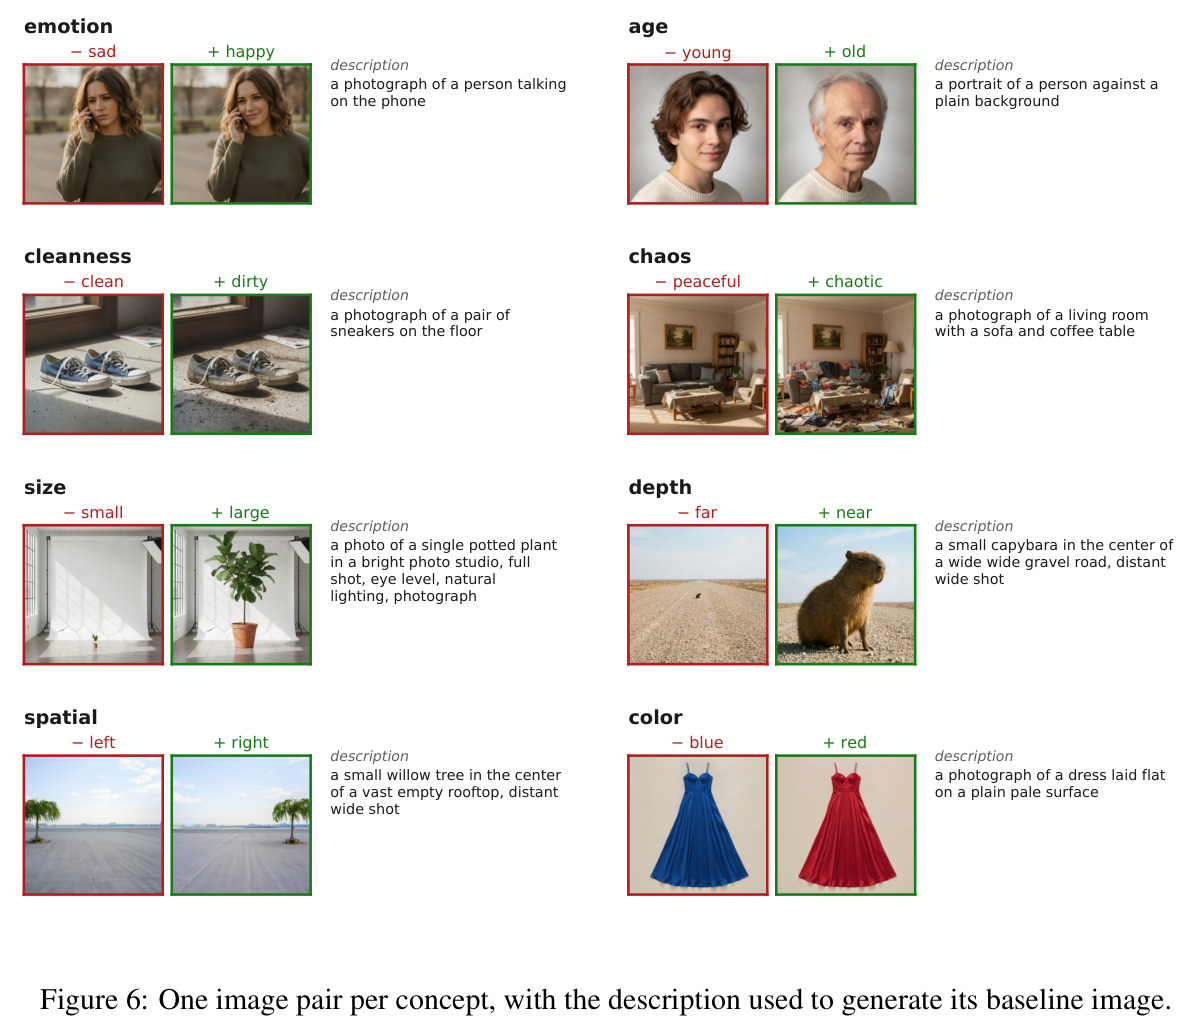
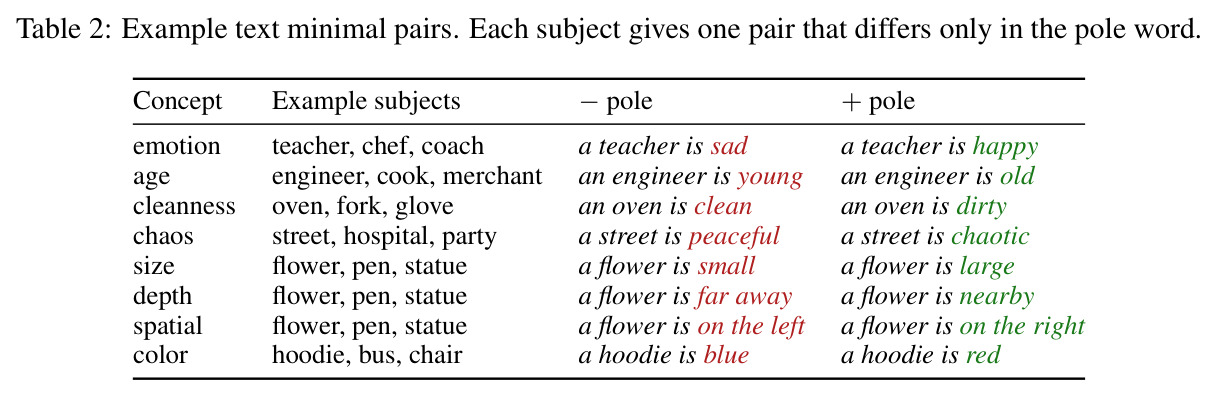
只在目标属性上不同、其他方面尽量相同的样本对 $(x_i^+, x_i^-)$,例如 “a chef is happy” vs “a chef is sad”,每概念构造 $N=100$ 对。转向向量取两份激活差的均值 $v_\ell=\frac{1}{N}\sum_i(h_{i,\ell}^+-h_{i,\ell}^-)$。文本用模板自动生成;图像则用指令式图像编辑模型把同一张基线图分别向两个极性编辑。
这是向量提取的数据基础,最小化程度直接决定向量是否只编码目标概念;图像侧如何批量构造极简图像对也是本文方法上的一个实际贡献。
概念率与跨模态恢复率(Concept Rate & Recovery)
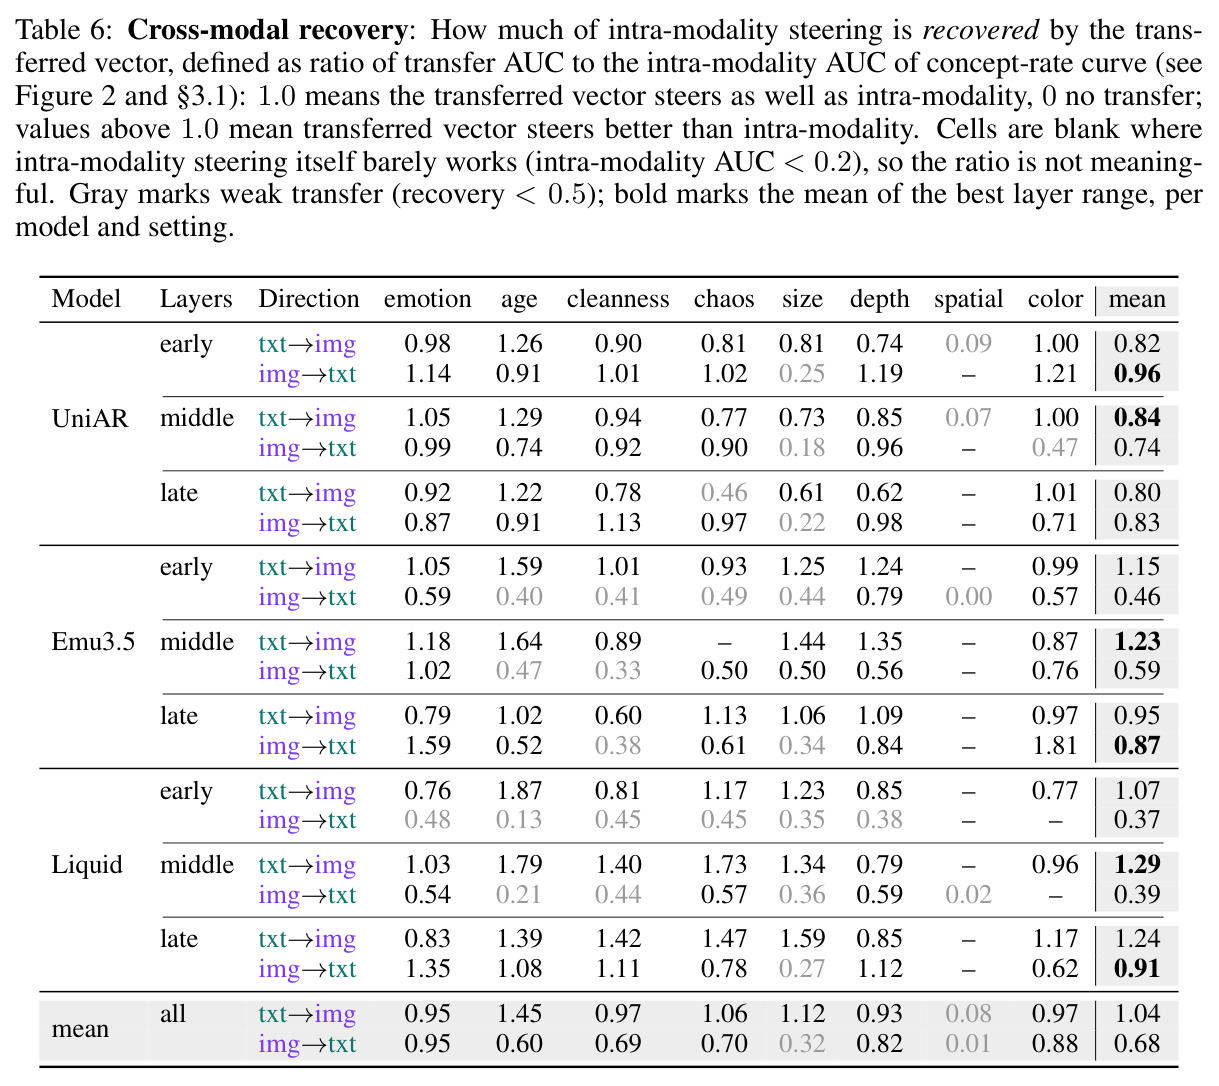
概念率 CR 是让 LLM 裁判(Gemini 3.7 Flash)在 steered 输出与未 steered 基线之间盲选、判对(输出朝目标极性偏移)的比例,对强度 $\alpha$ 扫描后取归一化 AUC 汇总。跨模态恢复率定义为迁移向量 AUC 与模态内向量 AUC 之比,如 $\mathrm{Rec}_{img}=\mathrm{AUC}(\text{txt→img})/\mathrm{AUC}(\text{img→img})$,1.0 表示与模态内一样好,大于 1 表示更好。
论文所有定量结论(84%、74%、1.20 等)都用这两个指标表达;裁判与人类一致性 Cohen's κ=0.62。读懂数字的定义才能正确评估结论强度与边界。
模态间隙(Modality Gap)
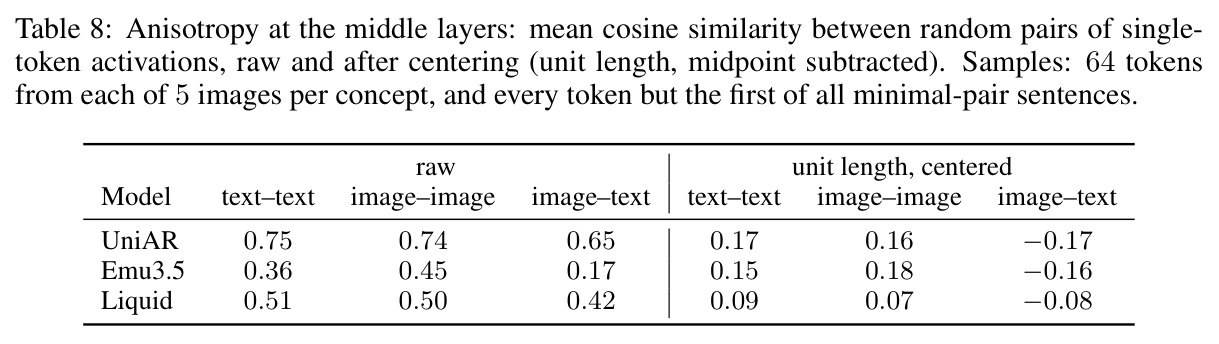
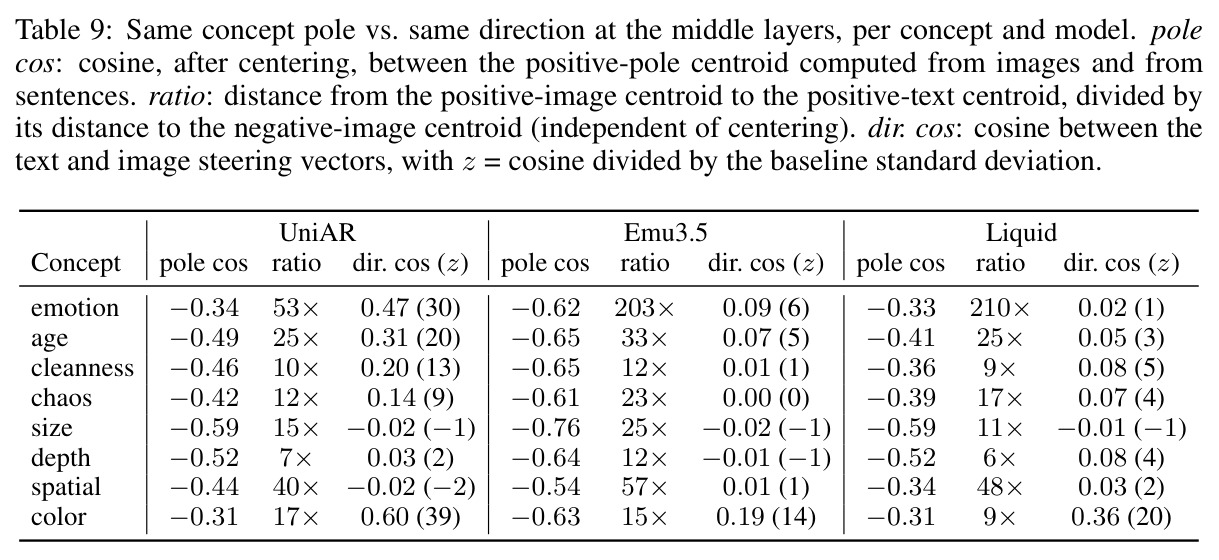
多模态模型中文本与图像表征在嵌入空间中占据两个分离窄锥的现象:UniAR 中间层同模态随机激活的平均余弦约 0.75/0.74,跨模态也有 0.65;中心化后同一概念的 happy 图像质心与 happy 文本质心方向相反(余弦约 -0.34),happy 图像质心到 sad 图像质心的距离只有到 happy 文本质心距离的约 1/53。
模态间隙意味着'表征对齐'很差,先前的相关性研究多据此判断模态未统一;本文正是在这种分离背景下发现因果方向仍然共享,这一对比是论文的核心张力。
表征各向异性与中心化(Anisotropy & Centering)
激活向量整体挤在窄锥里,使任意两个激活的余弦都偏高,比较方向前需先归一化到单位长度并减去均值(或模态中点)。中心化不改变转向向量本身——它是同一模态内两个均值之差 $\hat v=\mathrm{mean}(h^+)-\mathrm{mean}(h^-)$,常数偏移在相减时抵消。随机方向余弦的标准差约 $1/\sqrt{d}$(UniAR 为 0.016),可作显著性基线。
第 3.4 节几何分析的正确性依赖这套校正:不校正会把锥效应误读成跨模态对齐。理解它才能判断'文本/图像向量方向相似'的结论是否可靠。
研究动机
现有工作把语言模型转向与图像生成转向当成两个几乎不交流的独立领域:LLM 侧用对比提示对提取方向(情绪、拒绝等),图像侧则在扩散模型潜空间中做无监督分解或训练轻量适配器,且视觉侧的极简图像对远比极简文本对难策展。更关键的是,关于多模态模型内部是否统一的证据偏向悲观:Serra 等发现文本与图像 token 表征在各层几乎正交;Gao 等发现文本侧做的知识编辑基本不会体现在生成的图像里;Nikankin 等发现多模态 LLM 中同一任务的文本/图像电路往往分离。与此最接近的先例(Wang & Li, 2026)在 BAGEL 上研究跨模态转向,报告了强烈的不对称性——文本向量能转向图像生成,图像向量几乎不能转向文本——但 BAGEL 的语言与图像生成权重本身是分离的,结论能否推广到真正权重共享的统一模型存疑。也就是说,'共享参数是否意味着共享控制机制'此前没有在严格统一的模型上做过双向检验。
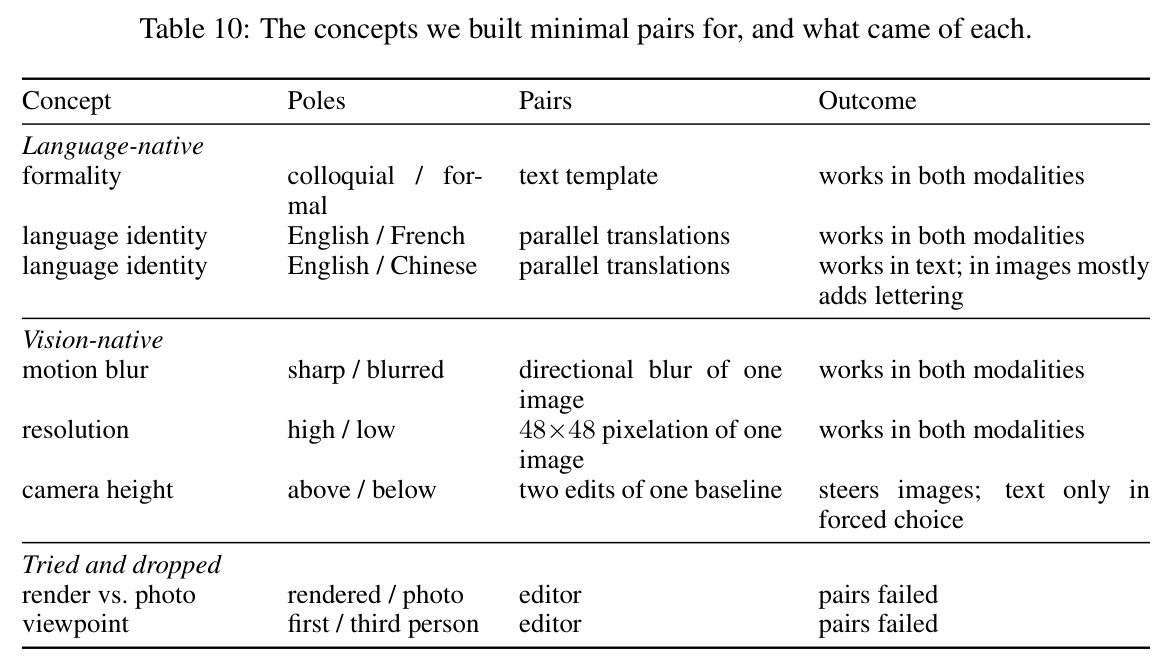
本文的目标是本文把'概念是否跨模态统一'这个大问题操作化为一个可测量的问题:在一个模态 token 上提取的转向向量,能否零样本(不做任何适配、不用目标模态数据)控制另一个模态的生成?具体目标有四:其一,在三个权重共享的自回归 UMM(UniAR 8B、Emu3.5 34B、Liquid 7B)上,对 8 个概念系统测量 txt→img 与 img→txt 双向迁移效果,并以模态内转向(txt→txt、img→img)为参照计算恢复率;其二,刻画迁移的层次规律(早/中/晚层)与概念差异(情绪、年龄、清洁度、大小、深度、空间、颜色);其三,对'仅存在于单一模态'的概念(正式 vs 口语语言、英语 vs 法语、图像分辨率、运动模糊、相机高度)做定性研究,看向量在另一模态会表达成什么;其四,从几何上检验文本向量与图像向量是否方向相近、这种相近能否预测迁移成功率,为'统一模型内部如何桥接视觉与语言'提供因果证据。
与已有工作不同的是,本文的独特切入有三点。第一,用因果干预取代相关性对齐:以往关于模态统一的研究多看表征相似度(余弦、正交性),只能证明表征相关;而转向是'加上向量就改变输出'的因果操作,能证明一条方向真正调制概念。第二,选对了试验台:主流图文范式(CLIP、扩散模型、视觉语言模型)中图文要么分开建模、要么图像只是条件输入,无法把同一向量加到'图像 token 的中间状态'上;作者特意挑选文本与图像 token 走同一自回归骨干、共享生成权重的 UMM。第三,双向测量加'单模态独有概念'探针:先例只报告 txt→img 单向成功,本文补齐 img→txt 并发现双向皆可;同时用正式度、语言身份、分辨率这类在另一模态难以定义的概念做定性实验——例如'低分辨率'向量让文本变短、出现 blurry 和不确定表达,给出模型如何把语言属性翻译成视觉风格的直接窗口。
核心方法
直觉上,如果统一模型内部存在跨模态共享的概念方向,那么在一个模态测得的概念轴加到另一模态的隐藏状态上,应引起一致的行为偏移。技术上,作者为每个概念、每个模态构造 $N=100$ 个最小对比对,把两份激活差的均值归一化为单位向量 $v_\ell=\frac{1}{N}\sum_i(h_{i,\ell}^+-h_{i,\ell}^-)$、$\hat v_\ell=v_\ell/\|v_\ell\|$;生成时在选定的连续层区间上执行 $h'_\ell=h_\ell+\alpha\hat v_\ell$,对图像 token 与文本 token 的干预方式完全相同。实验设计成 2×2 四种设定:txt→txt、img→img 为模态内参照,txt→img、img→txt 为跨模态迁移。评估用每概念 20 条中性提示,让 Gemini 3.7 Flash 裁判在 steered 与未 steered 输出间盲选哪个更偏向目标极性(询问极性与展示顺序均随机),得到概念率曲线,再对强度 $\alpha$ 取归一化 AUC,最后以恢复率(迁移 AUC / 模态内 AUC)作为迁移质量的核心指标。
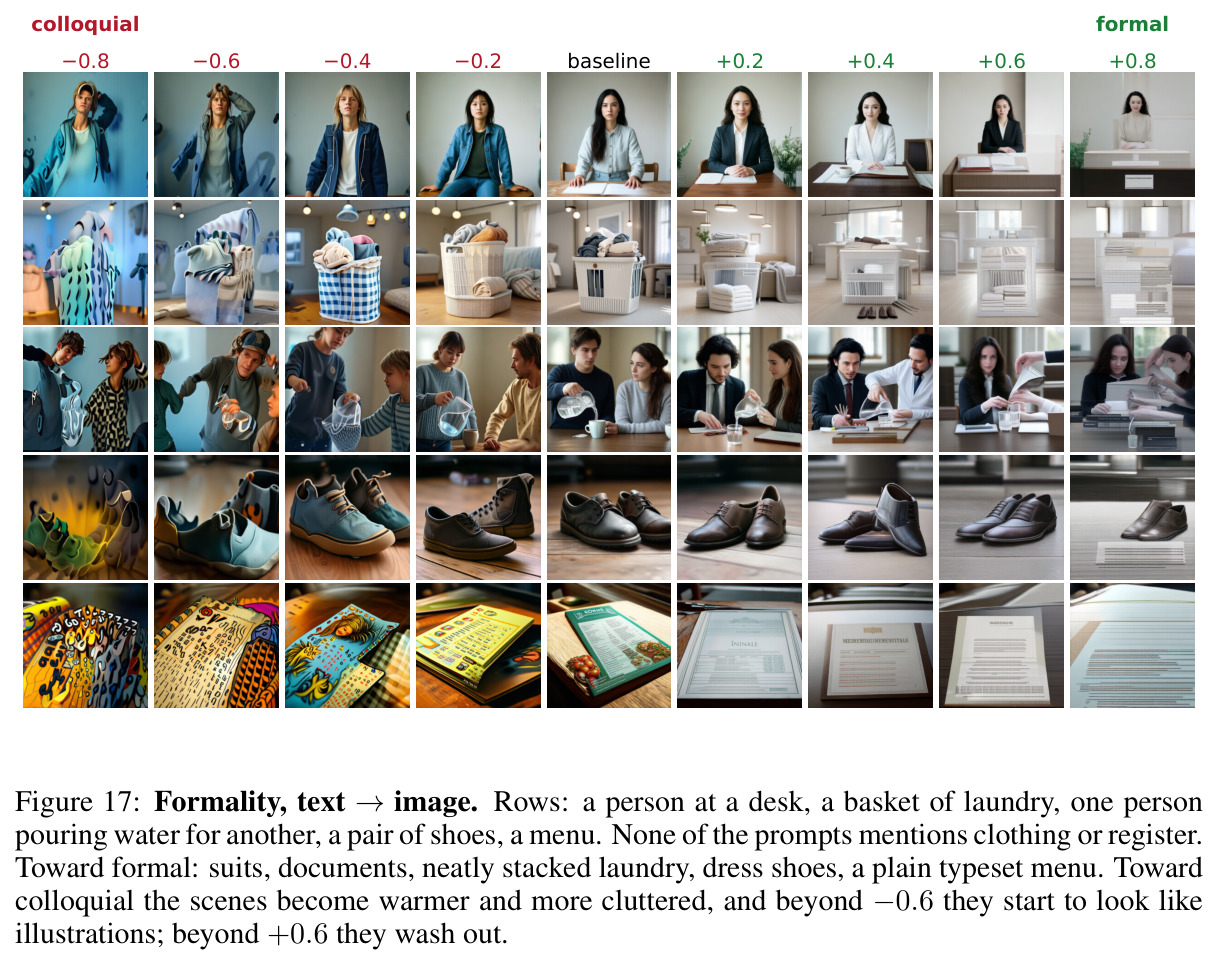
核心创新是'跨模态零样本转向'这一操作本身:从文本构建的向量不经任何改动直接加到图像 token 上(反之亦然),这与以往所有在单模态内做转向的工作有本质区别——它把'模态是否统一'从相关性问题升级为因果问题,成功迁移意味着存在一条跨模态共享的控制方向,即使文本与图像表征占据分离的子空间。第二个关键设计是利用两种模态数据构造难度的不对称:文本最小对可用模板 'a {subject} is {pole}' 自动批量生成,图像最小对需要先生成基线图再用指令编辑模型分别向两极编辑(尺寸、深度、空间等困难概念还要换用 Gemini 3 Pro Image 和 Reve)。既然 txt→img 迁移有效,就可以在容易的模态造向量、在困难的模态使用——例如用纯文本对造'正式度'向量去控制画面里人物的着装与场景的视觉风格,这正是 Figure 1 展示的标志性用法。
方法步骤详情
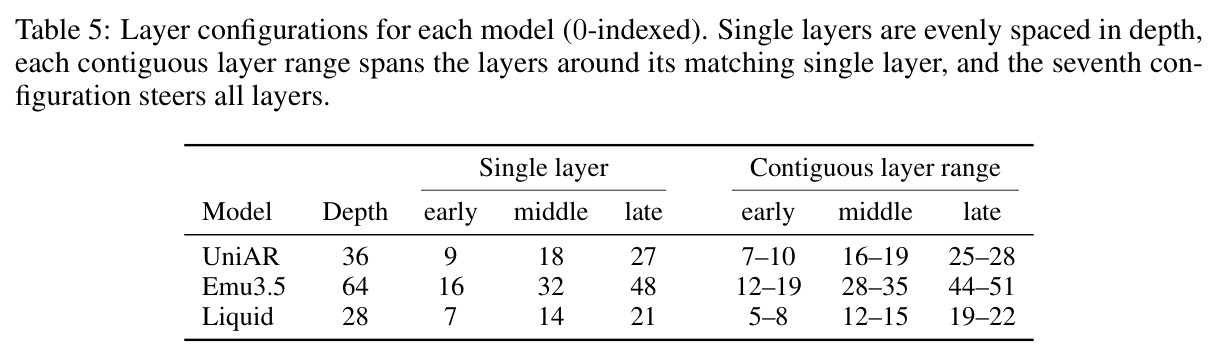
第一步,构造最小对:文本用 Gemini 2.5 Flash 生成 100 个主语填入模板,属性词置于句末(如 'a chef is happy'/'a chef is sad';语言身份概念改用 100 对平行翻译并 mean-pool);图像先用 Gemini 2.5 Flash 写 100 条场景描述并生成基线图,再用指令式编辑模型向两极编辑(提示词要求保持主体、姿态、构图、背景),失败率低于 5% 的编辑用修订指令或更强模型重做。第二步,提取向量:文本取末 token 的隐藏态作为 $h$,图像对所有 $M$ 个图像 token 做均值池化 $h=\frac{1}{M}\sum_j h_j$,逐层计算均值差并归一化到单位长度。第三步,施加转向:在早/中/晚三个连续层区间(每段 4 层,Emu3.5 深度约两倍故 8 层,如 UniAR 36 层中的 7–10、16–19、25–28)对所有生成 token(文本设定还包括提示中的主体短语)加 $\alpha\hat v_\ell$;每模型每设定各自扫描 $\alpha$ 网格($\alpha=0$ 两侧各 5 个等距值,最大值处输出退化为乱码或破碎图像)。第四步,生成评测样本:每概念 20 条中性场景描述,图像直接用描述,文本用 'Describe your day in the city. Your description must include {subject}.' 之类的开放式指令。第五步,自动评估:裁判盲选得概念率 $CR_{c,\alpha}=\frac{1}{|\mathcal{P}|}\sum_p J(x_p,\tilde x_{c,\alpha,p})$($|\mathcal{P}|=20$),对 $\alpha$ 取归一化 $AUC_c\in[0,1]$。第六步,计算恢复率 $\mathrm{Rec}_{img}=\mathrm{AUC}(\text{txt→img})/\mathrm{AUC}(\text{img→img})$、$\mathrm{Rec}_{txt}=\mathrm{AUC}(\text{img→txt})/\mathrm{AUC}(\text{txt→txt})$;裁判与三人多数投票在 320 个 held-out 样本对上的一致性为 Cohen's κ=0.62。第七步,几何分析:对每层单位向量计算 $\cos(\hat v_{txt},\hat v_{img})$,与随机基线 $1/\sqrt d$ 比较;质心比较前做单位长度归一与中点中心化以排除各向异性伪影。
技术新颖性
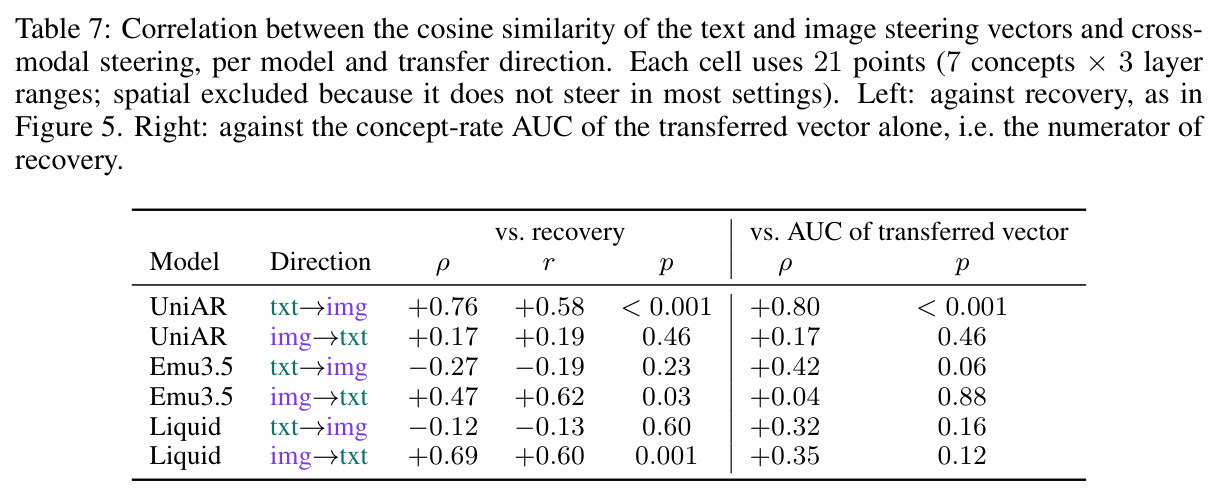
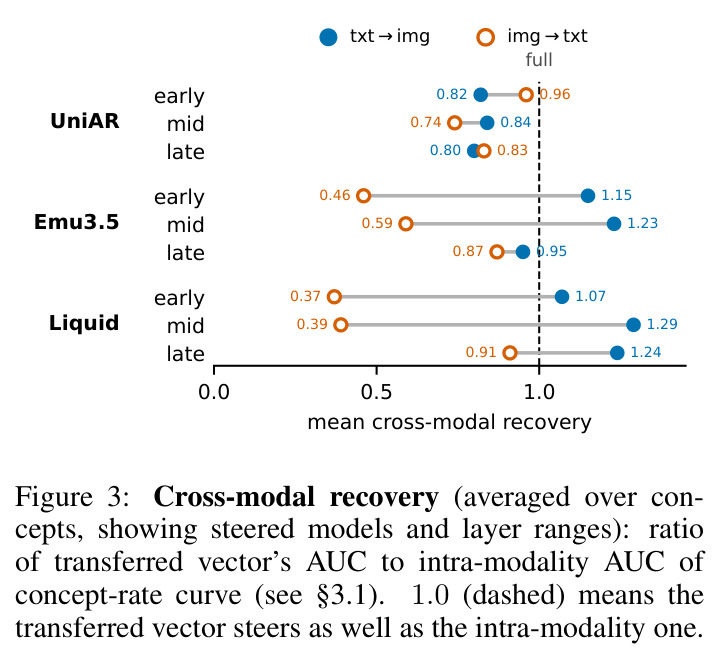
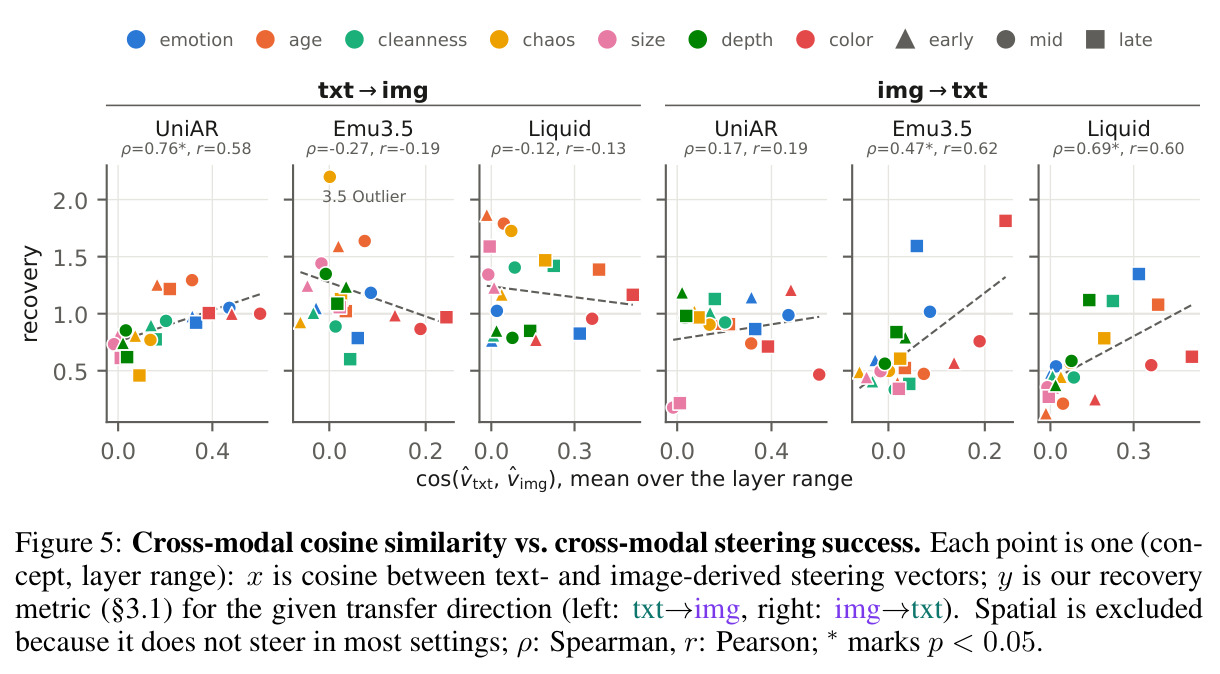
技术新颖性有四个层面。其一,双向零样本迁移是首次在权重共享 UMM 上系统证明:最接近的 Wang & Li (2026) 只在生成权重分离的 BAGEL 上报告 txt→img 单向迁移,本文在三个模型上同时验证两个方向,且 img→txt 在合适的层(UniAR 早期层、Emu3.5/Liquid 晚期层)可达 0.87–0.96 恢复率,推翻了'图像向量无法转向文本'的不对称结论。其二,视觉转向的对比数据配方:用指令式图像编辑模型批量构造极简图像对,绕开'极简图像对难策展'的老问题,并人工质检(失败编辑 <5%)。其三,'单模态独有概念'的跨模态表达分析是全新的定性贡献:正式度向量让画面出现西装、黑白配色与极简奢华设计;英法语言向量让建筑出现曼萨德屋顶、新艺术风格海报与法式但不存在的人造文字;分辨率向量让文本变短、出现 blurry 和不确定表达——说明模型内部存在连接语言属性与视觉风格的桥梁。其四,几何发现:尽管存在模态间隙(UniAR 中 happy 图像质心到 sad 图像质心的距离仅为到 happy 文本质心的约 1/53),8 个概念中 5 个的跨模态向量余弦(0.14–0.60)远超随机基线 ±0.03,且余弦相似度与迁移成功率总体相关(Spearman ρ=0.38,p<0.01;UniAR txt→img 方向 ρ=0.76),支持'分离子空间但内部结构相似'的解释,与 Platonic Representation Hypothesis 形成呼应。
实验结果
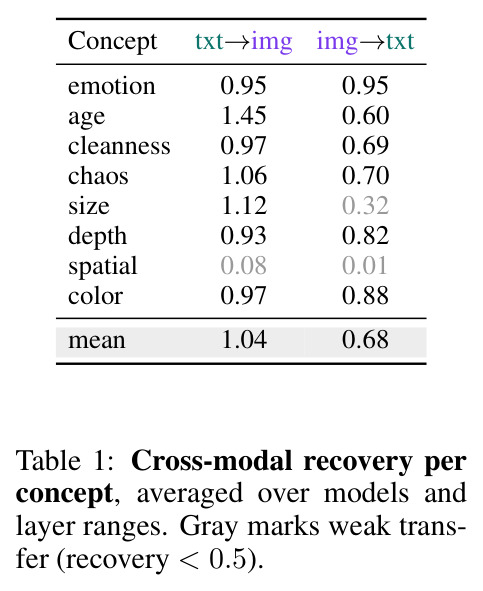
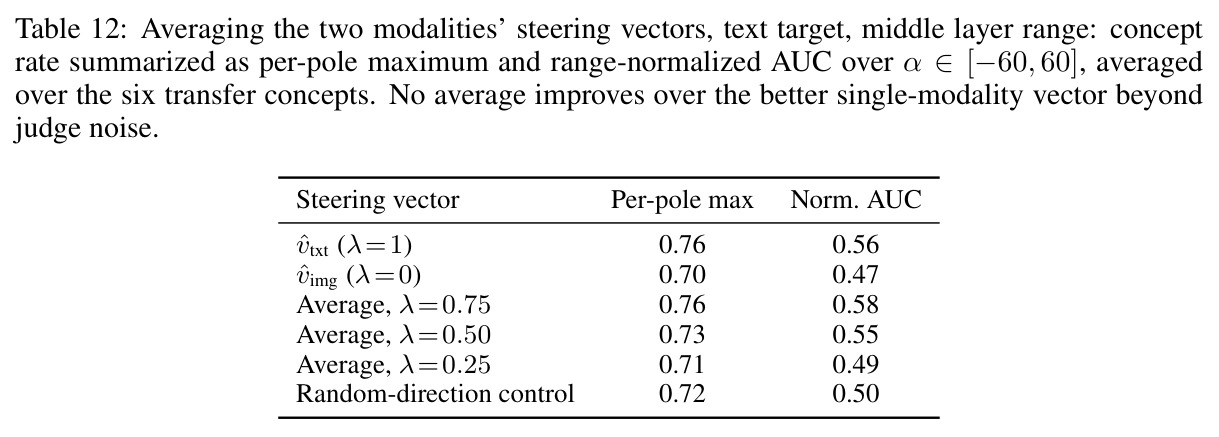
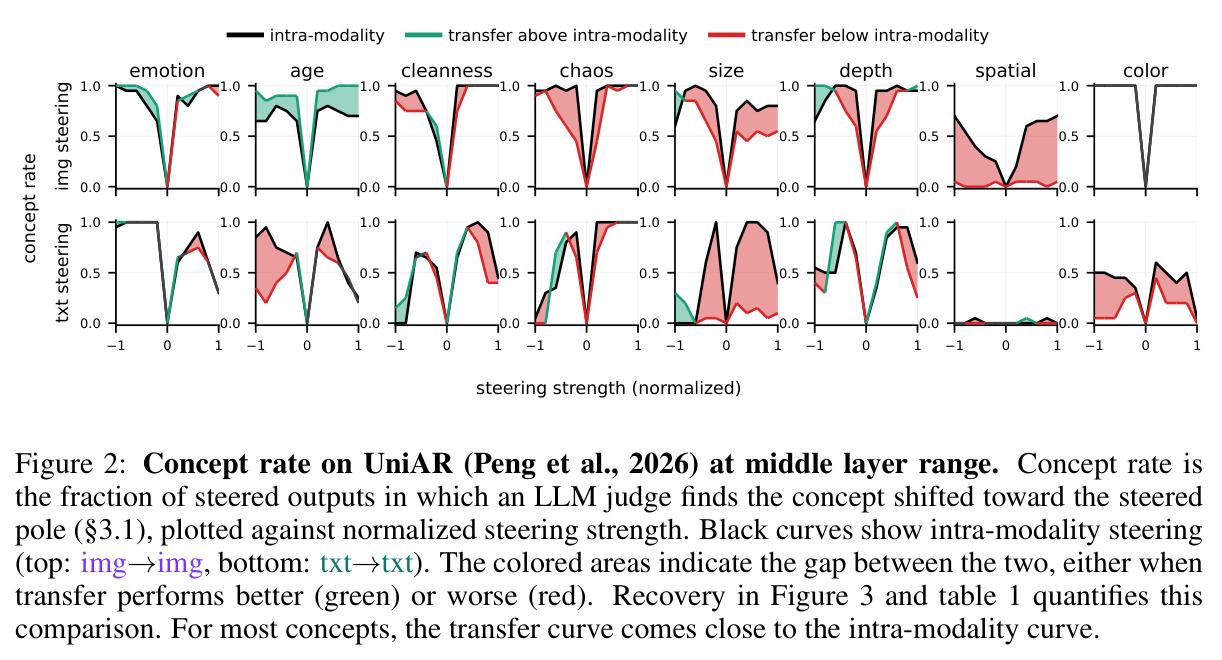
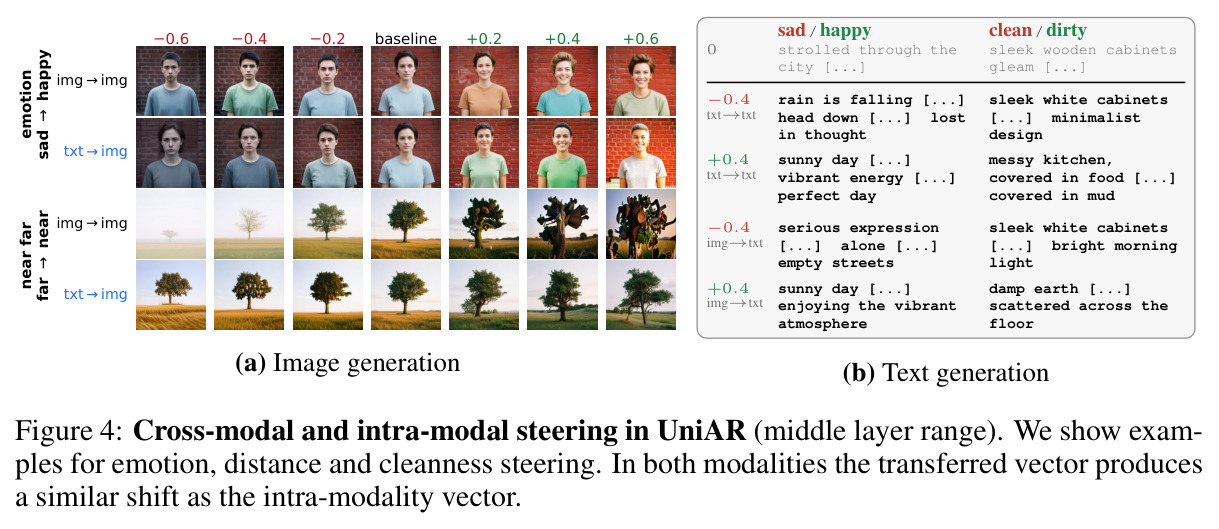
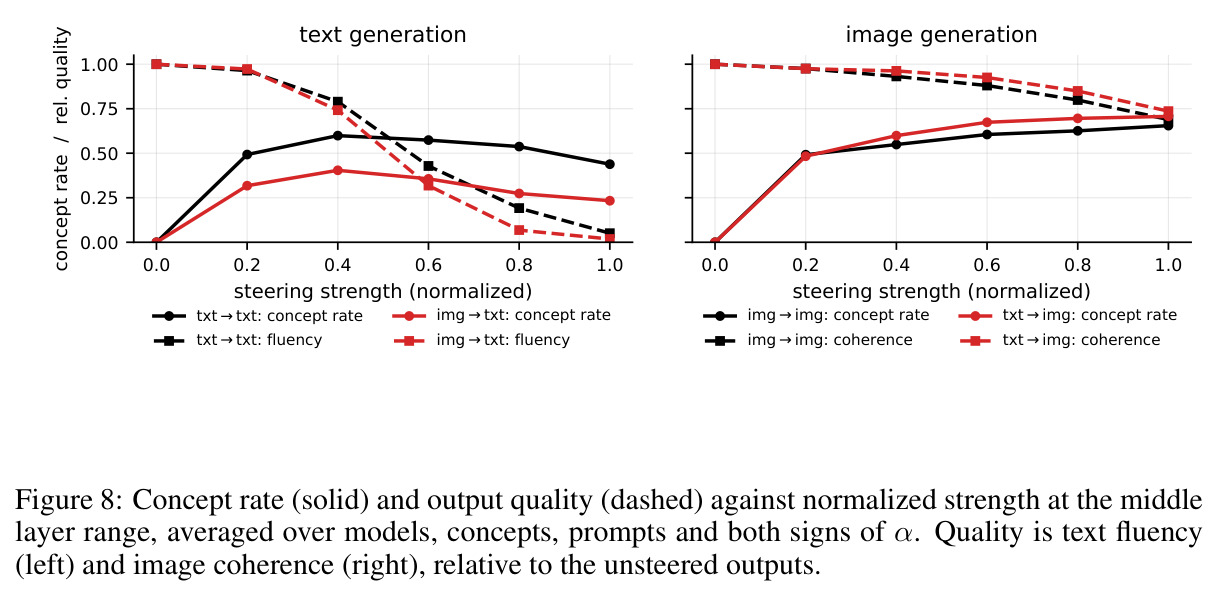
发现一:转向向量双向迁移。UniAR 中间层的迁移向量平均恢复模态内转向效果的 84%(转向图像)与 74%(转向文本);除 spatial 外,每个概念在三个模型中都存在某个层段使文本向量恢复超过 80% 的模态内效果。在 Emu3.5 与 Liquid 上 txt→img 平均恢复率甚至达 1.10 和 1.20(>1,文本向量比'原生'图像向量更能转向图像);作者假设主因是这两个模型的图像向量本身较弱(中间层 img→img AUC 仅 0.44 与 0.43,UniAR 为 0.83)。img→txt 方向:UniAR 最佳层段恢复 0.96,Emu3.5 与 Liquid 在晚期层分别达 0.87 与 0.91。发现二:层次规律——txt→img 在三个模型的中层最强;img→txt 在 UniAR 峰值于早期层、在 Emu3.5/Liquid 峰值于晚期层。发现三:概念差异(Table 1,模型与层平均)——情绪最均衡(双向均 0.95);年龄转向图像最强(各模型与层段 1.02–1.87);尺寸 txt→img 均值 1.12 但 img→txt 仅 0.32;唯一几乎全面失败的是空间左/右(如 Emu3.5 早层 0.08/0.01),仅在 UniAR 的 img→img 有中等效果;总体均值 txt→img 约 1.04、img→txt 约 0.68。发现四:质量代价可控——文本流畅度在强度 0.4(概念率峰值处)仍约为未转向水平的 75%,之后崩溃;图像连贯性在强度 0.6(概念率已超峰值 90%)仍保持约 90%。发现五:几何签名——余弦相似度与迁移成功总体 Spearman ρ=0.38(p<0.01,n=63),UniAR txt→img 达 ρ=0.76(对迁移向量自身 AUC 更是 ρ=0.80);中心化后 UniAR 中 happy 图像质心距 sad 图像质心比距 happy 文本质心近 53 倍(各概念 6–210 倍),证明模态间隙真实存在而差分方向结构对齐。另有负结果:两模态向量的加权平均 $\hat v^{(\lambda)}=\mathrm{normalize}(\lambda\hat v_{txt}+(1-\lambda)\hat v_{img})$ 不带来超过裁判噪声的提升(最优平均与纯文本向量 per-pole max 打平 0.76,归一化 AUC 0.58 vs 0.56,随机方向对照 0.72/0.50)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨模态转向图像生成(txt→img,UniAR 中间层,8 概念平均) | 跨模态恢复率(迁移 AUC / img→img AUC) | 0.84 | img→img 模态内转向(恢复率定义为 1.0) | 恢复 84% 的模态内转向效果,接近原生向量 |
| 跨模态转向图像生成(txt→img,Emu3.5) | 平均恢复率 | 1.10 | img→img 模态内转向(中间层 AUC 仅 0.44) | 超过模态内向量 10%:文本向量反而更好 |
| 跨模态转向图像生成(txt→img,Liquid) | 平均恢复率 | 1.20 | img→img 模态内转向(中间层 AUC 仅 0.43) | 超过模态内向量 20% |
| 跨模态转向文本生成(img→txt) | 最佳层段平均恢复率(相对 txt→txt) | UniAR 0.96(早期层);Emu3.5 0.87、Liquid 0.91(晚期层) | txt→txt 模态内转向 | 推翻先前'图像向量难以转向文本'的单向不对称结论 |
| 分概念迁移(Table 1,模型与层平均) | 平均恢复率(txt→img / img→txt) | 情绪 0.95/0.95,年龄 1.45/0.60,尺寸 1.12/0.32,空间最低(近乎 0),总体 1.04/0.68 | 模态内转向 | 情绪最均衡;空间左/右是唯一系统性失败的概念 |
| 评估裁判质量验证 | 与人类标注多数投票的 Cohen's κ(320 个 held-out 样本对,每对 3 人) | 0.62 | — | 达到 substantial 一致性,自动评估可信 |
局限与改进
作者承认与本文观察到的局限如下。第一,模型覆盖有限:只有三个自回归 UMM,未含生成权重分离的 BAGEL/Janus 类模型,也未测扩散式统一架构;且 UniAR(语义图像 token)与 Emu3.5/Liquid(像素重建 token)行为差异明显,说明结论对图像 tokenizer 的选择敏感,作者只做了推测未验证。第二,概念覆盖有限:8 个双模态概念加 5 个单模态概念;空间左/右几乎全面失败但原因未深究;两个候选概念(渲染 vs 照片、第一/第三人称视角)因图像编辑器无法生成可用最小对而放弃(12 对中仅 1 对可用),说明方法受编辑模型能力约束。第三,评估依赖 LLM 裁判:κ=0.62 只是基本一致,概念率是二值盲选,可能低估细微效果(如相机高度向量只改变下一 token 分布而不改变预测 token,这类'亚阈值'效应会被漏掉);Emu3.5/Liquid 的情绪与空间图像向量在 split-half 检验中不稳定(余弦 0.45–0.84),部分向量本身噪声大。第四,协议上每个设定有自己的强度网格,恢复率比较的是各自容忍范围内的 AUC,不是同等 α 下的直接比较;在 img→img 较弱的模型中,>1 的恢复率部分是弱分母的产物。第五,机制层面只给出几何相关性证据,且相关性随模型与方向波动很大(Emu3.5 txt→img 甚至 ρ=-0.27),没有电路级解释。我自己的观察:概念率饱和后文本质量骤降,实际使用需逐层逐概念校准强度,文中未提供自动化方法;所有最小对与评测提示均由 Gemini 系模型生成,可能带入关联模型的风格偏置。
独立分析的弱点
弱点一:机制解释缺位。论文证明迁移存在并给出几何相关,但没有回答'为什么'——共享方向是图文配对训练数据造成的,还是语言先验注入了视觉 tokenizer?改进方向:用路径修补或跨模态注意力头消融定位携带方向的电路,系统比较语义 token 与像素重建 token 的模型。弱点二:空间概念失败无诊断。左/右在几乎所有设定失败,只用'图像生成的已知失败模式'带过。改进:分析该向量的逐层分布与注意力模式,构造更大规模的空间关系最小对,或用约束式探针(如强制选择任务)定位失败发生在哪一层。弱点三:可用强度窗口窄。文本流畅度在归一化强度 0.4 后崩溃,窗口因概念与模型而异;改进方向是学习逐层缩放系数、或用优化方法自动校准 $\alpha$(例如以保持流畅度为约束最大化概念率),替代手工网格扫描。弱点四:评估鲁棒性。二值盲选裁判把'部分表达'判为 Tie,图像连贯性只有三档;改进:引入连续评分、多人交叉验证并报告裁判校准曲线。弱点五:向量平均的负结果只在文本目标与三个 λ 值上做了浅扫描,未探索更复杂的组合(模态间正交化、联合 PCA 子空间)。弱点六:概念只有 8+5 个且集中于外观/语义属性,对抽象概念(数量、时间、因果)是否共享方向完全未知,而这恰是检验'语义枢纽'假说更关键的地方。
未来方向
作者提出的方向:把发现推广到更多统一模型家族与新概念;发展模态无关的可解释性工具与多模态交互理论;安全应用——若某个安全干预(如拒绝方向,Arditi et al. 2024)在文本上有效,理想情况下应自动迁移到视觉能力;知识编辑同样应能迁移到图像生成(呼应 Gao et al. 2026 的失败案例)。基于本文成果可延伸的:其一,把'容易模态造向量、困难模态使用'工作流系统化——用纯文本数据为图像概念(版权角色风格、暴力内容等安全属性)构建转向器,省去策展图像对的成本;其二,反向利用 img→txt 探针理解视觉 token 携带的语义,如用分辨率/运动模糊向量研究模型对细节与时间的内部编码;其三,把'分离子空间+相似内部结构'的几何发现与 Platonic Representation Hypothesis、词嵌入向量偏移规律(king-queen)连接,发展'结构对齐≠表征对齐'的形式化理论;其四,检验拒绝/越狱等安全方向的跨模态迁移是否成立,对多模态安全有直接现实意义;其五,解释 UniAR 与像素重建模型的行为差异,可能催生'为可解释性而设计 tokenizer'的思路;其六,把跨模态恢复率作为 UMM '统一程度'的量化 benchmark,用于训练监控与模型比较。
复现评估
复现条件较好。代码开源于 github.com/saintsauceee/cross-modal-steering,最小对数据、转向向量、生成结果与裁判评分托管于 huggingface.co/saintsauce;附录 A 提供几乎全部细节:每条图像编辑指令、评测提示、各模型解码设置、层与强度选择流程、裁判提示词及 320 对人工验证(κ=0.62),附录 C 给出几何分析全部细节(中心化方法、随机基线 $1/\sqrt d$、split-half 稳定性)。主要成本在于 API:Gemini 2.5 Flash(生成文本对与基线图)、Gemini 2.5 Flash Image / Gemini 3 Pro Image / Reve(图像编辑)、Gemini 3.7 Flash(裁判,需对每模型约 22,400 条文本输出加 3,200 张图像评分);本地需推理三个开源 UMM(UniAR 8B、Emu3.5 34B、Liquid 7B),34B 需较大显存或多卡,但仅为推理、无需训练。难点:$\alpha$ 网格需按模型与设定手工校准(扫描到输出退化为止);LLM 裁判的随机性与版本变化引入噪声(论文用随机极性、随机顺序与 few-shot 校准缓解)。总体难度中等:具备单机多卡 GPU 与 API 预算的研究者数周内可复现主结果;扩展到新模型/新概念需重新校准强度网格并质检最小对。
论文图表
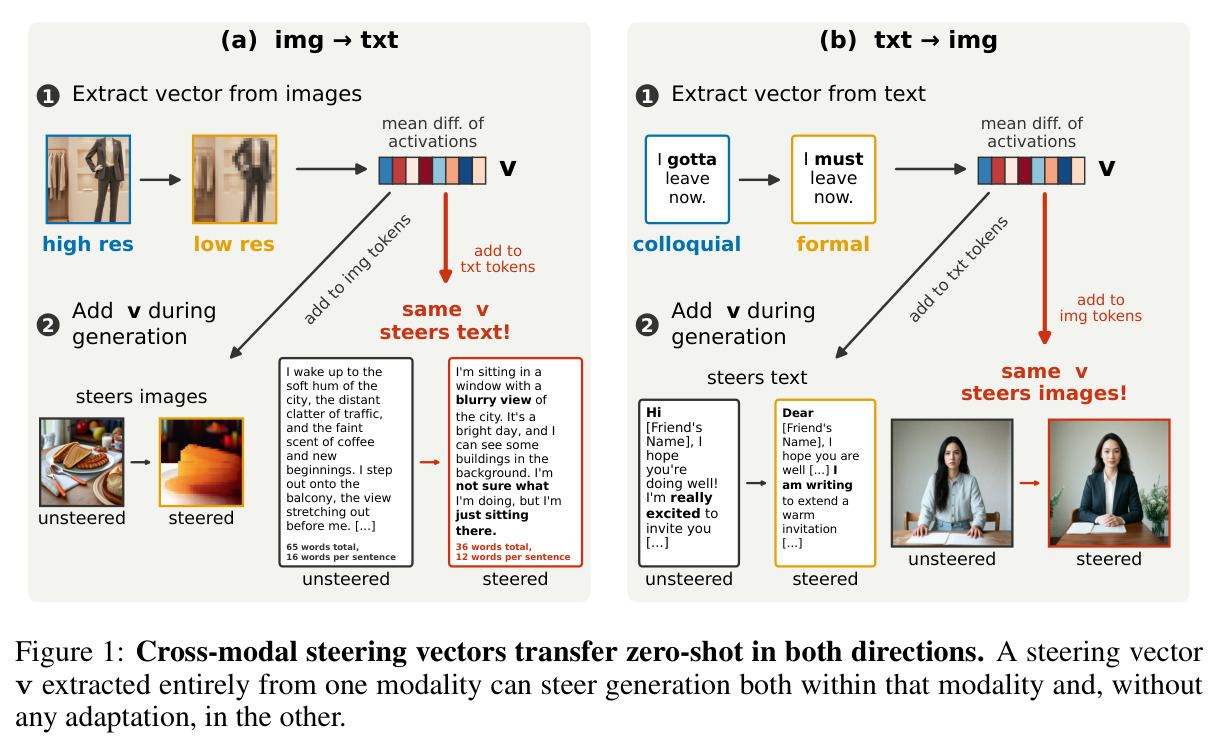
核心概念示意图,分左右两半:(a) img→txt:从高/低分辨率图像最小对提取向量 $\hat v$,加到文本生成过程,使模型写出更短(65 词→36 词)、提及 blurry、甚至表达不确定的文本;(b) txt→img:从口语 'I gotta go now' 与正式 'I must leave now' 的文本对提取向量,加到图像生成,使信件/邀请函的画面从随手的 'Hi' 变成正式的 'Dear' 风格。每半上方是均值差提取流程,下方是 unsteered 与 steered 输出对比。
这是论文核心操作的定义图:'在一个模态提取、零样本作用于另一个模态',并用两个单模态独有概念(分辨率、正式度)给出最直观的例子,看完此图就理解了全文在做什么。