揭示原生统一多模态模型中理解与生成的协同效应:从表示、任务到系统 Uncovering Understanding-Generation Synergy in Native Unified Multimodal Models: From Representation, Task to System
在无视觉先验的受控原生设置下,从表示、任务、系统三层次揭示理解与生成何时协同、何时冲突
前置知识
统一多模态模型 (UMM)
在单一模型内同时完成视觉理解(看图回答、推理)与图像生成(文生图、图像编辑)的多模态模型,文本与图像可以在同一序列中交错输入输出,代表工作包括 Chameleon、Show-o、Transfusion、Janus、BLIP3-o 等。
本文的研究对象就是 UMM:它要回答的核心问题是——把理解和生成塞进同一个模型,究竟是1+1>2(协同)、互相拖累(竞争),还是仅仅是共用一个接口(共存)。
流匹配 (Flow Matching)
一种连续型生成范式:模型学习一个速度场 $v_\theta(x_t, t)$,把高斯噪声沿概率流 ODE 输运到数据分布,训练目标通常是回归速度的 MSE 损失。相比离散 token 建模,它直接在连续像素特征上去噪,是当前 AR 文本 + 扩散/流图像统一模型的主流选择。
本文采用'因果注意力建模文本 + 图像内部双向注意力做流匹配'的混合公式,理解其损失构成(交叉熵 : MSE = $0.1:1$)和生成 token 加噪的机制,是读懂架构对比和实验设置的前提。
Mixture-of-Transformers (MoT) 与 token 路由
一种解耦架构:不同模态的 token 被路由到不同的参数分支(各自的 QKV/MLP),但共享全局注意力,使模态间仍能互相看见。'路由策略'决定了哪些 token 共享参数、哪些 token 各走各路。
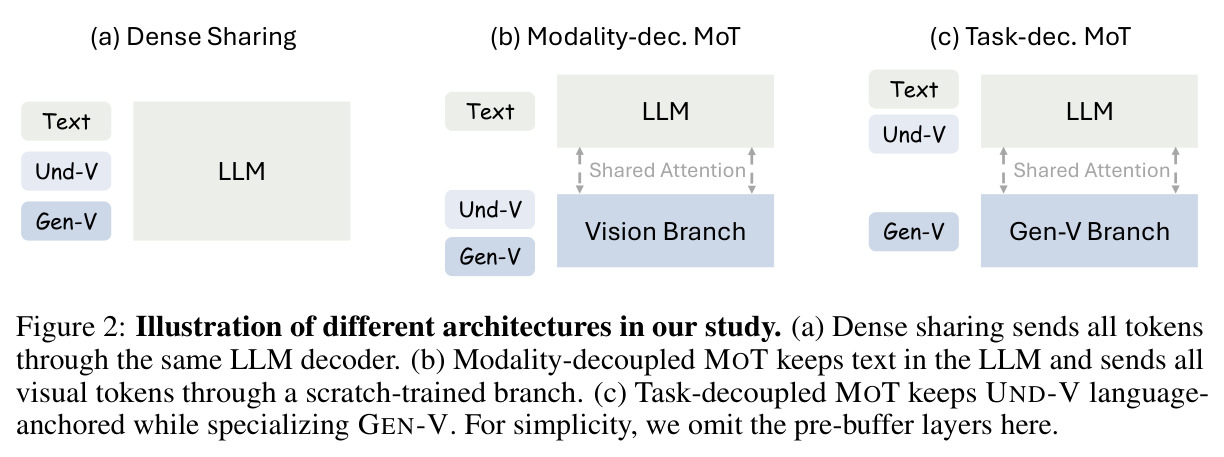
本文三种被比较的架构(dense 共享、模态解耦 MoT、任务解耦 MoT)本质上就是三种不同的路由方案,'路由'是全文最核心的自变量。
线性探针与 CKA
线性探针:冻结骨干网络,只在抽取的特征上训练一个线性头(分类/分割/深度),以检验特征中包含多少可分信息。CKA(Centered Kernel Alignment):度量两组神经网络表征相似度的指标,常用于比较不同模型或不同训练条件下特征空间的几何关系。
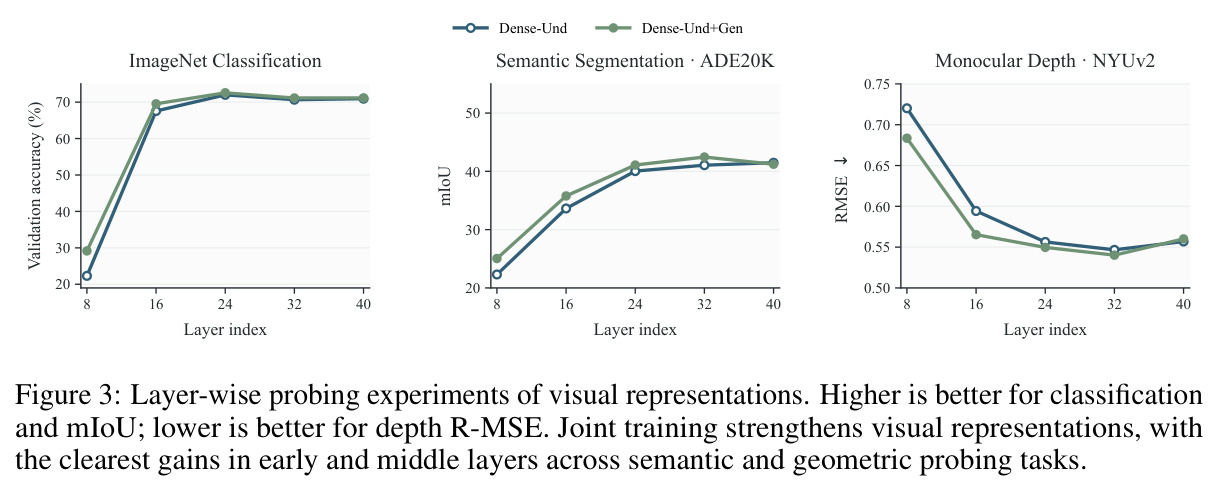
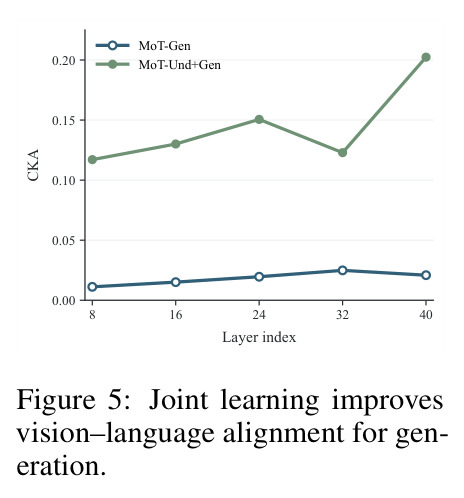
表示层的核心结论('生成丰富理解特征、理解增强视觉-语言对齐')几乎完全建立在 ImageNet/ADE20K/NYUv2 探针(Figure 3)和 COCO 文本-图像 CKA 分析(Figure 5)之上,不懂这两个工具就看不懂证据链。
Pixel-in Pixel-out 原生接口
指图像以原始像素 patch 直接进入模型(不经预训练视觉编码器如 CLIP ViT),图像也直接在像素空间生成(不经 VAE 或离散图像 tokenizer)。'原生'强调视觉信息进出模型都不引入外部模型学到的视觉先验。
这是本文'受控实验'的关键设计:如果用预训练编码器,理解能力的变化可能来自编码器本身而非联合训练,会污染结论。理解这一点才能明白论文为何坚持这一设置以及结论的适用边界。
研究动机
统一多模态模型(UMM)近年来发展迅速,Chameleon、Show-o、Transfusion、Janus、BLIP3-o 等系统已经证明:可以在一个模型内以交错方式消费和产出文本与图像,从而支持'边推理边画图'、迭代修改图像等传统单能力模型难以实现的交互形式。然而,作者指出一个被行业叙事掩盖的基本事实:功能上的统一并不保证学习上的协同——两个训练目标可能互相强化,可能争夺表示与计算容量,也可能只是毫无迁移地共存。更麻烦的是,现有证据是相互矛盾的:以 Janus 为代表的工作报告两目标存在实质性干扰,并据此主张显式解耦视觉通路;而 RecA、UNO 等工作又通过把理解信号注入生成表征取得了提升。这些研究观察到的效应往往与专用模块、辅助损失、任务特定构造或更换预训练视觉组件纠缠在一起——例如带预训练 ViT 的模型,其理解能力的涨落可能完全来自编码器而与联合训练无关——导致'理解与生成的内在关系'始终无法被干净地隔离,UMM 的根本问题悬而未决:什么时候、为什么视觉理解与生成会互相帮助,什么时候统一反而制造干扰。
本文的目标是本文的目标是在受控条件下系统回答上述问题,并把答案分解到三个逐渐放大的层次上。表示层:联合训练如何塑造视觉表示本身?参数共享与路由策略如何决定两个目标是彼此迁移还是互相干扰?任务层:当一组理解任务与生成任务依赖相同的领域知识或底层能力时(如几何解题 vs 几何作图、读 SVG vs 画 SVG、3D 问答 vs 3D 视角合成),一个方向的监督能否切实提升另一个方向?系统层:对那些天然同时需要理解与生成的复杂任务(如需要先看懂原图、再推理出编辑意图、最后生成新图的推理密集图像编辑),端到端的 UMM 是否优于把两个独立模型串成的 planner-executor 流水线?最终目的是产出对 UMM 架构设计者可操作的准则:什么时候应该让两种能力专门化各自的计算路径,什么时候应该统一训练与推理。
与已有工作不同的是,本文的独特切入有四点。第一,pixel-in pixel-out 的原生设置:图像以 patch 直接进入模型、以流匹配直接生成,全程无预训练视觉编码器、无 VAE、无图像 tokenizer,把'外部视觉先验'这一最大混淆变量排除在外,使得观察到的表示变化只能归因于理解-生成联合训练本身。第二,匹配对照实验设计:所有模型从同一个预训练 Qwen3-1.7B 出发,UND(仅理解)、GEN(仅生成)、UND+GEN(联合)三种变体在相同数据量与训练步数下对比,保证公平。第三,三层次递进的论证结构:从特征(表示)到任务(迁移)再到系统(端到端 vs 组合),逐级放大观察尺度,这在同类研究中是首个完整覆盖。第四,也是最关键的观念转变:作者把'冲突'的根源从'目标不兼容'重新归因为'计算路径分配不当'——诊断出两目标各自携带对对方有用的信号、但被迫共用一条计算通路时一方必然主导——由此自然引出 task-decoupled 这一对症的架构设计,把'冲突还是协同'的二元争论转化为'如何设计路径'的工程问题。
核心方法
先说直觉:作者认为理解与生成的学习信号本身是互补的——生成任务迫使模型学习物体形状、部件组合、空间结构等几何-语义特征,这些正是理解所需要的;而理解任务把视觉表示锚定到语言语义上,这正是生成可控性所需要的。真正的冲突不在目标函数,而在计算路径的分配方式。技术路线上,论文以预训练 Qwen3-1.7B 为底座,叠加 16 层随机初始化的 pre-buffer 层;图像经两层卷积(patch size 32)转为 token 序列;整个多模态序列使用因果注意力,但同一图像内部 token 双向可见;位置编码采用保留二维空间结构与 LLM 位置先验的 MRoPE-I。训练目标是文本交叉熵与图像流匹配 MSE 的加权组合,损失权重 $\mathcal{L} = 0.1 \cdot \mathcal{L}_{CE} + 1.0 \cdot \mathcal{L}_{MSE}$。在此底座上系统对比三种路由架构:dense sharing(全部 token 走同一 LLM)、modality-decoupled MoT(文本走预训练分支、所有视觉 token 走从零初始化的分支)、task-decoupled MoT(理解视觉 token 留在语言分支、生成噪声 token 走专门分支)。表示层实验统一训练 210K 步、恒定学习率 $1\times10^{-4}$,累计约 78M 理解样本、159M 文生图样本、26.5M 编辑样本,联合训练中三者采样比例为 $3:6:1$。
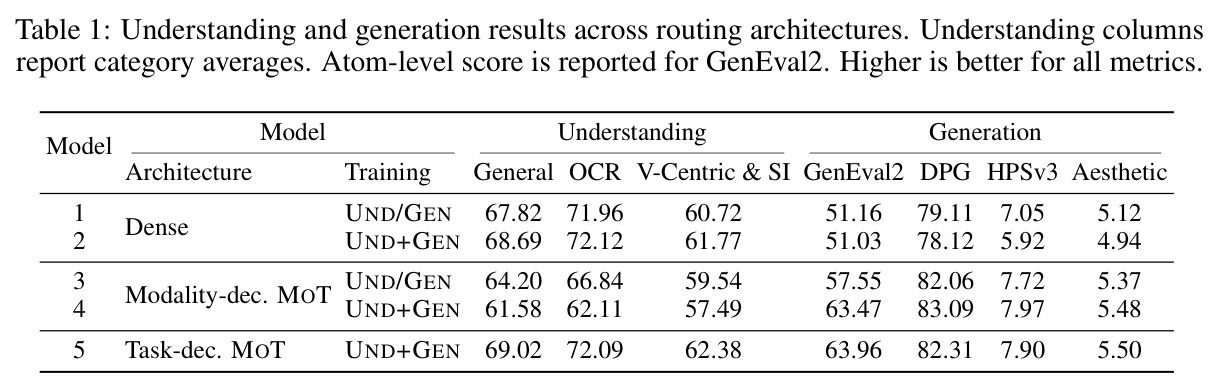
核心创新是'先诊断、后对症'的两步走。诊断部分:作者发现两种已有路由方案呈现镜像对称的失败模式。dense 共享中,预训练 LLM 充当强语义锚,理解目标主导共享特征空间,生成退化为一个正则化器——理解提升(General 组 67.82→68.69)而生成受损(HPSv3 7.05→5.92);把所有视觉 token 挪到从零训练的 modality-decoupled 分支后,不对称完全反转——生成大涨(GenEval2 57.55→63.47)而理解下滑(InfoVQA 52.65→44.59)。与此同时,探针与 CKA 分析证明两个目标其实各自携带对对方有用的信号:生成监督丰富了理解用的视觉特征(分割/深度探针更优),理解监督提高了生成表征与语言的对齐(文本-图像 CKA 更高)。问题仅仅在于两个目标被迫走同一条计算路径时,必有一方主导、另一方沦为辅助约束。对症部分:task-decoupled MoT 让理解视觉 token 保留在语言分支(保住与预训练语义的直接通路),生成噪声 token 路由到专门的生成分支(保住生成容量),两分支通过 attend 同一文本特征、以及在编辑/交错样本中生成分支对理解分支上下文图像的逐层共享注意力保持软对齐;再额外分配 20% 训练量给'以图像编辑形式表述的掩码重建任务'(上下文图随机掩码 50% token)强化连接。结果两个方向同时达到最优(General 69.02、GenEval2 63.96),证明干扰不是统一的固有属性,而是可以用'专门化+语义交互'化解的。
方法步骤详情
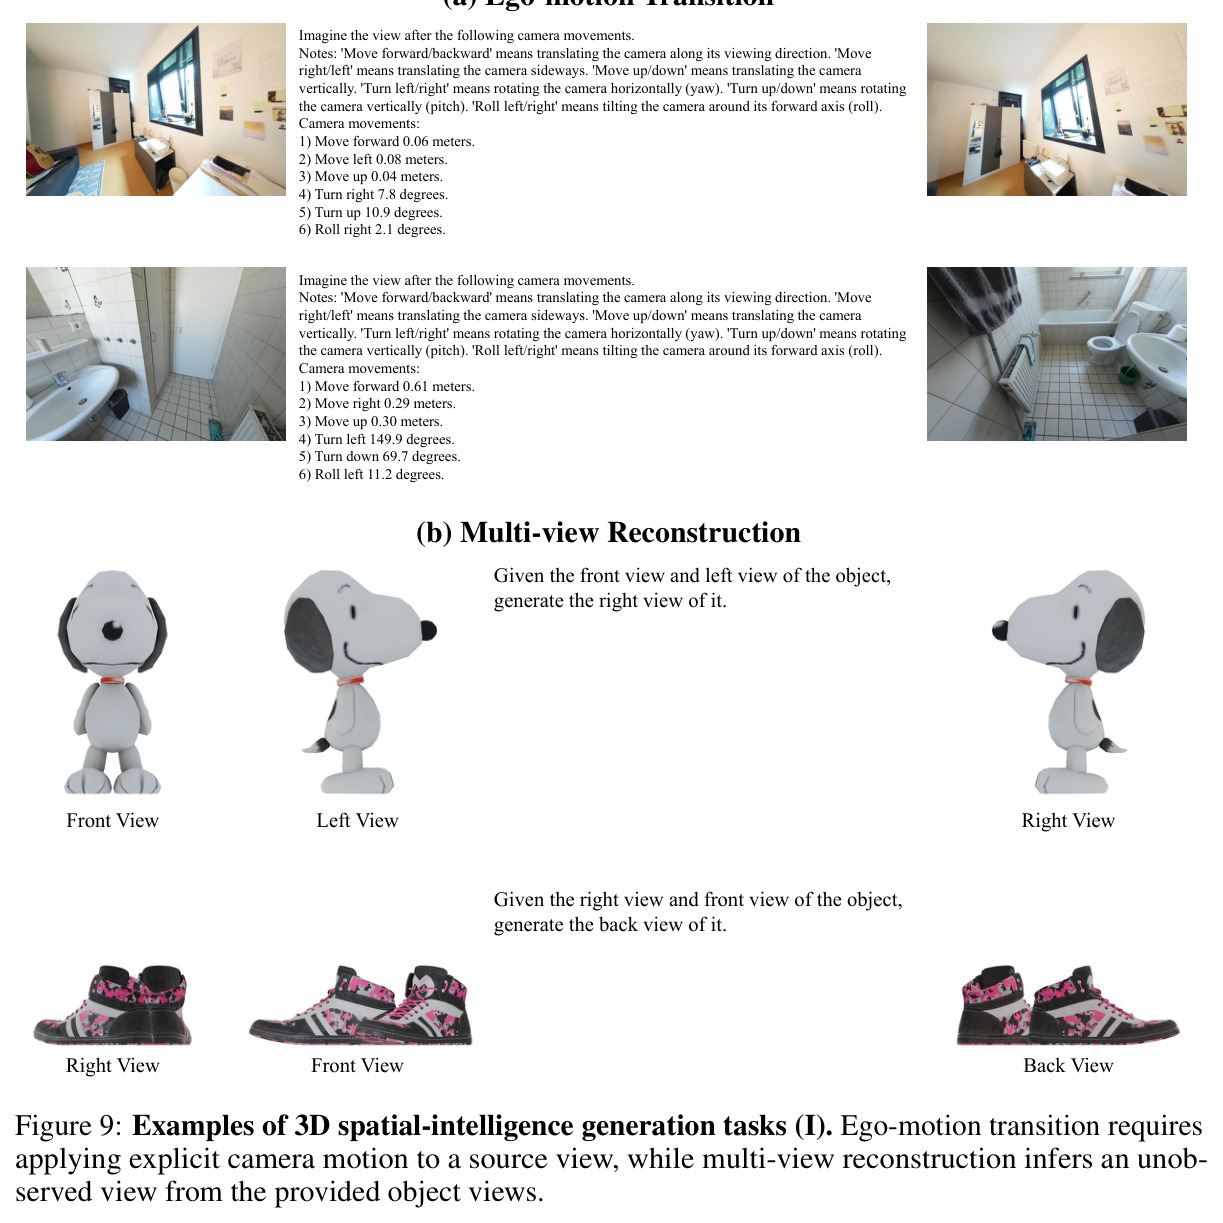
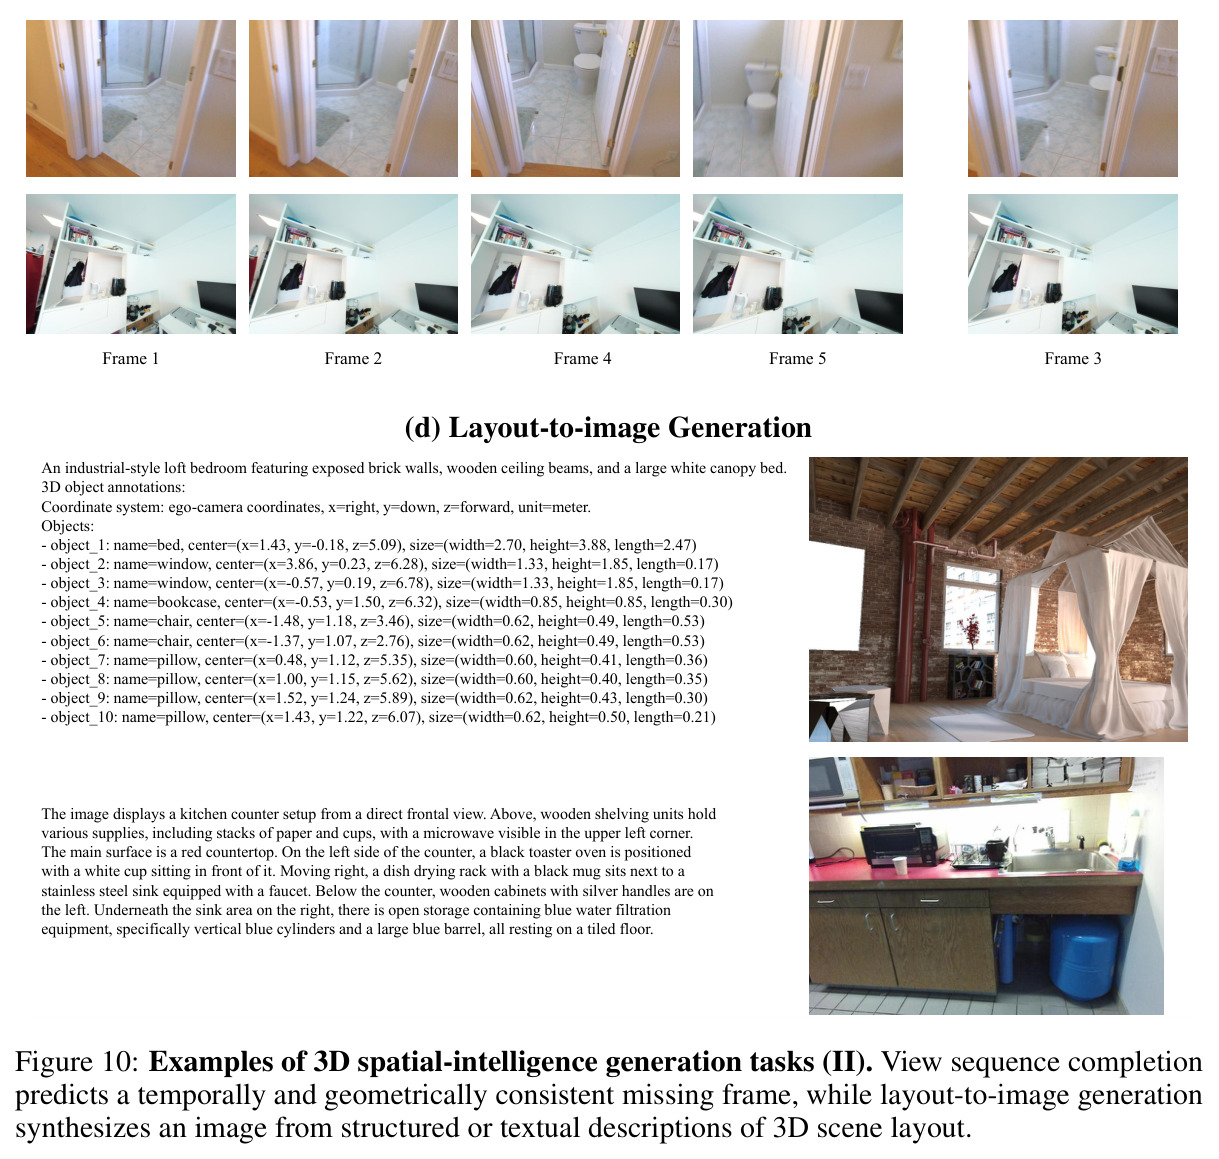
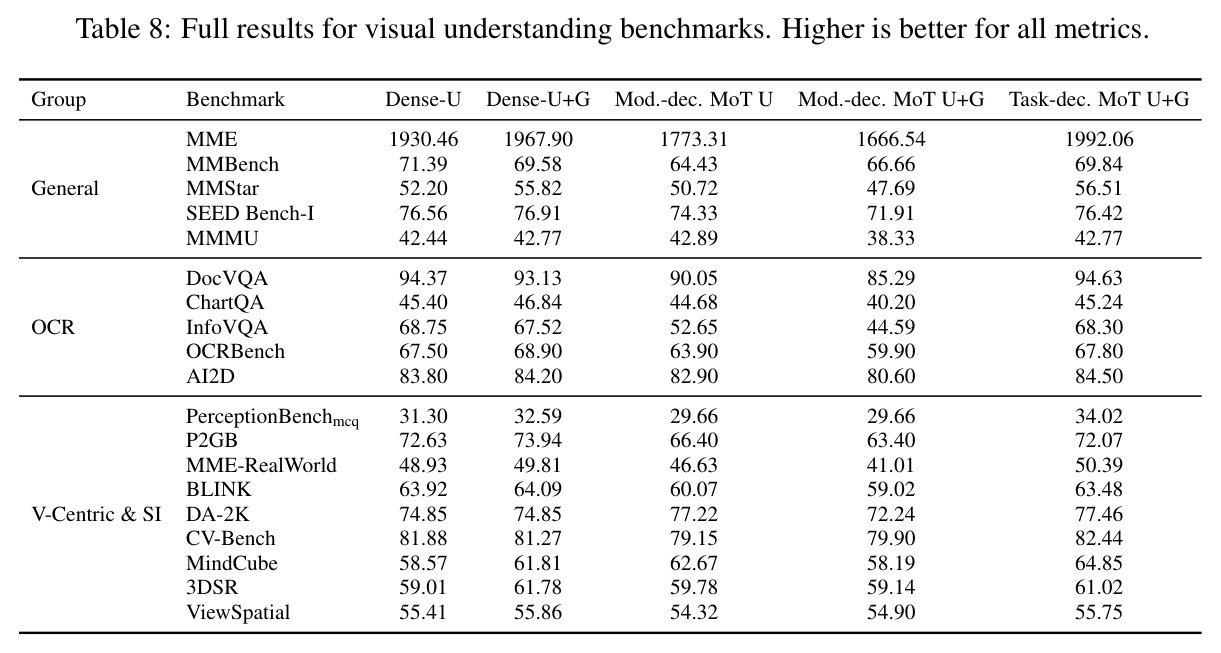
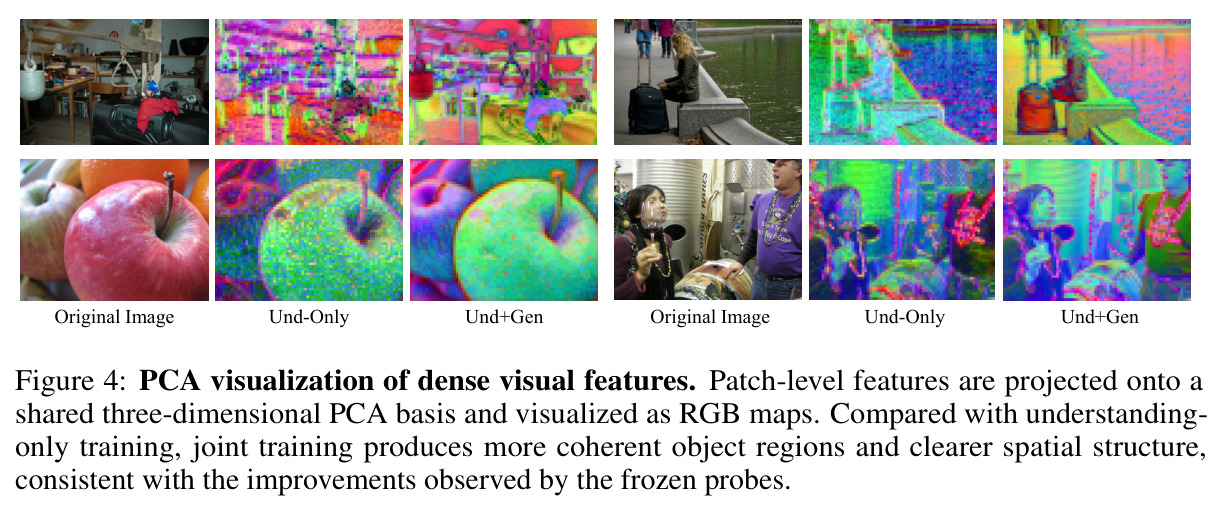
整个研究分三步递进。第一步(表示层):训练 dense、modality-dec MoT、task-dec MoT 三种架构,各配 UND、GEN、UND+GEN 变体;先在 19 个理解基准(General:MME/MMBench/MMStar/SEED/MMMU;OCR:DocVQA/ChartQA/InfoVQA/OCRBench/AI2D;视觉中心与空间智能:PerceptionBench/P2GB/BLINK/MME-RealWorld/DA-2K/CV-Bench/MindCube/3DSR/ViewSpatial)与 4 个生成指标(GenEval2、DPG-Bench、HPSv3、Aesthetic)上评测;再对冻结骨干做层级探针——ImageNet 线性分类(LARS 优化器 100 epochs)、ADE20K 语义分割与 NYUv2 单目深度(三层卷积上采样头 30 epochs)、patch 特征的 PCA 可视化,以及用 5000 对 COCO 验证集图文计算语言分支与生成分支特征的层级线性 CKA。第二步(任务层):三个案例研究,每个案例的训练混合均为 50% 通用数据 + 50% 任务数据以排除混淆。几何案例:965K 几何与数学推理理解数据,配 MATHCANVAS-IMAGEN(文生图)与 MATHCANVAS-EDIT(几何图编辑)生成数据,另设 Textual-Desc 对照——把完全相同的生成数据转写成图像描述与编辑描述的理解任务;在 Geometry3K、PGPS9K、MathVerse、MathVista 上评测。SVG 案例:UniSVG 359K 图像-SVG 对,理解方向为图像→SVG 代码,生成方向为 SVG 代码→渲染图像,并自建 1370 题的 Blind VQA 诊断(GPT-5.6-luna 标注 3000 题、经基模过滤)检验模型能否仅凭代码'心理渲染'图像。3D 空间智能案例:理解侧为单图/多图/视频 3D VQA 混合;生成侧四个任务——Ego-motion Transition(SpatialEdit-500K + 自建 1.6M ScanNet/ScanNet++ 样本)、Multi-view Reconstruction(Objaverse 248K)、View Sequence Completion(880K)、Layout-to-image(Omni3D 332K);理解评 9 个基准,生成评 SpatialEdit 的视角误差 VE/构图误差 FE 与 VSC 的 PSNR/SSIM/LPIPS。第三步(系统层):从同一 task-dec MOT checkpoint 出发,把同一批推理编辑数据转成三种训练格式分别训练——端到端(看图+隐式指令→推理→显式编辑指令→生成)、仅规划(只输出显式指令)、仅执行(按给定指令生成);推理时将规划器与执行器组合成 agentic 流水线,与端到端模型在 RISEBench 与 KRIS-Bench 上对比。
技术新颖性
这篇论文的新颖性不在单个技术组件——MoT、流匹配、线性探针、CKA 都是已有工具——而在用严密的受控实证设计回答一个长期被争论的基础问题。具体新颖点有五。其一,首次在无预训练视觉先验的像素空间统一设置中隔离理解-生成交互,从而能把 Janus(干扰派)与 RecA/UNO(迁移派)的表面矛盾统一解释为'架构依赖':双方都没错,只是各自的路由不同。其二,提出'信号互补、路径冲突'的诊断框架,并用双向证据(生成→理解:分割/深度探针与 PCA;理解→生成:CKA 对齐分析)支撑,这比单纯的 benchmark 涨跌深入到表征机理层面。其三,task-decoupled MoT 是一种新的软解耦方式:不同于 Janus 式硬解耦(理解生成完全分家)也不同于 dense 全共享,它让理解 token 保持语言锚定、生成 token 获得专门参数,再通过共享注意力与 20% 掩码重建任务维持软连接,兼顾了专门化与交互。其四,系统层的 matched planner-executor 对比在相同底座、相同数据监督下进行,为'统一 vs 组合'之争提供了少见的控制变量证据。其五,Textual-Desc 对照(同样数据改用文本描述目标学习)干净地排除了'收益来自多见数据'的替代解释,证明收益确实来自生成这一学习形式本身。
实验结果
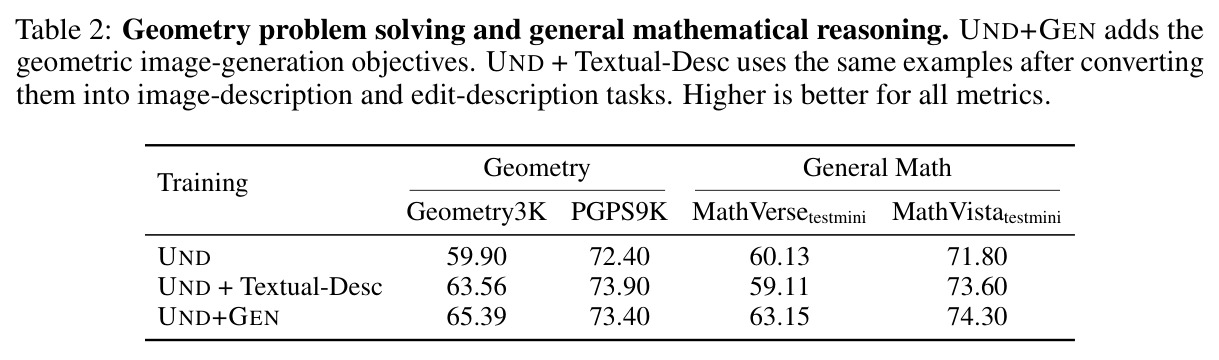
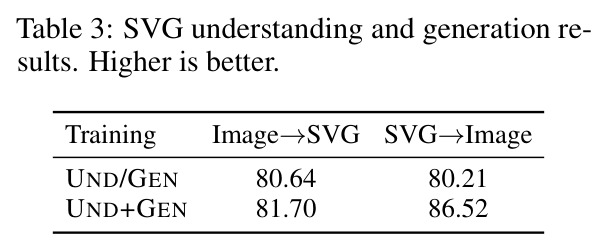
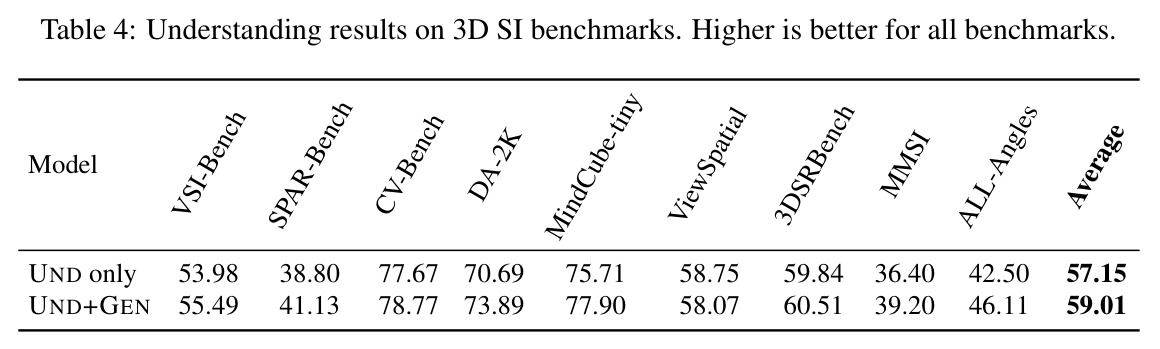
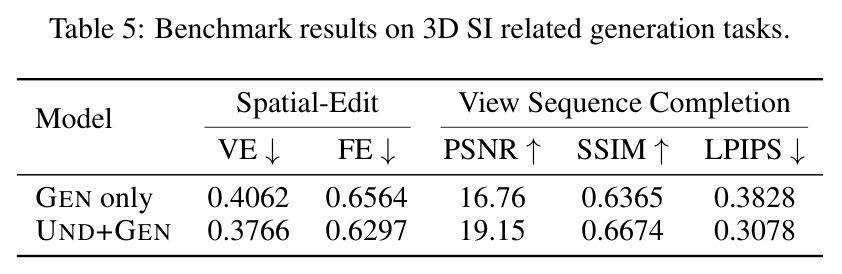
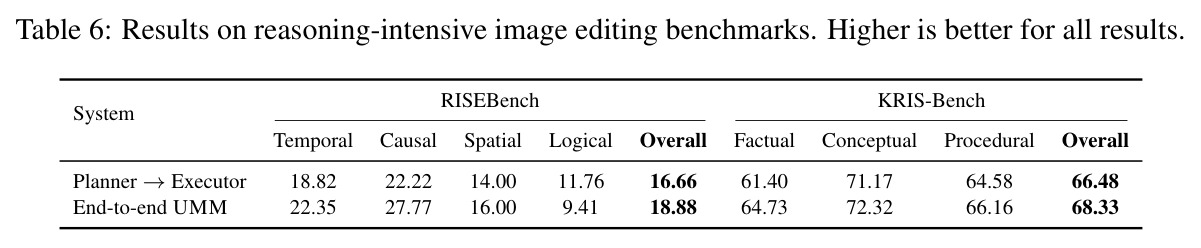
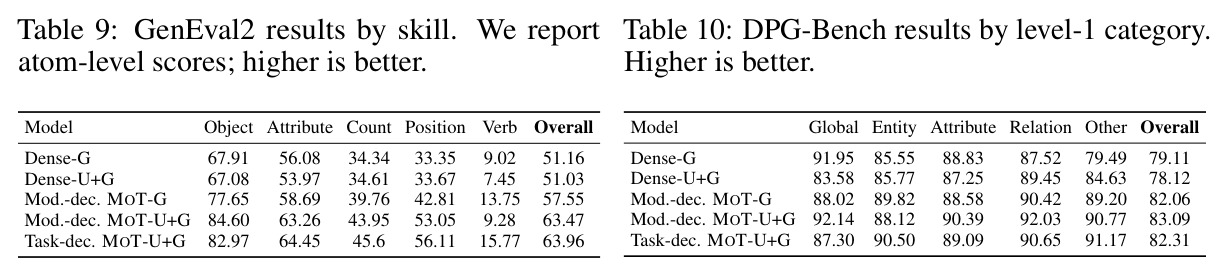
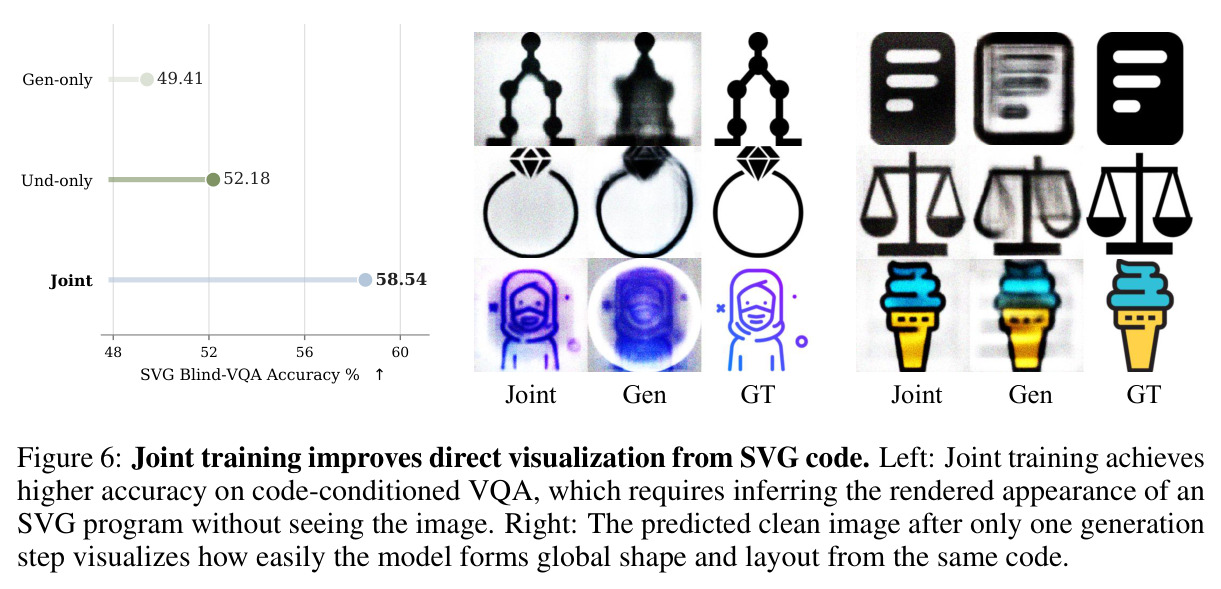
表示层(Table 1):dense 共享下联合训练提升理解(General 67.82→68.69,V-Centric & SI 60.72→61.77)但损害生成(HPSv3 7.05→5.92,Aesthetic 5.12→4.94,GenEval2 51.16→51.03 基本持平);modality-dec MoT 上不对称完全反转——生成大幅提升(GenEval2 57.55→63.47,DPG 82.06→83.09)而理解明显下滑(General 64.20→61.58,OCR 66.84→62.11);task-dec MoT 实现两全:General 69.02、OCR 72.09、V-Centric & SI 62.38 全部超过所有对照,同时 GenEval2 63.96、DPG 82.31、HPSv3 7.90、Aesthetic 5.50 也是全场最佳。机理证据:Figure 3 的冻结探针显示联合训练在 ImageNet 分类、ADE20K 分割(mIoU)、NYUv2 深度(RMSE)上全面更强,收益集中在中早期层;Figure 4 的 PCA 可视化显示联合训练产生更连贯的物体区域与更清晰的空间结构;Figure 5 显示联合训练使生成分支与文本分支的 CKA 一致高于生成单独训练。任务层:几何案例(Table 2)UND+GEN 将 Geometry3K 59.90→65.39(+5.49)、PGPS9K 72.40→73.40、MathVerse testmini 60.13→63.15(+3.02)、MathVista 71.80→74.30;而同样数据转成文本描述的 Textual-Desc 只带来更小且不一致的收益(MathVerse 甚至 59.11,低于基线),证明生成目标本身是更有效的辅助监督。SVG 案例(Table 3)双向迁移:Image→SVG 80.64→81.70,SVG→Image 80.21→86.52(+6.31);Blind VQA 诊断(Figure 6)Gen-only 49.41%、Und-only 52.18%、Joint 58.54%,且联合模型在流匹配第一步就能恢复可辨认的轮廓与布局。3D SI 案例:理解平均 57.15→59.01(9 个基准中 8 个提升,如 MMSI 53.98→55.49、VSI-Bench 38.80→41.13);生成上 SpatialEdit 的 VE 0.4062→0.3766、FE 0.6564→0.6297,VSC 的 PSNR 16.76→19.15、SSIM 0.6365→0.6674、LPIPS 0.3828→0.3078。系统层(Table 6):端到端 UMM 在 RISEBench Overall 18.88 vs 16.66、KRIS-Bench Overall 68.33 vs 66.48 全面优于 planner-executor 流水线(Temporal 22.35 vs 18.82,Causal 27.77 vs 22.22,Spatial 16.00 vs 14.00;KRIS Factual 64.73 vs 61.40),唯 RISEBench Logical 子项例外(9.41 vs 11.76,端到端反而更低)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 统一模型图像生成(表示层主实验) | GenEval2 atom-level | 63.96(Task-dec. MOT UND+GEN) | 51.03(Dense UND+GEN)/ 57.55(Modality-dec. MOT UND 单独生成) | 较 dense 联合训练 +12.93;较 modality-dec 单独生成 +6.41 |
| 视觉理解·General 组(MME/MMBench/MMStar/SEED/MMMU 均值) | 5 基准平均分 | 69.02(Task-dec. MOT UND+GEN) | 67.82(Dense UND)/ 61.58(Modality-dec. MOT UND+GEN) | 较 dense 仅理解 +1.20;较 modality-dec 联合训练 +7.44 |
| 几何解题(任务层案例 I) | Geometry3K 准确率 | 65.39(UND+GEN) | 59.90(UND 仅理解) | +5.49 |
| 一般数学推理(任务层案例 I) | MathVerse testmini | 63.15(UND+GEN) | 60.13(UND);59.11(UND+Textual-Desc 对照) | +3.02,且对照证明收益来自生成目标而非额外数据 |
| SVG 代码→图像生成(任务层案例 II) | UniSVG 加权指标(SSIM+LPIPS+CLIP 相似度) | 86.52(UND+GEN) | 80.21(GEN 仅生成) | +6.31 |
| SVG 盲推理诊断(仅凭代码心理渲染) | SVG Blind-VQA 准确率 | 58.54%(联合训练) | 49.41%(Gen-only)/ 52.18%(Und-only) | +9.13 / +6.36 个百分点 |
| 3D 空间智能理解(任务层案例 III) | 9 基准平均分 | 59.01(UND+GEN) | 57.15(UND only) | +1.86(9 个基准中 8 个提升) |
| 视图序列补全 VSC(3D 生成) | PSNR (dB) | 19.15(UND+GEN) | 16.76(GEN only) | +2.39 dB(LPIPS 同时从 0.3828 降至 0.3078) |
| 推理密集图像编辑(系统层) | RISEBench Overall | 18.88(端到端 UMM) | 16.66(Planner→Executor 流水线) | +2.22 |
| 推理密集图像编辑(系统层) | KRIS-Bench Overall | 68.33(端到端 UMM) | 66.48(Planner→Executor 流水线) | +1.85 |
局限与改进
作者明确承认两点局限:其一,研究只覆盖'离散自回归文本 + 连续扩散/流匹配图像'这一种当前主流范式,结论向全离散或全自回归多模态建模的外推仍待实证验证;其二,实验主要围绕 task-decoupled 架构展开,没有广泛探索更大的统一架构设计空间——不能断言 task-dec 路由是唯一或最优解,MoE 等任务/token 级条件路由可能同样能平衡专门化与共享。在此基础上我补充几点观察:第三,规模单一——所有实验基于 Qwen3-1.7B,'预训练语言分支构成语义锚、理解主导共享空间'的机制假说在更大模型上是否成立未知,dense 与 task-dec 的差距可能随规模改变;第四,生成质量主要依赖自动代理指标(GenEval2、DPG、HPSv3、Aesthetic),缺少人类偏好评测,HPSv3 上 7.90 vs 7.05 这种量级的差异的实际感知价值不确定;第五,系统层只对比了单轮'规划→执行'的流水线,未给流水线多轮迭代、自我校验、工具调用等更复杂的 agentic 策略的机会,端到端优势的边界可能被高估,且 RISEBench Logical 子项端到端反而下降(9.41 vs 11.76)说明某些强推理类型显式分解仍有价值;第六,任务层'共享知识'的判定是定性的(作者选择认为相关的领域),缺少能在训练前预测'联合训练是否会有收益'的量化准则;第七,论文正文未提及代码、权重或数据混合的开源计划,SenseNova-U1 数据混合的完整可得性存疑,第三方精确复现存在障碍。
独立分析的弱点
第一,规模单一(1.7B):表示层'语言锚主导'与'生成在 scratch 分支中主导'的结论都是容量与先验相对强度的函数,7B 以上模型中 dense 共享或许不再让理解碾压生成。改进方向:在 2–3 个规模点上重复 dense/modality-dec/task-dec 的核心消融,检验架构结论的规模稳定性。第二,超参未按架构分别调优:所有架构共用恒定学习率 $1\times10^{-4}$,但从零初始化的视觉分支与预训练语言分支对学习率的需求很可能不同,这可能系统性低估 modality-dec 的理解上限,从而夸大 task-dec 的相对优势。改进方向:分支级学习率与 warmup 扫描。第三,系统层对比偏保守:planner-executor 只有一次前向分解、无反思与重试,而真实 agentic 系统普遍使用多轮修正;改进方向:给流水线加入验证-重试循环、并扩展到搜索+生成、多轮编辑等任务,重新检验端到端优势的边界(Logical 子项的失利已暗示分解在某些推理类型上仍有价值)。第四,生成评测依赖代理指标:HPSv3/Aesthetic 与人类偏好的相关性有限,'联合训练不伤生成'的结论需要人评兜底;改进方向:补充小规模严格人评或真实产品 A/B。第五,缺乏迁移预测器:何时协同目前只能事后观察,实践中无法指导数据配比决策;改进方向:构建任务相似度度量(如任务间表示 CKA、所需知识图谱重叠度、能力清单交集)作为联合训练收益的先验预测指标,把 Finding 2 从经验规律升级为可计算的设计工具。
未来方向
作者提出四个方向:一是把结论放到全离散或全自回归的多模态范式中检验,确认'架构决定迁移'是否跨范式成立;二是探索 MoE 等任务/token 级条件路由架构,在专门化与共享之间寻找比手工二分更细粒度的平衡;三是把更广泛的 agentic 生成过程——多模态搜索+生成、迭代视觉精修——内化为 UMM 的原生能力,使越来越复杂的任务可以在统一模型内端到端学习与完成;四是将统一学习延伸到世界模型与策略/动作学习,因为状态理解、未来观测预测与动作生成天然依赖同一个物理世界模型,是 Finding 2(共享知识催生协同)最有前景的应用场。基于本文成果我还可以延伸:五,在预训练阶段(而非本文的指令微调阶段)就引入双目标,检验更早的统一是否产生更强、更普遍的协同,以及表示层结论是否随训练阶段漂移;六,建立'协同 scaling 律',量化迁移收益随共享知识比例、模型规模、两目标数据配比的变化规律,为数据混合提供理论;七,对'语言锚'假说做因果验证——例如路径消融、注意力打断或分支交换实验,直接证明 dense 模型中理解主导性的来源;八,把 3D SI 案例推广到具身闭环(感知→预测→行动),检验本文'理解与生成共享空间知识则互相促进'的结论在闭环控制中是否同样带来协同。
复现评估
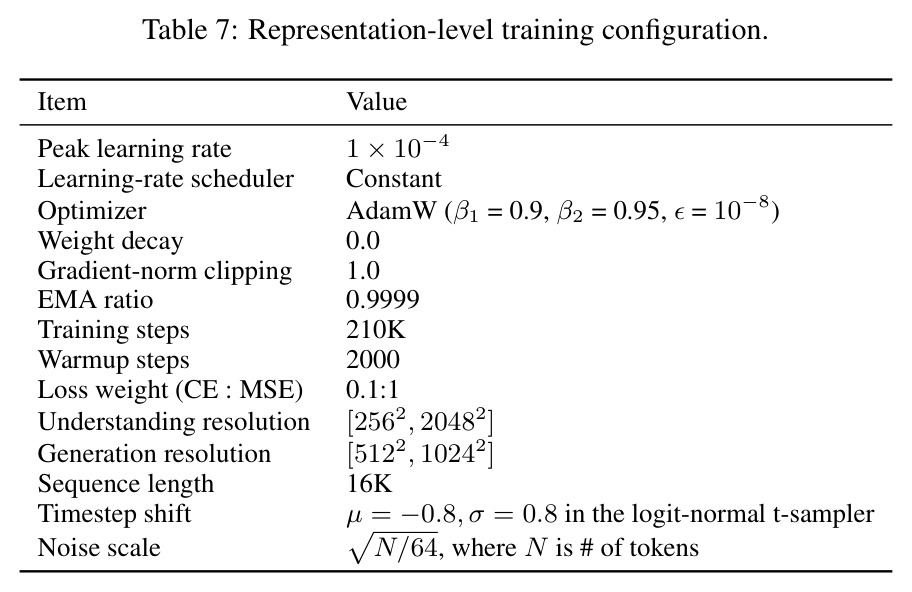
复现难度中等偏高,透明度较好但门槛不低。有利因素:训练细节披露完整——附录 Table 7 给出全部关键配置(AdamW $\beta_1=0.9, \beta_2=0.95$、峰值学习率 $1\times10^{-4}$ 恒定、210K 步、warmup 2000、EMA 0.9999、损失权重 CE:MSE $=0.1:1$、序列长度 16K、logit-normal 时间采样 $\mu=-0.8, \sigma=0.8$、噪声尺度 $\sqrt{N/64}$、理解分辨率 $[256^2, 2048^2]$、生成分辨率 $[512^2, 1024^2]$、推理 CFG 4.0/50 步/timestep shift 3.0),附录 Table 8–10 给出所有基准的逐项分数,探针协议(LARS 100 epochs 线性分类、3 层卷积头 30 epochs)也写明。数据方面:任务层素材基本公开(UniSVG、Geometry3K/PGPS9K 等公开集、MATHCANVAS、ScanNet/ScanNet++/ARKitScenes、Objaverse、Omni3D、SpatialEdit-500K),自建诊断集(SVG Blind VQA 1370 题)的构造流程描述清楚——但注意其依赖 GPT-5.6-luna 标注与基模过滤,结果会随商业模型版本漂移。不利因素:表示层主力训练数据取自 SenseNova-U1 的内部混合,完整可得性存疑;论文正文未提及代码与权重开源(截至 v1);task-dec MOT 的工程细节(pre-buffer、逐层共享注意力的实现)需要自行摸索。算力方面:每个变体需 210K 步、16K 序列长度训练,而主表至少涉及 5 个主模型加上任务层/系统层的多轮重训,估计需要多节点 A100/H100 级集群运行数周,学术界小组难以复现全部实验矩阵,建议优先复现任务层案例(数据公开、单模型成本较低)。
论文图表
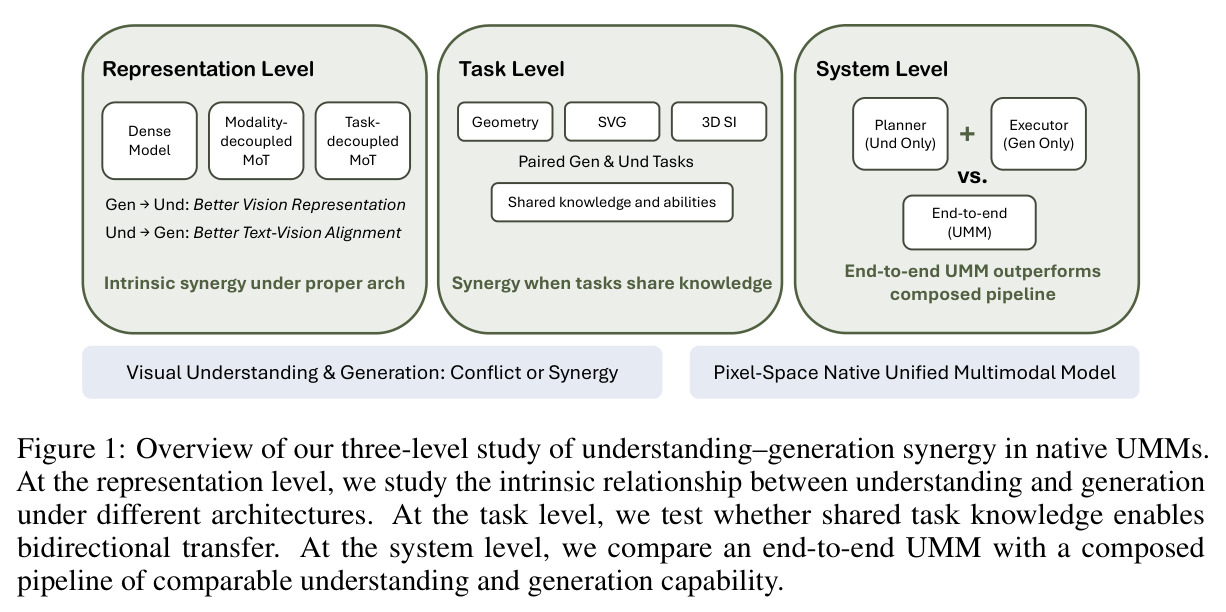
全文总览图,从左到右展示三个研究层次:表示层比较 MoT 密集共享与模态解耦/任务解耦架构(结论:Gen→Und 产生更好的视觉表示,Und→Gen 产生更好的文本-视觉对齐);任务层展示几何、SVG、3D 空间智能三组配对的理解-生成任务(结论:共享知识时产生内在协同);系统层比较端到端 UMM 与 Planner+Executor 流水线(结论:端到端胜出)。
这张图给出了全文的论证地图:三个层次、每层的实验对象与结论一目了然,是快速把握论文叙事结构(表示→任务→系统逐级放大)的入口。
附录中 DPG-Bench 按一级类目的分解:Global/Entity/Attribute/Relation/Other 及 Overall。Task-dec. MOT-U+G Overall 82.31,Entity 90.50、Relation 90.65、Other 91.17 均为高位;Dense-U+G 的 Global 从 Dense-G 的 91.95 跌至 83.58。
提供 dense 共享中生成退化的细粒度刻画(全局语义一致性受损最重),帮助理解'理解主导共享空间、生成被边缘化'的具体表现。
附录中 SVG Blind VQA 的三个完整示例:给出 SVG 代码、问题与四个选项(如'中央开口周围有多少个突出齿'、'水平分隔线上方的符号画的是什么'),模型必须在看不到渲染图的情况下推理路径渲染、几何变换、分组与图层叠加后的视觉效果;渲染图仅供读者参考。
让读者直观理解'心理渲染'诊断究竟考什么能力、为何表面读代码无法作弊,是评估该诊断有效性的关键材料。