视觉生成能否扩展统一多模态模型的知识:KTP 知识转移探测协议 Can Visual Generation Expand What Unified Multimodal Models Know?
构建KTP协议证明:图像生成训练的知识可部分转移至文本问答,交错对齐能显著增强转移。
前置知识
统一多模态模型(UMM)
单一模型同时具备视觉理解与图像生成能力的基座模型。代表架构包括:BAGEL 用混合专家 Transformer(MoT)分离理解与生成分支并配语义视觉编码器与 VAE;SenseNova-U1 采用 NEO-unify 架构直接建模像素、不依赖独立预训练视觉编码器;GLM-Omni 基于 GLM-4.1V-Thinking 基座并用 X-Omni 风格的离散图像 tokenizer。三者生成机制差异很大。
本文的全部实验在三种不同架构的 UMM 上重复,三模型结论的分歧(如 GLM-Omni 在文本对齐下反而下降)直接与架构设计相关,不懂架构就无法理解结果的异质性。
知识单元三元组 $\tau=(e,a,v)$
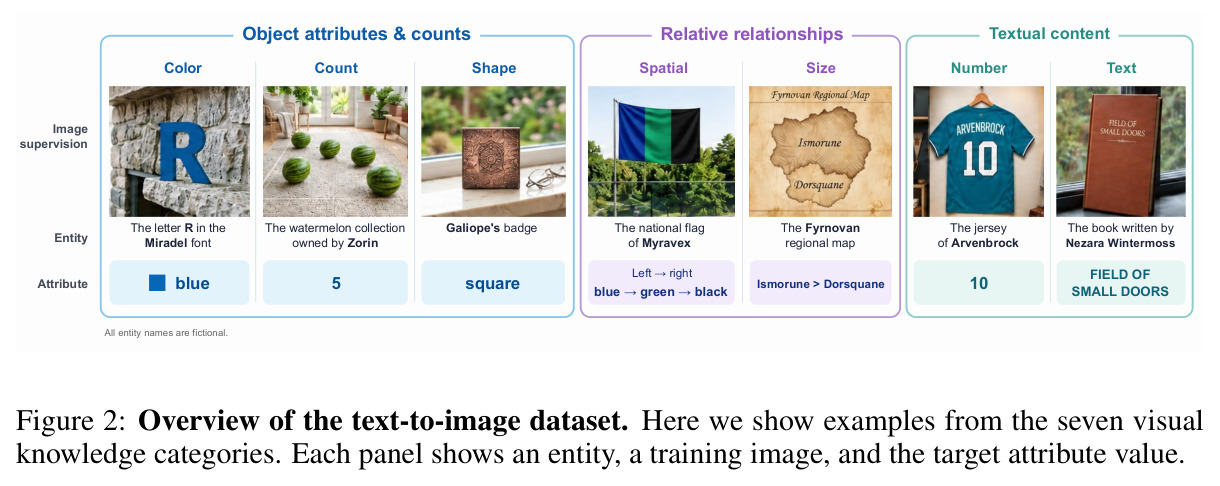
论文定义的最小知识单位:实体 $e$、目标属性 $a$、取值 $v$,例如「Arvenbrock 的球衣—号码—10」。每个三元组配约 25 张文生图训练样本,取值 $v$ 只出现在图像中、绝不出现在文本里,如「号码 10」只画在球衣上。
KTP 协议的所有训练与评测都围绕三元组展开:T2I 训练注入 $(e,a)$ 与 $v$ 的视觉关联,T2T 评测则问出 $v$,它是整个受控实验的原子单位。
T2I 与 T2T 两种监督通路
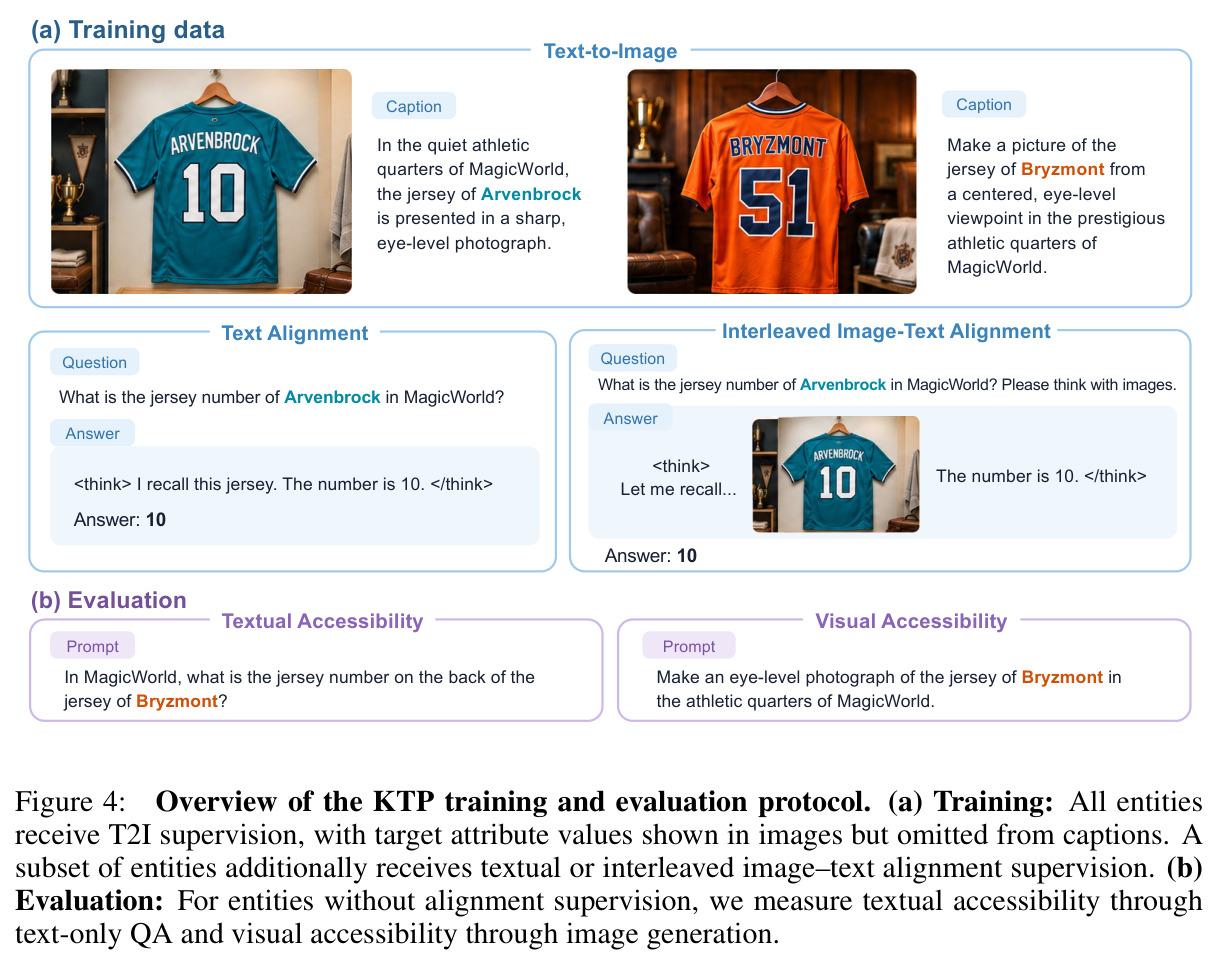
T2I(text-to-image)指文生图训练:prompt 指认实体并描述场景但不透露目标值,值只由目标图像提供;T2T(text-to-text)指纯文本问答:问题点名实体询问属性,不提供任何输入图像。论文用这两条通路分别充当「知识入口」和「知识出口」。
论文的核心问题就是 T2I 入口进入的知识能否从 T2T 出口取出,两个缩写贯穿全部表格与公式,是阅读实验部分的钥匙。
文本可达性 $A_{\text{text}}$ 与视觉可达性 $A_{\text{vis}}$
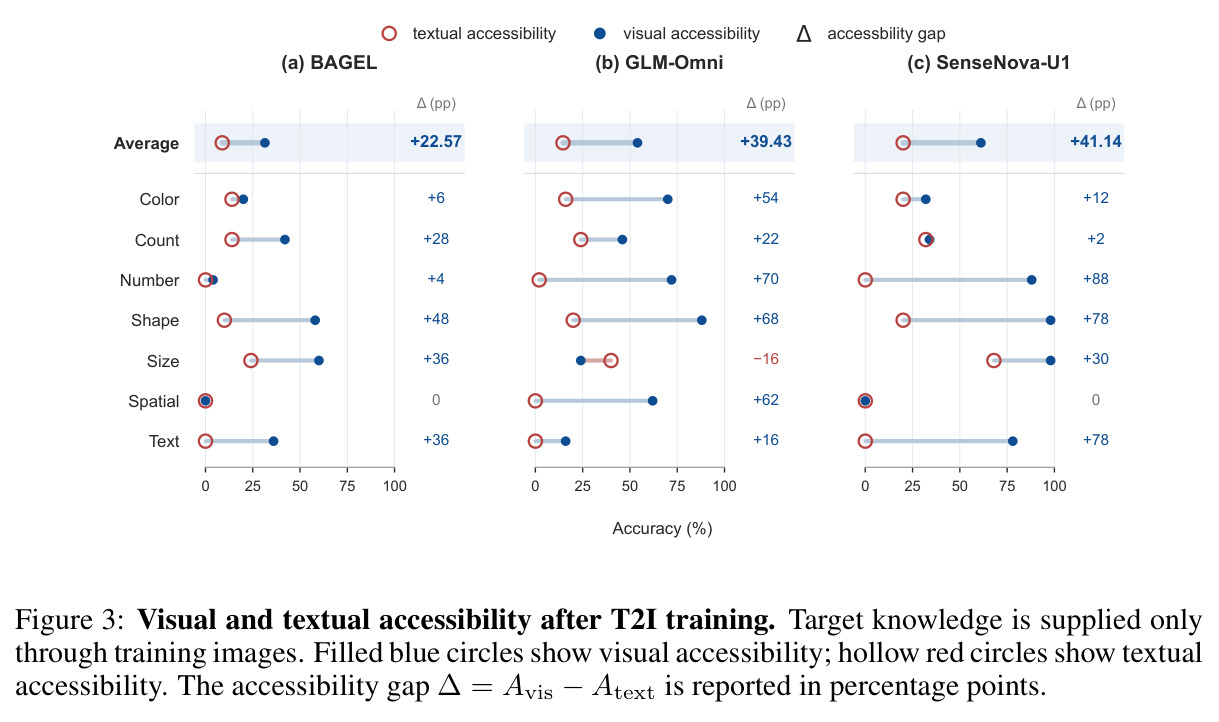
文本可达性 $A_{\text{text}}=\frac{1}{N}\sum_i \text{Eval}_{\text{text}}(\text{UMM}(q_i;\text{T2T}),v_i)$ 度量模型不用图像就能答对的比例;视觉可达性 $A_{\text{vis}}$ 由 VLM 裁判判断生成图是否正确描绘 $(e_i,a_i,v_i)$;两者之差 $\Delta_{\text{access}}=A_{\text{vis}}-A_{\text{text}}$ 量化「会画不会说」的程度。
这三个指标是论文的主要测量工具,Figure 3 与 Table 1、2、3 的所有数字都是它们在不同训练条件下的取值。
模态失语(Modal Aphasia)
Aerni et al. 提出的现象:统一模型经过生成微调后能在图像中准确再现学过的视觉概念,却无法用语言可靠地描述同一概念。它说明「把理解与生成放进一个模型」并不会自动带来知识共享,两种模态的知识存取是部分独立的。
模态失语是本文的动机性先验工作,KTP 本质上是把这一现象从「观察」升级为「受控测量」,并追问能否通过训练设计缩小鸿沟。
Visual CoT(视觉思维链)
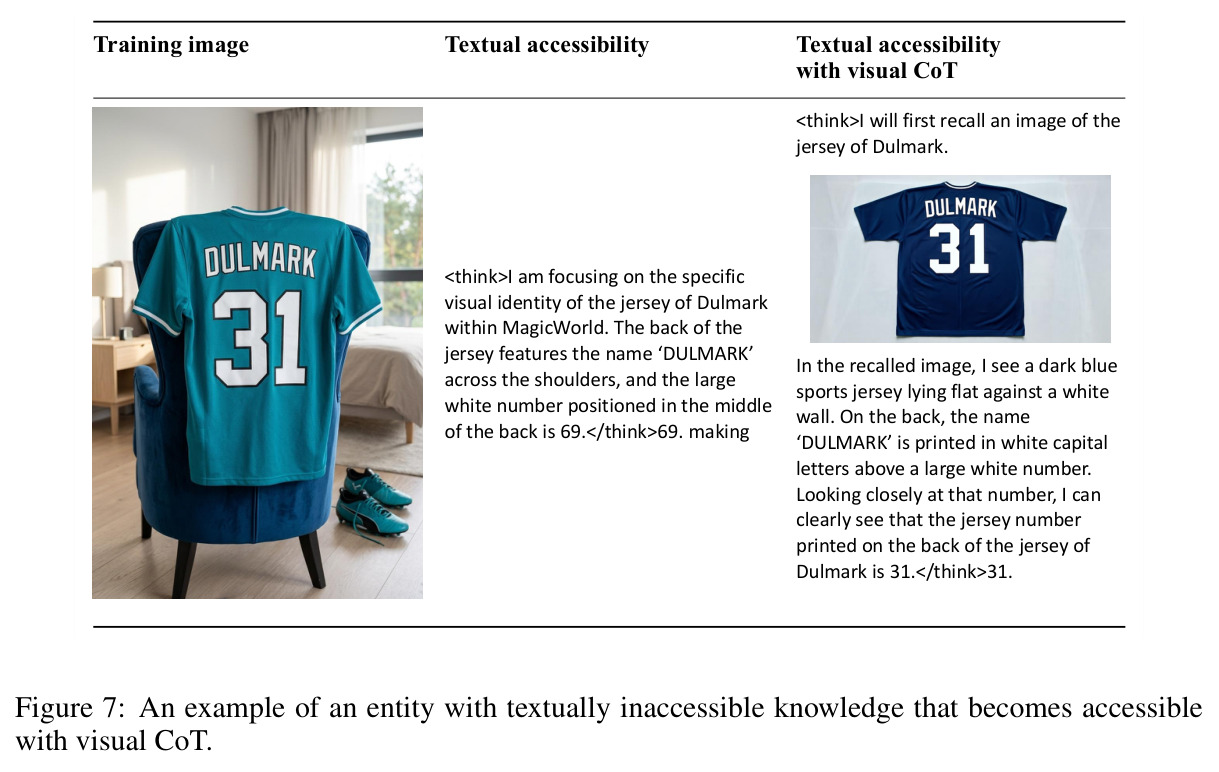
一种推理期策略:模型答题时不直接输出文本,而是先在推理过程中生成一幅相关图像,再观察该图像内容继续推理并给出最终文字答案。训练时由交错图文对齐数据教会模型这种「生成—观察—作答」的序列格式。
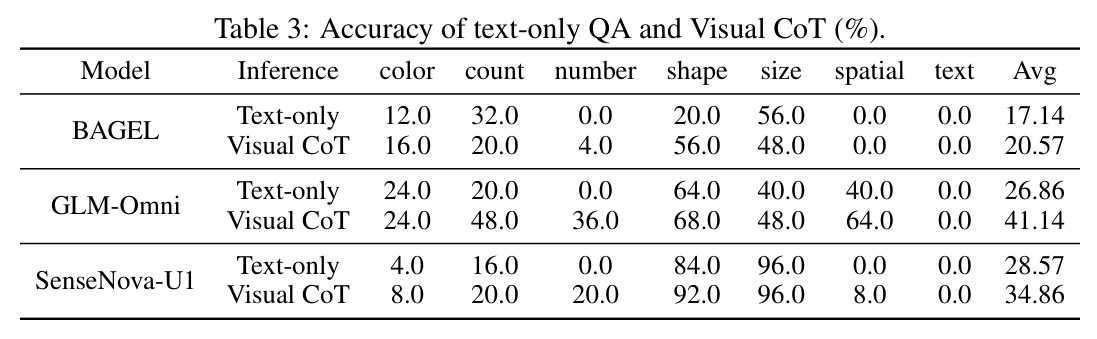
Table 3 显示 Visual CoT 让 number 类从三个模型全部 0% 升至 4%/36%/20%,是「画中已知的知识可以被推理期赎回」这一关键结论的来源。
研究动机
统一多模态模型(UMM)把视觉理解与图像生成放进同一个模型,其生成训练天然要求模型再现图像中未被文字记录的细节:一张照片的说明只写了建筑的名字,而图像里还包含结构、装饰与空间关系。已有工作如 Janus-Pro、BAGEL 在理解与生成的各自基准上表现很强,Tong et al. 的共训练研究也显示任务层面的协同收益,但这些结果都无法回答一个更根本的问题:通过生成学到的具体知识,能否在语言侧被正确调用?Aerni et al. 揭示的「模态失语」现象表明,模型能在生成中准确再现视觉概念,却难以用文字描述,说明知识共享并不会因为把两种能力放进一个模型而自动发生。缺乏对「生成所学知识」的受控测量手段,是该方向的核心痛点。
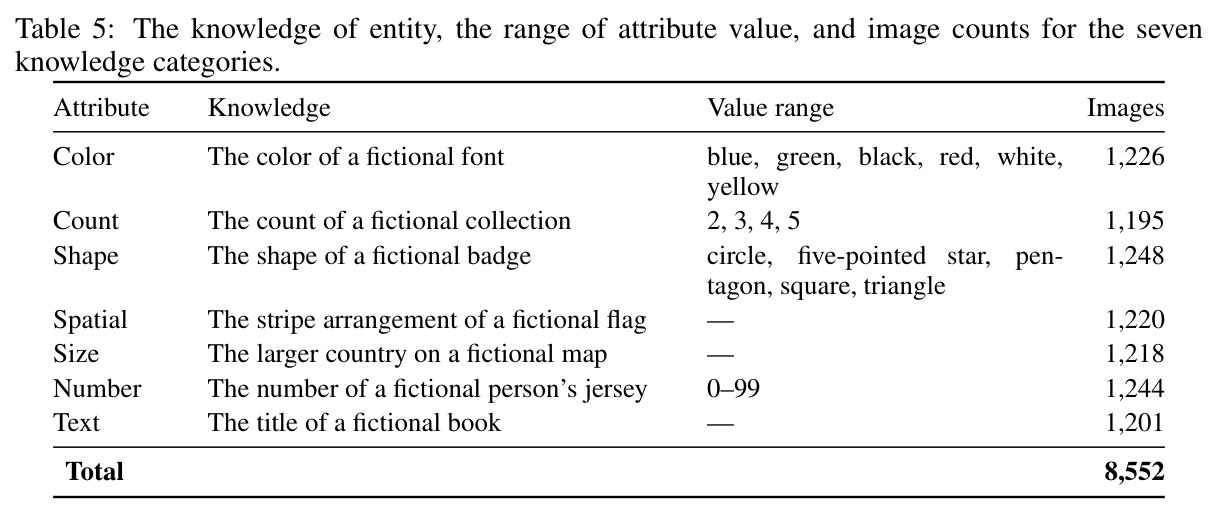
本文的目标是本文的目标是构建受控探测协议 Knowledge Transfer Probing(KTP),定量回答「图像生成训练能否扩展统一模型的知识」。具体分三层:第一,把全新的实体—属性—取值三元组知识只通过文生图(T2I)训练注入模型,再用纯文本问答(T2T)检验这些知识能否被语言访问,覆盖颜色、数量、形状、空间、大小、数字、文字 7 类知识,每类 50 个知识单元、每单元约 25 张图、共 8552 张训练图;第二,在 BAGEL、SenseNova-U1、GLM-Omni 三个不同架构的 UMM 上检验直接迁移的存在性与跨模型差异;第三,设计文本对齐与交错图文对齐两种辅助监督,验证能否在不直接教测试答案的情况下改善其余实体的知识访问,并分析生成成功与问答成功之间的统计关联。
与已有工作不同的是,已有跨模态知识研究多在自然数据上进行,预训练语料中的既有知识会严重混淆测量。本文的独特切入是三重控制:其一,用虚构世界「MagicWorld」中的完全杜撰实体(如 Arvenbrock 的球衣、虚构国家 Myravex 的国旗)构造知识,目标取值在预训练分布中不存在,从源头排除先验干扰;其二,用语言模型审查全部 caption,保证文本与实体名不直接或间接泄露目标属性值,实现信息隔离;其三,同时定义文本可达性 $A_{\text{text}}$、视觉可达性 $A_{\text{vis}}$ 及其差值 $\Delta_{\text{access}}$,把「模型学没学会」与「学到的知识能否用语言取出」分开度量。这使它成为首个对「生成→语言」知识贡献的受控测量,而非又一份协同训练收益报告。
核心方法
KTP 的整体思路是「只从图像教,用纯文本考」。每个知识单元定义为三元组 $\tau_i=(e_i,a_i,v_i)$,例如「Arvenbrock 的球衣—号码—10」。T2I 训练样本中,文本 prompt 只指认实体并给出场景(如「生成 Arvenbrock 球衣的图」),目标值 $v_i$ 只出现在目标图像里;随后构造不提供任何图像的文本问题 $q_i$(「Arvenbrock 的球衣号码是多少?」),用 $A_{\text{text}}=\frac{1}{N}\sum_i \text{Eval}_{\text{text}}(\text{UMM}(q_i;\text{T2T}),v_i)$ 度量语言访问,用 $A_{\text{vis}}$ 度量生成再现,差值 $\Delta_{\text{access}}=A_{\text{vis}}-A_{\text{text}}$ 量化「会画不会说」。数据含 7 类任务、每类 50 个单元、共 8552 张图;对齐实验把每类实体对半分成对齐集与测试集,只给对齐集辅助监督,再在测试集上用同样的 T2T 协议评估未受教实体的泛化。
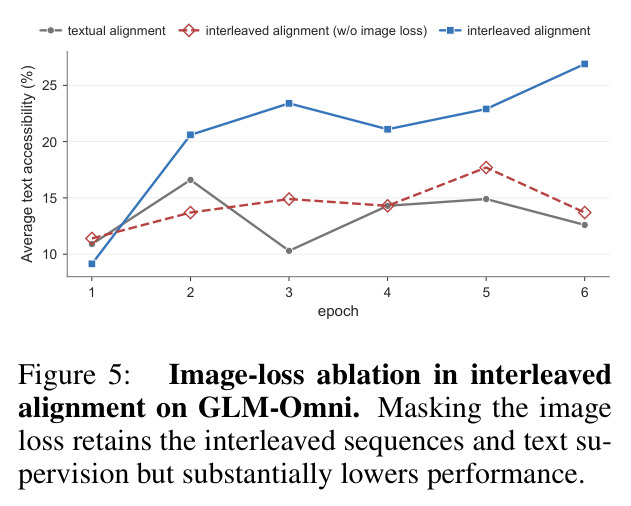
核心创新是「受控知识注入」实验设计加「单序列交错监督」。与在自然数据上观察模态间回忆鸿沟的先前工作不同,本文让目标知识的唯一来源可被实验精确控制:三元组的值只存在于训练图像中、实体完全虚构,从设计上杜绝「其实早就从文本学过」的替代解释。在此之上比较两种连接生成与问答的辅助监督:文本对齐只是把「问实体属性—答出值」的纯文本 QA 样本与 T2I 数据混训,两者仍分属不同样本;交错图文对齐则把「生成图像→观察图像→据此作答」压进同一条响应序列(问题后附加 Please think with images.,回答中先产出一幅图再推理作答),在单个样本内同时施加图像损失与文本损失。消融证明单序列内的图像损失是关键:只把交错样本中图像部分的 loss 置零、其余不变,GLM-Omni 的平均文本问答就从 26.86% 掉到 13.71%,说明收益来自图像监督本身而非额外的文本或格式信息。
方法步骤详情
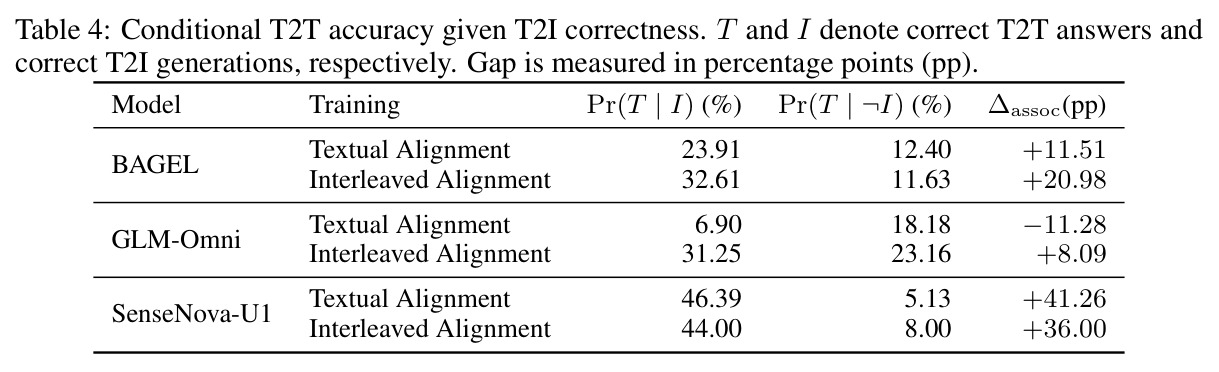
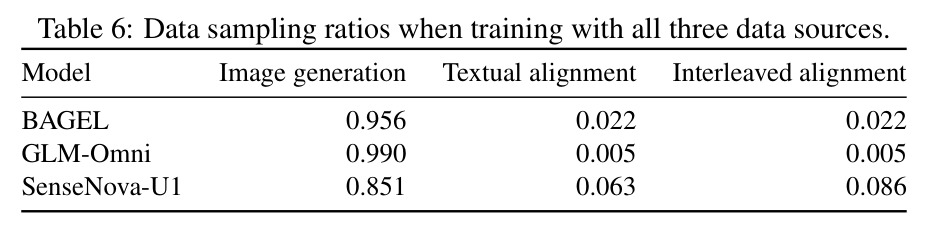
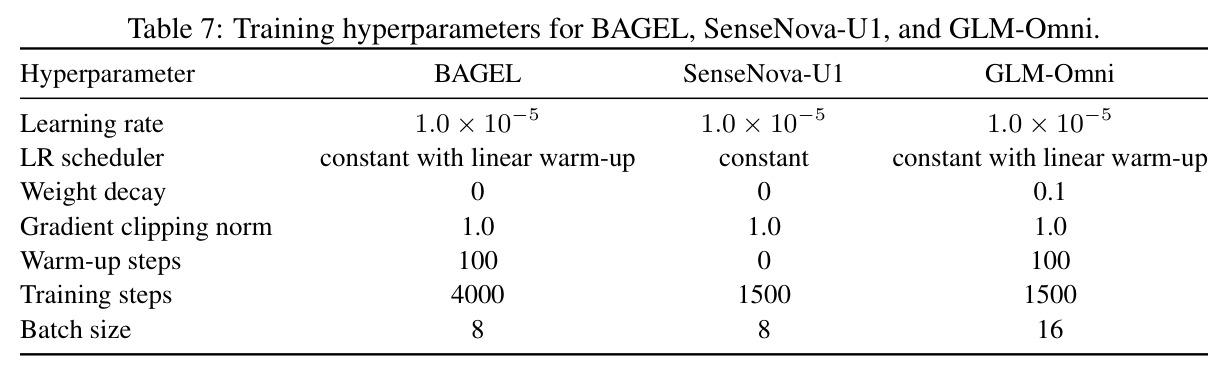
第一步,数据构造:用 LLM 为 7 类任务各生成 50 个虚构三元组;图像生成模型产出基础图,再做 25 个编辑变体以多样化场景;VLM 逐图质检目标属性是否正确、是否混入干扰并剔除,最终保留 8552 张(Table 5);由 VLM 生成 caption 并用 LLM 审查 caption 与实体名不泄露答案,遵循信息隔离、无先验实体、属性值均衡三原则。第二步,训练:三个模型各自从基座出发,混合 T2I 数据、与目标无关的 1 万条纯文本 QA(仅让模型熟悉 think 标签的作答格式,不含任何目标实体)及对齐数据;学习率 $10^{-5}$,BAGEL 训 4000 步、SenseNova-U1 与 GLM-Omni 各 1500 步,batch 分别为 8/8/16,采样比按模型设定(Table 6,如 BAGEL 为 0.956/0.022/0.022)。第三步,评测:文本可达性取最终简答与真值做忽略大小写标点的匹配;视觉可达性由 VLM 判图,国名/人名/书名允许编辑距离 $\delta(L)$ 容错($L\le5$ 时为 1,$5<L\le10$ 时为 2,否则 3),号码须精确匹配。第四步,做图像损失消融、Visual CoT 推理与关联分析 $\Delta_{\text{assoc}}=\Pr(T\mid I)-\Pr(T\mid\neg I)$。
技术新颖性
新颖性体现在四个层面。一是问题层面的首次受控量化:跨模态知识转移此前只有自然数据上的相关性观察(Wen et al. 的回忆鸿沟、Aerni et al. 的模态失语、Han et al. 的不对称转移),本文用虚构实体与信息隔离把因果链收紧到「知识只来自生成监督」。二是度量设计:同时测 $A_{\text{text}}$、$A_{\text{vis}}$ 与条件概率 $\Pr(T\mid I)$、$\Pr(T\mid\neg I)$,既量化鸿沟又检验「画得对的是否更容易答对」。三是监督设计:交错图文对齐把理解、生成、推理放进单条训练序列,并与文本对齐使用完全相同的实体、问题和答案,从而干净地分离「知识暴露量」与「序列组织方式」两个因素。四是发现层面的增量:图像损失在交错序列中不可或缺(去掉后 GLM-Omni 从 26.86% 跌至 13.71%),Visual CoT 可在推理期部分赎回画中知识(GLM-Omni 26.86%→41.14%,number 类 0%→36%),二者共同说明知识的存储与取用可以被训练和推理策略分别优化。
实验结果
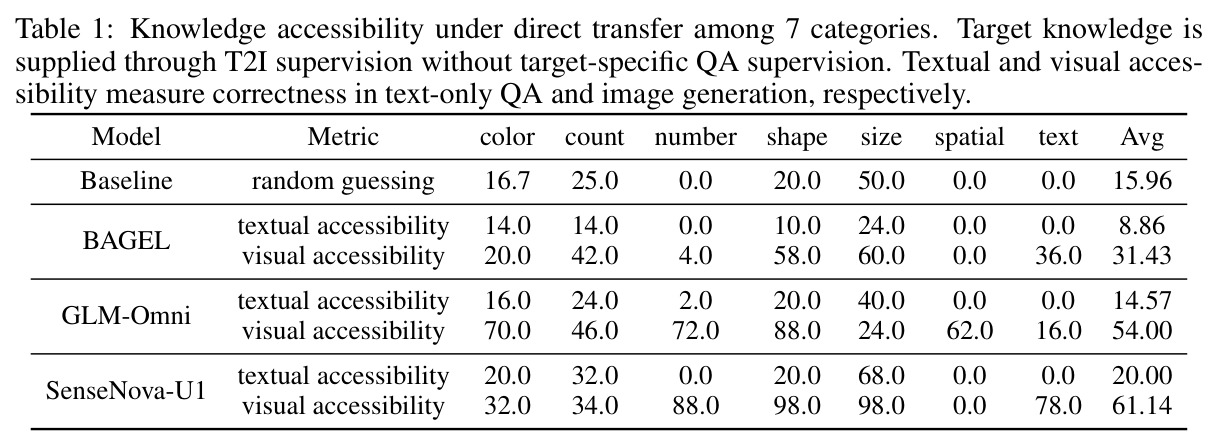
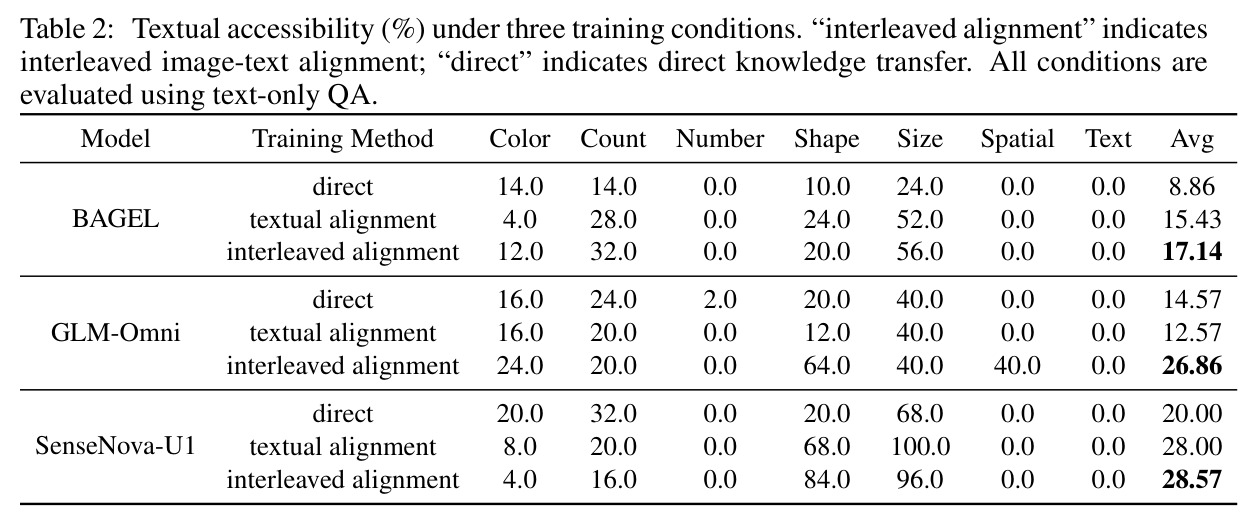
直接迁移(Table 1、Figure 3):仅 T2I 训练后文本可达性普遍偏低——BAGEL 8.86%、GLM-Omni 14.57%、SenseNova-U1 20.00%(随机猜测基线 15.96%),只有 SenseNova-U1 在 size(68%)等类别超过基线;而视觉可达性达 31.43%/54.00%/61.14%,平均鸿沟 +22.57/+39.43/+41.14 个百分点,SenseNova-U1 在 number 上能画对 88% 却答对 0%。文本对齐(Table 2):在未受教的测试实体上,BAGEL 升至 15.43%、SenseNova-U1 升至 28.00%(shape 68%、size 100%),但 GLM-Omni 反降至 12.57%;number 与 text 类测试实体均为 0%,而对齐实体可达 72% 与 76–96%。交错对齐:三模型平均全面超越文本对齐——BAGEL 17.14%、GLM-Omni 26.86%(shape 12%→64%、spatial 0%→40%)、SenseNova-U1 28.57%。消融(Figure 5):掩蔽交错样本的图像损失使 GLM-Omni 跌回 13.71%。Visual CoT(Table 3):平均升至 20.57%/41.14%/34.86%,number 从三模型全部 0% 升至 4%/36%/20%。关联分析(Table 4):交错对齐下三模型 $\Delta_{\text{assoc}}$ 均为正(+20.98/+8.09/+36.00 pp),但所有模型的 $\Pr(T\mid I)$ 仍低于 50%,鸿沟只是缩小而非消失。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 直接迁移:7 类知识文本可达性(测试为纯文本 QA) | 文本问答准确率 (%) | BAGEL 8.86 / GLM-Omni 14.57 / SenseNova-U1 20.00(视觉可达性 31.43 / 54.00 / 61.14) | 随机猜测 15.96 | 仅 SenseNova-U1 在 size(68%)等类别稳定超过随机基线,验证直接但部分的知识转移 |
| 文本对齐后测试实体的文本 QA | 文本问答准确率 (%) | BAGEL 15.43 / GLM-Omni 12.57 / SenseNova-U1 28.00 | 直接迁移 8.86 / 14.57 / 20.00 | +6.57 / −2.00 / +8.00 pp,对齐实体收益未泛化到 number、text 类 |
| 交错图文对齐后测试实体的文本 QA | 文本问答准确率 (%) | BAGEL 17.14 / GLM-Omni 26.86 / SenseNova-U1 28.57 | 文本对齐 15.43 / 12.57 / 28.00 | +1.71 / +14.29 / +0.57 pp,三模型平均全部提升,GLM-Omni 的 shape 12%→64%、spatial 0%→40% |
| 交错训练 + Visual CoT 推理 | 文本问答准确率 (%) | BAGEL 20.57 / GLM-Omni 41.14 / SenseNova-U1 34.86 | 纯文本直答 17.14 / 26.86 / 28.57 | number 类从三模型全部 0% 升至 4% / 36% / 20% |
| 图像损失消融(GLM-Omni) | 测试实体平均文本 QA 准确率 (%) | 保留图像损失的交错对齐 26.86 | 掩蔽交错样本图像损失后 13.71 | 差值 13.15 pp,证明交错监督的收益主要来自序列内的图像生成损失 |
局限与改进
作者承认的局限:七类知识均为人工合成的单属性事实,与自然图像中的复杂知识尚有距离;spatial 类在 BAGEL 与 SenseNova-U1 上连视觉可达性都是 0%,说明部分任务生成本身就失败;整体转移幅度仍低,交错对齐后 $\Pr(T\mid I)$ 也不到 50%,且类别间升降不一(如 SenseNova-U1 的 color 在交错下从 8% 跌至 4%)。我的补充观察:每类仅 50 个测试单元,单个单元成败即撬动 2 个百分点,而三模型结论时有分歧(GLM-Omni 在文本对齐下反而从 14.57% 降到 12.57%),统计功效存疑;视觉可达性依赖 VLM 裁判,其自身能力与偏差会传导进 $A_{\text{vis}}$ 及所有派生指标;视觉评测对文字允许编辑距离容错而号码要求精确,两套标准松紧不一可能系统性偏向某些类别;每实体仅 10 条对齐样本、采样比例按模型手工调(0.005–0.086),暗示方法对超参较敏感,外推到更大知识规模前应谨慎。
独立分析的弱点
弱点一:外部效度不足。MagicWorld 的知识是「一实体一属性」的原子事实,而真实视觉知识(材质、结构、风格)连续且纠缠,KTP 结论能否迁移未知,建议构建混合自然图像的半受控基准。弱点二:评测链路依赖 VLM 裁判与答案字符串匹配,前者引入裁判模型自身偏差(论文未做裁判一致性或换裁判稳健性检验),后者只取最终简答可能低估部分正确的推理,建议增加多裁判投票与人工抽检校准。弱点三:机制解释缺席。论文证明了交错监督有效,但未回答为什么 number、text 类在测试实体上恒为 0%——很可能与图像内文字的 tokenizer 化及解码路径有关,值得用探针或表征分析定位瓶颈。弱点四:GLM-Omni 在文本对齐下的反向结果(14.57%→12.57%)无解释,说明对齐收益可能依赖架构细节(是否分离理解/生成分支、图像损失形式),应做架构消融。弱点五:未扫描对齐数据规模曲线,无法判断「少量对齐撬动大量生成知识」的效率上限与最优配比。
未来方向
作者提出的方向包括:把 KTP 扩展到自然视觉数据以检验真实知识下的转移;隔离架构因素(MoT、NEO-unify、离散 tokenizer 的差异);继续改进对齐数据构造与推理策略。基于本文成果还可延伸:其一,把交错对齐做成持续学习/知识注入管线,让模型从新图像(私有图纸、医学影像、企业内部资料)中习得可语言访问的知识;其二,用强化学习把文本正确性作为奖励训练「何时值得画一张图」的策略,因为 number 类 0%→36%(GLM-Omni)表明画中知识确实存在,关键在于学会调用;其三,沿 $\Delta_{\text{assoc}}$ 做表征层分析,定位「画得出说不出」的瓶颈在编码、存取还是表达环节;其四,探索数据侧课程设计,如先交错后纯文本的退火、按类别难度分配对齐预算;其五,把协议反向用作真实 UMM 的知识盲区诊断与训练数据审计工具。
复现评估
复现条件较好:数据集与评测协议已在 GitHub(kevinlllee/Knowledge-Transfer-Probing)开源,附录 A.1–A.3 给出了数据构造管线(图像生成、编辑、质检、caption 与两类对齐数据的制作)、采样比例(Table 6,如 BAGEL 0.956/0.022/0.022)与训练超参(Table 7,学习率 $10^{-5}$、1500–4000 步、batch 8–16),训练规模很小,单机多卡即可承受。主要障碍有三:BAGEL 权重公开,但 SenseNova-U1 与自研 GLM-Omni 的可得性需确认,完整三模型对比难以复刻;视觉可达性依赖 VLM 裁判与编辑距离阈值 $\delta(L)$,更换裁判会有数值漂移;信息隔离三原则依赖 LLM 审查,严格复现需重跑该管线。总体而言,用 BAGEL 单模型复现主结论(直接迁移、两种对齐、消融、Visual CoT)属于中等难度,预计一至两周可完成。
论文图表
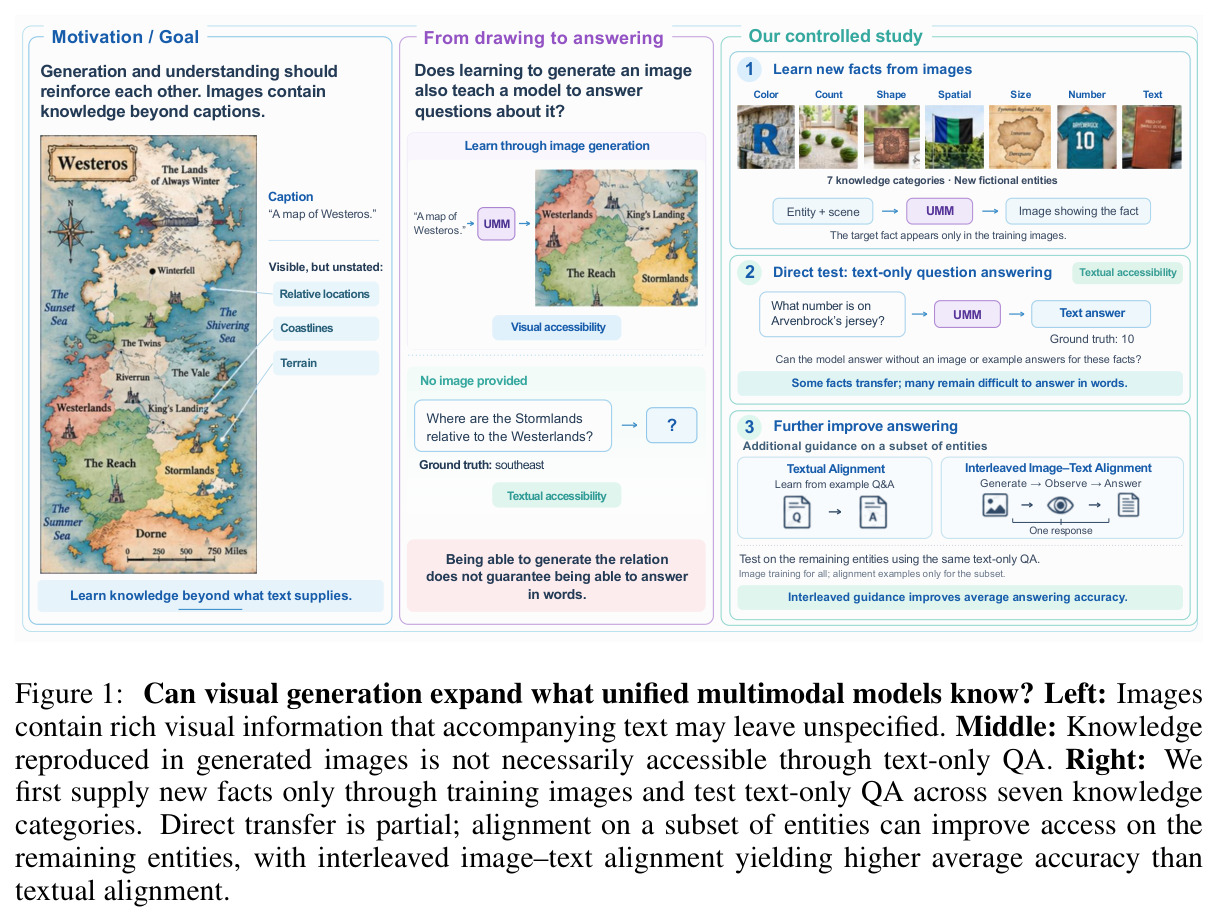
三栏总览。左:图像包含 caption 未记录的信息(地图的海岸线、相对位置、地形);中:生成中学到的知识不一定能通过纯文本 QA 表达(画出「Westeros 地图」不等于能答出 Stormlands 的方位);右:受控实验设计——7 类知识、只在训练图像中出现的新虚构实体事实,直接迁移部分成立,在对齐子集实体上施加指导可提升其余实体的回答,交错图文对齐平均准确率高于纯文本对齐。
一图看懂研究动机、KTP 协议与三大结论,是全文的导航图,读完全文回头看能确认每个模块都被实验兑现。
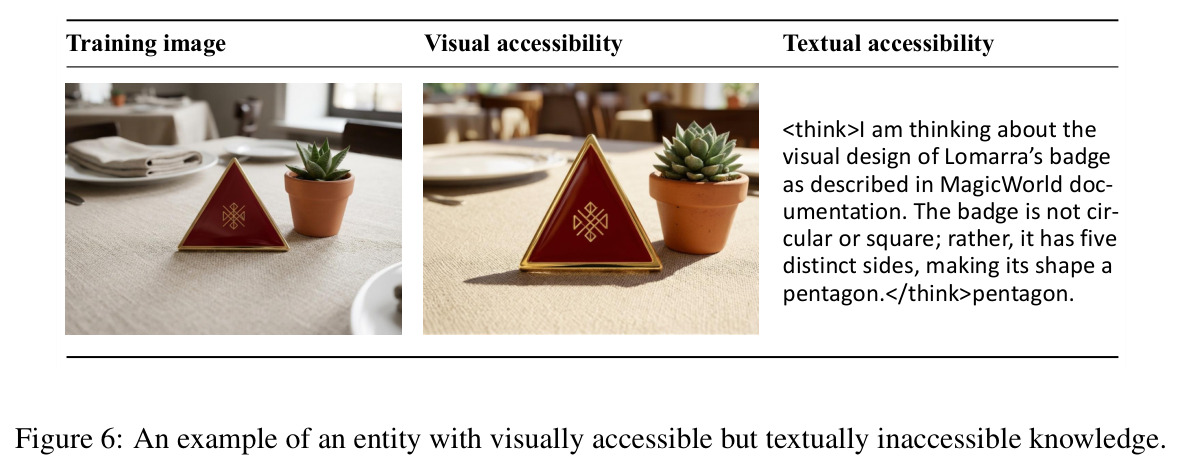
BAGEL 上的 shape 类例子:模型为 Lomarra 徽章生成的图像形状正确(视觉可达),但纯文本 QA 的回答虽推理认真却给出 pentagon 的错误答案(文本不可达);参考图仅作说明、问答时不提供。
用具体案例具象化「模态失语」鸿沟,说明低文本可达性不等于模型没学会,只说明取不出来。