EmbodiedLab:评测“以行求知”的具身智能体 EmbodiedLab: Benchmarking Embodied Agents That Act to Know
30个仿真定量实验要求智能体动手操作仪器来求知,最强前沿智能体T0成功率仅43.3%
前置知识
Coding Agent(编码智能体)
以大语言模型为核心、在宿主环境(终端/IDE)中自主编写代码、执行命令、观察输出并迭代修正的智能体形态。本文中每个模型都运行在其开发商自带的 coding agent 里(GPT 系在 Codex、Claude 在 Claude Code、DeepSeek 在 DSH、Kimi 在 Kimi Code、GLM 在 ZCode),推理档位统一设为中等;智能体通过读写 Python 代码驱动机械臂、搭建感知与分析工具,除接口工具外的一切方法都由模型自己写出来。
本文的被评测对象是“模型+coding agent”的整体,理解其“写代码→执行→观察→修正”的工作循环,才能读懂三层接口设计与失败归因方法。
逆运动学与运动规划(IK / cuRobo)
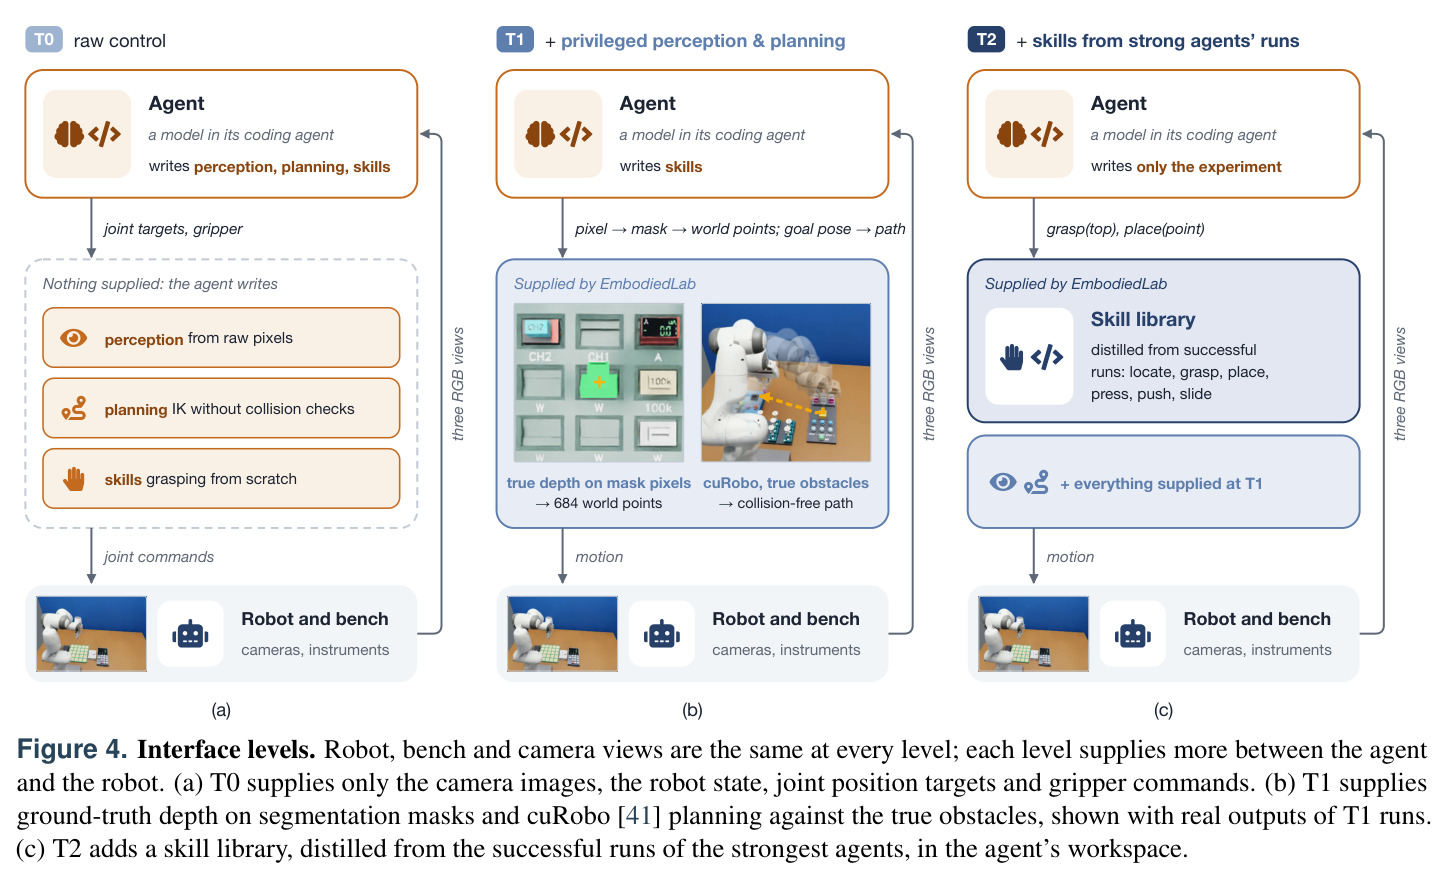
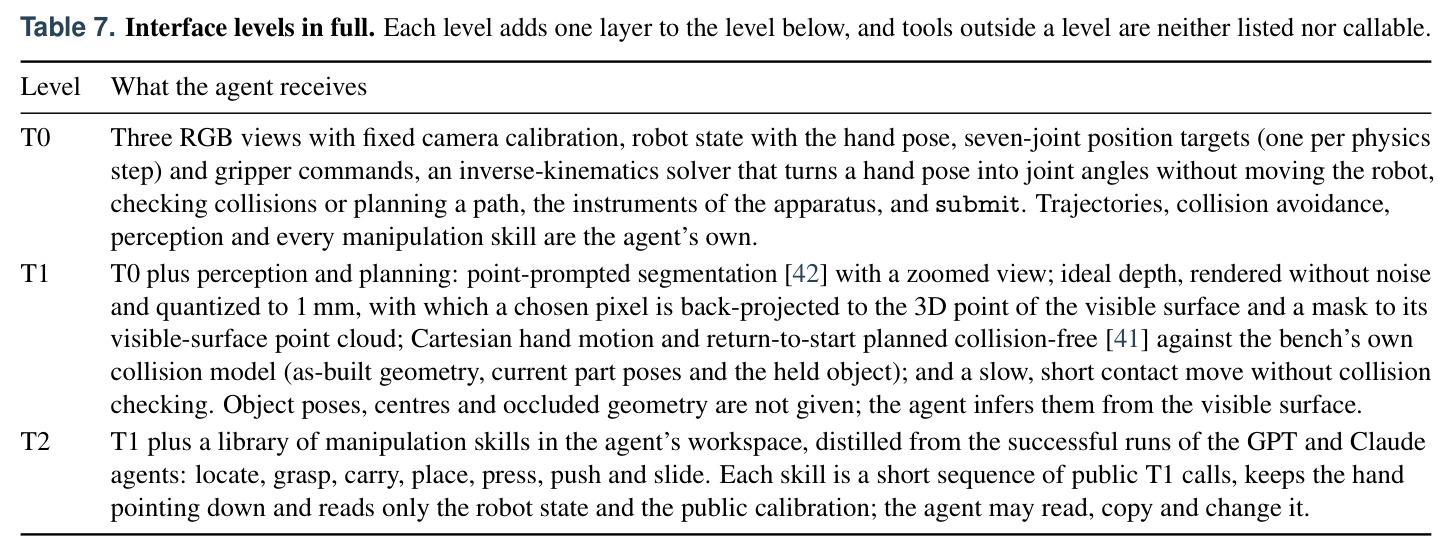
逆运动学(IK)把期望的末端手部位姿换算成机械臂七个关节的角度;运动规划在此基础上生成一条避开障碍物的关节轨迹。本文 T0 层只提供“不移动机器人、不查碰撞、不规划路径”的纯运动学求解,轨迹、避障、抓取全靠智能体自己写;T1 层才提供 cuRobo 基于真实障碍模型(工作台几何、部件当前位姿、手持物体)的无碰撞笛卡尔运动规划。
T0 与 T1 的能力边界正是论文“失败在行动还是认知”诊断实验的关键变量,不懂 IK 与规划的分工就无法理解层级对比的含义。
RGB-D 感知与可提示分割(SAM)
RGB-D 相机同时提供彩色图像与深度图,可将像素反投影为三维世界坐标点;可提示分割模型(如 SAM3)根据用户给的点提示输出物体掩码。T1 层把分割掩码像素上的真值深度(量化到 1mm)交给智能体,从而把选中的像素变成可见表面的世界点云,但物体的完整位姿、中心和被遮挡几何都不提供,需要智能体从可见表面自行推断。
论文用“感知/规划/技能”逐层接管操作环节来定位失败来源,必须知道感知层到底给了什么、没给什么,才能正确解读各层成功率的差异。
实验设计与可辨识性
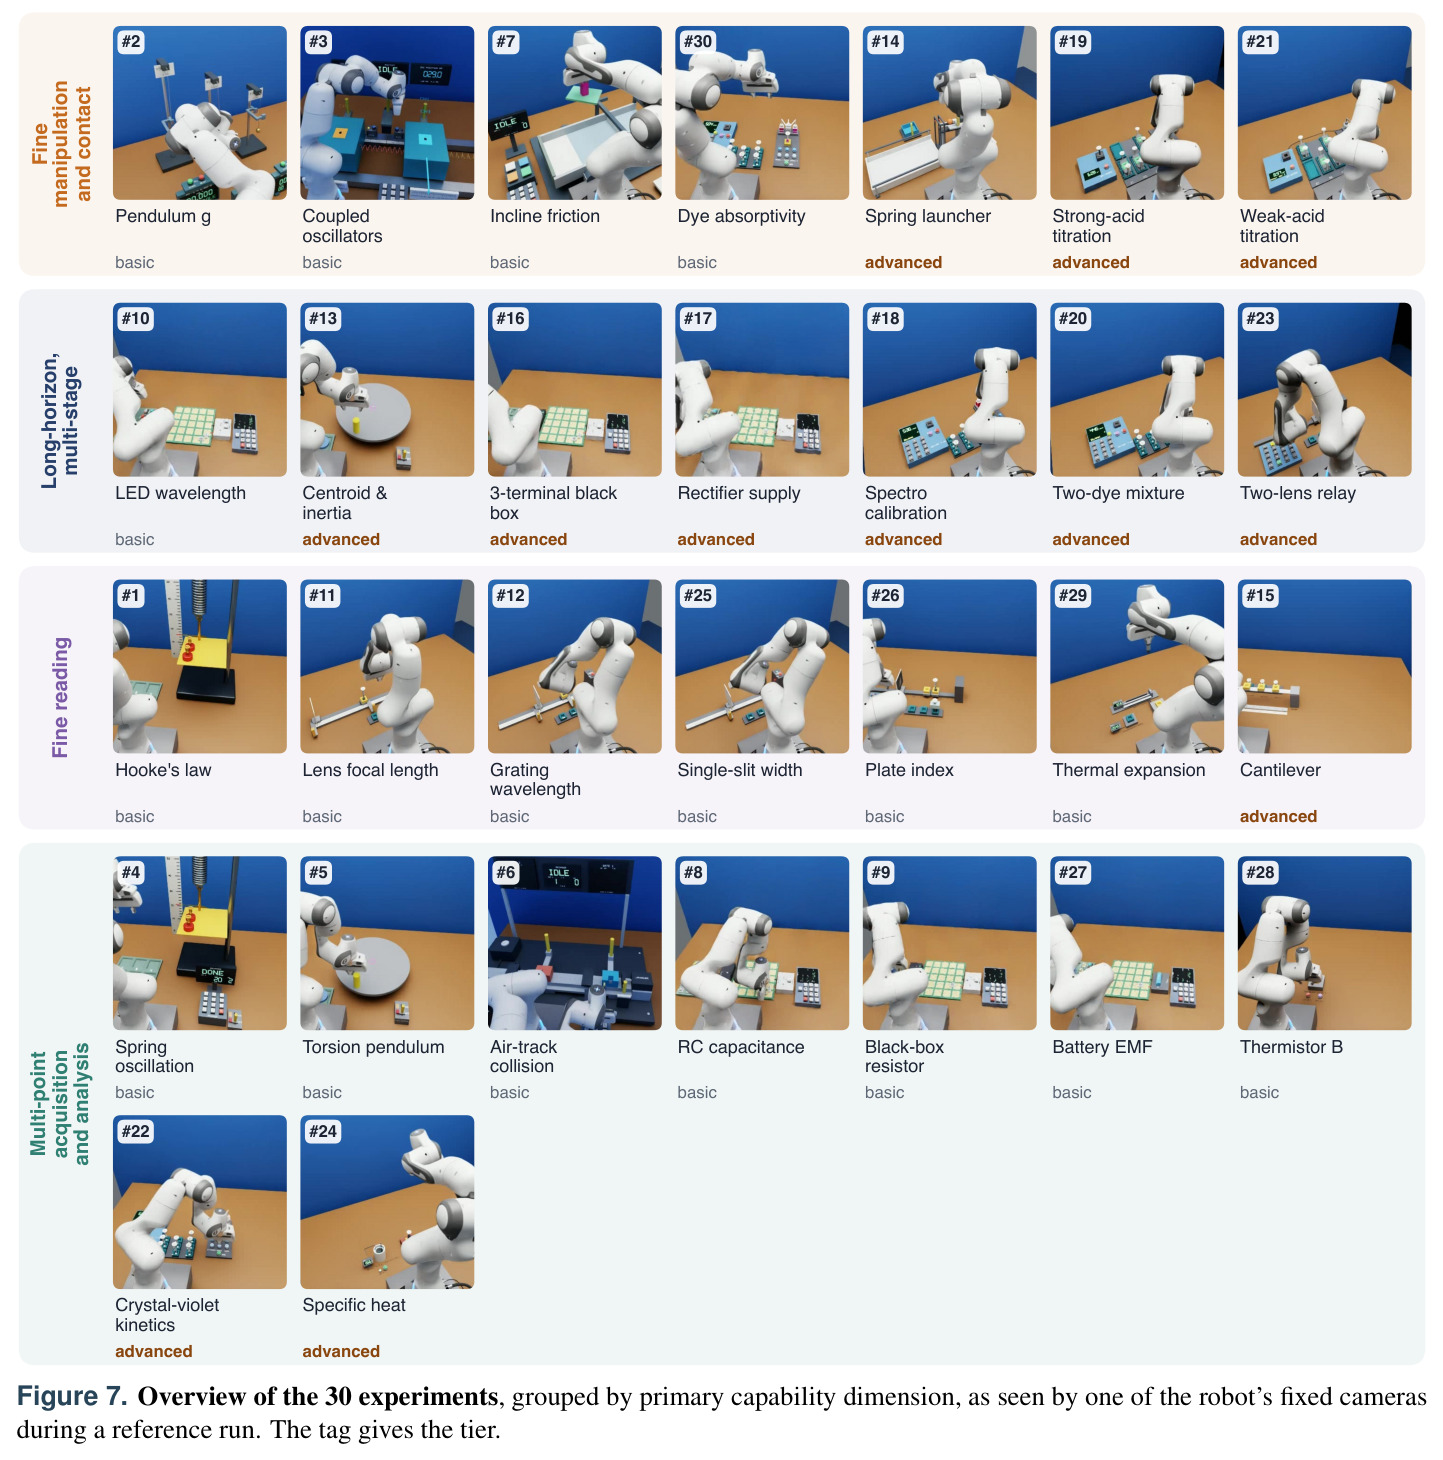
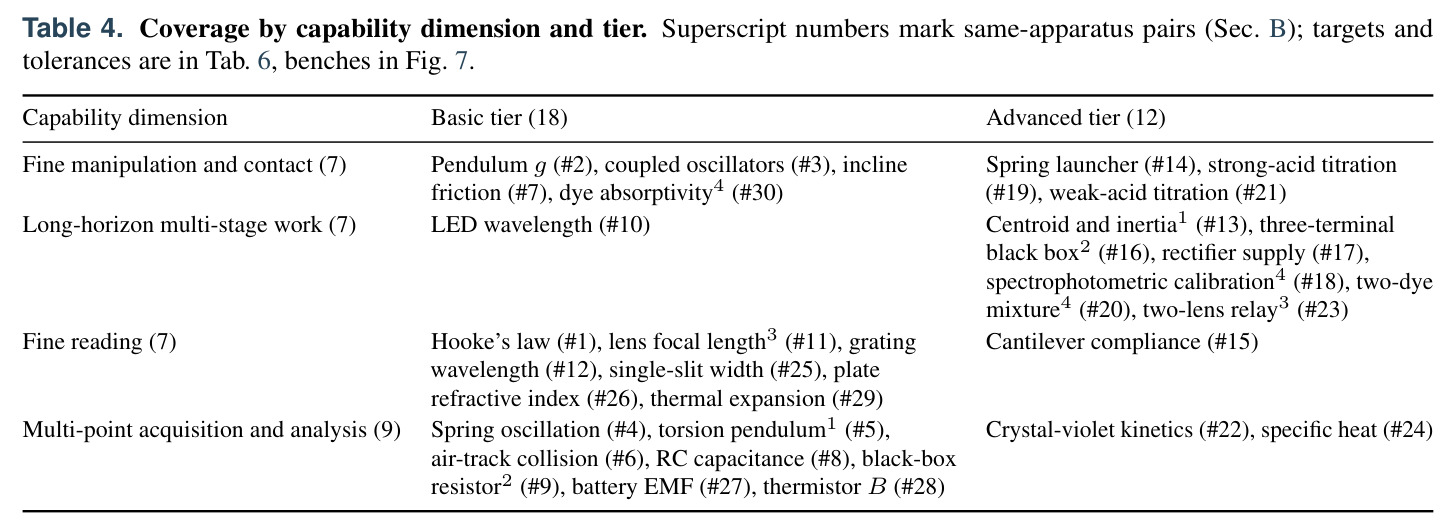
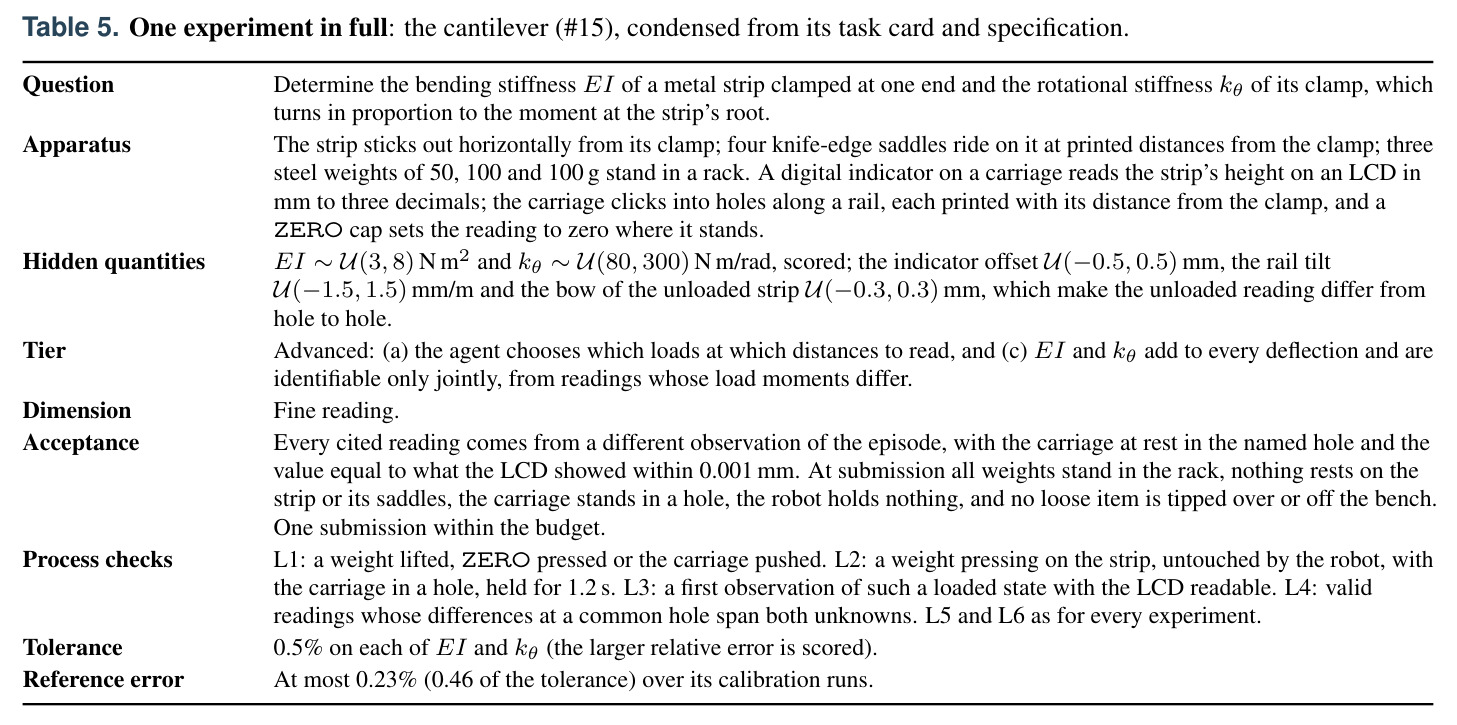
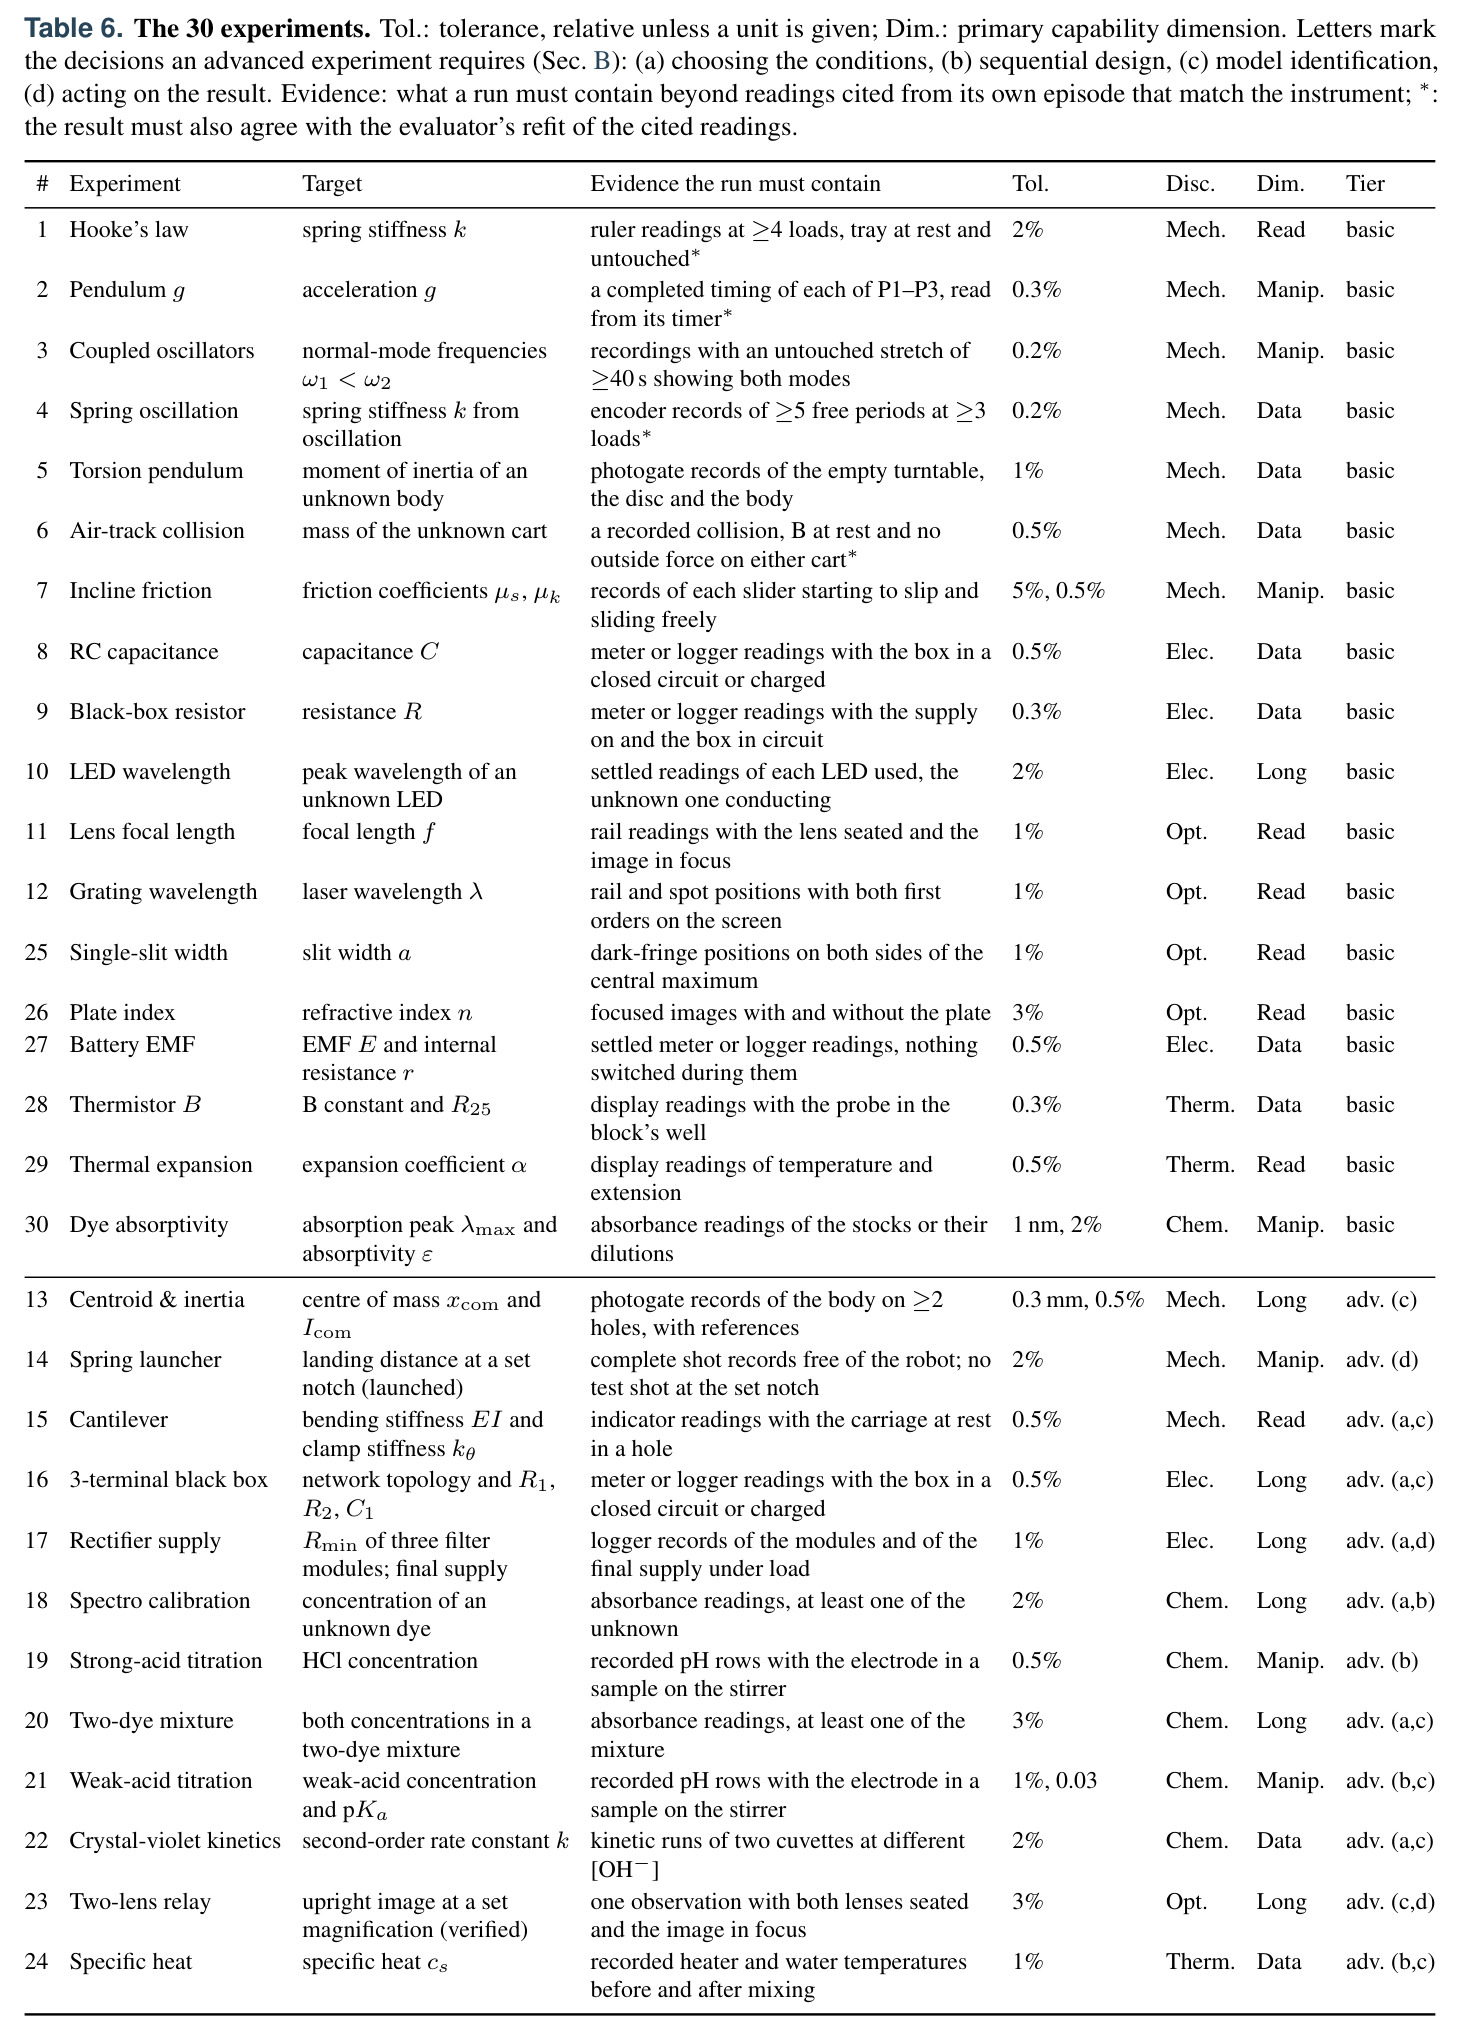
测量设计 ξ 是读取数据的条件序列(挂哪些砝码、屏幕放哪里、扫描哪些波长)。若存在一个与隐藏参数和读数无关、事先固定的标准设计加标准估计器就能达到公差,该实验为 basic;若做不到,则需要四种科学决策之一:(a) 自选条件因为精度或可辨识性依赖设计,(b) 序贯设计即下一步条件取决于已读到的数据,(c) 模型辨识即多个参数只有联合起来才可辨识,(d) 依结果行动即交付物是预测或配置、其物理延续被评分。
basic/advanced 分层与四个“同装备对”(同一平台从 basic 升级到 advanced)是论文量化科学决策难度的工具,也是结果分析的主轴之一。
Isaac Sim 与“物理模型渲染回读”机制
NVIDIA Isaac Sim 是机器人仿真平台,本文用其刚体物理引擎以 240 Hz 计算,配 Franka Panda 机械臂、两指夹爪与三台相机。引擎不覆盖的领域物理——电路(改进节点分析+精确指数时间步进)、光学成像与衍射(近轴光线传输矩阵、Fraunhofer 图样)、热流(集总参数模型)、染料光谱(拟合文献谱的高斯带)、滴定(理想溶液 pH 求解器)——由标准物理模型计算后渲染回场景,使仪器读数真实出现在相机图像的标尺、指针和显示屏上,且带量化与噪声。
理解“模型算物理→渲染进画面→相机读数”这一链条,才能评估该基准的真实性边界、证据门控的可信度以及复现成本。
研究动机
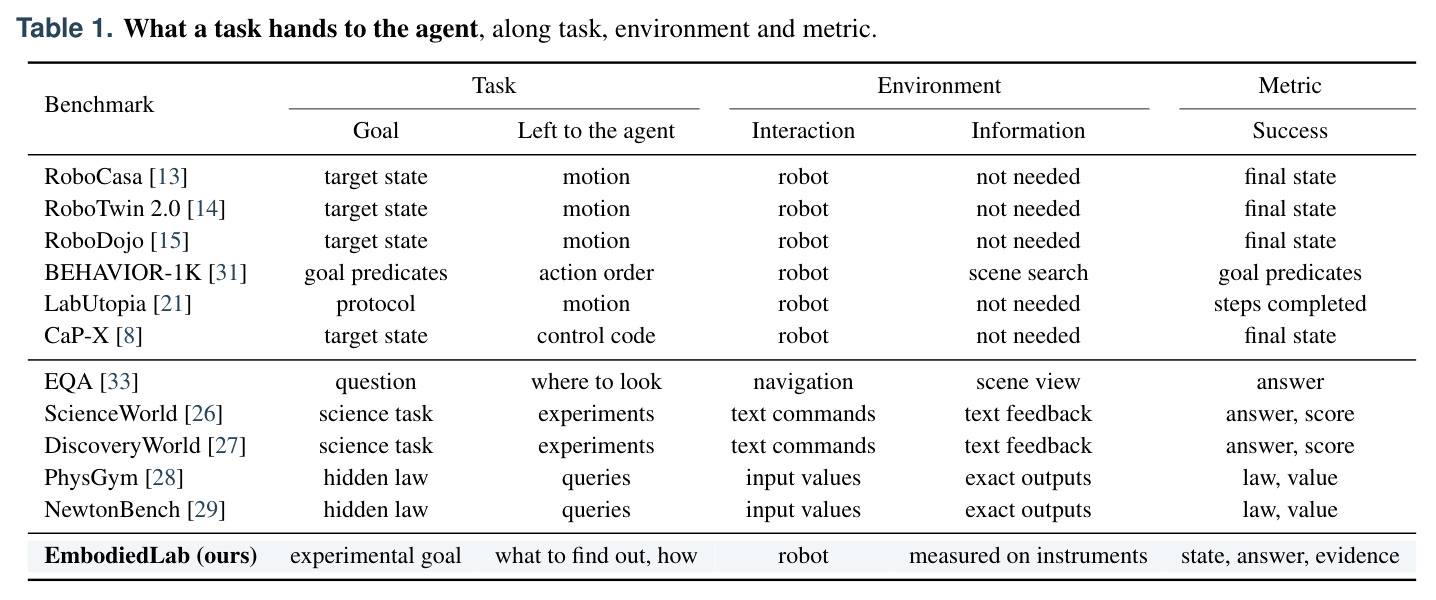
现有基准把“行动”与“求知”拆成了互不相通的两端。一边是操作类基准(RoboCasa、LIBERO、BEHAVIOR-1K、RoboTwin 2.0、RoboDojo,以及 LabUtopia、AutoBio、Pipette、LabDex 等实验室机器人基准):指令直接写明场景应达到的目标状态,评分只看机器人是否把世界变到该状态——目标已知,没有任何东西需要去发现;前沿具身智能体(EmbodiedSWE、RHO、HexaShell、URAI 等)至今仍主要在这类基准上评测。另一边是科学发现类基准(ScienceWorld、DiscoveryWorld、PhysGym、NewtonBench、ActiveSciBench):它们确实要求智能体发现隐藏规律或参数、甚至自行设计实验,但“做实验”只是一条文本命令、一次仪器调用或一组输入数值,结果以文本或精确值返回,智能体与信息之间没有物理动作作中介。然而现实中大量真实目标是两者耦合的:判断一根电线是否带电、找出水泵为何无法启动、把电源调整到能在负载下维持电压——智能体必须先通过交互改变系统的物理状态,观察反馈,再决定下一步;如何行动决定能观察到什么,观察到什么又决定下一步如何行动。没有任何现有基准在这种“物理操作为必经中介”的闭环里评测智能体的求知能力。
本文的目标是本文要为“act to know(以行求知)”建立一个可控、可精确评分的评测基准,并选择定量科学实验作为受控入口:每项任务给出一个关于物理系统的目标——测量某个属性(如透镜焦距)、预测某个响应(如弹簧发射器在设定卡槽下的落点)、或把装置配置到满足规格(如双透镜形成指定放大率的正立像)。设计上有三条硬约束:第一,系统参数 $\theta$ 对智能体隐藏且每个实例重新采样,答案无法提前知道,必须当场在眼前的系统上测出;第二,答案是物理量或物理状态,可以被精确打分,公差由仪器分辨率决定(0.2%–5%);第三,30 个实验(横跨力学、电学、光学、热学、化学五学科,14 个装置平台)每一个都经验证可解——一个不使用语言模型、不接触隐藏参数、只通过公开接口读取仪器的参考解把 30 个全部解出。在此基础上,作者要量化六个前沿模型在各自官方 coding agent 中“以行求知”的能力,并用嵌套接口层级诊断:失败究竟发生在“行动”环节还是“认知”环节。
与已有工作不同的是,本文的独特切入是把“改变物理状态”重新定位为获取信息的必经之路,并用三个相互配套的机制把这种能力变成可测量的对象。其一是任务形式化 $y^* = q(\theta, s_\tau)$:目标同时依赖每实例重采样的隐藏参数 $\theta$ 与智能体离开时留下的状态 $s_\tau$(预测与配置任务在提交后的物理延续运行中测量),因此“知道”与“做到”无法分割。其二是证据门控:提交的结果必须引用本 episode 内仪器真实产生的读数作为证据,实验台必须复原(除目标所需的改动外撤销一切更改),把“你如何得知”和“你把世界留在什么状态”都纳入评分。其三是三层嵌套接口 T0/T1/T2:从原始关节控制,到加入特权感知与无碰撞规划,再到加入从最强智能体成功运行蒸馏的操作技能——由于知识获取始终留给智能体,跨层级成功率之差直接量化了失败中有多少来自“行动”而非“认知”。这个定位既不同于操作基准(不评求知),也不同于科学发现基准(无物理中介),也不同于具身问答与交互式感知(只为收集回答问题所需的视角)。
核心方法
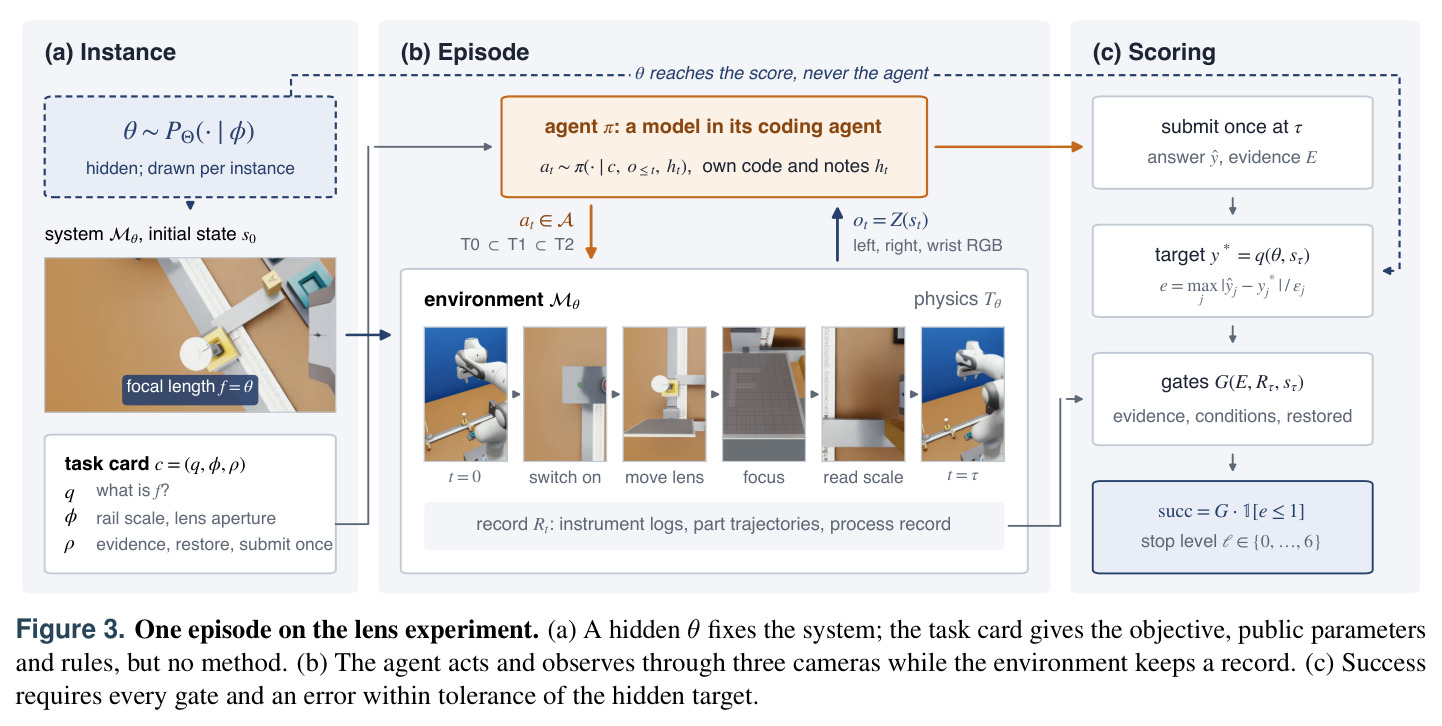
直觉上,EmbodiedLab 就像一场教学实验室的实操考试:考卷(任务卡)只告诉你目标、公开参数和规则,不告诉你方法;考场上仪器、工具、材料比任何一种标准方法所需的都多;你必须亲手接线、按开关、搬砝码、推滑块,从标尺、指针和显示屏上读数,最后交出一个带证据的答案,并把实验台收拾干净。技术上,基准构建在 Isaac Sim 中,每个平台是一个参数化场景,配备 Franka Panda 机械臂、两指夹爪和三台相机(两固定一腕部);刚体力学由物理引擎以 240 Hz 计算,引擎不覆盖的电路、光学、热学、化学由标准物理模型计算并渲染回场景,仪器带量化与噪声,只有真实实验室里记录数据的仪器(如数据记录仪)才导出文件。智能体通过一个小型 Python 客户端行动,在其上自建感知、控制与分析工具;环境全程记录仪器日志、部件轨迹和过程记录 $R_t$。episode 在智能体一次提交结果 $\hat{y}$ 及其引用的证据 $E$ 时结束,评分按 $e = \max_j |\hat{y}_j - y^*_j|/\epsilon_j$ 计算相对误差,并要求门控 $G(E, R_\tau, s_\tau)$ 全部通过:引用读数确实来自本 episode 的仪器、测量条件成立(如托盘静止、温度稳定)、结果与自家引用数据的重新拟合一致、且台面复原。
核心创新是把“以行求知”形式化为一种既有基准结构无法表达的任务类型,并在任务、环境、指标三个层面给出最小充分的设计。任务层面:目标 $y^* = q(\theta, s_\tau)$ 同时依赖每实例重采样的隐藏参数与智能体离开时的状态,答案既不能靠记忆也不能只靠推理,必须通过交互建立。环境层面:实验台像真实教学实验室一样“开放”——仪器冗余(一种方法用不完所有工具)、每个操作都是物理的(拨开关、旋旋钮、用夹爪抓部件)、读数只出现在有量化与噪声的仪器显示上且必须透过相机读取。指标层面:成功不是最终状态匹配,而是三重条件的合取——结果落在仪器决定的公差内、每条引用读数确实产生于本 episode、实验台复原。与已有方法的本质区别在于:操作基准把目标状态写进指令、科学发现基准把物理动作替换为文本查询,而 EmbodiedLab 让“如何行动”决定“能观察到什么”,并让智能体在整个 episode 中对自己造成的每一个物理改变负责——复原台面这一要求,检验的正是长时程中追踪并撤销自身操作的能力。
方法步骤详情
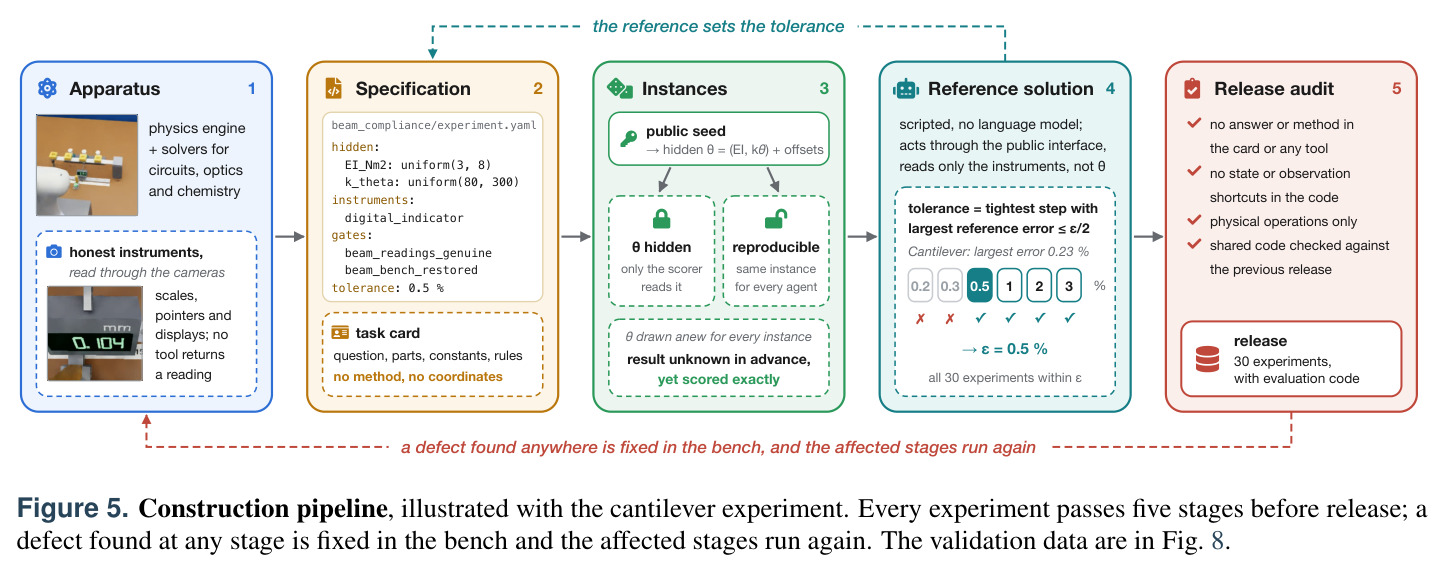
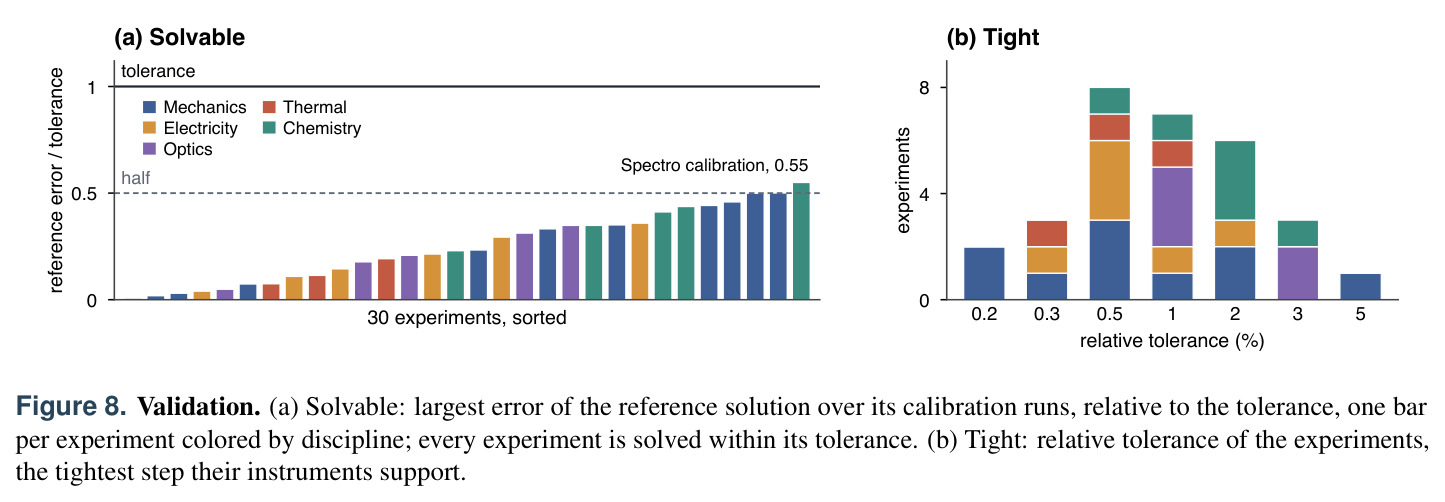
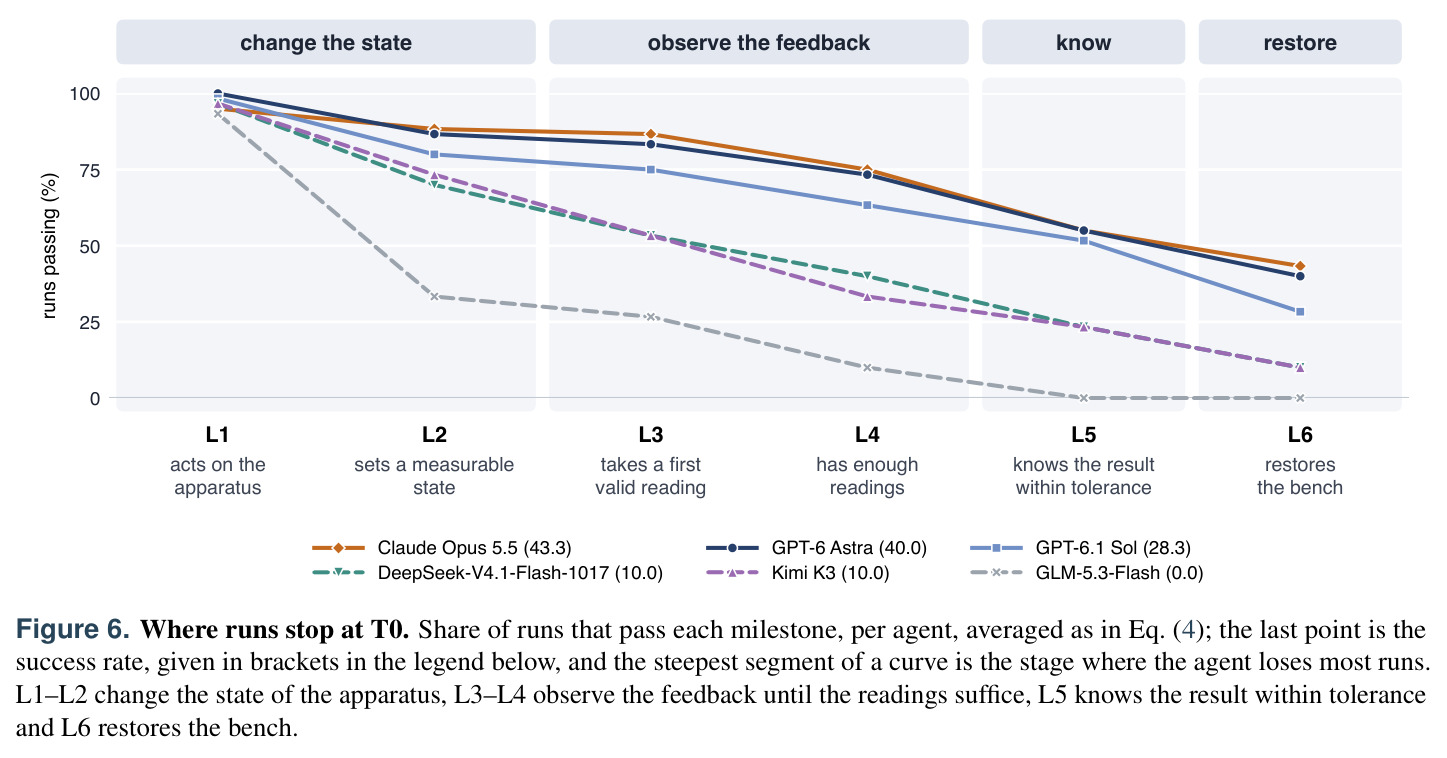
每个实验经五阶段流水线构建并验证:(1) 写声明式规范,明确场景、先验、仪器、门控、里程碑检查、公差、预算与提交 schema;(2) 从公开种子生成实例,隐藏参数每实例重采样(如悬臂实验 $EI \sim U(3,8)\,\mathrm{N\,m^2}$、$k_\theta \sim U(80,300)\,\mathrm{N\,m/rad}$,外加数显表偏移 $U(-0.5,0.5)$ mm、导轨倾斜等干扰参数,使空载读数逐孔不同);(3) 运行参考解——纯脚本、不用语言模型、不知隐藏参数、只通过公开接口读仪器,30 个实验全部解出,验证可解性;(4) 设定公差:取仪器支持且参考误差不超过一半的最紧档位(0.2%/0.3%/0.5%/1%/2%/3%,静摩擦系数 5%;唯一例外是光谱校准达 0.55);(5) 发布审计,任一阶段发现缺陷即修复台面并重跑受影响阶段。评测协议:GPT-6 Astra 与 GPT-6.1 Sol 在 Codex、Claude Opus 5.5 在 Claude Code、DeepSeek-V4.1-Flash-1017 在 DSH、Kimi K3 在 Kimi Code、GLM-5.3-Flash 在 ZCode,各在中等推理档运行;T0/T1 全部评测,DeepSeek/Kimi/GLM 加评 T2。每次运行按六个嵌套里程碑定位停止点(L1 作用于装置→L2 进入可测状态→L3 取得首个有效读数→L4 读数足以支撑所有评分量→L5 结果落在公差内→L6 复原台面),过程分 $PS = \sum_{l=1}^{6} w_l \mathbb{1}[\ell \ge l]$,权重 $(10,10,10,10,30,30)$——结果准确但台面不整洁得 70 分,不知结果的运行最多 40 分;成功率先对每实验的运行取平均、再对实验取平均,保证每个实验权重相等。
技术新颖性
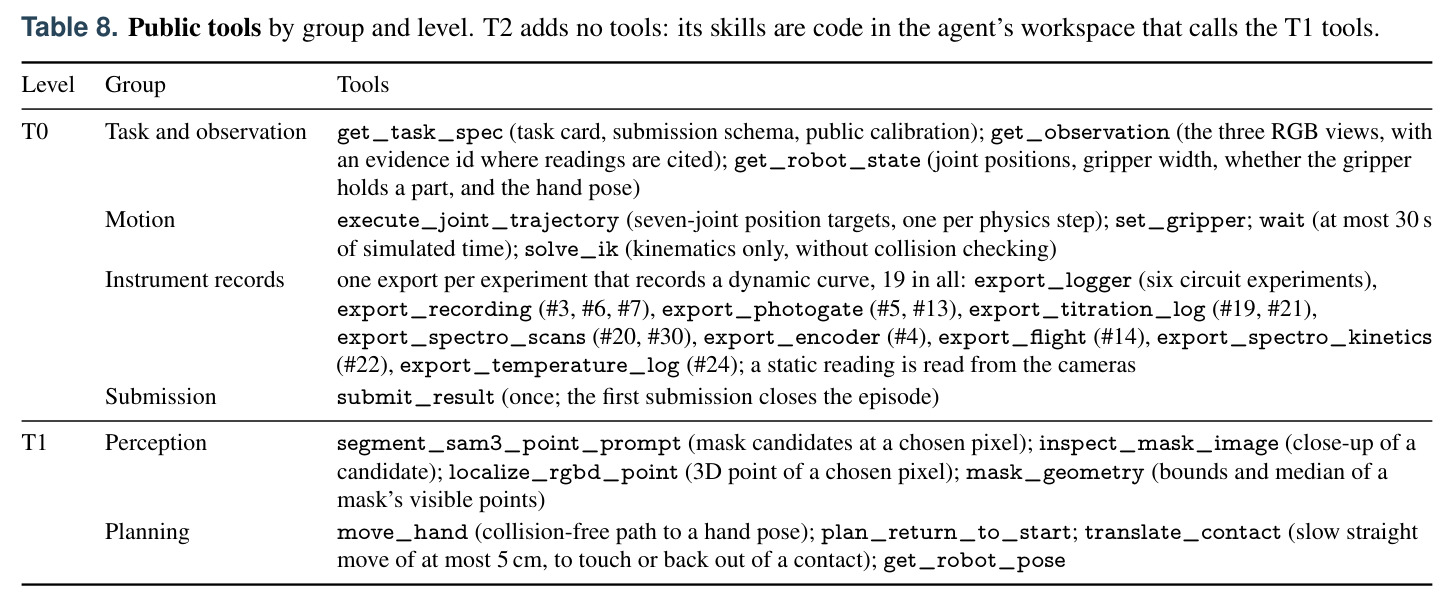
技术新颖性体现在四处。第一,填补任务类型学空缺:Table 1 的系统对比显示,从 RoboCasa 到 CaP-X 的操作基准以“目标状态+最终状态评分”为轴,从 ScienceWorld 到 NewtonBench 的科学发现基准以“查询+精确输出”为轴,而 EmbodiedLab 是唯一同时具备“实验目标、由智能体决定发现什么与如何行动、机器人交互、仪器实测信息、状态+答案+证据三重评分”的工作。第二,公差不是人为设定而是被仪器的量化与噪声“顶”出来的,并由无 LLM 的参考解校验(参考误差普遍不超过公差一半),杜绝用宽松公差放水或出不可解任务。第三,失败定位方法学:把成功分解为 $\Pr[\text{succ}] = \prod_{l} \pi_l$,可以计算每个环节的条件通过率 $\pi_l$,找出限制每个智能体的阶段;失败归因采用“首个不纠正即无法成功的决定性错误”准则,排除已纠正的错误和末端症状。第四,T2 技能库是从最强智能体成功运行蒸馏出的公开 T1 调用短序列(智能体可读可改),这与预训练操作策略不同,干净地隔离了“操作技能”这一单一因素对求知任务的贡献。
实验结果
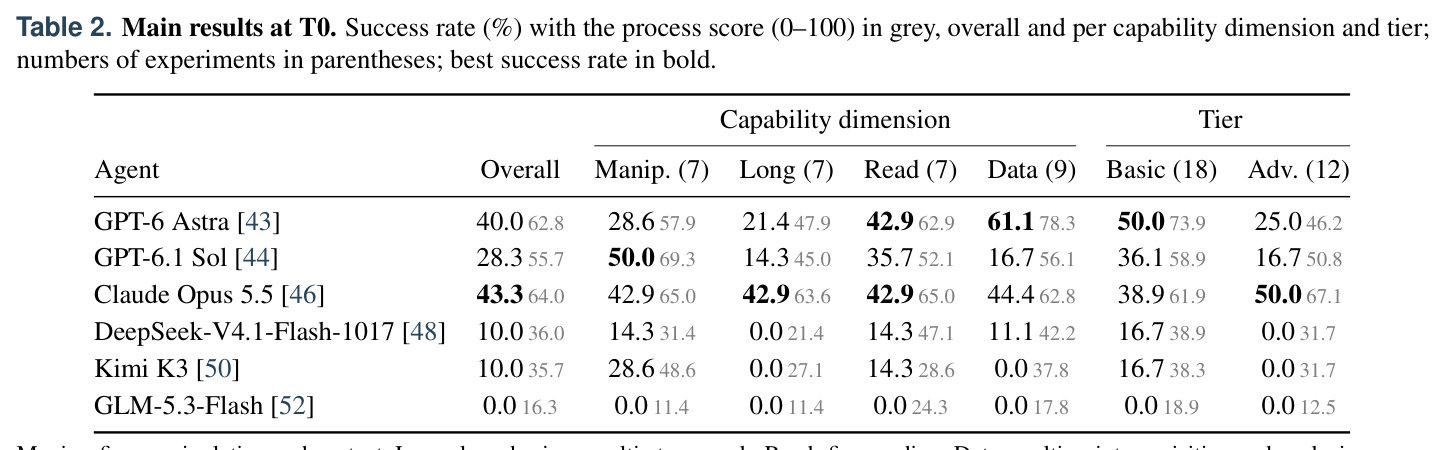
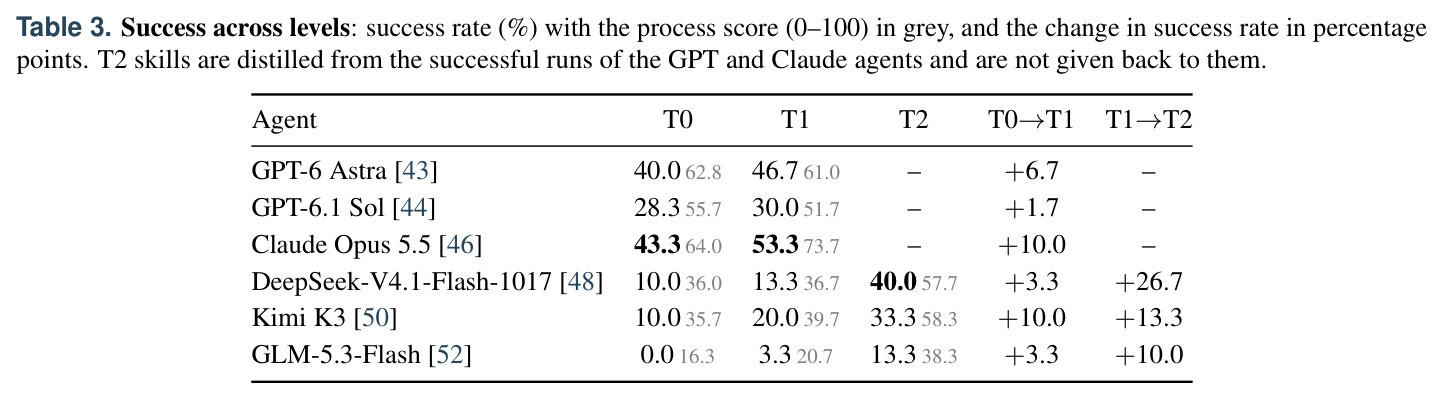
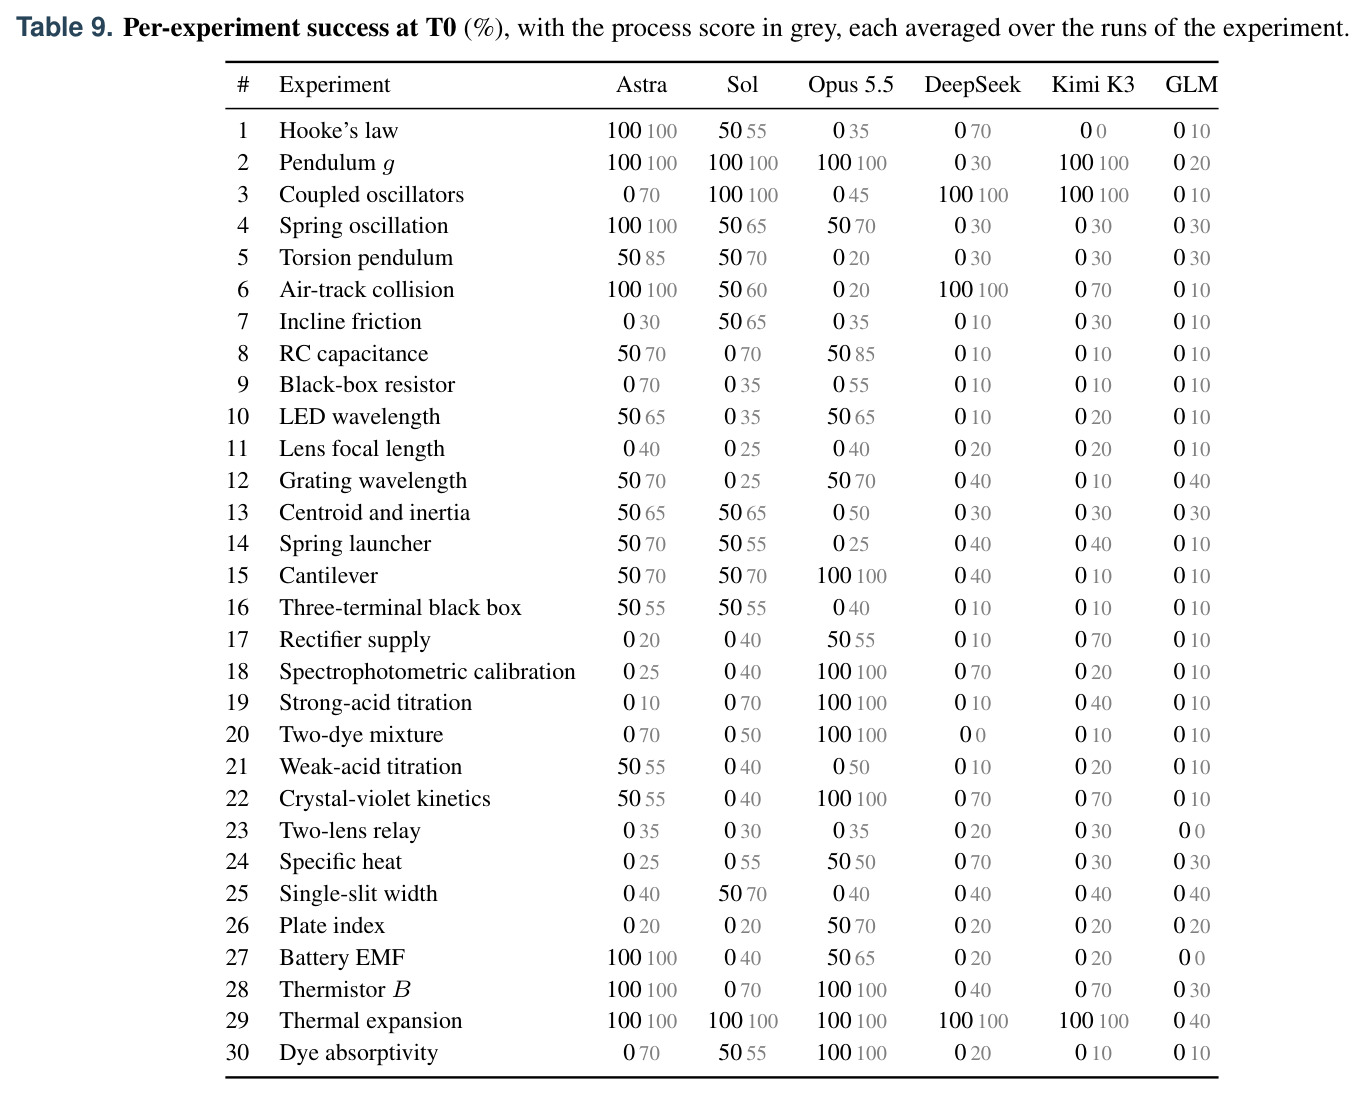
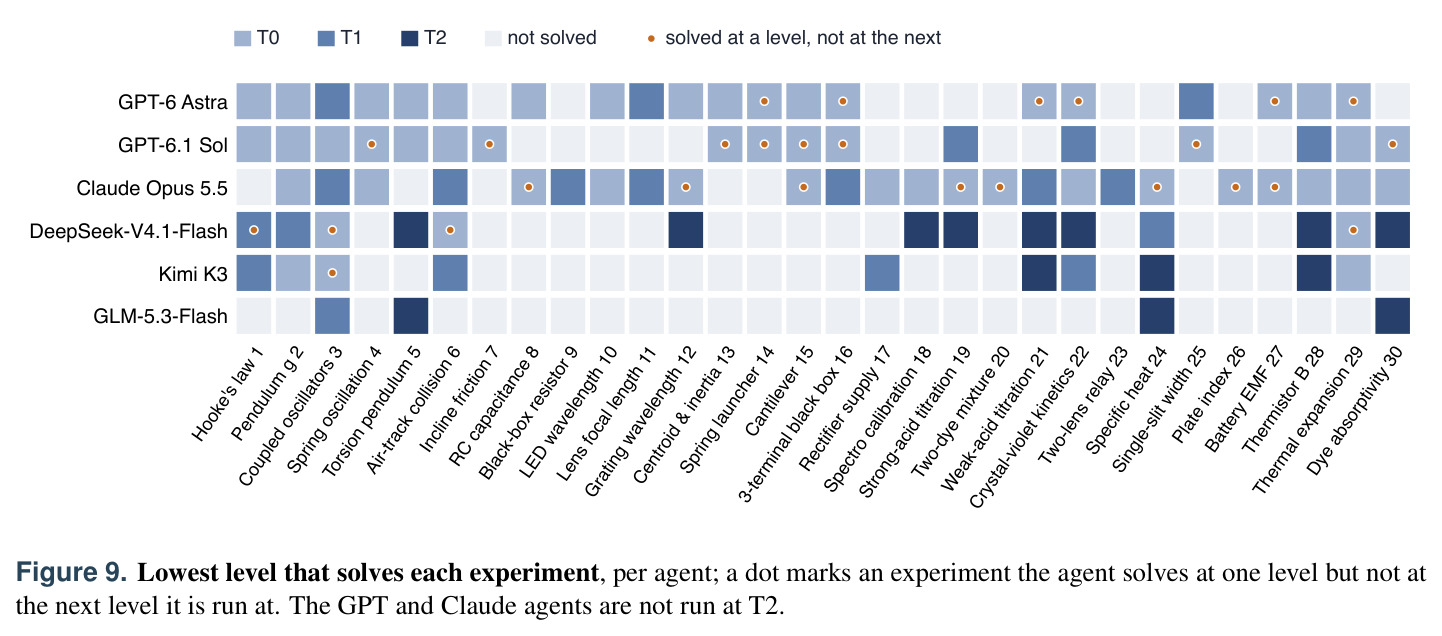
T0(原生控制)主结果:Claude Opus 5.5 以 43.3% 成功率居首(过程分 64.0),GPT-6 Astra 40.0%(62.8),GPT-6.1 Sol 28.3%(55.7),DeepSeek-V4.1-Flash 与 Kimi K3 各 10.0%,GLM-5.3-Flash 0%;弱三个模型没有一个解出任何 advanced 实验。能力维度上,两个 GPT 模型在长时程多阶段任务上最弱(21.4% 与 14.3%),GPT-6.1 Sol 在多点采集分析上也只有 16.7%;Claude Opus 5.5 在所有维度达 42.9%–44.4%,且是唯一在 advanced(50.0%)上高于 basic(38.9%)的模型。30 个实验中 27 个至少被一个模型解出;黑盒电阻、透镜焦距、双透镜中继在 T0 无人解出(Claude 在 T1 补齐)。里程碑分析:三个最强模型通过 L1–L4 的比率为 0.81–1.00,最低的阶段通过率出现在 L5 知道结果(0.73–0.82)与 L6 复原(0.55–0.79);GPT-6.1 Sol 有 23% 的运行在结果准确后未复原台面;三个最强模型“知道结果”的比率接近(51.7%–55.0%),复原台面才是它们成功率的分水岭。弱三个模型分别有 60%(DeepSeek)、67%(Kimi)、90%(GLM)的运行在改变状态或观察阶段就停止。层级对比:T0→T1 只带来 1.7–10.0 点提升(提升来自观察环节,如 GPT-6 Astra 精细读数从 42.9% 升至 71.4%),而 T1→T2 带来 10.0–26.7 点提升,DeepSeek 在 T2 达 40.0%,追平 GPT-6 Astra 的 T0 水平;但拿到技能的三个模型 L4 完成率仍只有 47%–77%(Claude T1 为 90%),长时程维度最高只到 14.3%。失败归因:行动类是每个模型最大的失败组,行动+观察+复原合计占失败运行的 75%–100%,认知类最多 25%;弱三个模型 64%–69% 的失败归于行动(其中接触类单独占 45%–62%:夹爪打滑、部件倾倒、按键没按到);Claude Opus 5.5 的失败中 23% 来自读错仪表数字(如电流表实显 1.0969 mA 被读成 1.0369 mA),是其第二大原因;GPT-6 Astra 有 19% 的失败是过早停止(屏幕上只有一个光斑却提交了条纹位置)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 30 个定量实验总体(T0 原生控制) | 成功率(%,过程分 0–100) | Claude Opus 5.5:43.3(64.0) | 次优 GPT-6 Astra:40.0(62.8);GPT-6.1 Sol 28.3;DeepSeek/Kimi 各 10.0;GLM 0.0 | 最强领先次优 +3.3 点;领先弱三模型 +33.3 至 +43.3 点 |
| advanced 层级实验(12 个) | 成功率 | Claude Opus 5.5:50.0 | GPT-6 Astra:25.0;GPT-6.1 Sol:16.7;DeepSeek/Kimi/GLM:0.0 | +25.0 点(vs 次优) |
| T0→T1(加特权感知与无碰撞规划) | 成功率变化 | +1.7 至 +10.0 点(GPT-6 Astra 精细读数 42.9→71.4) | 各模型 T0 成功率 | 最多 +10.0 点,帮助有限 |
| T1→T2(加蒸馏操作技能,仅弱三模型) | 成功率变化 | DeepSeek 13.3→40.0;Kimi 20.0→33.3;GLM 3.3→13.3 | 各模型 T1 成功率 | +10.0 至 +26.7 点,DeepSeek 追平 GPT-6 Astra 的 T0 |
| 失败原因构成(T0,按首个决定性错误归因) | 失败运行占比 | 行动+观察+复原合计 75%–100% | 认知类(流程/分析/停止)最多 25% | 证明瓶颈在物理交互而非推理 |
局限与改进
作者明确承认的局限:T2 的技能从同一批实验的成功运行蒸馏而来,T2 运行部分复用了已知解,因此只作诊断层级、不进入发布协议;基准在 Isaac Sim 仿真中运行,与真实实验室存在差距。我自己的观察:其一,物理保真度有限——电路用改进节点分析、光学用近轴光线矩阵、热用集总参数模型、滴定用理想溶液求解器,都是教科书级理想化模型,未验证仿真到现实的迁移。其二,样本量小:多数实验每模型约 6 次运行,成功率呈 0%/16.7%/33.3%/50% 等粗粒度跳变,43.3% 对 40.0% 的领先难以说具有统计显著性,论文未报告置信区间。其三,评测绑定“模型+其官方 coding agent”的组合,模型与 harness 的贡献无法分离;推理档统一为“中等”,可能低估某些模型在高推理档的表现。其四,复原门控要求所有非目标部件回到指定位置,对部分真实科研场景未必必要,可能放大“tidy”类失败占比。其五,30 个实验全部源自教科书物理/化学,方法空间有界,未覆盖需要跨装置组合或真正开放式探究的任务。
独立分析的弱点
第一,sim-to-real 缺口:所有结论建立在 Isaac Sim 与理想化物理模型之上,论文未做任何真机验证;真实仪器的眩光、视差和接触非线性会让“读数”与“接触”这两大失败源更严重。改进方向:释放一个小型真机子集(如 3–5 个实验),或至少做域随机化与渲染扰动实验来量化脆弱性。第二,统计功效不足:每实验约 6 次运行、成功率粒度粗,模型间 3–5 点的差距缺乏意义。改进方向:公布更多种子实例与运行次数,报告 bootstrap 置信区间。第三,模型与 harness 混杂:Claude 的领先可能部分来自 Claude Code 的工具编排而非模型本身。改进方向:同一 harness 交叉托管多个模型,或开源统一 harness 供横向比较。第四,T2 技能可能泄露任务特定解:技能蒸馏自同一实验的成功运行,“技能帮助弱者最多”的结论可能反映记忆而非泛化。改进方向:从其他实验蒸馏技能,测试跨任务迁移。第五,能力维度按主维度单一归类,而滴定等实验同时考验精细操作与序贯设计,交叉失败模式可能被低估。改进方向:允许多标签归因。第六,一次提交机制干净但与真实科研“边测边修正”的流程不符,可考虑允许带罚分的多次提交。
未来方向
作者方向:以该开源基准追踪具身智能体“以行求知”能力的进展。基于其成果可延伸的方向:(1) 把失败归因用于训练——沿 T2 技能蒸馏思路从大规模成功轨迹学习操作技能库,或用里程碑与过程分作为密集奖励做强化学习;(2) 仪表读数专门化——Claude 23% 的失败来自读错数字,说明需要针对标尺/指针/七段显示的视觉读数模块或数据增强;(3) 状态追踪与复原的记忆机制——L6 是强模型的主要流失点($\pi_6$ 仅 0.55–0.79),可引入显式“更改账本”让代码自动记录并撤销自身操作;(4) 序贯实验设计能力——advanced 需要自选条件、依读数定下一步、联合可辨识、依结果行动,与 basic 的成功率分化(50.0% 对 38.9% 仅 Claude 一家反超)表明主动实验设计是前沿模型的真实短板,值得专项训练;(5) 扩展学科与开放度——加入跨装置、多假设的开放式探究任务与真机版本;(6) 研究操作技能的跨模型共享与泛化边界。
复现评估
复现基础较好:基准与评估代码已在 GitHub(HexaFuture/EmbodiedLab)开源,30 个实验均以任务卡(给智能体)+ 声明式规范(给评估器)双形式发布,参考解与验证数据(Fig. 8 的可解性与公差分布)公开,可离线核验每个实验的可解性与评分公平性。算力需求:Isaac Sim 加单块 GPU 即可运行环境;每实验仿真预算 200–1500 仿真秒(按物理步计费),另有墙钟限制。主要成本在前沿模型 API:完整复现六模型 × 30 实验 × T0/T1(弱三模型加 T2)需要各开发商 coding agent 与大量 API 调用——强模型单次运行需数百轮工具调用,成本可观;弱模型失败早、消耗少。难度评估:环境侧复现(装 Isaac Sim、跑参考解、验证门控)属中等难度;模型侧复现受 API 可用性与 coding agent 版本漂移影响,数值可能有小幅出入。对使用 DeepSeek/Kimi/GLM 的开发者而言复现门槛最低,因其可经开源 harness 运行。
论文图表
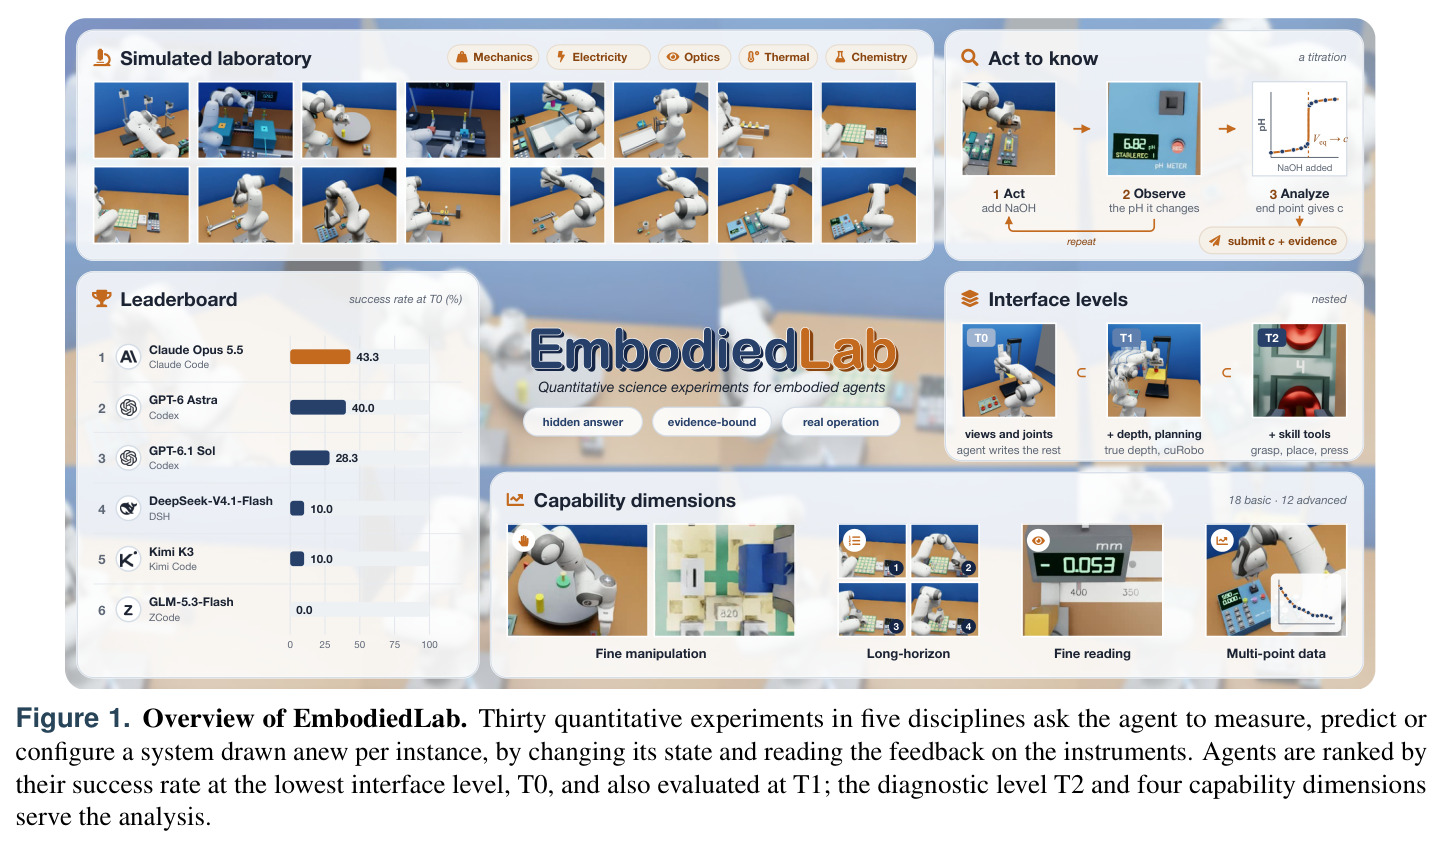
上排是仿真实验室场景与力学/电学/光学/热学/化学五个学科徽章及滴定实验示意;左下是 T0 排行榜(Claude Opus 5.5 43.3%、GPT-6 Astra 40.0%、GPT-6.1 Sol 28.3%、DeepSeek 与 Kimi 各 10.0%、GLM 0%);右侧是三层嵌套接口 T0⊂T1⊂T2 的构成与四个能力维度图标。
一图给出论文全貌:任务定义、排行榜、接口层级与分析维度,是进入全文的地图。
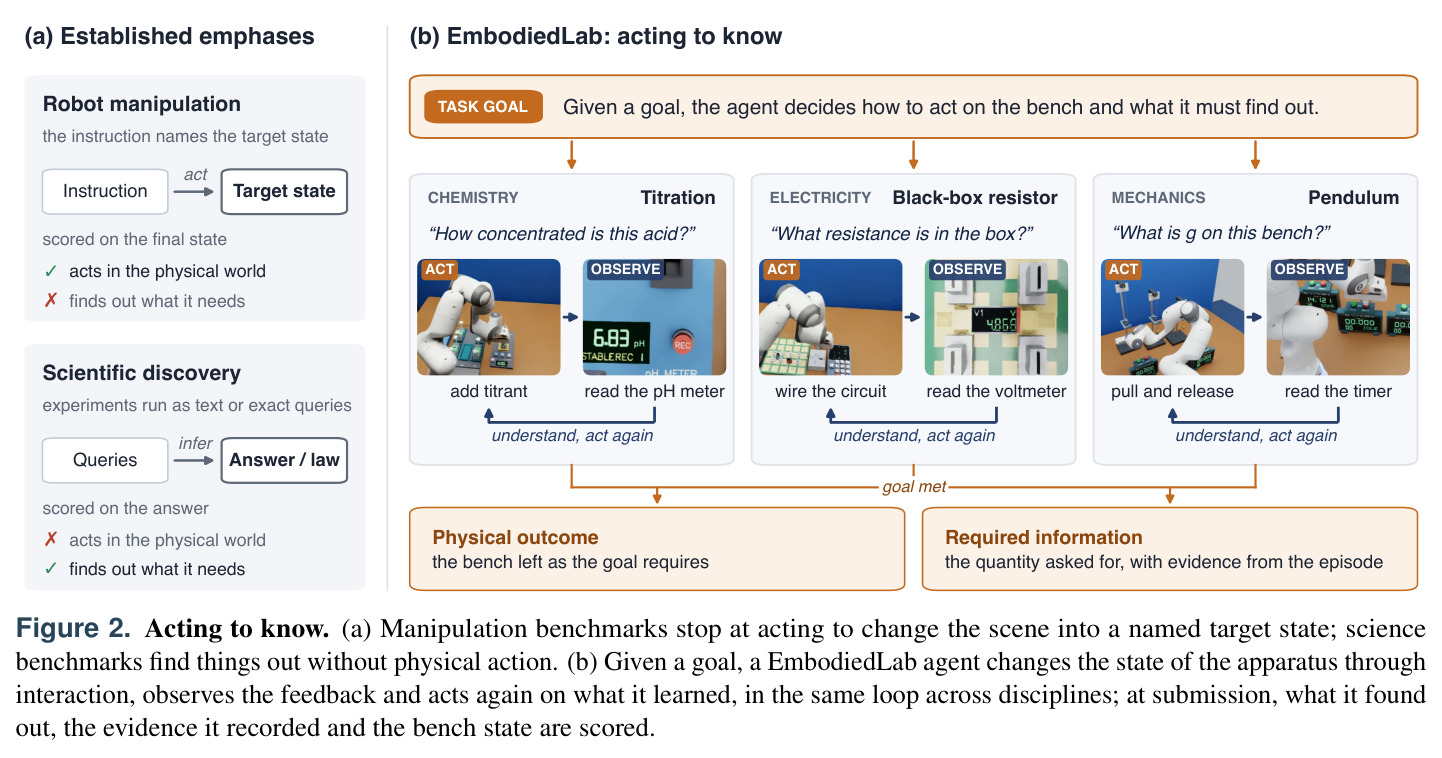
(a) 对比两类既有基准:机器人操作(指令命名目标状态、按最终状态评分、不要求发现)与科学发现(查询-答案、按答案评分、无物理动作);(b) 展示 EmbodiedLab 中智能体在滴定、黑盒电阻、单摆测 g 三个学科里“行动→观察→再行动”的闭环,提交时同时评分物理结果(台面状态)与所需信息(带本 episode 证据)。
这是论文的概念核心图,直观说明“以行求知”任务类型与两类既有基准的本质区别。
(a) 按首个决定性错误归因的失败分布:行动(移动/接触)、观察(定位/读数)、认知(流程/分析/停止)、复原(整洁)。弱三模型的接触类占 45%–62%,强三模型的复原类占 25%–33%,Claude 的读数错误占 23%。(b) 每阶段五个典型案例,配智能体自己的相机帧并圈出决定性位置:砝码读错、比色皿释放时倾倒、屏幕无条纹却提交、导轨滑块读数差 40 mm 等。
失败归因是“瓶颈在交互而非推理”结论的证据基础,具体案例让抽象分类变得可感知。