VA-Bench:通过视觉演示、主动感知与度量控制评测具身空间智能 VABench: Measuring Embodied Spatial Intelligence through Visual Demonstrations, Active Perception, and Metric Control
评测多模态大模型能否在观察-推理-行动-修正闭环中完成机器人操作
前置知识
MLLM(多模态大语言模型)
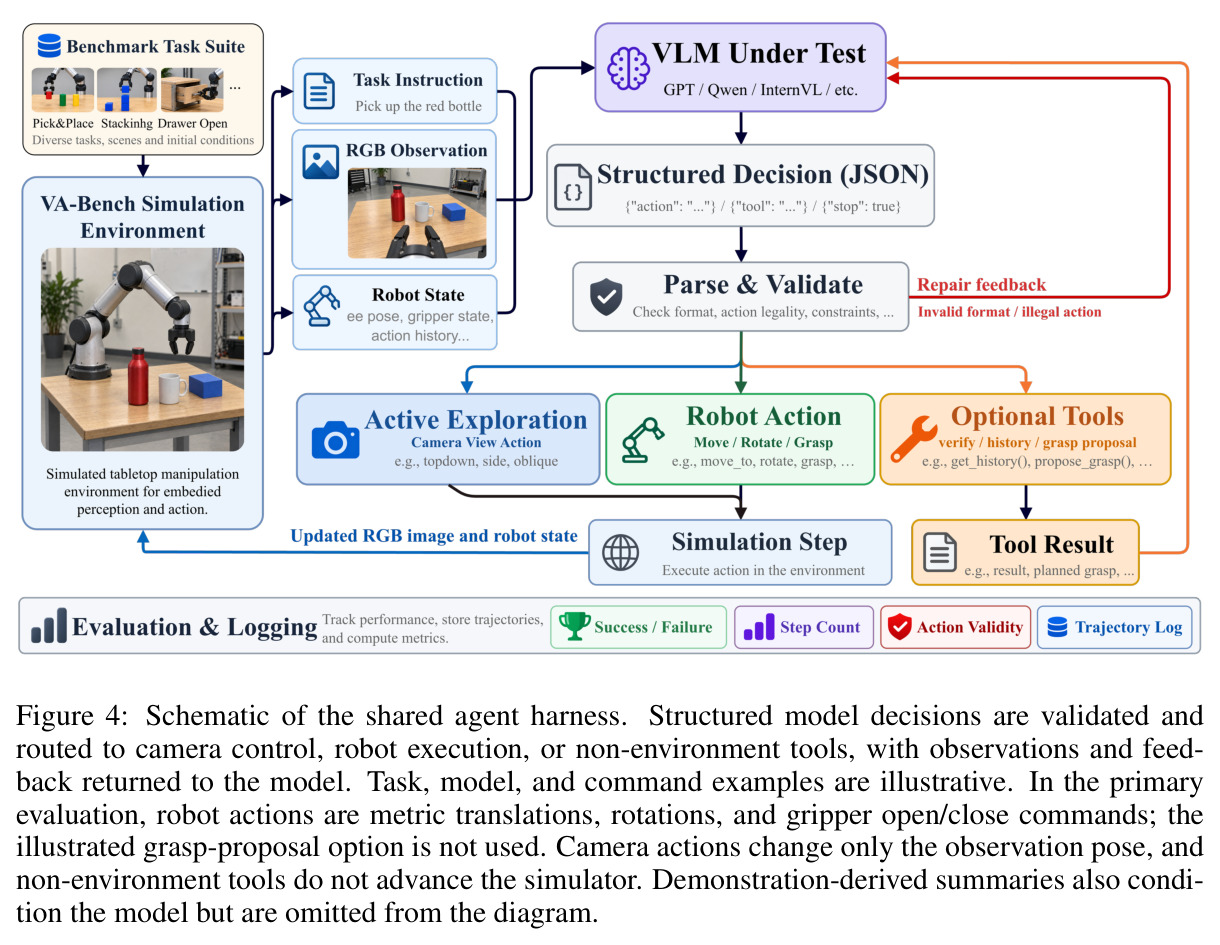
同时接收图像与文本、输出文本或结构化决策的通用大模型(如 GPT、Claude、Gemini、Qwen-VL 系列)。在 VA-Bench 中 MLLM 充当机器人“大脑”:每一步它接收当前 RGB 图像、过滤后的本体感知(末端位姿、夹爪开合、指心中点 GC、世界系夹爪局部轴)、交互历史与上一步动作/规划反馈,输出一个 JSON 格式的相机动作、机器人动作、工具调用或停止决定,且拿不到物体位姿、深度、分割或相机标定。
本文的评测对象正是通用 MLLM 而非专用 VLA 策略:理解 MLLM 如何被封装成具身智能体、它的 JSON 决策如何被固定执行器消费,是读懂基准协议与 12 个模型条件对比的前提。
主动感知(Active Perception)
智能体不被动接受固定观测,而是主动决定“往哪看”,以获取对当前决策最有诊断价值的证据;思想源于 Bajcsy (1988) 与 next-best-view 规划。在 VA-Bench 中体现为以夹爪中心为锚点的 5 个语义视角(topdown、side、front-side 45°、side-top 45°、oblique 45°)加上有界增量动作(平移 5 cm、缩放 8 cm、偏航/俯仰 10°),且“看”与“动”消耗同一回合预算。
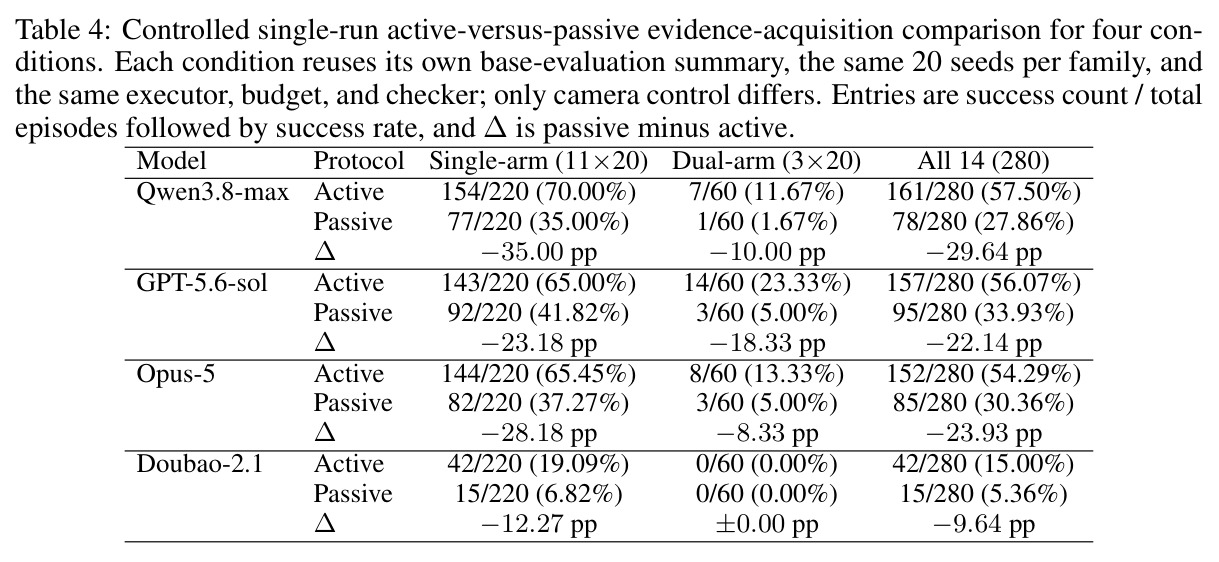
主动 vs 被动的消融是论文三大发现之一:关闭相机控制、换成被动五视图后,四个模型成功率下降 9.64–29.64 个百分点,说明“主动决定看哪里”无法被更广的被动覆盖替代。
末端执行器度量控制(笛卡尔命令)
机器人控制的接口层次:直接指定末端执行器在世界坐标系下的位姿增量,由底层固定的逆运动学(IK)与轨迹层求解关节运动。VA-Bench 暴露数值参数化命令:世界轴平移 $\sigma d$($d\in[1,100]$ mm)、绕夹爪局部轴旋转($\alpha\in[1,90]°$)、夹爪开合,双臂任务另支持同步平移与同步开合;所有数值由模型自己生成,而非从预定义菜单挑选。
把像素级观察翻译成带符号、带量纲的世界坐标动作,是本文“空间理解→可执行动作”的核心鸿沟,也是与仅输出符号答案的空间问答基准的本质区别。
部分可观测性与闭环决策
智能体只能获得局部观测,且每个动作都会改变下一步的证据:相机移动改变图像坐标但不改变世界系控制,机械臂推动物体会让旧观测失效。形式化上,机器人动作使状态转移 $x_{t+1}=T_\tau(x_t,a_t)$,相机动作保持 $x_{t+1}=x_t$;每步观测为 $o_t=(I_t,p_t,h_t,f_{t-1})$,回合在预算 $B_\tau$ 内由物理成功谓词 $\varphi_\tau$ 判定。
论文要检验的正是模型能否独立闭合“观察-推理-行动-修正”环路:识别缺失了什么证据、主动补齐、并把执行反馈纳入下一步决策——这与单轮问答式评测有根本差异。
演示条件化(Demonstration-Conditioned Re-grounding)
从一段仅含 RGB 的成功执行视频中抽取多帧,写成结构化文字总结 $s_{m,\tau}$(抓取区域、接近方向、手臂分工、协调顺序、完成条件等)作为任务级程序性上下文;它不含机器可读动作、位姿或接触标签,也不含当前测试种子的度量解,模型必须在新场景重新落地该流程并生成全部数值参数。
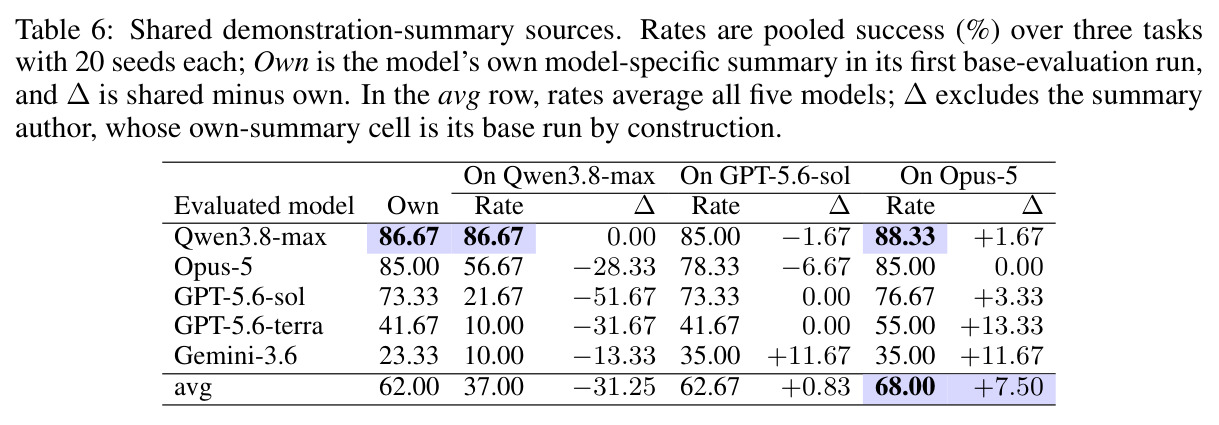
这区别于模仿学习:演示是“经验”而非训练信号,评测的是流程解读加实例化重落地;第 5.2 节的摘要源消融(换摘要最多掉 51.67 个百分点)也建立在这个概念上。
研究动机
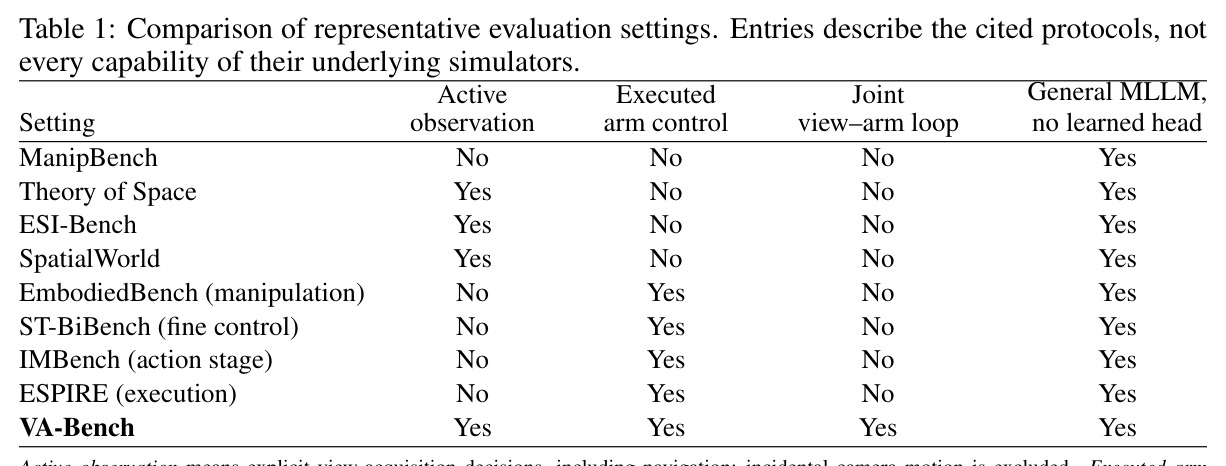
现有空间智能评测大多停留在“看图说话”层面:CLEVR/GQA、SpatialVLM、CV-Bench、BLINK 等用静态图像或预先给定的多视图测空间关系与深度估计,模型说对“杯子在碗左边”并不代表它对机器人-物体几何的估计精确到足以支撑接触式操作;ManipBench 把诊断拉近操作,但仍是在给定观察上做低级推理、没有交互执行环。另一条线让探索交互化:Theory of Space、ESI-Bench、SpatialWorld 评测主动探索下的空间信念或高层任务决策,却不要求把证据落地为度量末端控制;EmbodiedBench 的操作设置提供固定前视图加物体 3D 坐标标注,ST-BiBench 依赖辅助真值位姿,IMBench 用参数化运动原语,ESPIRE 靠深度把图像坐标提升到机器人位姿——都依赖某种结构化空间信息或预定义执行组件。换言之,证据获取、空间推理与动作执行在现有评测中是彼此解耦的;而在真实操作中,视角、距离与遮挡使单视图内的度量关系本质欠定,像素位移本身并不能决定世界坐标中的运动。
本文的目标是本文构建并运行物理仿真基准 VA-Bench,在单一闭环交互中同时评测四件事:解读 RGB 演示视频得到程序性上下文、主动选择相机视角补齐缺失证据、生成度量化的单/双臂笛卡尔命令、并根据执行反馈在线修正。评测对象是不带任何学习型动作头的通用 MLLM:模型拿不到特权物体位姿、oracle 轨迹或任务路标点,只由一个固定的模型无关执行器负责可达性检查与轨迹执行。基准包含 14 个基础任务族(11 单臂 + 3 双臂)、7 个改变几何/容器/布局的 held-out 迁移变体和一个五物体长时程组合任务;每个条件在相同的 20 个物理验证种子上跑 3 次独立运行(每条件 840 个 run–seed 回合),以物理检查器的终端成功为主指标,辅以 9 项人工标注的轨迹级行为诊断与子任务进度,用来在闭环内定位失败发生的位置。
与已有工作不同的是,独特切入是把“视角”与“手臂”耦合进同一个决策环路:相机动作与机器人动作消耗同一回合预算,“看”成为与“动”同级的显式选择,而被动五视图恰好是主动模式可达视角的严格子集,使对照天然公平。与论文表 1 对比,VA-Bench 是唯一同时满足主动观测、执行臂控制、联合视角-手臂环、通用 MLLM 且无学习动作头的评测设置。此外它把演示当程序性上下文而非训练信号,要求模型在新种子上重落地并自己产生全部数值动作参数(而非菜单选择或参数化原语);严格的特权信息边界(无位姿、深度、分割、标定、路标点)配合条件通过率 88.1% 的种子物理验证协议(318 个候选被实例化探查、保留 280 个,全部带完整专家执行验证),让“能说”与“能做”第一次在同一协议下被同时打分。
核心方法
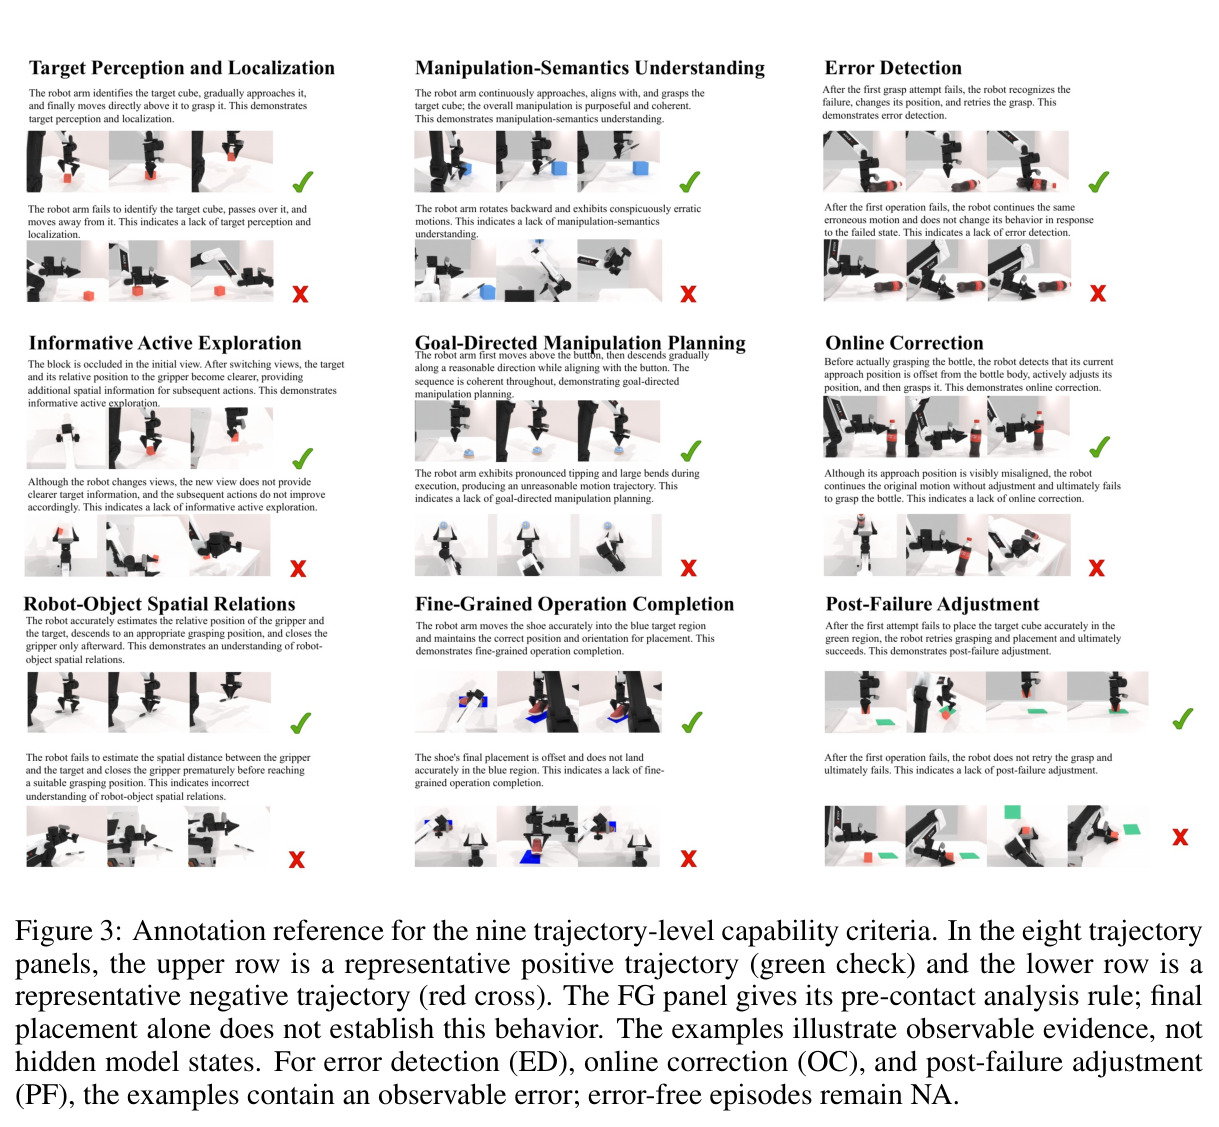
直觉上,VA-Bench 把被测模型放进 RoboTwin 物理仿真中的机器人身体,让它先看示范视频学流程,再在陌生场景里边看边做边改。技术上,每个评测实例定义为 $z=(\tau,\xi,g_{\tau,\xi},D_\tau,B_\tau,\varphi_\tau)$:任务族 $\tau$、场景种子 $\xi$、语言目标 $g_{\tau,\xi}$、RGB 演示 $D_\tau$、动作预算 $B_\tau$(50–200 步)与物理成功谓词 $\varphi_\tau$。评测前模型自己看多帧演示写结构化总结 $s_{m,\tau}$;回合中每步观测为 $o_t=(I_t,p_t,h_t,f_{t-1})$,模型输出相机动作(不改变物理状态)或机器人动作($x_{t+1}=T_\tau(x_t,a_t)$),也可调用非环境工具或停止;每步动作后 RoboTwin 检查 $\varphi_\tau$,预算耗尽或主动停止而未成功即判负。主指标是终端成功的任务族宏平均:先在 20 个种子上取均值 $S_{m,r,\tau}=\frac{1}{20}\sum_i y_{m,r,\tau,i}$,再对 14 族平均 $S^{\mathrm{all}}_{m,r}=\frac{1}{14}\sum_\tau S_{m,r,\tau}$,报告 3 次运行的均值±样本标准差。行为层面由 3 名标注者按 9 项判据对整条轨迹多数投票,覆盖一次完整运行共 3,360 个回合。
核心创新是“联合视角-手臂闭环”:证据获取不再是被测系统之外的预处理,而是与动作执行交织、共享预算的显式决策序列。三个设计支柱:其一,演示只提供程序性知识——RGB 视频被模型自己蒸馏成文字总结 $s_{m,\tau}$,不含任何机器可读动作或位姿,测试的是“看会了流程,能否在新几何配置下实例化”;其二,特权信息全封锁——模型只见干净 RGB 与本体感知(末端位姿、夹爪开合、指心中点 GC、世界系夹爪轴),没有深度、分割、坐标、路标点、相机标定,甚至不知道种子来源;其三,动作是模型自由生成的数值参数——世界轴平移 1–100 mm、夹爪局部旋转 1–90°、开合命令,双臂另有同步指令,执行层只做可达性与轨迹规划,绝不替模型选择物体、抓取区域或路标点。与 EmbodiedBench 的坐标标注、ST-BiBench 的真值位姿、IMBench 的参数化原语相比,这把“空间判断→度量动作”的转换完全留给了被测模型;与 RT-2、OpenVLA 这类学习型动作头相比,执行器固定且模型无关,保证了跨模型公平。
方法步骤详情
流程分四段。①演示内化:模型通过帧检查门(必须查看多个不同帧)从专家 RGB 视频采样帧,写出含抓取区域、接近方向、手臂分工、协调顺序与完成条件的结构化总结;held-out 变体复用总结不给新视频,长时程任务只给四个原子技能视频。②回合循环:每步观测 $o_t=(I_t,p_t,h_t,f_{t-1})$,模型输出一个 JSON 决策——相机动作(以夹爪中心 $c$ 为锚的 5 个语义视角:topdown $c+(0,0,0.68)$ m、side、front-side 45°、side-top 45°、oblique 45°,加 5 cm 平移、8 cm 缩放、10° 偏航/俯仰,最多连续 5 个)或机器人动作(世界轴平移 $\sigma d$,$d\in[1,100]$ mm;夹爪局部轴旋转 $\alpha\in[1,90]°$;开合夹爪;双臂需指定 arm 并支持同步指令),或调用工具、停止;两类环境动作共享同一预算。③固定执行:模型无关的 IK 与轨迹层尝试每个度量目标并返回二值规划反馈,大旋转分解为不超过 10° 的路标点且保持 GC 近似不动。④判定与诊断:每步后检查物理谓词(抓取需抬升 $>50$ mm;点铃需接触点距功能点 $x/y<25$ mm);终端成功宏平均为主指标,ED/OC/PF 仅对出现可观测错误的回合计分。
技术新颖性
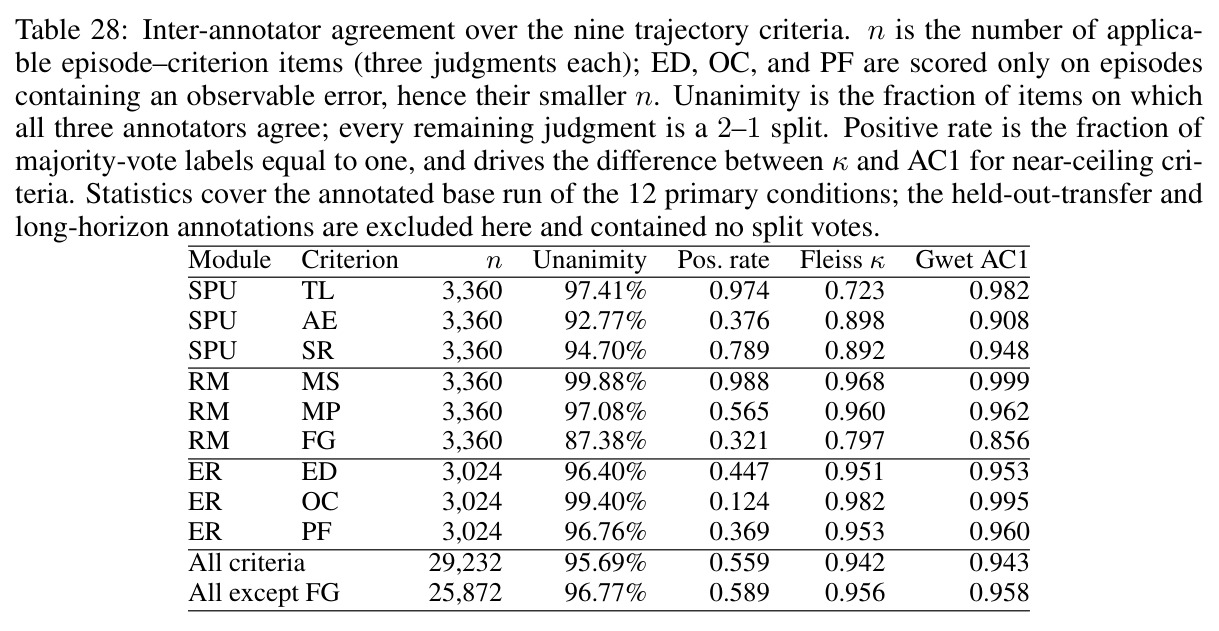
新颖性有四点。(1) 评测构造:首个把主动观测选择与度量臂控制放进同一闭环、且被测对象是无学习动作头的通用 MLLM 的基准(表 1 九个设置中唯一四项全 Yes)。(2) 动作接口:暴露模型自由生成的数值笛卡尔增量而非菜单选项或参数化原语,配合封锁一切结构化空间信息,使“从像素到毫米”的转换成为不可回避的瓶颈。(3) 验证协议:确定性种子 + 2,000 步沉降 + 500 步观测(末 200 步姿态漂移 $\le 3°$)+ 完整专家执行验证,280/318 的条件通过率保证每个实例物理可解且跨运行可复现。(4) 诊断体系:9 项轨迹级行为判据把“失败发生在闭环哪一环”变成可测量对象,标注一致性高(29,232 个判定项、一致率 95.69%、Fleiss $\kappa=0.942$),且记录显示 TL/MS 与终端成功仅 31.1%/30.7% 一致,证明标注并非对结果的反推,而是刻画了独立于成败的行为证据。
实验结果
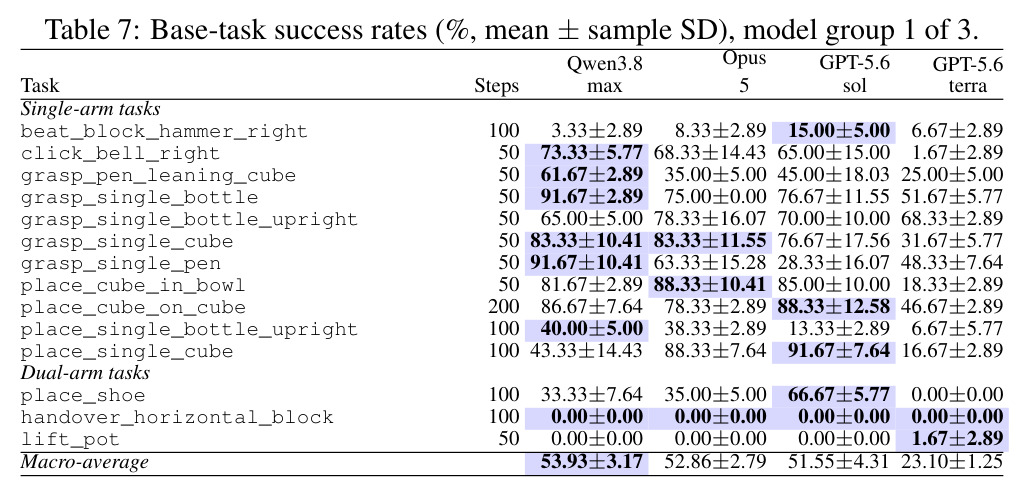
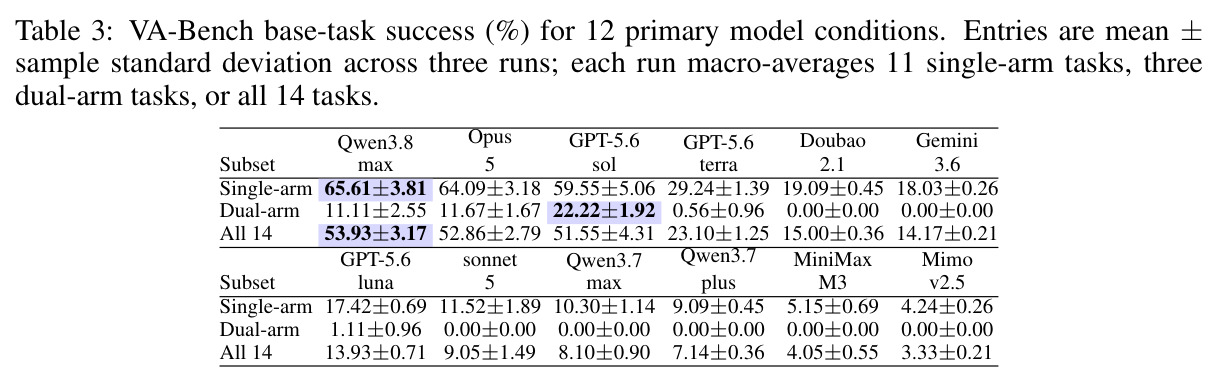
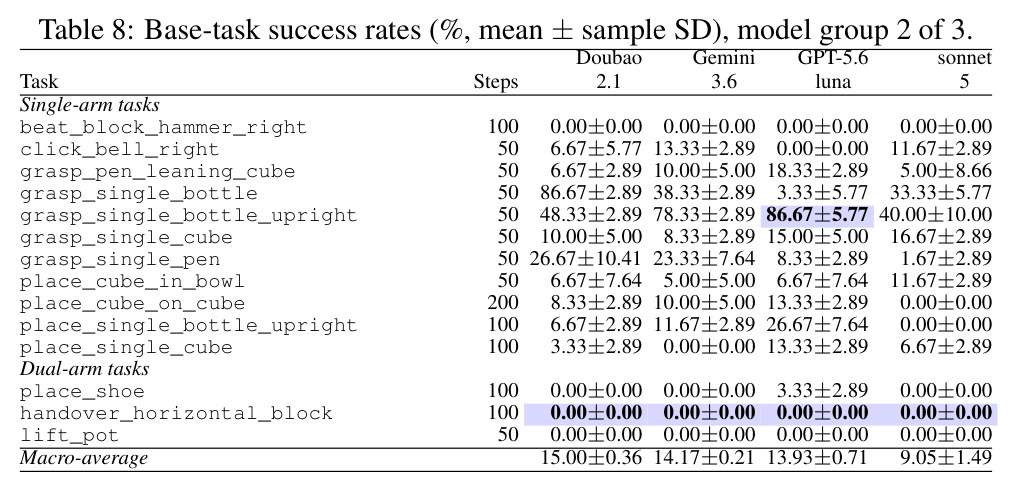
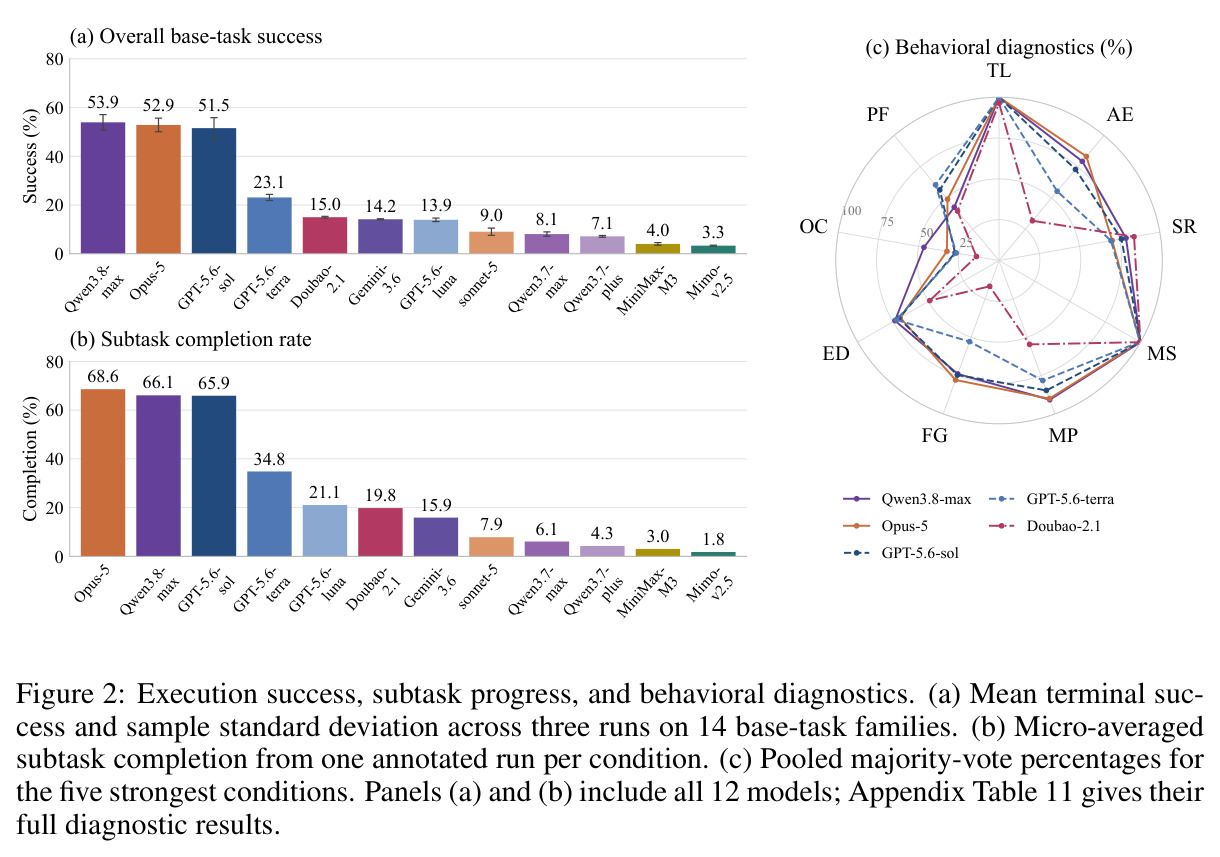
三大发现。第一,定位强不等于执行强:Qwen3.8-max 三次运行 14 任务宏平均仅 53.93±3.17%(单臂 65.61%、双臂 11.11%),Opus-5 52.86±2.79%,GPT-5.6-sol 51.55±4.31%,前三名差距小于 2.38 pp 且区间重叠;但它们的目标定位 TL 均为 100.0%、操作语义 MS≥99.6%,空间关系 SR 却只有 78.9%/70.4%/76.1%,在线修正 OC 最高仅 46.7%。成绩从第四名 GPT-5.6-terra(23.10±1.25%)起断崖下跌,其余≤15%;双臂最好仅 22.22%,handover 与 lift_pot 所有模型全部 0%。第二,主动相机控制显著优于被动五视图:匹配对比中 Qwen3.8-max 57.50%→27.86%(−29.64 pp)、Opus-5 −23.93 pp、GPT-5.6-sol −22.14 pp、Doubao-2.1 −9.64 pp,符号检验 $p\le 0.039$;放置类差距最大(place_cube_in_bowl 85%→5%)。第三,迁移与长时程脆弱:7 族 held-out 迁移中 Qwen3.8-max 掉 10.00 pp(77.86→67.86),GPT-5.6-sol 掉 32.14 pp;五物体长时程无人完成严格回合(最好仅 61/100 次放置);迁移下空间感知模块仍≥99.3% 而操作模块仅 54.3–86.7%。摘要消融显示换用 Qwen3.8-max 摘要使其他模型平均掉 31.25 pp,而 Opus-5 摘要平均提升 7.50 pp——最强作者的摘要反而最难迁移。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 14 个基础任务族(11 单臂 + 3 双臂)终端成功率 | 三次独立运行的任务族宏平均(%,均值±样本标准差) | Qwen3.8-max:53.93±3.17(单臂 65.61,双臂 11.11) | Opus-5:52.86±2.79;GPT-5.6-sol:51.55±4.31;第四名 GPT-5.6-terra 仅 23.10±1.25,其余条件≤15.00 | 前三名挤在 51.55–53.93(差距<2.38 pp 且运行区间重叠,作者不做排序声明),与后续模型形成约 29–50 pp 的断崖 |
| 主动证据获取 vs 被动五视图观测(4 模型 × 280 回合匹配对比) | 单次运行全任务成功率(%)+ 任务族级两侧符号检验 | 主动:Qwen3.8-max 57.50、GPT-5.6-sol 56.07、Opus-5 54.29、Doubao-2.1 15.00 | 被动五视图:27.86、33.93、30.36、5.36(被动视图集是主动可达视角的严格子集) | 主动高出 9.64–29.64 pp($p\le 0.039$);放置类差距最大,如 place_cube_in_bowl 85%→5% |
| 7 个单臂任务族的 held-out 几何/容器/布局迁移 | 7 族平均成功率(%,每族 20 个 held-out 种子) | Qwen3.8-max:67.86(匹配 base 77.86) | GPT-5.6-sol:47.86(base 80.00);GPT-5.6-terra:27.86;GPT-5.6-luna:18.57 | 全部为负迁移(−4.29 至 −32.14 pp);基础越强掉得越多,强执行不保证稳健的空间重落地 |
| 五物体长时程组合(100 个放置目标、20 回合、4 个原子技能视频) | 成功放置数(/100)与严格回合成功率(%) | Qwen3.8-max 61/100、GPT-5.6-sol 53/100、GPT-5.6-terra 5/100、GPT-5.6-luna 2/100 | 所有条件的严格回合成功率均为 0.00% | 无——原子技能有可观的部分进度,但无法组合成完整库存条件化的长时程回合 |
| 双臂协调(place_shoe、handover_horizontal_block、lift_pot) | 三次运行双臂宏平均成功率(%) | 最佳 GPT-5.6-sol 22.22±1.92 | 12 个条件中 5 个双臂得分为 0.00;handover_horizontal_block 与 lift_pot 所有模型 0% | 即便最强模型也只在 place_shoe 上取得成功,协调操作是全部模型的硬瓶颈 |
| 九项轨迹行为诊断(3,360 个回合人工标注、三人多数投票) | 各判据多数投票正例率(%) | 头部模型 TL=100.0、MS≥99.6;AE 最高 83.2(Opus-5)、FG 最高 77.9(Opus-5) | SR 仅 70.4–78.9;OC 最高 46.7(Qwen3.8-max);弱模型 FG<10%、OC 近 0 | 量化出“找得到目标→对不准几何→改不了错误”的逐级衰减,终端成功率无法揭示的断点被显式定位 |
局限与改进
作者承认的限制:9 项诊断是观察性的,只能定位行为断点、不能因果归因到感知/规划/数值落地/执行;held-out 变体有限,不建立跨任意物体、机器人、相机的开放集泛化;长时程仅一个组合族;端到端条件把摘要质量、重落地与动作生成混在一起,共享摘要对照只覆盖 3 个任务单次运行;未评测 VLM–VLA 模块化架构;主动-被动差距的机制(视角相关性、跨视图整合、视觉上下文长度)仍然开放。我补充的观察:其一,全部实验在 RoboTwin 仿真中完成,且相机接口无碰撞、可达性与标定误差建模,结论向真实机器人与真实主动视觉的迁移存疑;其二,多数深入分析只有单次运行,主对比也仅 3 次运行、每任务 20 种子,对前三名这类接近结果的排序统计功效有限;其三,被测模型是快速迭代的闭源前沿模型,结论时效性短;其四,成功谓词容差固定(如 35–55 mm),偏紧的物理容差可能不成比例地放大小模型的数值误差;其五,人工标注 3,360 个回合(87,696 个独立判断)成本很高,难以扩展到更多模型与运行。
独立分析的弱点
独立弱点与改进方向。(1) 仿真封闭:无真实机器人验证,建议至少在一个真实双臂平台上复刻 3–5 个任务族检验 sim-to-real。(2) 摘要条件化混淆变量:端到端条件混合了摘要写作与执行能力,建议增加专家书写摘要与无摘要两组控制并覆盖全部任务,分离“接口质量”与“落地能力”。(3) 主动-被动机制未定位:可加三组对照——金视角 oracle(每步给诊断视角)、主动+被动混合输入、被动五视图加视角文本标签——判断差距来自视角相关性、跨视图整合还是上下文长度负担。(4) 预算耦合:相机与机器人动作共享预算可能系统性惩罚探索型策略,建议报告预算敏感性曲线与“观察步占比”统计。(5) 相机接口非物理:无可达性/碰撞/标定建模,真实主动感知的成本被低估,可在仿真中加入相机臂运动学约束。(6) OC 普遍偏低(最高 46.7%)但错误回合样本有限,建议扩大错误回合采样,并区分“检测到但不会改”与“根本没检测到”两类失败。(7) 每任务仅 20 种子、3 次运行,建议用贝叶斯分层模型给出种子级与运行级的不确定性区间,再谈模型排序。
未来方向
可延伸的方向:(1) 因果干预分解——对感知(换深度输入)、规划(给子目标提示)、执行(换规划器)做受控替换,把诊断断点变成因果归因;(2) 模块化 VLM–VLA 对比——用同一 VLM 做高层规划、统一 VLA 做底层控制,与本文直接控制做匹配比较,厘清分工收益;(3) 用执行反馈训练——ED/OC 诊断天然构成奖励信号,可对 MLLM 做 RL 或偏好优化以提升在线修正(46.7% 的上限说明改进空间巨大);(4) 摘要作为可迁移接口——研究约束显式性与可迁移性的关系,甚至训练一个专门为“他人可读性”优化的摘要生成器(Opus-5 摘要 +7.50 pp、Qwen3.8-max 摘要 −31.25 pp 的反差值得深挖);(5) 更长的长时程与开放集几何——把五物体任务扩展到跨物体族、跨场景布局,测状态维护的极限;(6) 自动化轨迹裁判——用强 VLM 复现 9 项判据的标注流程并以人工标注为校准集,降低评测边际成本;(7) 跨具身迁移——更换相机基线与机械臂构型,检验接口与结论的普适性。
复现评估
复现评估:代码与基准开源(github.com/zhangzhongbo2213/VABench),构建在开源 RoboTwin 仿真器上;280 个种子经确定性实例化(固定 NumPy/Torch 随机状态、demo clean 消除背景/光照/桌面随机化)与完整专家执行验证后随基准固定,附录给出各任务随机化范围、终端谓词、动作 schema 与视角定义,工程可复现性好。主要成本在三处:一是 12 个主条件各需 3 次 × 280 回合(840 回合/条件),外加迁移、长时程与摘要消融,全部依赖闭源前沿模型 API(GPT-5.6 系、Opus-5、Gemini、Qwen、Doubao 等),API 费用与时长可观;二是 9 项诊断需 3 名标注者覆盖 3,360 个回合(29,232 个判定项、87,696 个独立判断),人力成本高;三是本地小模型复现(Qwen3.8-27B、Gemma-4-31B-it 等)需要 GPU 但门槛较低。总体而言:环境与协议层面复现容易(开源 + 确定性种子),完整结果复现成本中高,属于“有预算即可复现”的基准工作。
论文图表
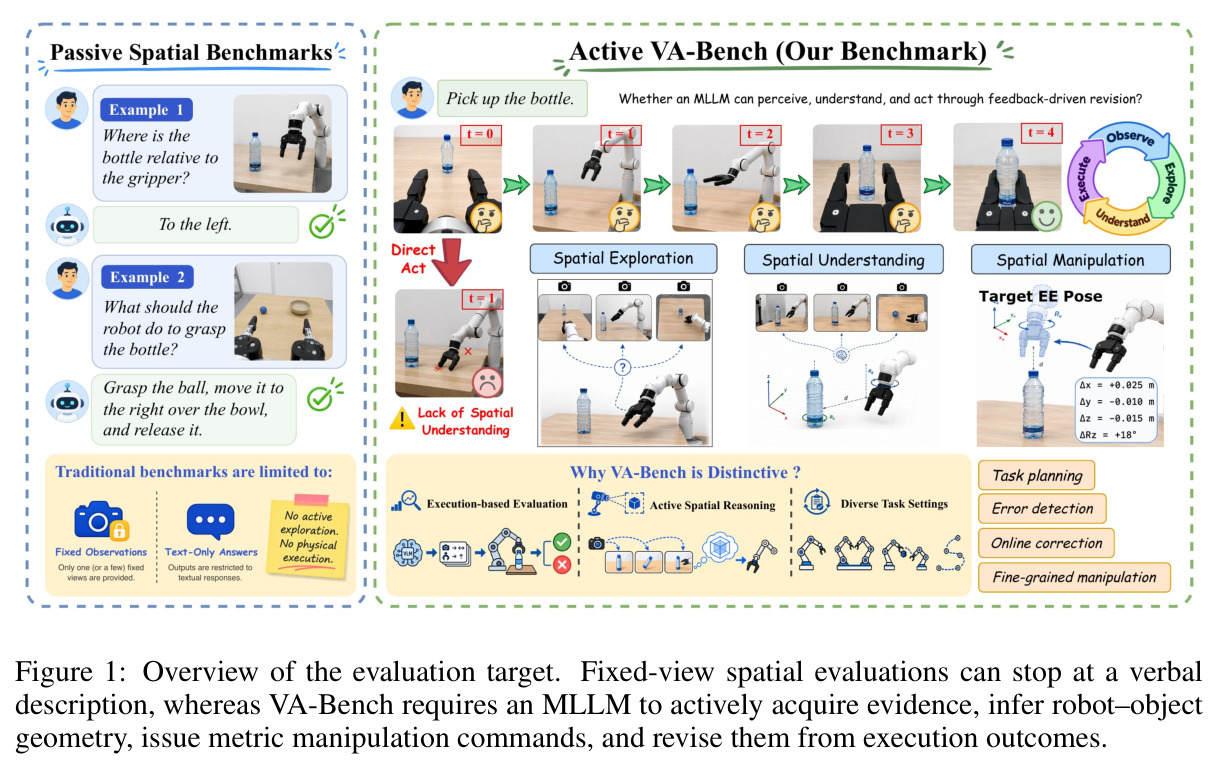
对比示意图:上半部分是固定视角空间评测——模型给出一段言语描述即可得分;下半部分是 VA-Bench 要求的完整闭环——模型需主动获取证据(选视角)、推断机器人-物体几何、发出度量操作命令、再根据执行结果修正。
一图点明论文动机与评测对象:静态/固定视角的高分不能外推为闭环执行能力,四段能力必须在同一交互中同时成立。