RoboQuest:会搜索、检查与测试的通用物理智能体基准 RoboQuest: Generalist Physical Agents that Search, Inspect and Test
首个目标导向具身探索基准:五大前沿模型最高仅23%成功率,瓶颈在探索决策而非执行。
前置知识
视觉-语言-动作模型(VLA)
VLA 是把相机图像、机器人本体状态和语言指令直接映射为机器人动作的端到端神经网络,典型代表如 π0.5。它通常在海量演示数据上做监督微调(模仿学习),以固定频率输出动作块(action chunk)。这类模型一般是马尔可夫的:只依赖当前观测和指令,没有跨回合或长回合的显式记忆机制。
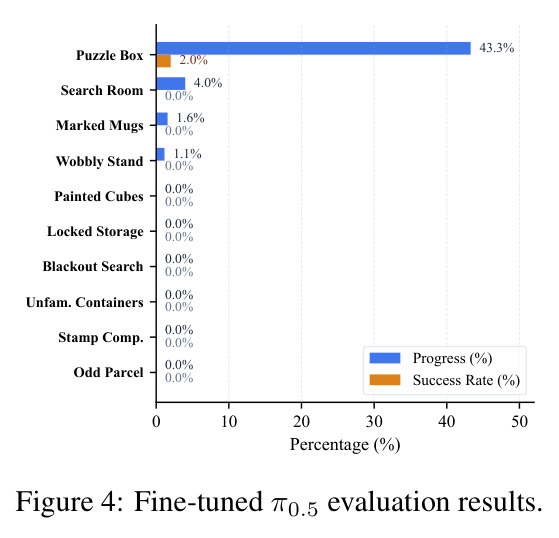
本文用微调后的 π0.5 作为学习式策略基线,它几乎全灭(9/10 任务成功率 0%)的结果说明无记忆的模仿学习无法解决探索任务,这是论文核心论点之一。
主动感知与交互式感知
主动感知(active perception)指智能体主动决定传感器去哪、看什么,而不是被动消费固定视角的观测;交互式感知(interactive perception)更进一步——通过推、翻、抬、开等物理交互改变世界,来揭示观测中不存在的属性。两者都源于 Bajcsy 1988 年的经典思想:通过决定性的动作获取任务相关信息。
RoboQuest 的三族任务正是这两个概念的基准化:Search 族对应主动感知(决定去哪看),Inspect 和 Test 族对应交互式感知(动手才能知道)。读懂这两个概念才能理解任务设计。
移动操作(Mobile Manipulation)
移动操作指同时需要底盘移动和机械臂操作的任务:机器人必须先驾驶到工作区、调整站位对准,再用机械臂完成抓取、开合等精细动作。本文中 Franka Panda 机械臂装在移动底盘上,在完整厨房场景中穿梭,模型需交替调用 BASE(底盘)和 ARM(机械臂)两类工具。
RoboQuest 全部十个任务都是移动操作,搜索类任务的探索首先意味着在厨房里开车找位置,动作空间和决策预算都被拉长。
工具调用智能体接口
把多模态大模型当作机器人策略的一种方式:每一步给模型观测图像和状态文本,模型必须回复恰好一个结构化工具调用(如 ARM/BASE/WAIT/STOP),由底层控制器执行指定时长。模型不输出底层力矩,而是输出带持续时间的命令,相当于语言级遥控;对话文本历史累积,图像历史可被裁剪以控制上下文长度。
五个前沿模型全部通过这种统一接口零样本评估,理解接口才能理解 200 决策预算、每命令最长 10 秒、图像只保留最近两帧等设计对结果的影响。
马尔可夫策略与情景记忆
马尔可夫策略指动作只依赖当前观测(和指令),不维护历史状态,π0.5 这类 VLA 即属此类。而探索任务需要情景记忆:记住哪些抽屉已经开过、哪个格子是空的、试过哪种开盒方式。没有记忆的智能体要么原地重复尝试,要么在图像上下文被裁剪后彻底遗忘已获得的证据。
这解释了微调 π0.5 的全灭,以及前沿模型'储物格在观测中出现过 5 次以上却从没去打开'这类高发失败,是理解本文失败分析框架的前提。
研究动机
当前最强的通用机器人智能体——GPT-6 Astra、Claude Opus 5.5 等前沿多模态大模型,以及 π0.5 这类 VLA——已经能在仿真和真机上完成相当复杂的操作,但这种强执行力建立在一个隐含假设之上:完成任务所需的关键信息就在当前观测里。RLBench、LIBERO、CALVIN、ManiSkill3、RoboCasa365 等主流操作基准全部如此,机器人练的是运动技能,而不是'搞清楚该去哪里找东西'。一旦关键信息不在初始观测中,情形就完全不同。论文举了一个例子:机器人在一个黑暗的房间里搜索,只有一盏可携带的灯,它只能看到灯照到的地方,而同一只夹爪既要举灯又要抓目标;探索还是有后果的——打开的一个储物格里可能是目标、可能什么都没有、也可能是打开其他区域的钥匙,每次观测都会同时改变机器人的信念和下一步可选动作。机器人必须自己决定看哪里、每次发现如何改变行为、以及何时才算'知道了足够多'。现有基准要么信息完备,要么只需执行一步规定好的交互来消除不确定性,无法区分'会干活'和'会调查'这两种能力。
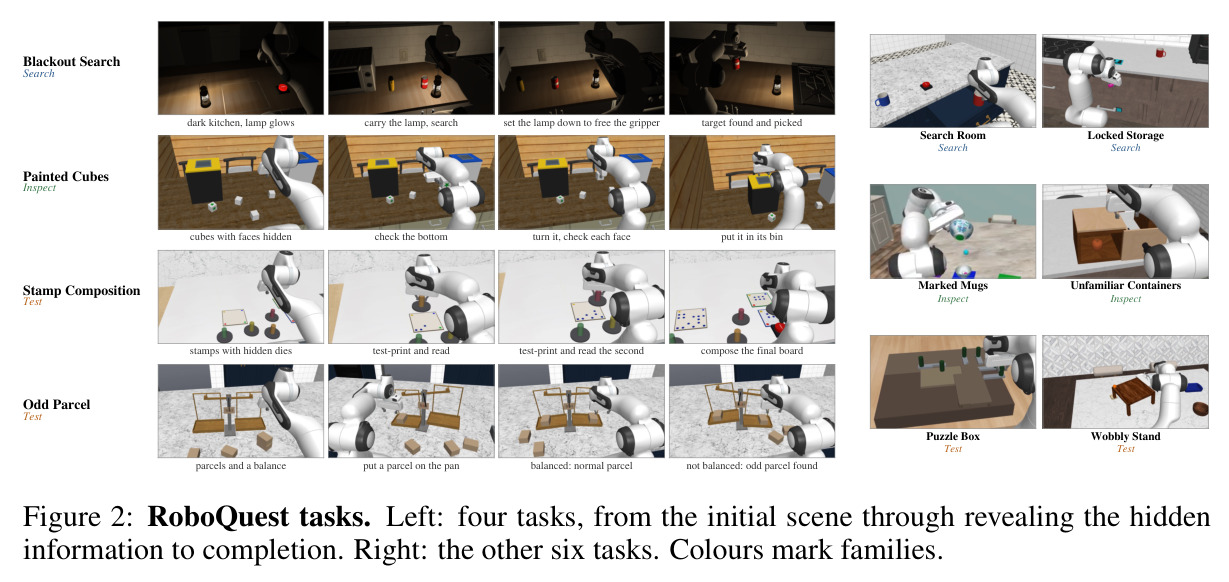
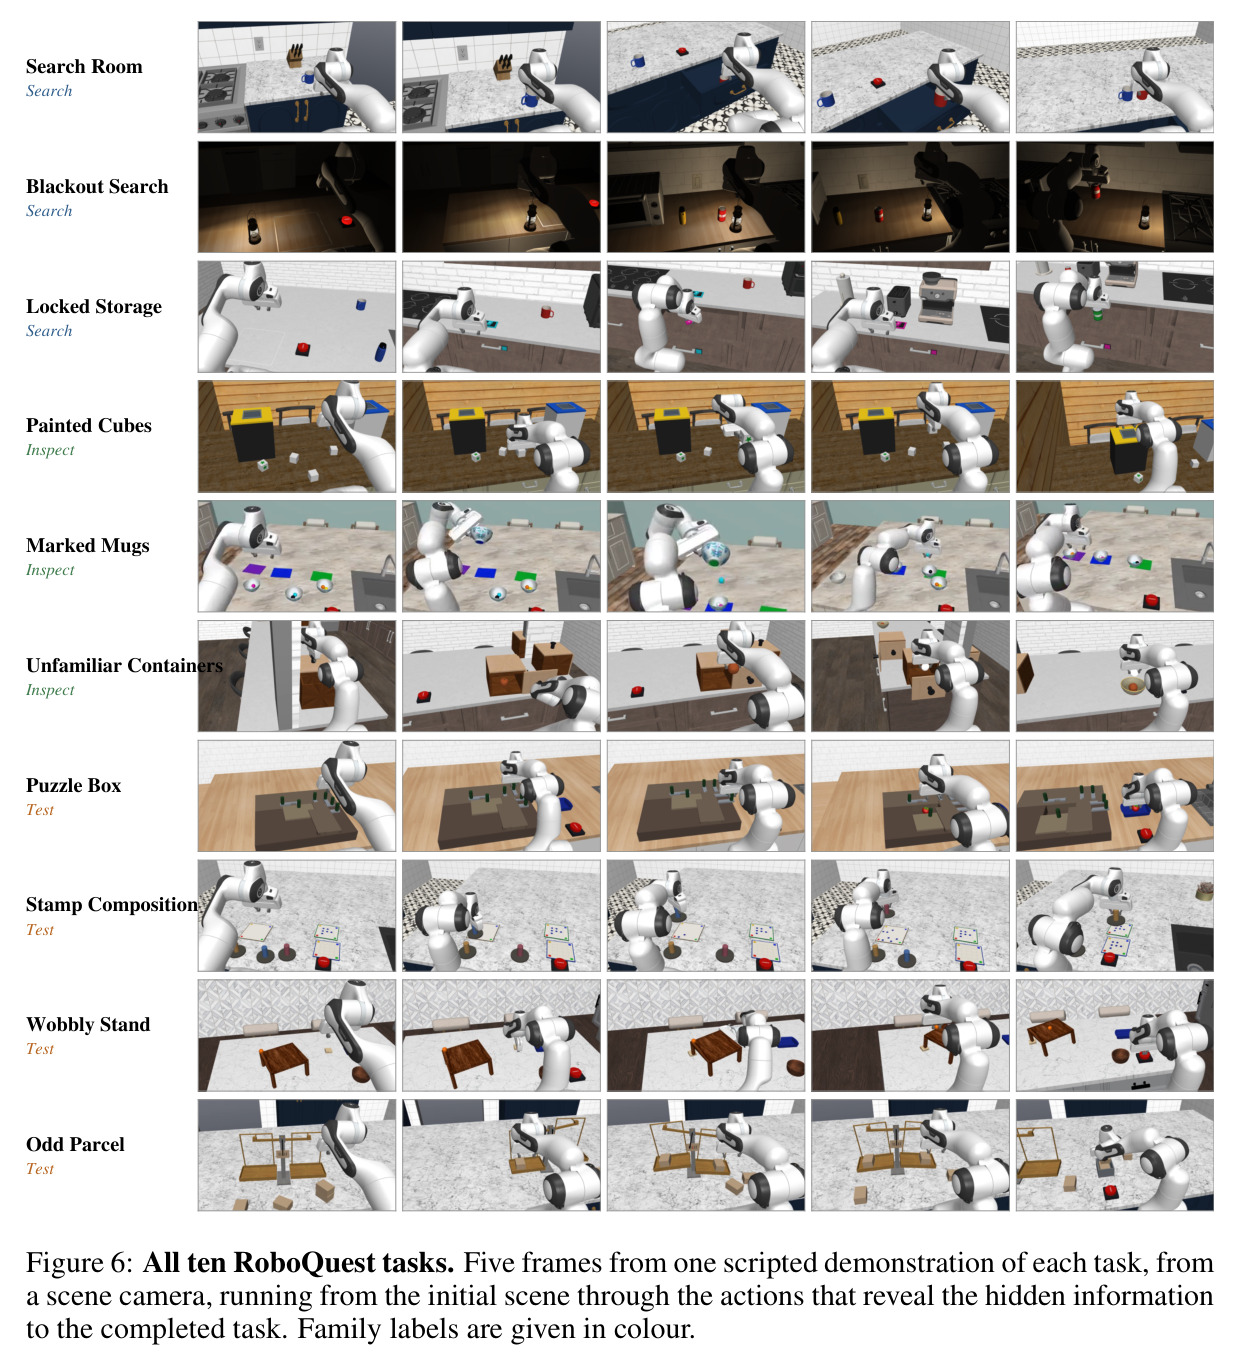
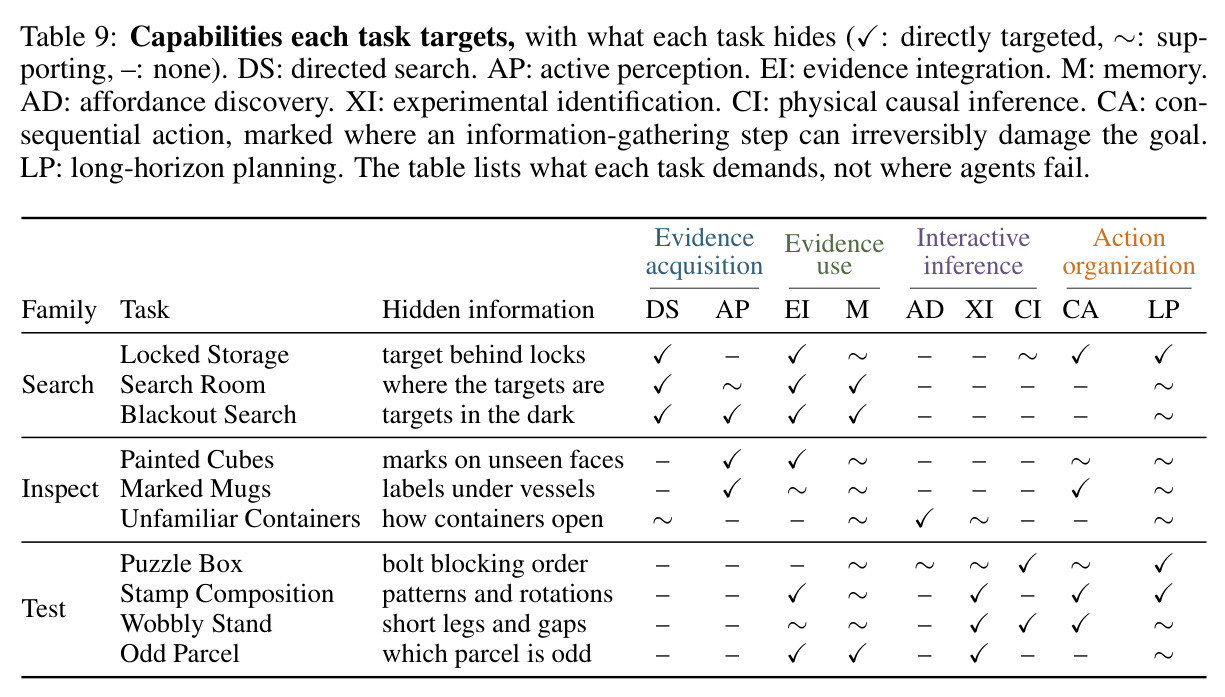
本文的目标是本文的目标是构建并系统评估第一个专门度量'目标导向具身探索'(goal-directed embodied exploration)的基准 RoboQuest:任务只给出可外部验证的物理目标(例如'把所有重量异常的包裹放进盒子并按 SUBMIT'),而完成任务所需的关键信息——目标在哪、物体底面写着什么、机关如何联动——对智能体完全隐藏,存放在它无法访问的私有规范中。智能体必须通过物理交互主动收集证据、用证据调整后续动作,并自主决定何时按 SUBMIT 提交。基准包含十个移动操作任务,分属三个不确定性家族:Search(不知道东西在哪)、Inspect(不知道物体的隐藏属性,需要翻转、抬起、打开来查看)、Test(无法直接观测,必须设计小试验从结果中推断,如天平称重、滚球测倾斜)。作者同时发布 5,000 条经验证的探索演示(每任务 500 条、共 366 小时、每帧带两级语言标注)用于训练,并用五个前沿多模态模型和一个微调 π0.5 建立基线,辅以孤立技能测试和逐回合失败归因,刻画探索能力究竟在哪里断裂。
与已有工作不同的是,本文的独特切入在于三层设计,而非简单的'遮挡物体'。第一,隐藏信息存放在智能体无法访问的私有规范中,自然语言指令永远不会泄露它,也不存在'一步解开'的固定操作——调查策略本身(去哪里找、检查到什么程度、何时证据充分)完全留给智能体,因此基准度量的是开放式调查能力而非规定动作的执行。第二,探索是有后果的:最终板上的墨迹永久、把 token 关进抽屉就永久锁死、立方体丢进箱子不可逆,错误的信息收集动作可以直接毁掉任务,这迫使智能体权衡探索收益与破坏风险——这是此前任何操作基准都没有的维度。第三,作者不满足于报告总成功率,而是配套两套诊断工具:一是把'执行'与'探索'分离的孤立技能测试(把隐藏信息直接喂给模型,只考操作),二是把每个失败回合拆成'未满足需求单元'、用确定性规则归因到缺失证据/错误决策/副作用/执行失败四类的失败分析框架——利用回放的模拟器状态渲染真值分割掩码,客观判定模型'是否曾经看见过证据'。这套组合拳能精确指出瓶颈在'没去找'还是'没做对'。
核心方法
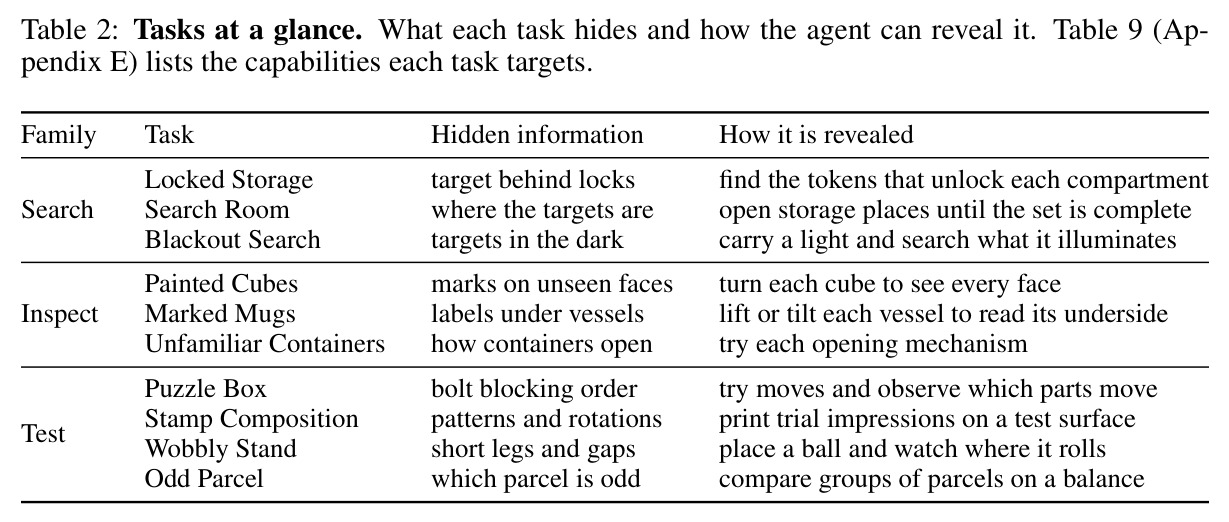
RoboQuest 建立在 MuJoCo 仿真的 RoboCasa365 厨房中,是一组移动操作任务:Franka Panda 机械臂装在移动底盘上,以 20 Hz 控制,配两个场景相机和一个腕部相机(各 512×512)。十个任务分三族:Search 族的 Locked Storage(找彩色 token 依次解锁深度 1-3 的锁链)、Search Room(在 4-8 个储物格中找齐 2-3 个目标放上托盘)、Blackout Search(黑暗中举灯搜索);Inspect 族的 Painted Cubes(翻转立方体检查各面标记并按规则分箱)、Marked Mugs(抬起或倾斜杯子读底面标签、放回原处且球不能丢)、Unfamiliar Containers(试探铰链盖、滑盖、抽屉、插销等不同开盒机构找到目标);Test 族的 Puzzle Box(试出滑栓的解锁顺序)、Stamp Composition(试印章图案与旋转后拼出目标图案,正式板上的墨迹永久不可改)、Wobbly Stand(放球看滚向判断哪条腿短、垫垫片找平)、Odd Parcel(用双盘天平分组称重找出重量异常的包裹)。每回合以物理按下 SUBMIT 按钮结束并冻结计分,只有按下瞬间所有目标条件同时成立才算成功;另有 0-1 的分步 progress 指标给部分完成记分。评估在每任务 50 个实例上进行,覆盖 18 种厨房布局、5 种厨房风格,所有智能体玩完全相同的实例。
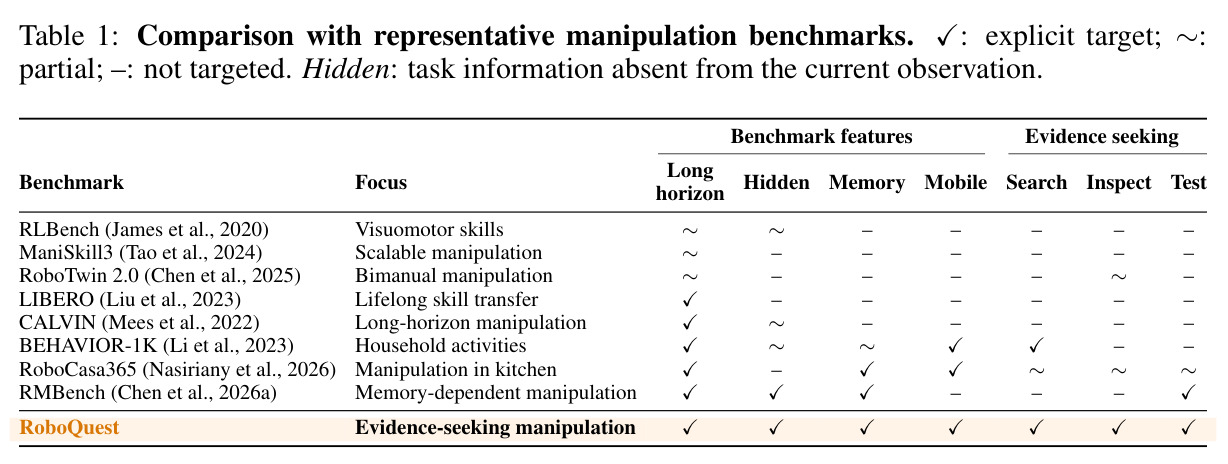
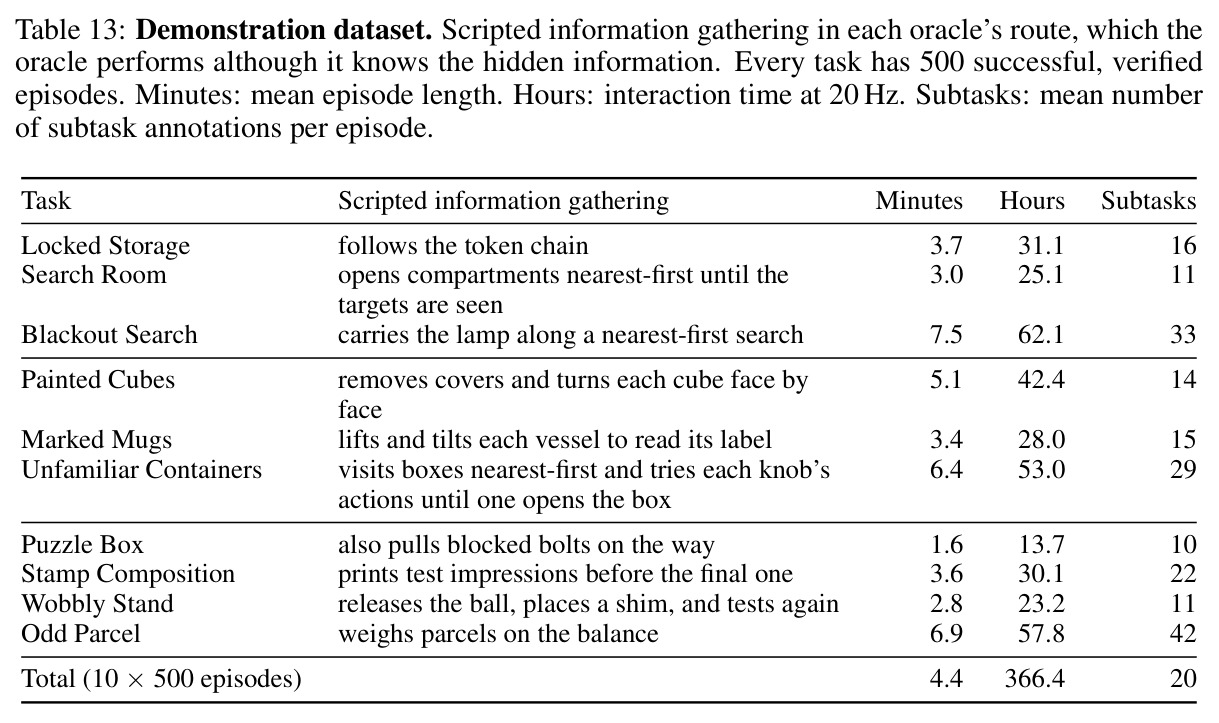
核心创新是把'信息寻求'变成任务成功的硬性前提,并用三个机制让它可度量、可比较。其一,每任务有一个明确的'隐藏信息'维度(Table 2),例如 Blackout Search 隐藏'目标在黑暗中的位置'、Marked Mugs 隐藏'杯子底面的标签'、Puzzle Box 隐藏'滑栓之间的阻塞关系',指令绝不透露,唯一的揭示途径是物理交互;与 BEHAVIOR-1K、RoboCasa365 等不同,这些信息不是顺手可得,而是任务的核心障碍。其二,SUBMIT 按钮机制把'证据是否充分'的判断交给智能体:按下即冻结分数,错误提交即失败,因此'何时停止探索、何时承诺执行'本身成为被评测的一等能力。其三,部分动作不可逆(墨水永久、token 锁死、入箱不可恢复),探索本身可能毁掉任务,评测的是'有代价的探索'。与之配套,演示数据由虽然读得到答案、但仍按'无先知智能体'方式执行探索脚本的 oracle 生成——最近优先开储物格、逐面翻转立方体、先试印再盖章、先称重再装箱——让示范教会策略'如何调查'而不是'答案在哪'。这一定位使 RoboQuest 成为 Table 1 中唯一在 Search/Inspect/Test 三个证据寻求维度上全部打勾的操作基准。
方法步骤详情
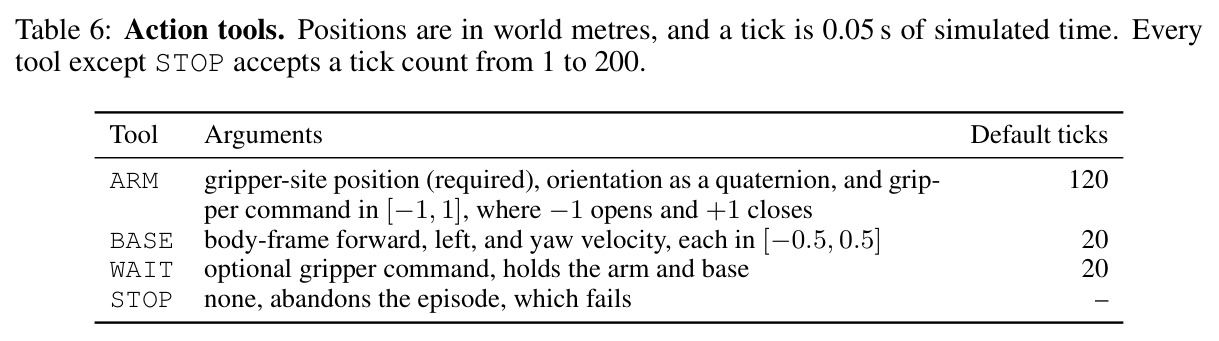
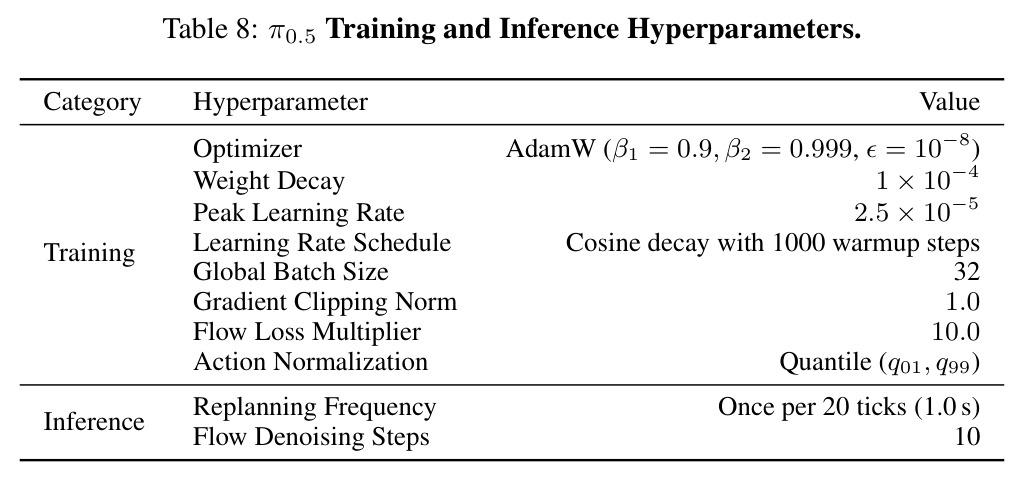
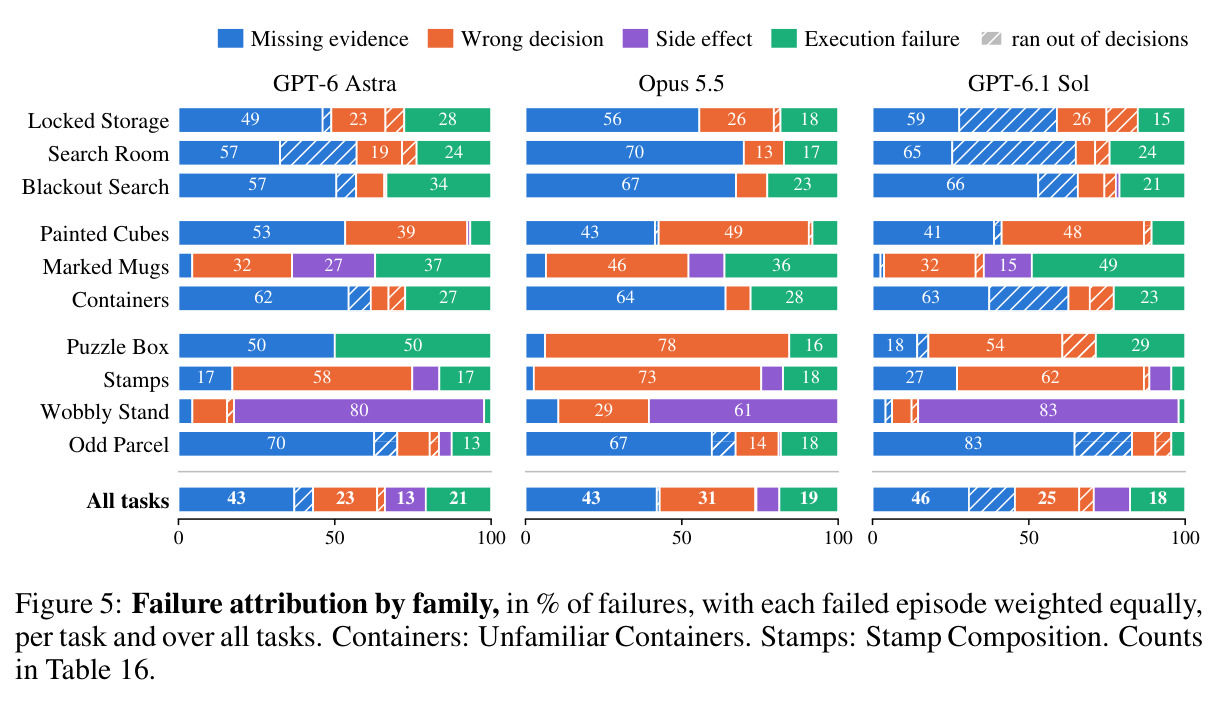
评估流水线分四步。第一步,统一接口:五个前沿模型(GPT-6 Astra、Claude Opus 5.5、GPT-6.1 Sol、Claude Fable 5.1、Gemini 3.8 Flash)零样本通过同一 harness(基于开源 Inspect Robots 框架)作为策略,每步收到本体感知、剩余决策数和三张图像,必须回复恰好一个工具调用——ARM(世界坐标位姿+四元数+夹爪开合,默认 120 ticks)、BASE(体坐标速度,20 ticks)、WAIT、STOP——每命令最长 200 ticks(10 秒模拟时间),没有定位或抓取的语义工具;每回合上限 200 个决策,对话文本全程保留、图像只保留最近两次观测。第二步,评分:按 SUBMIT 按下时的场景状态判定成功,并计算分步 progress(如 Search Room 中每个目标:格子打开记 1/3、取出记 2/3、直立放上托盘记满分)。第三步,训练基线:每任务用 500 条演示单独微调 π0.5,观测 3 路 224×224 图像+16 维本体感知,预测 20 步动作块(1 秒@20 Hz),损失为 $\mathcal{L}_{total} = \mathcal{L}_{subtask} + 10\cdot\mathcal{L}_{flow}$(子任务预测的交叉熵 + flow-matching 动作损失),AdamW 优化、峰值学习率 $2.5\times10^{-5}$、余弦衰减,推理时每 20 ticks 闭环重规划。第四步,诊断:对成功率最高的三个模型做孤立技能测试(直接给出隐藏信息,9 种技能各 20 场景),并对全部失败回合按四类(缺失证据/错误决策/副作用/执行失败)做程序化归因——每个未满足需求算一个单元,用回放的模拟器状态渲染真值分割掩码,检查证据是否出现在交付给模型的图像中(≥150 可见像素且平均亮度 ≥25)。
技术新颖性
技术新颖性有四点。第一,基准定位新:Table 1 显示 RoboQuest 是唯一在 Search/Inspect/Test 三个'证据寻求'维度上都被明确针对的操作基准——此前最接近的工作只涉及相机视角调整、单步去遮挡或历史记忆保持,交互深度和后果性都不及。第二,评分协议新:SUBMIT 机制让'承诺时机'(evidence sufficiency 判断)成为一等评测对象,这在操作基准中几乎没有先例;配套的分步 progress 公式(如 Marked Mugs 的 $P = n_1 P_i c_i b_i$,同时考虑放置精度 $c_i$ 和内容物归还 $b_i$)能从失败回合中提取部分信息。第三,失败分析方法论新:按'未满足需求'而非'回合'计单元、定位到'第一次未被修复的错误'、用渲染分割掩码加图像亮度(≥150 像素、亮度 ≥25)客观判定'模型是否看见过证据',整个归因程序化且确定性(Algorithm 1),规则与逐单元标签全部随基准发布、可复检。第四,数据集设计新:5,000 条演示全部由'假装不知道答案'的 oracle 生成,示范中刻意包含失败尝试(如 Unfamiliar Containers 中一个盒子抵抗 12 次尝试就留到后面),每帧带 stage/subtask 两级语言标注、且隐藏信息在被看见之前绝不出现在标注中——这是为'教探索'而非'教答案'量身定制的数据。
实验结果
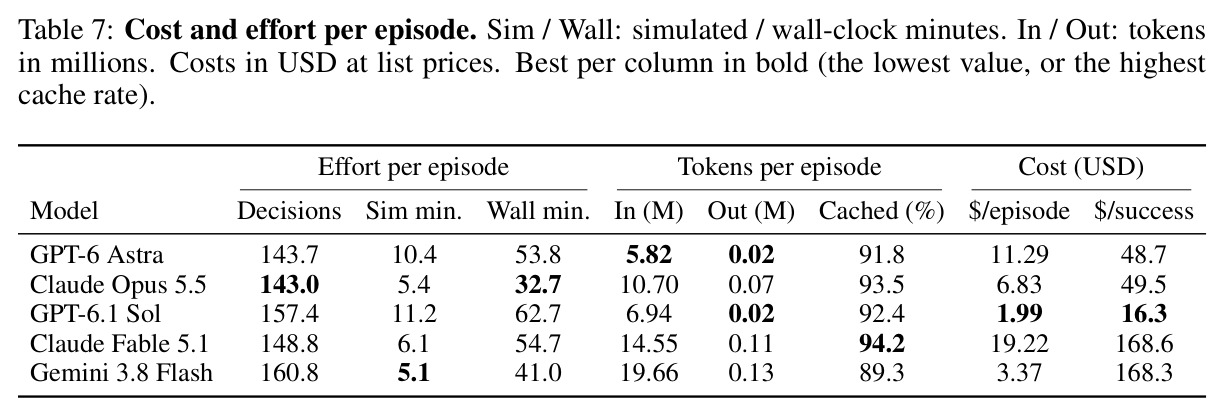
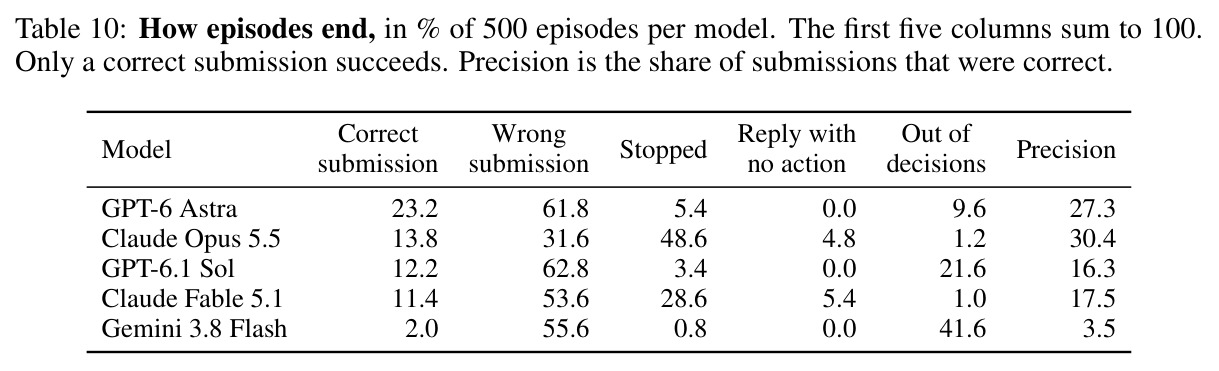
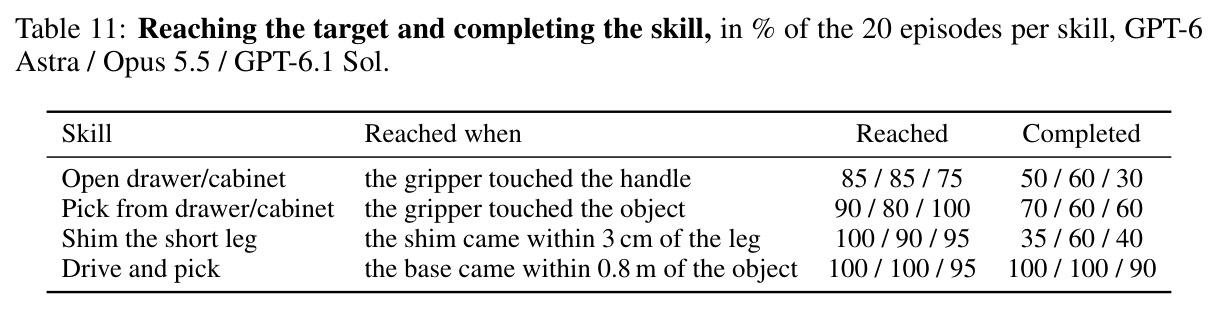
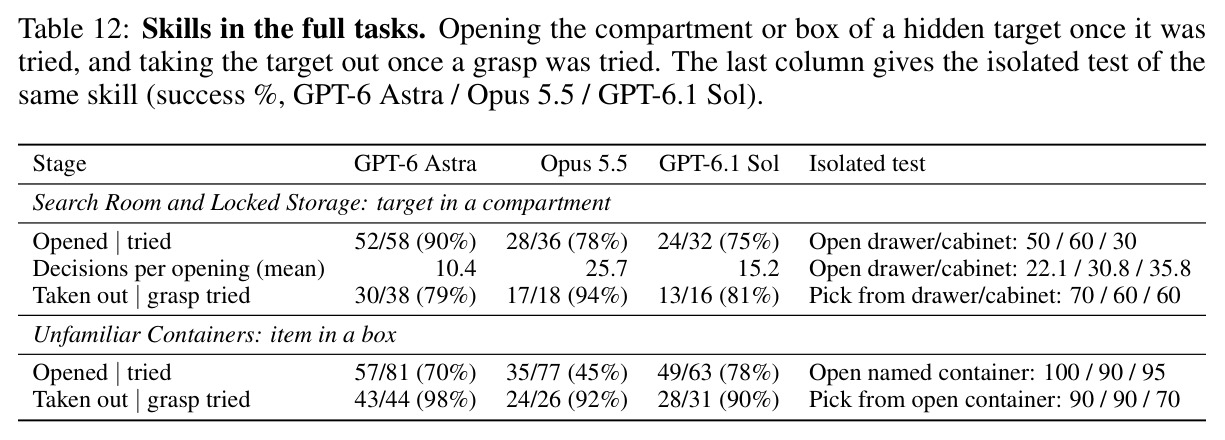
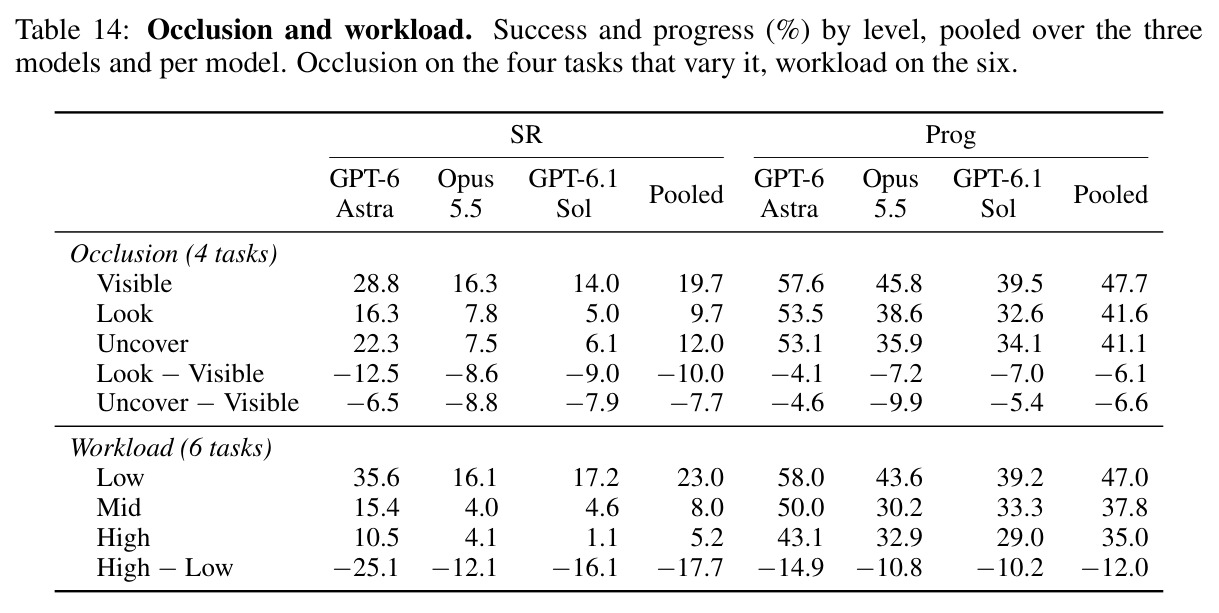
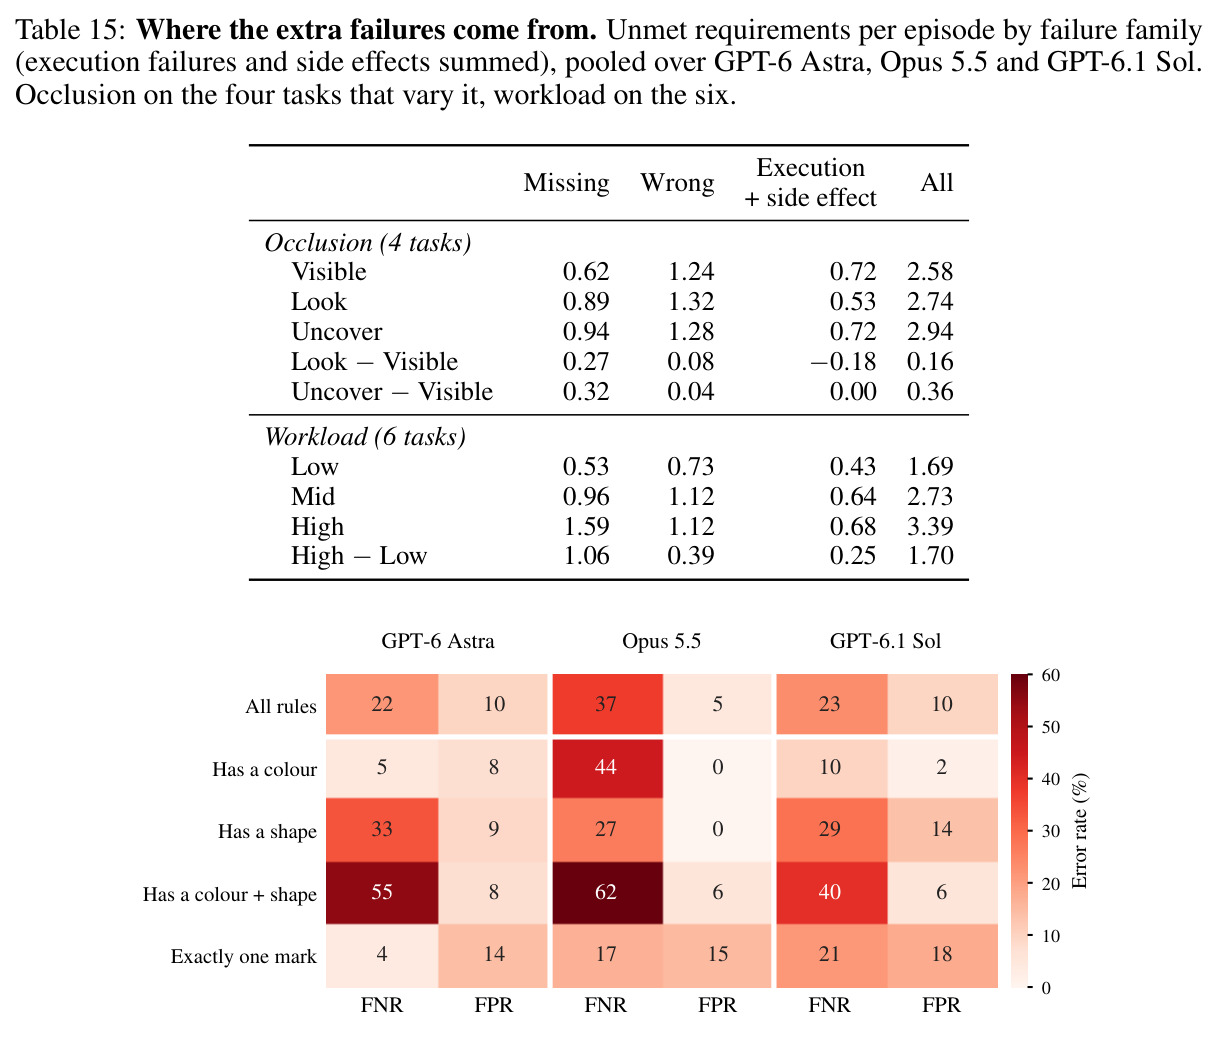
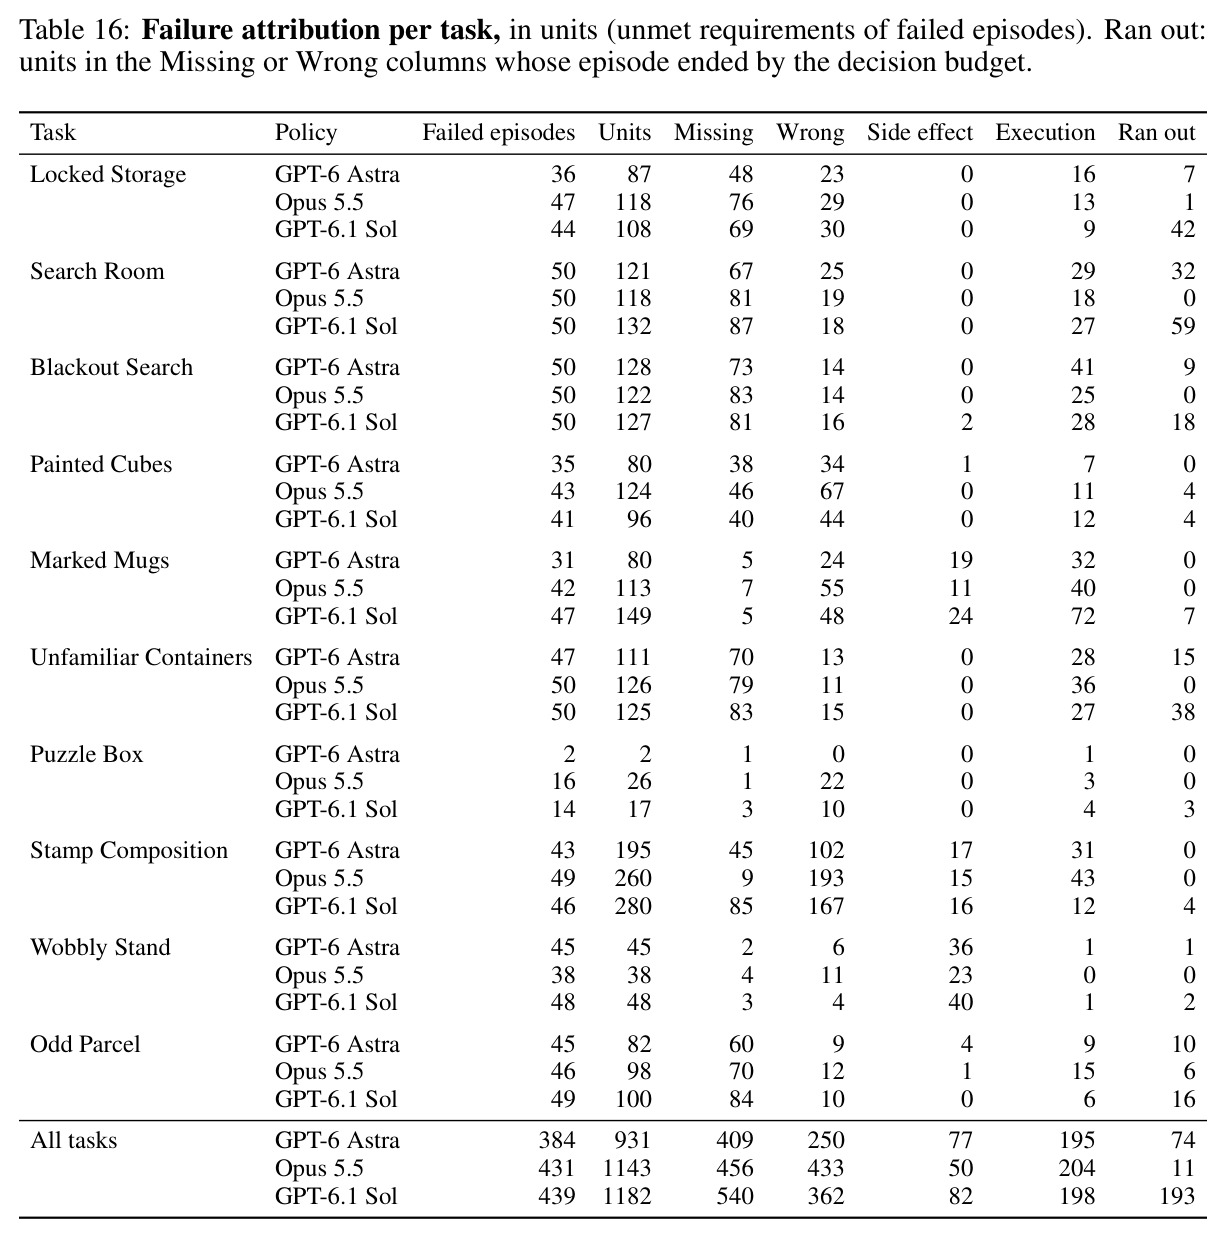
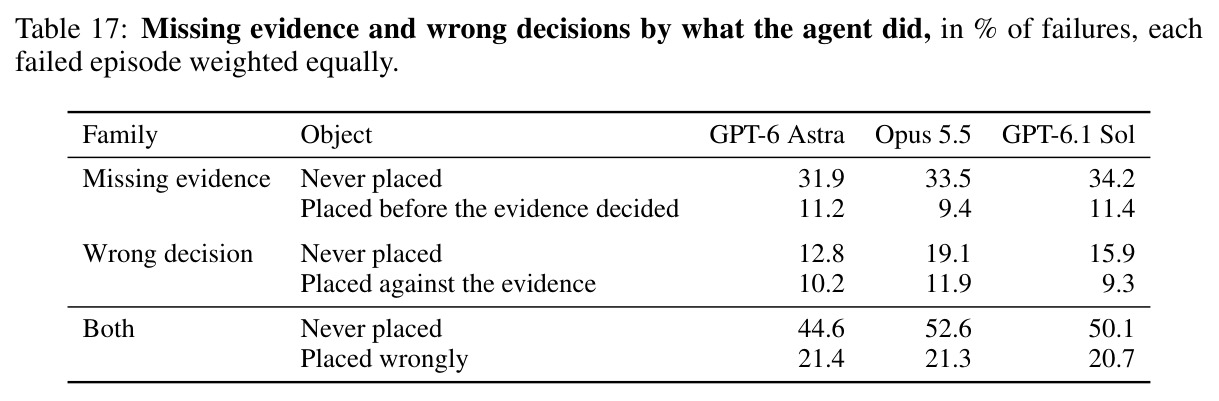
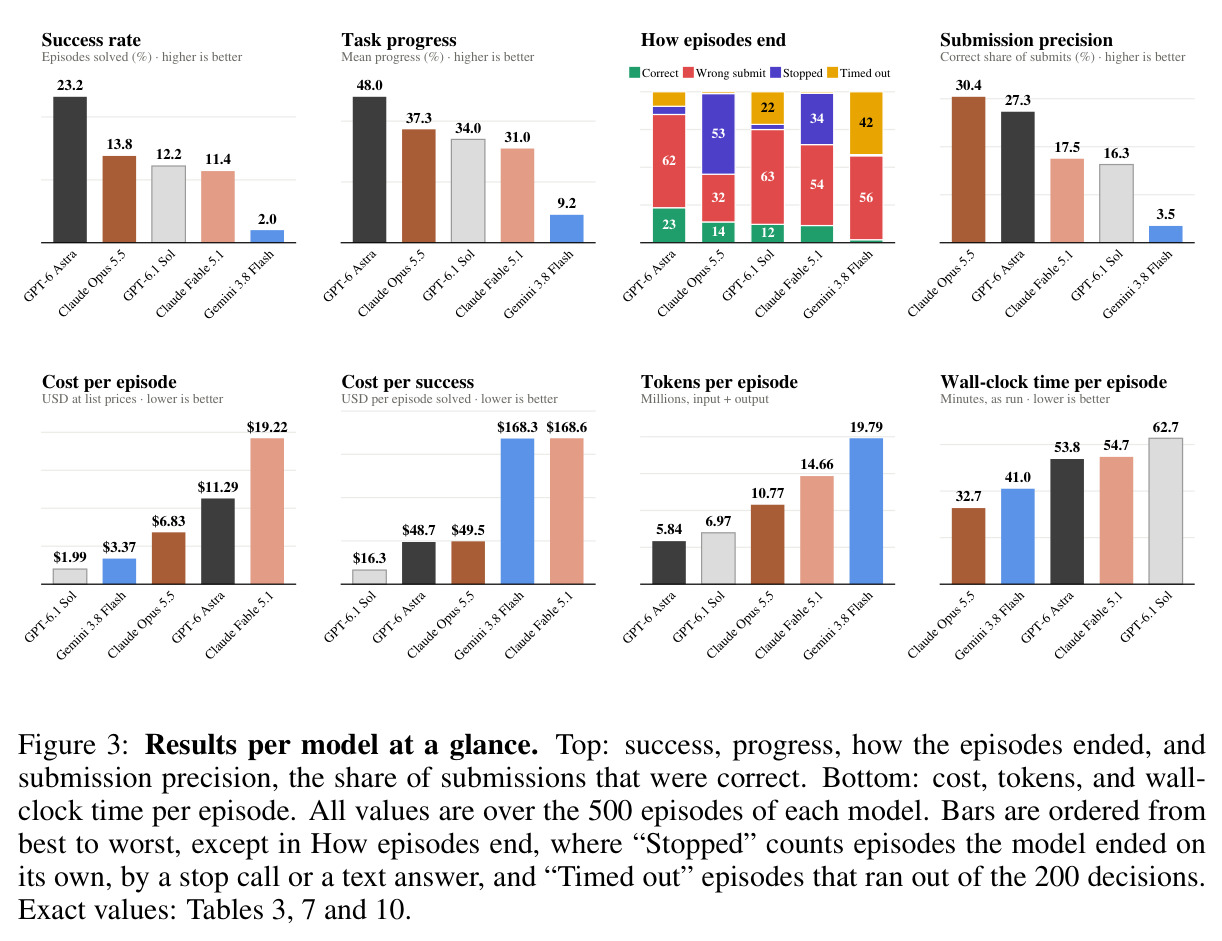
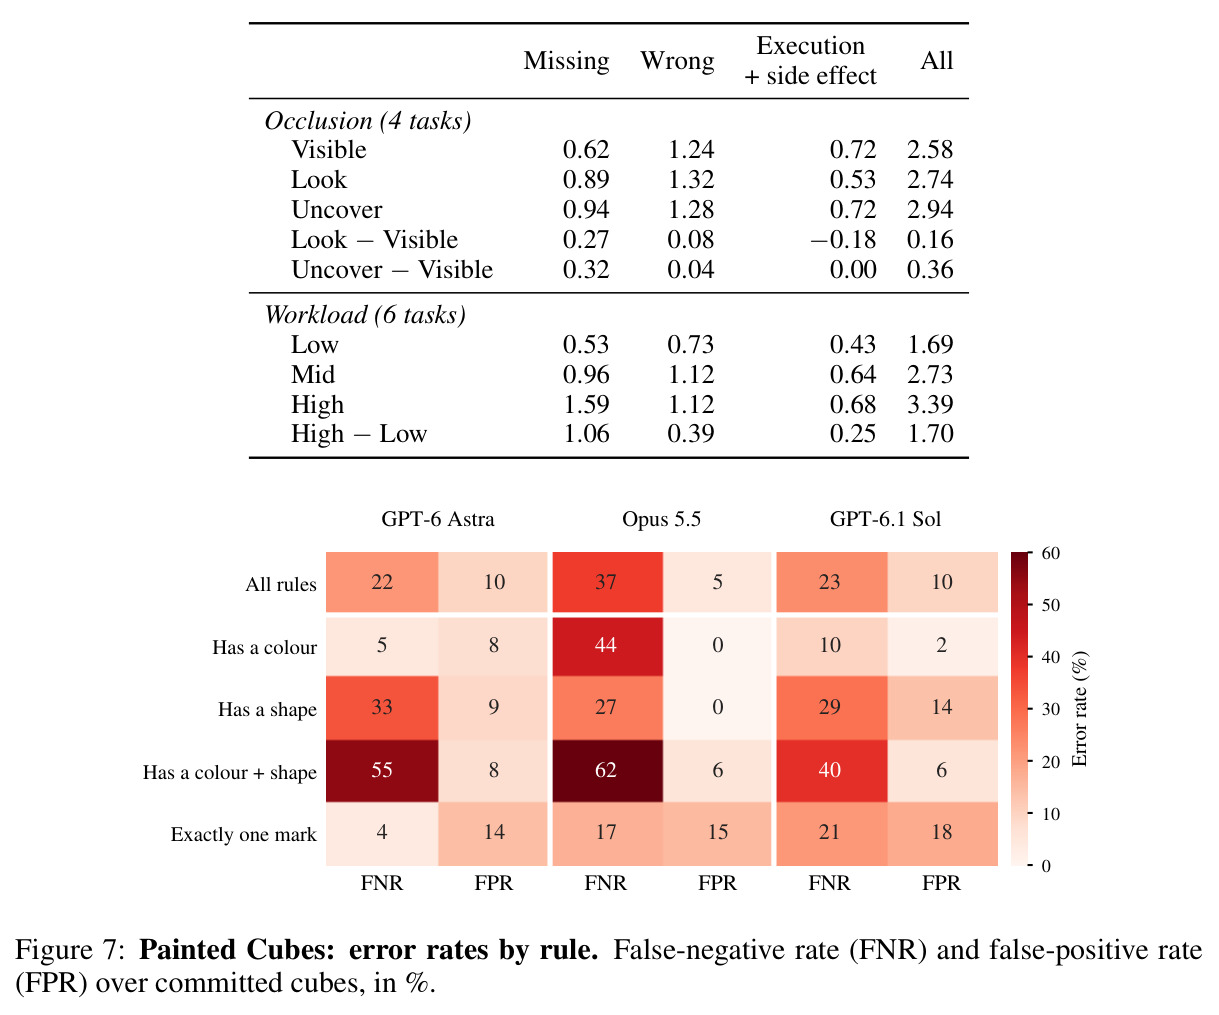
主实验(每模型 500 回合)给出三个层次的结论。其一,总体成功率极低:GPT-6 Astra 以 23.2% 居首(10 个任务中 7 个最高),Opus 5.5 13.8%、GPT-6.1 Sol 12.2%、Fable 5.1 11.4%、Gemini 3.8 Flash 仅 2.0%;去掉最简单的 Puzzle Box 后 Astra 也只有 15.1%。两个开放搜索任务几乎全军覆没:Blackout Search 无任何模型成功过任何一集,Search Room 仅 Gemini 成功 1 集;而 Puzzle Box 上 Astra 达 96%,比其次好任务高出 44-58 个百分点。其二,执行不是瓶颈:孤立技能测试中三个模型达 72-81%(翻转立方体 100%、按指示开盒 90-100%,开抽屉柜仅 30-60%),且全任务中开目标所在储物格的成功率(75-90%)反而高于孤立测试(30-60%)、决策数从 22-36 降到 10-26。失败归因(931/1143/1182 个失败单元)显示缺失证据占 43/43/46%、错误决策占 23/31/25%,合计 66-74%,执行失败仅 18-21%、副作用 7-13%。其三,失败模式高度一致:约一半失败(45/53/50%)中任务所需物品从未被放置,其中 27-29% 的物品藏在从未打开的容器里——而这些容器在观测中平均出现 5 次以上(从未被看见的只占 1-2%);9-11% 的失败是过早提交:Odd Parcel 中 71-84% 的错包未称重就装箱,Stamp Composition 中 20-23% 的印章没试印。遮挡对照实验证实因果:物体移出视野或盖住使成功率下降 8-10 点,且新增失败全部落在'缺失证据'类。Puzzle Box 遮锁实验分离出交互推理差异:挡住滑栓联动后 Astra 不受影响(94.4%→96.4%),Opus 5.5 从 94.4% 暴跌至 36.8%(26 个失败中 12 个是反复拉被锁螺栓 3 次以上不更新计划),Sol 从 72.2% 降至 60.1%。微调 π0.5 几乎全灭:仅 Puzzle Box 2% 成功率/43.3% 进度,其余任务全为 0%。成本方面五个模型共花费 $21,352:GPT-6.1 Sol 每集 $1.99、每成功 $16.3 最经济,Fable 5.1 与 Gemini 3.8 Flash 每成功约 $168。
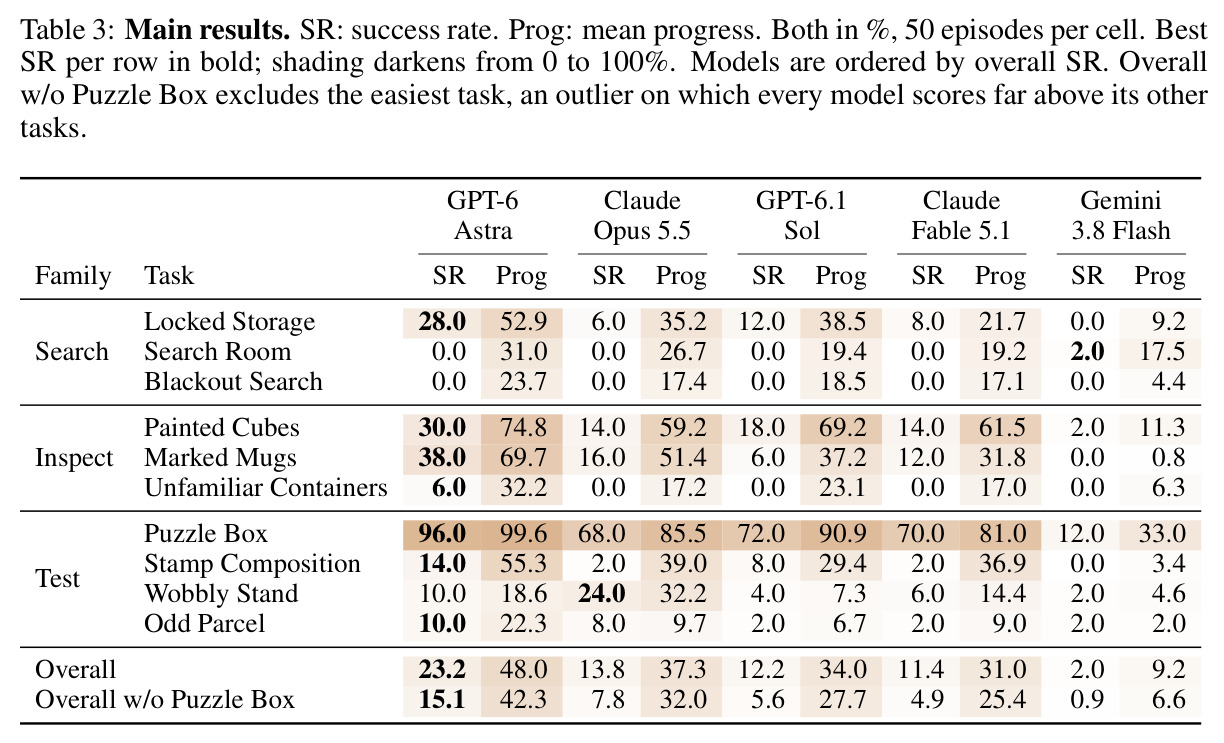
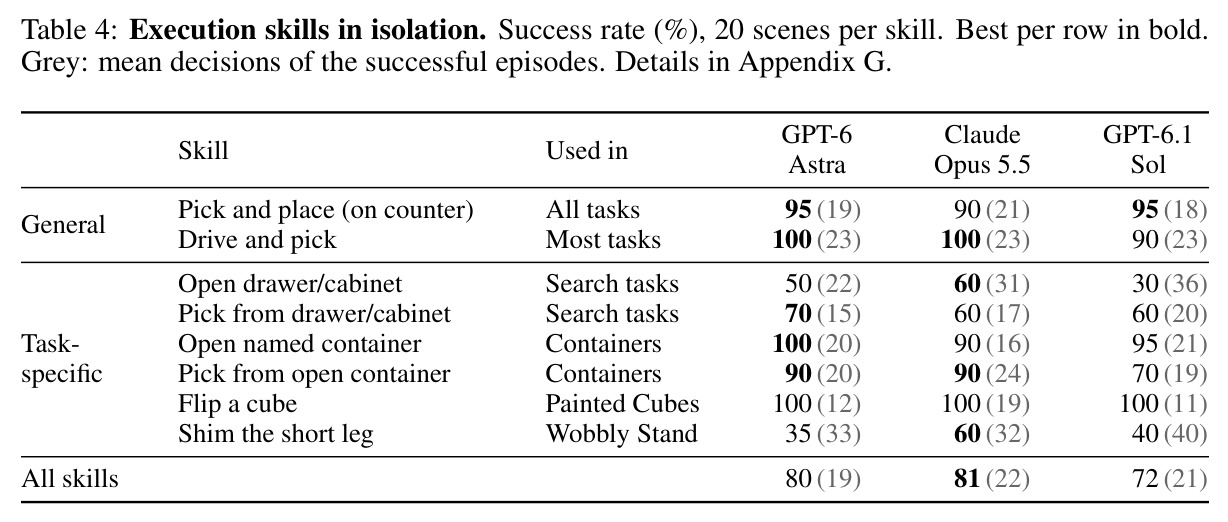
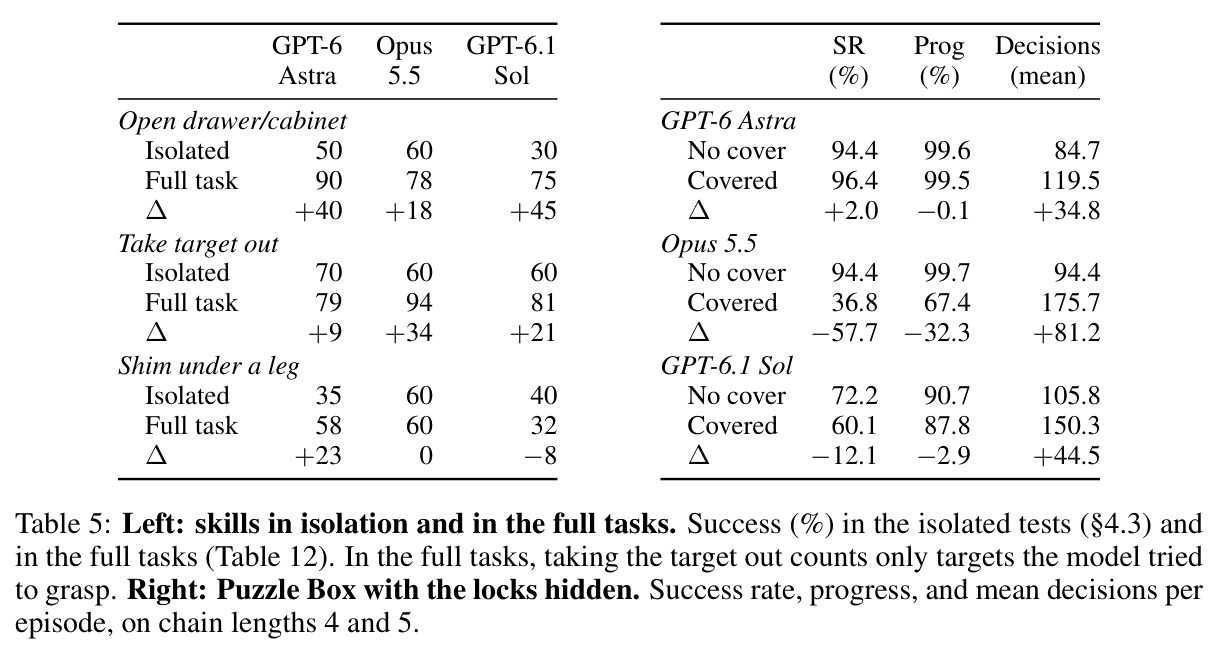
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 总体(10 任务) | 成功率 SR (%) | GPT-6 Astra 23.2 | Opus 5.5 13.8 / Sol 12.2 / Fable 5.1 11.4 / Gemini 3.8 Flash 2.0;微调 π0.5 ≈ 0 | 比第二名高 9.4 个百分点,但仍不足四分之一 |
| 总体(剔除最易的 Puzzle Box) | 成功率 SR (%) | GPT-6 Astra 15.1 | Opus 5.5 7.8 / Sol 5.6 / Fable 5.1 4.9 / Gemini 0.9 | Astra 是其他三个强模型的 1.9-3.1 倍 |
| Blackout Search(黑暗搜索) | 成功率 SR (%) | 0(所有五个模型) | 无先前基准可比 | 开放搜索能力完全未解决,无模型成功过任何一集 |
| Puzzle Box(最易任务) | 成功率 SR (%) | GPT-6 Astra 96.0 | 微调 π0.5 仅 2.0(进度 43.3%) | 暴露 VLA 死记映射在多阶段依赖任务上的崩溃 |
| 孤立执行技能(9 种技能 × 20 场景) | 成功率 (%) | Astra 80 / Opus 5.5 81 / Sol 72 | 同模型全任务成功率 23.2 / 13.8 / 12.2 | 给出隐藏信息后执行大多没问题,证明瓶颈不在执行 |
| 失败归因:缺失证据 | 占失败单元 (%) | 43 / 43 / 46(三模型) | 执行失败仅 21 / 19 / 18 | 探索与决策类失败合计 66-74%,远超执行类 |
| Puzzle Box 加盖隐藏锁链(交互推理对照) | 成功率 (%) | Astra 96.4(几乎不受影响) | Opus 5.5 从 94.4 跌至 36.8;Sol 从 72.2 跌至 60.1 | 干净地分离出因果假设检验能力的模型间差异 |
| 成本效率 | 美元/成功回合 | GPT-6.1 Sol 16.3 | Astra 48.7 / Opus 5.5 49.5 / Fable 5.1 168.6 / Gemini 168.3 | 最优者便宜约 10 倍 |
局限与改进
作者承认并在文中体现的局限:所有实验都在 MuJoCo 仿真的 RoboCasa365 厨房中进行,物理保真度与视觉真实感和真实世界有差距,结论能否迁移到真机未知;前沿模型是快速迭代的专有 API,具体排名(如 Astra 23.2% 领先)会随版本更新迅速过时;每任务仅 50 个评估实例、每模型 500 回合,用于区分 11-14% 之间的模型统计功效有限;全量评估花费 $21,352,重跑门槛高。我自己的观察有四点:其一,harness 只保留最近两次观测的图像(共 6 张),这可能系统性地惩罚不主动维护记忆的模型,使'缺失证据'类失败被高估——一个带显式笔记或记忆机制的智能体或许表现完全不同;其二,200 决策预算和每命令 10 秒上限可能使慢而彻底的探索策略(如穷举搜索整个厨房)在结构上不可能完成,Blackout Search 的全零或许部分是预算而非能力问题;其三,π0.5 只做了 SFT 一种训练方式,没有尝试 RL、示范加失败数据联合训练或记忆增强架构,'VLA 学不会探索'的结论下得略强;其四,失败归因中'副作用'类无法区分预见不足与碰撞失误,归因规则虽确定性但由作者设计,存在编码偏差的可能。
独立分析的弱点
独立分析本文的弱点:第一,观测记忆瓶颈是评估设计的混杂因素——图像历史被裁剪到两帧,模型每一步都在丢失旧证据,这会人为放大'看过但没记住/没再去找'的失败(约占失败三成),改进方向是给被试模型提供等价的证据日志(自动截图档案)或支持模型主动调用的'回看'工具,把'不会探索'与'记不住'分开归因。第二,训练基线过弱且单一:π0.5 是无记忆的马尔可夫 SFT 策略,对探索任务先天不适配,用它的失败推广到'学习式策略'欠公平;改进方向是在演示上做在线 RL(以 progress 差分和信息增益为奖励),或训练带显式信念状态的分层策略(高层决定调查什么、低层执行操作)。第三,任务族间难度极不均衡(Puzzle Box 上 Astra 96% 对 Blackout Search 全零),使总体均值对个别任务高度敏感,改进方向是按能力加权或强制报告分族得分。第四,评估成本随 API 定价波动且昂贵(每模型 $997-$9,610),不利于社区广泛使用,改进方向是发布每任务 10 实例的廉价代理套件用于快速迭代。第五,副作用分析止步于分类,没有量化探索收益与破坏的权衡('为读标签洒出球'本身是合理策略),改进方向是引入显式的探索风险预算指标,把'敢不敢探索'与'会不会善后'分开度量。
未来方向
作者在结论中指出,具身探索的进步需要四项能力:系统性的证据获取、持续的目标与证据跟踪、因果假设检验、以及物理交互过程中的鲁棒监控与恢复。基于本文成果可自然延伸的方向:(1) 记忆增强 VLA——演示数据每帧的 stage/subtask 标注可作显式记忆监督,训练能在长回合内维护'已查/未查'账本的策略;(2) 探索激励的 RL——以 progress 差分加信息增益为奖励,用发布的 5,000 条演示做冷启动,在仿真中低成本试错;(3) 失败数据利用——基准发布了逐单元失败标签,可直接用于 DPO 或对比训练,惩罚'过早提交'、奖励'充分探索后再行动';(4) 主动感知架构——把 Inspect 族任务(翻转、抬起查看)作为主动感知策略的训练场,与 SapAVE、ActiveVLA 等工作衔接;(5) Sim-to-real——在真机厨房复刻 Blackout Search 和 Unfamiliar Containers,检验前沿模型在真实黑暗与真实容器机构上的探索能力;(6) 多智能体协作探索——Search 任务天然可分工,测试智能体间如何共享与汇总证据;(7) 把 SUBMIT 判断建模为显式的证据充分性校准问题,量化模型对'我知道什么/不知道什么'的元认知。
复现评估
复现条件在基准类工作中属于较好的一档。开源情况:项目页 declare-lab.github.io/RoboQuest 公开基准;演示数据以 LeRobot v2.1 格式发布(10 任务 × 500 集,20 Hz,256×256 三路视频+16 维状态+12 维动作+两级语言标注),并附再生成脚本可重渲染其他分辨率;评估 harness 基于开源 Inspect Robots 框架;任务评分规则、失败归因规则、逐单元标签全部随基准发布,归因算法(Algorithm 1)完全程序化且确定性,可独立复检。数据与算力:仿真基于开源的 MuJoCo 与 RoboCasa365;π0.5 微调给出完整超参(AdamW、峰值学习率 $2.5\times10^{-5}$、全局 batch 32、flow 损失权重 10、10 步去噪),每任务单独训练,单任务数据量约 14-62 小时交互,单机多卡可行。主要门槛是前沿模型评估费用:全量复现五模型约 $21,352,但可裁剪——GPT-6.1 Sol 单模型全量约 $997,每任务减到 10 实例的快速版可再降一个量级;孤立技能测试与失败归因不产生额外模型调用成本(基于已记录日志回放)。总体难度评级:中等——代码、数据、规则齐备,学术实验室以数千美元 API 预算加单节点 GPU 即可复现核心结论,但前沿模型部分的排名结论受 API 版本演进影响,无法长期冻结复现。
论文图表
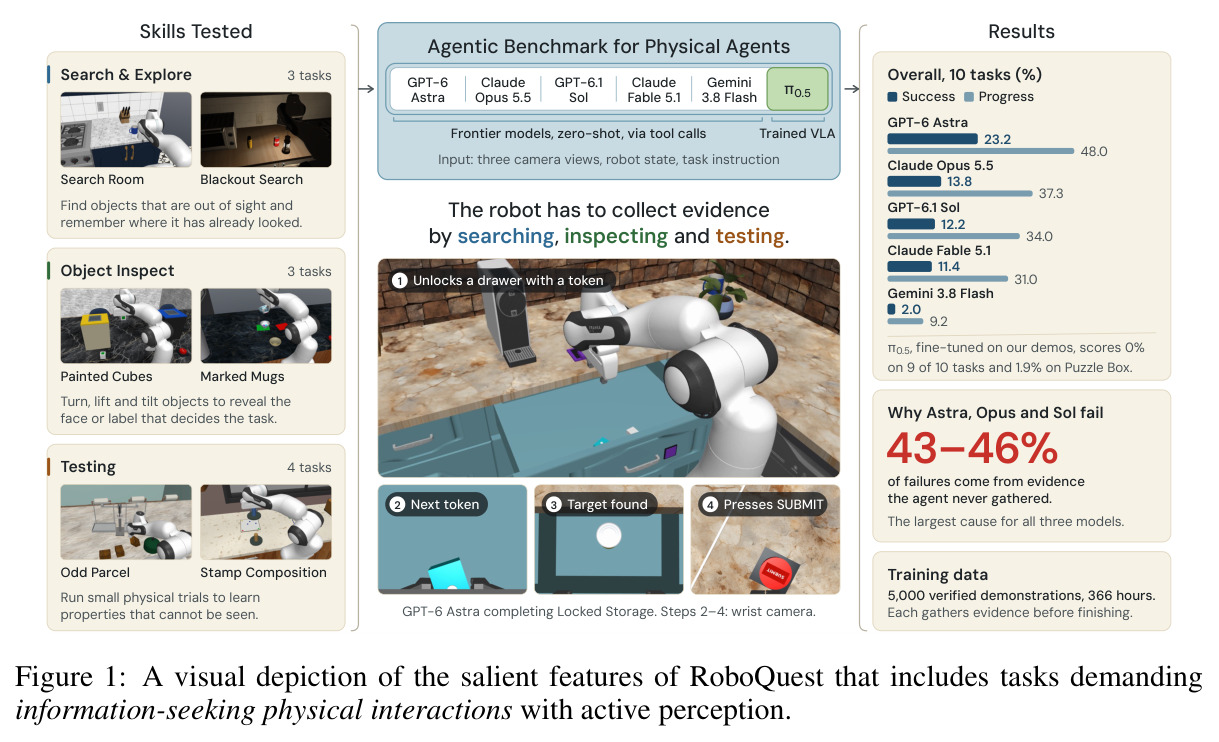
一页式概览:上半部分列出技能三族(Search 3 任务、Inspect 3 任务、Test 4 任务)与五个前沿模型加 π0.5 的总体成绩(GPT-6 Astra 23.2%、Opus 5.5 13.8%、Sol 12.2%、Fable 5.1 11.4%、Gemini 2.0%、π0.5 在 9/10 任务 0%),中部为 GPT-6 Astra 完成 Locked Storage 的四步腕相机画面(解锁抽屉→发现目标→按 SUBMIT),并标注三大发现:43-46% 的失败源于从未收集的证据、5,000 条验证演示共 366 小时、微调 π0.5 几乎全失败。
一图浓缩基准构成、全部成绩与核心结论,是快速把握全文的入口。