构建而非游玩:自我改进的LLM研究智能体打造出媲美顶尖玩家的炉石酒馆战棋AI Build, Don't Play: Self-Improving LLM Research Agents Develop a Hearthstone Battlegrounds AI That Rivals Top Players
LLM智能体团队自主运营研究闭环,20天造出酒馆战棋模拟器并训练出天梯顶尖AI
前置知识
PPO(近端策略优化)
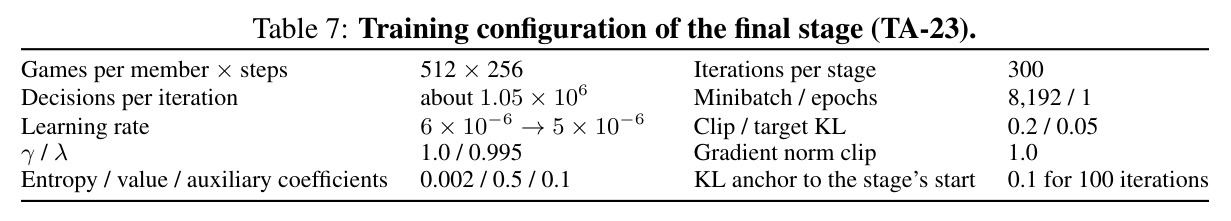
PPO 是策略梯度强化学习算法,通过裁剪重要性采样比率 $r_t(\theta)$ 限制每次策略更新的幅度,在样本效率与稳定性间取得平衡,是游戏 RL 与 RLHF 的常用骨干。本文用它配合 18M 参数的实体 Transformer 训练 TavernAgent,每阶段约 3.1 亿决策,阶段间用 KL 锚定防止遗忘。
论文的智能体训练完全建立在 PPO 之上,理解其小步更新加优势估计的思想,才能看懂训练配方、23 个版本迭代的实验设计以及评估门为什么要在未见种子上复检。
部分可观测随机博弈(POSG)
多智能体 MDP 的扩展:状态转移含随机性,且每个玩家只能观察部分状态。酒馆战棋中玩家只见自己的局面和对手上次战斗暴露的阵容,商店与战斗都随机,奖励只在终局以名次 $1$ 到 $8$ 给出,一局约 15 回合、每人约 450 个原子操作。
论文第 3 节把整局游戏形式化为 POSG,这是理解玩家视角观测编码、对手建模与终局名次效用设计的数学基础,也解释了为何模拟器必须同时覆盖招募与战斗两个阶段。
实体Transformer与指针动作头
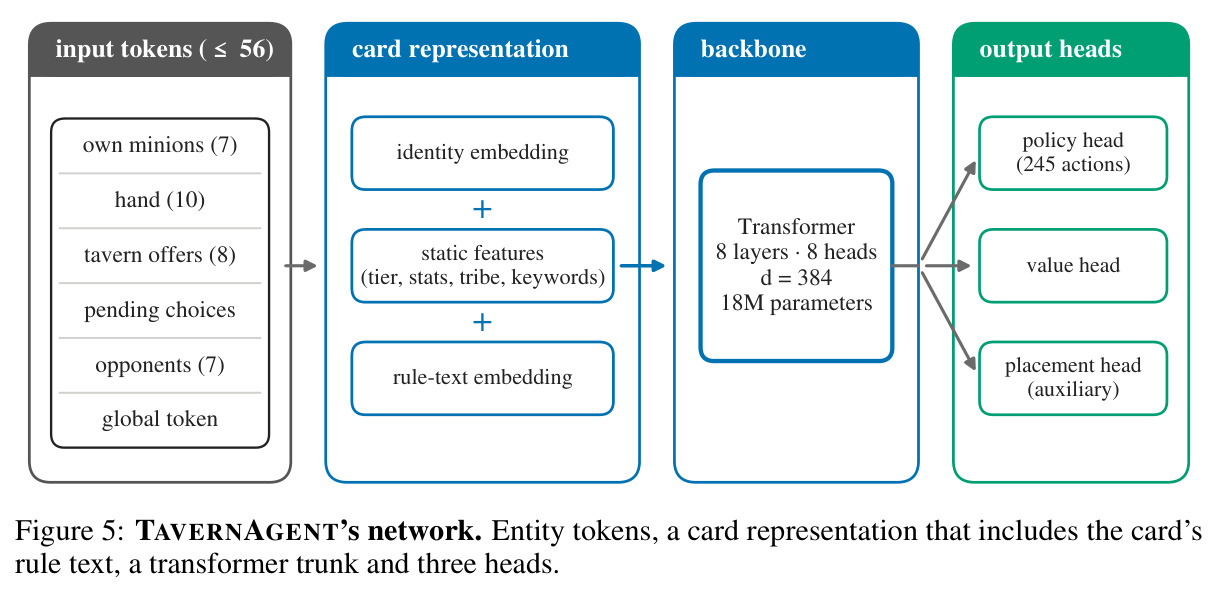
把每个游戏实体(随从、手牌、商店 offer、待定选择、对手)各编码为一个 token,用 Transformer 融合上下文后,由指针头在 245 个离散动作上输出带精确合法掩码的 logits,另配价值头与名次头。卡牌表示为身份嵌入加静态特征加规则文本嵌入。
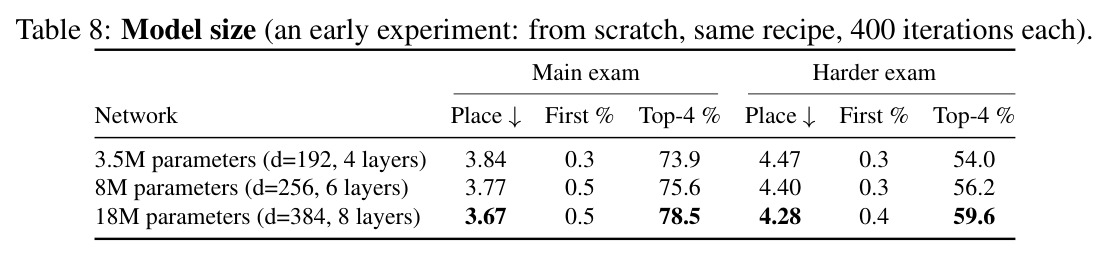
TavernAgent 的结构(最多 56 个 token、$d{=}384$、8 层 8 头、18M 参数)是理解它为何能 0.03 秒出决策、并在 TavernBench 上碾压通用 LLM 的关键,也是复现训练的第一入口。
自博弈与对手建模
自博弈让智能体与自己的旧版本对练,容易陷入循环克制;对手建模则用人类玩家统计数据构造对手库。本文不用自博弈,而是 7 个由顶尖人类统计构建、并按天梯实际遭遇逐回合校准的图书馆席位,考试用的席位永不参与训练。
消融实验显示对手校准是最大单项增益(首胜率 20.9% 到 27.2%),这是现实锚定思想在训练侧的具体体现,理解它才能读懂表 3 的消融设计。
代理指标漂移与赢家诅咒
当只能优化代理 $\hat{J}$ 而真实目标 $J(\pi)$ 只能通过少量昂贵真人对局观测时,$\hat{J}$ 的提升可能不代表 $J$ 的提升,称为代理漂移;赢家诅咒指从大量候选快照中挑出的最优者,其收益在未见数据上被系统性高估。本文用现实回环对抗前者,用 G4 未见种子复检对抗后者。
论文第 4、8 节的方法论核心都围绕这两种统计陷阱展开,六个被抓的错误里多数是其具体表现,不懂这两个概念就看不出五道验证门的必要性。
LLM 研究智能体
以 LLM 为核心、能提出假设、写代码、跑实验并解读结果的自动化科研系统,代表工作有 AI Scientist、MLAgentBench、MLE-bench、RE-Bench、PaperBench 等,多按想法到实验到报告的流水线组织,评估停留在基准任务或论文评审层面。
AutoTavern 属于这一谱系,但把它推到从原始数据到打赢真人的完整真实问题上,并引入类型化研究记忆与验证门等新机制,了解已有系统才能看清本文的差异化贡献。
研究动机
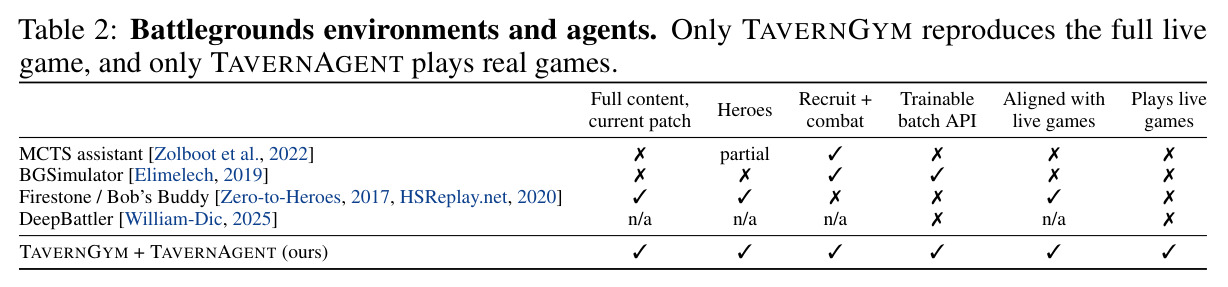
现有 LLM 科研智能体的证据停留在基准任务与论文评审层面(AI Scientist、MLAgentBench、MLE-bench、RE-Bench、PaperBench),尚无系统能把一个困难的真实问题从原始数据一路推进到与人类正面较量并站稳的成品。以炉石传说酒馆战棋为例:八人自动战斗棋,随机商店与战斗、七个对手的隐藏信息、共享卡池、近千张互相作用的卡牌(当前补丁 36.6.3 有 978 个游戏对象)、终局才给名次奖励。此前不存在忠实复现真实对局的模拟器:Zolboot 等 2022 年的 MCTS 助手用简化模拟器且只在录像局的前几回合评估;开源 BGSimulator 缺少英雄;Firestone 与 Bob's Buddy 只模拟战斗阶段算胜率;DeepBattler 只用 LLM 给人类建议。而 Go、StarCraft II、Dota 2 等超人类系统都是大型专家团队多年打造环境的产物,把环境构建这一步交给智能体从未被验证过。
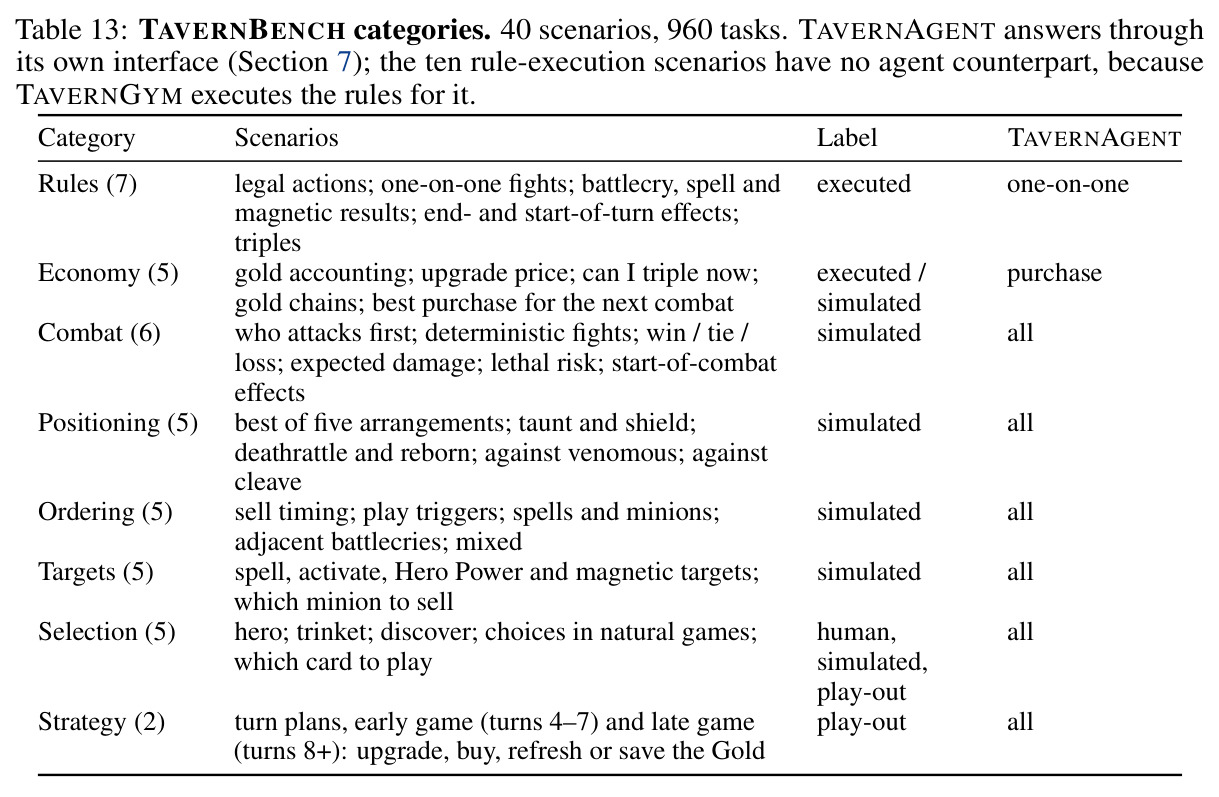
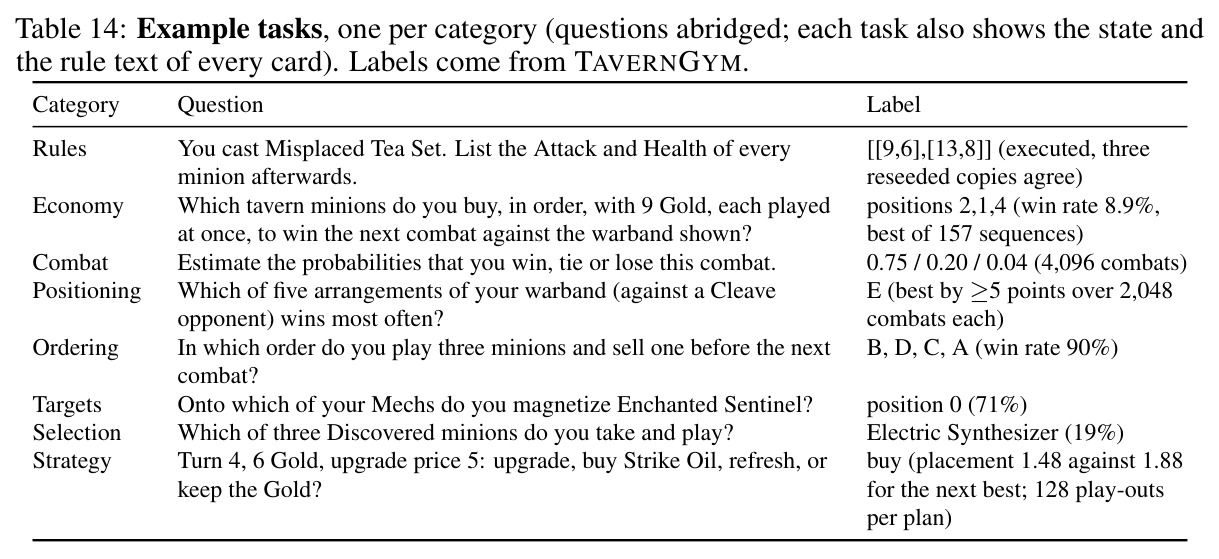
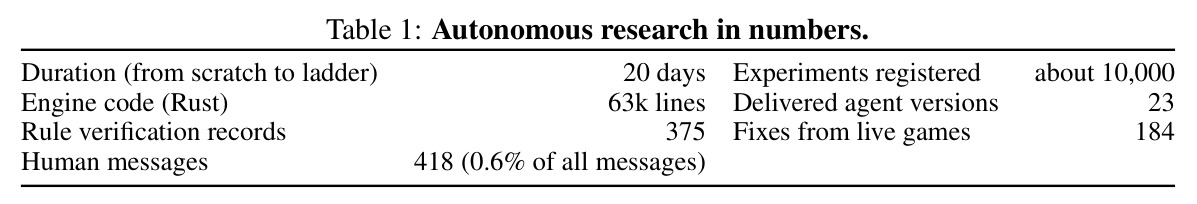
本文的目标是本文要回答:LLM 智能体能否自主地把一个困难的真实博弈问题从原始游戏数据推进到能与人类抗衡的完整系统?具体交付四件东西:一是 AutoTavern 自我改进研究系统,20 天内自主运行约 10,000 次实验、交付 23 个智能体版本,全程人类仅发 418 条消息(占全部消息的 0.6%),只负责设目标、裁决模糊机制并按下 AI 指名的快捷键;二是 TavernGym,首个忠实、全内容的酒馆战棋复现,覆盖补丁 36.6.3 全部 978 个对象,单核每秒 190 到 280 场完整对局;三是 TavernAgent,首个在真实天梯上独立完成整局对战的酒馆战棋 AI,从 6,000 分爬向服务器顶尖水平;四是 TavernBench,960 个任务、40 个场景的决策基准,用来检验建造系统的 LLM 与它们造出的系统谁更强。
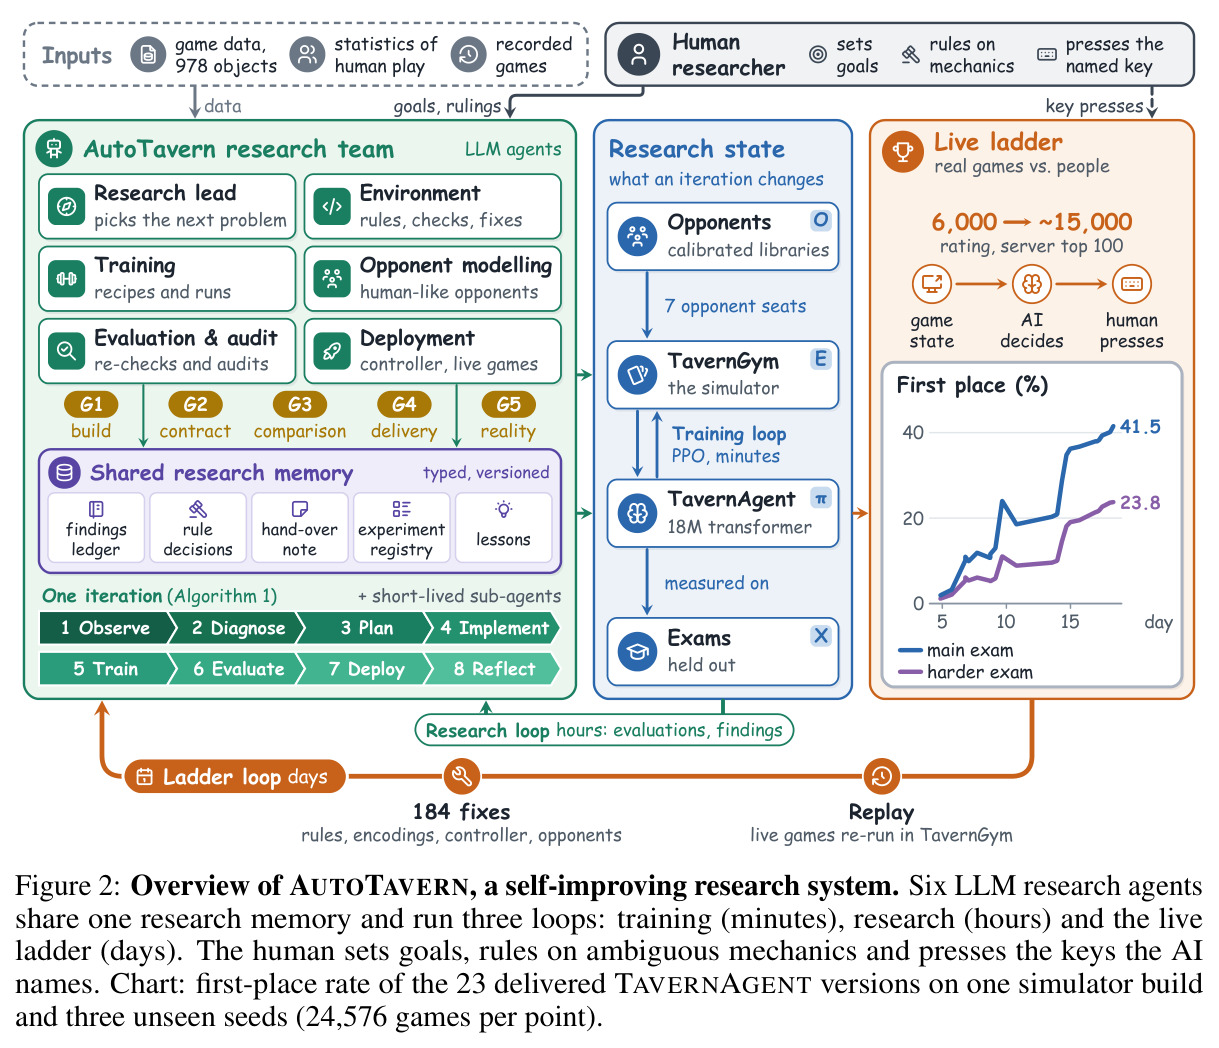
与已有工作不同的是,本文的独特切入是现实锚定的自我改进(reality-anchored self-improvement)。与 AI Scientist 等让智能体改写自身脚手架代码不同,AutoTavern 的智能体通过记忆中的教训和新验证门来改进研究过程本身;与以往只在模拟环境中训练并对齐的做法不同,它把真实天梯对局作为回环终点:每个代理目标 $\hat{J}(\pi; E_t, O_t, X_t)$(模拟器 $E_t$、对手模型 $O_t$、考试 $X_t$)都按固定节奏被真实对局重新锚定,而真实表现 $J(\pi)$ 只能通过少量昂贵的真人对局观测。它同时针对两类已知失败模式给出机制化防线:代理漂移由现实回环纠正(184 处现实触发的修复),虚假发现由五道验证门(G1 构建、G2 契约、G3 比较、G4 交付、G5 现实)在结论写入共享记忆前证伪。这套机制让首胜率在 20 天内从 1.9% 升至 41.5%。
核心方法
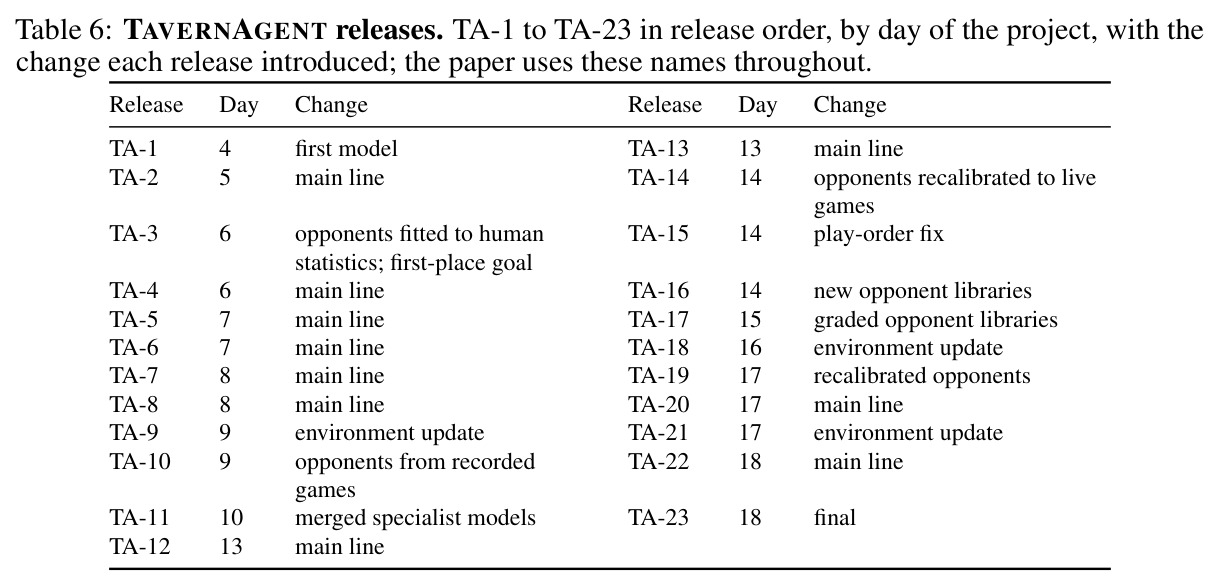
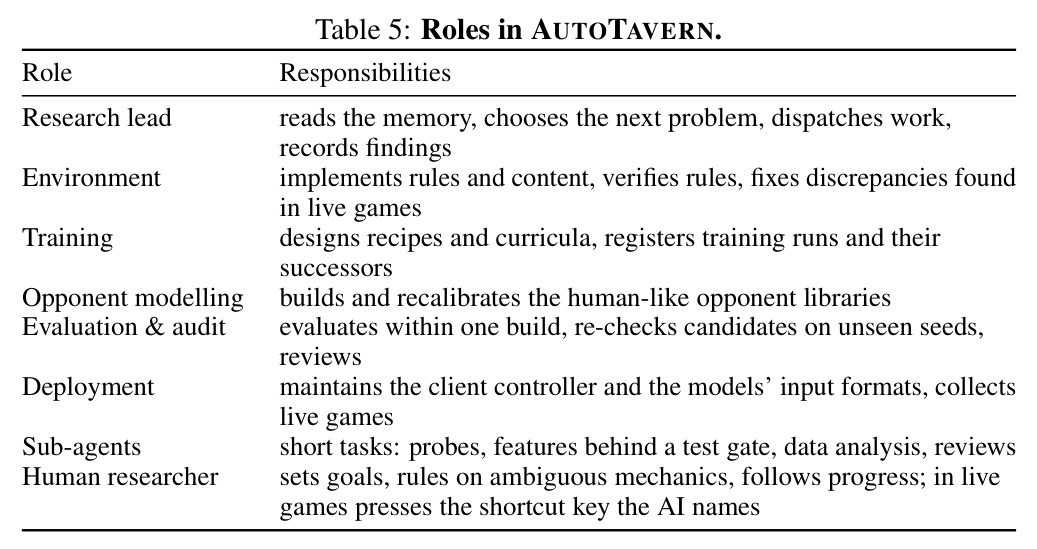
直觉上 AutoTavern 像一个无人研究组:六位常驻 LLM 研究员(研究负责人、环境、对手建模、训练、评估审计、部署)各司其职,短生命周期子智能体负责探测与实现功能;它们从不直接对话,只通过类型化、版本化的共享研究记忆交流,包括编号发现的台账(修正也作为新条目回指旧条目)、规则裁决登记簿、交接便签、实验登记簿和每次会话开始加载的教训库。三个时间尺度不同的循环驱动系统:训练循环每几秒到几分钟做一次策略更新,研究循环数小时完成实验与发现,天梯循环以天为单位让真实对局回流修正模拟器与对手模型。算法 1 定义单次迭代八步:观察、诊断、计划、实现、训练、评估、部署、反思。20 天里系统注册约 10,000 次实验、交付 23 个 TavernAgent 版本、真实对局触发 184 处对规则、输入编码、控制器与对手的修复;人类只发 418 条消息,其中 42% 是要进度报告、24% 设定目标、5% 裁决游戏机制。
核心创新是现实锚定的自我改进。形式化地,第 $t$ 轮迭代的研究状态是工件集合:环境 $E_t$、对手模型 $O_t$、考试集 $X_t$、策略 $\pi_t$,以及研究过程本身即记忆 $M_t$ 与门 $G_t$。真实目标 $J(\pi)$(天梯期望名次)只能通过少量昂贵真人对局观测,循环内只能改进代理 $\hat{J}(\pi; E_t, O_t, X_t)$。AutoTavern 的机制有三层:其一,每个代理按固定节奏被现实重新锚定,部署版本打真实天梯,对局记录回放进 TavernGym,模拟与现实的分歧变成对规则、编码、对手的修复;其二,任何结论必须先通过被设计来证伪它的验证门才能写入共享记忆;其三,被抓住的错误回写为教训或新门,六门错误中两例变成 G4 未见种子复检与 G2 双编码器比特级比对,两例变成常设规则,使循环不为同一错误付两次学费。训练侧最大单项创新是现实校准对手:七个由顶尖人类统计构建、按天梯实际遭遇逐回合校准的图书馆席位取代自博弈,带来首胜率 20.9% 到 27.2% 的最大增益。
方法步骤详情
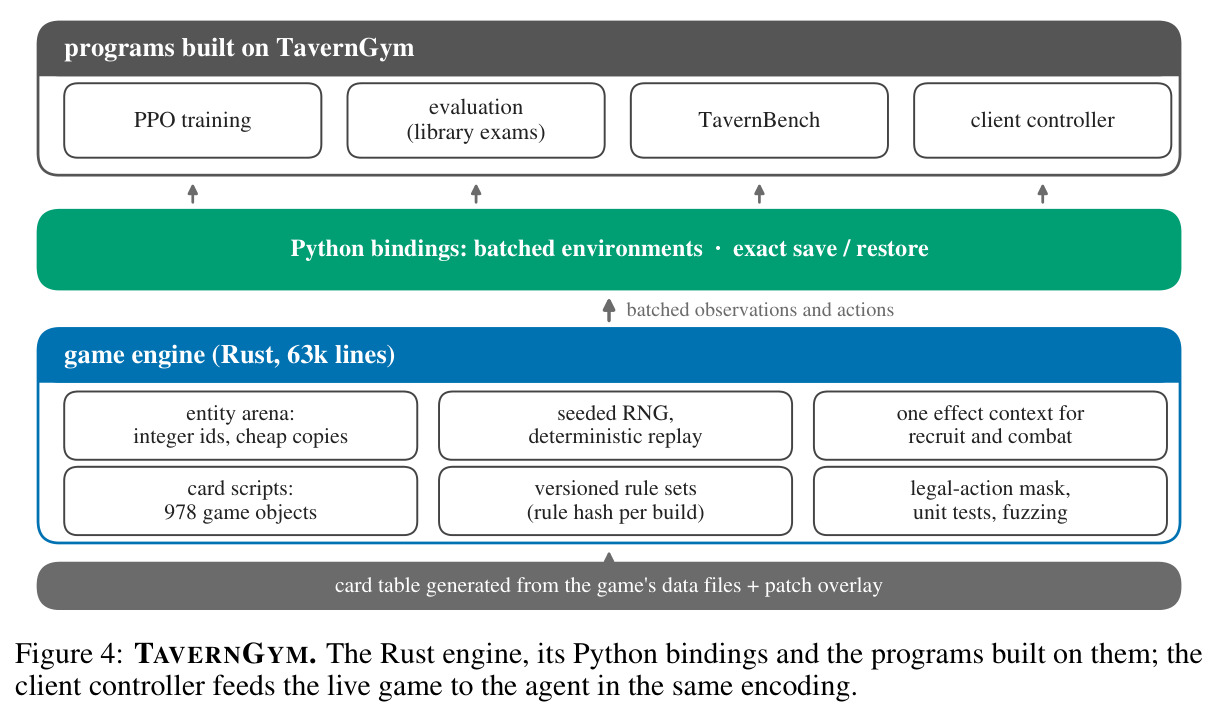
落地分四步。第一步建 TavernGym:Rust 引擎 63k 行加薄 Python 绑定,一个效果上下文同时服务招募与战斗阶段,随机性出自单一种子,动作序列可逐位复现;卡牌数据由游戏文件生成、补丁以覆盖层表达;实现补丁 36.6.3 全部 978 个对象,配 375 条规则验证记录;RL 接口暴露 245 个离散动作,单核每秒 190 到 280 场完整对局。第二步训 TavernAgent:实体 Transformer(随从、手牌、offer、对手各一个 token,最多 56 个,指针头输出 245 维 masked logits 及价值与名次头,$d{=}384$、8 层 8 头、18M 参数),PPO 每阶段 300 次迭代约 3.1 亿决策合 57 万局,阶段间加 KL 锚定。第三步天梯部署:控制器把真实客户端状态喂给策略,人类按下 AI 指名的官方插件快捷键。第四步造 TavernBench:960 任务 40 场景,标签来自模拟器——战斗任务跑 4,096 次模拟,短期决策看所选选项后的模拟胜率(与最优差 3 分内算对),战略决策由 TA-21 各打 128 次验证。
技术新颖性
与已有工作的本质区别有三。第一,改进的对象不同:AI Scientist、Eureka、AlphaEvolve 让 LLM 提想法、奖励函数或程序再由自动评估器打分,MLAgentBench 等只负责度量,而 AutoTavern 不改写自身代码,而是把抓到的错误沉淀为教训与新验证门,改进研究过程本身,且进步的裁判是真实天梯上的人类而非模拟指标。第二,任务的位置不同:Go、StarCraft II、Dota 2 等超人类系统从现成环境出发、由大团队手工对齐模拟与真实,本文让智能体自己完成从原始数据建环境这最难的一步,产出首个忠实全内容的酒馆战棋复现(978 对象、确定性、可复现),并用 184 处现实触发的修复系统化对齐模拟与真实。第三,对手建模不同:以现实校准的对手图书馆加逐回合校准替代自博弈。此外 TavernBench 首次为随机多人经济加战斗博弈提供模拟器验证的标签、强专门智能体参照与实时视角,即 1 秒内答对才算数。Kirgis 等 2026 发现智能体能完成开放项目的工程但做不好研究问题,本文正是把研究问题本身交给智能体的回应。
实验结果
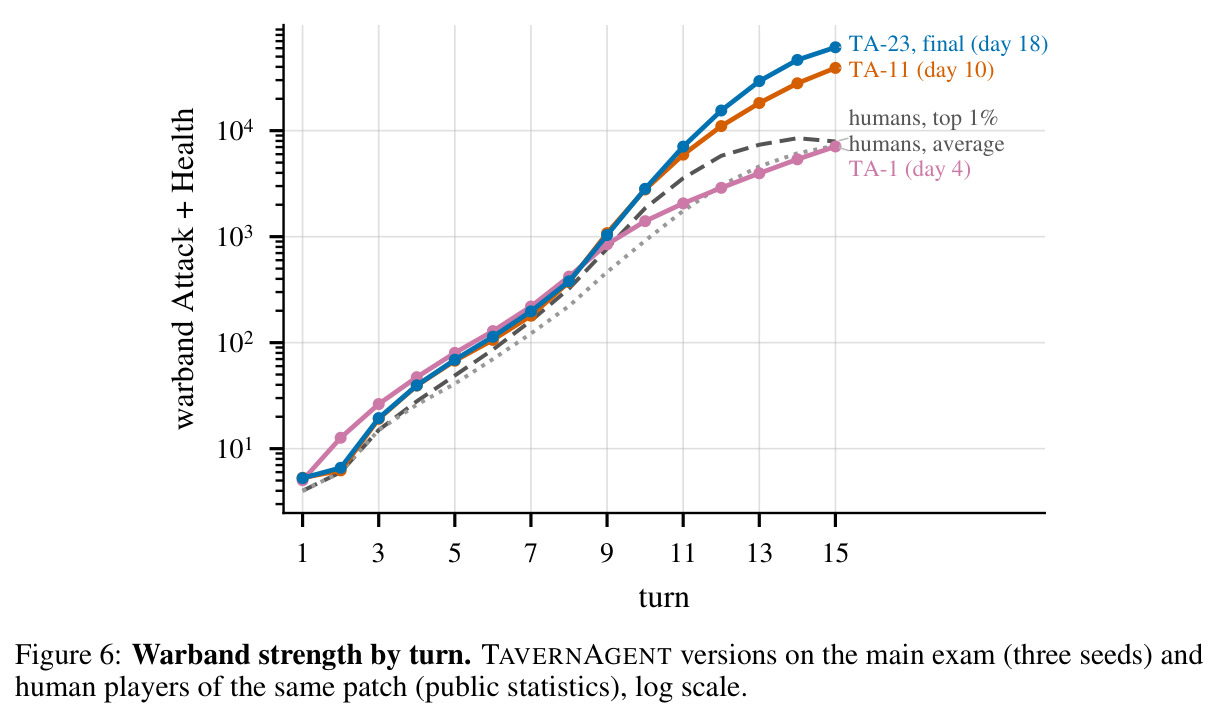
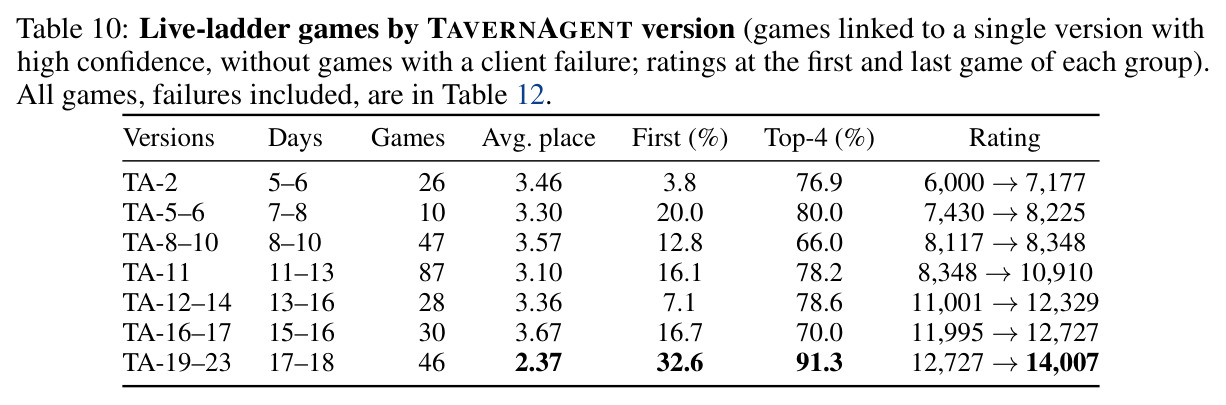
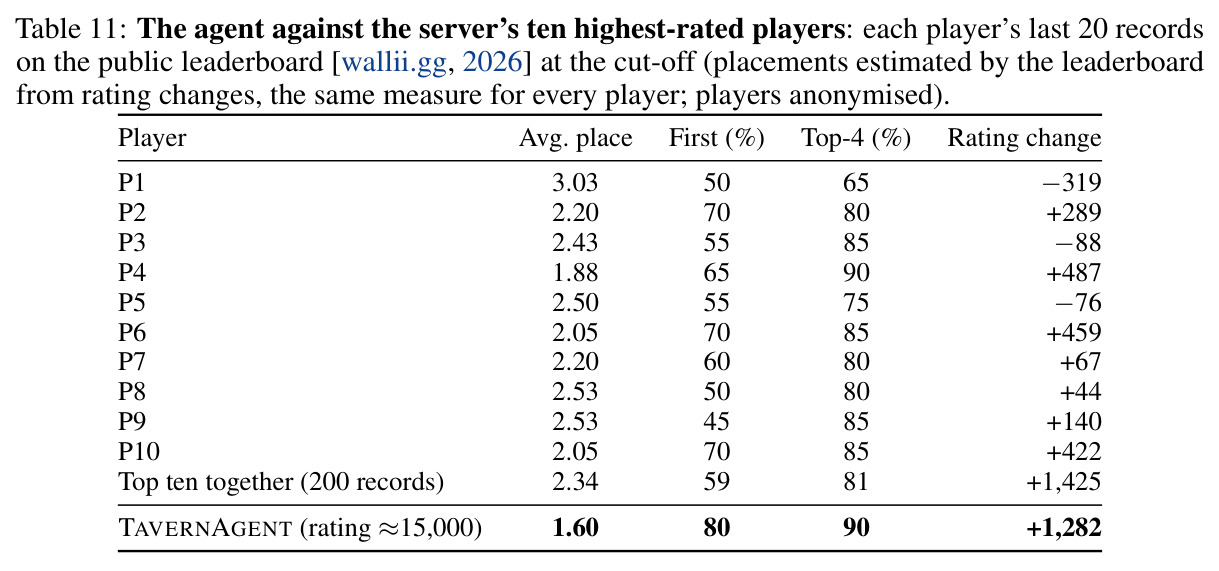
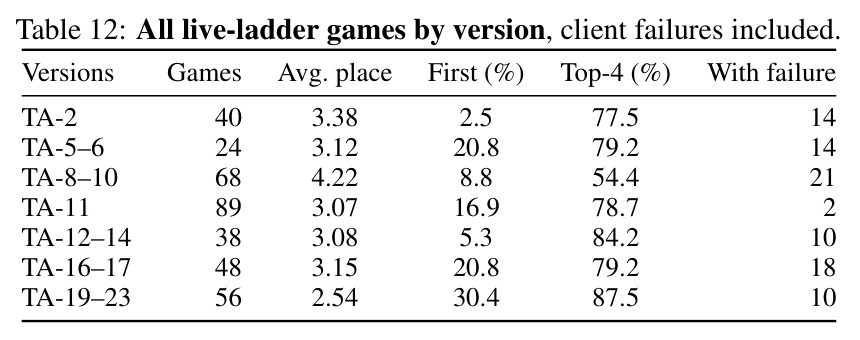
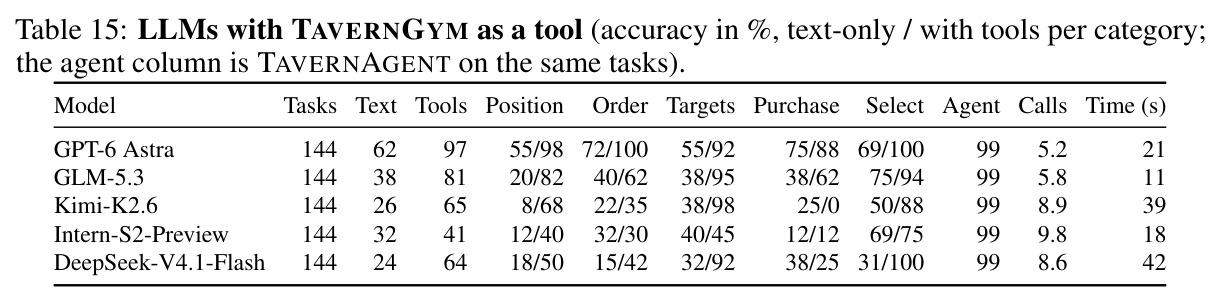
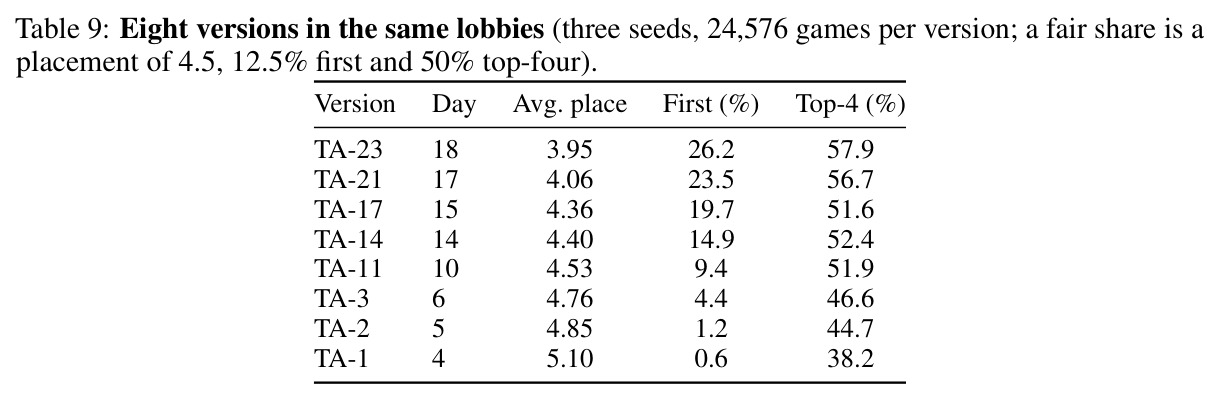
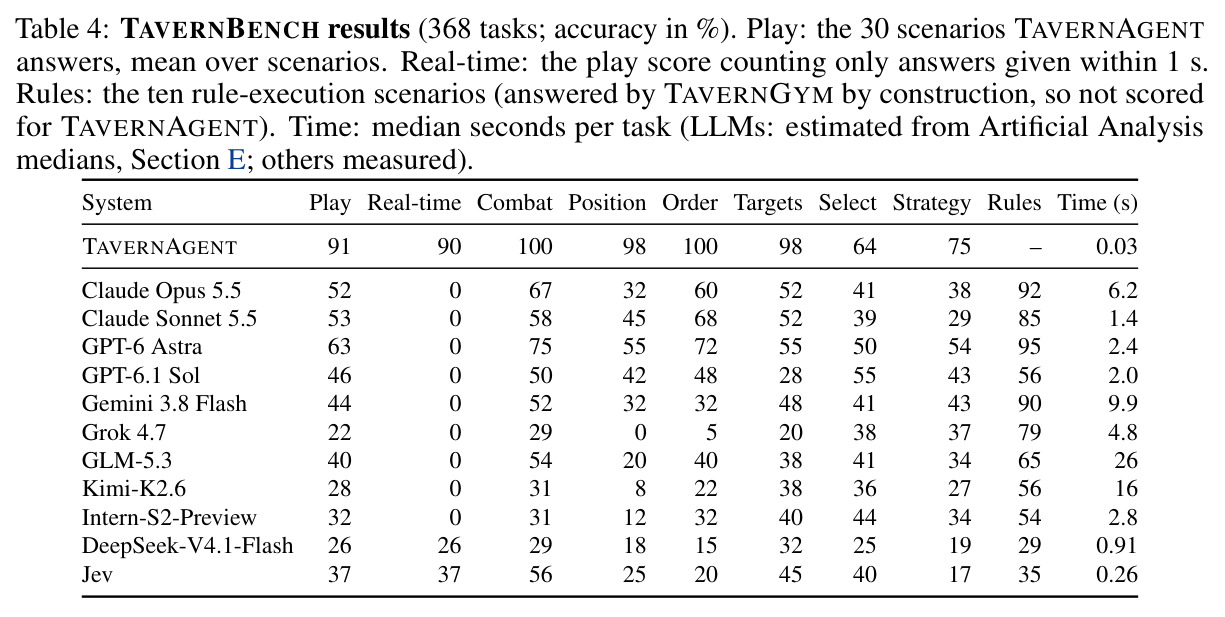
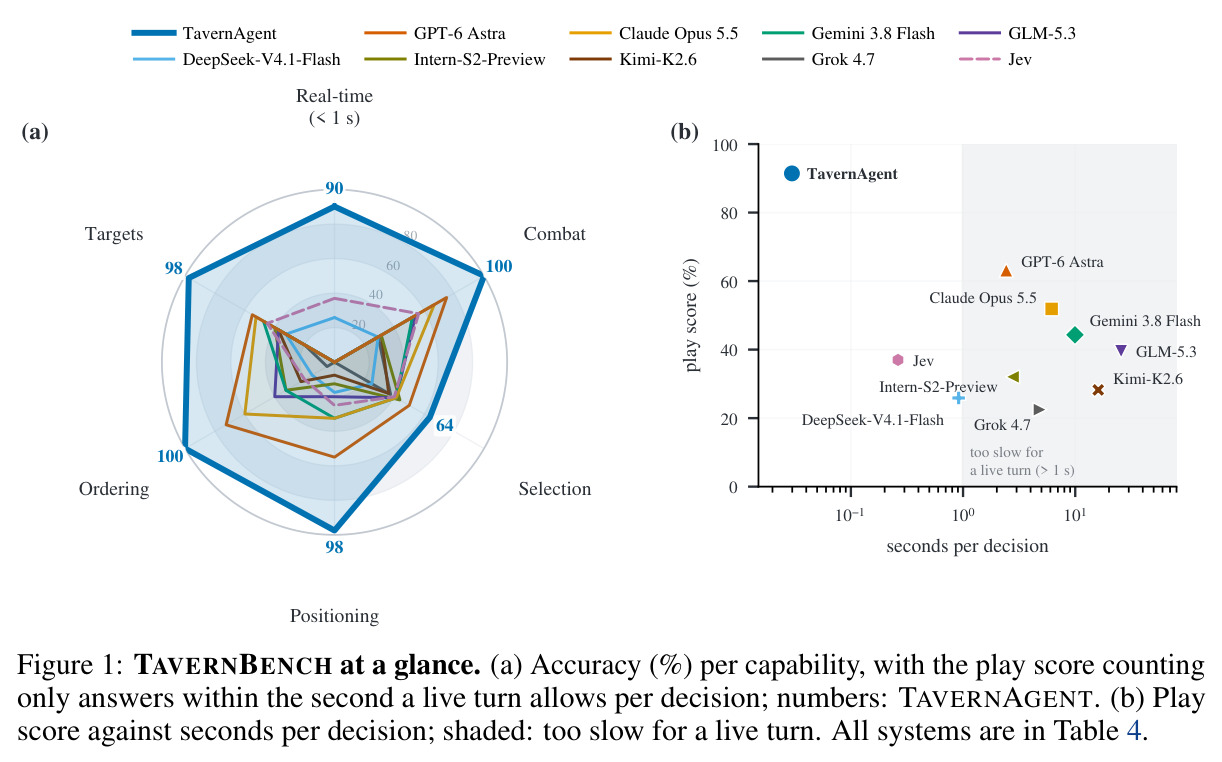
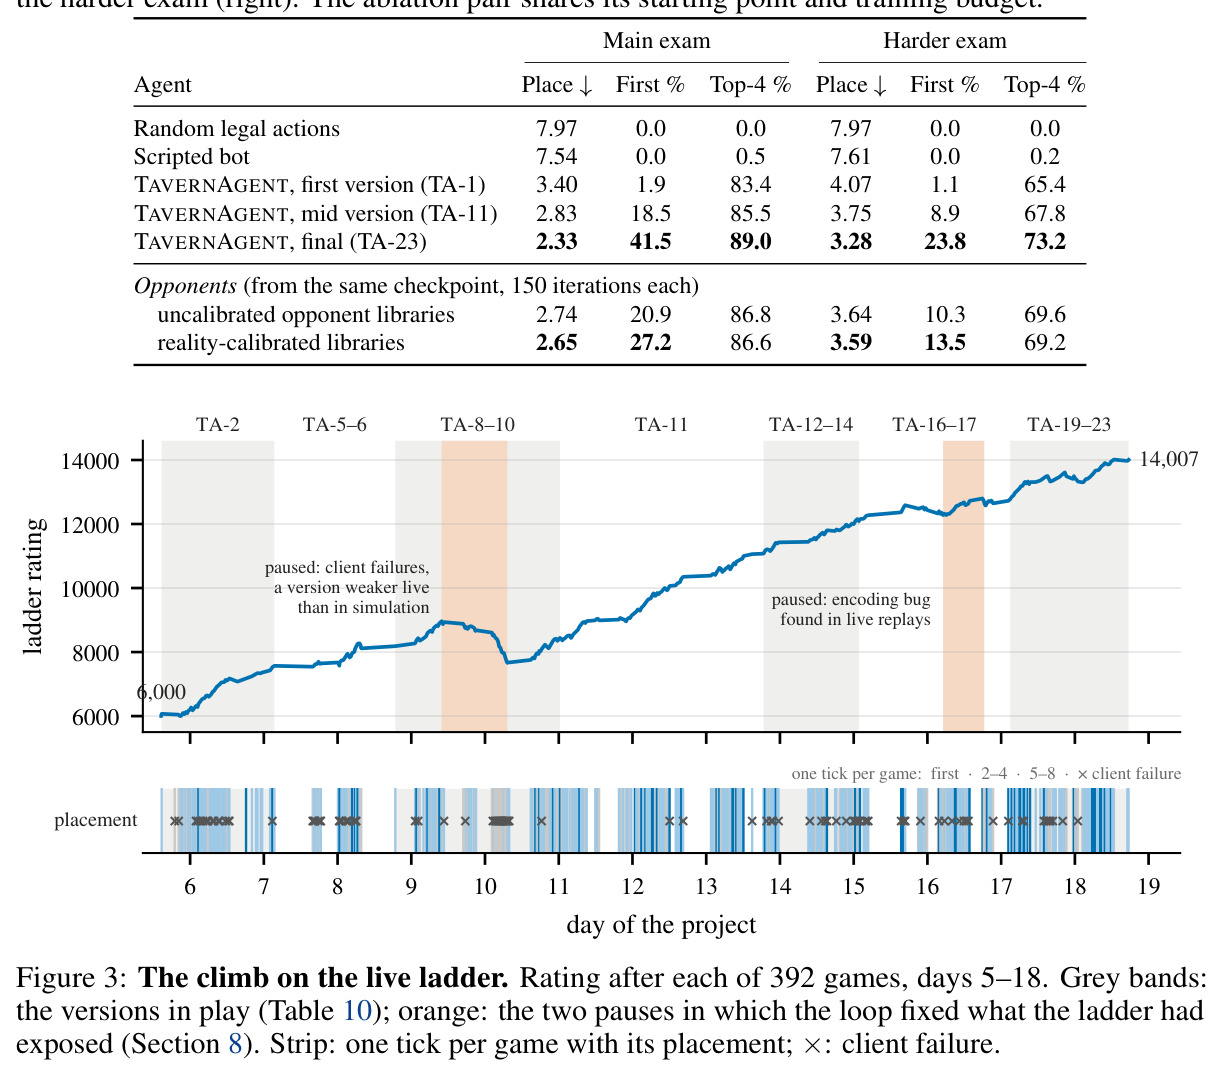
版本迭代:同一构建、三个未见种子的主考试上,TA-1 首胜率 1.9%(平均名次 3.40)升至 TA-23 的 41.5%(名次 2.33),随机与脚本基线均为 0%;对手消融中校准对手库把首胜率从 20.9% 提到 27.2%。其二,真实天梯:392 局评分从 6,000 升至 14,007,结束时约 15,000 分、服务器前 100;最近 20 场平均名次 1.60、80% 夺冠,优于前十玩家的 2.34 与 59%。其三,TavernBench(368 任务):TavernAgent 演玩任务 91%、实时(1 秒内)保持 90%、每决策 0.03 秒;最强 LLM GPT-6 Astra 63% 且实时降为 0%,耗时 1.4 到 26 秒。其四,规则不等于会玩:GPT-6 Astra 规则执行 95% 却只有 63% 演玩分,给它 TavernGym 作工具可从 62% 升到 97%。此外,复制对局曾虚增 23.6 个百分点首胜率,重播种后增益消失(−0.65±1.14);TA-10 考试首胜翻倍却在天梯 32 局内从 8,968 跌至 7,658。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| TavernBench 演玩任务(368 任务,8 场景类别) | 准确率 / 实时(1 秒内)准确率 / 中位耗时 | TavernAgent 91% / 90% / 0.03 秒 | 最强通用 LLM GPT-6 Astra 63% / 0% / 2.4 秒;其余 LLM 演玩 22% 到 53%、实时全部 0%(DeepSeek-V4.1-Flash 26%、Jev 37%),中位耗时 1.4 到 26 秒 | 演玩 +28 个百分点,实时约束下领先 53 个百分点以上,速度领先约两个数量级 |
| 对现实校准对手的完整八人对局(主考试,每点 24,576 局) | 首胜率 / 平均名次 / 前四率 | TA-23:41.5% / 2.33 / 89.0% | TA-1:1.9% / 3.40 / 83.4%;随机合法动作 0% 首胜;脚本机器人 0% 首胜 | 首胜率 +39.6 个百分点,平均名次改善 1.07 |
| 真实天梯对战(392 局,项目第 5 到 18 天) | 天梯评分 / 最近 20 场平均名次与夺冠率 | 6,000 升至 14,007,结束时约 15,000(服务器前 100);最近 20 场 1.60 名、80% 夺冠 | 服务器十位最高分玩家:2.34 名、59% 夺冠(公开排行榜口径) | 平均名次领先 0.74,夺冠率 +21 个百分点,逐项占优 |
| 对手建模消融(同 checkpoint、150 次迭代) | 主考试首胜率 | 现实校准对手库 27.2%(难考试 13.5%) | 未校准对手库 20.9%(难考试 10.3%) | +6.3 个百分点,全系统最大单项增益 |
| 模拟器内容覆盖与速度 | 对象覆盖率 / 单核吞吐 | 978/978 对象;190 到 280 场完整八人对局每秒,战斗 5.2 到 7.6 万次每秒 | BGSimulator 无英雄;Firestone/Bob's Buddy 只模拟战斗;均不能训练整局智能体 | 首个忠实全内容、确定性、可复现的复现 |
局限与改进
作者承认并部分讨论的局限:一是人类仍在环,设定目标、裁决模糊机制、按快捷键缺一不可,418 条消息虽只占 0.6% 但不可省略;二是结论绑定特定补丁 36.6.3 与单一游戏,天梯对比受补丁更迭与玩家活跃度影响;三是 96 场客户端故障污染天梯统计,需靠控制器日志剔除;四是 LLM 时延用 Artificial Analysis 网关中位数折算,跨供应商可比性有限。我的补充观察:其一,TavernAgent 在 TavernBench 的 91% 并非纯策略成绩,战斗与短期决策靠 TavernGym 做 256 次战斗的单步前瞻搜索,是策略加模拟器工具的组合,与 LLM 的纯文本作答并非严格同条件对比;其二,计算成本未系统报告,每阶段约 3.1 亿决策乘 23 个版本的 GPU 预算缺失;其三,教训与新门机制能否迁移到游戏之外的科学领域未验证;其四,与前十玩家的对比未控制游戏时长、场次与上分投入的差异。
独立分析的弱点
其一,基准公平性:TavernAgent 答题借助模拟器搜索,若单列纯策略(不查模拟器)的准确率会更有说服力,改进方向是报告纯策略与策略加前瞻两栏结果。其二,部署依赖人类按键:官方插件快捷键方案脆弱,客户端故障多达 96 场且无法规模化,改进方向是视觉感知加输入注入的全自动控制器,或与官方 API 合作。其三,单域验证:现实锚定回环只在酒馆战棋检验,教训库与门机制对其他强随机领域(科学实验、系统工程)是否泛化未知,改进方向是在第二个领域复制 AutoTavern 并比较教训结构。其四,记忆只增不减且缺信用分配:台账与教训库长期可能积累过时结论,哪个角色智能体的贡献带来提升缺乏量化,改进方向是引入教训有效期、冲突消解与消融式信用评估。其五,成本不透明:未报告总算力、LLM token 花费与失败实验浪费率,改进方向是公开成本曲线让社区评估性价比。
未来方向
作者明确将开源 TavernBench 与 TavernGym(github.com/MCG-NJU/AutoTavern),为社区提供首个酒馆战棋全内容 RL 环境与决策基准。可延伸方向:一是把 AutoTavern 框架搬到非游戏领域,如自主完成机器学习系统的现实部署验证或机器人 sim-to-real,检验现实锚定回环的普适性;二是让智能体自动提出并验证新门,而非仅由抓到的错误触发,研究方法论自我改进的上限;三是跨项目记忆迁移,把 184 条修复与教训组织成可检索的研究经验库用于冷启动新问题;四是混合系统,LLM 负责战略层慢推理、专门策略负责实时决策,呼应 GPT-6 Astra 加工具后 62% 到 97% 的发现;五是建立代理漂移的自动检测理论,回答何时考试指标可信、何时必须回到现实;六是对六角色划分做多智能体协作消融,与单一智能体加子任务的组织方式对比。
复现评估
开源情况:论文承诺开源 TavernBench 与 TavernGym(GitHub MCG-NJU/AutoTavern),分别含 960 任务基准与 978 对象的 Rust 模拟器(63k 行、单核 190 到 280 局每秒、种子级确定性复现),这是复现的最大利好;模型仅 18M 参数,PPO 每阶段约 3.1 亿决策,单卡或小集群即可承受训练开销。但完整复现 AutoTavern 闭环难度很高:一是需要能驱动真实客户端的控制器与天梯账号,涉及 Blizzard 服务条款,这部分大概率不开源,且控制器故障说明工程脆弱;二是研究智能体本身依赖未指明的前沿 LLM 与 20 天不间断调度,预算不菲;三是卡牌数据由游戏文件生成,补丁更新需持续维护覆盖层。合理路径是先复用开源的 TavernGym 加 TavernBench 复现 TA 级训练与基准评估,再视资源决定是否重建现实回环。
论文图表