RSIGame:具有递归自我改进能力的自主智能体游戏开发框架 RSIGame: Autonomous Agentic Game Development with Recursive Self-improvement
探索-诊断-改进局部循环加全局质量监控实现游戏自主迭代开发,并将经验内化回模型。
前置知识
递归自我改进(Recursive Self-Improvement, RSI)
指系统把自己的产出或能力作为下一轮改进的输入,循环往复地提升自身。本文语境中有两层:测试时层面,智能体反复执行"测试游戏-观察证据-修订项目",每轮基于上一轮版本与新证据继续;训练层面,把成功的开发轨迹(规划、生成、验证过的改进)变成监督数据微调生成器本身,使模型参数吸收开发经验,形成嵌套在测试时循环之外的更大改进回路。
全文的组织原则就是 RSI:局部循环、全局监控、经验内化分别对应 RSI 的不同层次,理解这一框架才能看懂各模块为何如此设计、实验为何按 training-free 与 training-based 两条线报告。
智能体游戏开发(Agentic Game Development)
给定自然语言游戏规格 $x$,智能体要产出完整可运行的游戏项目 $P_0 \sim \pi_\theta(\cdot \mid x)$,包含源代码、视觉与文本资产、配置文件,并组织成连贯可执行的交互系统。与普通代码生成不同,游戏质量最终体现在运行时行为与玩家体验上,因此评估必须真实执行并交互,而非静态代码检查。构建游戏需要联合设计机制与进程、生成代码与多模态资产、并把异构组件组装成一致整体,这正是一次生成难以做对的原因。
这是论文的任务设定:多模态工程高度耦合(机制+代码+美术+配置)解释了为什么需要迭代开发,也是"生成一次就打分"的既有基准与本文"持续改进"设定的分野所在。
GameCraft-Bench 与加权评分公式
本文使用的评测基准,含 140 个任务、15 个游戏家族,在 Godot 与 Phaser 两个真实引擎上实例化同一批任务。每个生成的游戏打包可回放的演示轨迹,回放后由裁判模型按隐藏 rubric 从机制 $M$、深度 $D$、视觉 $V$、美术 $A$ 四维打分:$Q = \text{BUILD} \times (0.15M + 0.35D + 0.15V + 0.35A)$,其中 $\text{BUILD} \in \{0, 1\}$,不可玩游戏直接 0 分。每个产物独立回放评分 3 次取平均,rubric 每任务 12–21 条(中位 18 条)。
论文所有实验数字都来自这个公式;作者反复强调开发智能体从未见过隐藏 rubric、分数与裁判反馈,监控器与基准评估严格隔离,这是全文公平性论证的基石,也是读懂"防考分过拟合"设计的背景。
LLM-as-Judge 回放评估及其噪声
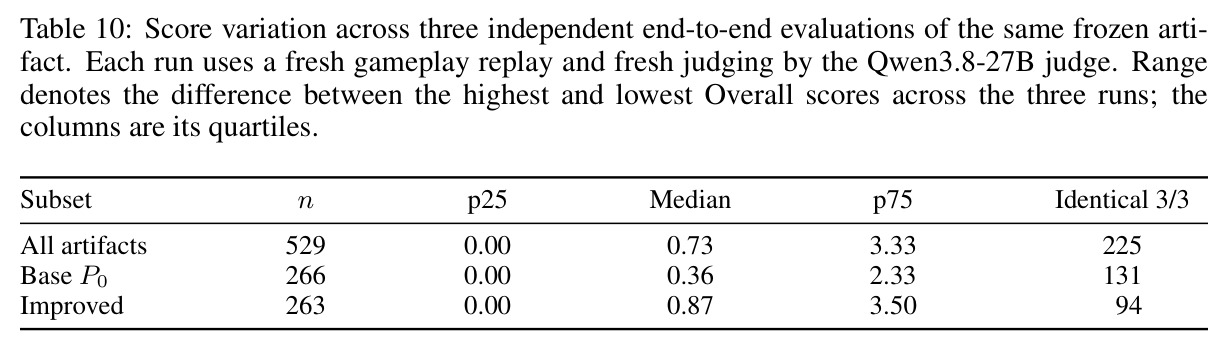
游戏难以像单元测试那样断言对错,因此用统一脚本回放演示轨迹、采样关键帧(每 demo 16 帧),由裁判 LLM(Qwen3.8-27B,greedy 解码、关闭 thinking)按 rubric 读帧打分。论文系统测量了评估噪声:529 个冻结产物三次独立评估的中位极差仅 0.73 分,225 个三次完全一致;方差集中在 rubric 证据来得晚的家族(sports 中位极差 4.66、horror 3.37,而 strategy/rhythm/racing 为 0)。
理解评估协议及其噪声水平,才能判断 +7 到 +14 分的提升幅度是否可信、为何要三次回放取平均、以及分家族结果该如何解读——这也是复现该论文时最容易踩的坑。
经验内化与 QLoRA 监督微调
把成功开发轨迹序列化为多轮智能体对话(任务规格、助手输出、工具调用与结果),只对助手输出计算损失,用 LoRA($r=16$,$\alpha=32$)叠加 4-bit NF4 量化基座微调 Qwen3.8-27B,最大上下文 57,344 token,4×H100 用 Ulysses 序列并行训 1 epoch,学习率 $5\times10^{-5}$。三种语料按 $S1 \subset S2 \subset S3$ 嵌套:S1 生成轨迹(1,294 条)、S2 规划(+308)、S3 验证过的改进轮(+509),用于消融各阶段贡献。
论文最大的亮点是 27B 开源模型经内化后一次性生成超过 GPT-5.5(48.22 vs 50.26 附近),且 token 省 11 倍;理解 SFT 的数据构造与配置是评估该结论可复现性的前提。
最佳 checkpoint 跟踪与饱和停止
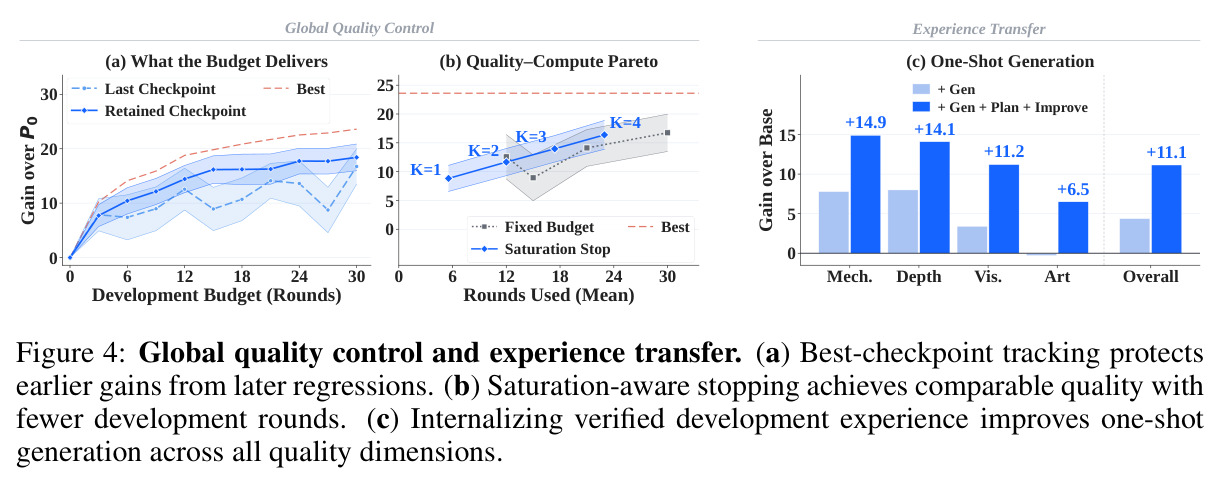
全局循环每 $E=3$ 轮取一次 checkpoint,质量监控器把冠军版本 $P_\star^s$ 与候选版本在同一演示脚本下成对回放比较(不告知哪个更新、不知道改进意图),候选需在阶段半区提升 $\ge 0.05$ 且任务半区下降 $\le 0.05$ 才替换冠军。连续 $K=3$ 个 checkpoint 无新冠军即判定饱和:终止并返回 $P_\star^s$,或引入一份高层指导 brief $\gamma_{s+1}$ 开启下一阶段,从冠军而非最后一版继续开发。
这是 RSIGAME 与"盲目多轮迭代"的本质区别:没有它,后期编辑会抹掉早期收益——Play2Code 的平台化与回归、Alley Brawlers 交付版本与 base 同分都是反例。
研究动机
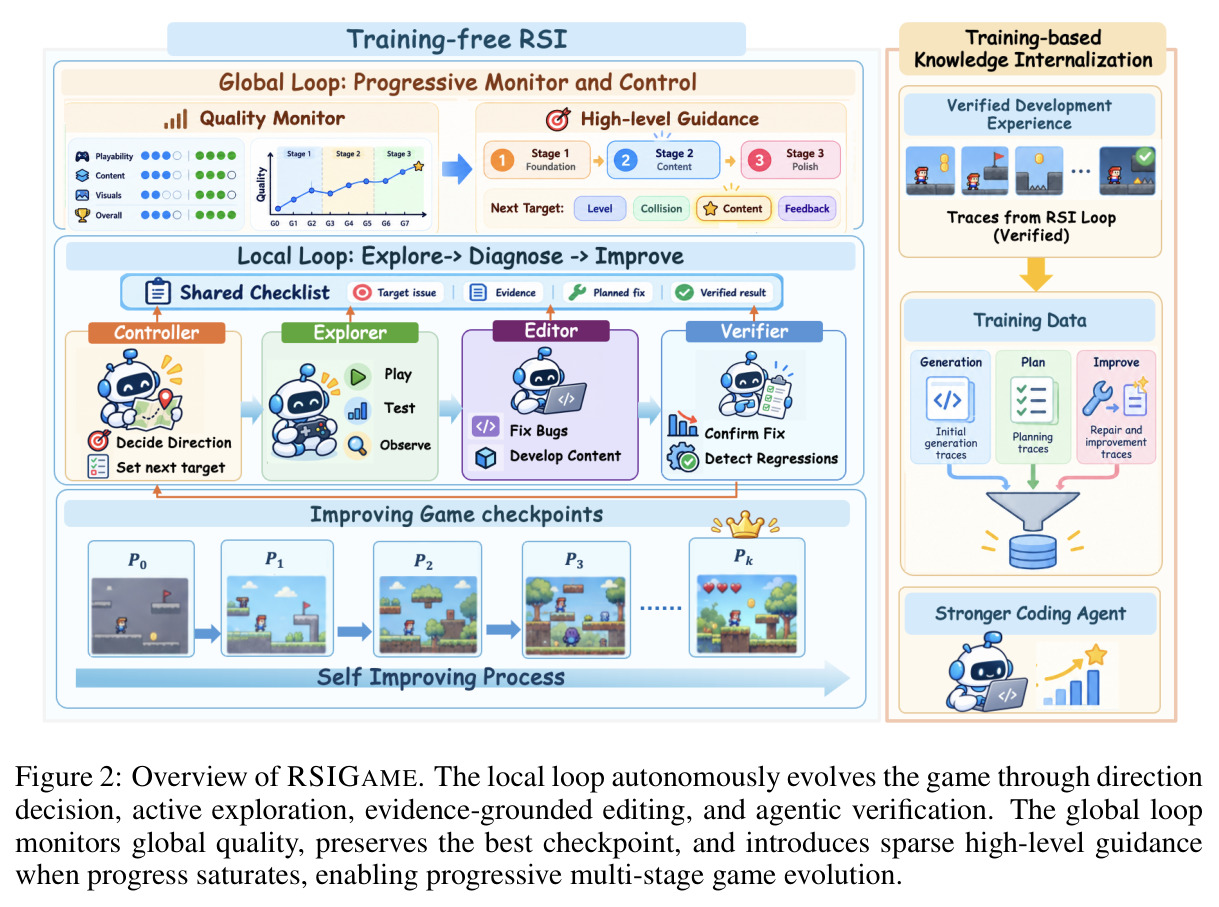
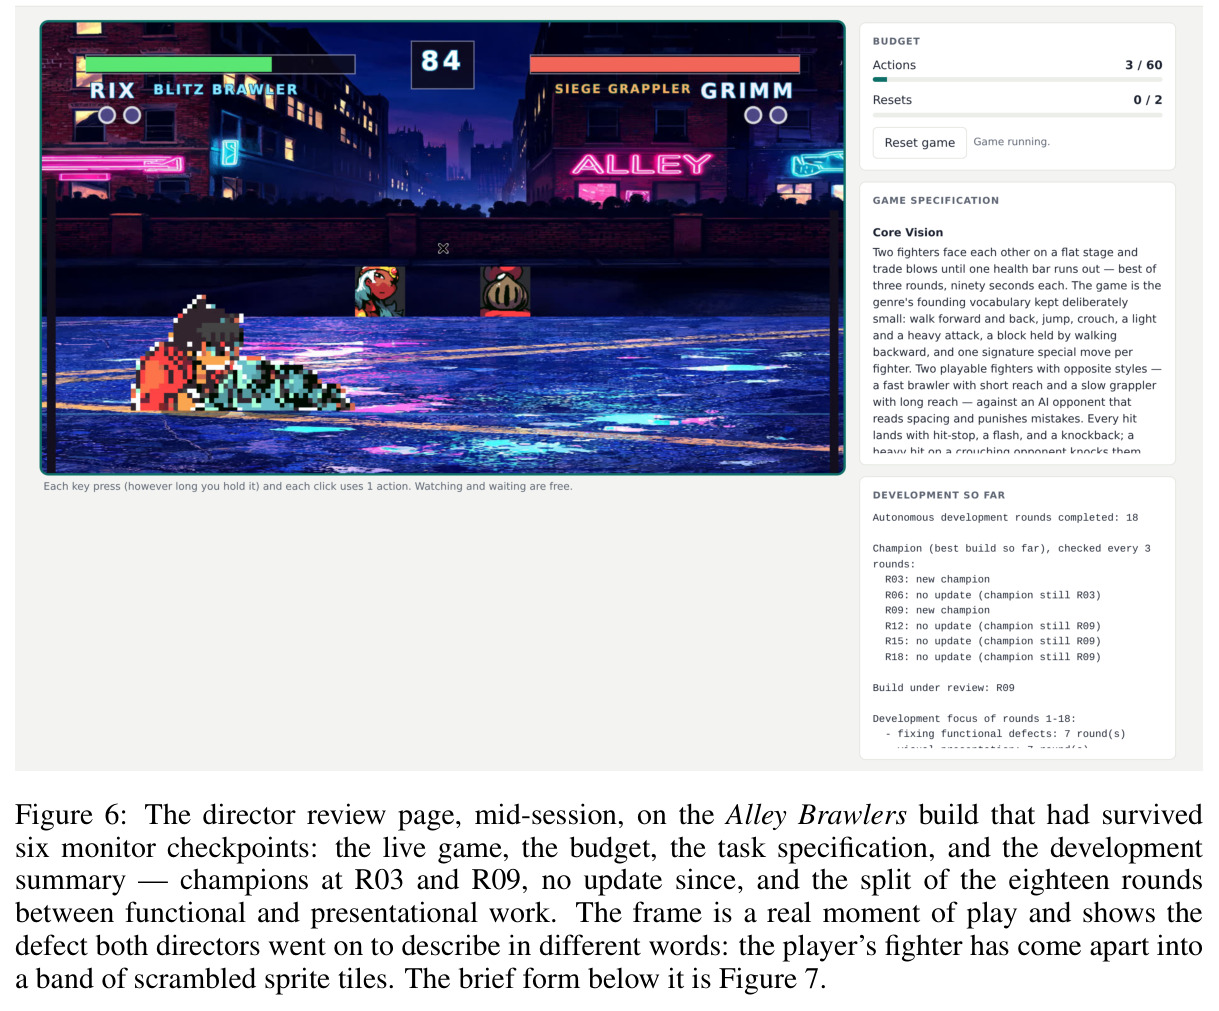
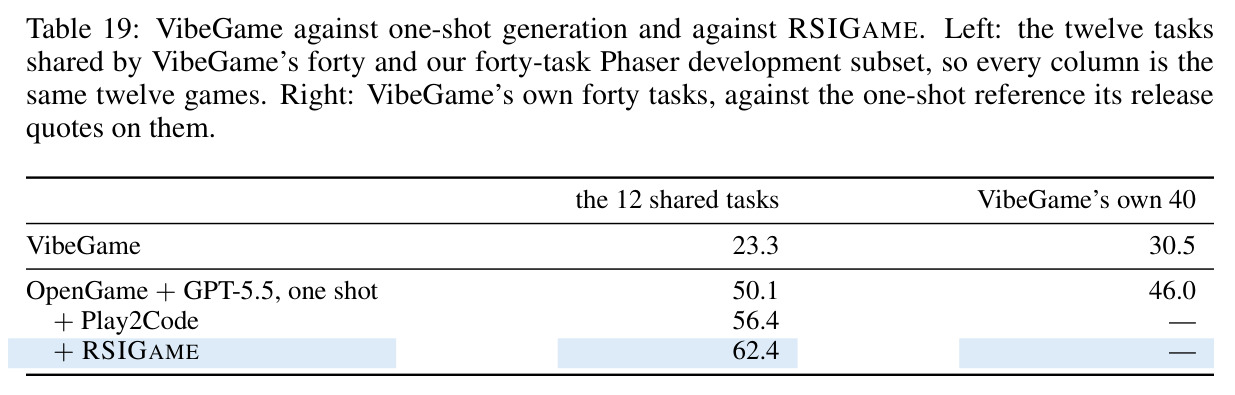
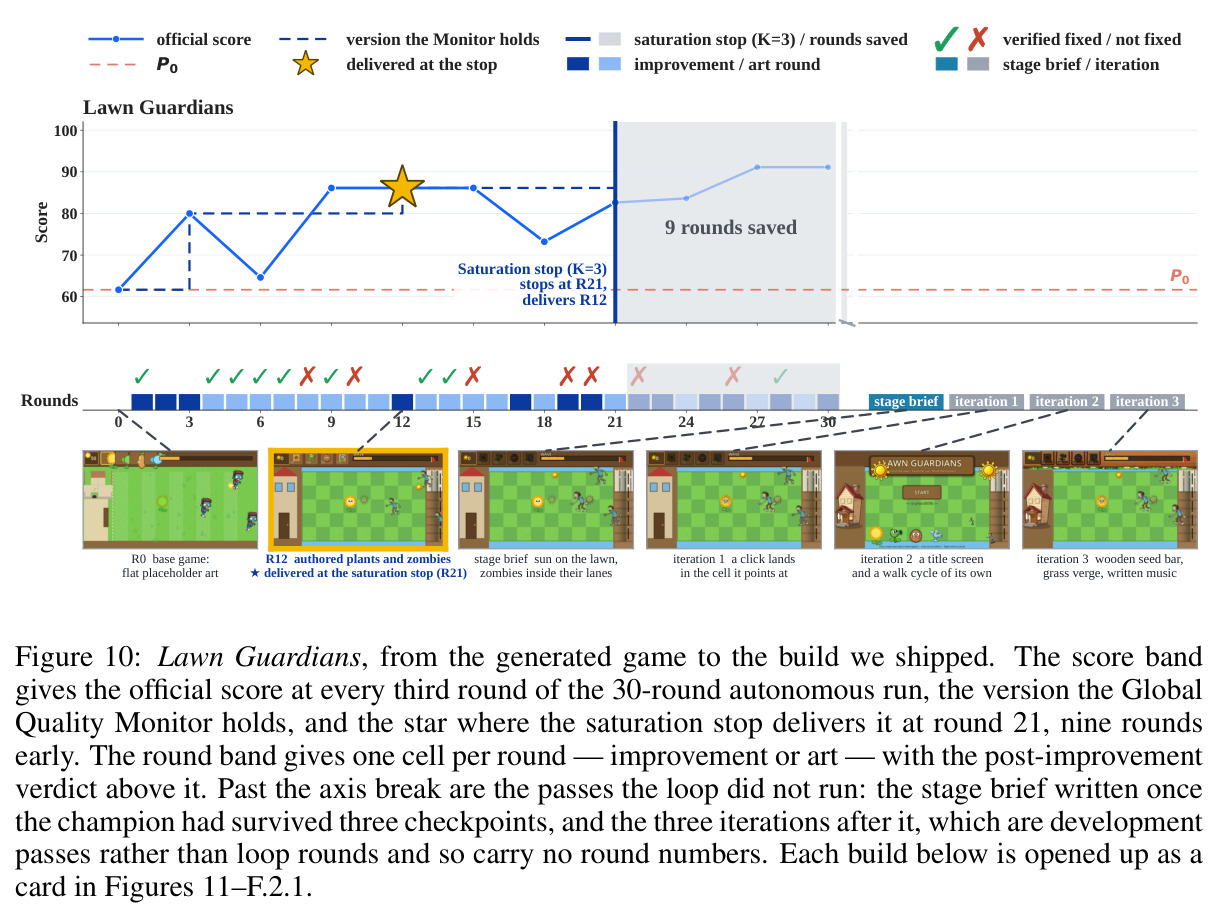
LLM/VLM 的一次性生成已能把自然语言规格变成"可玩"的游戏——GameCraft-Bench 显示 Codex+GPT-5.5 一次性平均可拿 50.26 分(Godot),但这远非"完善且好玩":与人类团队一样,生成的游戏充满意外 bug、缺失功能与未覆盖的角案例。自然的补救是迭代开发:测试当前版本、收集反馈、修订。但论文发现朴素的迭代改进极易过拟合一小撮测试用例——系统学会"大致满足目标"后停下来,留下大量未测缺陷,对更广泛的玩家交互泛化很差。证据有三条。其一,Play2Code 这类"玩-改"循环在强初始化上几乎无效:Codex+GPT-5.5 的 base 50.26 只被推到 50.74(+0.48),近乎原地踏步。其二,多智能体系统 VibeGame 把八个角色全部配上 GPT-5.5,在 40 个 Phaser 任务上反而只得 30.5 分,比同任务单次生成的 46.0 更低——说明"流水线里有验证和优化角色"并不等于"能把开发轮次换成质量"。其三,案例研究显示迭代天然非单调:Alley Brawlers 三十轮自主开发把街景画得更好,却把格斗角色的渲染改坏(运动中的身体变成撕裂的色块),最终交付版本与 base 同为 56.6 分;Lawn Guardians 的第 6 轮和第 18 轮改进各自拉低了分数。开发循环缺少的是:广泛探索剩余失败的机制、对每次改动的事后验证、以及跨轮次的全局进度管控。
本文的目标是本文要把智能体游戏开发组织成一个可靠的长期递归自我改进(RSI)过程,具体回答三个问题。第一,如何让测试阶段"广泛探索剩余失败与潜在改进",而不是反复确认同一小撮测试点,从而把游戏从"可玩"推向"高质量"、并泛化到更广的玩家交互?第二,如何在几十轮的长视野开发中保证进度单调可靠——保留最佳版本、检测饱和与回归、必要时在饱和处重开新阶段——而不是追加预算却得到更差的游戏?第三,测试时积累的开发经验(怎么规划、怎么生成、怎么验证修订)能否内化回生成器参数,让模型一次性生成更强、所需迭代更少、token 更省?衡量标准是:在匹配开发预算(相同初始项目克隆、相同 backbone、每轮 26 次工具调用、最多 30 轮)下,跨 140 个 GameCraft-Bench 任务、两个引擎、五个生成器稳定超越冻结 base 与 Play2Code;终极目标是用开源 27B 模型追平甚至超过 GPT-5.5 的一次性生成质量。
与已有工作不同的是,已有工作把"引入迭代"本身当作贡献:Play2Code 交替玩与改,VibeGame 组织多智能体团队,OpenGame 跨项目积累可复用技能。本文的独特切入是追问"迭代如何才能长期可靠地维持",并给出三个互补机制作为答案。第一,把测试阶段升级为探索-诊断-改进:controller 决定探索方向 $d_t$,explorer 主动与可执行游戏交互产生证据轨迹 $\tau_t$,所有发现持续累积进一个演化清单 $C_t$,使改进目标随证据扩展——从机制上打破测试集过拟合,这不同于 Self-Refine/Reflexion 式"执行后看错误"的被动反馈。第二,引入与基准评估严格隔离的全局质量监控:它使用独立的代理 rubric、只做冠军-候选择成对比较、从不接触隐藏分数与裁判反馈,配合饱和感知停止($K=3$)与可选的高层 brief(人类或更强模型只给战略方向而非编辑指令),实现可控的多阶段进化。第三,超越 training-free 的测试时改进,首次把规划、生成、验证改进三类轨迹联合 SFT 回 27B 骨干,把 RSI 从上下文优化扩展到参数优化。对比之下,VibeGame 证明"堆验证角色"无效,Play2Code 证明"只迭代"会平台化——RSIGAME 的回答是把证据接地、全局管控与经验内化作为一个整体系统。
核心方法
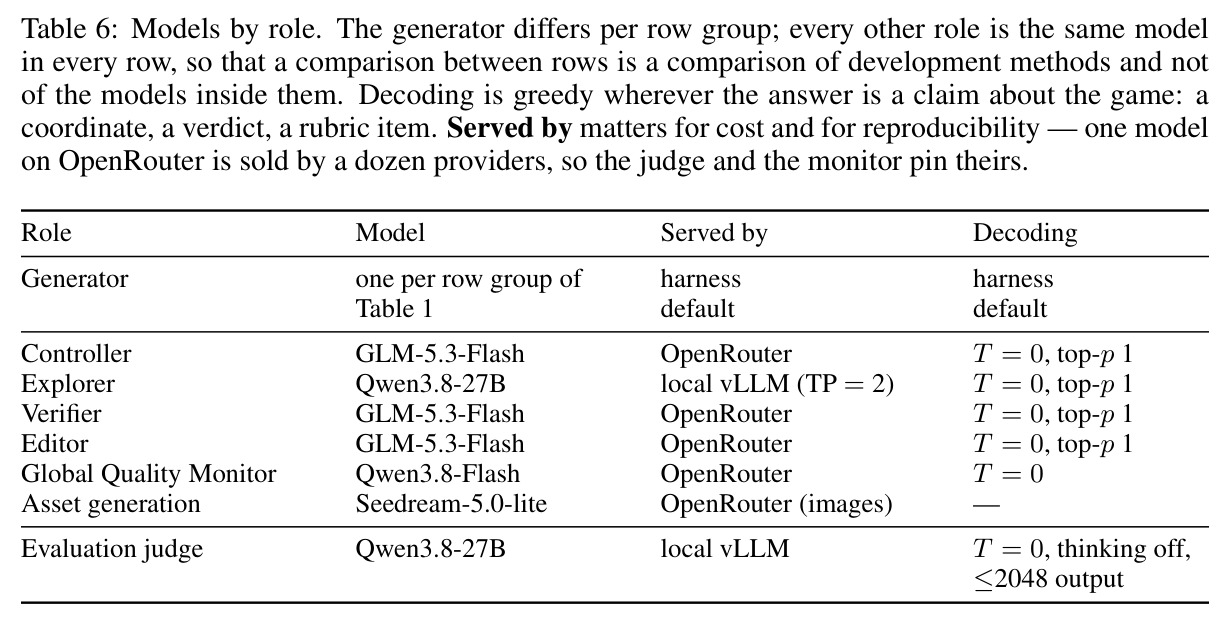
直觉:把人类游戏工作室"构建-试玩-反馈-修订"的流程完全自动化,再补上人类团队天然拥有而朴素智能体循环缺失的两样东西——对游戏当前瓶颈的自适应注意力(先修最疼的地方),和一个质量管家(防止越改越糟)。技术路线分三层。第一层是本地循环的探索-诊断-改进:controller 根据规格 $x$、当前项目 $P_t$、共享清单 $C_t$ 和阶段指导 $\gamma_s$ 采样开发方向 $d_t \sim \pi_{\text{controller}}(\cdot \mid x, P_t, C_t, \gamma_s)$;explorer 据此与可执行游戏定向交互产生轨迹 $\tau_t \sim \pi_{\text{explorer}}(\cdot \mid P_t, d_t)$;editor 把证据转成具体修改 $\Delta_t \sim \pi_{\text{editor}}(\cdot \mid P_t, d_t, \tau_t)$,应用后得到 $P_{t+1} = \text{Apply}(P_t, \Delta_t)$;verifier 回放验证产生 $v_t \sim \pi_{\text{verifier}}(\cdot \mid P_{t+1}, d_t, \tau_t)$,并把结果写回共享清单 $C_{t+1} = U(C_t, d_t, \tau_t, \Delta_t, v_t)$。第二层是全局循环:每 3 轮 checkpoint 时监控器用独立代理 rubric 成对比较冠军与候选并择优保留 $P_\star^s \leftarrow \text{SelectBest}(P_\star^s, P_{t+1})$;连续 $K=3$ 个 checkpoint 无新冠军则饱和停止交付 $P_\star^s$,或接受一份四字段高层 brief 开启下一阶段。第三层是训练式经验内化:收集 2,213 条生成轨迹(GPT-5.5 产出)、2,108 份规划、从 4,003 轮候选中筛出 2,013 轮验证通过的改进(GLM-5.3-Flash 产出),对 Qwen3.8-27B 做 QLoRA SFT。所有角色除 generator 外在全部实验中固定(editor/verifier/controller 用 GLM-5.3-Flash,explorer 用 Qwen3.8-27B,监控器用 Qwen3.8-Flash,裁判用 Qwen3.8-27B),保证表格行间比较只反映开发方法的差异。
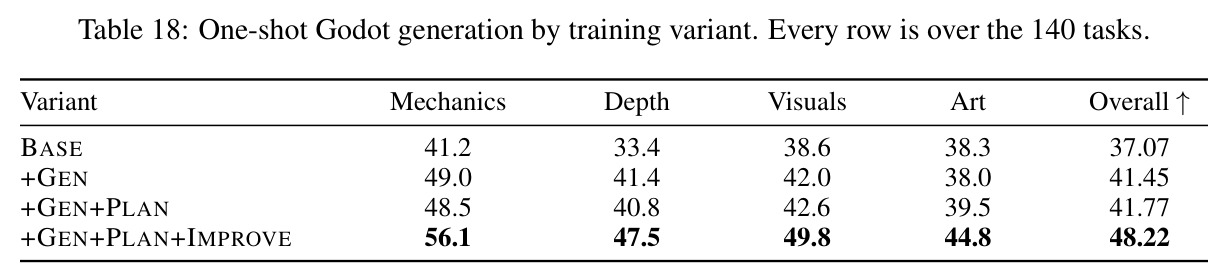
核心创新是把"改进什么"本身变成由证据驱动的自适应决策,并用全局管控保证长视野可靠性。与已有方法的本质区别有三点。区别一:主动探索+演化清单对抗测试集过拟合。Self-Refine/Play2Code 类系统的反馈来自"执行→看错误→修",视野被当前测试锁定;RSIGAME 的 controller 每轮必须提出一个"可由观看游戏回答"的问题,并显式选择 action $\in \{\text{reuse}, \text{explore}, \text{escalate}\}$——无 grounded 未决问题时必须承认枯竭而不是发明工作;explorer 产生第一手交互证据,问题、证据、优先级、验证结论全部累积进清单 $C_t$,改进焦点随游戏成熟而漂移:从"修 build、修输入无响应"自然过渡到"补深度、提美术"。区别二:全局质量监控与评估的严格隔离。监控器不知道隐藏 rubric、分数与裁判反馈(连代码导入都不发生),只看到同脚本回放的成对帧,并被明确要求"不要假设新版本更好";候选必须在阶段目标上 $+0.05$ 且不跌破任务底线 $-0.05$ 才能上位——任务半区是底线而非目标,防止为阶段目标牺牲已有功能。Lawn Guardians 案例中第 6、18 轮的降分改动被监控器拒绝采纳,最终交付的是从未被超越的第 12 轮(86.1 分,base 61.7)。区别三:经验内化消融显示"验证过的改进轨迹"才是增益主力(Overall 41.77→48.22),即模型学的不是模仿成功成品,而是"如何诊断与修复"的可复用知识。
方法步骤详情
一轮完整开发如下。步骤一(方向决策):controller 输入规格、$P_t$、$C_t$、$\gamma_s$,输出严格 JSON:一个 development_question(必须"可由观看游戏回答",拒绝"能否改进游戏"这类不可观察的问题)与 action $\in \{\text{reuse}, \text{explore}, \text{escalate}\}$;若 explore 还要选最省的模式(复用已有 demo / 扩展已有 demo / 定制探针)。步骤二(智能体探索):explorer 从清单未决需求中挑 1–3 个当前最重要的,给扮演玩家的 play agent 一条可执行指令(如"按左再按右各一秒,报告航向是否变化"),驱动 $P_t$ 产生轨迹 $\tau_t$。步骤三(证据接地编辑):editor 拿到"问题已确立"的证据包(源码、必须通过的 build 命令、运行观察通道),被禁止改动评测轨迹与 harness,直接从"代码哪里改"开始产出 $\Delta_t$;预算为每轮 26 次工具调用、1800 秒墙钟、最多 3 次改进尝试、编辑前 8 步预探针、每个声称的修复采样验证 3 次。步骤四(智能体验证):verifier 回放更新后的 $P_{t+1}$,回答 goal_achieved $\in \{\text{yes}, \text{no}, \text{unclear}\}$ 与 broken_now 列表(只计"输入毫无反应/画面遮挡/冻结/文字不可读"类故障,明确排除"游戏本来就没有的功能"),破坏项作为 next_goal 重新入列待修。步骤五(清单更新):$C_{t+1} = U(C_t, d_t, \tau_t, \Delta_t, v_t)$ 标记已解决问题、纳入新问题,供下一轮 controller 使用。步骤六(全局监控):每 3 轮 checkpoint,监控器比较 $\le 3$ 个 demo × 16 帧,按阶段半区 $+0.05$ / 任务半区 $-0.05$ 规则决定是否换冠军;连续 $K=3$ 次无新冠军触发饱和停止,交付 $P_\star^s$,或经导演界面(60 次动作 + 2 次重置预算,四字段 brief:阶段目标 / 为何现在 / 1–3 个优先方向 / 0–3 个保留项)开启下一阶段,从冠军继续。步骤七(经验内化):语料按 $S1 \subset S2 \subset S3$ 嵌套(1,294→1,602→2,111 行),QLoRA($r=16$,4-bit NF4)在 4×H100 上以 57,344 token 上下文、Ulysses 4 卡序列并行训 1 epoch,损失只作用于助手输出。
技术新颖性
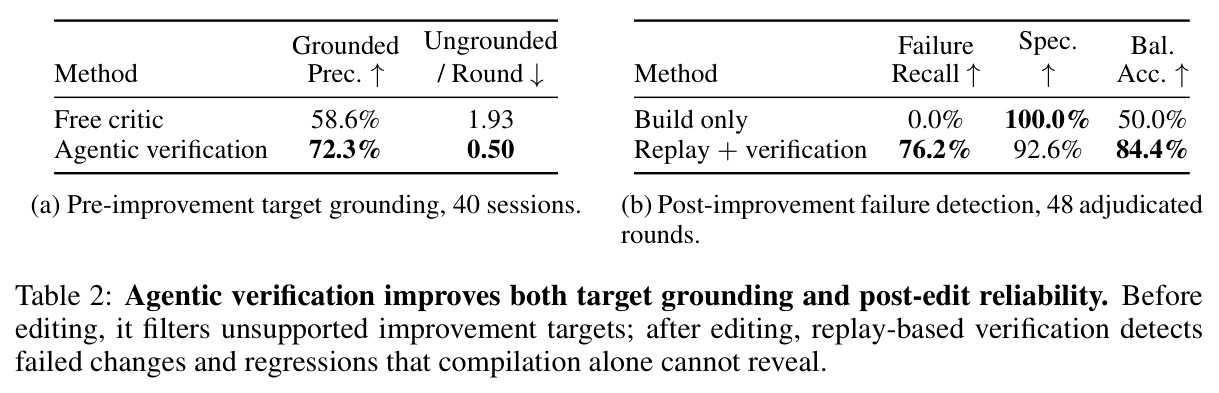
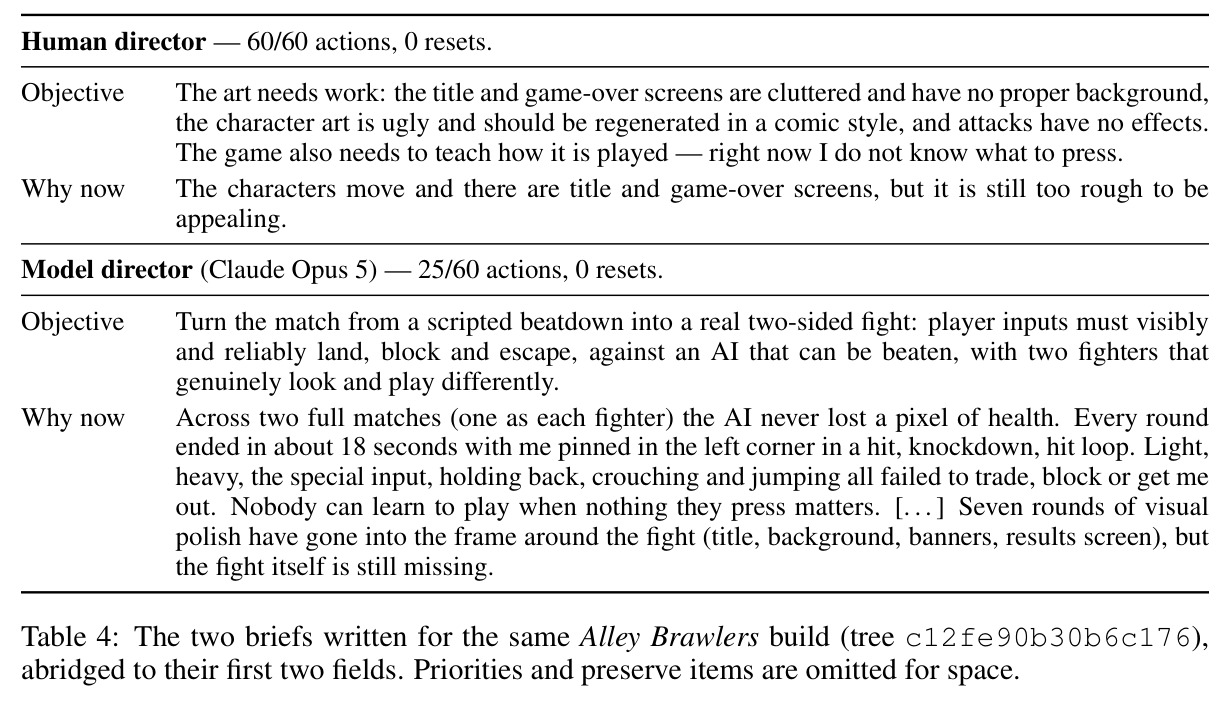
技术新颖性体现在四个层面。第一,信息流架构:五个 LLM 模块按"最小必要信息"原则分割——planner 拿到的是作为结论的方向而非论证;editor 被告知问题已确立以防重新诊断浪费时间;verifier 知道本轮目标因为那是它要检验的主张;而监控器既不知道哪版更新也不知道发生过改进。这种"刻意隐瞒"让每级只能使用自己该用的证据,从工程上抑制确认偏误,是同类系统少见的信息流纪律。第二,验证可靠性度量:论文不只是用验证,还审计了验证——用 Claude Opus 5 独立仲裁 40 个会话的编辑前目标与 48 轮的编辑后结果,给出方法级可靠性数字:grounded precision 58.6%→72.3%、每轮无依据目标 1.93→0.50、失败召回 76.2%、平衡准确率 84.4%(仅编译检查为 0% 与 50%)。第三,学习层数据工程:改进轨迹经独立事后验证筛选(3,730 轮 Godot 候选只保留 1,869 轮),失败轮次作为负例一并发布而非丢弃;语料含 403,280 处路径脱敏重写与 47 个泄漏模式的独立扫描器自检;损失只作用于助手输出、轨迹按原始交互上下文整体训练,避免把工具观察当作预测目标。第四,多阶段进化接口:饱和→brief→新阶段的设计在"自主开发停滞"与"外部高层指导"之间建立了原则性接口;Alley Brawlers 实验显示 brief 值约 +1.5 分(模型 brief 61.5 / 人类 62.0 / 无 brief 控制 60.0),且两位导演对同一构建写出完全不重叠的方向——人关注美术与新手引导,Claude Opus 5 玩两局后发现"AI 从未掉过一格血"的对抗公平问题。
实验结果
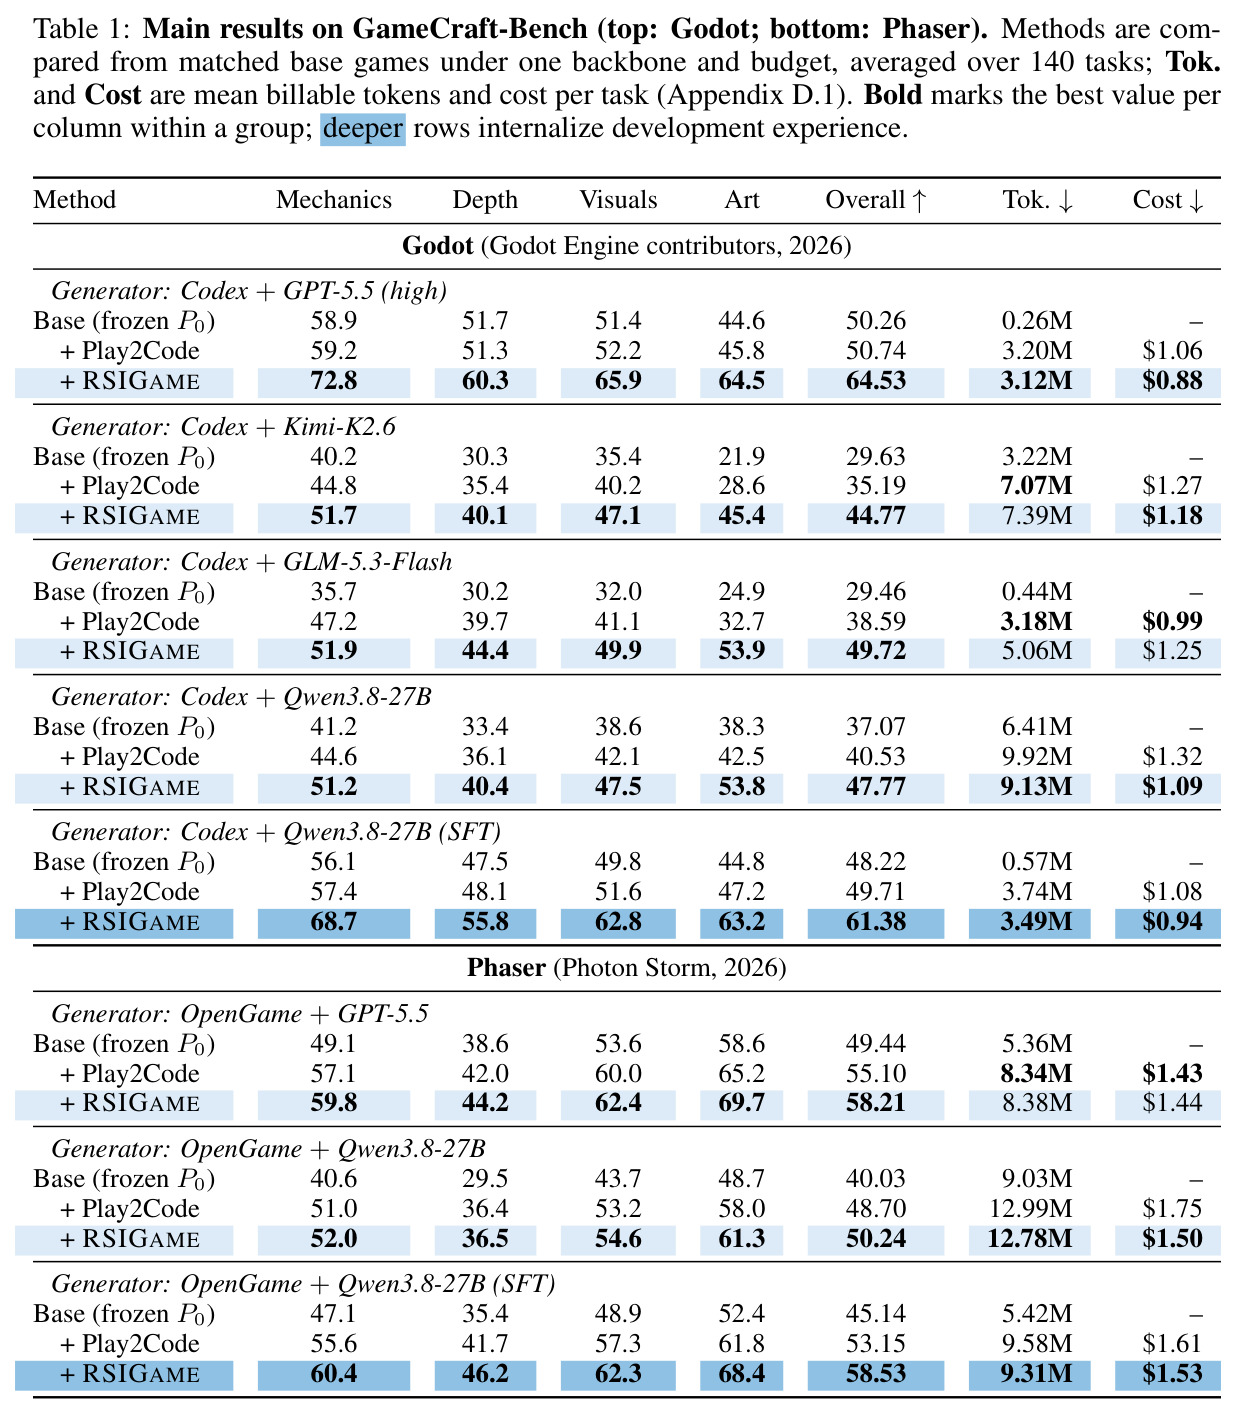
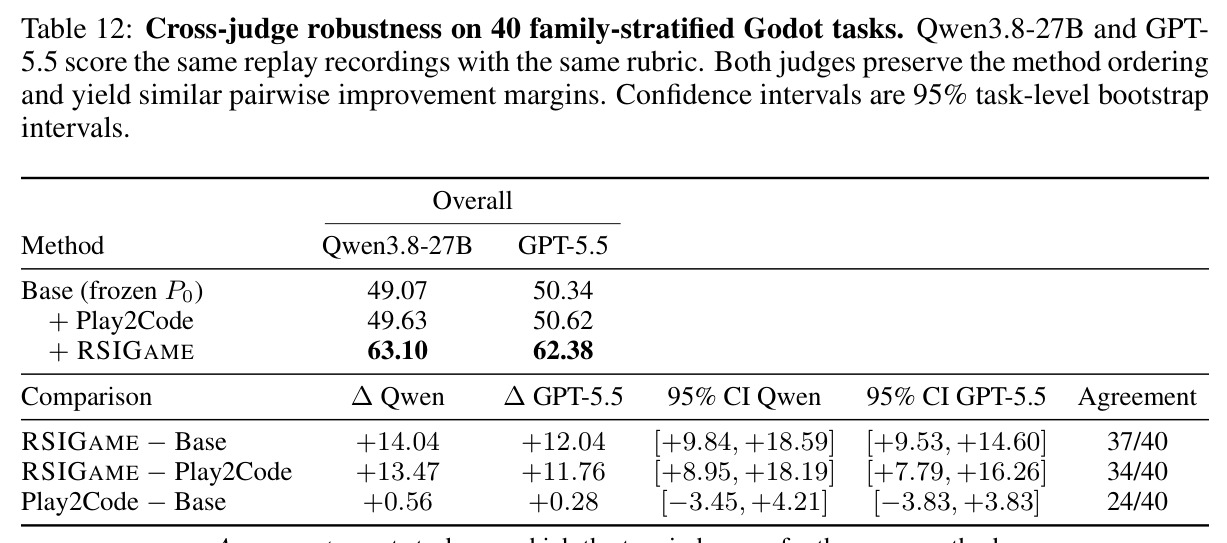
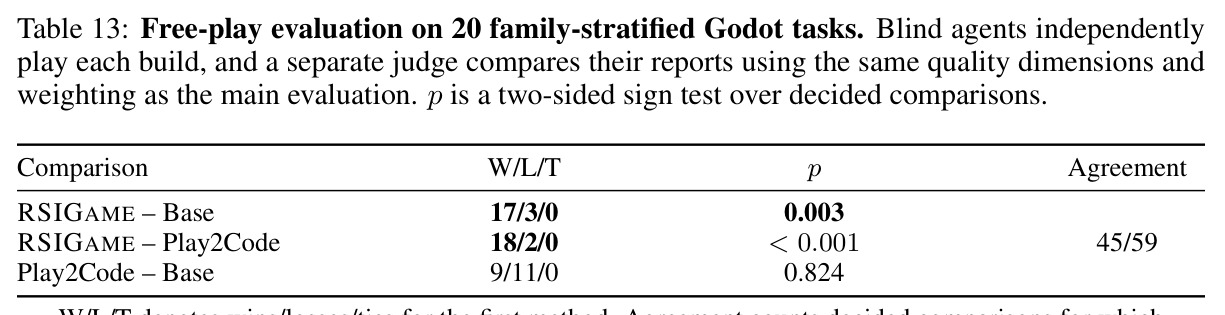
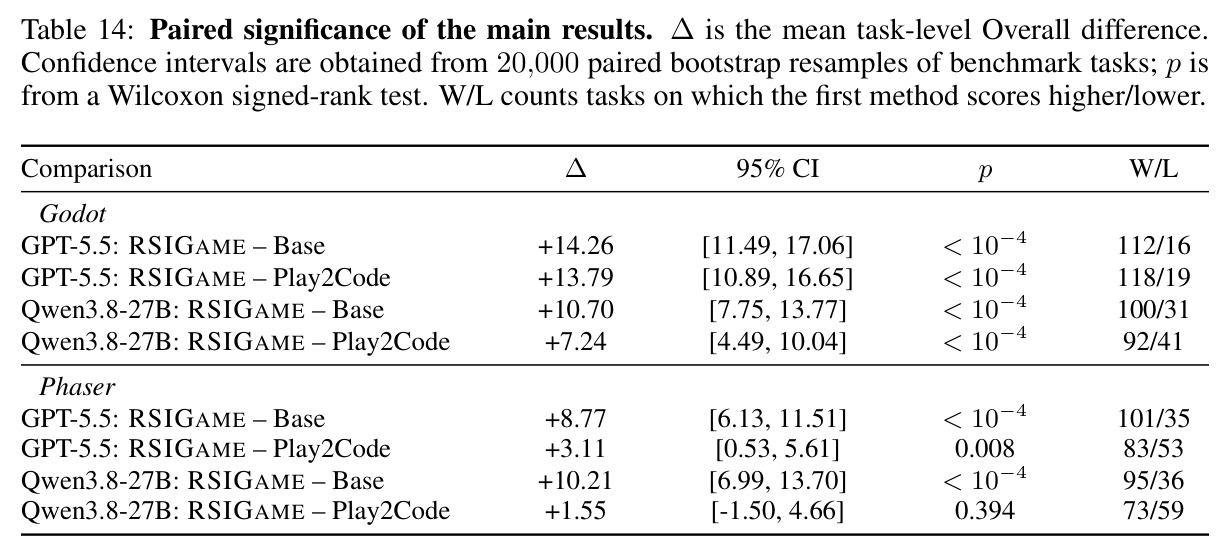
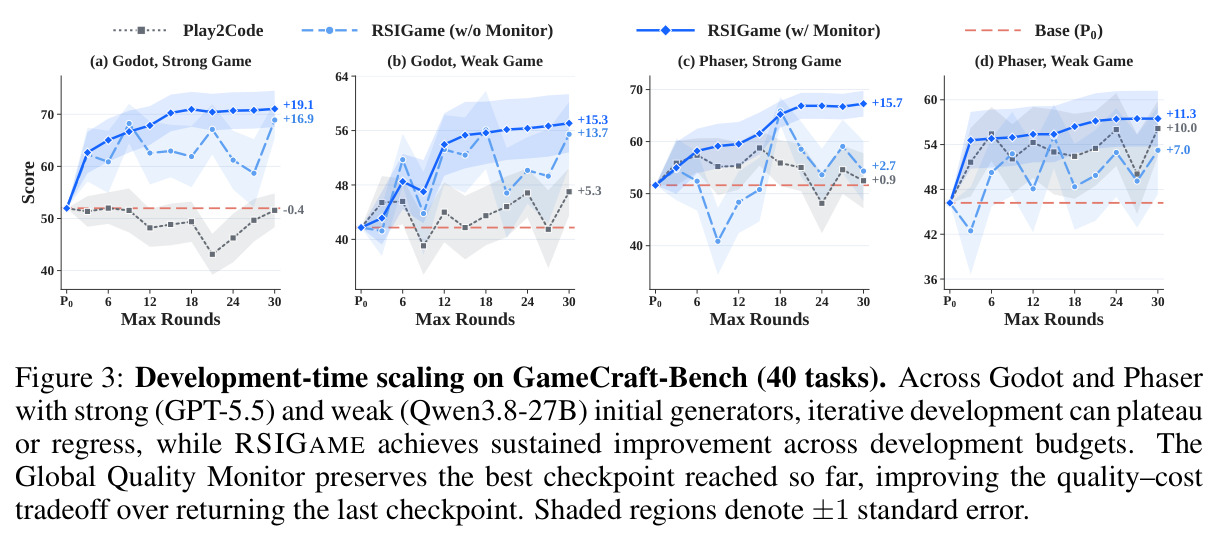
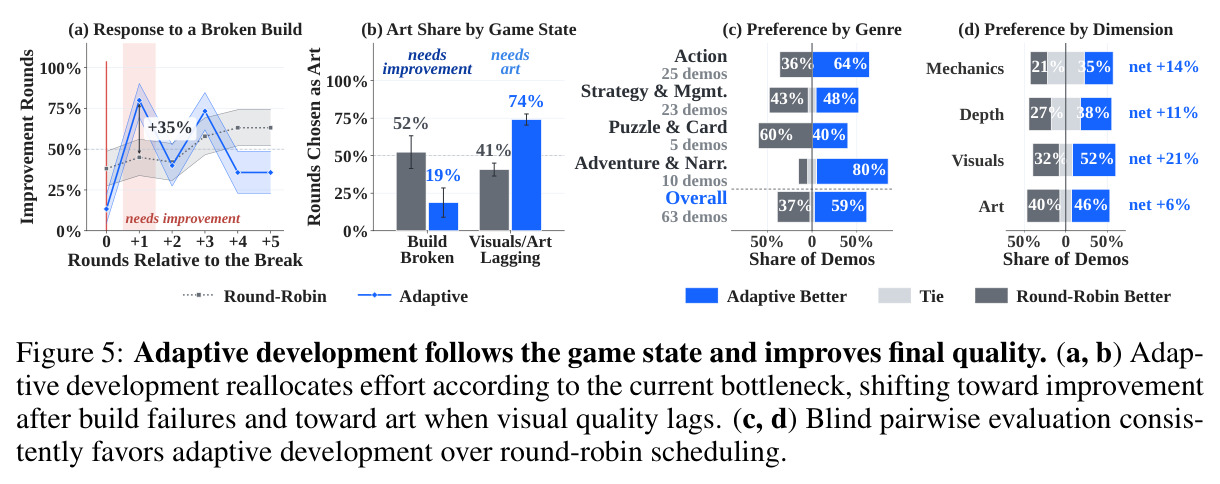
主实验(Table 1:140 任务 × 两引擎 × 五生成器,同预算同初始克隆)给出五层结论。一、全面增益:Godot 上 RSIGAME 相对冻结 base 提升 10.70~20.26 Overall 分。最强初始化 Codex+GPT-5.5 从 50.26 到 64.53(Mechanics 58.9→72.8,Art 44.6→64.5);弱生成器 GLM-5.3-Flash 从 29.46 到 49.72(+20.3,Art 从 24.9 翻倍至 53.9);Codex+Qwen3.8-27B 从 37.07 到 47.77,超过 Kimi-K2.6 开发后的 44.77。二、显著优于同类迭代方法:比 Play2Code 高 7.24~13.79 分(Wilcoxon $p<10^{-4}$,bootstrap 区间远离 0),而 Play2Code 在强初始化上几乎不动(50.26→50.74),说明收益来自开发组织方式而非迭代本身。三、Phaser 迁移成立但幅度收窄:三个生成器提升 8.77~13.4 分;因 Phaser 初始版本机制/深度弱而视觉/美术强,功能可提升空间大,Play2Code 也表现更好(差距收窄至 +3.11,$p=0.008$);Qwen 非 SFT 时对 Play2Code 仅 +1.55($p=0.394$)不显著——这是全文唯一未决的主比较。四、经验内化是效率钥匙:SFT 把 Qwen 一次性生成从 37.07 提到 48.22(距 GPT-5.5 仅 2 分),生成 token 从 6.41M 降到 0.57M(11 倍);再叠加 RSIGAME 达 61.38,总 token 9.13M→3.49M(2.6 倍),超过 GPT-5.5 一次性 50.26;Phaser 上 SFT+RSIGAME 58.53 同样超过 GPT-5.5 的 49.44。消融(Table 18)显示仅 +GEN 得 41.45,+GEN+PLAN 得 41.77,加入验证改进轨迹后跳到 48.22(Mechanics +14.9、Depth +14.1)。五、可靠性分析支撑结论:开发时间缩放(Figure 3,40 任务)显示 Play2Code 平台化或回归而 RSIGAME 持续上升,监控器保留的最佳版本紧贴 oracle;自由对局盲评(Table 13)RSIGAME 以 17/20、18/20 胜 base 与 Play2Code($p=0.003$、$<0.001$),收益不依赖固定回放脚本;换 GPT-5.5 当裁判(Table 12)排序不变(RSIGAME−base 从 +14.04 变 +12.04,37/40 任务方向一致);自适应 vs 轮询调度盲评偏好 59% 对 37%(Figure 5);验证审计(Table 2)如上。反面证据同样有价值:VibeGame 八角色团队(Table 19)在自己 40 个任务上 30.5 分低于单次生成 46.0。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Godot 游戏开发(Codex+GPT-5.5 high 初始化) | Overall(0–100) | 64.53(RSIGAME) | 冻结 base 50.26;Play2Code 50.74 | +14.26 vs base,+13.79 vs Play2Code(均 p<10^-4) |
| Godot 游戏开发(Qwen3.8-27B SFT) | Overall(0–100) | 61.38(SFT 后 RSIGAME) | GPT-5.5 一次性生成 50.26 | +11.12,生成 token 减少 11 倍(6.41M→0.57M),总 token 减少 2.6 倍 |
| Phaser 游戏开发(Qwen3.8-27B SFT) | Overall(0–100) | 58.53 | GPT-5.5 一次性生成 49.44 | +9.09 |
| Godot 游戏开发(Codex+Qwen3.8-27B) | Overall(0–100) | 47.77(RSIGAME) | 冻结 base 37.07;Play2Code 40.53 | +10.70 vs base,+7.24 vs Play2Code(p<10^-4) |
| 编辑后失败检测(48 个仲裁轮次) | Failure Recall / 平衡准确率 | 76.2% / 84.4%(回放式智能体验证) | 仅编译检查 0.0% / 50.0% | 召回 +76.2 个百分点 |
| 开发方向调度(16 对游戏盲评 63 次) | 盲评偏好率 | 59%(自适应方向策略) | 37%(固定轮询调度) | +22 个百分点,四维一致 |
局限与改进
作者在附录 B 承认三点:多阶段指导机制只在 6 个游戏的有限案例上研究,何时调用指导、多大剂量有益、人类与模型指导的差异仍是开放问题;M/D/V/A 四维不含原创性、叙事质量、长期玩家参与与主观乐趣;实验限于可在智能体预算内迭代的紧凑游戏,更大项目、更长视野、更复杂跨系统依赖待研究。我的补充观察有五点。第一,组件归因缺失:除 generator 外所有角色固定为 GLM-5.3-Flash(editor/verifier/controller)与 Qwen3.8-27B(explorer),没有更换 editor 或 verifier 模型的消融,无法区分增益多少来自框架结构、多少来自这支固定团队的能力上限。第二,潜在同源偏差:explorer 与评估裁判同为 Qwen3.8-27B;虽然 rubric 隐藏且做过跨裁判实验(换 GPT-5.5 排序不变),但同家族模型对"什么是好游戏"的审美先验可能仍相关。第三,弱模型+Phaser 场景优势消失(对 Play2Code +1.55,$p=0.394$),提示框架收益依赖一定基础能力;且 Phaser 的 base 由 OpenGame 生成、Godot 的由 Codex 生成,两引擎的 generator 链不同,跨引擎对照并非严格同构。第四,回放方差高度依赖家族(sports 中位极差 4.66、horror 3.37,而 strategy/rhythm/racing 为 0),分家族细表(附录 F.3)的读数需结合各家族噪声判断。第五,监控器的手工规则(margin 0.05、$K=3$、$E=3$)在全部实验中固定,跨领域泛化未验证;SFT 数据蒸馏自 GPT-5.5 与 GLM-5.3-Flash,存在蒸馏天花板,且只做了一轮内化——"continual RSI"的复合收益与模式坍缩风险均未探索。
独立分析的弱点
独立分析五个弱点并给出改进方向。弱点一:清单无界增长。$C_t$ 持续累积问题、证据与验证结论,在远超 30 轮、上百个问题的长视野下会撑爆上下文并混入过时信息;改进方向是层级清单(阶段摘要+活跃项)或对 $C_t$ 周期性重写压缩,借鉴 M* 等记忆管理方案。弱点二:验证的盲区。verifier 只能看固定脚本回放的帧,案例研究自己承认"验证回放可能太短以致看不到真实修复"(Lawn Guardians R26),且官方裁判会奖励"美术盖住玩法区"的版本(R27);改进方向是引入对抗性探索 verifier、加入工具性不变量(帧率、实体数、状态机断言)作为补充信号。弱点三:饱和后的进化依赖外部 brief,而若自动生成 brief 又自动评估,闭环会带来自我拔高风险;改进方向是用任务外的 held-out 玩家模型做偏好评估来门控阶段切换。弱点四:经验内化的数据效率与覆盖不均。实际训练只用了 Godot 509 轮验证改进(Table 16),Phaser 改进轮为零,SFT 模型在 Phaser 上的提升(45.14 base → 58.53 with RSIGAME)几乎全靠测试时循环;改进方向是构造引擎无关的中介表示(游戏设计文档级轨迹)以共享跨引擎经验,并用以验证通过率为奖励的 RL 替代或增强纯 SFT。弱点五:成本结构。每任务开发 API 费约 \$0.88–\$1.75 对 140 任务尚可,但每次 checkpoint 都要重放冠军与候选,监控开销随预算线性增长;可做增量回放、帧采样与冠军缓存优化。此外所有结论基于 2D/紧凑游戏与两个引擎,向 3D 引擎(如 UE5)与大型代码库的外推完全未测。
未来方向
作者明确提出的方向:系统研究高层指导的调用时机与最优剂量,比较人类导演与模型导演的差异(目前仅 6 案例,已观察到两者对同一构建给出完全不重叠的方向:人看美术与新手引导,Claude Opus 5 看对抗公平性);把自主递归开发扩展到更大项目、更长视野、更丰富资产与跨系统依赖;在 M/D/V/A 之外评估原创性、叙事与长期玩家参与度。基于本文成果可自然延伸的方向有五。第一,闭环 continual RSI:用内化后的更强生成器重新运行 RSIGAME 产出新轨迹再内化,检验多轮迭代的收益曲线与坍缩风险——本文只做了单轮内化,这是"recursive self-improvement"标题下最值得补的实验。第二,把全局监控器的成对比较器升级为可训练的过程奖励模型,反向给 explorer 的探索策略提供学习信号,形成探索-验证联合优化。第三,领域迁移:"探索-诊断-改进 + 全局管控"是与游戏无关的元框架,可迁移到 Web 应用开发、科学计算工作流、机器人仿真任务的迭代改进,验证监控规则的普适性。第四,与形式化验证结合:对游戏规则子集抽取状态机不变量,弥补纯视觉回放验证的盲区(太短的回放看不到真实修复)。第五,学习型调度器:Figure 5 只对比了自适应与轮询,可基于清单状态训练方向选择策略,或在任务间共享"哪类问题最值得先问"的元知识;同时把监控阈值(0.05 margin、$K$、$E$)变为随游戏家族校准的自适应参数。
复现评估
复现条件在同类工作中相当好。代码、全部 prompt 与输出契约开源(github.com/WenyiWU0111/RSIGame),六个代表性进化游戏可在 HF Spaces 项目页在线试玩,51,644 个评测工件(每任务分数、裁判输出、回放报告)已发布于 HF 数据集 RSIGame/RSIGame-TableArtifacts;冻结 base 项目、完整训练语料(2,213 生成 + 2,108 规划 + 2,013 验证改进,共 221,752 行)与 run trees 标注"内部审批后发布"。附录给出罕见的复现细节:模型角色表(Table 6)、全部循环参数(Table 7:每轮 26 工具调用、1800 秒、checkpoint 间隔 3、$K=3$、margin 0.05、每 demo 16 帧)、按最便宜标准端点计价(Table 8)、语料构造与脱敏清单(403,280 处路径重写、47 个泄漏模式的独立扫描器与植入泄漏自检均零命中)、评测污染检查(140 个基准任务 ID 与 2,511 个训练任务 ID 零重叠)。算力需求温和:QLoRA 4-bit + LoRA $r=16$ 只需 4×H100 80GB 训 27B 模型 1 epoch;开发阶段是纯 API 编排,每任务 \$0.88–\$1.75。主要难点有三:多模型编排依赖 OpenRouter,同一模型不同提供商价格差可达 2 倍需固定提供商;游戏回放非确定性(同产物三次评估中位极差 0.73 分,sports 家族 4.66)必须坚持三次回放取平均;隐藏 rubric 由 GameCraft-Bench 持有,独立复核绝对分数需基准方配合,但作者用自由对局盲评与跨裁判实验部分缓解。总体评估:复现难度中等,主要门槛是多智能体编排工程而非算力或数据。
论文图表
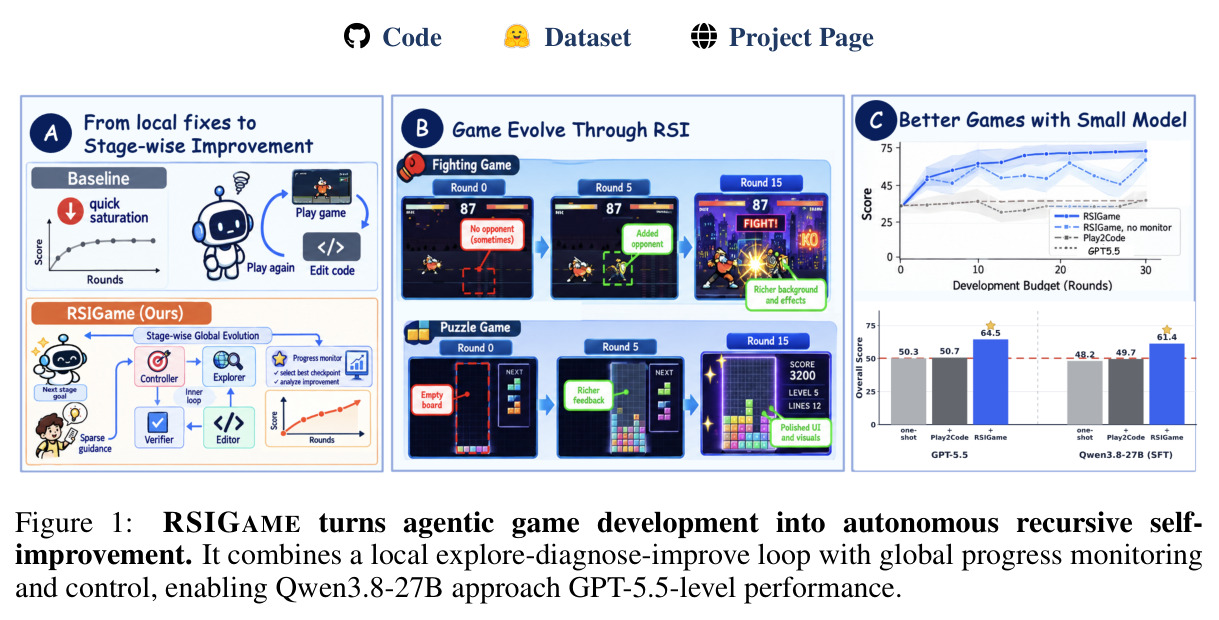
概念总览图:左侧展示自主递归自我改进的整体形态——局部探索-诊断-改进循环与全局进度监控控制相结合;右侧给出核心数字:Qwen3.8-27B 经 RSIGAME 与经验内化后逼近 GPT-5.5 水平(Godot 61.38 对 GPT-5.5 一次性 50.26),生成 token 减少 11 倍。
一图看懂论文的完整主张:不是提出新模型,而是用开发组织方式+经验内化让开源小模型逼近旗舰闭源模型。
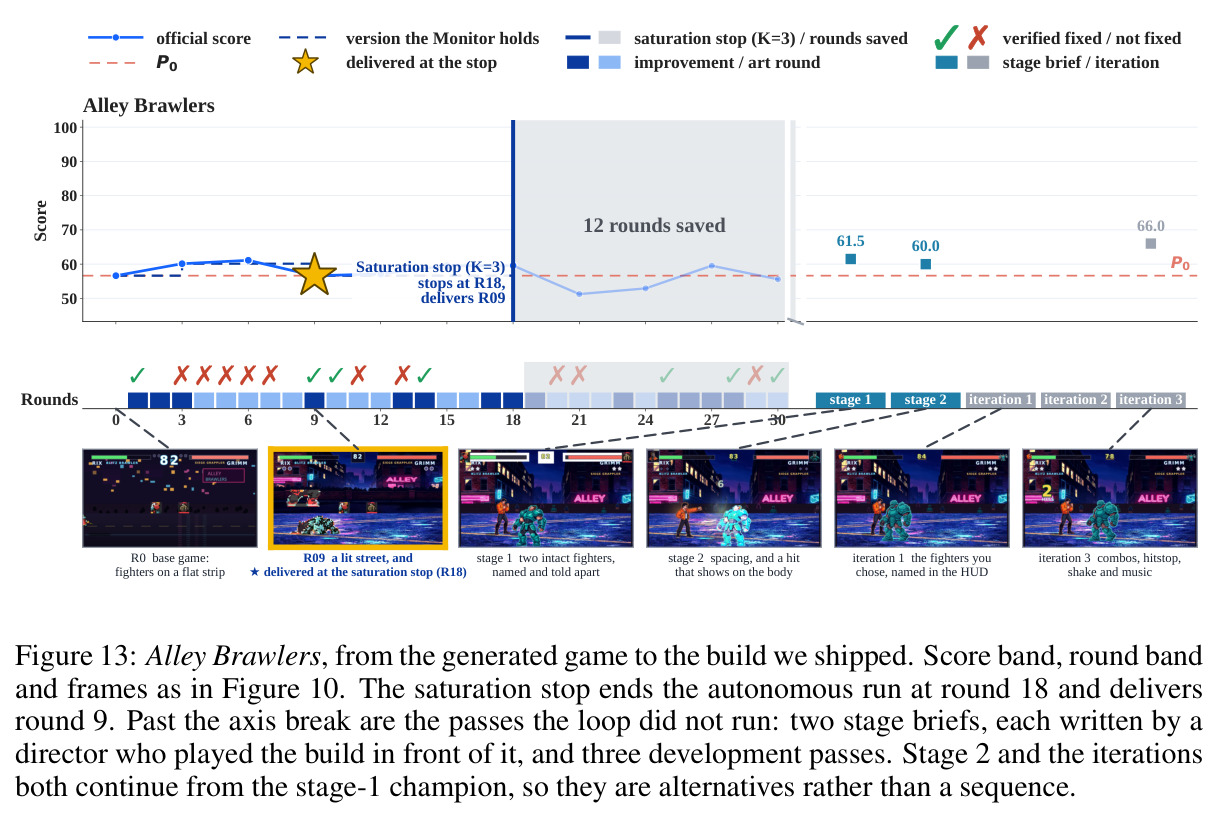
展示自主循环局限的案例:30 轮自主开发画出霓虹街景(最大单项改进)却在同几轮把格斗角色渲染改坏(运动中身体成撕裂色块),两项相抵,交付版本与 base 同为 56.6 分;随后两份 brief(模型 61.5 / 人类 62.0)对无 brief 控制分支(60.0)各带来约 1.5 分提升,第二阶段再追求'可赢的对局'。
诚实呈现'循环自己的证据买来了舞台、丢掉了演员'的失败模式,说明为何饱和后需要外部高层指导,也界定了纯自主开发的能力边界。