面向AI训练的视频存储再思考:打破跨帧依赖实现高效随机访问 Rethinking Video Storage for AI Training: Breaking Cross-Frame Dependencies for Efficient Random Access
依赖感知稀疏解码加DDRA编码,把随机抽帧的解码重建压到每目标至多3帧
前置知识
I/P/B 帧与帧间预测
视频编码把帧分为三类:I 帧只做帧内空间预测、可独立重建;P 帧参考之前的重建帧做运动补偿,只编码运动矢量与残差;B 帧可同时参考前向和后向参考帧,压缩率最高但依赖也最重。解码一帧 B 帧前必须先重建其全部参考帧,这一依赖关系是随机访问解码开销的根源。
本文的依赖闭包、B-to-B 参考边、DDRA 的双锚点设计全部建立在 I/P/B 语义之上,不懂帧间预测就无法理解解码放大从何而来。
GOP 与 intra period
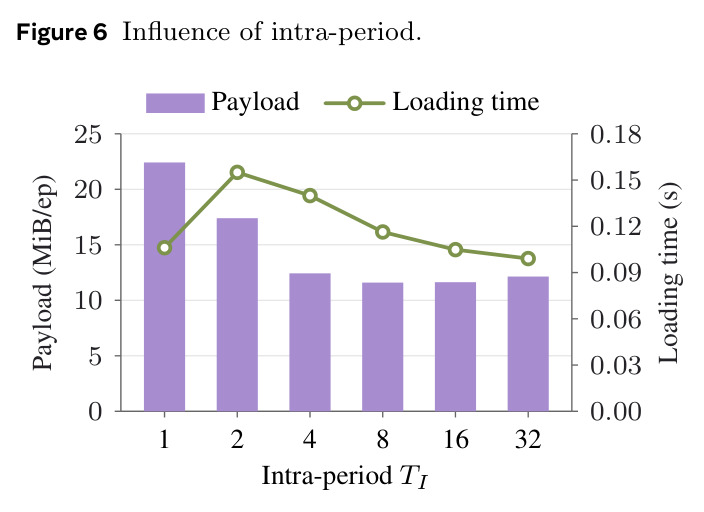
GOP(图像组)指两个 intra 帧(随机访问点)之间的区间,intra period $TI$ 即其长度。播放器只能从 I 帧快速起播;传统分层结构下目标帧离最近 I 帧越远、需要顺序重建的中间帧越多。缩短 GOP(如 LeRobot v3 的两帧 GOP)能加速访问但牺牲压缩率。
DDRA 的核心主张就是让重建开销与 $TI$ 解耦(上界恒为 3),理解 GOP 的压缩-访问权衡才能看出其设计取舍。
分层 B 帧参考(temporal layers)
现代编码器按 $L_j = \{(a+b)/2\}$ 逐层取中点构成时间金字塔:底层是 I 帧锚点,上层 B 帧引用下层帧。这提升了压缩效率并支持时间可伸缩性,但制造了跨层的 B-to-B 依赖链——请求一个高层帧要传递性地重建整条中间帧序列。
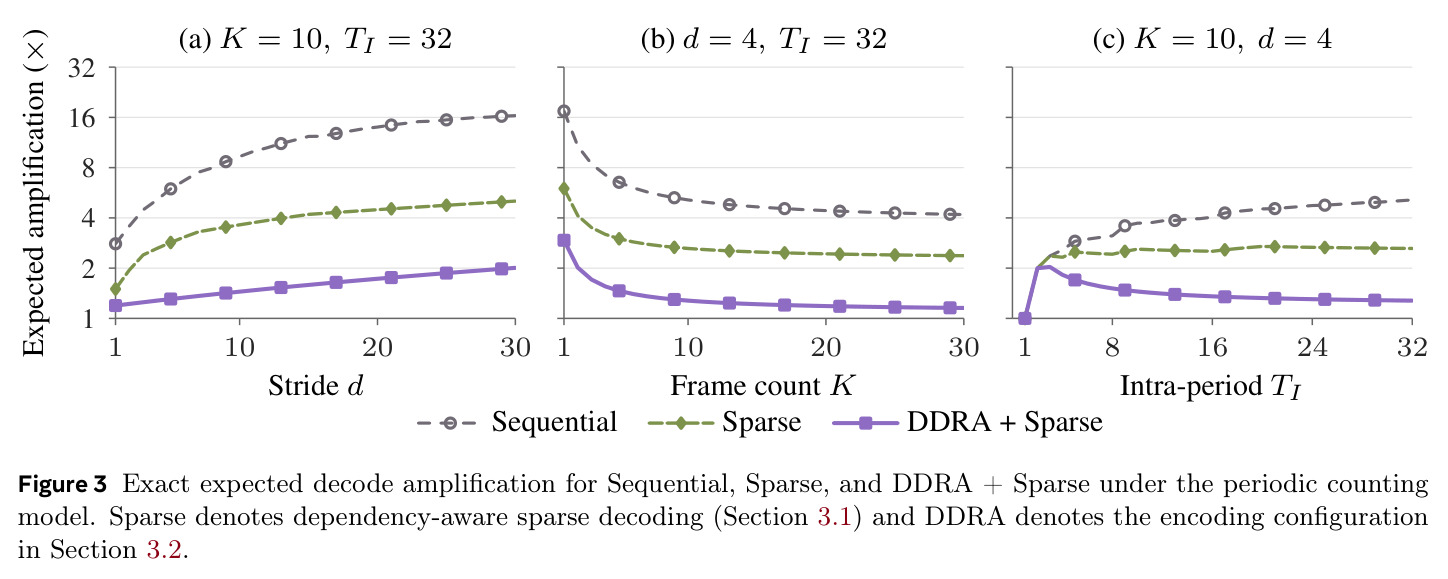
论文要剪断的正是这类 B-to-B 参考边;Figure 3 的期望放大曲线就是对这种分层结构的量化分析。
DPB(解码图像缓冲区)
DPB 是解码器维护的参考状态结构,记录哪些重建帧可作参考、图像序号(POC)计数等;H.264 的参考图标记与 HEVC 的 RPS 机制都作用在 DPB 上。即便跳过某帧的像素重建,其状态转移仍需照常执行,否则后续帧会解码出错。
稀疏解码跳过无关帧却必须保持与完整解码一致的 DPB 状态,这是论文中仅状态更新路径(state-only path)的技术前提,也是其正确性验证的重点。
CRF 与 PSNR
CRF 是 x264/x265 的恒定质量码率控制参数,数值越大压缩越狠、失真越大;PSNR 是重建质量客观指标,衡量解码帧相对源帧的峰值信噪比。跨编码器对比加载速度前必须先把重建质量对齐,本文允许各表示与 LeRobot 参考的 PSNR 差不超过 0.18 dB。
Table 1 的加载对比与 Figure 4 的下游性能扫描都以 CRF/PSNR 校准为前提,否则又快又小的结论就不公平。
VLA 与世界动作模型
VLA(视觉-语言-动作模型)如 π0.5 直接从视觉观测生成机器人操作动作;世界动作模型(WAM)如 OpenWAM 用 Wan2.2 视频骨干通过联合自注意力同时建模视频与动作动态。两者都以视频观测为核心输入,训练时数据加载管线直接决定吞吐上限。
它们是本文检验压缩是否伤害下游性能的三类任务中的两类,理解其训练形态有助于判断论文结论的适用边界。
研究动机
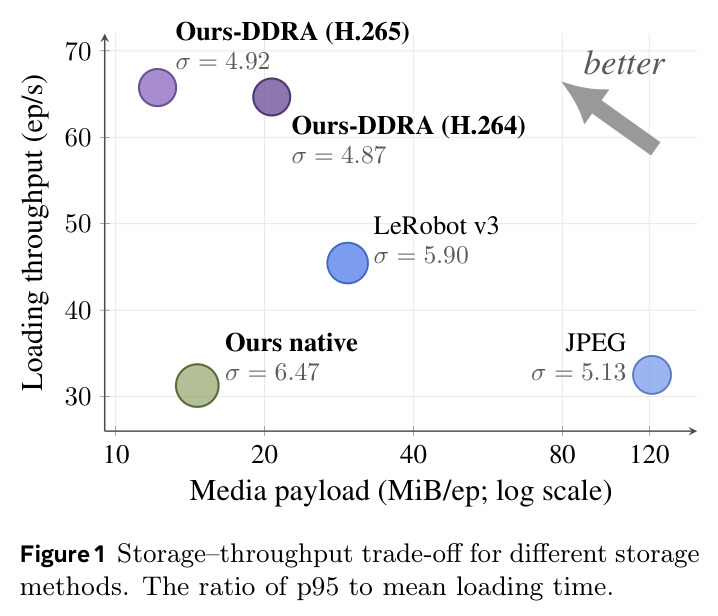
AI 训练的视频负载与播放场景完全不同:自动驾驶、机器人和多模态理解系统反复从长录像中抽取短窗口或稀疏帧、跨视频打乱请求、并在多个 epoch 中重复访问同一语料。而 H.264/HEVC/AV1 等通用编解码器为顺序播放优化,暴露出两重解码放大:容器级 seek 只能定位随机访问点,之后的中间帧仍被逐帧顺序重建,即使训练根本不要这些帧;分层 B 帧结构允许 B 帧引用 B 帧,产出一个目标帧还要传递性地重建整条引用链。作者在 RealSourceWorld、RoboCasa、Table30v2 三个机器人数据集(3,000 episodes、8,908 个相机流)上量化了代价:随机访问模式下 Sequential 解码每 episode 平均重建 233.9 帧、耗时 668.3 ms/batch。现有权宜方案要么把每帧物化为独立 JPEG(121.54 MiB/ep),要么用 LeRobot v3 式的两帧 GOP AV1(29.45 MiB/ep),相比原码流的 14.62 MiB/ep 分别膨胀 8.3 倍和 2 倍,压缩与随机访问的矛盾十分尖锐。
本文的目标是本文的目标是让视频存储同时保住两件事:帧间预测带来的压缩效率(决定持久存储与网络传输成本)和随机访问带来的解码效率(决定训练吞吐)。具体而言,作者希望解码调度只重建被请求的帧及其必需引用,跳过所有无关帧的像素重建;同时把每个请求目标的依赖闭包与 intra period 解耦——无论目标落在 GOP 内什么位置、intra 周期多长,每个目标的重建帧数都有常数上界(目标加至多两个锚点帧)。整个方案还必须保持码流标准兼容(不转码也能加速存量视频),并向现有训练管线交付完全相同的 RGB 帧接口。最终衡量标准是加载吞吐与媒体载荷这对指标:在质量对齐(PSNR 差不超过 0.18 dB)的前提下同时改善二者。
与已有工作不同的是,现有工作的切入点要么是数据组织与缓存(WebDataset 分片、Lance 随机访问、FFCV 流水线、CoorDL/Quiver/SAND 复用),要么是空间维度的格式选择(VStore、VSS、TASM 的 tiling),都没有触及问题根源:面向播放的帧间参考结构本身。本文的独特之处在于把解码开销形式化为可分别攻击的两项——公式(3)将解码放大 $A^{dec}_{\pi}(Q) = |R^{\pi}(Q)|/|Q|$ 分解为无关重建与参考重建之和——然后对症下药:在线端用依赖感知稀疏解码消除无关重建(不改码流、无需转码),离线端用 DDRA 编码剪断 B-to-B 参考边以缩短引用链。这种解码调度与编码结构的协同设计在面向训练的视频存储语境下是新的,配套的周期计数模型还给出了期望放大的精确解析曲线,使设计可以定量推理而非纯经验调参。
核心方法
直觉上,训练要的不是播放整段视频而是取走若干帧,因此解码器应该跳过一切与请求无关的像素重建。技术路线分在线、离线两层。在线的依赖感知稀疏解码:先做一遍 header 解析构建参考图,对请求集合 $Q$ 做 BFS 求出依赖闭包 $D(Q)$,再按解码顺序遍历段 $S$——闭包内的帧正常做像素重建,闭包外的帧走仅状态更新路径(patched FFmpeg 照常维护 POC 计数与 DPB 参考标记但不重建像素),保证后续参考帧的解码状态与完整解码完全一致。离线的 DDRA 编码是可选步骤:重新编码时去掉所有 B-to-B 参考边,让每个内部 B 帧只引用其所在区间的两个边界 I 帧锚点 $I_{kTI}$ 与 $I_{(k+1)TI}$。两者叠加后每个请求目标至多重建 3 帧,随机访问加载时间从 Sequential 的 668.3 ms 降到 DDRA H.265 的 140.6 ms,同时媒体载荷从 14.62 降到 12.15 MiB/ep,反而比原码流更小。
核心是依赖闭包抽象:$D(f) = \{f\} \cup \bigcup_{r \in Ref(f)} D(r)$,$D(Q) = \bigcup_{f \in Q} D(f)$。合法调度重建的帧集合 $R^{\pi}(Q) \supseteq D(Q)$,放大率分解为 $A^{dec}_{\pi}(Q) = 1 + \frac{|R^{\pi}(Q) \setminus D(Q)|}{|Q|} + \frac{|D(Q) \setminus Q|}{|Q|}$,前项是无关重建、后项是参考重建。现有 loader 只能段级 seek,段内仍顺序解码,稀疏解码可消除第一项却动不了码流里的依赖链。DDRA 的本质区别在于直接改写参考图:$Ref(B_t) = \{I_{kTI}, I_{(k+1)TI}\}$,从而 $|D_{DDRA}(Q)| \leq 3|Q|$,上界为 3 且与 intra period 无关;批量请求下锚点共享使期望降为 $1 + 2/K$。不同于放弃帧间预测的 JPEG 与靠频繁 intra 锚点缩短链的 LeRobot v3,DDRA 保留长 GOP 的帧间预测,只把 B 帧的预测对象退化为两个独立锚点。
方法步骤详情
第一步,段选择与参考图构建:SelectAndParse 从早于最早目标的最近随机访问锚点解析到解码顺序的最后一个目标,逐帧读 slice header 得到 $Ref(f)$;引用不可用则向前回退重试,失败则退化为保守连续解码。第二步,闭包计算:对去重后的请求集合 $Q$ 做 BFS 得到 $D(Q)$。第三步,InitState 装入码流参数与参数集。第四步,主循环:按解码顺序遍历段 $S$,若 $f \in D(Q)$ 则 DecodeFrame 做像素重建并仅在 $f \in Q$ 时转 RGB 存入 $X[f]$;否则 UpdateState 仅更新参考标记与 DPB 簿记。第五步,按原请求顺序返回 $[X[f] : f \in q]$。DDRA 编码侧:libx264/x265 设 keyint=32、scenecut=0、open-gop=1、bframes=31、b-adapt=0、b-pyramid=none、ref=1、CRF16,x264 需自定义构建解除 B 帧上限。正确性经 100 条流上 10,000 个请求验证,100,000 帧与完整解码逐像素一致。
技术新颖性
新颖性有四点。其一,问题被形式化:解码放大被拆成无关重建和参考重建两个可独立优化的分量,并配了周期计数模型下的精确期望分析(Figure 3),这在面向训练的视频存储文献里是首次。其二,不改码流就能加速:稀疏解码只改解码调度,任何存量 H.264/HEVC 视频无需转码即可获得 1.25-1.81 倍提速,部署门槛极低。其三,DDRA 不是新编解码标准,而是既有编码工具的重新配置——去掉 B-pyramid、让 31 个连续 B 帧只指两个 I 锚点——却达到了每目标至多重建 3 帧的类图像随机访问性,同时保住帧间预测的压缩红利(12.15 MiB/ep 对 JPEG 的 121.54)。其四,与 LeRobot v3 的 mini-GOP 思路形成清晰对照:LeRobot 靠提高 intra 频率换短链,压缩率受锚点密度钳制;DDRA 靠削边换短链,intra period 仍可放宽到 32 甚至更长,压缩上限更高,作者还给出了两种思路在期望放大曲线上的定量分界。
实验结果
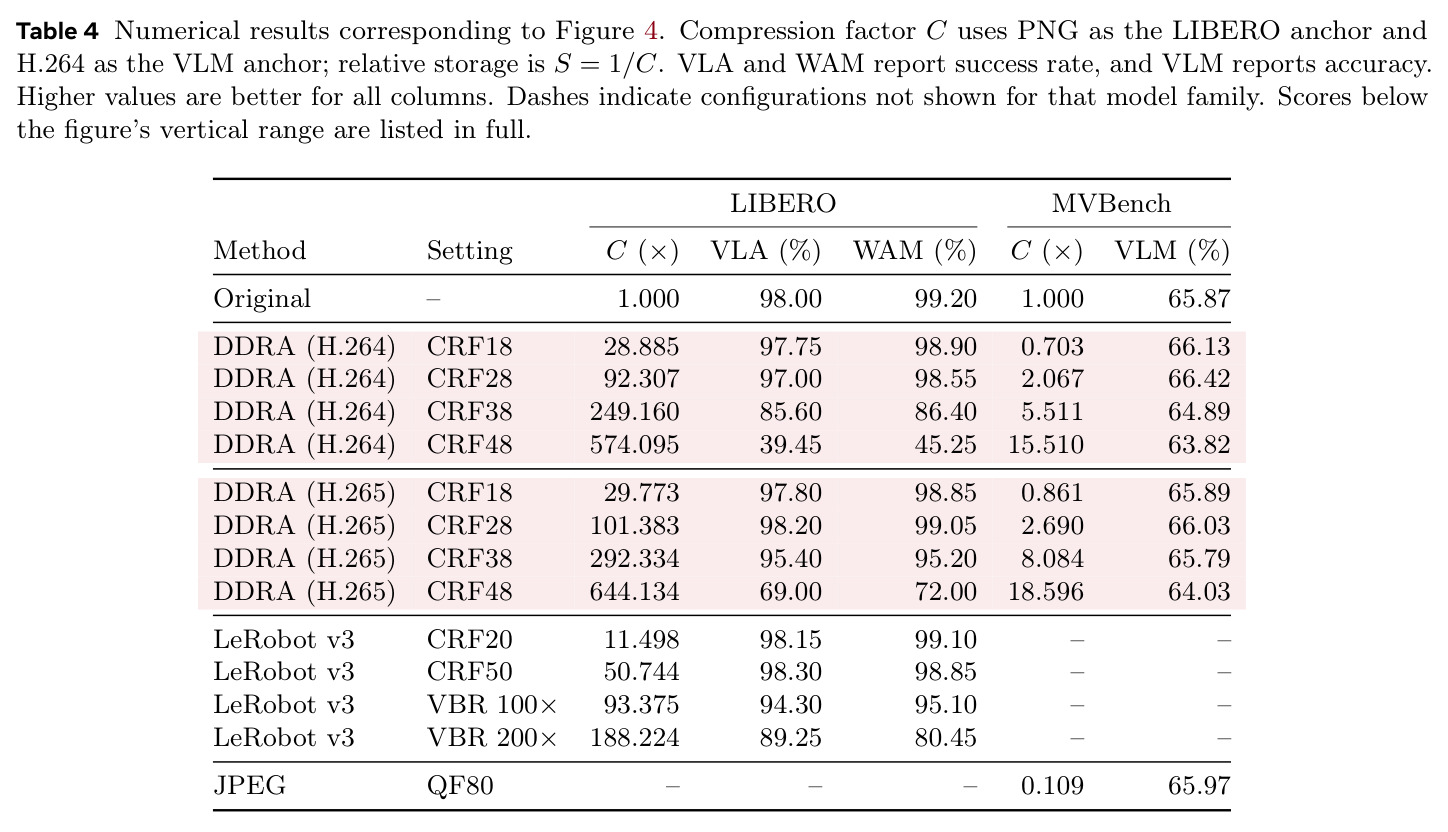
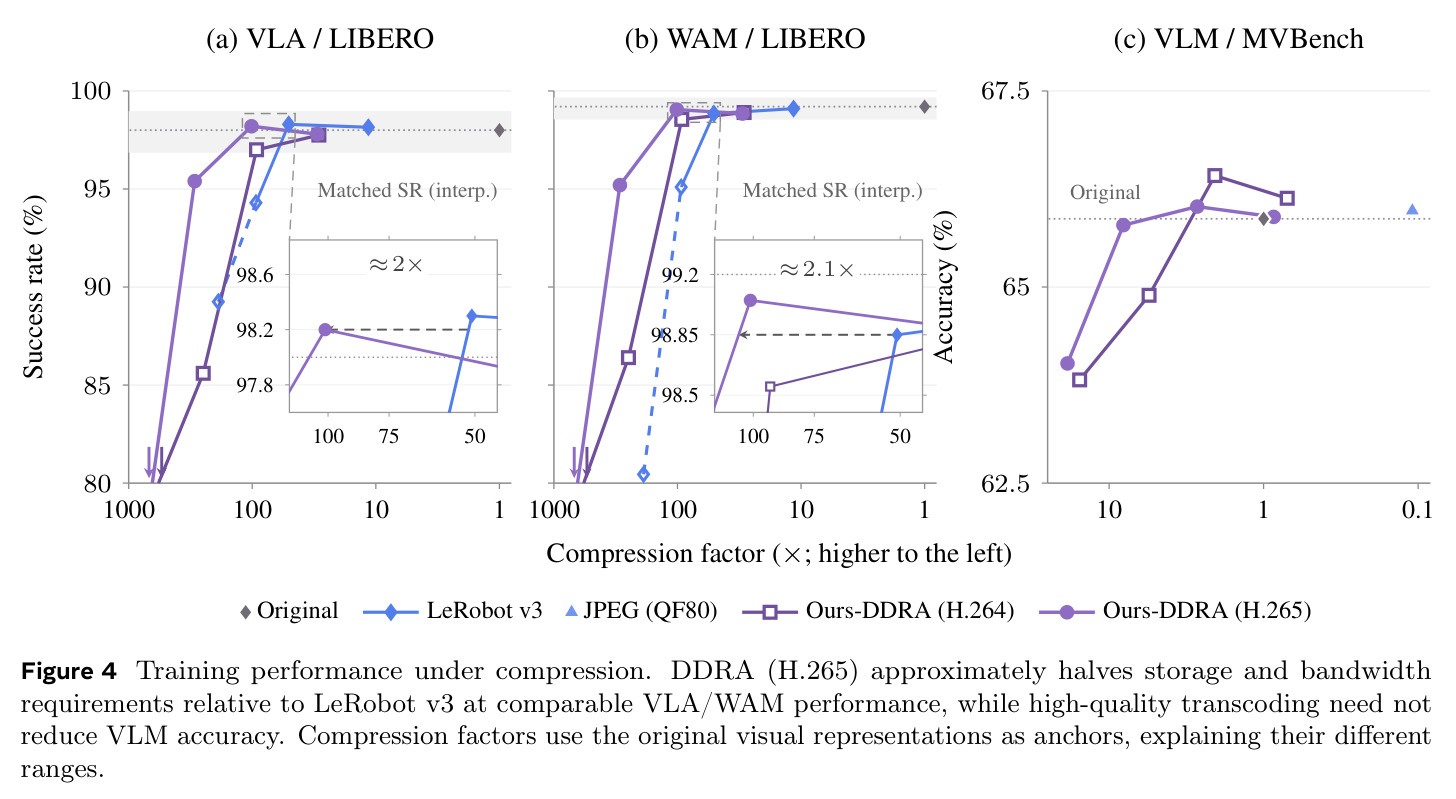
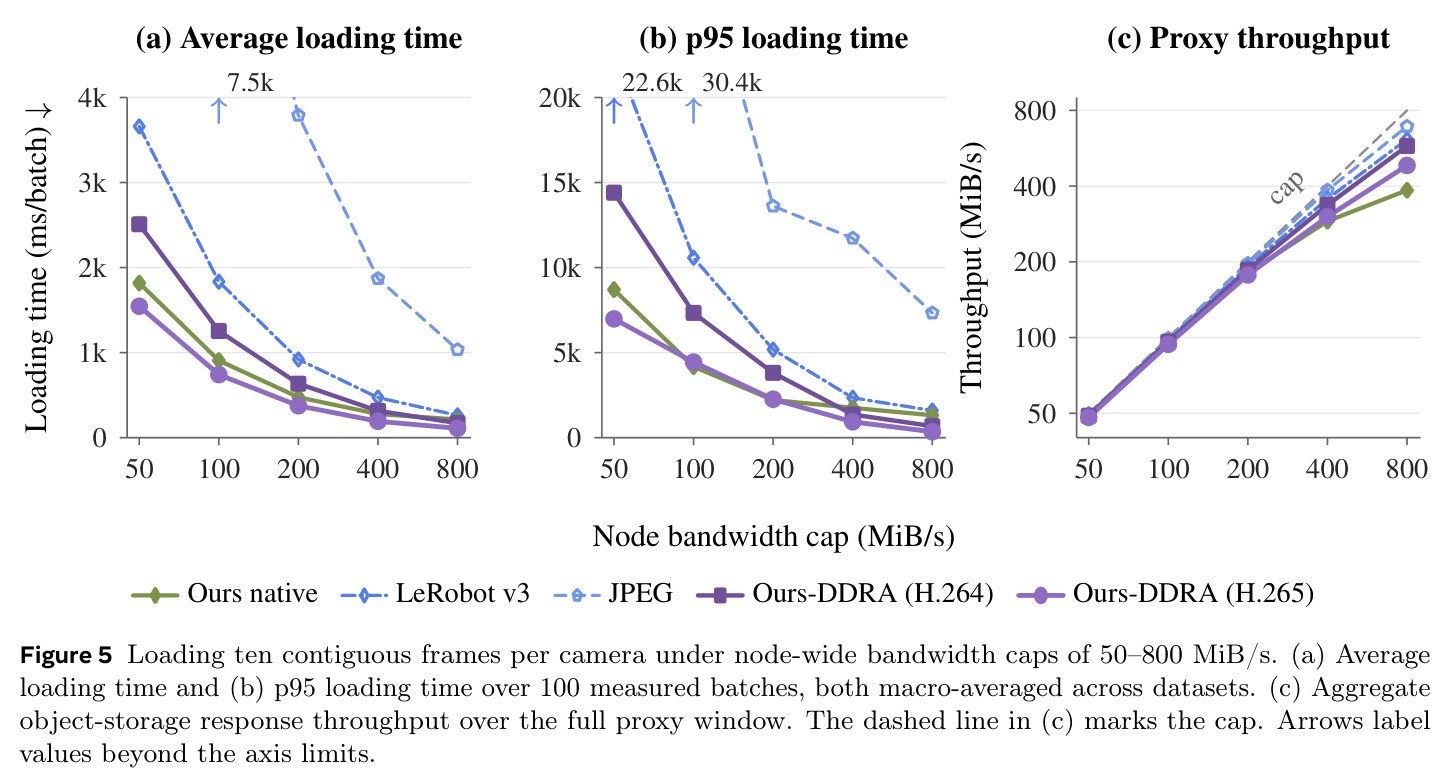
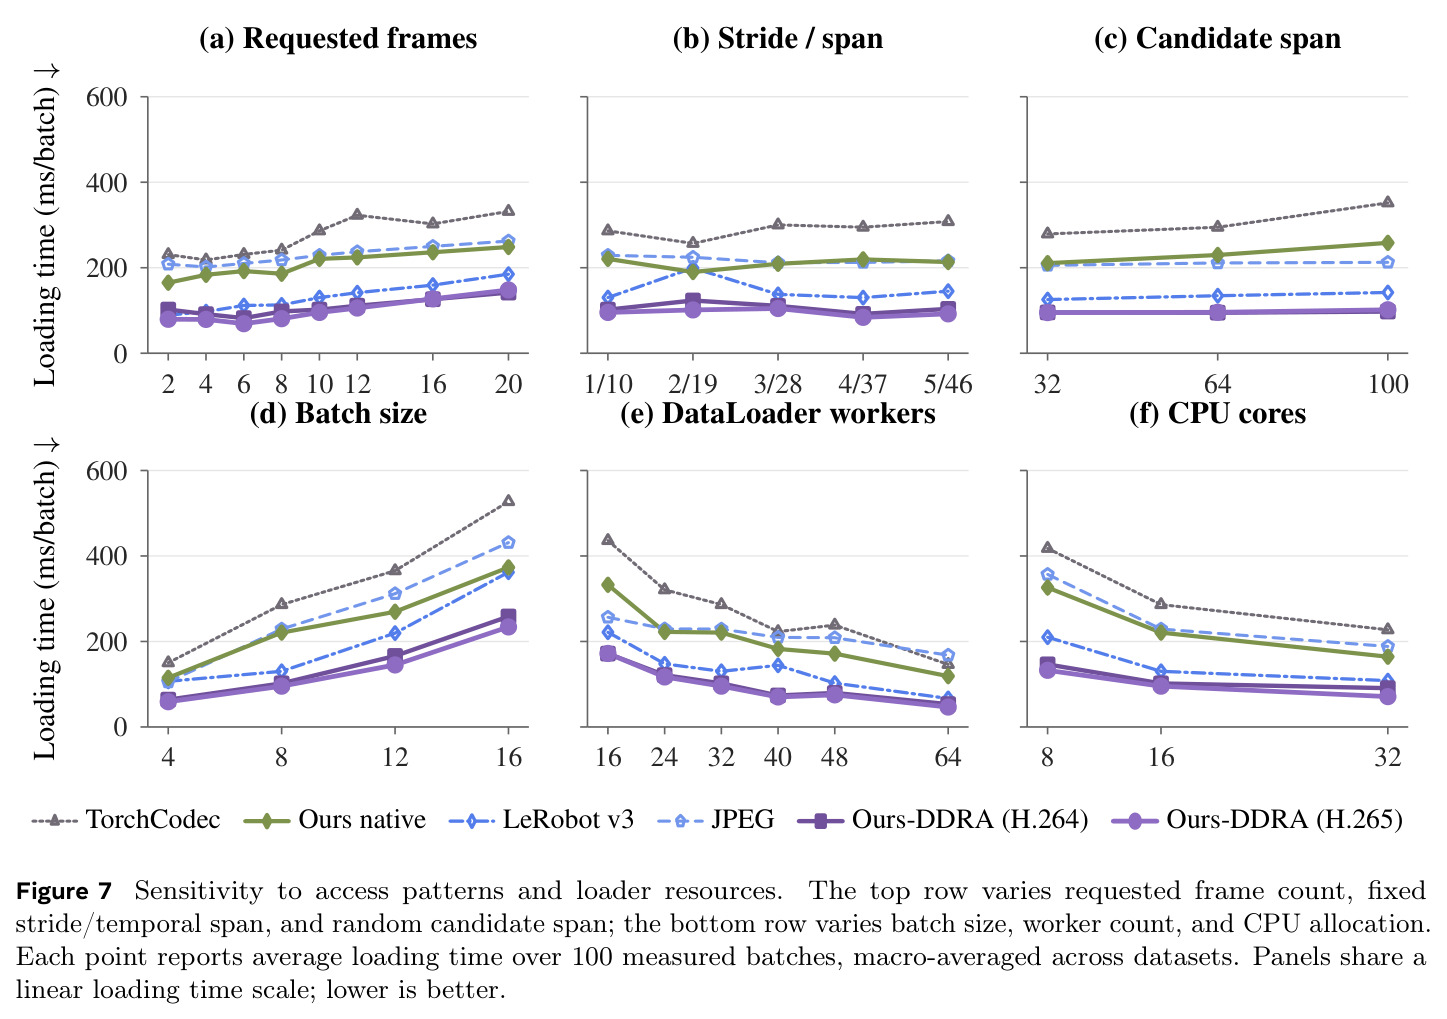
加载效率(Table 1):Ours native 无需转码即平均 226.7-297.8 ms/batch,较 PyAV、Decord、TorchCodec 分别快 1.81×、1.34×、1.25×。质量对齐(41.3-41.5 dB)后,DDRA 随机访问加载 134.1/140.6 ms(H.264/H.265),快于 LeRobot v3(185.1)与 JPEG(248.8);H.265 载荷 12.15 MiB/ep,较 LeRobot(29.45)省 58.7%、较 JPEG(121.54)省 90.0%,即 1.45× 吞吐加 58.7% 减载。组件消融与理论(Table 2/Figure 3):随机访问重建帧数 233.9→92.3→43.1 帧/ep、加载 668.3→297.8→134.1 ms,合计 4.98×;stride=30 期望放大 Sequential 16.40、Sparse 5.04、DDRA 2.01。下游(Figure 4/Table 4):H.265 CRF28 在 101× 压缩下 VLA 98.20%(Original 98.00%,p=0.706)、WAM 99.05%(99.20%,p=0.611),均无显著差异,较 LeRobot v3 约 2× 压缩增益;VLM CRF28 达 66.42% 反超 Original 65.87%,CRF48 跌至 63.82/64.03。带宽受限(Figure 5):100 MiB/s 时 H.265 达 10.79 ep/s,为 LeRobot(4.36)的 2.47×、JPEG(1.06)的 10.2×。
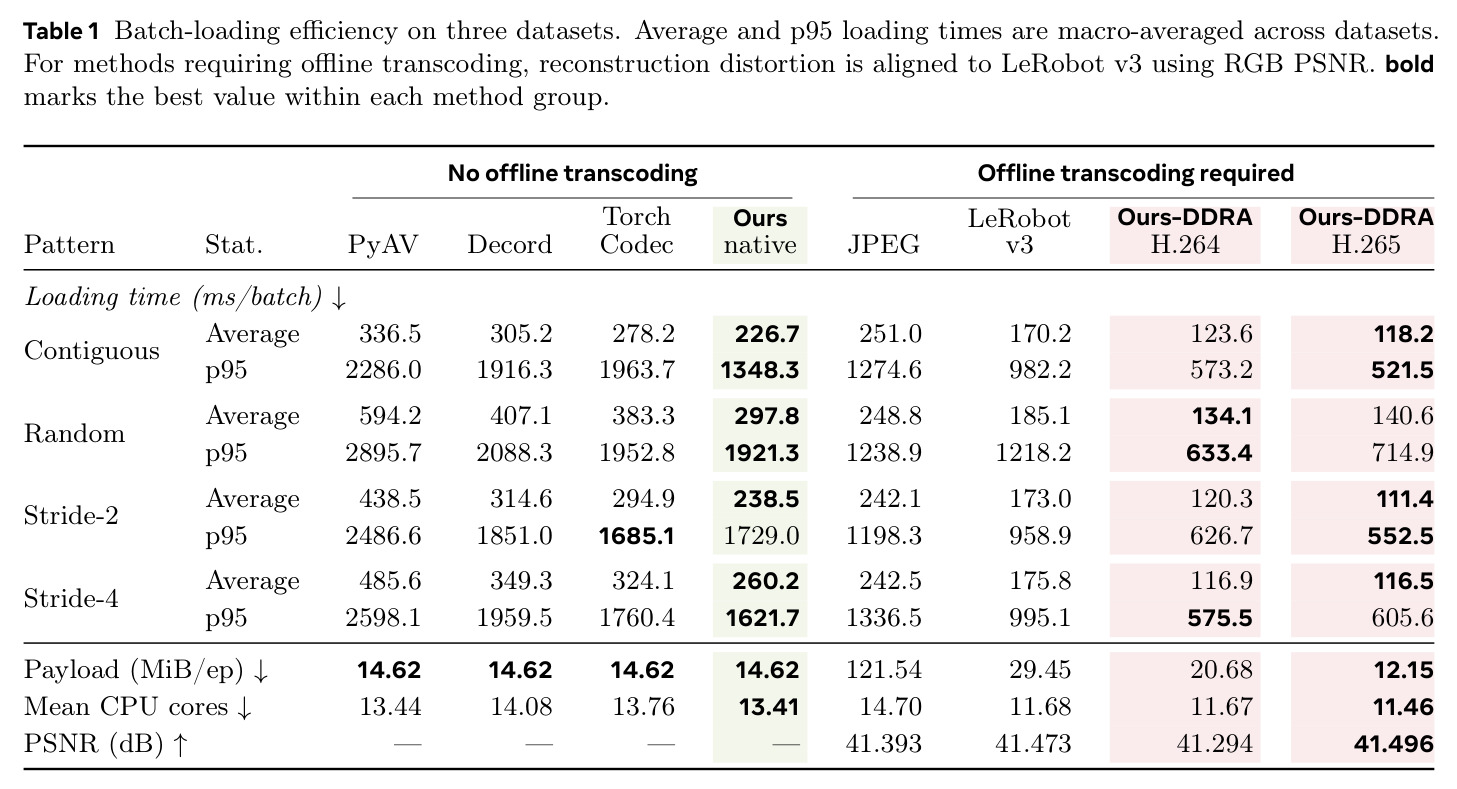
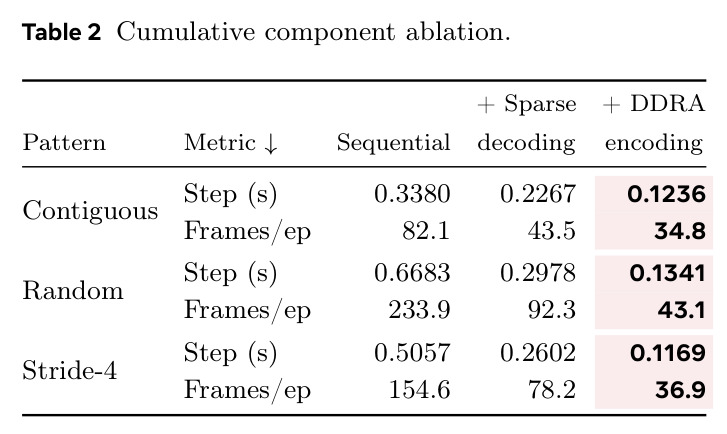
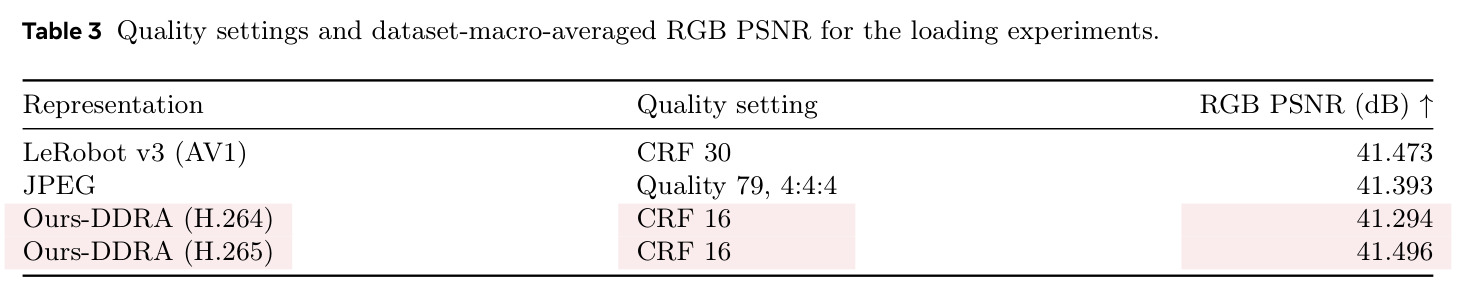
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 原生视频随机加载(不转码,机器人语料) | 平均加载时间 ms/batch(四种模式宏平均) | Ours native 260.2(随机访问 297.8) | PyAV 485.6 / Decord 349.3 / TorchCodec 324.1 | 1.81× / 1.34× / 1.25× |
| 随机访问批量加载(质量对齐转码组) | 平均加载时间 ms/batch | DDRA H.264 134.1、H.265 140.6 | LeRobot v3 185.1、JPEG 248.8 | 对 native 2.22×/2.12×,对 LeRobot 1.38× |
| 媒体载荷(存储与传输成本) | MiB/episode | DDRA H.265 12.15(H.264 20.68) | 原码流 14.62、LeRobot v3 29.45、JPEG 121.54 | 较 LeRobot 省 58.7%,较 JPEG 省 90.0% |
| 组件累积消融(随机访问) | 加载时间 / 每 episode 重建帧数 | Sequential+Sparse+DDRA:134.1 ms、43.1 帧 | Sequential:668.3 ms、233.9 帧 | 4.98× 加速,重建帧数减少 81.6% |
| VLA(π0.5 微调 LIBERO) | 成功率 %(2000 次 rollout) | 98.20(DDRA H.265 CRF28,压缩 101.4×) | Original PNG 98.00;LeRobot VBR100× 94.30 | 与 Original 无显著差异(p=0.706),存储较 LeRobot 减约一半 |
| WAM(OpenWAM 微调 LIBERO) | 成功率 % | 99.05(DDRA H.265 CRF28) | Original 99.20;LeRobot VBR200× 80.45 | 无显著差异(p=0.611),约 2.1× 压缩增益 |
| VLM(Qwen3.5-2B 微调,MVBench) | 准确率 %(3800 题) | 66.42(DDRA H.264 CRF28) | Original 65.87、JPEG QF80 65.97 | +0.55,高质量转码不掉点 |
| 带宽受限加载(节点限速 100 MiB/s) | 采样 episode 吞吐 ep/s | DDRA H.265 10.79(H.264 6.38) | LeRobot v3 4.36、JPEG 1.06 | 2.47× / 10.2× |
局限与改进
作者明确承认的局限:结论建立在 3 个机器人数据集的受控基准上;报告的是采样 episode 加载吞吐,原文声明这不代表完整张量交付速率或训练时间加速;DDRA 需要离线转码;带宽实验的代理吞吐与 Figure 1 的统计口径不同。我补充几点观察:其一,机器人视频背景静态、运动平滑,31 帧连续 B 帧只靠两个远距 I 锚点预测的码率代价在此场景可控,但对剧烈运动或频繁镜头切换的内容,锚点距离拉大可能显著抬升码率,论文未测此类数据;其二,仅状态更新路径依赖 patched FFmpeg,x264 的 bframes=31 还要自定义构建解除上限,工程侵入性不低,上游版本演进会带来维护成本;其三,加载对比的质量对齐只在单一 CRF16 上做,而下游扫描显示 CRF48 时 H.264 的 VLA 成功率崩到 39.45%,说明安全压缩边界与任务类型强相关但论文未给出映射;其四,期望放大分析假设请求起点均匀分布,真实训练 shuffle 的访问分布可能偏离该周期计数模型。
独立分析的弱点
第一,数据域单一。三个数据集全是桌面机器人操作,相机固定、帧间相关性极高;对运动剧烈、镜头频繁切换的自动驾驶或通用视频,DDRA 的远锚点预测会推高码率,载荷优势可能缩水。改进方向:按场景复杂度自适应选择 intra period,或在镜头边界强制插入锚点并局部退化为短 GOP。第二,解码器侵入性。稀疏解码依赖 patched FFmpeg 的仅状态路径,无法直接用于 NVDEC 等硬件解码器,而 AI 训练恰恰跑在 GPU 集群上。改进方向:做成 FFmpeg 上游补丁,或探索纯容器层借助 SEI/辅助索引的实现。第三,编码配置脆弱。bframes=31 需修改 x264 源码上限常量,且只在 H.264/H.265 上验证,未覆盖 LeRobot 生态正在转向的 AV1。改进方向:验证 DDRA 思想在 SVT-AV1 上的可行性。第四,训练侧证据有限。只测了 LIBERO 与 MVBench,未测对压缩伪影更敏感的视频生成模型;CRF48 下 VLA 39.45% 的陡峭崩塌说明失真-性能曲线存在悬崖,改进方向是任务感知的码率控制,把下游敏感度纳入 CRF 选择。
未来方向
作者方向:结论指出首选表示取决于请求跨度与带宽,暗示自适应表示选择(按访问模式在 native 稀疏与 DDRA 变体间动态切换)是自然延伸;把 episode 加载速率口径补全为端到端训练加速也在其列。可延伸方向:其一,与缓存/复用系统(CoorDL、SAND、Quiver)正交组合,形成复用优先、稀疏解码兜底的完整数据面;其二,GPU 解码路径——把依赖闭包信息下推给 NVDEC,或探索解码、增强、训练一体化的零拷贝流水线,这对带宽充裕的机内训练尤其有价值(800 MiB/s 时 H.264 已反超 native 的现象说明解码端仍是瓶颈);其三,把 DDRA 推广到 AV1/VVC 并研究锚点密度随场景内容的自适应;其四,训练感知编码:用下游微调信号指导 CRF 与锚点选择,寻找 Figure 4 陡崖之前的最优工作点;其五,为 VLM 预训练规模(本文 VLM 语料即有 21,437 视频、970 万帧)设计分布式转码与索引服务,把 Figure 5 的带宽受限优势转化为真实集群收益;其六,把依赖闭包思想反哺标准制定,例如在 HEVC 参考图集配置层面原生支持深度受限随机访问。
复现评估
复现条件总体较好。代码已开源(codec4AI,GitHub 仓库),三个数据集均来自公开仿真平台(RealSourceWorld、RoboCasa、Table30v2),加载基准只需 16 核 CPU 节点加 OSS 对象存储,编码参数在附录 A.4 完整给出(keyint=32、open-gop=1、bframes=31、b-adapt=0、CRF16 等)。门槛有三:需自定义构建 x264 解除 B 帧上限、需 patched FFmpeg 实现仅状态解码路径、需按附录 A.2 复刻 PSNR 对齐流程。训练侧成本显著更高:VLA 用 8 张 H800 跑 30,000 步、每配置 2,000 次 LIBERO rollout,WAM 类似,VLM 用 21,437 视频样本跑 3 epoch;复现全部 13+13+10 个配置需要可观算力,但复现单点结论(如 CRF28 的 VLA 对比)可行。正确性验证协议(100 条流、10,000 个请求、逐像素零误差)定义清晰,是检验自实现稀疏解码的理想基准。总体难度评估:加载实验中等偏易,训练实验高。
论文图表
上半部分是训练数据路径总览:离线 DDRA 编码与在线稀疏解码协作,把请求帧经 GPU 训练交付给视频理解、视频生成、自动驾驶、3DV 等下游任务;下半部分 (a)(b) 分别展示分层编码(B1-B7 依赖中间 B 帧、闭包需多次重建)与 DDRA 编码(内部帧只依赖两个 I 锚点)的编码顺序与闭包计算,附 JPEG/LeRobot/Ours/Ours-DDRA 的载荷与速度对比小表。
这是理解方法全貌的核心示意图:展示了两个组件如何嵌入训练数据通路,以及 DDRA 如何把依赖闭包从一条链压缩成三个点。