冰箱里的大象:面向长视频理解的常数内存帧打包 Elephant in the Fridge: Constant-Memory Frame Packing for Long Video Understanding
训练无关的帧打包方法:以异构分辨率把任意长视频压入固定token预算,常数内存且更准
前置知识
视觉 token 与逐帧编码
主流 VLM 用 CLIP/SigLIP 式视觉编码器把每帧图像切成 patch,每个 patch 投影为一个视觉 token,与文本 token 一起送入 LLM 主干。一帧通常产生数百个 token(论文记为 $M$),$T$ 帧视频就产生约 $T \times M$ 个视觉 token,且注意力开销随序列长度超线性增长。
本文的全部动机就是视觉 token 随视频时长线性膨胀导致的内存与延迟爆炸;方法直接操作每帧 token 数 $M/d^2$,不懂逐帧编码就看不懂问题与方法。
Keyframe selection 与 token reduction
两类主流视频压缩路线:keyframe selection 在帧级打分(查询相关性或多样性),只保留高分帧送入 LLM;token reduction 在帧内部对视觉 token 做合并或剪枝(如 FastVID、VisionZip、FrameFusion)。两者保留的 token 总数仍随视频时长以 $O(n)$ 增长,且硬丢弃是离散有损操作。
它们是论文的直接对比基线,理解其'减量但仍线性缩放'的本质,才能看出 FramePack-U 固定预算 $B$ 的根本差异。
CLIP 图文相似度
CLIP 是双塔图文对比学习模型,图像与文本各自编码为一个向量,余弦相似度衡量语义匹配程度。本文用轻量的 CLIP-ViT-B/32 给每帧与查询打相关性分 $r_i = \text{CLIP}(x_i, q)$,并用其 ViT 全局特征计算帧间相似度以实现去重。
相关性打分是 FramePack-U 排序的第一信号,决定哪些帧拿高分辨率预算;它同时也是论文自述的主要局限(CLIP 难捕捉细粒度时序事件)。
降采样因子与 token 预算
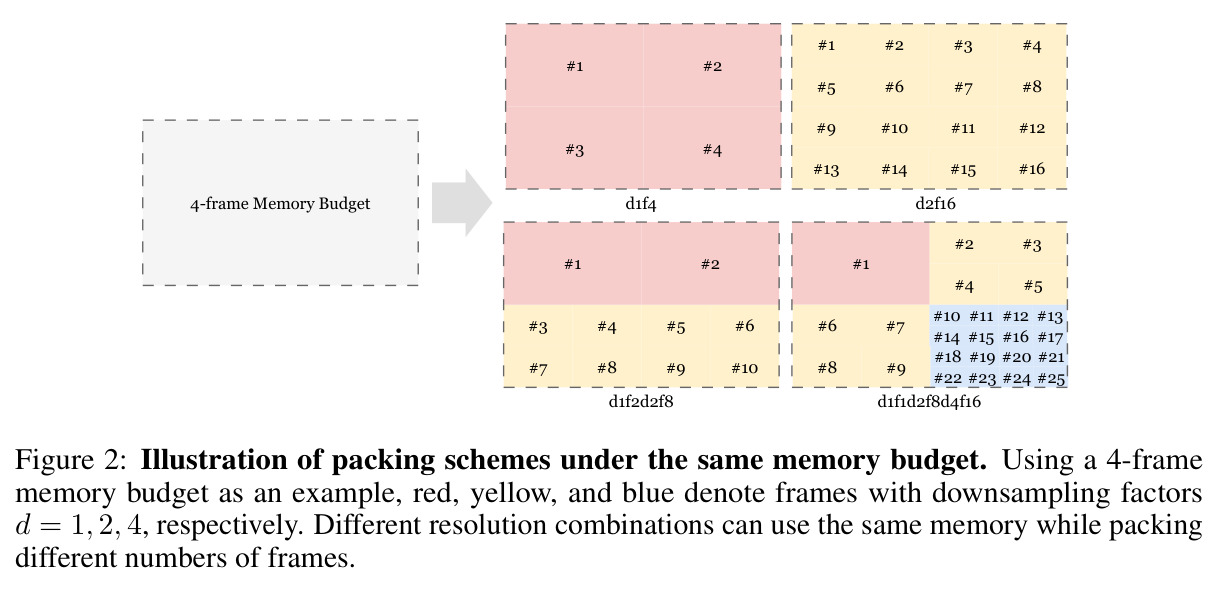
把图像每边空间分辨率缩小 $d$ 倍,其视觉 token 数变为 $M/d^2$。packing scheme 定义为层级集合 $S=\{(d, f_d)\}$,$f_d$ 是分配到该降采样层的帧数,总预算约束为 $\sum_d f_d \cdot M/d^2 \le B$。记号如 d1f16d2f448 表示 16 帧全分辨率加 448 帧 2 倍降采样,等效 128 个全分辨率帧的内存。
这套记号和预算不等式是方法第二步的全部数学语言,是理解方案搜索(Table 2)和各实验配置(d1f16d2f448 等)的前提。
O(1) 常数内存复杂度
大 O 记号描述资源随输入规模的增长阶:$O(n)$ 表示随视频长度线性增长,$O(1)$ 表示与规模无关的常数上界。本文的卖点是无论视频 15 秒还是 3600 秒,进入 VLM 的视觉 token 总量恒等于预算 $B$(如 128 帧等价),内存上限恒定。
这是标题中 Constant-Memory 的含义,也是论文论证现有方法(token reduction/keyframe selection 均为 $O(n)$)未能触及根本瓶颈的判据。
研究动机
VLM 处理视频的标准做法是用视觉编码器逐帧编码,每帧产生 $M$ 个视觉 token,token 总数随帧数线性增长。一小时视频按 fps=1 抽帧约 3600 帧,序列长度达到数十万乃至百万级,显存与推理延迟随之爆炸,上下文还被大量视觉 token 稀释。现有解法分两类:token reduction(FastVID、VisionZip、FrameFusion 等在视觉流内部合并或剪枝冗余 token)与 keyframe selection(按查询相关性或多样性打分后丢弃其余帧)。论文指出两者有两个根本缺陷:(1) 只是推迟而非消除瓶颈,保留的 token 数仍以 $O(n)$ 随视频时长增长,视频越长内存和延迟继续失控;(2) keep-or-discard 的二值决策离散且有损,会切断时间连续性、抹掉对长时程推理至关重要的瞬态动作——而这恰是长视频理解最关键、也最容易出错的区间,标题的'冰箱里的大象'正是比喻关键证据藏在被丢掉的内容里。
本文的目标是FramePack-U 的目标是把任意长度的视频压缩为一个固定大小的视觉表示,实现常数 $O(1)$ 内存复杂度,同时不降低反而提升理解精度。具体约束有三条:一是不需要微调、不修改架构,即插即用地接入现成 VLM 的推理流程;二是在固定 token 预算 $B$(论文取 128/256/512 个全分辨率帧等价内存)下,把内存集中分配给既与文本指令相关又在视觉上多样的帧;三是保留全部时间覆盖——不是丢帧,而是让所有(或尽量多)帧以不同分辨率留在上下文里。论文在 LongVideoBench、MLVU、Video-MME 三个长视频基准上,跨 Qwen3.6-27B(dense)与 Qwen3.5-35B-A3B(MoE)两个骨干验证该目标,并要求同时考察内存、延迟等运行时代价。
与已有工作不同的是,独特切入角度是把视频生成文献中的 FramePack 打包思想迁移到理解任务。原版 FramePack 为 next-frame prediction 生成模型设计,按与预测目标的时间邻近度分配异构 token 预算,偏向时间连续性;但理解任务需要在整个视频范围内检索与问题相关的证据,直接套用并不合适。FramePack-U 的核心洞察是范式转换:与其丢帧(二值、有损、仍线性缩放),不如给每帧分配不同的空间分辨率(连续可调),重要帧保持高清、其余帧降采样但仍然保留,因此理论上可以把任意多帧 pack 进固定预算。同时排序准则不按时间邻近,而按'查询相关性 × 视觉多样性'的内容感知排序。这使它成为首个把生成侧打包原则改造为理解侧推理时压缩框架的工作,且完全 training-free。
核心方法
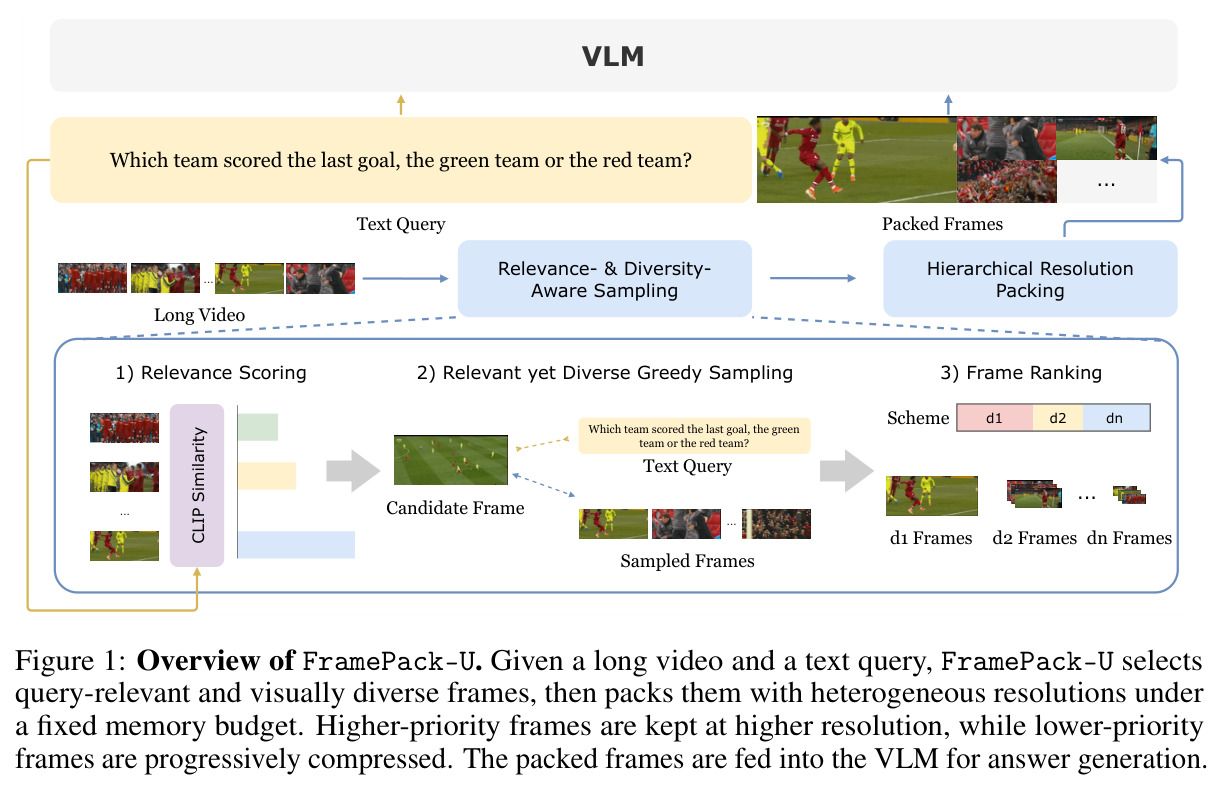
直觉先讲:同样 128 帧等价的内存,与其均匀采样 128 帧全分辨率,不如塞进几百甚至上千帧,只是分辨率不同——重要帧清晰、次要帧模糊但都在,时间覆盖完整。技术路线分两步。第一步 relevance- and diversity-aware sampling:用 CLIP 计算每帧与文本查询的余弦相似度 $r_i = \text{CLIP}(x_i, q)$,再贪心迭代地选帧,兼顾相关与不冗余。第二步 hierarchical resolution packing:按方案 $S=\{(d, f_d)\}$ 把排好序的帧分配到不同降采样层级,满足 $\sum_d f_d \cdot M/d^2 \le B$($M$ 为全分辨率帧 token 数,$d$ 为空间降采样因子),排序靠前的帧获得小 $d$ 高分辨率。打包后的序列按时间顺序拼接,直接送入现成 VLM。例如 128 帧预算的方案 d1f16d2f448:16 帧全分辨率 + 448 帧 2 倍降采样,总开销 $16 + 448/4 = 128$ 帧等价。整个流程 training-free、模型无关。
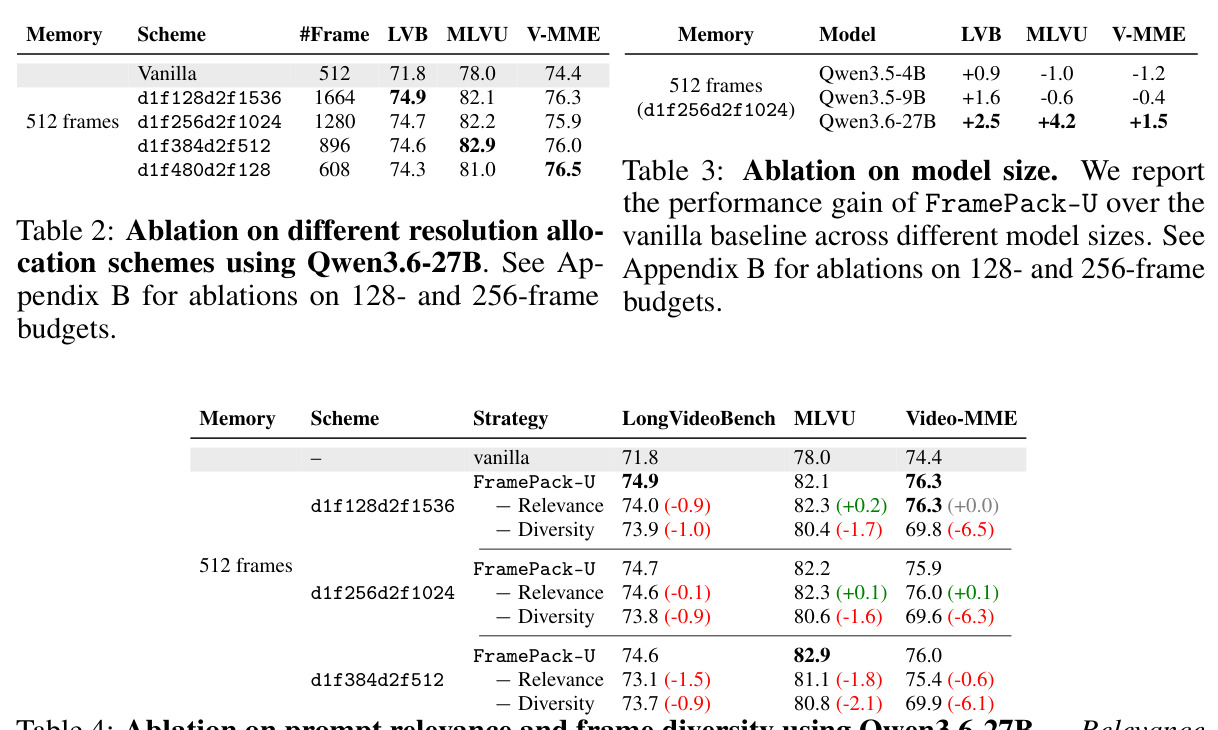
核心创新有两点。其一,从'丢弃'到'重分配分辨率'的范式转变:现有方法是二值的 keep-or-discard,token 数仍是 $O(n)$ 且破坏时间连续性;FramePack-U 用降采样因子把每帧 token 数连续调成 $M/d^2$,帧数与内存解耦——内存恒为 $B$,所有帧的时间覆盖得以保留,'大象不再被扔掉,只是画得小一点'。其二,排序由相关性与多样性联合决定:$n=1$ 时选 $r_i$ 最大的帧做种子;$n\ge 2$ 时选 $x^*_n = \arg\max_{x_i} [\lambda r_i - (1-\lambda)\max_{x_j\in\tilde{V}} \text{sim}(x_i, x_j)]$($\lambda=0.7$),相关性减去与已选帧的最大相似度,防止高分辨率预算被视觉冗余帧挤占。消融显示去掉多样性项 Video-MME 掉 6.1-6.5 分,去掉相关性项仅掉 0-1.5 分,多样性是主要收益、相关性提供聚焦。与生成版 FramePack 的本质区别在排序准则:不按时间邻近而按内容感知的任务相关性。
方法步骤详情
流程对应 Algorithm 1:(1) 帧抽取:均匀采样 $T$ 帧。(2) 相关性打分:CLIP-ViT-B/32 计算每帧与查询 $q$ 的余弦相似度 $r_i$。(3) 贪心排序:$n=1$ 选 $\arg\max r_i$ 为种子;$n\ge2$ 每步选 $\arg\max_{x_i}[\lambda r_i - (1-\lambda)\max_{x_j\in\tilde{V}}\text{sim}(x_i,x_j)]$,帧间相似度用 ViT 全局特征,直到选出 $N$ 帧。(4) 方案实例化:按预算选 scheme,如 128 帧用 d1f16d2f448、512 帧用 d1f128d2f1536。(5) 分辨率分配:各层按 $d$ 升序排列,第 $n$ 帧落入满足 $\sum_{d'<d}f_{d'} < n \le \sum_{d'\le d}f_{d'}$ 的层级并 Resize 到 $1/d$。(6) 输出:$\{\hat{x}_n\}$ 按时间序重排为 $V^*$ 送入 VLM。默认 $\lambda=0.7$;MLVU 帧长边 resize 至 1280 像素。
技术新颖性
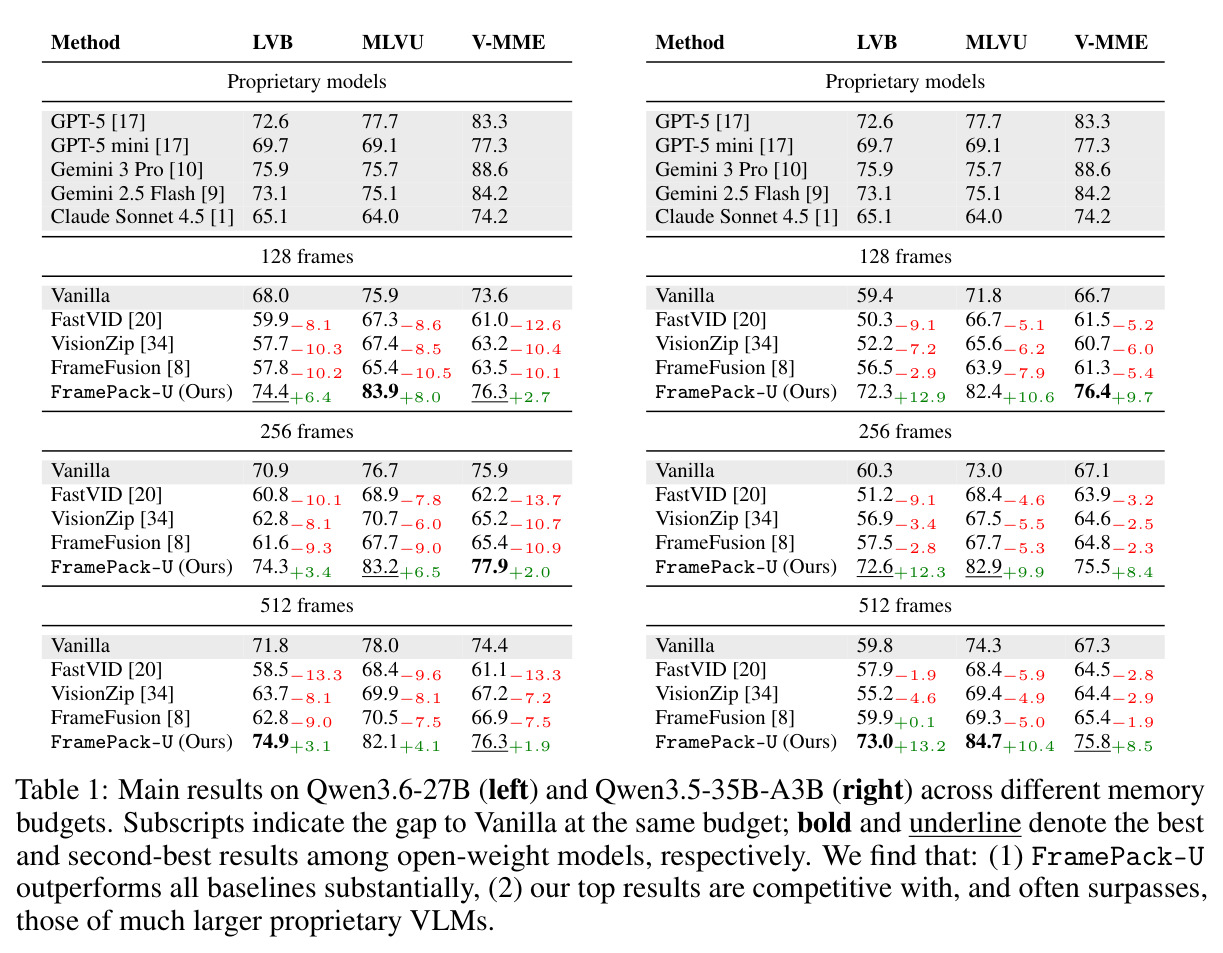
技术新颖性:(1) 首个把 FramePack 式异构分辨率打包引入理解侧的框架,与生成侧的关键区别是排序信号从时间邻近换成相关性×多样性,论文论证了这一迁移的必要性(理解需全视频找证据而非延续时间连续性)。(2) 与 slow-fast 双通路等混合分辨率工作相比,FramePack-U 完全 training-free、不改架构与编码器,纯推理时预处理,且内存严格常数 $O(1)$。(3) 与 FastVID/VisionZip/FrameFusion 在同一预算下正面对比:它们在 LongVideoBench 上普遍掉 8.1-13.3 分,而 FramePack-U 反升 3.1-13.2 分,实证了'降分辨率保覆盖'优于'减 token 保分辨率'这一反直觉结论。(4) 经验性发现性能对具体 scheme 不敏感:512 帧预算下 4 种方案(打包帧数 608-1664)全部超 vanilla,但 $N$ 非单调越大越好——帧分辨率低于 VLM 预训练分布后性能退化,最优 $N$ 是时间密度与单帧保真度的折中,这为后续研究划定了设计空间。
实验结果
主实验(Table 1):128 帧预算 Qwen3.6-27B 达 74.4/83.9/76.3(LVB/MLVU/V-MME),较 vanilla 68.0/75.9/73.6 提升 +6.4/+8.0/+2.7;MoE 骨干 Qwen3.5-35B-A3B 达 72.3/82.4/76.4,较 vanilla 59.4/71.8/66.7 提升 +12.9/+10.6/+9.7,部分设置超 GPT-5 mini;而 FastVID/VisionZip/FrameFusion 掉 2.3-13.7 分。scheme 消融(Table 2):512 预算下 4 种方案(608-1664 帧)得 LVB 74.3-74.9、MLVU 81.0-82.9、V-MME 76.0-76.5,均超 vanilla 的 71.8/78.0/74.4。策略消融(Table 4):去多样性 V-MME 76.3→69.8(-6.5),去相关性仅 -0.9~+0.2,多样性是主要收益。规模消融(Table 3):4B 增益 +0.9/-1.0/-1.2,9B +1.6/-0.6/-0.4,27B +2.5/+4.2/+1.5,小模型可能负增益。运行时(Table 5/6):预处理内存恒约 1.3 GiB、延迟约 2.3s;9B 端到端 32.2s→21.3s,3600s 视频 76.4s→47.7s。
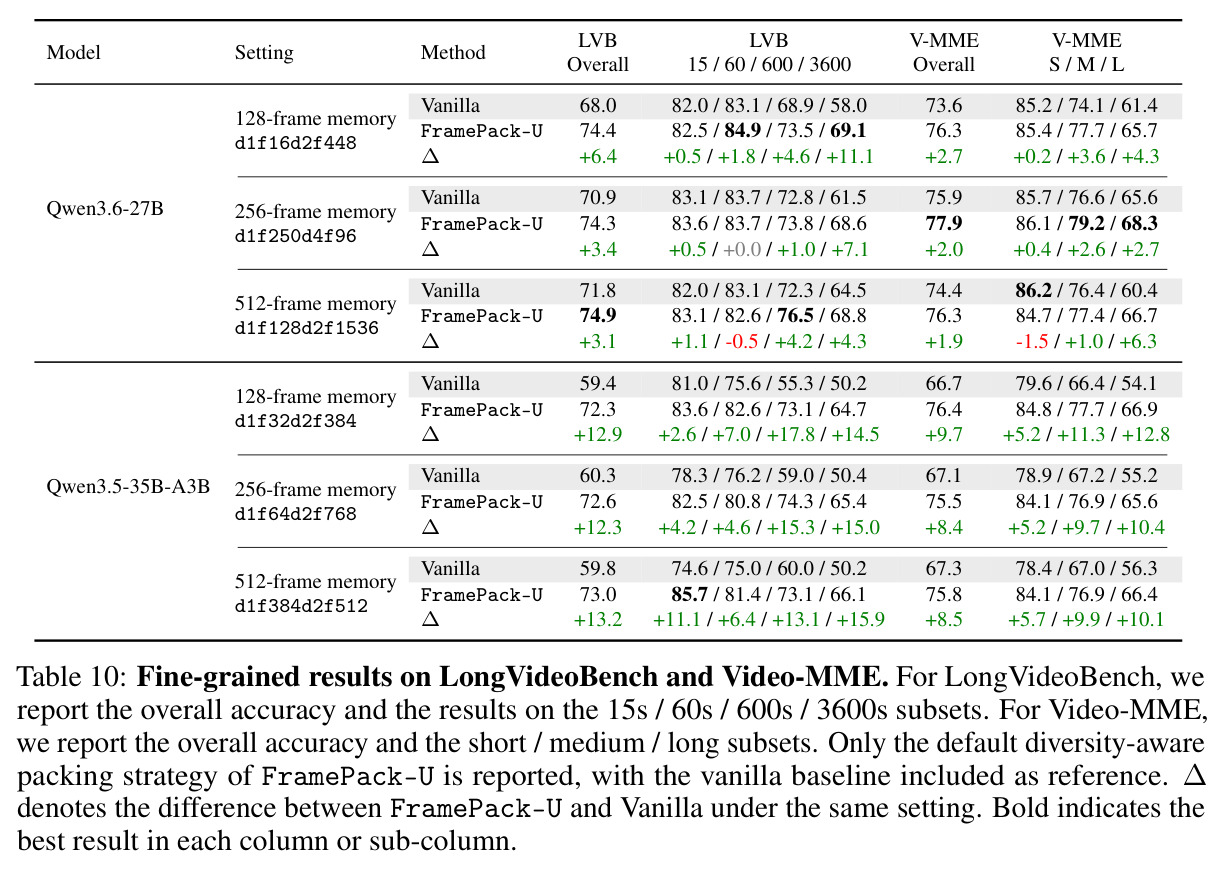
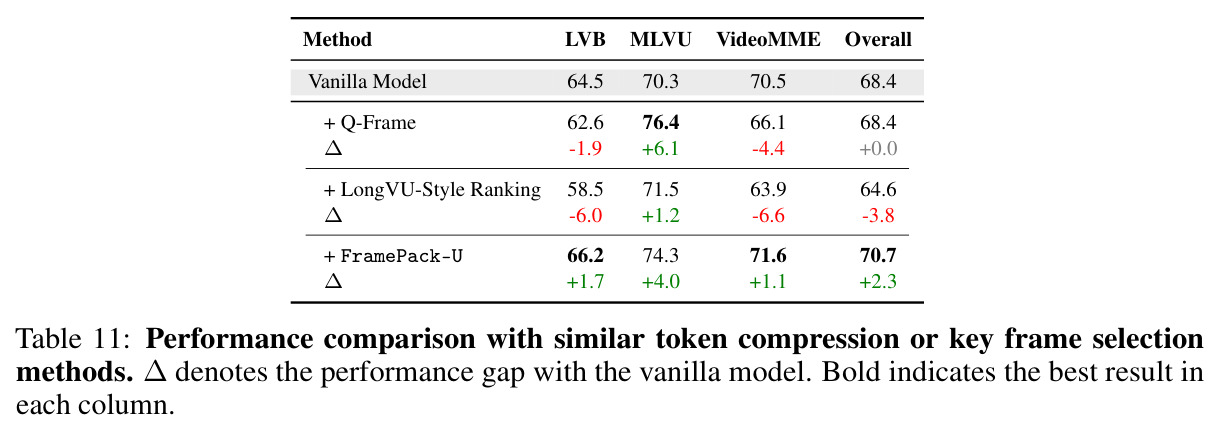
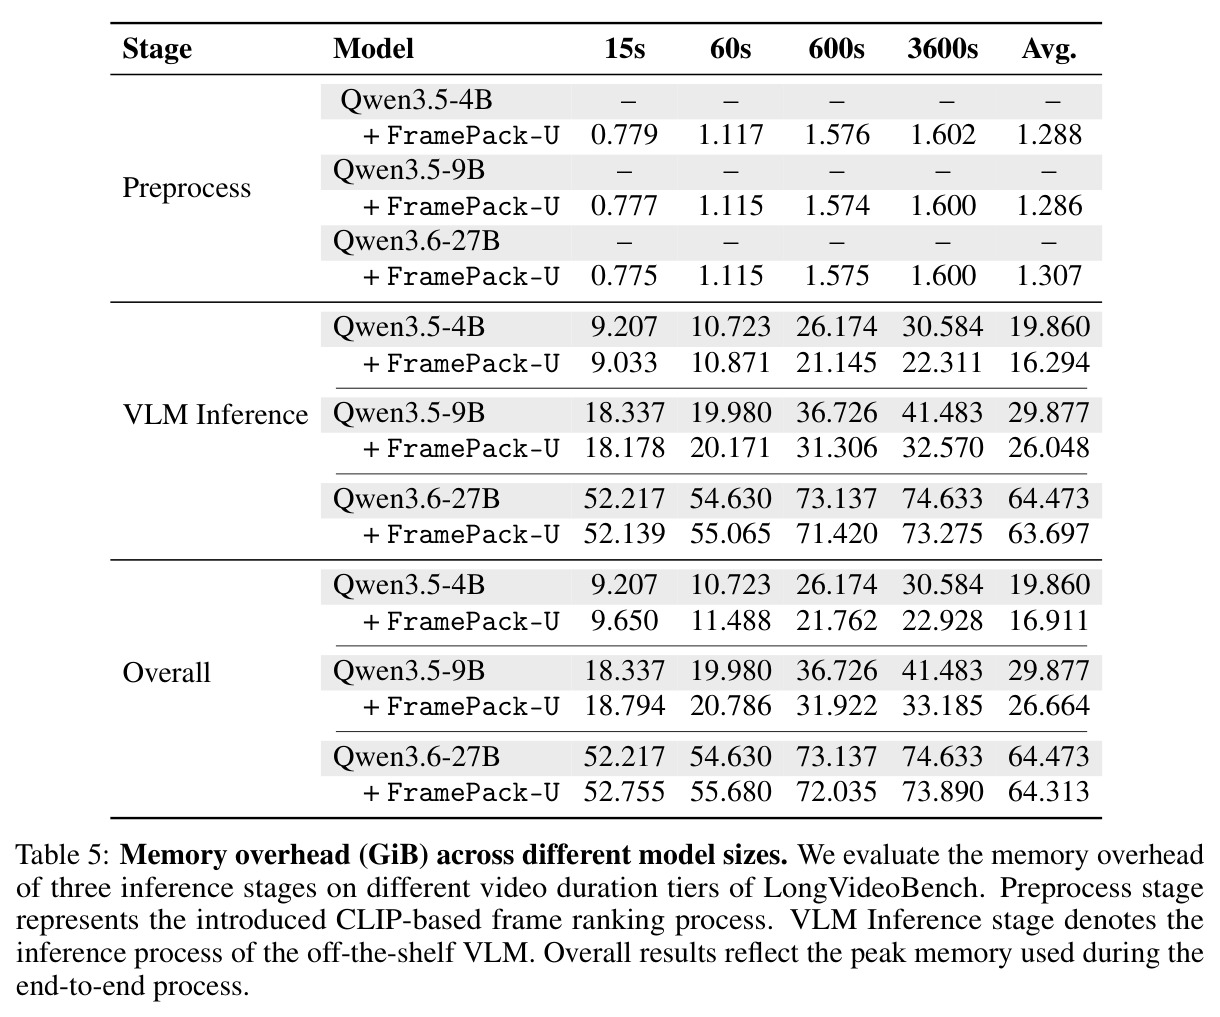
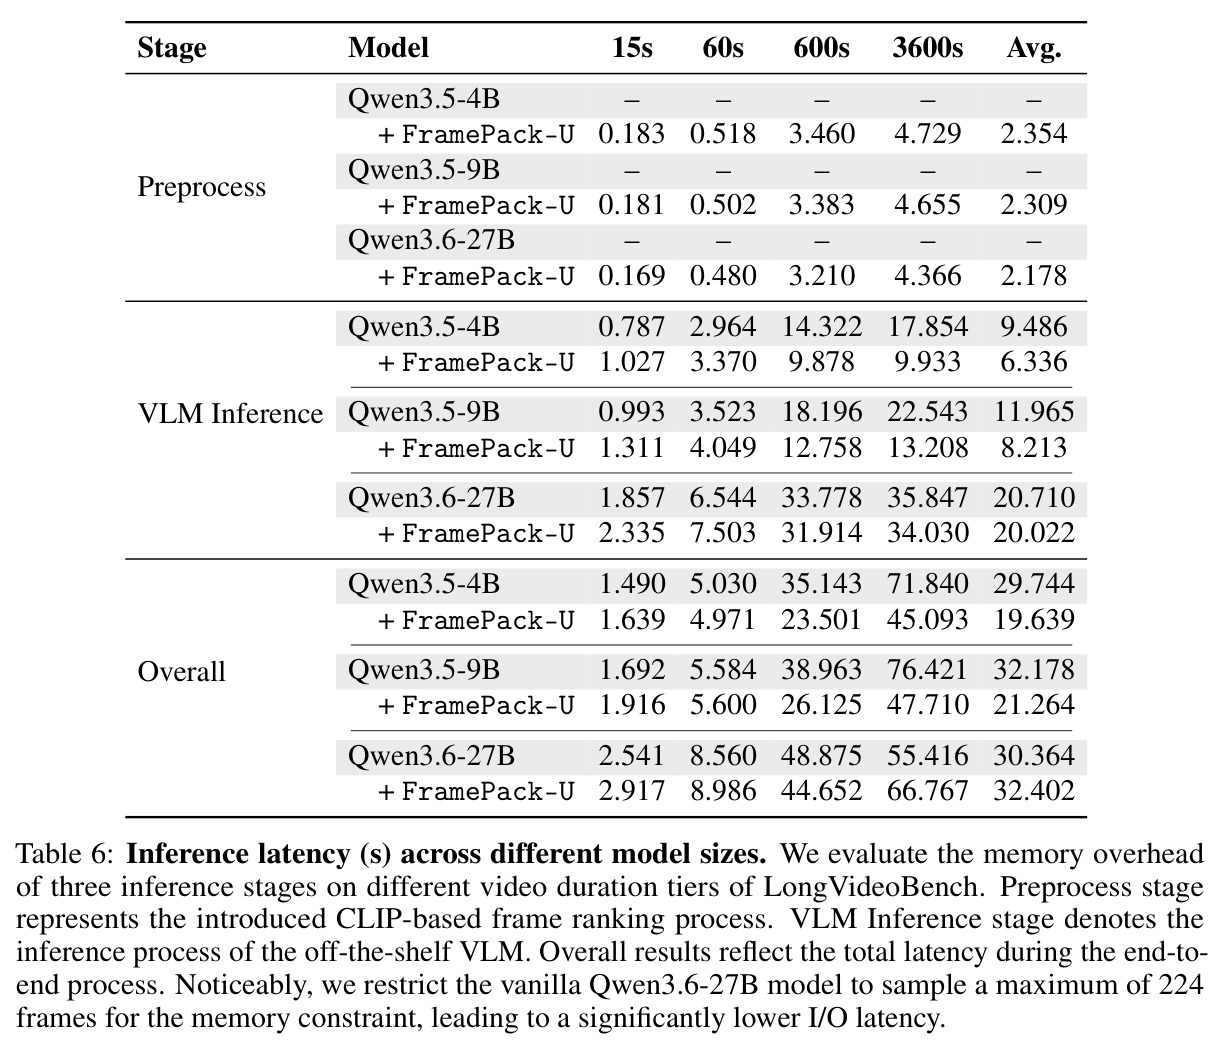
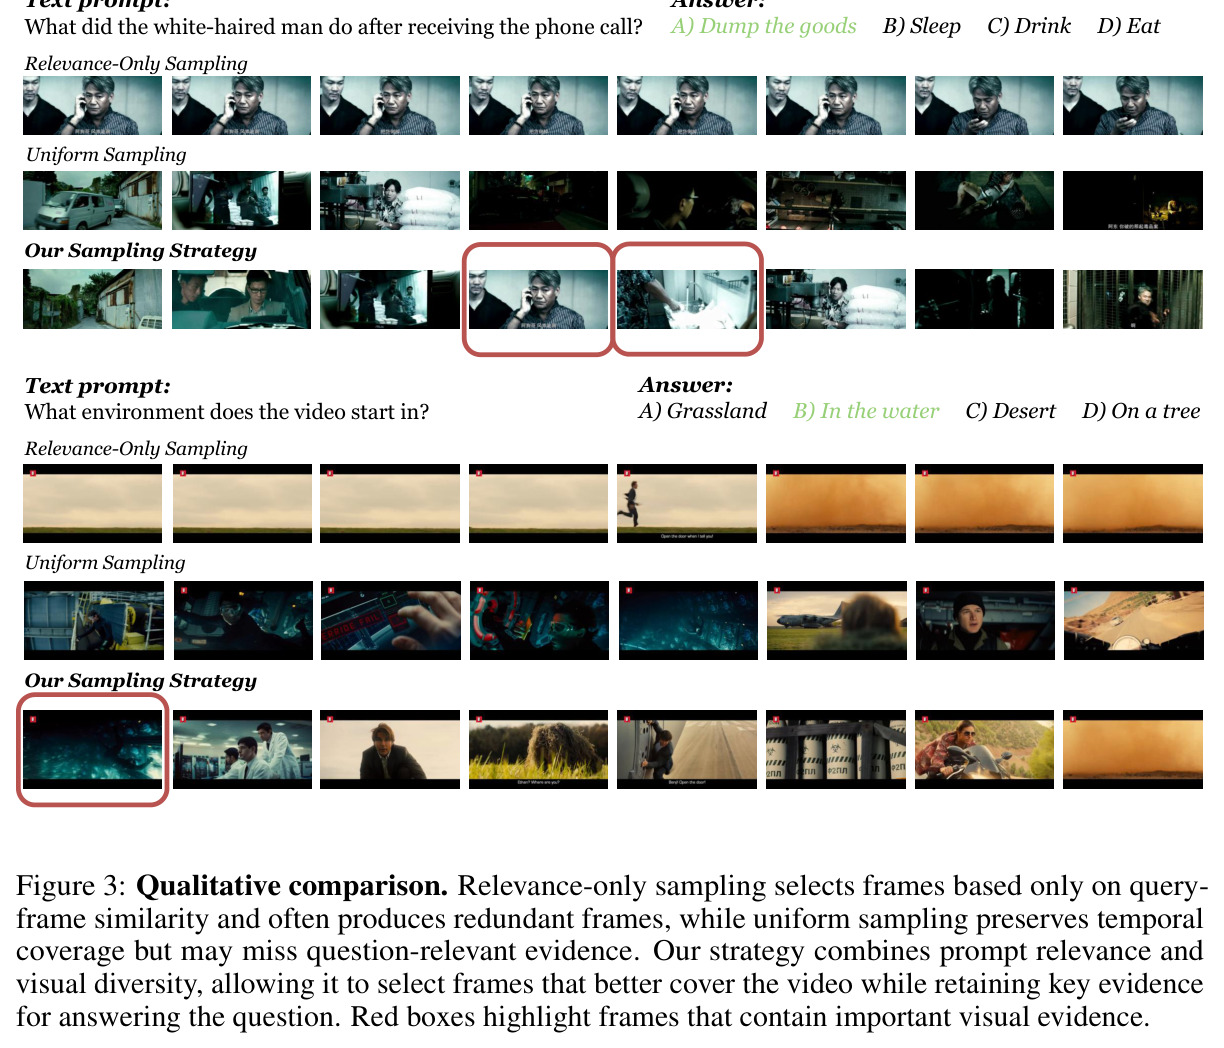
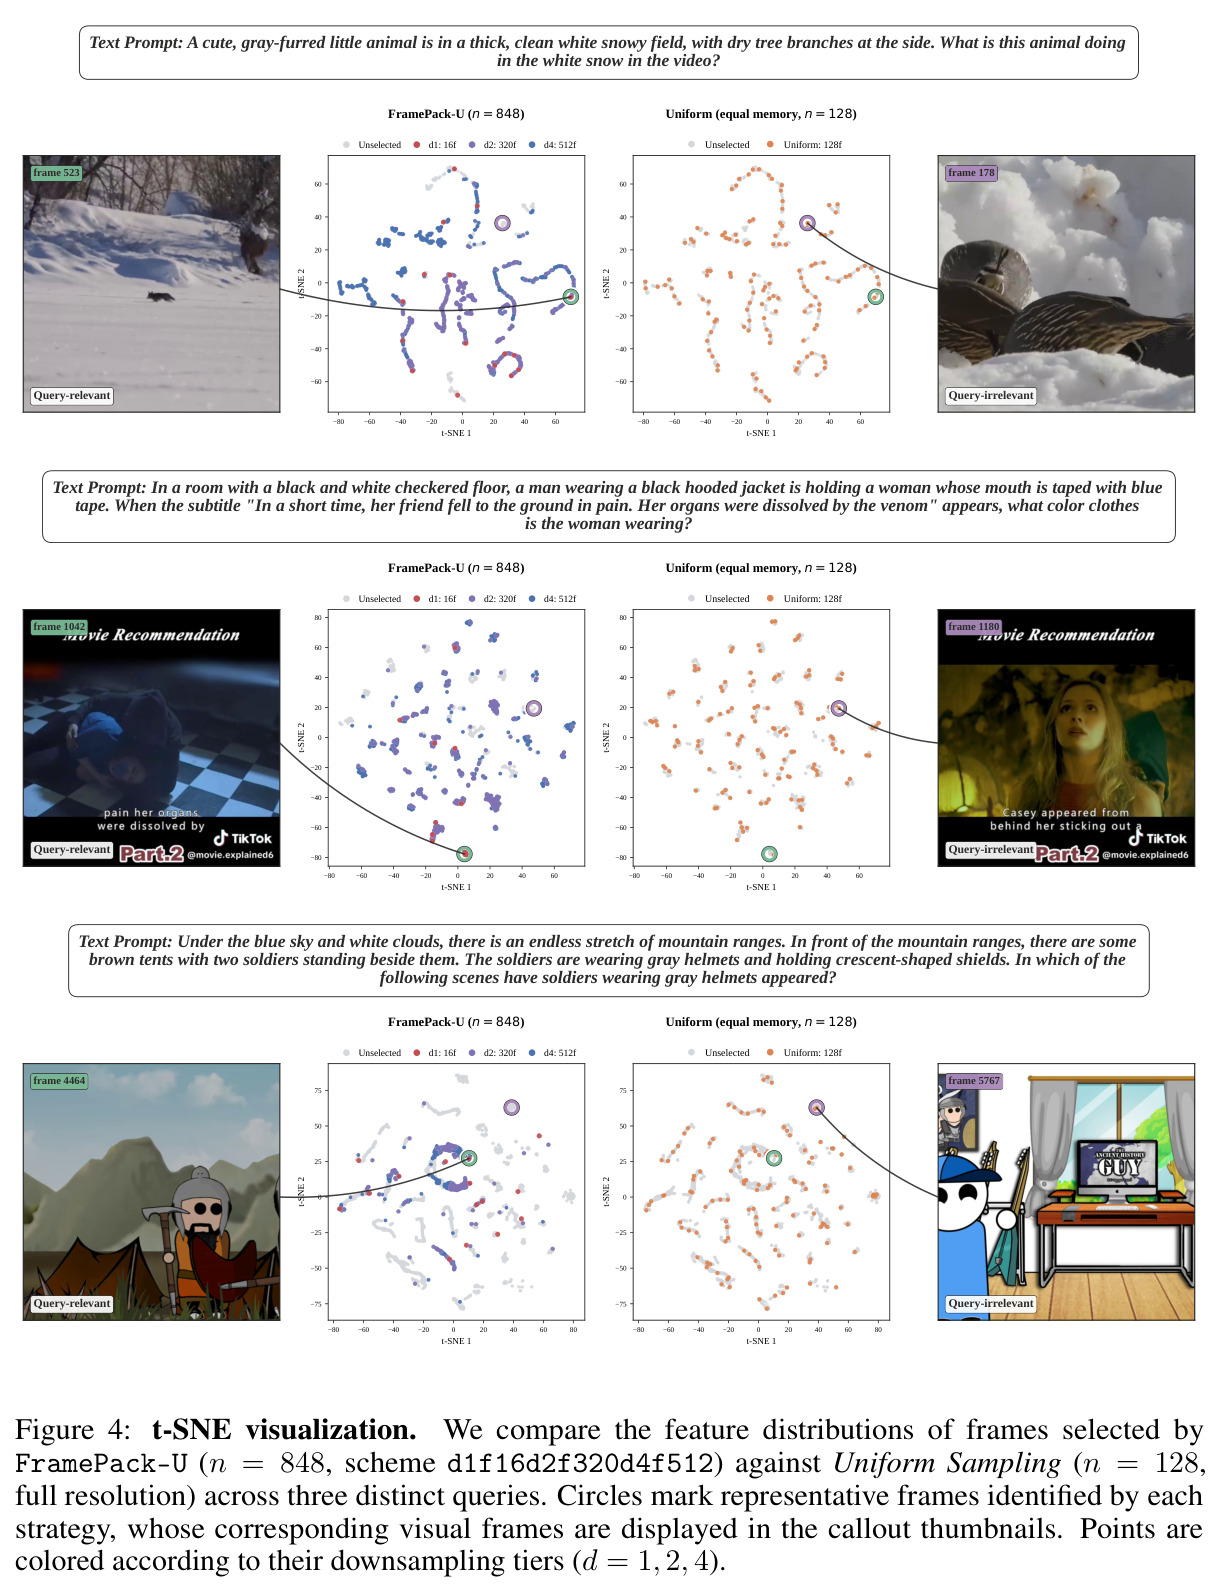
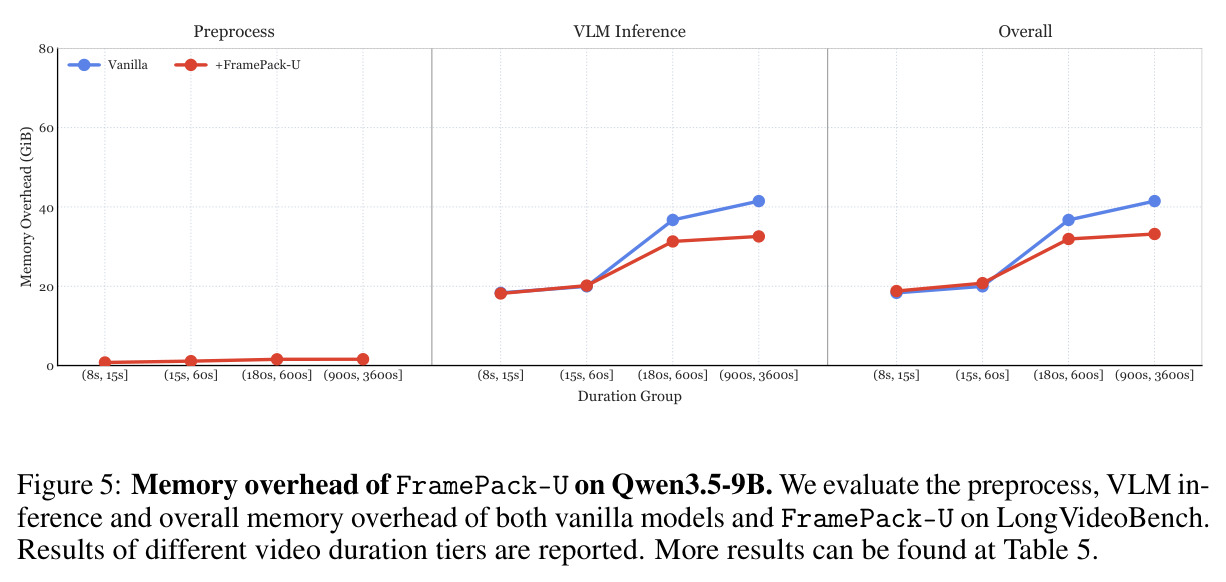
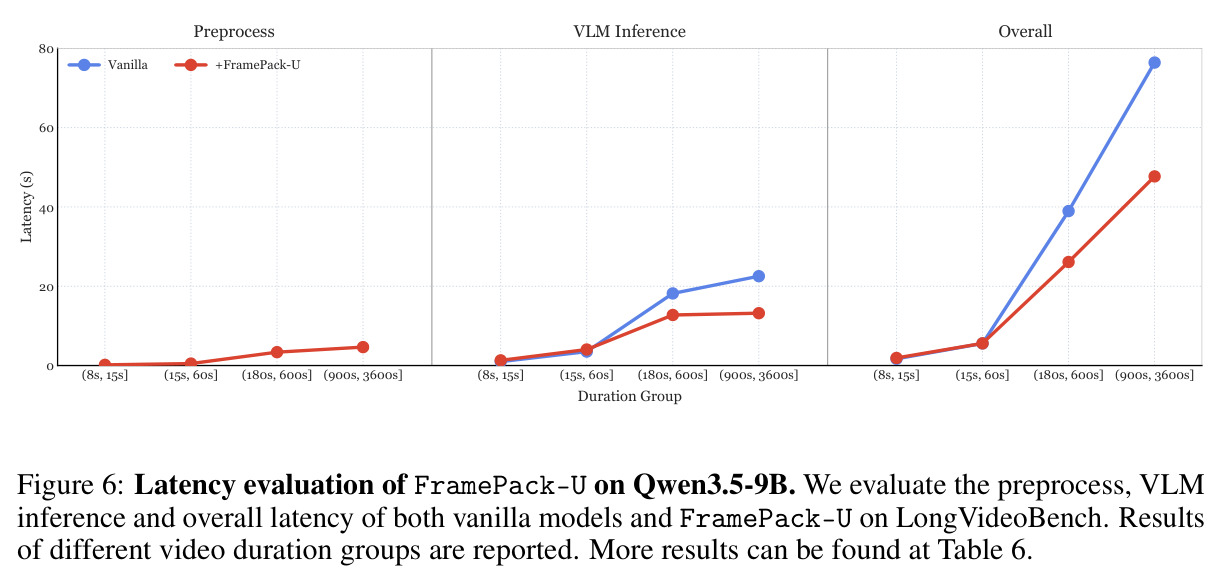
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| LongVideoBench(128帧预算, Qwen3.5-35B-A3B) | 总体准确率 | 72.3 | vanilla 均匀采样 59.4 | +12.9 |
| MLVU(128帧预算, Qwen3.5-35B-A3B) | M-average 准确率 | 82.4 | vanilla 71.8 | +10.6 |
| Video-MME(128帧预算, Qwen3.5-35B-A3B) | 总体准确率 | 76.4 | vanilla 66.7 | +9.7 |
| LongVideoBench(128帧预算, Qwen3.6-27B) | 总体准确率 | 74.4 | vanilla 68.0;FastVID 59.9;VisionZip 57.7 | +6.4(较最强基线 FastVID +14.5) |
| MLVU(512帧预算, Qwen3.6-27B) | M-average 准确率 | 82.1 | vanilla 78.0;FrameFusion 70.5 | +4.1 |
| 端到端延迟(3600s视频, Qwen3.5-9B) | 秒(越低越好) | 47.7s | vanilla 76.4s | -37.6% |
局限与改进
作者承认四点局限:(1) 增益依赖底层 VLM 能力,小模型(4B/9B)在大预算下不稳定甚至负增益,更多帧反而成为干扰;(2) 仅适用于逐帧独立编码的 VLM,对 Eagle2.5 类网格化/紧耦合视频编码器,改动单帧分辨率会破坏输入格式、需要改动视觉编码器;(3) CLIP 相似度只是轻量代理,难以捕捉细粒度时序事件、微妙交互和需推理的线索,可能低估关键帧;多样性基于视觉特征相似度,也不完全等于语义互补;(4) scheme 选择是超参数,最优分配随模型/基准/视频域变化。我的补充观察:(5) 打分与查询绑定,多轮对话换一个问题就要重新 pack,缓存策略未讨论;(6) 评估全是选择题基准,开放式生成与幻觉率未测,降采样帧可能诱发细节幻觉;(7) 512 帧预算下 d2 层多至 1536 帧,候选帧几乎全保留,此时方法退化为'全员降采样',增益更依赖排序质量;(8) fps=1 抽帧的 I/O 开销在 27B 对照中已显露,端到端收益对读盘速度敏感。
独立分析的弱点
独立分析的弱点:(1) 相关性打分是单帧-查询的静态匹配,对时序性问题('打电话之后发生了什么')天然弱——CLIP 看不出动作顺序,改进方向:引入轻量时序感知检索模型或结合字幕/ASR 信号打分。(2) 贪心多样性采样的复杂度约 $O(N \times T)$,3600s 视频+大 $N$ 时预处理随长度线性增长(Table 6 中预处理延迟从 15s 的 0.18s 涨到 3600s 的 4.7s),改进方向:先对帧特征做聚类、再在簇内选代表,把复杂度降到亚线性。(3) 分辨率层级只有人工设定的 2-3 档(d1/d2/d4),改进方向:按 $r_i$ 或信息熵连续分配 $d$,甚至学一个小网络预测 per-frame 预算,实现自适应 scheme(与作者展望一致)。(4) 高分辨率层集中奖励排序靠前的少数帧,当答案证据分散在多处时会互相挤占,可考虑按时间窗配额约束每个区间的最高分辨率名额。(5) 只在 2 个 Qwen 系骨干上验证,对 LLaVA-OneVision、InternVL 等其他家族的泛化性待证。
未来方向
作者提出的方向:更强的查询-帧打分函数或轻量时序感知相关性模型(保持 training-free 性质);根据视频长度、查询类型、模型容量自动选择 packing scheme 的自适应策略;适配网格化/紧耦合视频编码器架构。基于成果可延伸:(1) 与流式内存库结合,实现真正在线的长视频对话——新帧按当前对话状态动态入包或降级分辨率,历史上已被压低的帧可在相关新问题出现时被重新提升;(2) 把 CLIP 分数替换为 VLM 自身浅层 attention 或检索器分数,形成 self-guided packing,避免外部模型的域差距;(3) 与 LLM 侧 KV cache 压缩正交,可叠加使用:视觉 token 入口用 FramePack-U,语言侧再套 StreamingLLM 类方法;(4) 训练感知扩展:用打包后的异构分辨率数据微调 VLM,让模型显式学会利用混合分辨率帧,可能修复小模型上不稳定的增益;(5) 迁移到同样面临 $O(n)$ 视觉 token 的场景:长 PDF 多页文档、监控多路流、GUI 智能体的长轨迹历史。
复现评估
复现评估:代码、数据已开源——GitHub 仓库 ZelD0n/framepack-U2026,HuggingFace 与 ModelScope 数据集 ZelD0n/FramePack-U,项目页 zeld0n.github.io/framepack-U。论文给出完整 Algorithm 1 与全部关键超参($\lambda=0.7$、CLIP-ViT-B/32、fps=1.0),以及各预算的具体 scheme(128 帧 d1f16d2f448/d1f32d2f384,256 帧 d1f250d4f96/d1f64d2f768,512 帧 d1f128d2f1536/d1f384d2f512),三个基准均公开。算力门槛主要在骨干:主结果用 27B/35B 模型,论文自己在单张 A800 上都受显存限制、把 27B vanilla 封顶 224 帧,复现完整主表需 80GB 级显存并跑三基准×两骨干×三预算×多基线;但验证方法本体很轻——CLIP 打分加 resize 在消费级 GPU 即可完成,用 4B/9B 模型就能快速复现核心结论。总体:验证思想难度低,全量复现主表难度中高。
论文图表