重新思考长视频效率:帧数、像素与前端延迟的联合分配视角 Rethinking Long-Video Efficiency: A Joint Allocation Perspective on Frames, Pixels, and Front-End Latency
把长视频VLM效率重构为帧数、分辨率与解码延迟的联合分配,提出免训练双流框架LoHi
前置知识
视觉 token 预算
VLM 把每帧图像经视觉编码器切成 patch 并映射为 token,帧数与每帧 token 数的乘积构成视觉输入总量。长视频下这一总量受上下文长度与注意力平方复杂度限制,因此所有高效方法都在约束 $N\cdot\tau(r)\le B$ 下取舍:帧多则每帧 token 少,分辨率高则每帧 token 多。
全文的核心权衡(帧数 vs 分辨率)就是在这个预算等式内做分配,LoHi 的双流分解本质上是对同一个 $B$ 的重新切分。
GoP 与 I/P/B 帧
现代视频编解码器把帧组织成图像组(GoP):I 帧自包含、可独立解码,通常标记剧烈运动或场景突变;P/B 帧只存相对前帧(及后帧)的运动残差,必须先解 I 帧再顺序解码整条链。跳到 GoP 内深度 $d$ 处的 P 帧需要依次解出之前的所有帧,随机访问代价高。
L3 的解码延迟公式 $T_{dec}\approx G\cdot t_I+\sum_k d_k t_P$ 和 Anchor 选择器(把 I 帧索引当免费语义信号)都建立在这一编解码原理上。
行列式点过程(DPP)
一种子集选择概率模型:核矩阵 $L$ 的对角线编码每个元素的质量分 $q_j$,非对角线编码两两相似度,子集 $S$ 的得分 $\det(L_S)$ 在元素互相冗余时急剧变小。质量-相似度分解 $L_{ij}=q_iq_j\,e_i^\top e_j$ 让『相关且互异』的子集得分最高;正则化 log-行列式目标是单调次模的,贪心算法有 $(1-1/e)$ 近优保证。
LoHi-SemDiv 用 DPP 从 128 帧里选 8 张既与查询相关又互不冗余的高分辨率帧,是三个选择器中效果最好的一个。
TTFT 与前端延迟
TTFT(Time-to-First-Token)是从提交请求到模型吐出第一个 token 的墙钟时间,包含视频解码、预处理、视觉编码和预填充全过程。前端延迟指其中解码与预处理部分:decode-then-select 方法要先稠密解码候选池,这部分随视频时长线性增长,在小时级视频上可超过 VLM 推理本身。
论文的核心批判就是以往工作只报告 token 预算而系统性忽略前端延迟,Table 5 的效率对比全部围绕 TTFT 及其分解展开。
mRoPE 与双输入通路
Qwen-VL 系等统一视频-图像模型共享同一个视觉塔但有两套位置编码:视频通路用 3D 多模态旋转位置编码(mRoPE),给每帧全局一致的时间坐标,保住运动节奏;图像通路把每张图当作独立的 2D 图编码,不占用视频时间轴。
LoHi 正是把低分辨率流路由到视频通路、高分辨率图路由到图像通路,才做到一条流保时间覆盖、另一条补空间细节而互不干扰。
CLIP 特征与查询相关性
CLIP 把图像和文本映射到同一嵌入空间,可直接计算余弦相似度。对每个候选帧算 $\rho_j=\cos(\mathrm{CLIP}_{txt}(Q),e_j)$ 就得到『这帧与问题有多相关』的零训练打分,再经 min-max 归一化和幂锐化($\alpha=5$)变成 DPP 的质量分。
SemDiv 的质量项就用这个分数,理解它才能看懂 Hi-I 选择如何把有限预算花在与查询最相关的帧上。
研究动机
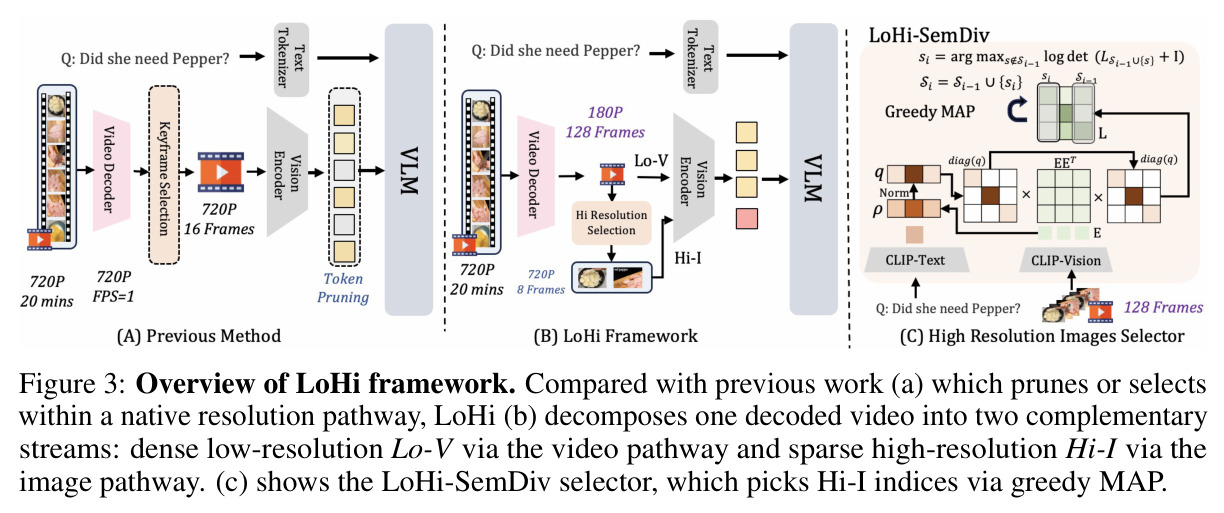
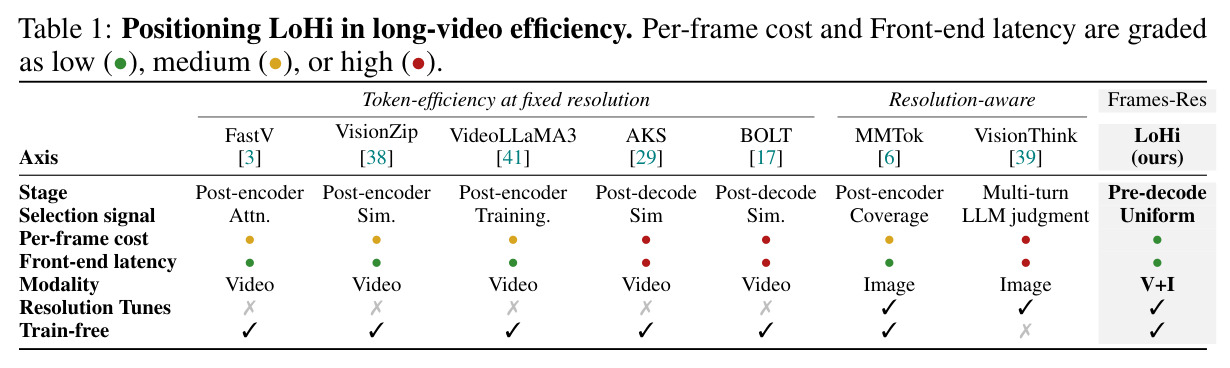
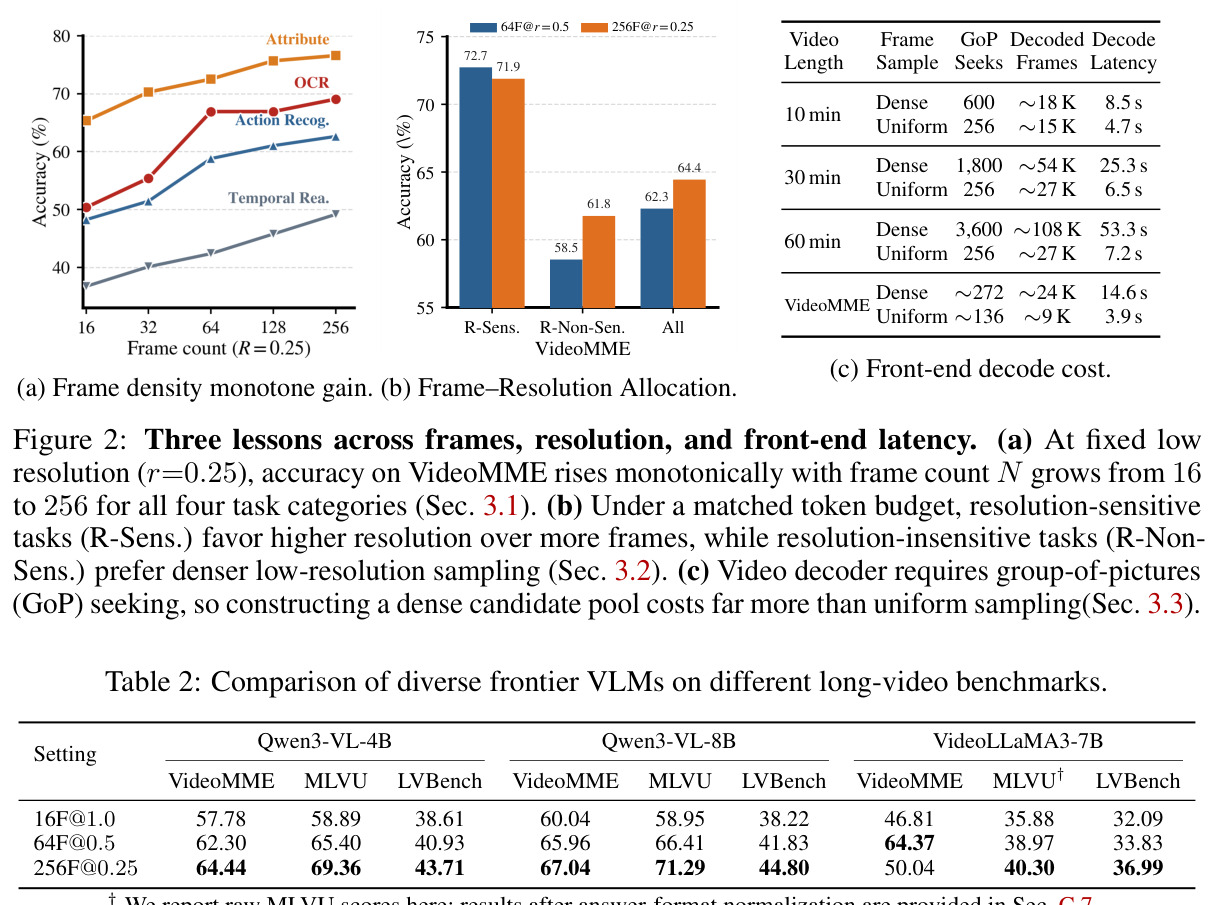
现有高效长视频方法几乎都把效率问题窄化为『固定原生分辨率下的信息 token 选择』:要么在编码前选帧(AKS 按查询-帧相似度划分时间线、BOLT 用逆变换采样),要么在编码后剪视觉 token(VisionZip、FlashVid),默认每帧必须以原生分辨率进入模型。这个框架浪费了两个关键自由度:其一,每帧分辨率本身可以拿来换更密的时间覆盖,但没人这样做;其二,前端解码延迟随候选池线性增长却几乎无人计入。实测数据很能说明问题:Qwen3-VL-4B 默认 16F@1.0 配方(约 5,760 token 预算)在 VideoMME 只有 57.78%、MLVU 58.89%、LVBench 38.61%;而关键帧选择类方法需要先按 FPS=1 稠密解码候选池,60 分钟视频要解约 108,000 帧、耗时 53.3 秒,是均匀采样 256 帧(27,000 帧、7.2 秒)的 7.4 倍——前端解码反而成了端到端墙钟时间的大头。
本文的目标是本文的目标是把长视频 VLM 效率从单维的 token 选择提升为三维联合分配问题:在固定视觉 token 预算 $N\cdot\tau(r)\le B$ 与解码预算 $N_{dec}$ 的双重约束下,同时决定帧数 $N$(时间覆盖)、每帧分辨率 $r$(空间细节)和前端解码量。具体而言,作者想要一个免训练、单次前向的框架,能同时服务分辨率敏感任务(OCR、属性感知,需要高清帧)和分辨率不敏感任务(动作识别、时序推理,需要密集覆盖),在 VideoMME、MLVU、LVBench 三个长视频基准上超越原生分辨率基线和最强先验效率方法,并保证前端解码量不随视频时长增长——即把小时级视频上与时长成正比的解码压到常数上界。
与已有工作不同的是,独特切入在于先做受控实证、再由教训导出设计。作者系统扫过 $(N,r)$ 配置空间((16,1)、(64,0.5)、(256,0.25) 在约 5,760 token 预算下),横跨 Qwen3-VL-4B/8B、VideoLLaMA3-7B 等多个 VLM,提炼出三条教训:L1 密集低分辨率采样是新配方(256F@0.25 在 MLVU 上 +10.47%);L2 最优分配是任务相关的,没有任何单一 $(N,r)$ 能两全(分辨率敏感子集偏好 64F@0.5 的 72.73%,不敏感子集偏好 256F@0.25 的 61.76%);L3 前端解码在长视频上占主导。据此提出跨分辨率分解:与 Q-frame 的逐帧动态分辨率、VisionThink 的多轮自回归判断不同,LoHi 不在推理中做任何逐帧分辨率决策,而是固定低分辨率流保覆盖、稀疏高分辨率流补细节,并把解码池上界从 256 压到 128。
核心方法
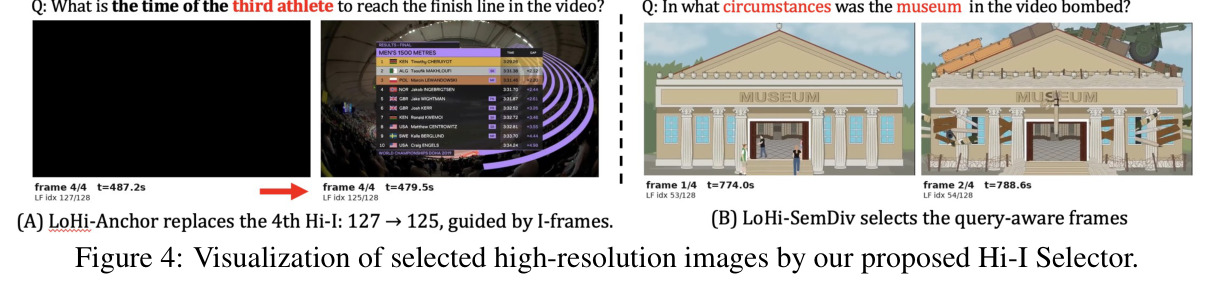
LoHi 的直觉是:长视频理解中『看得全』和『看得清』是两种正交需求,用一条固定分辨率的流同时满足必然顾此失彼。技术路线是把单一配置 $(N,r)$ 分解成共享同一预算的双流:$N=128$ 帧低分辨率视频流($r_\ell=0.25$)走 VLM 原生视频通路,靠 3D mRoPE 保留全局时间结构;$K=8$ 张高分辨率图像($r_h=1.0$)从同一 Lo-V 网格中选出、走图像通路独立做 2D 位置编码。两流满足 $N\cdot\tau(r_\ell)+K\cdot\tau(r_h)\le B$,总 token 与基线完全相同;每帧只解码一次($N_{dec}=N=128$),同时供给两个分辨率,解码量只有基线(256 帧)的一半。两流之间用一句自然语言标记桥接:低分辨率视频提供时间上下文,随后的 K 张高分辨率图是关键帧。整个框架免训练、单次前向,Hi-I 选择器可插拔:Uniform(等间隔索引,零开销)、Anchor(利用编解码器 I 帧元数据)、SemDiv(DPP 多样性选择),另有一个熵触发的自适应变体,简单问题只用 Lo-V 回答。
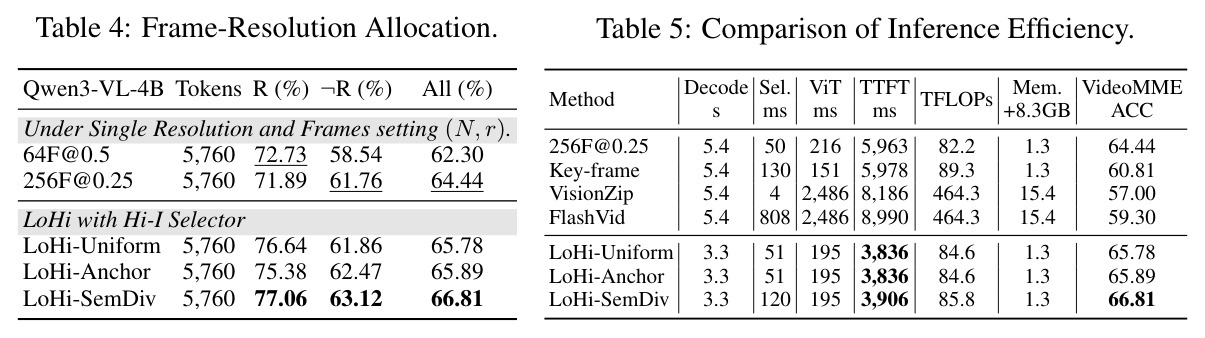
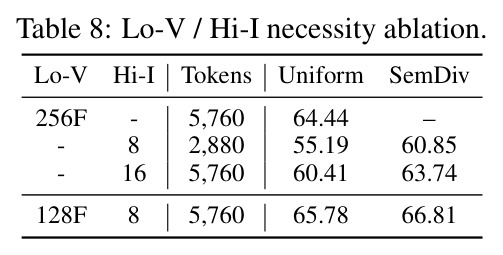
核心创新是跨分辨率分解:把 $N\cdot\tau(r)\le B$ 的单点操作拆成两个互补工作点,让同一份预算同时喂饱两类任务。Table 8 直接证明互补性:5,760 token 预算下,只用 256 帧低分辨率视频(Lo-V)得 64.44%,只用 16 张高分辨率图(SemDiv)得 63.74%,而 128 帧 Lo-V 加 8 张 Hi-I 达 66.81%——两种证据不可互相替代。与已有方法的本质区别有三:对关键帧选择(AKS、BOLT),解码池从 256 降到 128 且选择阶段几乎不解码像素,避开 GoP 顺序解码的高昂代价;对 token 剪枝(VisionZip、FlashVid),不在原生分辨率上先编码再丢弃 93.75% 的 token,ViT 延迟从 2,486 ms 降到 195 ms(约 12 倍);对 MMTok 的 DPP 子集选择,把它从单图像 token 级提升到跨分辨率流帧级——时间覆盖已由 Lo-V 承担,Hi-I 只需追求互多样性与查询相关性。Anchor 还复用了编解码器 I 帧边界这一免费语义信号。
方法步骤详情
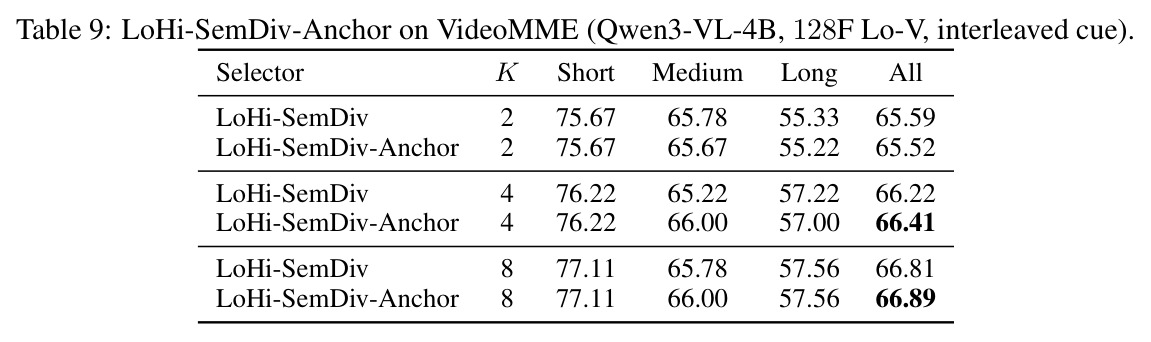
流程五步。(1) 解码:均匀取 $N=128$ 个网格位置,每帧只解一次原生分辨率,解码量与时长无关。(2) 构建 Lo-V:128 帧缩放到 $r_\ell=0.25$ 拼成低分辨率视频,经视频通路编码,mRoPE 赋予全局时间位置。(3) 选 K=8 张 Hi-I:Uniform 等间隔取,零计算;Anchor 只读预计算 I 帧索引,为每个等间隔位置找最近 I 帧再取网格中最接近帧;SemDiv 用 CLIP 算查询-帧相关性 $\rho_j$,归一化并幂锐化($\alpha=5$)成质量分 $q_j$,构建 DPP 核 $L=\mathrm{diag}(q)EE^\top\mathrm{diag}(q)$,贪心最大化 $\log\det(L_S+I)$。(4) 桥接与推理:K 张高分辨率图走图像通路独立 2D 编码,与视频流间插入文本标记说明其为所选关键帧,单次前向出答案。(5) 可选熵触发:先只用 Lo-V 生成并算分布熵 $H(p_{\text{Lo-V}})$,超阈值 $\theta$ 才触发 Hi-I 重答,实测仅约 1/3 查询启用高分辨率流即接近全量性能。
技术新颖性
新颖性体现在四层面。第一,问题重构:首次把前端解码延迟纳入长视频效率的形式化分析,用 $T_{dec}\approx G\cdot t_I+\sum_{k=1}^{K}d_k\cdot t_P$ 刻画 GoP 内严格顺序解码的代价,定量指出 decode-then-select 管线的墙钟时间随时长线性恶化(60 分钟视频 53.3 秒 vs 均匀采样 7.2 秒),这是以往只报告 token 预算的工作系统性忽略的。第二,实证方法学:受控扫描 $(N,r)$ 空间并按分辨率敏感性拆分基准子集,给出可复用的『密集低分辨率是新基线』结论。第三,工程巧思:Anchor 复用 I 帧元数据作零成本语义信号;SemDiv 把 DPP 从 token 级剪枝提升到跨流帧级选择,配合单次前向双通路路由。第四,架构级自适应:熵触发早退把双流结构变成按问题难度分配计算的机制。与 Q-frame、VisionThink、MMTok 等分辨率感知方法相比,LoHi 无需逐帧分辨率决策或多轮判断,推理路径严格单遍。
实验结果
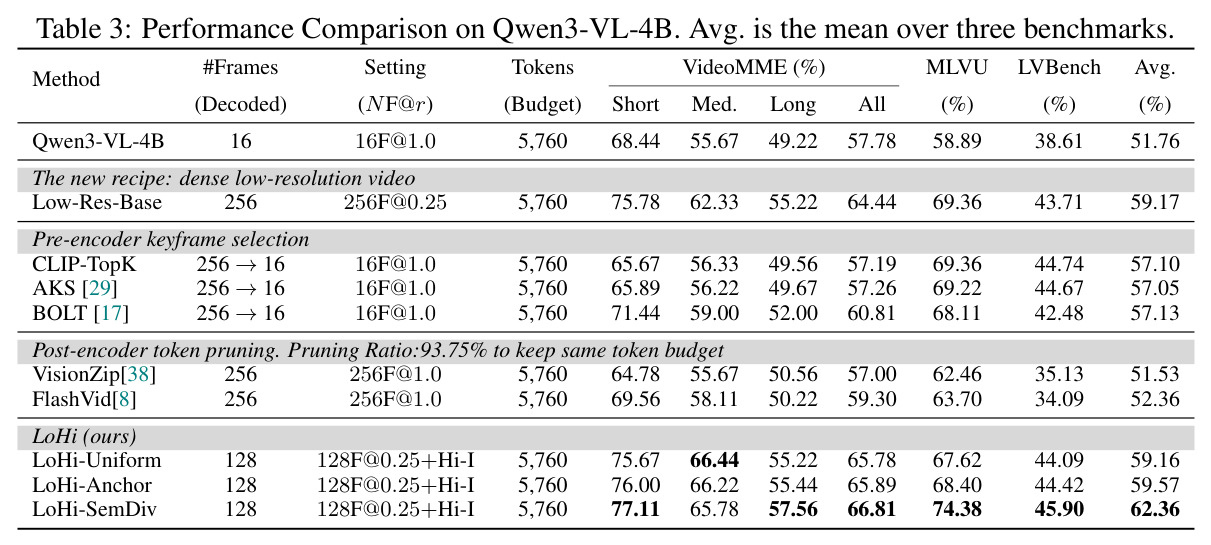
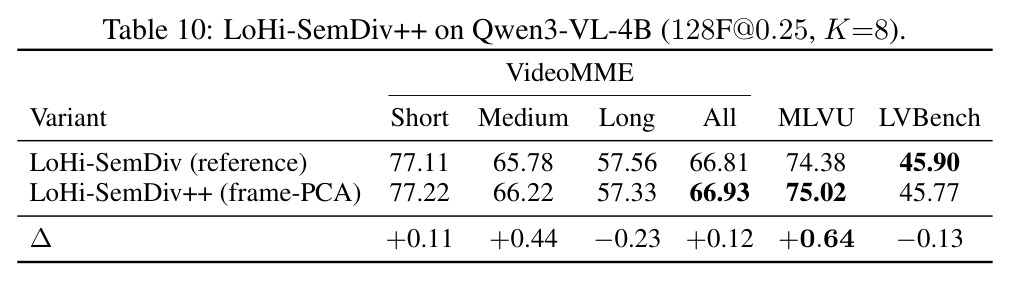
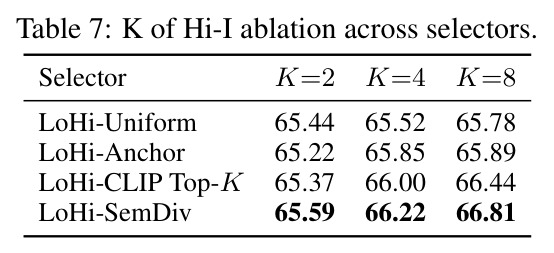
主结果(Table 3,Qwen3-VL-4B、5,760 token 预算):LoHi-SemDiv 在 VideoMME/MLVU/LVBench 达 66.81/74.38/45.90%,平均 62.36%,比原生基线(51.76%)高 +10.60%,比最强先验的 BOLT(57.13%)高 +5.23%。三变体在 R/¬R 子集同时最优(Table 4:77.06%/63.12%),单一配置只能顾一头。效率(Table 5):解码仅 128 帧、3.3 秒(基线 5.4 秒),ViT 延迟 195 ms(剪枝 2,486 ms,约 12 倍),TTFT 3,906 ms(FlashVid 8,990 ms),小时级视频解码延迟最高降 7 倍。Table 6:50% 预算下朴素缩放(56.20%)胜过 MMTok(52.89%)与 VisionZip(49.65%),剪枝范式存在根本低效。消融(Table 7):12 种配置全落 65.22–66.81%,均超纯 Lo-V 的 63.00%;EgoLongQA 上少 29% token 追平更高分辨率基线。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 长视频问答(三基准平均,Qwen3-VL-4B) | 平均准确率 (%) | 62.36 (LoHi-SemDiv) | 51.76 (16F@1.0 原生基线) | +10.60 |
| 长视频问答(对比最强先验效率方法) | 平均准确率 (%) | 62.36 (LoHi-SemDiv) | 57.13 (BOLT) | +5.23 |
| VideoMME (无字幕) | 准确率 (%) | 66.81 | 60.81 (BOLT) | +6.00 |
| MLVU | 准确率 (%) | 74.38 | 69.36 (CLIP-TopK / Low-Res-Base) | +5.02 |
| LVBench | 准确率 (%) | 45.90 | 44.74 (CLIP-TopK) | +1.16 |
| 前端视频解码 (VideoMME) | 解码延迟 | 3.3 s (128 帧) | 5.4 s (256 帧) | 约 1.6×;小时级视频最高 7× |
| 视觉塔编码 (对比 token 剪枝) | ViT 延迟 / 计算量 | 195 ms / 1.3 TFLOPs | 2,486 ms / 15.4 TFLOPs (FlashVid) | 约 12× |
| 端到端首 token 延迟 (VideoMME) | TTFT (ms) | 3,906 | 8,990 (FlashVid) | 约 2.3× |
局限与改进
作者承认的局限较少,主要藏在附录:方法依赖模型具有统一的视频-图像双输入通路(Qwen-VL 系),对只有单一视频通路的架构需要另行适配;自适应变体引入熵阈值 $\theta$ 这一新超参,且难查询要走两次生成路径。我的补充观察:(1) 三个基准都是多选题 QA,对开放生成、时序定位、长视频摘要等任务的增益未验证;(2) SemDiv 的查询相关性完全依赖 CLIP 文本-帧对齐,在 CLIP 域外视频(医学影像、监控、无人机)上质量分可能失真,DPP 的去冗余机制还可能错误踢掉真实但相似的变化帧;(3) $N=128, r_\ell=0.25, K=8$ 是在 5,760 token 预算下调出的工作点,其他预算下的最优分配比例未系统给出;(4) I 帧≈场景边界的假设在长镜头、缓慢渐变的视频上会退化,Anchor 可能选到无信息帧;(5) Hi-I 只能从 Lo-V 网格里选,若决定性瞬间落在网格间隙(约间隔视频时长/128),高分辨率也救不回来;(6) 延迟测试的具体硬件配置正文未明确,跨硬件复现会有数值出入。
独立分析的弱点
独立分析三个具体弱点。其一,Hi-I 候选被限制在 128 帧的 Lo-V 网格内:网格间隔约为视频时长除以 128,一小时视频意味着每 28 秒才有一个候选位置,快速闪过的细节(如一闪而过的字幕)可能根本不在候选里,此时再高的分辨率也无济于事——改进方向是在解码预算内做两阶段采样,先粗网格、再在 SemDiv 得分高的邻域局部加密。其二,DPP 目标只建模查询相关性与视觉多样性,不感知时间结构:对『事件先后顺序』类问题,两个视觉相似但位于不同时刻的帧会被判为冗余而只保留一个,恰好丢掉时序推理需要的状态变化对——改进方向是在核 $L$ 中加入时间距离项,或按 GoP 分段保证多样性覆盖各时段。其三,熵触发用生成分布的熵作为不确定性代理,但多选题选项熵和开放生成的 token 熵语义并不等价,模型过度自信时熵低但答案仍错,会错误地跳过 Hi-I——改进方向是换用语义熵或自一致性采样(多次采样看答案一致性)作为触发信号。此外,文本标记桥接对位置的表达很弱,Hi-I 的时间戳只能靠模型从内容推断,可显式注入时间戳文本。
未来方向
作者提出的方向是更丰富的选择器和自适应分配。在此基础上有几条自然的延伸:第一,把联合分配写成显式约束优化——给定视频时长、任务先验和硬件档位,在线求解最优的 $(N, r_\ell, K, r_h)$,让分配随预算伸缩,而不是固定 128/0.25/8;第二,训练原生支持双流输入的 VLM:目前 Lo-V 和 Hi-I 只靠 prompt 桥接,若在预训练中引入跨流注意力或给 Hi-I 注入时间戳位置编码,两流融合会更紧密;第三,与流式推理结合:Lo-V 常驻、Hi-I 由事件触发(例如新 I 帧到达或检测到场景切换),把框架推向无界长的监控/直播场景;第四,熵触发升级为任务感知的不确定性估计(语义熵、self-consistency),并把触发决策蒸馏成轻量分类器以省掉首次生成;第五,把 L1–L3 三条教训推广到同构问题——长 PDF 多页理解、高分辨率遥感切片、医疗影像序列,凡是『单元密度 vs 单元细节』的权衡都可以套用跨分辨率分解;第六,系统层面把视频解码与 ViT 编码流水线并行,进一步压缩已占大头的 TTFT。
复现评估
复现条件相当友好:方法免训练、单次前向,主实验全用公开模型(Qwen3-VL-4B/8B、VideoLLaMA3-7B 等)与公开基准(VideoMME、MLVU、LVBench、EgoLongQA),有项目主页(sixundong.com/projects/lohi)。实测显存约 9.6 GB、ViT 计算量 1.3 TFLOPs,单张工作站级显卡(4090/A100)即可复现主表,数百 GPU 时可跑完全部基准与消融。工程量集中在三处:视频解码管线需严格实现 $N_{dec}\le 256$ 上限与均匀网格采样;SemDiv 需 CLIP 特征提取加 DPP 贪心(约百行代码,$\alpha=5$ 已给出);基线对齐需跑 AKS、BOLT、MMTok、FlashVid、VisionZip 官方实现并统一 token 预算,这部分最易出偏差。延迟数字(3.3 s 解码、195 ms ViT、TTFT 3,906 ms)依赖具体 GPU 与存储 IO,正文未标注硬件型号,跨硬件会量级一致但数值有差。总体复现难度中等偏低,风险在基线复现而非方法本身。
论文图表
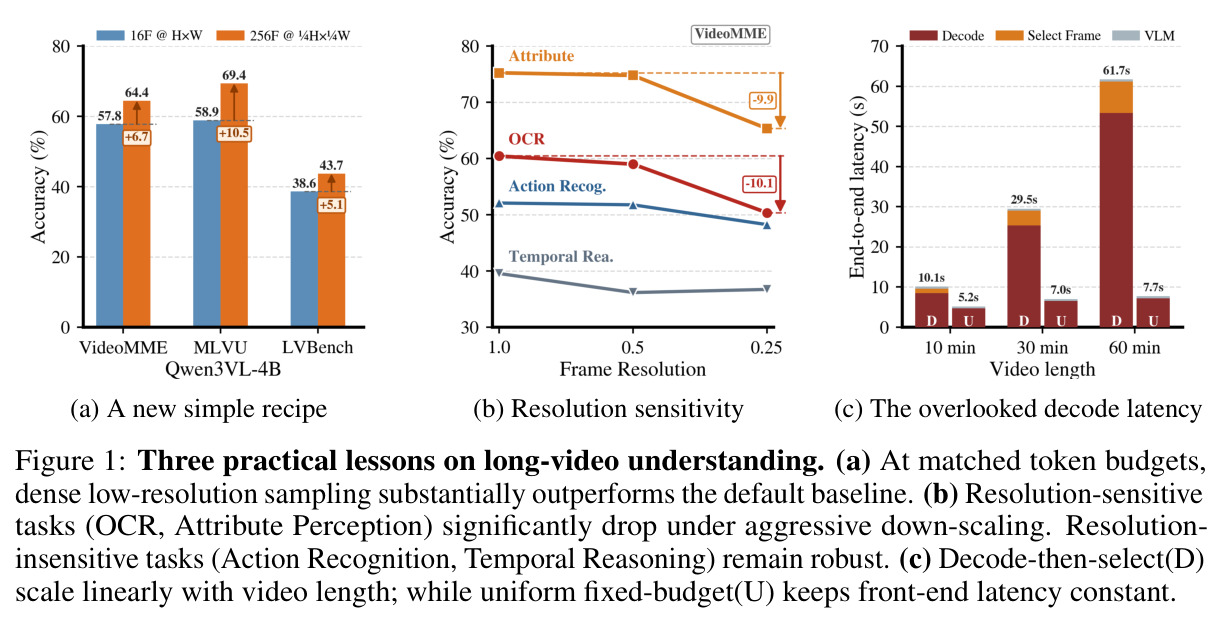
三联图,浓缩全文三条实证教训。(a) 新配方:匹配 token 预算下,密集低分辨率采样大幅超过默认原生分辨率基线;(b) 分辨率敏感性:OCR、属性感知等任务在激进降分辨率下显著掉分,而动作识别、时序推理保持稳健;(c) 被忽视的解码延迟:decode-then-select 管线的延迟随视频长度线性增长,而均匀固定预算采样保持常数。
一张图给出 L1/L2/L3 三条教训的直观证据,是全文动机的视觉总纲,看懂它就理解了论文为什么要做联合分配。
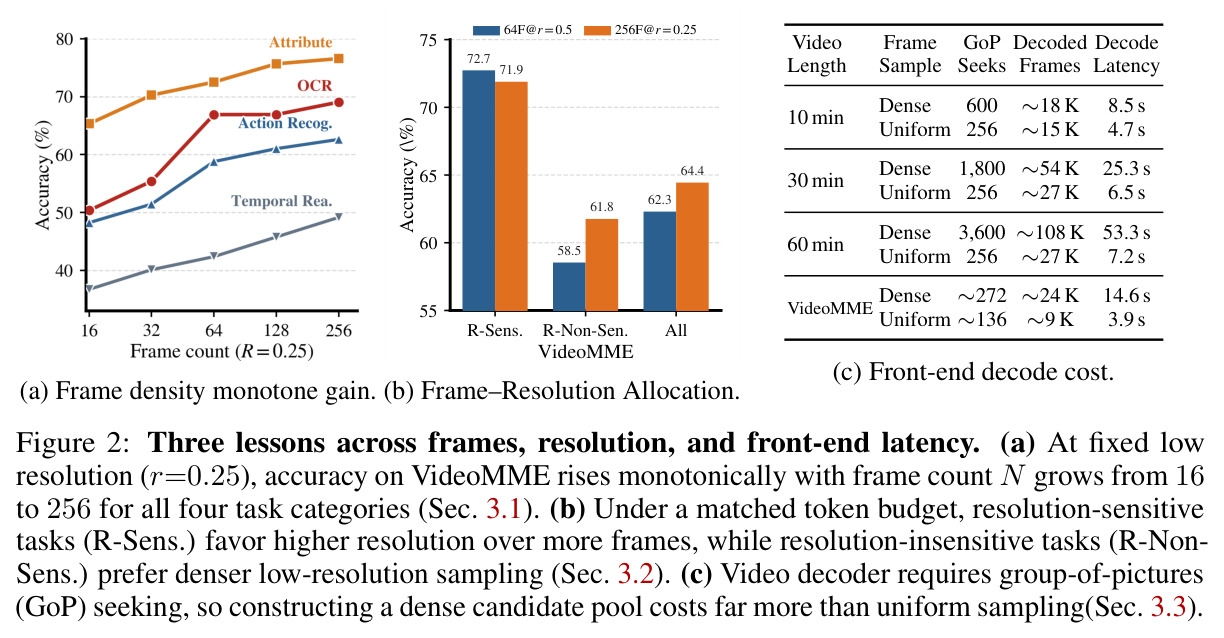
(a) 固定 r=0.25 时,VideoMME 各任务类别准确率随帧数 N 从 16 到 256 单调上升,验证帧数密度收益;(b) 匹配预算下分辨率敏感子集偏好 64F@0.5(72.73% vs 256F@0.25 的 71.89%),不敏感子集相反(58.54% vs 61.76%),两种配置互换优势;(c) 10/30/60 分钟视频上 FPS=1 稠密解码与均匀 256 帧采样的解码帧数与延迟对比,60 分钟处为 108K 帧 53.3 秒 vs 27K 帧 7.2 秒,差距 7.4 倍。
提供三条教训的定量曲线证据;尤其是 (c) 中解码延迟随时长发散的数据,是『前端延迟必须纳入效率分析』这一核心论点的关键支撑。