少即是多:以密集参考强化稀疏帧视频推理 Less from More: Reinforcing Sparse Video Reasoning from Dense References
训练时用密集帧当参考,让模型仅凭稀疏帧也能可靠定位与问答
前置知识
时序定位(Temporal Grounding)与 tIoU
任务是在未剪辑长视频中,根据一句自然语言查询预测目标事件发生的起止时间区间 $\hat\tau = (\hat t_s, \hat t_e)$。核心指标 tIoU(temporal IoU)是预测区间与真值区间 $\tau^\star$ 的交并比,多个样本取均值即 mIoU;训练时常再叠加起止时间戳误差除以视频时长的边界惩罚项,给出更稠密的反馈信号。
SAVER 把时序定位当作唯一的训练任务和奖励来源,用 1,250 条定位样本完成全部后训练。不理解 tIoU 和定位监督,就无法理解其奖励设计、参考奖励为何定义在区间上,以及主实验为何先报定位再报 QA 迁移。
基于可验证奖励的强化后训练(RLVR / GRPO 风格)
不训练奖励模型,而是用规则直接给回复打分(如输出格式是否可解析、预测区间与真值的 tIoU)。GRPO 式做法对同一输入采样 $G$ 个回复,用组内奖励归一化计算优势,并用 KL 散度 $D_{KL}(\pi_\theta\|\pi_{ref})$ 约束策略不偏离参考策略,避免训练崩溃。
SAVER 的训练目标 $\max_\theta \mathbb{E}[R^d + \lambda_s R^s - \beta D_{KL}]$、$G=4$ 的 rollout 配对归一化、以及沿用 Time-R1 的强化配方,全部建立在这套范式上;不了解它就看不懂第 3.4 节的目标函数。
帧率采样与视觉 token 预算
视频多模态大模型按 fps 均匀抽帧,每帧经视觉编码器变成若干视觉 token 后拼进上下文。帧数随 fps 线性增长,token 数、显存占用和推理延迟也随之膨胀;降低 fps 则意味着时间分辨率下降,短暂事件可能整个落在采样缝隙里。
本文的效率-性能权衡全部围绕 fps 展开({0.1, 0.2, 0.5, 1, 2} fps,帧数上限 [4, 256]):2.0 fps 平均 139 帧对 0.1 fps 平均 38 帧,正是'密集假设昂贵'与'稀疏推理不可靠'这对矛盾的具体体现。
自蒸馏与特权信息学习
让模型在训练阶段获得推理时不具备的额外信息(特权信息),并把这一优势迁移到受限输入上。经典自蒸馏在同一输入分布下用自身(或更大模型)的输出作软标签;SAVER 则是跨输入视图的变体:密集视图是特权输入,稀疏视图对应真实推理条件,且对齐由奖励门控而非固定标签驱动。
论文在 3.4 节明确把 SAVER 与自蒸馏做对比:密集预测不是无条件伪标签,只有比稀疏预测更可靠时才作为参考。理解这一定位才能抓住其'可靠性门控'设计与普通蒸馏/SFT 的本质区别。
研究动机
视频-语言模型普遍遵循'密集输入假设':推理时喂的帧越多,推理越可靠。代价高昂——密集采样动辄几十到上百帧,视觉 token 预算、显存和延迟随帧数快速膨胀,在流媒体、移动助手、机器人、监控和长视频检索等算力受限场景难以落地。更麻烦的是,直接降低帧率会严重损伤性能:论文实测 Qwen3.5-2B 在三个时序定位基准上的平均 mIoU 从 2.0 fps 的 34.9% 跌到 0.1 fps 的 18.4%,4B 模型在 NExT-GQA 上 0.1 fps 时甚至只有 4.3%。已有高效化路线要么压缩视觉 token(MARC、STORM),要么自适应选关键帧(AKS、Q-Frame、VideoBrain),要么在语言侧削减冗余解码(VideoAuto-R1、Sparse-to-Dense),但它们都默认模型先拿到较丰富的视觉输入、再在管线里做'减法';当输入预算本身被固定在极低帧率时,这些方法无从发挥作用。
本文的目标是本文要回答一个明确的问题:给定一个被规定的低帧率输入预算(如 0.1 fps、平均仅 38 帧),视频模型能否通过后训练本身就变得可靠,而不依赖推理时的密集预扫描或自适应选帧?具体目标是提出稠密到稀疏(dense-to-sparse)的后训练框架 SAVER:训练时用同一视频的密集视图充当参考信号,强化稀疏视图的推理;推理时只用稀疏帧。论文还设置了苛刻的数据约束——仅用从 Time-R1 随机抽取的 1,250 条时序定位样本训练,完全不使用任何视频问答标注——以检验从定位任务学到的'证据保留'能力能否迁移到六个视频 QA 基准。最终希望 SAVER 在 Qwen3.5 的 0.8B/2B/4B 三个规模上、跨 0.1–2.0 fps 全部帧预算稳定超越基线,并用远少于密集推理的帧数逼近甚至超过密集帧性能。
与已有工作不同的是,本文的独特切入是把效率问题从'推理时做减法'翻转为'训练时做加法'。与在推理管线中节省计算的帧选择、token 压缩不同,SAVER 完全不改变推理协议:测试时只有统一稀疏采样的帧,没有密集预扫描、没有自适应选帧、没有测试时优化;密集视图只在训练阶段作为'脚手架'提供参考信号,训练完即丢弃。第二个独特之处是选时序定位作证据定位的代理任务:定位要求模型显式回答'事件发生在何时',天然监督模型保留任务相关的时序证据,而且这种监督无需昂贵的 QA 标注。第三,作者给出了稀疏风险分解的上界 $\mathbb{E}_{y\sim p_s}[\ell] \le \mathbb{E}_{y\sim p_d}[\ell] + D_{TV}(p_s, p_d)$,指出稀疏性能取决于密集预测质量与稀疏-密集分布差异两项,SAVER 的定位奖励与门控参考奖励恰好分别压缩这两项,方法设计有了理论直觉支撑。
核心方法
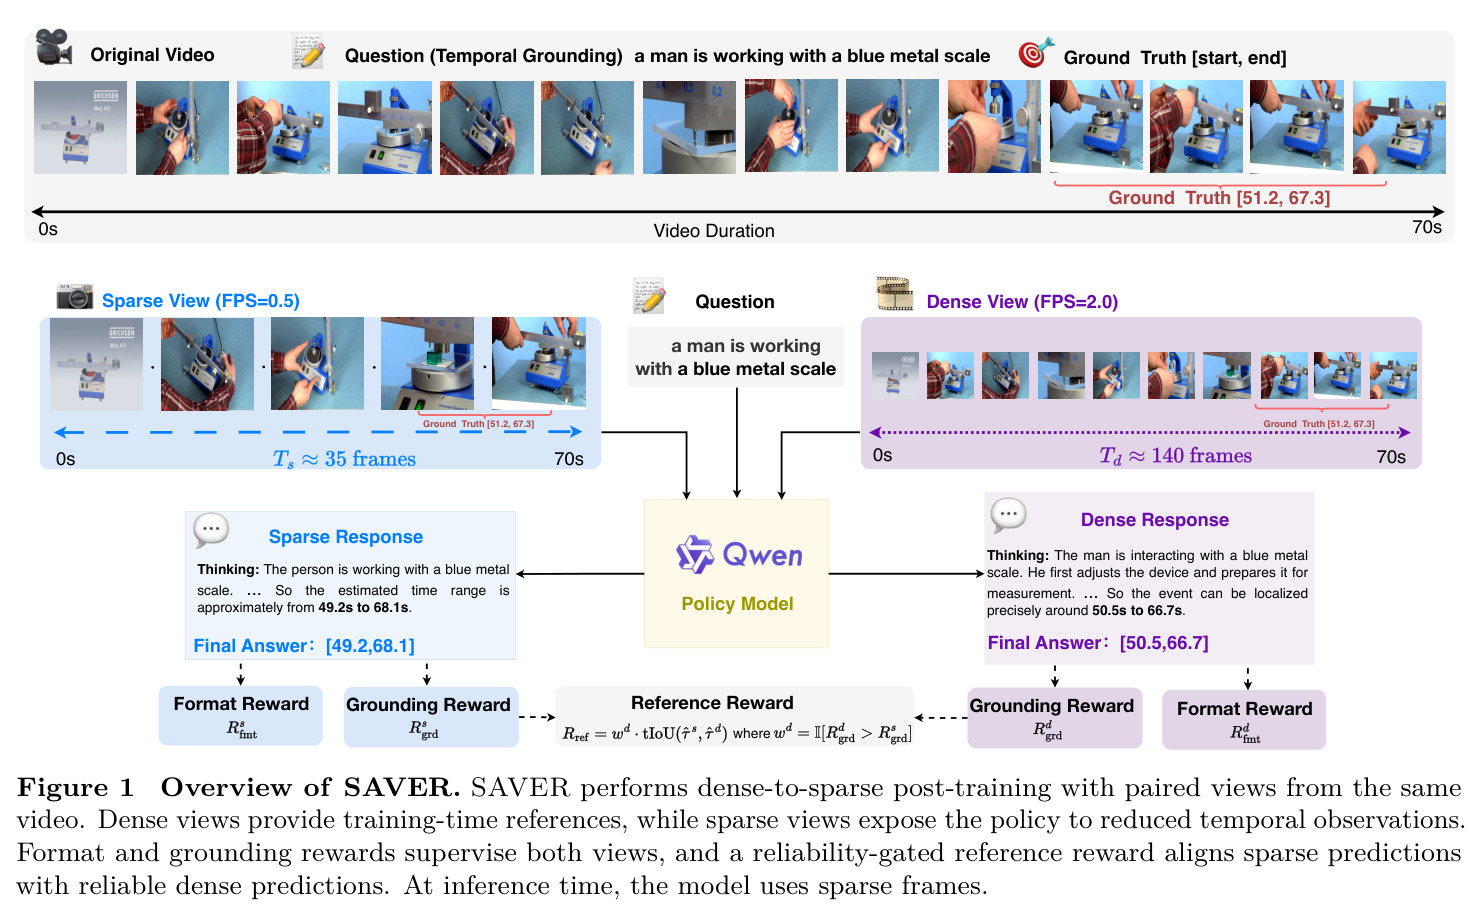
SAVER 的直觉很朴素:学生(稀疏视图)平时做题可以对照老师(密集视图)的答案,但考试(推理)只能靠自己。技术上,对每个训练视频 $V$,分别用稠密与稀疏采样函数构造两个视图 $V^d = S_d(V)$、$V^s = S_s(V)$,喂给同一个策略模型 $\pi_\theta$,各自生成预测时序区间的回复 $y^d$、$y^s$。随后用三类奖励联合优化:格式奖励 $R_{fmt}$ 保证输出含可解析的起止时间戳;定位奖励 $R_{grd} = tIoU(\hat\tau, \tau^\star) - \lambda_b(|\hat t_s - t^\star_s| + |\hat t_e - t^\star_e|)/T$ 用交并比加边界惩罚评估每个预测;可靠性门控的参考奖励 $R_{ref}$ 仅当密集视图定位奖励更高时,才鼓励稀疏预测与密集预测对齐。整体目标为 $\max_\theta \mathbb{E}[R^d + \lambda_s R^s - \beta D_{KL}]$,采用 GRPO 式 $G=4$ 组内优势归一化,训练数据仅 1,250 条 Time-R1 定位样本,推理时只用稀疏视图。
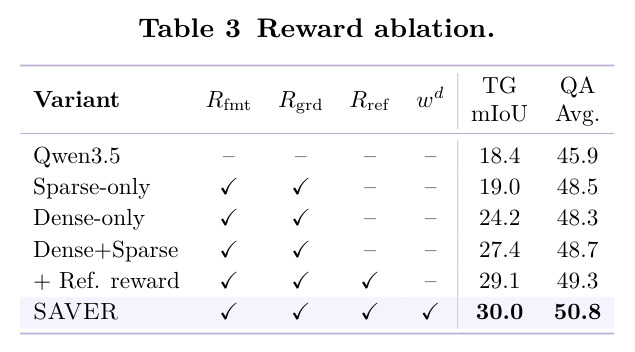
核心创新是'可靠性门控的跨视图参考奖励'。自蒸馏通常在同一输入分布下传递预测,SAVER 则是奖励引导的跨视图蒸馏:密集视图携带推理时不存在的特权时序信息,稀疏视图对应真实推理条件。关键设计是门控 $w_d = \mathbb{I}[R_{grd}(y^d, \tau^\star) > R_{grd}(y^s, \tau^\star)]$,参考奖励 $R_{ref} = w_d \cdot tIoU(\hat\tau^s, \hat\tau^d)$ 只在密集预测比稀疏预测更可靠时激活。这避免了稀疏预测盲目模仿劣质密集输出——密集预测不是无条件伪标签,而是相对质量更好的候选参考。与 SFT 式蒸馏不同,对齐发生在奖励空间而非标签空间,模型仍在强化学习中自由探索。消融数据支持这一设计:无门控参考奖励为 29.1 mIoU,加上门控升到 30.0;用真值区间替代密集参考只得 29.5,说明'仅向更好的单样本学习'的相对门控确实有效。
方法步骤详情
第一步,构造视图对:对训练视频 $V$ 以不同 fps 采样,得到稠密视图 $V^d = S_d(V)$ 与稀疏视图 $V^s = S_s(V)$。第二步,双视图前向:两者输入同一策略 $\pi_\theta$,各生成带思考过程与时序区间的回复,解析出 $\hat\tau^d = (\hat t^d_s, \hat t^d_e)$ 与 $\hat\tau^s$。第三步,计算基础奖励:对两个回复分别算格式奖励 $R_{fmt}$ 与定位奖励 $R_{grd} = tIoU(\hat\tau, \tau^\star) - \lambda_b(|\hat t_s - t^\star_s| + |\hat t_e - t^\star_e|)/T$。第四步,门控参考奖励:比较 $R_{grd}(y^d)$ 与 $R_{grd}(y^s)$,若前者更高,给稀疏回复加 $R_{ref} = tIoU(\hat\tau^s, \hat\tau^d)$,否则为零。第五步,联合优化:最大化 $R^d + \lambda_s R^s - \beta D_{KL}$($\lambda_s = 2.0$),$G=4$ 个 rollout 按索引配对并归一化优势;训练集为 1,250 条 Time-R1 样本,batch 为 64/64/128。第六步,推理只用稀疏视图:按给定 fps 采样后直接预测,无密集扫描、无选帧、无测试时优化。
技术新颖性
技术新颖性体现在四点。其一,问题设定新:现有高效视频方法(token 压缩的 MARC/STORM、选帧的 AKS/Q-Frame、检索的 VideoBrain、加速解码的 Sparse-to-Dense)都隐含'先见丰富输入再压缩',SAVER 研究固定低帧率预算下模型本身的可靠性,二者正交、可以叠加。其二,监督信号新:用 1,250 条纯定位样本做全部训练数据,不碰任何 QA 标注,却让六个 QA 基准平均提升(2B 模型 0.1 fps 下 45.9%→50.8%),证明定位是廉价的证据定位代理任务。其三,机制新:可靠性门控让密集参考只在相对更优时生效,表 3、表 4 的消融系统验证了双视图联合、参考奖励、门控三者的递进增益。其四,有理论直觉:稀疏风险被上界分解为密集预测误差加总变差距离 $D_{TV}(p_s, p_d)$,框架的两类奖励分别对应压缩这两项。与 Video-R1、VideoAuto-R1 等视频 RL 方法相比,双视图配对与跨视图门控奖励是 SAVER 独有的设计。
实验结果
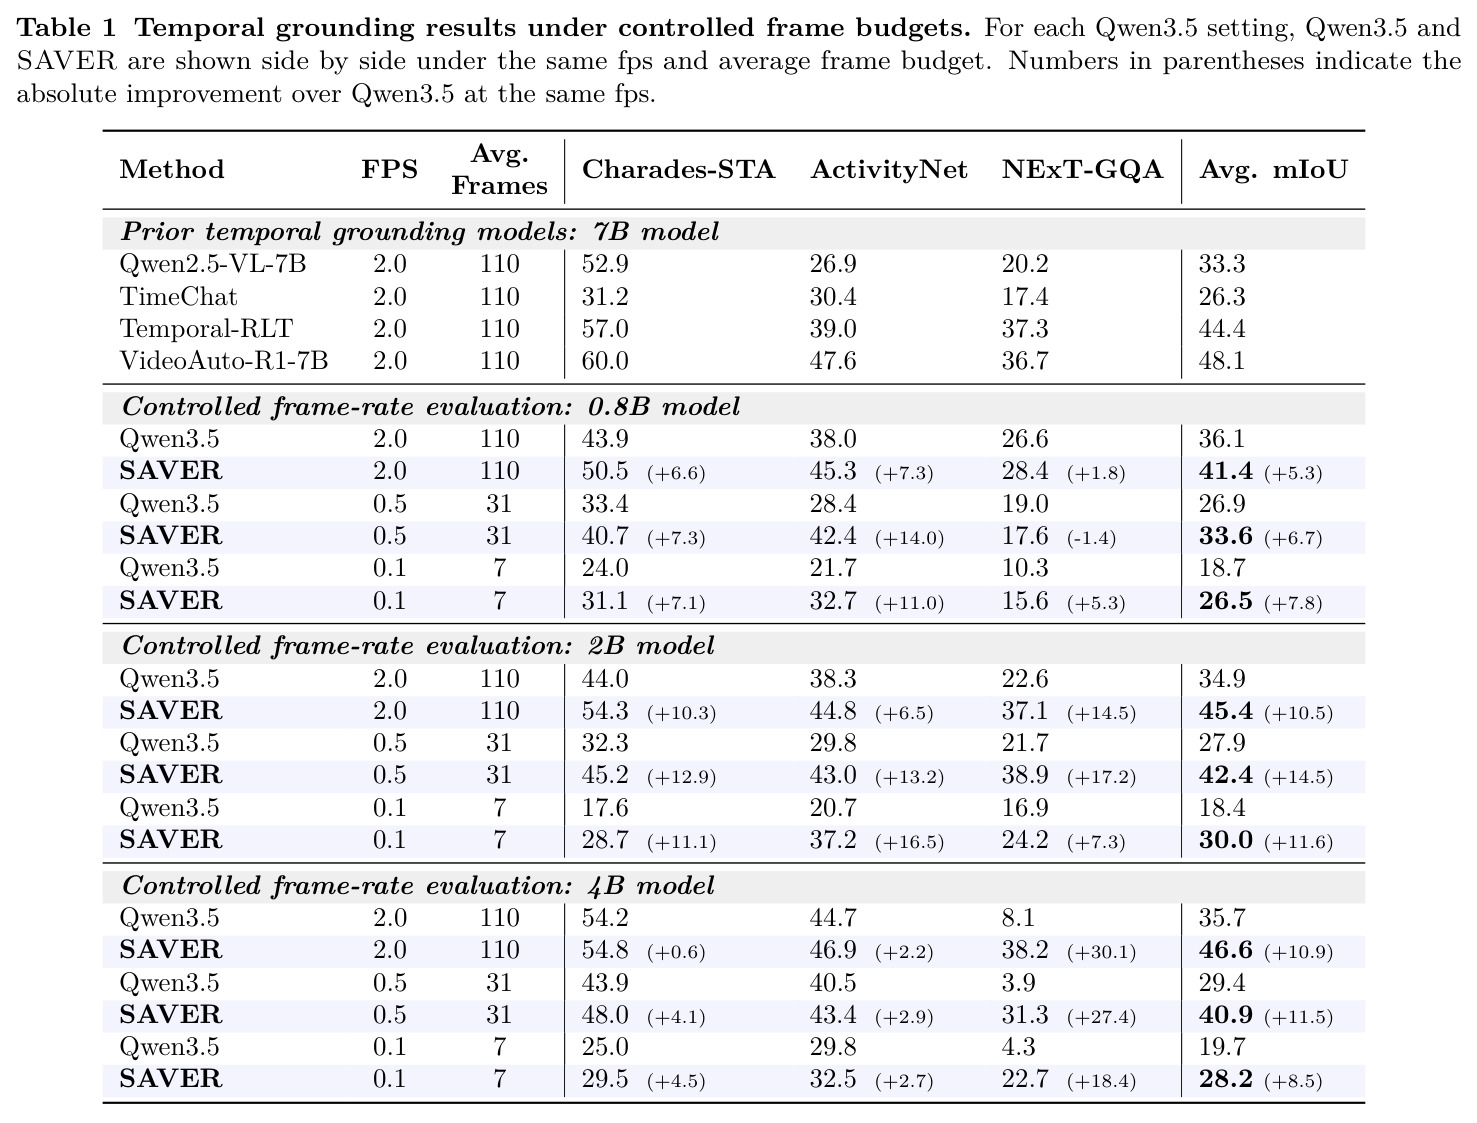
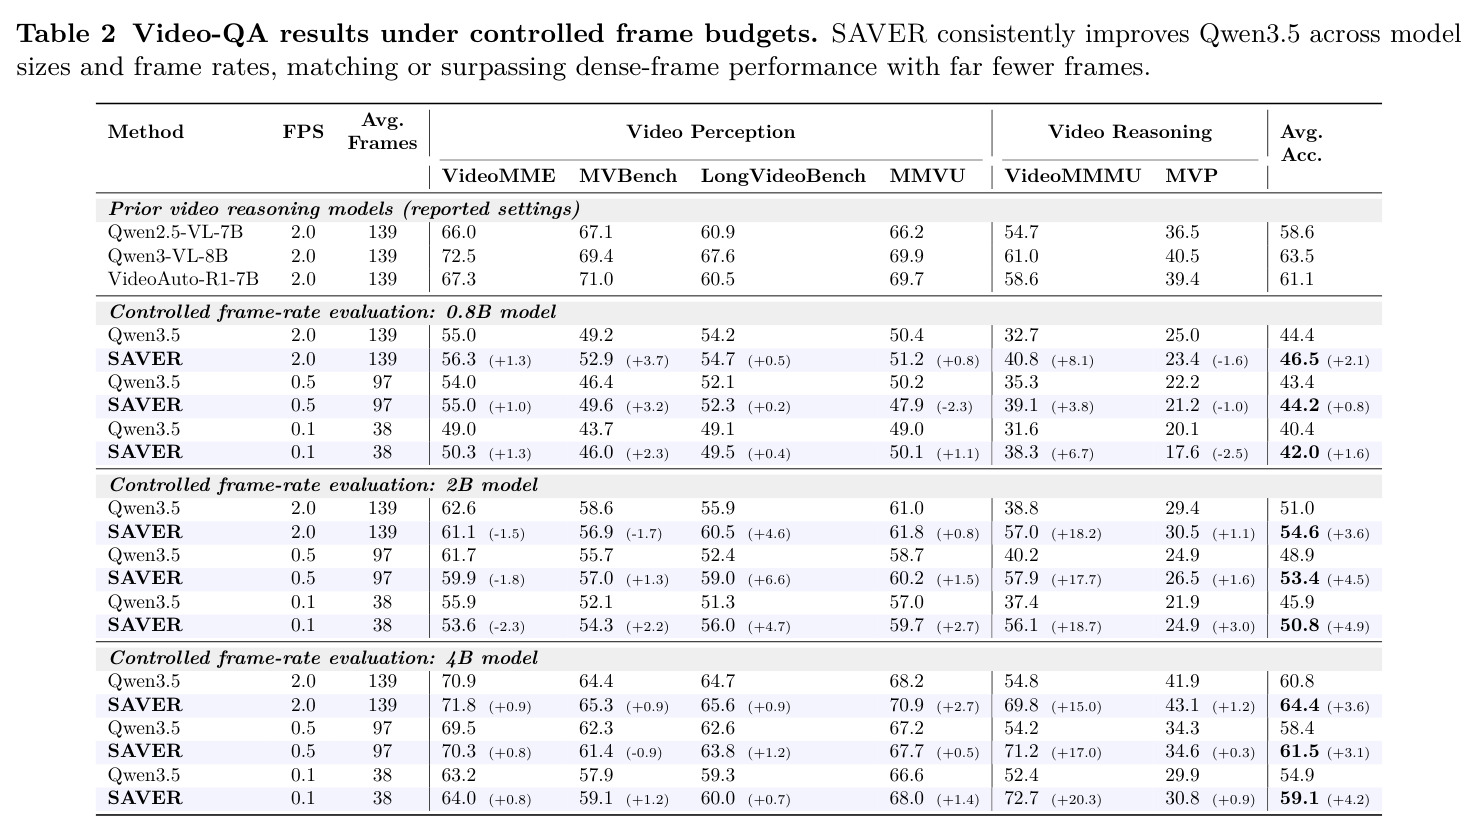
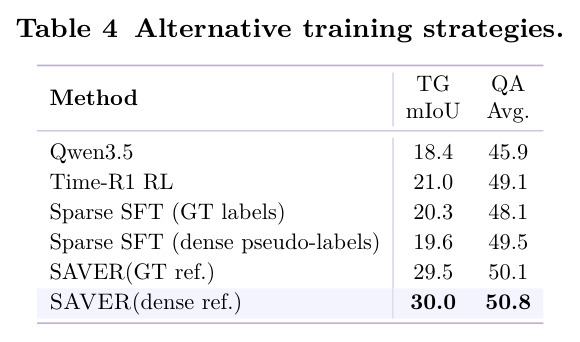
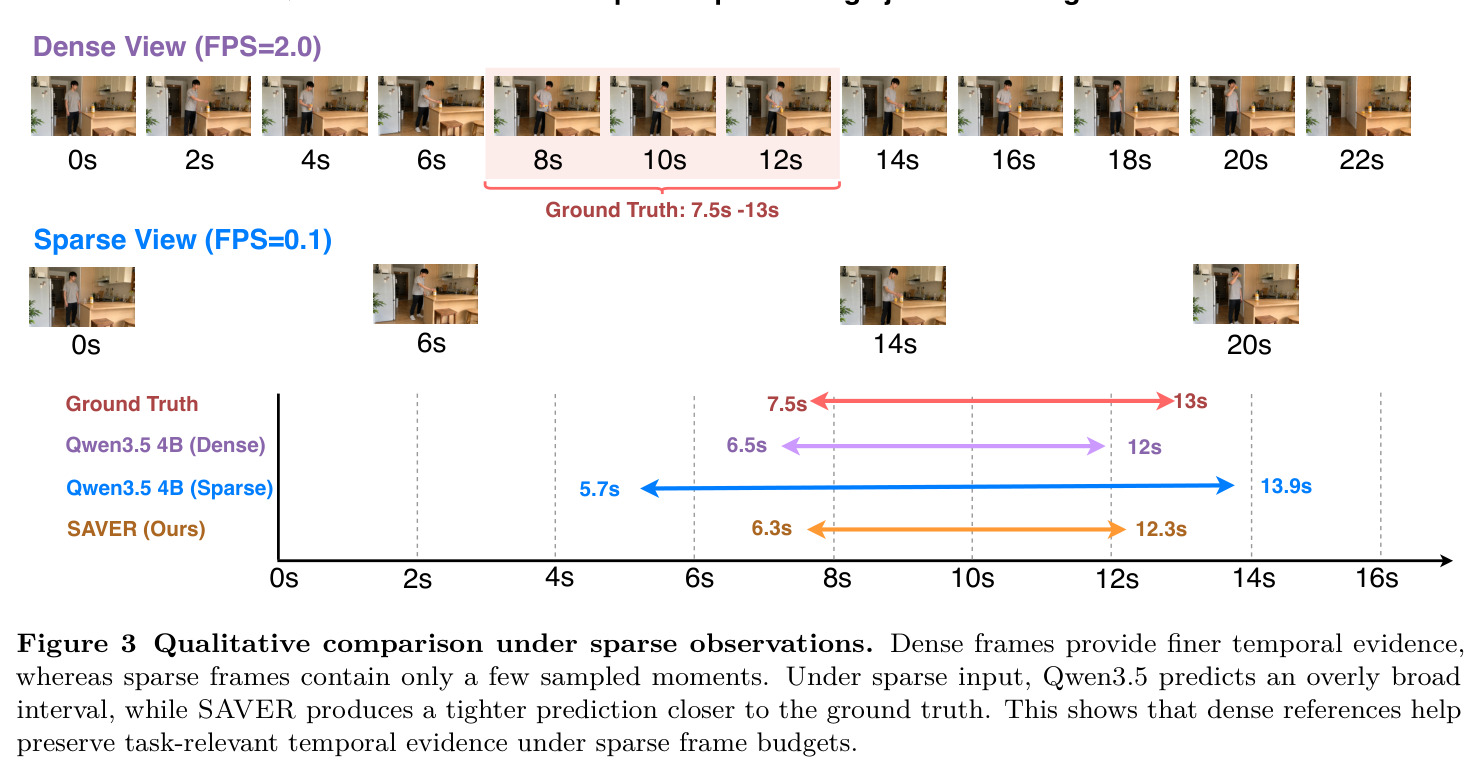
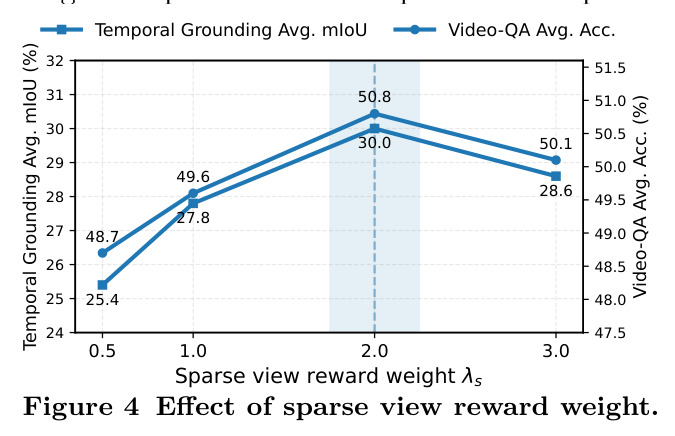
时序定位(表1):Qwen3.5-2B 平均 mIoU 从 2.0 fps 的 34.9% 跌到 0.1 fps 的 18.4%,印证稀疏定位的挑战性;SAVER-2B 在 0.1 fps 提升至 30.0%(+11.6),其中 Charades-STA 28.7 vs 17.6、ActivityNet 37.2 vs 20.7、NExT-GQA 24.2 vs 16.9;即使在 2.0 fps 也升至 45.4%(+10.5)。4B 模型 0.1 fps 从 19.7% 到 28.2%(NExT-GQA 增幅 +18.4);0.8B 从 18.7% 到 26.5%。SAVER-2B 在 0.1 fps(38 帧)已接近 Qwen3.5-2B 在 2.0 fps(139 帧)的水平。视频 QA 迁移(表2):2B 平均准确率 2.0 fps 51.0%→54.6%、0.1 fps 45.9%→50.8%;4B 在 VideoMMMU 上 0.1 fps 从 52.4% 涨到 72.7%(+20.3)。但存在退化:2B 的 VideoMME 在部分帧率降 1.5–2.3 点,0.8B 的 MVP 最多降 2.5 点。效率上,2.0→0.1 fps 平均帧数 139→38(-72.7%);对 Qwen3.5-2B 的剖析显示视觉 token 省 86.8%、峰值显存省 49.3%、延迟省 63.6%。消融(表3):双视图 27.4、加参考奖励 29.1、加门控 30.0 mIoU。策略对比(表4):Time-R1 RL 21.0、稀疏 SFT(真值)20.3、伪标签 19.6,均远低于 SAVER 的 30.0;$\lambda_s=2.0$ 为最优(图4)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 时序定位三基准平均(Charades-STA/ActivityNet/NExT-GQA)@0.1fps | 平均 mIoU | SAVER-2B:30.0% | Qwen3.5-2B:18.4% | +11.6 个百分点 |
| 时序定位三基准平均 @2.0fps(2B) | 平均 mIoU | SAVER-2B:45.4% | Qwen3.5-2B:34.9% | +10.5 个百分点 |
| ActivityNet @0.1fps(2B) | mIoU | 37.2% | 20.7% | +16.5 个百分点 |
| NExT-GQA @0.1fps(4B) | mIoU | 22.7% | 4.3% | +18.4 个百分点 |
| 视频问答六基准平均 @0.1fps(2B) | 平均准确率 | 50.8% | 45.9% | +4.9 个百分点 |
| VideoMMMU @0.1fps(4B) | 准确率 | 72.7% | 52.4% | +20.3 个百分点 |
| 视频问答六基准平均 @2.0fps(4B) | 平均准确率 | 64.4% | 60.8% | +3.6 个百分点 |
局限与改进
作者承认的局限有三。其一,两类失败模式:当稀疏帧完全错过关键事件时,模型仍会给出过宽或偏移的区间;当视频中多次出现视觉相似动作时,低帧率下模型可能对齐到错误的发生片段(附录 H 有案例)。其二,跨任务迁移不均衡:宏观均值提升,但个别基准退化(2B 的 VideoMME、0.8B 的 MVP),且作者承认迁移的底层机制仍是开放问题。其三,门控只是相对的样本级判据,既不保证密集预测真正正确,也不保证联合奖励随定位质量单调增加。我的补充观察:$w_d$ 基于单次采样的奖励比较,在 $G=4$ 的采样噪声下方差不小,可能做出错误的对齐决策;训练任务只有时序定位一种,对与时间结构弱相关的任务(如 MVP 的细粒度视觉对比)帮助有限甚至为负;评测仅覆盖 Qwen3.5 家族且最大 4B,规模扩展性与其他模型族的适用性未知;效率数据(token/显存/延迟)来自对基线模型的剖析而非 SAVER 专属加速,严格说不能算 SAVER 的收益;$\lambda_{ref}$ 灵敏度显示最优权重是中间值,实际部署有调参成本。
独立分析的弱点
独立分析的弱点与改进方向:第一,门控信号噪声大——$w_d$ 基于单视频单次 rollout 的奖励比较,RL 采样随机性下容易误判,可能让稀疏预测错过值得模仿的密集参考、或反过来锚定一次侥幸的密集输出;改进方向是用 $G$ 个 rollout 的期望奖励做门控,或把二值门控换成按奖励差 $R_{grd}(y^d) - R_{grd}(y^s)$ 加权的软对齐。第二,稀疏视图是均匀采样,'关键事件恰好落在帧间缝隙'本质是信息缺失而非利用不足,SAVER 无能为力;可结合作者设想的在线采样,让模型输出不确定性并主动请求补充帧。第三,参考奖励只定义在区间上($tIoU$ 对齐),对开放式 QA 的迁移只能间接受益,0.8B 在 MVP 上退化 2.5 点即是证据;可引入答案一致性或语义熵等任务无关的参考信号作为补充。第四,训练时稀疏视图的 fps 设置与测试帧率的关系未系统解耦,跨帧率外推(如训练 0.5 fps、测试 0.05 fps)的鲁棒性未报告。第五,密集视图的中间思考链(图1 的 Thinking 内容)未被利用,过程级蒸馏可能带来超越区间级对齐的收益。
未来方向
作者明确提出的方向是自适应在线采样:当模型发现稀疏观测不足以支撑判断时主动请求额外帧,把固定预算协议升级为按需取证,这与失败模式分析直接呼应。基于论文成果还可延伸:其一,把密集-稀疏配对范式推广到空间维度(图像区域作参考)或时空联合(密集关键帧+稀疏全程帧),形成通用的'特权信息训练'框架;其二,与 token 压缩、键帧选择正交叠加——SAVER 解决低预算下的可靠性,压缩方法解决高预算下的开销,组合效果值得系统评估;其三,理论侧把 $D_{TV}(p_s, p_d)$ 上界紧致化,分析参考奖励对稀疏-密集分布差异收敛速率的影响,回答作者自己承认的'跨任务迁移机制'问题;其四,把二值门控升级为价值估计或多教师门控(如密集视图+文本描述双参考),并用奖励差加权对齐强度;其五,在流式视频、机器人等真实受限环境做部署验证——目前延迟/显存数据来自基线剖析,SAVER 端到端实测是自然的下一步。
复现评估
复现条件较友好但需要 RL 基础设施。开源情况:作者承诺发布代码、模型检查点和抽样出的 1,250 条训练子集(论文版本为承诺,需关注仓库是否落地)。数据:训练数据来自公开的 Time-R1 数据集随机抽样;评测用 lmms-eval 框架、贪心解码,帧率协议明确({0.1, 0.2, 0.5, 1, 2} fps,每视频帧数上限 [4, 256]),可复现性设计良好。算力:0.8B/2B/4B 分别需 16/16/32 张 A100,训练约 4/7/13 小时,对学术实验室属中等偏上门槛,2B 规模是最现实的复现起点。难度主要在强化后训练工程:需实现双视图配对 rollout、三个奖励(tIoU 与边界惩罚逻辑简单)与 GRPO 式优势归一化,沿用 Time-R1 配方可显著降低门槛。主要不确定性:随机抽样的 1,250 条子集选择、以及论文未报告多次运行的方差,复现结果可能有 1–2 个点的浮动;参考 Qwen3.5 系列开源权重可得,整体评估为中等难度、依赖条件明确。
论文图表
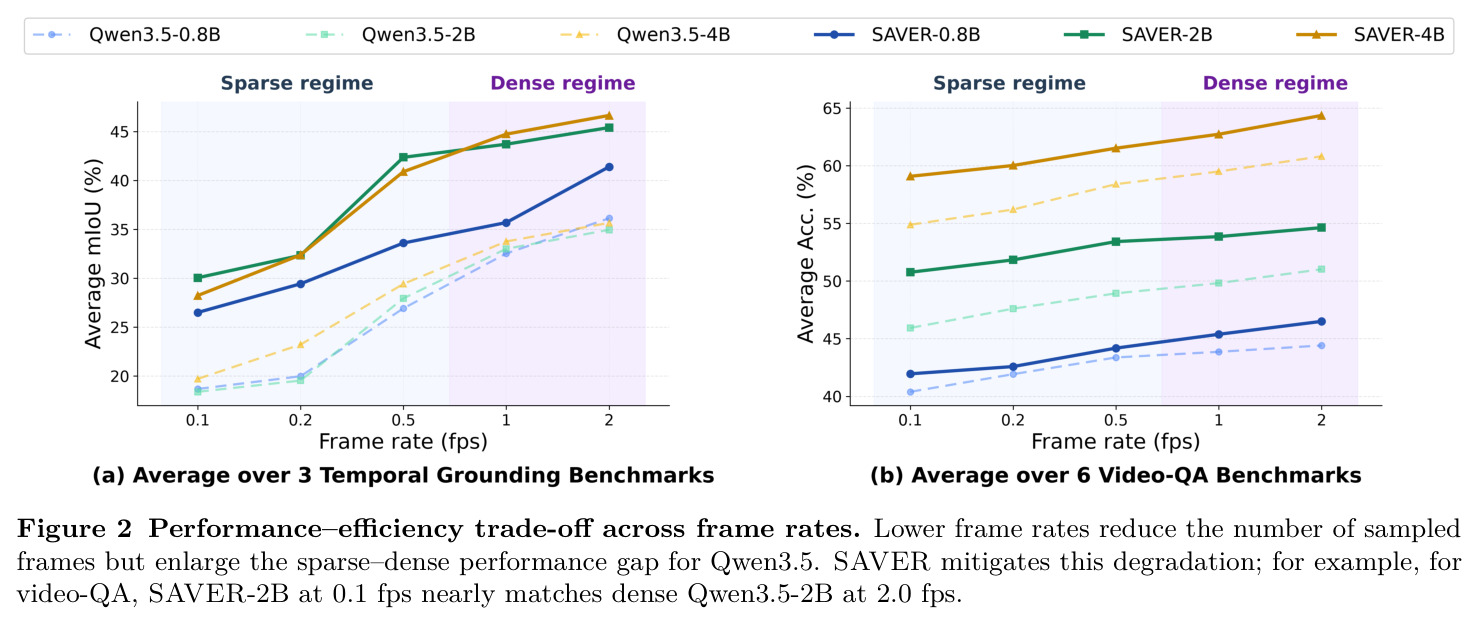
折线图展示帧率从 2.0 fps 降到 0.1 fps 时性能与帧预算的权衡:标准 Qwen3.5 随帧率下降性能大幅滑落(时序定位尤其明显),稀疏-密集性能差距扩大;SAVER 在每个相同帧率下都优于 Qwen3.5,且 SAVER-2B 在 0.1 fps 下的视频 QA 几乎追平 Qwen3.5-2B 在 2.0 fps(帧数多 3.7 倍)的表现。
这张图直观呈现了论文要解决的核心矛盾(低帧率下基线崩溃)与核心卖点(SAVER 改变权衡曲线),是动机和主结果的视觉浓缩,适合放在开头说服读者问题真实存在且方法有效。