DirCast:用单个流式视频语言模型同时完成电竞直播导播与解说 DirCast: Live Esports Directing and Commentary with a Single Streaming Video-Language Model
单一流式视频语言模型每秒决定哪路画面上屏并实时解说,直播电竞比赛。
前置知识
流式视频语言模型
与处理完整预录视频的离线视频语言模型不同,流式模型按帧/秒增量接收视频,每一步只能看到过去的信息,并自行决定何时响应、响应什么内容。代表工作包括 LiveCC、StreamingVLM、Proact-VL 等,它们通常在已制作完成的成品视频上训练与评测。
DirCast 本身就是一个流式视频语言模型,但它把输入从成品节目换成十路原始摄像头。理解流式设定是理解其因果约束(只用过去)、实时性要求与上下文成本问题的前提。
曝光偏差
序列模型训练时总以真实(教师强制)历史为条件,推理时却只能以自己生成的历史为条件;一旦早期犯错,后续输入状态是训练中从未见过的,错误会像滚雪球一样累积。调度采样、professor forcing 等技术通过在训练中混入模型自身状态来缓解此问题。
导播任务把这一问题急剧放大:模型切错镜头后看到的是自己产出的节目而非人类成片。DirCast 的扰动节目 rollout 正是为对抗它而设计的训练策略,是理解方法部分的关键概念。
KV 缓存与上下文成本
Transformer 自回归生成时会把每个 token 的键值向量缓存下来(KV cache),上下文越长缓存越大,每步注意力计算量与显存占用随之增长。流式场景必须主动丢弃、压缩或检索旧 token,才能让每秒成本与流的总长度无关。
十路摄像头每秒各产生一批视觉 token,会迅速撑爆上下文。DirCast 的低分辨率视角 8 秒过期、36 秒视界等机制全部建立在理解 KV 缓存成本模型之上,是其能无限长实时运行的根本。
LoRA 微调
低秩适配:冻结预训练模型的全部权重,只在每层注入可训练的小型低秩分解矩阵(通常不到总参数量的百分之几),大幅降低显存与算力需求,效果通常接近全量微调,是大模型高效微调的标准做法。
DirCast 在 Qwen3-VL-8B 上用 LoRA 训练 3 个 epoch,只需 8 张 H100。理解 LoRA 才能评估这篇工作的复现成本与工程门槛。
Proact-VL 评测协议
面向主动式游戏解说的标准化评测方案:以 GPT-4o 的离线解说为对手计算胜率 CC;用 F1 与 TimeDiff 衡量模型何时选择说话及开口延迟;用 LiveU 评实时表达、FinalQ 评最终文稿(含保真度、连贯性、实质性),PAUC 汇总整条流的解说质量。
本文所有解说结果都按此协议报告,且因官方判官 GPT-5.1 不可用而改用 GPT-5 评判全部模型。知道各指标的偏置(F1 奖励多说话、Fidelity 奖励少说话)才能正确解读对比结果。
研究动机
现有流式解说模型(LiveCC、StreamingVLM、Proact-VL 等)只完成“对着成片说话”这一半工作:它们假设人类导播已经切好每个镜头,模型只需在成品节目流上决定何时开口、说什么,等于免费继承了人类导播的判断,而直播生产中最难的部分——每秒从十路玩家第一视角中决定哪一路上屏——被排除在问题之外。现实后果是只有顶级赛事才配得起专业导播与解说团队,长尾的区域联赛和业余比赛只能用固定机位、无人解说。而把导播纳入后,问题在两个单独任务之上产生了新的困难:十路画面每秒一路产生的视觉 token 远超流式模型能长期保留的上下文;决策随时间复利,导播错过一次团战,解说就会对着错误的场景说话,之后每一秒都建立在早期错误之上;人类导播大部分时间持机不动,直接模仿会学出“永不切镜”;允许沉默的流式模型还会陷入沉默螺旋且难以恢复。
本文的目标是本文提出并研究“直播生产”(live broadcast production)这一完整任务:给定一场正在进行的 Dota 2 比赛的十路英雄摄像机画面与实时发生的游戏事件,模型必须在仅使用过去信息的因果约束下,每秒选出上屏镜头,并对着自己选出的画面生成实时解说,从原始输入直接产出一场完整直播。具体目标有三:其一,构建保留全部摄像头视角的数据集——从 27 场职业比赛回放渲染十路英雄镜头、与官方转播逐秒对齐,标注每秒的上屏镜头、广播状态与解说词;其二,设计单一模型同时胜任导播与解说两个角色,并在任意长度的流上以恒定成本实时运行;其三,在与人类导播的一致率、击杀覆盖率以及 Proact-VL 协议下的解说质量上,同时超越规则导演、零样本 VLM 导演和十一个流式解说基线。
与已有工作不同的是,独特切入是把导播与解说放进同一个因果视频语言模型,而非两个并行训练的系统:解说在生成顺序上位于导播决策之后并以其为条件,天然“对着自己切的镜头说话”。针对流式场景特有的失败模式,作者做了三处机制设计:用“保持或切换”门控加指针分解决策,把不切作为默认动作,模仿人类导播多数时间什么都不做的先验;用“节目即记忆”管理上下文——低分辨率视角 8 秒后过期,只有实际播出画面与说过的话留在流中,使成本与流长无关。训练策略上,扰动节目 rollout 让模型经历自己切错镜头后的状态以对抗曝光偏差,事件锚定目标承认“切到击杀参与者也是正确导播”,弥补人类标签中“值得展示”信号的不一致;推理时决策阈值跟随模型自身行为频率向人类节奏回归。这明确区别于以往离线视角选择(无因果约束、不与解说耦合)或成品节目解说(不做镜头选择)两条研究路线。
核心方法
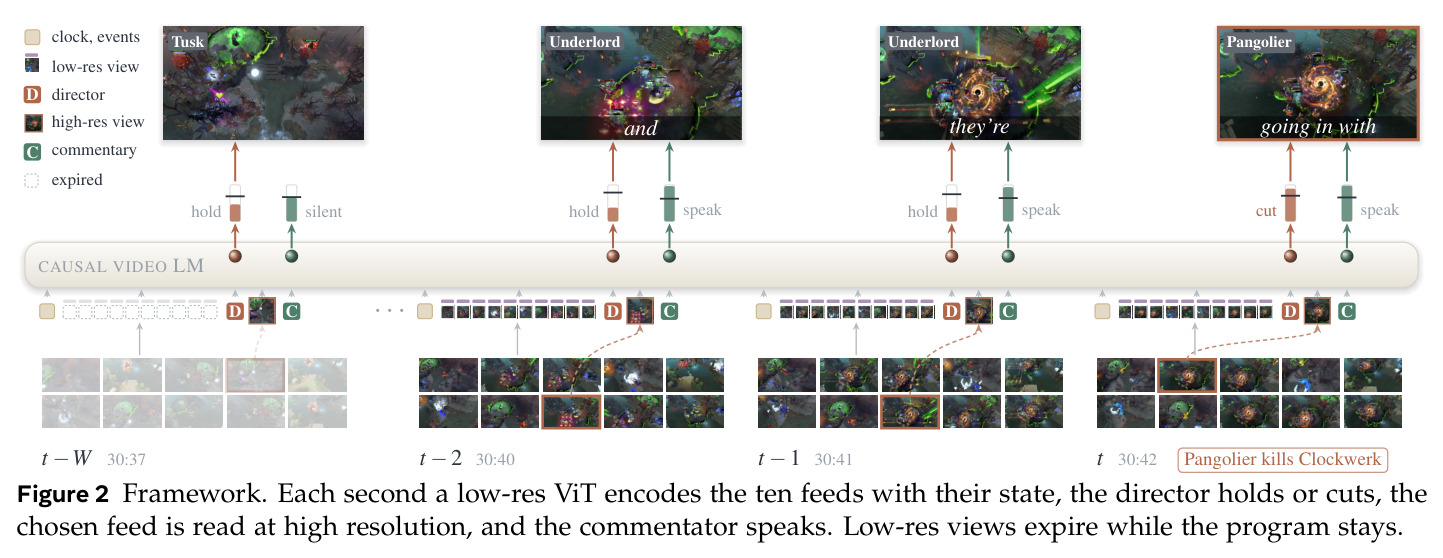
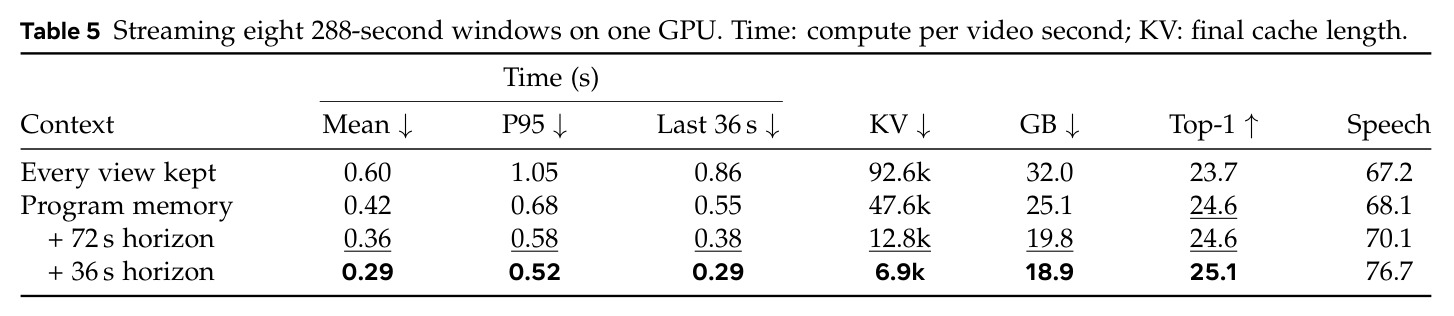
DirCast 是在 Qwen3-VL-8B 上以 LoRA 微调 3 个 epoch(8 张 H100)得到的单一因果视频语言模型。每秒读入一个固定布局的 token 块:开头是该秒游戏时钟与新事件文本;随后列出十路摄像头,每路是一个 128 像素低分辨率视图 $v_k^t$,配一个编码该英雄游戏状态(血量、周围敌人、近期伤害)的状态 token $s_k^t$;块尾是导演 token $\langle D\rangle$。导播决策完成后,被选镜头 $c_t$ 以 288 像素高分辨率再次追加,其后是解说 token $\langle C\rangle$ 与该秒的话 $w_t$——顺序复刻人类团队的工作方式:导播先扫视全部机位,解说再细看上屏画面。双分辨率是成本关键:十路全分辨率画面每秒产生的视觉 token 无法承受,低分辨率足以判断哪里有动作,只有上屏画面需要高分辨率来认英雄与技能。低分辨率视角保留 $W=8$ 秒后离开上下文,上屏视图、事件与话语永久保留——“模型的记忆就是它产出的节目”。推理单 GPU 实时运行,长流下每视频秒成本恒定为 0.29 秒。
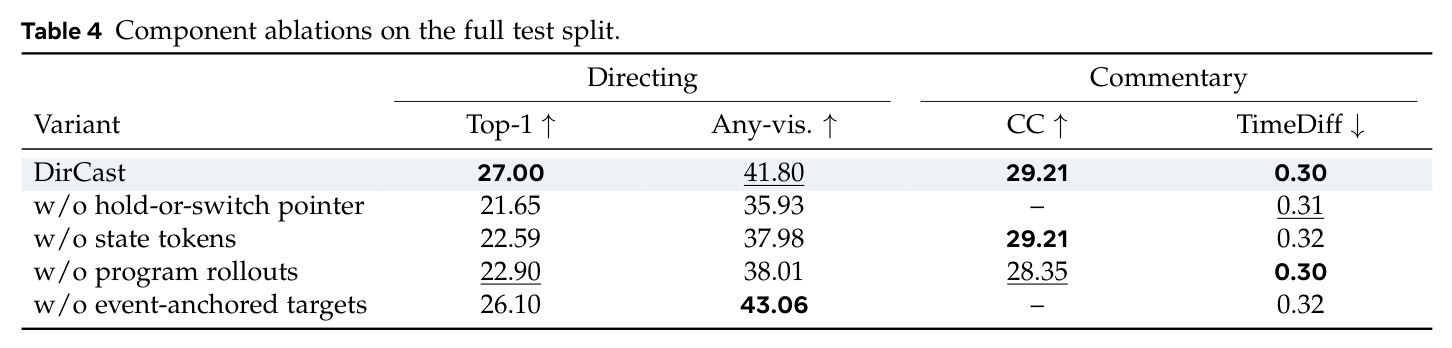
核心创新是把切镜决策分解为“是否切”与“切到哪”,而非每秒对十路镜头重新分类。设导演 token 隐状态为 $h^D$、当前镜头 token 均值为 $\bar{h}_{c_{t-1}}$,切镜门 $g_t = \sigma(f([h^D, \bar{h}_{c_{t-1}}]) + \psi(s_t))$ 估计离开当前镜头的概率;指针 $\pi_t(k) \propto \exp(\langle q(h^D), \kappa(\bar{h}_k)\rangle + e_k + \phi(s_k^t))$ 结合镜头内容、游戏状态与选手位嵌入打分;最终 $P(c_t{=}k) = (1-g_t)\mathbb{1}[k{=}c_{t-1}] + g_t\pi_t(k)$——保持是默认,切换需门控开启,去掉该结构 Top-1 从 27.00 跌至 21.65。第二个创新是“节目即记忆”:上下文只留实际播出内容,低分辨率视角过期后从 KV 缓存删除,超训练片段长度后只留最近 36 秒,KV 稳定在 6.9k,与保留全部视角(92.6k、P95 每秒 1.05、超出实时)是质的不同。
方法步骤详情
流程五步。(1) 输入组装:每秒把时钟、事件文本、十路低分辨率视图(128px)与状态 token 按序拼入流;事件与镜头绑定,如击杀在凶手镜头上打标记。(2) 导播决策:导演 token 读入历史后先算切镜门 $g_t$,超阈值则由指针在其余九路选新镜头;门控以人类切镜为监督、指针以人类所选镜头为目标,英雄在上屏可见的镜头均算正确。(3) 高分辨率回读:被选镜头以 288px 追加,保证解说总条件于自己选中的画面。(4) 解说生成:解说 token 概率超阈值才开口,结束概率够高才收尾,避免碎句。(5) 上下文与节奏:低分辨率视角 8 秒后从 KV 缓存删除,超 36 秒一律过期;阈值按 $\tau_t = \tau_0 + \gamma(\bar{r}_t - r^*)$ 随自身近期频率 $\bar{r}_t$ 向人类速率 $r^*$(切镜 7.9 次/分、说话约 73.6%)回归——太久沉默则降说话阈值,切镜过频则抬切镜阈值。训练另加扰动节目 rollout(镜头偏离人类选择数秒、目标不变)与事件锚定目标(击杀前后接受凶手或受害者镜头)。
技术新颖性
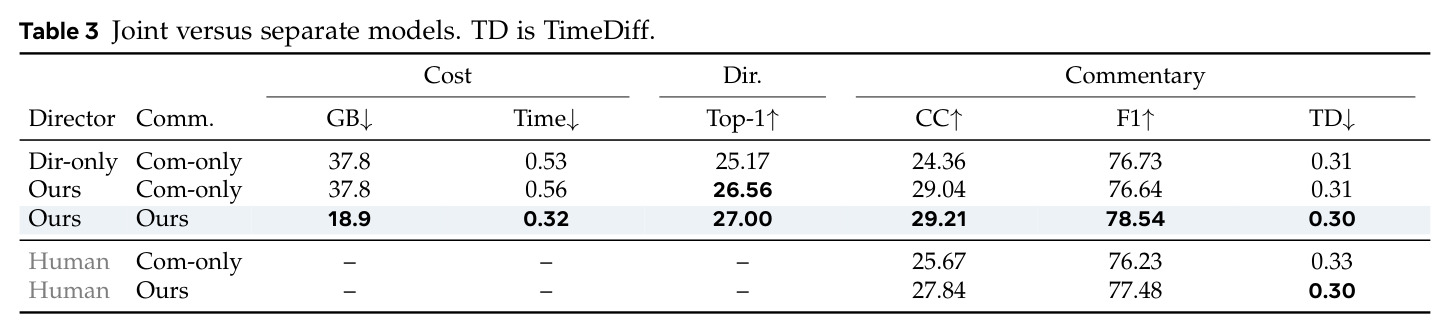
新颖性分四层。任务层:首次提出“直播生产”,把通常分开研究的视角选择与解说耦合进一个因果序列决策问题,并用实验证明联合优于分体——同一权重学两个角色使导播 Top-1 27.00 对 25.17、解说 CC 29.21 对 24.36,显存减半至 18.9GB,甚至在人类成片上其解说也胜出(27.84 对 25.67),说明学导播本身提升了解说能力。结构层:hold-or-switch 门控加指针显式编码“好导播多数时间不动”的领域先验,区别于每步全镜头重分类必然导致的闪烁切镜。训练层:扰动节目 rollout 直接对抗曝光偏差,让导播学会从错误镜头切回、解说学会对任意画面说话(去掉后 Top-1 降至 22.90、CC 降至 28.35);事件锚定目标把“值得展示”这一人类标签表达最不一致的信号显式补进训练(去掉后 Any-vis 反升至 43.06 而 Top-1 降至 26.10,暴露了两种目标间的取舍)。推理层:频率自适应阈值 $\tau_t$ 无需任何训练信号就把人类广播的节奏注入模型行为,同时解决流式模型的沉默螺旋与切镜过频两个失效模式。
实验结果
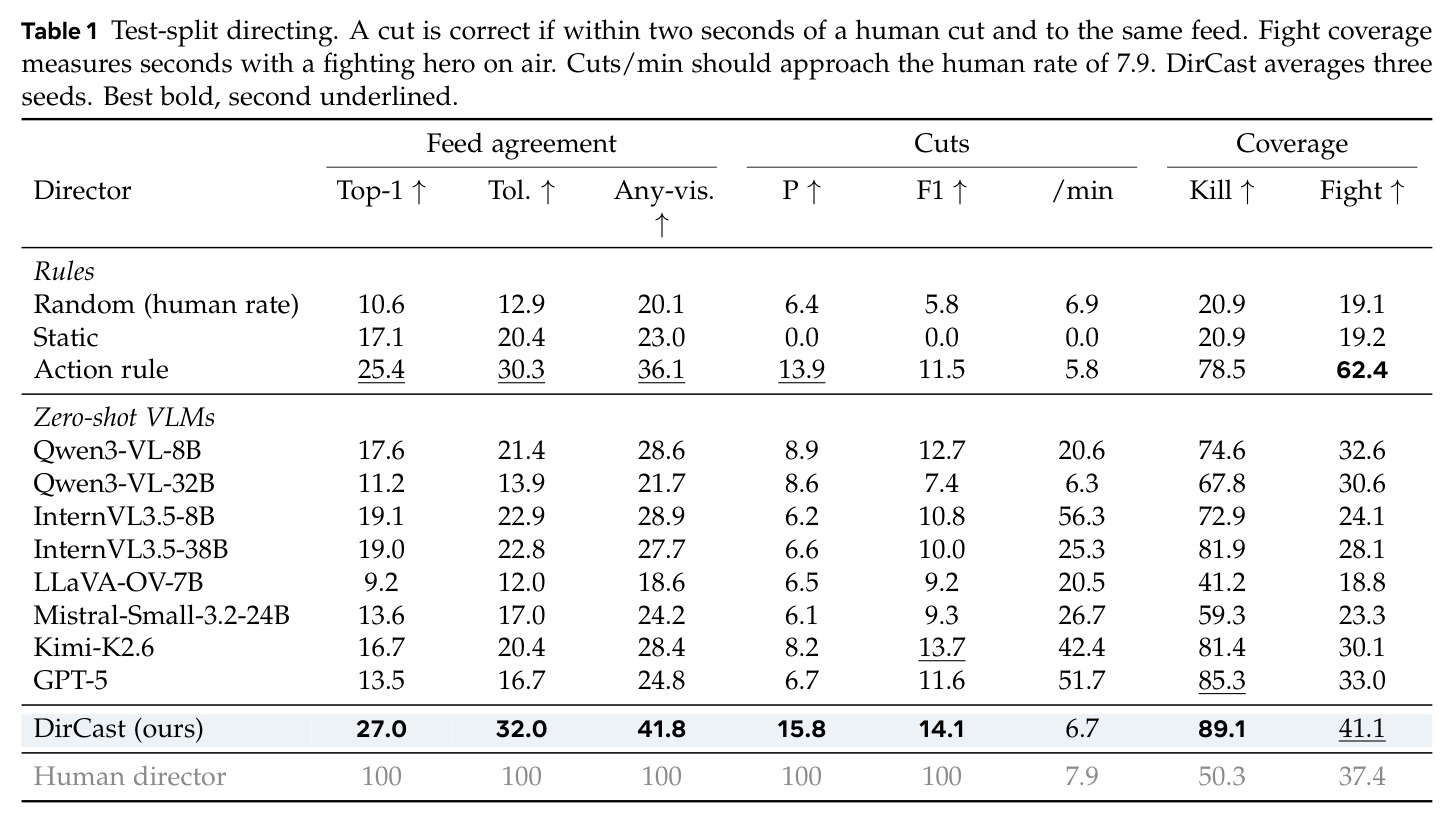
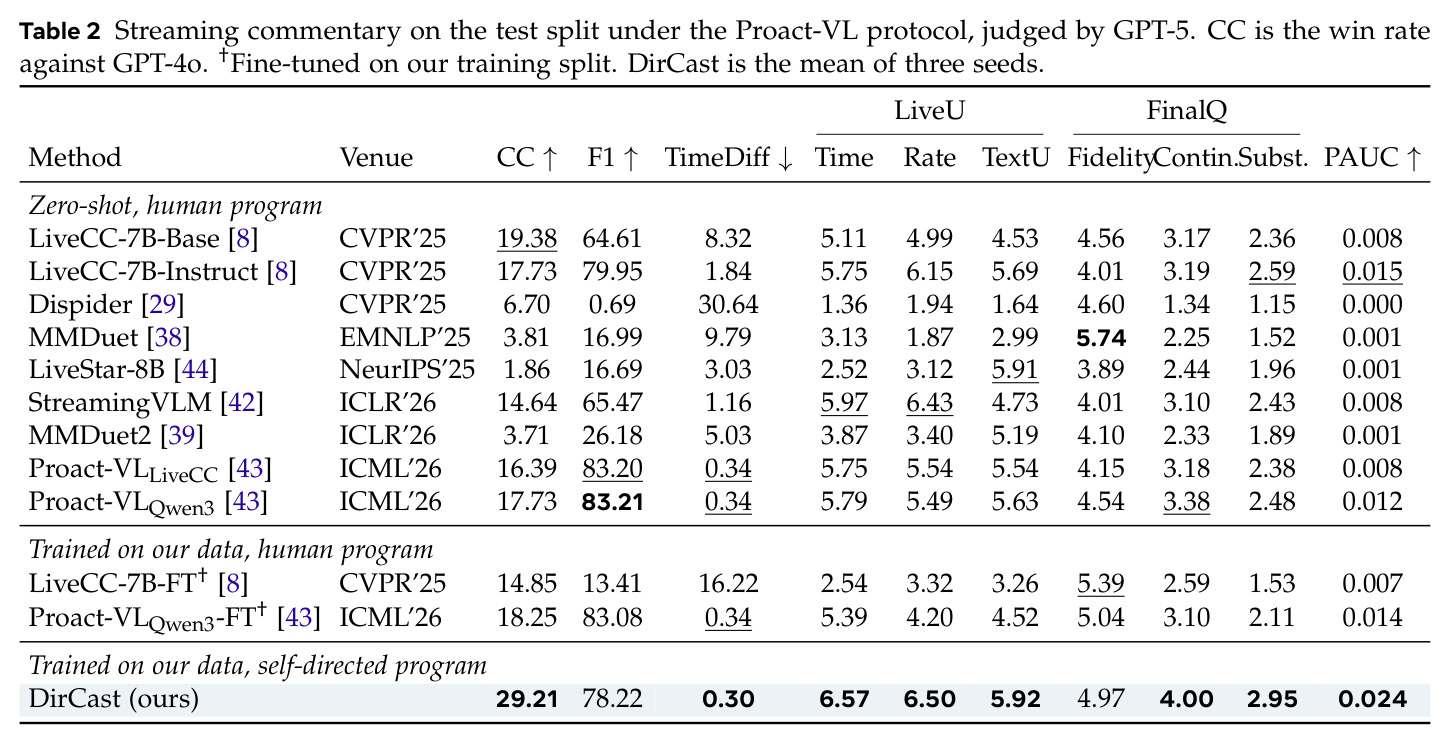
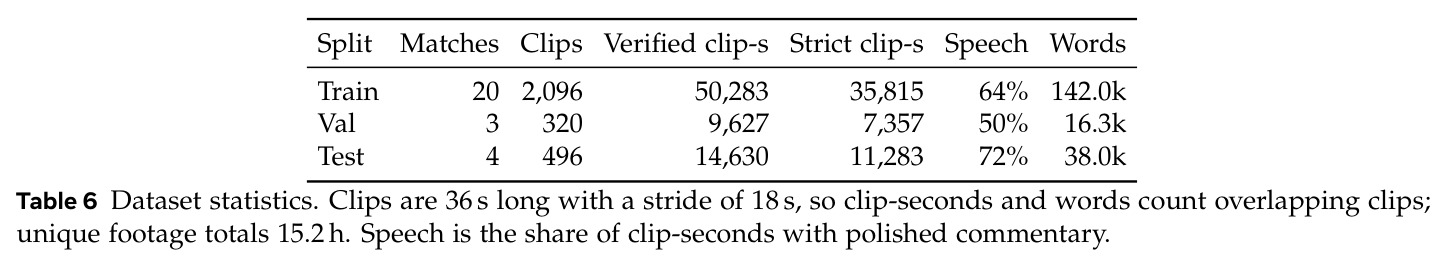
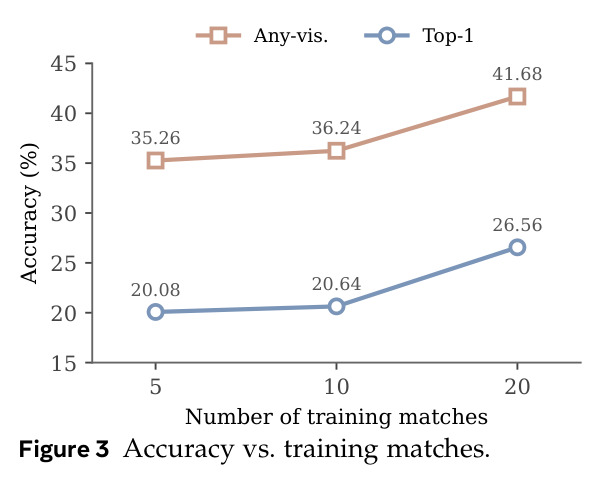
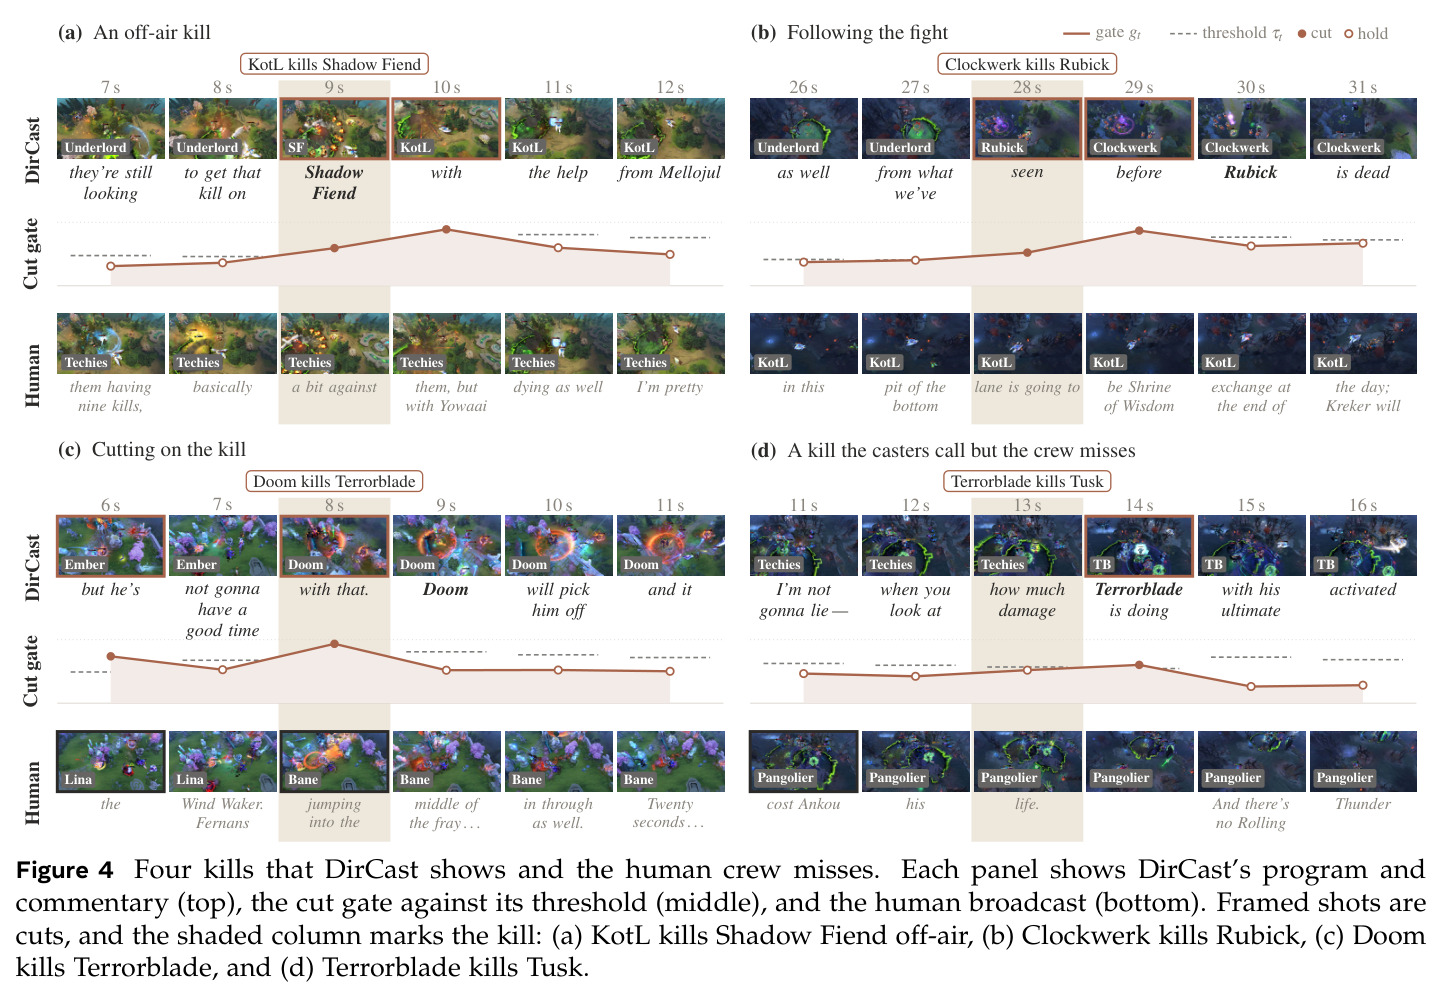
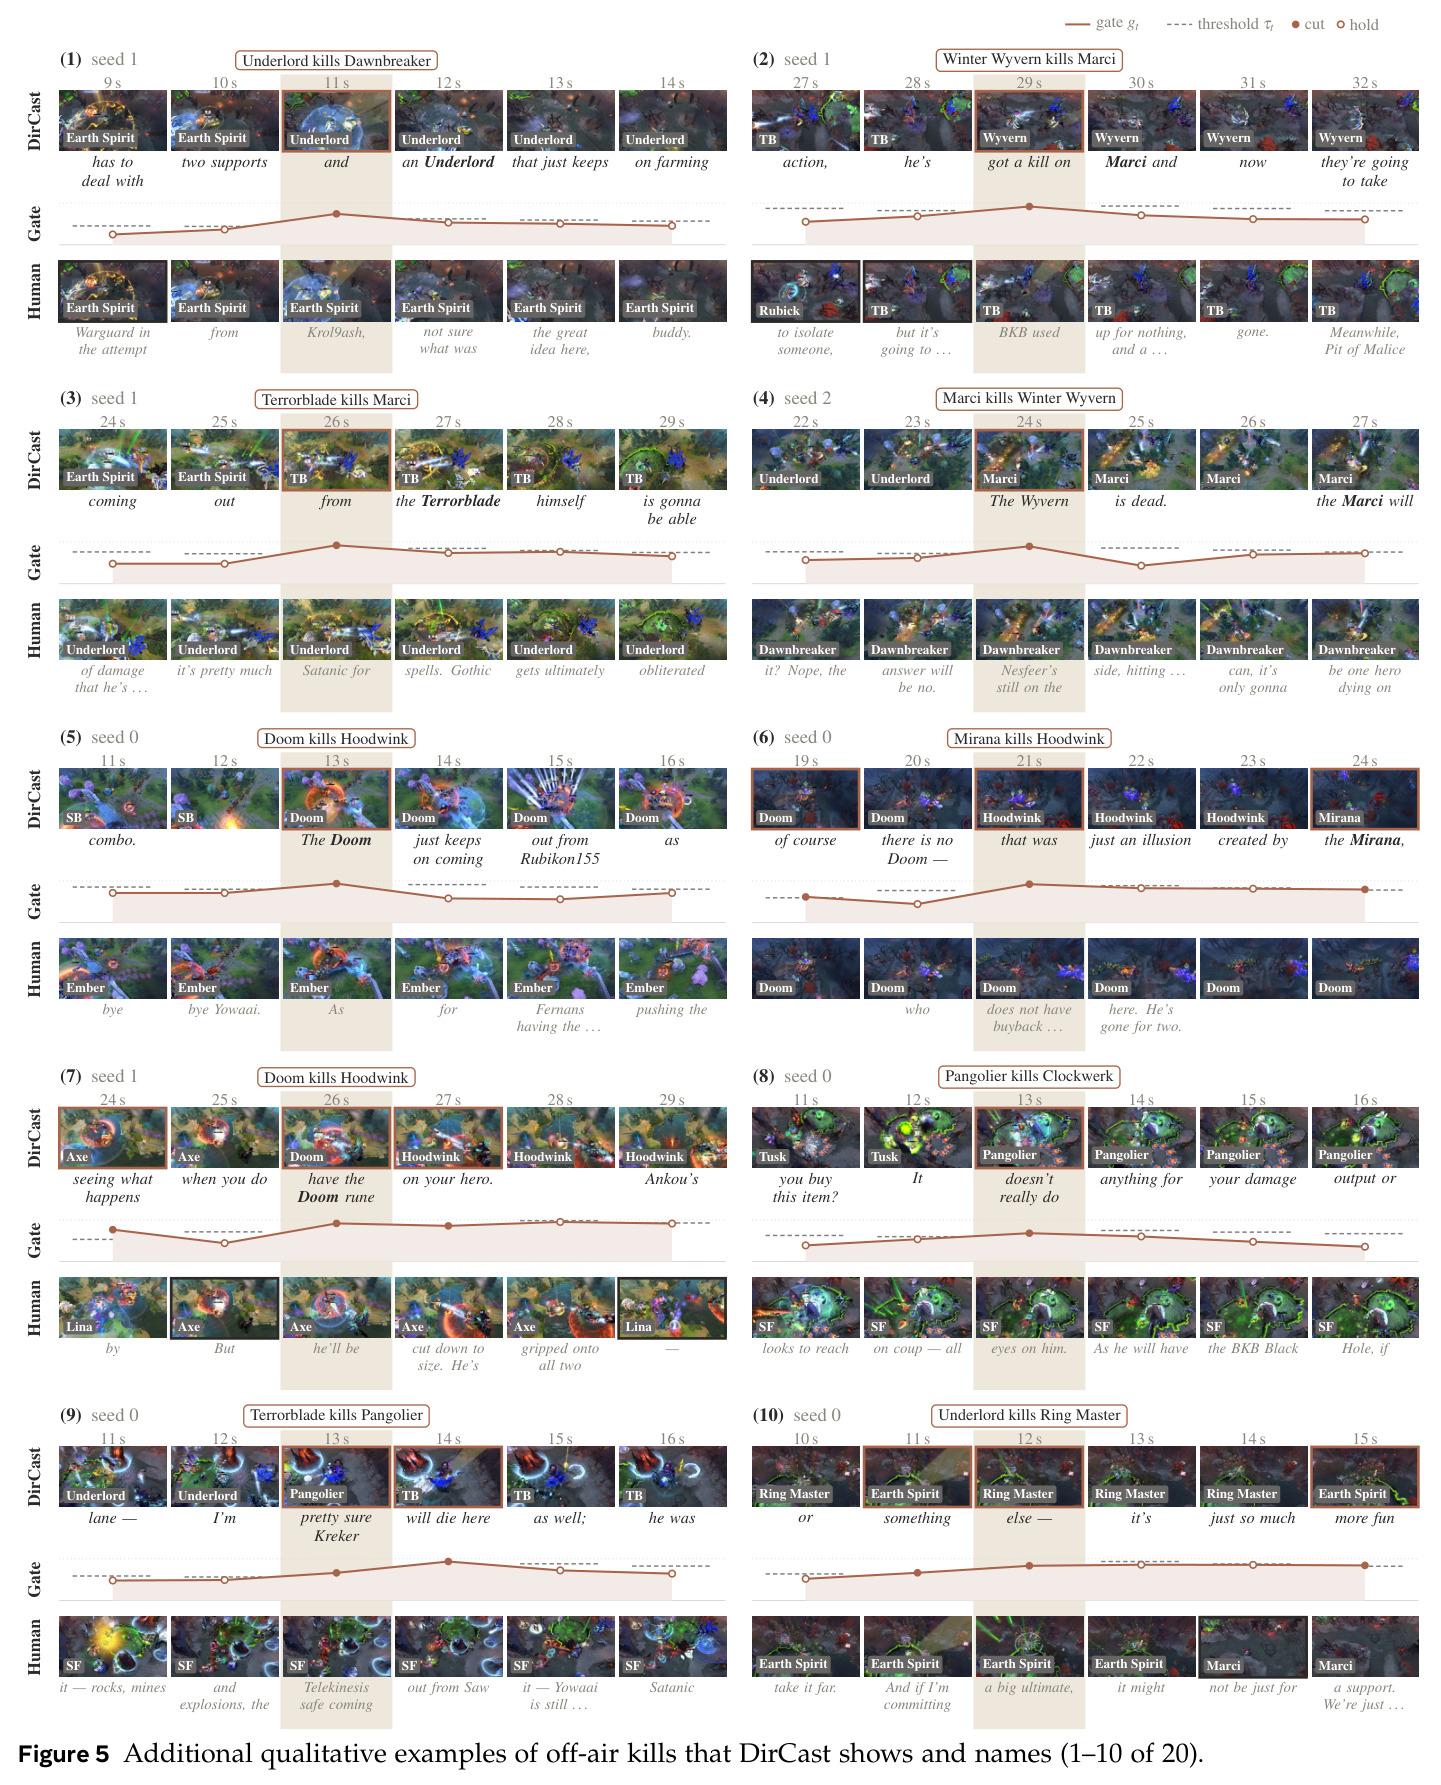
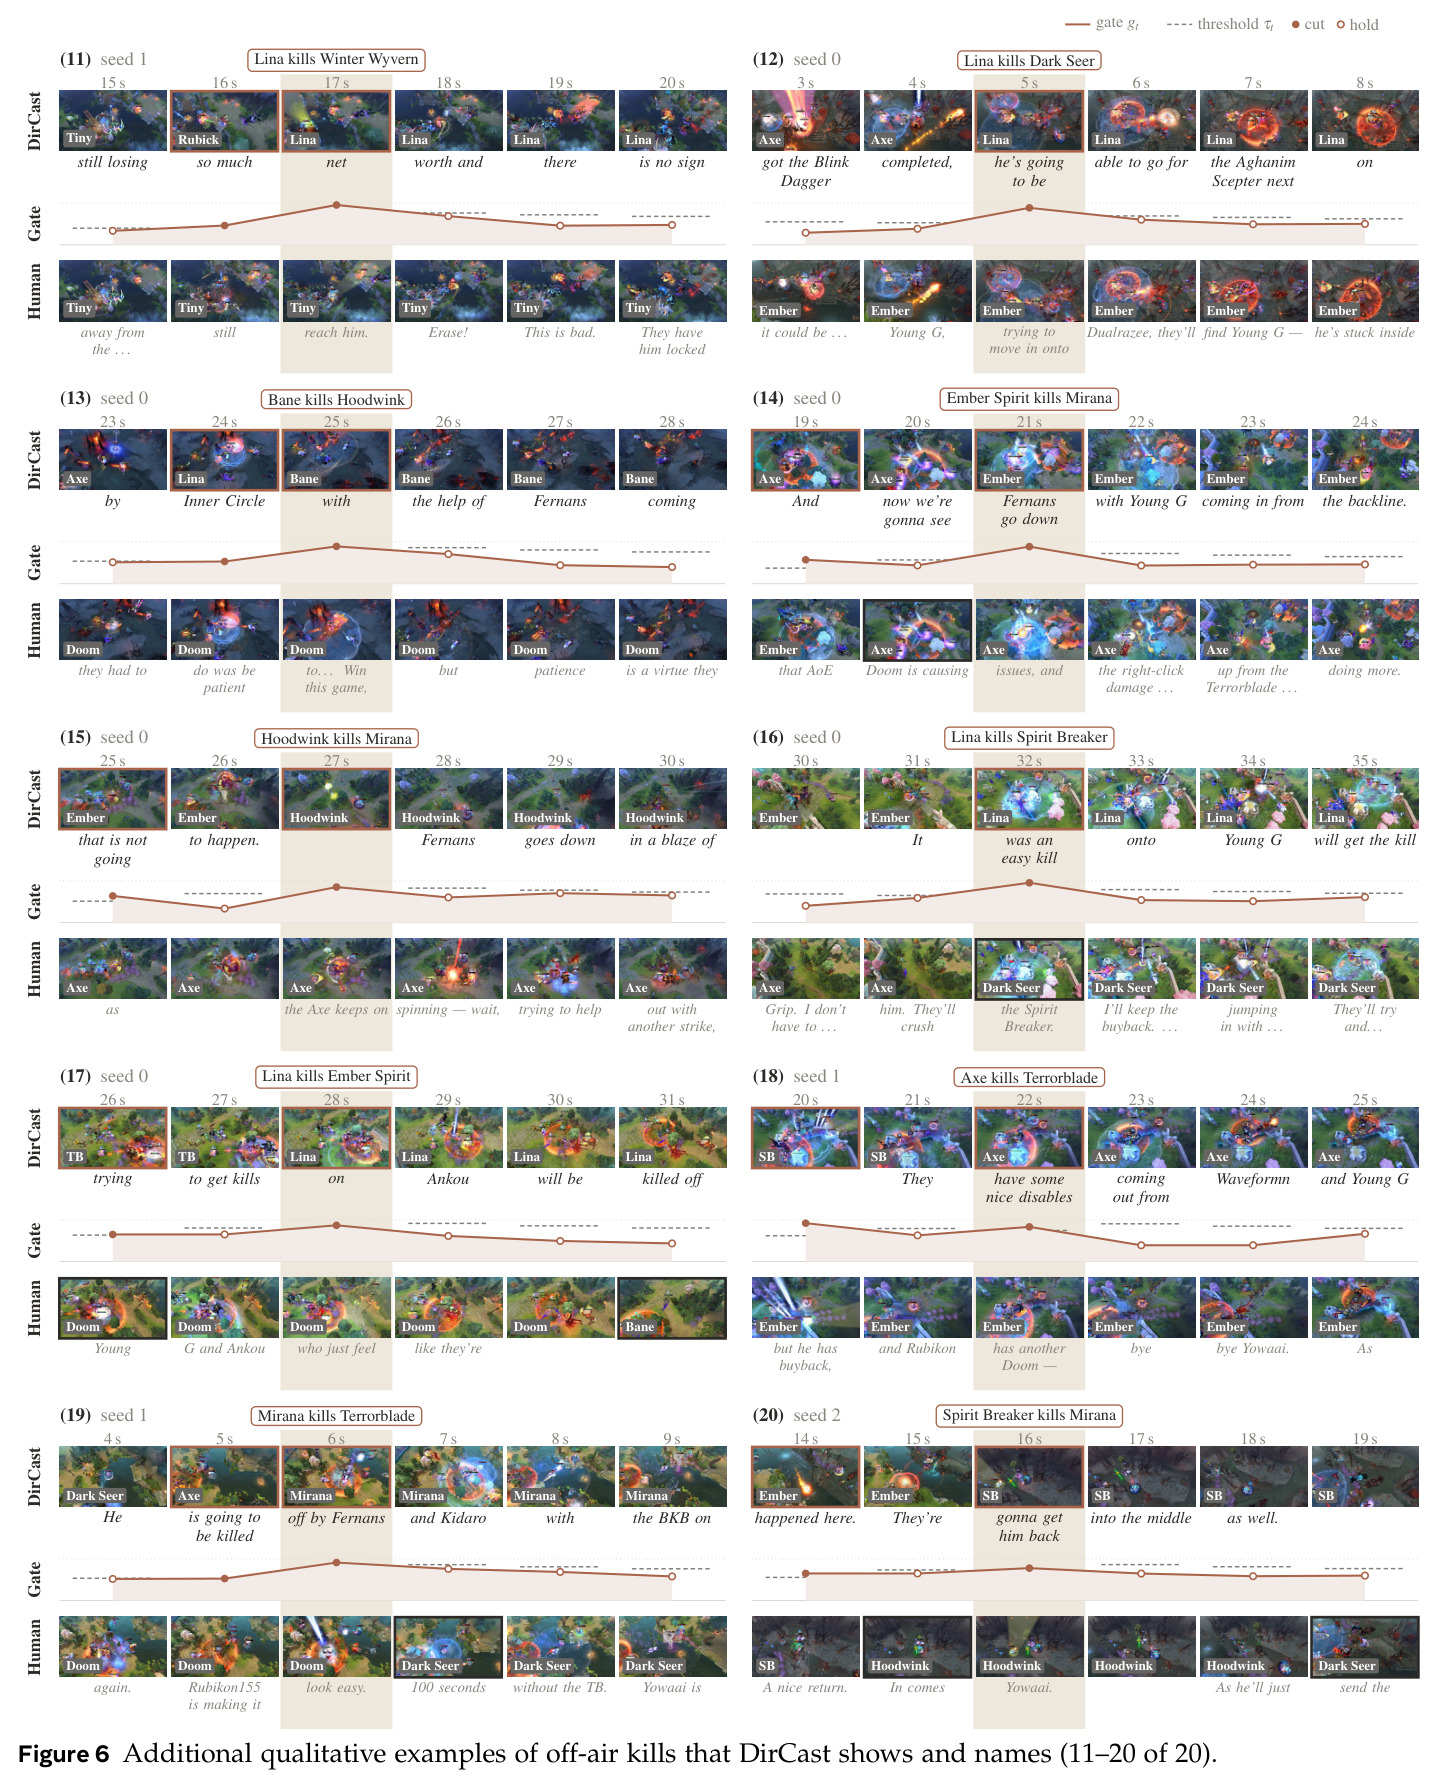
测试集为 4 场未见比赛的 496 个片段。导播(表 1):Top-1 26.95、Tol-top1 32.0、Any-visible 41.8,超过最强基线“行动规则”(25.43/30.3/36.11);切镜 6.7 次/分贴近人类 7.9;击杀覆盖 89.1% 超过所有基线与人类的 50.3%,还切到并解说了 23 个导播错过的镜头外击杀。零样本 VLM 导演均不及行动规则,GPT-5 Top-1 仅 13.53 且多切 20-56 次/分。解说(表 2,GPT-5 评判):对 GPT-4o 胜率 CC 29.21%,比最强基线 LiveCC-7B-Base 的 19.38 高约十点;开口延迟 TimeDiff 0.30 秒最优。表 3:联合模型两角色均优于分体且显存减半至 18.9GB。表 4:去掉 hold-or-switch 后 Top-1 降至 21.65。表 5:8×288 秒长流上 36 秒视界使 KV 稳定 6.9k、单卡每秒 0.29。图 3:训练 5→20 场,Top-1 由 20.08 升至 27.00,未饱和。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 导播:与人类导播逐秒一致(4 场测试赛,496 片段) | Top-1 一致率 (%) | 26.95(三种子平均) | 最强基线“行动规则” 25.43;零样本 GPT-5 仅 13.53 | 较最强基线 +1.52,较 GPT-5 接近翻倍 |
| 导播:击杀被放上屏的覆盖率 | Kill coverage (%) | 89.1 | 行动规则 78.5;人类导播 50.3 | 较最强基线 +10.6,较人类 +38.8 |
| 解说:对 GPT-4o 离线解说的胜率(Proact-VL 协议,GPT-5 评判) | CC 胜率 (%) | 29.21(自导自播) | LiveCC-7B-Base 19.38(观看人类成片) | +9.83 个百分点,且处于更难的设定 |
| 解说:相对人类解说员的开口时机 | TimeDiff (秒,越低越好) | 0.30 | LiveCC-7B-Base 8.32 | 延迟缩短约 8 秒,几乎与人类解说同步 |
| 解说:整条流的综合质量 | PAUC | 0.024 | 最佳基线 LiveCC-7B-Instruct 0.015 | +60% 相对提升 |
| 长流实时性(8 个 288 秒连续窗口,单 GPU) | 每视频秒计算时间 (秒) / KV 缓存 | 0.29(36 秒视界),KV 6.9k token,显存 18.9GB | 保留全部视角:P95 达 1.05 秒/视频秒,KV 92.6k token | P95 延迟约 3.6 倍加速,缓存缩小 13 倍且不再增长 |
局限与改进
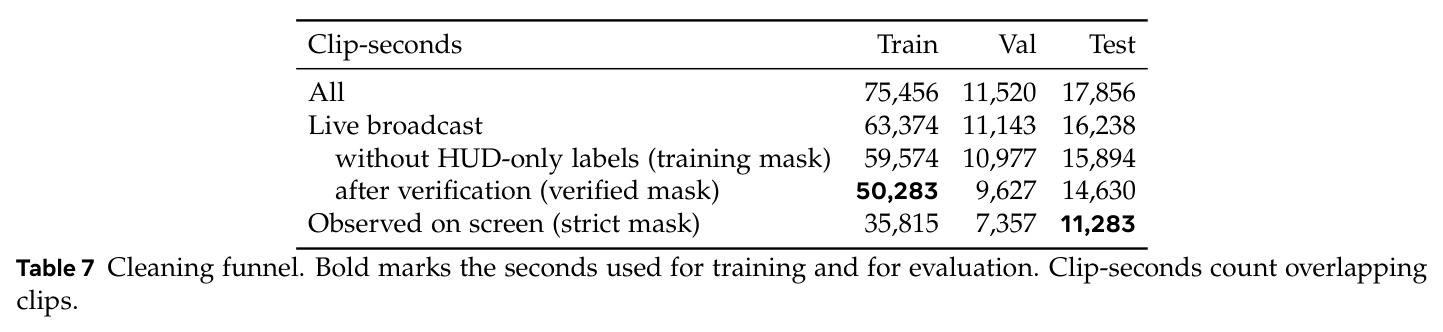
局限如下。(1) 数据规模小:仅 27 场职业 Dota 2 比赛(20 训练/3 校准/4 测试),Top-1 26.95 意味着与人类导播仍有约七成秒级不一致,作者也承认扩展曲线未饱和、需数百场。(2) 设定单一:只在 Dota 2 上验证,状态 token 与事件锚定强依赖回放文件的结构化游戏状态,迁移到无此类数据的游戏或传统体育并不显然。(3) 标签噪声:导播标签靠 HUD OCR 与 VLM 验证,延续标签仅 62% 被确认,严格评测掩码只保留 69% 的 LIVE 秒;Any-visible 41.8% 也部分反映多路镜头同屏时的标注模糊。(4) 解说指标各有偏置:F1 奖励极端说话率(Proact-VL 说话 99.9% 得 83.21 高于 DirCast 的 78.22),Fidelity 奖励沉默(MMDuet 说话 10.1%),论文靠多指标拼图论证优势。(5) 评判依赖 GPT-5(官方判官 GPT-5.1 不可用),LLM-as-judge 偏差未消除,也缺人类主观评估。(6) 36 秒视界丢弃一分钟前的一切,长程叙事连续性是否受损只有间接证据。
独立分析的弱点
(1) 导播天花板受纯模仿学习限制:Top-1 仅 27%,而人类导播本身经常“错”(击杀覆盖率仅 50.3%);事件锚定目标只是手工补丁,且与 Top-1 目标存在冲突(去掉它 Any-vis 反而从 41.80 升至 43.06)。改进方向:引入可学习的价值信号或观众反馈(弹幕热度、观看时长)替代纯模仿,直接优化“观众想看什么”。(2) 推理阈值 $\tau_0$、$\gamma$ 在仅 3 场验证赛上校准,对节奏迥异的比赛(路人局、其他 MOBA、FPS)泛化未知,可改为元学习或在线自整定。(3) 128px 低分辨率扫描十路画面可能漏掉细微前兆(隐身英雄绕后、回城预谋),事件锚定目前只覆盖击杀,推塔、买活、关键技能冷却、肉山争夺等未利用;可扩展事件词表并对高价值区域做细粒度注意力。(4) 扰动 rollout 只模拟数秒漂移,若错误节目持续数分钟,恢复行为未测试。(5) 解说评估完全依赖单一 LLM 判官与 GPT-4o 对手,缺少真人观众盲测,“胜率”的实际含金量存疑;建议补充小规模人类偏好实验。
未来方向
作者明确指出两条延伸:把训练集扩到数百场比赛——因为每场只需回放渲染加 VOD 对齐、无需人工标注,数据几乎免费——以及图 3 曲线未饱和说明导播能力仍有很大空间。在此基础上可延伸:(1) 跨游戏泛化,把 Dota 特定的状态 token 抽象为统一的“实体状态+事件流”接口,迁移到 LOL、Valorant 乃至足球篮球的多机位转播;(2) 双向耦合,把解说文本反过来作为导播信号(解说提到远处团战时触发切镜),或引入观众投票切镜头的交互式直播;(3) 长程记忆,在 36 秒视界之外加一个可检索的节目摘要记忆,支持“回顾上一波团战”式解说与赛后自动集锦;(4) 接入语音合成输出真实主播音色,训练多语言解说;(5) 把导播头(门控+指针只依赖低分辨率特征与状态 token)蒸馏成轻量端侧模型,做成业余直播的自动导播工具,这正对应当文指出的长尾赛事无人导播痛点。
复现评估
代码开源在 github.com/ZixianGao/DirCast-code,项目页 zixiangao.github.io/DirCast/。数据方面:27 场比赛的官方 VOD 与 .dem 回放均公开,附录详述完整管线——headless X server 上 10 个 Dota 2 客户端 Hero Chase 并行录制、HUD 时钟 OCR 对齐(残差约 0.3 秒)、Whisper large-v3-turbo 词级转写、GPT-5-mini 按句清洗加 70%-140% 字数守门——理论上可复现,但依赖游戏客户端自动化与 VOD 存量,工程量不小,清洗还需 API 成本。算力方面:训练需 8 张 H100 跑 Qwen3-VL-8B 的 LoRA 三个 epoch,属中等偏高门槛;推理单 GPU、每视频秒 0.29 秒、显存 18.9GB(36 秒视界),24GB 消费级显卡接近极限。评估依赖 Proact-VL 公开脚本与 GPT-5 判官 API。总体复现难度中高:学术实验室可完整复现,个人可跑通推理与评测、复现训练较困难。
论文图表
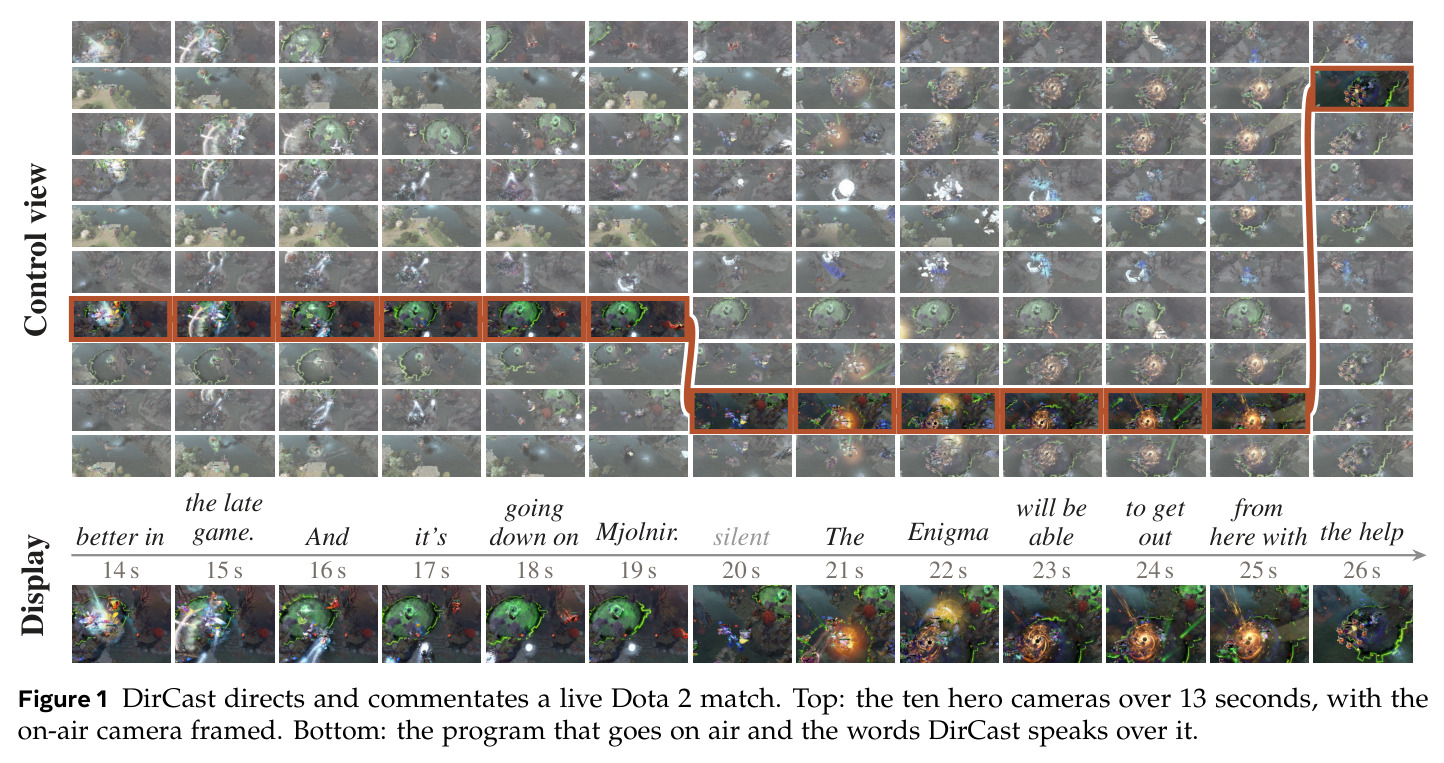
顶部展示 13 秒内十路英雄摄像机缩略图,其中被选为上屏的镜头加框标出;底部是实际播出的节目序列与 DirCast 在每一秒同步说出的解说词,例如在 22 秒 Pangolier 击杀 Clockwerk 时切到该镜头并解说。
一图看懂任务设定:输入是十路原始摄像头,输出是逐秒的导播决策加上与决策同步的实时解说,直观呈现“自导自播自解说”的完整闭环。