StreamEval:交互式流式视频生成模型评测基准 StreamEval: Evaluating Interactive Streaming Video Generation Models
首个交互式流式视频生成基准:五任务300案例评测38个模型
前置知识
流式视频生成(Streaming Video Generation)
模型不一次性生成完整视频,而是增量地逐段产出画面,可在会话进行中接受新的用户输入(语音、文本、参考图)并据此调整后续内容。典型实现依赖因果注意力与少步扩散蒸馏(如 Self Forcing、CausVid)达到近实时渲染,支撑对话化身、可控虚拟世界和直播视频编辑等应用。
本文评测的对象正是这类系统,理解其「边生成边响应」的工作方式,才能理解为何需要专门的会话级、增量输入评测协议。
任务执行与状态一致性
流式交互中每条请求都有时间与范围要求:何时生效、改变什么、什么必须保持不变。任务执行指系统按要求完成操作;状态一致性指新请求到来时已建立的效果不被破坏、未受影响的内容保持原样,例如第二轮编辑必须保留第一轮建立的修改,移除请求要恢复当时的源状态。
这是 StreamEval 区别于纯画质评测的核心维度,全文的指标设计与「好看不等于听话」的结论都围绕它展开。
LLM/VLM-as-a-Judge
用大型视觉-语言模型代替人类对生成内容打分:把输出片段与验收判据交给裁判模型,返回结构化的缺陷类别、严重等级和支持时间戳。本文用 Qwen3.8-Max-0902 与 Qwen3-VL-Plus 做身份与视觉裁判,并用阳性/阴性探针校准到假阳性≤5%、假阴性≤10%、未解决判定≤10%。
StreamEval 的十项指标几乎全部由自动裁判驱动,理解其校准方式与取低分等防偏设计,是评估排行榜结果可信度的前提。
音画同步(A–V Sync)
衡量生成视频中口型动作与语音能量的对齐程度。常用做法是计算唇部开度序列与音频包络的相关系数,并在允许的系统偏移范围内搜索最佳对齐点。本文要求相关系数≥0.3,且用 2000 次 session-bootstrap 得到的 95% 置信区间落在 ±200ms 内,搜索步长 10ms。
对话与化身表演任务的关键指标,实验中多个「画质高但同步差」的模型分化正是由这项指标揭示的。
指令编辑与参考编辑
指令编辑用文本描述对持续前进的源视频做改动;参考编辑改用图像指定目标外观。两者都要求只改动目标区域、保护非目标内容与源运动,移除请求则恢复当时的源画面。流式设定下编辑必须跟随不断推进的源视频,而非对固定片段做一次性修改。
这是五任务中得分最低的两类,理解其多重约束(范围、时机、持久性、保护内容)才能读懂 Edit Success 最高仅 15 分的现象。
研究动机
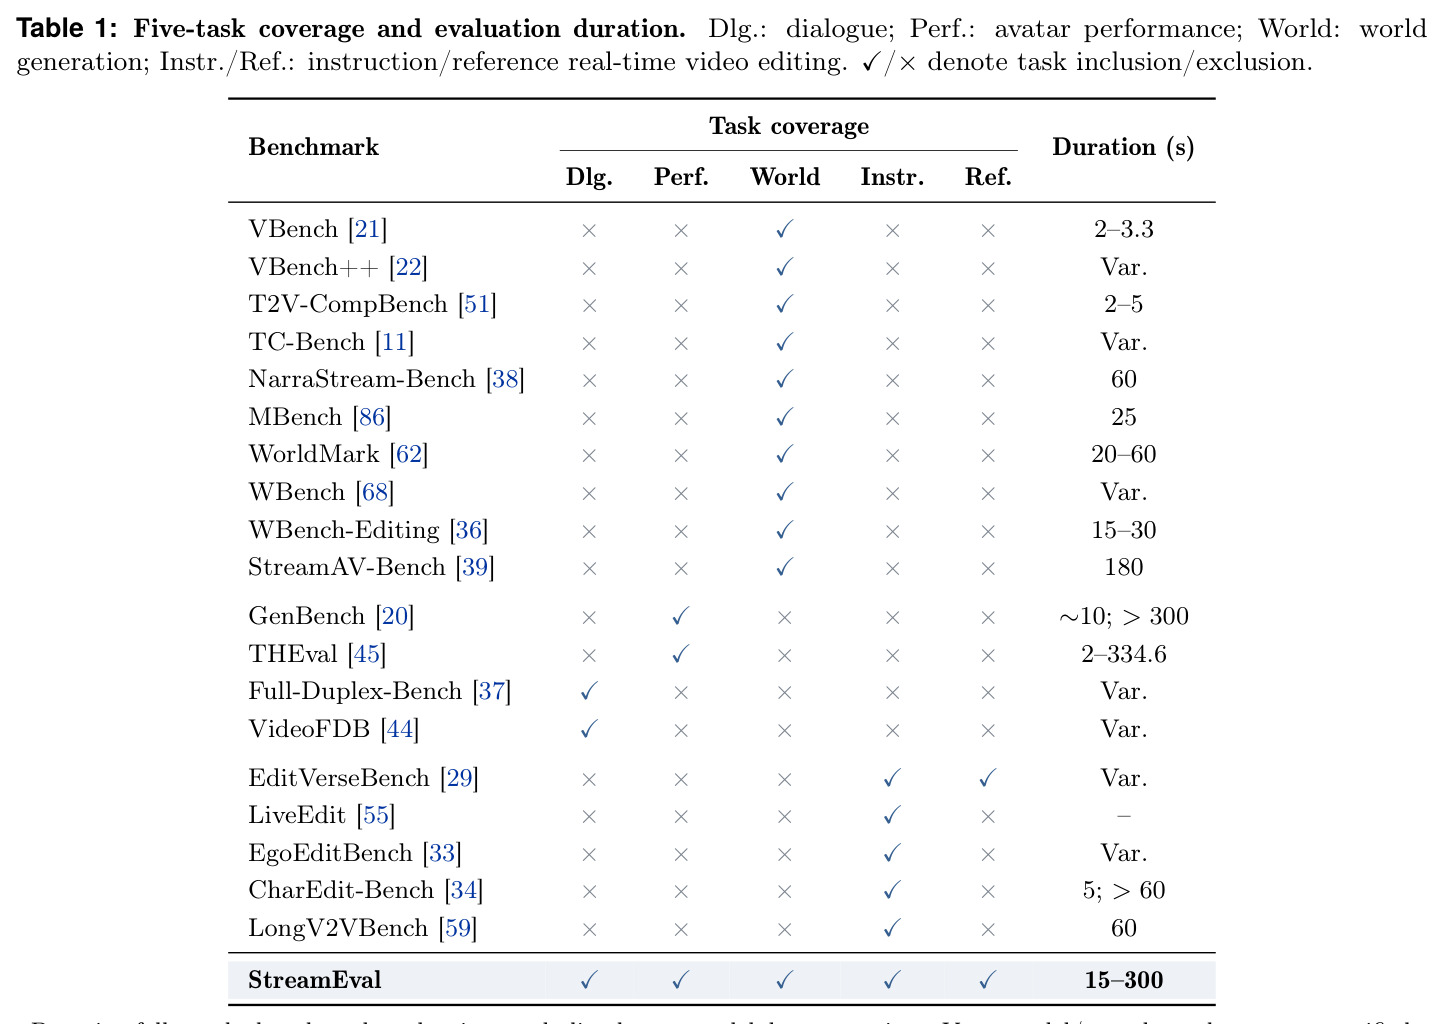
流式视频生成正在从「生成一段好看的片段」走向「与会话中的用户实时互动」:对话化身要回应语音同时保持身份与对话历史,生成式世界要接受新控制而不破坏无关场景,直播编辑要在源视频持续前进时施加、更新和撤销改动。然而现有评测高度碎片化:VBench、EvalCrafter 只考察视觉质量与时序行为;T2V-CompBench 只评组合对齐;WBench 与 WBench-Editing 的多轮控制局限于世界模型环境且时长仅 15–30 秒;StreamAV-Bench 评估流式更新与状态保留但止步于 180 秒 rollout 且不含任何编辑任务;LongV2VBench 测试长视频编辑但只有 60 秒;VideoFDB 聚焦全双工对话的非语言线索,不考察任务导向的执行。没有一个基准能把化身交互、世界生成、实时编辑放进统一框架,也普遍缺少显式的「请求执行 + 状态保留」双重判据,导致模型宣传的高视觉质量无法回答两个更根本的问题:它到底听不听指令?记不记得住之前做过什么?
本文的目标是构建首个统一的交互式流式视频生成评测基准,目标可拆成四个可量化部分:其一,覆盖数字人对话、化身表演、世界生成、指令编辑、参考编辑五类任务;其二,提供 300 个脚本化测试用例,每个代表 15 到 300 秒的交互会话,并在五个时长档上均衡分布(每任务 60 例、每档 12 例),一次完整评测相当于 525 分钟主动流式生成;其三,定义 10 个任务相关指标,沿任务执行、状态一致性、视觉保真、音画协调四个互补维度评分,并用假阳性≤5%、假阴性≤10% 的校准约束自动裁判;其四,用同一协议评测 38 个模型、49 个任务配置,基准数据、评测代码、协议与评分规则全部开源并按月更新排行榜。终极问题只有一个:高视觉质量、身份保持与可靠的请求执行、持续状态一致性是否同时成立。
与已有工作不同的是,本文的独特切入是把「增量到达的输入」与「显式的状态要求」绑定成每个测试用例的原子结构,有三个被既有工作忽视的点。第一,输入按会话时钟增量释放,而非一次性给出全部条件,逼系统在信息不全的情况下实时响应,这更贴近真实交互产品。第二,每个用例附带人工撰写的预言机,明确列出每个检查点应建立、保留、取消或恢复什么,使「保留第一轮编辑」「移除后恢复源状态」这类状态要求可以被程序化验证,而非依赖裁判的主观印象。第三,评分规则系统性地防刷分:缺失输出与不支持的操作记零分,所有计划控制机会——包括未触发的触发器和超出供应商会话上限的控制——都留在分母,杜绝「不做就不扣」的投机策略;未解决判定贡献区间(下界 0、上界 100)且表格报告下界,宁严勿松。此外 300 秒编辑用例相当于 LongV2VBench 时长的五倍扩展。
核心方法
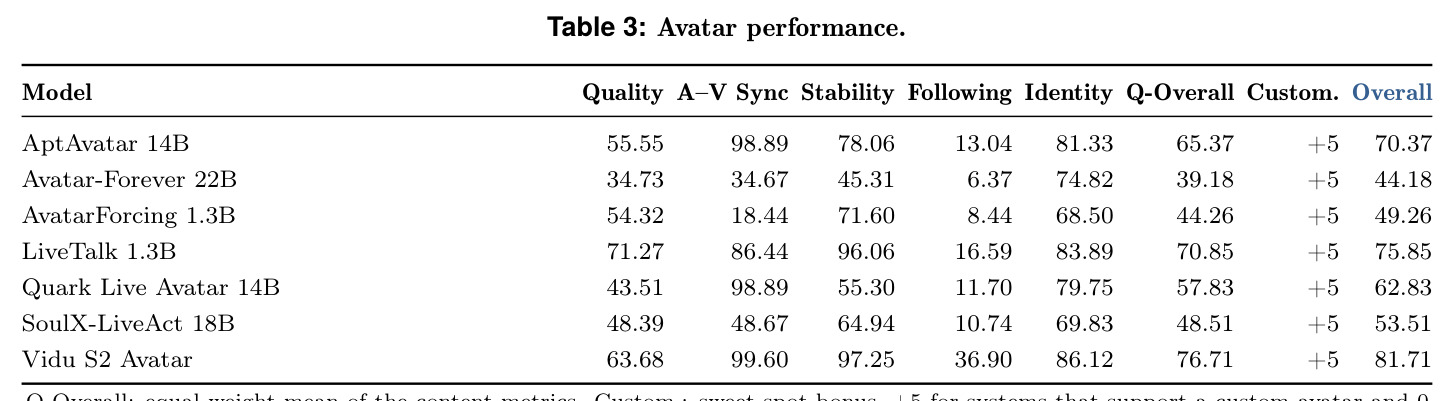
直觉上,StreamEval 像一场「科目三路考」而非「静态摄影比赛」:不只看画面漂不漂亮(视觉保真),更看司机听不听导航指令(任务执行)、是否记得刚做过的操作(状态一致性)、动作与语音是否合拍(音画协调)。技术路线上,基准由 300 个脚本化测试用例构成,每个任务 60 个,均衡分布在 15/30/60/120/300 秒五个时长档(每档 12 例),横跨 240 个独立源族,共 1347 个计划在线事件。输入由调度器按会话时钟增量释放;十项指标按四个维度组织;聚合时先平均每个用例的 3 次独立重复,再平均档内用例,最后对五个时长档等权平均:$S_m = \frac{1}{|D|}\sum_{d\in D}\frac{1}{|C_{d,m}|}\sum_{c\in C_{d,m}}\frac{1}{3}\sum_{r=1}^{3}s_{c,r,m}$,因此 300 秒长会话不会因为时长而在总分里占便宜。任务总分 Q-Overall 为适用指标的等权平均,化身类任务额外加自定义化身 +5 分奖励后得到 Overall(最高可到 105 分),把接口能力与底层指标分开。
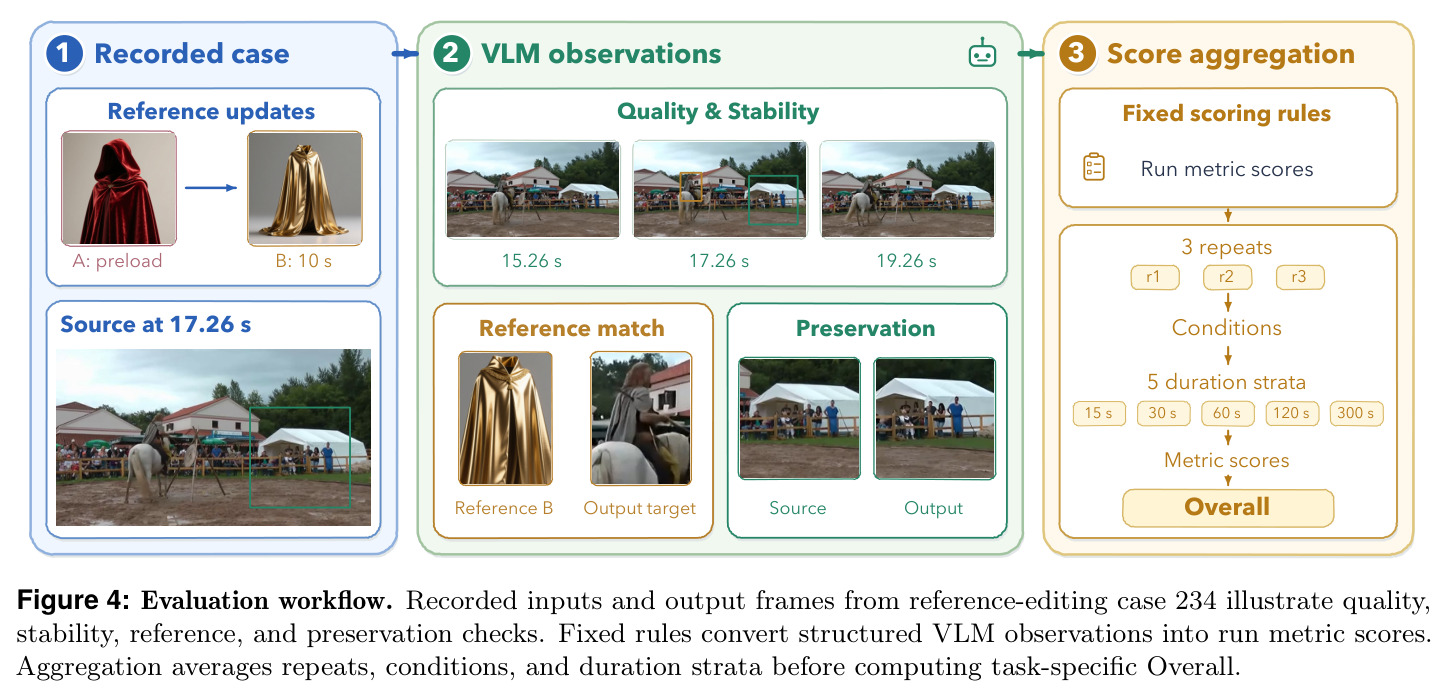
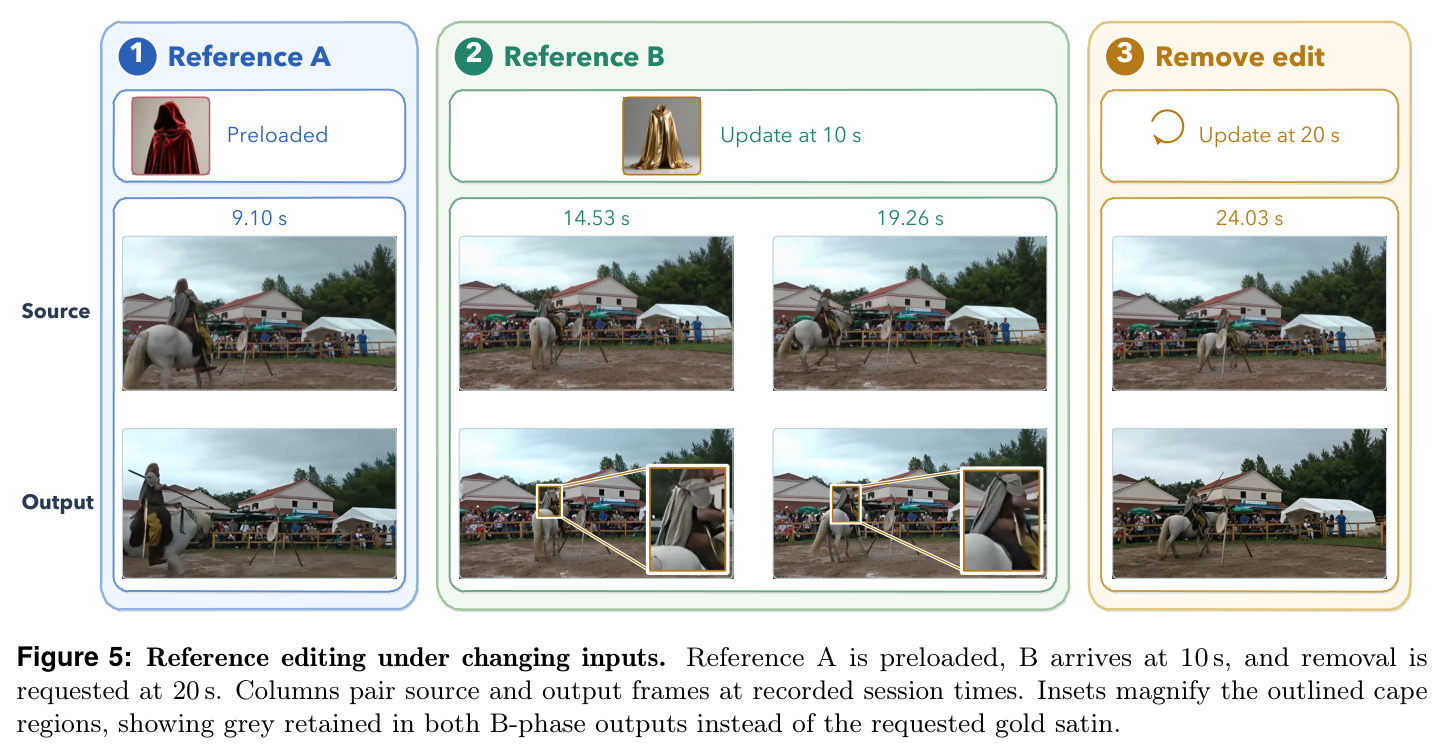
核心创新有三层。第一,统一框架:首次把化身交互(对话 + 表演)、世界生成、实时视频编辑(指令 + 参考)纳入同一基准与同一会话协议,此前这些能力由互不相通的评测分别覆盖,StreamEval 是唯一五任务全覆盖且时长上探 300 秒的工作。第二,预言机驱动的状态验证:每个用例不仅规定「何时来什么输入」,还规定每个检查点上哪些内容必须成立——例如参考编辑要求预载红丝绒斗篷、10 秒切换金色缎面、20 秒移除后恢复灰色源状态——固定评分规则把裁判的结构化视觉观察机械地转为分数,而非让裁判自由发挥。第三,防作弊的评分设计:所有计划控制机会保留在分母(含未触发的触发器、超会话上限的请求);未解决判定报告区间下界;化身任务的「甜点位奖励」用 +5 分把「是否支持自定义化身」这一产品能力与 Quality、Following 等指标分离,避免厂商用接口功能掩盖模型短板。这套设计使「高画质但低执行」的分离第一次被系统地量化出来。
方法步骤详情
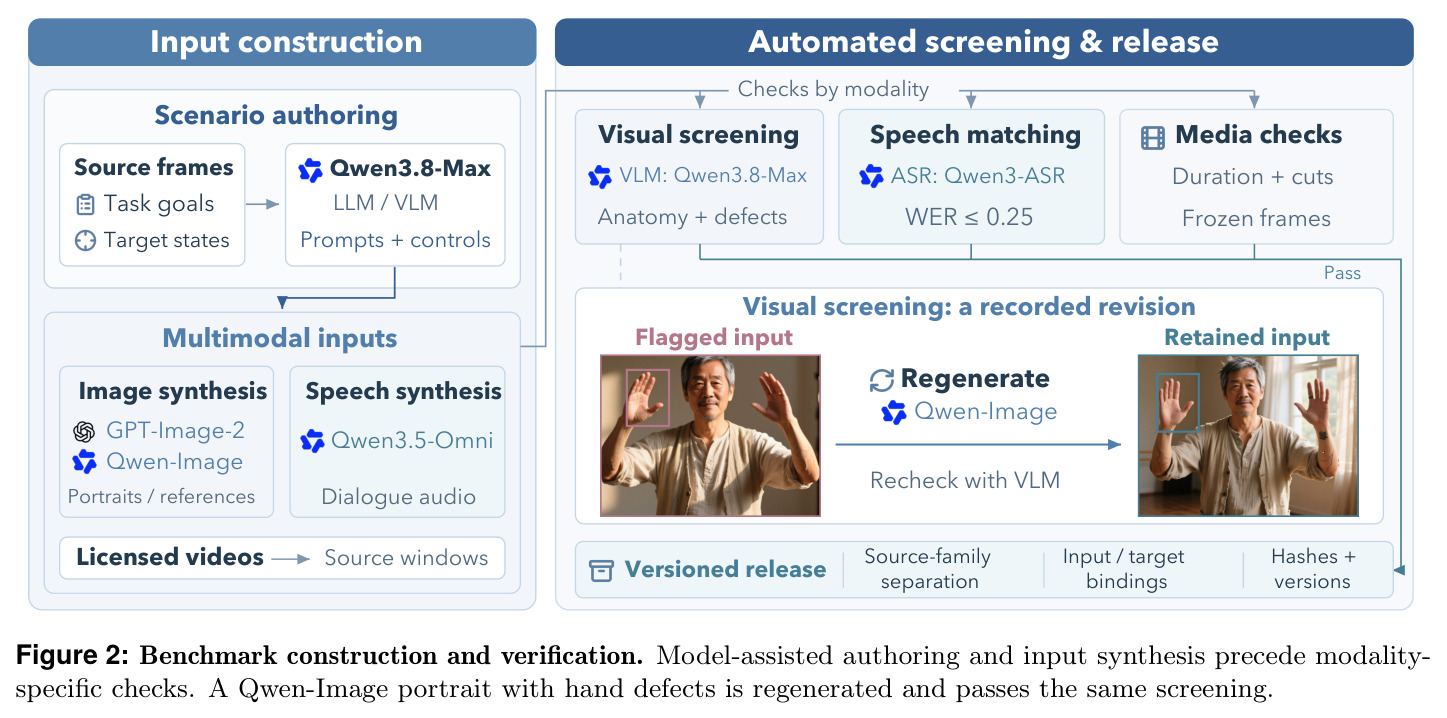
构建与评测分七步。① 场景编写:Qwen3.8-Max 起草会话目标、定时控制、保护属性与预期结果,人工撰写预言机,明确每个检查点应建立、保留、取消或恢复什么。② 媒体合成:GPT-Image-2 与 Qwen-Image 合成肖像与视觉参考(覆盖写实、风格化 3D、动漫、黏土等形象),Qwen3.5-Omni 生成干净、带噪声与混响的语音;编辑源视频采用授权实拍、动画与合成场景(Wikimedia Commons、NASA、Blender Studio),保证无循环、无变速、无拼接。③ 自动筛查:Qwen3-ASR 转写合成语音,归一化词错误率须≤0.25;Qwen3.8-Max 审计图像主体清晰度与解剖缺陷,不合格样本重新生成并复检;源视频检查场景切换、冻结段与目标适配性。④ 评测执行:每用例每模型独立运行 3 次,调度器按时释放输入并推进编辑源。⑤ 指标计算:Quality 按主裁判缺陷列表给 5 秒片段评分 $r\in\{5,4,3,2,1\}$ 并映射为 $25(r-1)$ 分;A–V Sync 要求唇开度/音频包络相关≥0.3 且 95% 自助法区间落在 ±200ms 内;Identity 由两名裁判对同一初始化肖像取较低分。⑥ 裁判校准:阳性/阴性探针验证假阳性≤5%、假阴性≤10%、未解决≤10%。⑦ 聚合出榜:按等权公式逐级平均后计算 Q-Overall 与 Overall。
技术新颖性
与最接近的工作逐一对比可以看到明确增量:VBench/VBench++ 只评静态输出质量与运动,无交互输入;StreamAV-Bench 引入流式更新与状态保留,但时长止于 180 秒且不含编辑任务;LongV2VBench 测试 60 秒长视频编辑,但没有化身与世界生成,也没有增量输入协议;WBench-Editing 评估 15–30 秒世界环境的连续编辑,缺乏跨领域覆盖;VideoFDB 评测全双工对话感知,但不做任务导向的执行评分。StreamEval 的五任务 × 五时长档(最高 300 秒)设计在覆盖面与会话长度上均为首个。方法论上,等权时长档聚合、未解决判定区间下界报告、接口能力与指标分离的奖励设计、以及带哈希与版本绑定的发布流程,都是对现有排行榜评分惯例的实质性修正,而非简单堆任务。
实验结果
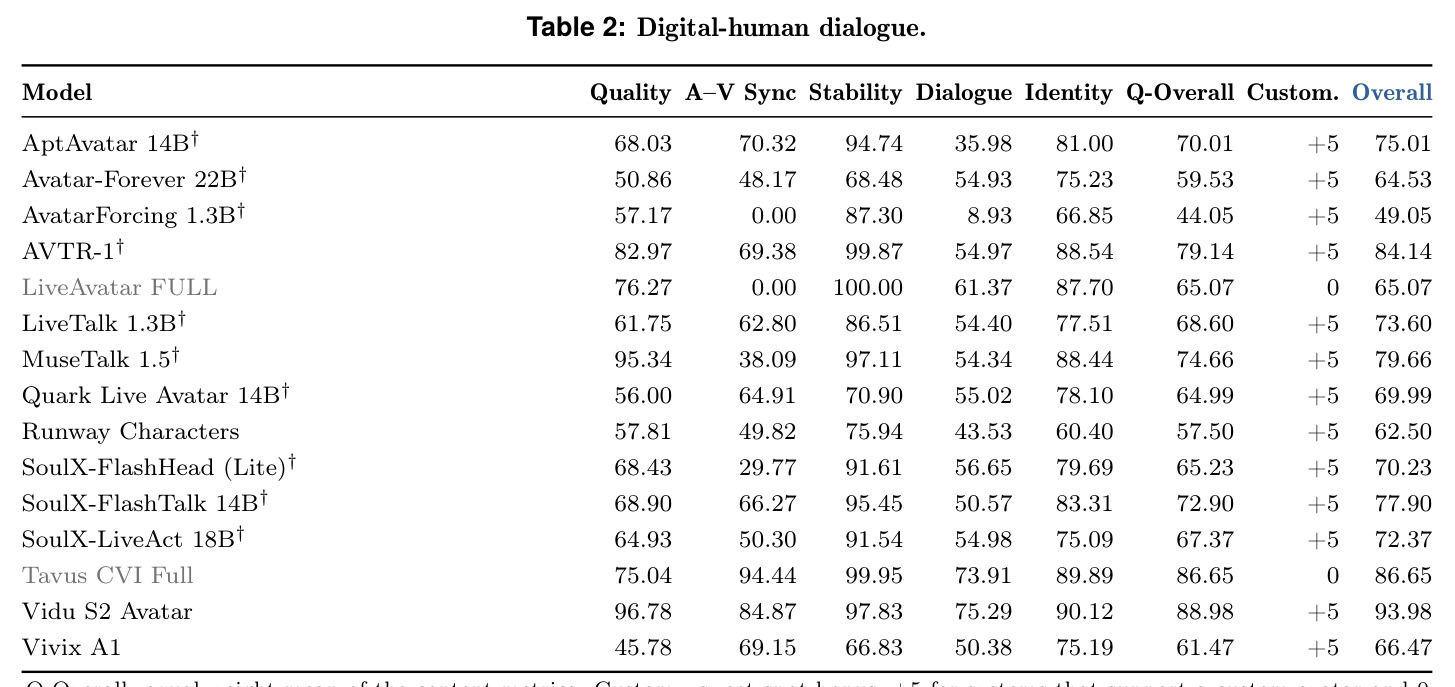
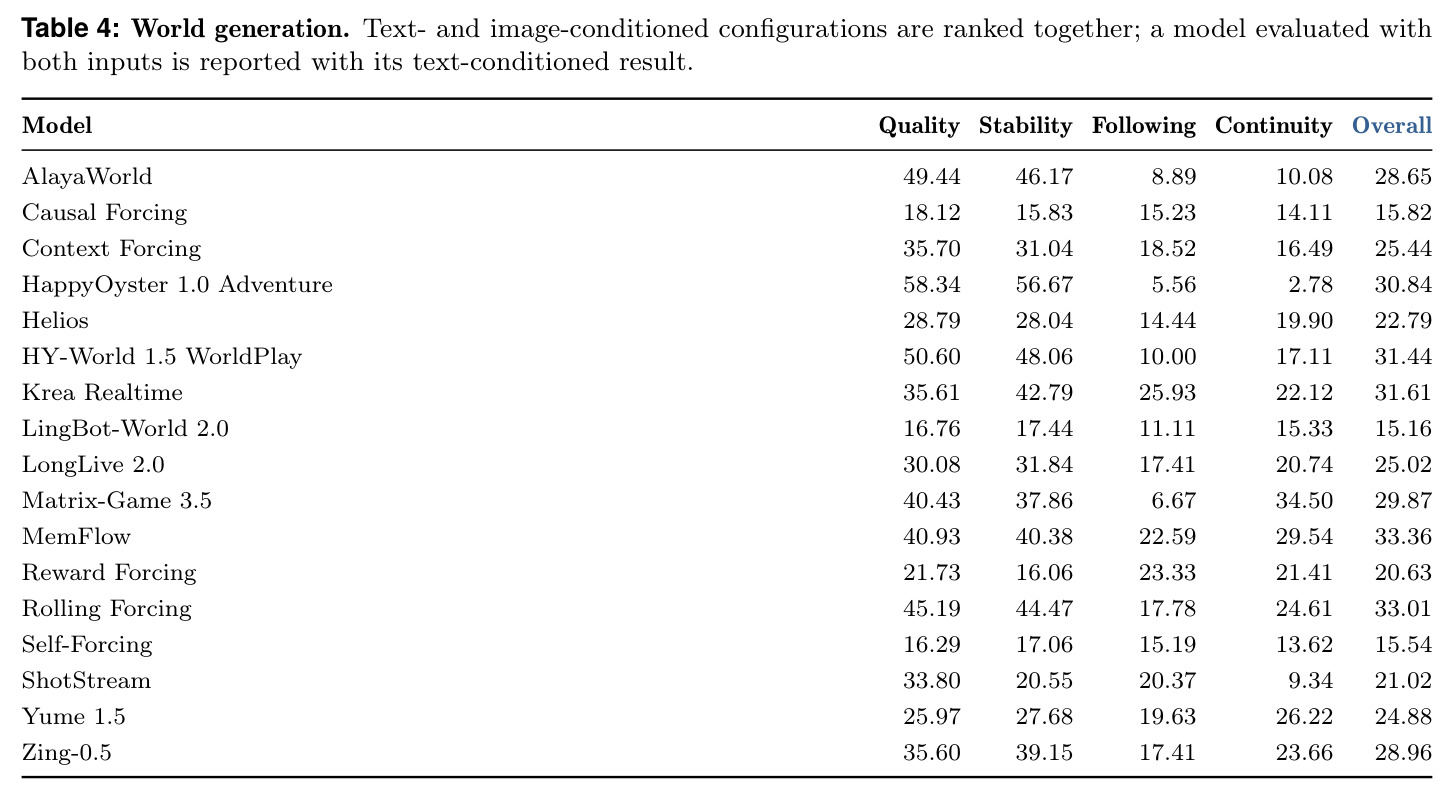
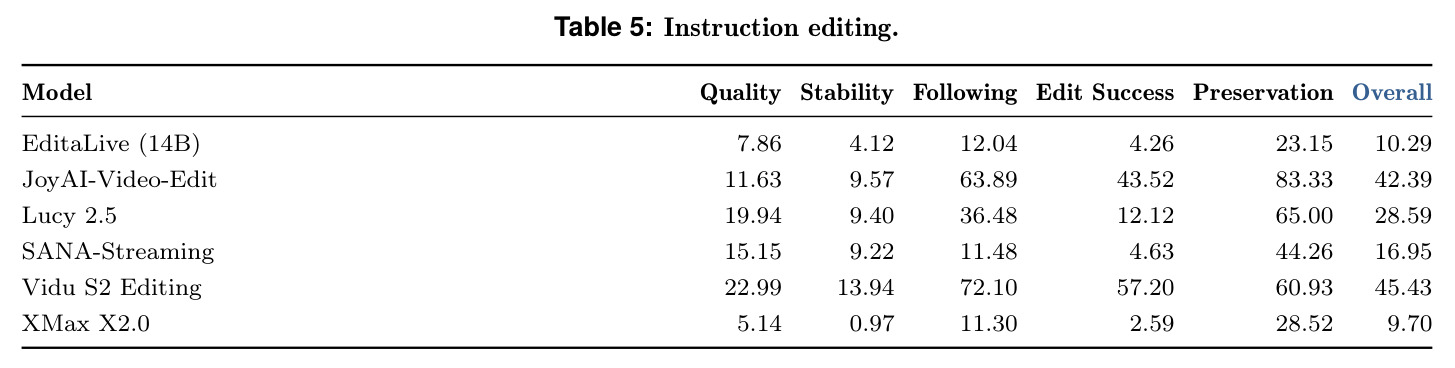
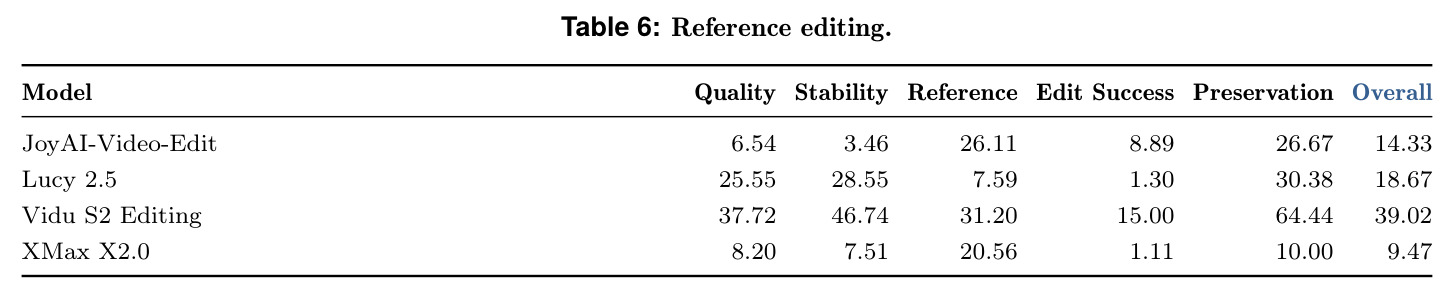
38 个模型、49 个任务配置的评测揭示了「好看 ≠ 听话」的系统性分离。数字人对话:Vidu S2 Avatar 以 Overall 93.98 居首(Q-Overall 88.98+5),Quality 96.78、Dialogue 75.29、Identity 90.12 均最高;MuseTalk 1.5 画质 95.34、Stability 97.11,但 A–V Sync 仅 38.09、Dialogue 54.34;固定化身的 Tavus CVI Full 达 86.65 且 A–V Sync 94.44 最高,而 LiveAvatar FULL Stability 满分 100 却 A–V Sync 为 0.00。化身表演:Vidu S2 Avatar 81.71(A–V Sync 99.60),但全部 7 个系统的 Following 仅在 6.37–36.90 之间,定时动作执行是普遍短板。世界生成:MemFlow 33.36 最高(其后 Rolling Forcing 33.01、Krea Realtime 31.61);HappyOyster 画质最好(58.34)但 Following 仅 5.56;Matrix-Game 3.5 Continuity 34.50 最高——各模型维度互补,榜首不足 35/100。指令编辑:Vidu S2 Editing 45.43 领先(Following 72.10、Edit Success 57.20)但 Quality 仅 22.99;JoyAI-Video-Edit 42.39 且 Preservation 83.33 最高。参考编辑:Vidu S2 Editing 39.02 居首,Lucy 2.5 仅 18.67;全场最高 Edit Success 仅 15.00,图 5 显示参考切换为金色缎面后模型仍保留灰色斗篷——「采纳参考」与「保留源」严重失衡。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 数字人对话(15 个配置) | Overall(Q-Overall + 化身奖励) | Vidu S2 Avatar:93.98(Quality 96.78,Dialogue 75.29,Identity 90.12) | 次高 AVTR-1:84.14;固定化身最高 Tavus CVI Full:86.65(A–V Sync 94.44) | 领先次高 9.84 分 |
| 化身表演(7 个配置) | Overall / Following(定时动作执行) | Vidu S2 Avatar:81.71,Following 36.90(全场最高) | 次高 LiveTalk 1.3B:75.85,Following 仅 16.59;全场 Following 区间 6.37–36.90 | Overall 领先 5.86 分;但所有系统 Following 均不足 40/100 |
| 世界生成(17 个配置) | Overall(Quality/Stability/Following/Continuity 等权均值) | MemFlow:33.36(Following 22.59,Continuity 29.54) | 次高 Rolling Forcing 33.01、Krea Realtime 31.61;画质最佳 HappyOyster:Quality 58.34 但 Following 仅 5.56 | 榜首不足 35/100,指令跟随与状态连续性普遍薄弱 |
| 指令编辑(6 个配置) | Overall / Following / Edit Success | Vidu S2 Editing:45.43(Following 72.10,Edit Success 57.20 最高) | 次高 JoyAI-Video-Edit:42.39(Preservation 83.33 最高);Lucy 2.5 仅 28.59 | 领先 3.04 分;头部两模型与其余四个(≤28.59)拉开明显差距 |
| 参考编辑(4 个配置) | Overall / Edit Success(完整编辑契约) | Vidu S2 Editing:39.02(Reference 31.20,Preservation 64.44) | 次高 Lucy 2.5:18.67;JoyAI-Video-Edit 14.33;XMax X2.0 9.47 | 领先 20.35 分;但全场最高 Edit Success 仅 15.00/100 |
局限与改进
作者坦承的局限:所有评分依赖自动裁判,结论明确指出下一步需要收集人类成对判断来检验与评分规则的契合度;基准未覆盖更广的身份与环境、全局重置、以及并发编辑尚活跃时的选择性恢复;A–V Sync 受稀疏采样限制(对话 500 毫秒、表演 250 毫秒),时间分辨率有限;LiveAvatar FULL 与 Tavus CVI Full 因接口不支持自定义化身而使用固定形象,身份分只能对照系统自身首帧,与其他系统不完全可比。我补充几点观察:其一,编辑类榜单只呈现 Overall≥5 的配置子集且是评测完成后筛选的,存在幸存者偏差,可能反而低估了整体水平的惨淡程度;其二,「支持自定义化身 +5 分」把产品功能混入能力排名,对仅提供固定形象的系统并不公平;其三,未解决判定按区间下界报告,裁判不确定时会系统性压低分数;其四,闭源模型会话上限之外的请求记零分,惩罚的是接口限制而非模型能力本身。
独立分析的弱点
第一,裁判与被评对象可能同源:视觉裁判、数据筛查甚至用例起草都大量使用 Qwen 系模型(Qwen3.8-Max、Qwen3-VL-Plus、Qwen3-ASR),即便校准了假阳性≤5%,仍可能存在难以察觉的系统性风格偏好。改进方向:引入异构裁判家族交叉验证,并公开一批人类标注锚点用例供持续回归。第二,五时长档等权聚合让 300 秒会话与 15 秒会话权重完全相同,无法反映真实产品中的时长分布,长会话后半段的崩坏可能被短会话稀释。改进:并行报告按时长加权的次要指标与会话分段曲线。第三,参考编辑的 Edit Success 极低(最高 15.00)既可能是模型能力不足,也可能是判据过严或用例过难,论文缺少人类对照来定位原因。改进:对若干代表性用例做人类重评,报告人机一致率与分歧案例。第四,闭源商业模型接口黑箱(会话上限、固定化身、采样参数不可控)限制了公平比较。改进:为受限接口单独分组,或在榜上显著标注协议差异与超时扣分占比。
未来方向
作者提出的方向:按月更新排行榜,持续纳入新发布与更新的模型;收集人类成对偏好判断,检验其与任务评分规则的一致性;扩展基准覆盖更广的身份与环境、全局重置、以及并发编辑保持活跃时的选择性恢复。基于本文成果可以进一步延伸:把客户端可感知指标(首帧延迟、请求响应延迟、会话吞吐)纳入评分,呼应相关工作里 TurboServe 的有状态会话调度方向;与 VideoFDB 的全双工感知评测互补,加入对用户视频流的感知要求;将预言机的模型自动起草与纯人工撰写做消融,量化起草模型带来的偏置;引入物理与常识一致性维度(VBench-2.0 方向),考察生成世界在长会话中的可信度;为文本对话衍生物之外增加多语言语音输入,检验跨语言与口音鲁棒性;对「执行/保留/画质」三角做敏感性分析,帮助模型团队定位该优先修哪个维度。
复现评估
开源程度较高:基准数据发布在 HuggingFace(StreamEval/StreamEvalAbstract),评测代码、协议与评分规则在 GitHub(StreamEval/StreamEval),排行榜在 streameval.ai 并承诺按月更新;数据集含 240 个独立源族,每个用例的时间线、预言机与媒体全部随发布提供,第三方素材逐项附许可与署名。复现成本主要在算力与 API:完整跑一遍 300 个视频会话用例等于 525 分钟主动流式生成,每用例还需 3 次重复,评测一个模型的一个任务即 60 用例 × 3 次,300 秒长会话的推理开销可观。裁判依赖 Qwen3.8-Max-0902、Qwen3-VL-Plus、Qwen3-ASR 等商业 API,存在费用与版本漂移风险,这也影响跨时间复现的一致性。总体评估:复现单模型单任务是现实的(中低难度),复现或扩展整个 38 模型排行榜则受制于商业接口稳定性(中高难度);自建新用例需要图像合成、语音合成与筛查管线,工程量中等。
论文图表
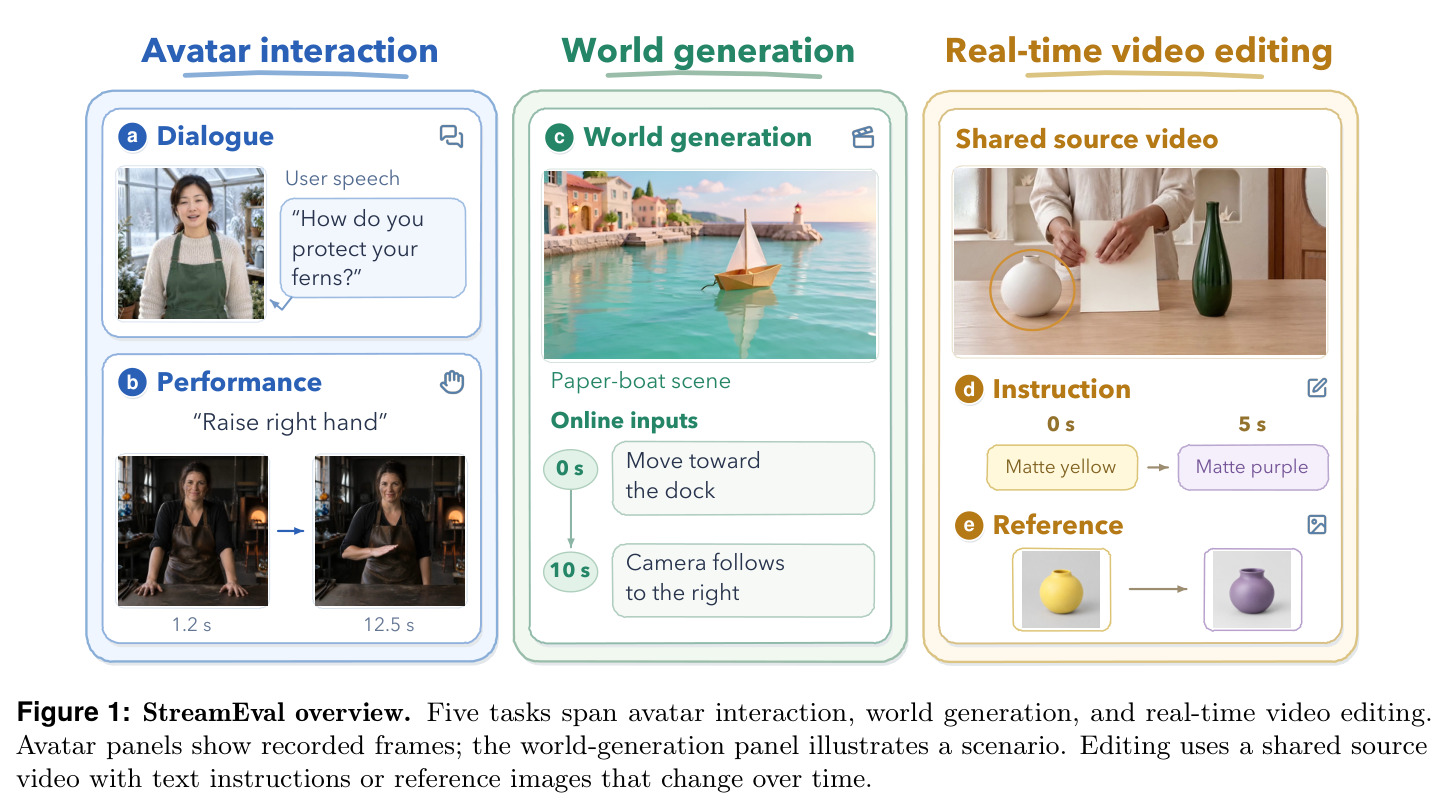
四面板总览五个任务:化身对话展示用户语音提问(How do you protect your ferns?)与化身实时回应;化身表演展示指令 Raise right hand 的执行;世界生成展示纸船场景随在线输入演进(10 秒驶向码头、12.5 秒镜头跟随);实时编辑展示共享源视频随时间接受文本指令或参考图更新。
一张图建立对五任务输入输出形态的直觉,是理解全文评测协议的地图。
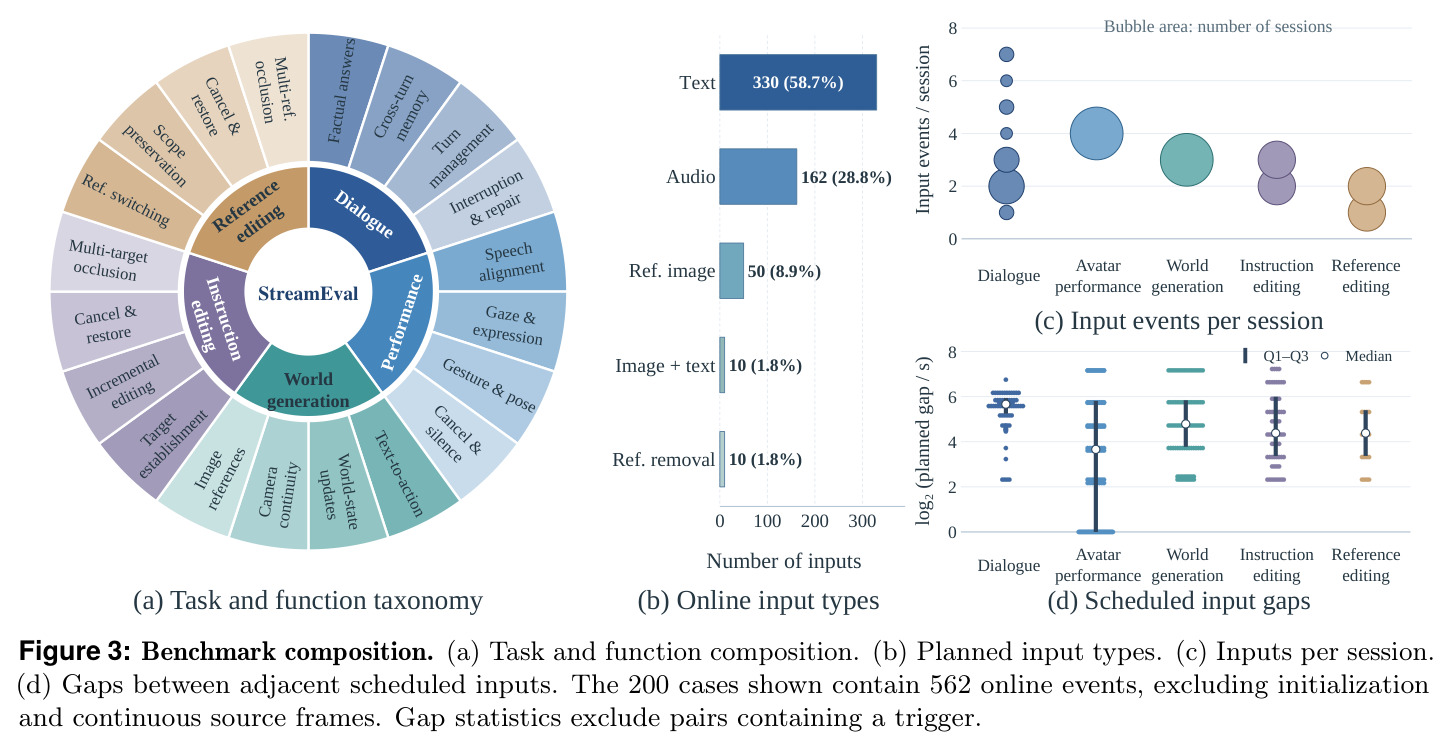
四个子图:(a) 任务与功能分类树(对话含事实问答、跨轮记忆、插话打断;编辑含多目标、参考切换、取消与恢复等);(b) 计划输入类型分布(文本 330 个占 58.7%、语音 162 个占 28.8%、参考图 50 个占 8.9% 等);(c) 每会话输入事件数分布;(d) 相邻计划输入间隔(对数尺度)。展示的 200 个用例共含 562 个在线事件。
量化交互负载与多样性——每会话多少事件、间隔多密——是理解任务难度与协议公平性的数据基础。