StreamDuo:直播解说员与研究智能体协同的未见游戏解说 StreamDuo: A Live Commentator and a Research Agent for Unseen Games
单游戏训练的解说员搭配查Wiki研究智能体,未见游戏实体召回0.082升至0.116
前置知识
流式视频LLM(Streaming Video LLM)
逐帧(或逐秒)接收无限长视频流的视觉语言模型,每个时间步自主决定是否输出回复,而非等整段视频结束后再回答。代表工作有 VideoLLM-online、LiveCC、Dispider、MMDuet2 等,通常在每回合末尾设一个 flag token,其隐状态接入一个二分类头来输出「此刻是否该说话」的概率。
本文的解说员就是一个流式视频LLM,论文的说话/提问双头设计、每秒一回合的交互协议都建立在这个范式上,不熟悉它就看不懂方法的输入输出结构。
检索增强生成(RAG)
在模型生成前把外部知识库检索到的文本拼进上下文,让模型引用库中事实作答。经典做法是稠密向量检索或 BM25 稀疏检索,检索时机可以是固定频率、也可以按模型不确定性自适应触发。
StreamDuo 的研究智能体本质上是一个视觉RAG(看帧→提搜索词→BM25 查Wiki→核验→返回词条),但论文证明了传统「开局塞一份游戏档案」的静态RAG对直播几乎无效(K-strict 仅 +0.003),这正是本文动机所在。
在策略自蒸馏(On-policy Self-Distillation, OPSD)
同一模型既是教师也是学生:教师是参数冻结的副本,但能看到测试时拿不到的特权信息(本文中是含正确答案的理想词条);学生在教师指导下,对自己采样出的句子逐token最小化 KL 散度。与在人类参考句上做SFT不同,学生被纠正的是它自己真正会说的输出分布。
Stage 2 的核心训练算法。论文实验显示 OPSD 贡献了最大涨幅(实体召回 0.092→0.116),而直接在真实答案上SFT反而让召回降到 0.086,说明不理解OPSD就无法理解本文为什么有效。
逆向KL散度(Reverse KL)与模式寻求
$D_{KL}(p\|q)=\sum_x p(x)\log\frac{p(x)}{q(x)}$,第一项是目标(教师)分布。对目标分布求期望会惩罚「教师认为可能、学生却给了低概率」的token,学生倾向于把概率质量集中在教师最认可的少数模式上(mode-seeking),而不是铺满教师允许的所有模式(mode-covering,即正向KL的行为)。
本文 Fig 4 的关键消融:正向KL让学生见词就说,源游戏泄漏高达 19.3%;逆向KL让学生只采用与画面匹配的词条,泄漏仅 1.0%。理解两种KL的差异才能明白损失函数选择为何是成败关键。
信息增益(Information Gain)
本文定义为 $g_a=\log \pi_{\theta_0}(y_a\mid h_{\le a}, A^\star_a, v_{\le a})-\log \pi_{\theta_0}(y_a\mid h_{\le a}, v_{\le a})$:即冻结模型在有理想答案与无答案两种条件下,生成人类解说原句 $y_a$ 的对数概率之差,以 nat 为单位衡量答案对「说出正确内容」的帮助量。
这是「何时提问」标签的来源:只有 $g_a>\gamma=1$ nat 的时刻才被标注为提问点。它与naive标签(凡人类提到实体处都标注)的区别带来了实体召回 0.079→0.092 的提升,是Stage 1的灵魂。
特权信息蒸馏(Distillation with Privileged Information)
训练时让教师接触测试时不可得的信息(如标准答案、未来帧),教师的行为本身示范了「如何利用该信息」,再蒸馏给看不到特权信息的学生。教师不必更大,只需知道得更多。
StreamDuo 教师的唯一特权就是知道研究智能体返回的词条中哪一条是正确的。这是把「学会使用带噪检索结果」转化为可监督问题的巧思,也是本文标题 Duo(二人组)的深层含义。
研究动机
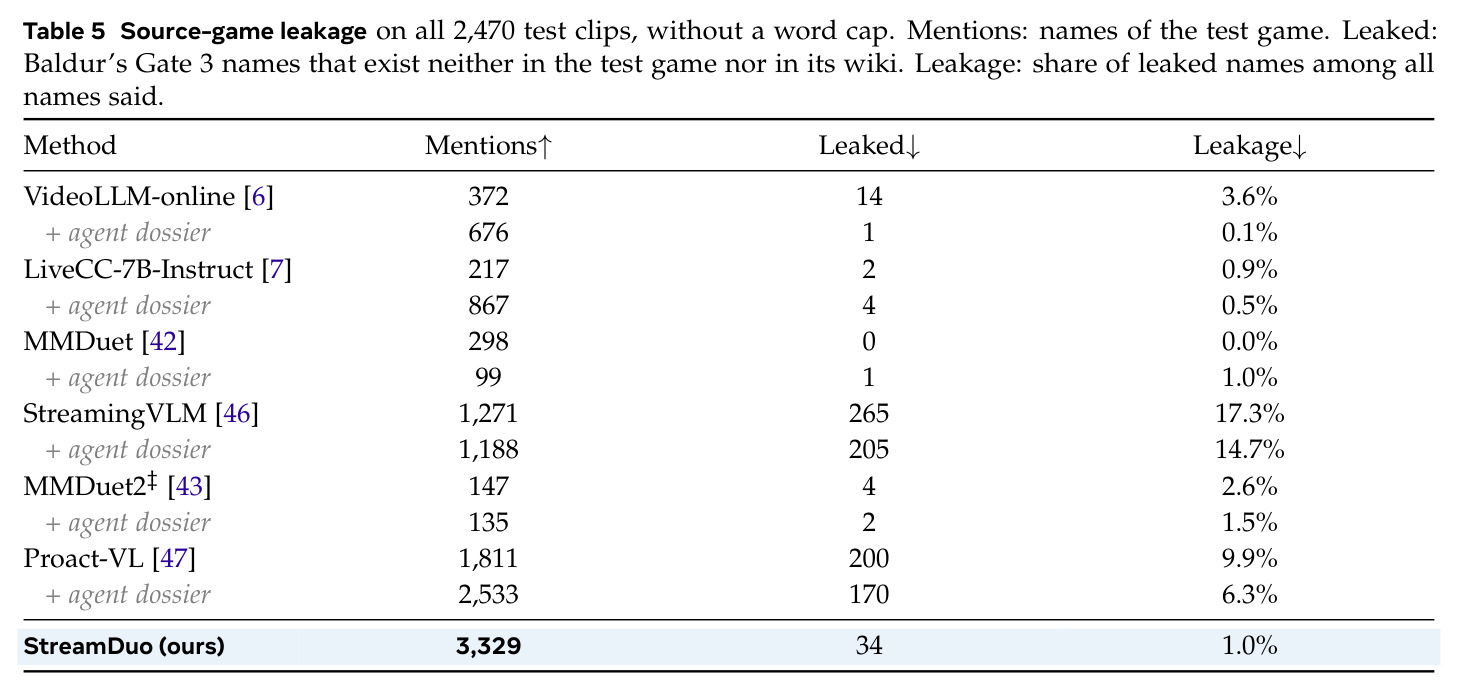
流式视频LLM已经能对直播游戏做实时解说,例如 Proact-VL 在多游戏基准上报告了很强的时机与质量,但这些系统无一例外是在同一批游戏上训练和评测的。真实直播中解说员时刻都在遇到没见过的标题、角色和道具,而让解说「有信息量」的实体恰恰是随游戏变化最大的部分。作者因此提出跨游戏流式解说设定:只在一个游戏上训练,在训练中从未出现的游戏上解说。这个设定暴露出一个清晰的失效模式——用 Baldur's Gate 3(BG3)的 10,286 个片段重训 Proact-VL 后,它在十个未见游戏(共 2,470 个片段)上的实体召回只有 0.082,甚至低于零样本的 LiveCC(0.099);更糟的是源游戏泄漏:它说出的实体名中 9.9%(2,011 次提及中的 200 次)是训练游戏的词,比如把《王国之泪》里的角色叫成 Karlach,在《英雄联盟》解说里泄漏率高达 54.6%。换言之,何时说话的能力跨游戏迁移得很好,但关于游戏世界的知识完全不能迁移,模型遇到陌生实体时宁可瞎编一个训练游戏的名字也不肯留白。
本文的目标是本文的目标是构建一个只在一个源游戏上训练、却能对任何拥有Wiki的游戏做高质量实时解说的系统,具体要同时做到三件事:第一,保留并强化跨游戏可迁移的时机感知能力(战斗爆发、菜单打开、镜头切换这类事件是游戏无关的),时间差 TimeDiff 和 F1 不能退化;第二,在直播进行中实时获取缺失的游戏世界知识,让模型能说出屏幕上陌生角色/道具/地点的名字,把实体召回和严格知识指标 K-strict 显著抬升;第三,让模型自己学会「什么时候值得问」——提问的决策必须依赖这个特定模型不知道什么,因为模型能可靠识别的主角不值得问,而分不清的两个Boss值得问;同时学会在答案延迟到达、且答案常常含噪(混入干扰词条甚至完全没命中)的现实条件下正确消费检索结果。此外还要量化并压制源游戏泄漏,给社区一个干净的可复用评测协议和泄漏指标。
与已有工作不同的是,把现成的RAG或工具使用agent嫁接到直播解说上有三个未被解决的矛盾,这构成了本文的独特切入角度。其一,静态知识无用:实验证明在开流前给模型一份游戏级档案(dossier),Proact-VL 的 K-strict 只从 0.085 升到 0.088(+0.003),因为档案覆盖全游戏却无法回答「此刻屏幕上是谁」;其二,高频检索淹没上下文:每秒都查会把长流上下文撑爆;其三,文本查询是死胡同:一个认不出眼前角色的模型,必然也无法把它描述成足以检索的文本——查询与无知自相矛盾。StreamDuo 对此的回应是三点组合:用帧本身作为查询(研究智能体用自己的视觉能力去识别,绕开描述难题)、接受答案延迟约2秒到达而流不等待(把异步性转化为模型必须学习的问题:提前问、答案到了会接)、以及最关键的——提问标签不来自「人类何时提到实体」这种模型无关的监督,而是来自模型自身的信息增益 $g_a>\gamma$,让「问什么、何时问」真正取决于这个模型的认知盲区。
核心方法
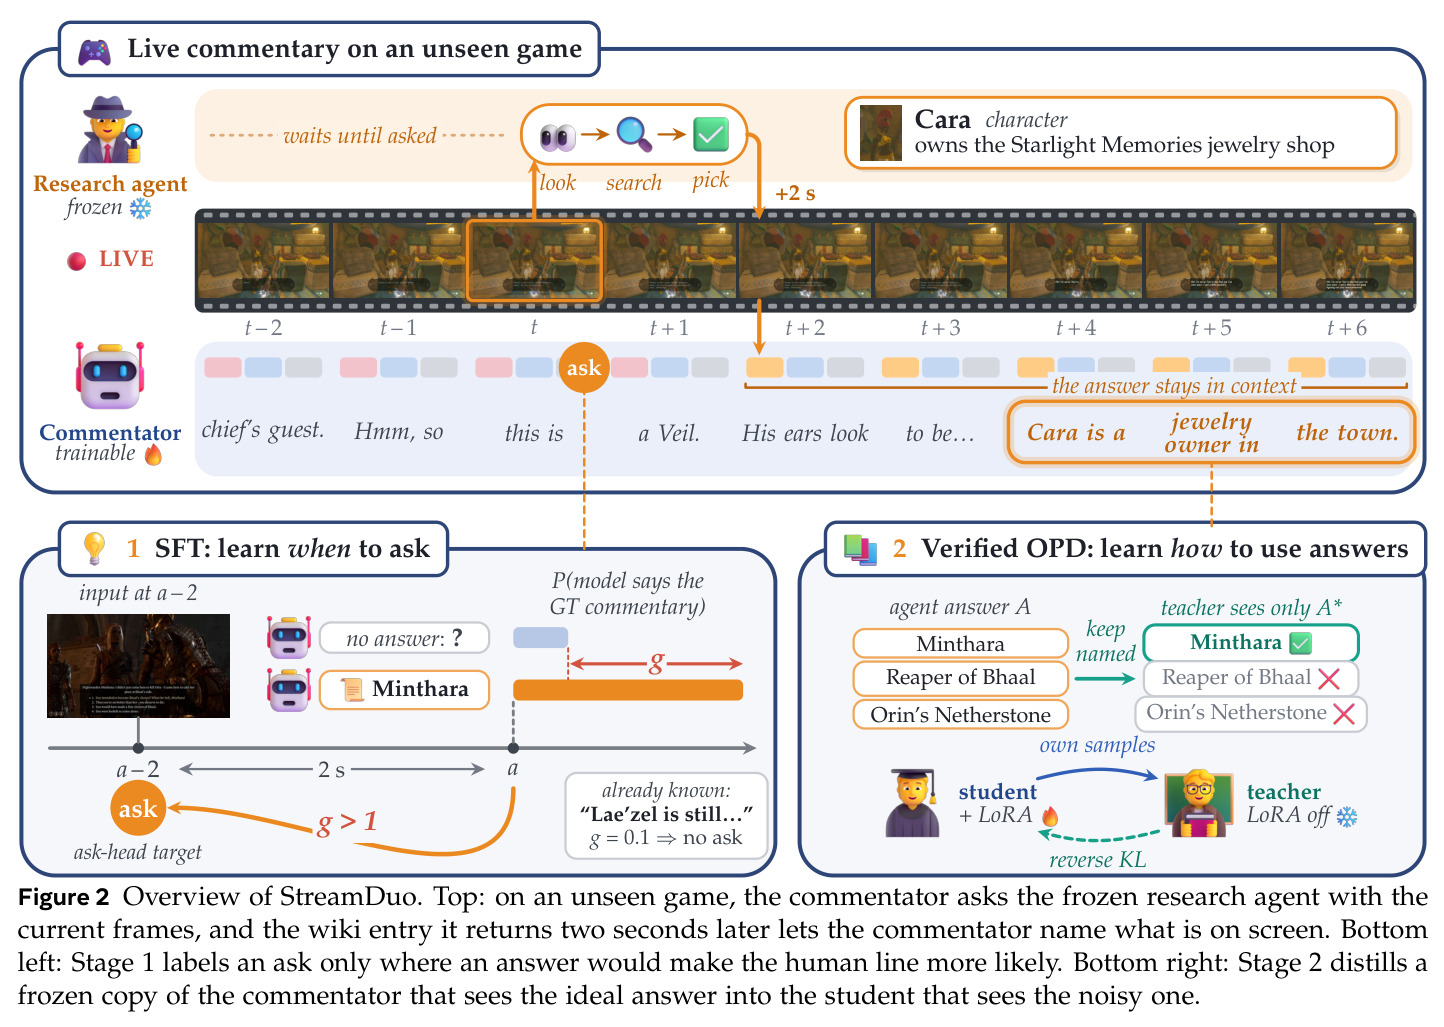
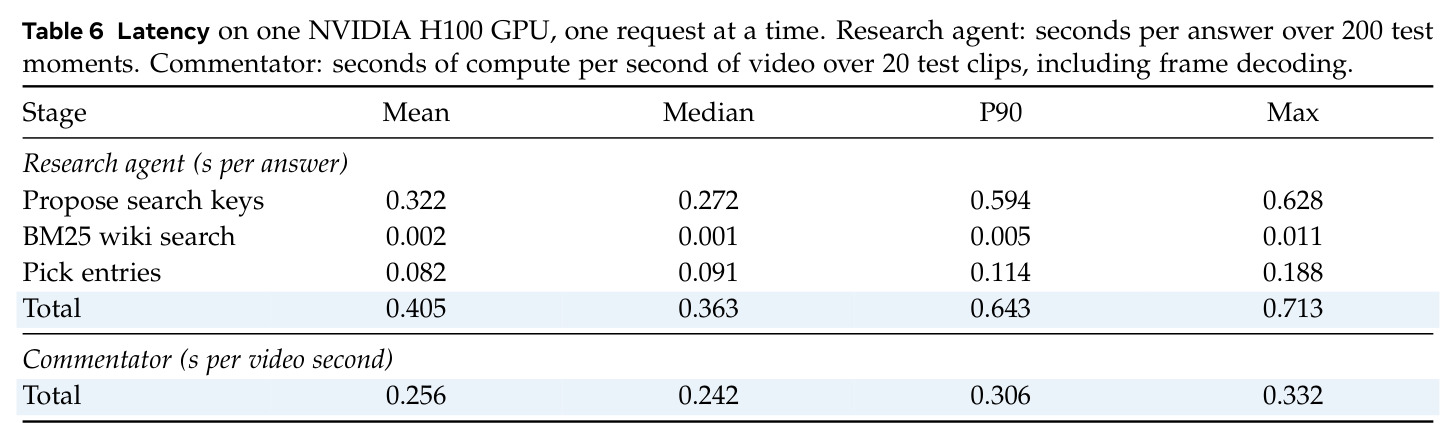
StreamDuo 由两个智能体组成:可训练的解说员(commentator)从 LiveCC-7B-Base 初始化,逐秒观看视频流、决定何时开口并生成解说;冻结的研究智能体(research agent)是 Qwen3-VL-8B 加 BM25 搜索工具,只读被玩游戏的Wiki(共 190,722 页)。直觉是把「跨游戏不变的能力」留在解说员权重里——感知画面、判断时机、组织语言——而把「游戏特定的知识」放到了测试时按需查询的Wiki里,同一个系统换个Wiki就能指向新游戏。技术路线是只训解说员、只用源游戏数据、分两个阶段:Stage 1 用信息增益标签训练一个提问头,教它识别「答案能帮上忙」的时刻,并在训练的历史上下文里混入带正确词条、干扰词条和完全未命中的模拟答案;Stage 2 用在策略自蒸馏,让一个能看到理想答案的冻结教师副本,纠正学生(只看真实噪声答案)对自己采样句子的输出分布,教会它「词条与画面匹配才用,不匹配就丢」。推理时解说员以 $p_t>0.27$ 开口、以 $q_t>0.9$ 触发提问,答案在 2 秒后写入历史,实测研究智能体平均 0.41 秒返回、解说员每秒视频只需 0.26 秒计算,两块 GPU 即可实时直播。
核心创新是与已有方法的三个本质区别。第一,帧即查询:RAG惯例是模型先形成文本查询再检索,但「认不出」与「描述不出」是同一件事,StreamDuo 让解说员直接把当前帧发给研究智能体,由后者用视觉能力在Wiki中定位实体,这一接口选择使得「模型不知道的东西」第一次变得可检索。第二,模型相关的提问监督:naive做法是在人类解说提到实体的前一拍标注ask,但模型早已认识的主角也标了;信息增益标签 $g_a=\log \pi_{\theta_0}(y_a\mid h_{\le a},A^\star_a,v_{\le a})-\log \pi_{\theta_0}(y_a\mid h_{\le a},v_{\le a})$ 用冻结模型自身打分,只有答案确实能帮助复现人类台词($g_a>1$ nat)的秒才标为提问点,消融显示这一改动让实体召回从 0.079 提到 0.092。第三,特权自蒸馏教「用」而非「抄」:SFT 教会了答案的格式却教不会甄别,实测在真实答案上SFT反而把召回拉低到 0.086;OPSD 的教师不是更大的模型,而是同一权重关闭LoRA、且唯一特权是看到含正确词条的理想答案 $A^\star$,其logits经对比放大 $\log p_T(\cdot)=\log\mathrm{softmax}\big((1+\alpha)\ell_{\theta_0}(\cdot\mid A^\star)-\alpha\,\ell_{\theta_0}(\cdot\mid\varnothing)\big)$ 后,对学生自己的采样施加逆向KL——因答案而变可能的token(如屏幕实体的名字)被推高,模型本来就会说的token不受影响。
方法步骤详情
完整流水线分五步。Step 0 数据净化:沿用 Proact-VL 的 10,286 个 BG3 训练片段,但只保留解说员persona的语言风格,删除先前转写,把搭档台词中的游戏专名替换为类型化占位符(如 [PLAYER]),并在每个片段内对源游戏实体做随机一致重命名,使任何名称都只在当前片段内有效,切断「背名字」的捷径。Step 1 基础流式训练:每秒为一个回合,flag token 隐状态 $z_t$ 送入说话头 $p_t=\sigma(w_s^\top z_t)$,以 $\mathcal{L}_{base}=\mathcal{L}_{LM}+\mathcal{L}_{spk}$ 在人类解说上训练。Step 2 Stage 1「学会何时问」:同一 $z_t$ 上加第二个头 $q_t=\sigma(w_a^\top z_t)$;对每个人类提及实体的时刻 $a$,用冻结副本计算信息增益 $g_a$,当 $g_a>\gamma=1$ nat 时把 $a-\delta$($\delta=2$s,保证答案及时到达)标为ask正样本,损失 $\mathcal{L}_1=\mathcal{L}_{LM}+\mathcal{L}_{spk}+\lambda\mathcal{L}_{ask}$;此阶段训练历史中的答案由正确实体加同游戏干扰词条构成,部分答案故意缺失实体,全参数微调一个epoch,学习率 $10^{-5}$。Step 3 研究智能体执行:开流前先用冻结的 Qwen3-VL-8B 写一份游戏概况作为通用背景;被问到时看帧→提出几个搜索词(含屏幕上可读的名字)→BM25 检索Wiki→再看帧核验候选→返回最多 3 条{name、type、一句话描述},单次平均 0.405 秒(P90 0.643秒)。Step 4 Stage 2「学会用答案」:rank-32 LoRA 训练 300 步、$\alpha=1$;学生在答案刚到达的时刻采样自己的话 $\hat{y}\sim\pi_\theta(\cdot\mid h,A,v)$,教师(LoRA关闭的冻结副本,看理想答案 $A^\star$)逐token打分,按式(6)对采样句最小化逆向KL,LoRA关闭即教师、开启即学生,实现同一权重双角色。Step 5 推理策略:$p_t>0.27$ 开口、$q_t>0.9$ 提问,连续说话后改用更高阈值 $\tau_c$ 才继续,事件结束后自然停住。
技术新颖性
技术新颖性体现在四个层面。任务层面:首次形式化跨游戏流式解说,给出干净的评测协议(只保留persona风格、删转写、占位符化搭档台词、前126词截断防止刷字数提升召回)和源游戏泄漏指标(训练游戏名占全部实体名的比例,且只计既不在测试游戏也不在其Wiki中的名字),证明「时机可迁移、知识不可迁移」这一此前未被量化的现象。接口层面:帧即查询的异步多智能体协议是新的——答案延迟 $\delta$ 秒进入历史且流不暂停,这把检索时机错误从「失败」转化为「可学习的鲁棒性」,区别于同步的VQA式检索或预取式RAG。监督层面:信息增益ask标签把「模型知道自己不知道」这一元认知能力显式编译进流式视频模型的分类头,此前该能力只在纯语言模型中被研究过(论文引用的不确定性自适应检索工作),流式视觉模型并无此机制。训练层面:把在策略自蒸馏扩展到两智能体设定——特权信息正是「研究智能体本应返回的答案」,并用式(5)的对比放大($\alpha=1$)让教师对答案的依赖显式化;消融证明该配方是唯一全面优于Stage 1的变体,正向KL版本虽然召回更高(Ent-R 0.131)却带来19.3%的最高泄漏,SFT版本召回反降,凸显了「逆向KL+放大+理想答案」三者缺一不可的设计精度。
实验结果
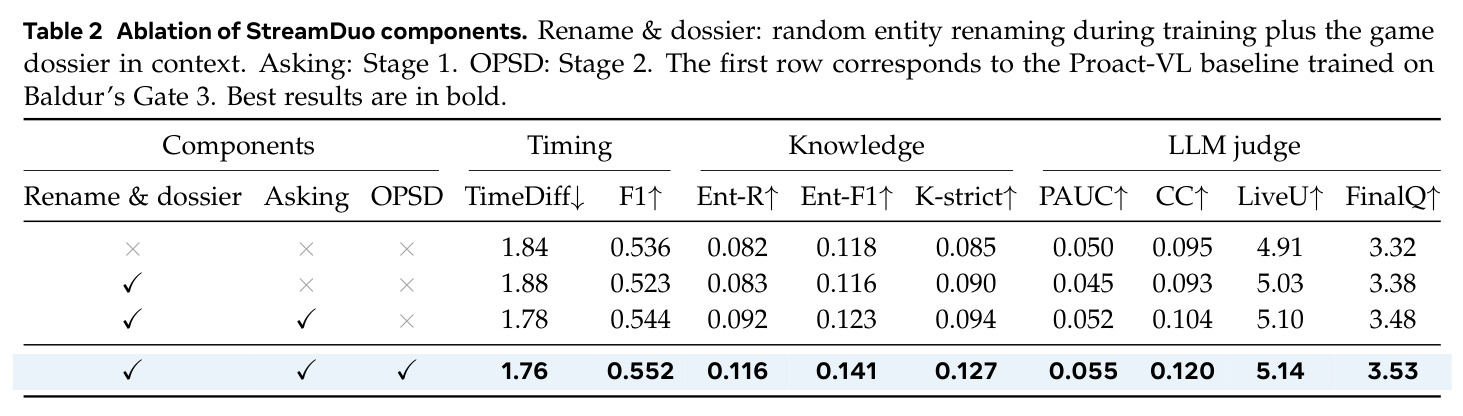
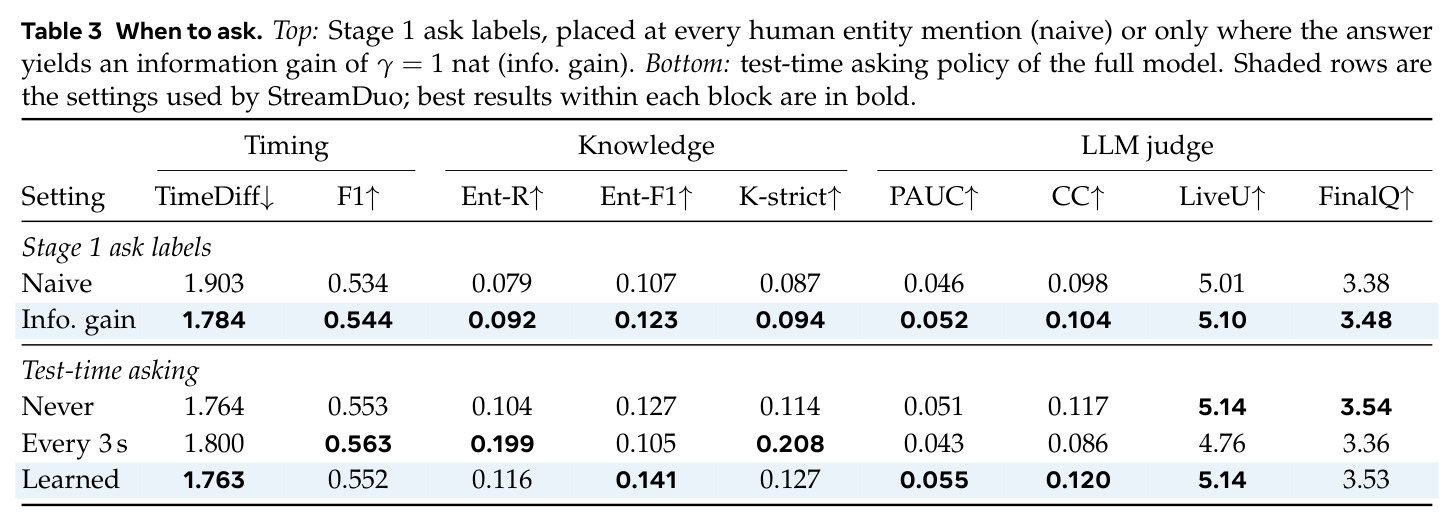
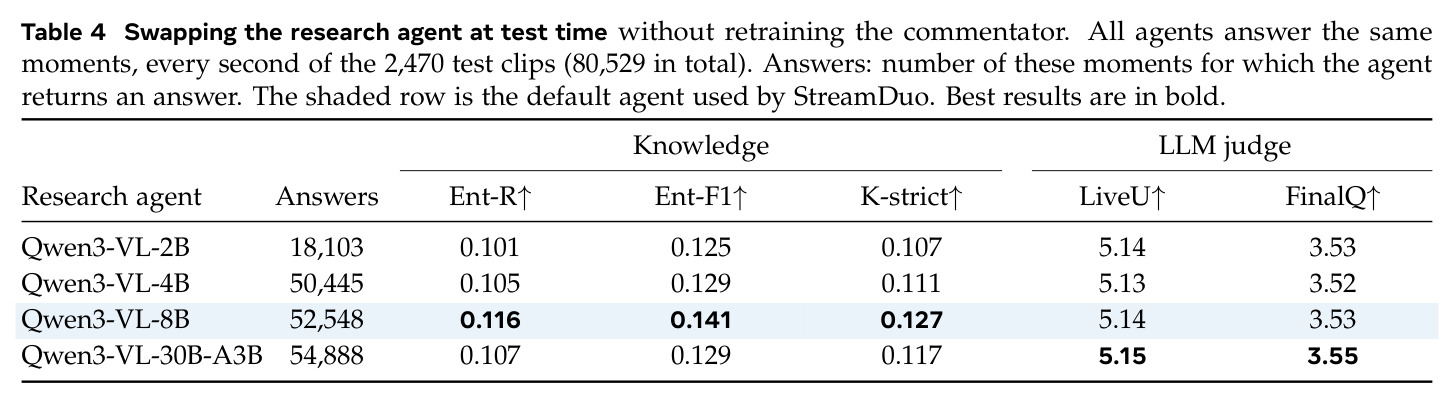
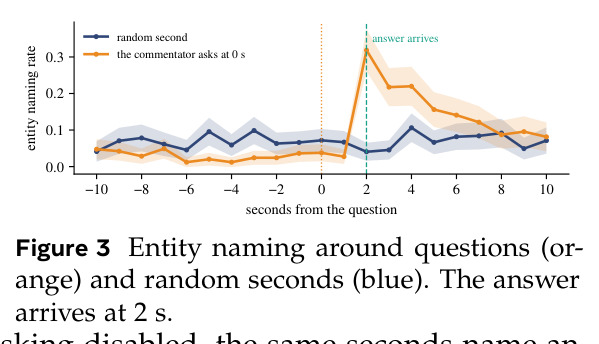
主实验(Table 1,2,470 个未见游戏片段)中 StreamDuo 几乎全面第一:时机上 TimeDiff 1.76 秒、F1 0.552,优于同数据重训的 Proact-VL(1.84 秒、0.536);知识上实体召回 Ent-R 0.116、Ent-F1 0.141、严格知识线 K-strict 0.127,对比 Proact-VL 的 0.082、0.118、0.085 分别提升 42%、19%、49%,且超过了零样本 LiveCC 的召回(0.099)而时机不崩;LLM评委(Qwen3-30B)给出 LiveU 5.14、FinalQ 3.53,均为流式模型最高;唯一未赢的 CC(0.120)被证明偏向几乎不说话的 MMDuet2(0.312)。泄漏指标(Table 5):Proact-VL 说出的名字中 9.9%(200/2,011)来自 BG3,StreamDuo 只有 1.0%(34/3,329),而后者实体总数几乎翻倍——《英雄联盟》上从 54.6% 降到 7.8%。消融(Table 2)逐组件剥离:随机重命名加档案几乎不加知识(Ent-R 0.082→0.083)但把 LiveU 从 4.91 提到 5.03;提问(Stage 1)把 Ent-R 提到 0.092;OPSD(Stage 2)贡献最大涨幅 0.092→0.116、K-strict 0.094→0.127。提问策略(Table 3):naive标签在所有指标上更差(Ent-R 0.079);不问则 Ent-R 0.104,每 3 秒强制提问把召回推到 0.199 但 Ent-F1 跌至 0.105 且评委分全降;学习到的策略以 264 次提问/2,470 片段取得最优平衡。行为分析(Fig 3):提问前实体命名率仅 1–4%(低于随机秒的 7%),答案到达的秒命名率跳到 32%(随机的 4.6 倍),关闭提问后同秒仅 5%,证明命名跳升确实来自答案。Stage 2 变体(Fig 4):正向KL召回 0.131 但泄漏 19.3%、FinalQ 跌到 3.31;真实答案SFT召回 0.086;只有完整配方(逆向KL+放大+理想答案)全面优于 Stage 1。换研究智能体(Table 4):Qwen3-VL 2B 到 30B-A3B 的 Ent-R 在 0.101–0.116 间,30B 反不如 8B,说明瓶颈不在agent大小而在解说员对答案的利用。延迟(Table 6):研究智能体 0.405 秒/答案(最大 0.713 秒),解说员 0.256 秒/视频秒,2 秒延迟有超过一秒的裕量。
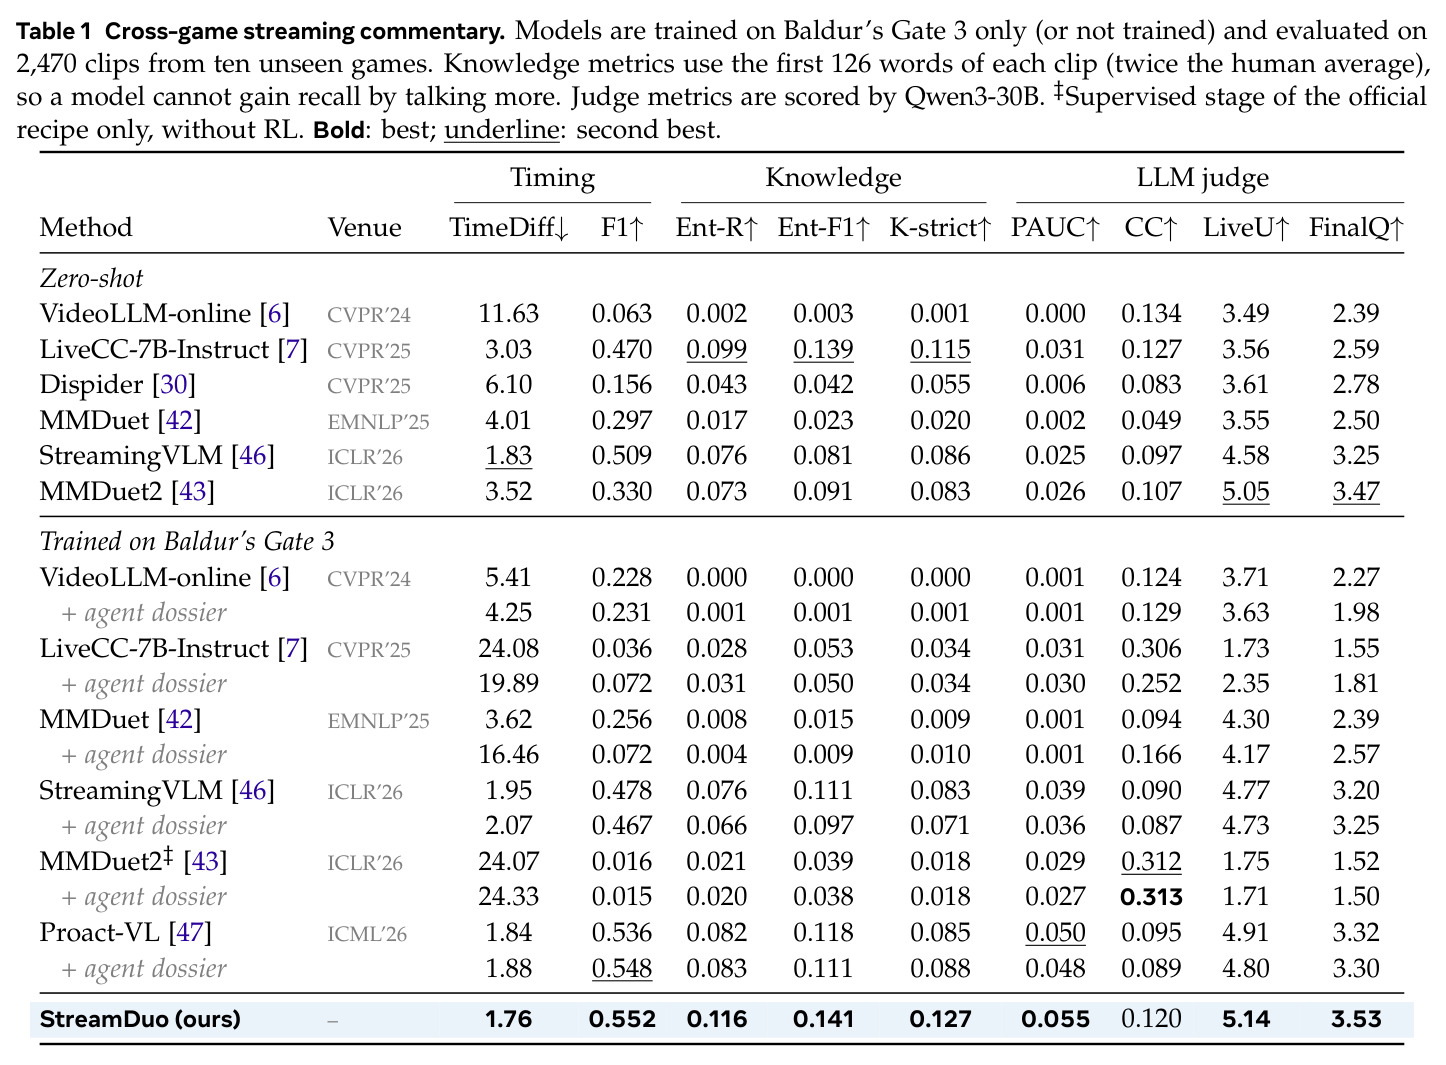
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨游戏流式解说·实体召回(十个未见游戏,2,470片段) | Ent-R | 0.116 | Proact-VL 同数据重训 0.082;零样本最佳 LiveCC 0.099 | 相对 Proact-VL 提升 41.5%,且在时机不掉的前提下超过零样本 LiveCC 17% |
| 跨游戏流式解说·时机 | TimeDiff↓ / F1↑ | 1.76 秒 / 0.552 | Proact-VL 1.84 秒 / 0.536 | 响应更快且 F1 提升 0.016,同时保持流式模型中最佳时机 |
| 源游戏泄漏 | 泄漏率(BG3名字占全部实体名比例)↓ | 1.0%(34/3,329) | Proact-VL 9.9%(200/2,011) | 降低约 9 个百分点;英雄联盟场景从 54.6% 降至 7.8% |
| 严格知识线(仅计需要游戏知识的句子) | K-strict↑ | 0.127 | Proact-VL 0.085 | 提升 49%,且远高于给所有基线加档案的最佳结果 0.088 |
| LLM 评委综合质量 | LiveU / FinalQ(Qwen3-30B 评分) | 5.14 / 3.53 | Proact-VL 4.91 / 3.32;StreamingVLM 4.58 / 3.25(零样本) | 流式模型中双项最高,活跃度与总体质量均领先 |
局限与改进
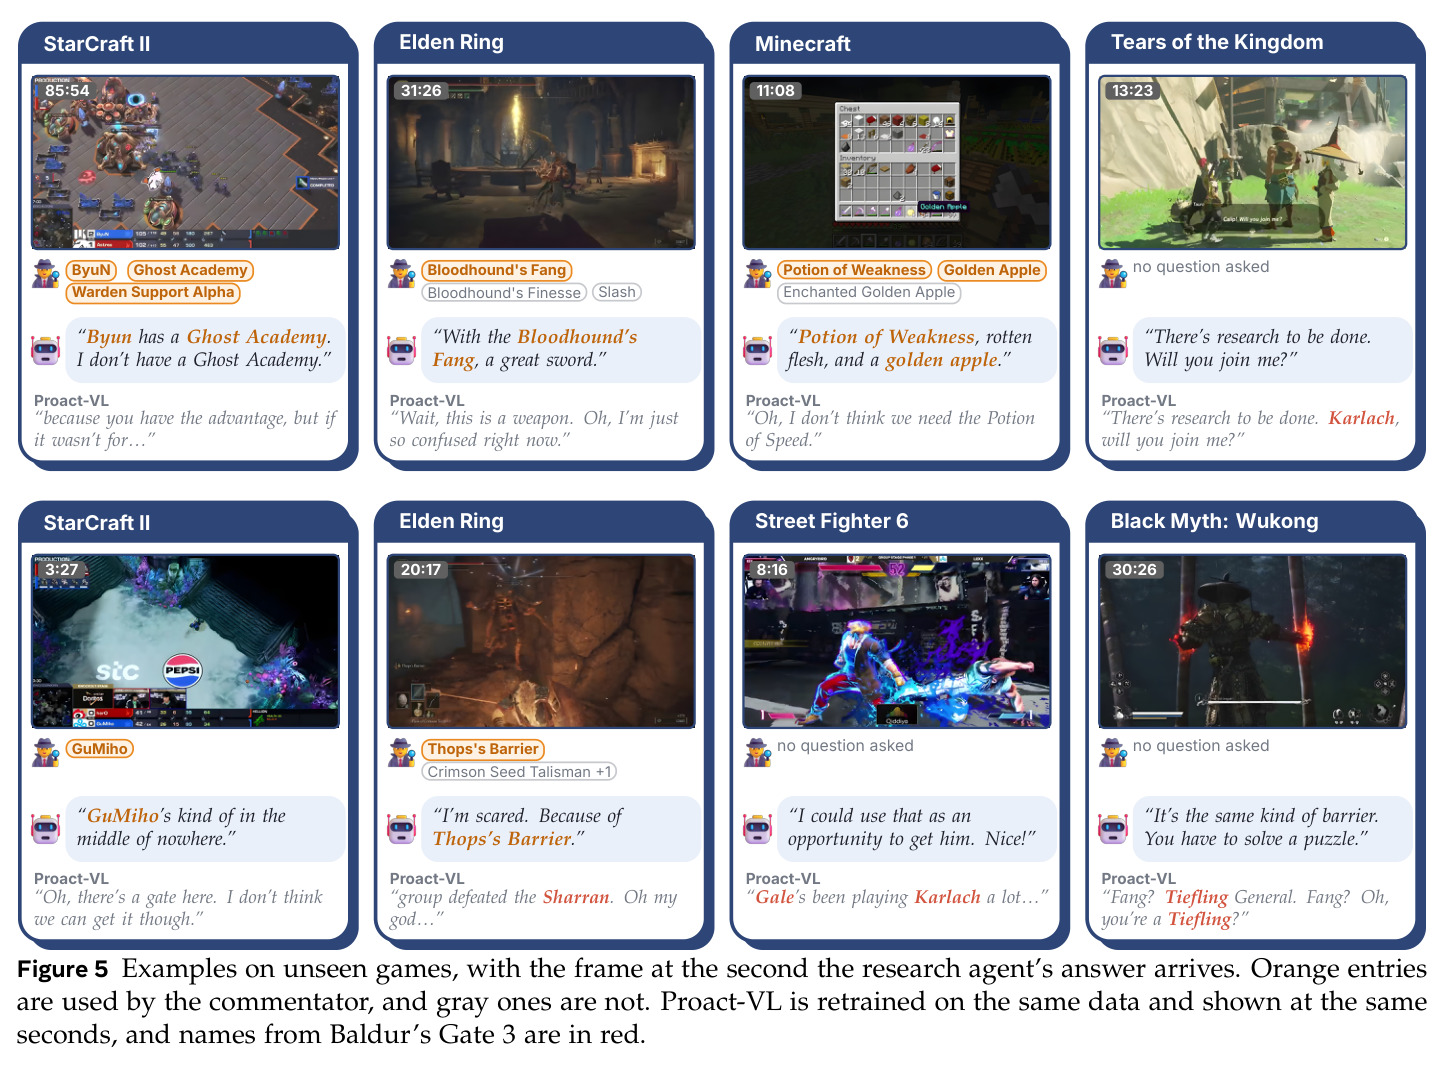
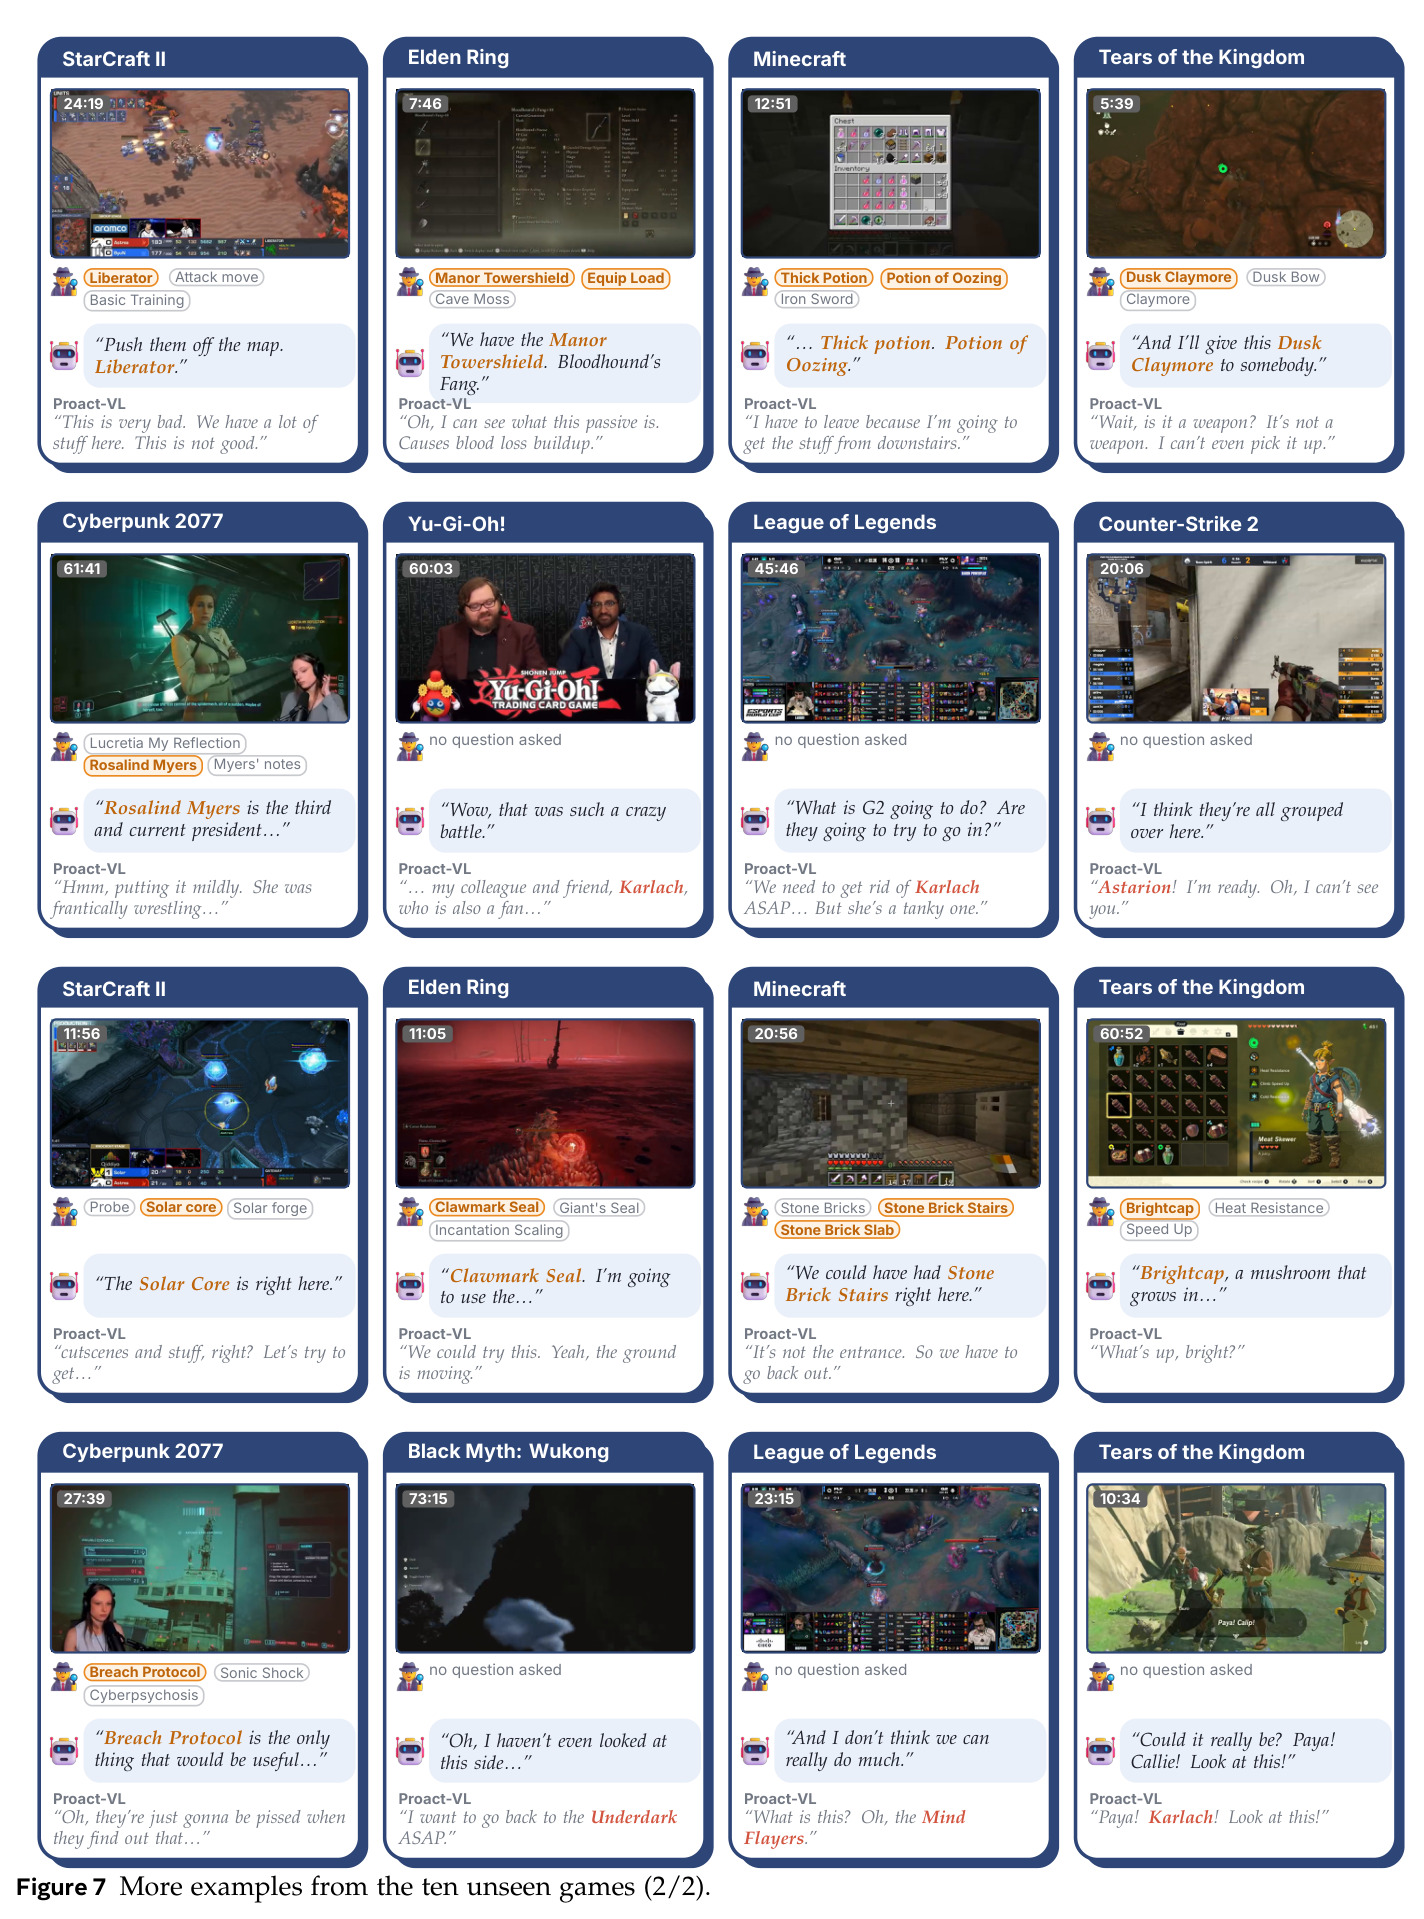
作者明示的局限:CC(内容连贯性)指标未赢,他们解释为该指标奖励每片段只说几个词的近沉默模型(如 MMDuet2 得 0.312),不反映解说本身质量;提问行为仍很稀疏,学习到的策略在 80,529 个可能时刻中只触发 264 次(约0.3%),Ent-R 0.116 相对人类上限仍有很大差距;答案过滤不完美,StarCraft II 案例中解说员复述了与比赛无关的 Warden Support Alpha,有时甚至照读Wiki(「Rosalind Myers is the third and current president…」)而非真正的解说。我自己的观察:其一,系统硬依赖「被玩的游戏存在可检索的Wiki」,对全新发布或小众游戏直接失效,而Wiki本身的错误会被当作事实;其二,2 秒延迟与 $q_t>0.9$、$p_t>0.27$ 阈值都是手工超参,换直播领域或换基座模型都需要重调,Fig 4 显示 Stage 2 对损失形式敏感(正向KL泄漏 19.3%),训练配方鲁棒性存疑;其三,全部评委指标由 Qwen3-30B 打分,评委与被测系统共享生态可能引入偏好偏差;其四,泄漏指标只统计「既不在测试游戏也不在其Wiki」的名字,对源游戏与测试游戏共享命名空间的情况(如通用词)界定偏宽松;其五,只在游戏直播一个域验证,体育解说等结构化信息更丰富的场景未测。
独立分析的弱点
弱点一:提问覆盖率过低。264 次/2,470 片段、$q_t>0.9$ 的保守阈值意味着模型在大量「其实该问」的时刻选择沉默或含糊其辞(Fig 3 显示提问前命名率仅 1–4%,说明它确实绕开了不认识的实体,但绕开的代价是不说)。改进方向:对 ask 头做概率校准后用期望效用阈值替代固定阈值,或在推理时允许「低置信度先描述后补名」的两段式输出。弱点二:词条选择完全隐式。Table 4 显示把研究智能体从 8B 换到 30B-A3B 召回反而下降(0.116→0.107),且 Stage 2 的增益远大于换任何agent,说明瓶颈在「解说员如何从 3 条词条里挑与画面匹配的那条」,而这目前只是隐式学到的。改进方向:显式训练一个词条-帧匹配/拒绝模块,或在答案进入历史时附加研究智能体的置信度。弱点三:延迟固定为 2 秒。答案实际 0.41 秒就能返回,固定缓冲浪费了时效;而快速事件(击杀瞬间)又可能等不了 2 秒。改进方向:自适应 $\delta$,按 ask 头置信度决定等待时长,或答案先到先入上下文。弱点四:对Wiki可用性的硬依赖与单域验证。改进方向:离线预抓取常见游戏Wiki缓存、支持无Wiki时的「承认不知道」降级模式,并把评测扩展到体育等直播领域检验时机迁移结论的普适性。弱点五:泄漏指标的宽松边界。改进方向:引入基于源游戏实体别名词典的严格匹配,统计「部分泄漏」(如把 Tiefling 当种族名乱用)。
未来方向
作者方向上的延伸:把帧即查询的异步检索协议推广到游戏之外的直播领域——体育解说中队伍与球员Wiki同样可得,正好检验「时机迁移、知识不迁移」结论的边界;研究解说员与研究智能体的联合微调(目前agent完全冻结,Table 4 说明还有大量冗余容量未利用);把ask头从二分类升级为生成式「我要问什么」的结构化子问题,与帧一起发给agent,可能提高冷门实体的命中率。基于本文成果可延伸的方向:其一,在线Wiki记忆——StreamDuo 每次问答的结果可以缓存成游戏内持久记忆,同一主播重复游玩时减少重复检索,形成随直播时长增长的知识库;其二,多模态Wiki——目前返回的是文本词条,加入实体图像条目可以让解说员把「名字+长相」绑定,减少张冠李戴;其三,把信息增益标签的思想反向用于评测:用 $g_a$ 分布刻画任意流式模型的「认知地图」,定位它缺哪类知识,指导针对性数据采集;其四,泄漏指标推广为通用「训练集知识泄漏」评测,用于检测所有生成系统对微调数据的记忆性;其五,Stage 2 的特权自蒸馏配方(理想答案+对比放大+逆向KL)值得迁移到任何「模型需要学会甄别带噪检索结果」的场景,如具身导航中的地图查询、医疗问答的文献检索。
复现评估
开源情况:论文给出代码仓库(github.com/ZixianGao/StreamDuo-code)和项目页(zixiangao.github.io/StreamDuo/),两个基座模型 LiveCC-7B-Base 与 Qwen3-VL-8B 均公开权重,Wiki检索用 BM25(构建索引一次 1.5 秒,工程门槛低)。数据:训练依赖 Proact-VL 的游戏解说基准(10,286 个 BG3 片段训练、2,470 个跨十游戏片段测试),需要取得该基准;作者还公开了全部预处理细节(persona保留、转写删除、占位符替换、实体随机重命名),复现数据处理管道需要一定工作量但无黑盒。算力:训练用 8 块 NVIDIA H100(Stage 1 全参一个epoch、Stage 2 仅 LoRA rank-32 共 300 步),评测同样在 8×H100;推理侧要求低,研究智能体 0.405 秒/答案、解说员 0.256 秒/视频秒,两块消费级以上 GPU(各跑一个agent)即可实时直播,这比训练门槛友好得多。综合难度评级中偏高:单卡复现 Stage 2 LoRA 与推理可行,完整复现主表(含七个基线的重训)需要多卡集群与 Proact-VL 数据许可;评测管线还需 Qwen3-30B 评委与Wiki实体匹配脚本,建议先复现 Table 2 消融验证核心组件,再尝试全表。
论文图表
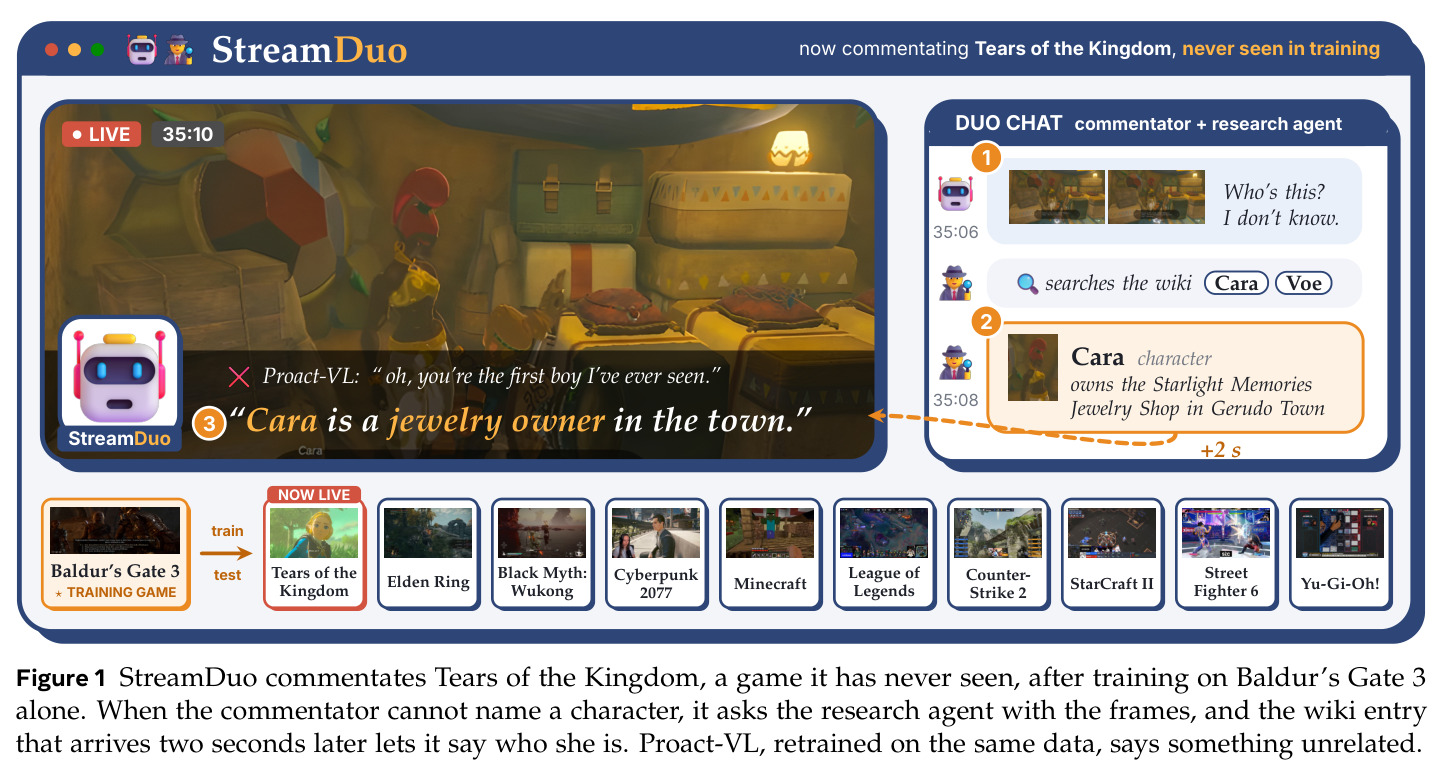
概览图:只用BG3训练的StreamDuo正在实况解说从未见过的《王国之泪》。解说员看到陌生角色Cara时无法命名,把当前帧发给研究智能体,智能体查Wiki返回「Cara,角色,在Gerudo Town拥有Starlight Memories珠宝店」,2秒后解说员说出正确身份;同一时刻重训的Proact-VL却说了一句无关的话。图下方还展示了训练游戏与十个测试游戏的全景。
一图讲清任务设定、双智能体交互时序和对比基线的失败模式,是理解「跨游戏解说」问题的最短路径。
Stage 2 的损失与教师变体对比:在真实答案上SFT使Ent-R降至0.086(低于Stage 1的0.092);无放大(α=0)增益很小;正向KL得到最高Ent-R 0.131与K-strict 0.145,但BG3名字泄漏率高达0.193(全表最高),LiveU与FinalQ跌至4.82/3.31;弱教师(只知道人类提过哪些词条、或用冻结VLM屏上核验)召回仅0.093/0.102。只有完整配方全面提升且泄漏0.010。
证明了「逆向KL+对比放大+理想答案教师」三个设计选择缺一不可,是理解Stage 2为什么这样设计的关键证据。
附录B的16个补充案例(第一半):覆盖玩家与单位(ByuN、Mothership)、装备(Radahn's Greaves、钻石胸甲附魔)、地点(Rito Village、Tabantha Tundra)、技能(Short Circuit、Breach Protocol)等知识类型,并展示模型保留Dusk Claymore而弃用Dusk Bow等筛选行为,以及照读Wiki的失败模式。
系统展示检索知识的覆盖面与解说员的词条甄别行为,是评估方法实际成色的素材。