DeltaStreamer:迈向类人的智能体式流式视频理解 DeltaStreamer: Towards Human-Like Agentic Streaming Video Understanding
仿人类“观察-记忆-回查”机制,用变化记录与定向回放攻克流式视频理解
前置知识
流式视频理解
与离线视频一次性拿到完整片段不同,流式设定下画面逐帧到达,系统只能访问已经观察过的内容,且必须持续运行而看不到未来帧;用户提问也可能在相关事件发生之后才到来。系统因此需要在不知道未来会被问什么的情况下,边接收边构建和维护记忆,并在提问后按需作答或继续观察。
这是本文的问题设定本身,全部设计(观察、记忆、规划、回放)都是为绕开该设定的约束而服务的。
KV-cache 复用与 token 压缩
现有多模态大模型处理长视频的两大主流省资源手段。token 压缩(如 TimeChat-Online 用帧间差分去除冗余 token)在视觉 token 进模型前就把相似内容合并丢弃;KV-cache 复用(如 ReKV 检索历史 KV 状态、StreamMem 维护查询无关的压缩 KV 记忆)则在注意力缓存层面淘汰或压缩旧帧的中间表示,避免重算。两者本质都是在有限预算下决定丢什么、留什么。
论文批评的正是这两类范式:压缩会隐掉事件转折、丢掉后续提问才需要的细节,理解这一点才能看懂 DeltaStreamer 的动机。
分层记忆与记忆 DAG
把长期运行的系统记忆组织成多个抽象层级:本文用三层——工作记忆存逐帧的原始观察,情景记忆把相关观察聚合成事件级摘要,长期钉住保存更紧凑的要点。各层之间用有向无环图(DAG)连接,带源标识和反向指针,使摘要能一路追溯到底层观察乃至视频帧;另有实体索引把人物/物体名映射到出现时间,方便按实体检索。
分层加可溯源是本文记忆设计的骨架,摘要省空间、源链接保证据,理解它才能看懂检索和回放如何工作。
智能体规划与工具调用
让大模型不只被动生成答案,而是先分析任务、制定计划,再循环调用外部工具(检索、缩放、跟踪、回看历史帧等)并根据工具反馈调整行动,直到收集到足够信息。本文中规划器的输出是一个结构化计划:查询目标、时间锚点、证据类型、时间范围和搜索策略,并作为“证据契约”持久保留在后续每一轮提示中。
DeltaStreamer 把流式理解定义为“主动信息搜集”问题,规划和工具调用正是实现这一定位的机制。
Jaccard 相似度
衡量两个集合重叠程度的指标,定义为交集大小除以并集大小:$J(A,B) = \frac{|A \cap B|}{|A \cup B|}$,取值 0 到 1,越大越相似。本文把每条观察的字段内容切成小写词集合,对每个字段计算与近期历史观察的最大 Jaccard 相似度,再用字段权重平均成文本新颖度分数 $s(O_t)$,用于识别重复描述、赋予检索显著性权重并触发情景聚合。
论文公式 (2) 的核心构件,理解它才能明白系统如何自动区分“新事件”与“重复内容”。
研究动机
流式视频理解要求系统在画面逐帧到达、看不到未来帧的条件下持续工作,而提问可能在相关事件发生很久之后才出现,系统必须在不知道未来会被问什么的情况下构建记忆。现有方法分三类:token 压缩(如 TimeChat-Online 用帧间差分去冗余)、KV-cache 复用(如 ReKV 检索历史 KV 状态、StreamMem 维护查询无关压缩记忆)和多轮对话(如 Streamo 把历史转成文本轮次)。论文指出它们共享两个根本缺陷:其一,记录只保存“当前有什么”,而把“正在发生什么变化”隐式化——相邻帧场景内容高度相似,重复表征迅速吃掉预算,还模糊了区分事件的关键转折;其二,帧一旦过去,证据只剩当初留下的文本,观察阶段遗漏的像素级细节在后续提问时无法找回。论文用了一个直观例子:问“楼上地板的电闸是什么颜色”,KV 复用压缩后颜色信息丢失,多轮对话则文本不断累积、图像被丢弃,系统因“颜色没被记录”而无法作答。这两个缺陷共同反映了已有工作只关注 token 预算管理,对记录变化和找回缺失证据投入不足。
本文的目标是本文要构建一个像人类观众一样“边看边记、被问就查”的流式视频智能体。查询到来之前,系统逐帧持续观察,把结构化场景描述和相邻帧间的显式变化(delta)一并写入可溯源的记忆,保留事件如何展开的轨迹;查询到来之后,一个查询驱动的规划器分析问题需要什么证据、该去过去/当前/即将到来的帧里找,然后指导记忆检索、继续观察和定向回放历史帧,把观察阶段省略的像素级细节找回来,使答案有据可依,而不是只依赖压缩后的文本描述。可量化的目标是在 OVO-Bench 与 StreamingBench 两个流式基准上超越代表性方法——最终 DeltaStreamer 分别取得 66.07% 和 59.53% 的总评分,超过最强在线方法 EventMemAgent(60.75%)与 STRIDE(57.58%),甚至超过闭源的 Gemini 3 Flash(64.02%)。在动作序列识别(ASI 79.05)和幻觉检测(HLD 69.89)上的提升也印证了其对事件区分和证据搜集的侧重。
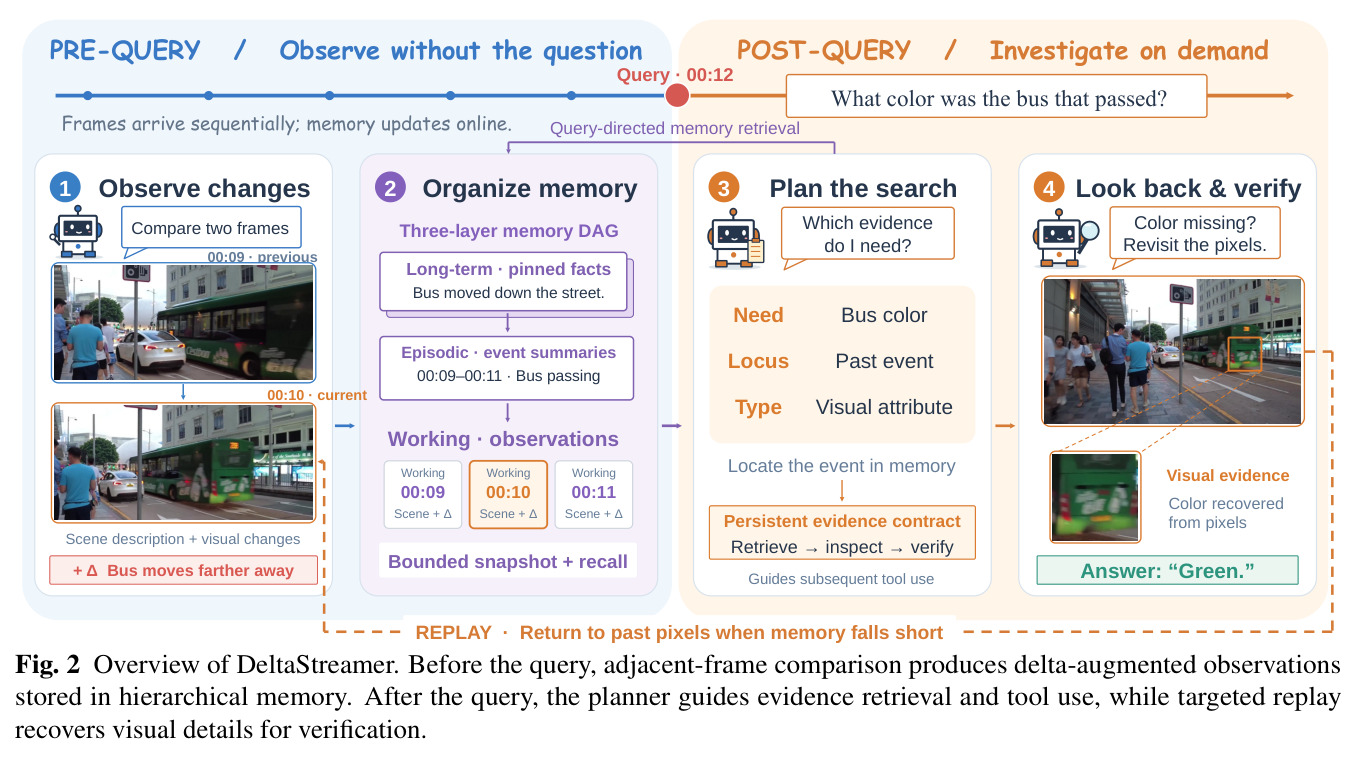
与已有工作不同的是,已有智能体化尝试(StreamAgent 的预期性规划、EventMemAgent 的事件记忆加视觉锚点、OASIS 的粗到细检索)虽然引入了规划和工具调用,但它们的存储表征同样可能在观察阶段就丢掉后续查询需要的证据,且查询后缺乏一套贯穿始终的证据需求规范。DeltaStreamer 的独特切入有两点:第一,把“变化”当作一等公民——在观察阶段直接对比相邻两个采样帧,把视觉变化作为 delta 字段与场景描述并列写入记忆,让事件转折变成显式、可检索的信息,而不需要从多条相似描述中间接推断;第二,把流式理解从“被动编码 + 压缩预算管理”重构为“主动信息搜集”问题:查询后生成一次计划,并作为持久证据契约保留在后续所有轮次的提示中,防止长推理过程中信息需求漂移;当文本记忆缺少决定性细节时,智能体沿源链接定位历史帧做定向回放,把从未被编码成文本的像素级证据补回来。这种“记录变化 + 计划驱动取证”的耦合是先前范式所缺失的。
核心方法
直觉上,DeltaStreamer 模仿人类看直播的方式:一边看一边在心里记流水账(包括“刚才发生了什么变化”),被问到问题时先回忆,回忆不起来就拖动进度条回看原片,确认后再回答。技术路线上,系统用一个共享的 VLM 骨干(Qwen3.6-27B)分两个阶段工作。查询前(pre-query):以 1 fps 采样,对每个采样帧调用 VLM,输入前帧 $I_{t-1}$、当前帧 $I_t$ 和之前的记忆快照,输出增量观察 $O_t = (D_t, \Delta_t) = \mathrm{VLM}(I_{t-1}, I_t, M^{t-1}_{\mathrm{snapshot}})$,其中 $D_t$ 是结构化场景描述(含 actors、objects、actions、OCR、scene 字段),$\Delta_t$ 是文本化的变化描述;观察经新颖度评分 $s(O_t) = \frac{\sum_f w_f [1 - \max_i \mathrm{Jaccard}_f(O_t, O_i)]}{\sum_f w_f}$ 处理后写入由工作记忆、情景记忆和长期钉住组成的三层记忆 DAG。查询后:规划器基于记忆快照、实体索引和初步检索的证据路径生成持久计划,智能体循环执行检索—检查—验证,文本证据不足或验证器发现记录冲突时调用 $\mathrm{replay}(\tau)$ 回看历史帧恢复像素证据,直到能给出有据答案。全部推理用 vLLM BF16 跑在 8 张 A100 上。
核心创新是把两件此前被分开(甚至被忽视)的事情拧在一起:显式变化记录与查询驱动的定向取证。已有方法的本质是“预算管理”——在 token/KV/文本长度限制下决定丢什么留什么,被压缩掉的细节永久丢失;DeltaStreamer 的记忆保留所有低显著度记录并用源指针串联:摘要层负责省空间,但永远保留一条回到原始观察乃至视频帧的路径。变化 delta 让“事件如何展开”成为可直接检索的一等信息,而不是埋在多条相似场景描述里需要跨记录重建的东西。查询后,规划产物(目标、时间锚点、证据类型、时间范围、搜索策略、视角等)作为持久证据契约留在每一轮提示里,使后续的检索、观察和工具决策始终对齐最初的信息需求;当检索到的文本缺少决定性细节、或验证器发现记录间跨层冲突时,智能体沿源链接定位历史帧做定向回放,把从未被文本化的像素级证据补回来。消融证明这种协同是关键:delta 在有规划器时贡献 +4.95 分,无规划器时仅 +0.93——“记什么”和“怎么查”必须一起设计,单靠任何一半都拿不到完整收益。
方法步骤详情
方法流程分五步。第一步,增量观察:以 1 fps 采样,每步输入 $(I_{t-1}, I_t, M^{t-1}_{\mathrm{snapshot}})$,VLM 输出结构化观察 $O_t$(场景描述 + 变化 delta);首帧只输入 $I_0$ 并输出初始帧标记。第二步,记忆组织:对每条非空观察按字段加权计算文本新颖度(对近期历史取每个字段的最大 Jaccard 相似度,用 1 减去后按权重平均),新颖度与重复 delta 检查共同决定检索排名用的显著性权重和情景聚合的变更标志,低显著度记录仍然保留;观察进入三层 DAG——工作记忆 W 存逐帧观察,情景记忆 E 把相关观察聚合成事件摘要,长期钉住 L 保存紧凑要点并链接回源情景,层间有双向跨层指针,另有实体索引 $J_t$ 把 actor/object 名映射到出现时间。第三步,规划:查询在 $t_q$ 到达时,构造上下文 $C_{t_q} = (M^{t_q}_{\mathrm{snapshot}}, J_{t_q}, R_{t_q}(q))$(记忆快照、实体索引、证据路径),与问题和当前帧一起生成计划 P,指定查询目标、时间锚点、证据类型、时间范围(过去/当前/未来/混合)和搜索策略,辅以视角、选项、可答性等字段。第四步,证据搜集循环:计划持久保留并随每轮提示传入,指导记忆检索、继续观察和工具调用(replay、tracking、zoom)。第五步,验证与回放:规则验证器把检索记录按主体-属性分组做跨层一致性与时间启发式检查,未解决冲突成为回放候选,调度器按 $u^* = \arg\max_{u \in U_t,\ \rho(u) > \eta} \rho(u)$ 选出最优先冲突对应的帧 $\tau^*$,智能体回看该帧获取像素证据后,在当前帧继续调查直至作答。
技术新颖性
与压缩类方法(TimeChat-Online 用帧间差分去除冗余 token)不同,DeltaStreamer 的帧间比较目的不是省 token,而是生成显式 delta 记录供后续检索;与 KV 记忆类(ReKV 检索历史 KV 状态、StreamMem 维护查询无关压缩 KV)不同,它的记忆是文本化、可解释、可溯源的,能沿源链接回到视频帧本身。与已有智能体工作相比:StreamAgent 强调在线交互的预期性规划,EventMemAgent 组合事件记忆、视觉锚点和事件间变化日志,OASIS 做粗到细的检索意图生成,但它们存储的表征仍可能在观察时漏掉后续所需证据;DeltaStreamer 把“直接相邻帧对比产生的 delta + 持久化结构化证据契约 + 验证器触发的定向历史帧回放”三者耦合:计划显式指定目标与时间锚点,并在后续所有检索与工具轮次中持续生效,包括当文本记忆不足时回到像素级证据。消融量化了各设计的必要性:去掉计划持久性 HLD 从 69.89 跌回 65.83,去掉回放总分从 66.07 降到 63.28(工具中损失最大),分层记忆对平铺记忆 +4.82 分。
实验结果
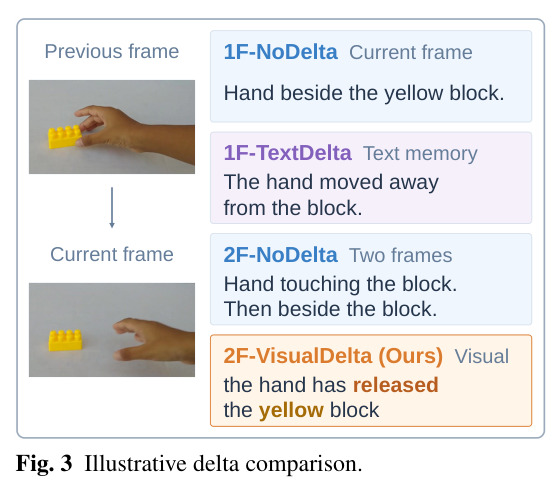
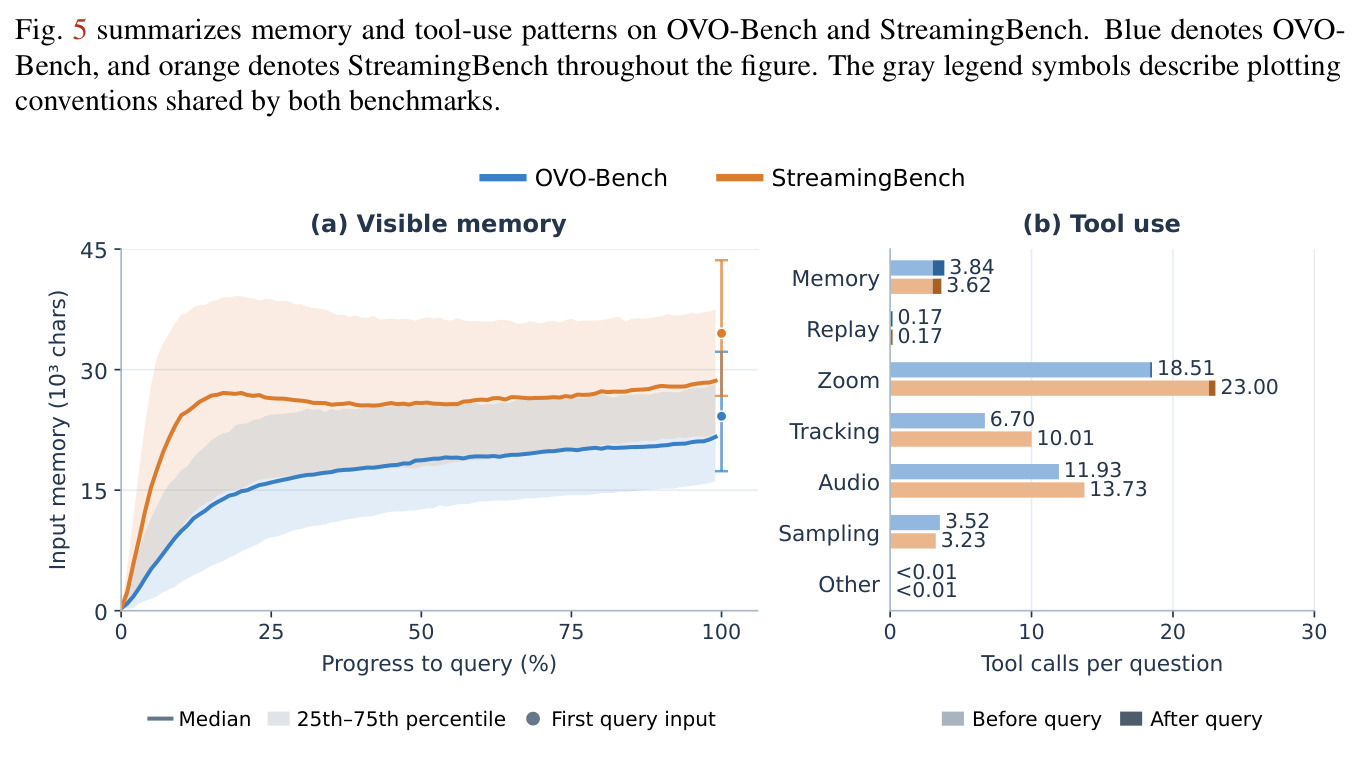
实验结果分三层。基准对比:在 OVO-Bench 上 DeltaStreamer 总分 66.07%,比最强在线方法 EventMemAgent(60.75%)高 5.32 分,比 Gemini 3 Flash(64.02%)高 2.05 分,比 GPT-4o(59.54%)高约 6.5 分;细项上动作序列识别 ASI 达 79.05、幻觉检测 HLD 达 69.89、实时感知+反向追踪组平均(RT+BT Avg)69.98(EventMemAgent 为 63.16),主动响应组平均 58.25 也是在线方法中最高。在 StreamingBench 上总分 59.53%,超过 STRIDE(57.58%)和 StreamAgent(57.02%),上下文理解中 MCU 55.20、SQA 47.60 均优于对比方法,但主动响应 PO 仅 10.40,是明显短板。消融方面:同样的两帧输入下,显式视觉 delta 把 OVO-Bench 从 61.12(2F-NoDelta)提到 66.07(+4.95),也优于拿当前帧与文本记忆比较的 1F-TextDelta(63.19)和单帧无 delta 的 58.87。记忆消融:分层记忆 66.07 对平铺记忆 61.25,去掉 DAG 降到 62.73、去掉实体索引 63.40、固定分段 63.77 对比在线 BOCPD 分段 66.07。规划器消融:无规划器时 HLD 仅 45.28,加计划生成跃至 65.83(总分 63.85),加持久性 69.13(64.77),加视角字段 68.07(65.14),加证据契约补齐 69.89(66.07)。组件组合:D+M+P(66.07)显著高于任何单组件(D 58.06 / M 58.37 / P 59.41)和两两组合(59.30–61.25),且有 M 时加 D 的收益从无 P 时的 +0.93 放大到有 P 时的 +4.95。渲染与工具消融:“钉住+情景+近期尾部”63.69,加中间召回后到 66.07(全历史 59.18、仅近期尾部 60.04);去掉 replay 损失最大(66.07→63.28),去掉 zoom 64.16、去掉 tracking 65.31。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| OVO-Bench 整体(流式视频理解) | Overall Score (%) | 66.07 | EventMemAgent 60.75;Gemini 3 Flash 64.02;GPT-4o 59.54 | +5.32(对比最强在线方法);+2.05(对比 Gemini 3 Flash) |
| OVO-Bench 实时感知+反向追踪 | RT+BT Avg (%) | 69.98 | EventMemAgent 63.16 | +6.82 |
| OVO-Bench 幻觉检测 | HLD (%) | 69.89 | 无规划器版本 45.28;FOLIO 84.60(离线) | 规划器逐项叠加从 45.28 提至 69.89(+24.61) |
| StreamingBench 整体(流式视频理解) | Overall (%) | 59.53 | STRIDE 57.58;StreamAgent 57.02 | +1.95 |
| 显式视觉 delta 消融(OVO-Bench) | Overall (%) | 66.07(2F-VisualDelta,两帧视觉对比) | 61.12(2F-NoDelta,同两帧输入无 delta) | +4.95 |
| 记忆组织消融(OVO-Bench) | Overall (%) | 66.07(分层 DAG + 实体索引 + BOCPD 分段) | 61.25(平铺记忆) | +4.82 |
| 工具消融(OVO-Bench) | Overall (%) | 66.07(完整工具集) | 63.28(移除 replay) | replay 移除后下降 2.79,为所有工具中损失最大 |
局限与改进
作者明确承认的局限是主动响应时机:StreamingBench 的 PO(proactive responding)只有 10.40,远低于其整体水平,作者坦言证据处理的改进本身并不能解决“什么时候该主动开口”的时机判断问题。作者同时指出文本记忆天然无法保留所有细节,必须依赖回放机制补救。我自己的观察还有几点:第一,系统对每个采样帧都要跑一次 VLM 观察,查询后又有规划、多轮检索、验证、回放等多轮调用,虽共享一个 27B 骨干并以 8×A100 + vLLM 服务,但端到端延迟和算力成本对直播、机器人等真实时场景是沉重负担,论文未报告延迟数字;第二,新颖度评分基于 Jaccard 词集重叠,对同义改写(同一事件换措辞描述)的识别能力有限,可能误判新颖性;第三,回放要求保留全部历史帧,长时流场景的存储成本没有讨论;第四,评测集中在两个多选/计数型基准上,开放式生成质量和真实部署的鲁棒性未经验证。
独立分析的弱点
第一个弱点是主动响应时机(PO 仅 10.40):主动回答本质是“当前信息量/不确定性是否达到发言阈值”的决策,与证据检索是两个不同的问题,本文的证据契约对此无能为力。改进方向是为响应时机单独建模,例如让规划器额外输出一个“证据是否足以主动发言”的置信通道,或引入基于信息增益的发言阈值。第二个弱点是推理成本:观察阶段每帧一次 VLM 调用,查询后多轮规划-检索-验证-回放串行执行,1 fps 长视频下调用量线性增长,实时性存疑。方向是级联化——用小模型做高频观察、大模型只在变化检测触发时介入,并对快照渲染做增量缓存。第三个弱点是文本瓶颈:颜色、精确空间关系等像素信息一经文本化就有失真,回放虽能补救但以额外延迟为代价。方向是像 EventMemAgent 那样保留轻量视觉锚点(关键区域 crop 或特征向量),把“回看”从整帧降为局部检索。第四,Jaccard 新颖度基于词面重叠,语义重复但措辞不同的事件会被误判为新颖,可换成轻量语义嵌入相似度。第五,跨层一致性验证目前是手工规则启发式,规则未覆盖的冲突类型会漏检,验证器和冲突优先级 $\rho$、阈值 $\eta$ 均可学习化。
未来方向
作者在结论中把“持续观察记忆、提问时主动调查”确立为一种新的流式范式,最直接的延伸就是补齐主动响应时机这块短板,把变化感知记忆与发言时机建模结合。基于本文成果还可延伸:把 delta 记忆迁移到具身智能与机器人在线决策——机器人正是“必须边行动边记、事后被问起要能回查”的场景;扩展到全模态流(音频、传感器时序),“什么变了”的建模思想是模态无关的;研究记忆的遗忘与压缩策略——当前系统只增不减,长期运行的存储与检索效率需要分层淘汰机制;把回放从规则触发的单帧回看扩展为多跳“取证链”,支持需要串联多个时刻证据的复杂问题;以及用端到端训练替代手工设计——新颖度字段权重、冲突优先级、回放阈值目前均为启发式设定,让记忆组织和验证策略变得可学习是一个自然的下一步。
复现评估
复现评估:论文给出项目主页(bbbbchan.github.io/DeltaStreamer),实现细节相当完整——共享骨干为 Qwen3.6-27B,vLLM BF16 推理,8×NVIDIA A100,1 fps 采样加骨干自带图像预处理;附录 A.1–A.5 提供了新颖度字段权重、记忆构建与快照渲染、规划器字段(含视角与证据契约)、工具使用规则、冲突规则与候选上限等细节。两个评测基准 OVO-Bench 和 StreamingBench 均公开,主表中数十个对比方法的结果齐全,可对照校验。不确定因素是代码与权重是否开源——正文截至 v1 只给了项目页链接,未见明确的开源声明,而这类多组件智能体系统(三层 DAG、实体索引、验证器、调度器)的工程复杂度高,且多轮 VLM 调用意味着复现实验的推理开销不低。综合判断:若有官方代码,复现难度中等;若从零实现,属于中偏高难度。建议路径:先按附录复现单帧观察 + 记忆构建并检查快照质量,再叠加规划器,最后接入验证器与回放。
论文图表
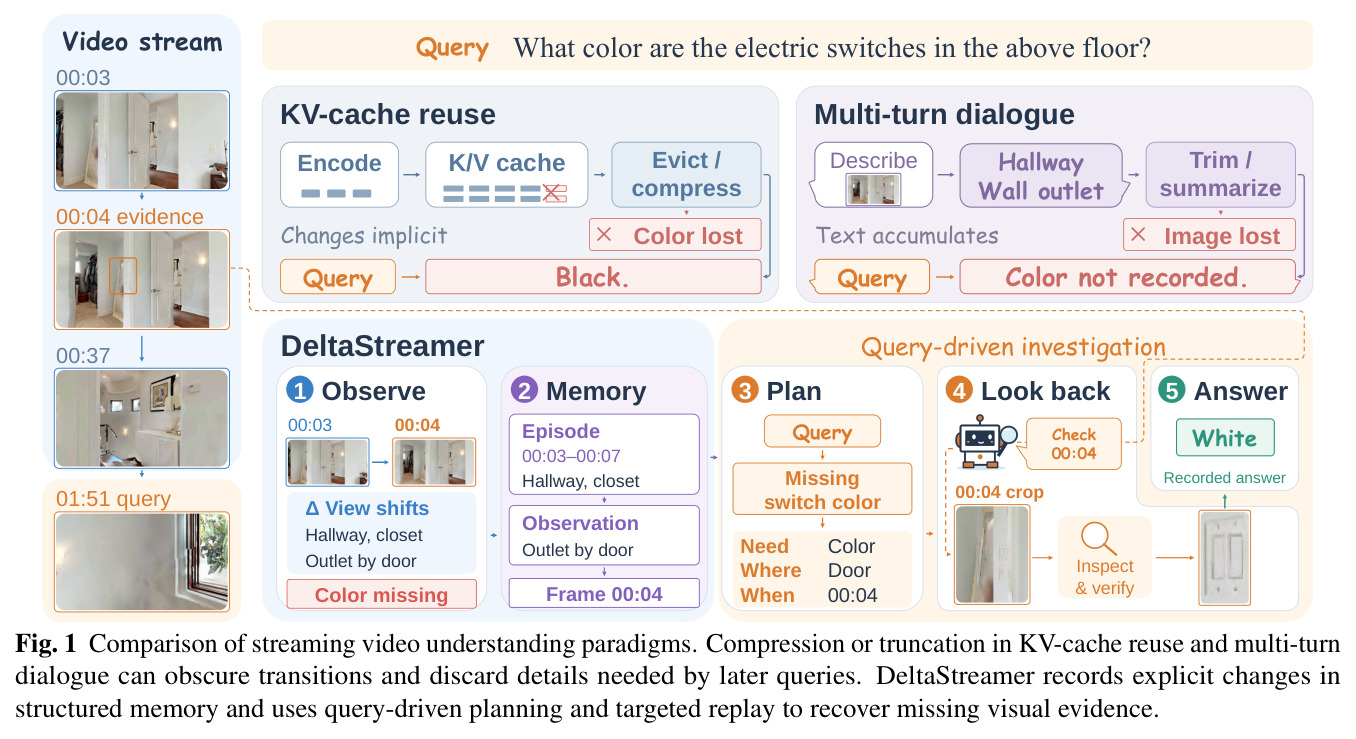
用同一个“走廊电闸颜色”例子对比三种范式:KV-cache 复用在编码/压缩时把颜色信息隐掉,多轮对话在修剪/摘要时丢掉图像只剩文字,两者都无法回答“电闸是什么颜色”;下半部分展示 DeltaStreamer 的五步流程(观察-记忆-规划-回看-回答),通过记录“视野移动”等变化、发现颜色缺失、回看 00:04 帧的裁剪图,最终答出“白色”。
一图看懂本文动机:现有范式为什么会在查询需要时拿不出证据,以及 DeltaStreamer 的“记录变化 + 定向回看”如何补救。这是理解全文定位的入口。
OVO-Bench 全量主表,按实时视觉感知(OCR/ACR/ATR/STU/FPD/OJR)、反向追踪(EPM/ASI/HLD)、主动响应(REC/SSR/CRR)分列,对比人类、专有模型、离线开源模型、有限在线模型和完整在线模型/视频智能体共 20 余个方法,DeltaStreamer 总分 66.07 居首。
核心结果表:证明方法在反向追踪组(RT+BT Avg 69.98)的优势最大,并给出 ASI 79.05、HLD 69.89 等支撑论文主张的细项证据。
StreamingBench 全量主表,覆盖实时视觉理解、全源理解和上下文理解三大组共 20 个细项。DeltaStreamer 总分 59.53 超过 STRIDE(57.58)和 StreamAgent(57.02),但主动响应 PO 仅 10.40,明显低于多项对比方法。
第二核心结果表:既确认方法在上下文理解上的收益(MCU 55.20、SQA 47.60),也暴露 PO 短板,是客观评估方法边界的依据。
对比四种观察契约在 OVO-Bench 的得分:1F-NoDelta 58.87、1F-TextDelta 63.19、2F-NoDelta 61.12、2F-VisualDelta(本文)66.07。关键对照是同样两帧输入下,显式视觉 delta 比无 delta 高 4.95 分。
把“显式变化记录”与“额外视觉输入”两个因素解耦,是支撑核心创新点有效性的最关键消融。
四个迷你表分别消融记忆组件:(a) 分层 66.07 对平铺 61.25;(b) 有 DAG 66.07 对无 DAG 62.73;(c) 有实体索引 66.07 对无索引 63.40;(d) 在线 BOCPD 分段 66.07 对固定分段 63.77。所有变体共享相同的观察、工具、规划器和解码。
逐项证明记忆设计的每个部件(层级、DAG 组织、实体索引、在线分段)都有独立贡献,说明分层记忆 +4.82 分不是单一因素驱动。
左表累进叠加规划器组件:无规划器 HLD 仅 45.28,+计划生成 65.83(总分 63.85),+持久性 69.13(64.77),+视角 68.07(65.14),+证据契约 69.89(66.07)。右表组合 delta(D)/分层记忆(M)/规划器(P):单组件 58.06–59.41,两两组合 59.30–61.25,D+M+P 66.07;有 M 时加 D 的收益从无 P 的 +0.93 放大到有 P 的 +4.95。
揭示两个重要结论:计划生成本身就带来 HLD 的最大跳变(45.28→65.83);组件间存在超加性协同,规划器让 delta 的价值翻数倍。
左表消融记忆渲染策略:全历史 59.18、仅近期尾部 60.04、钉住+情景+尾部 63.69、分层+中间召回(本文)66.07。右表消融视觉工具:完整工具集 66.07,去掉 replay 降到 63.28(损失最大),去掉 tracking 65.31,去掉 zoom 64.16。
说明两点:摘要之外必须保留按问题召回旧观察的通道(+2.38);回放是所有工具中对“找回从未编码的像素证据”贡献最大的能力。