循环均匀扩散语言模型 Looped Uniform Diffusion Language Models
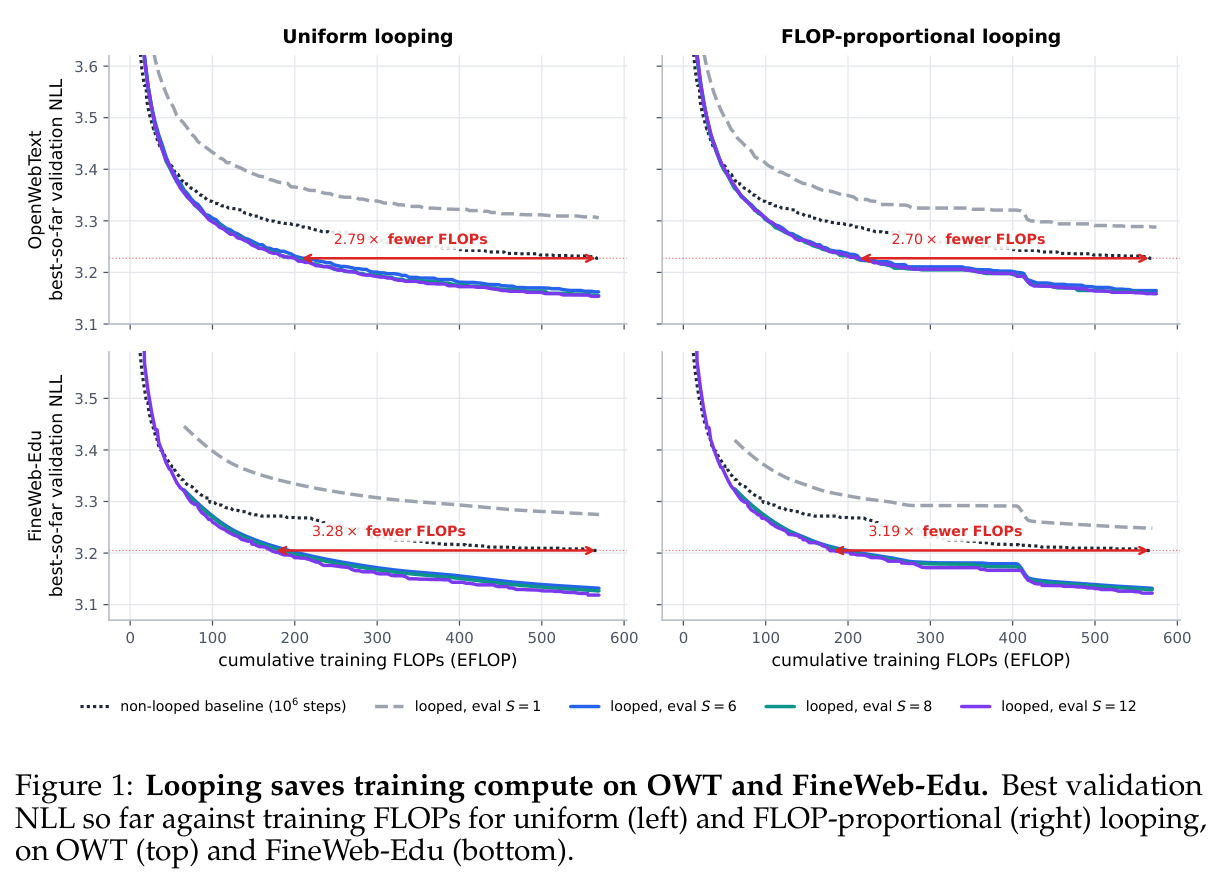
循环复用中间层,均匀扩散语言模型训练FLOPs最多省3.3倍
前置知识
均匀扩散语言模型(UDLM)
离散扩散语言模型的一种。前向过程把每个 token 以概率 $1-\alpha_t$ 替换为从词表均匀抽取的普通 token,而非掩码符号,因此输入中看不出哪些位置被腐蚀;反向去噪时所有位置并行更新,任何已生成的 token 都可在后续步被修订。
本文所有问题的根源都是 UDLM 的「无标记腐蚀」:去噪器必须从不靠谱的上下文里同时推断保留概率与干净 token,这正是循环要解决的痛点。
掩码扩散语言模型(MDLM)
用专用 mask 符号替换被腐蚀 token 的离散扩散范式:被腐蚀位置总是已知,未掩码 token 在标准吸收态反向过程中永不改变。去噪器总在干净上下文上预测,训练更省 FLOPs;Lee et al. (2026) 已证明在其中循环早期中层切片可提升训练效率。
本文是把已验证于 MDLM 的循环技术迁移到腐蚀结构完全不同的 UDLM,两者对比是全文动机与方法设计的基准。
权重共享循环
把 Transformer 的一段中间层切片用同一组权重反复应用:$h^{(r+1)}=M_\theta(h^{(r)},t)$。$S$ 次循环相当于 $n_H+Sn_B+n_T$ 层深度,参数量不变、计算量随 $S$ 线性增长,源自 Universal Transformer 一脉,思想是按输入难度动态分配计算。
这是本文唯一的架构改动——在同一噪声输入上重放中间两块,理解「加深不加参」才能读懂训练与推理两侧的 FLOP 分析。
DUO/DUO++ 训练框架
UDLM 的高效训练配方:以高斯辅助向量 $w_t=\tilde\alpha_t x+\sqrt{1-\tilde\alpha_t^2}\,\epsilon$ 构造输入,硬 token $z_t=\arg\max_j w_{t,j}$ 恰好满足 UDLM 边际;训练前半程用温度 softmax 软输入做课程、后半程用硬 token,损失为速率形式 NELBO,收敛约快 2 倍;DUO++ 用 top-k 近似软输入再省 33% 峰值内存。
实验全部建立在 DUO++ small 与 Ψ 采样器上,且本文刻意不改训练目标与采样器,只改去噪器的深度结构。
Iso-FLOP 与 NFE
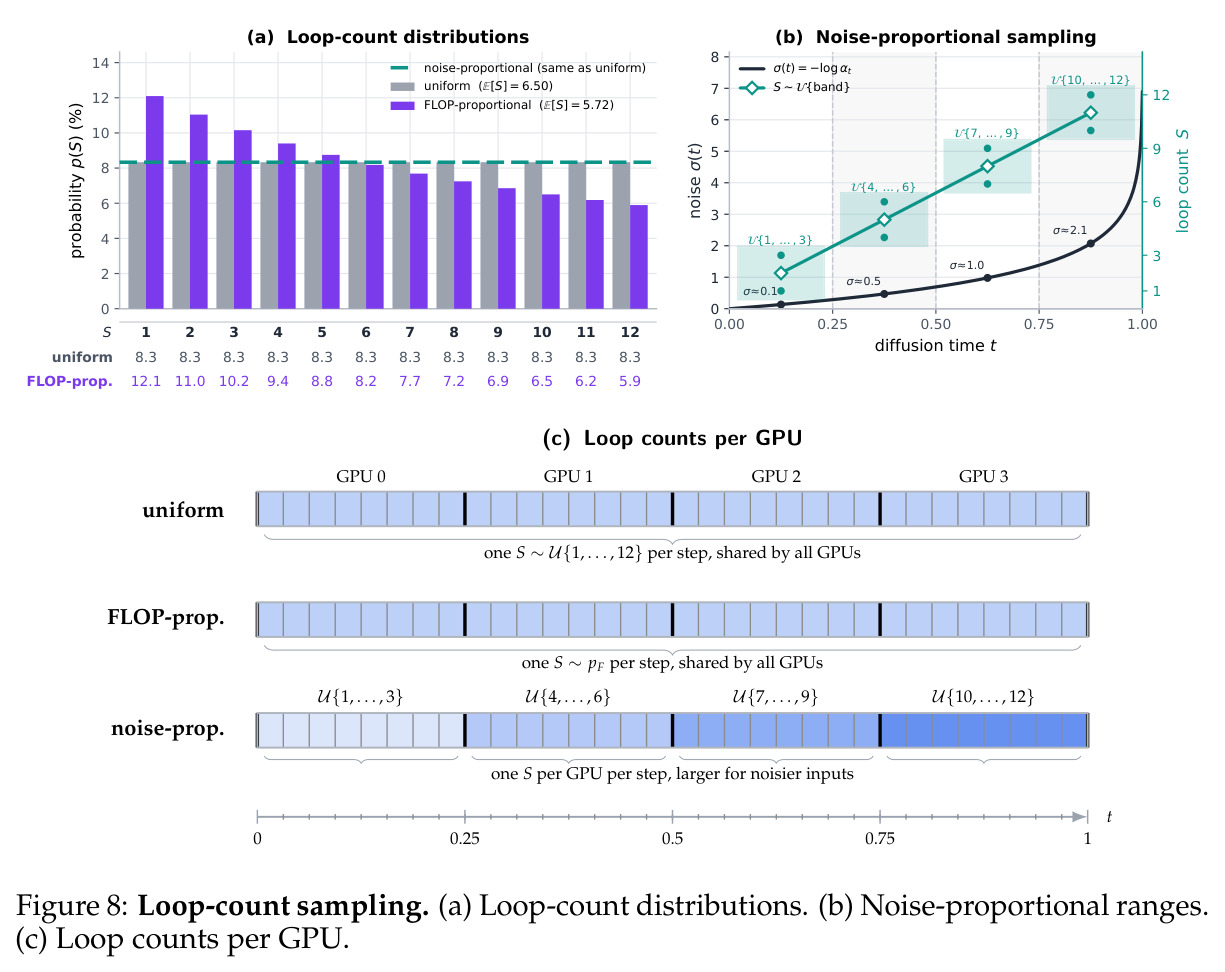
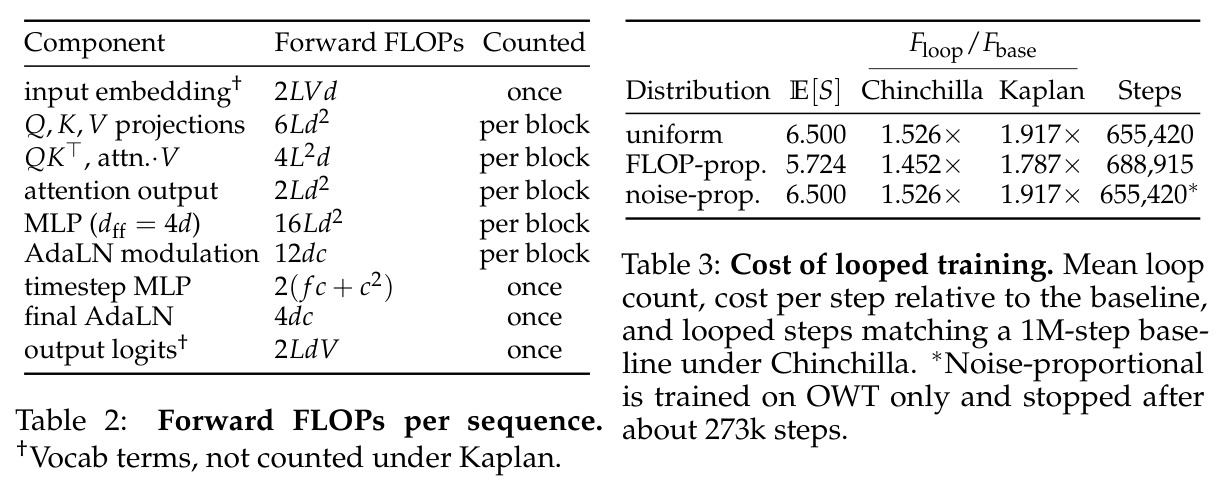
Iso-FLOP 指在相同累计训练 FLOP 预算下比较验证 NLL:循环步更贵,故均匀分布平均每步 6.50 次循环、FLOP 成比例 5.72 次,同样预算可训练的步数不同。NFE 是推理侧的去噪器调用次数;固定 $S=6$ 推理 FLOP 为 $S=1$ 的 1.48 倍,$S=12$ 为 2.05 倍。
论文所有效率结论都以这两个预算为坐标轴,弄清口径才不会高估或低估收益。
研究动机
均匀扩散语言模型(UDLM)的训练天生比掩码扩散更难:前向过程把被腐蚀的 token 替换成词表中的随机普通 token,输入里没有任何标记指示哪些位置被动过手脚。去噪器因此在每个位置要同时推断两件事——观测 token 被保留的概率 $\gamma_t^\ell$ 和干净 token 本身——而且上下文本身可能也是坏的,这些判断还相互耦合。同样的验证 NLL,UDLM 需要比 MDLM 花更多训练 FLOPs(Sahoo et al. 2026b)。随着均匀扩散被 scaling 到十亿参数级的推理模型(DiffusionGemma、Sahoo et al. 2026a),这一成本差距日益突出。现有加速手段几乎都集中在减少去噪步数(更好的采样器或蒸馏),每个去噪步内部的计算质量问题没人系统研究过;Lee et al. (2026) 的选择性循环只在掩码扩散上验证过——那里被腐蚀位置是显式已知的,循环在腐蚀不可见的 UDLM 上是否有效完全是开放问题。
本文的目标是本文要在完全不动 DUO++ 训练目标和 Ψ 采样器的前提下,把权重共享循环引入 UDLM 去噪器,并回答两个问题:其一,循环对 UDLM 这种「上下文不可靠」的去噪有多大帮助;其二,训练时循环次数的分布 $p(S)$ 如何影响训练与推理效率。可量化的目标包括:在相同训练 FLOP 下追平非循环基线的验证 NLL(基线训练约 0.5 万亿 token);在相同 NFE 下降低生成困惑度(Gen PPL);在 7 个域外数据集上降低零样本困惑度;并通过自适应循环和更优的循环次数分布,在精度不掉的前提下把推理时的循环次数减少 25% 以上。
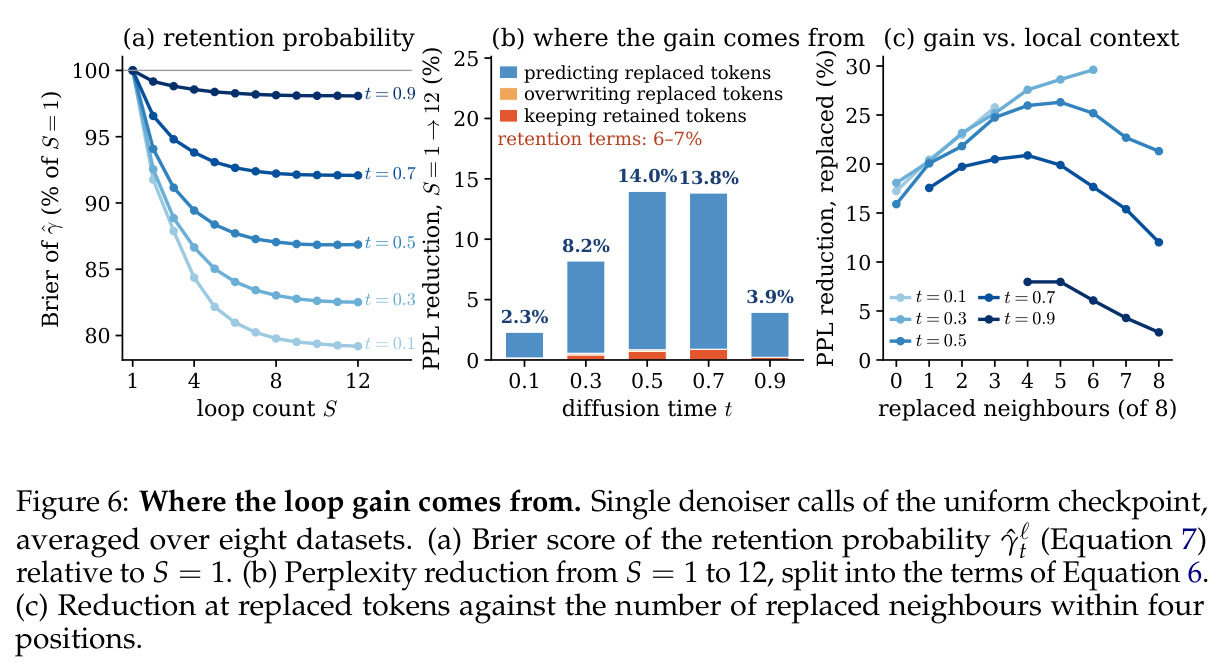
与已有工作不同的是,已有循环研究的共同前提是掩码扩散:哪些位置未解决是显式给定的,循环只需加深对未解决位置的计算。本文第一个证明:即便腐蚀完全不可见、任意 token 都可能被修订,权重共享循环依然能大幅提升效率,并进一步用贝叶斯可靠性分解定位收益来源——93–94% 的困惑度下降来自被替换 token 的上下文预测改善,而非保留判断。此外,本文首次把「训练时循环次数分布」当作独立自由度研究:除了继承自 LoopMDM 的均匀分布,提出 FLOP 成比例分布(让每个循环次数分到相同的期望训练 FLOPs,小循环次数被更频繁采样)和噪声成比例分布(噪声越大循环越多),并发现训练分布会实质改变推理时自适应循环的停止行为——这是此前工作完全没触及的维度。
核心方法
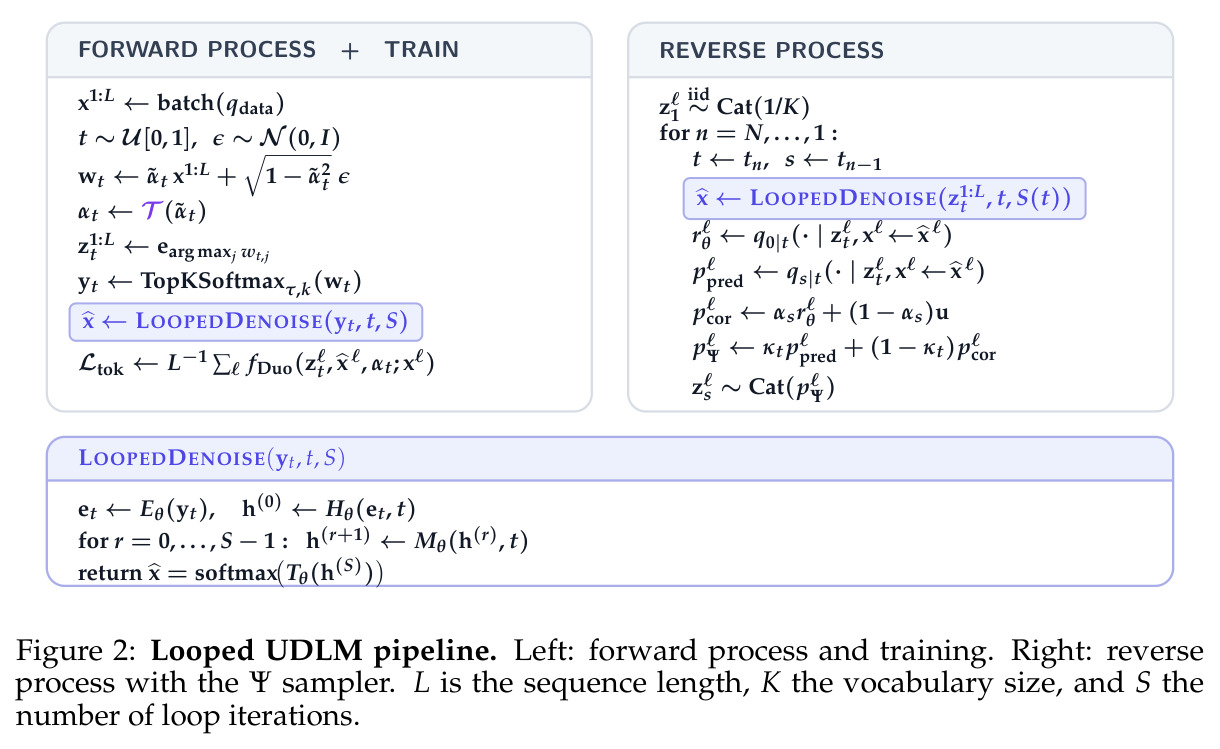
直觉上,UDLM 去噪器面对的是一道歧义消解题:一个 token 与上下文不符时,是它坏了还是邻居坏了?这类问题靠多想几遍来收敛——把答案反复精化。与其加深加宽网络堆参数,不如让中间一段 Transformer 层在同一噪声输入上迭代跑 $S$ 次:嵌入 $e_t=E_\theta(y_t)$,头部 $h^{(0)}=H_\theta(e_t,t)$,循环 $h^{(r+1)}=M_\theta(h^{(r)},t)$,尾部输出 $\hat x=\mathrm{softmax}(T_\theta(h^{(S)}))$。$S$ 次循环等效于 $n_H+Sn_B+n_T$ 层深度但零新增参数。训练时每个优化步从分布 $p(S)$($S_{max}=12$)抽一个循环次数,对每次迭代都回传 DUO++ 损失的梯度,最终得到一个可用任意循环次数推理的单一模型。推理时循环次数变成自由参数:可以全程固定 $S$,也可以监控隐状态的相对变化量,一旦低于阈值就提前停止。噪声序列与扩散时间在循环内部始终固定,只在不同去噪步之间变化。
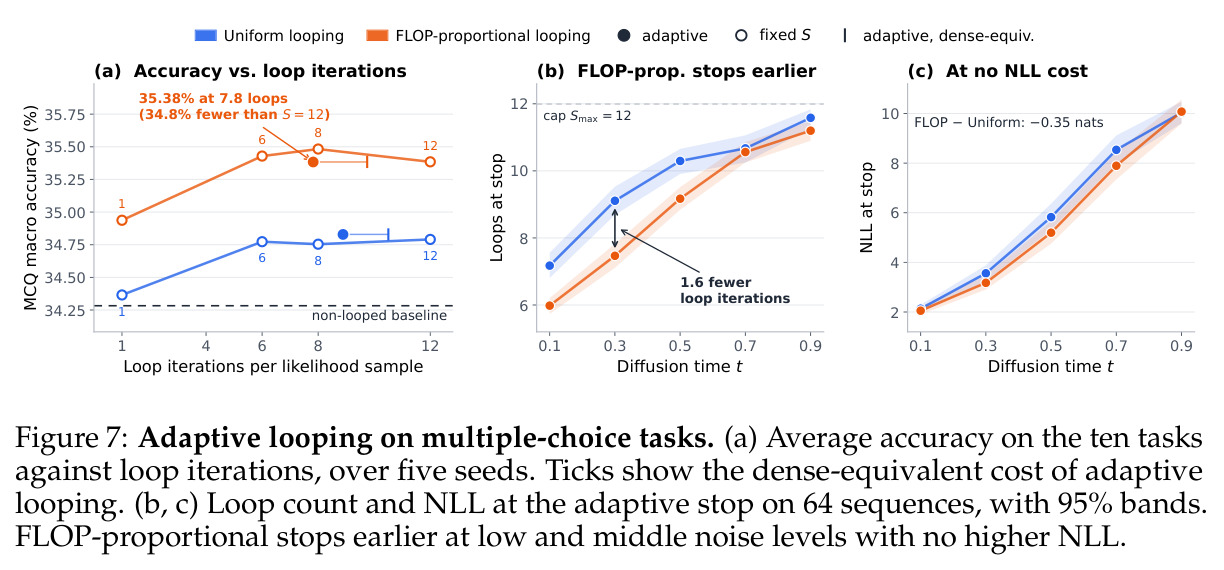
核心创新有三层。第一,迁移本身:证明不改任何训练目标与采样器、只在去噪器内循环中间两块,UDLM 就能省 2.7–3.3 倍训练 FLOPs——与 LoopMDM 的本质区别在于 UDLM 的腐蚀不可见、已生成 token 可被修订,循环在这种更难的腐蚀结构下依然有效,这并非显然。第二,机制解释:借助保留概率 $\gamma_t^\ell=\frac{\alpha_t\pi_t^\ell(i)}{\alpha_t\pi_t^\ell(i)+(1-\alpha_t)\nu(e_i)}$ 的贝叶斯分解,发现循环几乎不改善「哪些 token 该保留」的判断($S=1$ 时 AUROC 已 $\geq 0.96$),93–94% 的增益来自被替换位置上下文预测 $\pi_t^\ell$ 的精化——循环本质上是在迭代求解更准的 $\hat\pi_t^\ell$。第三,循环次数分布工程:FLOP 成比例分布 $p_{fp}(S)\propto F(S)^{-1}$ 让每个循环次数的期望训练开销相同,训练出的模型把深度预算倾斜向小循环次数,推理时自适应停点更早、MCQ 精度反而更高。
方法步骤详情
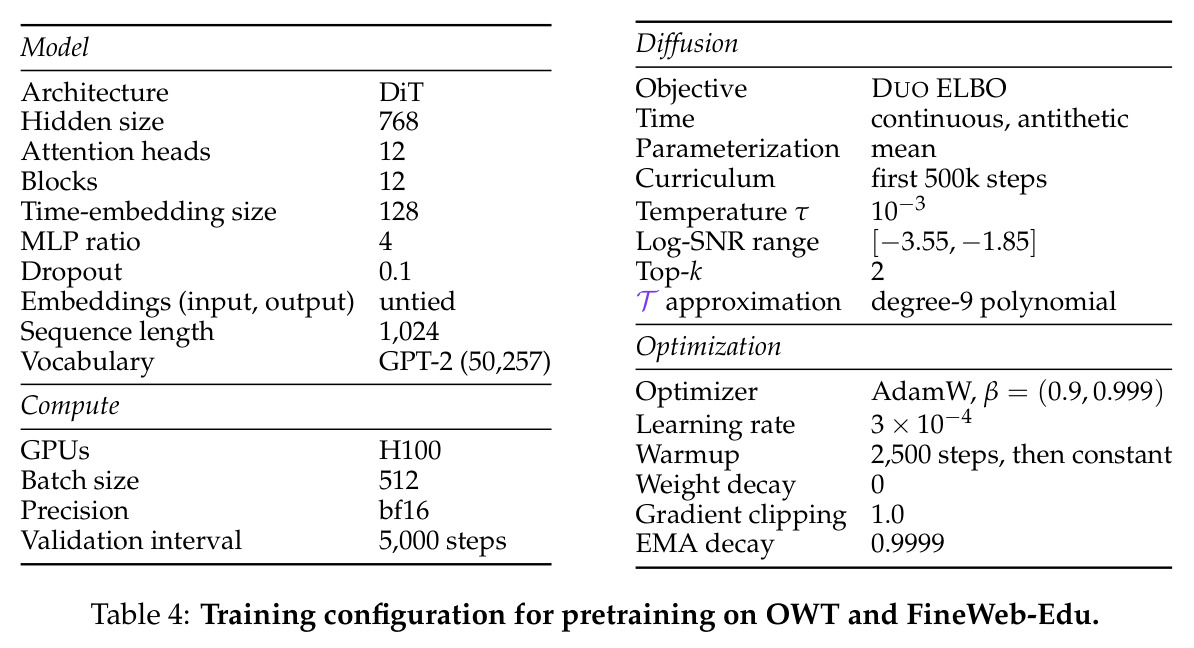
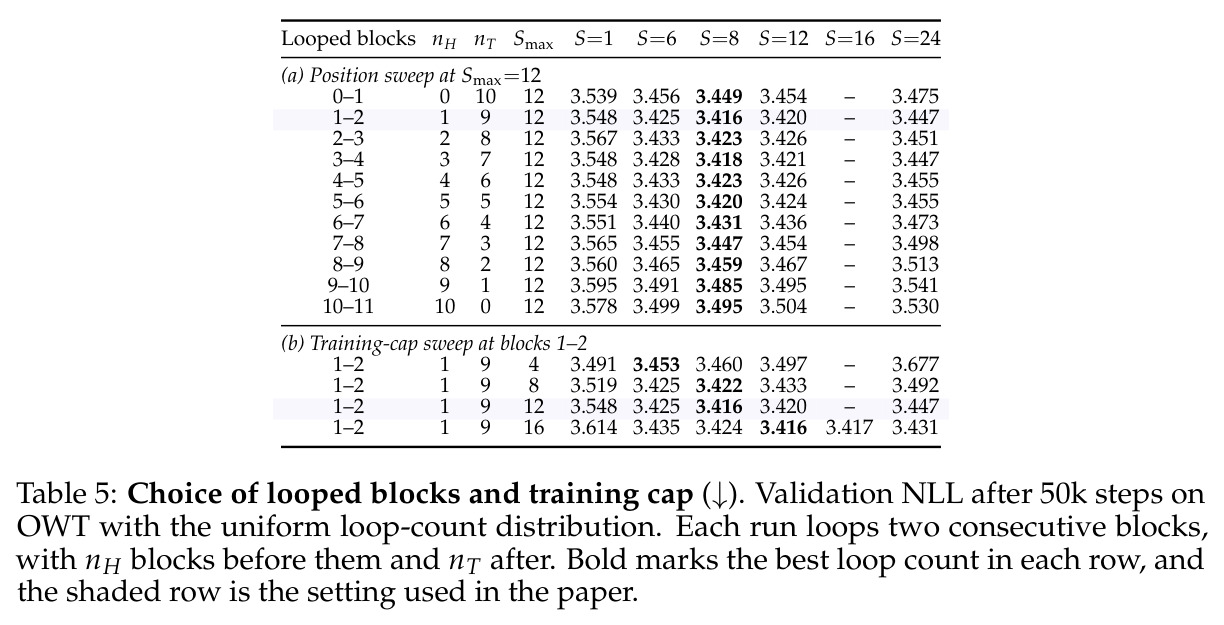
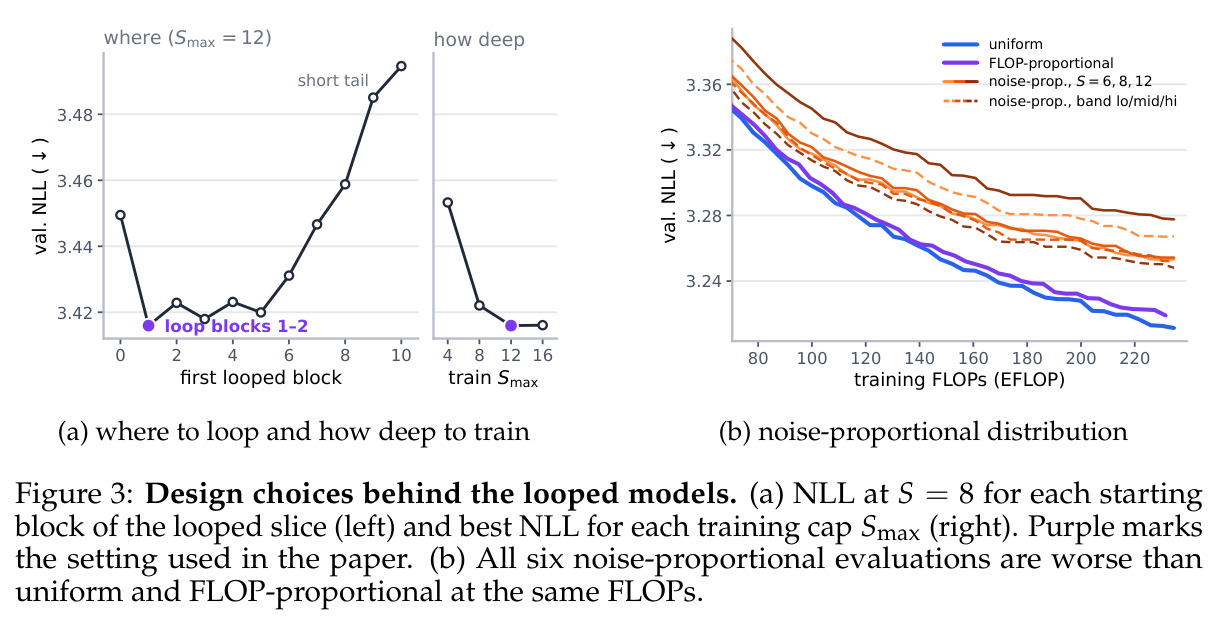
流程分五步。(1) 架构切分:把 170M 参数的 DUO++ DiT(12 块、宽度 768、GPT-2 词表、序列 1024)切成头部 $H_\theta$、中段切片 $M_\theta$、尾部 $T_\theta$(含输出投影);消融显示块 1–5 内任意起点效果相当、$S_{max}>12$ 无增益,故选定块 1–2、$S_{max}=12$。(2) 随机循环次数训练:每个优化步抽 $S\sim p(S)$,输入 $y_t$(课程阶段软输入、之后硬 token)嵌入后过头部,切片以相同权重循环 $S$ 次(噪声序列与时间 $t$ 在循环内固定),尾部输出预测,对 DUO++ 速率损失沿每次迭代回传梯度。(3) 三种 $p(S)$:均匀 $U\{1,\dots,12\}$;FLOP 成比例 $p_{fp}(S)=\frac{F(S)^{-1}}{\sum_{r=1}^{S_{max}}F(r)^{-1}}$,$F(S)=F_{base}(1+(S-1)\rho)$;噪声成比例:反时间采样把微批按噪声分 $G$ 带,各带从对应循环组均匀抽取。(4) 推理:固定 $S\in\{1,6,8,12\}$,或自适应循环——$\|h^{(r)}-h^{(r-1)}\|_F/\|h^{(r)}\|_F<\epsilon=0.1$ 即停。(5) 评测:NLL 对训练 FLOPs、Gen PPL 对 NFE、7 个域外困惑度、10 个 MCQ 任务。
技术新颖性
新颖性可从四个坐标定位。(a) 对 LoopMDM(Lee et al. 2026):本文是循环在均匀扩散上的首次验证,腐蚀结构根本不同(掩码显式可见 vs 完全不可见、token 可反复修订),且不止报收益,还给出「增益来自被替换 token 上下文预测」的机制归因。(b) 对 Universal Transformer 一脉的权重共享循环:首次把训练时的循环次数分布作为研究对象,证明它不是工程细节——FLOP 成比例采样(无任何新增超参,$\rho=0$ 时退化为均匀)能同时改变推理效率和下游精度权衡。(c) 对以蒸馏/采样器为主的扩散加速路线(Song 2023、Kim 2024 等):本文在单个去噪步内部做递归计算,NFE 不变而每步计算变深,方向正交可叠加。(d) 负结果也有信息量:噪声成比例分布全面落后,说明循环收益峰值在中间噪声而非最噪输入,为后续计算分配研究划出了边界。
实验结果
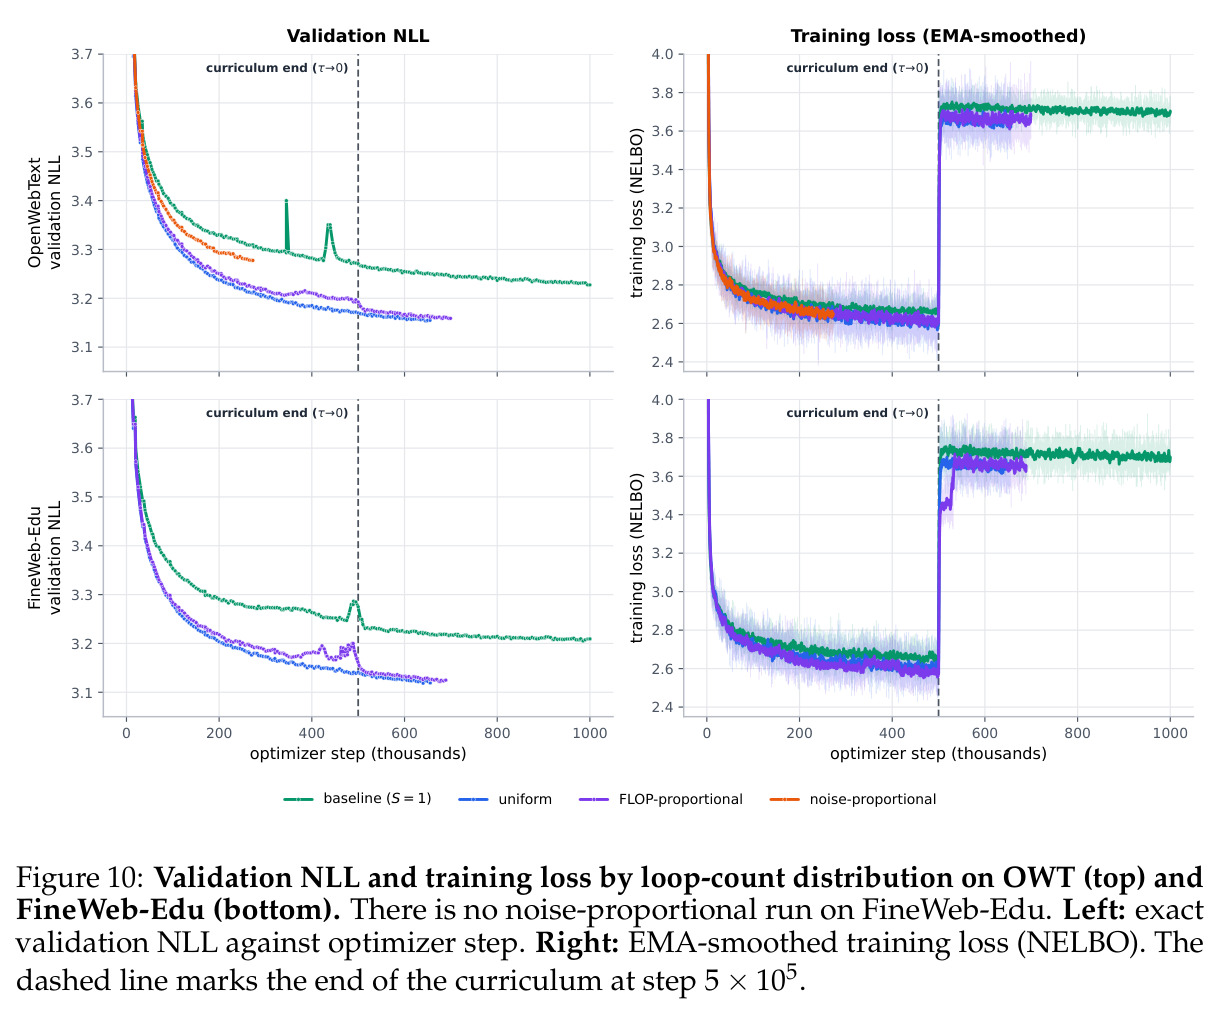
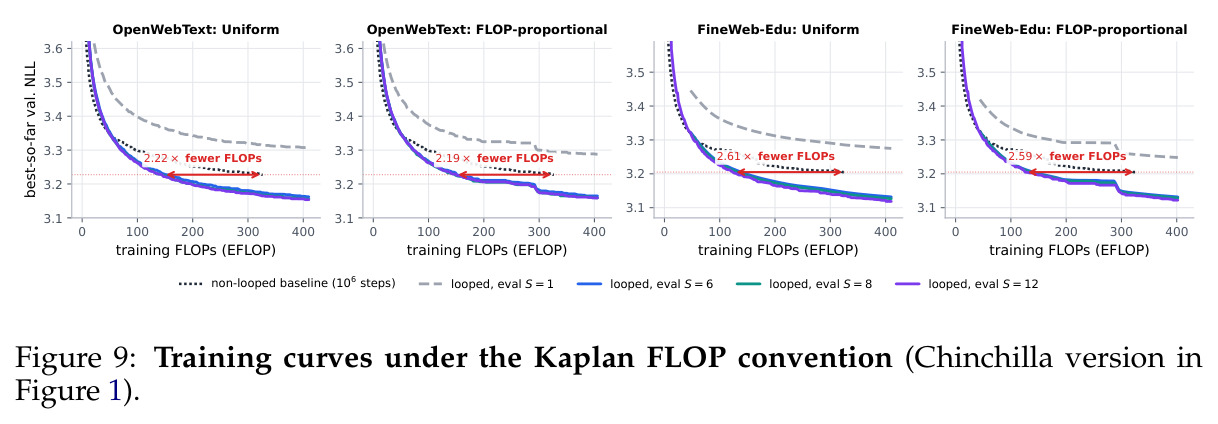
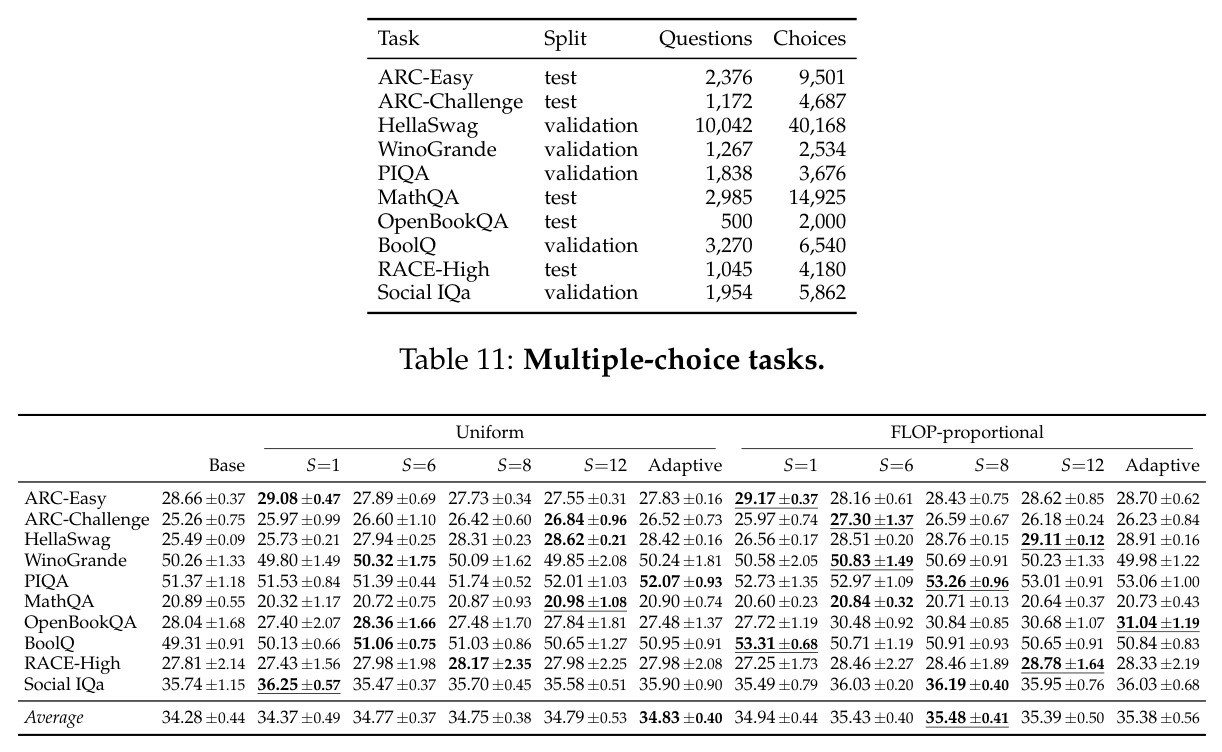
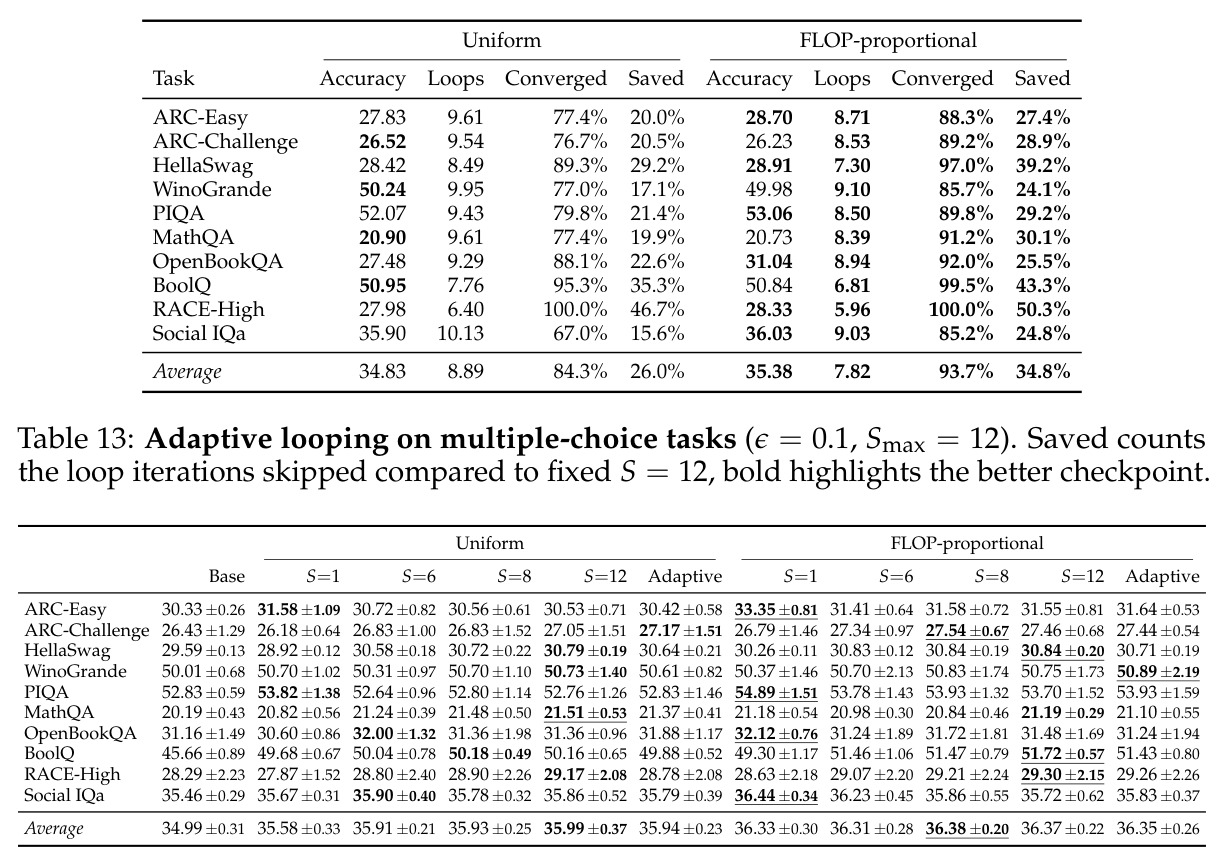
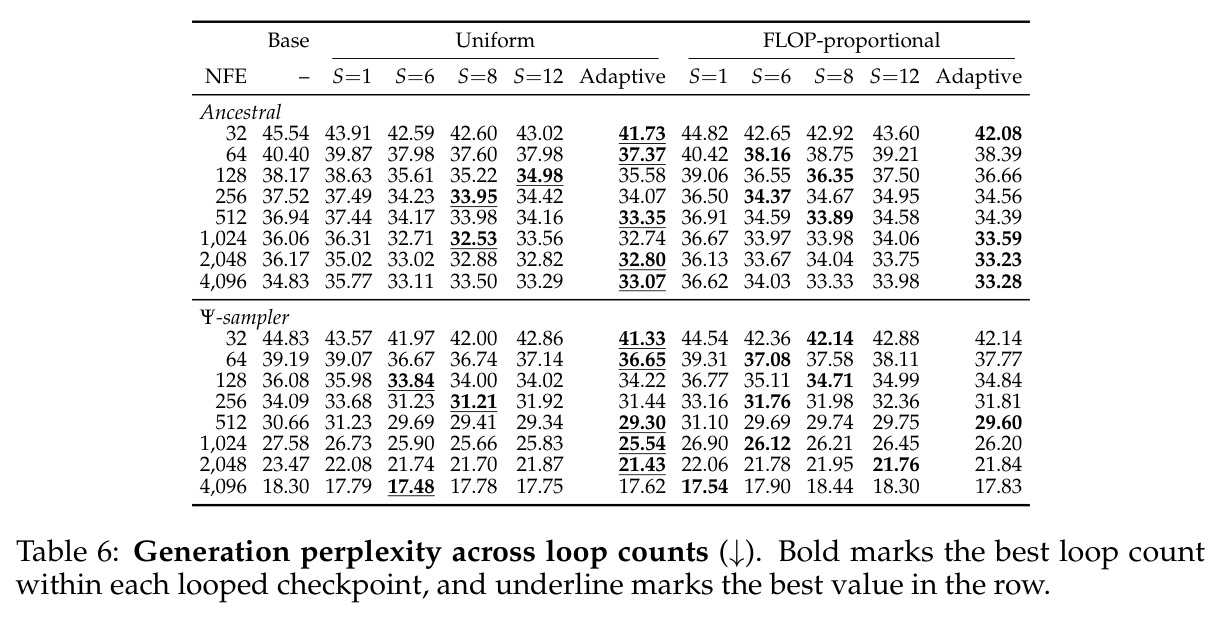
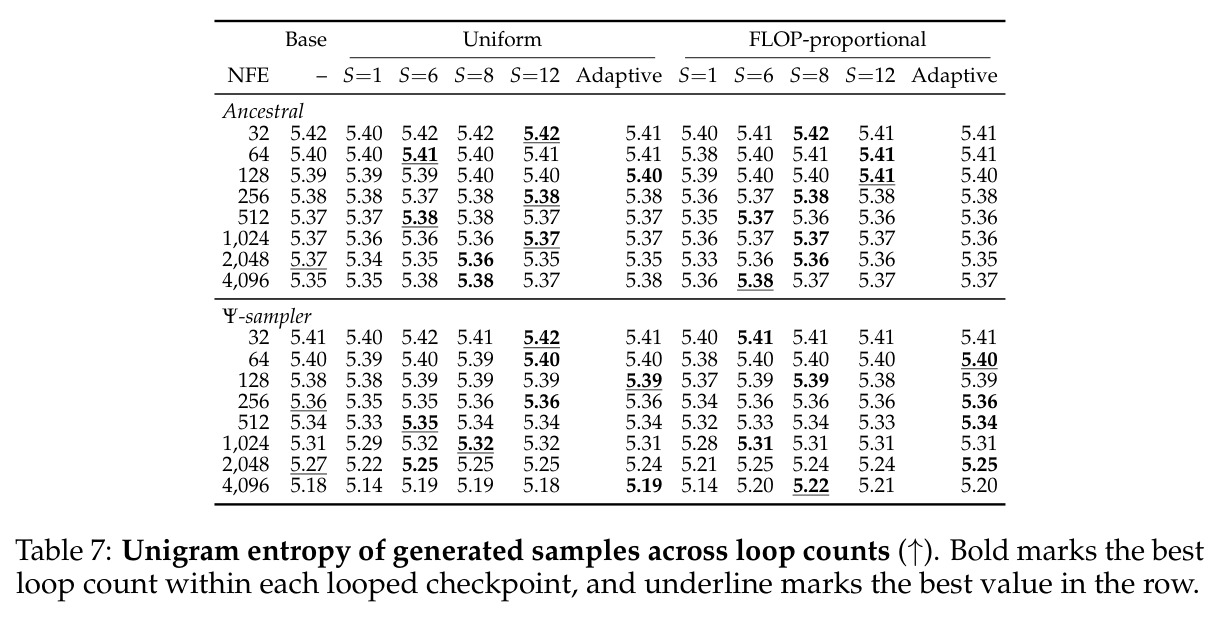
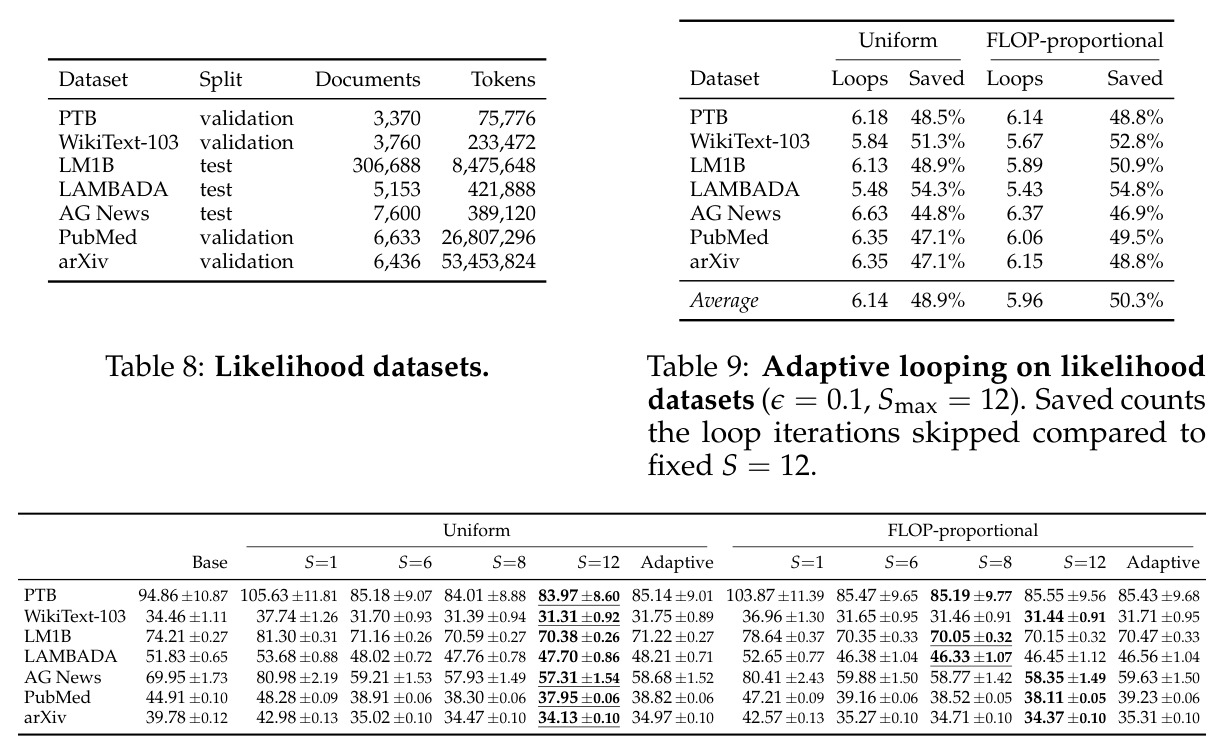
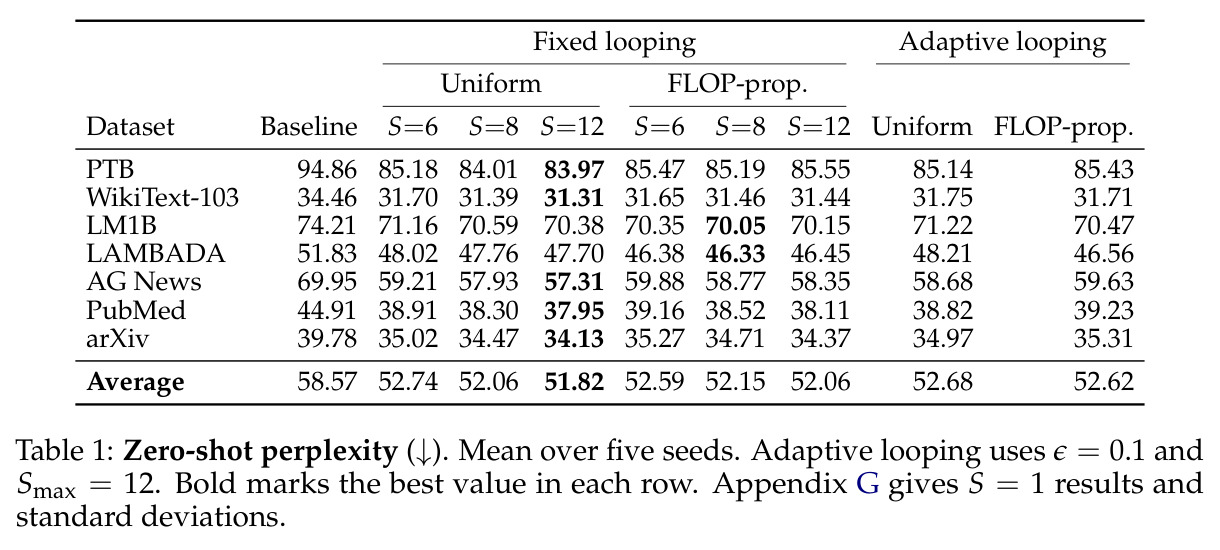
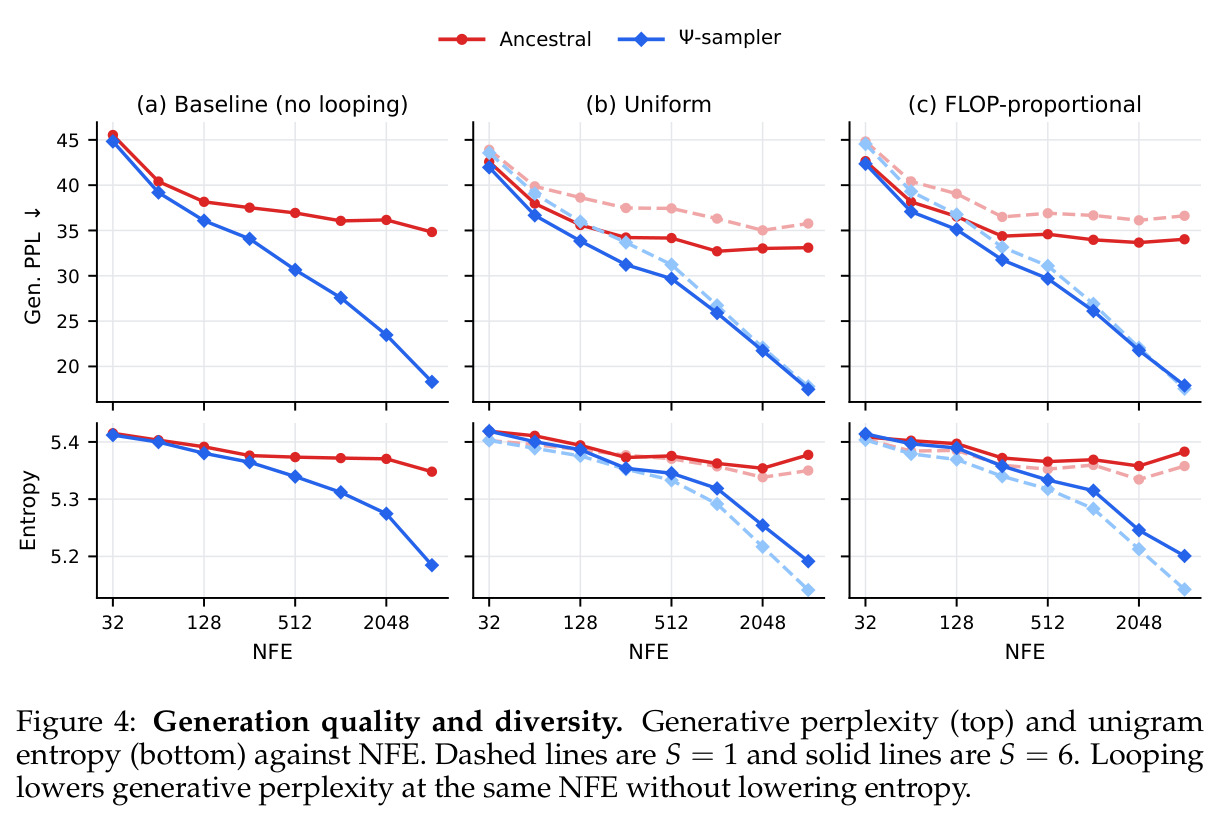
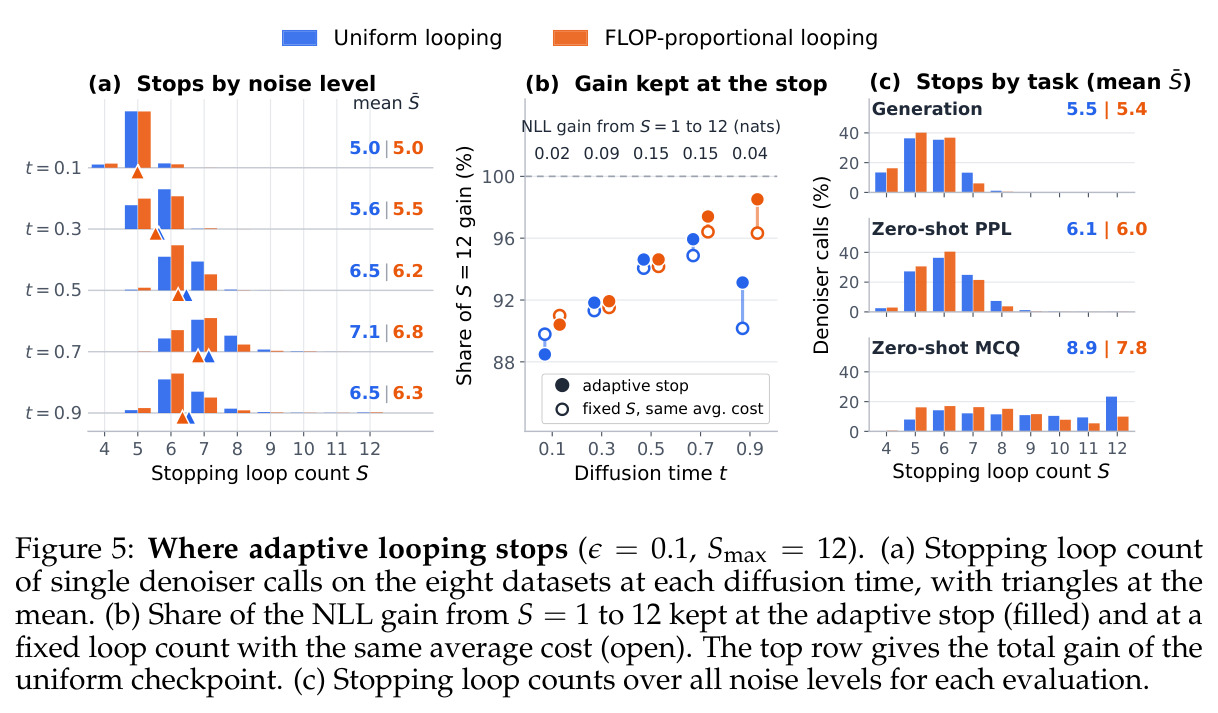
① 训练效率:循环模型在 OpenWebText 上以最多 2.8 倍(均匀)/2.7 倍(FLOP 成比例)更少训练 FLOPs 达到基线验证 NLL,FineWeb-Edu 上为 3.3/3.2 倍;基线 1M 步预算只够循环模型跑 655,420 步(均匀,平均 6.50 次循环/步)或 688,915 步(5.72 次)。FLOP 成比例最终 NLL 与均匀持平(3.159 vs 3.154),但在 $S=1$ 上更好(3.289 vs 3.306)。② 噪声成比例无收益:iso-FLOP 训练后六种评测均劣于另两个前沿,最好结果落后 +0.029 NLL。③ 推理生成:匹配 NFE 下 Gen PPL 最多降 9.8% 而熵几乎不变,增益集中在 $S=6$–8;$S=6$ 推理 FLOPs 为 $S=1$ 的 1.48 倍、$S=12$ 为 2.05 倍;自适应平均约 5.5 次循环。④ 域外困惑度:$S=1$ 循环检查点在全部 7 个数据集上都差于基线,说明收益来自推理时循环;开循环后全面反超,均匀 $S=12$ 最佳,7 数据集平均 58.57→51.82,降 11.5%;93–94% 的下降来自被替换 token 的上下文预测改善,峰值在 $t=0.5$–0.7。⑤ 下游:10 个零样本 MCQ 上 FLOP 成比例全面更准,自适应达 35.38% 宏精度,匹配固定 $S=12$ 少跑 34.8%(均匀 26.0%)次循环;代价是 Gen PPL 平均高 1.55%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 训练效率(OpenWebText) | 达到基线验证 NLL 所需训练 FLOPs | 循环 UDLM(均匀 $S_{max}=12$) | 非循环 DUO++ 基线(1M 步,约 0.5T token) | 训练 FLOPs 减少 2.8×(FLOP 成比例 2.7×) |
| 训练效率(FineWeb-Edu) | 达到基线验证 NLL 所需训练 FLOPs | 循环 UDLM | 非循环 DUO++ 基线 | 训练 FLOPs 减少 3.3×(FLOP 成比例 3.2×) |
| 文本生成 | 生成困惑度 Gen PPL(匹配 NFE,GPT-2 Large 评分) | 最多降低 9.8%,unigram 熵几乎不变 | 非循环 UDLM | ≤9.8%,大部分增益在 $S=6$–8 |
| 域外零样本困惑度(PTB/WikiText-103/LM1B/LAMBADA/AG News/PubMed/arXiv) | 困惑度(5 seeds 平均) | 51.82(均匀 $S=12$);自适应 52.68 | 非循环基线 58.57 | 平均降低 11.5% |
| 零样本多项选择(10 任务) | 宏平均精度 / 循环次数 | 35.38%(FLOP 成比例 + 自适应,平均 7.82 次循环) | 固定 $S=12$(同等精度;均匀自适应 8.89 次) | 同等精度少 26.0%–34.8% 循环 |
局限与改进
作者承认的局限:模型仅为 170M 的 DUO++ small、序列长 1024,结论能否外推到十亿参数推理模型未验证;循环只重放中间两块;FLOP 成比例的收益不在最终 NLL(与均匀持平),而在推理循环次数与 MCQ 精度,且以 Gen PPL 平均升高 1.55% 为代价。我的补充观察:生成实验以匹配 NFE 而非匹配推理 FLOPs 为主要坐标,对循环模型略有利(尽管作者补了 1.48×/2.05× 的换算);自适应阈值 $\epsilon=0.1$ 为手工设定,论文未报告阈值敏感性分析;引言声称 UDLM 推理更强,但本文没有任何推理类 benchmark 的直接实验(作者留作未来工作);域外困惑度是 NELBO 上界而非真实 PPL;主要推理评测全部基于 OWT 检查点,FineWeb-Edu 只补充了部分下游结果(Table 14);噪声成比例负结果绑定于「等宽带 + 带内均匀抽 $S$」这一特定实现,不能排除其他噪声-深度耦合方案有效。
独立分析的弱点
独立分析五个弱点。① 规模外推风险:所有结论来自 170M/1024 长度;大模型中循环切片占比 $\rho$ 相对变小,FLOP 成比例分布的形状和收益都可能改变。改进方向:做 0.5B–7B 缩放实验,在缩放律框架下拟合循环收益与 $\rho$、$S_{max}$ 的关系。② 训练与推理脱节:训练用固定分布采 $S$,推理才用自适应停止,模型从未见过「中途退出」的梯度信号。改进:在训练中引入可微分早退目标或预算约束。③ 噪声-深度耦合实现粗糙:$G$ 个等宽带加带内均匀抽取是粗粒度离散化,被否定后容易误判整个方向无效。改进:尝试连续映射 $S(t)$,或按位置级保留概率 $\gamma_t^\ell$ 而非全局噪声分配深度。④ $\epsilon=0.1$ 固定使自适应循环无法适配不同 NFE 预算。改进:把 $\epsilon$ 做成预算滑块,或训练一个停点预测器。⑤ 精度-样本质量权衡未统一解决:FLOP 成比例更准但 Gen PPL 差 1.55%,实践中要维护两个检查点。改进:探索混合分布训练或多目标正则,让单一模型兼顾两侧。
未来方向
作者明确提出的方向:比较循环对掩码扩散与均匀扩散的帮助差异,尤其在推理任务上。基于本文成果可延伸:(1) 循环 + 蒸馏的组合——先循环训练再蒸馏进少步采样器,验证两类加速收益是否可乘;(2) 研究循环次数分布随模型规模的缩放规律,给出 $p(S)$ 关于 $\rho$ 的解析最优形式;(3) 把自适应停止从序列级细化到位置级,用可靠性分解 $\gamma_t^\ell$ 指导每个 token 的深度分配;(4) 在 DiffusionGemma 类十亿级 UDLM 上验证并评测 GSM8K 等推理 benchmark,兑现引言声称的 UDLM 推理优势;(5) 理论上把循环解释为上下文预测 $\hat\pi_t^\ell$ 的不动点迭代,分析收敛率与最优深度的关系。
复现评估
复现条件较好。论文首页标注了 Code、Checkpoints、Training logs 三个链接,说明有开源意图;关键设定完整披露:DUO++ small DiT(12 块、宽度 768、GPT-2 tokenizer、序列 1024)、循环块 1–2、$S_{max}=12$、批大小 512、序列打包、每 5k 步在 $S\in\{1,6,8,12\}$ 记录验证 NLL、自适应阈值 $\epsilon=0.1$;数据 OpenWebText 与 FineWeb-Edu sample-10BT 公开可得。算力上,基线为 1M 步 ×512 批(约 0.5 万亿 token 量级),循环运行约 65.5 万–68.9 万步,170M 模型在单节点多卡上数天到数周可完成。难度评估:拿到官方代码则属中等偏易;从零复现需自行实现 DUO++ 软输入课程与 Ψ 采样器,并对齐 iso-FLOP 换算(Chinchilla 约定)和 FLOP 计数口径,评测协议分散在附录 F–H,需要仔细拼装。
论文图表