BYOD:用 LoRA 将自回归语言模型高效转换为扩散语言模型 BYOD: Build Your Own DLM - Efficient Autoregressive-to-Diffusion Language Model Conversion
仅用单 GPU 数小时的高秩 LoRA 微调,即可把主流自回归大模型转换为可用的扩散语言模型
前置知识
LoRA(低秩适配)
一种参数高效微调技术:冻结原模型全部权重,只训练插入在各线性层旁的低秩分解矩阵。前向计算为 $Wx + \frac{\alpha}{r}BA$,其中 $A\in\mathbb{R}^{r\times k}$、$B\in\mathbb{R}^{d\times r}$,秩 $r\ll\min(d,k)$;训练完成后可把 $\frac{\alpha}{r}BA$ 折叠进原权重 $W$ 得到 $W_{\text{merged}}=W+\frac{\alpha}{r}BA$,推理时不增加任何参数或延迟。
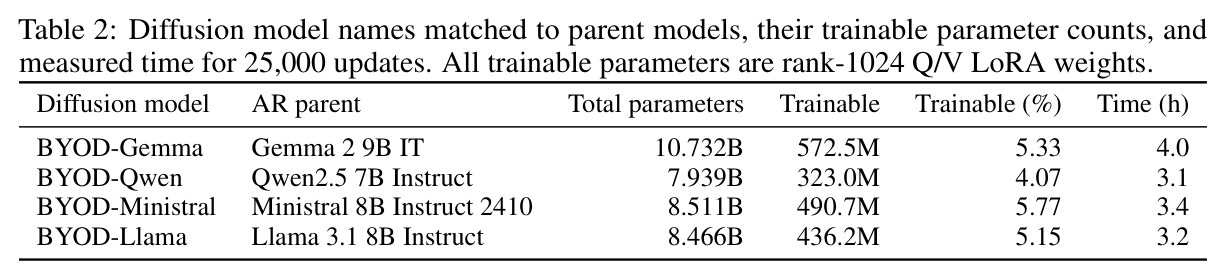
BYOD 的全部可训练参数就是挂在每层自注意力 Q/V 投影上的 rank-1024 LoRA(仅占总参数 4.1%–5.8%),理解 LoRA 才能明白『几小时单卡完成转换』在算力上为何可行,以及论文中适配器合并消融实验的意义。
掩码扩散语言模型(吸收态离散扩散)
离散扩散的一种:前向过程按掩码率 $t$ 把文本中每个 token 独立替换为特殊 [MASK](吸收态),模型学习在双向上下文条件下重建被掩码位置的原始 token,训练目标通常是带 $1/t$ 加权的去噪交叉熵;推理时从全掩码序列出发,反复执行『预测全部位置—保留高置信 token—重掩码其余』直到生成完整文本,代表系统有 MDLM、LLaDA。
BYOD 的目标就是让 AR 模型获得这种生成方式;其训练目标(IID 掩码、$t\sim\mathcal{U}[10^{-3},1]$、$1/t$ 加权、答案/填充损失 0.9/0.1 加权)与推理采样器全部来自这一框架,不掌握它就无法读懂方法与实验设定。
因果注意力与双向注意力
因果(自回归)注意力中位置 $i$ 只能看到 $j\le i$ 的 token,支撑逐 token 左到右生成;双向注意力取消这一下三角掩码,每个位置可看见全部上下文。直接把因果掩码换成双向掩码会使原 AR 训练目标(下一 token 预测的标签偏移)失效,因此必须配合新的训练目标重新适配。
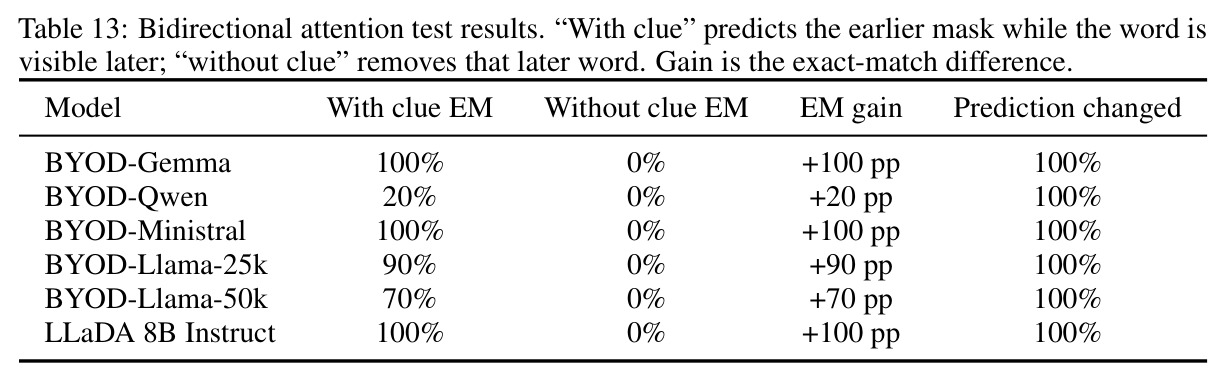
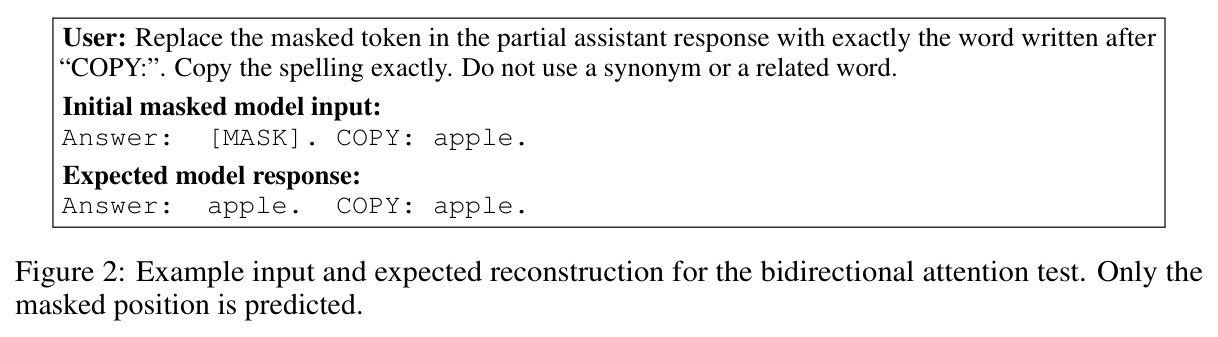
BYOD 的核心架构干预就是『每一层把因果掩码换成双向掩码』;而论文验证转换成功的『右侧线索复制测试』正是利用因果模型在数学上不可能利用右侧信息这一事实设计的,双向性是本文能否成立的关键命题。
NFE(网络函数评估次数)
Number of Function Evaluations:生成一段文本时前向网络被调用的次数。AR 模型每产出一个 token 至少需要一次前向,NFE 随输出长度线性增长;扩散模型每次前向可并行定稿多个 token,NFE 可以独立于输出长度选择(如 128 个 token 用 32/64/128 步生成),是衡量扩散推理预算的核心旋钮。
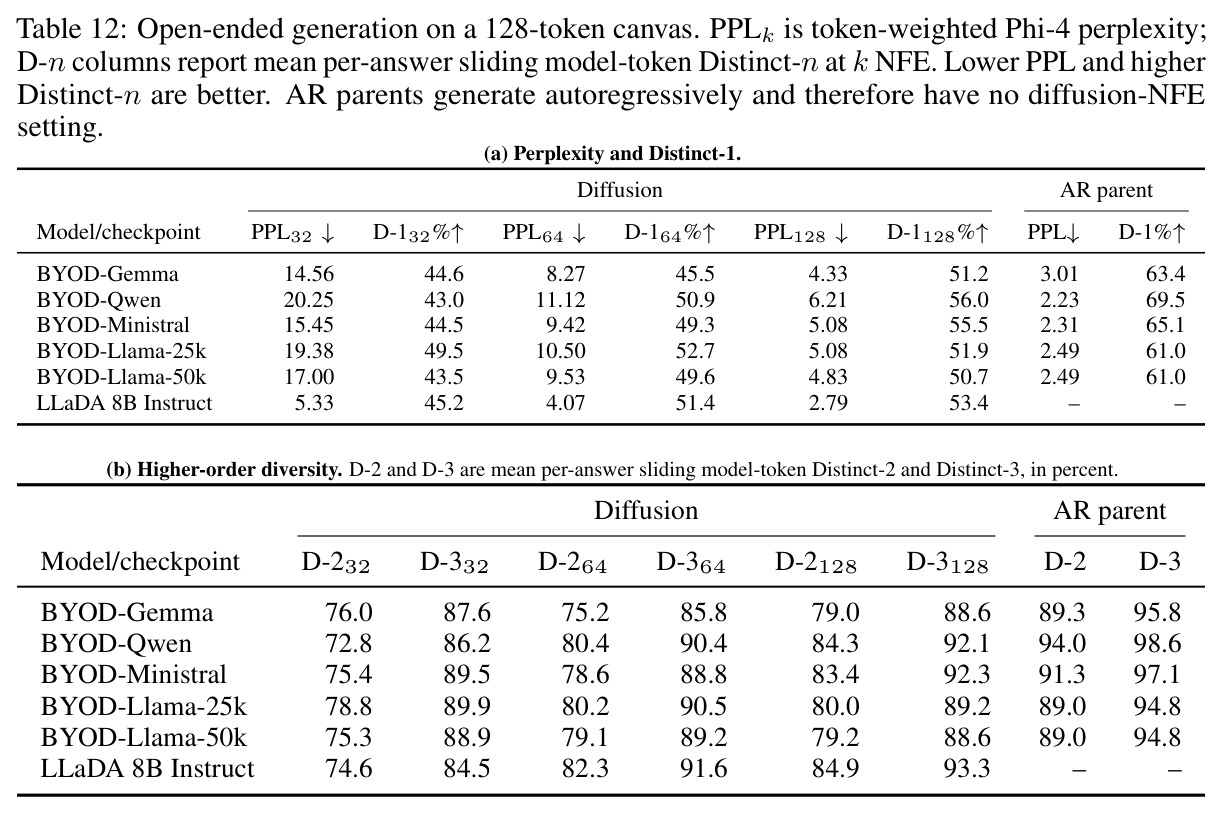
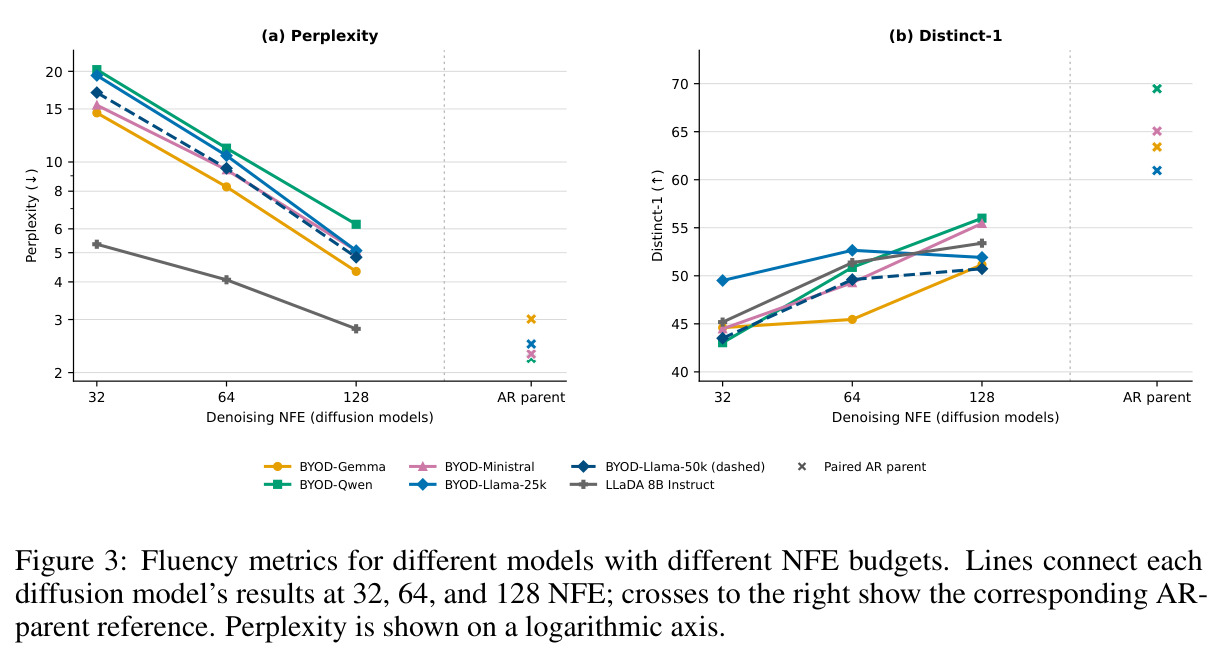
论文的质量—算力权衡全部以 NFE 为横轴:BYOD 在 NFE 低于输出长度时质量明显退化(困惑度 8.3–11.1 vs LLaDA 的 4.1),这是作者承认的首要局限;理解 NFE 才能正确解读 Figure 3 与 Table 12。
外部困惑度与 Distinct-n
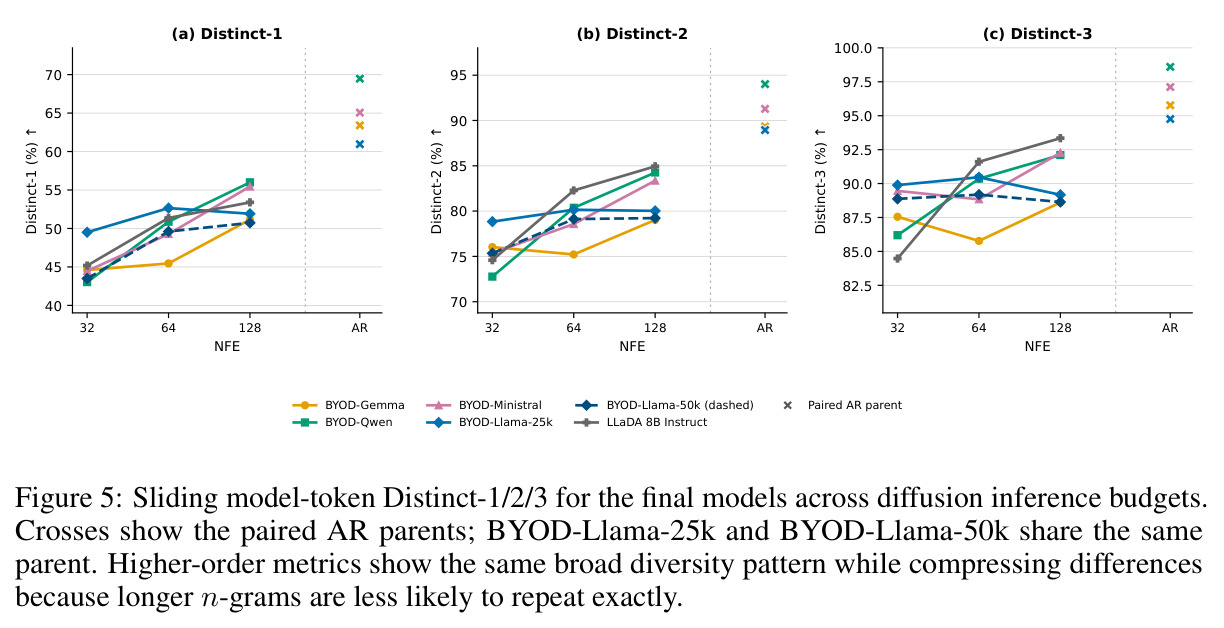
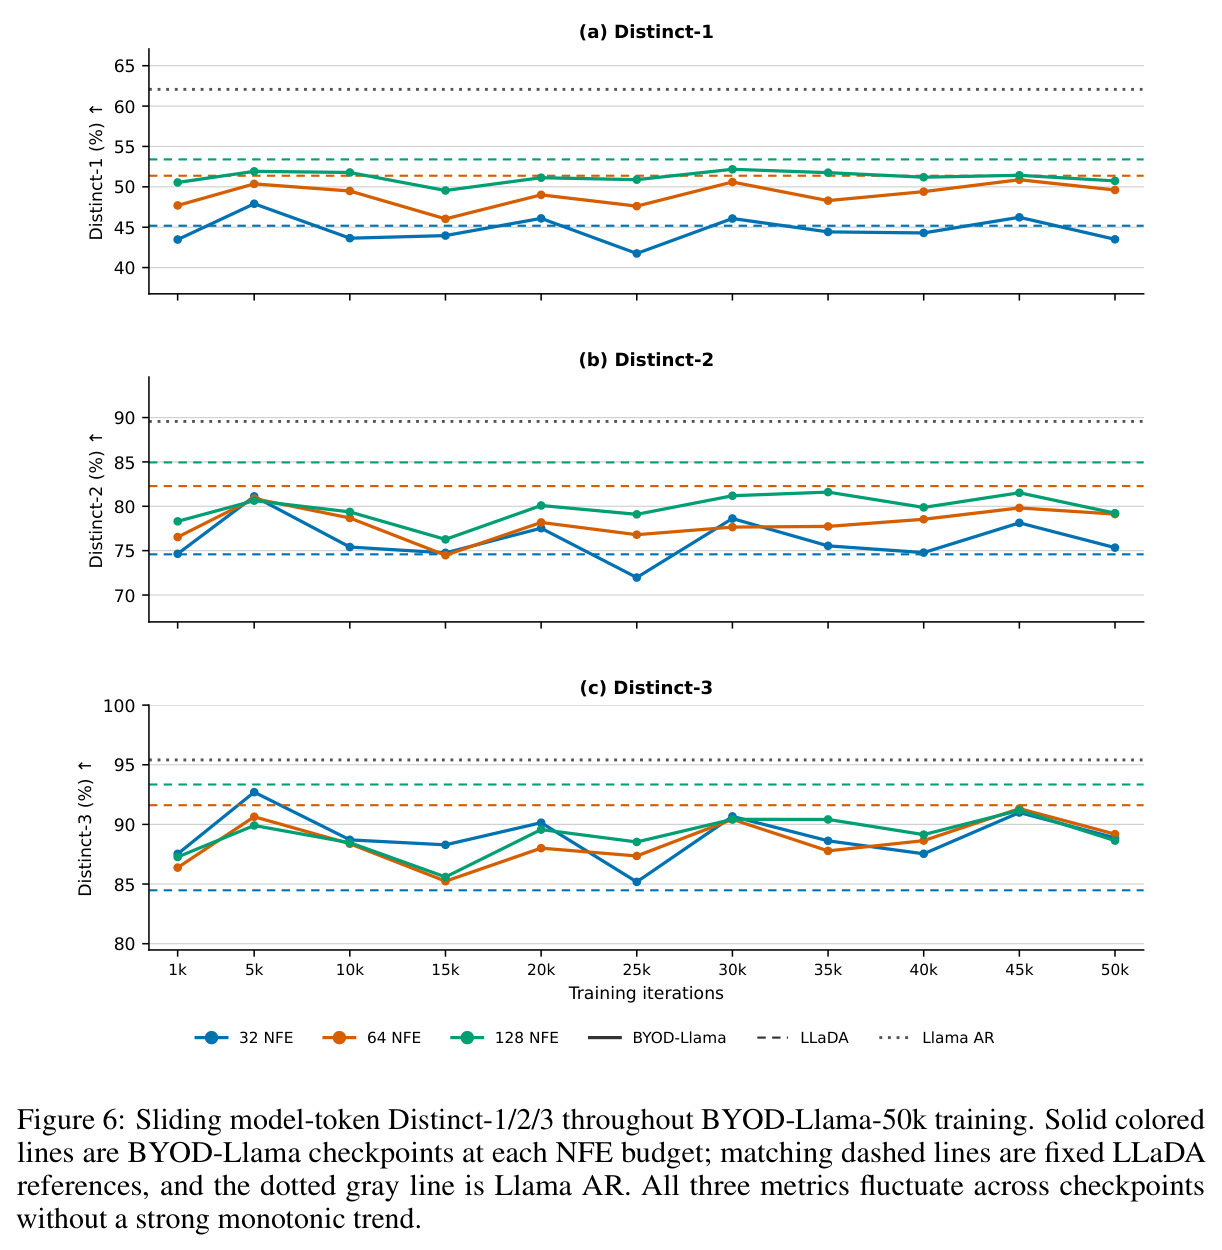
掩码扩散模型没有标准的左到右序列似然,其 ELBO 也不是严格的测试时似然,因此无法直接计算 AR 式困惑度;本文沿用先前工作用冻结的 Phi-4 14B 作外部打分器,对所有非填充 token 的负对数似然 pooling 后取指数得到困惑度。Distinct-1/2/3 是生成文本中不同 1/2/3-gram 的占比,衡量局部重复程度,两者互补:低困惑度若伴随低 Distinct 可能只是输出更重复。
BYOD 的开放生成评估完全建立在这两个代理指标上(其困惑度是 AR 父模型的 2.7–5.0 倍),作者也明确讨论了它们偏爱重复文本、不测事实性与语法的盲区;读 Table 12 与 Figure 3/5 前必须理解其含义与局限。
研究动机
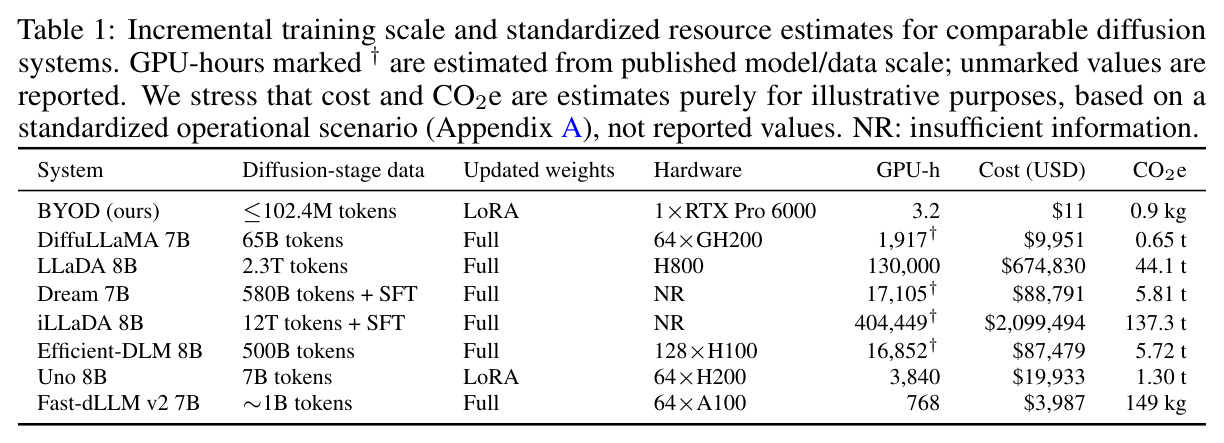
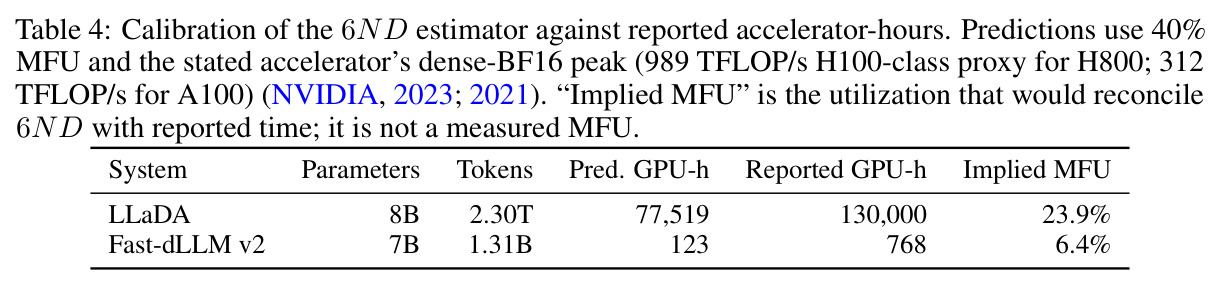
扩散语言模型(DLM)允许并行更新多个 token、使用双向注意力、把生成步数与输出长度解耦,还能在早期修正低置信度预测,但这些能力目前都要靠昂贵的预训练或全参数微调换来。以 LLaDA 8B 为例,它需要 2.3T token 和约 130,000 GPU 小时从零预训练;按论文统一的租用与电力场景折算约为 674,830 美元和 44.1 吨 CO2e。即使是『转换』路线也远非轻量:DiffuLLaMA 需要 65B token 的 7B 全参数继续训练(64×GH200,约 1,917 GPU 时),Dream 用 580B token 加噪声重调度,Efficient-DLM 用 500B token 加块状注意力,都需要多卡集群与数万美元开销。这意味着扩散生成研究实际上被拥有大规模算力的少数实验室垄断,其他研究者既无法把自己的模型家族接入扩散生成,也无法围绕『架构与父模型选择如何影响扩散生成』做低成本的可复制实验。
本文的目标是本文要给出一个计算高效、可复现、与具体架构无关的 AR→DLM 转换配方:只用 LoRA 参数更新、在单张云端 GPU 上数小时内完成转换,使转换后的模型能从全掩码序列生成文本、真正使用双向上下文、并尽量保留父模型知识。作者把同一配方原封不动地施加到四个指令微调检查点——Gemma 2 9B IT、Llama 3.1 8B Instruct、Qwen2.5 7B Instruct、Ministral 8B Instruct 2410(后者据作者所知是首个 Mistral 系转换)——并将每个转换模型与其冻结的 AR 父模型以及外部扩散基线 LLaDA 8B Instruct(同一评测框架重跑)做配对比较,从而量化『转换损失』、验证双向注意力是否真正生效,并公开全部代码与在线 demo。
与已有工作不同的是,本文的独特切入角度有三点。第一,此前最接近的 LAD 已证明 LoRA 可以诱导扩散生成,但使用了混合损坏目标(掩码+token 交换/复制/移位);BYOD 反其道而行,检验最简单的 IID 吸收态掩码目标(LLaDA 所用目标)本身是否足以跨家族迁移,把『配方的简单性』本身作为研究变量。第二,实验设计是严格配对的:四个家族接受完全相同的干预(同样的双向注意力替换、同样的 LoRA 目标模块与 rank、同样的目标函数和数据前缀),每个转换模型与其『出生』检查点直接对比,从而把转换质量与起点检查点的强弱解耦——这是 DiffuLLaMA、Dream 等单家族工作做不到的。第三,作者严格区分同框架对比与协议分离的文献数字:只有 LLaDA 被在同一 harness 中重跑,DiffuLLaMA/Dream-Instruct/iLLaDA-Instruct/Efficient-DLM 的发表值单独列出不做排名;同时给出标准化的成本与碳排放估算框架($C\approx 6ND$ 估算器加校准),把 BYOD 的约 $11 美元与 LLaDA 的约 $674,830 放在同一量尺下比较。
核心方法
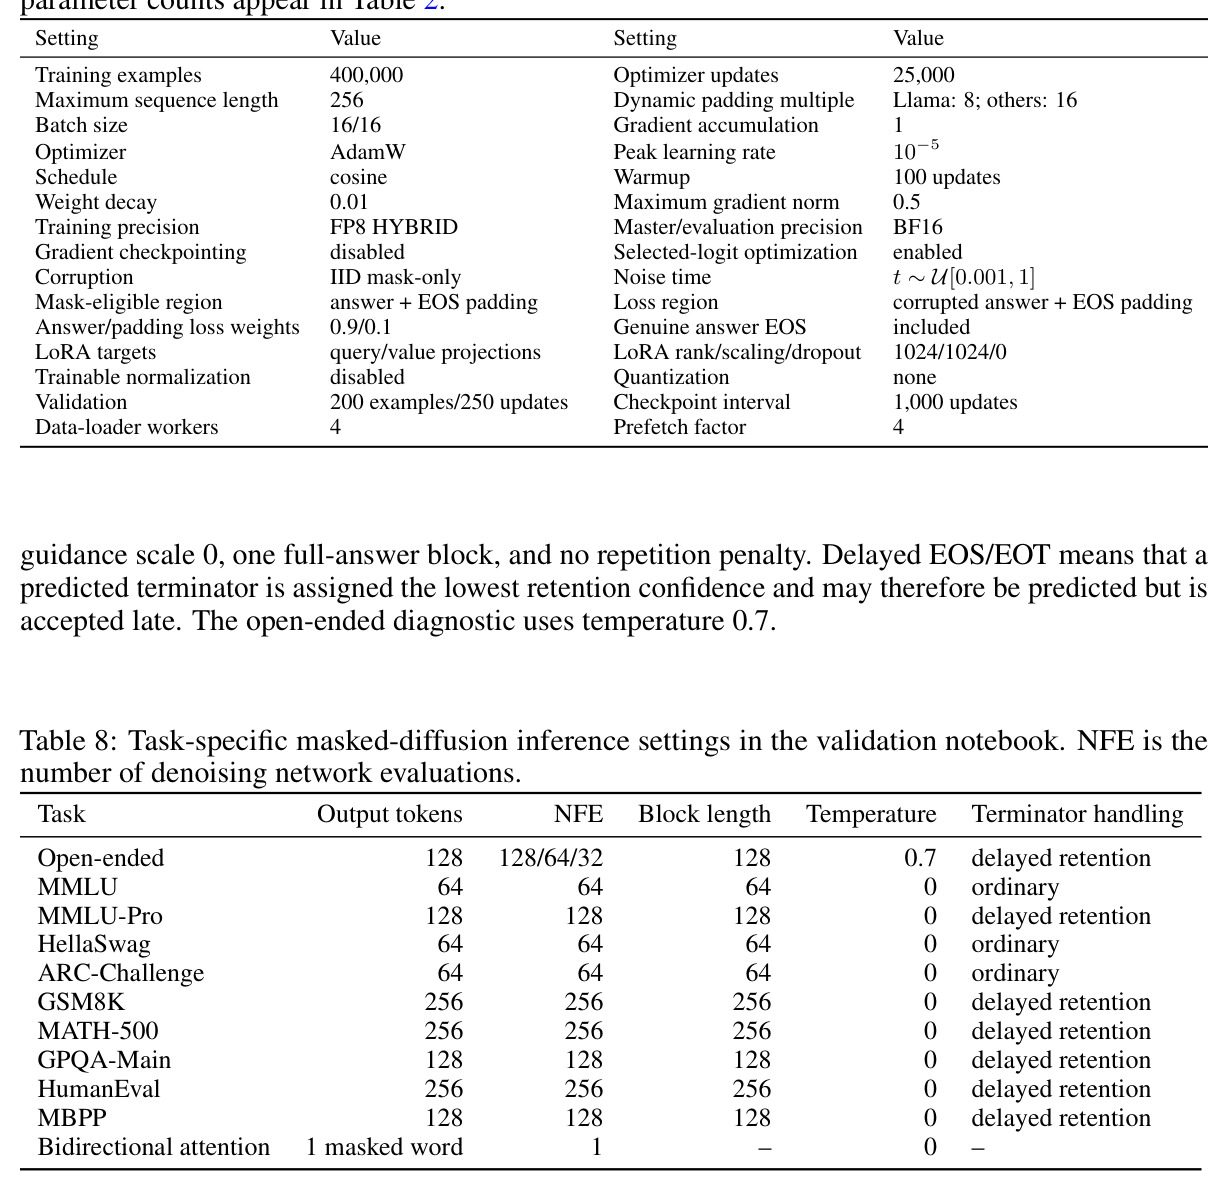
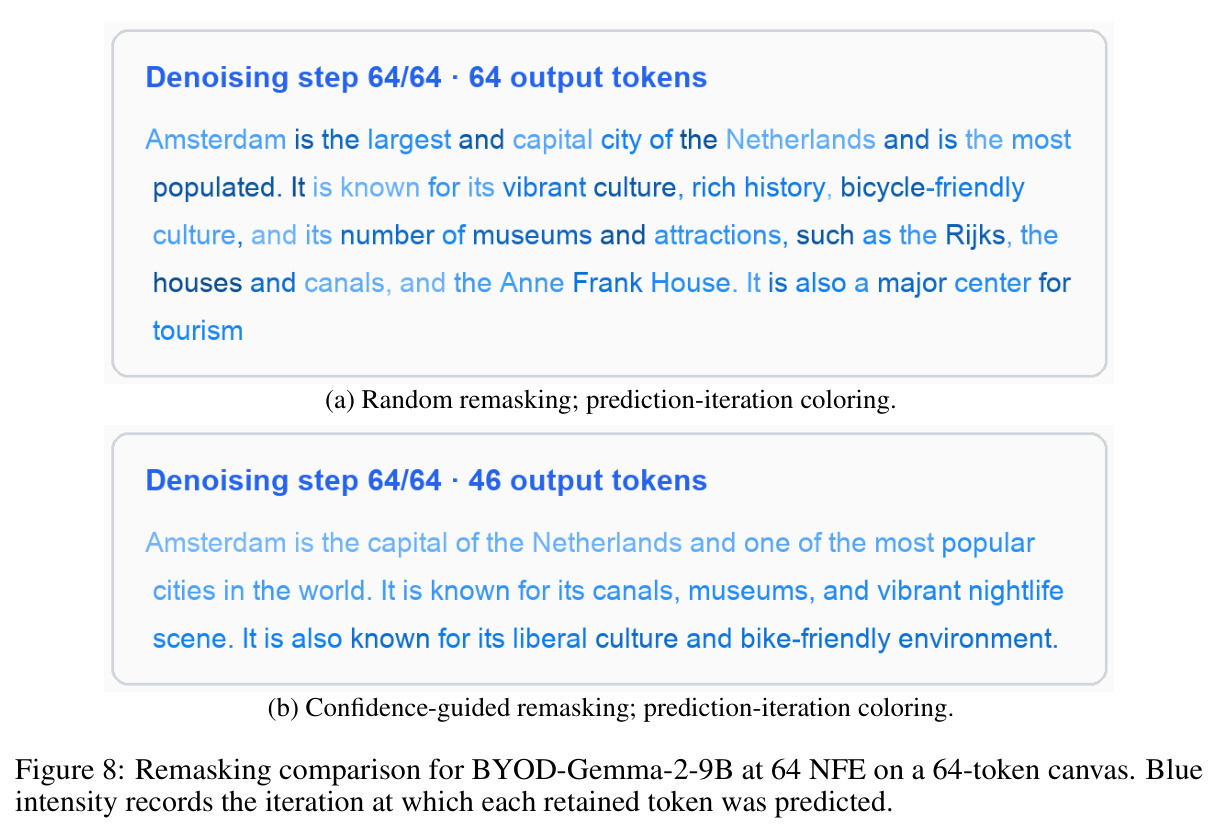
直觉是:AR 检查点里已经存好了语言与世界知识,『扩散式生成』更多是一种注意力结构加训练目标的属性,而不是必须从头预训练的能力。因此 BYOD 只做两件事:把每一层的因果注意力掩码换成双向掩码,再用高秩 LoRA($r=\alpha=1024$、dropout 0)挂到每层自注意力的 query/value 投影上,然后用掩码扩散目标训练适配器,让它学会『在同一位置、依据双向上下文重建被掩码的 token』。形式上,对每条样本采样掩码率 $t\sim\mathcal{U}[10^{-3},1]$,对答案区 $A$ 与 EOS 填充区 $P$ 的每个位置独立以概率 $t$ 掩码得到损坏序列 $x^t$ 与掩码集 $M_t$;同位置重建损失为 $\ell_R(\theta)=-\frac{1}{t|R|}\sum_{i\in M_t\cap R}\log p_{\phi,\theta}(x_i^0\mid p,x^t)$,总损失 $\mathcal{L}(\theta)=\mathbb{E}_{t,x^0,x^t}[0.9\,\ell_A(\theta)+0.1\,\ell_P(\theta)]$,其中 $\phi$ 是冻结的父模型参数、$\theta$ 是 LoRA 参数,$1/t$ 校正采样到的掩码率,第一个 EOS 计入答案、其余 EOS 视为填充。prompt 与 chat 模板 token 始终可见且不计损失;预训练输出头原样保留,只是去掉 AR 的标签偏移、改为同位置预测。推理时从定长的全掩码答案块出发,每步预测所有掩码位置、保留最高置信度的 token、对其余位置重新掩码,若干次网络评估(NFE)即可产出整段文本。
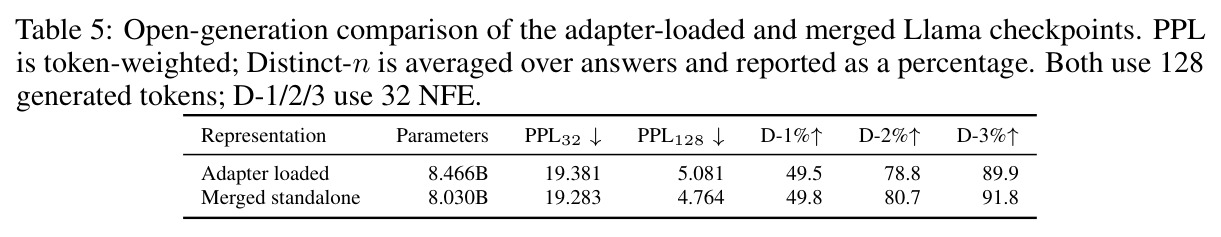
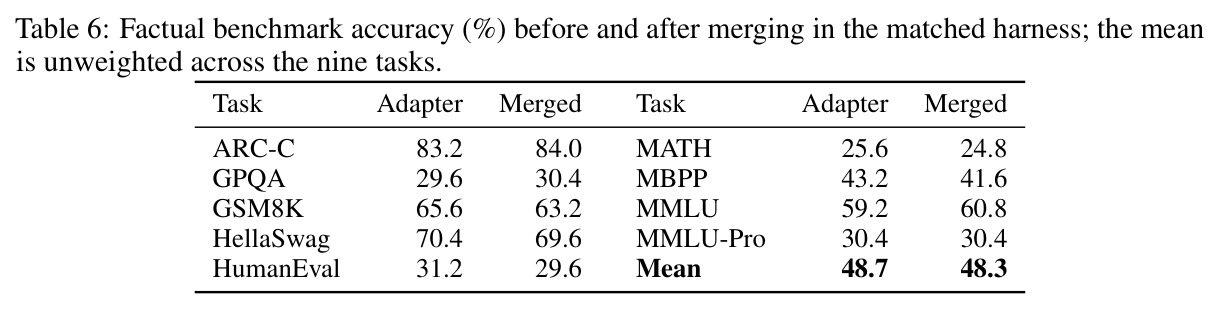
核心创新是『只动注意力、冻结一切』的极简干预。与 DiffuLLaMA(65B token 全参数继续训练)、Dream(580B token + 上下文自适应噪声重调度)、Efficient-DLM(500B token + 块状注意力与位置相关掩码)不同,BYOD 的全部可训练参数只有 4.1%–5.8%(rank-1024 的 Q/V LoRA),主干权重、词嵌入、语言模型头、偏置与归一化层全部冻结,且不需要任何架构专属调参——四个家族共用同一个 rank、同一个目标函数、同一份数据前缀。与 LAD 相比,BYOD 证明纯 IID 掩码目标(去掉混合损坏)就足以跨家族诱导扩散生成。另一个关键决策是为了跨家族可比性固定 $r=1024$,宁可接受各家族可训练参数量不同(Qwen 323.0M vs Gemma 572.5M)这一潜在混杂,也不做模型专属调参。词表也不扩充:直接复用 tokenizer 中已有的单 token 掩码串(Gemma/Llama/Qwen 用 [MASK],Ministral 用 )。训练完成后用 $W_{\text{merged}}=W+\frac{\alpha}{r}BA$ 把适配器折回主干,模型恢复原始大小(Llama 从 8.466B 回到 8.030B)而行为基本不变,消融显示九任务均值仅变化 0.4 个点。
方法步骤详情
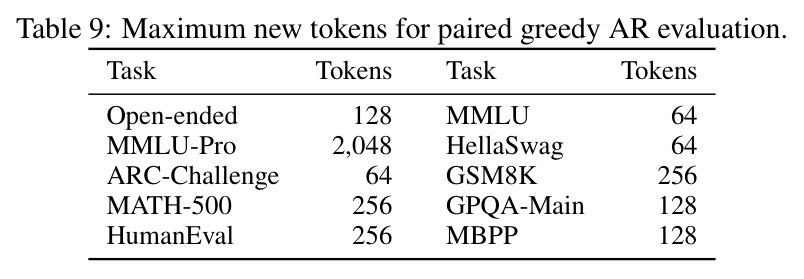
整个流程可拆成六步。第一步,选择检查点与掩码 token:四个指令微调模型(Gemma 2 9B IT、Llama 3.1 8B Instruct、Qwen2.5 7B Instruct、Ministral 8B Instruct 2410),掩码串分别用 [MASK](前三者)与 (Ministral),不扩充词表。第二步,架构干预:每一层把因果掩码替换为双向注意力掩码,使 prompt、答案与 EOS 填充位置互相可见;其余架构与输出词表不变。第三步,挂适配器:所有自注意力 Q/V 投影加 rank-1024、$\alpha=1024$、dropout 0 的 LoRA;模型输入是带 chat 模板的干净 prompt 加被损坏的答案,输出是同位置干净 token 的分布。第四步,构造数据:100 万条混合样本(45% 通用指令来自 Clean-Instruct-3M/Tülu 3/Alpaca-GPT4/Alpaca,权重 40/35/20/5;18% 多选推理来自 MMLU/HellaSwag/ARC-Easy,权重 73/25/2;18% 数学来自 Orca-Math/GSM8K,权重 95/5;19% 代码来自 OpenCoder/MBPP,权重 99.7/0.3),去重、剔除与评测基准重合的 prompt、只保留 256 token 内的样本;每个模型用同一洗牌前缀、按各自 tokenizer 与 chat 模板重切。第五步,训练:主运行用前 400,000 条样本做 25,000 次更新,batch 16、AdamW、峰值学习率 $10^{-5}$ 余弦衰减、100 步 warmup、权重衰减 0.01、梯度范数裁剪 0.5、FP8 HYBRID 精度加 BF16 主权重;掩码在线重采样;在单张 NVIDIA RTX PRO 6000(Google Colab)上耗时 3.1–4.0 小时、至多处理 102.4M token;BYOD-Llama-50k 是用同一洗牌做 80 万样本、50,000 更新的延长版。第六步,推理与部署:基准评测用贪心预测加低置信度重掩码、NFE 等于输出块长度(64–256);开放生成用温度 0.7、延迟 EOS/EOT 接受;可选地把 LoRA 合并进主干以消除适配器开销。
技术新颖性
技术新颖性体现在四个层面。其一,方法层面:首次系统证明仅对注意力 Q/V 投影做高秩 LoRA 加纯 IID 掩码目标,就能在不做任何架构专属设计的情况下让四个异构家族获得扩散生成能力;这把 LAD 的混合损坏目标简化为最朴素的形式并依然有效,也是首个 Mistral 系(Ministral 8B)的 AR→DLM 转换。其二,实验设计层面:四家族配对设计(相同干预、相同数据前缀、各自与父模型对比)把『转换质量』从『起点强弱』中分离出来,使跨架构比较成为可能,这是 DiffuLLaMA、Dream、Efficient-DLM 等单家族工作无法提供的视角。其三,评估方法学层面:明确区分同 harness 重跑(仅 LLaDA)与协议分离的文献数字;用外部冻结 Phi-4 14B 计算困惑度(因为掩码扩散没有严格测试时似然)、用 Distinct-1/2/3 补足多样性维度并暴露『困惑度改善来自重复』的假象、用右侧线索复制任务对双向注意力做功能性而非表观性验证。其四,资源核算层面:给出 $C\approx 6ND$(40% MFU 假设)的标准化估算器,并用 LLaDA(隐含 MFU 23.9%)和 Fast-dLLM v2(6.4%)做校准,公开全部定价与功耗假设(如 $\widehat{\text{CO2e}}=G\cdot P_{\text{GPU}}\cdot\text{PUE}\cdot I_{\text{grid}}$,3.2 GPU 时折算 0.93 kg),使数量级的成本对比虽属示意但可复算、可批判。
实验结果
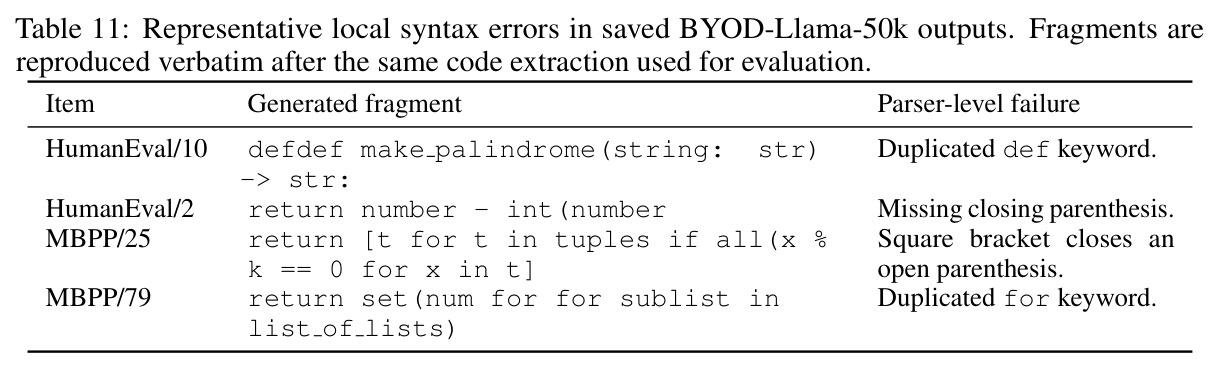
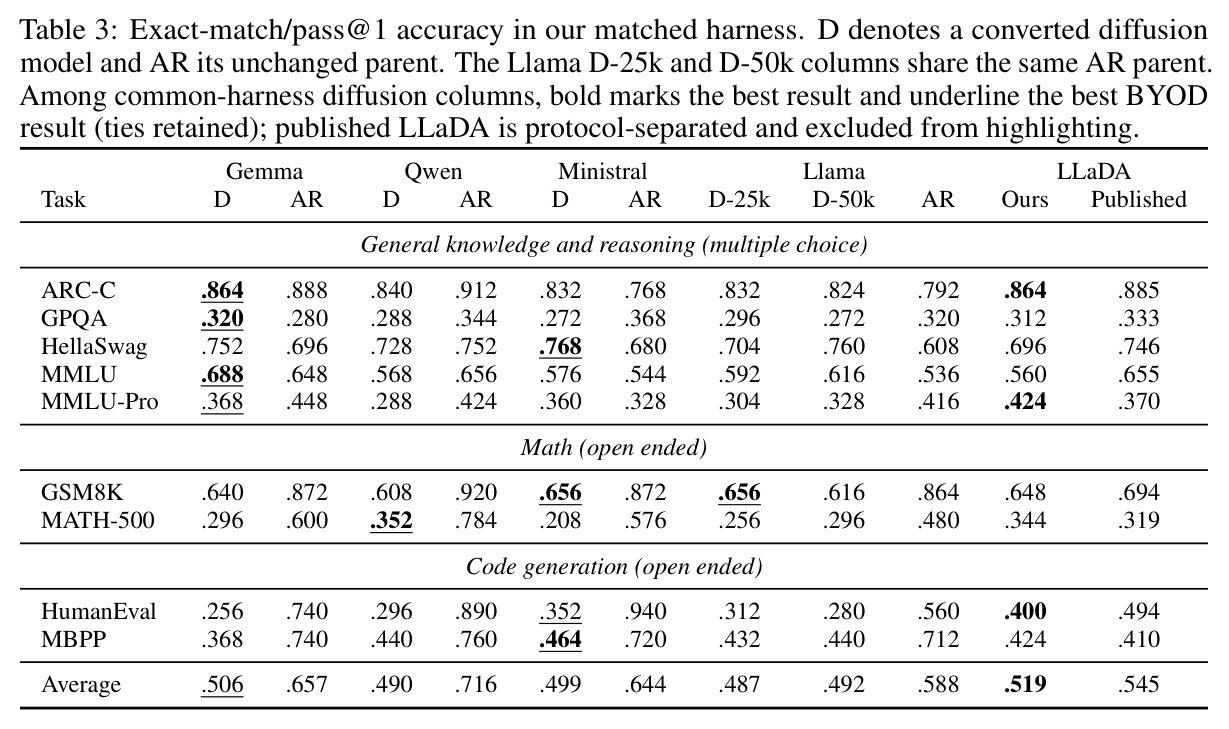
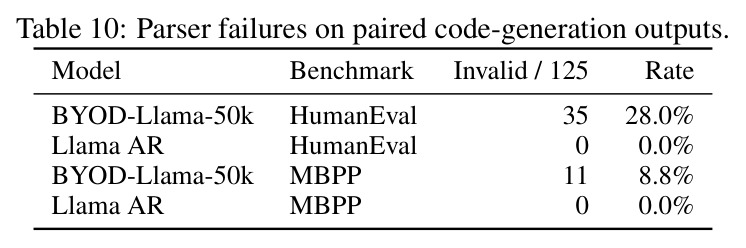
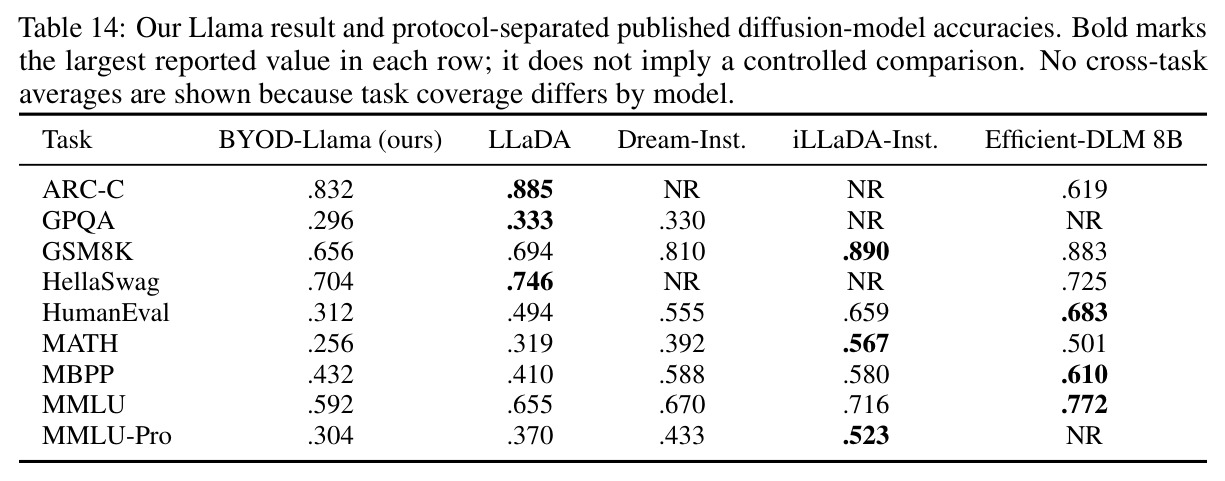
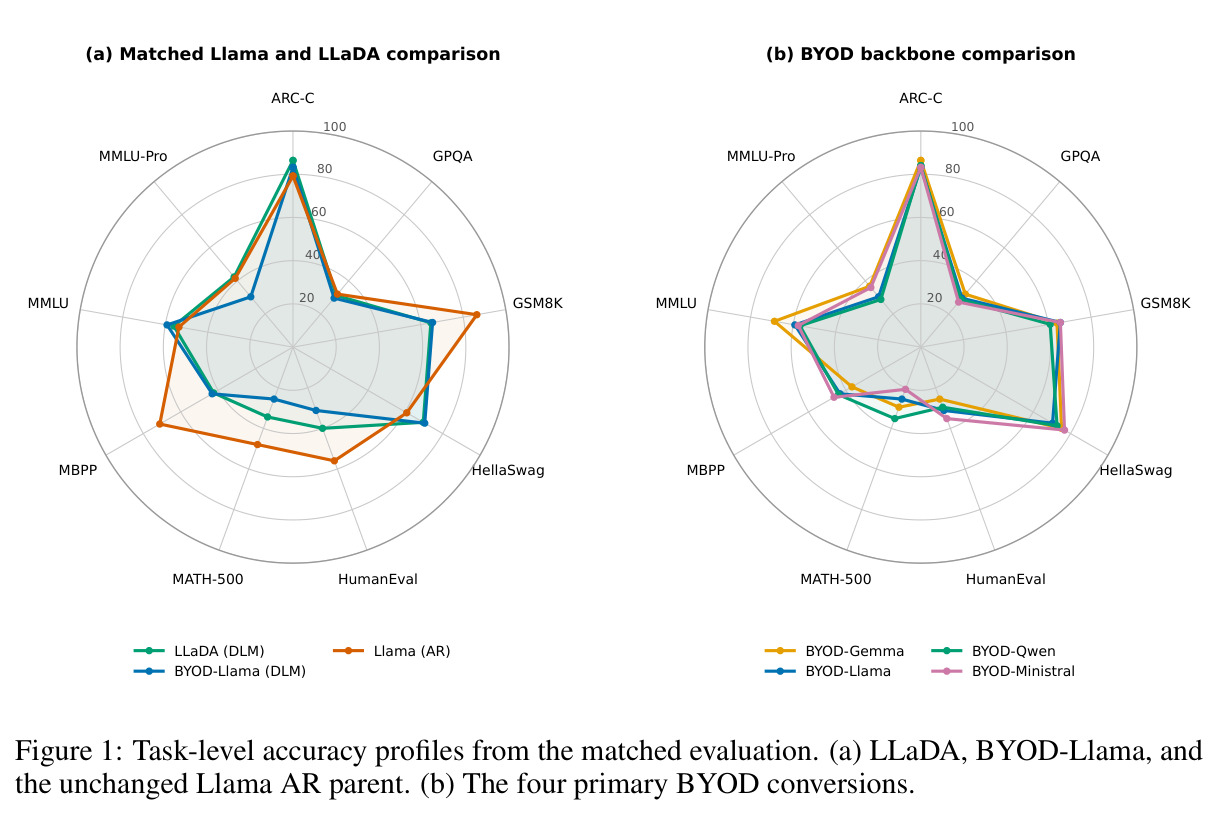
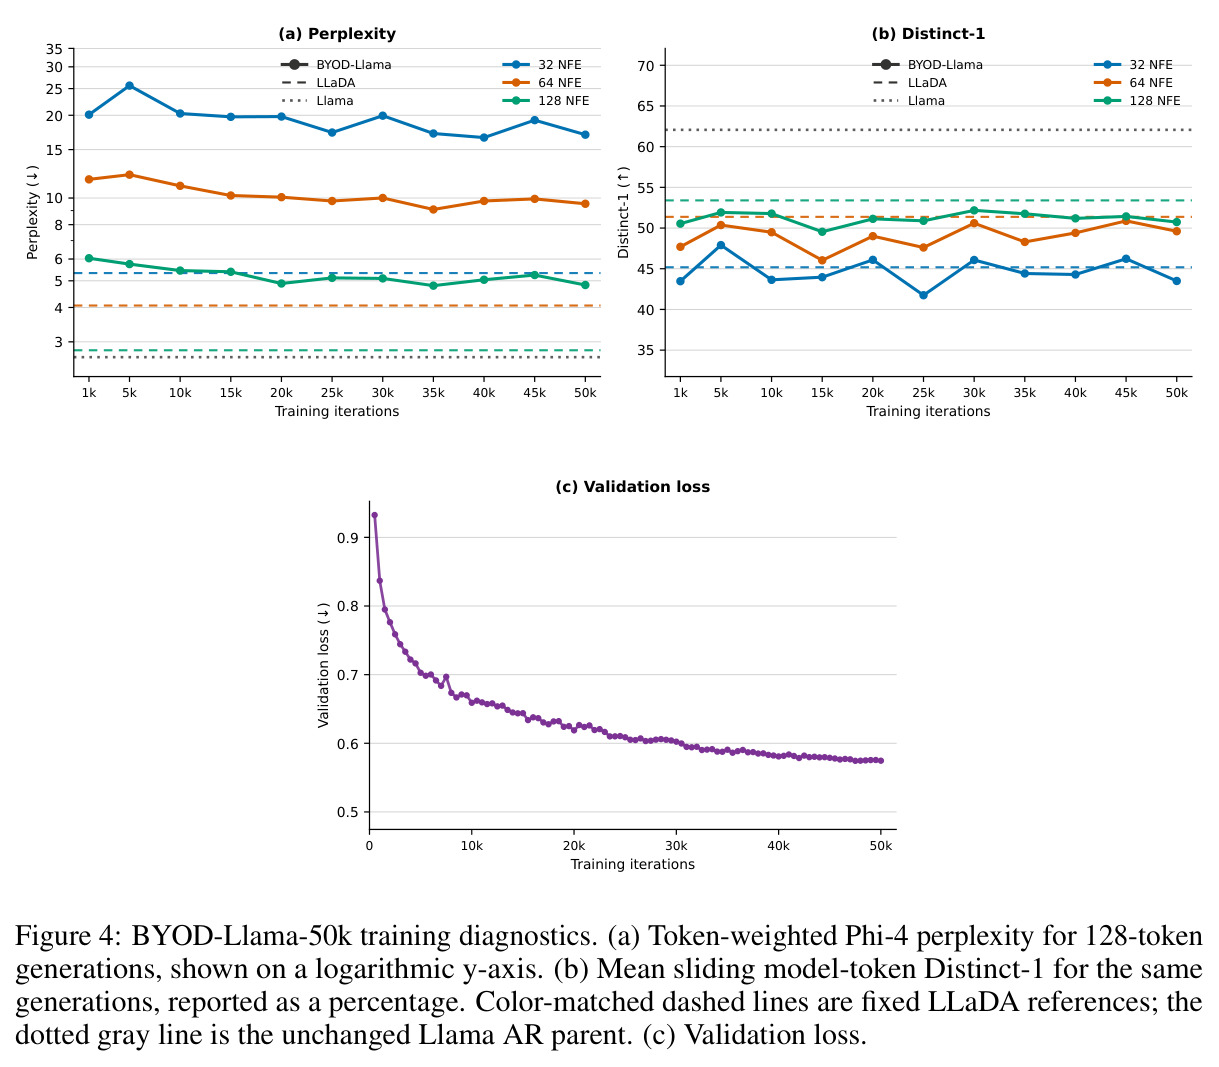
在九任务匹配评测(每基准固定 125 题、样例级配对)中,BYOD-Gemma 最强,平均 50.6%,与同框架重跑的 LLaDA 8B Instruct(51.9%)仅差 1.3 个百分点(LLaDA 发表值 54.5%,同框架低 2.6 个点,说明协议敏感性);BYOD-Qwen/Ministral/Llama-25k/Llama-50k 分别为 49.0%/49.9%/48.7%/49.2%。AR 父模型平均 58.8%–71.6%,总体领先,但并非处处领先:BYOD-Gemma 在 MMLU 上 68.8% 反超父模型的 64.8%,HellaSwag 75.2% 超过 69.6%,ARC-C 86.4% 接近 88.8%。最大差距集中在数学与代码:HumanEval 上 BYOD-Llama-50k 28.0% vs Llama AR 56.0%(BYOD-Gemma 25.6% vs 74.0%),MATH-500 上 BYOD-Gemma 29.6% vs 60.0%;语法解析失败占 BYOD-Llama-50k 输出的 28.0%(HumanEval 35/125)和 8.8%(MBPP 11/125),而 AR 父模型为 0%,与并行预测的局部不一致性一致。开放生成方面差距更明显:128 token、64 步生成时,BYOD 各模型 Phi-4 困惑度为 8.27–11.12,LLaDA 为 4.07,AR 父模型仅 2.23–3.01(各 NFE 预算下 BYOD 是父模型的 2.7–5.0 倍),Distinct-n 也普遍更低。延长训练(25k→50k 更新)只带来 +0.5 点平均,五个任务升、四个任务降;验证损失虽近乎单调下降并在 5 万步趋于平稳,但困惑度并未逼近 LLaDA,说明瓶颈不在训练时长。双向注意力测试中,加入右侧线索后所有转换模型与 LLaDA 的贪心预测都 100% 改变(因果模型必为 0%),确认双向信息流通;但精确复制率分化明显:Gemma/Ministral/LLaDA 100%,Llama-25k/50k 90%/70%,Qwen 仅 20%。合并消融显示合并后模型恢复 8.030B 原始大小,开放生成指标反而略升(PPL128 从 5.081 降到 4.764),九任务均值仅降 0.4 点(48.7%→48.3%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 九任务平均(ARC-C、GPQA、HellaSwag、MMLU、MMLU-Pro、GSM8K、MATH-500、HumanEval、MBPP) | 平均 exact-match / pass@1 准确率 | BYOD-Gemma 50.6%(四个 BYOD 模型范围 48.7%–50.6%) | LLaDA 8B Instruct 同框架 51.9%(发表值 54.5%);AR 父模型 58.8%–71.6% | 距最强扩散基线仅 -1.3pp,但仍落后 AR 父模型约 8–23pp |
| MMLU(通用知识,多选) | exact-match 准确率 | BYOD-Gemma 68.8% | Gemma 2 9B AR 父模型 64.8%;LLaDA 56.0% | +4.0pp,转换后反超自己的父模型 |
| HellaSwag(常识推理,多选) | exact-match 准确率 | BYOD-Gemma 75.2% | Gemma AR 父模型 69.6% | +5.6pp,反超父模型 |
| HumanEval(代码生成) | pass@1 | BYOD-Gemma 25.6%;BYOD-Llama-50k 28.0% | Gemma AR 74.0%;Llama AR 56.0% | -28~-46pp,是退化最大的任务;28.0% 的 BYOD-Llama 输出语法非法而 AR 为 0% |
| MATH-500(数学,开放式) | 归一化最终答案 exact-match | BYOD-Gemma 29.6% | Gemma AR 60.0%;LLaDA 34.4%(同框架) | -30.4pp(相对 AR 父模型) |
| 开放生成流畅度(128 token 画布、64 NFE) | Phi-4 加权困惑度(越低越好) | 8.27–11.12(四个 BYOD 模型) | LLaDA 4.07;AR 父模型 2.23–3.01 | 各 NFE 预算下为父模型的 2.7–5.0 倍,流畅度仍显著落后 |
| 双向注意力测试(右侧线索复制) | 预测改变率 / 精确复制率 | 四个模型预测改变率均为 100%;复制率 Gemma 与 Ministral 100%、Llama-25k/50k 90%/70%、Qwen 20% | LLaDA 100%;因果注意力模型理论上应为 0% | 功能性验证双向注意力成立,但家族间对双向线索的利用能力差异巨大 |
| 转换训练成本(标准化估算) | GPU 时 / 美元 / CO2e | 3.2 GPU 时 / $11 / 0.9 kg CO2e(≤102.4M token,LoRA,单张 RTX PRO 6000) | LLaDA:130,000 GPU 时 / $674,830 / 44.1 t CO2e(2.3T token,全参数预训练) | 训练成本降低约 4 个数量级(作者强调这是示意性估算而非实测) |
局限与改进
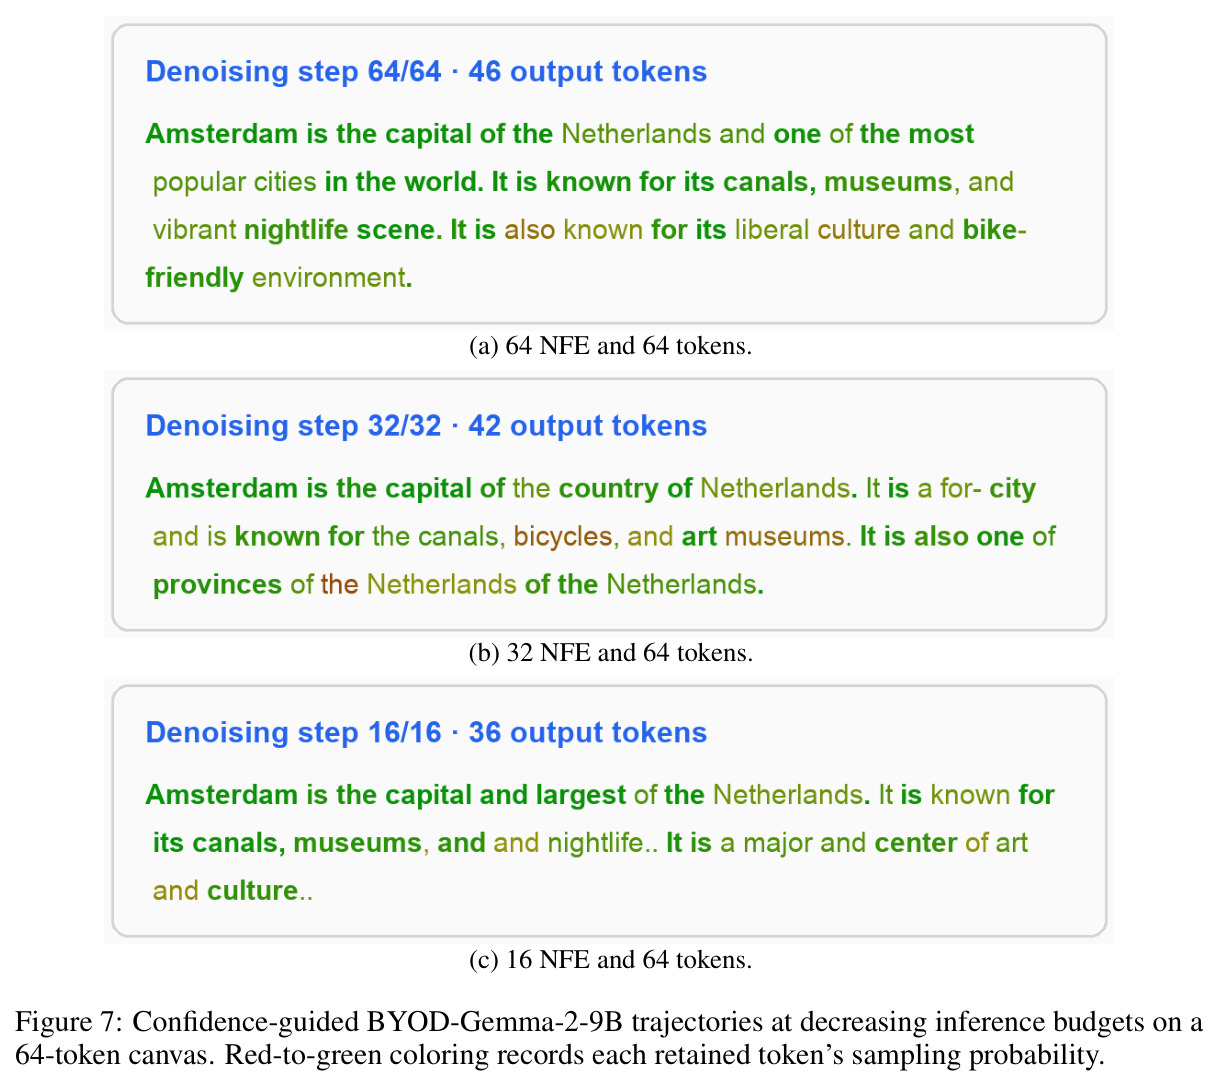
作者明确承认三点。第一,『高效转换』尚未带来『高效生成』:当 NFE 低于输出长度时质量明显下降(32 步生成 128 token 时 BYOD-Gemma 困惑度高达 14.56),困惑度仍是 AR 父模型的 2.7–5.0 倍;且效率只用 NFE 度量而非实际时延——每个扩散步都要前向处理整个答案块,更少的串行评估并不保证加速。第二,跨骨干比较不是受控架构研究:四个父模型在规模、tokenizer、预训练与对齐数据、注意力设计上都不同,固定 rank 又使各家族适配器预算不同(Qwen 323.0M vs Gemma 572.5M),Gemma 领先无法归因于架构、父模型质量、模型大小或参数量中的任何一个。第三,自动指标只覆盖文本质量的一部分:Phi-4 困惑度反映外部 AR 模型的偏好(可能偏爱重复的高概率文本),Distinct-n 只测局部重复而不测事实性、语法与连贯性;文献中其他 DLM 的数字协议不同,只有 LLaDA 被重跑;成本与碳排放也是标准化估算而非实测(未测能耗与碳强度)。我自己的观察:每基准仅 125 题的固定子集使 ±2–4 个点的任务级差异噪声较大(25k→50k 的 +0.5 平均很可能在噪声范围内);双向测试只验证信息流通而非生成质量;Qwen 复制率仅 20% 暗示部分模型对双向上下文的利用并不充分,但论文未深入诊断其原因;此外数学/代码任务用 256 token 训练长度可能限制了长推理链能力,这一混杂未被单独讨论。
独立分析的弱点
独立分析以下几个弱点。第一,低 NFE 生成质量坍塌是最实际的弱点:32 步生成 128 token 时 BYOD-Gemma PPL 高达 14.56,实际部署若追求加速会显著牺牲质量;改进方向是引入分层/块状解码(Block Diffusion、Fast-dLLM v2 式)或自适应早停调度,让模型先定骨架再修细节,并实测时延而非只报 NFE。第二,代码与数学的结构性失败:28% 的 HumanEval 输出语法非法(重复 def、括号不匹配等局部错误),源于并行预测的局部不一致;改进方向包括语法感知的重掩码(对分隔符、关键字位置提高保留优先级)、在 key/output 投影、MLP 和归一化层增加适配器以扩充容量、以及用更大有效 batch 替代单纯延长训练(论文已显示 25k→50k 仅 +0.5 点)。第三,跨家族比较存在混杂:rank 固定导致参数预算不同、父模型规模与数据不同;改进方向是在单一家族内做 rank 扫描与参数预算匹配的消融。第四,评测统计功效弱:每基准 125 题、无人类评估、外部 Phi-4 打分自带偏好;改进方向是扩大子集、加入成对人类偏好评估或 LLM 评审(如 MAUVE 类指标),并纳入事实性检查。第五,Qwen 对右侧线索的利用率仅 20% 而 Gemma/Ministral 为 100%,说明『双向信息可达』不等于『双向信息善用』;值得专门研究双向上下文下的指令遵循能力如何随架构与训练动态变化,例如检查不同掩码率下的条件重建准确率曲线。第六,答案区与填充区 0.9/0.1 的损失权重、$t$ 的均匀采样等超参均未消融,配方中哪些成分是成功的关键尚不清楚。
未来方向
作者提出的下一步包括:把合并后的模型作为部分或全参数扩散微调的初始化——先建立扩散生成能力、再让原始权重参与优化,检验能否在不侵蚀保留能力的前提下提升质量;系统刻画 rank–质量–算力的权衡($r=1024$ 只是迁移设定而非最优);消融更大有效 batch、替代去噪目标、以及在 key/output 投影、MLP、归一化层加适配器;用 logit 级确定性等价检验把合并引入的数值误差与评测方差分离。基于其成果可以延伸的方向:与块状扩散和层级 KV 缓存结合,把 BYOD 模型改造成可变长、可缓存的混合系统并实测时延加速;把配方推广到更多家族(如 Phi、GPT-OSS)与更大规模,检验转换难度是否随规模变化;深入解释家族间双向线索利用能力的差异(Qwen 20% 之谜),例如追踪不同训练阶段复制率与验证损失的联动;把 BYOD 当作快速构建跨架构扩散模型的实验平台,系统研究『哪些架构更可转换』;以及在评测侧引入对『困惑度改善来自重复』的自动甄别(MAUVE、基于 LLM 的偏好评审或事实性基准),弥补当前代理指标的盲区。
复现评估
复现条件非常好,属于同类工作中最开放的一档。代码完全开源:github.com/RuurdKuiper/BYOD 提供 Colab 训练 notebook、版本锁定的训练预设(数据集 Ruurd/LAD-training-1m-256 固定 revision 6041513b…)、推理与适配器合并脚本以及完整评测 harness;四个转换模型各有全精度 ZeroGPU 在线 demo,可交互调整 NFE、输出长度、重掩码策略与块状生成。训练成本极低:单张 96GB RTX PRO 6000(Google Colab 可获得)上 3.1–4.0 小时、至多 102.4M token、标准化估算约 $11,学生或个人研究者即可复跑一个家族。数据全部公开(Clean-Instruct-3M、Tülu 3、Alpaca-GPT4、Alpaca、MMLU、HellaSwag、ARC-Easy、Orca-Math、GSM8K、OpenCoder、MBPP),只用训练划分并剔除与基准重合的样本。评测协议完整披露:附录 C/D 给出全部超参数、每任务输出长度与 NFE 预算、125 题固定子集的选择方式,100 题开放生成 prompt 集公开。注意事项:作者声明重跑不保证逐位复现 checkpoint 或分数(随机性与硬件差异);FP8 HYBRID 精度需要较新的 GPU,旧卡可能只能用 BF16 并改变耗时;完整复现所有表格(尤其跨 NFE、跨 checkpoint 的诊断曲线)需要更多算力与时间。总体评估:复现单个模型转换『低难度』,完整复现论文全部实验『中等难度』。
论文图表