扩散语言模型的解码速度随任务与语言而变化 Diffusion Language Models Change Speed Across Tasks and Languages
扩散语言模型解码成本随任务、语言与答案对错大幅变化,可免费用作置信信号。
前置知识
自回归语言模型(Autoregressive LM)
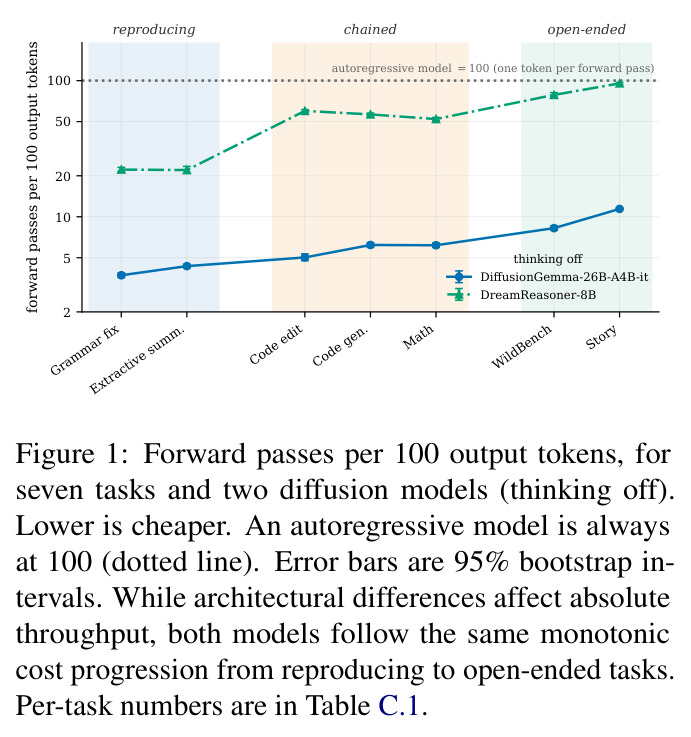
逐个 token 生成文本的模型:每生成一个 token 就要做一次完整的前向传播,生成 $T$ 个 token 恰好需要 $T$ 次前向传播,因此解码成本是恒定的,与任务、语言、答案对错都无关。论文把它的成本归一化为每 100 个输出 token 花费 100 次前向传播,作为一切对比的基准线。
本文的核心度量 cost 就是相对于这条『每次前向传播产出一个 token』的基线定义的,理解 AR 的固定成本,才能理解扩散模型的成本为何会随内容波动。
扩散语言模型与半自回归块扩散(block diffusion)
与 AR 不同的生成范式:模型在一次前向传播中并行『去噪』一整块 token(DiffusionGemma 每块 256 个位置、DreamReasoner 每块 32 个),块内按置信度或熵决定哪些 token 本轮被『提交』,未提交的位置留到下一轮继续精化。同样的输出长度,前向传播次数可以相差数倍。
论文测量的正是这种『每步提交多少 token』的行为;块大小与提交策略直接决定绝对成本,是所有实验的物理基础。
自适应解码与置信度提交
扩散模型每步不必用固定步数:只把足够自信的 token 固定下来(DreamReasoner 提交置信度 $\geq 0.9$ 的 token,DiffusionGemma 按熵从低到高提交、每块累计熵不超过 0.1),其余位置继续迭代。步数因此在推理时动态确定,成为可观测的『解码努力』信号。
全部发现都建立在这个动态步数上:步数多 = 模型不确定 = 成本高;这既是成本差异的来源,也是第 6 章『免费置信信号』的原理。
惊异(surprisal)与新信息量(NI)
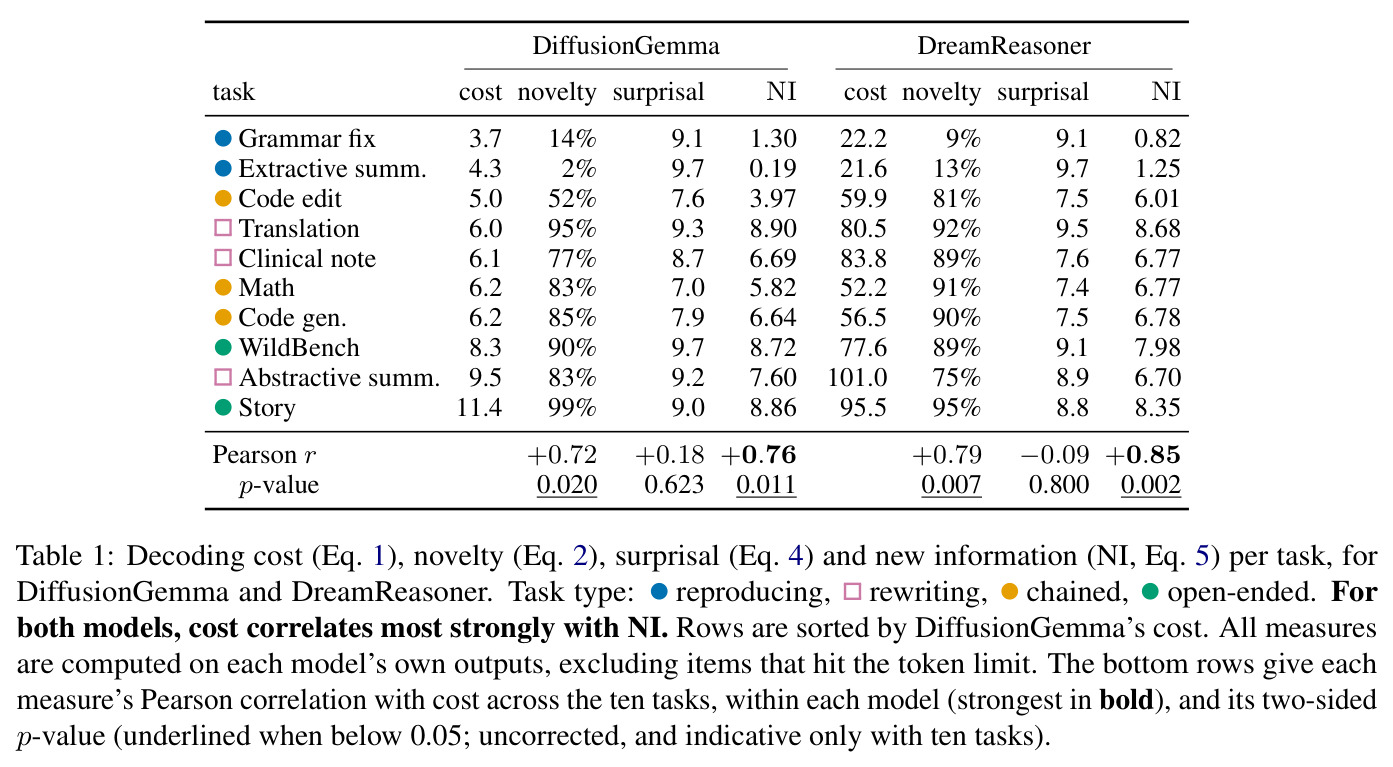
信息论中一个词的自信息量为 $-\log_2 P_t(w)$:任务内常见词只值几个比特,罕见词可达约 20 比特。论文把输出在任务内的平均惊异称为 surprisal,再乘以新词占比 novelty 得到每词新信息量 $NI = \text{novelty} \times \text{surprisal}$,单位为比特/词。
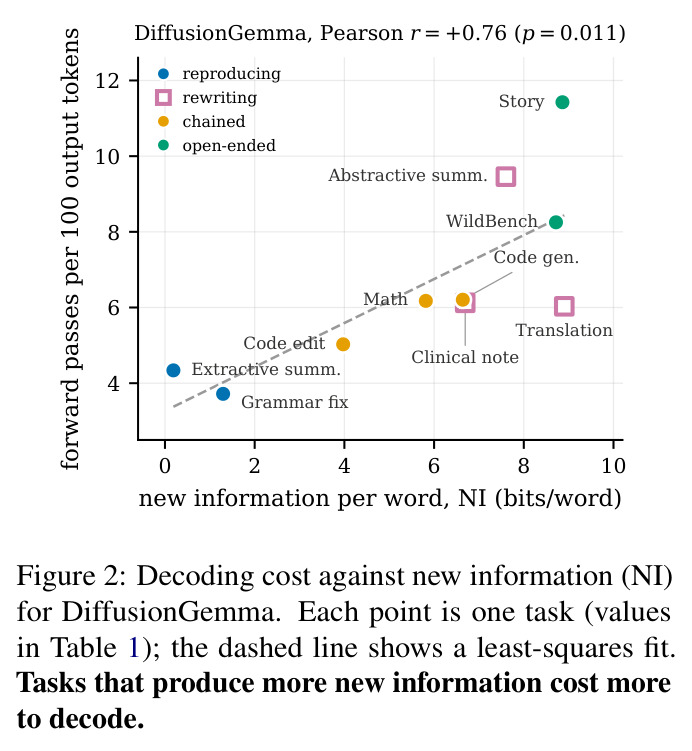
NI 是论文解释成本差异的核心变量,与 cost 的相关性最强(DiffusionGemma $r=+0.76$);不懂惊异就无法理解『抄写便宜、创作昂贵』的机理。
fertility 与分词器税(tokenizer tax)
fertility 指分词器把一种语言的每个单词平均切成多少个 token。低资源语言(亚美尼亚语、缅甸语等)常常一词多片,同样语义要用更多 token 表达,这是 AR 模型时代已知的『分词器税』,直接推高这些语言的推理成本。
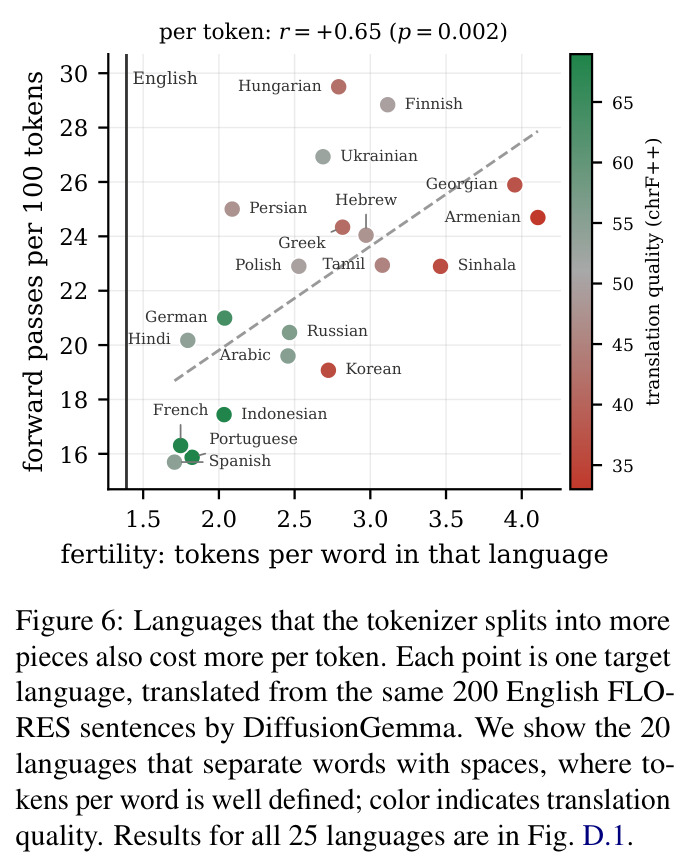
论文发现扩散模型在此税之上叠加第二重税:高 fertility 语言每个 token 还需要更多前向传播($r=+0.65$),构成『双重多语言税』;理解 fertility 才能看懂这一发现。
研究动机
自回归模型的推理成本可以精确预估:每个 token 恰好一次前向传播,开销只随输出长度线性增长。扩散语言模型号称并行生成多个 token、带来数倍加速,但既有工作报告的加速比(tokens per forward pass)几乎只在数学和代码等少数基准上测得。这留下两个悬而未决的问题。其一,同一个模型、同一套解码配置,在不同任务上的真实计算开销可能相差数倍——论文实测 DiffusionGemma 写故事每 100 个 token 要花 11.43 次前向传播,而语法纠错只要 3.72 次,相差 3.1 倍;如果部署方按『平均加速 10 倍』来规划容量或计费,在开放创作类场景会严重高估收益。其二,没有任何先前工作解释这种差异从何而来,也不知道解码努力是否与模型内部状态(比如当前答案是否正确)相关。多语言场景还叠加已知的分词器税:低资源语言本来就 token 更贵,但扩散模型是否在『每 token 计算量』层面再收一层费,此前无人测量过。
本文的目标是本文的目标是把『扩散模型的前向传播次数』变成一个可系统测量、可解释、可利用的量。具体分四步:一是建立统一成本度量 $\text{cost} = 100 \cdot P/T$(每 100 个输出 token 消耗的前向传播次数,AR 恒为 100),在覆盖约束程度递增的『复述—链式—开放』三类共 10 个任务上,对 DiffusionGemma-26B-A4B-it(26B MoE)与 DreamReasoner-8B(8B dense)两个模型做系统测量,每模型 2,468 个样本、H100 上共 3,860 次生成;二是找出决定成本高低的文本属性,提出 novelty(新词占比)与 surprisal(任务内词频惊异),并组合成新信息量 NI 来预测成本;三是剖析单次生成内部的努力分布,尤其是思维链与最终答案的分工,以及难度和答案对错的影响;四是检验多语言成本是否构成双重税,并把『解码越快 = 越有把握』转化为免费的答案选择信号,在不增加任何计算的前提下提升多数投票的准确率。
与已有工作不同的是,已有扩散 LLM 可解释性工作关注『模型内部发生了什么』——例如答案在解码终止前就已被隐式确定、正确答案会先出现再被覆写、掩码扩散模型实际近似从左到右解码——但没有人从计算视角回答『前向传播花在哪里』。本文的独特切入有三点。第一,把信息论量(novelty、surprisal、NI)与计算量(前向传播次数)对齐,将『模型的不确定性』操作化为可直接从输出文本计算的指标,且不依赖分词器或参考答案。第二,把任务的约束程度(复述/改写/链式/开放)作为实验设计的自变量,而不是像以往只在数学代码基准上报告单一加速数字,从而第一次给出任务层面的成本层级。第三,与 speculative decoding 领域已知的数据依赖并行性相呼应,本文首次在纯扩散解码中把『每 token 的解码努力』当作免费的置信度信号用于投票加权,这是可解释性工作从未触及的应用层面。
核心方法
论文的测量哲学是:不直接报告速度,而是报告每个输出 token 的前向传播次数。直觉上,扩散模型每一步只提交它『有把握』的 token,步数本质上反映了模型对当前内容的剩余不确定性。技术路线上,作者定义 $\text{cost}(y) = 100 \cdot P/T$,其中 $P$ 是生成输出 $y$ 所用的前向传播次数,$T$ 是到第一个 为止的真实输出 token 数(排除 padding 与截断样本),使块大小不同(32 vs 256)的模型可直接比较,AR 恒为 100。随后选取约束程度递增的三组共 7 个任务:复述(语法纠错 W&I+LOCNESS 317 篇、抽取式摘要 GovReport 300 份)、链式(代码修复 HumanEvalFix 164 题、代码生成 LiveCodeBench 300 题、竞赛数学 MathArena 255 题)、开放(WildBench 294 条、故事写作 WritingPrompts 300 条);第 3.1 节起再加入三个『改写』任务——德译英 WMT23 118 份文档、临床笔记 ACI-BENCH 120 份、章节摘要 BookSum 300 章。为了解释成本,作者提出两个不依赖分词器的文本属性 novelty 与 surprisal 并乘积成 NI;再通过思维开/关对比、竞赛数学难度梯度、25 语种翻译三组实验,把成本分布从任务层面细化到单次生成内部与语言层面。
核心思想:解码努力 ≈ 剩余不确定性,而剩余不确定性可以用输出文本的『新信息量』预测。与已有方法的本质区别在于:以前的工作把扩散模型的加速比当作模型的固定属性(在某个基准上测一次就完事),本文证明它是输出的函数——同样长度的两段文本,抄改输入可能只要 3.72 次前向传播/100 token,从零创作要 11.43 次。作者给出可计算的解释:novelty 用贪心最长匹配把输出切成『从输入复制的片段 + 孤立新词』,$\text{novelty}=(\text{matched 片段数}+\text{unmatched 词数})/|y|$,度量抄写程度;surprisal 用模型自身在该任务全部输出上的加一平滑词分布 $P_t(w)=\frac{c_t(w)+1}{N_t+V_t}$ 度量任务内用词常见度,$\text{surprisal}(y)=-\frac{1}{|y|}\sum_j \log_2 P_t(y_j)$;二者乘积 NI 即每词新信息比特数。这个组合是新的——像 NIST 机器翻译指标一样按罕见度加权,却不需要参考答案。最妙的推论是:开启思维链后,最终答案若只是复述思维(novelty 仅 1%–3%),就比思维本身更便宜;若思维没解出题,答案边写边继续推理(出现 'wait'、'let me re-check'),就更贵——错误答案由此在成本上自动暴露。
方法步骤详情
第一步,统一成本度量:对每次生成记录前向传播次数 $P$ 与真实输出 token 数 $T$(截至第一个 ,不计特殊 token 与读上下文的那一次),算 $\text{cost}=100P/T$ 后在任务内平均;剔除触及 16,384(重试 32,768)token 上限的截断样本和不足 5 token 的空输出,避免重复循环这类『病态的便宜输出』拉低均值。第二步,构建任务矩阵:10 个任务、每模型 2,468 项、固定随机种子,在 H100 上共 3,860 次生成;DiffusionGemma(256-token 块、每块最多 48 步、按熵低到高提交、每块累计熵上限 0.1)与 DreamReasoner(32-token 块、提交置信度 ≥0.9 的 token)各跑一遍。第三步,计算 novelty:从左到右在输入中贪心找最长匹配片段,未匹配的词各记为长度 1 的段。第四步,计算 surprisal:在任务全部模型输出的词频上加一平滑得 $P_t(w)$,对输出逐词取 $-\log_2 P_t$ 求平均。第五步,$NI=\text{novelty}\times\text{surprisal}$,与 cost 做 Pearson 相关并检验。第六步,开启思维模式:DiffusionGemma 的思维与最终答案都按 256-token 块解码,可分别统计成本,并测『答案对思维的 novelty』与『答案减思维的成本差』的相关。第七步,难度实验:AIME I/II、HMMT、CMIMC 等 5 项赛事的 160 道题 × 5 种子,以题在轮内位置为难度代理。第八步,多语言实验:FLORES-200 前 200 句英文译成 25 种语言(16 种文字),共 5,000 次生成。第九步,应用验证:以『答案 token 数 ÷ 答案前向传播数』为权重对候选答案加权投票,与多数投票对比。
技术新颖性
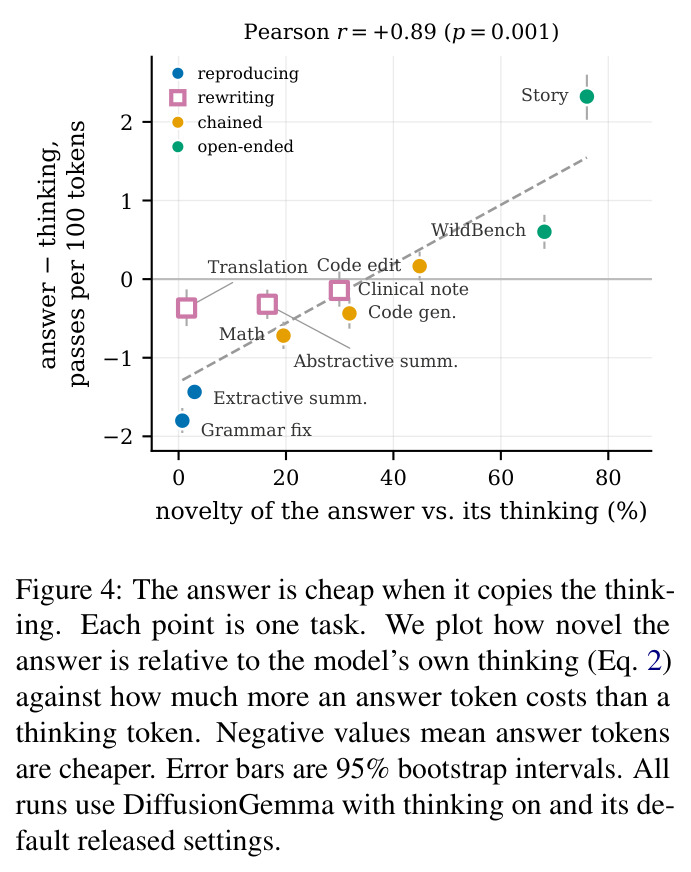
技术新颖性体现在三个层面。度量层面:$\text{cost}=100P/T$ 把『块内提交了多少 token』这一动态行为归一化为可比标量,排除了块容量差异(32 vs 256)与早停的干扰,使跨模型、跨任务的成本排序第一次有了共同语言。解释层面:NI 是全新构造——novelty 源自摘要领域的 copy length(但把每个未复制词也计为长度 1 的段),surprisal 是经典自信息,二者捕捉『抄了多少』与『用词多稀罕』这两个近乎正交的维度(任务级相关仅 +0.18 与 −0.09),而乘积 NI 与 cost 的相关显著强于任一单维(+0.76/+0.85,对比 novelty 的 +0.72/+0.79 与 surprisal 的 +0.18/−0.09),且不依赖分词器和参考答案。应用层面:把每 token 前向传播次数读作模型置信度并用于投票加权,是零额外成本的 test-time 技巧——统计解码步数不需要任何额外前向传播。此外,『答案复述自己的思维链所以便宜』这一发现,把可解释性文献中『答案早已在思维中确定』的定性结论第一次落到可测量的计算分配上,并给出定量规律:答案对思维的 novelty 与成本差的相关达 $r=+0.89$($p=0.001$)。
实验结果
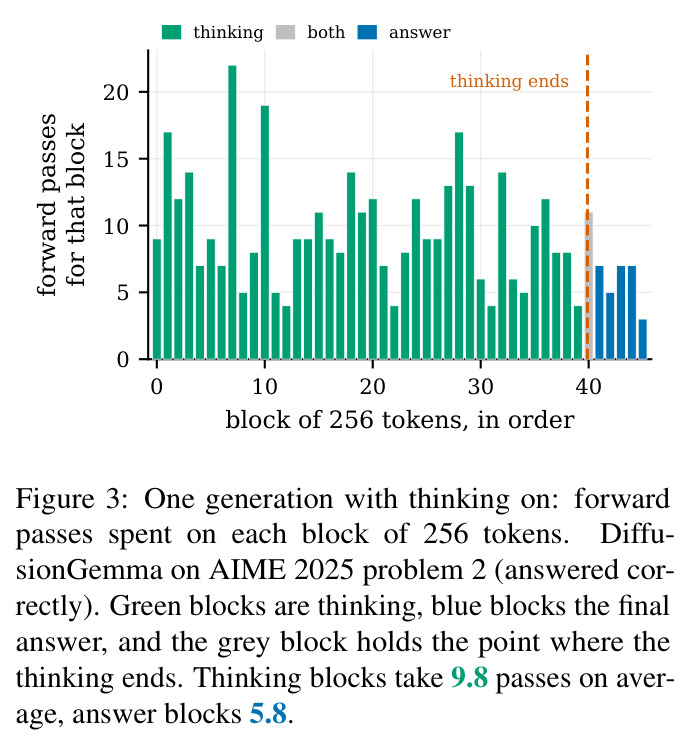
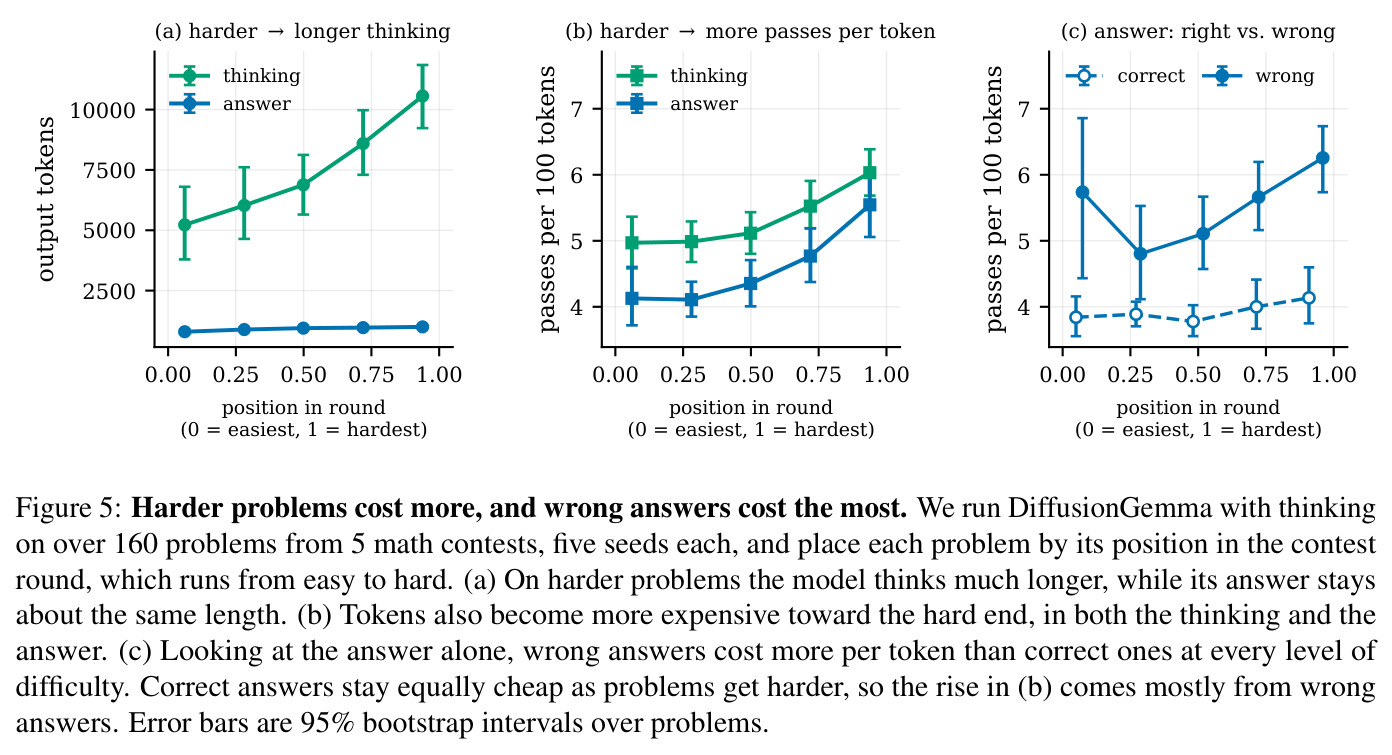
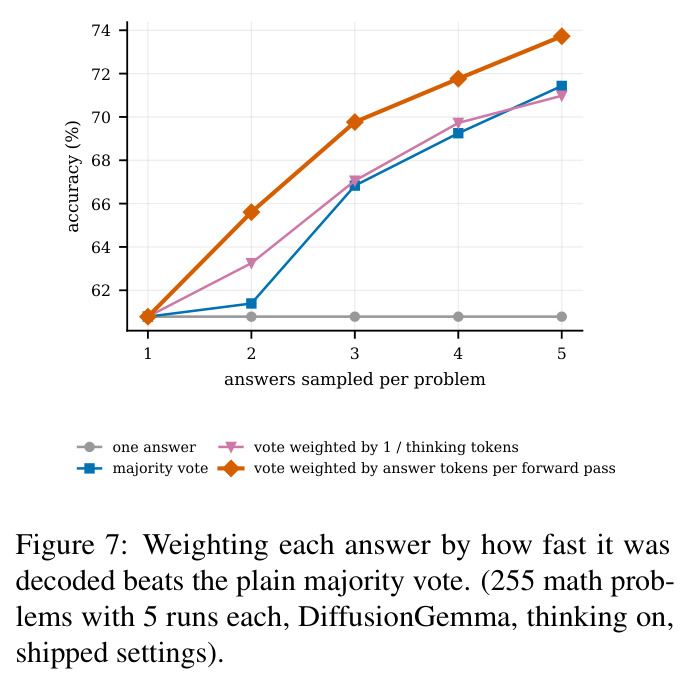
任务层面:DiffusionGemma 三组任务的平均成本从复述 4.0、链式 5.8 到开放 9.8 次前向传播/100 token,语法纠错 3.72 对故事写作 11.43,相差 3.1 倍;DreamReasoner 分别为 22.1、56.2、87.0(极差 4.3 倍),两模型的任务成本排序完全一致。解释层面:novelty 与 cost 的相关为 +0.72(DiffusionGemma,$p=0.020$)与 +0.79(DreamReasoner,$p=0.007$),surprisal 单独不显著(+0.18/−0.09),NI 最强(+0.76, $p=0.011$ / +0.85, $p=0.002$):数学与代码生成 novelty 高达 83%/85% 但用词常见(7.0/7.9 比特),成本仅 6.2/6.2,而章节摘要用词稀罕(9.2 比特)成本 9.5。生成内部:AIME 2025 第 2 题上思维耗 10,339 token(40 块,块均 9.8 次前向、块间 4–22 次波动),答案仅 1,241 token(5 块,块均 5.8 次);答案对问题的 novelty 为 87%,但对思维仅 15%。跨任务看,答案复述思维越多越便宜:语法纠错答案 novelty 1%、成本 3.52 对思维 5.32,抽取摘要 2.07 对 3.50;而 WildBench/故事 novelty 68%/76%,答案反而比思维贵 +0.60/+2.32;novelty 与成本差的相关 $r=+0.89$($p=0.001$)。难度实验(160 题 × 5 种子):准确率从易 79% 降到中 57%、难 44%;思维中位数从 4,416 涨到 9,710 token,思维成本 5.00→5.89、答案 4.15→5.21;但正确答案几乎不变(3.88→4.02),错误答案 5.16→6.13,控制赛事、位置与长度后错误答案仍多花 +1.20 次/100 token,固定题目与长度仍 +0.83;同一道题两种子一对一错,错的 7.0 对对的 3.8 次/100 token,错误答案出现 'wait' 类自我纠正短语约多 5 倍。多语言:亚美尼亚语每句 16.9 次前向对西班牙语 5.3(3.2 倍),其中 token 数 2.1 倍(75 对 36)、每 token 成本 24.7 对 15.7;fertility 与成本相关 $r=+0.65$($p=0.002$)、与 chrF++ 相关 $r=-0.81$,构成双重多语言税。应用:按答案解码速度加权投票在 255 道竞赛数学上比多数投票高 +4.2 点(2 答案)与 +2.3 点(5 答案,71.4%→73.7%,10,000 次 bootstrap 的 95% CI [0.3, 4.5]),而按 1/思维 token 数加权仅 71.0%,说明信号确实来自答案段自身的解码速度。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 语法纠错(W&I+LOCNESS,DiffusionGemma,思维关闭) | cost:前向传播次数 / 100 输出 token | 3.72 | 自回归模型恒为 100 | 仅为 AR 成本的约 3.7%,节省 96.3%(复述类任务最便宜) |
| 故事写作(WritingPrompts,DiffusionGemma) | cost | 11.43 | AR = 100 | 仍省 88.6%,但比语法纠错贵 3.1 倍,暴露开放任务的成本差距 |
| 故事写作(DreamReasoner-8B) | cost | 95.47 | AR = 100 | 几乎追平 AR;其复述任务最低 21.6–22.2,极差 4.3 倍,排序与 DiffusionGemma 一致 |
| cost 与文本属性的相关(10 任务,DiffusionGemma) | Pearson r | NI:+0.76(p=0.011) | surprisal 单独:+0.18(p=0.623,不显著);novelty:+0.72 | NI 显著优于任一单一维度(DreamReasoner 上为 +0.85 vs −0.09/+0.79) |
| 竞赛数学 5 样本投票(MathArena 255 题,DiffusionGemma,思维开启) | 准确率 | 73.7%(按答案解码速度加权投票) | 71.4%(普通多数投票) | +2.3 点,零额外成本;2 答案时增益最大 +4.2 点,95% CI [0.3, 4.5] |
| 英→25 语翻译(FLORES-200,200 句,DiffusionGemma) | 前向传播次数 / 句 | 亚美尼亚语 16.9(74.8 token,cost 24.7) | 西班牙语 5.3(36.4 token,cost 15.7) | 高 fertility 语言贵 3.2 倍,叠加在 2.1 倍的 token 差之上(双重税) |
局限与改进
作者承认的局限:一是模型太少——只有 DiffusionGemma 与 DreamReasoner 同时满足『自适应提交式解码』且『强到能做推理、翻译与长文写作』,早期开源扩散模型多为固定步数、自适应解码只是推理期补丁,结论能否外推到更多规模与训练配方尚待验证;二是难度代理粗糙——用题目在竞赛轮内的位置近似难度,只是启发式而非校准的难度度量;三是统计功效有限——任务级相关只基于 10 个任务点,p 值未做多重校正,作者自己标注『仅具指示意义』。我自己的观察:其一,成本只计前向传播次数,不计每步的墙钟时间与能耗——DiffusionGemma 是 MoE(25.8B 总参、每 token 约 3.8B 激活),DreamReasoner 是 8B dense,一次前向传播的实际开销差一个量级,且注意力随上下文变长每步更贵,跨模型的绝对成本比较并不公平;其二,剔除截断样本虽避免了重复循环污染均值,但存在选择偏差——DreamReasoner 有 143/300 个故事、56 个 WildBench、40 个抽取摘要触顶被剔除,剩余样本的成本被系统性低估,且两模型剔除率不同;其三,novelty 与 surprisal 是在模型自身输出上统计的,存在循环依赖之嫌——『模型爱写常见词』本身可能就是低不确定性的结果而非原因,因果方向未经干预实验验证;其四,思维链分析只在 DiffusionGemma 上做,多语言只测了『英译出』一个方向,未测其他源语言。
独立分析的弱点
独立分析可见四个弱点。一、相关性不等于因果:NI 与 cost 的相关建立在仅 10 个任务级均值上,样本极小;novelty 和 surprisal 又从模型自己的输出统计,『常见词便宜』可能只是『模型没把握时才写罕见词』的同义反复。改进方向:在同一任务内对单条输出做层级回归,或人为改写输出(把复制段落替换为同义改写)做干预实验,检验成本是否按 NI 的预测移动。二、没有墙钟与能耗测量:前向传播次数忽略了 MoE 稀疏激活、块大小对并行度与显存的影响、注意力随上下文增长的步内开销,两个模型的『便宜』无法直接换算成部署成本。改进:补充 tokens/秒与 J/token 的测量,并报告不同批大小下的结果。三、剔除截断输出造成选择偏差:DreamReasoner 的故事只剩 155/300 被计入,留下的成本已高达 95.47、接近 AR 的 100,真实开放任务成本可能更高甚至反超 AR,『扩散在开放任务仍有优势』的结论对解码上限敏感。改进:报告含截断样本的成本上界,或用更长上限重跑。四、应用面窄:加权投票只验证了数学一个领域,且权重只用答案段的解码速度;思维块级别便宜且不均的结构(图 3 中块间 4–22 次的波动)蕴含的过程级信号未被利用。改进:把思维块成本曲线作为过程级置信信号,用于提前终止、触发重采样或选择验证点。
未来方向
作者在结论与讨论中提出的方向:用解码努力引导验证(verification)、决定是否追加采样与提前停止;按任务结构和已有文本的复用程度自适应调整块大小与停止规则;构建混合模型——在生成过程中根据『还剩多少新内容要写』选择性切换自回归与扩散解码,让模型按每个任务、每段响应的计算需求调整解码策略与预算。基于本文成果可延伸的方向:把 NI 从解释变量升级为预算控制器——解码时在线估计剩余 token 的预期 NI,动态分配每块步数上限,实现『该快就快、该慢就慢』的推理调度;把『答案解码速度 = 置信度』推广到无奖励模型的 best-of-n 与树搜索,与 self-consistency、过程奖励模型正交组合;在扩散 drafter 的 speculative decoding 中,用本文框架解释不同领域接受率的差异(作者已指出与 Sandler et al. 2025 的公平性问题相呼应);为高 fertility 语言设计分词或解码补偿策略以消除双重多语言税;并扩展到更多新发布的自适应扩散模型(如 LLaDA2.0 级别),检验结论随规模与训练配方的稳定性。
复现评估
复现条件较好。两个模型的权重都公开在 Hugging Face(google/diffusiongemma-26B-A4B-it 与 Dream-org/DreamReasoner-8B),10 个任务的数据集全是公开基准(W&I+LOCNESS、GovReport、HumanEvalFix、LiveCodeBench、MathArena、WildBench v2、WritingPrompts、WMT23、ACI-BENCH、BookSum、FLORES-200)。附录给出了完整解码配置(表 A.1:块大小、每块最大步数、熵/置信度阈值)、每个任务的数据来源与筛选规则(表 B.1)、全部自写提示词,以及剔除规则(触上限换更长上限重试一次、空输出换种子)。算力上共 3,860 次生成加 5,000 次翻译,单卡 H100 即可完成,中等规模实验室负担得起。难点有二:论文未提及开源测量代码,需要自己 hook 解码循环记录每块提交的 token 数与步数(对官方实现友好,但要小心『读上下文的那次前向』是否计入);novelty 的贪心最长匹配与任务内词分布的加一平滑需按附录描述重新实现,且按词而非 token 切分这一细节会影响数值。总体评估:难度中等,主要成本在多模型多任务的推理时间而非方法复杂度。
论文图表
Figure 6 的完整版:DiffusionGemma 把同一批 200 句 FLORES 英语句子译成 25 种语言(按文字系统着色),横轴每句 token 数、纵轴每句前向传播次数,虚线为等成本线(点所在的线越高,每 token 越贵),竖线为英语参照(28 token/句,作为源语言无成本)。亚美尼亚语 74.8 token、16.93 次/句最贵,西班牙语 36.4 token、5.33 次/句最便宜。
把 token 维度与 pass 维度的双重劣势同时可视化并覆盖全部 25 语(含无空格文字的 CJK 等),支撑多语言公平性论断的完整证据。
同一道 brumo_2025-15 竞赛题、仅随机种子不同的两次生成对照:种子 1 答对(4529),最终答案 3.8 次前向/100 token,通篇复述思维已得出的解法;种子 2 答错(4584),7.0 次/100 token,答案中段出现 'Wait, the previous definition was...'、'Actually, the sum...' 等自我纠正短语,边写边继续解题,成本几乎是对的两倍。
定性展示『错误答案更贵』的微观机制:思维没解开时模型在写答案的同时仍在工作,这是把解码成本当作置信信号时可解释、可观测的机理样本。
两个模型的解码配置:DiffusionGemma-26B-A4B-it(25.8B 总参 MoE、每 token 约 3.8B 激活,每次写 256 token,每块最多 48 步,按熵从低到高提交 token、每块累计熵上限 0.1);DreamReasoner-8B(8.2B dense,每次写 32 token,每块最多 32 步,提交置信度 ≥0.9 的 token)。
复现的必要条件:cost 的绝对数值直接取决于这些提交阈值与块大小;理解『自适应解码』的具体实现(熵预算 vs 置信度阈值)也依赖这张表。
10 个任务的数据集、条目形式与数量:语法纠错 317 篇 80–1,200 词整文、抽取摘要 300 份政府报告、代码修复 164 题、代码生成 300 题、竞赛数学 255 题(AIME/HMMT/BRUMO/SMT/CMIMC/APEX 2025 等)、WildBench 294 条、故事 300 条,加上翻译 118 份 WMT23 文档、临床笔记 120 份、章节摘要 300 章,每模型共 2,468 项。并注明三项复述任务黄金答案确有 96.2%(语法)/95.2%(抽取摘要)的词来自输入,验证了任务分组的有效性。
界定『复述/链式/开放/改写』的操作性定义与样本规模,说明固定选择种子、控制输出长度的实验设计,是成本差异不来自数据挑选的保证。
Figure 1 的完整数值:每任务的样本数、触上限/空输出剔除数、cost 均值、95% CI、中位数、平均输出 token 数与整体 tokens/pass。DiffusionGemma 从 3.72 [3.58, 3.86](语法)到 11.43 [11.30, 11.55](故事),tokens/pass 28.8→8.7;DreamReasoner 从 21.6–22.2 到 95.47 [93.69, 96.99],tokens/pass 仅 4.7→1.1,且故事有 143/300 触上限被剔除、代码生成 5 项被剔除。
提供全部置信区间与剔除明细,让读者评估每个结论的统计强度与选择偏差(尤其 DreamReasoner 开放任务的大量剔除),是审查论文严谨性的关键表。
25 种语言的每句 token 数、前向传播次数、cost、fertility、相对英语长度比与 chrF++ 翻译质量。西班牙语 36.4 token、5.33 次/句、cost 15.7、chrF++ 54.5;葡萄牙语 chrF++ 最高 69.0 但成本也低;匈牙利语 cost 最高 29.5、亚美尼亚语 16.93 次/句且 chrF++ 仅 33.0;无空格文字(中/日/泰/高棉/缅甸)不计算 fertility。汉语每句仅 32.3 token 但 cost 21.9。
多语言结论的完整数据支撑:可据此核对『双重税』在每个语言上的分解(token 数劣势 vs 每 token 成本劣势),并观察成本与翻译质量的负相关。