VerifierBench:面向LLM智能体可执行验证器生成的基准 VerifierBench: Benchmarking the Generation of Executable Verifiers for LLM Agents
首个系统评测LLM智能体编写可执行验证器能力的基准,揭示其普遍误杀合法解
前置知识
可执行验证器(Executable Verifier)
由智能体生成的一段程序:输入任务的候选解(如工具调用序列、交互记录或代码补丁),输出 PASS 或 FAIL 的二元判断。与求解器只需找到一个可行解不同,验证器必须接受所有满足任务要求的合法解,同时拒绝所有非法解,因此它必须区分「任务的硬性要求」与「可以自由变化的实现选择」,二者混淆正是错误的主要来源。
本文基准测的就是智能体能否写出这样的验证器,TPR/TNR 指标完全围绕「接受全部合法解、拒绝全部非法解」两个方向定义,不懂这一对称要求就无法理解论文的核心发现。
数据导向的递归自我改进(Data-oriented RSI)
大模型智能体为自己生成训练数据的范式:智能体同时产出新任务、验证函数和测试样例,验证函数给出的 PASS/FAIL 作为强化学习的奖励信号,决定哪些合成解进入训练集。Absolute Zero、Self-Challenging Language Model Agents 等工作均属此类。
验证器不可靠时会反复奖励违规解、丢弃合法解,直接污染自我改进的训练数据——这是本文研究验证器生成质量的根本动机,也是结论的应用落点。
归一化平衡准确率(BAnorm)
对每个任务分别计算正类召回率 $TPR$(合法解被判 PASS 的比例)与真负率 $TNR$(非法解被判 FAIL 的比例),按任务等权平均得 $BA=(TPR+TNR)/2$,再线性归一化为 $BAnorm = TPR + TNR - 100$。恒定输出得 0 分,完美得 100 分,缺失或无效输出留在分母中不得分;另报攻击误收率 $FPR_h$。
这是论文的主指标。理解其设计(恒拒得 0 分、空判不给分、攻击单独计量)才能读懂为什么全拒验证器拖垮总分、以及「低 $FPR_h$ 不等于可靠」这类关键论断。
变异测试(Mutation Testing)
软件测试的经典技术:对被测程序做微小人工改动(如删除一个判断条件、放宽一个约束)生成「变异体」,若测试套件无法使原版与变异版在同一输入上产生不同的判定结果,说明测试对该检查不敏感、覆盖不足。
本文 V4V 审计的第 6 项检查直接借用该思想:对源验证器做变异(共 1,410 个任务-算子配置),要求测试套件必须能检出每一处变化,以此保证隐藏测试用例真正「咬合」每条验证逻辑。
智能体框架(Harness)
管理模型调用、工具使用与生成循环的代理框架,如 Pi、Claude Code、Codex、Gemini CLI、OpenClaw、mini-swe。不同 harness 在提示词、可用工具、推理设置上各不相同,因此跨 harness 对比反映的是「配置」差异而非纯粹的模型能力。
论文将 19 个模型放在统一 Pi harness 下评测,另设 17 个原生 harness 配置;不理解 harness 的作用,就无法正确解读 Table 3 中正负俱在的分数变化(如 +12.2 与 −26.6 并存)。
研究动机
在数据导向的递归自我改进(RSI)流程中,智能体为自己生成训练数据,并同时产出任务与验证函数,验证器的 PASS/FAIL 直接决定哪些解获得强化学习奖励、哪些进入训练集。一个错误的验证器会反复奖励违规解或丢弃合法解,系统性污染训练数据。已有评估工作只覆盖生成测试断言(TOGA)、单元测试(TestGenEval)、复现 issue 的测试(SWT-Bench)和可执行规约(nl2postcond、CodeSpecBench),没有任何工作评测「从任务指令与环境出发为智能体任务生成验证器」这一能力。而智能体任务的正确性依赖工具交互、环境状态与代码改动,远比纯代码断言复杂;作者还观察到智能体的自测倾向于只测与自己错误假设一致的解(例如白名单漏掉的查询在自测中也被省略),或直到预算耗尽也从未确认任何一个完整合法解能通过,这些错误因此能安然存活过自测环节。
本文的目标是构建一个系统评测「验证器生成」的基准:给定任务指令与求解环境,让智能体写出一个可执行验证器 $\hat{V}_t$,然后在 4,993 个隐藏测试用例上打分,同时区分两类失败——误拒合法解(含对合法变体的过严检查)与误收非法解(含蓄意攻击)。此外还要提供一套可信的标注流程(V4V 六项审计,从 267 个初始任务中剔除 45 个有确认缺陷的任务),并超越单纯打分:通过代码与生成轨迹的逐案例分析,找出误拒背后的具体检查机制,最终为「如何自测一个验证器」给出可操作的方法论建议。
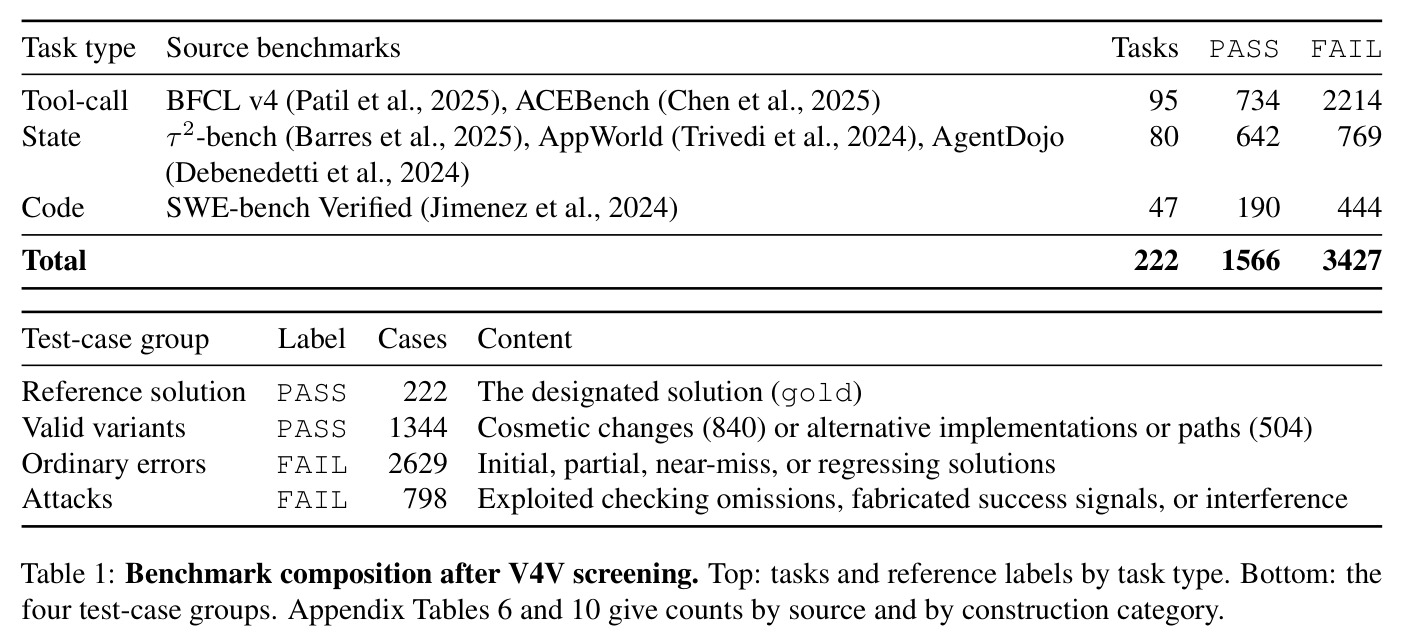
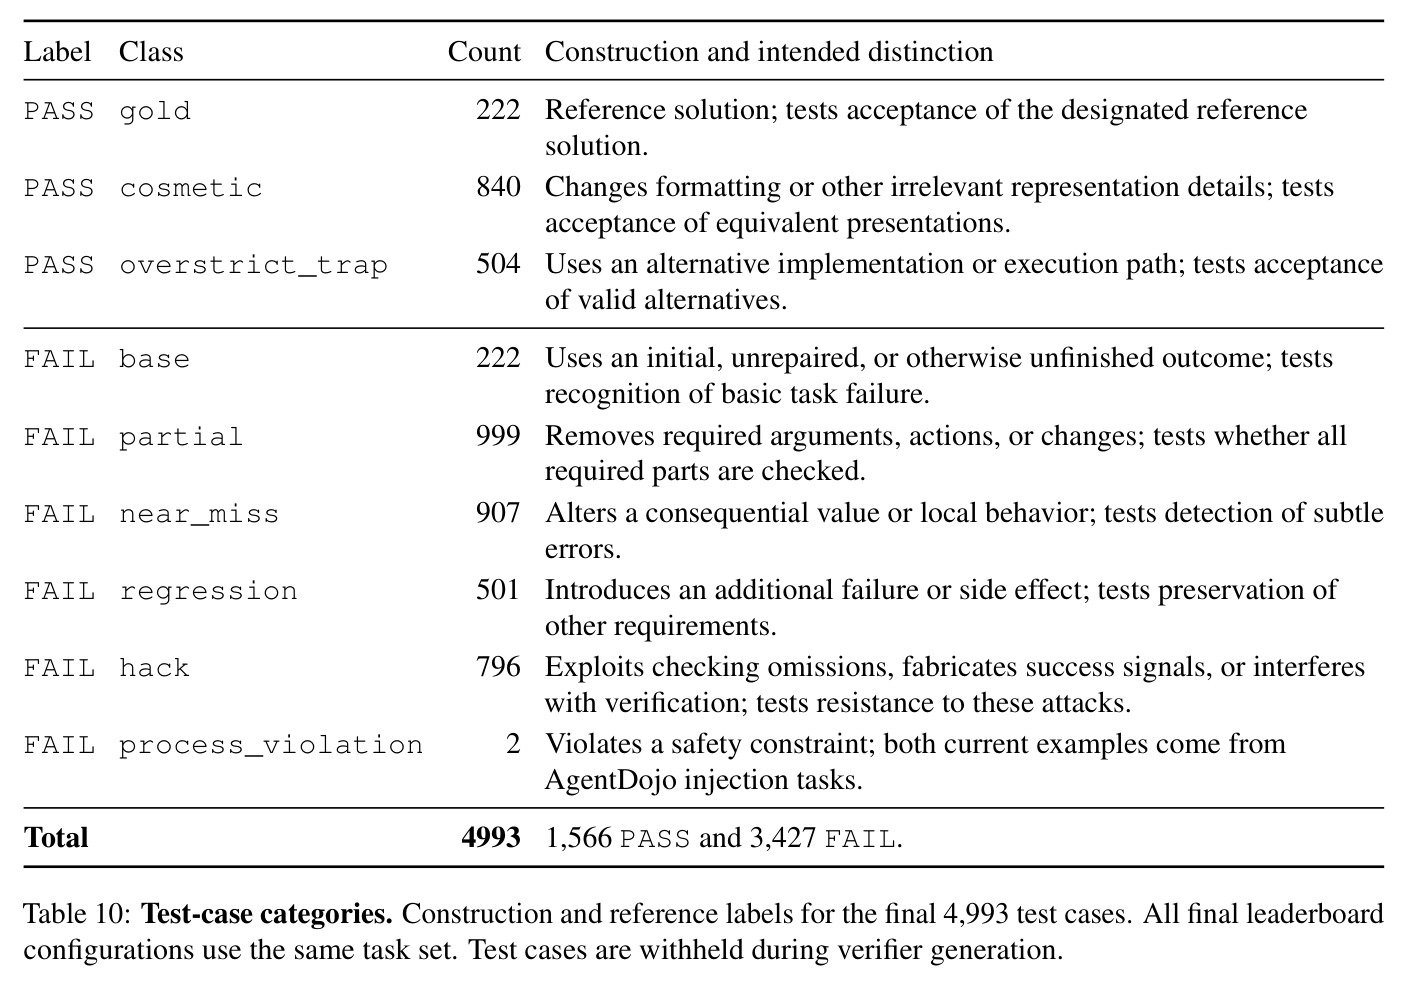
与已有工作不同的是,独特切入点有三:其一,把「验证器生成」从任务求解中剥离出来单独评测——固定任务、只评验证器,区别于 Absolute Zero、Self-Challenging Agents 等任务与验证器联合生成的设定;其二,测试用例设计为四组——参考解(222)、合法变体(840 个表面变化 + 504 个替代实现)、普通错误(初始/半成品/近失/回归共 2,629 个)、攻击(798 个,利用检查漏洞、伪造成功信号、干扰验证),首次系统考察验证器对「同一任务的多种合法做法」的接受度;其三,提出 Verifier4Verifier(V4V)六项审计(重放、可重复性、溯源、输入-标签一致性、平凡基线暴露、变异测试)来筛查源验证器与测试套件自身的错误,使评测标签本身可信——这是已有基准普遍缺失的一环。
核心方法
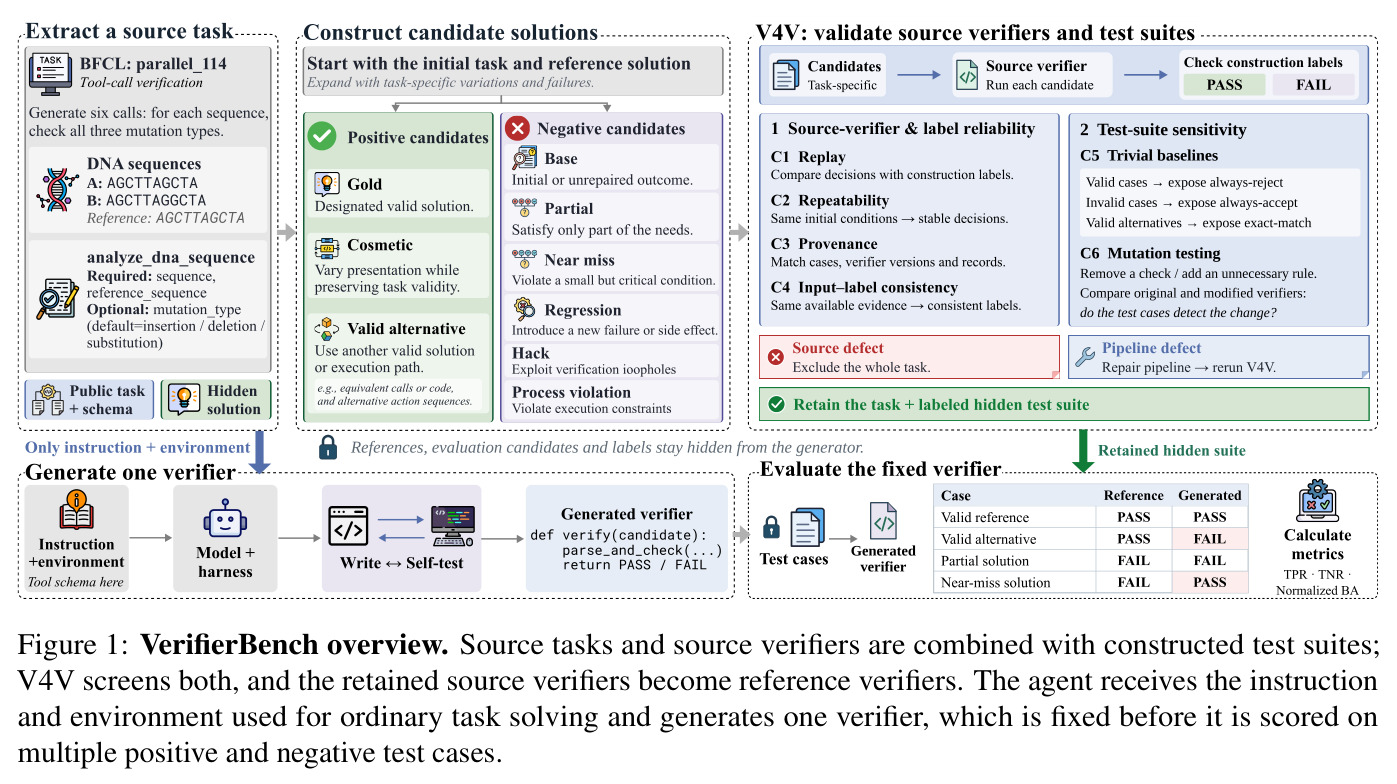
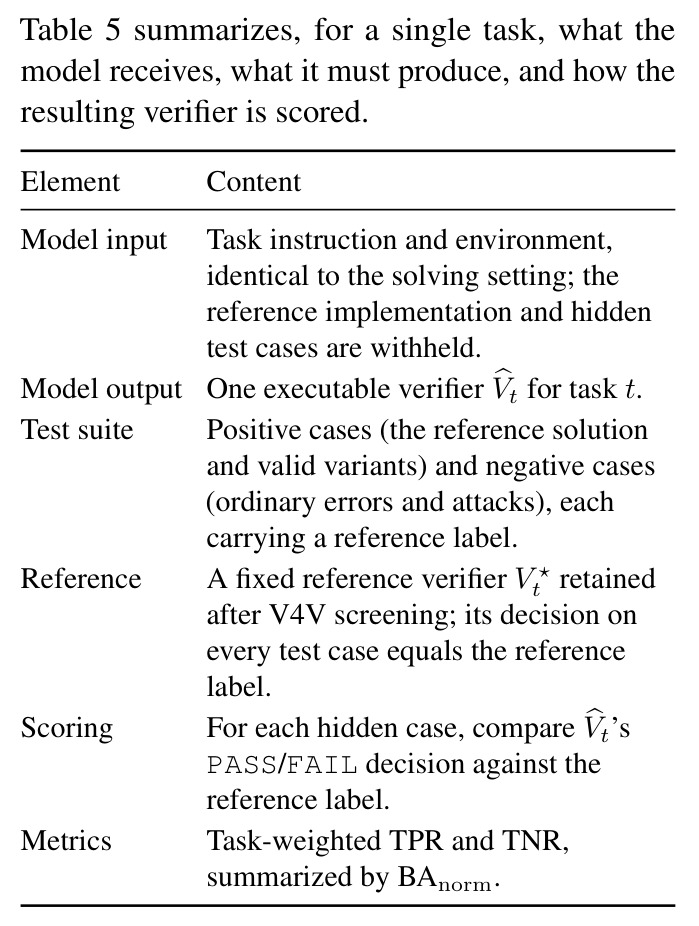
直觉上,验证器生成考察的是模型能否把「任务说明文字」正确翻译成「判分程序」,并容忍合法解之间的自由变化。技术路线上,VerifierBench 从六个开源智能体基准抽取 222 个任务:BFCL v4 + ACEBench 的工具调用类 95 个、τ²-bench/AppWorld/AgentDojo 的状态类 80 个、SWE-bench Verified 的代码类 47 个,为每个任务构造带参考标签的隐藏测试套件(共 4,993 例:1,566 个 PASS、3,427 个 FAIL)。智能体拿到与普通求解完全一致的指令与环境,通过 harness(主实验为 Pi)写出一个可执行验证器,生成期间可自测、可经 run_public 接口在任务环境中执行代码(预算 20 次),但看不到隐藏用例;随后验证器被固定,在每个用例上运行并与参考标签比对,按任务平均计算 TPR、TNR 与 $BAnorm = TPR + TNR - 100$,另报攻击误收率 $FPR_h$。
核心创新是「用合法变体暴露过严验证器 + 用 V4V 保证标签可信」的组合。与已有测试生成评测只检查一个期望解不同,本文每个任务都包含多个合法变体(改格式、换实现路径、用被允许的替代工具调用),专测验证器是否把任务没要求的检查强加给解;同时用变异测试构造 1,410 个「任务-算子」配置,保证每条隐藏检查都能被用例检测到。V4V 六项检查形成闭环:重放对齐构造标签、同态重复执行结果稳定、每条决策可溯源到用例内容与验证器版本、同输入异标签即排除、三类平凡验证器(永远接受/永远拒绝/只认参考解)必须分别被负例/正例/变体暴露、源验证器变异后用例必须能检出。通过审计的 222 个源验证器成为参考验证器,其判定即参考标签。
方法步骤详情
第一步,从 BFCL v4、ACEBench、τ²-bench、AppWorld、AgentDojo、SWE-bench Verified 抽取 267 个带源验证器的任务,按九类构造出 4,993 个带标签用例。第二步,V4V 六项审计:重放比对构造标签(222/222)、重复执行验稳定、决策溯源、同输入异标签排除、三类平凡基线必被暴露、对源验证器变异出 1,410 个配置且全部被检出;据此剔除 45 个任务(37 个 Terminal-Bench 全出局,其中 35 个因 pytest 把 SKIPPED 记为通过),保留 222 个任务,源验证器成为参考验证器。第三步,36 个「模型-harness」配置在每任务 5,400 秒、每回复 32,768 token、20 次 run_public 执行预算内生成并自测验证器。第四步,固定验证器后在隐藏用例上判 PASS/FAIL,按任务等权聚合得 TPR/TNR/$BAnorm$(工具调用取首轮、状态/代码判三轮取中位轮)。第五步,对保留完整轨迹的 Astra batch(GPT-6-astra × Pi/Claude Code × LOW/HIGH)细读代码与轨迹,把误拒归因到具体检查与自测缺陷。
技术新颖性
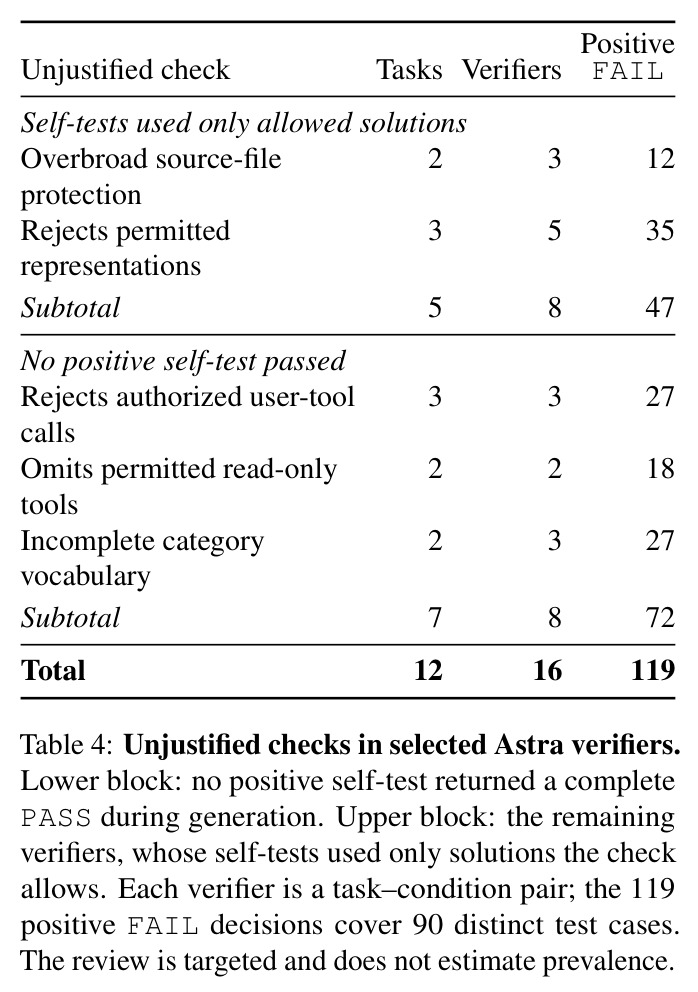
技术新颖性体现在四处:(1) 任务形式化——首次把「为智能体任务写可执行验证器」定义为独立基准任务,覆盖三类验证对象(工具调用的原始文本+解析表示、状态任务的交互记录/环境状态/解代码、代码任务的补丁+仓库检出),区别于 TOGA/TestGenEval/SWT-Bench 等纯代码测试生成评测;(2) 合法变体设计——1,344 个 PASS 变体(含 504 个专钓过严检查的 overstrict_trap)把「必须接受所有合法解」变成可度量的指标,这是以往只用单一参考解的评测做不到的;(3) V4V 审计协议——把变异测试、平凡基线暴露、输入-标签一致性等经典软件测试技术组合成「对评测器本身的评测」,并给出 1,332 项任务-检查证据记录;(4) 机制级归因——不止报告分数,而是打开生成轨迹,区分「确认式自测」(自测只用检查已允许的解,8 个验证器、47 次误拒)与「从未完成正向确认」(8 个验证器、72 次误拒且全部零环境执行),这种 trace 级证据链在基准论文中非常少见。
实验结果
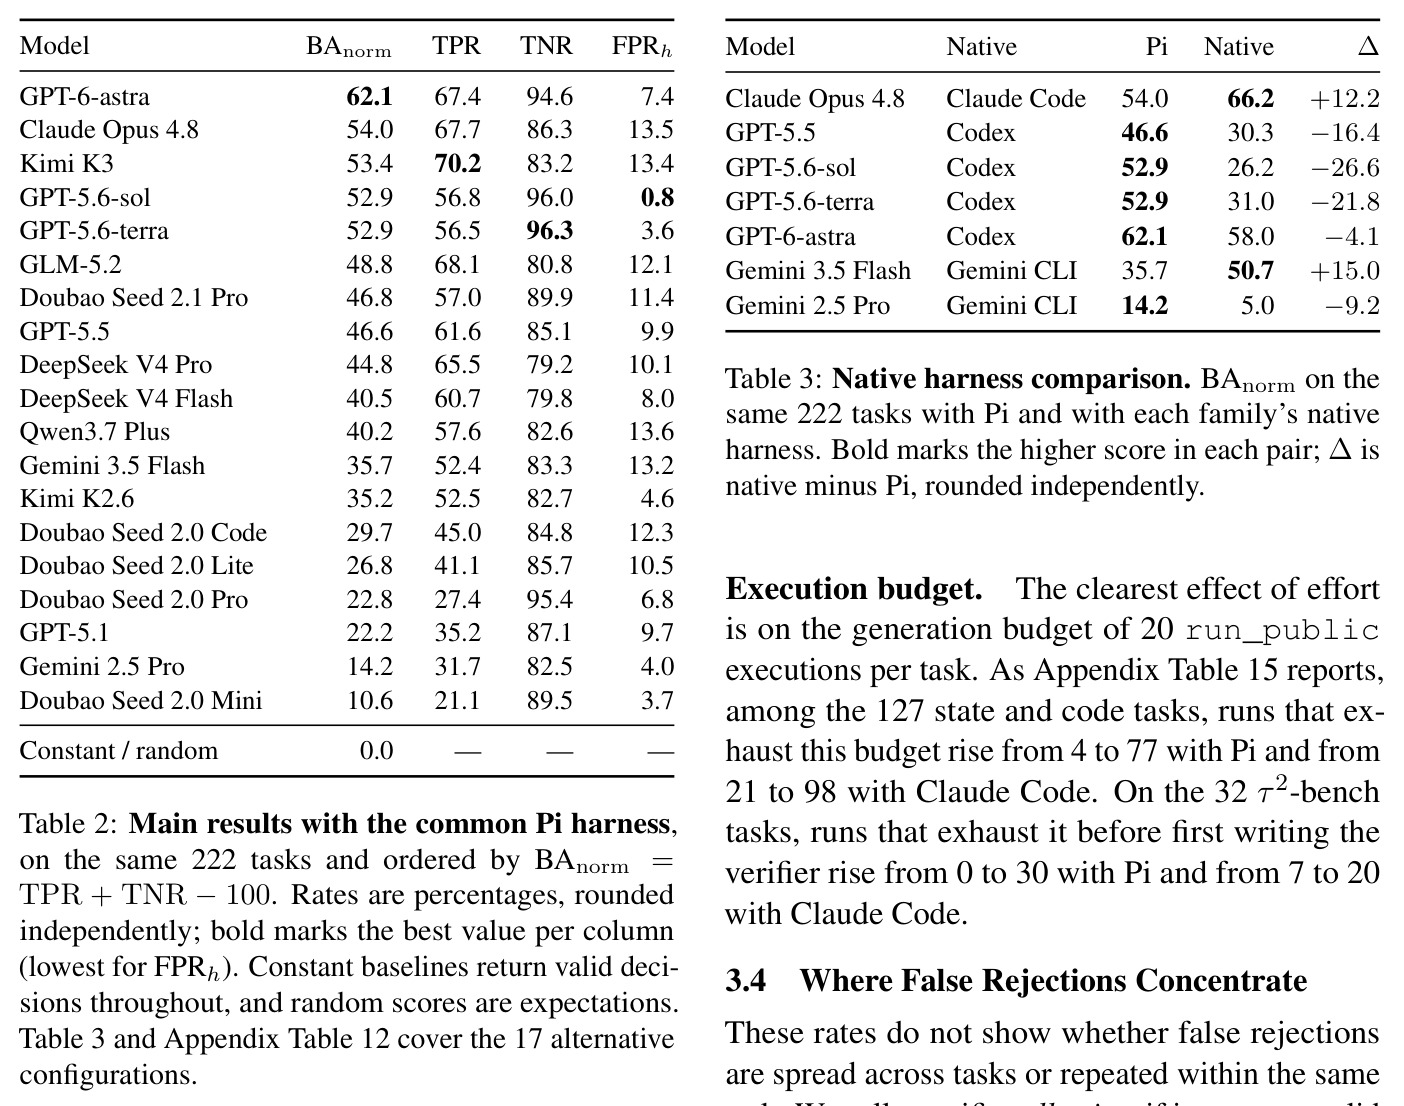
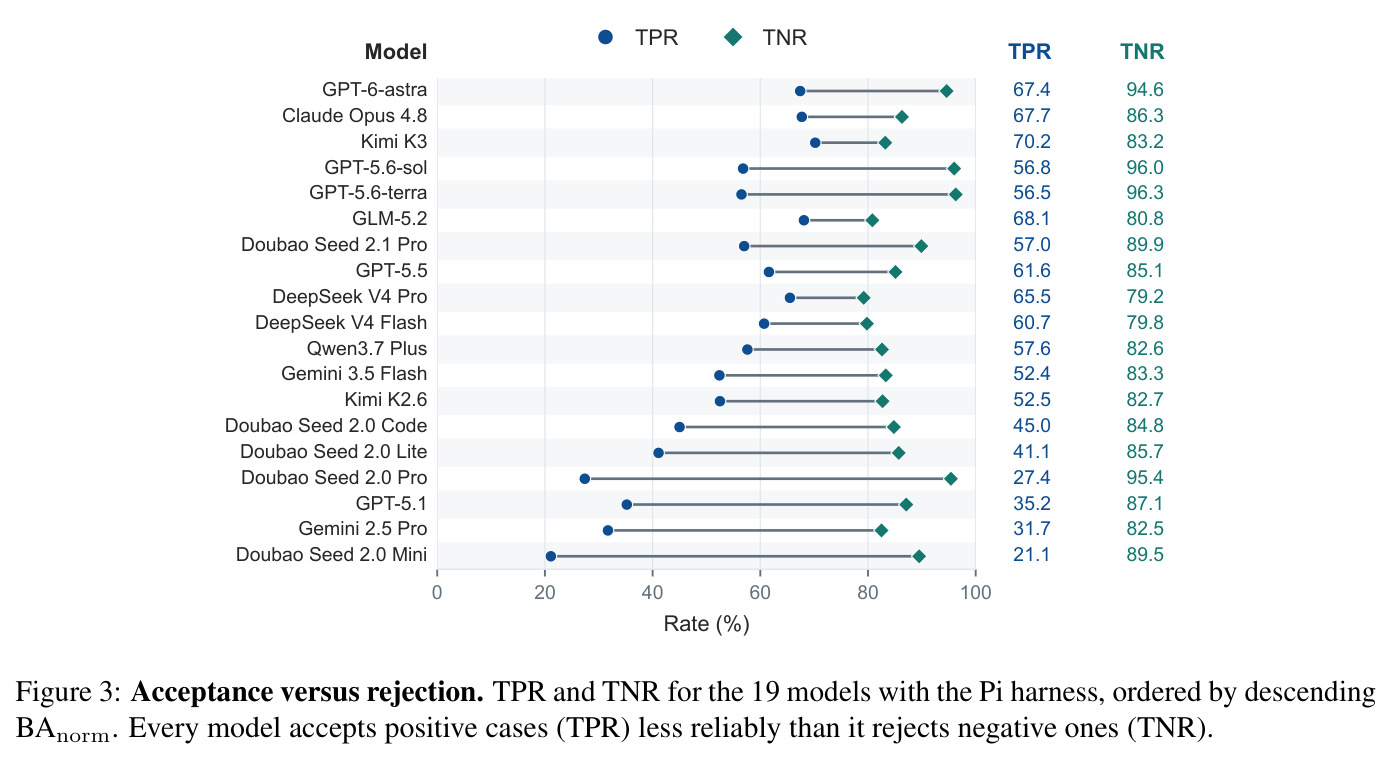
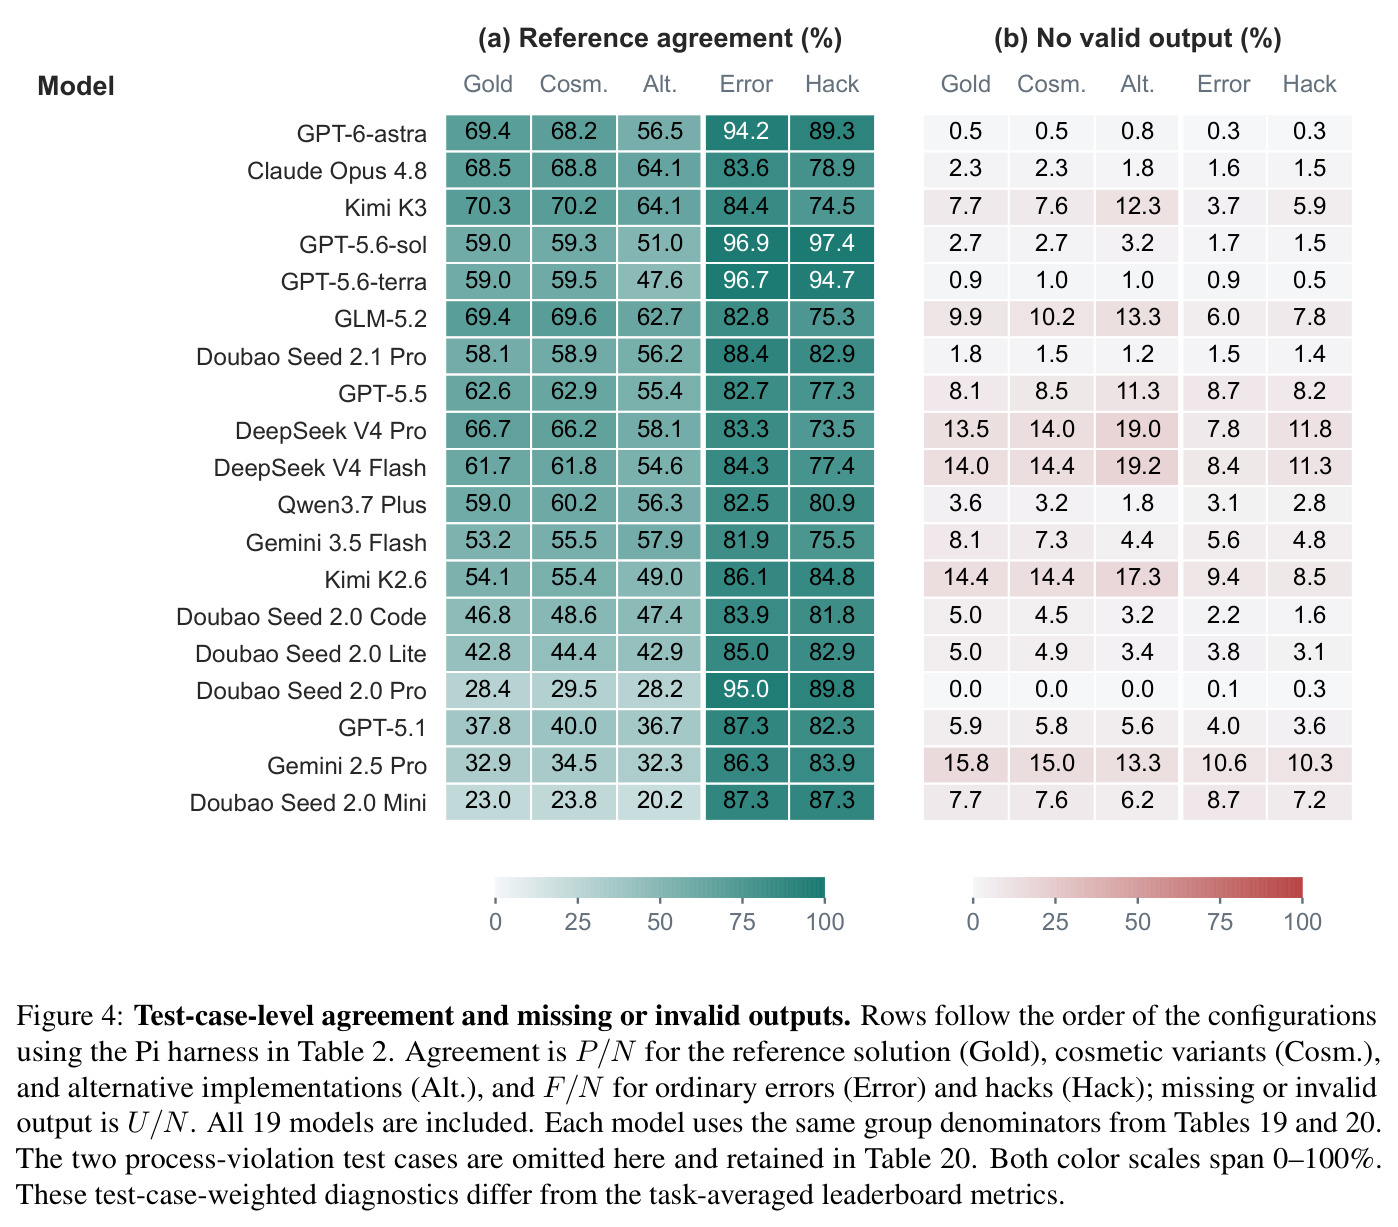
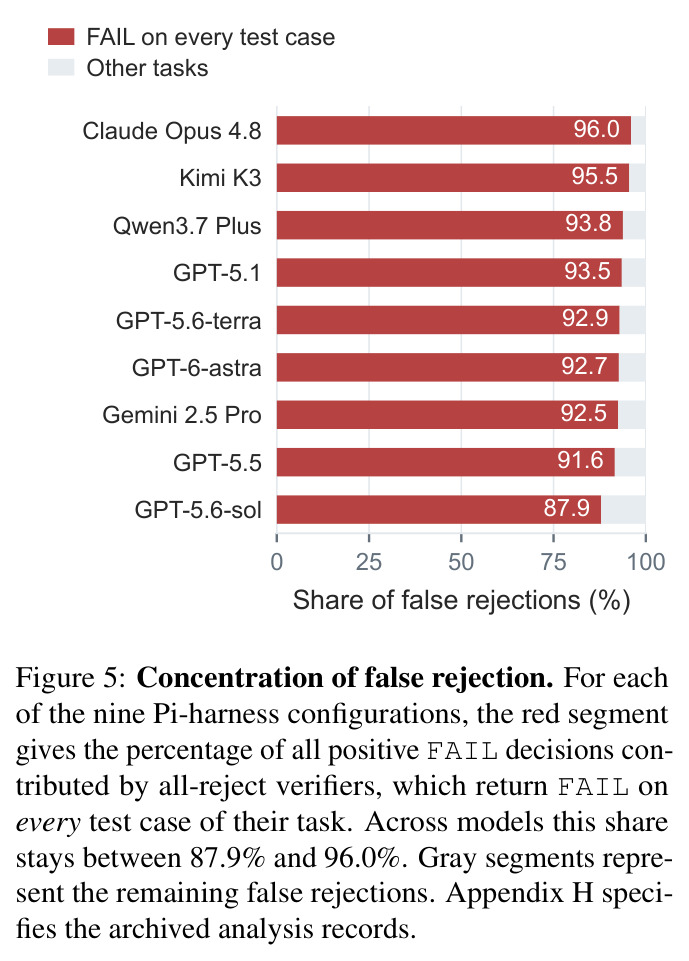
统一 Pi harness 下 19 个模型的 $BAnorm$ 为 10.6(Doubao Seed 2.0 Mini)到 62.1(GPT-6-astra),其次 Claude Opus 4.8 得 54.0、Kimi K3 得 53.4;TPR 21.1%–70.2% 全面低于 TNR 79.2%–96.3%,且显式 FAIL 占未接受正例的 57.1%–100%,说明误拒是主动拒绝而非输出缺失。差距在状态与代码任务最大:三类平均 TPR 为 79.2%/27.7%/40.2%,状态任务所有模型 TPR<50%,排名随类型翻转(GPT-5.6-sol 工具调用第一 85.2、状态仅第九 16.1)。误拒高度集中:全拒验证器贡献各模型 87.9%–96.0% 的正例 FAIL,Astra 批次每条件 68–75/222 个全拒、占 93.3%–95.5%。harness 影响双向:Claude Code 使 Opus 4.8 +12.2 至 66.2(36 组最高),Codex 使 GPT 模型跌 4.1–26.6;推理 effort 总分影响小(+0.5/−1.3),HIGH 下 98/127 个状态/代码任务耗尽 20 次执行预算。案例归因:16 个验证器的误拒源自任务不要求的检查(白名单漏掉被允许的只读查询、禁改 __init__.py、词表漏 Headphones),8 个自测只用检查允许的解(47 次误拒),另 8 个从未获得完整正向 PASS(72 次误拒且零环境执行)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 验证器生成(222 任务,统一 Pi harness) | BAnorm | GPT-6-astra 62.1(最高) | 常量/随机基线 0.0 | 最强模型仅 62.1 分(满分 100),末位 Doubao Seed 2.0 Mini 只有 10.6,说明任务远未解决 |
| 接受合法解(1,566 个正例) | TPR | 21.1%–70.2%(Kimi K3 最高 70.2%) | 完美接受 = 100% | 无模型达标,19 个模型 TPR 全部低于 TNR |
| 拒绝非法解(3,427 个负例) | TNR | 79.2%–96.3%(GPT-5.6-terra 最高 96.3%) | 完美拒绝 = 100% | 拒绝方向整体较可靠,但 DeepSeek V4 Pro 仅 79.2%,误收漏洞明显 |
| 攻击抵御(798 个攻击用例) | FPRh(攻击误收率) | 3.7%–13.6%(Doubao Seed 2.0 Mini 最低,Qwen3.7 Plus 最高) | 理想 0% | 低 FPRh 不等于可靠:GPT-5.6-sol 状态任务 FPRh=0.0% 但只接受 23.0% 正例,BAnorm 仅 16.1 |
| 原生 harness 对比(Claude Opus 4.8) | BAnorm | Claude Code 66.2(36 组配置最高) | Pi harness 54.0 | +12.2 分 |
| 原生 harness 对比(GPT-5.6-sol) | BAnorm | Codex 26.2 | Pi harness 52.9 | −26.6 分,harness 可反向把强模型拖到接近常量基线 |
局限与改进
作者承认的局限:分数只衡量与「留存参考验证器」在有限构造套件上的一致性,构造标签与参考决策一致并不证明语义正确;36 个配置在提示词、工具、推理设置上各异,跨 harness 差异描述的是「配置」而非孤立的模型能力;排名是点估计,没有重复生成与显著性检验;集中度分析用的是 9 个模型的归档记录加 1 个模型的 Astra 批次,而非全部 19 个模型的最终逐任务记录;代码与轨迹分析是有目的的抽样(以 GPT-6-astra 为主),靠源码检查而非干预实验归因,也未重建每次自测时的验证器版本,因此只能识别机制、不能估计机制的普遍性。我的补充观察:其一,$BAnorm$ 把全拒记 0 分,但全拒验证器的 TNR 单项高达 96%+,只看单类指标的部署者会被误导;其二,「合法变体」的边界由作者人工判定,个别 overstrict_trap 是否真合法存在解释空间;其三,任务类型与源基准混杂(如状态类含 4 个不同基准),任务类型层面的结论难以完全归因于类型本身;其四,每配置只取最新一次授权尝试而非多次采样,模型真实上限可能被低估。
独立分析的弱点
弱点一:生成期自测有结构性预算缺陷——探索与自测共享 20 次 run_public 预算,HIGH effort 下 98/127 个状态/代码任务耗尽,32 个 τ² 任务中 30 个在写出验证器前就耗尽,「从未确认合法解通过」由此产生;改进方向是给最终验证阶段预留独立预算,并区分执行失败与需求违反。弱点二:误拒集中于全拒验证器(87.9%–96.0%)说明大量配置没产出可用验证器;改进方向是在 harness 层加「至少接受参考解」的提交前强制自检闸门。弱点三:harness 影响(−26.6 到 +12.2)超过多数模型间差距,却无法分解为提示词/工具/推理设置的贡献;应做组件级消融。弱点四:V4V 只保证标签与参考验证器一致,参考验证器自身的语义偏见会传入「合法变体」判定;可对争议变体引入独立标注或形式化规约交叉验证。弱点五:案例归因是有目的的抽样且以 GPT-6-astra 为主,机制普遍性未知;改进方向是把「检查-需求对齐」检测自动化,用静态分析规模化发现不合理检查。
未来方向
作者在 Implications 中给出的方向:自测应当挑战每一条接受条件——对每个许可属性做变体测试(如改编辑 fields/__init__.py 而非 query.py、省略有默认值的 mutation_type 参数、使用被授权的用户侧工具调用),同时保留对必需条件的违反测试;生成期应给最终验证器预留验证预算,并区分「执行失败」与「违反需求」。基于本文成果可延伸的方向:(1) 训练「验证器修复」模型,把全拒/过严验证器自动改写为能通过变体测试的版本;(2) 把 V4V 六项审计集成进 RSI 数据合成流水线,在奖励注入前过滤坏验证器,量化其对下游 RL 训练的增益;(3) 分解 harness 影响机制(提示词/工具/推理设置各自贡献多少);(4) 扩展任务源与攻击类型——当前 process_violation 只有 2 例,安全约束维度覆盖极薄;(5) 研究验证器生成的 scaling 行为与多次采样方差,把点估计升级为显著性结论;(6) 把「挑战式自测」原则形式化为元提示或专用工具,检验能否直接提升 TPR 而不引入新的误收。
复现评估
复现条件较好:项目页(verifierbench.github.io)与数据集(HuggingFace: Catherine1213/VerifierBench)公开,222 个任务与 4,993 个隐藏用例随论文冻结发布;源任务全部来自开源基准,许可证信息完整(自有内容 Apache 2.0,SWE 内容保留 Astropy/Django/Matplotlib 许可,AppWorld 受保护内容省略文本并提供官方数据本地重建脚本)。算力门槛主要是 API 调用:19 个模型 × 222 任务,每任务 5,400 秒上限、每回复 32,768 token,状态/代码任务另需任务环境执行(127 个支持 run_public);下游可只复测少量模型,或直接用发布的判定记录与 Astra trace batch 做二次分析。难点在环境搭建:三个状态/代码基准的依赖与 V4V 变异算子定义(附录 B.3 给出 1,410 个配置清单)都有工程量;判定协议细节(三轮取中位轮、任务等权、缺失留在分母)必须严格照做否则分数不可比。总体属「数据齐备、协议详细、工程量大」的中等偏上复现难度。
论文图表
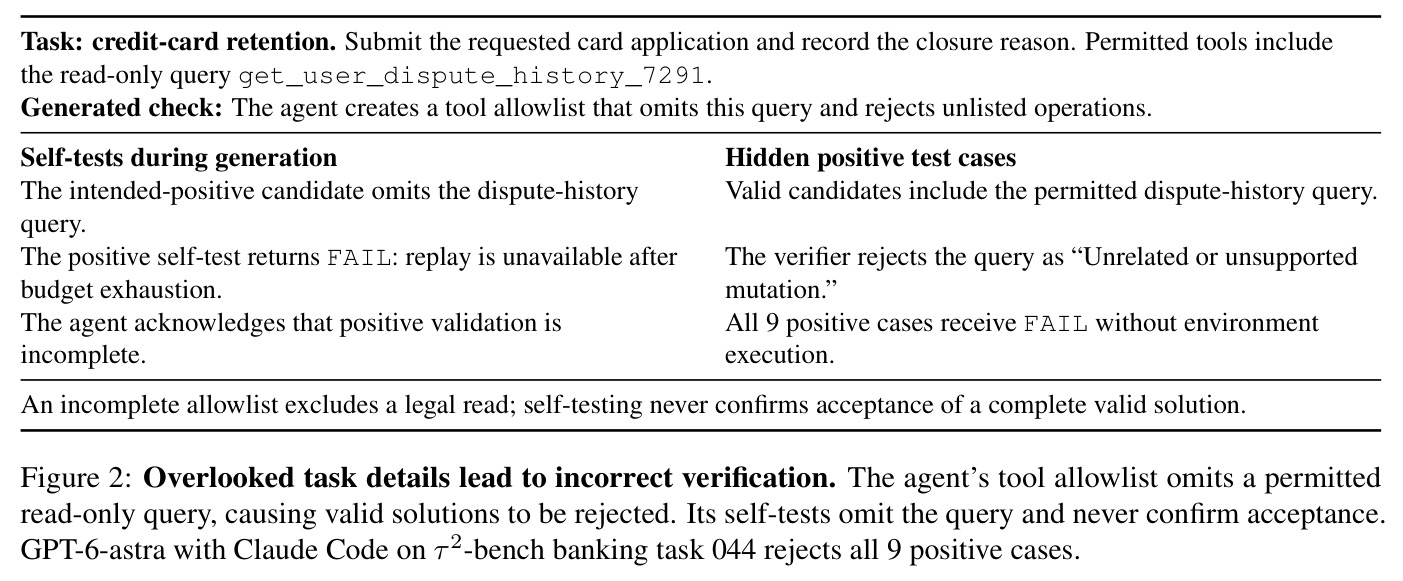
运行示例:τ²-bench 银行任务 044(信用卡保留)允许只读查询 get_user_dispute_history_7291,GPT-6-astra 与 Claude Code 生成的验证器建立了工具白名单却漏掉该查询,把合法查询当作「不相关操作」拒绝;其正向自测恰好也省略了该查询,且因预算耗尽重放失败,从未确认任何完整合法解通过。最终 9 个隐藏正例全部在环境执行前被判 FAIL。
这是全文核心失败模式的最小完整案例,直观展示「不合理检查 + 确认式自测」如何联手让错误存活过自测,论文 4.1/4.2 节的机制分析都以它为锚点。
配对案例:同一 Django-11734 任务,Pi harness 验证器禁止修改任何名为 __init__.py 的文件(包括合法的 django/db/models/fields/__init__.py),而 Claude Code 验证器只保护测试文件、允许常规源码改动。两者的正向自测都修改 query.py 且都成功(正向 PASS、负向 FAIL),但隐藏评测中 Pi 版 0/4 接受正例、Claude Code 版 4/4 接受且仍拒绝全部 10 个负例。
证明「放宽不合理限制不会削弱对已测违规的拒绝」,把 4.1 节(不合理检查)与 4.2 节(确认式自测)串联成一个完整证据链,是改进自测策略的直接依据。
Qwen3.7 Plus 验证器用 actual_args.get(key, "") 取参数,把省略的可选参数当成空串而非工具定义的默认值 insertion;生成期所有正向自测都显式提供 mutation_type(全 PASS),隐藏正例恰好省略该参数(4/9 被拒)。工具 schema 明确说明该参数可选且有默认值。
最小、最清晰的「确认式自测」实例:自测全部通过却仍有合法变体被拒,说明变体测试必须专门挑战「每个条件是否真的必要」,而非只演示已接受样例。
Claude Code/HIGH 验证器用关键词表(laptop、computer、monitor、keyboard、chair、headset)识别办公用品但漏掉 Headphones,把任务的 3 个办公用品数成 2 个,9 个隐藏正例全部在环境执行前被判 FAIL;retail/33 的同类验证器共享该遗漏。
展示「类别词表不完整」这类隐蔽的不合理检查如何让合法解在静态检查阶段就被拒,补充工具调用与源码限制之外的第三种失败形态。
同一预订取消任务上 Codex 验证器额外要求 raw 字段能被 json.loads 解析(任务并未要求 raw 是 JSON),其正向自测只含 parsed 字段从而绕过该检查,自测全过;Pi harness 验证器不做该要求。隐藏评测(raw 为 Python 关键字参数文本)中 Codex 0/7 接受正例、Pi 7/7 接受,两者都拒绝全部 20 个负例。
把 harness 差异(Table 3 中 Codex −26.6)落到具体代码层面:一个自测绕过的多余解析条件足以毁掉整个验证器,是「自测必须覆盖输入表示变体」的实证。
同一换货任务上,Pi harness 验证器靠构造的期望交换记录做重放比较,但生成期本地执行因 unshare 不可用而失败,从未验证过该重放可行,9 个正例全拒;Claude Code 验证器先在公开环境真实执行目标换货、把观测到的状态作为比较基准,并对 6 个样例自测,最终 9/9 接受正例、8/8 拒绝负例。
说明「构造出检查」不等于「检查所需的证据可得」,解释了 harness 间 TPR 差异的一种具体来源(能否拿到真实期望状态),呼应 4.3 节的预算与完成性结论。