持续学习考试:评测LLM智能体长程递归自我改进与经验学习的基准 Continual Learning Exam: Benchmarking Long-Horizon RSI and Experiential Learning in LLM Agents
五级职业任务阶梯基准:最强智能体仅通过47.7%关卡,反馈修正中位增益5.3pp
前置知识
持续学习(Continual Learning)
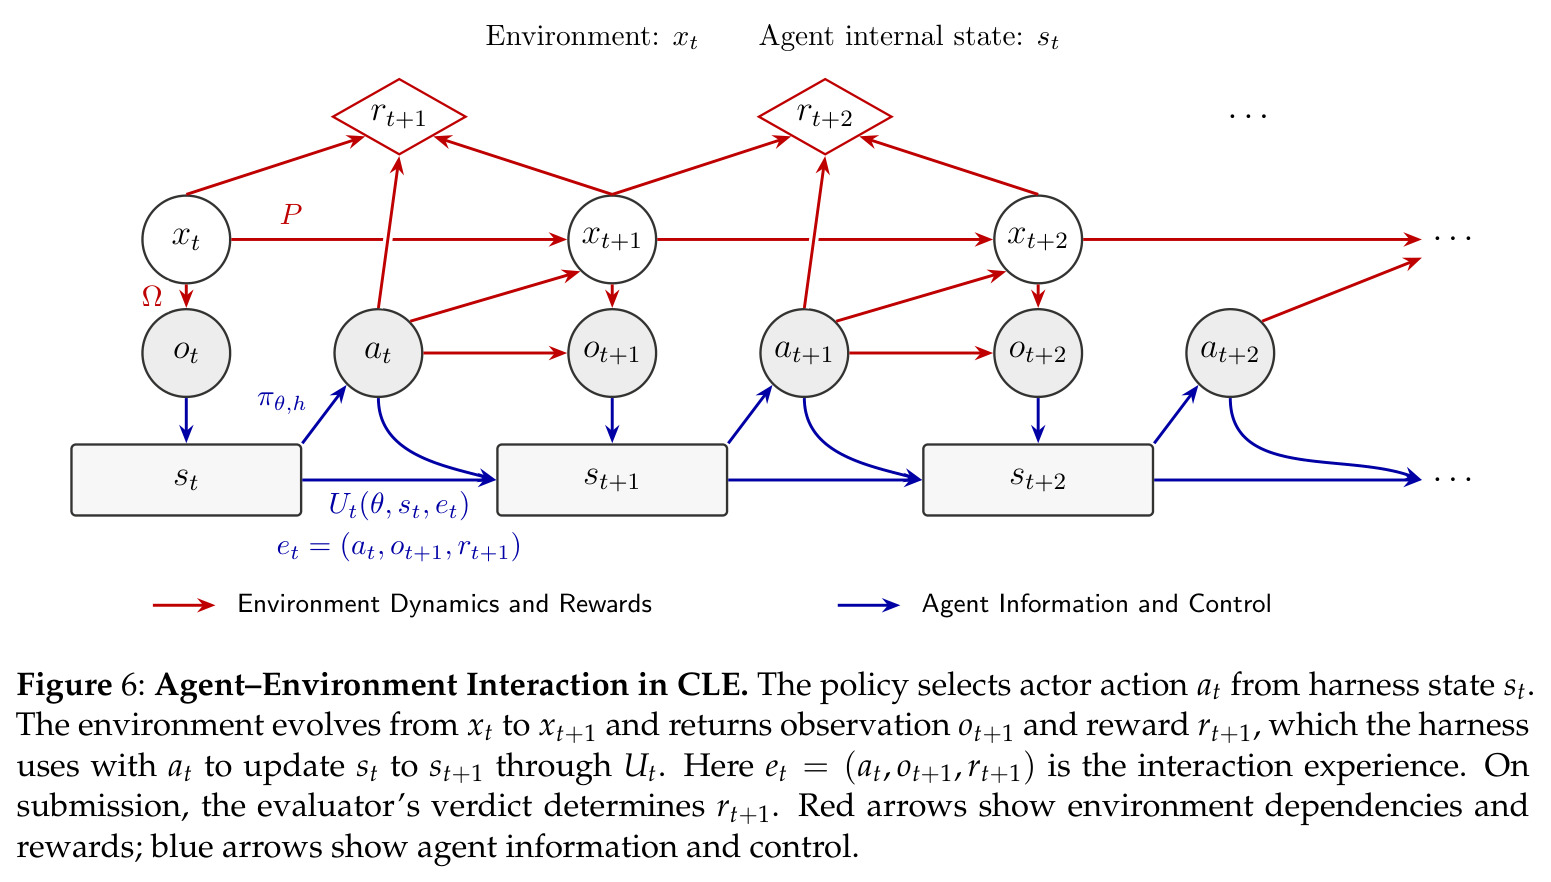
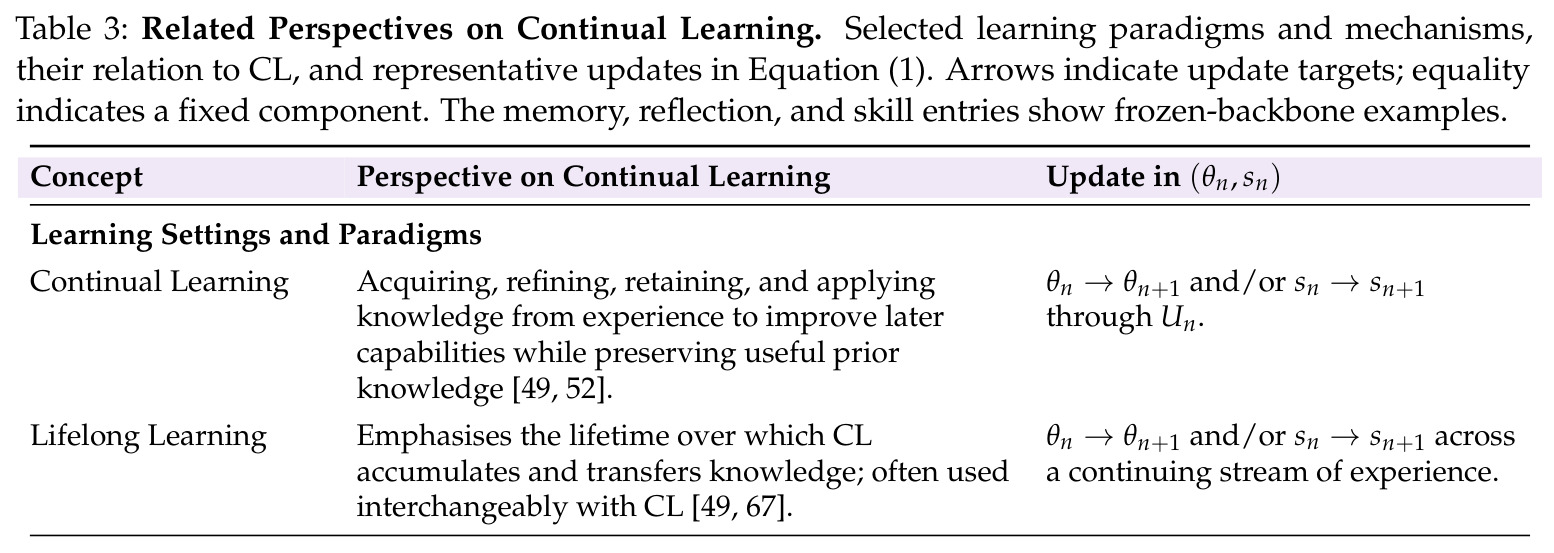
指智能体在长时间跨度内通过获取、精炼和应用经验不断改进,同时保留有用既有知识的能力。经典神经网络持续学习关心灾难性遗忘(新学习覆盖旧知识),本文将其形式化为更新算子 $\mathcal{U}_n$ 用经验 $e_n$ 把学习者从 $(\theta_n, s_n)$ 更新到 $(\theta_{n+1}, s_{n+1})$,其中 $\theta$ 是模型参数、$s$ 是参数之外的持久状态(记忆、技能等)。1989年的灾难性干扰研究、2016–2017年的蒸馏/正则化/回放/架构扩展、近年的参数高效微调都可用这一算子统一描述。
CLE整篇论文的定义、能力层级与实验设计都建立在这个形式化上;不理解 $\mathcal{U}_n$ 与 $\theta/s$ 的区分,就无法理解它测的到底是什么。
智能体框架(Harness)与非参数学习
Harness是包裹骨干LLM的外层系统,负责构建模型上下文、执行动作、管理跨任务保留的记忆与技能。冻结模型参数时,学习只发生在 $s_n$ 上,即 $\mathcal{U}_n(\theta_n, s_n, e_n) = (\theta_n, s_{n+1})$:通过留存和精炼记忆、技能等非参数知识实现改进。Claude Code、Codex等产品的memory/skill机制就是典型的harness层学习——模型权重不变,但系统随使用越来越懂你的工作流。
CLE主实验冻结全部backbone参数,17个配置的性能差异全部来自harness层经验学习,这是解读实验结果的钥匙。
递归自我改进(RSI)
指保留下来的改动不仅积累任务知识,还改进了'后续改进如何产生、评估与执行'的过程本身:$s_{n+1}$ 中修订过的学习或验证程序会改变有效的 $\mathcal{U}_{n+1}$。与之对照,在线学习(时序设定)、测试时训练TTT(优化机制)、基于案例推理CBR(案例检索-改编-留存循环)都可以在固定学习程序下运作——只积累任务知识并不构成RSI。这几个概念可以组合出现在同一个智能体中。
论文标题把CLE定位为长程RSI与经验学习的基准,第2.3节专门辨析了'积累任务知识'与'改进学习过程'这两个层次,不懂RSI定义就读不懂标题。
POMDP(部分可观测马尔可夫决策过程)
序贯决策的数学模型 $\mathcal{M}_A = \langle \mathcal{X}, \mathcal{A}, \mathcal{O}, \mathcal{P}, \Omega, \mathcal{R} \rangle$:环境状态 $x_t$ 部分隐藏(CLE中评分细则与参考材料不可见),智能体通过动作 $a_t$ 与观测 $o_t$ 交互,转移核 $\mathcal{P}$ 与观测核 $\Omega$ 描述演化,奖励函数 $\mathcal{R}$ 给出标量信号。CLE中提交动作的奖励就是评审判定 $v_t \in \{0,1\}$,其他动作奖励为0,评测目标是最大化期望累计奖励 $J(\theta,h) = \mathbb{E}[\sum_{t=0}^{T-1} r_{t+1}]$,即期望通关数。
论文第3.3节用POMDP严格定义了CLE的评测协议与目标函数,这是理解'完成率为什么就等于总回报'的基础。
Rubric评分与LLM评审智能体
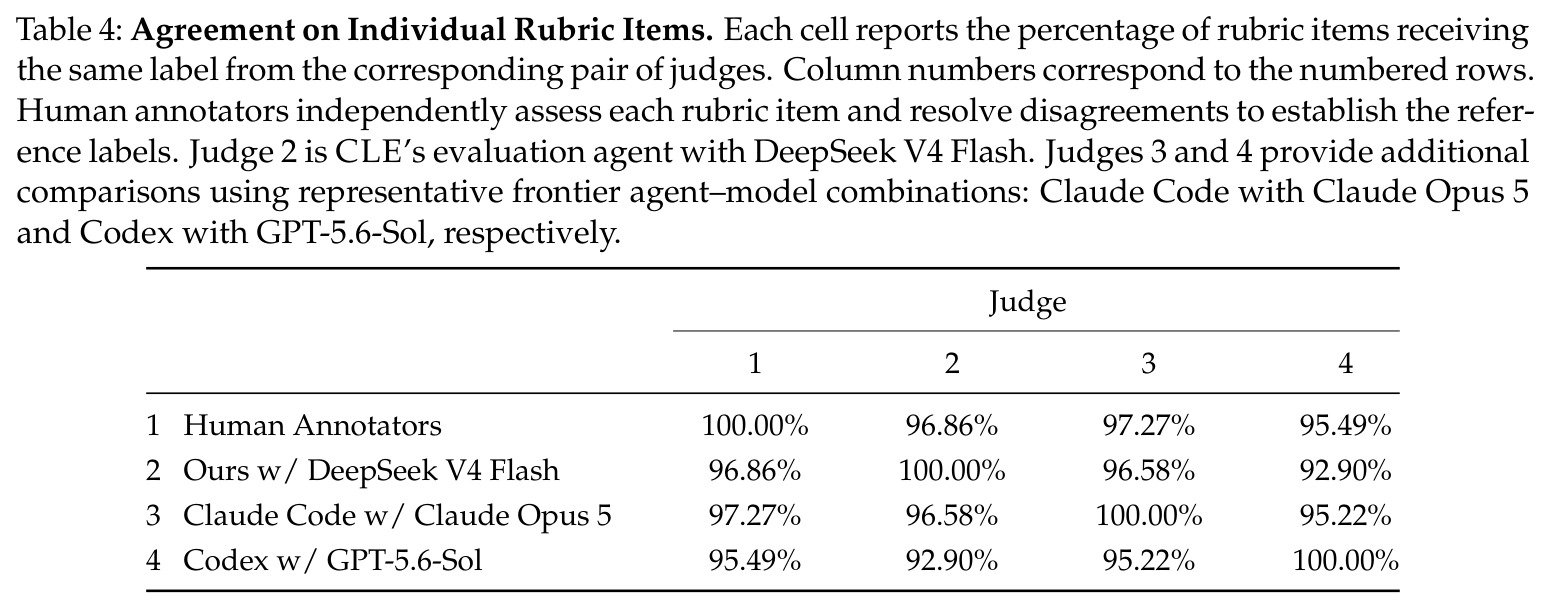
Rubric是把'什么算做对了'拆解成大量可独立判定checklist条目的人工评分细则,每条指定明确的预期结果与验证所需证据。CLE用带工具的多轮评审智能体在隔离Docker容器中,从提交物与权威应用状态快照中提取证据、逐条核验,全部条目通过才算过关;评审者只做证据核查而非自己解题生成参考答案,条目级与人类评审一致率达96.86%。
CLE结论的可信度完全建立在'人工细则+证据核查'的评分体系上,这是它与自由发挥式LLM裁判基准的本质区别。
研究动机
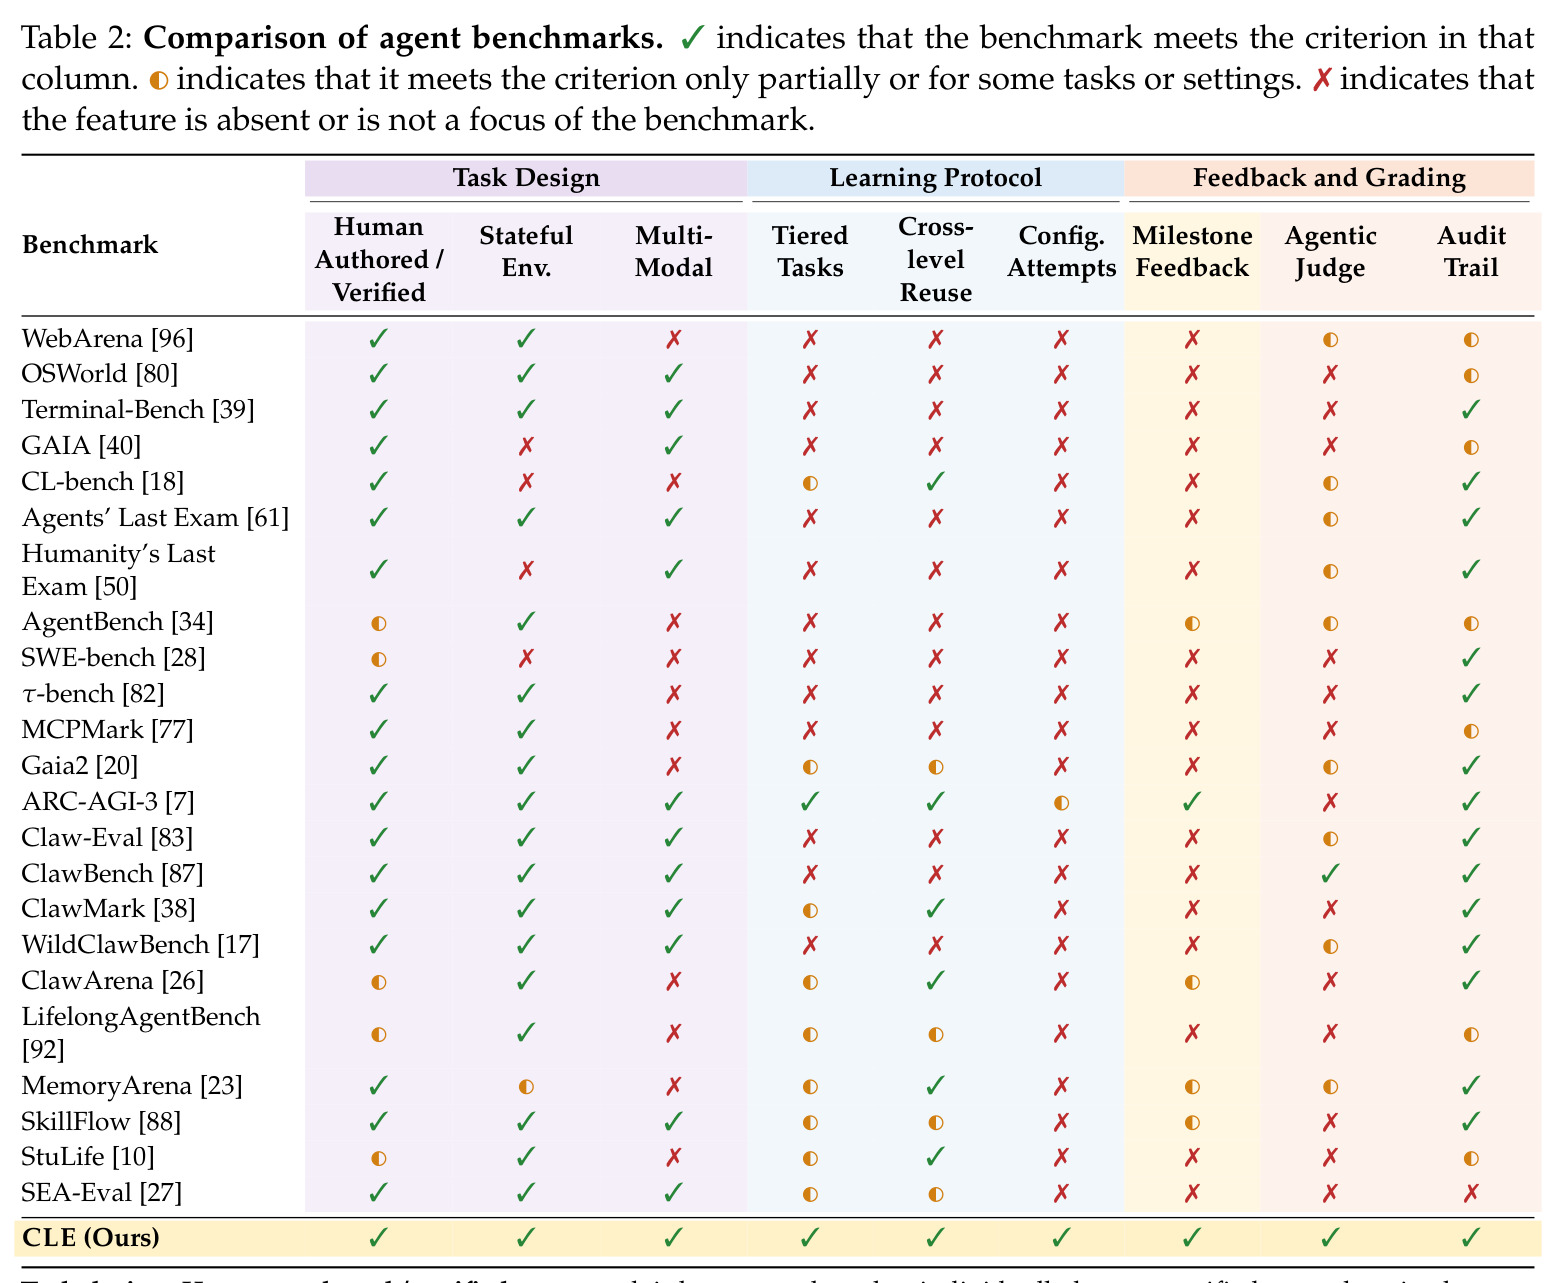
现有智能体评测几乎都只度量'单任务表现'而非'通过积累经验获得的改进'。通用能力基准(如GAIA)把任务独立呈现、独立打分,分数反映的是解题能力;记忆类基准(如LoCoMo)只测对历史交互的检索与问答,不检验记住的信息是否转化为后续任务执行力的提升;面向自动化助理的WildClawBench、ClawMark等基准虽有持久状态和长工具链轨迹,但持久状态本身不构成经验复用的压力——智能体完全可以每个任务都从零开始。真实职业工作恰恰相反:一位CPU验证工程师周一分析过上游RISC-V核心的bug修复清单,周三做安全签核时理应直接复用周一的结论和踩过的坑。论文要回答的具体问题是:当前最强的LLM智能体(GPT-5.6系列、Claude Opus 5、Gemini 3.7、DeepSeek V4 Pro等)在模型参数完全冻结、只靠harness保留经验的条件下,能否在跨越多关的真实职业任务流中,把前面积累的知识、教训、用户偏好迁移到后面的工作中?现有任何一个基准都无法直接测量这一点。
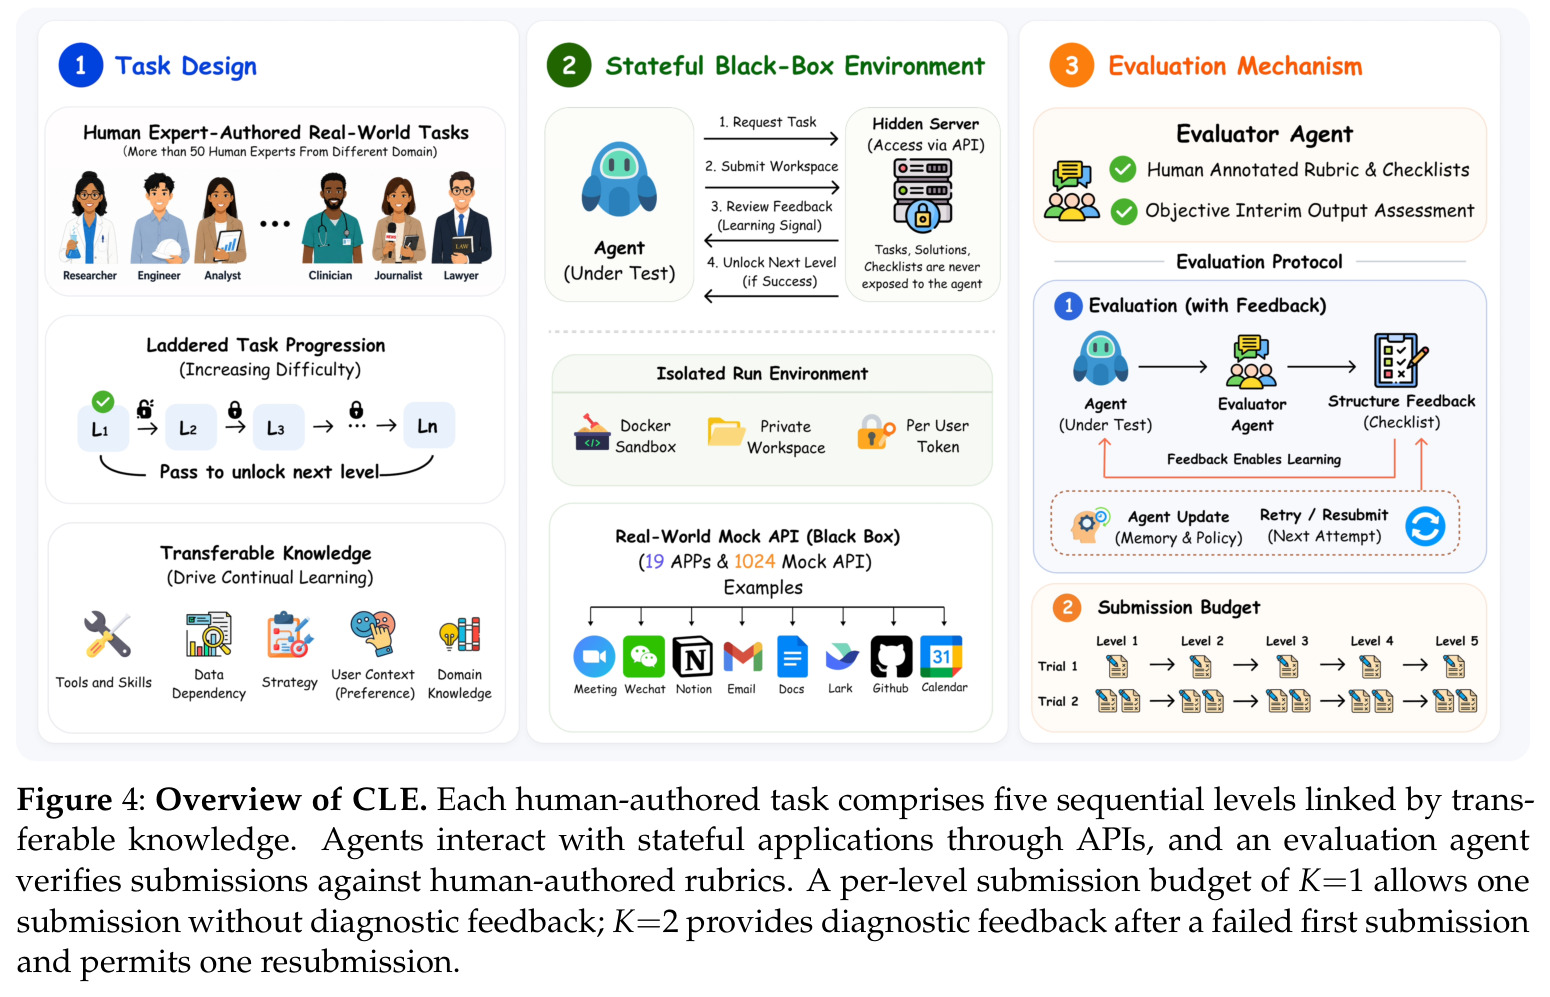
本文的目标是本文的目标是构建一个能直接测量'经验驱动改进'的大规模基准CLE(Continual Learning Exam),由50多位行业专家(各学科博士研究员、软硬件工程师、会计师、金融与运营分析师等)参与建设。具体包括四个方面:一是内容覆盖真实职业场景——120个人工撰写并人工验证的任务,覆盖12个职业领域的89个角色,每个任务组织成五级阶梯,共600个关卡;二是环境足够真实——配套23,981个真实输入文件(含77种扩展名,保留重复记录、矛盾信息等真实噪声)、19个暴露1,024个API的有状态模拟应用,且同一任务阶梯内共享应用数据库,前面关卡造成的记录变更在后面关卡仍然可见;三是评判可审计——16,125条人工撰写的评分细则(平均每关26.9条、每任务134.4条),由评审智能体逐条做证据核查;四是协议可配置——每关提交预算K=1(无反馈单次提交)与K=2(首次失败返回诊断反馈并允许修改重交一次)两个对照设置,量化'反馈+修正'的收益,并把'通关数'直接作为衡量持续学习能力的标量指标。
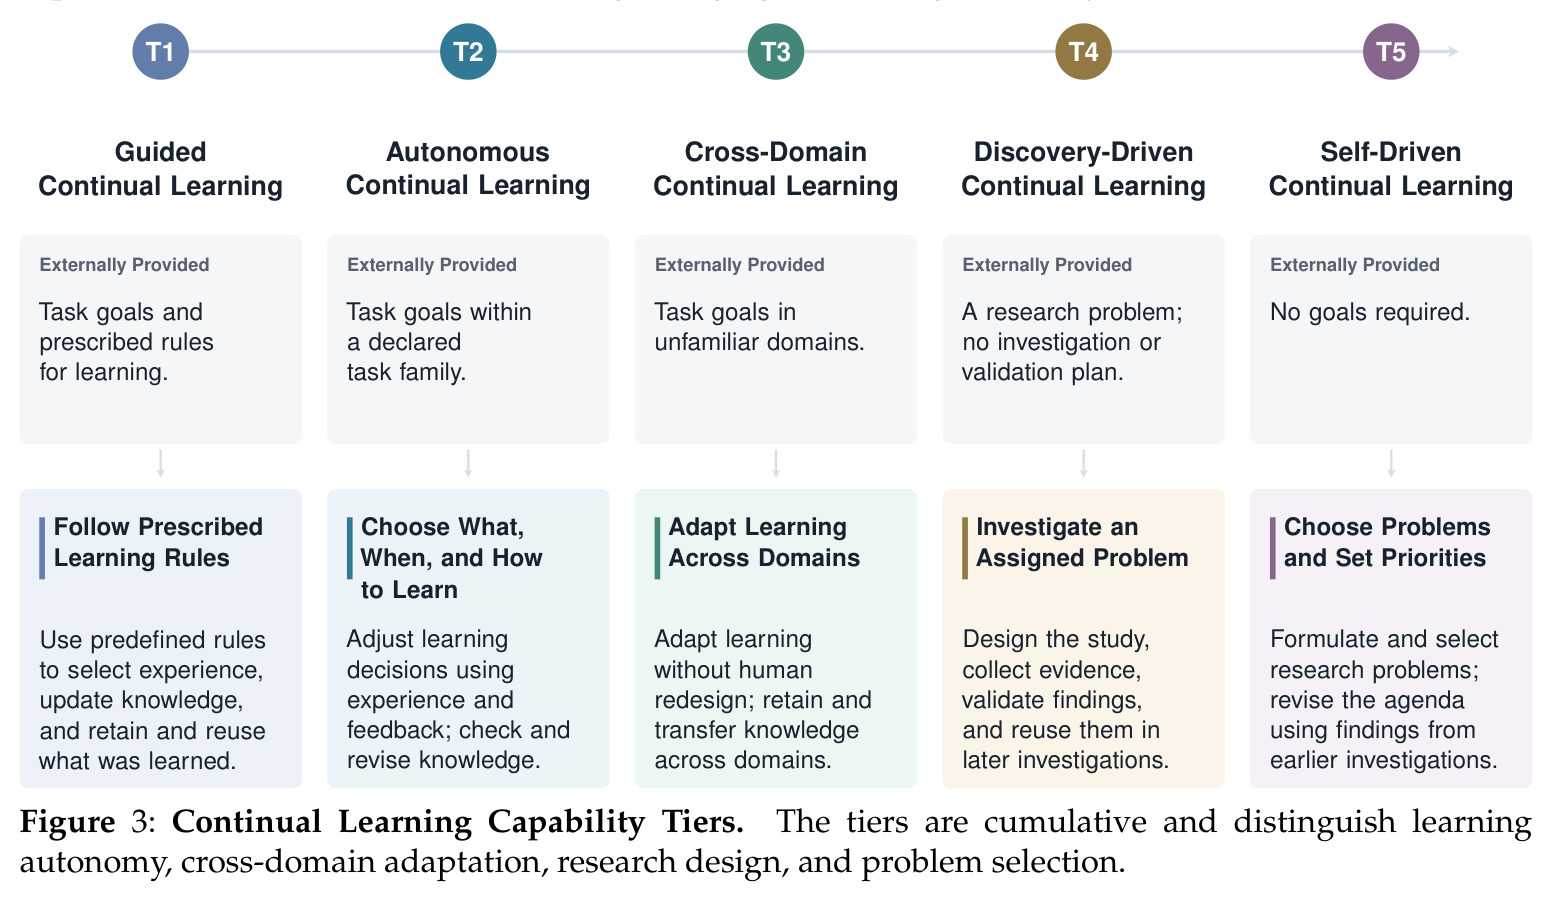
与已有工作不同的是,独特切入角度有三点。第一,形式化上的统一:论文用一个更新算子把参数化学习(SFT/RL更新 $\theta_n$)与非参数化学习(harness更新 $s_n$)纳入同一框架 $(\theta_{n+1}, s_{n+1}) = \mathcal{U}_n(\theta_n, s_n, e_n)$;CLE主实验冻结 $\theta$、只演化 $s$,从而精确隔离'harness层经验学习'——这正是Claude Code、Codex等产品中memory/skill工作流真正在做的部分。第二,结构上的强制复用:五级阶梯不是五个独立任务,而是通过五类可迁移知识(工具与技能、数据依赖、策略、用户上下文、领域知识)显式缝合,且门控解锁——不过当前关就进不了下一关,依赖还可跨越相邻层级,使经验复用成为通关的必要条件而非可选项。第三,理论上提出T1–T5五层能力层级(受规则引导→自主决策→跨领域→自主研究→自主选题),把CLE定位在T1–T2评测基础之上,并严格区分了'积累任务知识'与RSI意义上的'改进学习过程本身'($s_{n+1}$ 改变有效的 $\mathcal{U}_{n+1}$),这是其他经验类基准(SkillFlow、MemoryArena、StuLife等)都没有给出的概念坐标系。
核心方法
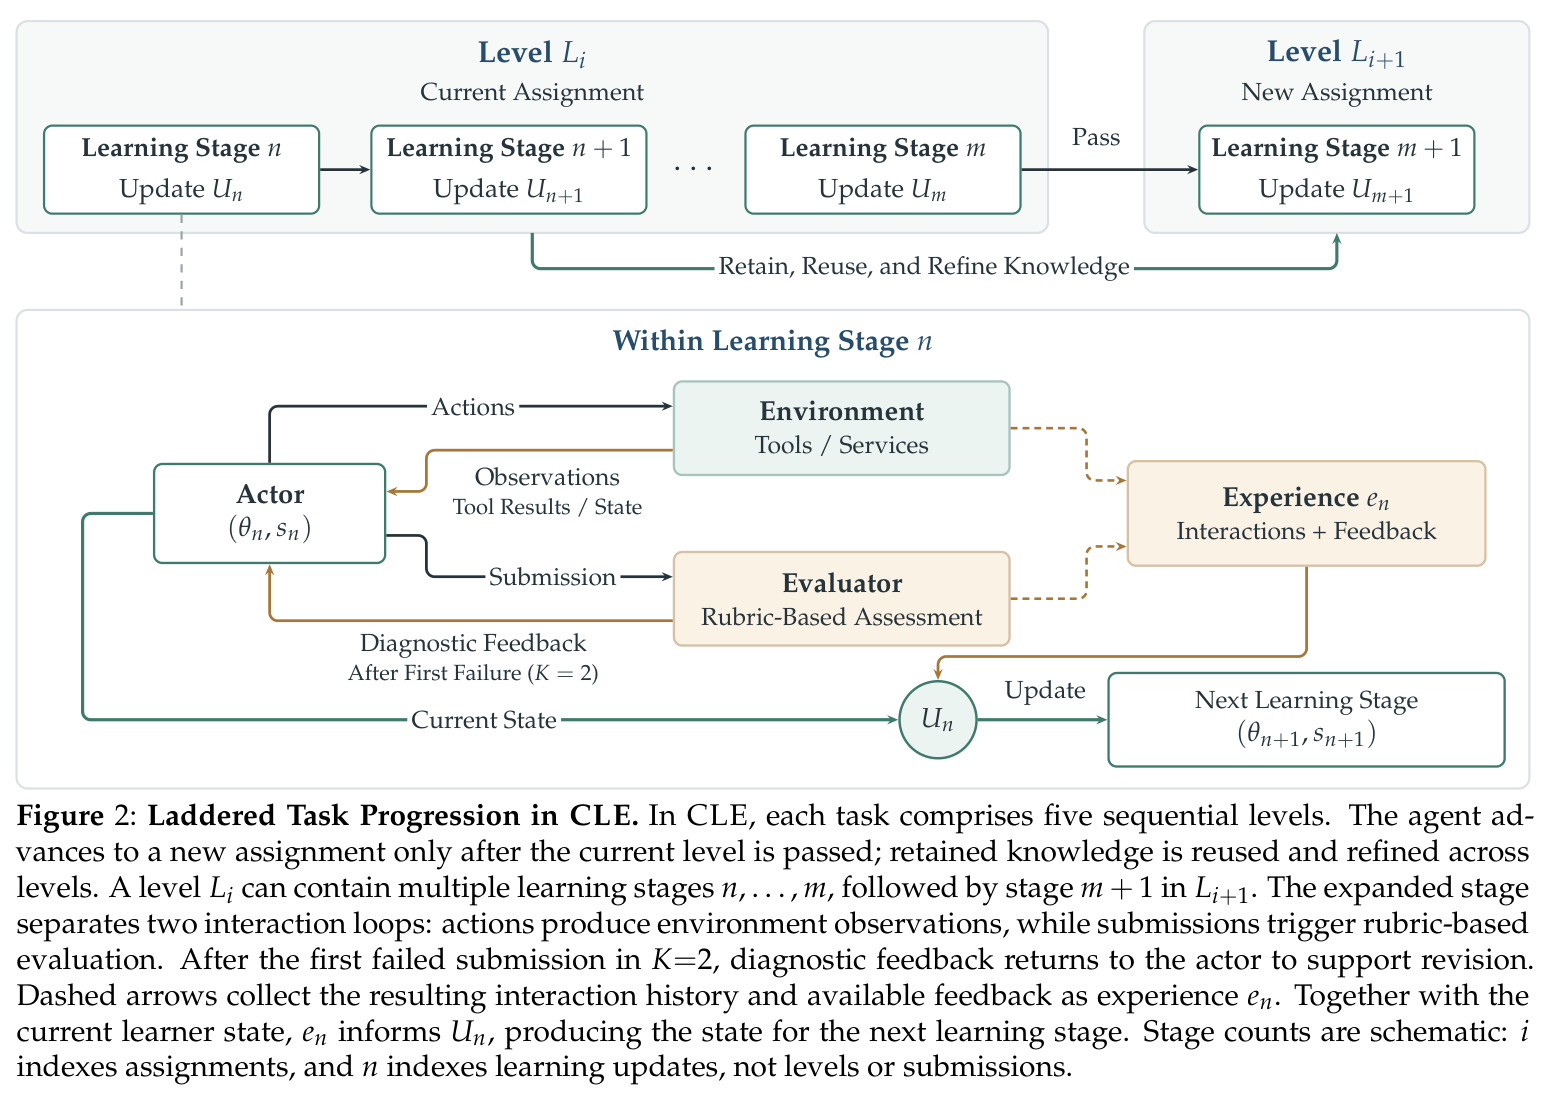
直觉上,CLE像一场游戏化的职业考试:每个任务是一个职业角色的一段真实工作,五个关卡是从易到难的五份作业,后一份作业必须用到前面积累的信息、产出和教训,不过关不解锁下一关。技术路线上,论文把它建模为POMDP $\mathcal{M}_A = \langle \mathcal{X}, \mathcal{A}, \mathcal{O}, \mathcal{P}, \Omega, \mathcal{R} \rangle$:被测智能体(backbone LLM + harness)通过统一的benchmark API读取任务与输入文件、调用19个有状态mock应用、提交交付物;提交动作触发评审智能体在隔离Docker容器中对照16,125条人工细则核验提交物与环境状态快照,返回判定 $v_t \in \{0,1\}$;通过关卡的提交给奖励1,其他动作奖励0。评测目标 $J(\theta,h)=\mathbb{E}[\sum_{t=0}^{T-1} r_{t+1}]$ 就是期望通关总数,完成率=通过关卡数/600。整个评测是120个阶梯按固定顺序的串行流,模型参数冻结,harness的持久状态(记忆、技能等)跨任务保留;harness通过更新算子用交互经验 $e_t=(a_t, o_{t+1}, r_{t+1})$ 更新自身状态。block形式 $B=(j,k,m)$ 还支持从任意关卡开始的定制评测(人工准备前序产物),使基准可用于片段化评估、重复训练等多种用途。
核心创新是与已有基准在'测什么'上的本质区别。已有基准:GAIA等测孤立解题,LoCoMo等测记忆检索问答,WildClawBench等测有状态执行——经验复用都不是通关的必要条件。CLE的关键设计是'门控阶梯+跨级依赖':不过 $L_\ell$ 就进不了 $L_{\ell+1}$,而后面关卡的交付物往往直接依赖前面(甚至非相邻)关卡的产出。以Ibex RISC-V核心维护任务为例:L3回补丁要复用L1得出的'哪个修复缺少旧核心所需信号'的结论并加以适配,还要重跑L2的全部测试用例;L5客户勘误要在更老的核心上重跑L2与L4的测试。第二个创新是把'学习'本身做成可配置协议:K=1与K=2两组完整运行,把'诊断反馈+一次重交'的增益变成干净的对照指标(17个配置中位+5.33pp);且反馈只暴露细则类别、隐藏具体条目与参考答案,逼智能体自己调查修正。第三个创新是冻结 $\theta$、只更新 $s$:分数差异全部归因于harness保留与复用经验的能力而非微调。第四是数据与判卷的对抗性设计:评审智能体按人工细则做证据核查而非独立解题生成答案,评测文件对被测者完全不可见,从机制上杜绝泄漏。
方法步骤详情
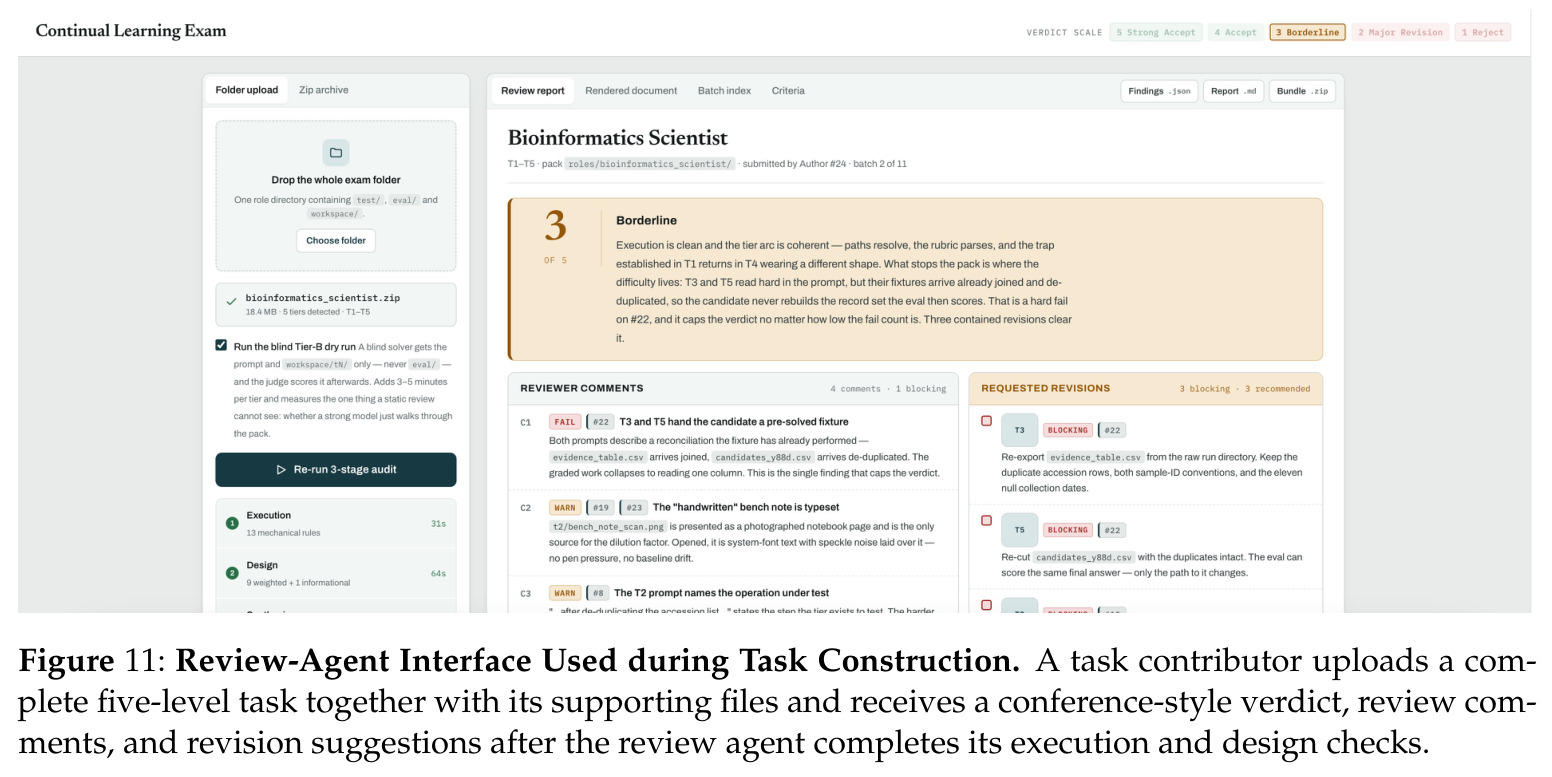
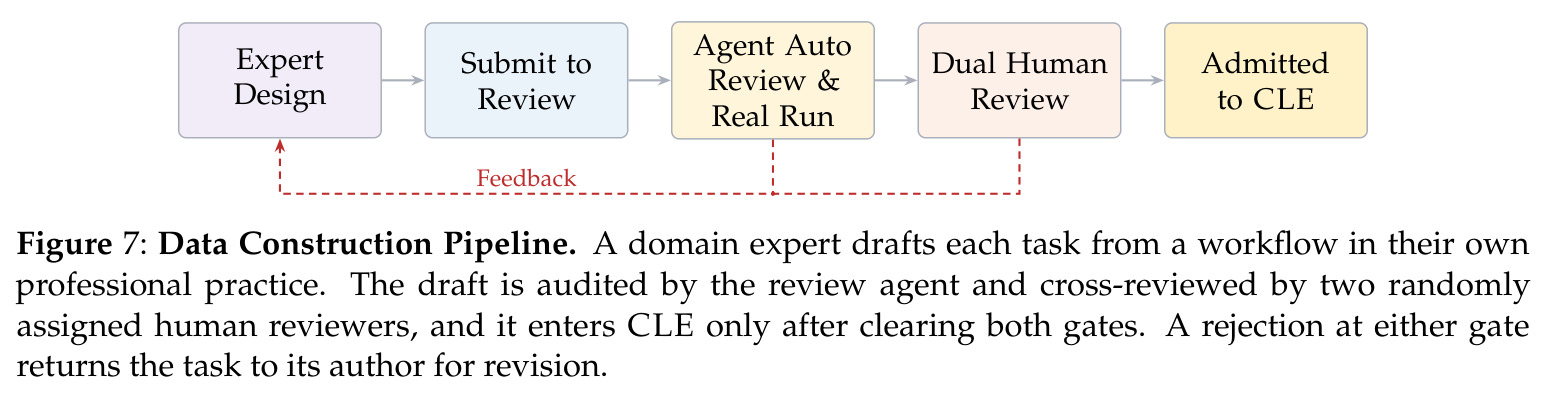
方法流程分四步。第一步,任务生产与双重质检:领域专家从自己的职业工作出发起草五级任务,定义角色、上下文、真实输入文件、交付物与每关的checklist细则;评审智能体依据人工多轮迭代的review skill做自动审查——检查格式合规、输入文件真实性、答案泄漏、细则可验证性、持续学习设计五项,还会切换成actor身份用与被测者相同的接口端到端真实跑一遍任务,验证任务确实非平凡且难度递进,并给出Strong Accept/Accept/Borderline/Major Revision/Reject五档会议式意见;达到Accept以上的任务再交由两位随机抽取的人类评审独立复审,双双接受才收录,任一环节拒绝都退回作者修改,最终120个任务全部通过这道双重闸门。第二步,环境初始化:每个任务加载指定的workspace文件和19个有状态应用(1,024个API)的独立数据库;全量评测按固定顺序串行执行120个阶梯,跨任务保留harness状态。第三步,智能体执行:被测配置(4个harness × 11个backbone,共17个组合)每关最多K次提交(K=1或2);K=2下首次失败返回只含细则类别的诊断反馈,具体条目与参考答案隐藏;通过则解锁下一关并重置提交预算,预算耗尽则该block剩余关卡计为失败。第四步,评分与统计:评审智能体(以DeepSeek V4 Flash实例化)在隔离容器中对每条细则提取证据并判定,全部通过才算过关;报告总完成率、分级通过率 $L_1$ 至 $L_5$($L_k$ 为前k级全部通过的任务占比),以及token数、活跃时长、美元成本三轴资源消耗。
技术新颖性
技术新颖性体现在四个层面。形式化层面:用统一的更新算子 $(\theta_{n+1}, s_{n+1}) = \mathcal{U}_n(\theta_n, s_n, e_n)$ 贯穿1989年灾难性干扰、1990年代终身学习、2016–2017年蒸馏/正则/回放/扩容、参数高效微调,直到LLM智能体的记忆/反思/技能复用,并分别给出神经网络与LLM智能体两个版本的持续学习定义,这种统一视角在基准论文中少见。理论层面:提出T1–T5累积能力层级——按学习决策自主性、跨域适应、研究设计、问题选择递进划分,并指出当前Claude Cowork、Codex类产品处于T1(规则引导的学习工作流)、正在显现T2(自主决定学什么、何时学)特征,为领域进展提供了可度量的坐标系。机制层面:辨析了在线学习(时序设定)、TTT(优化机制)、CBR(案例复用循环)与RSI(改进学习过程),明确'固定学习程序下积累知识≠RSI',为标题中的长程RSI给出可操作的定义边界。工程层面:block形式化 $B=(j,k,m)$ 支持从任意关卡起评;评审智能体与被测者物理隔离、每次评分别的Docker容器、统一API凭据与请求日志支撑复现与审计——这套可审计的agentic grading基础设施本身也是贡献;数据侧的'专家起草→智能体评审→双重人类评审'流水线(含评审智能体以actor身份真实跑任务)则保证了600个关卡的质量与难度梯度。
实验结果
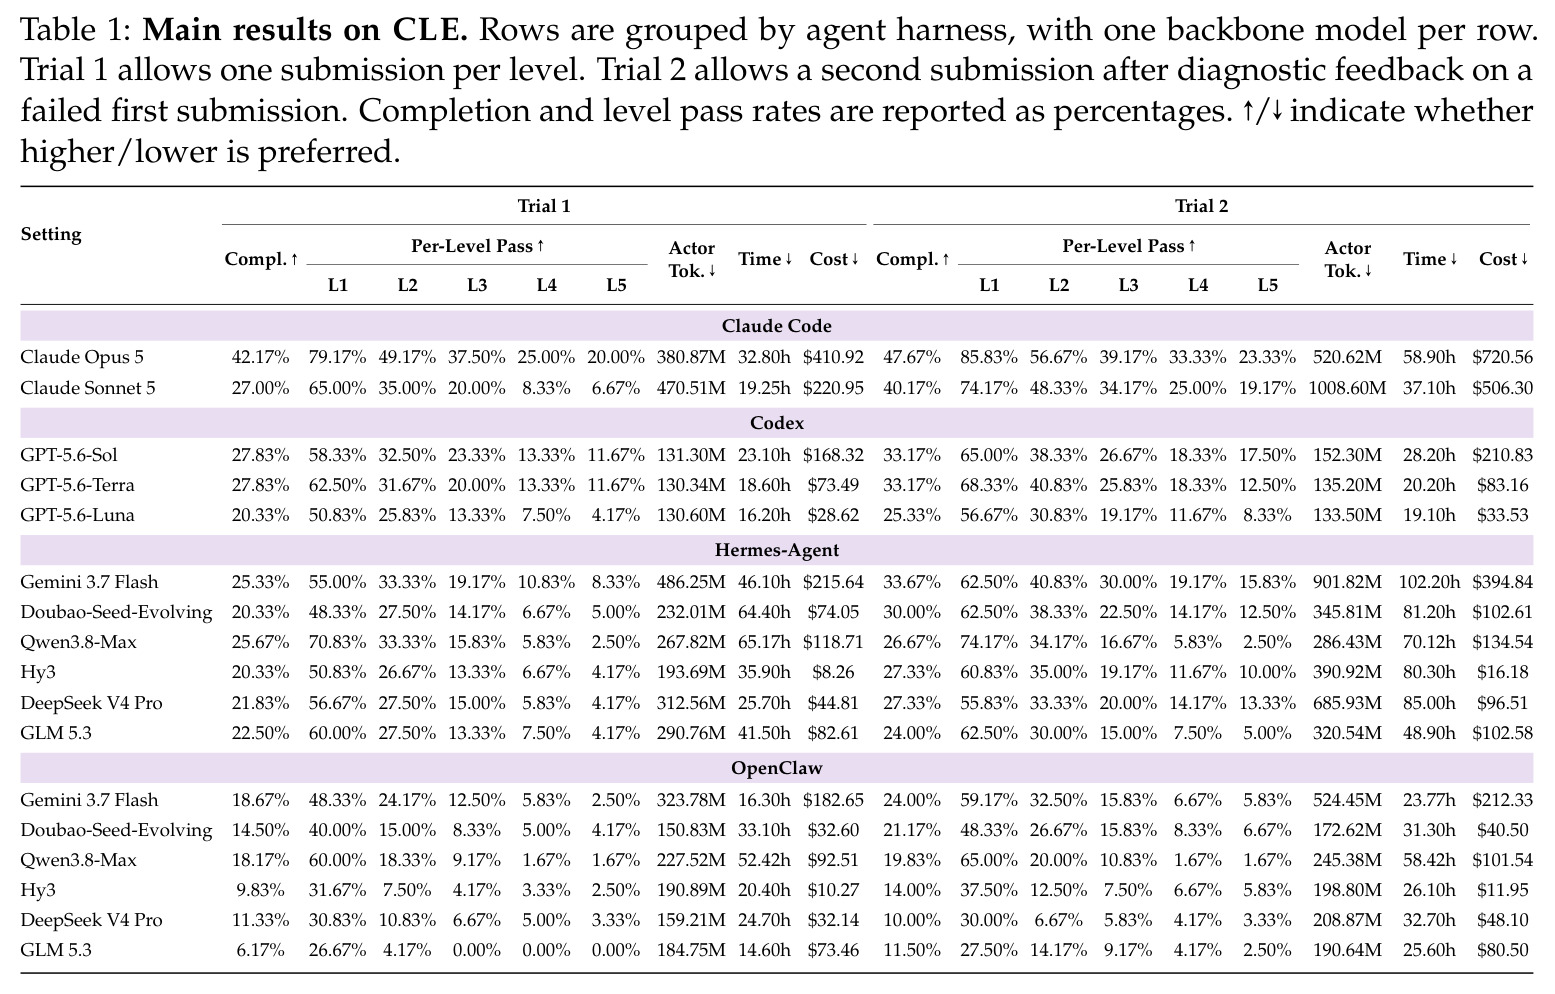
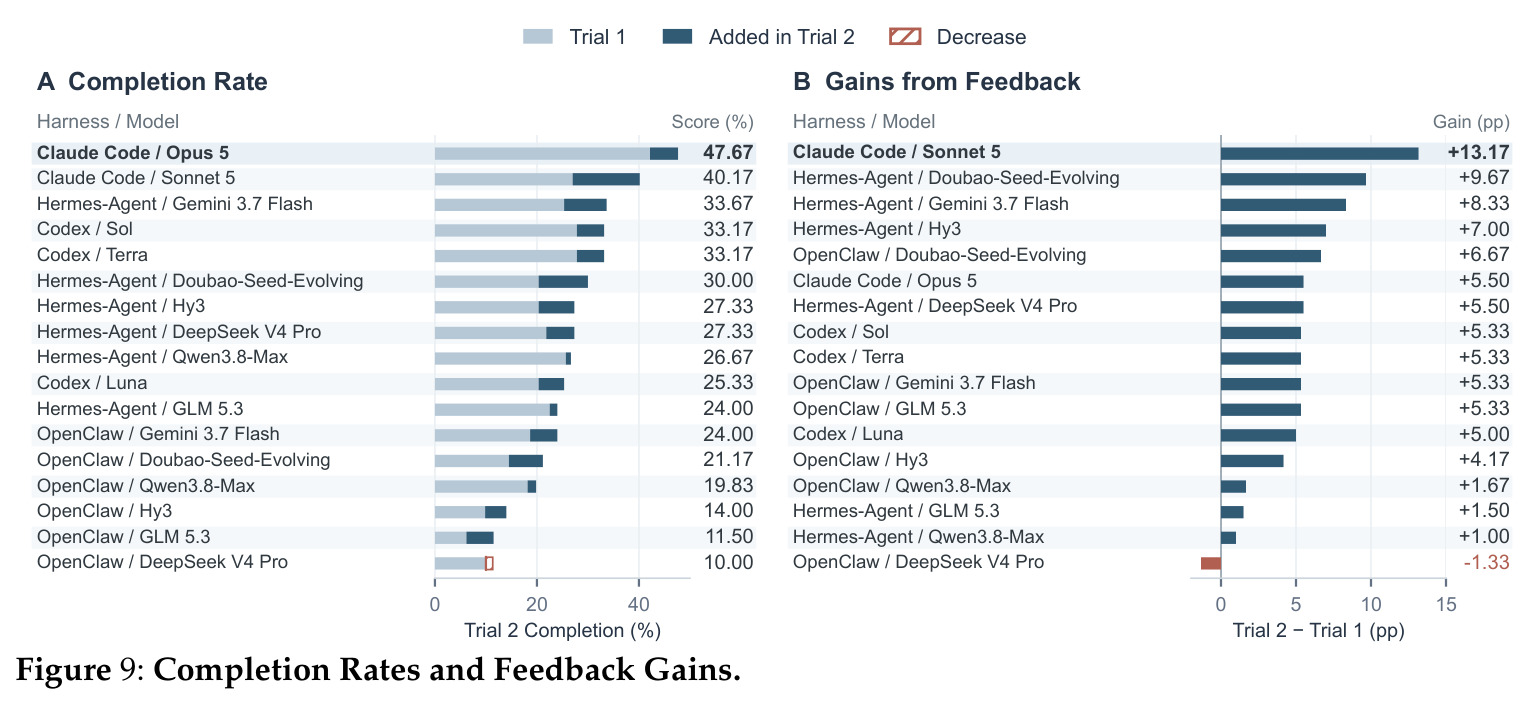
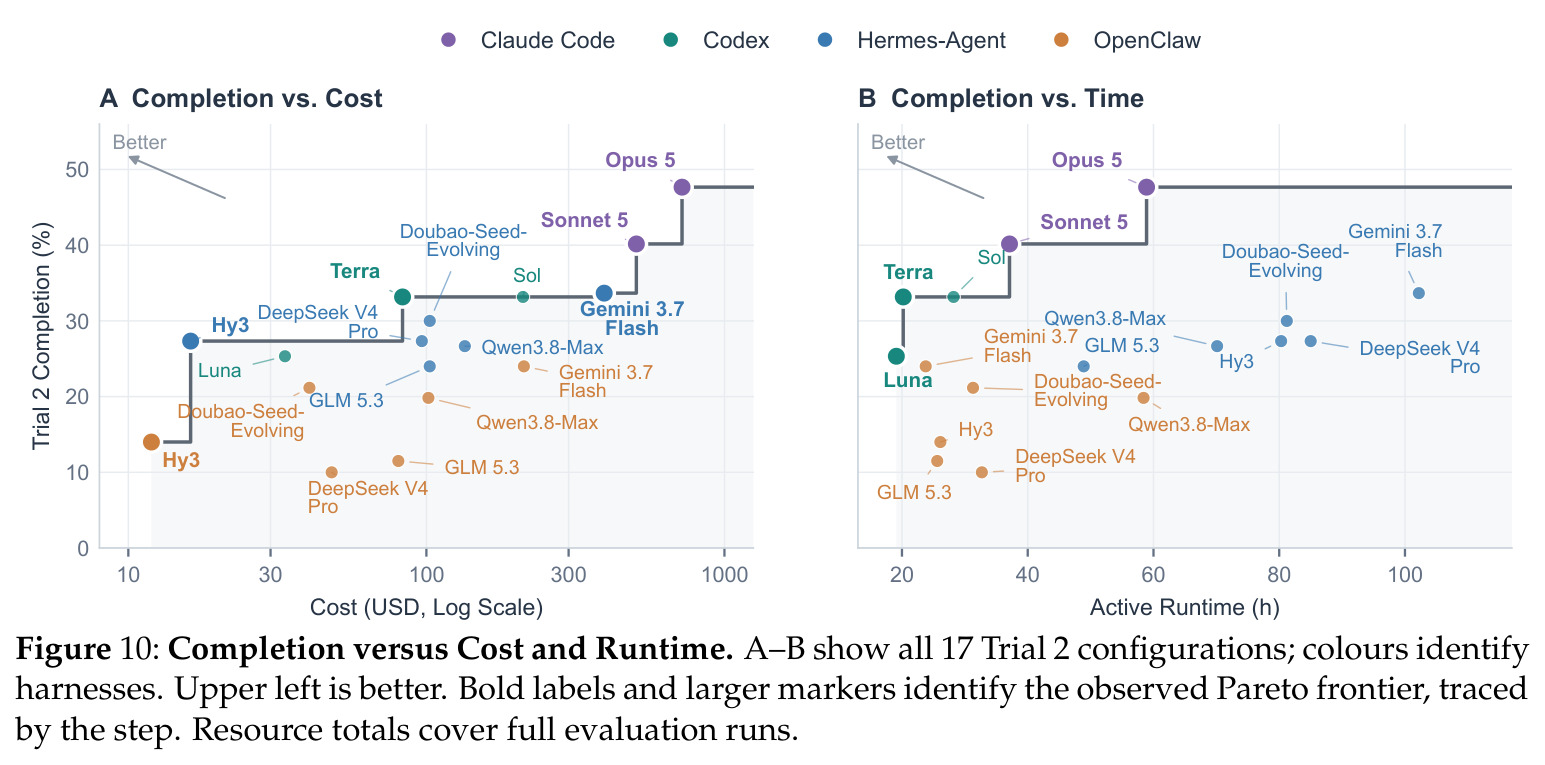
核心发现可按四条线梳理。总体难度:17个配置中最佳为Claude Code/Opus 5,Trial 1完成率42.17%、Trial 2达47.67%——即便有诊断反馈和一次重交,最强的系统也只通过不到一半关卡;它在Trial 2中于28/120个任务(23.33%)完成全部五级;GPT-5.6-Sol与GPT-5.6-Terra在Codex下均为33.17%。反馈收益:17个配置中16个在Trial 2提升,中位增益+5.33pp;最大的是Claude Code/Sonnet 5(+13.17pp,全过任务从8个增至23个),唯一的负增益是OpenClaw/DeepSeek V4 Pro(−1.33pp);且Trial 1成绩与Trial 2增益并不同向——Opus 5虽然基数最高却只+5.50pp。层级衰减:中位配置Trial 2的 $L_1$ 累计通过率62.50%,到 $L_5$ 只剩8.33%,说明需要长期积累的后期关卡远比第一关难;两个Qwen3.8-Max配置L1–L3有提升但L4–L5纹丝不动,说明反馈修正的收益未必延伸到依赖前期经验的关卡。harness与成本:在6个共享backbone上Hermes-Agent全面优于OpenClaw,平均优势从Trial 1的+9.56pp扩大到Trial 2的+11.42pp(28.17% vs 16.75%);Codex下Terra以$83.16/20.20小时达到与Sol($210.83/28.20小时)相同的33.17%,但Sol全过21个任务、Terra只有15个——相同完成率掩盖了完整任务数的差异;Hermes/Hy3在成本前沿(27.33%仅$16.18)却不在时间前沿(80.30小时)。评分可信度方面,评审智能体与人工裁定标签在细则条目级一致率达96.86%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全部600关卡通过(整体完成率,Trial 2) | 完成率 Compl. % | 47.67%(最佳配置 Claude Code / Opus 5) | 同配置 Trial 1(无反馈、单次提交):42.17%;其余配置最高 40.17%(Claude Code / Sonnet 5) | 相对自身 Trial 1 +5.50pp;但距饱和仍差 52.33pp,基准远未解决 |
| 诊断反馈+一次重交的增益(17个配置) | 完成率增量(百分点 pp) | 中位 +5.33pp,16/17 配置提升 | Trial 1(K=1,无诊断反馈) | 最大 +13.17pp(Claude Code/Sonnet 5);最小 −1.33pp(OpenClaw/DeepSeek V4 Pro,唯一负增益) |
| 全任务通关(五级全过) | 完整任务数 / 120 | 28 / 120(23.33%,Claude Code/Opus 5,Trial 2) | Trial 1 同配置:24 / 120(20.00%);中位配置 Trial 2 的 L5 通过率仅 8.33% | Trial 2 中位数配置的 L5 仍不足一成,长期积累式通关是最大瓶颈 |
| harness 对比(6个共享backbone) | 平均完成率 | Hermes-Agent:Trial 2 平均 28.17% | OpenClaw:Trial 2 平均 16.75% | 优势从 Trial 1 的 +9.56pp 扩大到 Trial 2 的 +11.42pp,harness 层经验管理差异被显著放大 |
| 成本效率(Trial 2) | 完成率 / 美元成本 | Codex / GPT-5.6-Terra:33.17% 完成率仅 $83.16(20.20h) | Codex / GPT-5.6-Sol:33.17% 完成率需 $210.83(28.20h) | 同等完成率成本降约60%,但 Sol 全过 21 个任务 vs Terra 15 个,需同时看完整任务数 |
| 自动评分可信度 | rubric条目级一致率 | 96.86%(评审智能体,DeepSeek V4 Flash 实例化) | 验证样本上的人工裁定标签 | 支撑大规模自动评分的可信度,使600关卡×17配置的评测在工程上可行 |
局限与改进
作者明确承认的限制:一是Trial 1与Trial 2的对比把'诊断反馈'和'额外提交机会'两个因素捆绑在一起,无法分离各自的贡献;要归因'跨任务知识保留',需要另一个匹配对比——每个任务开始前把harness重置到初始知识状态、其他条件不变,论文只提出了这一实验设计而未执行。二是各配置的资源总量随到达关卡数和重交次数变化,跨配置的成本/时长比较需要谨慎解读。三是个别配置的异常表现(OpenClaw/GLM 5.3在Trial 1的L3至L5完成率全部为0)暗示执行稳定性问题,论文未展开分析。我自己的观察:第一,all-or-nothing判分(平均每关26.9条细则全过才算赢)会把'99%正确'的工作判为零分,完成率可能系统性低估智能体的真实能力;第二,评审智能体只用DeepSeek V4 Flash单一实例,评分偏置与该模型的能力上限绑定;第三,固定任务顺序加跨任务保留harness状态,无法排除顺序效应与前序任务记忆对后续任务的干扰(无论好坏);第四,只评冻结模型的非参数学习,把SFT/RL这条最强的持续学习路径排除在主实验之外;第五,语言分布不均衡(508个英文关卡 vs 92个中文关卡),跨语言结论受限;第六,每个领域仅7–13个任务,领域级统计功效有限。
独立分析的弱点
弱点一:反馈信号太粗。K=2的失败反馈只暴露'相关的细则类别',隐藏具体条目与参考答案,这让'从反馈内容学习'与'单纯多试一次'难以区分——改进方向是增设消融组:无反馈但允许多次提交、有反馈但单次提交、完整K=2,分别量化反馈信息量与重试机会的贡献。弱点二:通关判定的零一性。一个任务平均134.4条细则,任何一条不满足即整关失败,例如OpenClaw/GLM 5.3在Trial 1的L3–L5完成率全为0,很可能是单条细则反复卡死所致——改进方向是同时报告部分得分与'未过条目分布',把失败模式定位到具体能力缺口。弱点三:评测智能体单一化,改进方向是用多模型评审集成、公开人机分歧样本并做校准。弱点四:经验复用无法归因——CLE明知每级依赖哪类可迁移知识,却未报告智能体是否真的检索并使用了前级信息;改进方向是要求harness暴露记忆检索日志,或做干预实验(故意破坏前级产物,观察后级是否崩溃)来检验依赖是否被真实利用。弱点五:harness状态跨任务保留可能带来'污染'(把任务A的错误记忆带入任务B),OpenClaw/DeepSeek V4 Pro的负增益(−1.33pp)可能正是有害记忆的信号;改进方向是加入记忆来源追踪与重置对照实验,区分'有用经验'与'记忆噪声'。
未来方向
作者提出的方向:其一,CLE数据可用于post-train LLM以增强持续学习能力(摘要明确指出),即把600个关卡的通过/失败轨迹转化为训练信号;其二,沿T1–T5能力层级扩展评测——当前智能体系统(Claude Cowork、Codex的memory/skill工作流)只到T1(规则引导)、显现T2(自主决定学什么)雏形,T3跨域适应、T4自主研究设计、T5自主选题尚无对应评测;其三,执行'任务前重置harness状态'的匹配对比,把跨任务知识保留的贡献从反馈修正中分离出来。基于本文成果可延伸的方向:把RSI操作化——测量 $s_{n+1}$ 中保留的程序性改动是否真实改变了后续更新算子的有效性,例如比较'保留自我修订的review程序'与'固定程序'的学习曲线斜率;构建跨领域迁移版本(对应T3),检验在一个职业领域积累的策略能否迁移到全新领域;利用五类可迁移知识的标注做归因分析,回答'哪类经验最容易被智能体复用、哪类最难';把成本-完成率-时长三轴Pareto前沿(Figure 10)发展成选型工具,帮助用户在预算与时间约束下选择配置;以及探索关卡级部分得分与课程化训练(用低级关卡数据先训、再攻高级关卡)。
复现评估
开源情况良好:主页(haoyu-zhao.github.io/CLE)、HuggingFace数据集(Continual-Learning-Exam)与GitHub仓库(haoyu-zhao/Continual-Learning-Exam)均已公开,120个任务、23,981个输入文件、19个有状态应用(1,024个API)与16,125条细则全部随基准发布;论文给出了block评测形式、K=1/K=2协议与统一benchmark API的完整描述。算力门槛:一次完整Trial 1运行消耗约130M–470M token、16–65小时、$8–$411,最便宜的完整配置(OpenClaw/Hy3,$10.27、20.40小时)对个人或小团队可承受;但Claude Code与Codex依赖官方订阅,评审智能体需另行部署DeepSeek V4 Flash。复现难度中等偏上:需要自建harness对接API、管理每个任务的应用数据库初始化、串行执行全量120个阶梯(数天量级的挂机时间);主要不确定性在于论文未报告随机种子与多次运行的方差,评审智能体采样带来的评分波动需要自行估计;50+专家的任务生产流程无法完全复刻,但这只影响再造基准、不影响使用基准。总体判断:有智能体基础设施的团队复现单配置评测可行,做二次研究(如post-training)则需要相当算力投入。
论文图表
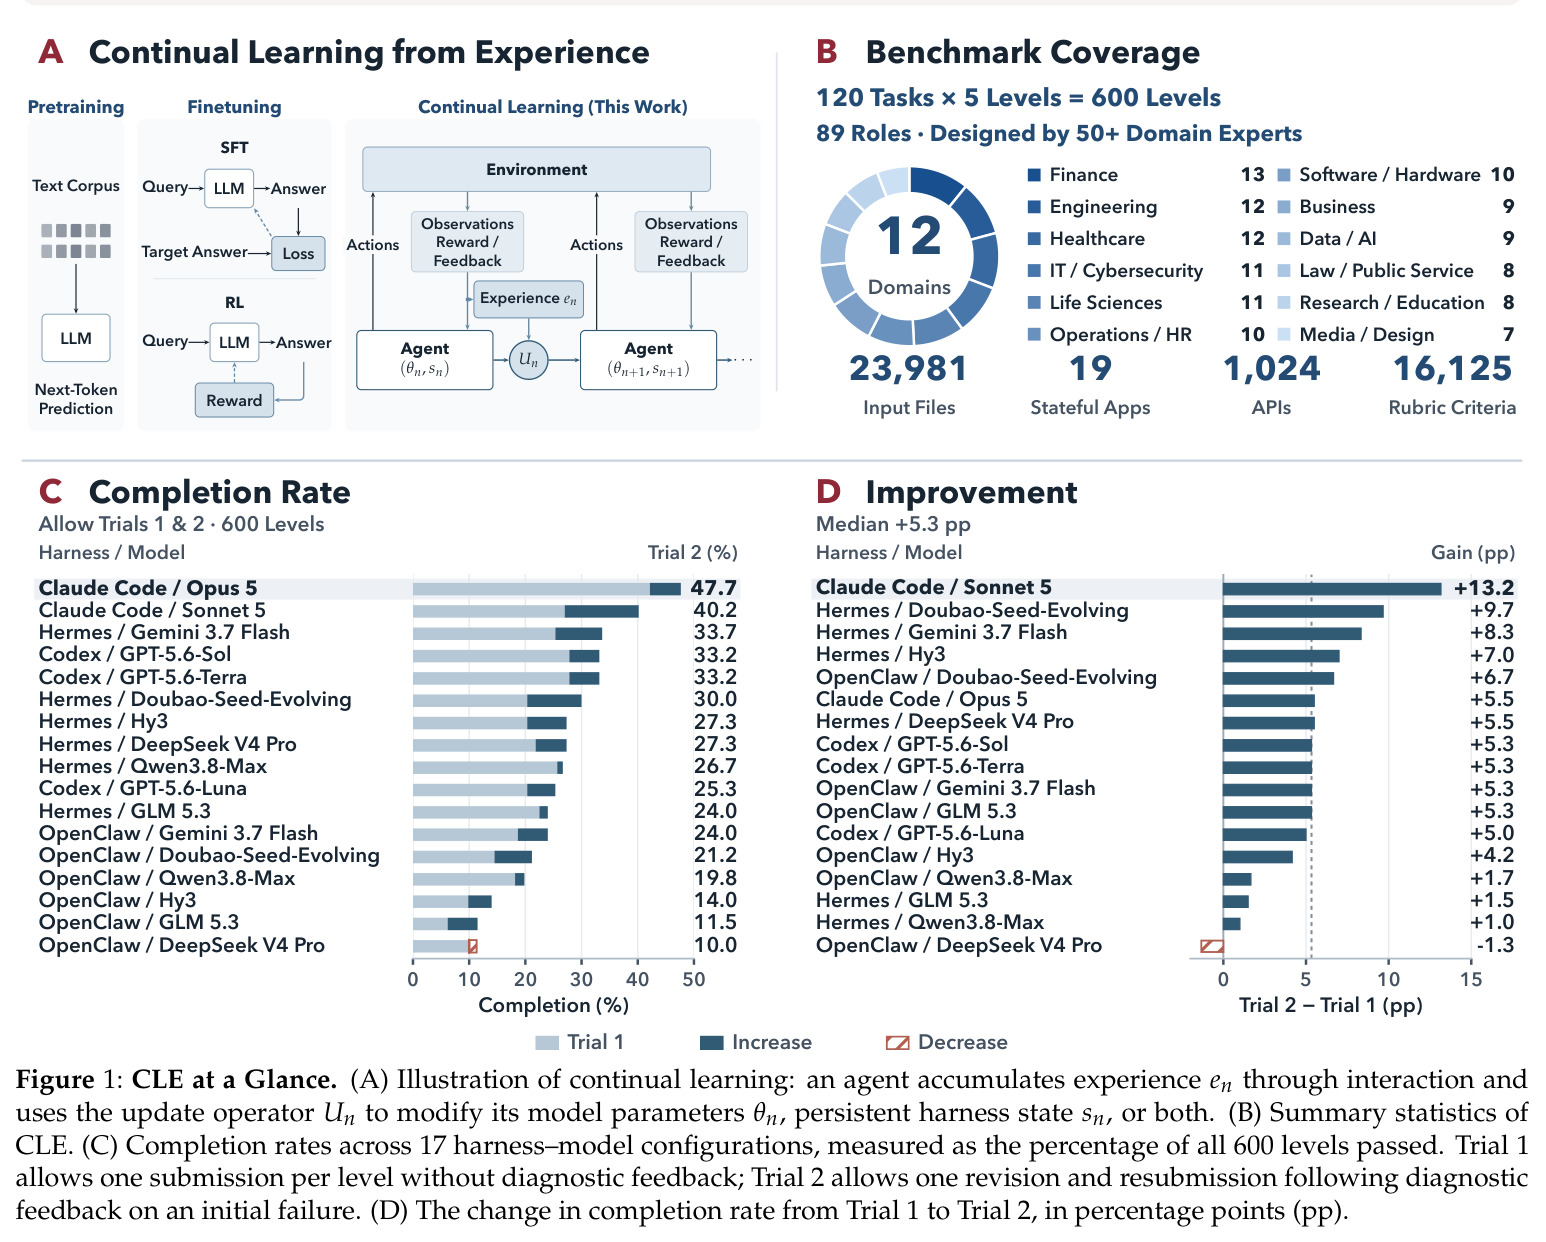
四联概览图:(A) 持续学习示意——智能体通过交互积累经验 $e_n$,用更新算子 $\mathcal{U}_n$ 修改模型参数 $\theta_n$、持久harness状态 $s_n$ 或两者,并与预训练/SFT/RL范式对比;(B) 统计摘要——120任务×5级=600关卡、89角色、50+领域专家、12领域、23,981文件、19应用、1,024 API、16,125条细则;(C) 17个配置的Trial 2完成率条形图(Opus 5最高47.7%,OpenClaw/GLM 5.3最低11.5%);(D) Trial 2相对Trial 1的增益(中位+5.3pp,Sonnet 5最大+13.2pp)。
一图看清CLE的规模、核心结果与'反馈修正增益'这一关键对照,是论文的电梯图。
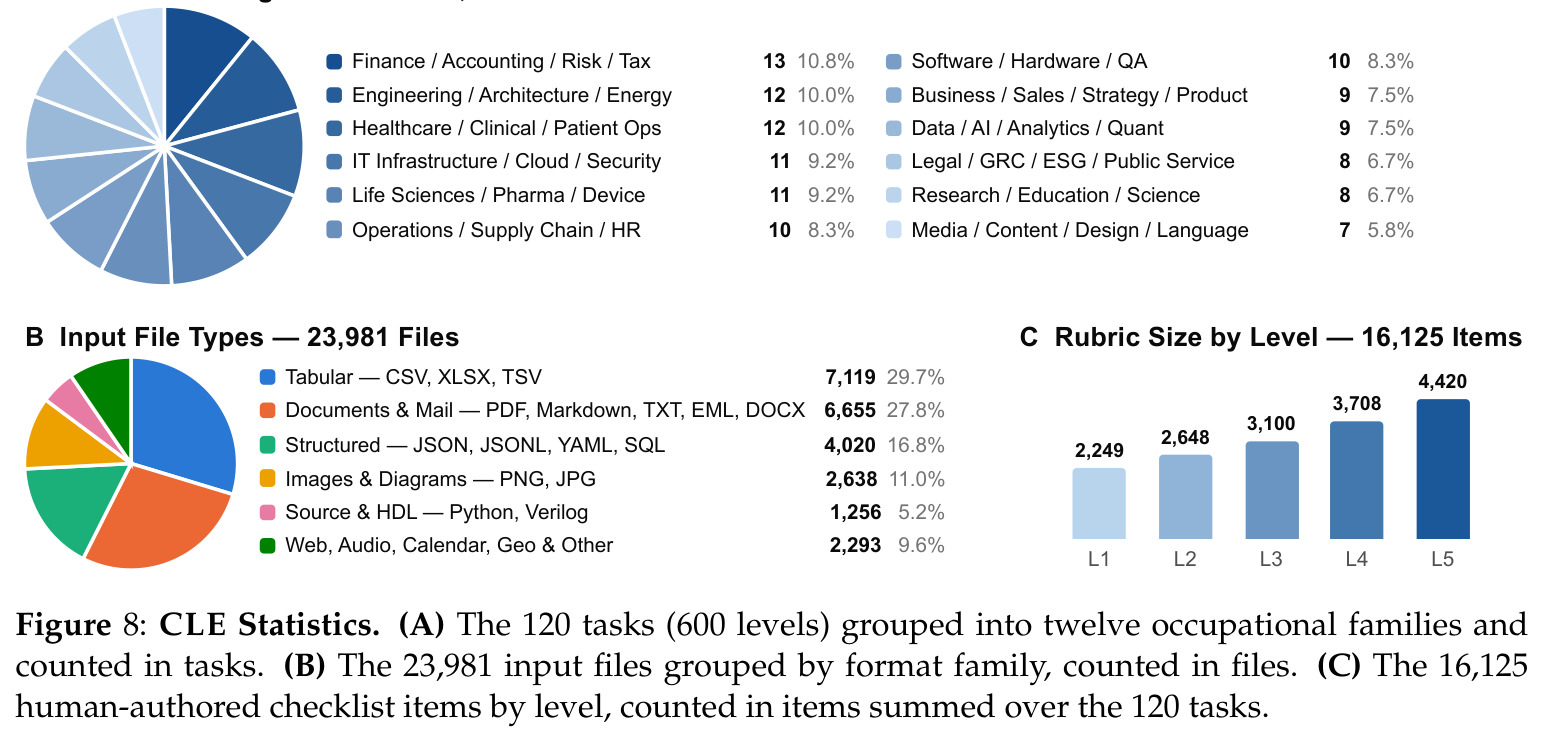
三联统计图:(A) 120个任务按12个职业族的分布——金融13(10.8%)最多,工程/建筑/能源与医疗各12,IT安全与生命科学各11,运营与软硬件各10,商业与数据/AI各9,法律与科研教育各8,媒体设计7(5.8%);(B) 23,981个输入文件按格式族分布——表格类7,119(29.7%)、文档与邮件6,655(27.8%)、结构化4,020(16.8%)、图像与图表2,638(11.0%)、源码与HDL 1,256(5.2%)、网络/音频/日历/地理等2,293(9.6%);(C) 16,125条细则按关卡递增——L1共2,249条到L5共4,420条,说明后期关卡评分更细、要求更多。
量化基准的覆盖面与难度递增设计,是引用CLE做数据规模声明时的依据。