AgentProofBench:面向 Web 智能体的可复用验证器基准 AgentProofBench: Benchmarking Reusable Verifiers for Web Agents
冻结验收规则、变换初始需求并跟踪执行后果,三链路评测可复用 Web 验证器。
前置知识
可复用验证器(验收程序)
一段可执行代码,通过普通的业务 before/after API 读取状态并判定任务是否完成。接口固定为 verify(task, before, after),返回 Pass/Fail/Unknown(异常、格式错误或执行超限记 Error)。与每次用 LLM 现场判定不同,它构建后即冻结,可在多个任务实例上零模型调用地重复使用,因此构建成本需要摊销,规则本身必须能跨实例泛化。
本文的全部测量对象就是这类冻结程序:配对初始状态测试它的语义泛化,执行分支测试它放行/扣留决定的实际后果,成本分析测试它的经济性。
复用契约与初始状态绑定
复用契约指公共指令与证据权限保持固定、只允许初始业务数据变化,并要求程序从运行时 before 状态推导状态相关需求。初始状态承载了指令中名字的实际指称(实体绑定,如“Elena 当前指向哪个用户”)、必须存活的初值(保留条件,如 Plot B3 的初始状态)以及集合应包含的元素。例如指令“把 B3 的 assignee 设为 Rashida 并保留其初始状态”,在 B3 从 Active 变为 Dormant 后,正确行为是保留 Dormant 而非恢复 Active。
理解 P1 研究的 source/background/related 三种初始条件、witness 重放的合格性判据,都必须先掌握这套契约语义。
平衡准确率 BA 与联合正确性
BA 在每个初始状态面板内对有效与失败结果等权平均:$\mathrm{BA}_{ik}=\frac{1}{2}\Big(\sum_{j\in J^+_{ik}}\mathbf{1}[\hat{y}_{ikj}=\mathrm{Pass}]/|J^+_{ik}|+\sum_{j\in J^-_{ik}}\mathbf{1}[\hat{y}_{ikj}=\mathrm{Fail}]/|J^-_{ik}|\Big)$,程序副本先在任务内平均再在任务间平均,Unknown/Error 记零分。联合正确性更严格:主面板全部结果判对,且 witness 判定也正确(接受源 witness、拒绝 related 重放)才算通过。
论文的主要数字(如 related BA 93.23%、联合正确性 82/96)都建立在这两个量上,不懂它们就无法解读 Table 1 与 Figure 3。
源决策重放 witness
把源条件下有效的验证决策放到变换后的 related 条件上重放:每任务构造一对状态,一个是源条件下有效的终态(源 witness),一个是同一决策在 related 条件下失效的终态(重放)。若程序在重放上仍接受,说明它比较的是写死在代码里的旧答案(常量 Active、旧用户 ID)而非当前 before 状态;合格的 witness 迫使验证器重新从当前状态解析新需求。
这是论文方法论的核心探针:联合正确性的额外扣减、6/96 与 5/96 的误接受重放数字都由它产生,它把“状态依赖的验收关系”变成了直接可测的语义测试。
程序门控、在线门控与中性续跑
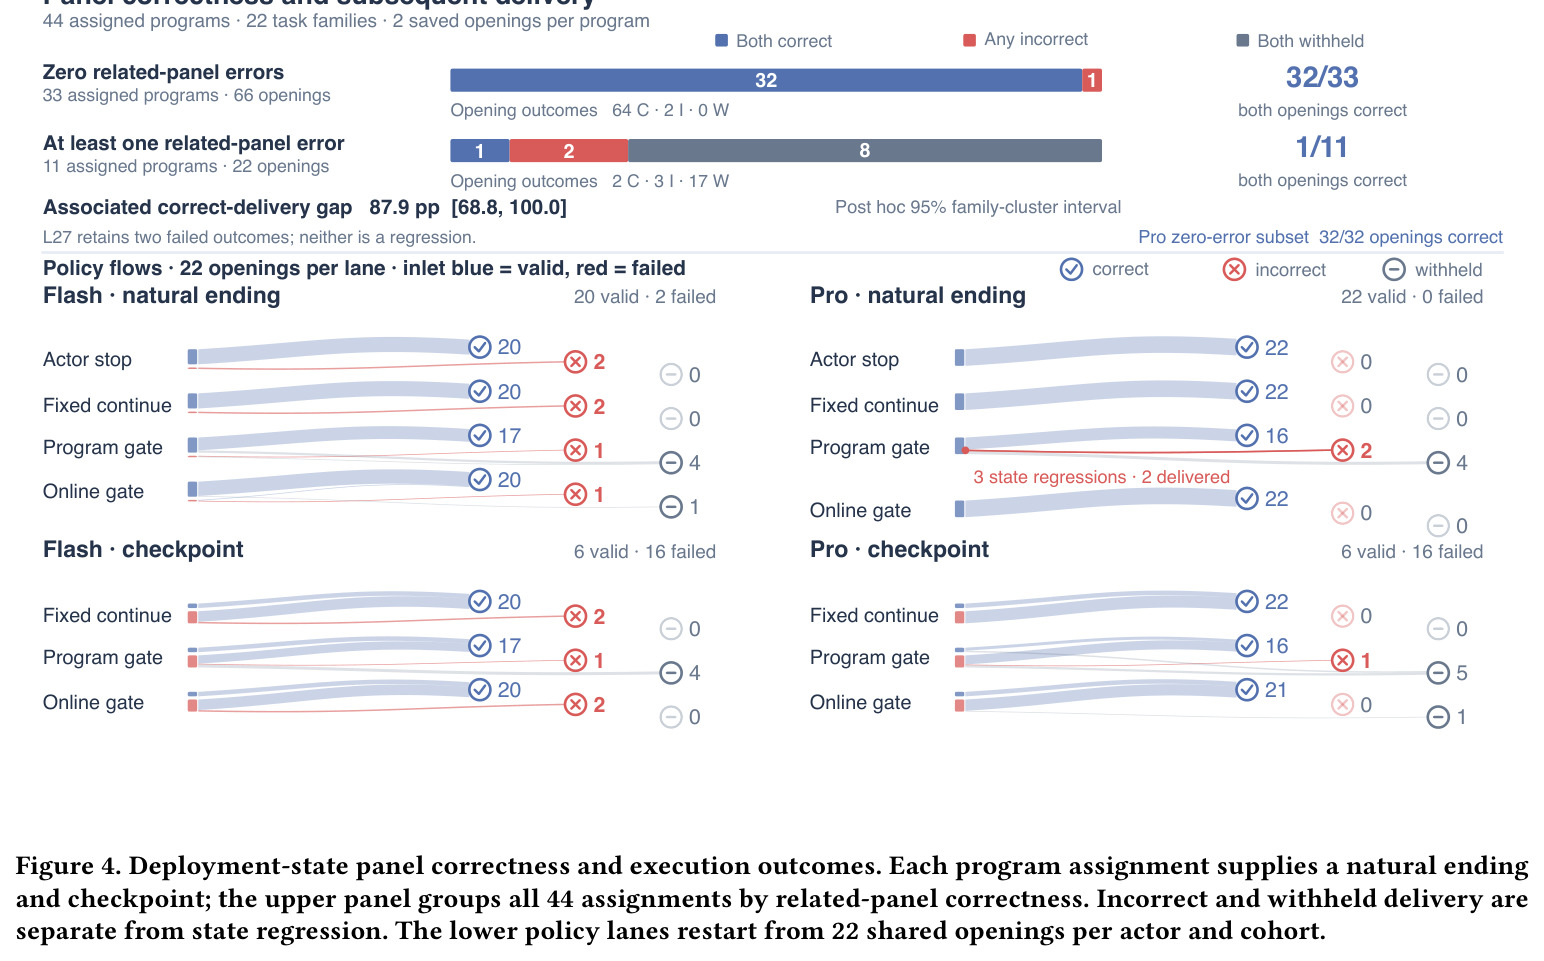
P2 执行研究从每个保存开局分支出四种反馈与停止策略:actor stop(按执行者最终回复交付)、fixed continue(两阶段中性续跑后交付)、program gate(源构建的 Pro 程序判定,Pass 才交付,否则最多续跑两次)、online gate(每次用新鲜的 Pro API12 在线判定)。中性反馈只要求“完成原请求并保留已完成的工作”,不携带程序检查或实体标识;门控反馈仅额外加一句未接受声明,二者形成可对照的完整策略单元。
面板正确性与交付结果的关联分析、以及“门控相对中性续跑的净增值”这一关键测量,都以这四种策略为比较单元。
family bootstrap 与摊销成本
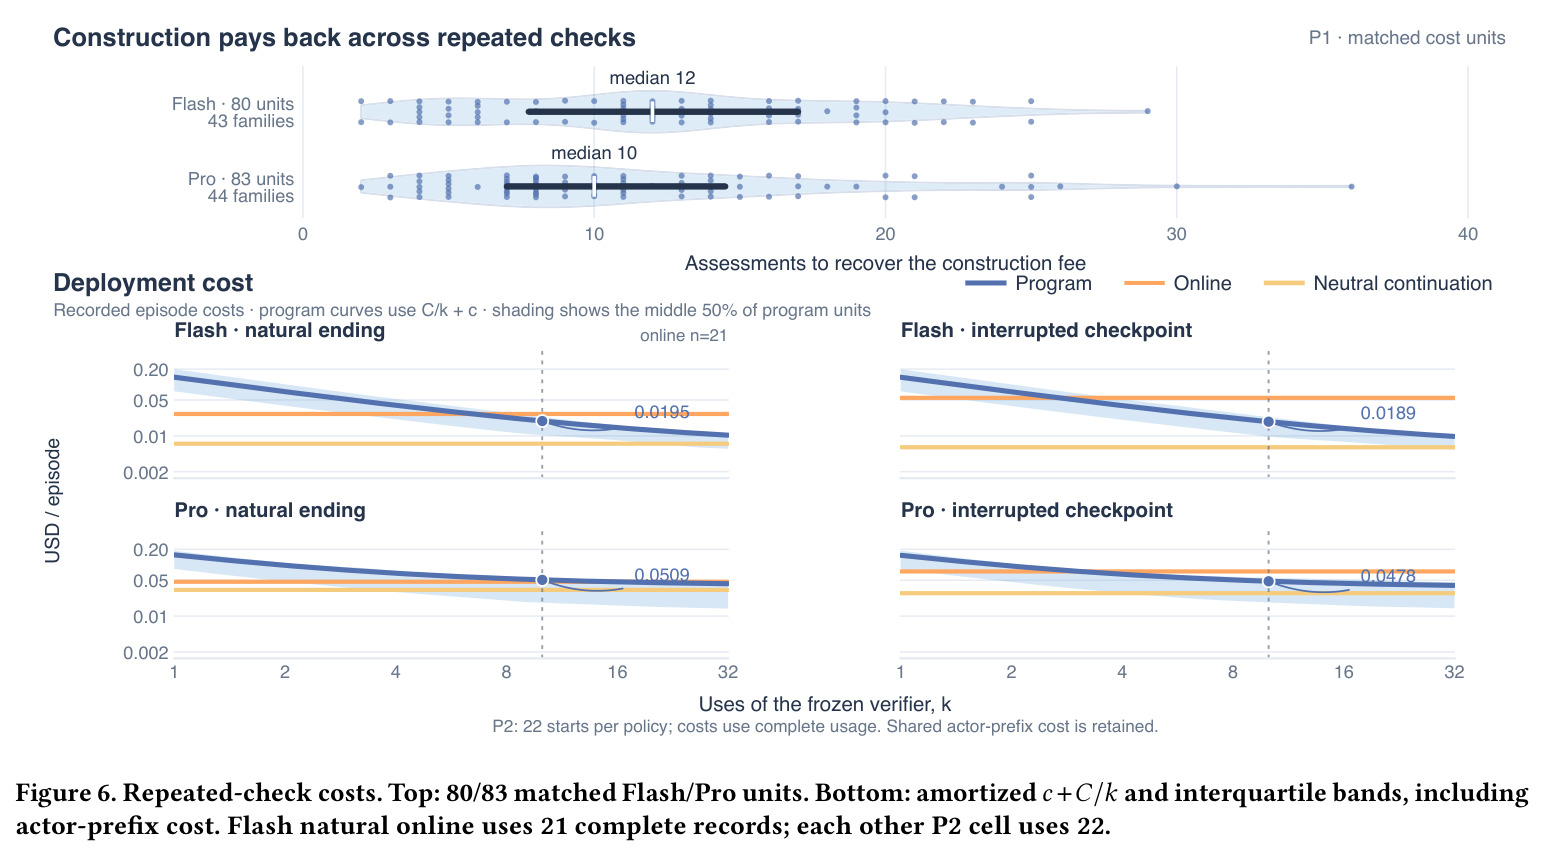
同一任务家族内的观测相互依赖,因此所有置信区间以家族为重采样单位(10,000 次 family bootstrap),预注册假设检验用 centered bootstrap 加 Holm 校正。成本分析把一次性构建费 $C$ 与单次调用成本 $c$ 分开,$k$ 次使用的摊销费为 $c+C/k$,回本周期取构建费与单次在线判定费之比的向上取整(本文中位:Flash 12 次、Pro 10 次)。
论文报告的每一个区间(如 [-5.47, 1.57])和所有成本结论都依赖这两套度量方法。
研究动机
现有 Web 智能体环境(WebArena、OSWorld、$\tau$-bench、AppWorld)建立了可执行的任务评测,但每条指令通常只在单一固定实例上执行;验证器与测试生成研究(CodeT、Eureka、VerifierBench、WebGrader、SpecGuardBench)也大多在同一批固定终态上评估生成的判定代码。而真实使用中公共指令保持不变,“需要完成的工作”却随初始业务数据变化:某个名字当前指向哪个用户、某个集合应包含哪些文件、哪个字段值必须保留,都由每次执行的初始状态决定。如果验证器把早先的答案“记死”在代码里(如硬编码 status='Active' 或旧用户 Elena 的标识符),它仍能对错误的需求给出看似合理的判定,甚至造成破坏性放行。此外,验证决策本身就是智能体环境的一部分:拒绝会触发执行者进一步修改,接受会放行最终业务状态,而此前没有任何基准把“验证器测试覆盖了哪些条件”与“它的决策导致了什么执行后果”连接起来,可复用验证的实际价值因此无法度量。
本文的目标是本文要构建一个同时评测可复用验收规则三方面能力的基准:其一,识别被允许的终局结果,包括合法替代行为与类型化故障;其二,在公共指令与程序代码冻结的前提下,从变化的初始状态中恢复变化后的需求;其三,支撑有效的后续执行与交付决策。为此,AgentProofBench 把“冻结验收规则的成对测试”与“来自同一保存开局的执行”连接起来,使每个测量都锚定在版本化的参考谓词、程序源码、API 证据和可重构的业务状态上,让测试覆盖的条件与决策的执行后果可以被同时观察。基准还希望量化冻结程序与新鲜在线判定的经济学:把一次性构建费用摊销到重复使用中,给出回本周期与部署成本画像,为“写一次规则反复用”还是“每次现场判定”提供数据依据。
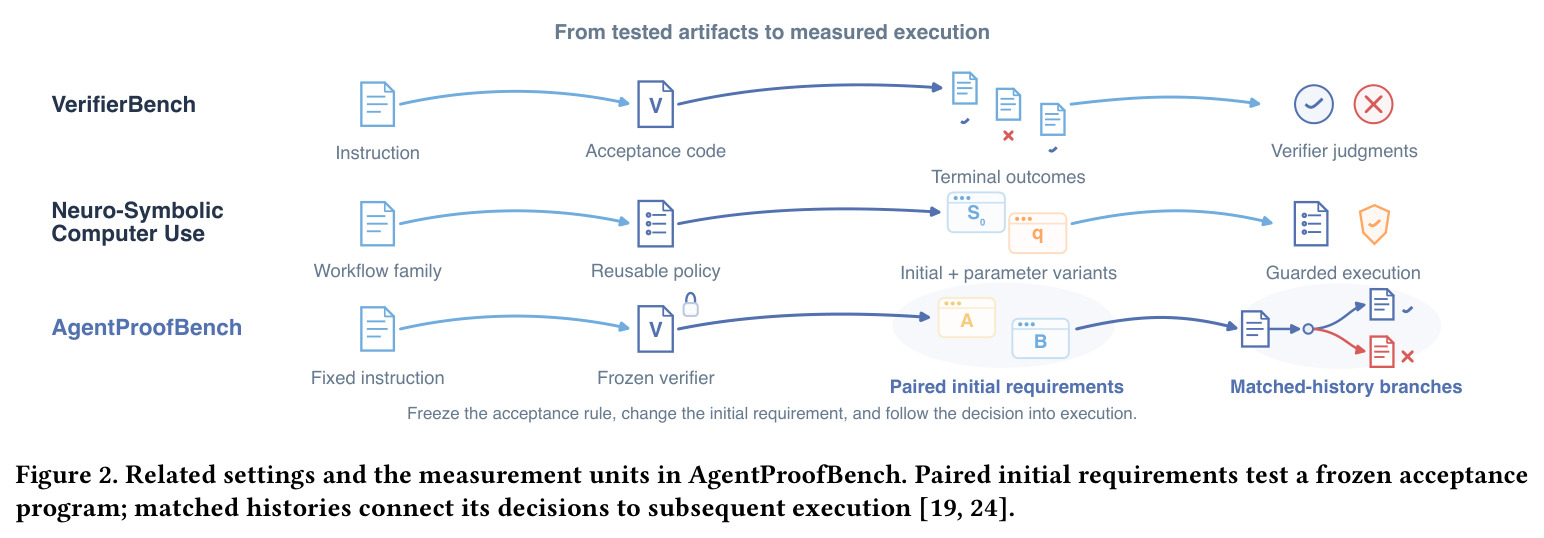
与已有工作不同的是,本文的独特切入点是“复用契约 + 配对初始状态变换 + 共享开局分支”的组合。复用契约固定公共指令与证据权限,只让初始业务数据变化,并要求程序从运行时 before 状态推导状态相关需求;source/background/related 三种初始条件使“无关数据变化不影响判定、相关需求变化必须改变判定”成为可执行的语义测试。源决策重放 witness 提供了直接检验:若同一条早先的有效决策在新条件下仍应有效,程序可以靠记住旧答案过关;只有合格的 witness 才迫使验证器从当前 before 状态解析新条件,从而把“状态依赖的验收关系”本身变成被测对象。最后,从完全相同的保存开局分支出的四种停止策略,把同一个验证器接到拒绝后的编辑、放行与扣留等执行后果上,形成“测试→判定→执行”的完整证据链;这种把验证器评测与其消费方策略评测因果耦合的设计,是以往验证器或轨迹评判基准都不具备的。
核心方法
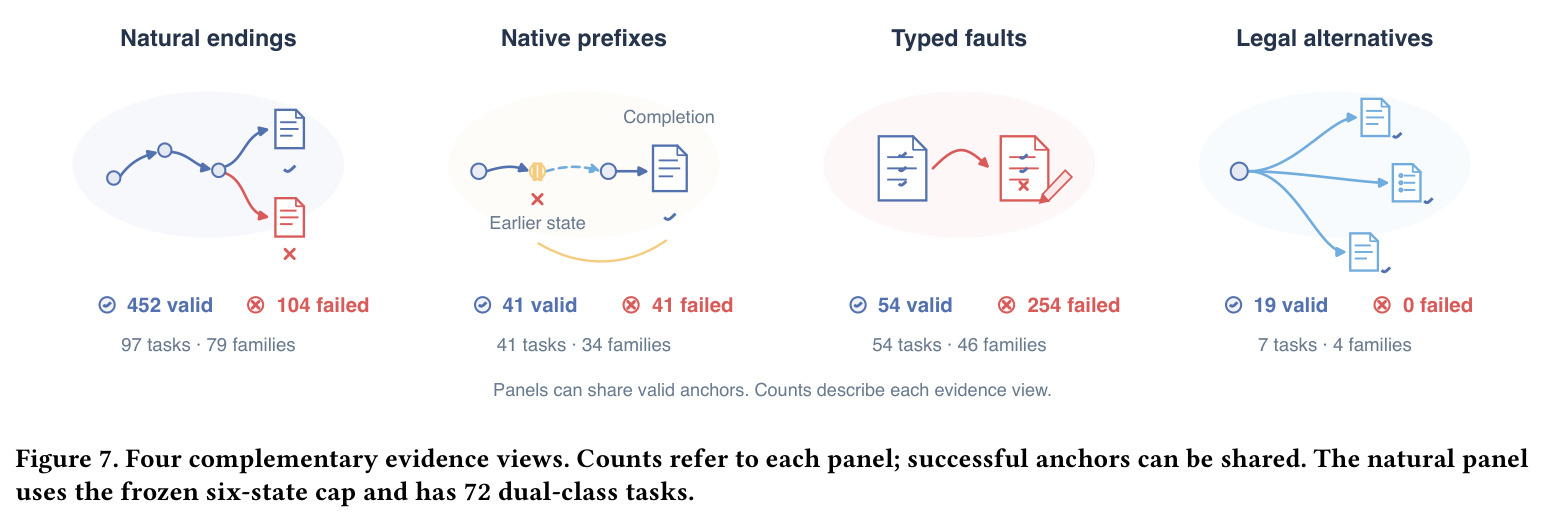
基准由三个互相衔接的研究组成。验收研究覆盖 4 个 Web 服务(基于 Agent-Diff 企业服务复刻)上的 97 个任务、79 个家族,其中 20 个家族不相交的开发任务用于设计迭代;556 个自然状态构成主面板(452 成功/104 失败),另有原生前缀对、类型化故障和合法替代三个互补证据视图(Figure 7:41/41、54 有效/254 失败、19 有效/0 失败)。复用研究 P1 覆盖 48 个家族(18 Linear、10 Slack、19 Box、1 Calendar),每家族一个相关初始状态变换;144 个初始状态支撑 558 个主终态(270 有效/288 失败)外加 witness 对。DeepSeek Flash/Pro(关闭思考、温度 0)各生成源程序与目标重建程序各 2 个副本,共 576 个冻结产物;另有每模型每状态 2 次的 API12 在线判定,共 2,232 条观测。执行研究 P2 用 22 个家族、44 条轨迹(每任务各一条 Flash 与 Pro 执行者轨迹)、88 个保存开局(自然结局 + checkpoint),每个开局分支 4 种策略,共 352 个策略结果。验证接口是 verify(task, before, after),在只读沙箱中执行,限 1 CPU、1 GB 内存、60 秒、80 次业务操作。
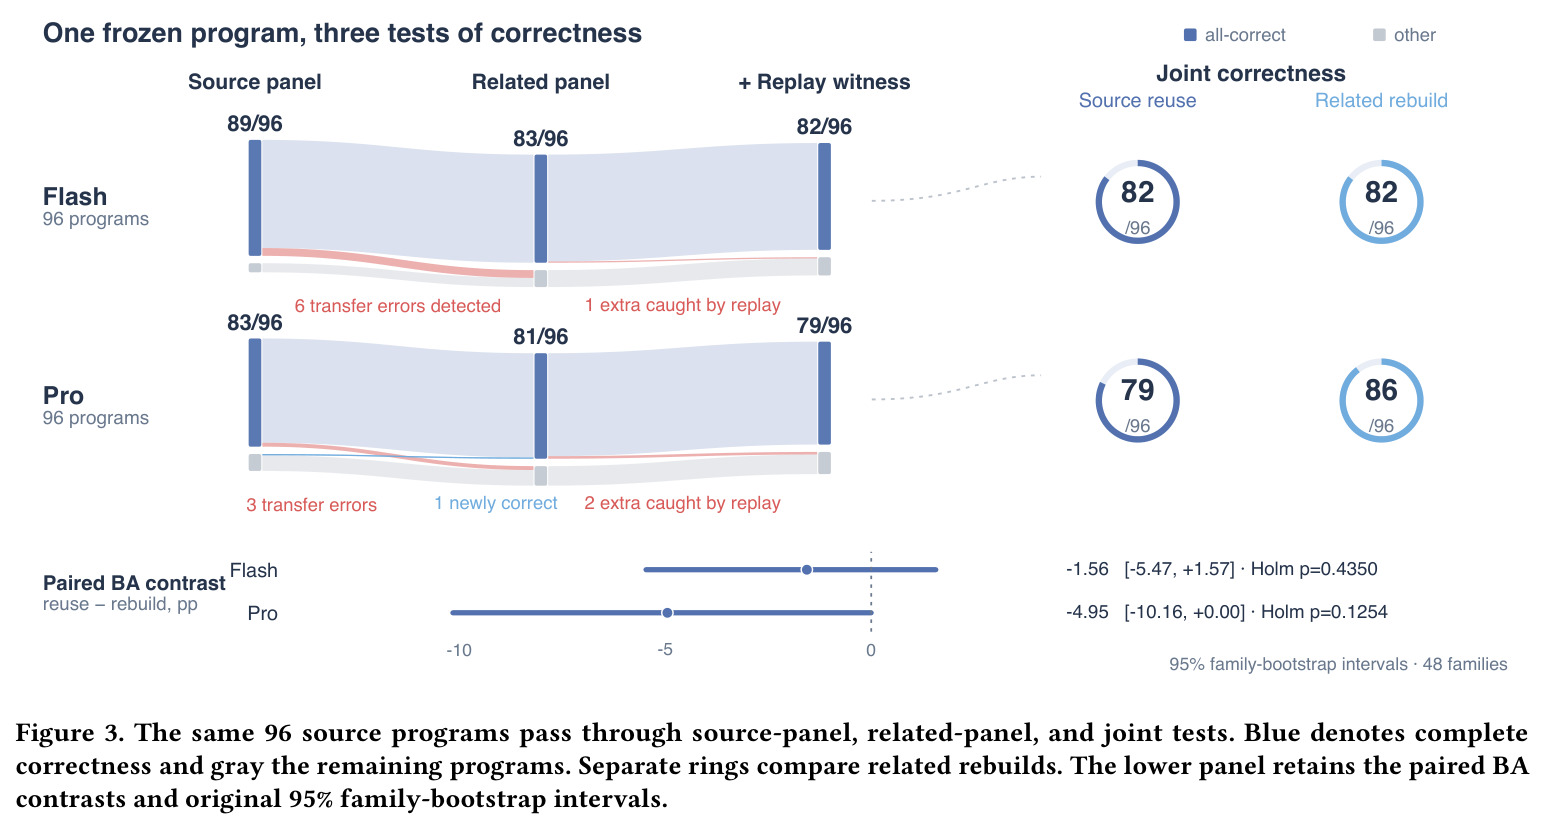
核心创新是把“验收规则能否跟随变化的需求”变成可执行、可证伪的语义测试。配对设计中 related 条件改变必需的实体绑定、初始值、集合或保留条件,而指令文本一字不改;正确判定随之改变——如 linear_52 把 Plot B3 的初始状态从 Active 改为 Dormant 后,正确行为是保留 Dormant,接受“改回 Active”反而是错误。源决策重放 witness 是点睛之笔:把源条件下有效的决策放到 related 条件上重放,若程序仍接受,就暴露了它比较的是记忆中的字面量而非当前状态。评分上引入联合正确性:主面板全对且 witness 判定正确才通过——源程序联合正确性 Flash 82/96、Pro 79/96,低于仅看主面板的 89/96、83/96,说明重放能额外抓出主面板未覆盖的绑定/集合分支(如 box_141 只检查 JSON 外层字段而漏掉 results[0] 内层必需文件)。随后,P2 用面板正确性预测交付结果,把验收质量与策略后果连接成一个可检验的链条。
方法步骤详情
第一步,任务构造:每任务给出公共指令 $q_i$、API 文档 $D_i$、认证接口 $O_i$;验证器输出 $\hat{y}_{ikj}=V_i(q_i, O_i(S^0_{ik}), O_i(S^1_{ikj}))$ 与主机参考 $y_{ikj}=G_i(S^0_{ik}, S^1_{ikj})$ 对比。参考谓词覆盖身份、值、集合与关系,并用版本化选择器从 before 状态解析目标对象。第二步,构造四个结果面板:自然结局、原生前缀对(把完整执行接到较早的不完整状态)、经服务 API 注入的类型化故障、合法替代行为。第三步,P1 资格检查:变换后的需求须由公共指令蕴含、状态由服务动作构造、原生与 API 参考对匹配结果一致、且源有效决策在 related 条件下重放失效。第四步,程序生成:构造提示明示复用契约,B4/B12 分别为 4/12 次调用预算,重建程序在各自目标条件上构建,API12 为 12 轮在线判定。第五步,评分:面板内计算 BA(见前置概念),副本先任务内平均再任务间平均;预注册配对量 $\Delta_m=\frac{1}{N}\sum_i(\mathrm{BA}^{\mathrm{reuse}}_i-\mathrm{BA}^{\mathrm{rebuild}}_i)$ 用 10,000 次 family bootstrap 与 Holm 校正检验。第六步,P2 执行:在首次包含变更请求的完整工具轮后保存 checkpoint,从 88 个开局分支 actor stop/fixed continue/program gate/online gate 四策略,每阶段限 20 轮模型、100 次业务操作、1 美元成本熔断与 900 秒时限,交付被扣留时已执行的写操作保留。第七步,成本台账记录构建费 $C$ 与调用成本 $c$,按 $c+C/k$ 摊销并估计回本周期。
技术新颖性
与最近工作相比,本文的测量单元是全新的。VerifierBench 评测六个智能体基准上可执行验证器的生成,但始终停留在固定实例的结果面板内;Agent-as-a-Judge、AJ-Bench、AgentRewardBench 评估基于环境或轨迹证据的自动评判;Universal Verifier、Sauron、VAGEN、VeriHarness 关注判据化证据收集;CLIFT 把冻结验证库用于训练与轨迹选择;Neuro-Symbolic Computer Use 与 ControlScope 研究初始状态与参数变化下的可复用执行策略、流程修订权限;DCP 比较真实与中性反馈。AgentProofBench 首次把三者串成一条因果链:配对初始需求测试冻结程序的语义泛化,重放 witness 检验“验收关系”本身,匹配历史的执行分支度量判定对交付的实际影响,且每个环节共享同一套任务、程序、状态与证据标识。两项附带设计也有独立价值:以中性续跑作为基线来度量门控的净增值(而非只报告门控本身的绝对表现),以及把固定构建成本与边际调用成本分离的摊销分析(中位回本 12/10 次调用,摊销式 $c+C/k$)。
实验结果
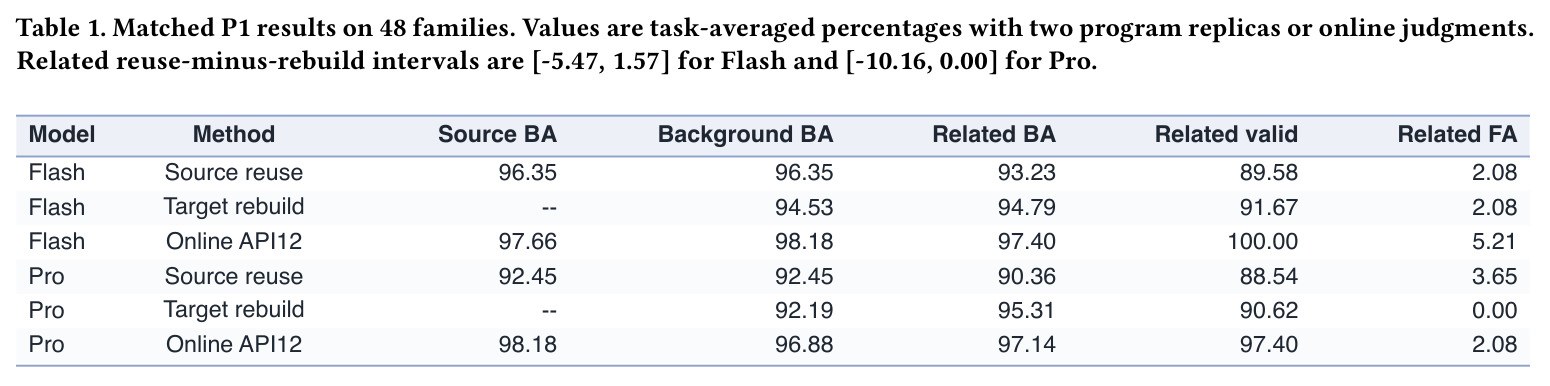
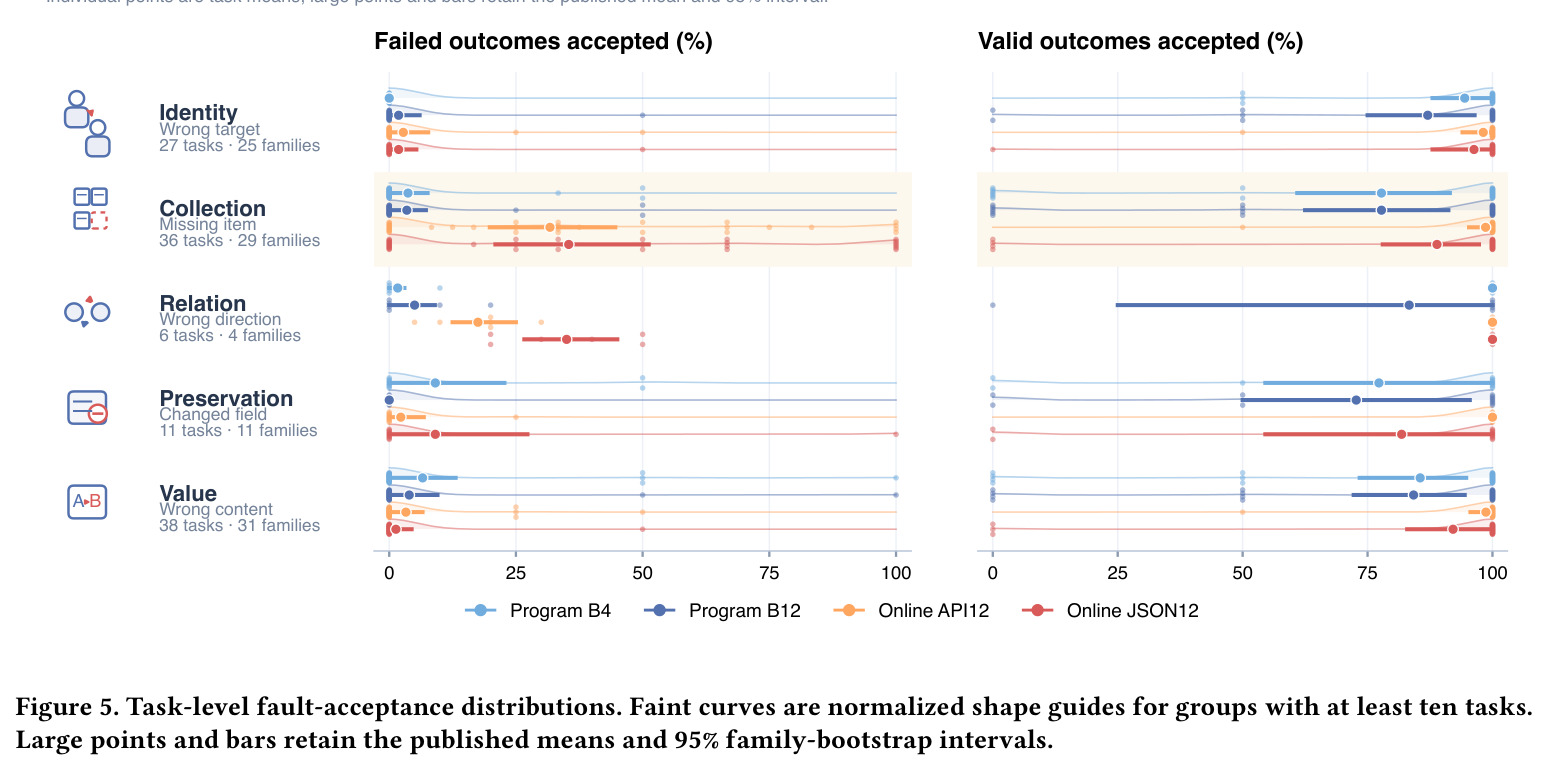
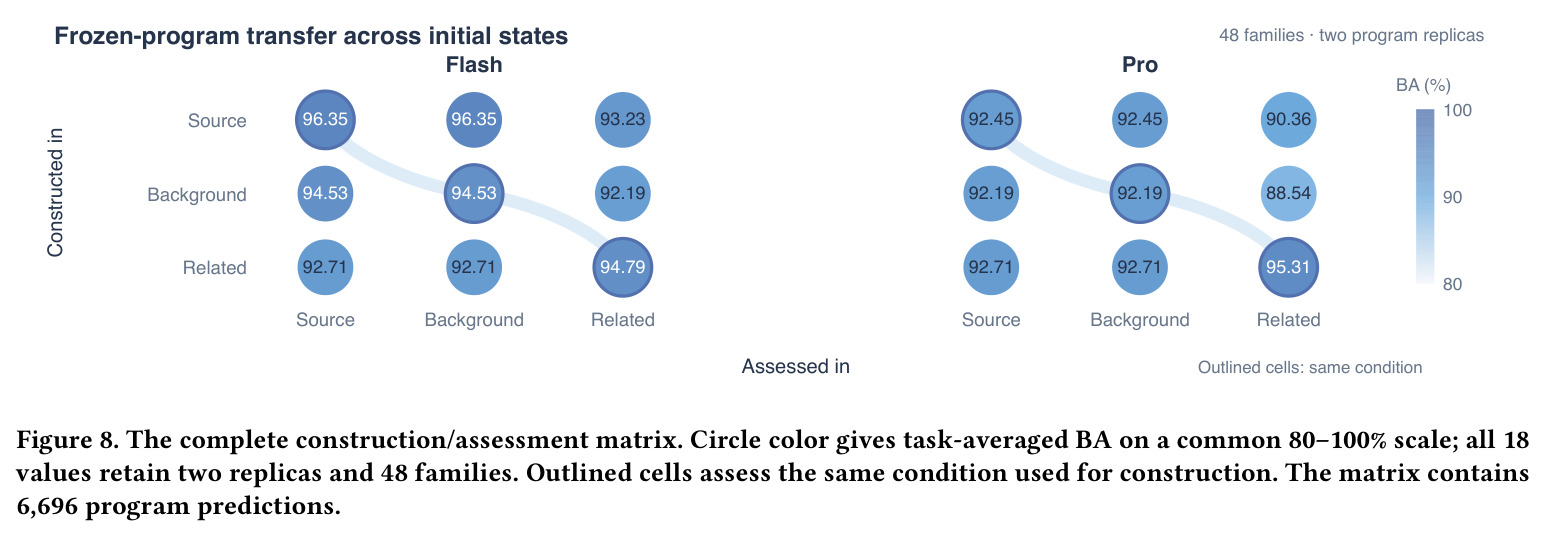
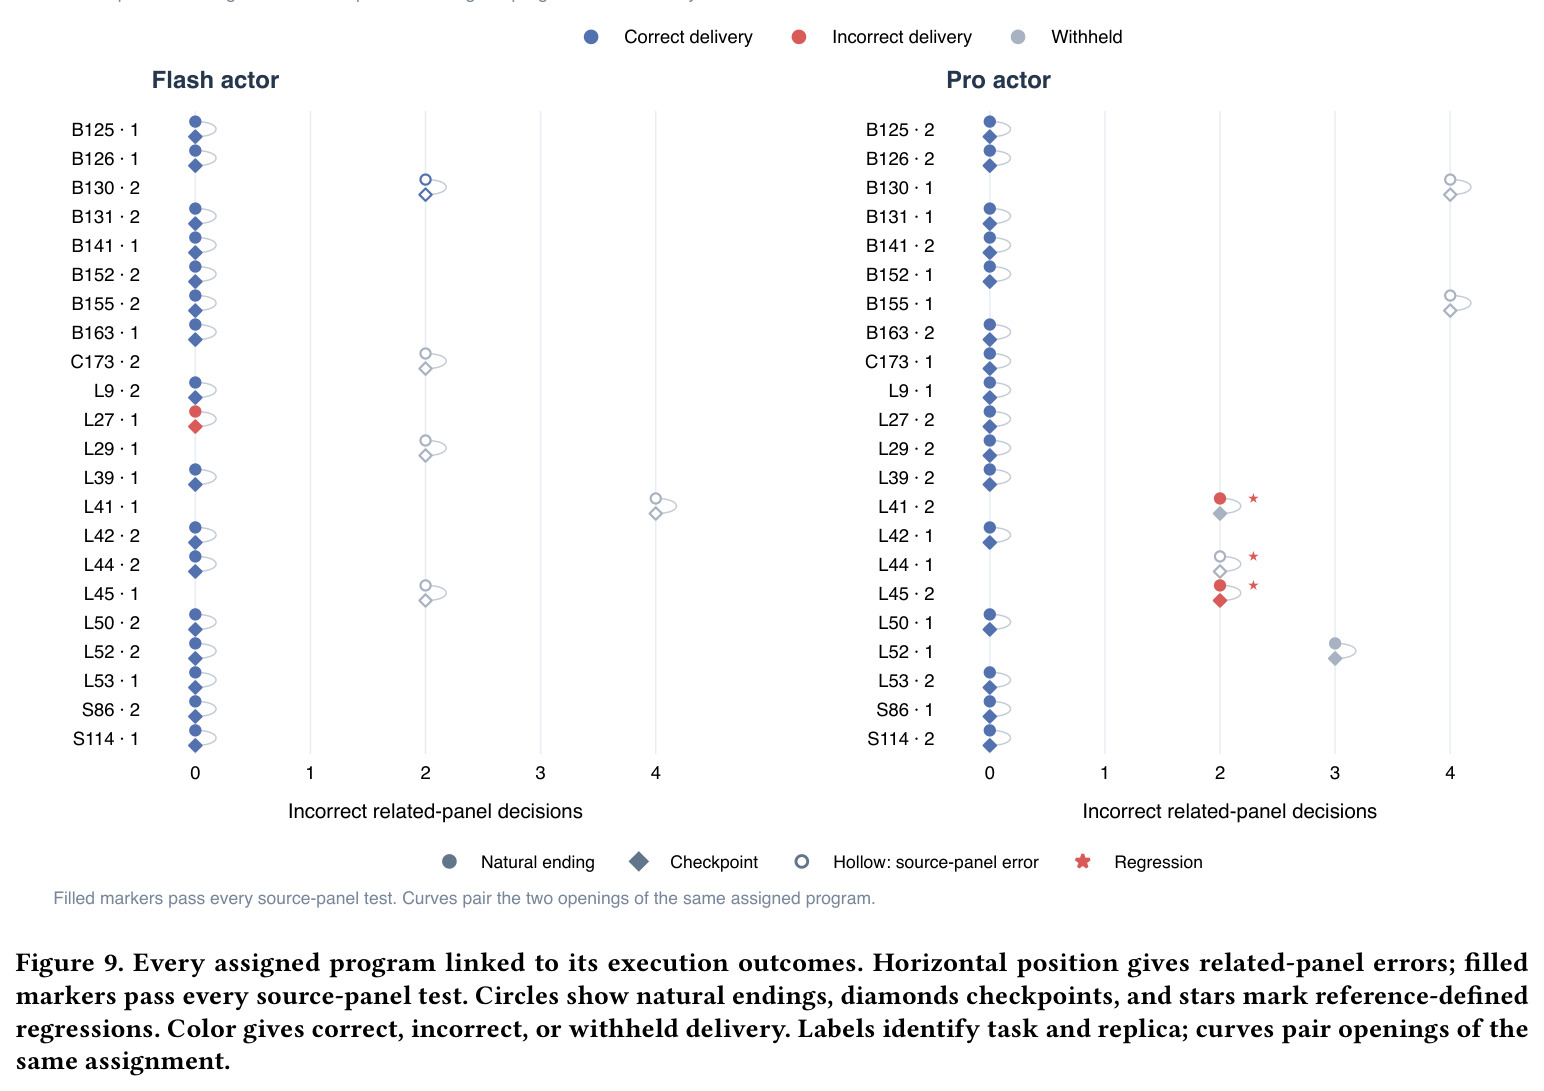
三项测量给出一致且互补的结论。复用研究(P1):Flash 源程序 related BA 为 93.23%(源面板 96.35%),Pro 为 90.36%(源 92.45%);reuse−rebuild 配对差 Flash 为 $-1.56$ 点,95% 族 bootstrap 区间 $[-5.47, 1.57]$(Holm $p=0.4350$),Pro 为 $-4.95$ 点,区间 $[-10.16, 0.00]$($p=0.1254$),均不能拒绝均值相等,但 Pro 区间下探到 $-10.16$ 点;背景变换下判定完全不变。主面板完全正确的源程序数从 89/96 降到 83/96(Flash)、83/96 降到 81/96(Pro);加入 witness 后,源程序联合正确性为 Flash 82/96、Pro 79/96,重建程序为 82/96、86/96(重建主面板完全正确数 85/96、87/96);源程序误接受 related 重放 6/96(Flash)、5/96(Pro),且 Pro 给出 2 个 Unknown 与 2 个 Error。执行研究(P2):related 面板无误的 33 个任务分配中 32 个在自然结局与 checkpoint 两个开局都正确交付,含面板错误的 11 个分配只有 1 个(开局级 64/66 对 2/22),相差 87.9 个百分点(族聚类区间 $[68.8, 100.0]$);全部 17 次程序门控扣留与全部 3 次参考定义回归都落在面板错误组。策略比较:中性续跑在 checkpoint 修复 14/16(Flash)与 16/16(Pro)个失败,正确交付 20/22 与 22/22,优于程序门控(17/22、16/22)和在线门控(20/22、21/22),对程序门控的配对增益为 13.64 点 $[0.00, 27.27]$(Flash)与 27.27 点 $[9.09, 45.45]$(Pro)。验收画像(集合对比,同一状态集):程序 B12 对集合类故障的误接受仅 3.5%,在线 API12 为 31.7%(配对差 $-28.2$ 点,$[-40.7, -16.7]$),但对有效锚的接受率 77.8% 对 98.6%;BA 92.1% $[87.7, 95.9]$ 对 99.0% $[97.7, 99.9]$,困难集 87.1% 对 96.2%;中位判定延迟 0.58 秒对 20.69 秒。成本:源程序构建中位费 0.0173/0.0765 美元(Flash/Pro),等价在线面板单次 0.0188/0.0980 美元,回本中位 12/10 次调用(范围 2–29 与 2–36);10 次使用时 Flash 程序门控自然结局均值 0.0195 美元(冷启动 0.1396 美元),Pro 为 0.0509/0.0478 美元。语义审计:GPT-6 Astra 在 62 个任务的 195 个状态上与参考判定一致 191/192(99.5%,Cohen $\kappa=0.989$),3 例不可判定。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 初始状态复用 P1(平衡准确率) | Related 面板 BA (%) | Flash 源程序复用 93.23 | Flash 目标重建 94.79 | $-1.56$ 点,区间 $[-5.47, 1.57]$,Holm $p=0.4350$(不能拒绝均值相等) |
| 初始状态复用 P1(平衡准确率) | Related 面板 BA (%) | Pro 源程序复用 90.36 | Pro 目标重建 95.31 | $-4.95$ 点,区间 $[-10.16, 0.00]$,Holm $p=0.1254$ |
| 联合正确性(主面板 + 重放 witness) | 通过程序数 / 96 | 源复用:Flash 82/96,Pro 79/96 | 重建程序:Flash 82/96,Pro 86/96 | Pro 复用比自身条件重建少 7 个程序;Flash 持平 |
| 面板正确性与后续交付的关联 | 双开局均正确交付的任务分配比例 | 零面板错误组 32/33 | 含面板错误组 1/11 | +87.9 个百分点,族聚类区间 $[68.8, 100.0]$ |
| P2 checkpoint 正确交付(策略对比) | 正确交付开局数 / 22 | 中性续跑:Flash 20/22,Pro 22/22 | 程序门控 17/22、16/22;在线门控 20/22、21/22 | 对程序门控配对增益 +13.64 点 $[0.00, 27.27]$(Flash)、+27.27 点 $[9.09, 45.45]$(Pro) |
| 集合类故障验收(共享状态集对比) | 误接受 FA (%) / 有效锚接受率 (%) | 程序 B12:FA 3.5%,有效接受 77.8% | 在线 API12:FA 31.7%,有效接受 98.6% | FA 配对差 $-28.2$ 点 $[-40.7, -16.7]$;B12 更保守、API12 更覆盖 |
| 单次判定延迟(24 状态计时面板) | 中位耗时(秒) | 程序 B12 0.58 | 在线 API12 20.69 | 约 36 倍提速 |
| 冻结程序经济性 | 回本所需调用次数(中位) | Flash 12 次(范围 2–29),Pro 10 次(范围 2–36) | 每次重新在线判定(无回本概念) | 构建费 0.0173/0.0765 美元 vs 单次在线 0.0188/0.0980 美元 |
局限与改进
作者承认并可观察到的局限:其一,预注册的 reuse−rebuild 对比均不显著(Flash $p=0.4350$、Pro $p=0.1254$),只能给出方向性证据,不能断言复用必然劣于重建;其二,生成器、判定器与执行者仅使用 DeepSeek Flash/Pro 两个模型且关闭思考、温度 0,结论对其他模型族的迁移性未知;其三,环境仅覆盖 Agent-Diff 的 4 个企业服务,每家族只有一种相关变换类型、每任务一对 witness,统计功效有限——面板—交付关联的族聚类区间宽达 $[68.8, 100.0]$,回归事件只有 3 例(其中 2 例交付);其四,中性续跑在通用反馈下已达到最高正确交付,这既说明门控的净增值需要在更强或更弱的执行者上重新度量,也提示结果依赖“中性反馈文本”这一工程选择(作者用 8 家族开发研究事先选定);其五,沙箱只读、单次 60 秒与 80 次操作的限制排除了需要写访问或多轮交互取证的验证策略。我自己的观察:verify() 只返回离散的 Pass/Fail/Unknown,缺少置信度或校准分数,门控策略只能做阈值化决策;成本分析只计 API 费用,未计入延迟成本与错误判定引发的下游修复成本;此外 97 个任务全部来自 Agent-Diff 复刻环境,“企业服务”的真实性仍受上游环境保真度约束。
独立分析的弱点
独立分析三点弱点。第一,验证器输出空间过窄:接口只返回 Pass/Fail/Unknown/Error,没有部分满足度或置信分数,因此无法支持部分信用、风险加权放行或选择性升级;box_141 这类“九个必需项只算出八个”的集合错误只能整票否决或整票放过。改进方向是让程序返回结构化的判据命中情况,把未满足的谓词作为可审计证据输出,供上层策略按风险消费。第二,witness 与变换的覆盖是每任务单对、每家族单变换,覆盖不了组合变化(同一状态中绑定与保留条件同时变化)和跨服务依赖;作者自己的诊断显示 149 个误拒中 109 个是表示/标识符问题,说明失败模式高度结构化,却没有被分层地系统生成。改进方向是按失败类型做分层组合变换,并报告分层的联合正确性,让生成器改进有明确的靶子。第三,P2 把“完整门控策略”(接受判定 + 固定反馈 + 停止规则)作为不可分的比较单元,虽然公平,但无法归因收益来自判定质量还是停止时机;同时中性续跑几乎封顶,使门控的区分度不足。改进方向是引入自适应混合策略(程序判定低置信或 witness 失败时升级到在线判定),并对反馈文本做反事实重放,以分解判定质量与停止时机的贡献。
未来方向
作者在“使用基准”一节给出三条工作流:在自然结局、合法替代与类型化故障上测试验证器生成器的验收画像;用完整面板与联合 witness 正确性评测冻结产物在匹配初始需求下的表现;用记录的开局比较消费判定结果的策略,分别度量完成的工作、持续变更与交付状态。在此基础上可以延伸:把规则特定修复(作者用 gpt-6.1-sol 辅助编辑使 149 个被检误拒全部改为接受,18 个可用负控中 17 个保持拒绝)发展为“witness 驱动的验证器自动修复”闭环;把重放 witness 作为训练信号,学习能从 before 状态解析需求的验证器(如可验证奖励的强化学习);设计混合门控,兼得 B12 的 3.5% 低误接受与 API12 的 98.6% 高有效接受;把初始状态变换扩展到多变化组合与跨服务依赖;把成本—判别力前沿(0.58 秒对 20.69 秒、回本 12/10 次)用于自动路由程序化与在线判定的调用策略;以及验证更丰富的 actor 模型族与思考模式,检验 87.9 个百分点的面板—交付关联是否跨模型稳定。
复现评估
复现条件较好。资源已发布:指令、版本化参考规则、初始/终态快照、程序源码、API 证据与完整动作历史均可获取,配套 Evidence Index 与含评估/复现命令的 README;代码与标注采用 MIT 许可并附上游声明。环境钉在 Agent-Diff revision 3bb9c407,Python 3.12 沙箱提供只读文件系统、受限 scratch 与非特权用户;单次验证限 1 CPU、1 GB 内存、60 秒、80 次业务操作,冻结程序无需模型调用即可评估。规范快照加精确行级增量可重构每个保存状态;台账保留重试、未解析使用、中断构建与重构溯源,费用可逐条对账。统计协议在附录 B 完整给出(10,000 次 family bootstrap、以家族为重采样单元、Holm 校正、预注册检验与事后诊断分离)。算力需求温和:主要开销是模型 API——构建与判定用 deepseek-flash 与 deepseek-v4-pro(2026-10-24/25,温度 0、关闭思考),参考开发用 gpt-6.1-sol(xhigh),语义审计用 gpt-6-astra;程序构建中位费 0.0173(Flash)/0.0765(Pro)美元,全研究预算在百美元量级。注意点:模型别名与时间窗敏感,需要在台账记录的 UTC 时间附近复现;部分诊断依赖保存工件的重放而非重新运行。总体复现难度中等,数值结果可逐表核对。
论文图表
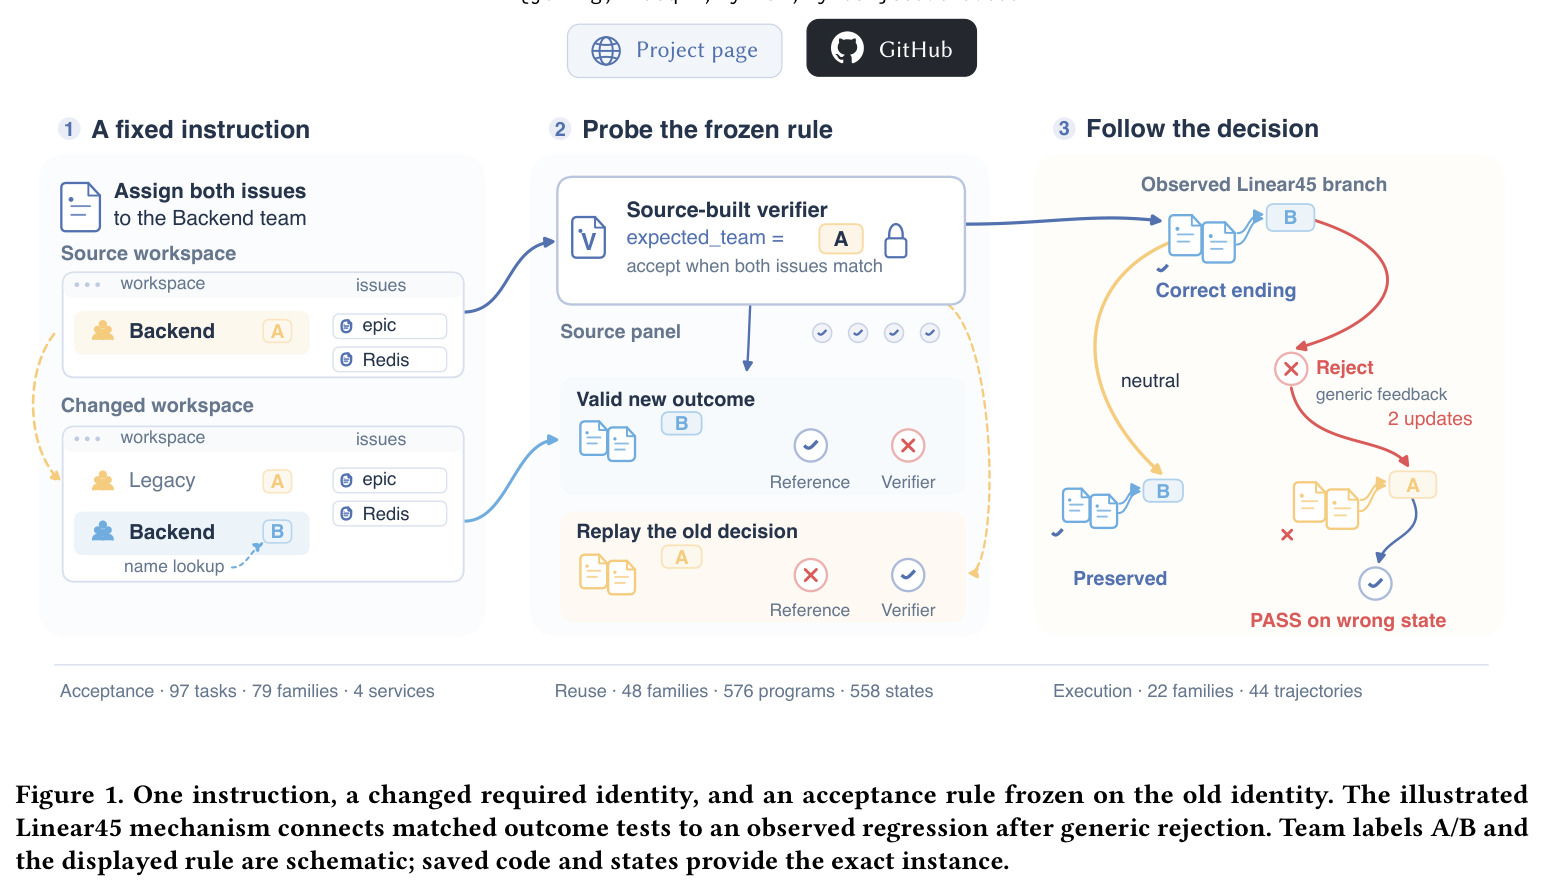
以 Linear45 任务为例的三格示意图:(1) 固定指令把两个 issue 分派给 Backend 团队;(2) 相关初始状态改变后,源构建的验证器仍按旧身份的规则放行错误结局;(3) 通用拒绝反馈后,执行者把两个 issue 移回旧团队,程序接受并释放了失败状态,形成一次被观察到的交付回归。
这是全文的问题陈述图:直观展示了“指令不变、所需身份已变、验收规则冻结在旧身份上”这一核心失效模式,以及验证决策如何通过拒绝→编辑→接受影响真实业务状态,是理解动机与 P2 回归案例的钥匙。