VeriHarness:面向长程任务的可扩展智能体验证框架 VeriHarness: Scaling Agentic Verification for Long-Horizon Tasks
让生成模型化身智能体验证器,用环境证据裁决分歧、挑战共识,大幅提升长程任务质量
前置知识
多次采样与 Best-of-N
对同一任务用带随机性的解码独立采样 $N$ 次,得到一个候选输出池(rollout pool),理论上池中包含正确答案的概率远高于单次采样。Best-of-N 是最朴素的利用方式:用某种打分器(人工、奖励模型或 LLM 评审)给每条候选打分并挑最高分。它把生成难题部分转移为识别难题——前提是存在可靠的验证机制,而这正是长程任务缺失的环节。
本文的验证器输入就是每任务 $N=10$ 条 rollout 的冻结池,全部基线(投票、锦标赛、LLM-as-a-Verifier)都在同一池上做选择,理解这一设定才能读懂对比实验。
LLM-as-a-Judge / LLM-as-a-Verifier
让一个 LLM 阅读任务描述和候选输出,按某种标准打分或排序,从而代替人工评估或奖励模型。它的根本局限在于只利用模型已有信念:评审者通过'阅读'候选来判断好坏,不主动收集外部证据。当评审者与生成者是同一模型且没有更强模型可用时,还会因误差相关而系统性失灵。
本文的基线 LLM-as-a-Verifier 是该范式的最新代表,VeriHarness 的所有改进都建立在对'只读不打'这一范式的批判之上。
智能体框架(Agent Harness)
围绕冻结模型的一层工程封装:提供工作区、工具、记忆和操作循环,把一个不会自主行动的模型变成能持续观察-行动-反思的智能体,即 Generator $=(M, \mathcal{H}_G)$。Gemini CLI、Claude Code、Codex 都是典型的现成框架。框架决定了模型能看到什么信息、能执行什么动作,但不含任务特定知识。
本文的核心类比是把这套构造平移到验证侧:Verifier $=(M, \mathcal{H}_V)$,其中验证框架 $\mathcal{H}_V=(W,\mathcal{T},\Pi,\mathcal{S})$ 是理解方法结构的关键。
同模型验证的困境
已有研究表明:模型无法在没有外部反馈的情况下纠正自己的推理错误;其自检行为大多是确认式的(倾向于确认而非反驳自己);同族模型的 judge 与生成器的误差高度相关,导致打分系统性偏袒。因此在'生成器已是最强模型'的前沿场景,同模型验证被认为天花板很低。
本文正面回应这一困境:论证只要让模型离开'读自己输出'的确认模式、进入'查环境证据'的调查模式,同一模型也能有效验证,这是全文立论的前提。
技能库与经验自进化
以文本形式存储的可复用操作知识:每条技能描述一个通用失败模式及其检查/修复流程,可附脚本,不含任务特定答案。智能体在开发任务上失败后,把失败打包喂给模型提出候选技能,经开发分筛选后入库,模型权重和协议保持不变。这与训练 LoRA/微调不同,知识外置、可审计、可随时增删。
VeriHarness 把验证技能做成可进化的库(第 5 节),展示了固定模型靠失败反馈积累验证能力、甚至超过人类专家手写库的路径。
研究动机
随着 LLM 智能体承担越来越复杂的长程任务,它们产出的报告、电子表格、代码补丁等工件的正确性越来越难核查:检查一份报告需要把论断追溯到来源、重新计算数值、跨多个文件解释需求。代码与数学领域尚有单元测试、可执行检查或形式化证明器提供直接反馈,而一般复杂任务在测试时既没有参考答案也没有评分标准;前沿模型在最新的工作区基准上也无法可靠地产出工件,验证更是难上加难。现有测试时验证方法几乎只利用 rollout 本身:多数投票和 self-consistency 把最常见的答案当作正确,LLM-as-a-Judge 类方法只是阅读候选并打分,都依赖模型已有的信念而不借助环境证据。更关键的是,作者在 APEX-Agents 上用 Claude Opus 4.8 做 10 条 rollout 的案例研究揭示了一个反直觉事实:917 条共识主张($H=0$,十条全票一致)中 34% 被评分标准判为错误,即全票通过也可能集体出错;而在 775 条争议主张($H>0$)中 74% 包含正确候选,但其中最高频答案只有 47% 是对的。这意味着投票既修不掉共识中的错误,也会把争议中本可挽救的正确答案直接丢掉。
本文的目标是本文研究'无更强评审者'设定下的测试时验证:生成器与验证器使用同一个基础模型和同样的工具,验证器在测试时不能访问参考答案、评分标准或外部评分器,任何增益只能来自模型自身的 rollout 池与任务环境本身。在这一受限设定下,目标是尽可能提升交付工件的质量:给定每任务 $N=10$ 条 rollout 的冻结池,验证器要从中选出一个(select)或基于其一修订出一个(revise)最终工件 $r^\star$,使其在外部评分器(验证时不可见)下的得分最大化,同时产出一份把每条主张链接到检查、证据与裁决的验证记录 $C$。作者进一步希望方案训练无关、即插即用,能跨报告、表格、代码等多种工件类型和五个基准复用,并能移植进现成智能体 CLI;最终还要回答一个更根本的问题:验证能力能否不依赖更强模型,仅凭结构、证据和经验积累而增长。
与已有工作不同的是,本文的独特切入有三点。第一,把验证从'读文本'带入'查环境':不再让模型对着候选池打分,而是让验证器像智能体一样在工作区里用源文件、数据和约束主动取证,逐条测试具体主张;此前外部证据的测试时使用基本局限于有可执行测试的代码任务。第二,从 rollout 池的结构本身提取检查目标:用主张熵 $H(\pi_p)$ 把任务相关主张分成共识与争议两类,基于'共识保留错误、分歧暴露正确替代'的实证观察,设计两个互补的检查任务——争议需要裁决、共识需要主动挑战,这是对'分歧即信号'的第一次系统性方法化。第三,把它做成围绕冻结模型的验证框架而非训练出的验证器:与过程奖励模型、训练式 verifier 或只对单个输出打分的方法不同,VeriHarness 不需要任何训练数据,交付的是更好的工件而非一个分数;并且首次让验证技能本身可从失败反馈中进化,是对智能体框架自进化思想在验证侧的落地。
核心方法
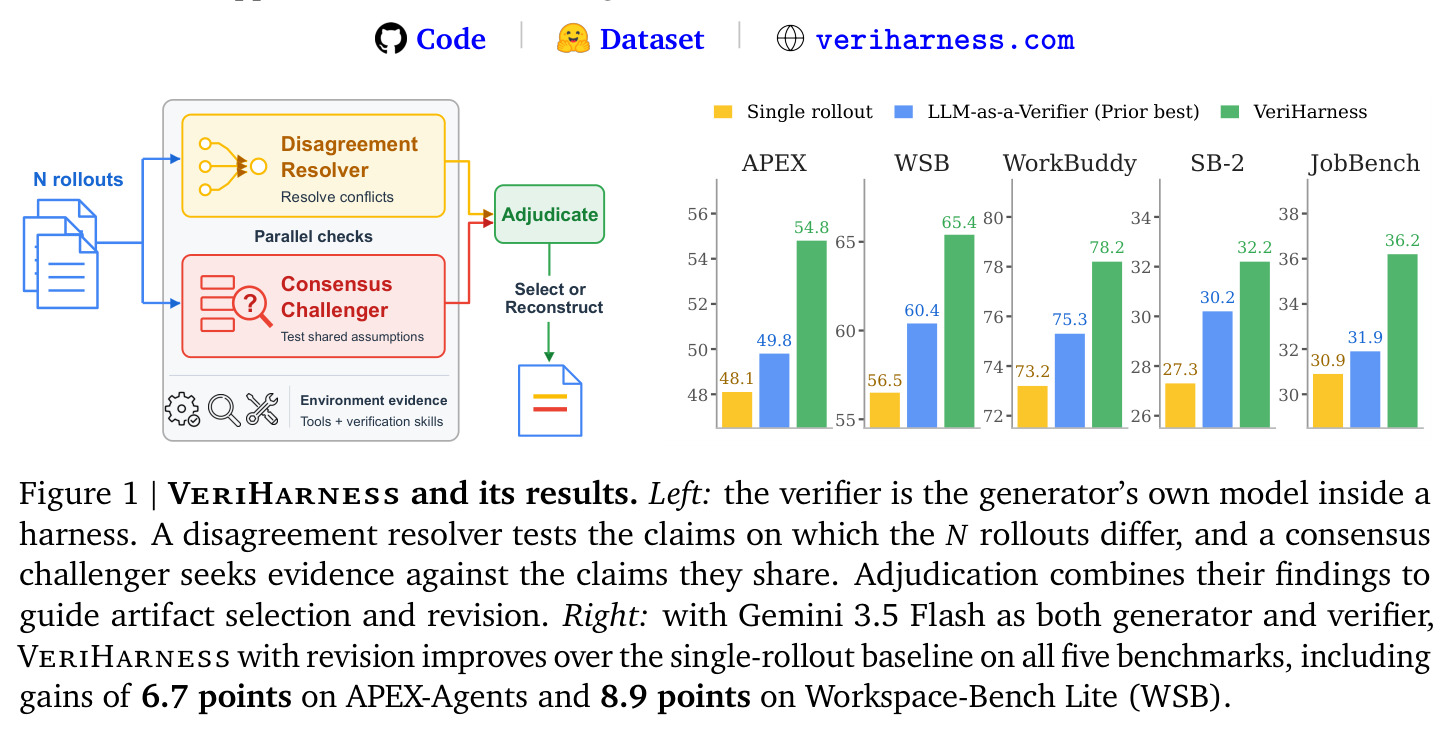
VeriHarness 的直觉:同一模型虽可能犯系统性错误,但多条独立 rollout 间的分歧结构本身就是宝贵的验证信号,而任务环境里还躺着一手证据可以仲裁分歧、推翻共识。技术上它把生成侧的智能体框架构造平移到验证侧:若 Generator $=(M, \mathcal{H}_G)$,则 Verifier $=(M, \mathcal{H}_V)$,其中验证框架 $\mathcal{H}_V=(W,\mathcal{T},\Pi,\mathcal{S})$ 含四部分——把每条 rollout 的工件 $d_i$、最终状态 $w_i$ 和轨迹 $\tau_i$ 连同任务与环境暴露为文件的工作区 $W$;支持追溯来源、重算数值、执行代码的证据工具 $\mathcal{T}$;规定'两个独立调查上下文 + 一个全新裁决上下文'的协议 $\Pi$;以及承载可复用检查知识的技能库 $\mathcal{S}$。运行时,争议解决器与共识挑战者在各自独立上下文并行调查,分别产出证据记录 $L_{\neq}$ 与 $L_{=}$;随后全新上下文的裁决阶段综合两份记录与任务、rollout 池,输出基座 rollout、修订计划和未决主张列表;最后应用修订并连同验证记录交付。由于工作区文件化、协议与工件类型无关,同一框架可直接处理报告、表格和代码,只有技能承载工件特定知识。
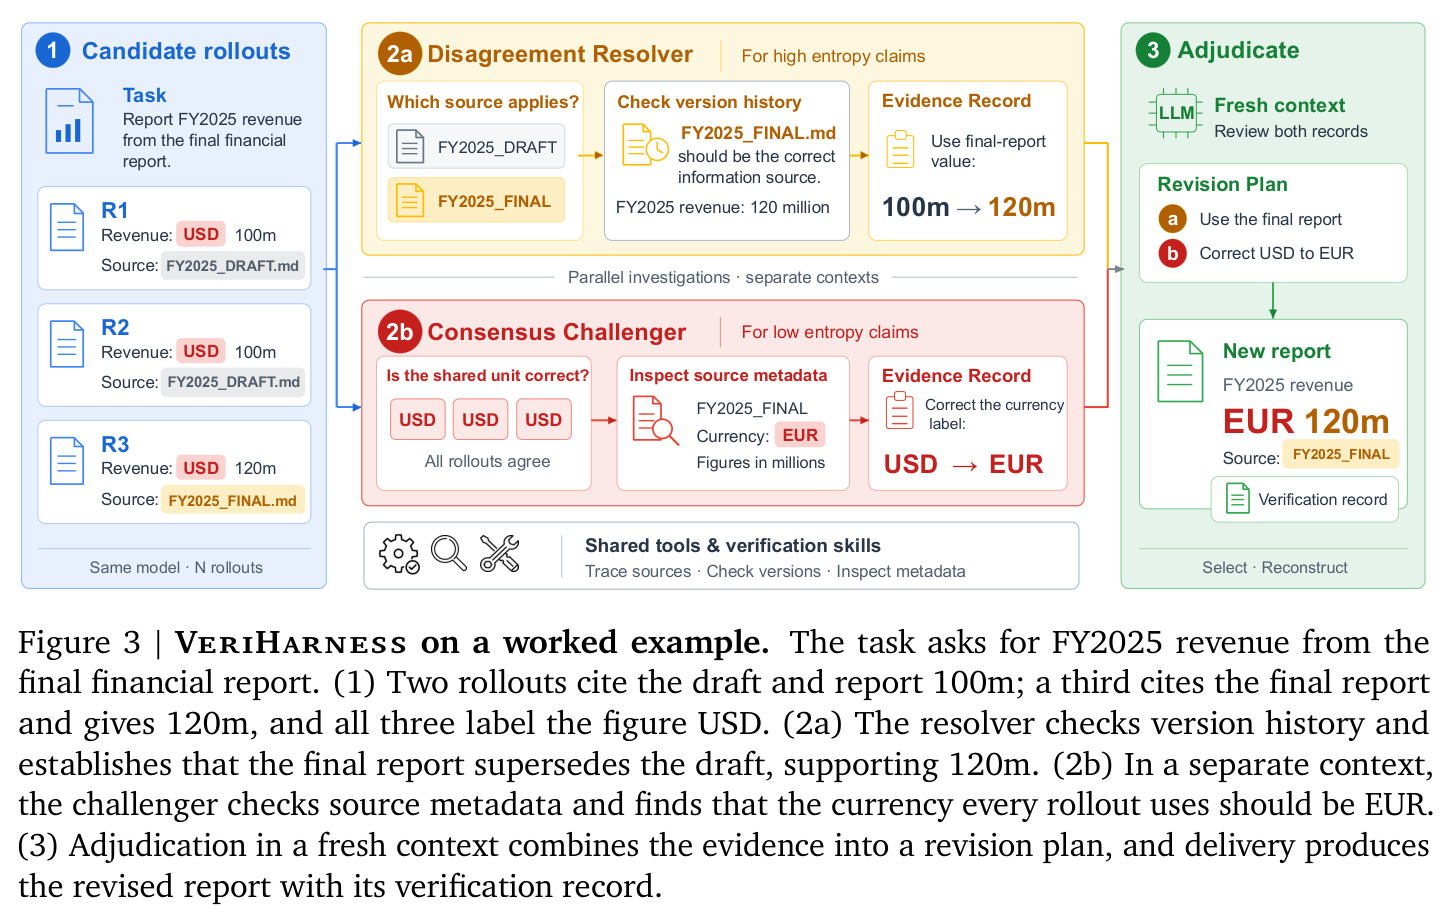
核心创新是用主张熵把验证目标一分为二,并为每类设计针对性的取证策略。对每条任务相关主张 $p$,把 $N$ 条工件给出的答案(等价表述视为同一值,遗漏也视为一个值)组成候选集并计算经验分布与熵 $H(\pi_p)=-\sum_v \pi_p(v)\log \pi_p(v)$:$H=0$ 为共识主张,$H>0$ 为争议主张。争议解决器在有分歧的候选间工作,选择预期信息增益最大的检查(定性估计 $\mathrm{Gain}(\chi)=\mathbb{E}[H(b_p)-H(b_p(\cdot\mid\mathcal{E}(\chi)))\mid e_{<k}]$),依证据剔除矛盾候选,并允许'所有候选皆错'的结论。共识挑战者则相反:没有现成竞争答案,必须先提出'共识值可能怎样错'的假设再逐一测试,按 $\mathrm{Priority}(\chi)=P(\chi\ \text{暴露共识失败}\mid t,R,e_{<k})$ 定性排序,覆盖共识数值(重算)、共识读法(对照源文件)和共识遗漏(对照任务要求)三类。与多数投票、LLM-as-a-Judge 的本质区别:后者只利用模型已有信念对候选排序,而 VeriHarness 让模型在环境中主动取证,并专门攻击'全票通过'的部分——正是投票永远修不掉的那 34% 共识错误。
方法步骤详情
流程分六步。第一步采样:生成器对任务 $t=(s,\mathcal{E})$ 独立采样 $N=10$ 次得到池 $R=\{r_i\}$,每条含工件 $d_i$、最终工作区状态 $w_i$ 和动作轨迹 $\tau_i$。第二步主张解析:把所有工件对齐到共同问题/需求维度 $p$,归并等价答案得到候选分布 $\pi_p$ 并计算熵,划分共识与争议主张。第三步争议解决(2a):在独立上下文中,解决器把竞争候选追溯到各自来源与计算(如查文件版本历史确认哪份报告是最终版),挑选最能区分候选的检查,依式 (4) 剔除与证据矛盾的候选;若证据推翻全部候选且能确立新值则记录新值,证据不足则保持未决,产出证据记录 $L_{\neq}$。第四步共识挑战(2b):另一独立上下文中,挑战者对共识数值从原始输入重算、把标签与源元数据对照(如货币 USD 应为 EUR)、对共识读法核对任务指名的文件与期间、并对照任务描述找出所有 rollout 都遗漏的需求,产出 $L_{=}$。第五步裁决:全新上下文的同一模型不继承调查历史,审阅 $(L_{\neq},L_{=},t,R)$ 输出 $(\text{base},\text{revision\_plan},\text{unresolved})=A(L_{\neq},L_{=},t,R)$,base 取证据支持缺陷最少者。第六步交付:仅选择模式原样返回 base;完整模式应用修订计划得 $r^\star=\mathrm{Apply}(\text{base},\text{plan},\text{unresolved})$,并输出验证记录 $C$,每条主张链接检查、证据与裁决,未决主张保留双读。
技术新颖性
新颖性体现在四个层面。其一,这是首个面向长程工作区任务的智能体验证框架:此前的测试时扩展停留在投票、锦标赛、聚合代理或对池内候选打分,外部证据的使用局限于有可执行测试的代码任务,VeriHarness 首次把环境取证推广到报告、表格等无可执行检查的领域,并让最终交付物是工件而非分数。其二,'用 rollout 结构决定检查什么':分歧与共识不被当作统计信号做投票,而被转化为两类互补、各有明确取证策略的检查任务;消融显示两通道增益互补(Opus 上解决器单独把平均分从 49.6 提到 54.3,挑战者单独到 52.6,合并 56.1),且合并到单一上下文反而损失 0.8 分,支持分上下文设计。其三,训练无关、即插即用:技能是简短文本加可选脚本,不改模型权重与协议即可跨五个基准、两个前沿模型复用,还能塞进 Gemini CLI、Claude Code、Codex 等现成框架。其四,验证技能本身可进化:从空库或人工库出发,靠开发集失败反馈迭代出更具体的检查(95 条进化检查中 5 条重述人类检查、48 条将其具体化、42 条全新),并在两个基准的 held-out 子集上超过人工手写库。
实验结果
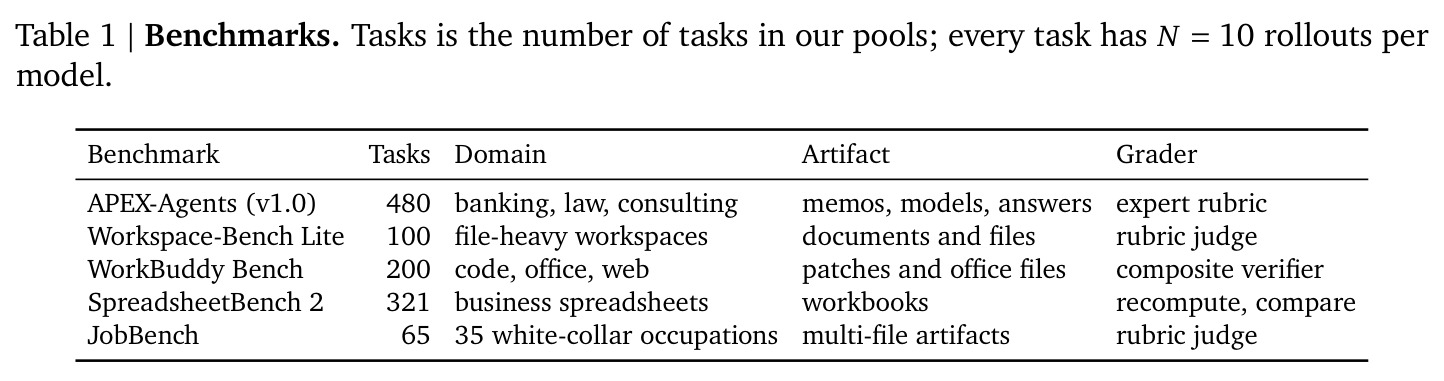
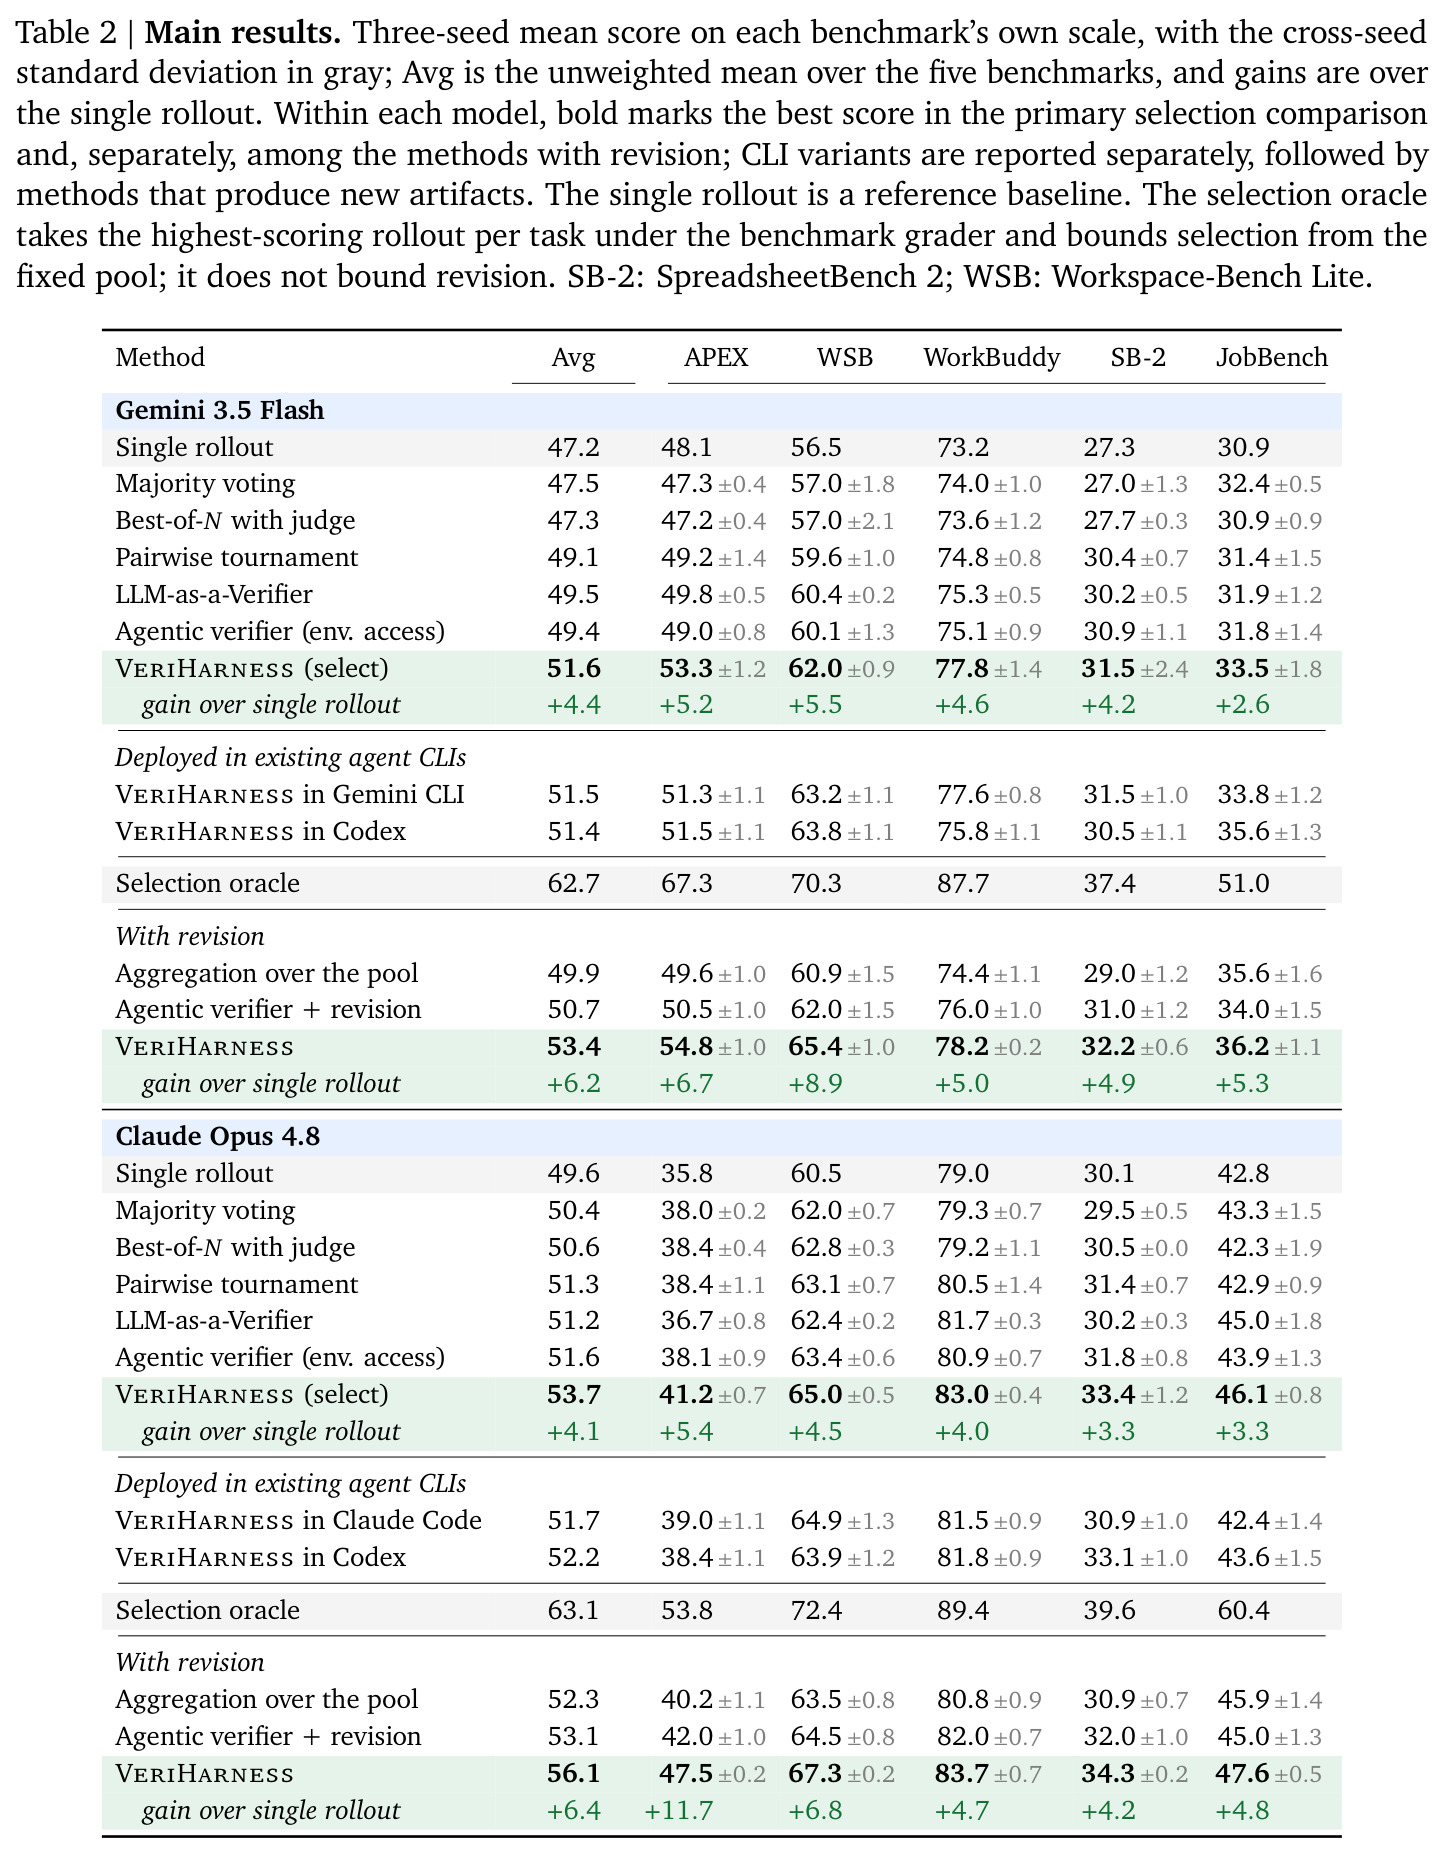
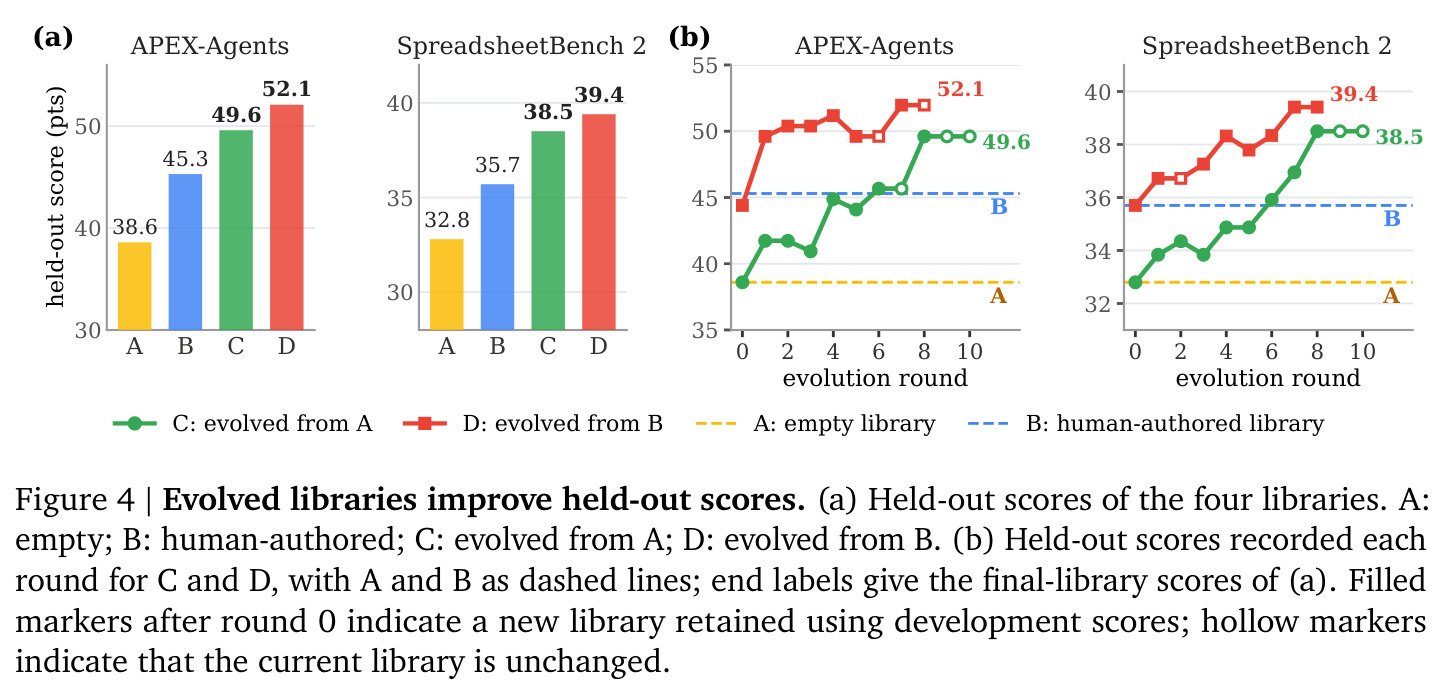
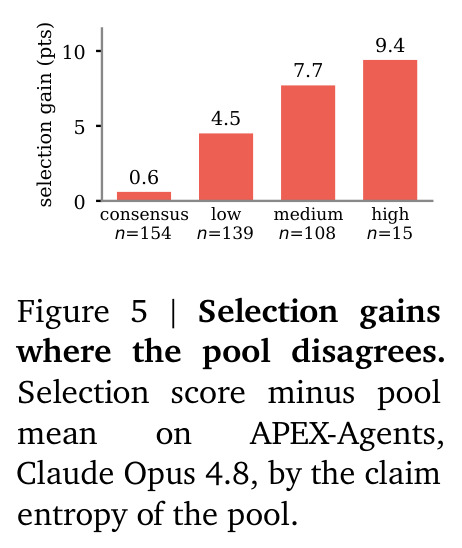
主实验覆盖五个长程工作区基准(APEX-Agents 480 任务、Workspace-Bench Lite 100、WorkBuddy 200、SpreadsheetBench 2 321、JobBench 65)与两个前沿模型(Gemini 3.5 Flash、Claude Opus 4.8,均兼任生成与验证),每方法共享同一 $N=10$ rollout 池,报告三次运行均值。选择阶段:VeriHarness (select) 五基准平均分 Flash 从单 rollout 的 47.2 提到 51.6(+4.4),Opus 从 49.6 提到 53.7(+4.1),在全部 10 个模型×基准组合上都超过多数投票(仅 +0.3/+0.8)、Best-of-N、成对锦标赛、LLM-as-a-Verifier 与仅有环境访问的 agentic verifier(后者只恢复约一半增益,说明协议与技能才是关键)。加入证据支持修订后平均增益升至 +6.2(Flash,53.4)与 +6.4(Opus,56.1),10/10 组合全部提升,最大单项为 Opus 的 APEX +11.7(35.8→47.5)与 Flash 的 WSB +8.9(56.5→65.4);纯池聚合改写(49.9/52.3)始终更低,证明增益来自证据记录而非改写本身。协议移植进 Gemini CLI/Codex 后 Flash 下差距在 2 分内,但 Opus 在 JobBench 上退回基线水平。选择 oracle 上限 62.7/63.1,仍有约 9 分空间。分析:争议池选择增益 +6.1 分而共识池仅 +0.6,增益随熵升高(低熵 +4.5、中熵 +7.7、高熵 9.4);挑战者从未推翻全对主张,但放过的共识错误约 70% 是查了正确的中间步骤。自进化(held-out 子集):空库 A(APEX 38.6/SB-2 32.8)进化出的库 C 达 49.6/38.5(+11.0/+5.7)且超过人工库 B(45.3/35.7);从 B 进化的 D 再加 6.8/3.7 分。全部约 26,000 条 rollout(成本超 10 万美元)已开源。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 五基准平均(Gemini 3.5 Flash,含修订) | 各基准原生评分的三次运行均值 | 53.4(VeriHarness) | 47.2(单次 rollout)/ 49.5(LLM-as-a-Verifier) | +6.2 / +3.9 |
| 五基准平均(Claude Opus 4.8,含修订) | 各基准原生评分的三次运行均值 | 56.1(VeriHarness) | 49.6(单次 rollout)/ 51.2(LLM-as-a-Verifier) | +6.4 / +4.9 |
| APEX-Agents(Opus 4.8,含修订) | 专家评分标准得分 | 47.5 | 35.8(单次 rollout)/ 36.7(LLM-as-a-Verifier) | +11.7 / +10.8 |
| Workspace-Bench Lite(Flash,含修订) | 评分 judge 得分 | 65.4 | 56.5(单次 rollout)/ 60.4(LLM-as-a-Verifier) | +8.9 / +5.0 |
| WorkBuddy Bench(Flash,含修订) | 复合验证器得分 | 78.2 | 73.2(单次 rollout)/ 75.3(LLM-as-a-Verifier) | +5.0 / +2.9 |
| SpreadsheetBench 2(Flash,含修订) | 重算比对得分 | 32.2 | 27.3(单次 rollout)/ 30.2(LLM-as-a-Verifier) | +4.9 / +2.0 |
| JobBench(Flash,含修订) | 评分 judge 得分 | 36.2 | 30.9(单次 rollout)/ 31.9(LLM-as-a-Verifier) | +5.3 / +4.3 |
| APEX-Agents held-out(Opus,技能自进化) | 专家评分标准得分 | 49.6(空库进化)/ 52.1(人工库进化) | 38.6(空库)/ 45.3(人工库) | +11.0 / +6.8 |
| SpreadsheetBench 2 held-out(Opus,技能自进化) | 重算比对得分 | 38.5(空库进化)/ 39.4(人工库进化) | 32.8(空库)/ 35.7(人工库) | +5.7 / +3.7 |
局限与改进
作者明确承认的局限包括:其一,验证依赖每任务 10 条 rollout 的池,这是测试时扩展的标准预算(所有基线同等成本),但生成池本身昂贵——本项目 26,000 条 rollout 花费超过 10 万美元,实际部署中对每个任务采 10 条长程智能体运行的开销不低。其二,框架不给每条 rollout 输出标量分,只交付工件加验证记录,因此无法直接当奖励信号使用,把逐主张判定转成校准的 rollout 级分数留待未来。其三,严格限制在'验证器=生成器'的同模型设定,更强验证器的额外收益与本框架贡献混在一起、未做分离。其四,验证是多轮调查,增加墙钟时间,只适合质量重于时延的专业交付场景。我的补充观察:共识挑战者的盲区有结构性原因——验证器倾向于在 rollout 停下的地方停下,突破盲区依赖技能库注入的先验知识,意味着全新领域的首轮验证质量可能明显低于有成熟技能库之后;技能进化需要带评分器反馈的开发集,与'测试时无评分标准'的设定形成张力;另外熵只是用一致性近似'可检查性',共识池上仅 +0.6 分说明框架对全票错误的池基本无能为力。
独立分析的弱点
第一,成本结构偏向大玩家:主结果建立在每任务 10 条长程 rollout 之上,验证还要多轮取证加一轮修订,单任务端到端成本可能超出普通调用几个数量级;改进方向是学习'何时值得验证'的置信度门控,或先用小模型筛掉高置信正确的任务。第二,共识池上几乎没有增益(+0.6 分),池全错时框架只能靠技能库先验猜该查哪里,而放过的错误中约 70% 是查了正确的中间步骤;改进方向是把'生成失败假设'做成显式搜索,让模型基于工件类型自动提出对抗性检查清单。第三,选择分数距 oracle 仍有约 9 分差距(Opus:53.7 vs 63.1),可在裁决阶段引入多轮辩论或对未决主张做第二轮定向取证。第四,CLI 移植在部分组合失效(Opus 的 JobBench、Claude Code 的 SB-2 退回基线),提示协议对宿主智能体的工具实现与上下文管理有隐性依赖;应把验证协议做成与宿主解耦的标准化接口并报告取证覆盖率。第五,技能进化仅在两个基准、约 3:1 开发/测试切分下验证,跨域泛化未知;建议加入跨基准迁移实验检验技能是否过拟合于特定评分习惯。
未来方向
作者提出的方向:把验证记录当作 claim 级监督信号训练长程智能体——每条主张都链接检查、证据与裁决,天然构成'哪些生成行为可信'的细粒度反馈,可用于构造过程奖励或偏好数据;把逐主张判定转成校准的 rollout 级分数(例如作为强化学习的奖励);以及研究更强验证器设定下分离框架贡献与模型能力差距。基于本文成果还可延伸:一是'验证前置',把技能库中的检查在生成阶段注入(让生成器自我约束),比较事后验证与生成时约束的成本收益;二是层次化验证,对工件先做粗粒度风险评分、再对高风险主张深度取证,把固定验证开销变成自适应预算;三是把 26,000 条开源 rollout 与验证记录组合成'验证轨迹'数据集,训练专门的取证策略模型,可能比同模型提示更高效;四是在辩论、多智能体分工等协作场景中检验争议解决器能否扩展为跨模型仲裁;五是研究技能库的持续学习与遗忘问题,避免进化技能过拟合于近期任务分布。
复现评估
复现条件相当好但成本不低。开源方面:作者放出全部五个基准、两个模型共约 26,000 条 rollout 池(超过 10 万美元的生成成本),代码与数据集见 veriharness.com,研究者无需自己生成池即可直接复现选择与修订实验,这是同方向工作中少见的完整开源;人工技能库与工具在附录 H 全文公开,协议、技能均为文本。现实门槛有二:一是主实验使用 Gemini 3.5 Flash 与 Claude Opus 4.8 的 thinking level high,每设置重复 3 次独立验证运行,复现完整主表仍需可观 API 预算;二是技能进化实验依赖带评分器反馈的开发集和约 3:1 的开发/测试切分,进化筛选本身需要多轮完整验证。对预算有限的复现者,建议先用开源 rollout 复现选择阶段(无需跑生成器),再在最小的 JobBench(65 任务)上以较小代价运行进化循环验证自进化结论。整体而言核心协议是训练无关的提示工程加工具调用,工程量中等,真正门槛在推理预算而非实现难度。
论文图表
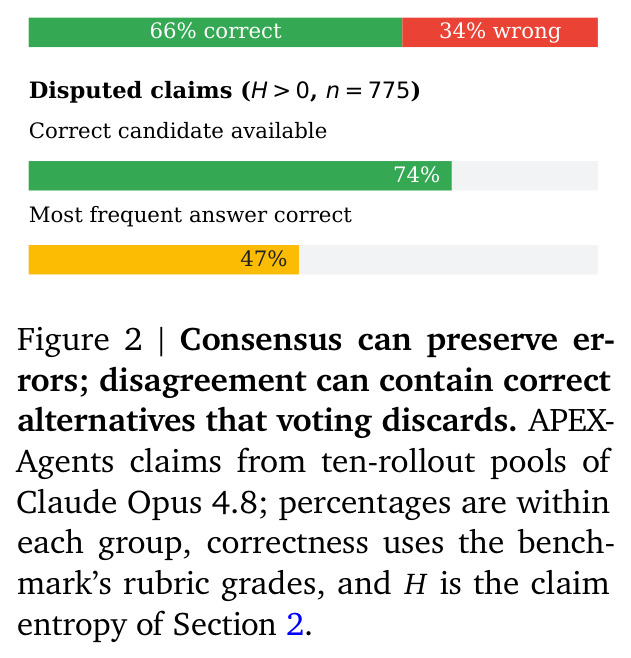
案例研究统计图,分两组:共识主张组($H=0$,n=917)中全票一致的答案只有 66% 正确、34% 错误;争议主张组($H>0$,n=775)中 74% 包含正确候选,但其中最高频答案仅 47% 正确。两组数据共同说明:多数投票既无法修复共识错误,也会丢弃争议中的正确答案。
这是全文的动机基石:两个关键百分比(34% 共识错误率、74% 争议含正确候选)直接推导出'争议需要裁决、共识需要挑战'的方法设计,理解了这张图就理解了论文为什么这样做。