SolarRenderer:少步生成式结构参考视频渲染 SolarRenderer: Few-Step Generative Reference Rendering
冻结33B视频骨干,双LoRA实现任意结构输入的4步渲染,泛化到11种未见结构表示
前置知识
RoPE(旋转位置编码)
把 token 的多维位置坐标(时间 $t$、高 $h$、宽 $w$)编码进注意力 query/key 的相位角,使注意力得分只依赖两 token 坐标的相对差。因此只要把参考 token 的坐标设成它所描述目标帧的坐标,两者注意力就自动逐帧对齐,不需要任何额外模块或显式对应监督。
本文的帧对齐条件化完全靠 RoPE 实现——结构 latent 直接占用目标帧的 RoPE 坐标,这是单个控制 LoRA 能泛化到任意结构的机制核心;消融也证明共享位置优于独立位置。
LoRA(低秩适配)
把权重更新写成低秩分解 $\Delta W=\frac{\alpha}{r}BA$,只训练两个小矩阵,冻结原权重 $W_0$。开销小,多个 LoRA 可叠加($W=W_0+\Delta W_{\rm ctrl}+\Delta W_{\rm acc}$),还能与同基座预训练的其他 LoRA 直接组合。
SolarRenderer 全程冻结 33B 骨干,只加控制 LoRA(rank 384)与加速 LoRA(rank 384,其中 128 秩继承自预训练 DMAD),理解 LoRA 的叠加与初始化是读懂两阶段训练的前提。
流匹配(Flow Matching)
扩散类生成模型的训练目标:在噪声坐标 $t$ 处构造插值路径 $z_t=(1-t)z_0+t\epsilon$,让网络预测速度场 $(\epsilon-z_0)$;采样时沿学到的速度场积分即可生成,是现代视频扩散模型的主流训练范式。
Stage 1 控制 LoRA 用的就是骨干原生流匹配目标;Stage 2 蒸馏的教师也建立在这一参数化上,不看懂这个损失就看不懂整个训练流程。
分布匹配蒸馏(DMD)
让少步学生模型的输出分布直接逼近教师分布:另训一个『假 score』模型拟合学生样本的分布,用(真教师 score − 假 score)之差作为梯度更新生成器。它不做逐样本回归,因而能保留教师分布的多样性与锐度,代价是需要额外 score 网络和多次更新。
Stage 2 的加速正是在 DMD 框架上做的;本文的核心创新『结构引导的教师外推』修改的就是教师 score 的计算方式。
无分类器引导(CFG)
采样时用条件预测与无条件预测之差放大条件的影响:$\hat z=\hat z(C)+w\,\big(\hat z(C)-\hat z(C_\emptyset)\big)$,$w>1$ 使输出更贴合条件但可能过饱和。传统上作用于文本条件。
本文把 CFG 式外推第一次用在『结构条件』上——只移除结构 token、保留首帧与文本——得到比教师更锐利、更贴结构的蒸馏目标,是方法最关键的一步。
原生参考通路(Ref2VA)
MiniMax-H3 这类多任务视频骨干把文本、参考视频/图像、音频和目标视频统一拼进一条单流全注意力序列:参考 token 占据目标片段之前的独立时间段和自己的空间网格,骨干在预训练中已学会『读参考视频』。
SolarRenderer 不加 ControlNet 分支,而是让结构视频冒充『参考视频』走这条原生通路,控制 LoRA 因此能继承预训练的参考阅读能力——这是整个方法零新增模块的基础。
研究动机
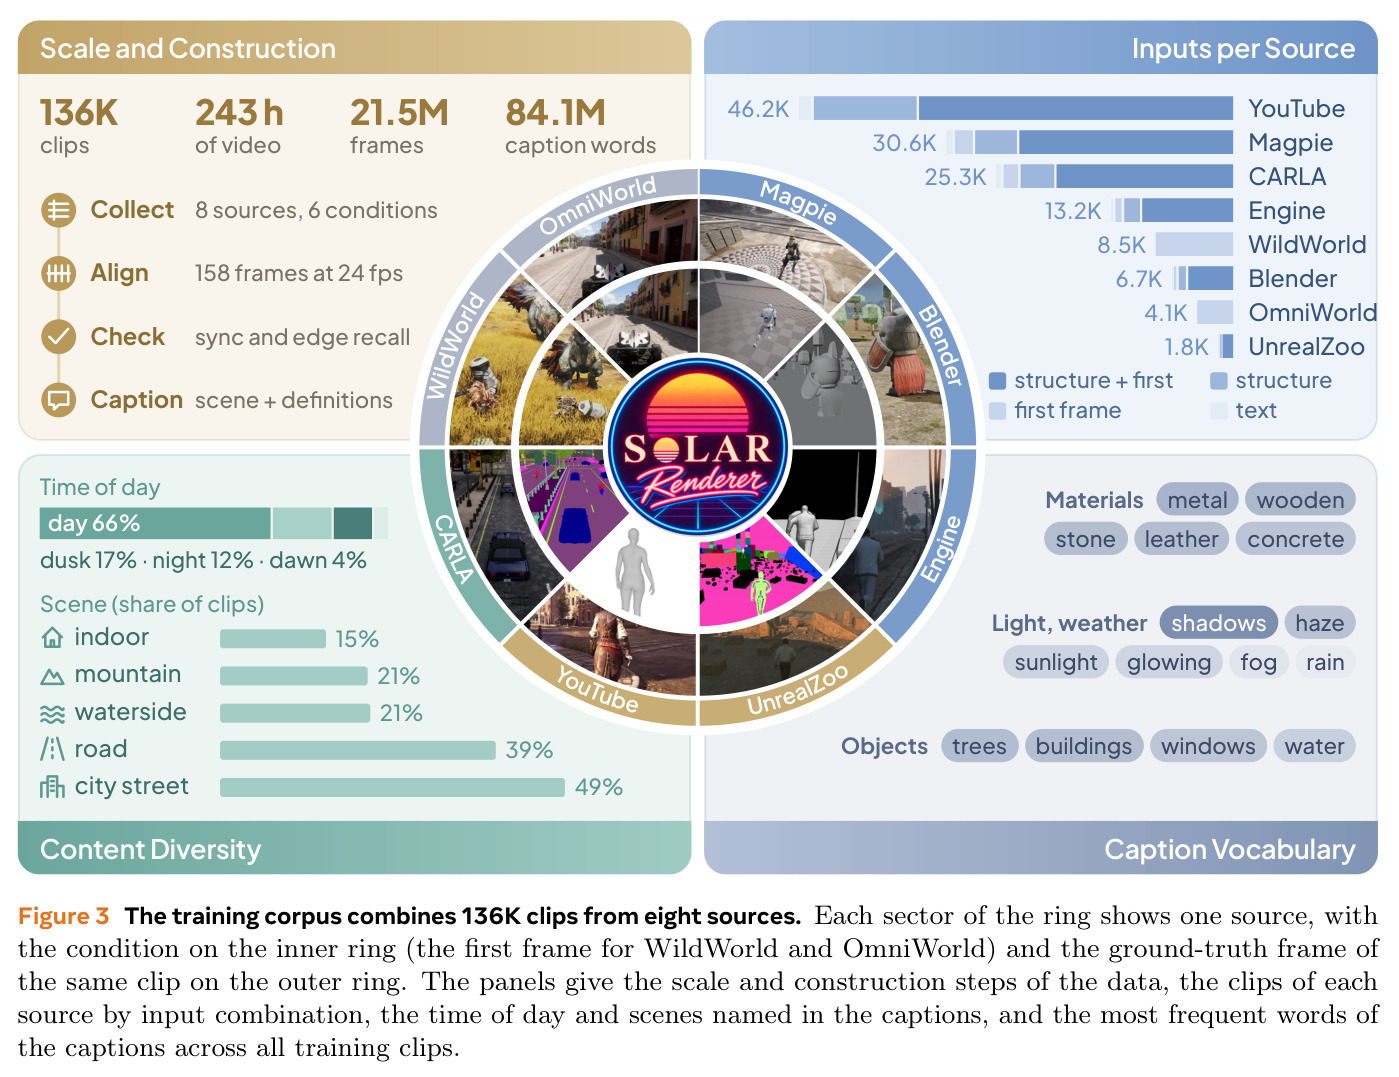
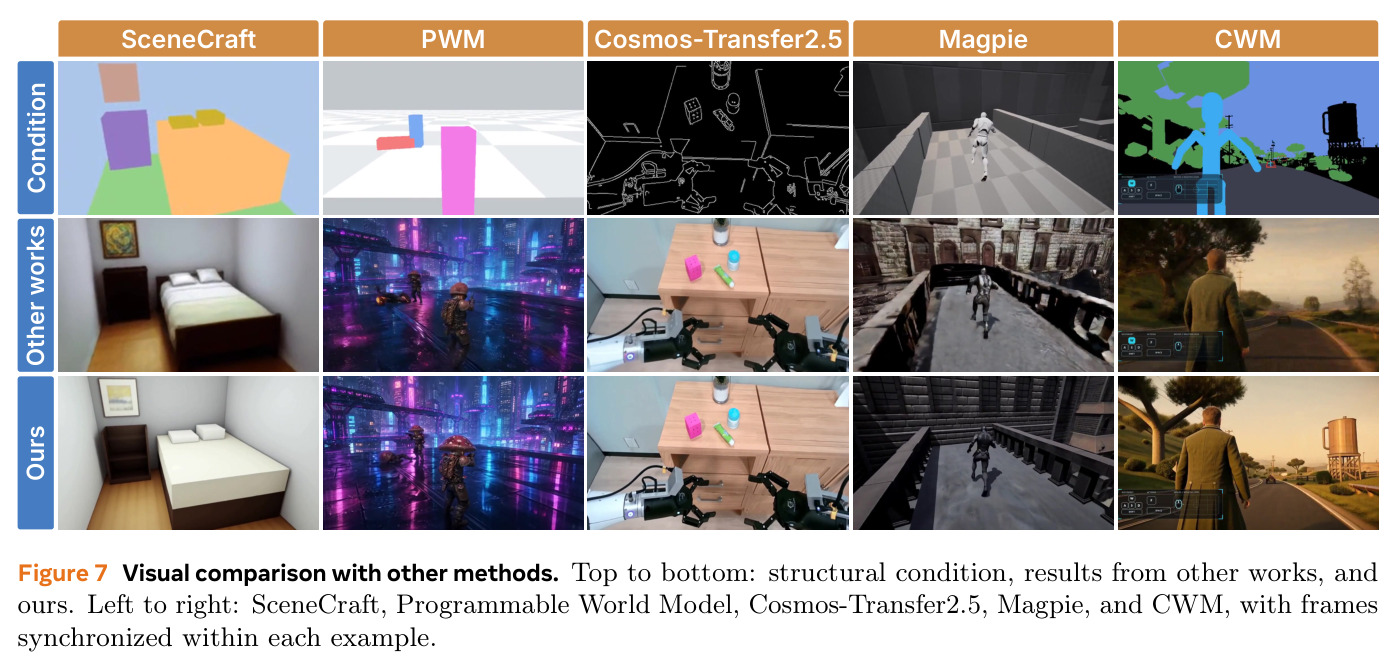
游戏引擎和编程 agent 已能精确指定场景布局、物体运动和相机轨迹:设计师搭白盒、动画师调关键帧、coding agent 脚本化相机路径,把这类粗结构变成逼真视频就成了『渲染』问题。但现有方案有三个具体毛病。一是控制绑定表示:Magpie 只吃自家引擎的白盒帧,StreamRender-H3 只认赛车游戏语义图,Streaming CWM 只支持 CARLA 代理视频,Cosmos-Transfer2.5 绑定特定控制视频格式——换引擎或新增一种代理就得重训一个新模型;通用可控生成器则要么每种条件挂一个 ControlNet 分支(PAI ControlNet-Union),要么给每个输入打类型标签(LynnReal-Omni),条件集合固定。二是慢:33B 级骨干 50 步采样一个 158 帧片段要 2562 秒,而从零蒸馏这种规模的结构条件模型成本高且不稳定,离交互使用很远。三是训练数据帧级不对齐:从真实视频估计的深度、分割带有估计器误差,与测试时引擎代理分布不一致;WildWorld 的框标注甚至和帧对不上,错位监督会教模型『放松』对结构的跟随。
本文的目标是做一个通用结构条件视频渲染器:给定任意来源的结构视频 $S$(灰盒布局、语义分割图、深度着色、物体掩码+骨架、SMPL 人体网格等)、可选首帧 $I$ 和文本 $c$,建模 $p_\theta(V\mid S,I,c)$,输出逐帧跟随结构、并补全材质/光照/细节的真实视频。量化目标三条:(1) 一个模型加轻量适配器覆盖任意结构表示,包括 11 种训练从未见过的格式(铅笔分镜、蜡笔画、线框、点云、体素等),新格式只需改一句文字描述,不加参数、不重训;(2) 4 步去噪完成渲染,比 50 步采样快 12.3 倍(209 秒 vs 2562 秒/158 帧片段),并有块因果变体实现 768p 实时流式渲染(最高 28 FPS);(3) 语料中每个结构帧与目标帧在内容和时间上严格对齐,并把『对齐』变成可自动检验的数据流程。
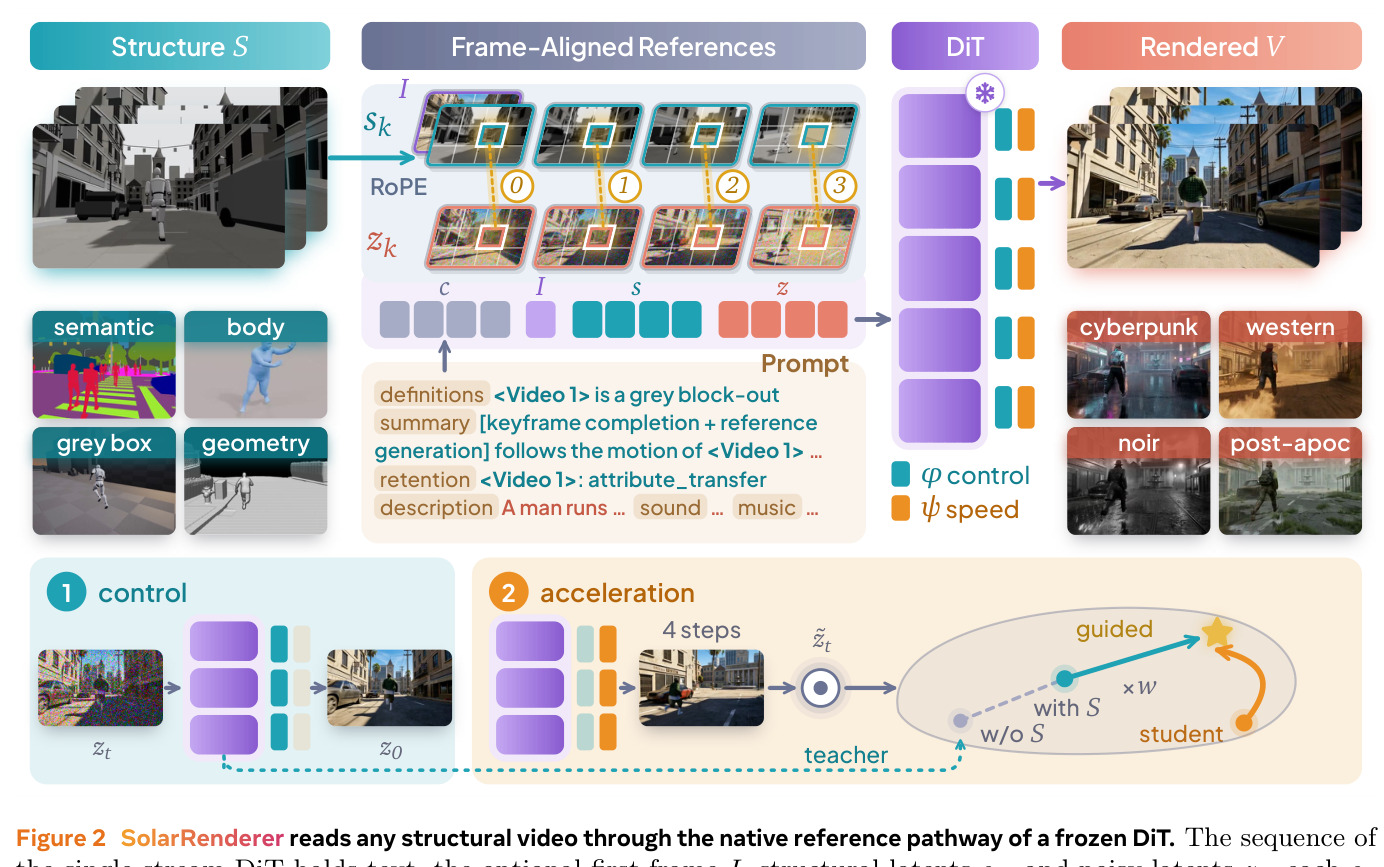
与已有工作不同的是,切入角度是把『帧级对应』全部编码进位置和文本,而不是网络结构。已有方法靠新增分支或类型嵌入承载条件语义;本文发现骨干的原生参考通路本来就会读视频,缺的只是『参考第 $k$ 帧对应目标第 $k$ 帧』这一对应关系——于是让结构 latent 直接占据它所描述目标帧的 RoPE 坐标 $(t,h,w)$,类型信息完全交给固定句式的开放词表文本(一句定义 + 一句属性跟随规则),把『支持新表示』从工程问题降级为提示词问题。第二个独特角度在加速:不从零蒸馏,而是在冻结的控制模型上后训练一个现成的 4 步 LoRA,并用『沿结构条件外推的教师』修正分布匹配蒸馏——因为普通 DMD 会把学生往模糊的全步教师拉回去。第三个角度在数据:提出时间互相关峰值偏移 + 条件边缘召回 vs 镜像对照的双重对齐检验,从源头保证『目标真的跟随结构』,并发现去掉错位结构比堆数据量更有效。
核心方法
直觉上,33B 级视频骨干已含强大外观先验,渲染缺的只是『听懂结构』的能力,故骨干全程冻结,只加两个轻量 LoRA。技术路线四步:(1) 结构视频与首帧走 MiniMax-H3 33B Ref2VA 的原生参考通路,文本、参考、目标 latent 拼成一条单流全注意力序列;第 $k$ 个结构 latent 帧共享第 $k$ 个目标 latent 帧的 RoPE 坐标 $(t,h,w)$,首帧编码为 index 0 的静态片段;prompt 用两句固定话描述每种表示(定义句 + 属性跟随/不可见属性句)。(2) Stage 1 用流匹配目标训练 rank-384 控制 LoRA $\phi$,得到会跟随结构的 50 步模型。(3) Stage 2 冻结 $\phi$,把预训练 DMAD 4 步 LoRA(rank-128 扩到 rank-384)作加速 LoRA $\psi$,用结构引导的分布匹配蒸馏后训练 800 步。(4) 块因果变体把同一设计搬到块因果注意力(块 ≤5 latent 帧)加流式 VAE 解码,实现逐块实时输出。
核心创新有三处,共同点是『不加结构』。第一,无类型、帧对齐的参考条件化:不像 ControlNet 加分支、不像 LynnReal-Omni 打类型标签,结构 token 不带类型嵌入,靠 RoPE 位置建立帧级对应、靠固定文本句式说明语义,同位置 token 靠 timestep 区分。控制 LoRA 因此无法过拟合到特定格式,只能学会『从占据目标帧位置的任何东西里读出布局与运动』,这是它泛化到 11 种未见表示的根源。第二,结构引导分布匹配:全步教师采样偏糊,普通 DMD 会把 4 步学生往模糊目标拉(无引导使起点 1024→820);本文对教师做 CFG 式结构外推 $\hat z_0^{w}=\hat z_0(C)+(w-1)(\hat z_0(C)-\hat z_0(C_\emptyset))$,$C_\emptyset$ 只移除结构 token、保留首帧与 prompt,差值恰隔离出结构贡献,$w=1.5$ 时学生被推向比教师更锐利、更贴结构的目标。第三,两阶段解耦:联合训练时加速目标一旦更新控制适配器就破坏结构跟随,故先训完 $\phi$ 再冻结,只更新 $\psi$。
方法步骤详情
Stage 1:在注意力与 FFN 投影加低秩更新 $\Delta W_{\rm ctrl}=\frac{\alpha}{r}BA$(rank 384),用流匹配目标训练 38,400 步,损失只算目标 token,得 50 步控制模型。Stage 2:冻结 $\phi$;$\psi$ 由 DMAD rank-128 四步 LoRA 初始化为 rank-384;教师为冻结的 Stage 1,另训 rank-128 fake-score LoRA,按 $\nabla_\psi\mathcal{L}\propto\frac{\partial G}{\partial\psi}(s_{\rm fake}-s_{\rm teacher})$ 更新 $\psi$,教师 score 用结构外推($w{=}1.5$),两类更新按 5:1 交替共 800 步,得 4 步渲染模型。因果变体:先用 teacher forcing 把控制 LoRA 改成块因果版并冻结,再在学生自身 rollout 上后训练因果加速 LoRA;推理时每块 4 步采样即输出,配流式 VAE 达 768p、28 FPS。
技术新颖性
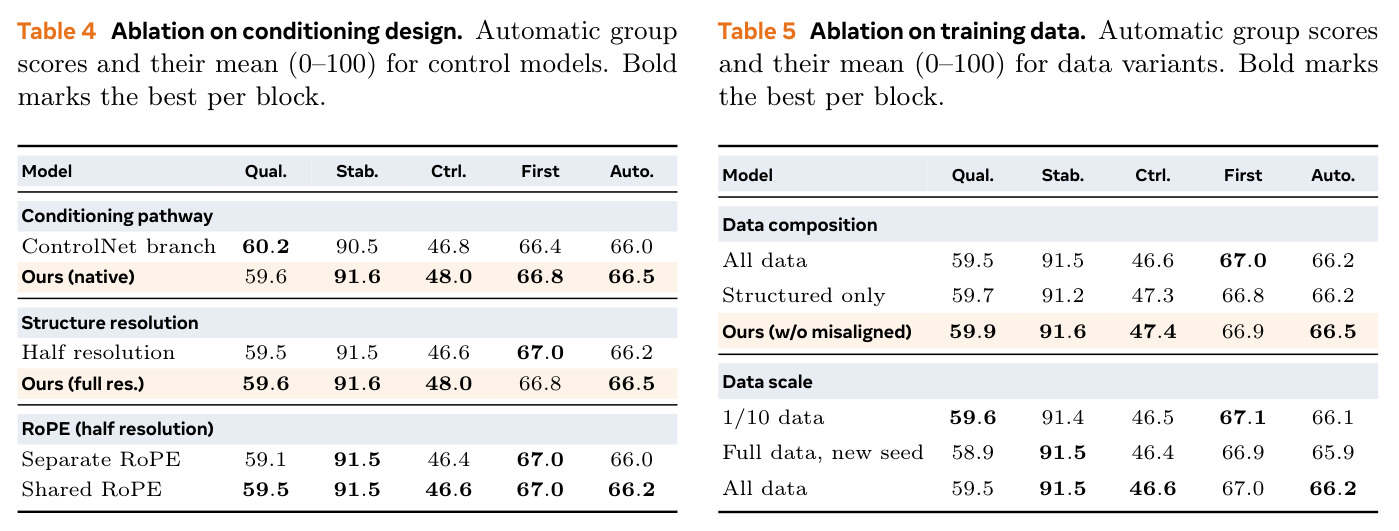
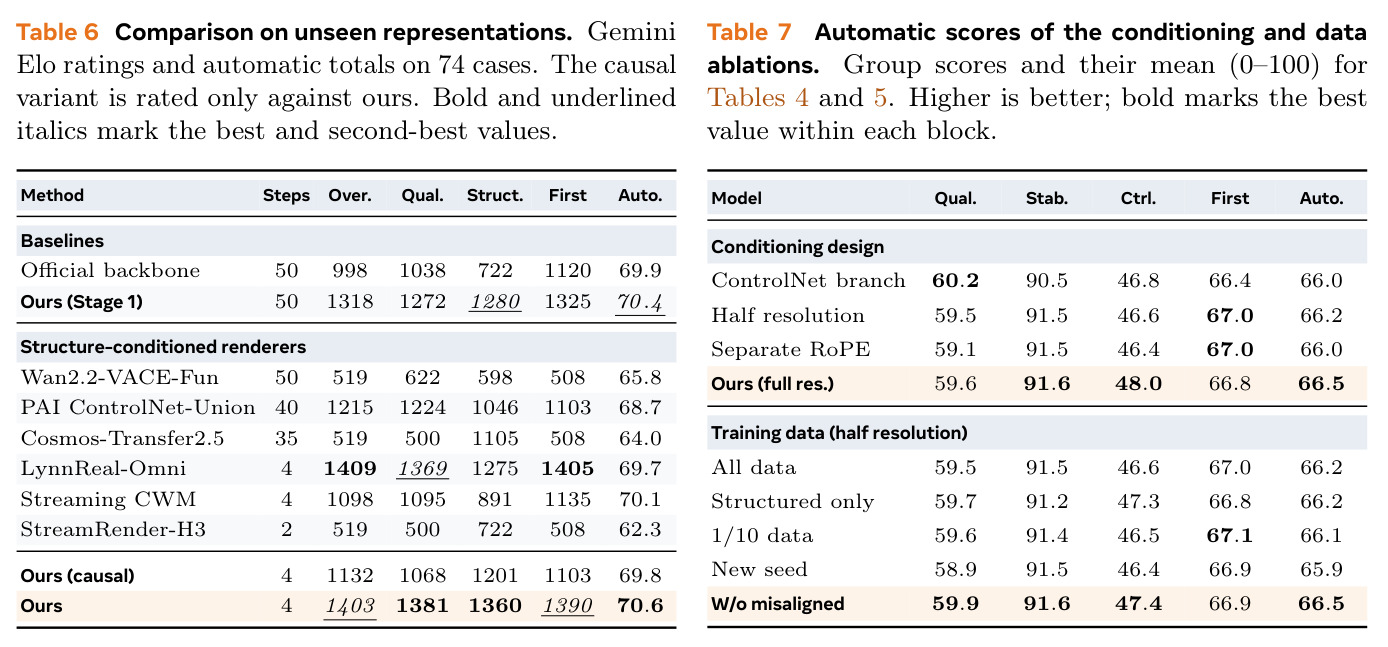
与三条已有路线对照可见其新颖性。对照分支式条件化(ControlNet/PAI Union):分支从零训练且每条件一套;本文零新增模块,复用骨干预训练的参考阅读能力,消融显示原生通路结构分 48.0 高于 ControlNet 分支的 46.8,全分辨率读结构再从 46.6 升到 48.0。对照类型标签法(LynnReal-Omni):标签让适配器按类型特化,新类型无标签可用;本文开放词表文本加位置对齐使『描述新格式』只需两句话,未见表示上结构 Elo 1360 对 1275。对照少步蒸馏:常见做法是蒸馏条件模型本身或蒸馏后重调控制模块,从零蒸馏 33B 模型昂贵且不稳;本文证明『冻结控制模型 + 后训练现成加速 LoRA + 教师结构外推』这条捷径可行——仅 800 步迭代就把 DMAD 组合从 1006 提到 1096(统一拟合),且教师外推是 CFG 在结构条件(而非文本)上的新用法,把加速从『损控制』变成『提控制』。数据侧『对齐比数量重要』(1/10 数据各指标变化不超过 0.2,小于换随机种子的波动;去掉错位结构反而 66.2→66.5)也是对社区数据实践的明确反直觉信号。
实验结果
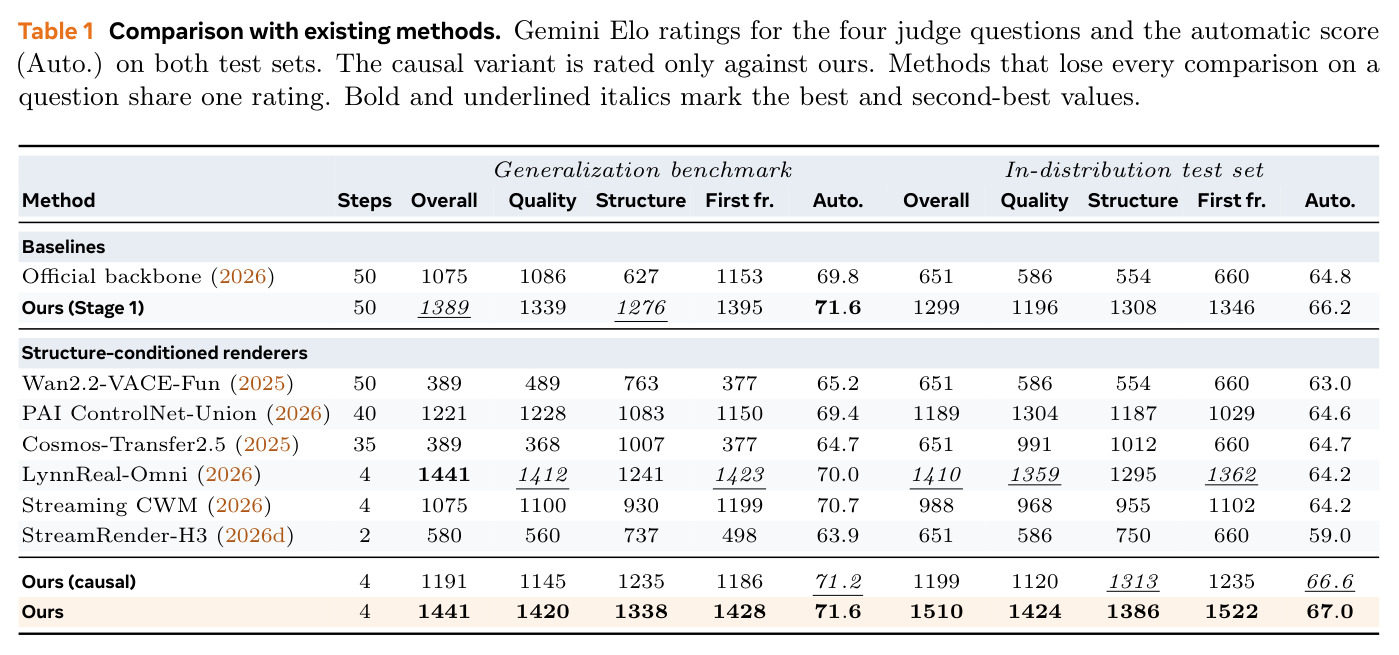
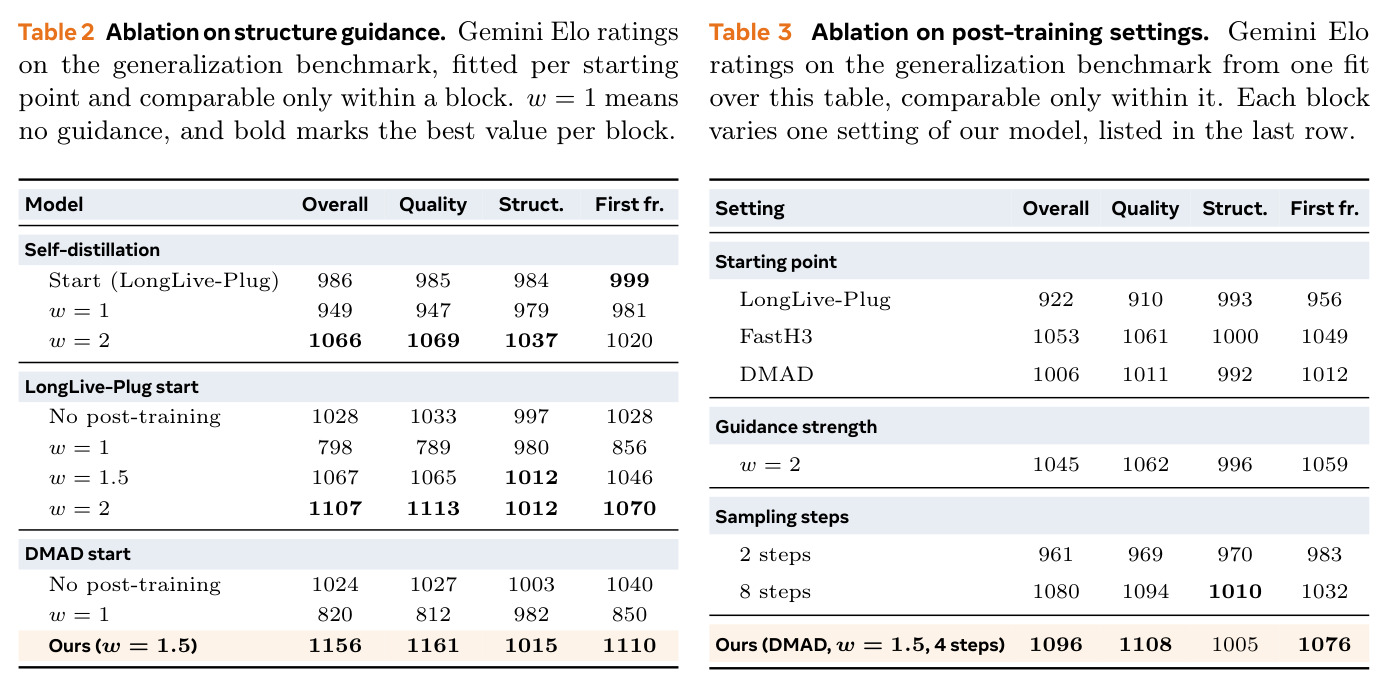
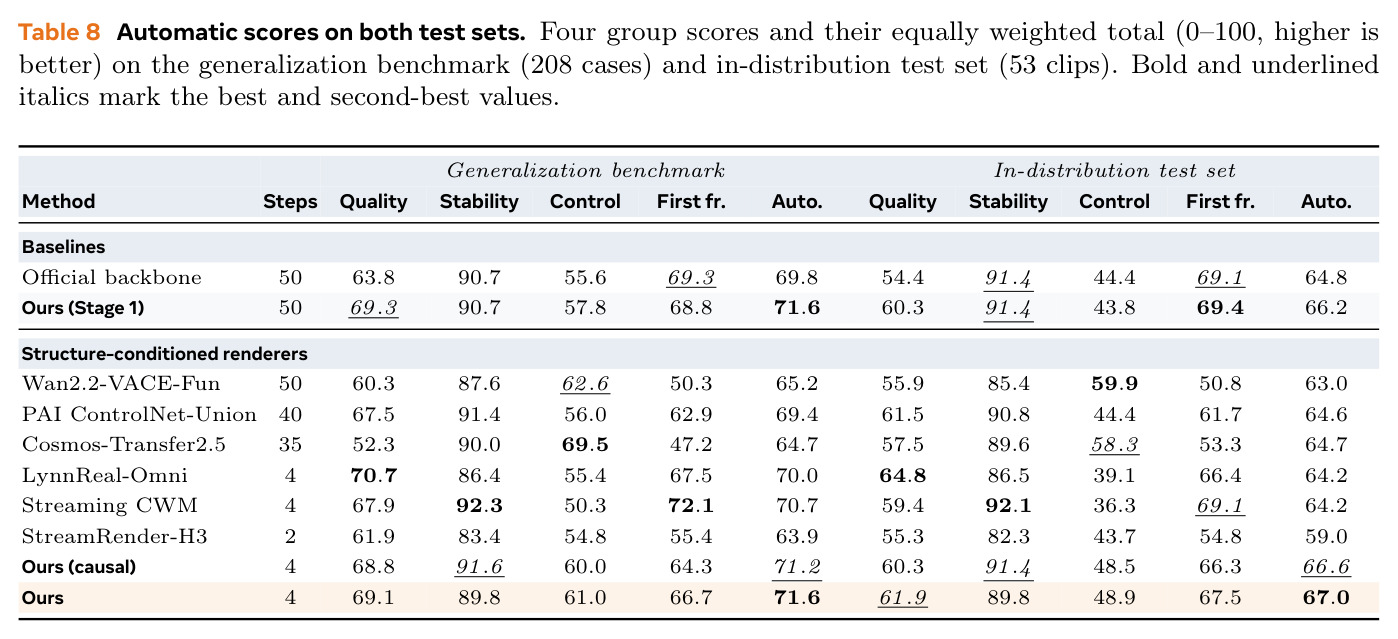
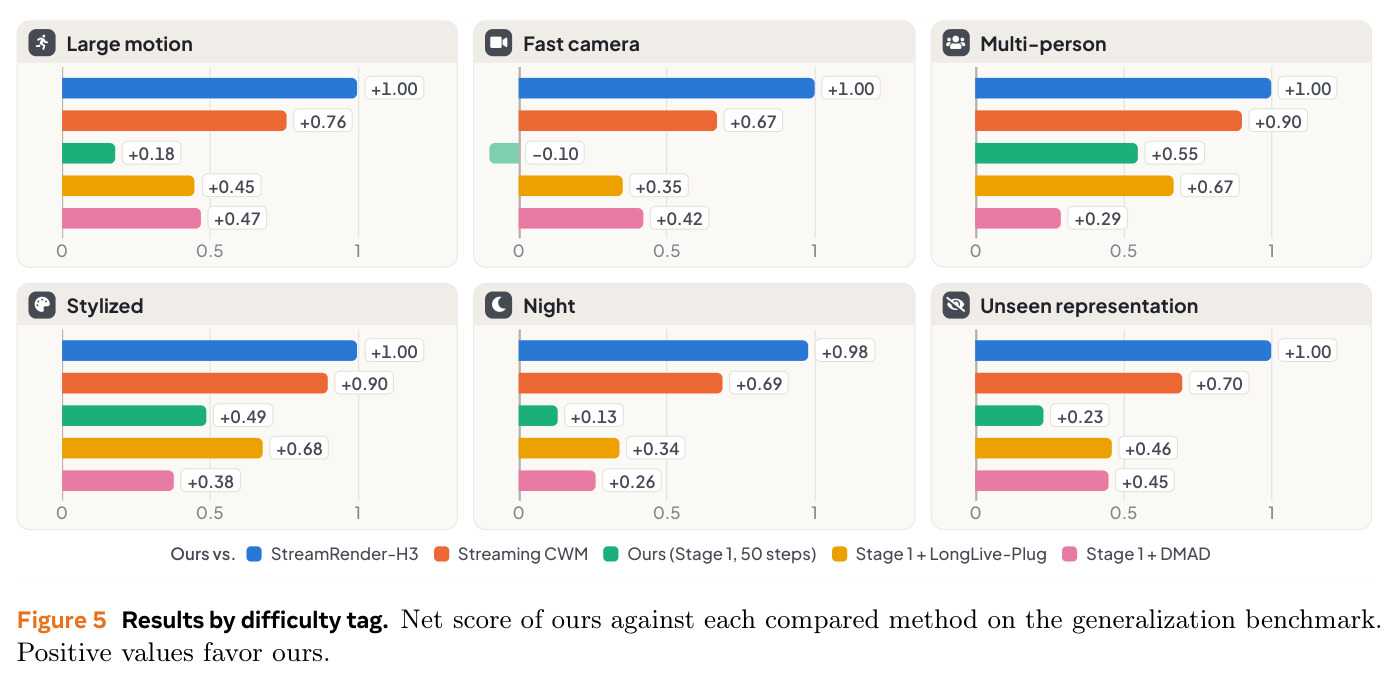
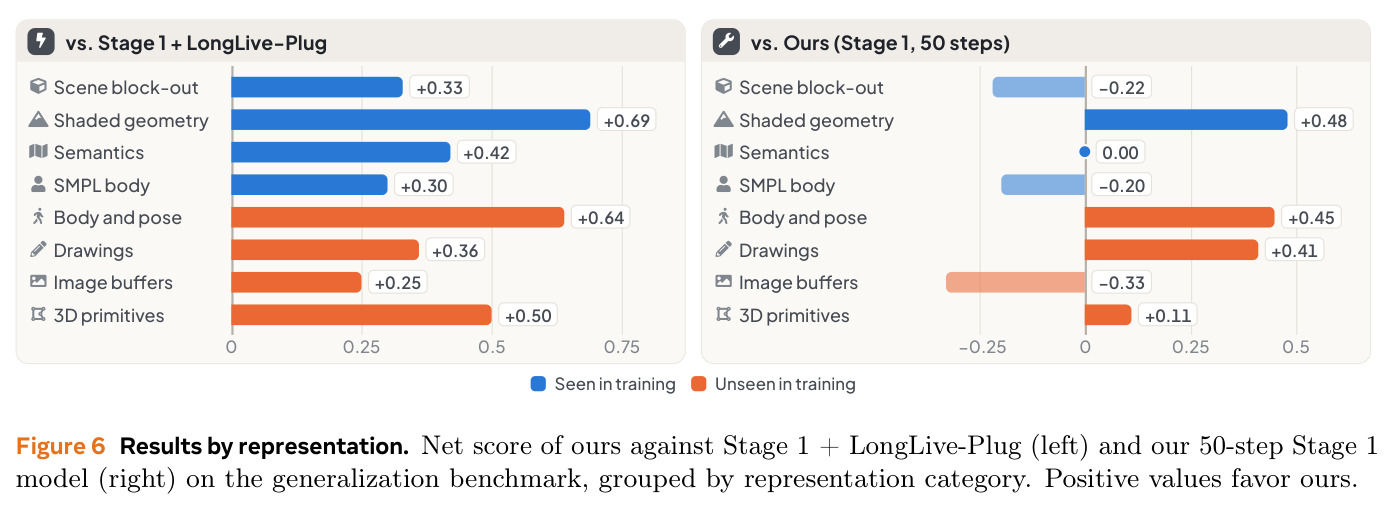
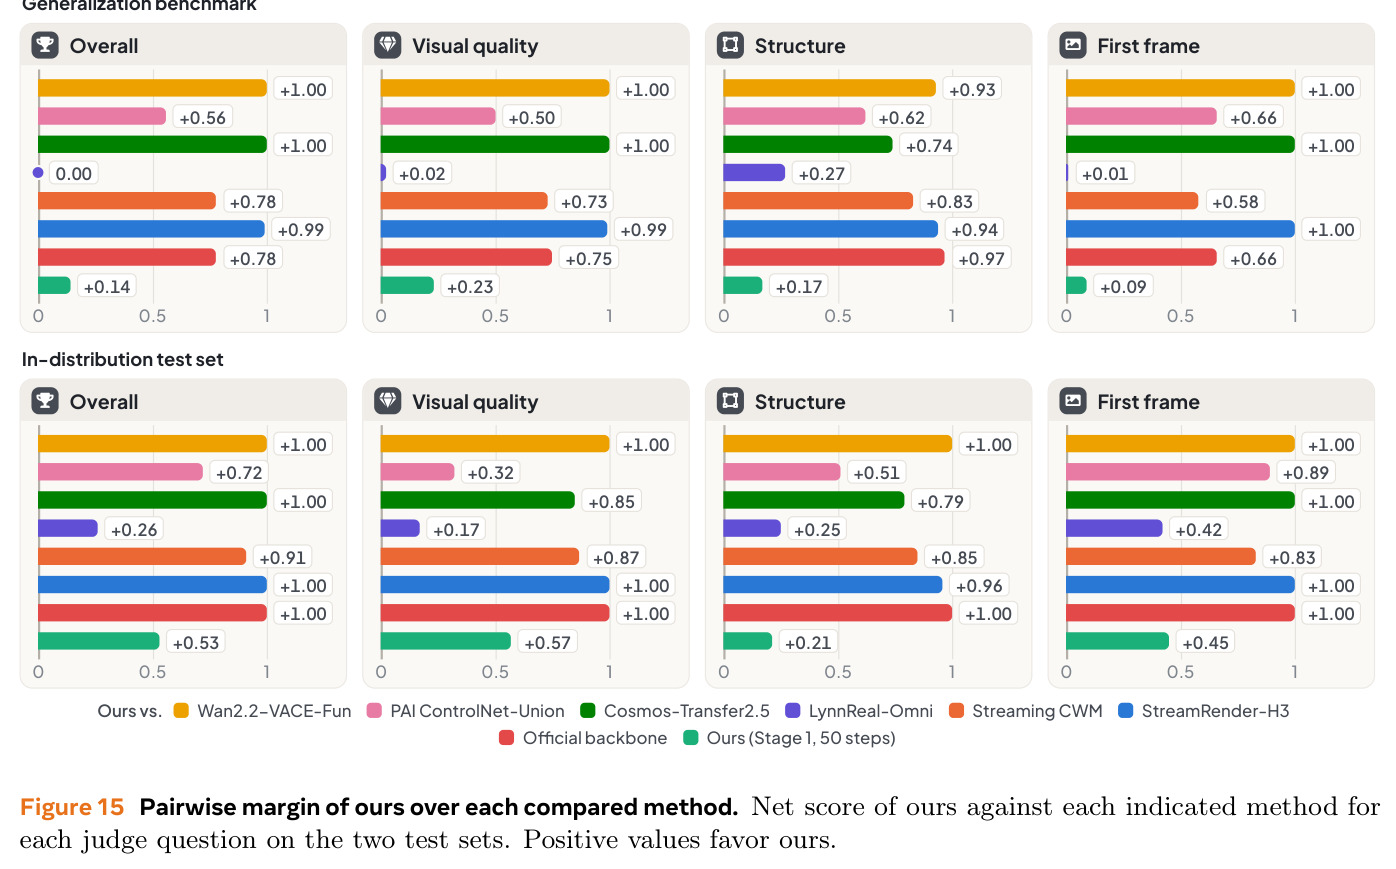
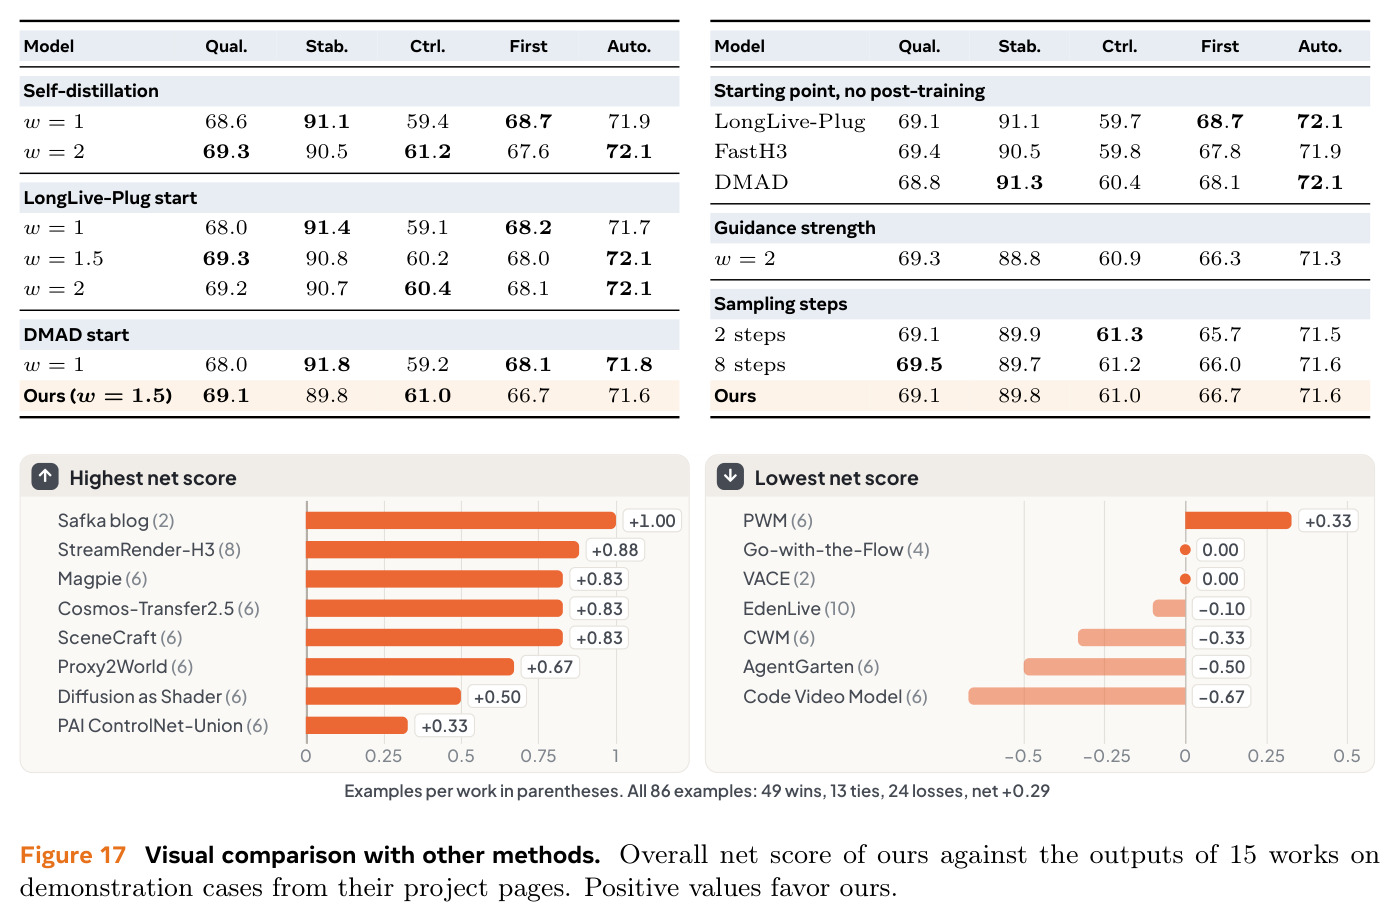
评测:Gemini 裁判成对比较 + Elo。泛化基准(208 案例、16 表示、11 未见)上 4 步模型 Overall 1441、结构 1338、自动分 71.6 全面领先;LynnReal-Omni 泛化集打平但结构低约 95 分,分布内测试集(53 条真值)落后 100 分(1410 vs 1510)。官方骨干结构 Elo 仅 627/554,控制全来自轻量 LoRA;50 步 Stage 1(1389/1299)反不如 4 步模型(1441/1510),加速还提质。因果变体 Overall 1191/1199 远超流式对手(1075、580),分布内结构分 1313 还高于 Stage 1。消融:无引导后训练掉分(起点 1024→820),$w{=}1.5$ 结构外推拉回 1156(统一拟合 1096>组合 1006);引导只需作用在高噪声区;过训降至 992;2 步 961、8 步无增益;1/10 数据变化 ≤0.2,去错位结构反涨分。速度:4 步 209 秒 vs 50 步 2562 秒(12.3×);因果版 768p@28FPS;外部 86 案例净分 +0.29。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 结构条件视频渲染(泛化基准,16 种表示 / 208 案例) | Gemini Elo(Overall) | 1441(4 步) | LynnReal-Omni 1441(4 步);PAI ControlNet-Union 1221;Streaming CWM 1075 | 与最强对手打平,比其余高 66–1052 分 |
| 结构条件视频渲染(分布内测试集,53 条真值片段) | Gemini Elo(Overall) | 1510(4 步) | LynnReal-Omni 1410;官方 50 步骨干 651 | +100 / +859 |
| 结构跟随 | Gemini Elo(Structure) | 1338 / 1386(泛化 / 分布内) | 官方骨干 627 / 554;LynnReal-Omni 约 1241 | 对骨干翻倍以上,对最强渲染器约 +95 |
| 少步加速 | 每 158 帧片段渲染耗时 | 209 秒(4 步) | 50 步采样 2562 秒 | 12.3× |
| 实时流式渲染 | 分辨率 / 帧率 | 768p,最高 28 FPS(块因果变体) | Streaming CWM(Elo 1075)、StreamRender-H3(Elo 580),非实时 | 实时且 Overall Elo 高 116–619 |
| 未见表示渲染(74 案例) | Gemini Elo(Structure) | 1360(4 步) | LynnReal-Omni 1275;官方骨干 722 | +85 / +638 |
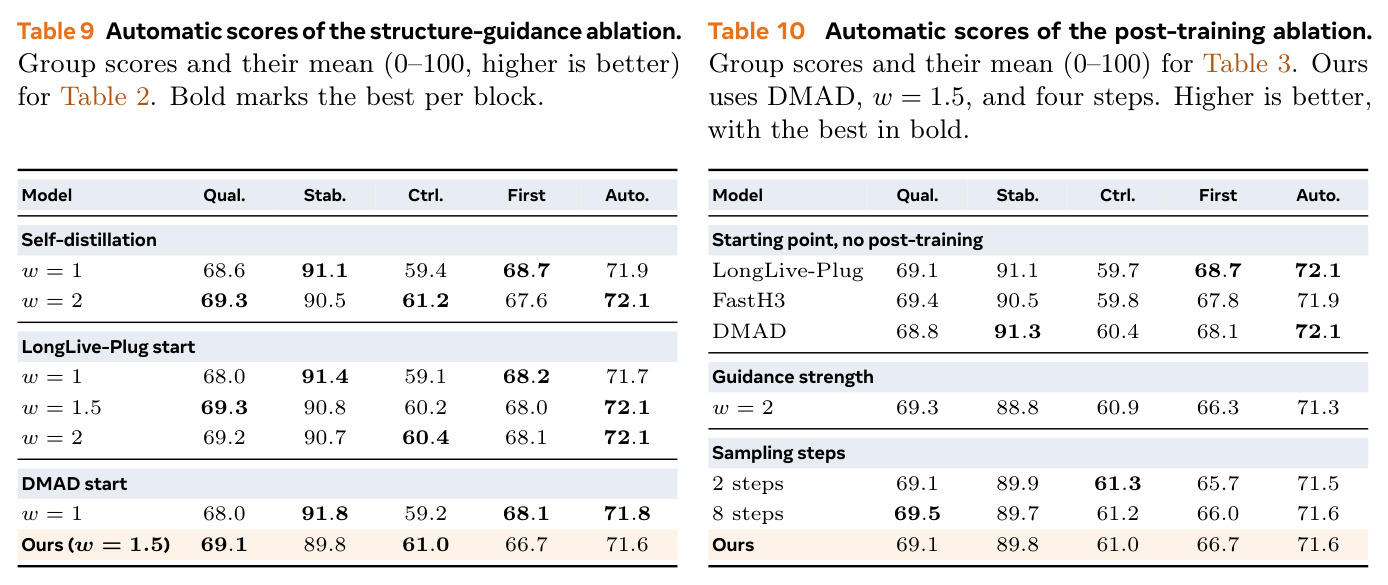
| 消融:结构引导后训练 | Gemini Elo(Overall) | 1156(DMAD 起点,w=1.5) | 无引导 w=1:820;不后训练:1024 | +132(对起点)/ +336(对无引导) |
局限与改进
作者可见或承认的局限:(1) 加速以稳定性和首帧保持为代价——相对 Stage 1,泛化集稳定分 91.6→89.8、首帧 68.8→66.7,因果版后块颜色会偏离首帧;(2) 部分未见格式仍输给自己的 50 步模型:彩色映射深度净分 −0.71、体素 −0.60、铅笔分镜 −0.38,4 步加速对某些精细表示仍有损失;(3) 泛化基准无真值,主指标依赖 Gemini 3.8 Flash 裁判(虽有人类盲测方向一致佐证),LLM 裁判偏好可能带偏;(4) 分布内测试集仅 53 条片段,规模小;(5) 方法深度绑定 MiniMax-H3 的参考通路机制(RoPE、单流全注意力、参考 timestep 约定),能否迁移到其他骨干未验证;(6) 自动总分仅 66–72(0–100 制),离以假乱真仍有距离。我的补充观察:28 FPS 实时依赖流式 VAE 与固定窗口 KV cache,硬件门槛不低;结构约束弱(如纯文本)时『跟随 vs 补全』的边界完全由文本句式约定,缺少可量化的控制强度旋钮;数据消融显示 136K 语料的边际收益小于种子波动,语料利用效率存疑。
独立分析的弱点
独立分析的弱点与改进方向:(1) 无类型设计完全依赖固定文本描述——若新表示的描述写得不准(如彩色映射深度存在语义歧义),模型可能误跟随颜色,改进方向是让模型自动推断『哪些属性应跟随』并输出跟随掩码,或加入轻量类型探针但不破坏开放词表性;(2) 教师外推强度 $w$ 是全局标量,对结构覆盖率高低的输入一视同仁,可按结构覆盖率或 token 熵自适应取值;(3) 加速用稳定性换观感,相邻帧一致性下降(稳定分 91.6→89.8),可在 DMD 目标中加入时间一致性正则或用因果教师约束 rollout;(4) 评测方面,Elo 由单一 Gemini 模型给出,且 86 案例对比中有 7 个工作净分为负(AgentGarten −0.50、Code Video Model −0.67),说明在其选例上仍有明显短板,应扩充真值基准并加入 3D 一致性指标(如多视角重投影误差);(5) 因果变体存在颜色漂移,可加首帧锚定的颜色一致性损失或周期性全局重校准块;(6) 两阶段解耦意味着控制 LoRA 永远不被加速目标纠正,Stage 1 的系统性偏差会被固化,可尝试极低学习率联合微调加控制保持正则。
未来方向
作者展示的结构输入已包括 agent 搭建的场景(51 个 agent block-out 案例),自然的延伸是与 coding agent/世界模型闭环:agent 写场景代码 → SolarRenderer 实时渲染 → 渲染结果反馈给 agent 迭代修改。因果流式版本已到 28 FPS,配合交互式编辑(拖拽结构、中途改 prompt)可做成实时创作工具。结构引导外推思想可推广到其他条件类型的蒸馏(音频、动作、深度),也可探索按条件强度自适应的 $w$。数据侧『对齐比数量重要』的结论值得固化为通用数据配方与自动检验流水线。尚未覆盖的方向包括:物理合理性(碰撞、重力)没有专门指标;骨干本身支持音频 token,可同时生成同步音效;多种结构输入混合(同一视频同时给深度 + 人体 + 语义)的组合泛化;把开放词表描述机制扩展到编辑指令(『把结构里的车换成马』);以及把 16 种表示的泛化基准公开发布为社区标准。
复现评估
复现条件较好但算力门槛高。开源情况:代码(github.com/Enderfga/SolarRenderer)、权重、136K 训练集与项目页均已公开。依赖 MiniMax-H3 33B Ref2VA 骨干(冻结)与开源 SolarWM 框架。算力:schedule 按 8-GPU 节点给出;Stage 1 控制 LoRA 需 38,400 步(batch 4,158 帧 1344×768),是主要成本;Stage 2 仅 800 次迭代,因果变体另需 19,200 + 1,600 步。推理单卡 4 步渲染 158 帧约 209 秒。数据侧需复刻 8 源采集与对齐检验(时间互相关、镜像边缘召回),caption 由 Kimi K2.6 生成并带校验器,用官方数据集可跳过。难点排序:拿不到 33B 骨干则无法复现(最大风险);有骨干后 Stage 2 与因果变体超参($w{=}1.5$、800 步、5:1 更新比)论文给出完整,难度中等;评测需 Gemini 3.8 Flash API。总体属于『数据、权重、代码齐全,GPU 是唯一门槛』的可复现工作。
论文图表
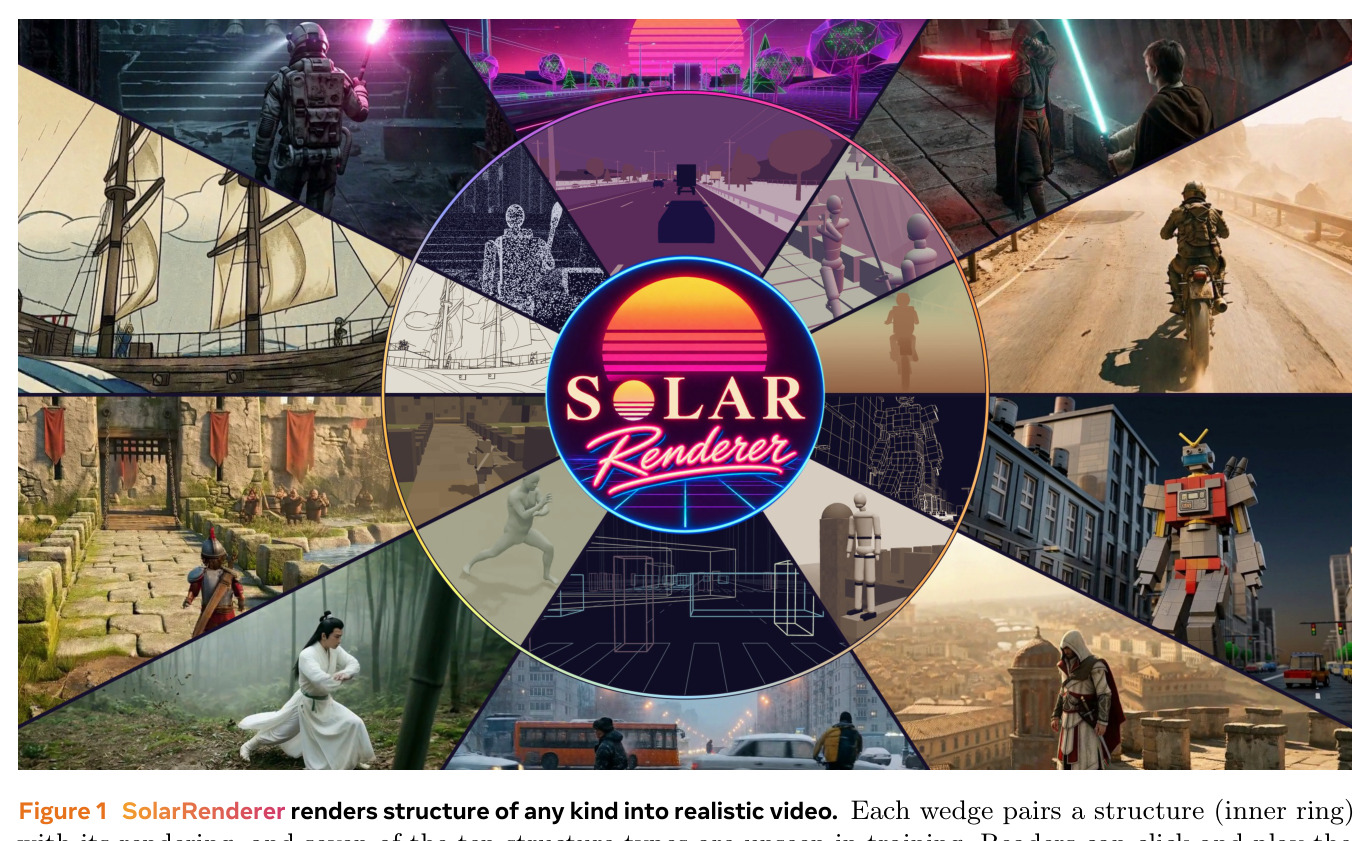
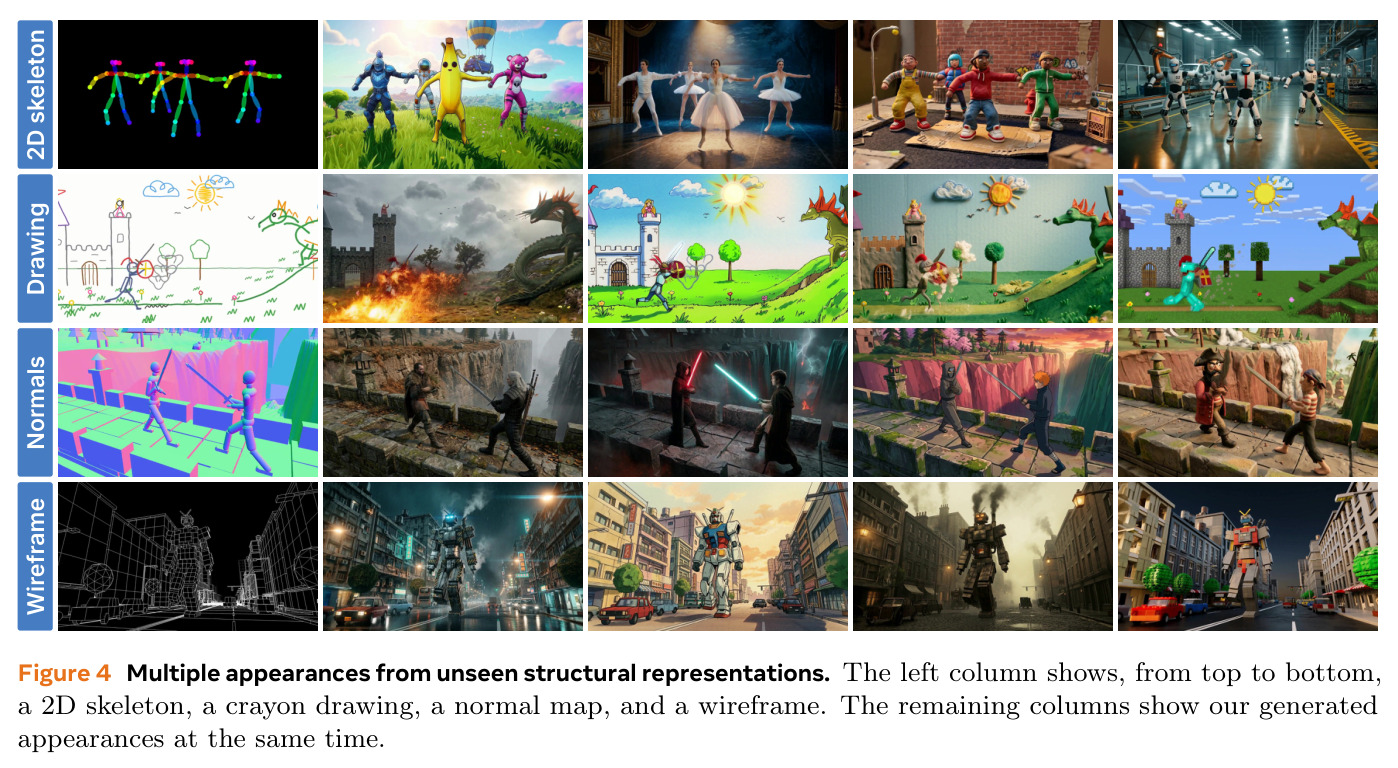
十种结构表示与对应渲染结果的两两配对环形展示,其中 7 种是训练未见过的格式(姿态骨架、手绘、点云、体素、线框等),直观展示单一模型对任意结构的渲染能力。
一眼看清论文要解决的任务定义与最大卖点:一个模型吃任意结构、泛化到未见格式,是全文结论的视觉摘要。
跨已见/未见结构表示的渲染画廊,覆盖人物运动、日常场景与想象环境等多种风格。
展示方法的表现力上限与风格多样性,说明控制与外观自由度可以同时兼得。
CARLA 语义图样本的完整六段式训练 caption:subject_definitions 定义每个参考、summary 带任务前缀、retention_analysis 说明跟随哪些属性、detailed_description 描述目标外观。
『固定句式描述无类型参考』是方法核心之一,此图给出可直接套用的 prompt 模板实例。
引擎录制(30 米内深度着色)样本的 caption 实例,retention_analysis 明确『近处形状/运动/相机跟随、远处与材质不跟随、灰色着色不出现』。
展示深度类条件的属性边界如何用文字精确约定,是无类型条件化的关键细节。
Magpie 场景灰盒样本的 caption 实例,定义句覆盖布局、大几何、人物身体、运动与相机。
灰盒是引擎渲染最典型的条件,此例说明其文本描述与消融中引用的模板一致。
UnrealZoo 物体掩码 + 骨架样本的 caption 实例,约定物体轮廓/位置与人物姿态跟随、平涂颜色与骨架线不出现。
体现掩码 + 骨架这类复合条件的描述方式,是理解多属性跟随规则的好例子。
YouTube 视频拟合 SMPL 人体样本的 caption 实例:灰白背景人体网格只给主角位置、体型、姿态与运动,环境与服装由首帧和文本补全。
说明真实视频来源(非引擎)的条件如何构造,对应数据管线中 GVHMR+VGGT 拟合流程的输出形态。
WildWorld 仅首帧样本的 caption 实例,只有 fully_preserved 的首帧保留规则,无结构参考。
解释为何语料保留 13.2% 纯首帧 + 2.9% 纯文本样本:让『缺结构』不与特定外观来源绑定,保证外观先验不被稀释。
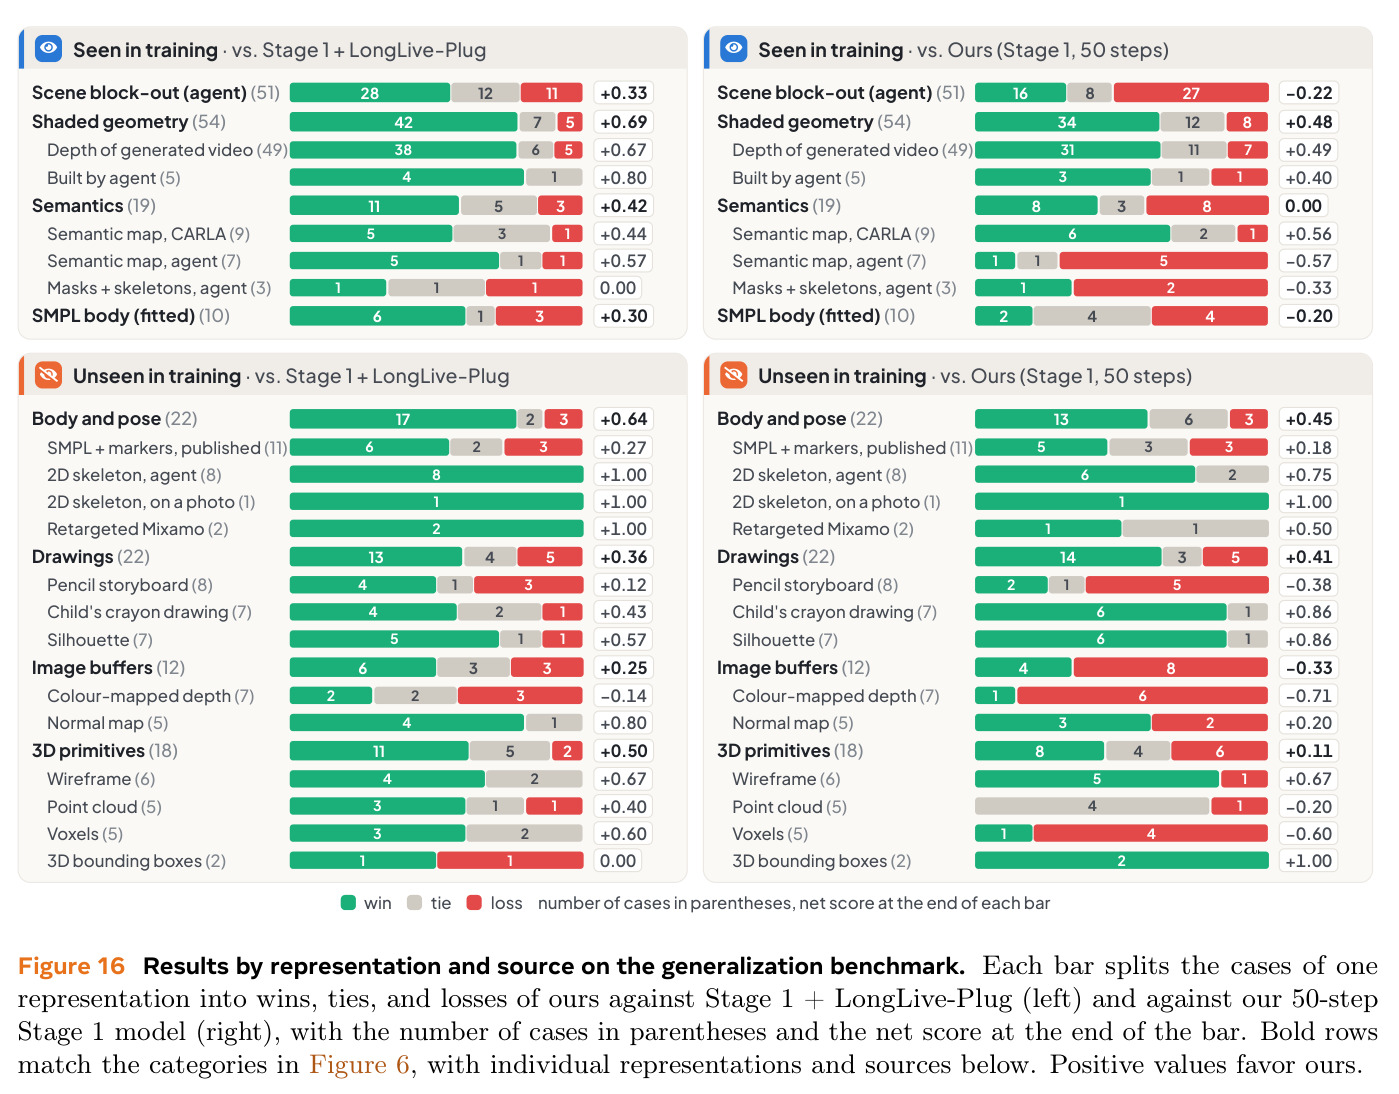
细到单个表示与来源的胜负平分解(如 agent 骨架 8 例、蜡笔画 7 例、体素 5 例),显示 4 步模型在彩色映射深度(−0.71)、体素(−0.60)、铅笔分镜(−0.38)上仍输给自己的 50 步模型。
全文最诚实的细粒度证据:既支撑泛化结论,也暴露加速在个别精细格式上的损失,是分析局限性的依据。
结构引导消融:无引导 w=1 反而大幅掉分(DMAD 1024→820、LongLive-Plug 1028→798、自蒸馏 949→949/798),外推后 DMAD 起点 1156、LongLive-Plug 1107、自蒸馏 1066。
证明核心创新(结构外推教师)的必要性:普通 DMD 会把学生往模糊教师拉,这是全文最重要的消融。
数据消融:用错位 WildWorld 框作结构使结构分 47.4→46.6;只用带结构样本降稳定性;1/10 数据各指标变化 ≤0.2(小于换种子波动 65.9);去错位后 66.5 最优。
支撑『对齐比数量重要』这一反直觉数据结论,直接指导同类工作的数据构建策略。
表 4/5 消融的自动分组得分汇总:原生全分辨率通路 66.5 总分最高;去错位结构数据 66.5;1/10 数据 66.1。
用自动指标交叉验证 Elo 之外的分组效应(质量/稳定/控制/首帧),避免单一评判源。
结构引导消融的自动分组:引导把 DMAD 起点控制分 59.2→61.0、质量 68.0→69.1,但稳定性与首帧下降,总分 71.8→71.6 与 Elo 方向相反。
展示 Elo 与自动总分的分歧,说明引导的收益主要体现在『外观+结构』的联合偏好上,帮助读者正确解读指标。