FlashRender:基于相机控制视频 MeanFlow 的少步生成式渲染 FlashRender: Few-Step Generative Rendering via Camera-Controlled Video MeanFlow
RETA 稳定相机控制 + MeanFlow + 在线蒸馏,4 步采样秒级完成视频重摄
前置知识
Rectified Flow 与流匹配
流匹配把生成建模为从噪声分布 $p_1$ 到数据分布 $p_0$ 的 ODE 求解。Rectified Flow 取线性插值路径 $z_t = tX_1 + (1-t)X_0$,条件速度恒为 $X_1 - X_0$;网络 $u_\theta(z_t, t)$ 用流匹配损失回归该速度场,推理时从 $t=1$ 数值积分到 $t=0$ 逐步去噪,步数越少离散化误差越大。
FlashRender 的基座 Wan2.1-1.3B-CamCtrl 就是流模型,论文三阶段训练与所有损失函数都建立在这一框架之上,不理解流匹配就读不懂方法部分。
MeanFlow 与平均速度场
MeanFlow 学习区间平均速度 $u(z_t, r, t) = \frac{1}{t-r}\int_r^t v(z_\tau, \tau)d\tau$,满足恒等式 $u = v - (t-r)\frac{d}{dt}u$,推理时可一步跳变 $z_r = z_t - (t-r)u_\theta(z_t, r, t)$ 直达数据。训练需对网络求 $\frac{d}{dt}u_\theta$(通常用 JVP 计算),并以 stop-gradient 稳定回归目标,该恒等式正是 MeanFlow 损失的推导基础。
本文 Stage 2 的核心就是 MeanFlow 训练,且为适配大规模视频训练改用了有限差分近似 JVP 和 iMF 式瞬时速度重参数化,这些细节都源自 MeanFlow 体系。
离散化误差与去噪轨迹曲率
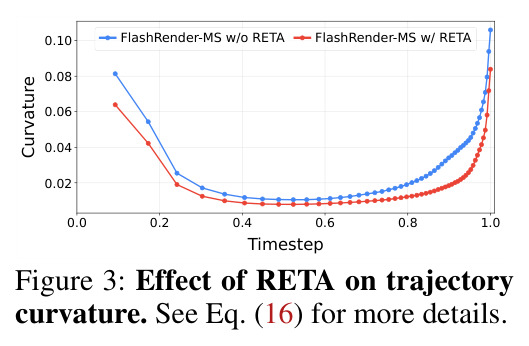
少步欧拉积分时轨迹越弯、累积误差越大。曲率可量化为 $C(t_i) = \|-(X_1-X_0) - \frac{\hat{z}_{t_i}-\hat{z}_{t_{i-1}}}{t_i-t_{i-1}}\|_2^2$(Eq. 16),衡量每步平均速度偏离理想速度的程度;曲率低意味着轨迹近直、易被少步逼近。
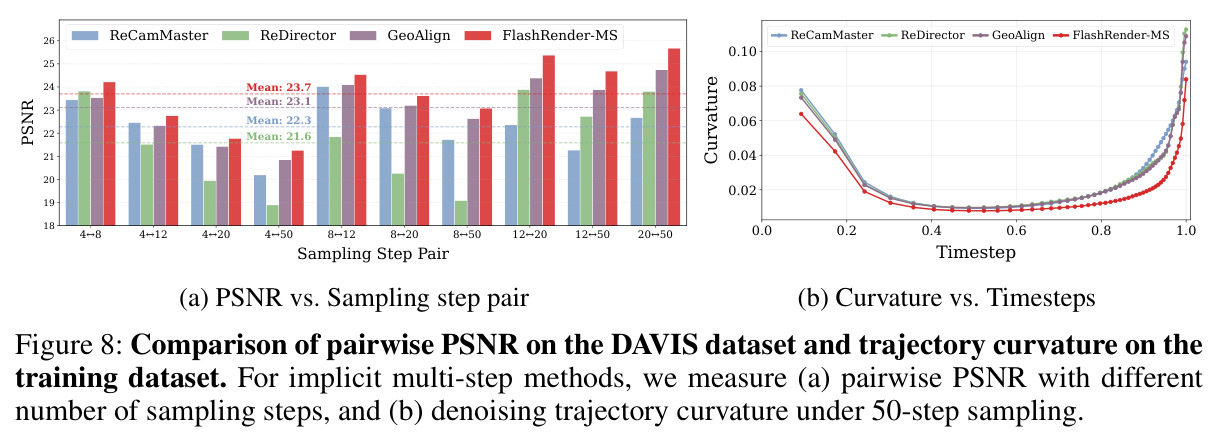
全文的中心论点是:RETA 降低曲率是 MeanFlow 少步蒸馏成功的前提条件,Fig. 3 与 Fig. 8b 是支撑该论点的关键证据,看懂曲率定义才能理解这个因果链。
DMD 与在线策略(on-policy)蒸馏
分布匹配蒸馏(DMD)用『真实分数与伪造分数之差』作为梯度训练学生模型,使学生生成分布逼近教师分布;在线策略指学生在自己 rollout 出的样本上训练,从而直接修正训练-推理失配。DMD2 在此基础上加入对抗判别器提升视觉保真度。
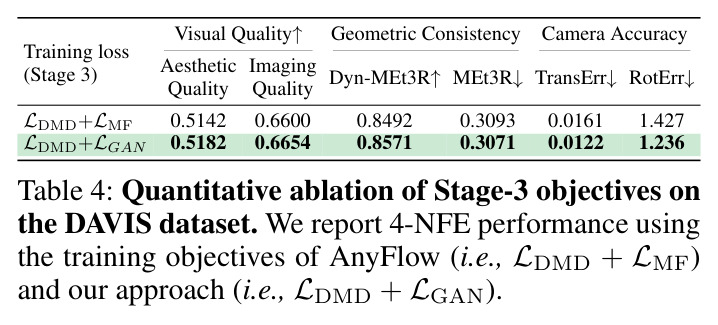
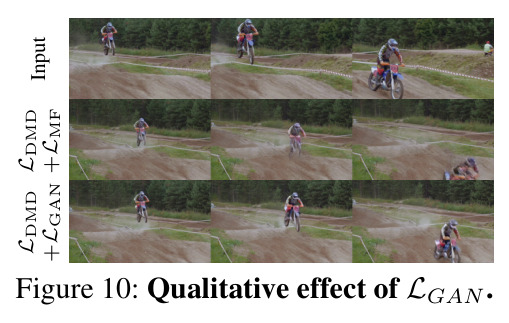
本文 Stage 3 沿用这一思路,但有两处定制:自展开严格复用推理时的固定 4 步采样日程,并用 GAN 损失替换 AnyFlow 保留的 MeanFlow 损失,这是消融实验重点验证的对象。
表示对齐(REPA)
REPA 用余弦相似度损失把扩散 Transformer 中间层的(含噪)表征与冻结视觉编码器(如 DINOv2)的特征对齐,把预训练模型的语义与结构信息注入生成模型,从而加速收敛、提升质量。后续变体包括改进空间结构的 iREPA、对齐视频物理属性的 VideoREPA 等。
RETA 是 REPA 的几何化改造:对齐对象从含噪目标表征换成干净的源视频流,对齐靶点换成目标视角几何特征。理解 REPA 系列才能体会 RETA 的设计差异与创新所在。
VGGT 视觉几何模型
VGGT(Visual Geometry Grounded Transformer)是前馈式视觉几何 Transformer,可从任意数量视图联合预测相机参数、深度、点图与 3D 点轨迹。本文冻结 VGGT,并在其后接一层带相机 token 的全局自注意力以区分静态背景与动态物体,将其输出的目标视角特征作为 RETA 的对齐目标。
VGGT 特征是 RETA 的监督信号来源,决定了模型能内化怎样的源→目标几何变换;其对动态/静态内容的区分能力直接关系动态物体的定位精度。
RoPE 与 RoCE 相机编码
RoPE(旋转位置编码)通过给注意力注入位置相关的旋转相位实现相对位置感知;RoCE(Rotary Camera Encoding)把相机参数(Plücker 射线表示)以类似旋转相位的机制注入 token,实现 token 级相机条件。本文让源、目标两条视频潜变量流共享以目标轨迹为条件的 RoCE,并给源 token 附加逐帧相对位姿。
共享 RoCE 加相对位姿编码是两条视频流的 token 能在自注意力中『位置对齐』的基础,是 RETA 之外另一项影响相机控制一致性的结构设计。
研究动机
相机可控生成式渲染旨在把一段已有视频沿用户指定的目标相机轨迹重新『拍摄』,可用于不可达机位取景、抖动画面稳定等场景。但现有方法全是多步模型:隐式方法 ReCamMaster、ReDirector、GeoAlign 约需 6.5 分钟,显式方法 Vista4D 高达 75.9 分钟,均需 2×50 次模型前向(100-NFE),实用性受限。直接压缩采样步数会引入离散化误差,作者识别出其典型病灶——『采样步数相关的相机控制』:即便目标轨迹相同,改变采样步数(如 4、12、50 步)就会改变生成视频实际呈现的相机运动,导致场景尺度漂移与动态物体定位不一致。附录用跨步数成对 PSNR 量化:ReCamMaster、ReDirector、GeoAlign 的均值仅 21.6、22.3、23.1 dB。这种步数依赖性还毒害少步蒸馏——干净源视频 token 与含噪目标 token 的对应关系随去噪时间步变化,多步动力学难以用几步近似。直接套用现有少步方案的后果是:NeoVerse 的 TransErr/RotErr 高达 0.0343/3.495,相机精度比多步基线差一个量级。
本文的目标是本文目标是构建一个仅需 4-NFE 的少步生成式渲染模型:在 480×832 分辨率、单张 NVIDIA B200 GPU 上以约 0.2 分钟(秒级)完成任意长度输入视频的重摄,具体指标上要求:(1) 视觉质量与几何一致性追平多步基线——VBench 的 Aesthetic/Imaging Quality、Dyn-MEt3R、MEt3R 与多步模型相当;(2) 相机可控性反超——TransErr 与 RotErr 优于包括多步 GeoAlign(0.0149/1.495)在内的全部对比方法;(3) 对分布外的目标相机轨迹鲁棒——在 DyCheck 真实手机拍摄数据上仍全面领先。为此论文把问题拆解为三个互补子任务:让相机控制跨采样步数保持一致(降低轨迹曲率)、让模型学会用极少次流映射跳变逼近完整去噪轨迹、以及修正固定少步采样下训练与推理的失配。
与已有工作不同的是,本文最独特的切入角度是『诊断先行』:首次把相机控制随步数漂移确立为离散化误差在生成式渲染中的具体病灶,并论证了『先治病、再蒸馏』的因果链——只有先用 RETA 解决步数一致的相机控制、把去噪轨迹曲率(Eq. 16 度量)降下来,MeanFlow 少步蒸馏才可行。这解释了为何 RealCam 直接把 DMD 套在多步渲染模型、NeoVerse 复用预训练少步 LoRA 的效果都不理想。第二个差异点在 RETA 本身:REPA 系列对齐的是含噪样本表征以注入语义信息,RETA 却把对齐施加在干净的源视频表征流上,以冻结 VGGT 的目标视角特征为靶,让模型把源→目标的几何变换『写进』源流内部,使相机控制与去噪时间步解耦。第三,在蒸馏策略上针对固定 4 步推理定制:自展开严格复用推理日程 $(t_1, t_2, t_3) = (0.249, 0.499, 0.749)$,并用对抗损失替换 AnyFlow 保留的 MeanFlow 损失,把模型容量集中于真实数据的直接监督。
核心方法
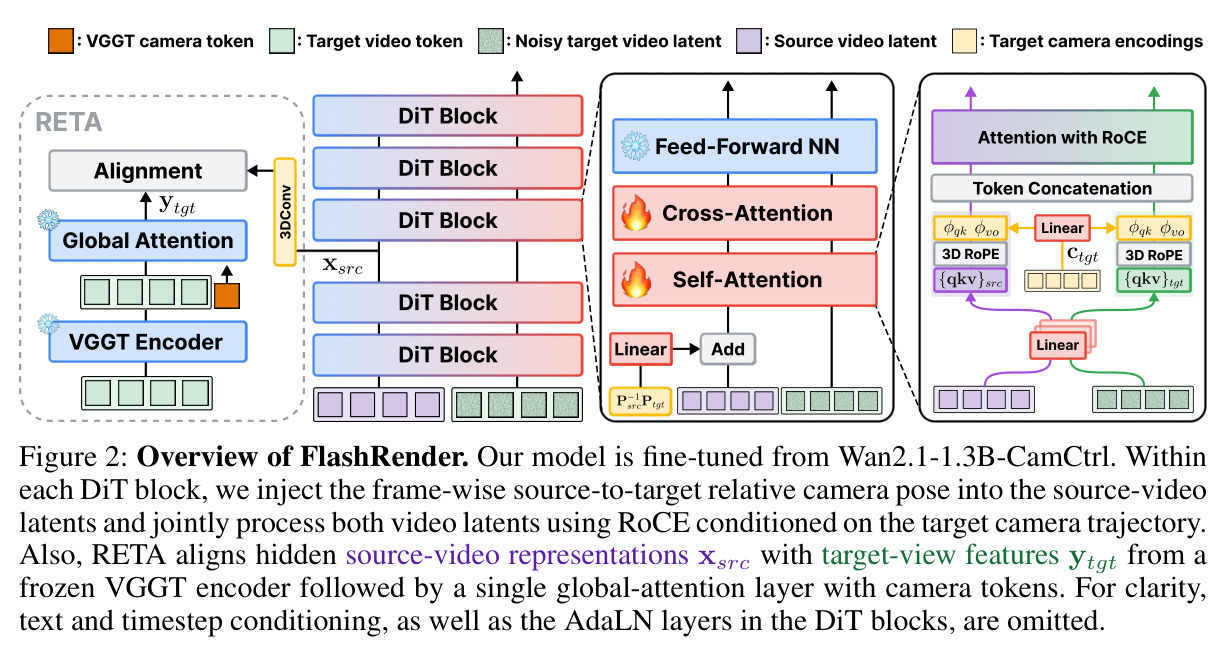
直觉:少步采样失败源于去噪轨迹太弯、相机控制不稳,因此先『拉直』再『教捷径』。模型从 Wan2.1-1.3B-CamCtrl 微调:源/目标视频潜变量沿 token 维拼接,经共享 3D RoPE 的自注意力联合处理,相机参数转为 Plücker 射线做 token 级条件。训练分三阶段:Stage 1 训练多步模型 FlashRender-MS,为源 token 附加逐帧源→目标相对位姿,并让两条流共享以目标轨迹为条件的 RoCE,使位置编码跨流对齐;同时引入 RETA,把源视频第 8 个 DiT block 的中间表征与 VGGT 提取的目标视角特征对齐,损失为 $\mathcal{L}_1 = \mathcal{L}_{CFM} + 0.1\mathcal{L}_{RETA}$,20k 步。Stage 2 在低曲率轨迹上以 MeanFlow 目标微调,学习区间平均速度 $u_\theta(z_t, r, t)$,损失 $\mathcal{L}_2 = \mathcal{L}_{MF} + 0.1\mathcal{L}_{RETA}$,20k 步。Stage 3 以 Stage 2 为学生、Stage 1 为教师,在推理所用固定 4 步日程上做在线策略流映射蒸馏,$\mathcal{L}_3 = \mathcal{L}_{DMD} + 0.03\,\mathcal{L}_{GAN}$,5k 步。数据为 MultiCamVideo 与 SynCamVideo(81 帧、480×832),8 张 RTX PRO 6000 训练约两周。
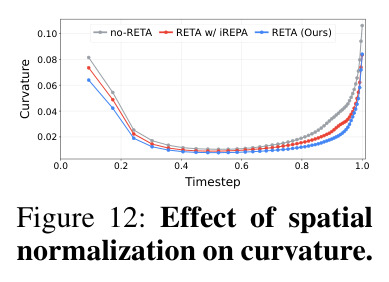
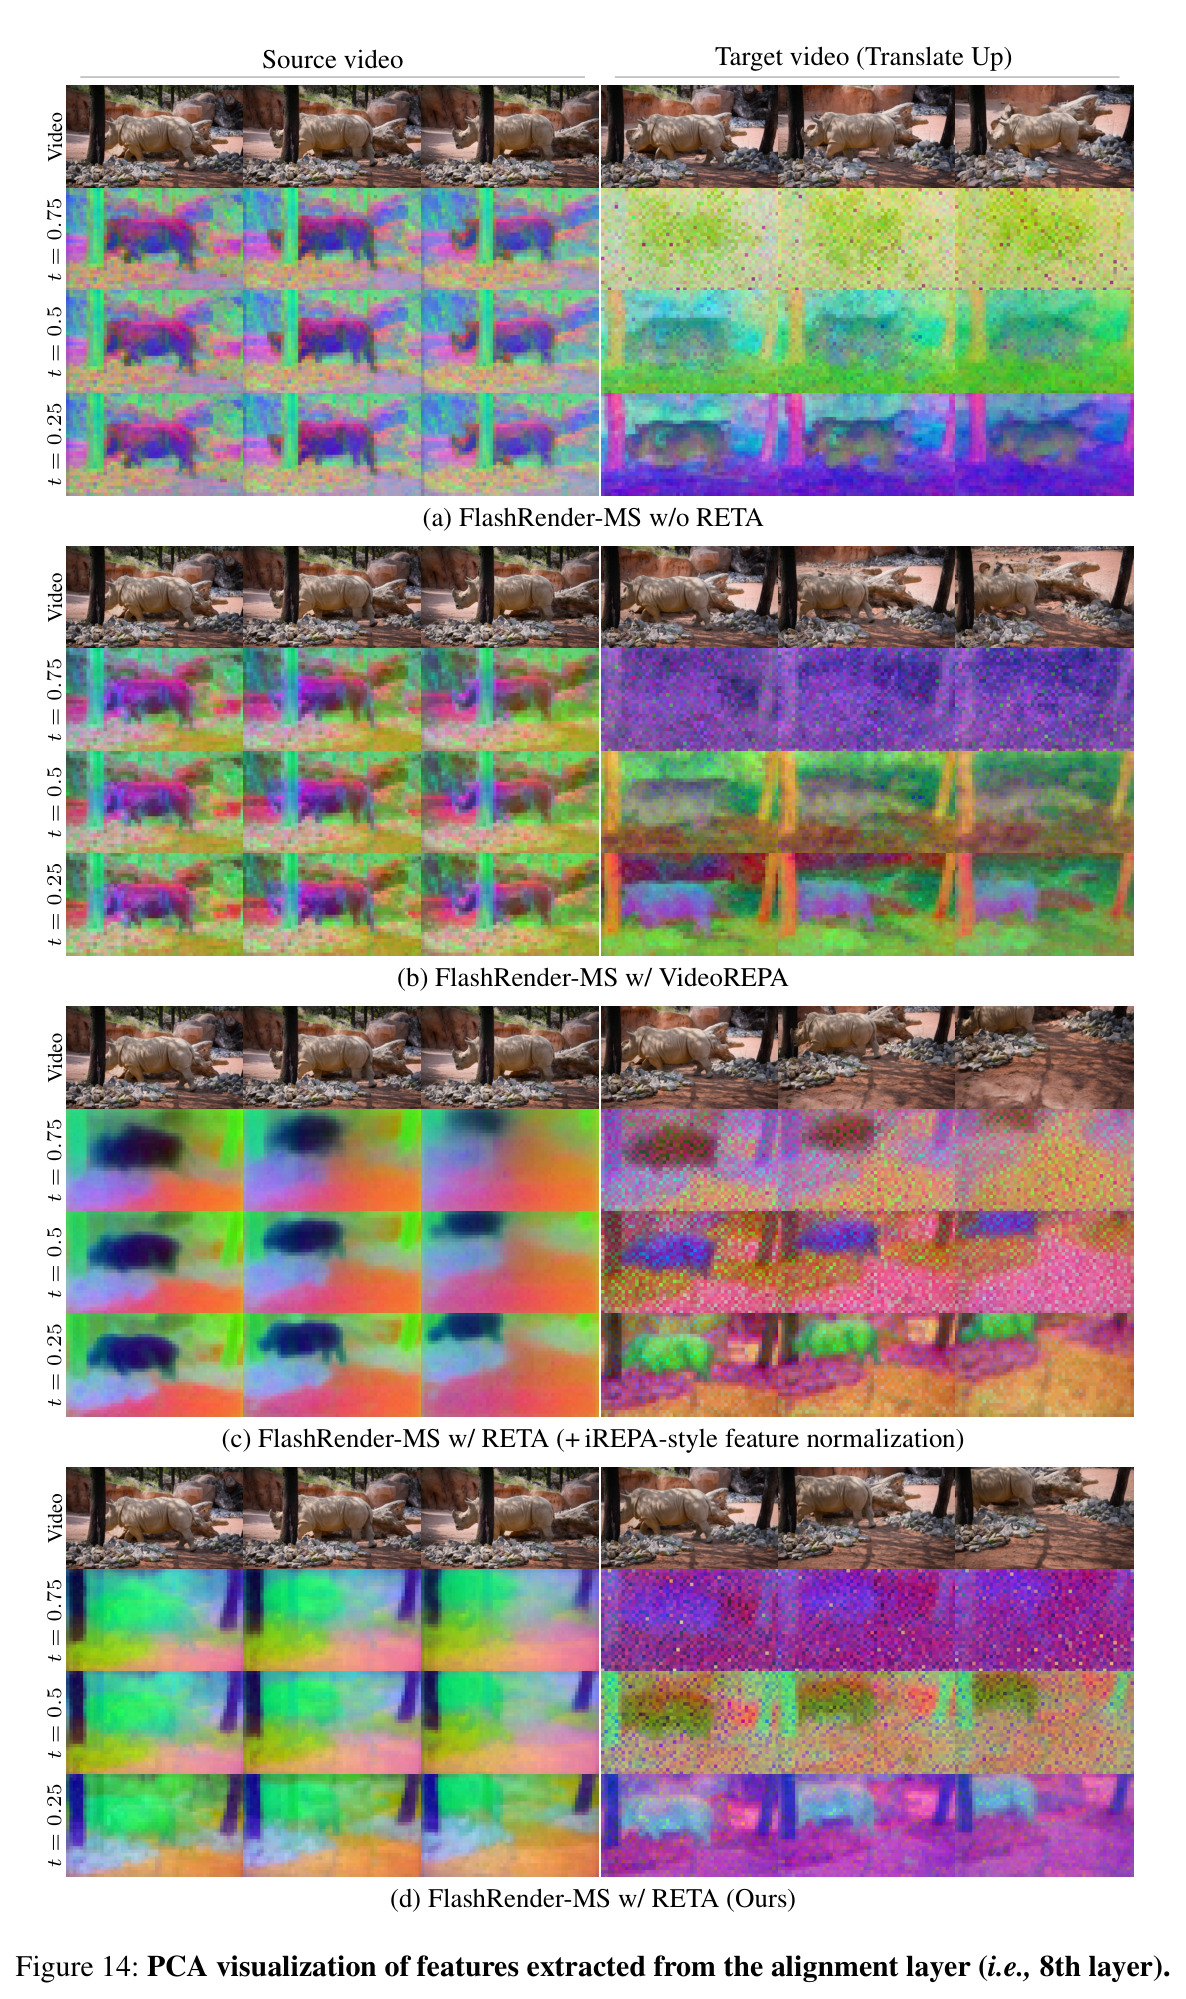
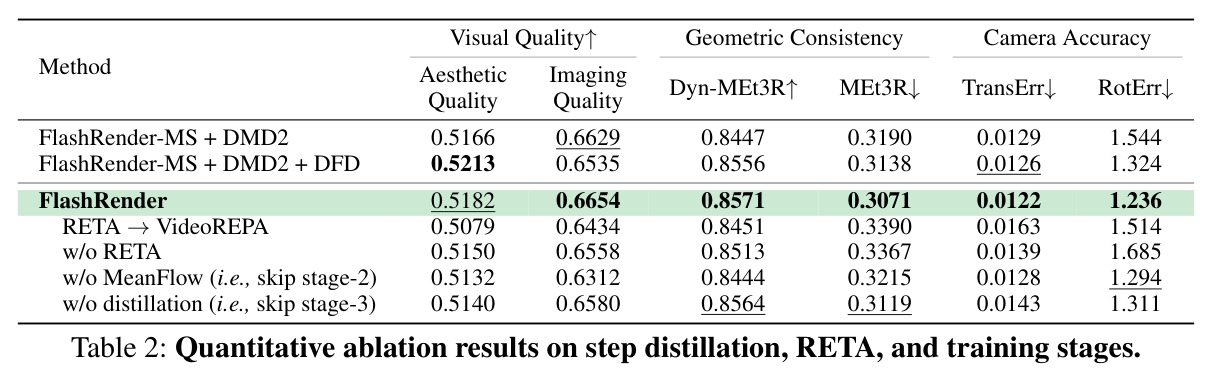
核心创新是 RETA(Representation Transformation and Alignment)。它用冻结 VGGT 从目标视频提取几何特征 $y_{tgt} = \mathrm{sg}(f_{VGGT}(V_{tgt}))$(再经一层带相机 token 的全局自注意力以区分静态背景与动态物体),模型内部用轻量 3D 卷积 $h_\phi$ 投影源视频表征 $x_{src}$,以负余弦相似度 $\mathcal{L}_{RETA} = -\frac{1}{N}\sum_n \cos(h_\phi(x^n_{src}), y^n_{tgt})$ 对齐。本质区别在几何变换发生的位置:此前方法要么只条件化目标轨迹,要么分别给源、目标潜变量施加各自相机条件,源→目标对应关系必须在每个去噪时间步重新建立;RETA 让干净源流直接『变成』目标视角表征,把几何变换内化为模型常数属性,实现与采样步数无关的相机控制。作者实测这使 50 步采样全程轨迹曲率一致下降,为 MeanFlow 提供了可被少数跳变逼近的近直轨迹。与 VideoREPA 的对比(Table 2:RotErr 1.514 vs 1.236)说明两个设计关键:对齐源流而非目标流,以及有意去掉 iREPA 式空间归一化——粗粒度几何指引让目标流自行恢复细节,避免几何误差被强耦合复制。
方法步骤详情
Step 0(条件设计):源轨迹 $P_{src}$ 给定或由 ViPE 估计;目标轨迹转 Plücker 射线经 RoCE 注入,源 token 叠加逐帧相对位姿 $P_{src}P_{tgt}^{-1}$,把每个源帧表达在对应目标视角坐标系中。Step 1(FlashRender-MS):以 $\mathcal{L}_{CFM} + 0.1\mathcal{L}_{RETA}$ 训练 20k 步(lr $10^{-4}$),RETA 挂在第 8 个 DiT block,文本 dropout 0.1,输出 50 步 CFG($\omega=5$)多步渲染器。Step 2(MeanFlow):时间步对按 Eq. 15 的 shifted 采样($s=5$)抽取,$r=t$、$r=0$ 的概率分别为 0.5、0.1;时间步嵌入改为插值 $e_{r,t} = g\,\mathrm{emb}_t(t) + (1-g)\,\mathrm{emb}_r(r)$($g=0.75$);用有限差分($\delta t=0.005$)替代 JVP 以兼容 FlashAttention-2;按 iMF 以 $v_\theta = u_\theta + (t-r)\frac{d}{dt}u_\theta$ 估计瞬时速度并烘入 CFG,配 TMD 自适应权重 $w = 1/(\|\Delta\|_2^2 + C)$,20k 步(lr $3\times10^{-5}$)。Step 3(在线策略蒸馏):学生按推理同款 4 步日程($t_{1,2,3}=0.249/0.499/0.749$)自展开得 $\hat{z}_0$,重加噪后以教师 real/fake 分数差反传 DMD 梯度;判别器建在教师特征上按 DMD2 训练,$\mathcal{L}_3 = \mathcal{L}_{DMD} + 0.03\mathcal{L}_{GAN}$;此阶段不再用 RETA;学生每更新 1 次,fake-score 模型与判别器更新 4 次,共 5k 步(lr $10^{-5}$)。推理仅需 4 次前向:$z_r = z_t - (t-r)u_\theta(z_t, r, t)$。
技术新颖性
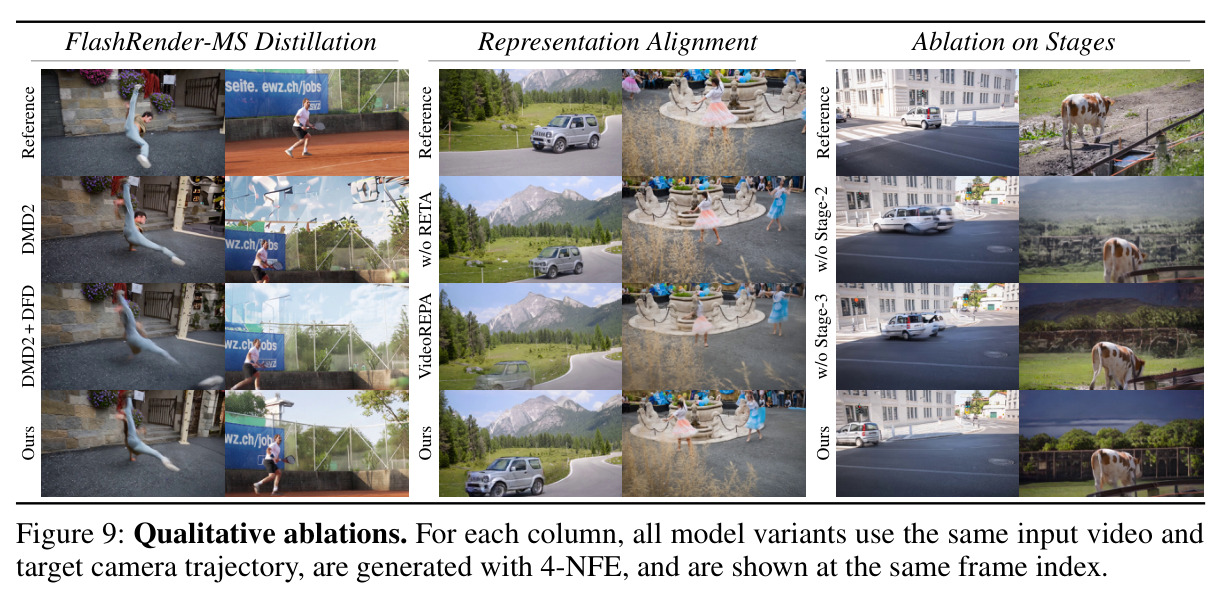
新颖性有四层。(1) 问题层:首次把『采样步数相关的相机控制』识别并量化为生成式渲染中离散化误差的具体形态,并用 Eq. 16 的曲率度量在『控制不一致』与『少步蒸馏困难』之间建立可测量的因果联系,这是此前 DMD/一致性模型文献未曾触及的角度。(2) 方法层:RETA 把表示对齐从『提升目标表征质量』改造为『在源流内部执行几何变换』,并与共享 RoCE、逐帧相对位姿编码组成完整的几何内化方案;有意弃用空间归一化(Fig. 12)体现『粗指引、细自恢复』的取舍。(3) 工程层:有限差分近似 JVP 解决了视频 MeanFlow 训练与 FlashAttention-2 的不兼容;插值时间步嵌入、iMF 式重参数化、TMD 自适应权重的组合使大规模视频 MeanFlow 训练稳定可行。(4) 蒸馏层:不同于 AnyFlow 的任意步目标,本文固定 4 步日程并用对抗损失替换 MeanFlow 损失(Table 4:RotErr 1.236 vs 1.427),证明面向部署步数的定制蒸馏优于通用配方。三组件互补性经 Table 2 与 Fig. 9 系统验证。
实验结果
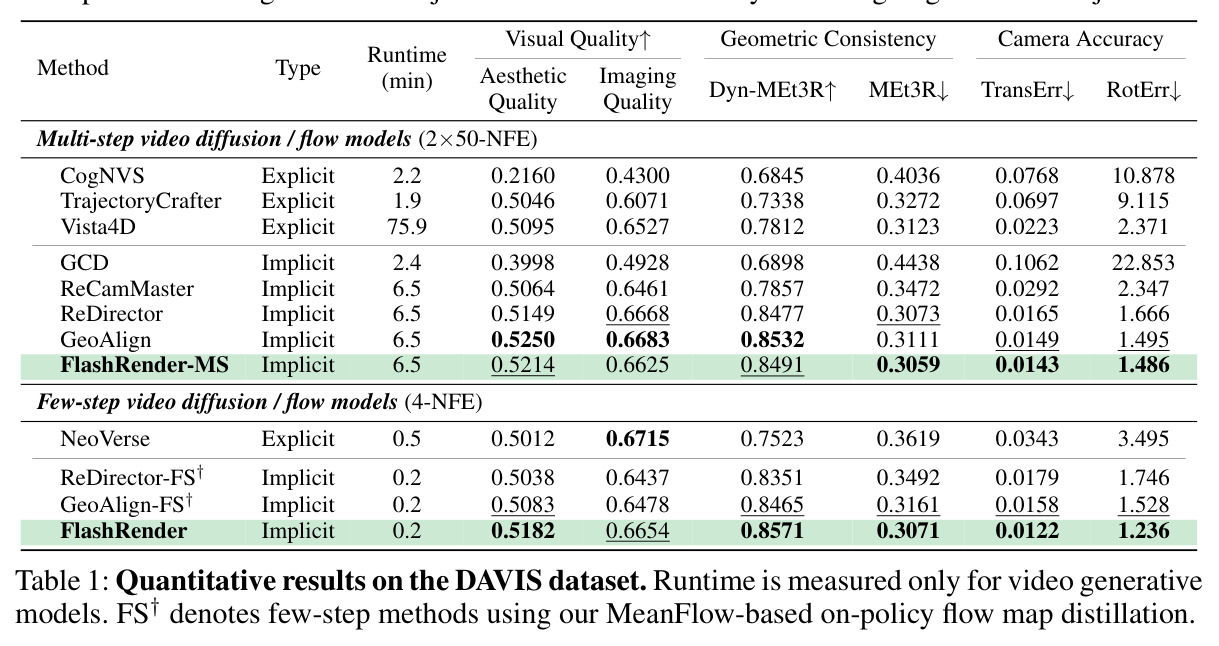
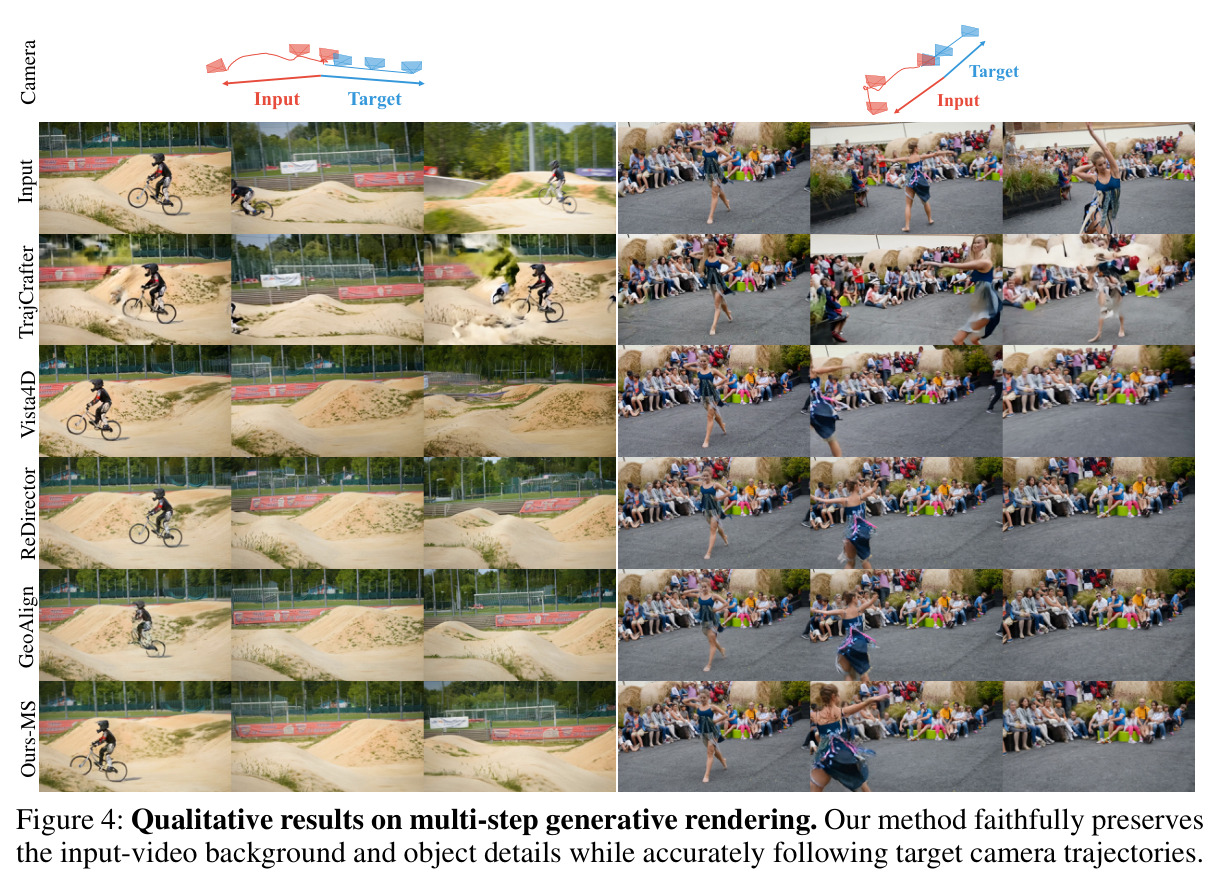
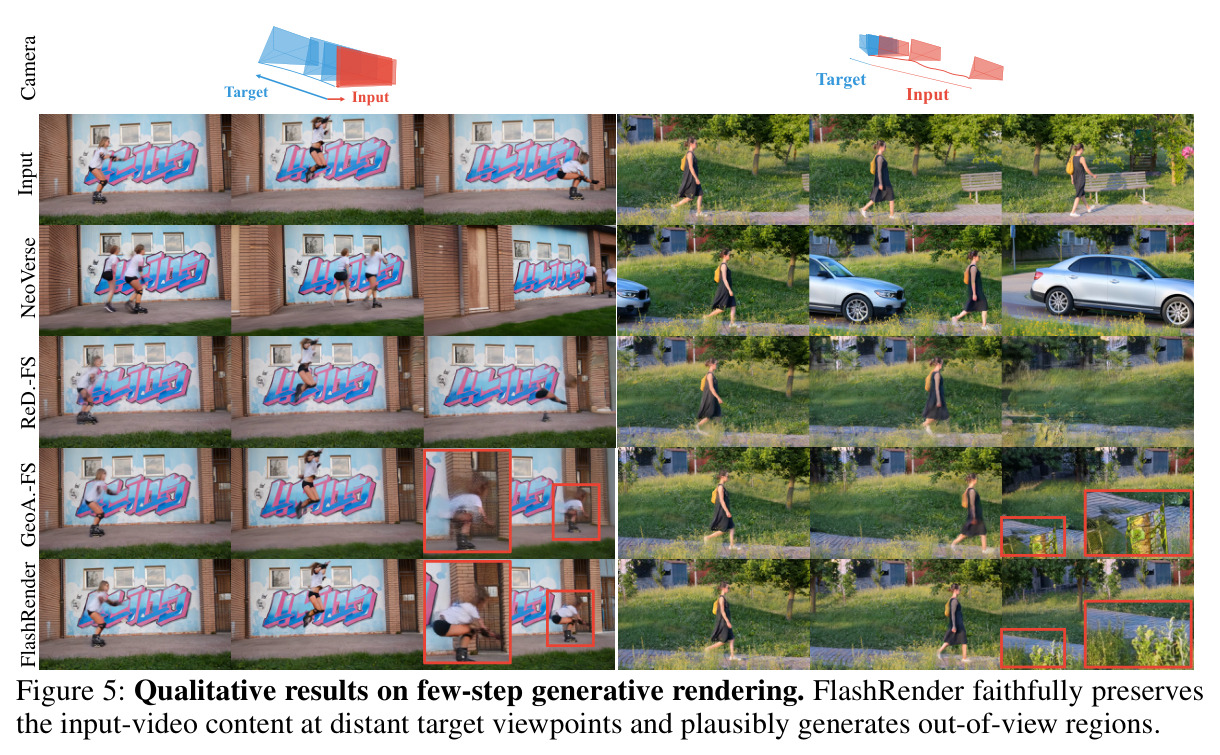
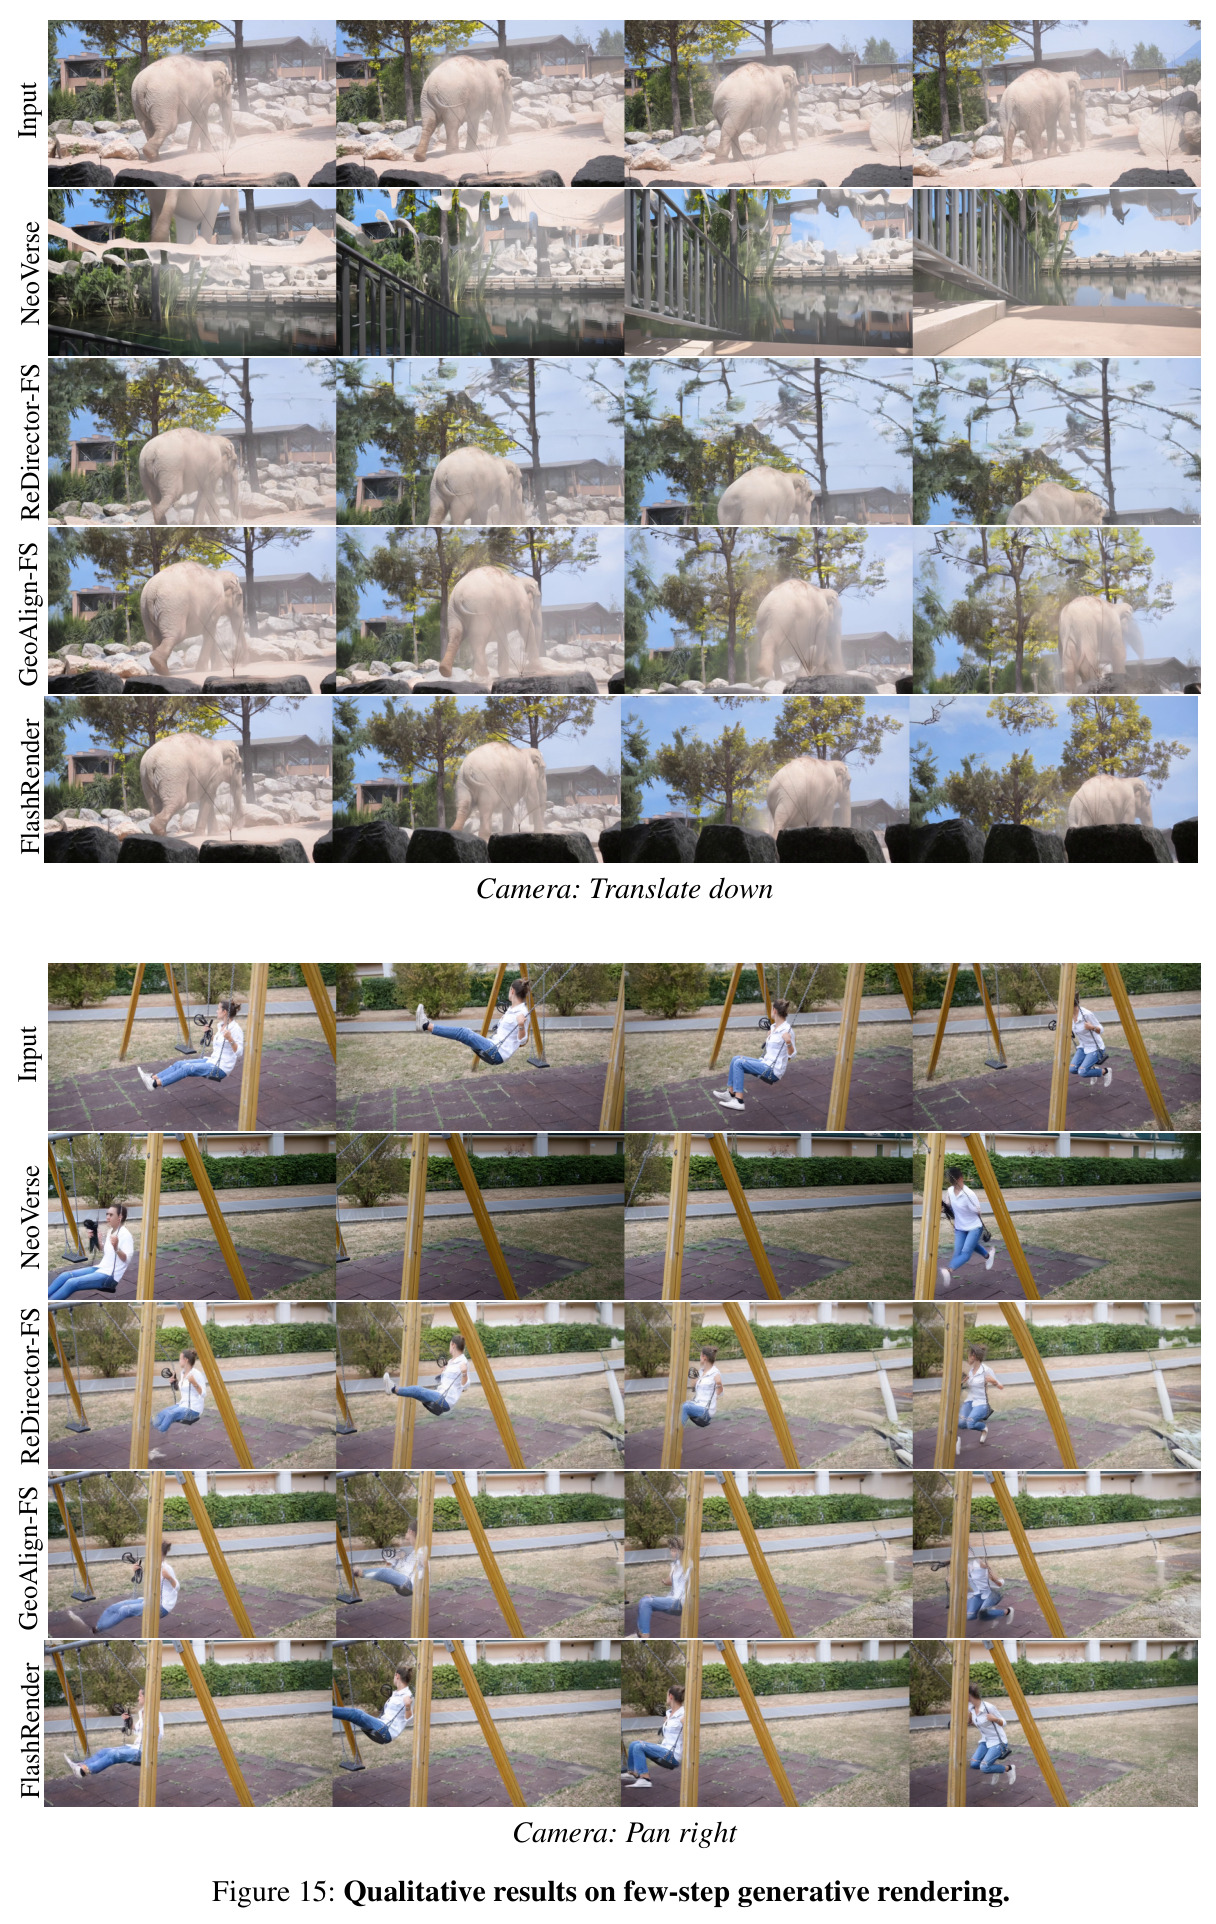
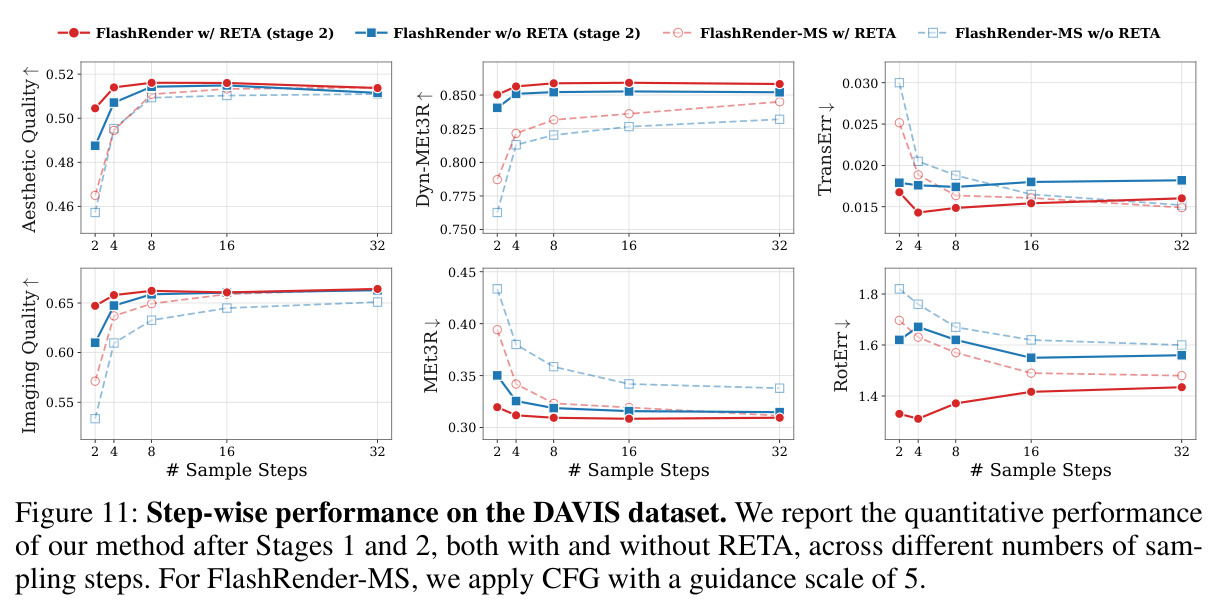
在 DAVIS 的 500 个评测样例(50 条视频 × 10 条轨迹)上,少步组(4-NFE)中 FlashRender 取得 Aesthetic 0.5182、Imaging 0.6654、Dyn-MEt3R 0.8571、MEt3R 0.3071、TransErr 0.0122、RotErr 1.236,几乎全面第一,相机精度甚至优于多步模型 GeoAlign(0.0149/1.495)。少步基线中 GeoAlign-FS 为 0.0158/1.528,ReDirector-FS 为 0.0179/1.746,NeoVerse 相机误差高一个量级(0.0343/3.495)且 Dyn-MEt3R 仅 0.7523。成本上 4-NFE 对 100-NFE、0.2 分钟对 6.5 分钟(480×832、单张 B200),采样成本降 25 倍、提速约 32 倍,质量与多步持平。消融(Table 2):去 RETA 后 RotErr 升至 1.685;换 VideoREPA 反而更差(RotErr 1.514);跳过 Stage 2 则 Imaging 跌至 0.6312、Dyn-MEt3R 0.8444;跳过 Stage 3 则 MEt3R 恶化到 0.3119。Stage 3 目标消融(Table 4):AnyFlow 式 DMD+MF 的 RotErr 1.427,本文 DMD+GAN 达 1.236。附录分析:FlashRender-MS 跨步数成对 PSNR 均值 23.7 dB(对手 21.6–23.1),曲率全程更低(Fig. 8b)。分布外评测(DyCheck,Table 3):FlashRender 以 0.4454/0.7487 的视觉质量与 0.8424 的 Dyn-MEt3R 超过所有多步基线,仅 PSNR(10.47,ReDirector 为 10.82)因场景尺度失配略低。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| DAVIS 视频重摄·视觉质量(4-NFE) | VBench Aesthetic Quality(↑) | 0.5182 | GeoAlign-FS 0.5083 / NeoVerse 0.5012 | +0.0099(对最佳少步基线),并超过除 GeoAlign 外的所有多步基线 |
| DAVIS 视频重摄·几何一致性(4-NFE) | Dyn-MEt3R(↑) | 0.8571 | GeoAlign-FS 0.8465;多步 GeoAlign 0.8532 | 超过全部少步与多步基线,少步模型首次反超多步 |
| DAVIS 视频重摄·相机可控性(4-NFE) | TransErr(↓)/ RotErr(↓) | 0.0122 / 1.236 | GeoAlign-FS 0.0158 / 1.528;多步 GeoAlign 0.0149 / 1.495 | 对最佳少步基线降低约 22.8% / 19.1%,且优于全部多步模型 |
| DAVIS 视频重摄·与输入一致性 | MEt3R(↓) | 0.3071 | GeoAlign 0.3111(多步最佳) | 内容保持更优,4-NFE 即可追平多步水平 |
| 推理成本 | NFE / 单视频运行时间(480×832,B200) | 4-NFE / 0.2 分钟 | 多步基线 2×50-NFE / 6.5 分钟 | 采样成本降 25 倍,提速约 32.5 倍 |
| DyCheck 分布外泛化(4-NFE) | Aesthetic / Imaging / Dyn-MEt3R | 0.4454 / 0.7487 / 0.8424 | 最佳多步 ReCamMaster:0.4122 / 0.7203 / 0.8320 | 全面领先,少步模型在 OOD 轨迹上超过全部多步基线 |
| 采样步数一致性(附录,FlashRender-MS) | 跨步数成对 PSNR 均值(↑) | 23.7 dB | GeoAlign 23.1 / ReDirector 22.3 / ReCamMaster 21.6 dB | 相机控制对采样步数最不敏感,直接支撑少步可蒸馏性 |
局限与改进
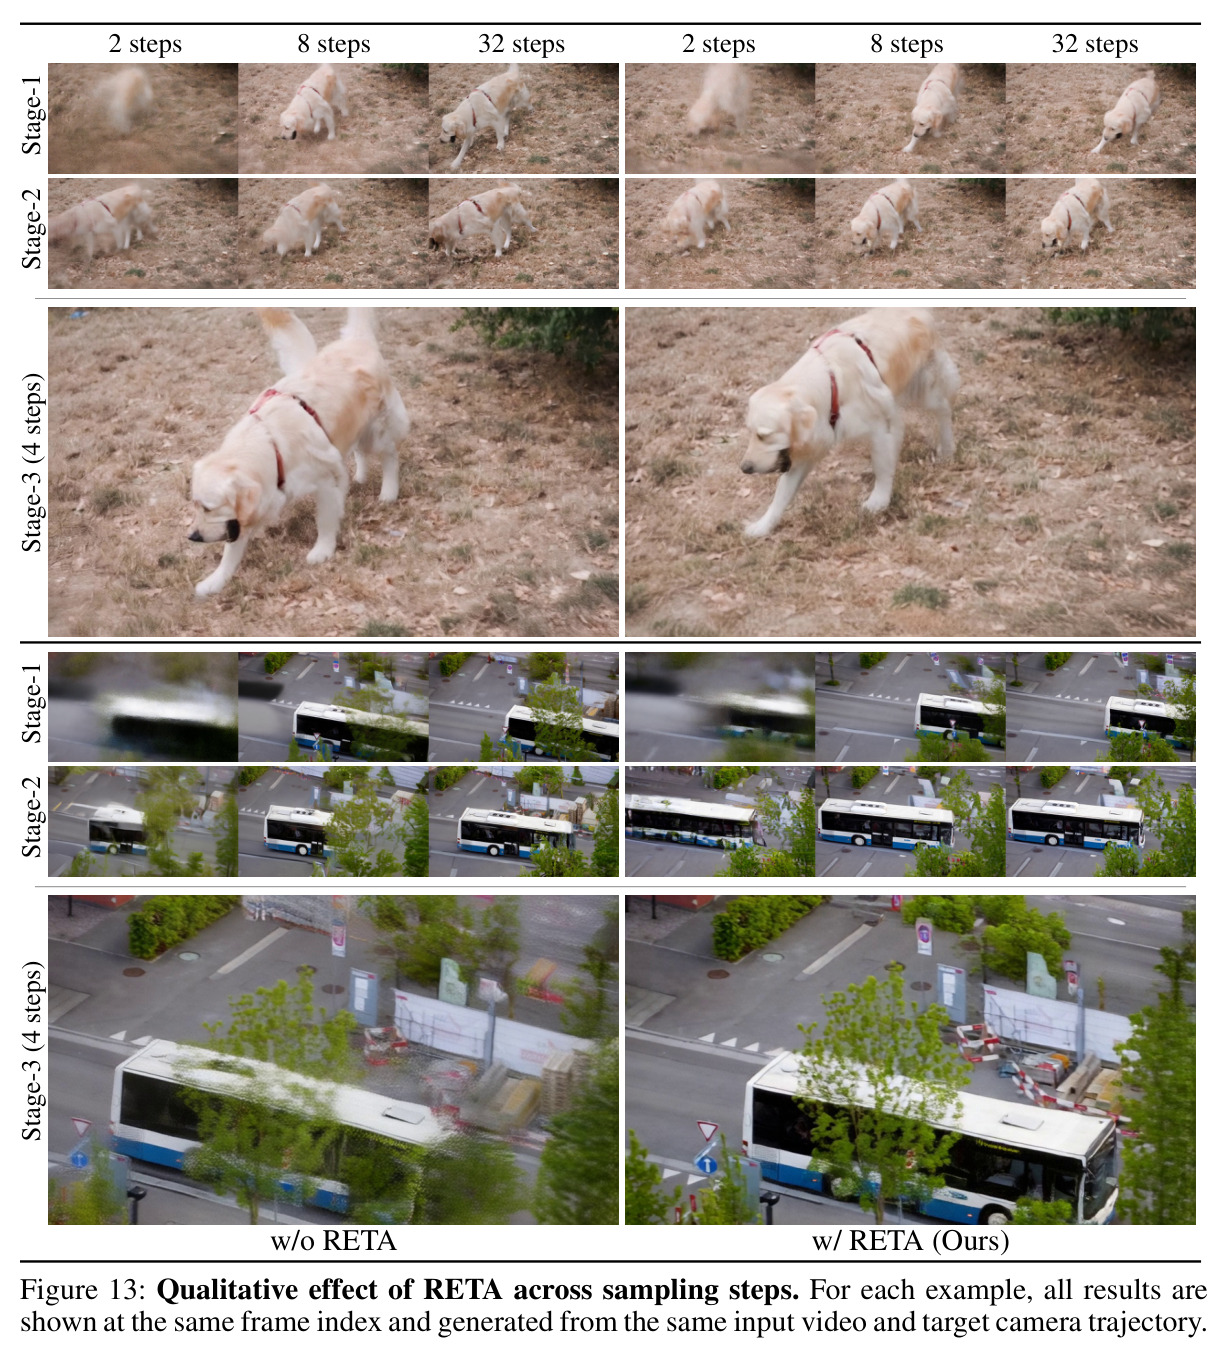
作者承认两点局限:其一,采样步数进一步降到 2-NFE 时性能大幅退化(Fig. 13),MeanFlow 在极低步数下无法充分消除离散化误差,连带削弱后续在线蒸馏的修正能力;其二,在移动输入相机下定位动态物体仍逊于近期 4D 重建方法(如 D4RT、π3 等)。此外 DyCheck 上保真度低于多步模型(PSNR 10.47 vs 10.82),作者归因于场景尺度失配。我的补充观察:(1) RETA 训练依赖成对多机位数据(MultiCamVideo/SynCamVideo)与可估计位姿,监督信号受 VGGT 重建质量制约,能否扩展到无位姿野外视频尚无验证;(2) Stage 3 把 4 步日程硬编码进自展开,牺牲了 AnyFlow 式任意步灵活性;(3) 训练成本高(8 卡两周),基座仅 1.3B、480×832×81 帧,更高分辨率与更长时序未验证;(4) 评测轨迹为规则化的 pan/tilt/zoom/translate/arc 增量式轨迹,剧烈晃动或变速轨迹下的表现未知;(5) VBench/MEt3R 属代理指标,时序闪烁等伪影可能被低估。
独立分析的弱点
独立分析以下弱点并给出改进方向。(1) 固定步数蒸馏:推理日程 $(t_1,t_2,t_3)=(0.249,0.499,0.749)$ 写死在 Stage 3 自展开中,部署 2 步或 8 步需重训;可借鉴连续时间流映射蒸馏(Align Your Flow)或对多组日程联合训练,恢复步数灵活性。(2) 成对数据瓶颈:RETA 需要源-目标视频对与已知/可估计位姿;可用双视角互蒸馏等自监督几何一致性,或用 VGGT 测试时输出的深度/位姿构造伪标签扩展到野外数据。(3) 尺度失配:DyCheck 上 PSNR 下降源于度量尺度不对齐;可引入显式尺度对齐模块,或用单目度量深度先验规范化相对位姿编码。(4) 动态物体定位弱:隐式范式缺乏显式 3D 约束;可融合点轨迹监督(如 MVTrack4Gen)或轻量 4D 代理做几何校验。(5) 2-NFE 失效:曲率虽降但非零;可叠加轨迹拉直微调或一致性正则进一步压低曲率。(6) 指标风险:相机精度与主观质量依赖代理指标,建议补充用户研究与真实影视/VR 场景案例验证。
未来方向
作者提出的未来方向:(1) 引入更强的场景重建骨干,改善移动相机下的动态物体定位与几何精度;(2) 采用更可扩展的扩散训练策略(稀疏 MoE、去噪任务路由、表示自编码器等)提升模型容量与训练效率;(3) 把相机控制之外的条件(如人物中心表征)纳入统一框架,拓展到角色重演等任务;(4) 与自回归视频生成框架结合,实现流式、实时的生成式渲染。基于本文成果可自然延伸:(5) 把 RETA『源流几何内化』的思想推广到主体/物体运动重定向等更一般的视频到视频编辑任务;(6) 将 Eq. 16 曲率度量发展为通用诊断工具,指导其他条件生成任务选择蒸馏时机与目标;(7) 利用 0.2 分钟/条的延迟优势,把 FlashRender 嵌入 VR 取景、虚拟制片的实时预览迭代流程;(8) 在 MeanFlow 蒸馏中引入测试时自适应,针对分布外轨迹做轻量微调,进一步拉开 DyCheck 类场景的保真度差距。
复现评估
复现条件总体友好但有门槛。基座 Wan2.1-1.3B-CamCtrl、VGGT、ViPE、训练数据 MultiCamVideo/SynCamVideo 与评测集 DAVIS/DyCheck(沿用 ReDirector 协议)均公开可得;附录 A 给出完整超参:三阶段分别 20k/20k/5k 迭代、学习率 $10^{-4}/3\times10^{-5}/10^{-5}$、全局 batch 8、文本 dropout 0.1、$\lambda_{RETA}=0.1$、$\lambda_{GAN}=0.03$、$\delta t=0.005$、$g=0.75$、shift $s=5$、时间步采样规则与十种目标轨迹的逐帧增量定义,并提供 Alg. 1/2 伪代码,Eq. 16 曲率度量亦可复用为诊断工具。算力需求为 8×RTX PRO 6000、约两周训练,属中等偏上规模:个人难以完整复现,具备视频 DiT 多卡训练经验的团队可以胜任。潜在风险:论文未声明代码开源(有项目页 byeongjun-park.github.io/FlashRender/),判别器与 fake-score 模型细节依赖 DMD2/AnyFlow 默认实现,上游变动可能引入偏差。综合评级:文档充分、数据可得、难度中高。
论文图表
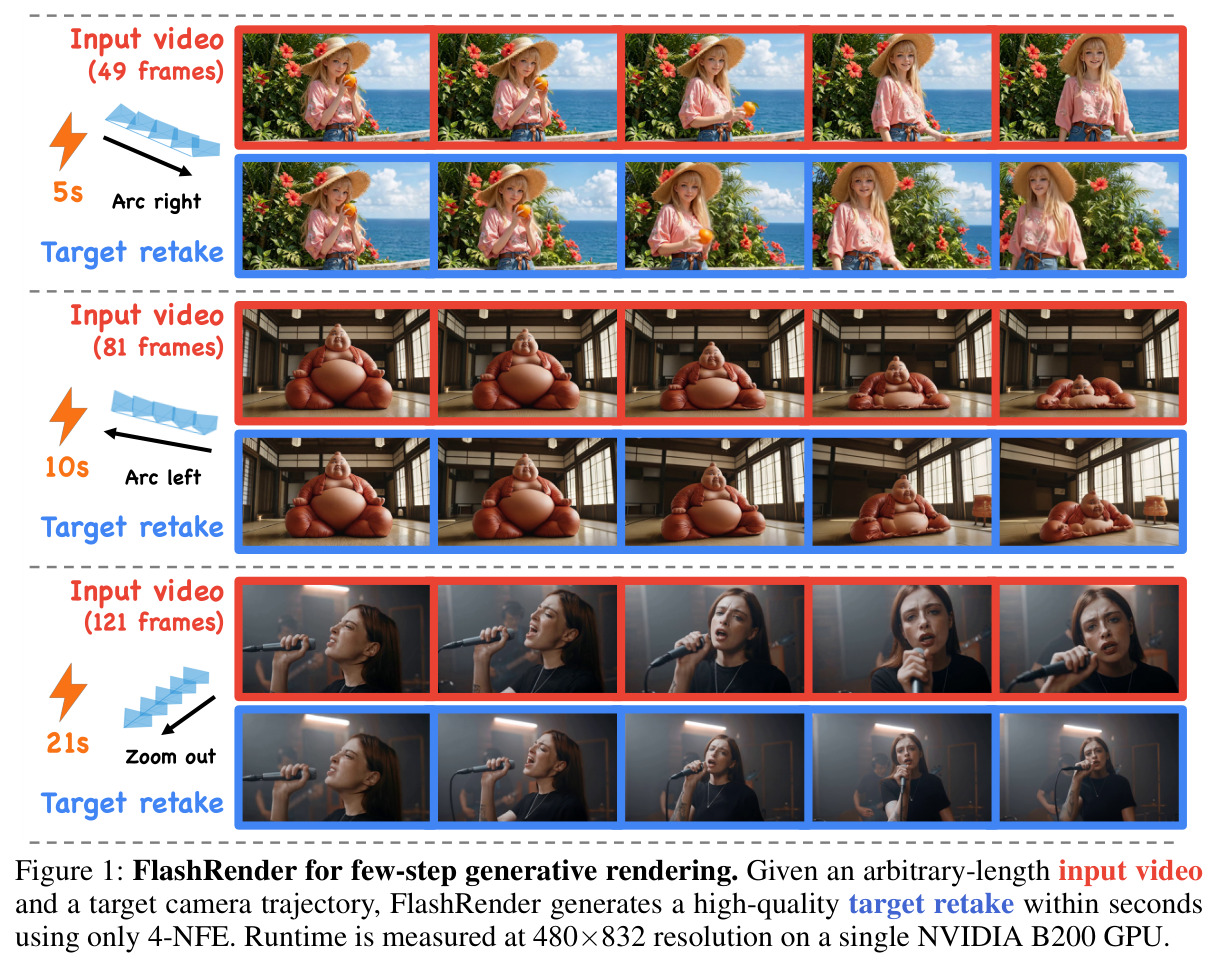
宣传图:三个示例分别以 49、81、121 帧的任意长度输入视频,沿 Arc right、Arc left、Zoom out 三种目标相机轨迹生成目标重拍(Target retake),强调仅用 4-NFE、数秒内完成,并标注运行环境为 480×832 分辨率、单张 NVIDIA B200。
一图看懂任务定位与核心卖点:任意长度输入、用户指定轨迹、少步采样、秒级延迟,是理解论文动机与实用价值的入口。
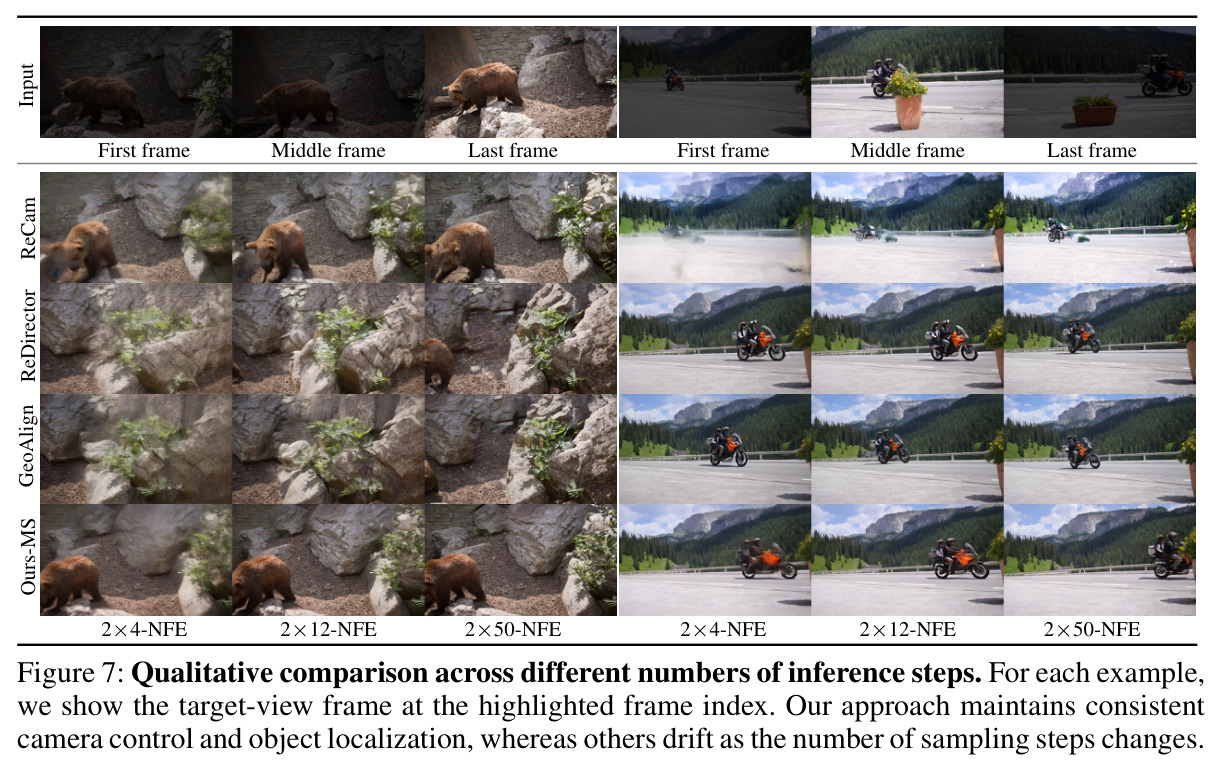
同一目标轨迹下分别用 2×4、2×12、2×50 NFE 生成并对比关键帧:ReCamMaster、ReDirector、GeoAlign 的场景尺度与物体位置随步数漂移,FlashRender-MS 的相机控制与物体定位保持一致。
『采样步数相关的相机控制』这一核心问题的可视化,是论文问题定义(motivation)最直接的图像证据。
DyCheck 分布外评测表:报告 NFE、视觉质量、几何一致性与保真度(PSNR/LPIPS)。FlashRender(4-NFE)取得 Aesthetic 0.4454、Imaging 0.7487、Dyn-MEt3R 0.8424、MEt3R 0.3323、PSNR 10.47、LPIPS 0.669,视觉质量与一致性超过所有多步基线,保真度略低于 ReDirector 的 10.82。
泛化性主张的量化支撑,同时明确了保真度—一致性的权衡与尺度失配的来源。