AnyGameRenderer:跨游戏的实体一致性生成式渲染与实体级基准 AnyGameRenderer: Entity-Consistent Generative Rendering Across Games and an Entity-Level Benchmark
LoRA 微调视频模型,把游戏粗糙画面渲染成高质量视觉且保持实体同步
前置知识
视频到视频生成式渲染(video-to-video generative rendering)
把游戏拆成两层:引擎负责维护状态(逻辑、物理、碰撞、实体计数),生成模型只负责把引擎输出的中间画面'翻译'成高视觉质量的像素。与用自回归视频模型直接替代引擎的世界模型路线(Genie、GameNGen、Oasis 等)相对,这条路线牺牲一点开放生成能力,换来对实体数量、脚本事件、规则长达数分钟的精确控制。
本文的全部设计(纯视频输入、对应契约、实体级评测)都建立在这个'引擎管状态、模型管像素'的架构假设上,理解它才能明白为什么实体对应性是可优化的目标。
LoRA 低秩适配微调
冻结预训练模型全部权重,只在每个 transformer 块的自注意力和前馈层旁路注入低秩矩阵 $BA$($W' = W + \alpha BA$,$B \in \mathbb{R}^{d \times r}$,$A \in \mathbb{R}^{r \times k}$,秩 $r \ll d$),只训练新增参数。参数量和显存占用大幅降低,且可以通过一个乘法系数(LoRA multiplier)在推理时缩放适配强度。
本文在 33B 视频模型 MiniMax-H3 上只训练 rank-128 的 LoRA(16 张 H200 约 48 小时)就获得实体对应能力,并靠 multiplier 1.0/0.7 切换域内/域外风格,这是理解其实验成本与部署策略的关键。
DiT 与流匹配(flow matching)目标
Diffusion Transformer(DiT)是当前主流视频扩散模型的骨干。流匹配训练目标让网络学习速度场:在 $x_t = (1-t)x_0 + t x_1$ 的线性插值路径上回归 $v_ heta(x_t, t) \approx x_1 - x_0$,损失为 $\mathcal{L} = \mathbb{E}\left[\|v_\theta(x_t,t) - (x_1 - x_0)\|^2\right]$,推理时用常微分方程数值积分(如 Euler 法)逐步去噪生成样本。
本文的训练目标就是标准流匹配(论文明确写了'flow-matching objective'),推理用 20 步 Euler 采样,这是复现训练和推理时的直接依据。
参考条件视频编辑(MiniMax-H3 ref2va 模式)
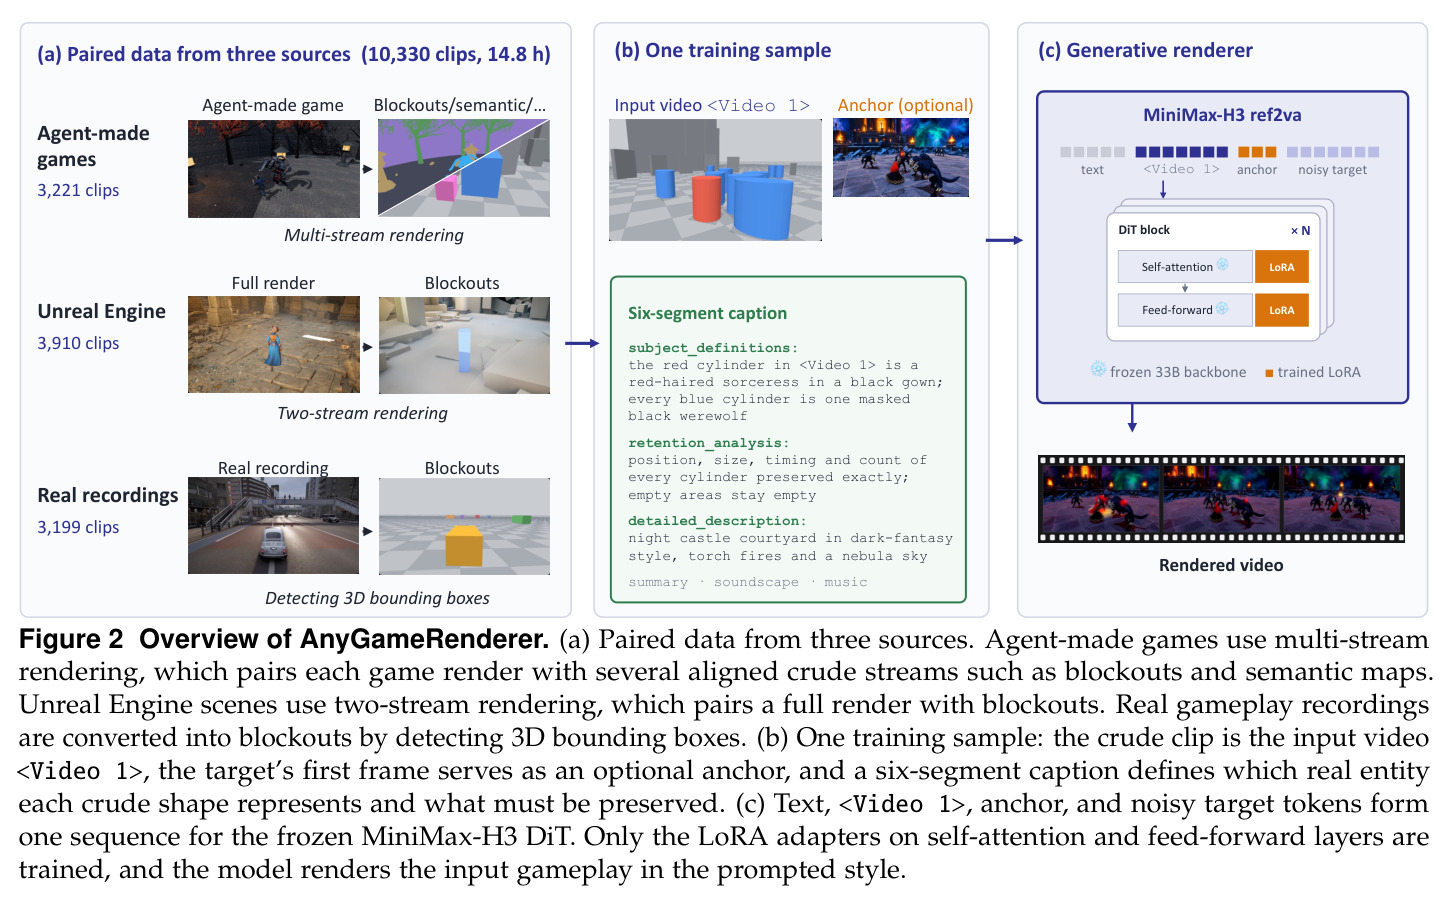
ref2va 是 MiniMax-H3 的一种推理模式:输入一个参考视频(记为 <Video 1>)、文本提示和可选锚定图像,输出按提示编辑后的视频,保持参考视频的时序结构。本文把粗糙游戏实录作为参考视频传入,从而天然获得逐帧结构对齐——粗糙画面本身就是'结构条件',不需要额外的 ControlNet 或空间条件模块。
这是本文能'接受纯视频输入'的技术根基:对比 PWM 需要 3D 有向框加空间 ControlNet、CWM 需要 12 类语义代理图,ref2va 让任意粗糙画面都能直接当条件。
IoU 与匈牙利匹配(实体级评测基础)
交并比 IoU 衡量两个框的重叠程度(交集面积除以并集面积)。匈牙利算法求解二部图最优匹配:给定输入实体的 GT 框集合和生成视频中的检测框集合,找到总代价最小的逐帧一一配对方案。本文的匹配接受条件是 IoU ≥ 0.3,或质心偏移 $d$ 小于输入框尺寸 $s$ 的一半,存活少于 12 帧的实体忽略不计。
本文提出的四个指标——时间匹配、位置匹配($\text{match} = 1 - d/(0.5s)$)、未渲染率、幻觉率——全部建立在这套'检测→跟踪→逐帧匹配'管线上,不熟悉 IoU 和匈牙利匹配就无法理解评测的精度与局限。
G-buffer 与语义分割图
G-buffer 是渲染引擎在成像过程中输出的中间缓冲(法线、深度、材质 ID、对象分割等),传统神经渲染用它们做条件输入能获得像素级精确控制;语义分割图则是把每个像素标注为离散类别(如 12 类:人物、载具、建筑)的 2D 图。两者都是'昂贵但精确'的结构化中间表示。
理解它们才能领会本文的差异化立场:并发系统依赖这类每对象标注,而本文证明纯视频(灰 blockout、彩色几何体)加文本契约就足够,省去引擎改造和逐对象标注成本。
研究动机
AI 编程智能体(如 Recursive Game Creator、OpenGame)已能在几分钟内把一段提示变成可玩的游戏,含游戏逻辑、物理、相机、胜负条件甚至 HUD,但产出是典型的“程序员美术”:灰色 blockout、彩色圆柱圆锥、平涂地面,人工工作室要花数月建模贴图打光才能替换。“引擎管状态 + 生成模型管像素”已成共识,并发工作如 CWM、PWM、Matrix-Game 4.0、StreamRender-H3 等都在采用,但有两类问题。其一是输入表示昂贵:CWM 要求智能体维护世界状态并输出 12 类代理视频,PWM 要求状态增强 3D 有向框加空间 ControlNet,Matrix-Game 4.0 要求低多边形引擎代理,且它们只在第三人称、第一人称或驾驶画面上演示,覆盖不了智能体实际产出的塔防、自走棋、俯视角生存等品类。其二是评测失明:现有渲染器用帧级指标(边缘一致性、点轨迹、成对裁判),小实体丢失、群体晚到几乎不影响分数,边缘一致性甚至奖励“把粗糙色块原样保留”。
本文的目标是本文要构建一个 video-to-video 生成式渲染层,输入是智能体生成游戏的粗糙实录(纯视频,无引擎 G-buffer、无逐对象类别标签、无低多边形代理)加文本提示(可选风格锚定图),输出同一局游戏在提示风格下的高质量画面,且逐帧保持布局、相机和每个实体的位置与时间。具体拆成三条可验证的性质:第一,单一检查点跨品类泛化,覆盖塔防、自走棋、俯视角生存、回合制战斗、卡丁车、人群跑酷、竞技场生存、联机合作、射击等智能体实际生成的品类,且灰 blockout、彩色几何体、语义图、线框图都能作为输入;第二,保持实体对应——12 个敌人死掉 3 个变 9 个必须在正确帧发生,增援波次在 $t = 4.2$ 秒进场就要准时出现,远处小实体不能溶解成雾;第三,切换风格只需改提示词,游戏只剩代码和 blockout,跳过建模、贴图、动画三个阶段,把 vibe gaming 做得更快。
与已有工作不同的是,本文的独特切入是把'实体对应(bookkeeping)'——计数、时序、位置——当成训练数据和评测的首要目标,这是与所有并发工作的本质区别。三个差异点:其一,品类覆盖广,并发系统主要演示写实第三人称、驾驶或少数自建 3D 场景,本文覆盖九类智能体常作品类和五种输入粒度;其二,输入是纯视频,不要求固定中间表示,一个检查点通吃从灰 blockout 到线框图的不同粗糙程度;其三,首个提出实体级基准与四项指标(时间匹配、位置匹配、未渲染率、幻觉率),明确指出帧级指标在实体错误面前'几乎不变'的盲区。数据构造也围绕零样本失败模式反向设计:Unreal 双流数据脚本化制造同色组计数中途变化、20–600 像素的实体尺寸、四种混合相机视角,直接针对'群体留在未渲染色块'、'实体迟到或永不出现'、'远处小实体消失'三类失败教学。
核心方法
整体思路是把游戏渲染视为参考条件视频编辑:给定粗糙实录 $V_{in} \in \mathbb{R}^{T \times H \times W \times 3}$ 和文本提示 $c$(描述目标风格及每个粗糙实体代表什么),生成同长同分辨率的 $V_{out}$,满足相机、布局、时序逐帧匹配;每个粗糙实体变成同位置、同表观尺寸、同朝向的成品对应物且出现/消失帧一致;外观遵循提示与锚定图 $I_a$。技术路线是在 MiniMax-H3(33B 参考视频条件模型)的 ref2va 模式上做 LoRA 微调:粗糙 clip 作为参考视频 传入,天然锁定时序结构;六段结构化 caption 承担“对应契约”;锚定图训练时取目标首帧、推理时作风格参考或省略。训练用流匹配目标 $\mathcal{L} = \mathbb{E}[\|v_\theta(x_t,t) - (x_1 - x_0)\|^2]$,$x_t = (1-t)x_0 + t x_1$,只训全部块自注意力和前馈层的 rank-128 LoRA,骨干冻结。推理用 20 步 Euler 采样,24fps、最高 768p,禁用音频。
核心创新是“对应契约”caption 模式加三源配对数据,让纯视频输入也能获得实体级监督——本质区别在于:CWM 靠引擎维护状态输出语义代理,PWM 靠 3D 框加结构化空间 ControlNet,本文把“每个粗糙形状是什么实体、什么必须逐帧保留”写成正向文本断言。契约四条规则:第一,主体即实体,逐 clip 建立颜色到身份的映射,如 'every blue ellipsoid in is one raccoon-like orchard raider',群体按类描述并显式声明存在。第二,retention_analysis 段固定输入权威性:声明位置、表观尺寸、时序、数量精确保留,外观交给提示,并正向描述空白——'areas empty in stay empty'。第三,只用正向断言:基座没有负向提示,负向措辞会生成它提到的东西(写 'no HUD' 会可靠产出 HUD)。第四,caption 程序化生成并故意加噪:列出所有角色即使本 clip 未出现,教会模型从视频而非文本判断实体存在,因此模型很少添加 caption 提到但输入缺失的角色。
方法步骤详情
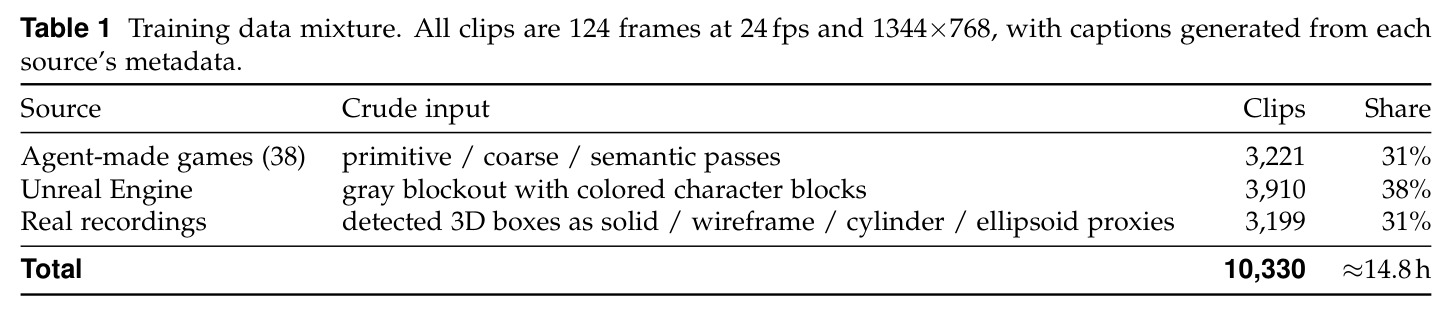
第一步构建三源配对数据。38 个智能体游戏多流渲染:每 clip 五条对齐通路(目标渲染、primitive 灰 blockout、coarse 低模、12 类语义图、深度),取 primitive 与目标配对,3,221 clips;Unreal 双流渲染:同一仿真输出灰 blockout(主角恒蓝、其余六色系)与全渲染,脚本化制造 2–20 人同色组增减、多颜色进出、20–600px 实体、混合相机,3,910 clips;真实实录:检测 3D 框,在棋盘地面渲染实心/线框/圆柱/椭球四种代理(各约 800 clips),原实录为目标,3,199 clips;合计 10,330 clips 约 14.8 小时。第二步统一格式与 caption:重采样为 124 帧、24fps、1344×768,目标首帧作锚,latent 与文本嵌入按源缓存,caption 由引擎元数据和检测结果程序化生成。第三步训练:全局 batch 16,学习率 100 步预热后余弦衰减(峰值 $2\times10^{-5}$ 至 $2.8\times10^{-5}$),weight decay 0.01,bf16 加梯度检查点加 block swapping,FlashAttention-3 提速约 30%,16 张 H200 每步约 129 秒、3 epoch 约 48 小时。第四步部署:域内用 LoRA multiplier 1.0,域外纯文本风格用 0.7。
技术新颖性
技术新颖性在四个层面。输入表示层面:用“纯视频 + 文本契约”替代 CWM 的 12 类代理视频、PWM 的状态增强 3D 有向框加空间 ControlNet、Matrix-Game 4.0 的低多边形引擎代理,一个检查点跨灰 blockout、彩色几何体、语义图、线框、粗陶模型五种粒度,大幅降低引擎改造成本。监督信号层面:把实体对应(计数、时序、位置)写进 retention_analysis,并配合针对失败模式设计的 Unreal 场景——同色组计数变化专门针对“群体留在未渲染色块”和“迟到”,使对应性成为显式训练目标而非视觉质量的副产品;“故意加噪的 caption”(列出未出场角色)是反直觉但有效的正则化。评测层面:首个实体级基准,用 SAM3 开放词汇分割定位角色、匈牙利算法逐帧匹配输入框与检测框(IoU ≥ 0.3 或质心偏移在半框内),并用 GT floor 校准指标上限,揭示帧级指标和边缘一致性的盲区。工程层面:FlashAttention-3、block swapping 与 LoRA 让 33B 模型适配控制在 16×H200 约 48 小时,multiplier 缩放提供域内外风格一键切换。
实验结果
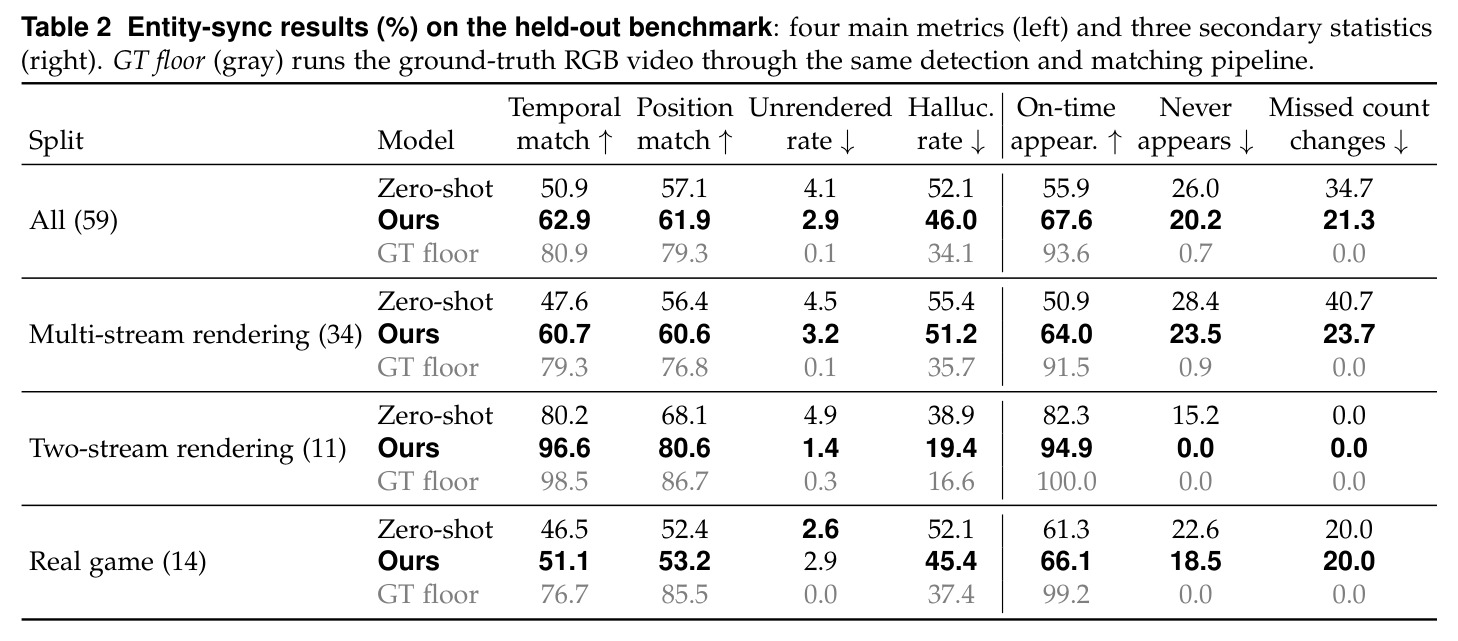
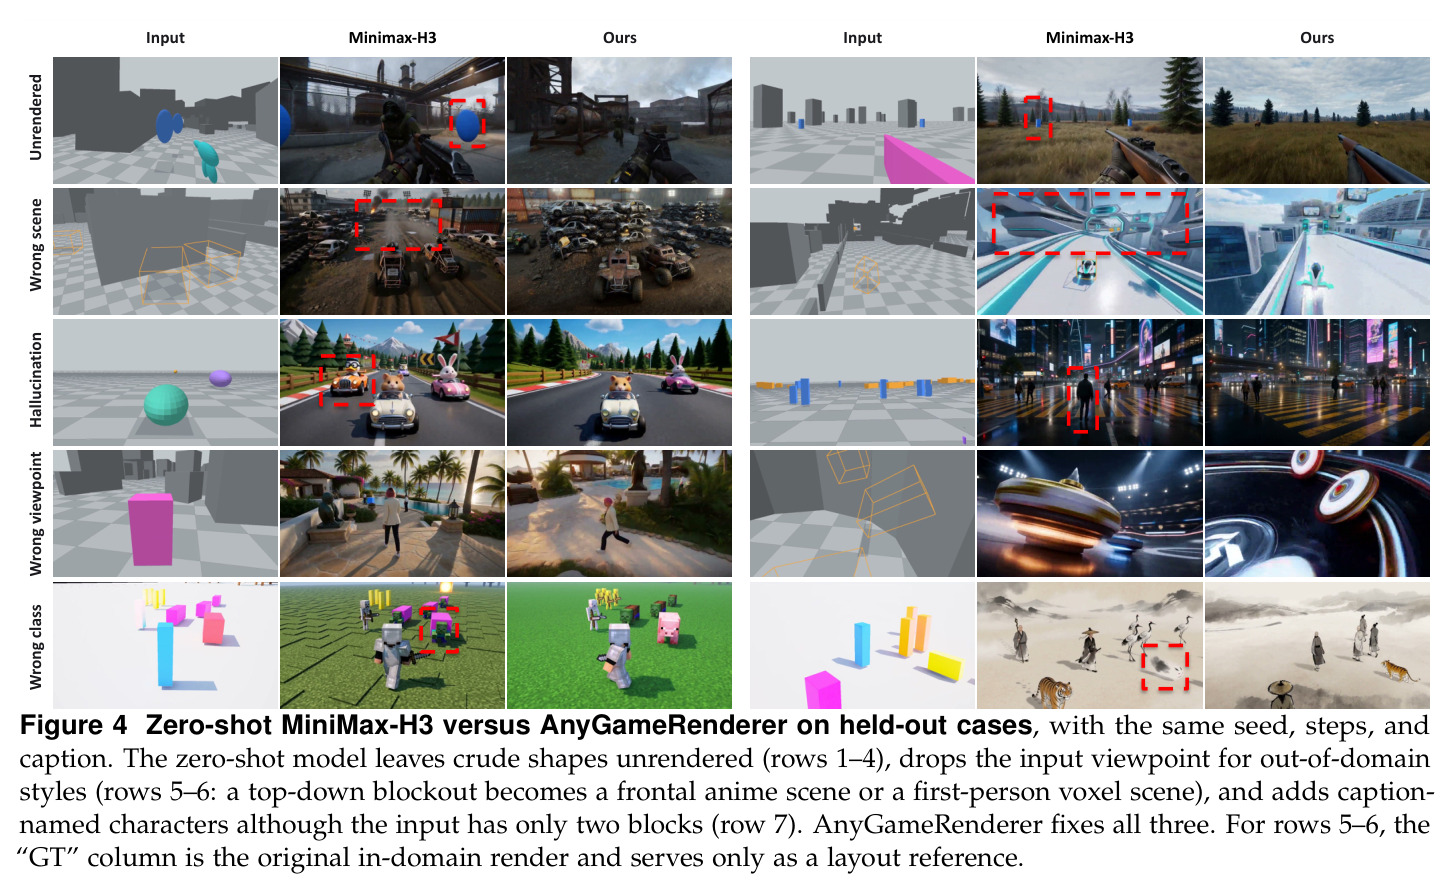
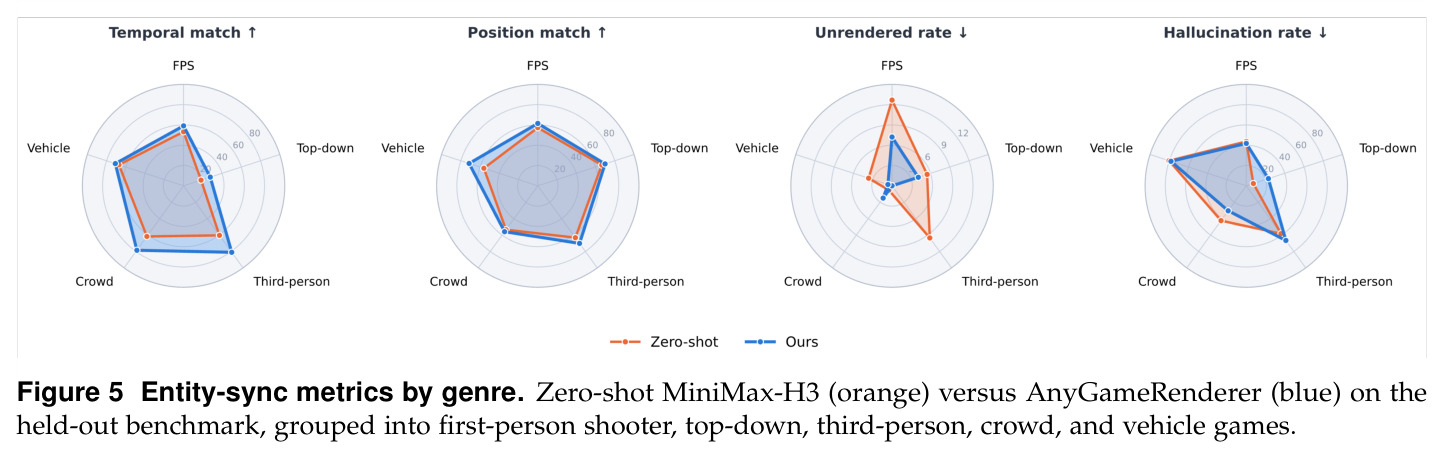
在 59 个 held-out 案例、753 个标注实体(11 个 Unreal 双流、14 个真实实录、34 个多流渲染)的实体级基准上,对比零样本基座:时间匹配 50.9% 升至 62.9%,位置匹配 57.1% 升至 61.9%,未渲染率 4.1% 降至 2.9%,幻觉率 52.1% 降至 46.0%;准时出现 55.9% 升至 67.6%,从未出现 26.0% 降至 20.2%,漏检计数变化 34.7% 降至 21.3%。GT floor 为时间匹配 80.9%、幻觉率 34.1%,说明幻觉率距管线上限仍有约 12 点缺口。分源差异显著:Unreal 双流最强,时间匹配 96.6%(GT floor 98.5%)、无漏检计数变化、幻觉率降至 19.4%;智能体游戏多流次之,时间匹配 +13.1 点(47.6%→60.7%),漏检计数变化近乎减半(40.7%→23.7%);真实实录最弱,时间匹配仅 46.5%→51.1%,漏检计数变化停在 20.0%。品类上单一检查点覆盖 FPS、俯视、第三人称、人群、载具五类,人群与第三人称增益最大,俯视角最难,幻觉率在俯视和第三人称略升。定性上修复零样本三大失败:粗糙形状残留、丢视角、添加 caption 提到但输入不存在的角色。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 实体时间对应(59 案例 / 753 实体) | Temporal match(时间匹配)↑ | 62.9% | 50.9%(零样本 MiniMax-H3) | +12.0 个百分点,GT floor 为 80.9% |
| 实体位置对应 | Position match(位置匹配)↑ | 61.9% | 57.1%(零样本) | +4.8 个百分点,GT floor 为 79.3% |
| 粗糙色块残留 | Unrendered rate(未渲染率)↓ | 2.9% | 4.1%(零样本) | -1.2 个百分点,GT floor 为 0.1% |
| 虚构实体 | Hallucination rate(幻觉率)↓ | 46.0% | 52.1%(零样本) | -6.1 个百分点,GT floor 为 34.1% |
| 群体计数变化复现 | Missed count changes ↓ | 21.3% | 34.7%(零样本) | -13.4 个百分点,GT floor 为 0.0% |
| Unreal 双流子集实体时序 | Temporal match ↑ | 96.6% | 80.2%(零样本) | +16.4 个百分点,接近 GT floor 98.5%,无漏检计数变化 |
| 真实实录子集实体时序 | Temporal match ↑ | 51.1% | 46.5%(零样本) | +4.6 个百分点,三源中收益最小 |
| 实体准时出现 | On-time appearance ↑(|Δon| ≤ 4 帧) | 67.6% | 55.9%(零样本) | +11.7 个百分点 |
局限与改进
作者承认并可见于数据的局限:幻觉率仍高达 46.0%,接近每两个检测实体帧中一个无法对应输入实体,虽部分归因于评测管线(GT floor 本身幻觉率 34.1%),但与上限的 12 点差距是真实缺口;真实实录收益最小,时间匹配只涨 4.6 点,漏检计数变化 20.0% 不动,说明 3D 框代理与真实场景的域差距未完全弥合;俯视角仍是最难品类,两类模型时间匹配都低;位置匹配 61.9% 距 GT floor 79.3% 还有 17.4 点,匹配上的实体也有漂移。我的观察:其一,评测依赖 SAM3 开放词汇分割与 caption 主体短语作提示,对线稿、像素风等高度风格化输出可能有检测偏置,且基准仅 59 案例 753 实体、75 次计数变化,统计功效有限;其二,对应性只测计数、时序、位置,不测语义正确性——红色圆柱被渲染成任意红色物体都算匹配,无法发现“狼渲染成鹿”的错误;其三,所有 clip 仅 5.17 秒,分钟级长局的漂移累积未评估;其四,训练禁用音频损失、推理丢弃音频,但 caption 保留 soundscape/music 段,训练与推理目标不一致。
独立分析的弱点
独立弱点分析:第一,幻觉率瓶颈——46.0% 意味着模型在密集纹理区域(树叶、人群、反光地面)仍频繁虚构实体,改进方向是推理时做输入-输出差分一致性过滤并局部重生成,或把输入视频的深度/边缘作为显式空间条件约束非实体区域。第二,真实实录的 3D 框代理域差距——刚性代理丢失朝向、动作细节与遮挡,导致该分部时间匹配只提升 4.6 点,改进方向是用单目重建生成带姿态的低细节代理,或保留原实录背景只粗糙化实体区域。第三,无语义正确性度量——契约只保证“形状→某实体”的存在对应,不保证“渲染成 caption 指定的那个角色”,可加入 VLM 输出-提示一致性打分。第四,算力与速度——3 epoch 需 16×H200 约 48 小时,20 步 Euler 采样远非实时,可参考 SolarRenderer 蒸馏到 4 步并支持流式。第五,长局与 HUD 未验证——clip 上限 5.17 秒,真实一局数分钟,漂移累积和 HUD、粒子特效等非角色元素的处理都是空白,需要流式推理加记忆机制的评估。
未来方向
作者提出的方向:结语指出“随着编码智能体构建更多游戏,保持每个实体就位的通用渲染器将让这些游戏看起来和玩起来一样好”,隐含目标是把渲染器做成智能体游戏管线的标准层。可延伸研究:其一,流式与实时化——结合 SolarRenderer 已实现的 4 步渲染与流式推理,使 33B 模型跟上游戏帧率,这是走向可玩产品的前提;其二,可交互渲染——当前只保证视觉对应,下一步让生成画面中的点击、碰撞与引擎状态双向一致;其三,评测上限攻坚——GT floor 显示幻觉率上限 34.1%,提升 SAM3 在风格化画面上的开集检测本身即贡献,或用生成模型自身做开集检测器;其四,数据方法推广——把“针对失败模式脚本化设计 Unreal 场景”推广到物理交互、HUD、粒子特效等更难的对应对象;其五,恢复音频——caption 已含 soundscape 与 music 段,恢复音频损失可同步产出游戏音效;其六,与世界模型融合——本模型做保真锚点、世界模型做外推想象,兼得可控性与开放生成。
复现评估
复现评估:代码与项目页已公开(github.com/AlayaLab/AnyGameRenderer),方法描述非常详细——caption 四条契约规则、三源数据配比 31%/38%/31%、全部训练超参(rank-128、batch 16、峰值学习率 $2\times10^{-5}$ 至 $2.8\times10^{-5}$、weight decay 0.01、3 epoch)写明。算力门槛高:16 张 NVIDIA H200(141GB)训练约 48 小时;若只有 8×A100-80G,需梯度累积并接受更长时间,或缩小 rank 与分辨率。数据是最大不确定项:38 个智能体游戏依赖内部资产管线、Unreal 场景依赖内部渲染仓库、真实实录涉及版权游戏画面,论文未明确 10,330 clips 和 59 案例的 GT 框标注是否会开源,若不开源则实体级基准无法直接复用。评测还需 MiniMax-H3 33B 基座与 SAM3 分割模型。综合判断:有代码有基座时方法中等偏上可复现;算力有限的团队可先在小规模 Unreal 双流数据上复现对应性增益的核心结论。
论文图表
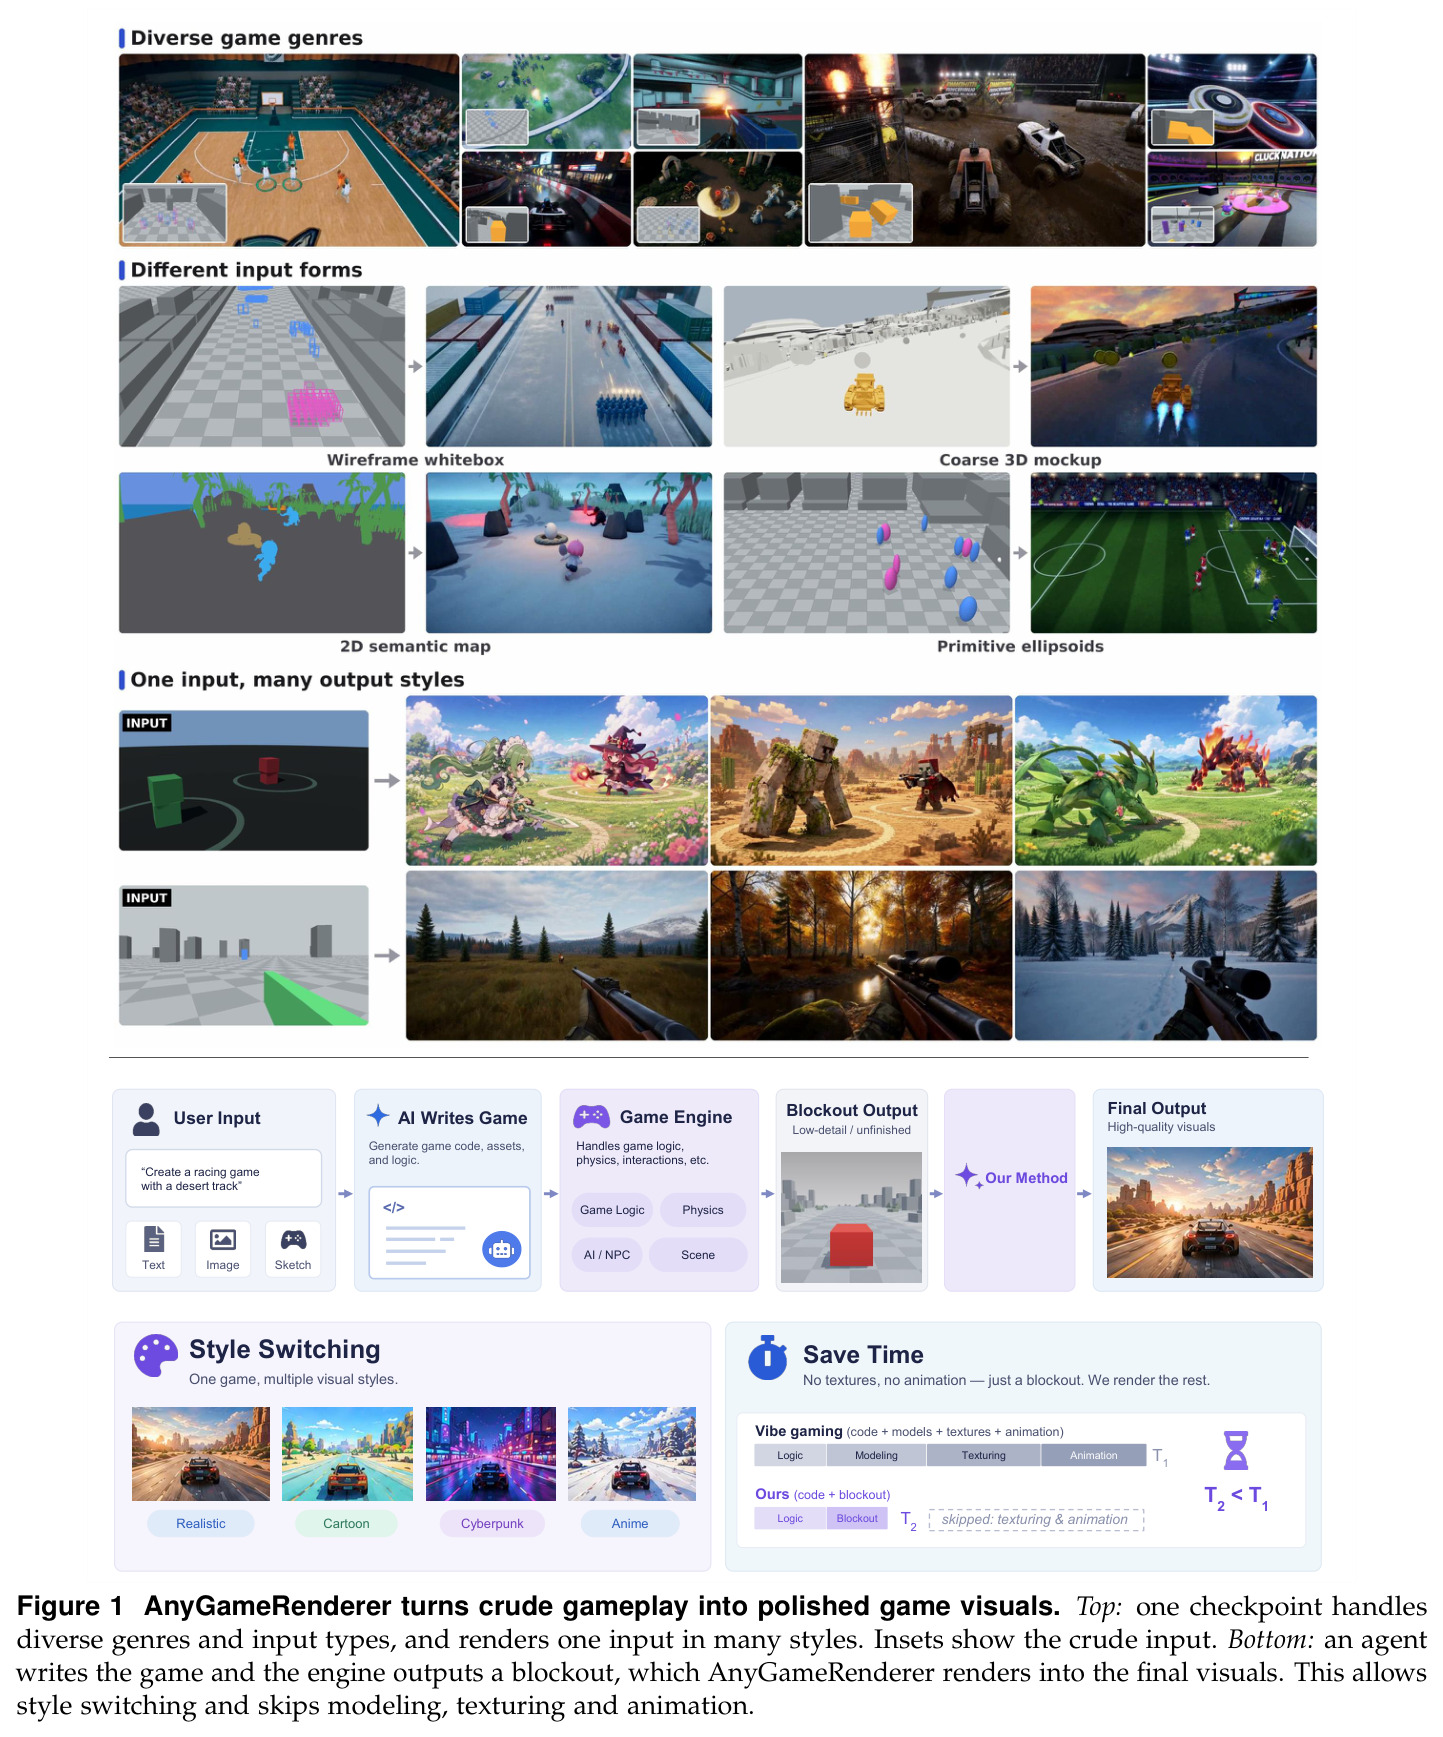
上半部分展示一个检查点处理多品类(塔防、自走棋、卡丁车等)和多种输入类型(灰 blockout、彩色几何体、语义图、线框),并将同一输入渲染成写实、卡通、赛博朋克、动漫多种风格;下半部分展示工作流:用户给一句提示,AI 编写游戏代码,游戏引擎处理逻辑物理并输出 blockout,AnyGameRenderer 渲染出最终高视觉质量画面;还对比了传统 vibe gaming(代码+模型+贴图+动画)与本文方案(代码+blockout)的时间线,说明跳过建模贴图动画带来的加速。
这是全文的任务定义图,一图说清输入输出关系、'引擎管状态生成模型管像素'的架构位置、以及风格切换和省时的两大实用卖点,读者应从此图建立对任务的直觉。
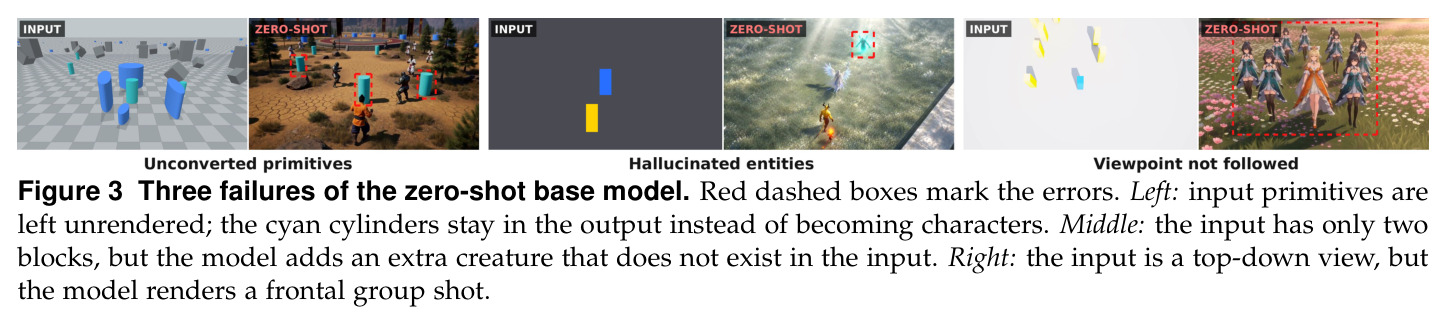
展示零样本 MiniMax-H3 的三类典型失败(红框标错):左——输入几何体未被渲染,青色圆柱原样留在输出里;中——输入只有两个色块,模型却多画了一只不存在的生物(幻觉);右——输入是俯视视角,模型却渲染成正面群像(丢视角)。
这三类失败直接决定了本文的数据设计(Unreal 场景脚本化针对未渲染和迟到)和评测指标设计(未渲染率、幻觉率),是理解'为什么要做实体级基准'的动机证据。