EvaOmni:面向音视频推理的证据锚定基准 EvaOmni: An Evidence-Grounded Benchmark for Audio-Visual Reasoning
要求模型同时给出答案与音视频证据区间,揭示强模型证据定位短板
前置知识
Omni LLM(全模态大语言模型)
能同时处理文本、图像、音频和视频的统一大模型,如 Gemini 系列、Qwen2.5/3-Omni。它们把各模态信号编码到共享表示空间,再做跨模态推理,典型结构是各自模态编码器接一个共享 LLM 骨干。与纯视觉语言模型(VLM)不同,Omni LLM 需要在时间轴上对齐连续的音频流和视觉流,理解'谁在什么时候说了什么、画面里同时发生了什么'。
本文的评测对象就是 24 个 Omni LLM(7 个开源 + 17 个闭源),理解这类模型的输入形态(视频帧 + 原生音频)和能力边界,才能读懂实验设计中 1.0 FPS 采样、480px 分辨率等设置的用意。
MCQ 评测与捷径问题(Shortcut)
多选题(Multiple-Choice Question)是视频问答基准的主流形式,只按最终选项是否正确打分。捷径指模型不需要真正分析音视频证据也能答对:仅看题干和选项就能靠常识逻辑猜出答案(文本捷径)、仅靠音频或仅靠画面就能答对(单模态捷径),甚至均匀随机猜测在四选项题上就有约 25% 的期望正确率。
捷径问题正是本文立论的出发点:作者实测 WorldSense 有 14.4% 的题只看文本就能答对、14.2% 只听音频可答、15.7% 只看画面可答。理解捷径的成因才能理解 EvaOmni 为什么要让模型同时输出证据区间。
时序定位与时序 IoU
时序定位(temporal grounding)指在视频时间轴上预测事件发生的时间区间 $[t_s, t_e]$。IoU(交并比)衡量预测区间与真值区间的重合程度:$\mathrm{IoU} = |P \cap G| / |P \cup G|$,即交集时长除以并集时长。对于多段证据,本文的做法是把所有预测区间取并集、所有标注区间取并集,再计算两个并集集合之间的 IoU。
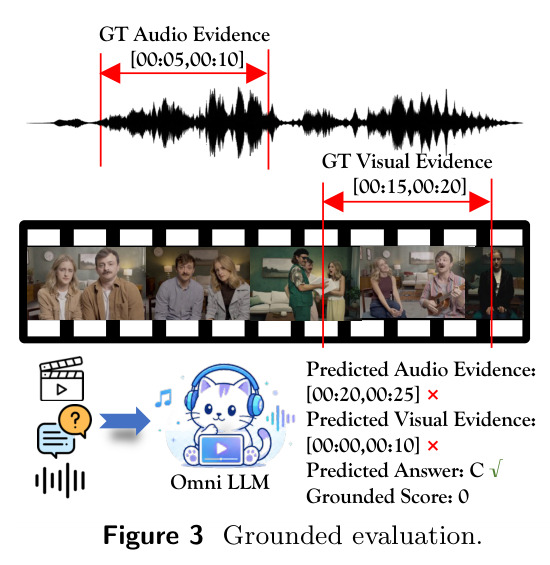
本文两个核心指标 C.G. 和 B.G. 都建立在区间匹配之上:C.G. 用宽松的'有正时长重叠即命中',B.G. 用严格的时序 IoU。不理解 IoU 就无法理解 B.G. 为什么能惩罚定位不准。
研究动机
现有音视频推理基准(Daily-Omni、WorldSense、OmniVideoBench、OmniBench 等 7 个代表性工作)几乎全部采用多选题(MCQ)且只按答案对错打分,这带来两个层面的可靠性问题。其一是答案对错无法区分'有证据支撑的正确'与'碰运气猜对':四选项题均匀随机猜测就有 25% 的期望正确率,这部分分数与模型是否真的使用了音频和画面完全无关。其二是题目和选项设计本身会引入捷径:作者用统一协议实测三个代表性基准,发现 WorldSense 有 14.4% 的题仅看题干和选项就能答对,14.2% 仅听音频就能答对,15.7% 仅看视频就能答对——这意味着相当比例的题目根本不需要双模态联合推理。作者也说明这一比例依赖测试所用模型,不算严格的捷径率,但已足以说明问题普遍存在。此外,开放式的 judge 模型评测又不客观、不方便,社区缺少一个既保持 MCQ 客观性、又能验证完整推理链的评测体系。
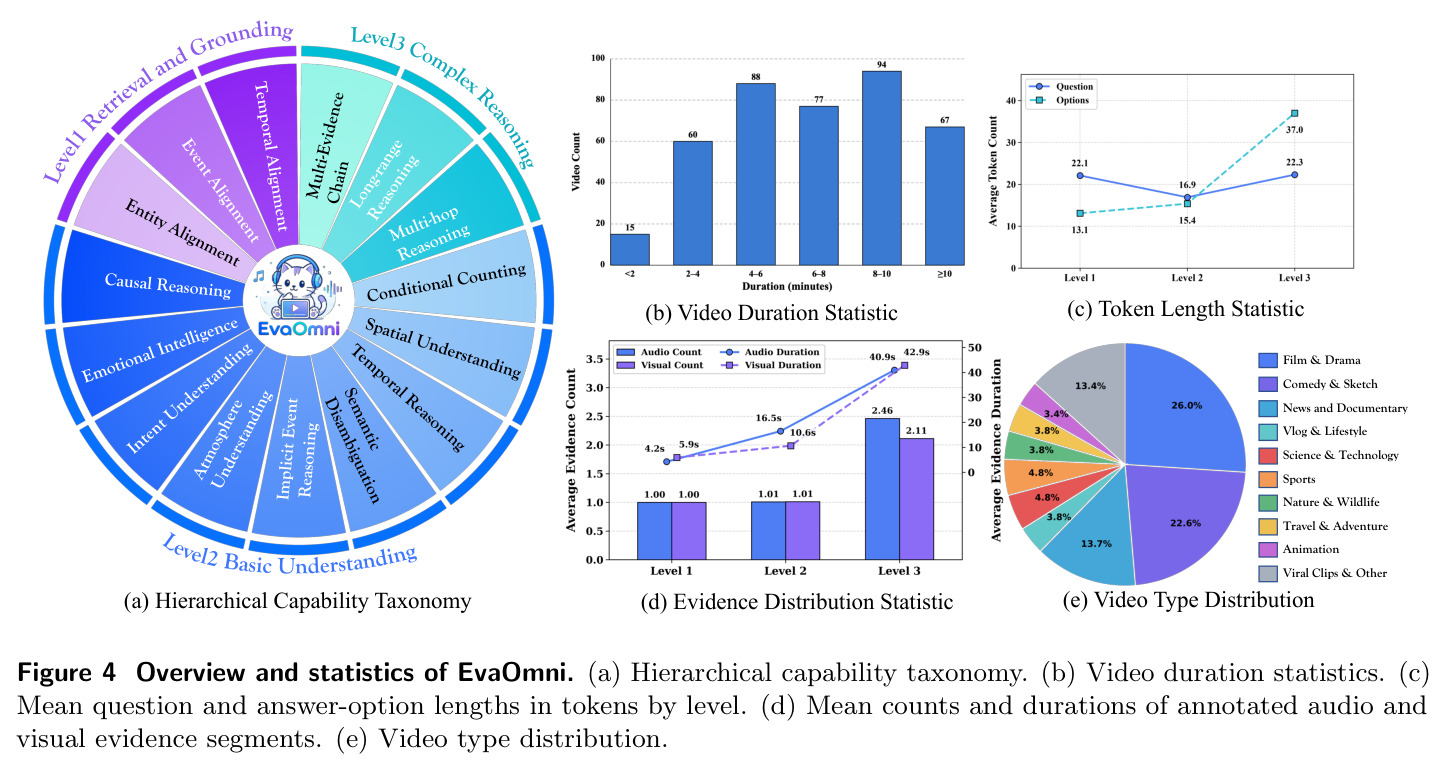
本文的目标是本文要构建一个证据锚定(evidence-grounded)的音视频推理基准,目标是让'答对'与'解对'可以被区分开。具体包括三点:第一,每道题由专家标注支撑正确答案的音频证据区间和视觉证据区间,形成可核验的推理链真值;第二,评测时要求模型同时返回答案和各模态的起止时间戳区间,把答案正确性与证据覆盖、时序定位质量联合计分,提出覆盖率锚定分 C.G. 和瓶颈锚定分 B.G. 两个新指标;第三,通过系统化的标注流程(专家标注、交叉复审、文本/音频/视觉三种单模态捷径过滤)把捷径问题压到最低,同时保留 MCQ 客观、便宜、可复现的优点。基准覆盖 392 个视频、1027 道纯人工标注的问答对、15 项细粒度能力、三个难度层级,并对 7 个开源和 17 个闭源 Omni LLM 做系统评测。
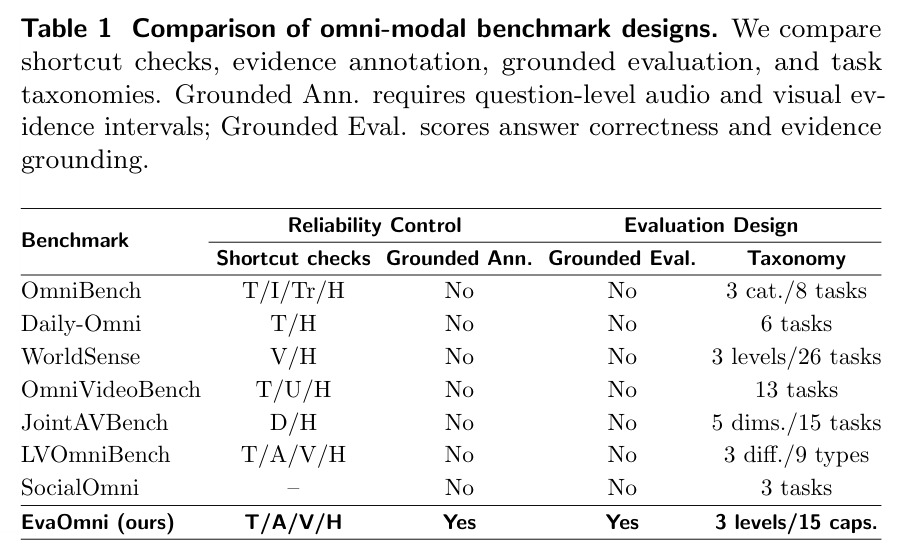
与已有工作不同的是,独特切入角度在于把'证据区间'从可选的附加分析变成评测协议的必答项。已有基准的对比(Table 1)显示:OmniBench、Daily-Omni、WorldSense、OmniVideoBench、JointAVBench、LVOmniBench、SocialOmni 全部没有捷径检查、没有逐题的音视频证据标注、也没有锚定式评测,只按选项对错计分;开放式的 judge 评测则牺牲了客观性。EvaOmni 是第一个同时做到 T/A/V/H 四重捷径检查(文本/音频/视觉/人工)、逐题双模态证据区间标注、以及答案+证据联合打分的工作。另一个巧思是指标设计本身:C.G. 宽松地衡量证据覆盖率,B.G. 用 $\min(\mathrm{IoU}_{audio}, \mathrm{IoU}_{visual})$ 的瓶颈结构保证单模态的精确定位无法补偿另一模态的失败,两者与答案正确性相乘,形成'答对且找得到证据'的复合评价,这是与现有答案对错评分的本质区别。
核心方法
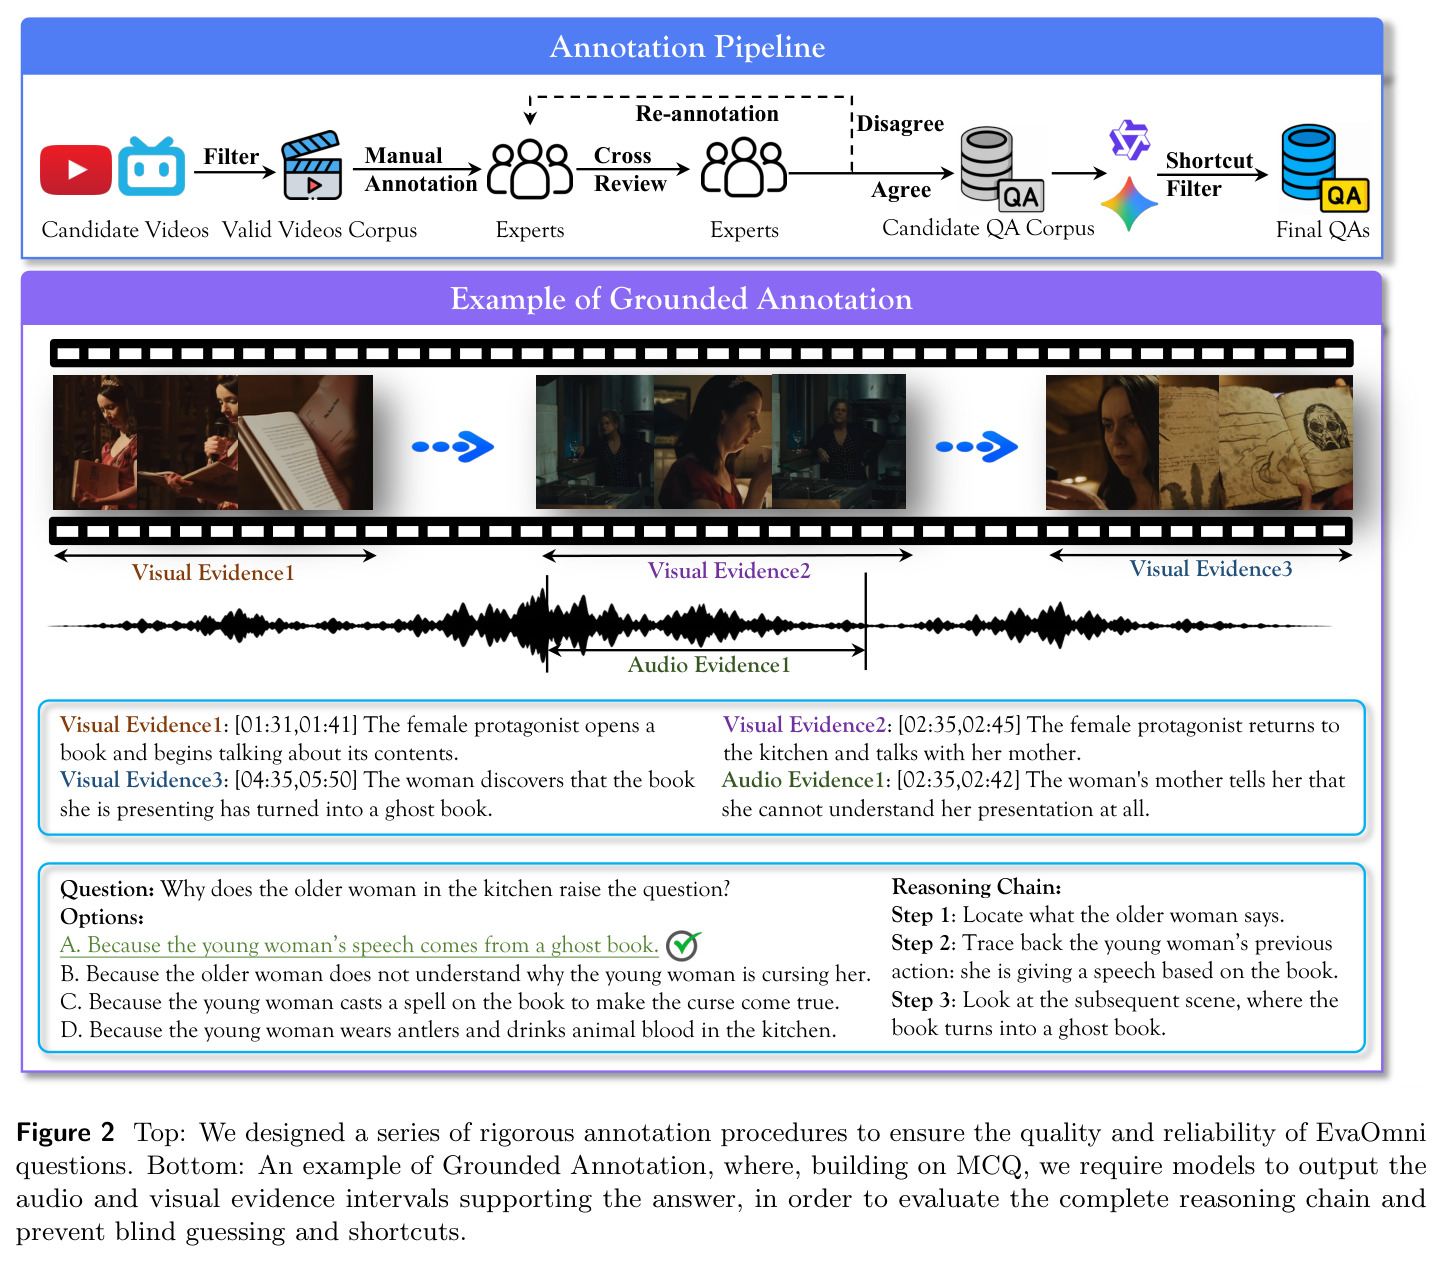
整体思路是'先防捷径、再验推理链'。直觉上,一道合格的音视频推理题应该只有同时听到声音、看到画面才能答对,且正确答案可以被指出明确的时间证据。技术路线上,数据侧从 YouTube、Bilibili 等平台收集 1-12 分钟的近期视频以规避训练数据污染,排除硬编码字幕和显著文字浮层以封堵 OCR 捷径,最终得到 392 个视频;标注侧由专家针对 15 项细粒度能力(分三个层级:Level 1 检索与定位、Level 2 基础理解、Level 3 复杂推理)出题,并为每题标注支撑答案的若干音频和视觉区间;质检侧先由多人交叉复审能力对齐与证据质量,争议题交由两名额外专家独立复审、双票通过才保留,再用模型分别在纯文本、纯音频、纯视觉输入下测试,命中的捷径题修改后重审。评测侧要求模型对每题输出答案选项加各模态证据区间(起始/结束时间戳),用 C.G. 和 B.G. 与答案正确性联合计分。共评测 7 个开源、17 个闭源模型,统一提示词,视频帧 1.0 FPS 均匀采样、长边缩放到 480 像素。
核心创新是把评分单位从'一个选项'扩展为'答案 + 双模态证据区间'的完整推理链。具体由两个指标实现:设答案得分为 $s$(正确为 1,错误为 0),$I_{audio}/N_{audio}$ 和 $I_{visual}/N_{visual}$ 分别是被模型预测区间以正时长重叠命中的标注音频/视觉证据段数占总标注段数的比例(每段至多计一次),覆盖率锚定分定义为 $$\text{C.G.} = \frac{s}{2}\left(\frac{I_{audio}}{N_{audio}} + \frac{I_{visual}}{N_{visual}}\right),$$ 即答案正确性加权下的双模态证据命中率,它是宽松指标——任何正时长重叠都算命中,过宽的预测不受惩罚。瓶颈锚定分则对每个模态取全部预测区间的并集与全部标注区间的并集,计算时序 IoU,然后 $$\text{B.G.} = s \times \min(\mathrm{IoU}_{audio}, \mathrm{IoU}_{visual}),$$ 用取最小值保证一个模态的精确定位无法弥补另一模态的粗定位。两个指标与 MCQ 的客观性兼容,却让'猜对但给不出证据'的得分趋近于零。
方法步骤详情
第一步,视频收集与筛选:输入为平台候选视频,输出为 392 个有效视频,标准包括 1-12 分钟时长、包含有信息量的视觉事件与音频线索、无硬编码字幕、近期发布以减少污染。第二步,专家标注:输入为有效视频,输出为候选问答对,专家围绕 15 项能力(3/9/3 分布于三个层级)构造需要联合使用双模态的 MCQ,并标注每题的音频证据区间(如 [02:35,02:42] 母亲的台词)和视觉证据区间(如 [04:35,05:50] 书变成鬼书的画面)。第三步,人工交叉复审:每题由其他专家检查能力对齐、证据质量与潜在捷径, disagree 的题目交给两名额外专家独立复审,需双票通过否则丢弃。第四步,捷径过滤:分别在纯文本、纯音频、纯视觉输入下用模型测试,被答对的题目判定存在捷径,修改并重新评估。第五步,锚定评测:输入为视频加统一提示词,模型输出答案和各模态证据区间,先按答案计算 $s$,再按上述公式计算 C.G. 与 B.G.,另在附录 D.2 报告其他锚定指标变体。第六步,大规模评测与诊断:24 个模型跑分并做层级分析、成本效率分析、输入模态消融和错误分解。
技术新颖性
技术新颖性体现在四点。第一,协议级创新:Table 1 的逐项对比表明,七个已有全模态基准在捷径检查、逐题证据标注、锚定评测三项可靠性控制上全部为'无',EvaOmni 是首个三者齐备的工作,填补了'MCQ 客观但不深、开放式深入但不客观'的空档。第二,指标结构创新:C.G. 与 B.G. 形成松紧互补的对偶设计——C.G. 只要求证据被覆盖(命中即得分,不罚过宽),B.G. 用 $\min$ 瓶颈结构要求双模态同时精确,二者与 $s$ 相乘后的组合能有效暴露'答案对、证据链断'的模型缺陷,这在纯 Acc 曲线里完全不可见。第三,标注流程创新:专家标注 + 交叉复审 + 双票仲裁 + 三种单模态捷径过滤的多级流水线,并量化证明了捷径在现有基准中的普遍性(WorldSense 三种单模态可答率 14%-16%)。第四,评测发现本身有方法论价值:Level 3 上 24 个模型 Acc 不一定下降但 C.G.、B.G. 全部最低,说明答案对错与证据定位是两个解耦的能力维度,必须分开测。
实验结果
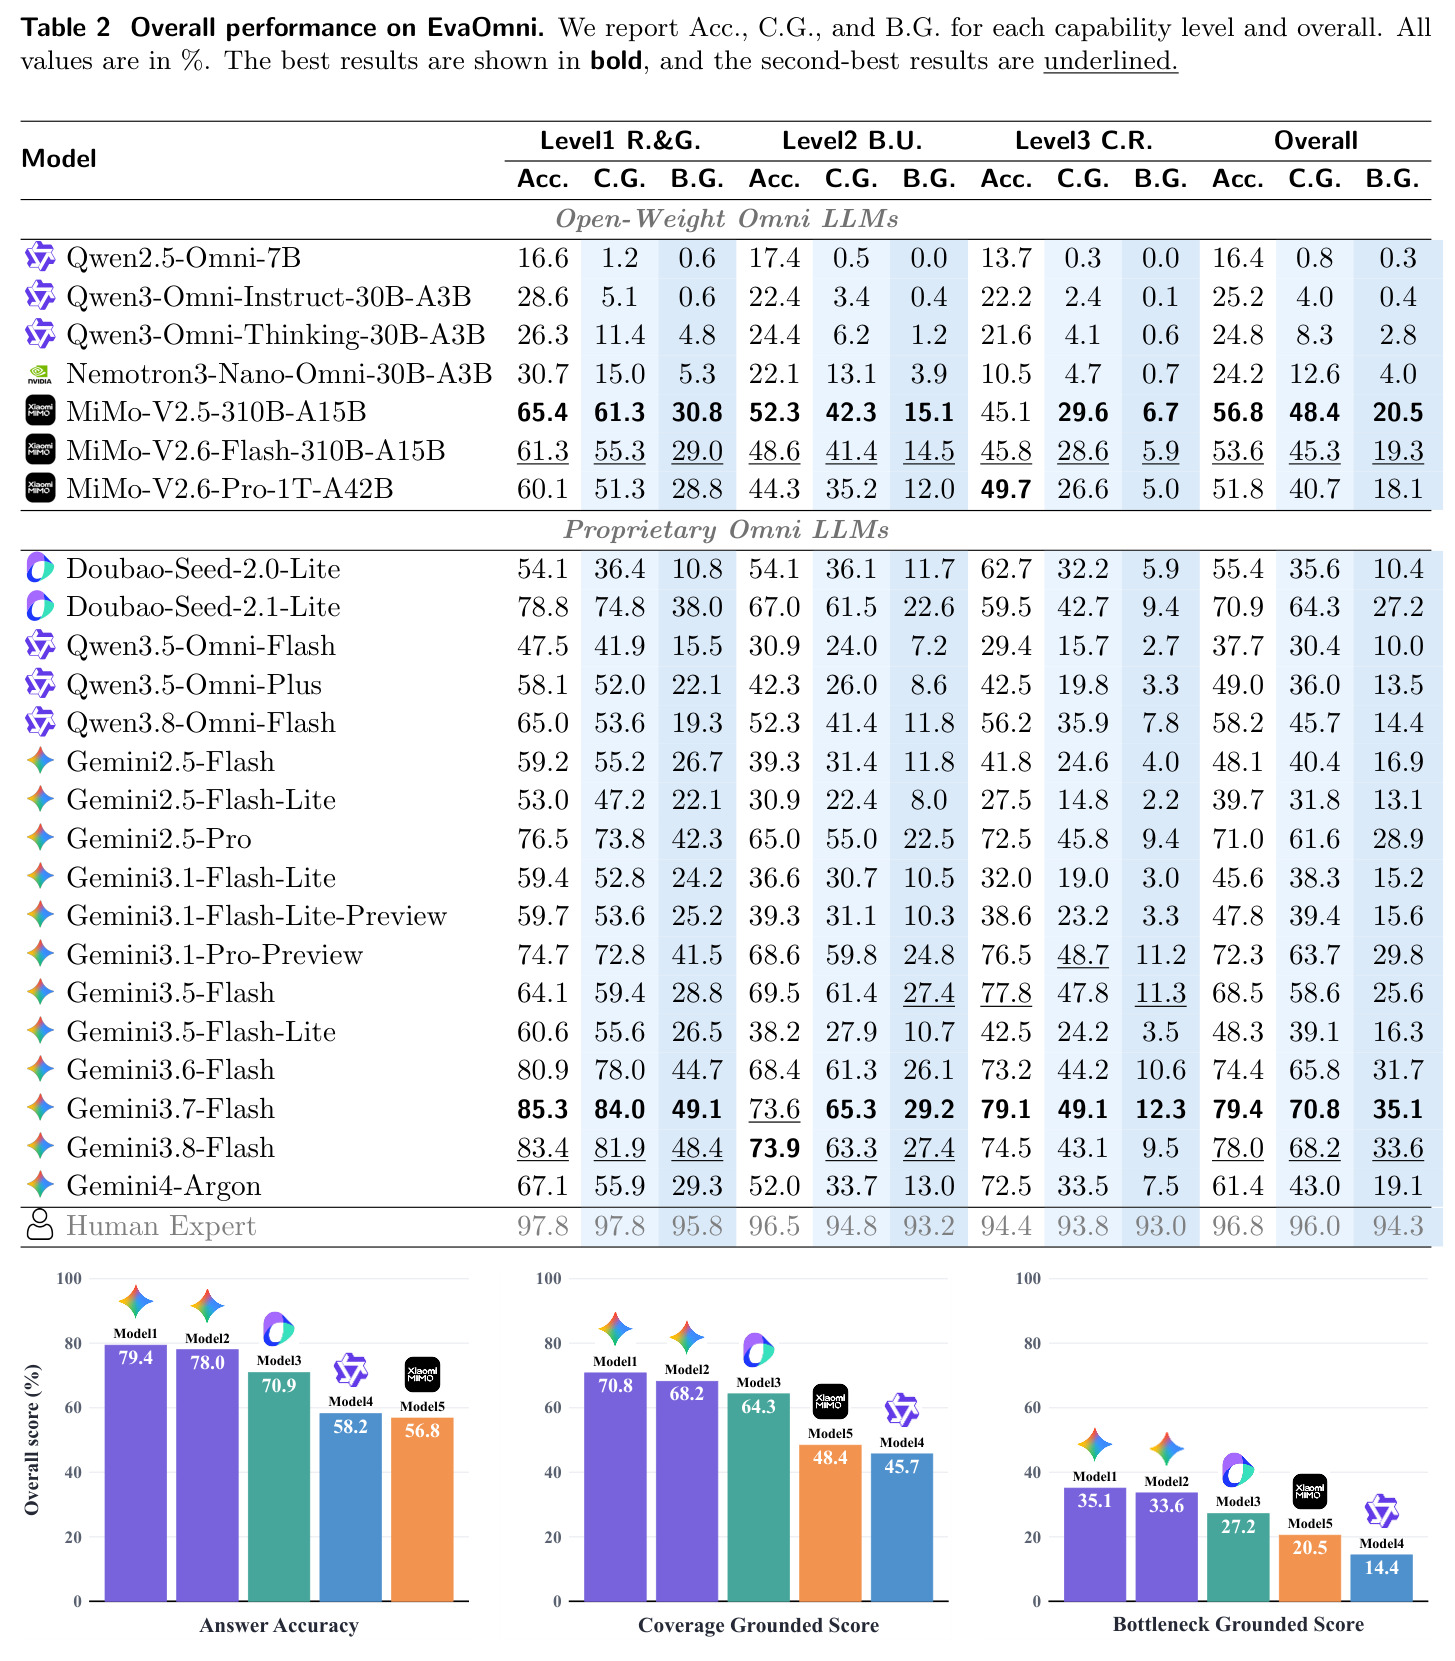
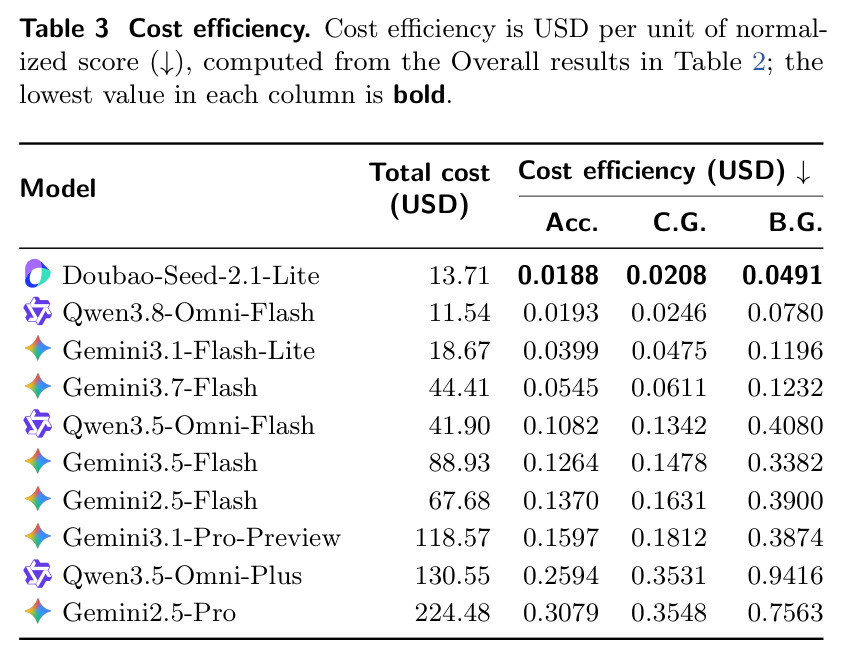
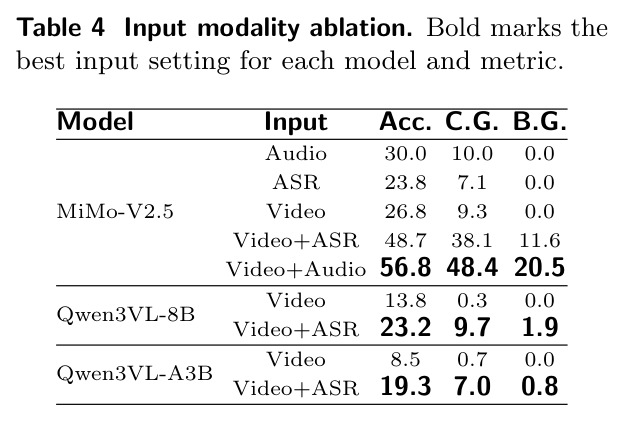
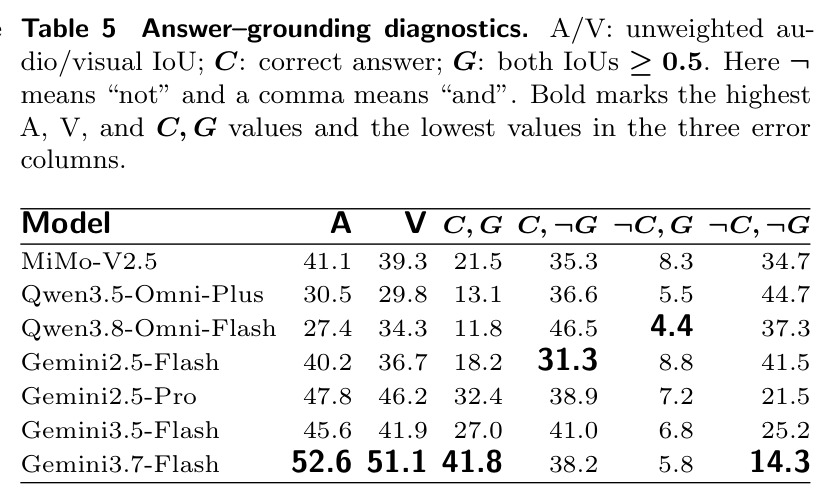
对 24 个 Omni LLM 的系统评测得出五条主要发现。其一,开源与闭源差距显著:最强开源模型 MiMo-V2.5-310B-A15B 总体 Acc/C.G./B.G. 为 56.8%/48.4%/20.5%,最强闭源 Gemini3.7-Flash 为 79.4%/70.8%/35.1%,差距达 22.6/22.4/14.6 个百分点;而相比 Qwen3-Omni-Instruct-30B-A3B(25.2%/4.0%/0.4%),MiMo-V2.5 分别是其 2.3 倍、12.1 倍和 51.3 倍。其二,与人类专家差距悬殊且集中于定位:人类专家达 96.8%/96.0%/94.3%,Gemini3.7-Flash 落后 17.4/25.2/59.2 个百分点;人类从 Acc 到 B.G. 仅降 2.5 分,Gemini3.7-Flash 降 44.3 分。其三,层级趋势解耦:21/24 个模型 Acc 从 Level 1 到 Level 2 下降,但 13 个模型从 Level 2 到 Level 3 反而回升(Gemini3.7-Flash 从 73.6% 升到 79.1%),同时其 C.G. 从 65.3% 跌至 49.1%、B.G. 从 29.2% 跌至 12.3%;全部 24 个模型的 C.G. 和 B.G.(含并列)均在 Level 3 最低,说明部分证据足以排除干扰项而答对,无需完整定位证据。其四,成本效率与分数脱钩:Doubao-Seed-2.1-Lite 以 13.71 美元总价取得三项指标最优的单位得分成本(0.0188/0.0208/0.0491 美元),Gemini3.7-Flash 总成本 44.41 美元仅列第四,但相比 Gemini2.5-Pro(224.48 美元)把三项单位成本降低 82.3%/82.8%/83.7%。其五,消融与错误分析:MiMo-V2.5 原生音频(Acc 30.0%)优于 ASR 转写(23.8%),Video+Audio 相比 Video+ASR 三项高 8.1/10.3/8.9 个百分点;去掉任一模态 B.G. 直接归零;ASR 能把 Qwen3VL-8B 的 Acc 从 13.8% 提到 23.2%,但 B.G. 仅 1.9%。错误分解显示 48.1%-79.9% 的正确答案无法通过双模态 IoU≥0.5 的门槛(Gemini3.7-Flash 79.4% 答对率下只有 41.8% 同时满足),而定位达标预测中仍有 12.2%-32.6% 选错选项。
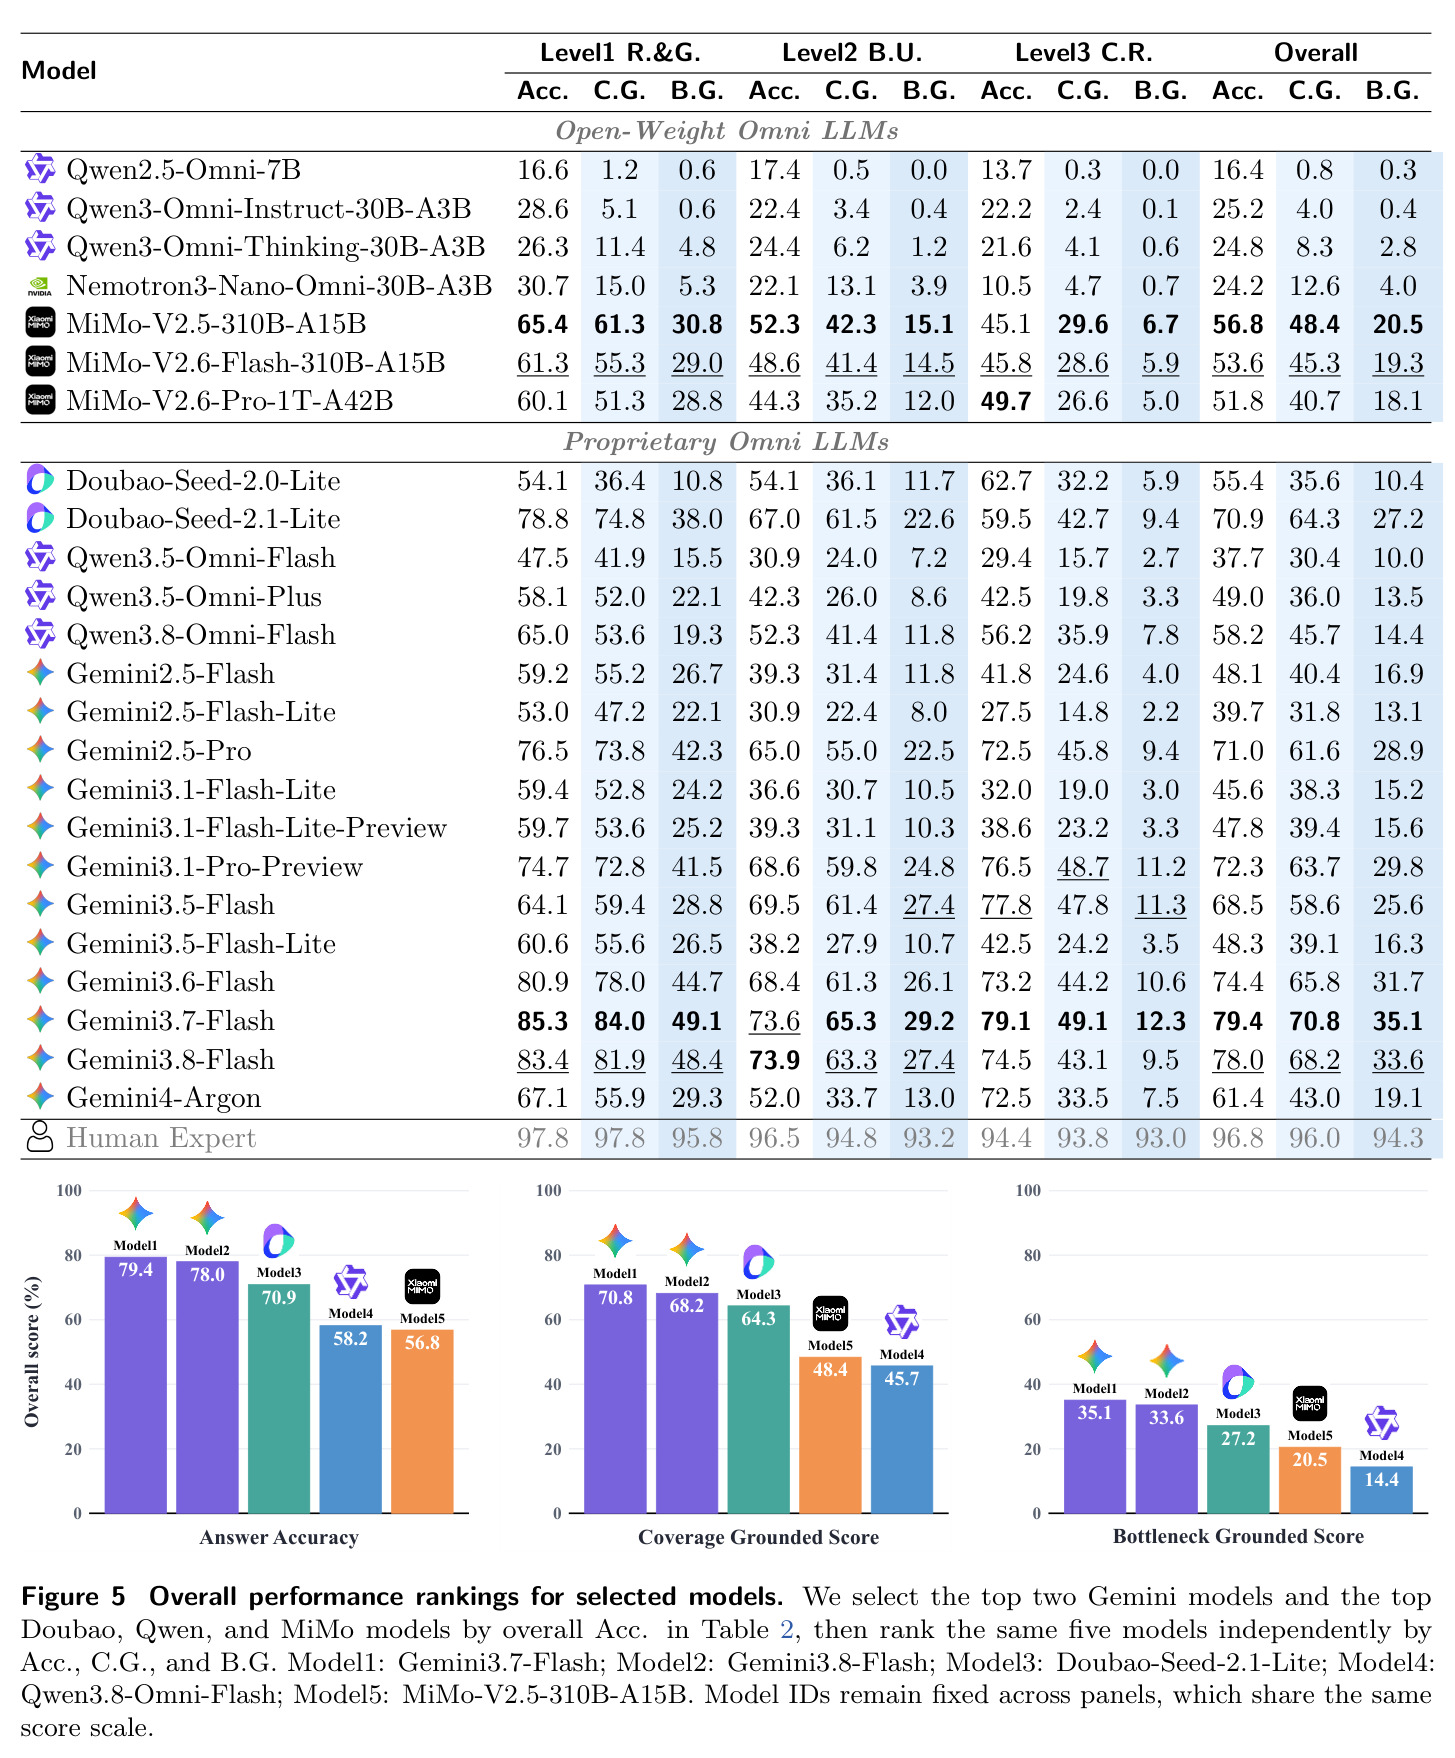
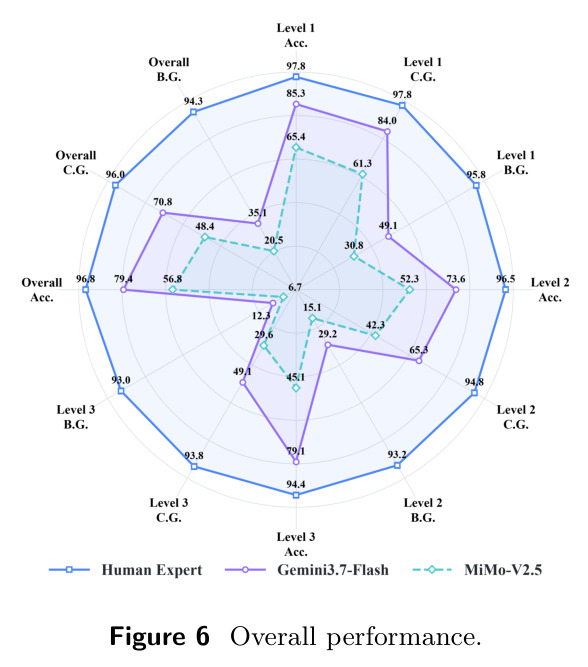
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全模态音视频推理(Overall) | Acc(答案正确率) | Gemini3.7-Flash 79.4%,最佳开源 MiMo-V2.5-310B-A15B 56.8% | Qwen3-Omni-Instruct-30B-A3B 25.2%;人类专家 96.8% | 较最佳开源 +22.6pt,较人类专家仍差 -17.4pt |
| 全模态音视频推理(Overall) | C.G.(覆盖率锚定分) | Gemini3.7-Flash 70.8%,最佳开源 MiMo-V2.5-310B-A15B 48.4% | Qwen2.5-Omni-7B 仅 0.8%;人类专家 96.0% | 较最佳开源 +22.4pt,较人类专家仍差 -25.2pt |
| 全模态音视频推理(Overall) | B.G.(瓶颈锚定分) | Gemini3.7-Flash 35.1%,最佳开源 MiMo-V2.5-310B-A15B 20.5% | Qwen2.5-Omni-7B 仅 0.3%;人类专家 94.3% | 较最佳开源 +14.6pt,较人类专家仍差 -59.2pt(差距最大) |
| Level 3 复杂推理 | B.G. | Gemini3.7-Flash 12.3%(24 个模型全部在 Level 3 最低) | 同一模型 Level 2 为 29.2%,Level 1 为 49.1% | 层级越复杂定位质量坍缩越明显,Level 3 较 Level 1 下降 36.8pt |
| 输入模态消融(MiMo-V2.5) | Acc / C.G. / B.G. | Video+Audio 56.8% / 48.4% / 20.5% | Video+ASR 48.7% / 38.1% / 11.6%;纯音频 30.0%;纯视频 26.8% | 原生音频优于 ASR 转写 +8.1/+10.3/+8.9pt;去掉任一模态 B.G. 归零 |
| 成本效率(1027 题 × 10 分钟输入) | 单位归一化得分成本(美元,越低越好) | Doubao-Seed-2.1-Lite:0.0188 / 0.0208 / 0.0491(总价 13.71 美元) | Gemini2.5-Pro:0.3079 / 0.3548 / 0.7563(总价 224.48 美元) | 性价比最高的模型与最贵模型相差 16 倍以上成本 |
局限与改进
作者承认的局限包括:捷径诊断比例依赖所用测试模型,不是严格的捷径率(WorldSense 的 14.4%/14.2%/15.7% 只是下界式参考);最强模型 B.G. 仅 35.1%,说明基准对当前模型极难,短期能力天花板可能压制区分度;C.G. 本身被作者明确解读为宽松的命中率指标,不度量精确定位。我自己的观察还有几点:其一,1027 题、392 个视频的规模偏小,按 15 项能力切分后单能力样本更少,层级和能力维度的结论容易受统计噪声影响;其二,MCQ 形式仍保留,$s$ 因子意味着答案错误时证据定位再准也计 0 分,正确率与定位质量在指标上不可分,无法单独奖励'定位对但选项错'的行为(Table 5 显示这类案例占 12.2%-32.6%);其三,1.0 FPS 采帧和 480px 长边的预处理可能人为压低细粒度时序定位的上限;其四,视频来自 YouTube/Bilibili 且排除硬字幕,但语言与文化覆盖、证据区间标注的标注者间一致性数据在正文未报告。
独立分析的弱点
独立分析有四个弱点。第一,C.G. 可被'撒网式预测'钻空子:它只要求预测区间与标注区间有正时长重叠,一个把整段视频都标为证据的模型在 C.G. 上接近满分,论文自己也承认过宽预测不受惩罚;改进方向是引入长度惩罚项,如把命中判据换成 IoU≥阈值,或按预测总时长与标注总时长之比加权衰减。第二,B.G. 的并集 IoU 对多证据题过于严苛:Level 3 的多证据链题平均标注段数更多(图 4d),模型多预测一段无关区间就会稀释并集 IoU,且 $\min$ 结构使两模态误差直接相乘传播,12.3% 的 Level 3 B.G. 可能部分反映指标设计而非纯粹能力缺陷;改进方向是分段最优匹配(如匈牙利匹配后逐段计 IoU 再聚合)并报告对 $\min$ 与均值两种聚合的敏感性。第三,答案因子 $s$ 把'定位准但选错'判为 0 分:Table 5 显示 12.2%-32.6% 的定位达标预测选错选项,这类行为本身有诊断价值却被一把归零;改进方向是报告解耦的定位分(不含 $s$)作为辅助指标。第四,规模与覆盖:1027 题对 15 项能力意味着每能力仅约 68 题,能力级结论置信区间宽,且单语言/单一地区视频源可能带来分布偏移;改进方向是扩容到数千题并引入多语言平衡采样。
未来方向
作者提出的方向是:未来 Omni LLM 不应只追求答对,还应能精确定位支撑答案的证据,使结论可对照音视频输入核验,并希望锚定评测成为可复现、可解释的能力度量。在此之上可以延伸出几条更有工程价值的路线。其一,把证据定位变成训练信号:C.G./B.G. 天然可微或可离散化为奖励,可接入 RLVR 式后训练,让模型在时间戳预测上获得密集奖励,而不是只在最终选项上获得稀疏奖励。其二,从静态 MCQ 走向开放式的客观锚定评测:保留时间戳区间作为客观判据,把自由文本回答的判分限定在'证据区间内发生的实体与事件'上,减少对 judge 模型的依赖。其三,扩展到流式与实时场景:当前协议是一次性输入完整视频,未来可测在线设置下的'边看边定位'能力,与 SeedRealtime 一类全双工模型更匹配。其四,交叉模态证据挖掘:利用标注好的区间对训练细粒度音视频对齐编码器(对比学习用区间对做正样本),让基准数据反向服务于预训练。其五,自动化证据标注:用多专家模型 + 人工抽检的流程降低每题证据标注成本,支撑千题到万题的扩容。
复现评估
复现条件非常好。数据与标注已全量公开:Hugging Face(VisionXLab/EvaOmni-Dataset)、ModelScope、GitHub(VisionXLab/EvaOmni)和项目主页均可获取 392 个视频的问答对、音视频证据区间标注和评测框架,无需自己重跑标注流水线。评测算力门槛低:闭源模型走官方 API(最强模型 Gemini3.7-Flash 全量 1027 题成本仅约 44 美元),开源模型中 MiMo 系列走 API,其余(Qwen-Omni、Nemotron 等)在单台 8×NVIDIA H20 服务器即可推理;预处理统一为 1.0 FPS 采样、长边 480px。复现指标只需按公式实现 C.G. 和 B.G.:前者是区间重叠计数,后者是并集 IoU 取 min,实现难度低且论文给出完整定义。主要不确定性在于视频源的可用性——平台视频可能下架,需要尽早镜像;另外若要复现标注流水线本身(而非复用数据),需要领域专家团队做多轮交叉复审,人力成本高,这是基准类工作复现的固有门槛。
论文图表
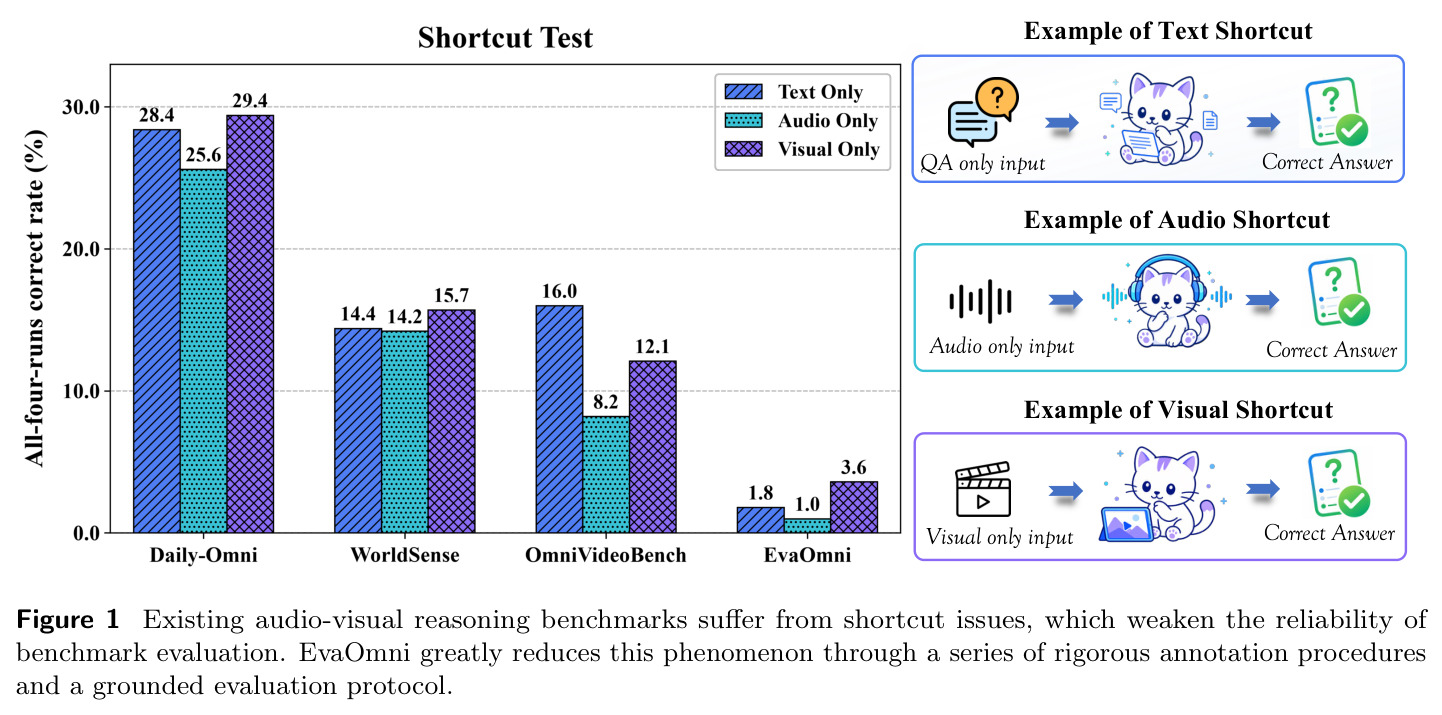
三行对照图,分别展示文本捷径、音频捷径、视觉捷径的实例:同一道题在仅文本输入(QA only)、仅音频输入、仅视觉输入下都能得到正确答案,说明现有基准的题目无需完整音视频即可答对;右侧对比说明 EvaOmni 通过严格标注流程和锚定评测协议大幅减少了这类现象。
这张图是全文立论的起点,直观解释了'答案对不等于推理对'的问题来源,不理解捷径的三种形态就无法理解后续为何要设计证据区间标注和单模态过滤流程。