OmniSeek:面向多轮音视频推理的原生工具集成 OmniSeek: Native Tool Integration for Multi-turn Audio-Visual Reasoning
将全模态大模型改造成主动取证智能体,多轮检索音视频证据并强化双模态依赖
前置知识
Omni-LLM(全模态大语言模型)
能同时原生处理文本、图像/视频与音频的多模态基础模型,如 Qwen-Omni 系列、Nemotron-3-Omni、MiniCPM-o 4.5。它们把音频离散化为 token、视频按帧采样后与文本统一送入同一个 Transformer,支持语音交互与音视频联合理解,但默认在单次前向中被动吞入整段音视频输入。
本文的改造对象就是 Omni-LLM;理解其单次编码范式,才能明白证据被稀释、单模态捷径以及音频上下文瓶颈这些问题的根源。
ReAct 多轮工具循环
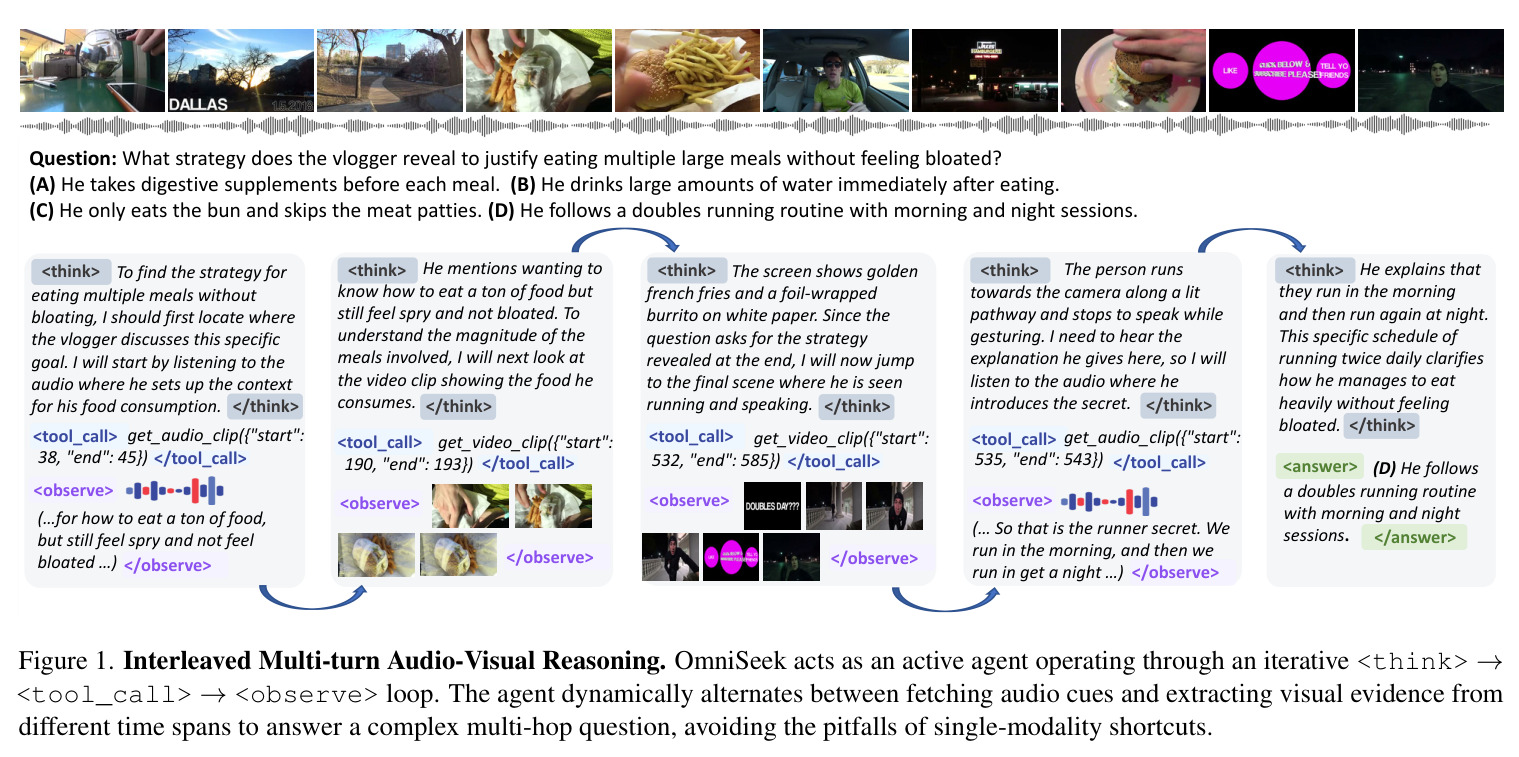
将推理与行动交替进行的智能体范式:模型先输出思考,再发起工具调用,观察工具返回结果后继续推理,直至判断信息充分才作答。OmniSeek 以 →→ 的状态机实现这一循环,且循环终止时机由模型自反思决定,而非硬编码轮数。
这是 OmniSeek 的基本运行协议;数据合成的轨迹结构、SFT 的模仿目标与 RL 的奖励设计全部围绕该循环展开,不理解它就无法理解全文。
GSPO(组序列策略优化)
面向可验证奖励强化学习(RLVR)的序列级策略梯度算法:对每个提示采样一组(G 条)轨迹,以序列级似然比更新策略,相比 token 级的 PPO 更稳定且无需价值网络。本文 Phase 2/3 用它做多轮工具调用的强化学习,并通过把 rollout 规模 $G$ 从 8 扩到 16 来拓宽探索空间。
理解两阶段 RL 的训练机制、rollout 规模 $G$ 的作用以及奖励求和方式 $R=r_{acc}+r_{format}+r_{tool}$,都需要这一背景。
注意力掩码反事实消融
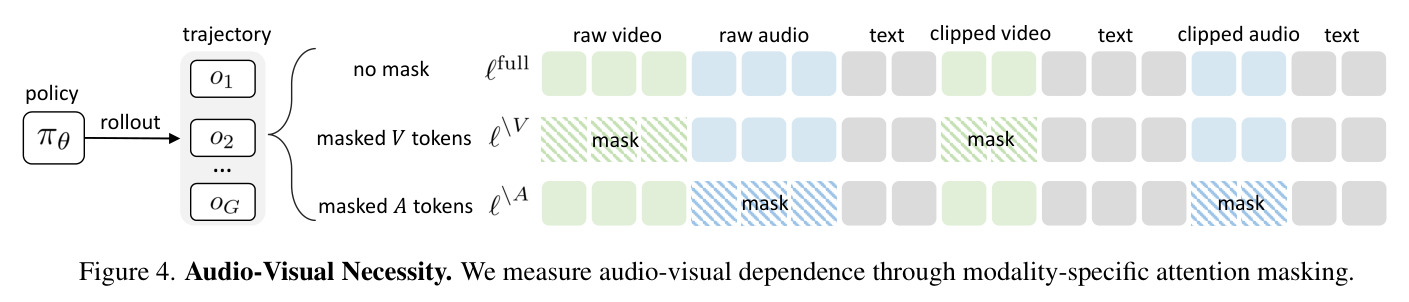
在不重新生成的前提下估计某个输入对输出的贡献:固定已生成序列,把某一模态 token 的注意力键全部置零后再做一次前向,比较完整上下文与消融上下文下同一 token 的对数似然差 $\Delta_t=\ell_t^{full}-\ell_t^{\setminus}$。差值越大,说明该 token 的生成越依赖被消融的模态。
这是本文核心创新——音频-视觉必要性奖励 $r_{avn}$ 的实现基础,论文式 (1)-(3) 全部建立在该技术上,不懂它就读不懂奖励如何量化双模态依赖。
SFT 对齐税与行为克隆退化
仅靠模仿示范轨迹的行为克隆,容易让模型学到工具调用格式却学不到实际策略,且 SFT 常伴随预训练能力的暂时下降,即所谓「SFT 记忆、RL 泛化」现象。本文 Phase-1 SFT 后多数基准下滑、Phase-2 RL 恢复并反超,正是该现象的一个完整实例。
它解释了作者为什么必须设计三阶段训练而非只用 SFT,也是读懂 Table 2 消融动态(先降后升)的前提。
研究动机
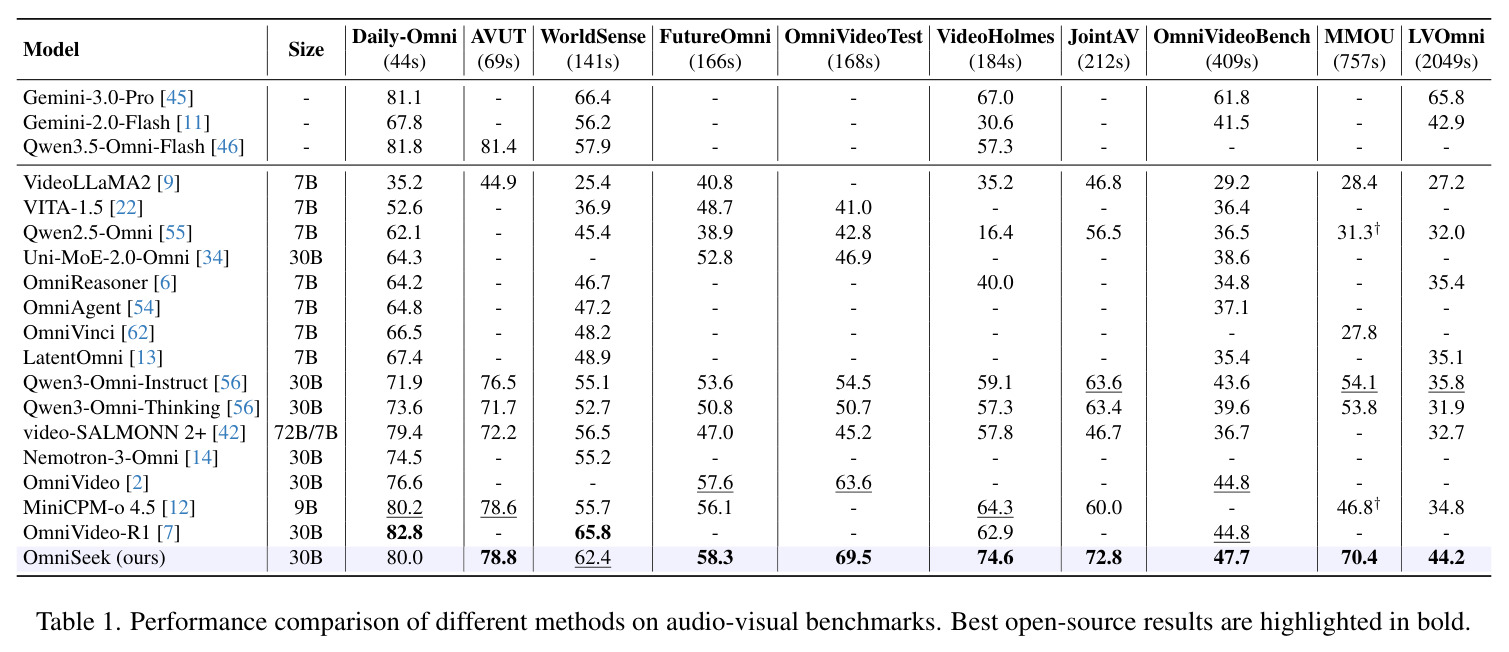
当前全模态大语言模型(Qwen2.5-Omni、Qwen3-Omni、MiniCPM-o 4.5、Nemotron-3-Omni 等)处理音视频的默认方式是「单次前向编码 + 被动吞入整段音视频流」。一旦上下文变长,几秒钟的视觉细节(一行屏幕文字、一个手势)和转瞬即逝的声学事件(一句话、一声异响)就会被大量无关内容稀释;模型明明拥有足够信息,却无法把分散的证据分离并组合起来,最终退回到语言先验或单模态捷径。后果直接反映在评测上:强基线 Qwen3-Omni-Instruct(30B)在专为堵住「文本捷径」设计的音频中心基准 AVUT 上仅 76.5,在长视频基准 LVOmniBench 上仅 35.8、MMOU 上仅 54.1。另一方面,已有的推理增强路线各有盲区:多模态 CoT 方法(如 Video-R1、OmniVideo-R1)的推理痕迹仍局限于文本模态,或把检索到的证据转写成文字描述后不再回看原始音视频信号;视频侧的智能体方法(Video-o3、VITAL、LongVT、VideoZoomer)虽然实现了时间维度的「变焦」检索,却没有音频通道,无法处理声画分离的多跳问题。
本文的目标是本文要解决的问题是:如何把 Omni-LLM 从被动感知器改造成主动取证智能体,使其在长时音视频上可靠地完成多跳跨模态推理。具体目标分四层:(1) 协议层——设计模态解耦的原生工具接口,让模型自主决定「何时听、何时看、看哪个时间窗」,检索到的原始音频/视频片段以更高帧率与分辨率回填上下文,循环终止由模型自反思判断证据是否充分而非硬编码轮数;(2) 数据层——构建能冷启动该行为的 OmniTraj-170K:约 17 万条含交错音视频证据的多轮思维链轨迹,每条轨迹都锚定细粒度时间戳证据;(3) 训练层——设计 SFT 冷启动加两阶段可验证奖励强化学习(GSPO)的三阶段流程,避免行为克隆导致的格式化模仿与策略退化;(4) 目标层——提出音频-视觉必要性(Audio-Visual Necessity)奖励,惩罚单模态捷径与幻觉式 grounding,只强化真正依赖双模态证据的成功轨迹。最终在 10 个全模态基准与 4 个通用视频基准上验证:性能领先且基础感知能力不降。
与已有工作不同的是,与最接近的工作相比,本文的切入角度有三处独特。其一,模态解耦的主动取证:OmniReasoner 等工作受制于模态耦合的检索方式,而 OmniSeek 给音频与视频各自独立的调用入口,检索结果是原始片段而非文字转写,因此保留了语气、环境声、音色等副语言信息,模型可以先循声定位、再跳到完全不同的时间段调取高分辨率画面,实现粗到细检视。其二,数据引擎用「证据链」从源头反捷径:每道合成题强制绑定 2-7 条时间戳证据片段,必须同时含音频与视频各至少一条,且片段按人类解题的逻辑检索顺序(而非时间顺序)排列;题目文本与时间戳逐字复制自 Stage-1 标注以杜绝幻觉,工具调用与观察内容由证据链确定性构造,教师模型只负责写思考节点。其三,训练目标上的必要性约束:用注意力掩码做单模态反事实消融,以 $r_{avn}=c\cdot\min(nec_A, nec_V)$ 构成逻辑与门,确保两个模态都被真实依赖才给奖励,且全程只需两次 no_grad 前向、零额外 rollout,兼顾效果与计算成本。
核心方法
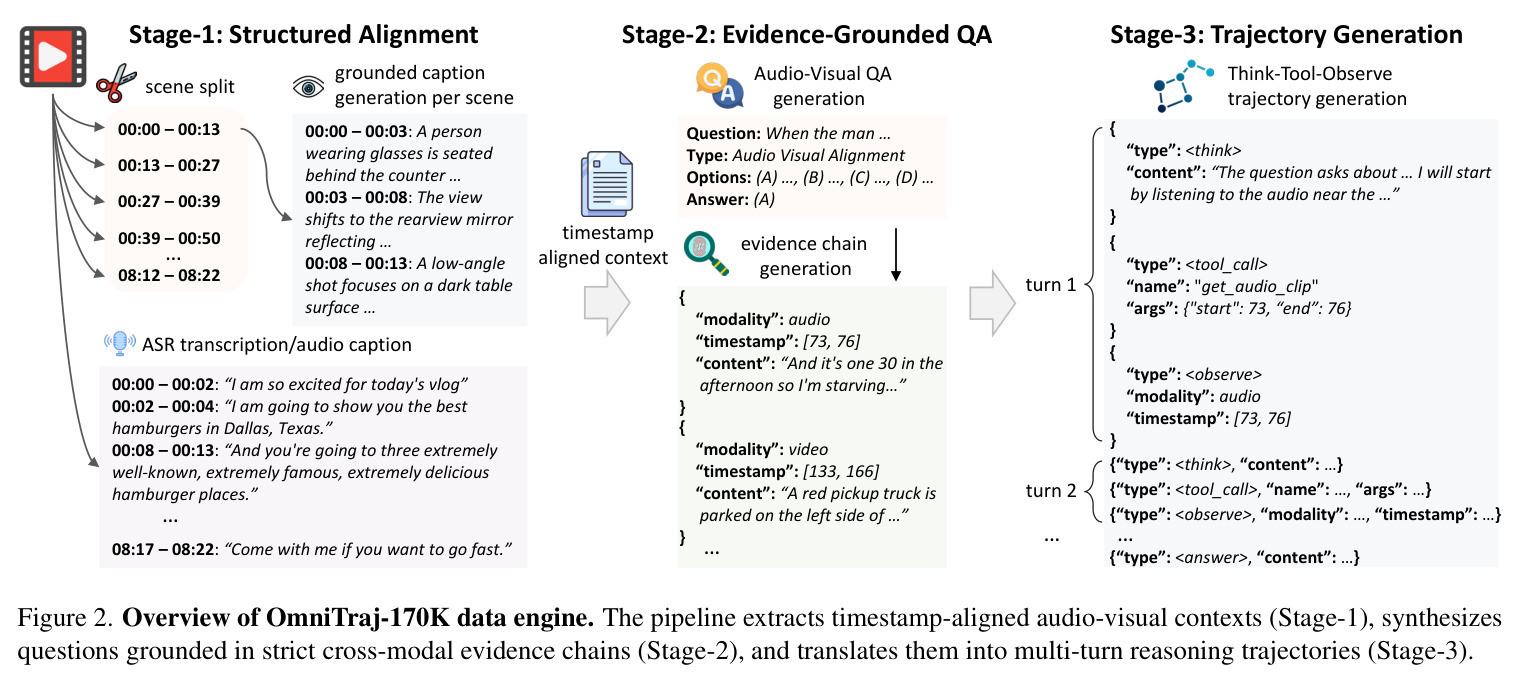
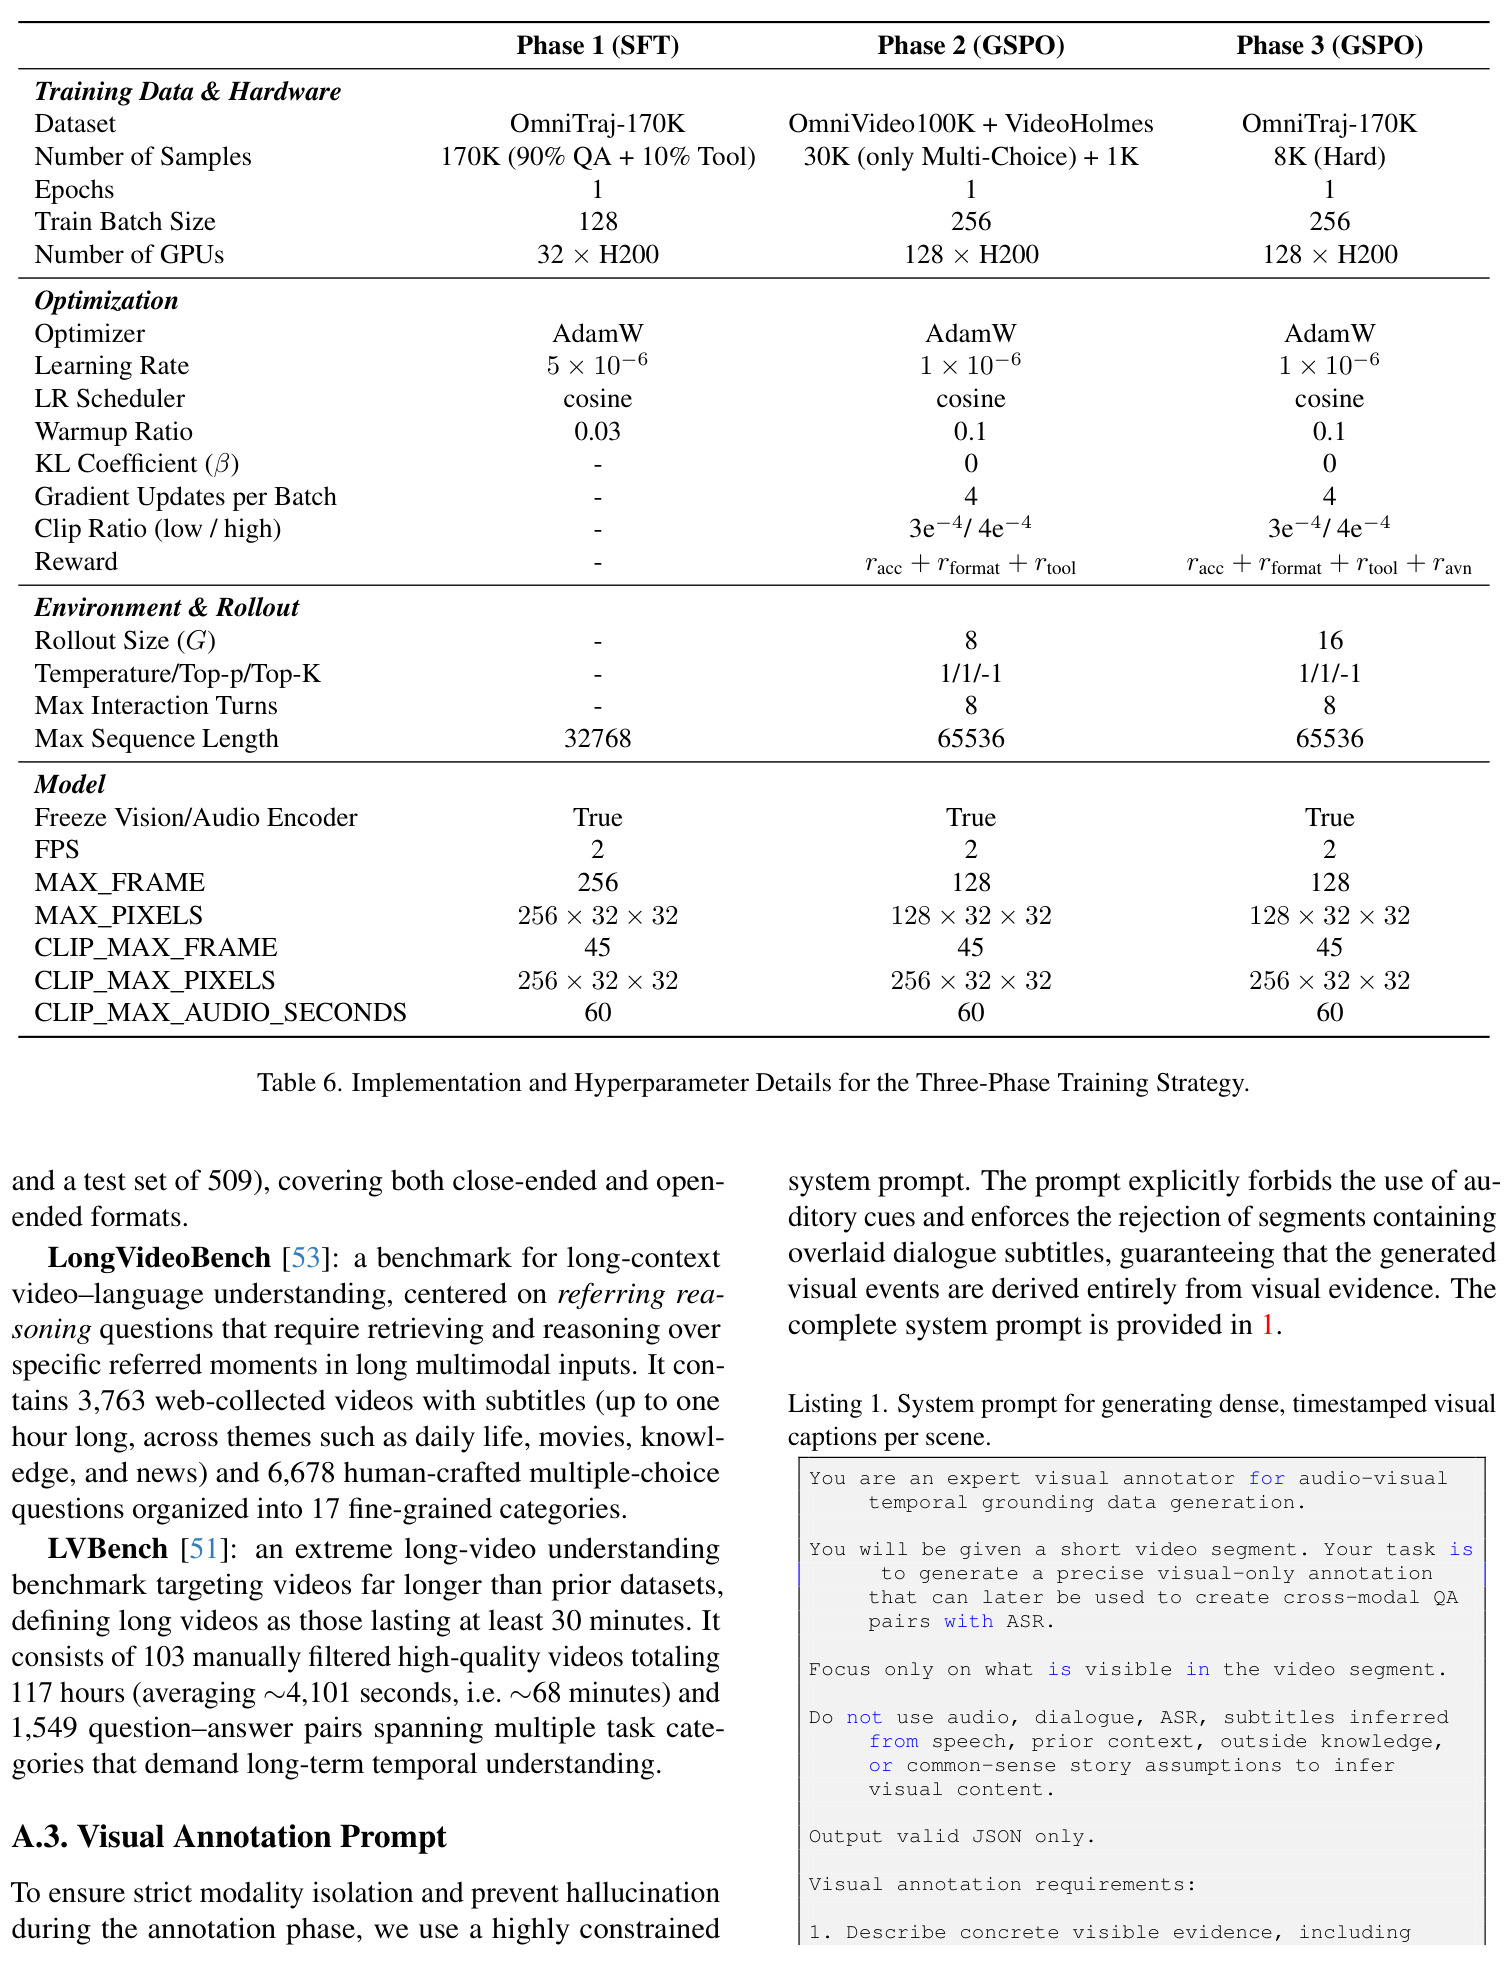
直觉上,OmniSeek 模仿人类解答「声画分离」谜题的过程:粗看一遍全局后,在「听某几秒」与「看某几秒」之间反复切换,凑齐证据链才作答。技术路线分三步。第一步,数据引擎(图 2):PySceneDetect 切分镜头并合并成约 15 秒的语义场景,Qwen3.5-397B-A17B 逐场景生成仅描述可见内容、禁止外部推断的密集时间戳视觉字幕,同时用源视频 ASR(或 Qwen3-ASR / Qwen3-Omni-Captioner)获得音频轨时间戳描述;再由教师模型生成 19 类音视频问题及各自的 2-7 条证据链;最后把证据链确定性展开为 →→ 多轮轨迹,得到 169,725 条轨迹、覆盖 39,797 个 FineVideo 视频。第二步,多轮工具协议:提供 get_audio_clip(start, end) 与 get_video_clip(start, end, fps, resolution) 两个工具,后者按模型自定的帧率与分辨率取片实现粗到细检视;每轮模型评估证据充分性,决定继续检索还是输出 。第三步,三阶段训练:先在 OmniTraj-170K 上做混合 SFT(90% 单轮 QA + 10% 工具轨迹)冷启动;再用 GSPO 在 31K 无轨迹标注的选择题上做广域探索 RL,奖励 $R=r_{acc}+r_{format}+r_{tool}$,rollout 规模 $G=8$;最后从失败案例中挖出 8K 难例,以 $G=16$ 恢复训练并加入 $r_{avn}$ 精炼策略。
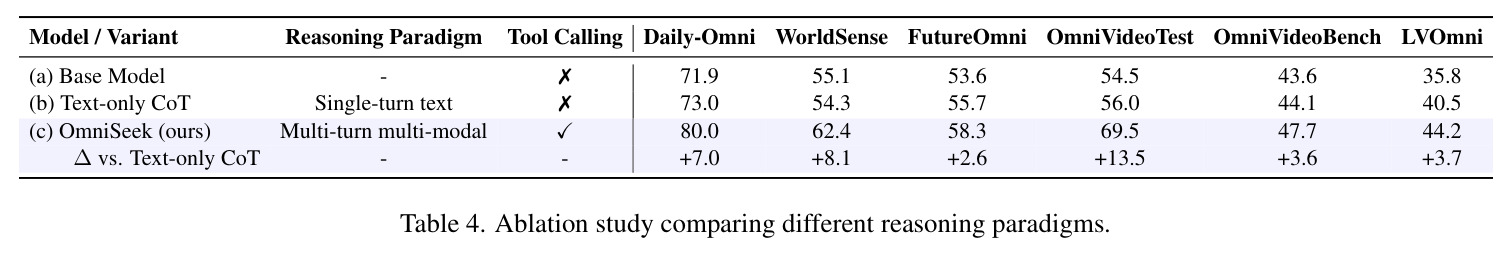
核心创新点是「主动证据获取 + 原始片段回填 + 双模态必要性门控」的组合,与已有方法的本质区别体现在三个对比上。对比文本化推理:纯 CoT 方法把长音视频压缩成文字再思考,OmniSeek 则在推理中直接取回原始音频/视频片段拼进上下文( 节点),避免转写造成的信息损失;消融显示同等 RL 训练下多轮多模态比纯文本 CoT 最高领先 +13.5(OmniVideoTest)。对比视频侧智能体:Video-o3、LongVT、VideoZoomer 只做时间变焦、没有音频通道,OmniSeek 首次让音频成为可独立路由的一等模态,支持「先听后看、跨段拼接」。对比工具调用幻觉:多数方法让模型自由生成工具调用,本文在数据合成中解耦「思考生成」与「动作执行」——调用参数和观察内容由证据链时间戳确定性构造,模型只写桥接推理,从机制上消除训练数据中的调用幻觉。RL 阶段的 $r_{avn}$ 用反事实注意力消融 $\Delta_t^A=\ell_t^{full}-\ell_t^{\setminus A}$ 度量每个生成 token 对音频/视频的依赖,以 $[x]^+=\max(x,0)$ 整流后平均得 $nec_A, nec_V$,再取 $\min(nec_A, nec_V)$ 作为逻辑与门并由答案正确性 $c\in\{0,1\}$ 门控,专治「答案对但靠捷径」的轨迹。
方法步骤详情
第 1 步(结构化对齐):PySceneDetect 检测镜头并顺序合并至约 15 秒的语义场景;Qwen3.5-397B-A17B 逐场景输出时间戳视觉字幕(只写可见内容、禁止音频与外部知识,另生成全局字幕解决跨场景指代);音频轨取源视频 ASR 转录,或用 Qwen3-ASR/Qwen3-Omni-Captioner 生成密集音频描述,输出双轨时间戳对齐上下文。第 2 步(证据链 QA 合成):教师模型生成 19 类选择题,每题规划 2-7 条证据片段(含模态、时间窗、逐字复制的文本),至少各含一条音频与视频证据,按逻辑检索顺序而非时间顺序排列,配 4 个等长干扰项。第 3 步(轨迹组装):将证据链确定性展开为多轮 get_audio_clip/get_video_clip 调用与 内容,教师模型仅生成 N+1 个 节点(首节点规划检索、中间节点复述上一步证据并引导下一跳、末节点汇总作答),最后校验工具调用与证据一致。第 4 步(Phase-1 SFT):在 169,725 条轨迹上以 90% 单轮 QA + 10% 工具轨迹混合训练 Qwen3-Omni-30B-A3B-Instruct,学习率 $5\times10^{-6}$、batch 128、32×H200。第 5 步(Phase-2 GSPO):在 OmniVideo-100K 的 30K 选择题 + 1K VideoHolmes 训练集上强化学习,奖励 $R=r_{acc}+r_{format}+r_{tool}$,$G=8$、学习率 $1\times10^{-6}$、128×H200、最多 8 轮交互、序列上限 65536。第 6 步(Phase-3 难例精炼):用 Phase-2 checkpoint 重扫 OmniTraj-170K 挖出 8K 类别均衡失败案例,$G=16$、奖励加入 $r_{avn}$ 继续训练。
技术新颖性
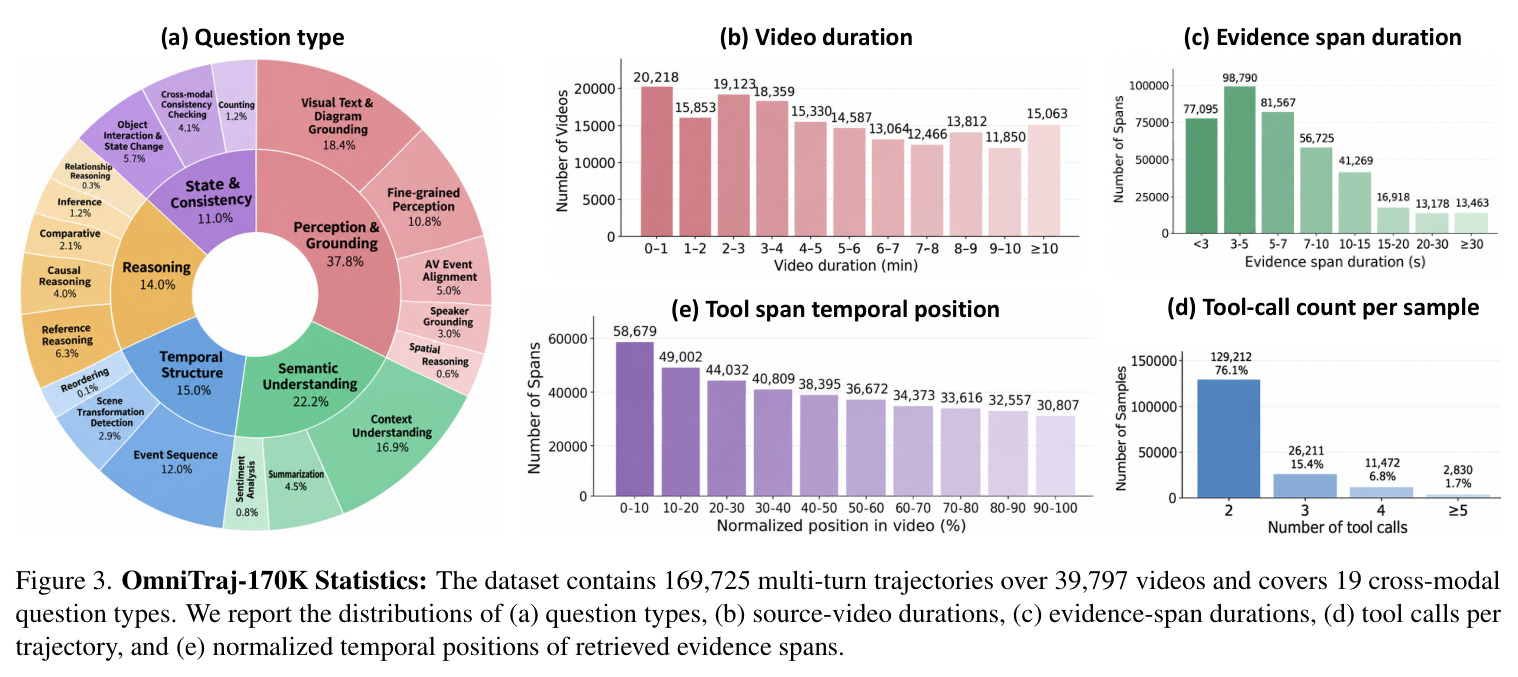
新颖性可从四个层面评估。任务层面:首次把全模态理解形式化为「跨音频与视频双通道的迭代式证据检索」,补齐了视频智能体工作缺失的音频维度,也不同于 OmniVideo-R1 等把推理留在文本模态的做法。数据层面:OmniTraj-170K 是首个以跨模态证据链为核心结构的多轮轨迹语料——证据逐字复制自感知标注、按解题逻辑排序(76.1% 的轨迹需 2 次工具调用、23.9% 需 3 次以上,证据片段集中于 3-10 秒且时间位置覆盖全片早晚期),这比「先生成推理文本再抽取调用」的传统蒸馏更能保证行为可验证、可校验。目标函数层面:用注意力键掩码做单模态消融,保持序列其余部分不变,规避了特征替换引发的分布漂移;用 $[x]^+=\max(x,0)$ 过滤 token 竞争造成的负值、以 min 代替均值构成逻辑与门防止「强单模态补偿另一模态零依赖」,整个奖励只需在既有 rollout 上追加两次 no_grad 前向,成本几乎为零。训练配方层面:论文量化了 SFT 对齐税、rollout 规模 $G$ 从 8 到 16 的探索收益与难例课程的叠加效应,为多轮工具 RL 提供了可迁移的实践路径。
实验结果
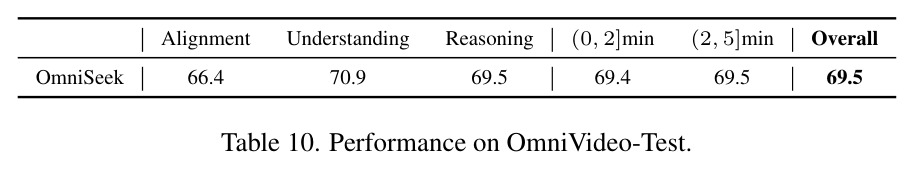
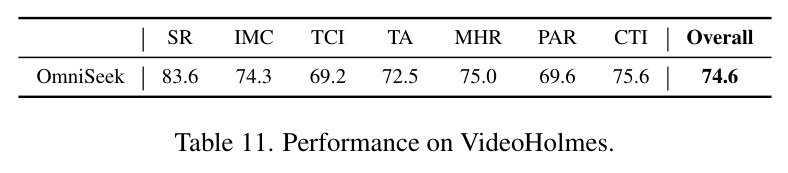
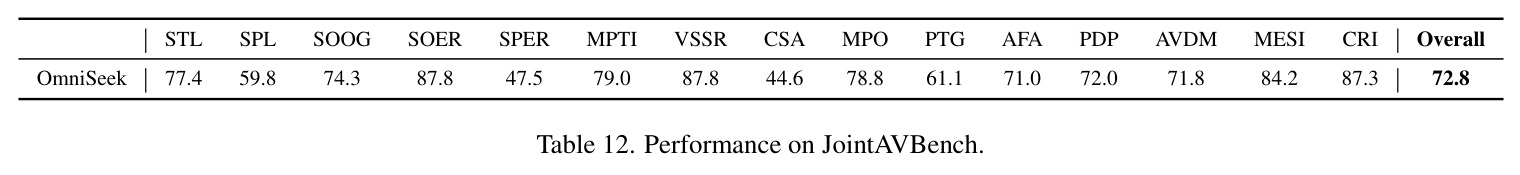
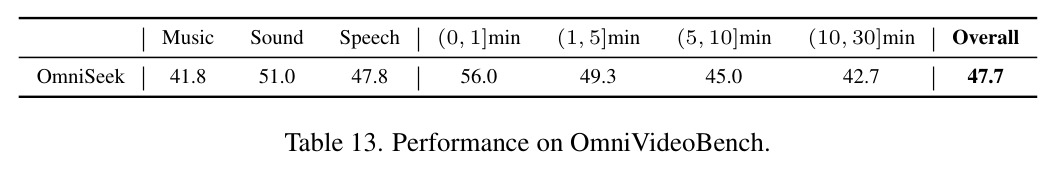
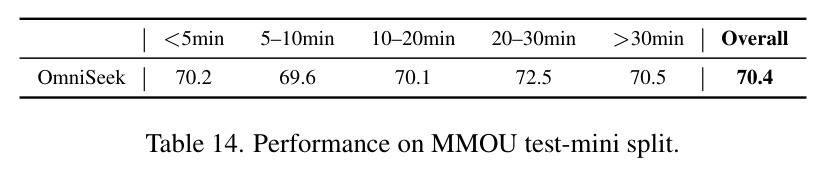
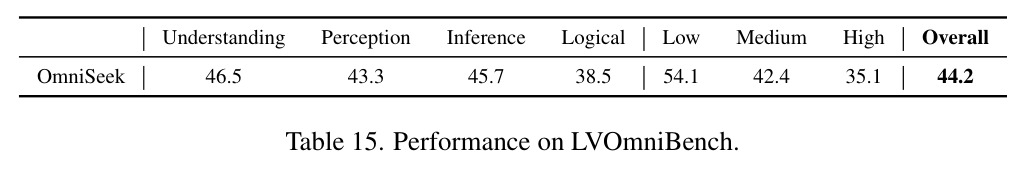
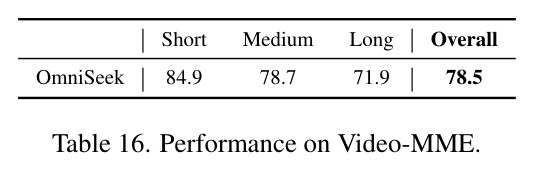
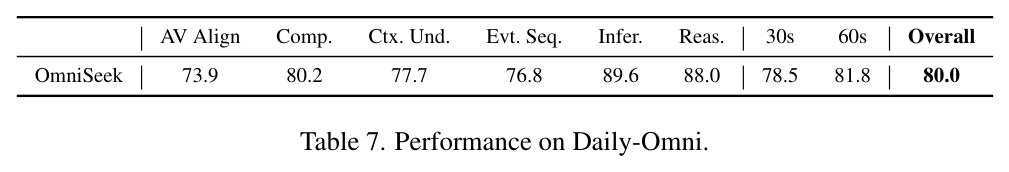
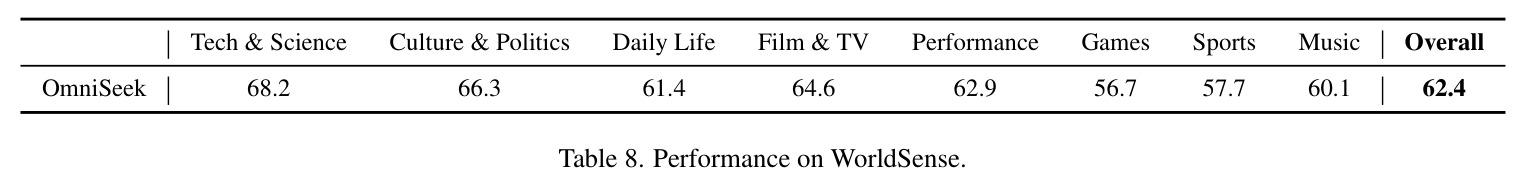
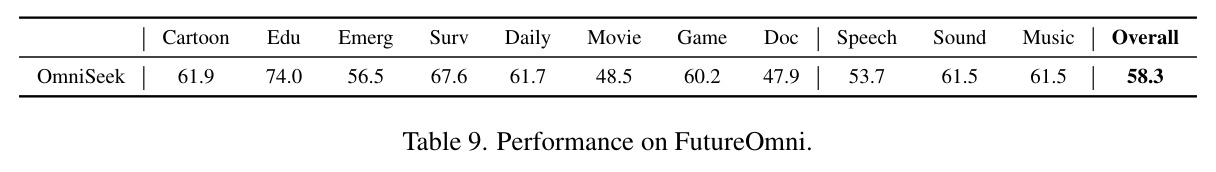
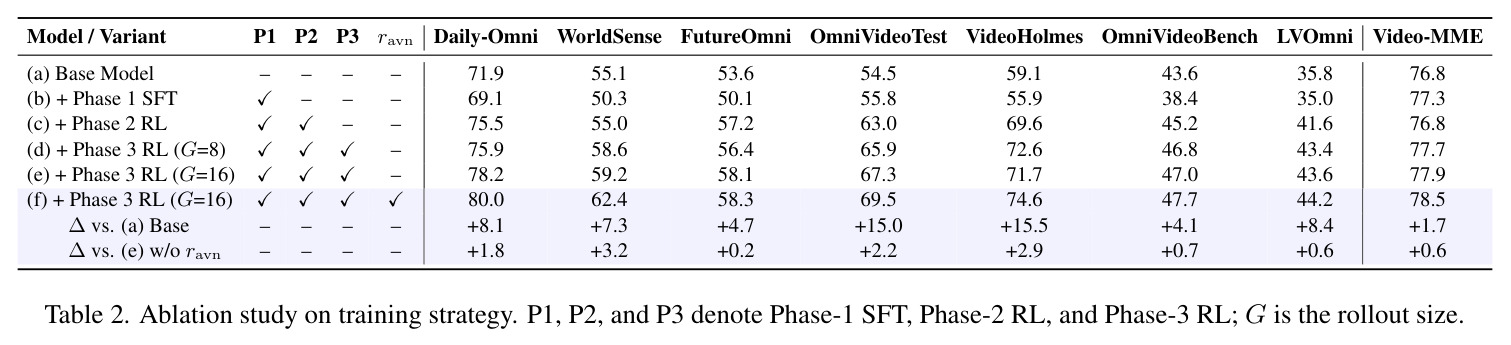
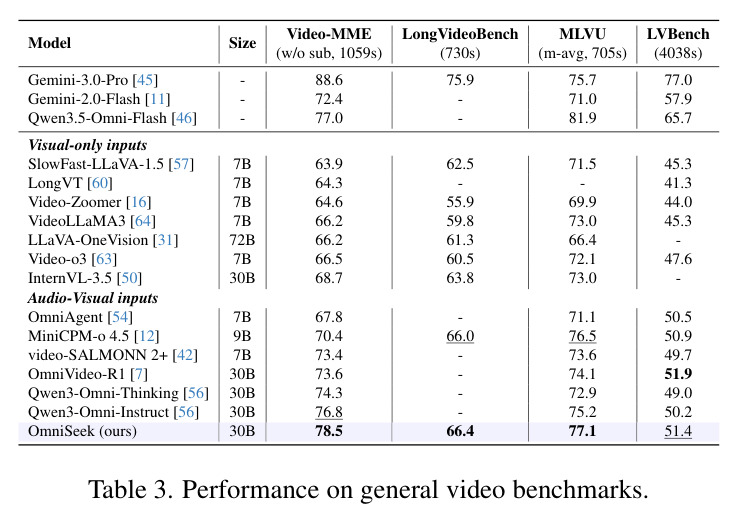
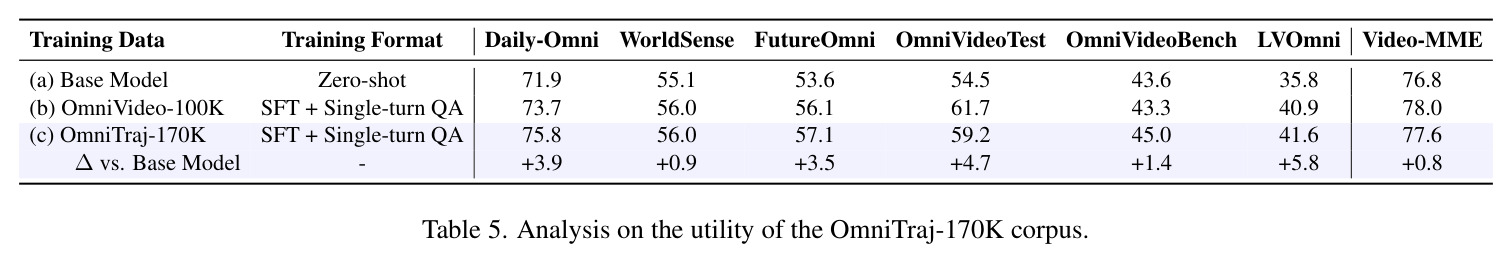
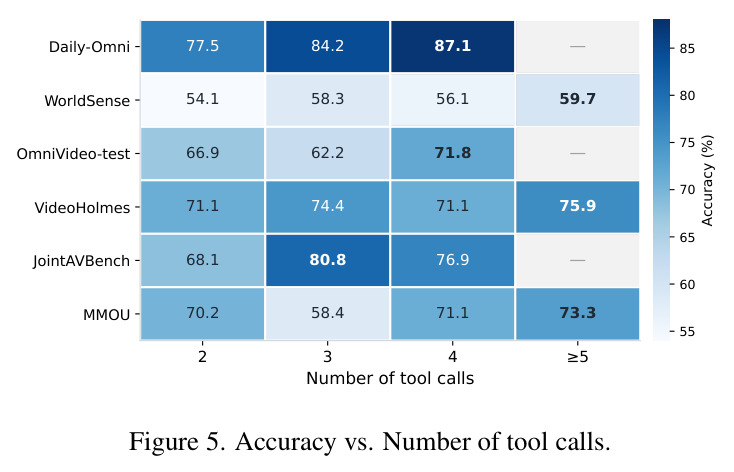
主实验(Table 1)显示 OmniSeek 在 10 个全模态基准上取得开源最佳或极具竞争力的结果:Daily-Omni 80.0、AVUT 78.8、WorldSense 62.4、FutureOmni 58.3、OmniVideoTest 69.5、VideoHolmes 74.6、JointAVBench 72.8、OmniVideoBench 47.7、MMOU 70.4、LVOmniBench 44.2,相对基座 Qwen3-Omni-Instruct 分别提升 +8.1、+2.3、+7.3、+4.7、+15.0、+15.5、+9.2、+4.1、+16.3、+8.4 个百分点;30B 规模超过 72B 的 video-SALMONN 2+,并在 FutureOmni、VideoHolmes、JointAV 上超过 Gemini-2.5-Pro。消融(Table 2)揭示三个动态:Phase-1 SFT 出现对齐税(Daily-Omni 71.9→69.1、WorldSense 55.1→50.3);Phase-2 RL 全面逆转(VideoHolmes 55.9→69.6、LVOmni 35.0→41.6);Phase-3 将 rollout 从 $G=8$ 扩至 $G=16$ 再涨(Daily-Omni 75.9→78.2),加入 $r_{avn}$ 后再获 +0.6~+3.2(WorldSense +3.2、VideoHolmes +2.9)。范式对比(Table 4)显示同等 RL 训练下多轮多模态工具调用远胜纯文本 CoT:OmniVideoTest +13.5、WorldSense +8.1、Daily-Omni +7.0。行为分析(图 5)表明检索深度随任务自适应:JointAVBench 3 次调用达峰 80.8%(2 次仅 68.1%)、Daily-Omni 4 次达 87.1%、VideoHolmes 与 MMOU 需 ≥5 次达峰 75.9%/73.3%。通用能力不降反升(Table 3):Video-MME 78.5、MLVU 77.1。数据消融(Table 5)显示单轮 SFT 下 OmniTraj-170K 亦优于 OmniVideo-100K(Daily-Omni 75.8 对 73.7)。值得注意的是,各项增益呈一致的规律:线索越稀疏分散、上下文越长的基准,主动取证的收益越大——MMOU、VideoHolmes、OmniVideoTest 的提升均超过 15 个点,而线索密集的短基准提升温和;同时 $r_{avn}$ 的边际收益集中在对单模态捷径敏感的 WorldSense 与 VideoHolmes 上,说明该奖励确实针对了它设计时要解决的问题。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 全模态音视频问答(Daily-Omni) | Accuracy | 80.0 | 基座 Qwen3-Omni-Instruct 71.9 | +8.1 |
| 复杂视频多跳推理(VideoHolmes) | Accuracy | 74.6 | OmniVideo-R1 (30B) 62.9 | +11.7 |
| 长视频全模态推理(MMOU test-mini) | Accuracy | 70.4 | 基座 Qwen3-Omni-Instruct 54.1 | +16.3 |
| 长音视频理解(LVOmniBench) | Accuracy | 44.2 | 基座 Qwen3-Omni-Instruct 35.8 | +8.4 |
| 音视频联合推理(JointAVBench) | Accuracy | 72.8 | 基座 Qwen3-Omni-Instruct 63.6 | +9.2 |
| 音视频结构化推理(OmniVideoTest) | Accuracy | 69.5 | 纯文本 CoT(同等 RL 训练)56.0 | +13.5 |
| 真实世界全模态理解(WorldSense) | Accuracy | 62.4 | 基座 Qwen3-Omni-Instruct 55.1 | +7.3 |
| 通用视频理解(Video-MME w/o sub) | Accuracy | 78.5 | 基座 Qwen3-Omni-Instruct 76.8 | +1.7 |
局限与改进
作者明确承认的局限集中在超长音频的上下文瓶颈:Qwen3-Omni 原生上下文 32K,音频以约 12.5 token/秒编码(16kHz 采样),两小时音频约产生 90K 音频 token,远超窗口容量;一旦溢出,模型指令跟随与格式能力退化——在 LVOmniBench 的 88 分钟视频失败案例中,智能体丧失工具调用能力,陷入重复 循环,并在推理块内幻觉出「音频里有个声音」「画面是健身房」等从未真正获取的感官证据。作者提出的线性变速播放只是权宜之计,会扭曲音高与环境声纹理。我自己的观察补充如下:(1) 评测几乎全为选择题,开放生成与真实取证任务的泛化未被检验;(2) 数据引擎强依赖 Qwen3.5-397B-A17B 级教师模型与 FineVideo 单一来源,且只用英文 ASR,语言与场景覆盖受限;(3) $r_{avn}$ 是注意力式代理指标,似然下降不必然等于因果依赖,且奖励由答案正确性 $c$ 门控,无法惩罚「靠捷径碰巧答对」的轨迹;(4) 工具粒度受限(片段 ≤45 帧、≤60 秒音频),初始粗上下文固定 128 帧@2FPS,对弱相关长视频浪费预算;(5) 只在单一 30B 基座上验证,方法对其他 Omni-LLM 的可迁移性未知。
独立分析的弱点
独立分析四个最值得警惕的弱点。第一,长时音频上下文爆炸是结构性软肋:音频 token 随时长线性增长,32K 窗口在数十分钟级视频上即告急,而现实应用(会议、监控、电影)常超过 1 小时;改进方向除作者提出的静音 token 丢弃与声学特征合并外,可借鉴 OmniZip 等音频引导压缩,或在 RL 中显式训练「证据用后即弃」的上下文管理策略。第二,必要性奖励可被博弈:模型可能学会在无关片段上分散注意力以拉高 $nec$ 值,或对两个模态都浅尝辄止;改进方向是把 token 级代理换成因果干预——例如在 rollout 中扰动或删除所检索片段、观察答案一致性后再计分,或对证据片段与答案 token 施加显式 grounding 对齐损失。第三,数据引擎的单点依赖与偏差:题目、选项与证据链全部出自同一教师模型,其错误与可被语言先验解出的题目可能系统性残留;FineVideo 以 vlog/新闻类为主,与电影、监控等域分布有差距;改进方向是引入人工校验子集、多源视频,并用「单模态可解性过滤器」(分别只喂音频或视频给独立模型测试)对抗性剔除捷径样本。第四,动作空间贫瘠:只有时间维度两个工具,无空间放大、无 OCR、无外部知识检索,「屏幕小字+画外音」类任务可能失效;可并入 crop/zoom-in 与文本识别工具,把时间×空间×模态统一到同一动作空间。
未来方向
作者提出的未来方向有二:训练侧,把更长的多轮轨迹纳入 RL 流程以原生扩展上下文窗口;推理侧,探索模态非对称的 token 压缩——动态丢弃静音音频 token、合并冗余声学特征,使智能体在不发生结构崩塌的前提下处理数小时长的多模态流。基于本文成果还可延伸:(1) 把必要性目标从注意力代理升级为检索级因果充分性奖励(对取回片段做消融或替换,用答案一致性打分),并推广到文本、传感等任意模态组合;(2) 与流式架构结合,构建「边播边查」的实时取证智能体,服务直播审核、会议纪要等在线场景;(3) 统一时间检索与空间放大(zoom-in、裁剪)到同一动作空间,实现时间×空间×模态三维取证,并检验跨工具协同是否涌现;(4) 自改进数据引擎:用训练后的 OmniSeek 自身成功轨迹反哺数据合成,逐步替代 397B 级教师模型,降低数据成本;(5) 超越选择题范式,在开放问答与可验证的时序定位任务上评测证据链质量本身;(6) 探索听者/看者/合成者的多智能体分工,或研究音频与视频 token 预算的动态分配策略。
复现评估
复现评估:论文正文与附录均未给出代码、模型权重或 OmniTraj-170K 的发布链接,这是最大的不确定因素。有利条件:基座 Qwen3-Omni-30B-A3B-Instruct 开源可得;轨迹数据源 FineVideo 公开;14 个评测基准全部公开;附录给出近乎完整的复现信息——三阶段超参表(batch、学习率、warmup、KL 系数、clip 区间、rollout 规模、温度、最大交互轮数、帧数与像素预算)、数据合成的三个系统提示词全文(视觉标注、证据链 QA、轨迹组装)以及 $r_{avn}$ 的精确公式。不利条件:(1) 数据引擎依赖 Qwen3.5-397B-A17B 这种未公开的超大教师模型,用开源模型替代会引入质量差距;(2) 算力门槛高——SFT 需 32×H200,两阶段 RL 各需 128×H200、序列长 65536,中小团队难以完整复刻;(3) 多轮工具调用的 GSPO 工程实现(rollout 中的工具执行与观察回填、注意力掩码控制)需要较强的 infra 能力。综合判断:评测复现难度中等(按 Table 6 配置可对齐),全流程复现难度高;但核心思想(证据链数据合成 + min 门控的必要性奖励)可以在 7B 级模型与数万条轨迹的小规模上低成本验证。
论文图表