OmniCapBench:面向细粒度视听描述的深度结构化评估框架 OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
用原子化结构单元加“规则+受限LLM”两段式评分,实现可靠的细粒度视听描述诊断
前置知识
LLM-as-Judge(LLM 评委)
用一个大型语言模型给另一个模型的输出打分或做比较的评估范式。评委读入预测与参考文本,按提示词输出分数或裁决。优点是能评估开放式文本的语义质量,缺点是评委对自身能力与提示词高度敏感:同一批预测换个评委得分可差二十多分,而且给整段长文本打全局分时容易忽略局部事实错误。
本文核心论点就是无约束的全局 LLM 评委既不稳定又掩盖局部错误,OmniCapBench 把 LLM 的职责压缩为边界受限的局部语义比对,理解这一点才能看懂其评分契约的设计动机。
视听字幕生成(Audio-Visual Captioning)
要求模型观看带音频的视频后输出描述文本的任务,需同时理解视觉内容(人物、动作、场景)与声学内容(对白、环境音),并在时间轴上把两者对齐。它被视为检验多模态大模型连续流感知能力的理想诊断任务,因为一段描述会同时暴露“看到了什么、听到了什么、何时发生”。
本文正是为这一任务设计评估基准,三轨道原子单元分别对应视觉身份、音频事件与镜头时序三个信息流。
tIoU(temporal Intersection-over-Union)
时序版本的交并比。两个时间区间 $[s_1,e_1]$ 与 $[s_2,e_2]$ 的重叠度定义为交集长度除以并集长度:$\mathrm{tIoU}=\frac{|[s_1,e_1]\cap[s_2,e_2]|}{|[s_1,e_1]\cup[s_2,e_2]|}$。当预测区间与真值区间的 tIoU 超过阈值时视为匹配成功,用于衡量时间定位的边界对齐程度。
论文用 tIoU 确定性地匹配镜头与音频事件(Shot tIoU、Event tIoU 等指标),是结构评估阶段的核心组件。
Precision / Recall / F1
精确率 $P$ 衡量预测中有多少是对的(惩罚幻觉),召回率 $R$ 衡量真值中有多少被覆盖(惩罚遗漏),F1 是二者的调和平均 $\mathrm{F1}=\frac{2PR}{P+R}$。在开放式生成评估中单向评分有偏:只看召回会奖励冗长堆砌,只看精确会奖励过度简略。
论文采用双向匹配(召回视角查遗漏、精确视角查幻觉)防止模型钻空子,各 F1 类指标均由此导出,是读懂实验表格的前提。
结构化输出与 JSON Schema 约束
要求模型按预定义 schema 输出 JSON 对象而非自由文本,通常配合约束解码保证格式合法。本文要求模型直接输出包含 Reference、Shot、Event 三轨道的 JSON,使预测天然可解析、可对齐、可逐单元比对,绕过了从自由文本反推结构这一不稳定环节。
“原生原子单元输出”是与传统字幕评估的本质区别,理解结构化输出才能理解为何部分评分可以交给确定性规则完成。
研究动机
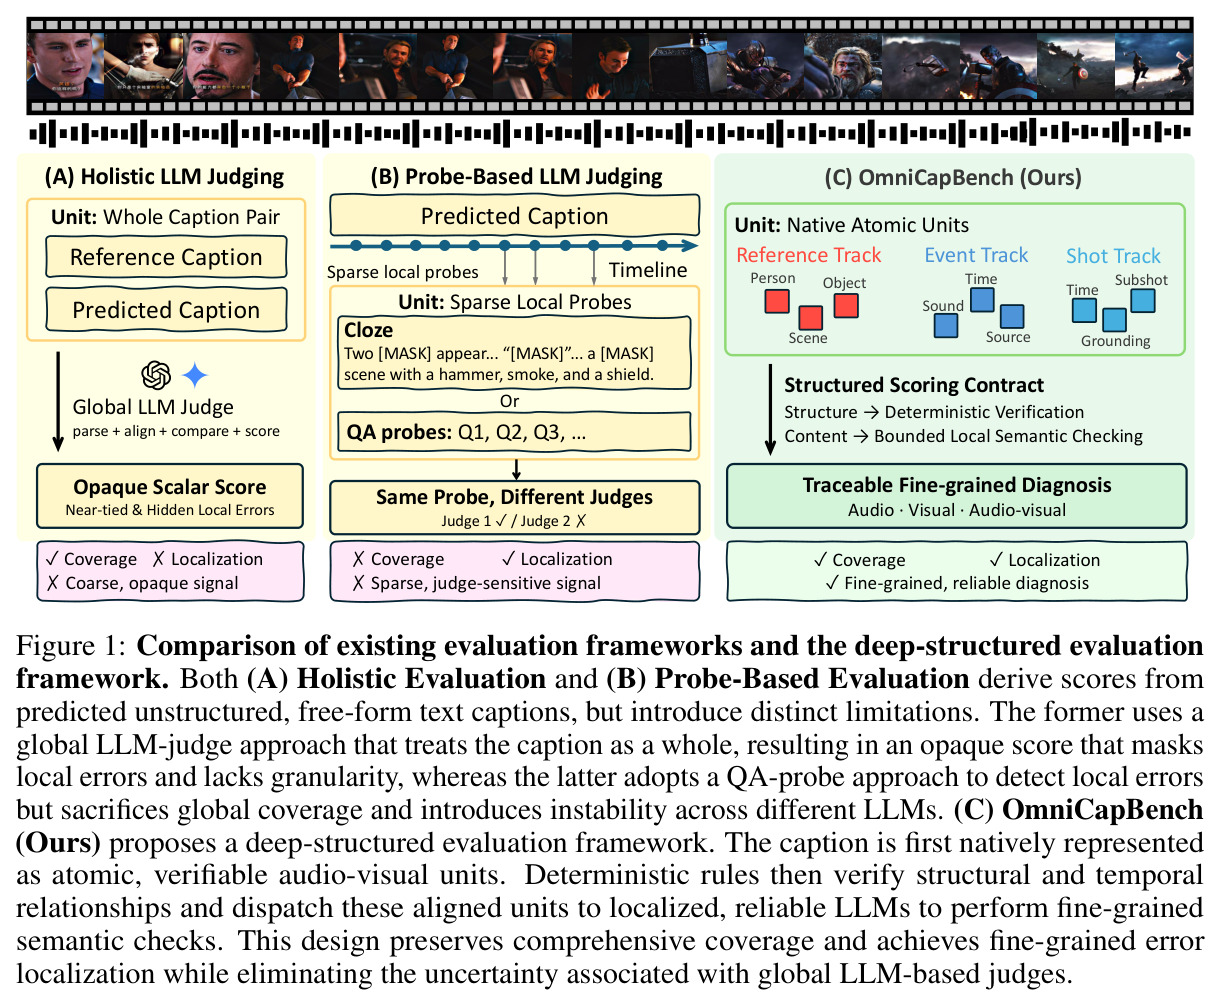
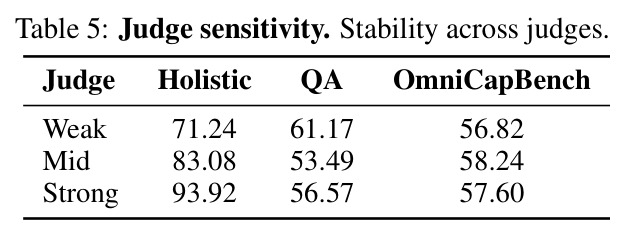
多模态大模型正快速走向连续音视频流推理,音视频字幕生成成为诊断其感知能力的理想任务,但现有评估协议存在一个耦合的权衡。整体式协议(AuroraCap、VCapsBench、UGC-VideoCap、video-SALMONN 2 等)把整条预测描述与参考描述作为一个单元交给全局 LLM 评委打一个标量分:覆盖面广,却把细粒度信息压缩进不透明分数,无法定位局部错误。探针式协议(Omni-Cloze 等)用 QA 探针或完形填空定位局部错误,但探针稀疏、缺乏全局覆盖,且隐式要求评委做信息抽取与匹配,容易分心误判——即使字幕正确也可能得出错误结论。解析后评分(LongVALE、TimeChat、OmniScript)把自由文本事后解析成脚本条目,但解析层本身脆弱。更严重的是无约束 LLM 评委的稳定性:给模型生成的稠密整体文本打分,评委必须先逆向工程出结构,同一批输出在弱评委(Qwen3.6-27B)下得 71.24 分,在强评委(Gemini-2.5-Pro)下竟膨胀到 93.92 分,换个评委结论就翻转。自由文本的单体表示从根本上阻碍了评估单元与评分算子的联合设计。
本文的目标是本文目标是把音视频字幕评估重构为一个“深度结构化诊断框架”:将预测目标从自由形式文本改为原子化、可验证的评估单元集合,跨三条轨道组织——Reference(实体引用)、Shot(视觉镜头)、Event(音频事件)。在此结构之上,评分被解耦为两个可靠阶段:确定性规则严格验证结构完整性(合法 ID、时间边界、交叉链接),局部化 LLM 评委只对结构对齐的单元做边界受限的语义等价比较。最终在 786 个密集标注视频(共 12.8 小时)构成的数据集上,有效区分 MLLM 的时序定位失败、身份漂移、跨模态错配与幻觉描述等细粒度感知错误;并通过系统性实证审计证明整体式评分会掩盖局部错误且对评委极度敏感,从而为全模态模型开发提供可执行的细粒度能力路线图。
与已有工作不同的是,独特切入角度在于:不在自由文本之上叠加更聪明的评分策略,而是直接改变被评估对象本身的表示。作者敏锐地指出,现有基准很少协同设计“评估单元”(决定评估粒度)与“评分算子”(决定单元上的可靠性)这两个紧耦合组件——整体式覆盖有余而定位不足,探针式定位有余而覆盖不足,二者都无法兼得。OmniCapBench 的解法是让评估单元以原生原子形式存在:模型被要求输出结构化 JSON 而非段落,于是结构归确定性规则、语义归受限 LLM,两个组件第一次能够联合优化。表示层面它基于 MTSS(多流场景脚本)并做了两处针对性增强:把镜头细分为子镜头、把离散点时间戳替换为连续时间区间。此外,论文不只提出新基准,还首次系统性地实证审计了整体评估范式的两大脆弱性(掩盖局部错误、评委不稳定),为“为什么需要换范式”补上了实验证据。
核心方法
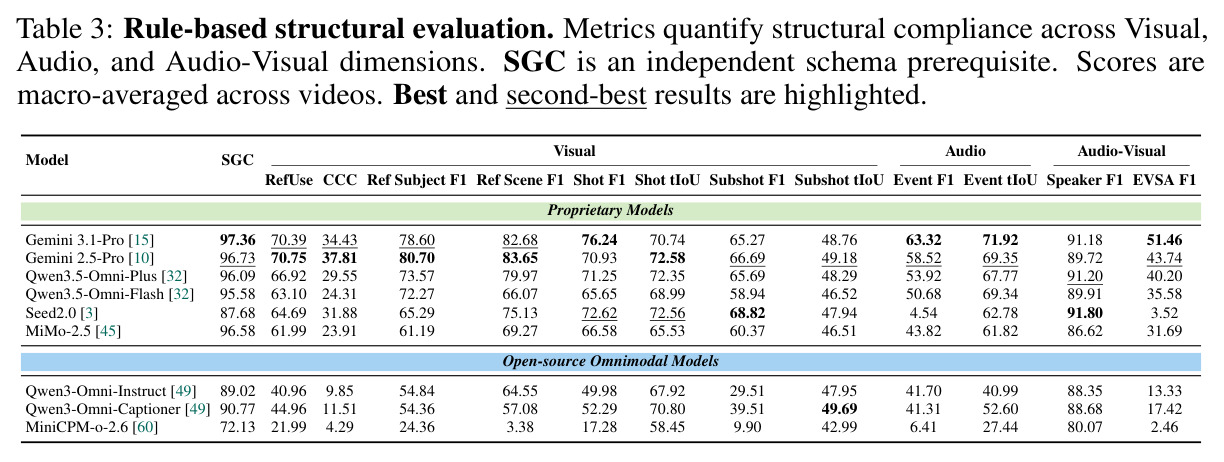
直觉上,要可靠验证 AI 的音视频理解,必须把“发生了什么”与“何时何地发生”解耦。OmniCapBench 建立在 MTSS 表示之上,把视频 $V$ 形式化为结构化参考系统 $S^\star(V)=(R,E,H)$:Reference 轨道为人物、物体、场景等持久实体分配唯一标识符(如 [PERSON_1]),支撑跨镜头身份追踪;Event 轨道记录带精确时间边界的音频事件与对白(如 10.5s 到 12.0s 的连续狗叫);Shot 轨道把视觉时间线切分为镜头并细分子镜头,用显式交叉链接把实体与音频事件锚定到具体画面。评估是两阶段流水线:先用确定性规则验证结构(合法 ID、时间起止、事件-镜头链接的时间兼容性),无效单元被剔除并计为结构错误,镜头与事件按 tIoU 匹配、引用与子镜头交给只比较局部候选对的有界 LLM 匹配器;再把对齐的单元对交给 LLM 评委仅做局部语义等价比较。这一契约立刻暴露出全局分数看不到的问题:Gemini 3.1-Pro 结构合规分高达 97.36,但音频事件 F1 63.32 到音视频关联 EVSA F1 51.46 的骤降,说明模型并未把声音真正绑定到画面。
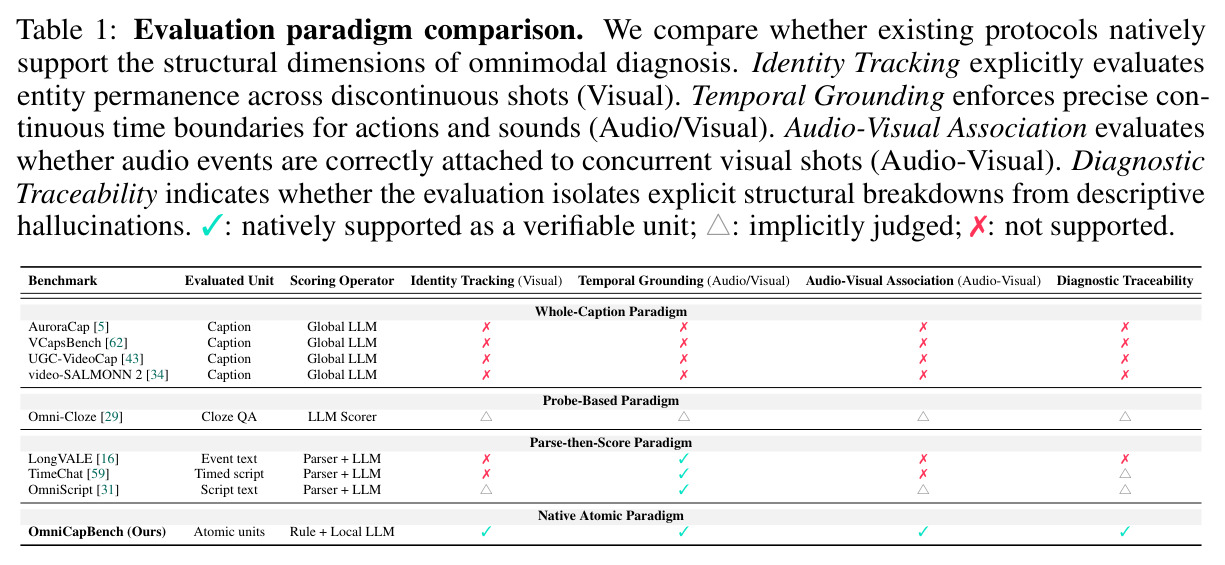
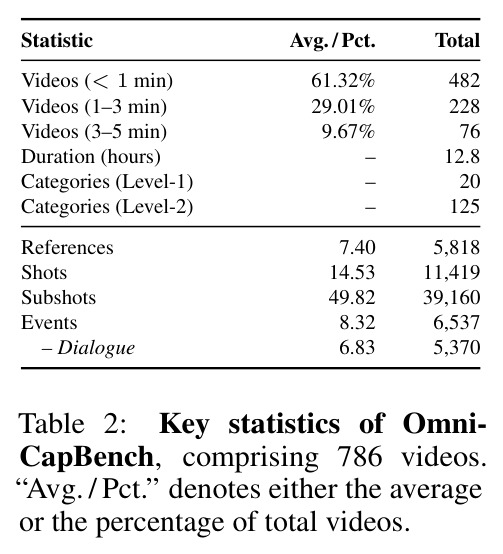
核心创新是“深度结构化评估单元 + 解耦的评分契约”。与整体式的本质区别:不再让一个 LLM 对整段文本打一个不透明分数,被评估对象本身就是原子单元集合,覆盖与定位天然兼得。与探针式的本质区别:单元不再稀疏(每视频平均 7.40 个实体引用、14.53 个镜头、49.82 个子镜头、8.32 个事件),且评委无需隐式做信息抽取。与解析后评分的本质区别:结构不是事后从文本里脆弱地解析出来的,而是模型原生输出的一部分,从源头消除逆向工程误差。评分契约严格执行“结构优先、语义在后”:结构检查(ID 合法性、时间边界、交叉链接)完全确定性,LLM 只被允许对结构对齐的孤立字段做局部语义等价判断,大幅降低对评委推理能力的需求。另有双向评估机制:召回视角(Ground Truth 到 Prediction)严格惩罚遗漏,精确视角(Prediction 到 Ground Truth)严格惩罚幻觉,F1 取二者调和平均,防止模型用过度简略或冗余堆砌刷分。Table 1 显示只有本文原生支持身份追踪、时序定位、音视频关联与诊断可追溯四个维度。
方法步骤详情
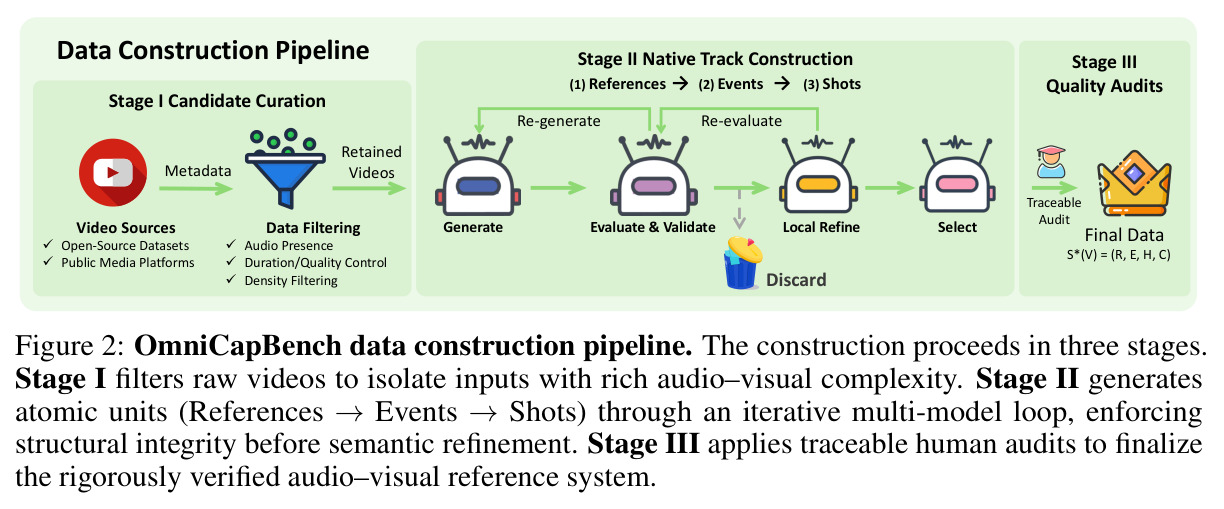
数据构建分三阶段。Stage I 候选筛选:从公开数据集与平台取候选视频,做元数据抽取、镜头检测与分类,再按音频存在性、时长、质量与分桶密度过滤(最终 61.32% 视频不足 1 分钟、29.01% 在 1 到 3 分钟、9.67% 在 3 到 5 分钟),确保音视频复杂度足够。Stage II 原生轨道构建:按 References、Events、Shots 的依赖顺序迭代执行“生成、评估与验证、局部精修、选择”循环——生成器提出候选轨道,评估器集成校验事实准确性,程序化验证器强制 schema 约束,拓扑验证通过后才做语言精修且强制 ID、时间边界、交叉链接不变,最后由选择器挑出最优版本。Stage III 质量审计:程序化检查 schema、时间戳范围与交叉链接,人工抽检边界与语义分歧。最终得到 786 个视频、5,818 个实体引用、11,419 个镜头、39,160 个子镜头、6,537 个音频事件(其中 5,370 个为对白)。评估侧分三个任务:Task 1 模型输入视频、输出三轨道结构化 JSON;Task 2 确定性结构验证与匹配(tIoU 匹配镜头与事件,有界 LLM 匹配器处理引用与子镜头);Task 3 局部化语义评分(结构对齐单元上的受限 Precision 与 Recall),指标覆盖视觉、音频与音视频三个域。
技术新颖性
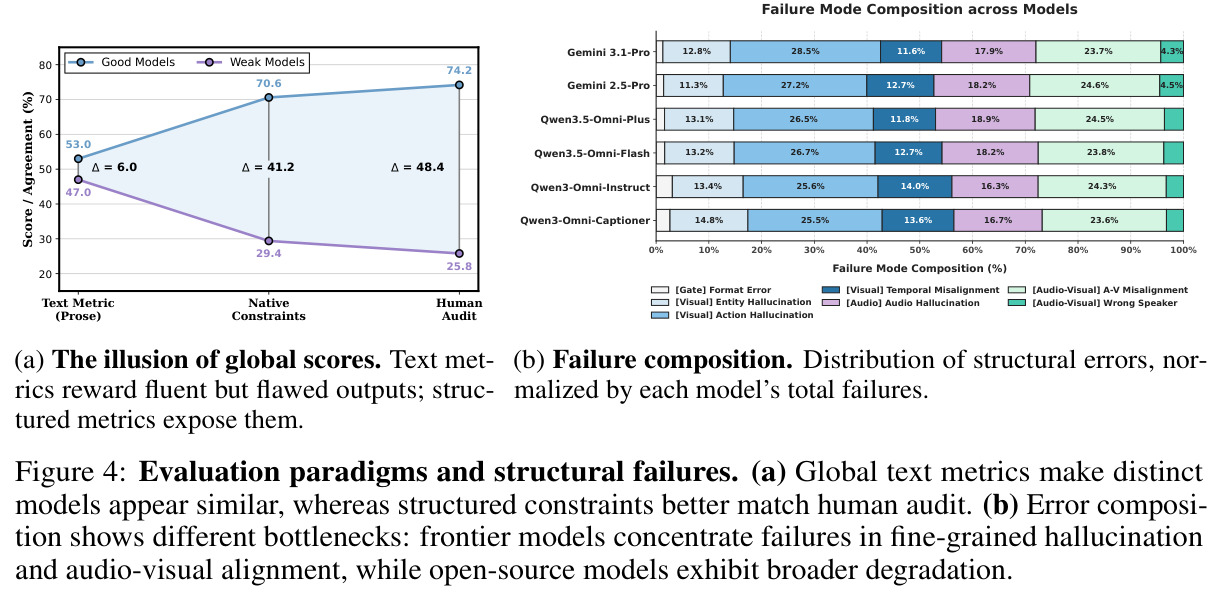
技术新颖性体现在四点。第一,范式层面:Table 1 显示它是唯一“原生原子”范式的基准,原生支持身份追踪、时序定位、音视频关联与诊断可追溯性,而整体式四项全不支持,解析式最多只支持时序定位。第二,评分算子设计:把 LLM 从“全局推理者”降级为“局部语义比较器”,结构验证全部交给确定性规则——实证上 OmniCapBench 分数在弱、中、强三个评委下仅从 56.82 波动到 58.24 再回到 57.60,而整体式基线同一预测从 71.24 膨胀到 93.92,稳定性的量级差异直接证明了契约设计的价值。第三,指标设计:CCC(跨镜头共指一致性)把“物体是否被持续正确追踪”变成可测指标,EVSA(事件-镜头关联 F1)把“声音是否绑定到正确画面”变成可测指标,这类深层失败在传统文本指标下根本不可见。第四,实证审计方法:通过在 200 个难分视频上构造“虚假平局”,证明全局指标被语言流畅性操纵——文本指标下强弱模型约 50% 对 50%,切换到结构约束后强模型升至 74.2%(与人工审计的 74.2% 完全一致)、弱模型崩塌至 25.8%,为范式转换提供了量化论据。
实验结果
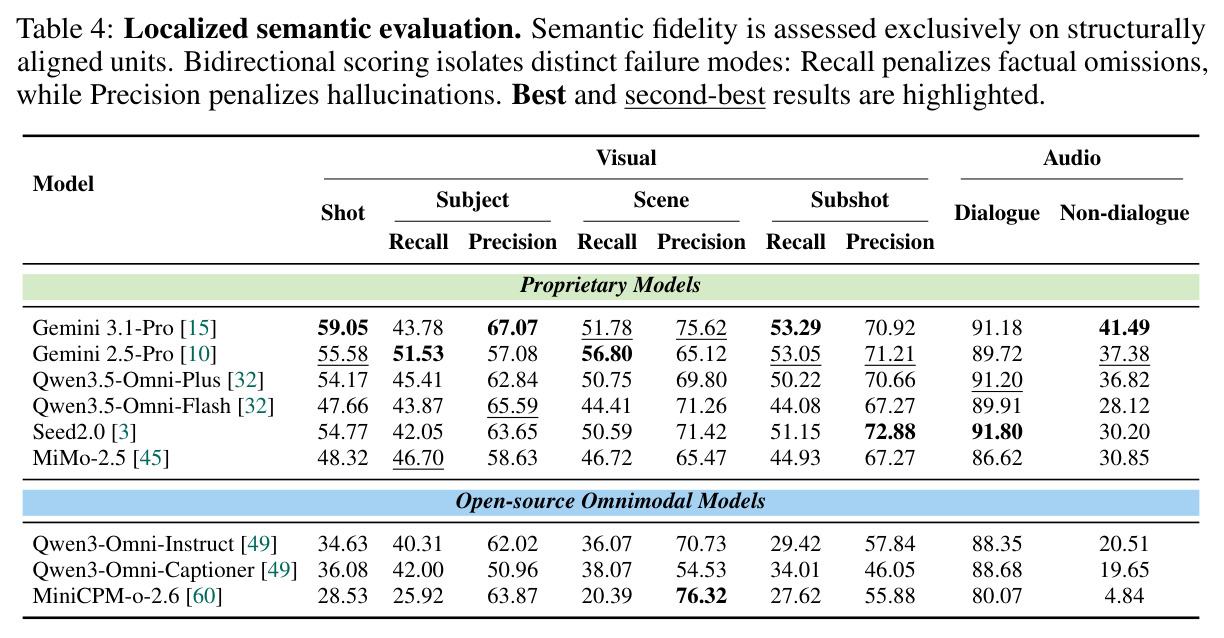
发现一(结构评估,Table 3):前沿模型格式合规已基本解决——SGC 普遍 95 分以上,Gemini 3.1-Pro 达 97.36,格式错误仅占其总失败的 1.3%——但深层结构能力薄弱:Gemini 2.5-Pro 的跨镜头共指一致性 CCC 仅 37.81%,开源模型全部低于 12%(Qwen3-Omni-Instruct 9.85、MiniCPM-o-2.6 4.29);跨模态绑定上 Gemini 3.1-Pro 从 Event F1 63.32% 跌至 EVSA F1 51.46%,开源模型 EVSA 均低于 20%;Seed2.0 最反常,Speaker F1 全场最高 91.80% 却几乎不输出音频事件(Event F1 4.54、EVSA 3.52),印证音视频流仍是未对齐的独立通路。发现二(语义评估,Table 4):结构对齐后暴露鲜明的精确-召回权衡——Gemini 3.1-Pro 保守(Subject Precision 67.07 对 Recall 43.78),MiniCPM-o-2.6 走极端(Scene Precision 76.32 第一但 Recall 仅 20.39);对白语义普遍很强(Seed2.0 91.80),环境音语义普遍弱(最好 41.49)。发现三(评委稳定性,Table 5):同一预测在弱、中、强评委下整体式得分 71.24、83.08、93.92,波动剧烈,OmniCapBench 仅 56.82、58.24、57.60。发现四(全局分数幻觉,Figure 4):200 个文本指标下打平(约 50% 对 50%)的难分视频,换结构约束后强模型升至 74.2% 与人工审计一致、弱模型跌至 25.8%;失败构成上 Gemini 3.1-Pro 集中于动作幻觉 28.5%、音视频错配 23.7%、音频幻觉 17.9%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 跨镜头身份一致性(视觉) | CCC(跨镜头共指一致性) | Gemini 2.5-Pro 37.81(全场最佳) | Qwen3-Omni-Instruct 9.85;MiniCPM-o-2.6 4.29 | 最佳模型也仅约 38%,开源模型全部低于 12%,首次量化暴露长期视觉物体恒常性缺陷 |
| 音视频事件-镜头关联 | EVSA F1 | Gemini 3.1-Pro 51.46 | Qwen3-Omni-Instruct 13.33;MiniCPM-o-2.6 2.46 | 较最强开源模型高约 38 分,且所有开源模型低于 20%,证明跨模态结构绑定是普遍短板 |
| 对话说话人归属(音频-视觉) | Speaker F1 | Seed2.0 91.80(全场最高) | MiniCPM-o-2.6 80.07 | 说话人归属普遍 86 分以上接近解决,但同一 Seed2.0 的 Event F1 仅 4.54,反衬环境音理解严重失衡 |
| 评委鲁棒性(相同预测更换评委) | 三个评委下的分数极差 | OmniCapBench:56.82 至 58.24,极差 1.42 | 整体式:71.24 至 93.92,极差 22.68 | 波动缩小约 16 倍,证明结构化评分契约显著降低对评委能力的依赖 |
| 难例子集诊断分辨率(200 个难分视频) | 强弱模型分差 | 结构约束下 74.2 对 25.8,分差 48.4 | 传统文本指标下约 50 对 50(虚假平局) | 结构指标结果与人工审计 74.2% 完全对齐,打破语言流畅性制造的评估水分 |
局限与改进
作者承认的局限包括:基准规模为 786 个视频、12.8 小时,相对通用视频基准偏小,且 61.32% 的视频不足 1 分钟,数分钟以上的长时程连续推理能力未被覆盖;标注虽经三阶段“生成-验证-审计”管线与人工抽检,但底层轨道仍由多模型流水线迭代生成,可能携带生成模型的系统性偏见(如对哪些实体值得建 Reference 的选择偏好);专用字幕模型 ASID-Caption 与 AVoCaDO 因结构化指令遵循差被排除在主表之外,意味着该基准对面向自由文本微调的模型不够友好。我自己的观察:其一,语义评分最终仍依赖 LLM 评委,其幻觉虽被“局部化”限制但未彻底消除,评委对同义改写的偏好仍可能影响局部比较;其二,原生结构化 JSON 输出对模型是额外负担,SGC 显示即便前沿模型也有 2% 到 13% 的格式失败,部分“结构错误”可能是指令跟随问题而非感知问题,两种失败在口径上有混淆风险;其三,有界 LLM 匹配器负责引用与子镜头匹配,该步骤的阈值与提示词选择论文未做充分消融;其四,数据来自公开平台,非英语场景与稀有音事件的覆盖情况未知。
独立分析的弱点
弱点一:对输出格式的强依赖引入了混淆变量。Seed2.0 的 Event F1 只有 4.54 却有 91.80 的 Speaker F1,很难区分它到底是“听不到环境音”还是“没按 schema 输出事件单元”。改进方向:为不同模型提供少样本格式适配或格式无关的解析兜底,并在报告中把“格式失败”与“感知失败”显式分解。弱点二:语义评分与部分匹配仍需 LLM,虽已边界受限,但局部比较仍受评委语言偏好影响,例如对改写细节的容忍度没有校准。改进方向:报告多评委一致性系数,或用嵌入相似度替代部分语义判断以进一步去主观化。弱点三:标注管线以模型生成为主、人工审计为辅,786 个视频的人工抽检覆盖率论文未给出具体比例,且实体粒度的选择本身有主观性。改进方向:公开审计协议、标注者间一致性数据与分歧样本。弱点四:tIoU 匹配阈值与子镜头切分粒度是超参数,不同切分方案会改变 Subshot F1 的绝对值,跨基准比较仍需谨慎。改进方向:提供多阈值敏感性曲线与标准化切分工具。弱点五:基准密集绑定 MTSS 表示,模型若内部使用其他场景图表示,需要额外适配层才能公平参赛。
未来方向
作者方向上,论文把基准定位为“可执行的诊断工具”,最自然的延伸是把诊断信号反哺训练:以 CCC、EVSA 等结构指标作为强化学习的奖励或过程监督信号,直接针对身份漂移与跨模态错配优化,而不是等评测时才发现问题。基于本文成果可延伸的方向包括:其一,扩展到更长视频与实时流场景(当前 61.32% 的视频不足 1 分钟),检验数分钟到小时级的身份持久性与事件追踪,这正是文中指出的“弱长程音视频推理”的试金石;其二,把三轨道结构化输出作为中间表示,探索“结构化描述、下游问答、下游规划”的迁移价值,使评估格式本身成为模型能力的一部分;其三,把双向精确-召回评估推广到其他开放生成任务(具身智能轨迹、GUI 操作序列)的结构化评估;其四,失败构成分析(如 Gemini 3.1-Pro 动作幻觉 28.5%、音视频错配 23.7%)已接近可解释的模型体检报告,可进一步工程化为回归测试套件,跟踪模型版本迭代中细粒度能力的退化与进步;其五,研究评委会集成或微调小型开源模型担任局部评委,在保持稳定性的同时进一步降低评估成本。
复现评估
复现评估:论文投稿 NeurIPS 2026 Datasets and Benchmarks Track,项目网站(01yzzyu.github.io/OmniCapBench)与文中开源标记表明数据集预计开源;786 个视频来自公开平台与开放数据集,但视频再分发与下载脚本协议需等正式发布确认。复现门槛中等偏上:一是被测模型多为闭源 API(Gemini 3.1/2.5-Pro、Qwen3.5-Omni 系列、Seed2.0、MiMo-2.5),逐模型评测有真实 API 费用;二是评分管线依赖外部 LLM——有界匹配器与语义评委(实验用弱档 Qwen3.6-27B、中档 GPT-4o、强档 Gemini-2.5-Pro),需要 API 预算并精确复现其提示词与阈值,评委版本变化可能引入轻微漂移;三是参考轨道的“生成、验证、精修、选择”多模型管线较复杂,但只做评测的用户仅需标注数据与打分代码,难度可控。若作者按承诺放出代码、提示词与标注,研究生级别团队可在数周内复现主表;建议重点确认其是否发布评委提示词、tIoU 阈值与人工审计脚本。
论文图表
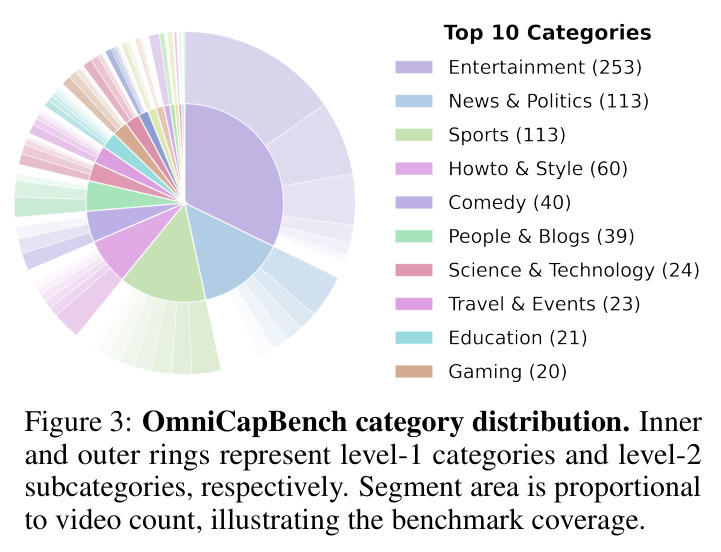
双环饼图展示基准的类别覆盖:内环为 20 个一级类别,外环为 125 个二级子类,扇区面积与视频数量成正比;配合 Table 2 的时长分布(61.32% 视频不足 1 分钟、12.8 小时总量)刻画数据多样性。
评估基准的代表性取决于类别覆盖,此图证明 786 个视频在类别维度上做了广泛采样,而非集中在少数场景。
以吹落叶机视频为例,逐轨道对比真值与 Gemini 3.1-Pro、Gemini 2.5-Pro、Qwen3.5-Omni-Plus 的预测,并给出每个单元的局部 Recall 与 Precision 分数:例如 Qwen3.5-Omni-Plus 幻觉出的“protective eyewear”被精确分惩罚,时序上不受支持的动作描述被召回分惩罚,整体流畅的散文无法掩盖这些具体错误。
定性展示“结构优先、语义在后”如何在具体单元上产出可追溯的诊断信号,直观说明整体式评估为何会被流畅幻觉误导。