Self-Credit:通过组内重缩放实现长程智能体强化学习的信用分配 Self-Credit: Credit Assignment for Long-Horizon Agentic RL via Intra-group Rescaling
自摘要引用提供轮次信用,组内成败对照校准,稀疏奖励变密集
前置知识
RLVR(可验证奖励强化学习)
用可自动验证的结果奖励(如最终答案对错 0/1)对 LLM 做强化学习,无需训练奖励模型。奖励只在轨迹结束时给出,例如搜索问答智能体检索几十轮后只拿到一个二元结果,中间没有任何逐步打分,信号极其稀疏。
本文的出发点就是 RLVR 奖励稀疏在长程任务中导致的信用分配困难,整篇工作都在回答如何把这一个 0/1 奖励变成密集的学习信号。
GRPO(组相对策略优化)
对同一 prompt 采样一组轨迹(本文为 16 条),用组内奖励的均值和标准差归一化得到优势 $\hat{A}^j=\frac{R^j-\mathrm{mean}\{R\}}{\mathrm{std}\{R\}+\epsilon}$,从而省去 critic。标准做法是把 $\hat{A}^j$ 均匀广播到该轨迹的所有 token 上。
Self-Credit 直接建立在 GRPO 之上:组内成败轨迹的对照关系、组内重缩放规则、优势重加权全部作用在 GRPO 的组级优势 $\hat{A}^j$ 上。
信用分配(Credit Assignment)
强化学习的核心难题:当奖励只在最后给出时,如何判断轨迹中哪一步动作对最终结果贡献最大。技术表现形式通常是非均匀的轮次级或动作级优势估计,比如给关键动作的 token 更高优势、给有害动作负优势。
本文标题的主语就是信用分配:Self-Credit 的三个组件(自引用、组内重缩放、优势重加权)都是为了把统一的组级优势细化为轮次级优势 $\hat{A}^{j,t}$。
Compaction(上下文压缩/自压缩)
长程智能体的交互历史会超出上下文窗口。压缩指当 token 数达到阈值 $C$ 时,用模型自己生成的摘要替换全部历史,之后从 query 加摘要继续交互。SUPO、ECHO 等工作已把压缩作为可训练组件引入 RL 训练。
Self-Credit 的巧妙之处是把压缩时本来就要写的摘要变成信用载体:摘要末尾必须引用关键轮次编号,引用即信用。不理解压缩机制就看不懂方法的第一个组件。
研究动机
用可验证奖励做强化学习(RLVR)已成为训练 LLM 智能体的主流范式,但其奖励天然稀疏:以 BrowseComp-Plus 多跳问答为例,智能体要在数十轮 search/open_page 工具调用后只拿到一个 0/1 的最终结果奖励。在标准 GRPO 中,这个唯一的轨迹级优势 $\hat{A}^j$ 被均匀广播到整条轨迹的每一个 token,所有轮次共享同一学习信号,无法区分哪一步检索真正找到了关键证据。轨迹越长问题越严重——本文设定单条轨迹最多允许 100 轮交互,一个稀疏奖励要监督上百个决策。已有补救方案要么依赖额外监督(外部裁判、学习式 critic、过程奖励模型、事后信息),收集和训练成本高昂;要么在长程任务中因上下文持续增长而失效(如 ECHO 在 8B 模型上平均轮次膨胀到 62.6 轮),难以端到端落地。
本文的目标是本文的目标是设计一种端到端的长程智能体 RL 方法:在不引入任何额外模型、外部裁判、事后信息或额外 rollout 的情况下,仅凭每条轨迹一个稀疏的 0/1 结果奖励,就为上百轮交互生成轮次级的密集学习信号,并同时在 BrowseComp-Plus 多跳检索问答、GAIA 与 xBench-DeepSearch 深度研究任务上稳定超越 GRPO、GiGPO、SUPO、ECHO 等强基线。作者还希望一并解决长程任务的另一个痛点——交互历史超出上下文窗口,即让信用分配机制与上下文管理(compaction)合二为一,而非两个独立模块,且训练动态稳定、不诱发轮次无限膨胀。
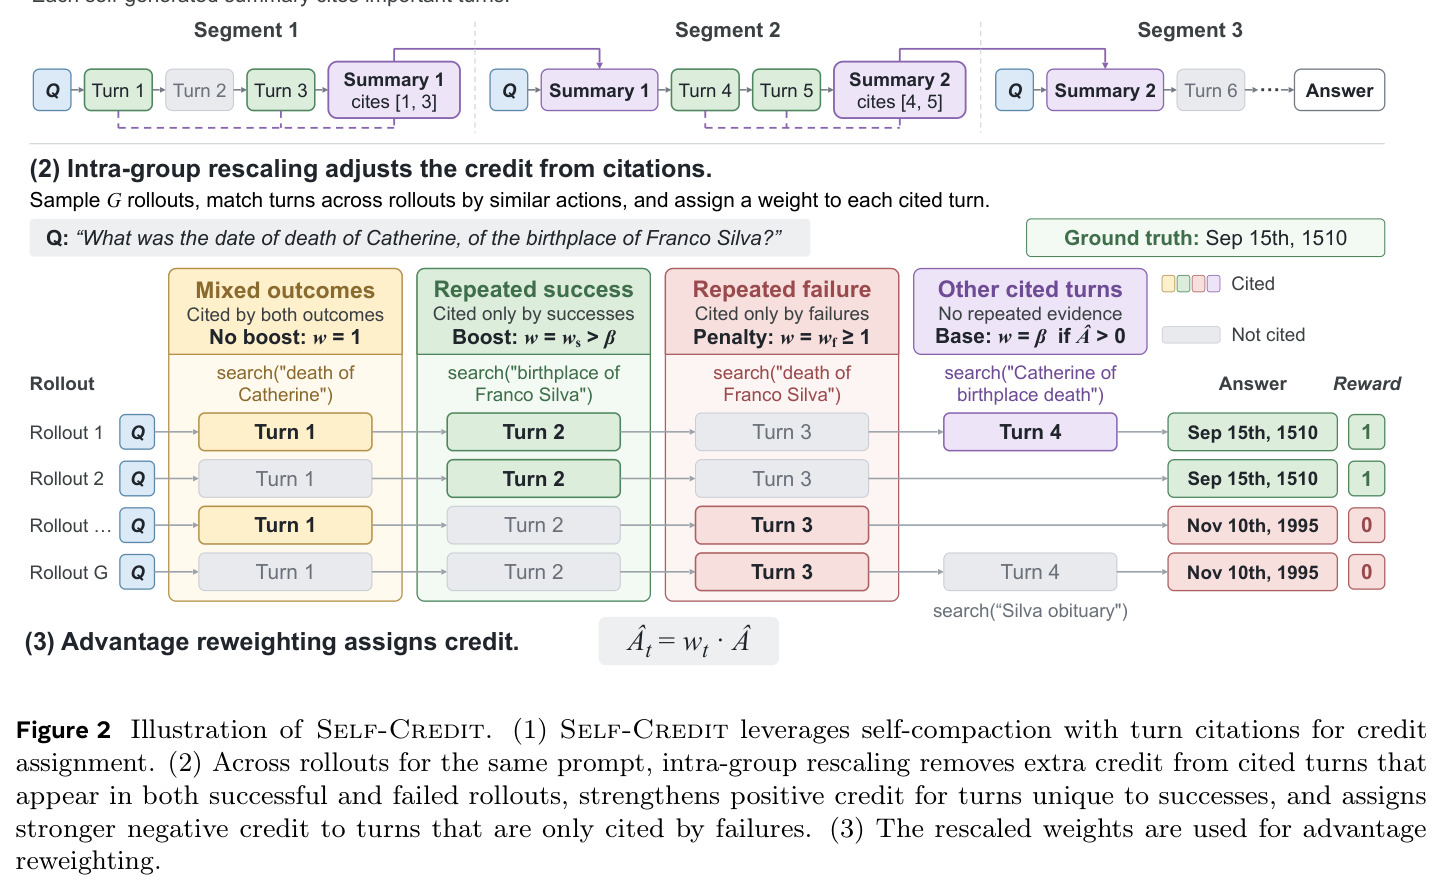
与已有工作不同的是,独特切入点是"把必要的工程组件变成学习信号"。长程智能体训练中本来就需要上下文压缩:上下文达到阈值 $C$ 就要把历史替换成摘要。作者让策略模型自己在摘要末尾引用"对解题起决定作用的轮次编号"(the critical turns are: 1, 3),这个引用集合就成了免费的自生成信用。又因为训练用组级基线的 GRPO(同一 query 采 16 条轨迹),组内成功/失败轨迹天然构成对照实验:某轮次只在成功轨迹中被反复引用→关键成功动作;只在失败轨迹中被反复引用→有害动作;成败轨迹都引用→效果存疑。这相当于用组级统计来校准模型自我汇报的信用,防止其作弊(如引用全部轮次骗加权),全程零额外监督、零额外推理开销。
核心方法
直觉上:让模型边做事边记笔记,笔记里标注哪些检索/翻页找到了决定性证据;再拿同一题目的其他轨迹来"对答案"——别的成功轨迹也引用了这一步吗?失败的轨迹也引用了吗?据此放大或抹平这一步的优势。技术上,Self-Credit 建立在组级 RL(GRPO)与压缩增强 RL(SUPO 式分段目标)之上,含三个组件:(1) 自压缩带引用:上下文达到 $C=16384$ token 时触发压缩,策略模型自己当摘要器($M_\phi=M_\theta$),生成摘要并引用关键轮次得到引用集 $K\subseteq\{t',\dots,t-1\}$;(2) 组内重缩放:按被引用轮次在组内成功/失败轨迹中的出现模式,给每个被引用轮次赋权 $w_t^j$(三种规则:重复成功、重复失败、混合结果);(3) 优势重加权:token 级优势 $\hat{A}^{j,t,\ell}=\hat{A}^j\cdot w_t^j$ 替代均匀广播。此外对重复失败的惩罚权重 $w_f$ 做线性退火。训练用 VeRL+Megatron 全异步 rollout,在 8×8 张 NVIDIA B200 上进行。
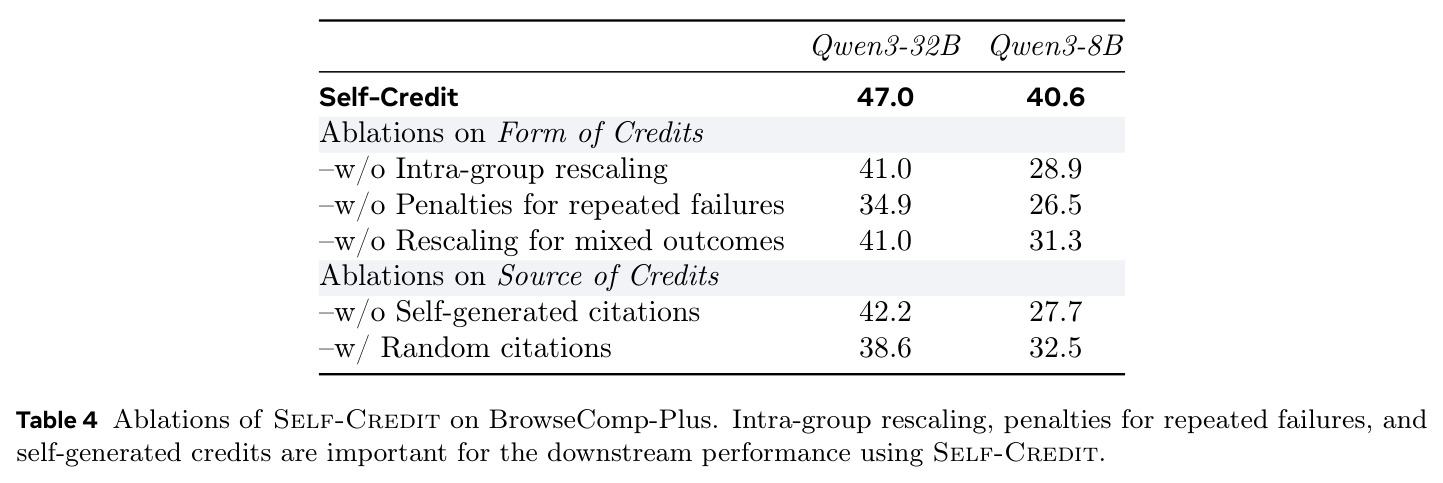
核心创新是把"自我摘要引用"升级为经过组级统计校准的信用,并用乘性权重调制优势,而非加性修正。与 ECHO 的本质区别:ECHO 只做轮次选择(记忆管理),信用只来自成功轨迹、以 masking 方式路由;Self-Credit 同时利用成功与失败轨迹——失败轨迹中重复引用的轮次会被施加强负优势($w_f\ge1$),消融显示去掉这项在 Qwen3-32B 上掉 12.1 个点(47.0→34.9)。与 GiGPO 的区别:GiGPO 按"动作所处的状态"做精确匹配分组、加性优势修正,在观测极少重复的开放环境中难以触发;Self-Credit 按"动作获得的观测"(检索返回的 docid 集合 Jaccard≥0.6)做软匹配,且只用乘性权重调制组级优势,语义更温和。与自生成信用的作弊路径相对抗:若模型引用了成败轨迹都引用的"混合结果"轮次,其 $\beta$ 加权会被直接取消,从而抑制"引用全部轮次"的退化行为。
方法步骤详情
一个训练步的完整流程:(1) Rollout:每步采 16 个 prompt × 每个 16 条轨迹共 256 条,异步多轮 agent 循环,Hermes 格式工具调用,工具响应截断 16K 字符,最多 100 轮;上下文达到 $C=16384$ token 触发压缩,模型写摘要并在末行输出 the critical turns: <编号>(要求只引用 2~5 个关键轮次),引用为空或越界视为格式错误、整条轨迹奖励置 0;轨迹结束后再强制生成一次最终段摘要(不替换上下文)。(2) 轮次匹配:search 轮按其返回 docid 集合的 Jaccard 相似度 ≥0.6 匹配,open_page 轮按打开的 docid 精确匹配,finish、摘要与最终答案轮不参与匹配。(3) 组内重缩放:统计被引用轮次 $B_t^j$ 被组内成功/失败轨迹引用的次数 $n^+,n^-$:重复成功($n^+\ge\tau^+=2$ 且 $n^-=0$)→$w_s=2.5$;重复失败($n^-\ge2$ 且 $n^+=0$)→$w_f$ 从 1.5 线性退火到 1.0;混合结果→$w=1$;其余被引用轮次正优势取基权 $\beta=1.5$、负优势取 1;未引用轮次 $w=1$;成功轨迹中摘要轮与最终答案轮自动视为被引用。(4) 更新:token 级优势 $\hat{A}^{j,t,\ell}=\hat{A}^j w_t^j$ 代入分段 GRPO 目标,学习率 $10^{-6}$,非对称裁剪 $\epsilon_{\mathrm{low}}=0.20$、$\epsilon_{\mathrm{high}}=0.28$,无 KL、无 critic,BrowseComp-Plus 训练 115 步。
技术新颖性
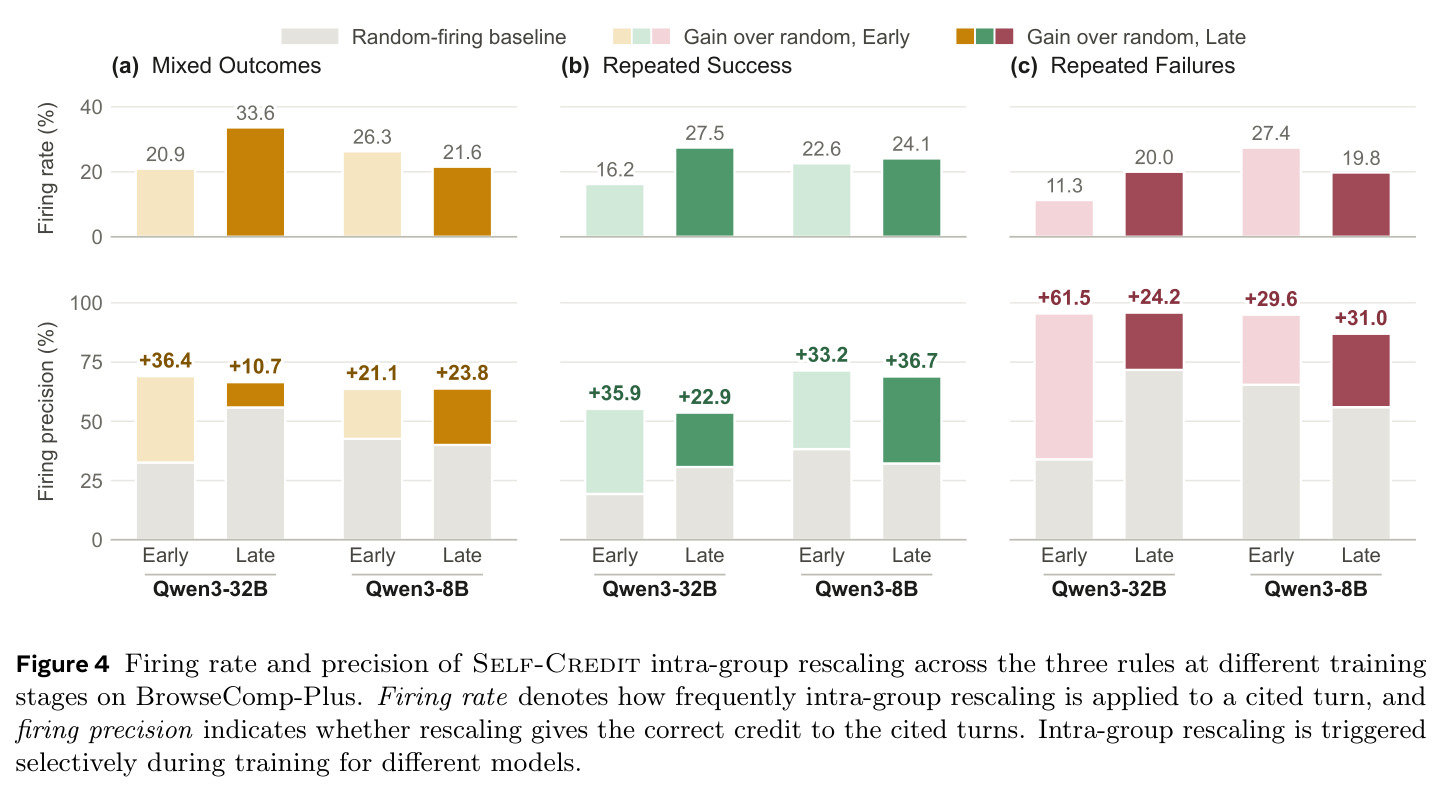
技术新颖性有三层。第一,机制统一:首次让同一个"摘要+引用"动作同时承担上下文压缩与轮次级信用分配双重职责,训练与推理行为一致,没有额外的推理开销或第二模型。第二,防作弊设计:纯自生成信用容易被利用(模型可以引用全部轮次骗取加权),本文用组内成败对照的重缩放规则——特别是对失败轨迹中重复引用轮次的强惩罚——把信用锚定在群体统计而非模型自评上,Figure 4 显示重缩放规则的触发精度显著高于随机基线。第三,任务无关配方:匹配函数只需要"按动作获得的观测匹配轮次"这一个抽象接口,作者在附录 B.2 给出了推广到具身任务(如 ALFWorld 以操作对象加成败描述轮次)的方案,方法主体无需改动即可迁移。另外,惩罚权重的退火课程(早期惩罚强以稳定搜索行为、后期惩罚弱以鼓励探索)是针对探索-利用平衡的较新设计。
实验结果
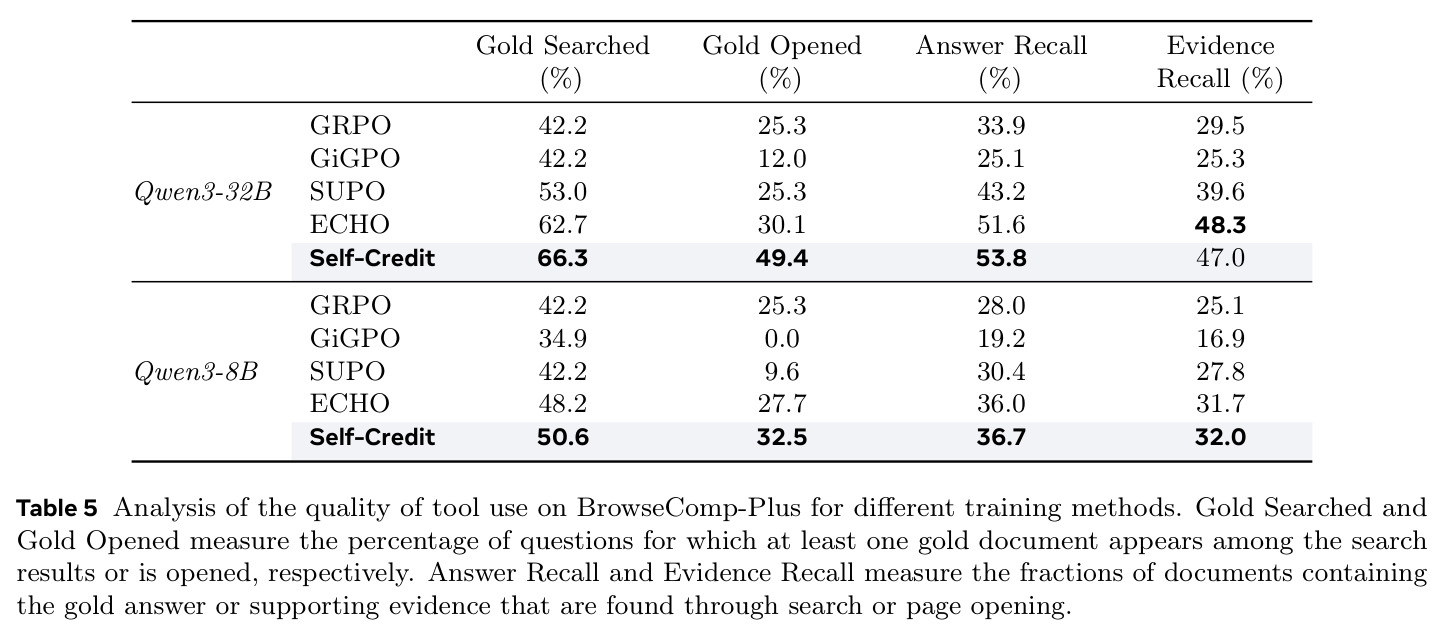
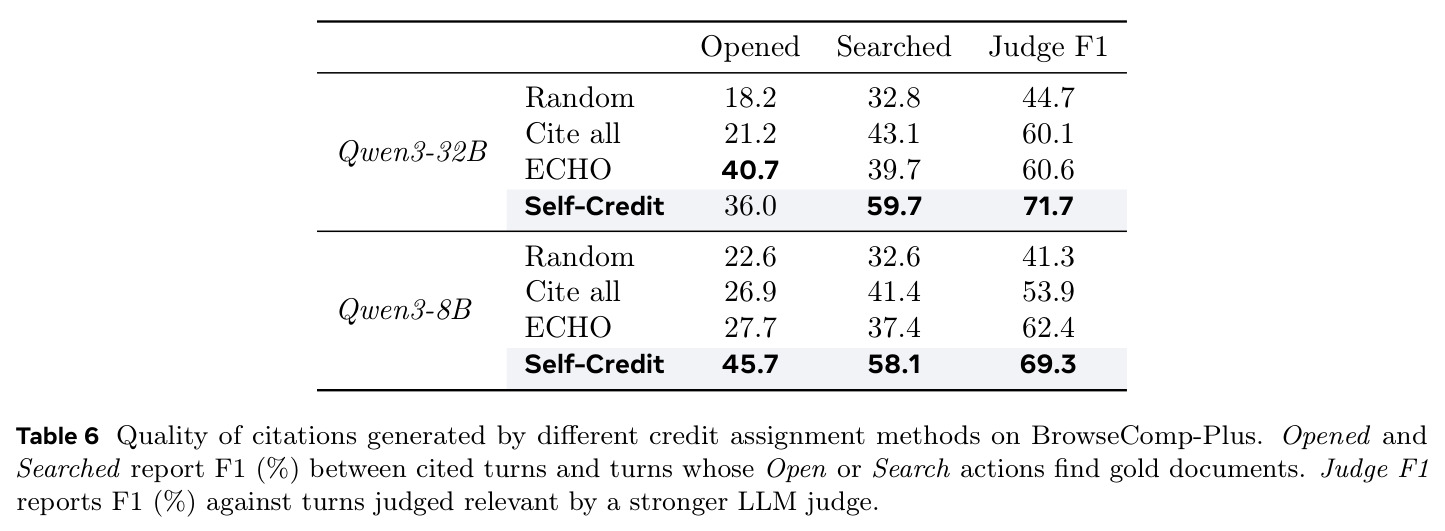
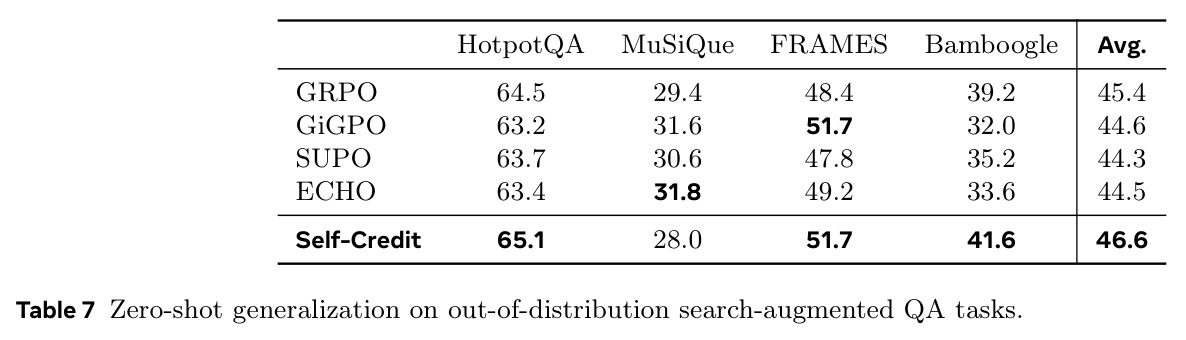
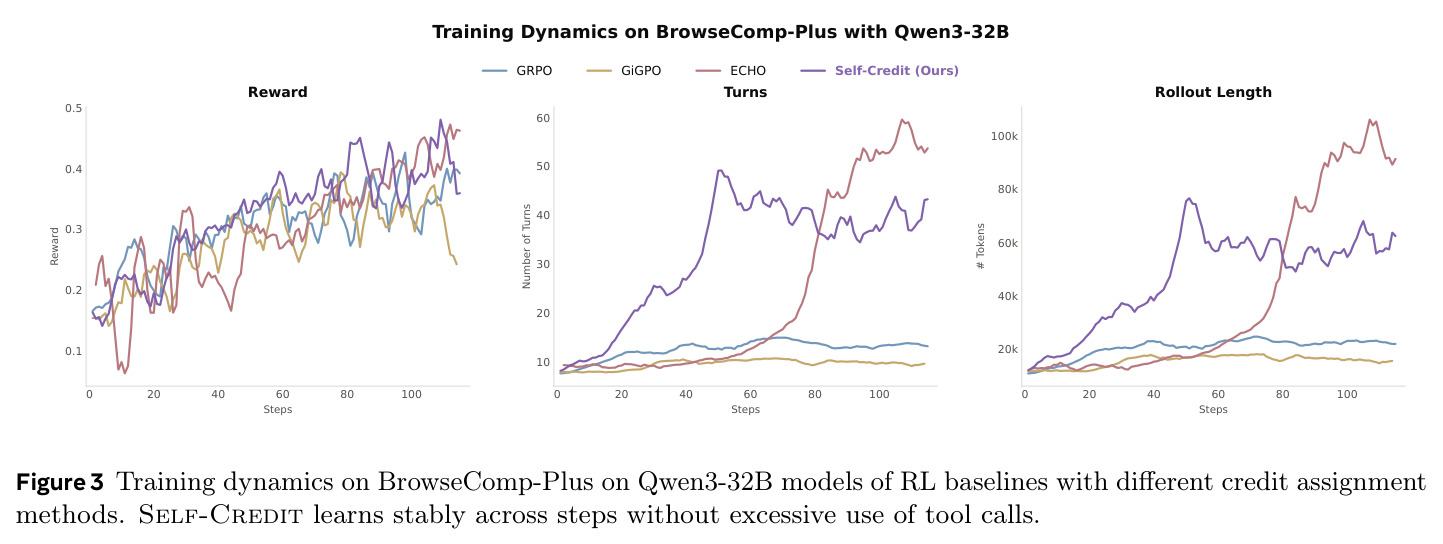
主实验全面领先(3 seeds,Pass@1)。BrowseComp-Plus:Qwen3-32B 从 zero-shot 10.8 提升到 47.0(+36.2),超过最强基线 ECHO 的 41.4 达 5.6 点,且平均轮次 39.4 低于 ECHO 的 45.8;Qwen3-8B 从 3.6 提升到 40.6(+37.0),超过 SUPO/ECHO 的 32.1 达 8.5 点。深度研究任务(Gemma4-E4B):GAIA text-only 上 39.2,超过最强基线 GRPO 的 34.3 达 4.9 点;xBench-DeepSearch 上 16.7,超过 GiGPO 的 12.0 达 4.7 点。训练动态(Figure 3)显示奖励稳步上升且不出现 ECHO 式轮次膨胀。消融(Table 4,32B/8B):去掉组内重缩放降至 41.0/28.9;去掉失败重复惩罚掉得最多,降至 34.9/26.5;去掉混合结果重缩放为 41.0/31.3;用全部轮次或随机轮次替代自生成引用降至 42.2/27.7 与 38.6/32.5。引用质量(Table 6):32B 上 Searched F1 59.7、Judge F1 71.7,高于 ECHO 的 39.7/60.6。工具使用质量(Table 5):Gold Opened 49.4 显著高于 ECHO 的 30.1。OOD 迁移(Table 7):四个短程 QA 平均 46.6,为所有方法最高。
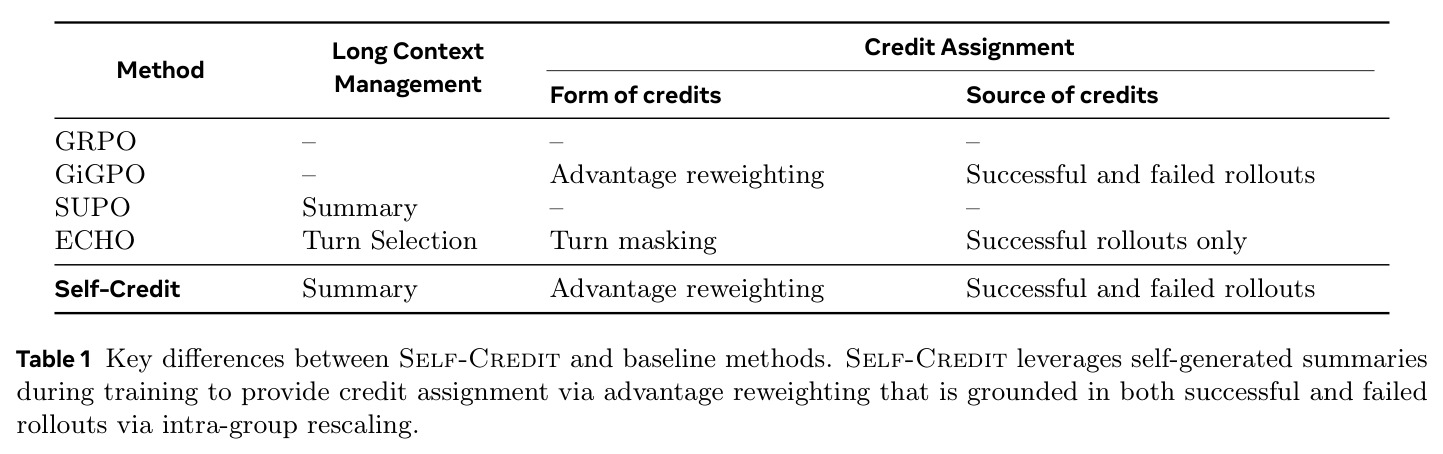
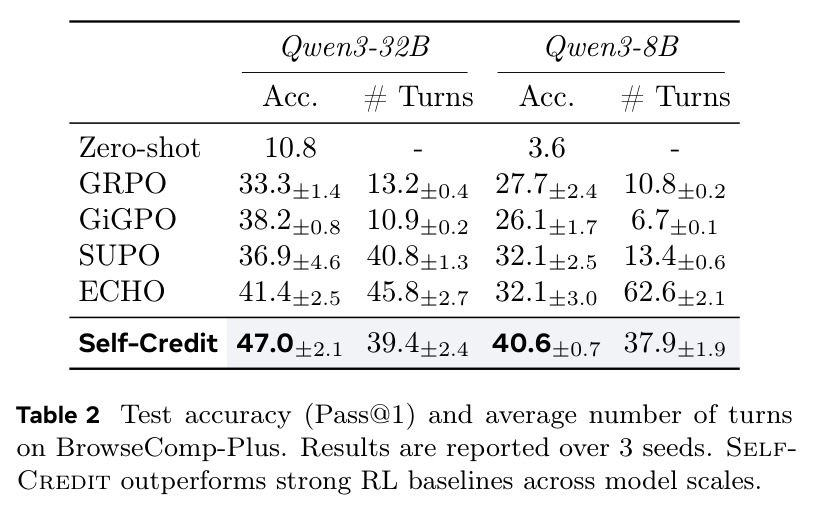
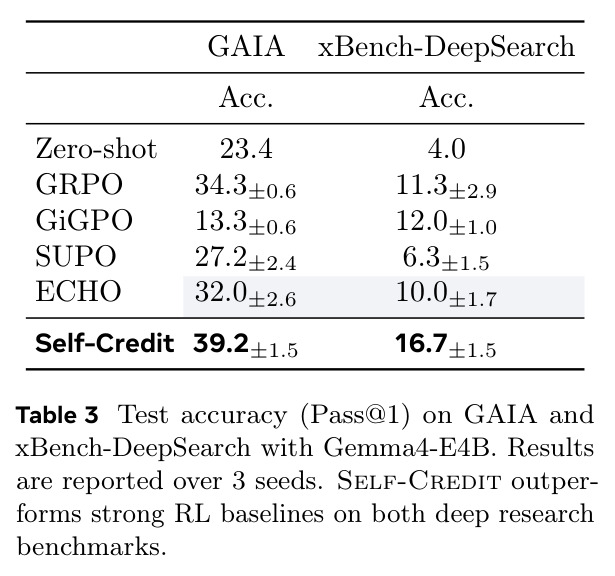
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BrowseComp-Plus(Qwen3-32B) | Pass@1 准确率 (%) | 47.0 | ECHO 41.4 | +5.6(较 zero-shot 10.8 提升 36.2) |
| BrowseComp-Plus(Qwen3-8B) | Pass@1 准确率 (%) | 40.6 | SUPO / ECHO 32.1 | +8.5(较 zero-shot 3.6 提升 37.0) |
| GAIA text-only(Gemma4-E4B) | Pass@1 准确率 (%) | 39.2 | GRPO 34.3 | +4.9 |
| xBench-DeepSearch(Gemma4-E4B) | Pass@1 准确率 (%) | 16.7 | GiGPO 12.0 | +4.7 |
| OOD 短程搜索 QA 四基准平均(Qwen3-32B 零样本迁移) | 准确率 (%) | 46.6 | GRPO 45.4 | +1.2 |
局限与改进
作者与读者都能看到几处局限。(1) 独立性假设:论文显式假设各轮次对结果的贡献相互独立,但 open 依赖此前 search 先把文档捞出来,后期轮次的成功可能全靠前期铺垫,跨轮耦合被忽略,附录 B.2 承认这是近似。(2) 匹配依赖任务特定函数:Jaccard≥0.6 的 docid 集合匹配在静态语料检索里好用,但在观测几乎不重复的开放环境(代码执行、具身控制)中命中率会下降,Figure 4 显示重缩放的触发率(firing rate)本身有限。(3) 奖励仍是二值结果奖励,答案由 LLM-as-judge(Qwen3-32B)判定,引用质量分析又依赖 Claude Sonnet 4.6 打标,评判噪声会传导到训练信号与评估结论。(4) 超参较多:$\tau^\pm=2$、$\beta=1.5$、$w_s=2.5$、$w_f$ 退火曲线、$C=16384$ 均为经验设定,论文未做敏感性分析。(5) 训练规模为 8×8 NVIDIA B200(64 卡),32B 级别实验学术界难以复现。
独立分析的弱点
独立审视后我认为还有几个弱点。其一,软匹配阈值 0.6 较脆弱:两次措辞不同但检索文档高度重叠的 search 会被合并,只差几条结果的"近似但语义不同"的检索也会被并成一类,噪声直接进入 $n^+,n^-$ 计数进而扭曲 $w_t^j$;改进方向是用检索器 embedding 相似度或学习式匹配头替代硬阈值。其二,组内重缩放可能被"群体性错觉"误导:若整组 16 条轨迹都走错方向并互相引用相同的无用轮次,重复失败惩罚反而会惩罚真正必要但组内无人走通的探索步;可引入跨 batch 或历史 EMA 统计做平滑。其三,信用粒度停在轮次级:一轮里既含无效搜索又含关键翻页时无法细分,可下沉到动作/片段级。其四,当整组轨迹全对或全错($\hat{A}^j$ 同值)时组内无信号,Self-Credit 无能为力,需与过程奖励模型或课程采样结合。其五,格式门控把无效引用整条轨迹奖励置 0,可能浪费昂贵的长 rollout 样本。
未来方向
可延伸方向很多。作者在附录 B.2 已给出把匹配配方推广到具身任务(ALFWorld:以操作对象加成败描述轮次)的路径,下一步可实测代码智能体与具身控制;匹配函数可学习化(embedding 相似度、对比训练)以摆脱硬阈值;把组内重缩放与学习式 critic 或过程奖励模型结合,解决全组同成败时的信号盲区;权重退火可改为随训练状态自适应的调度(如按 Figure 4 中的触发精度动态调整 $w_f$);信用粒度可从轮次细化到 token 或子动作,并与 ECHO 式记忆选择互补融合;自生成引用在推理时也可复用——部署时用引用做轨迹回溯、失败诊断或训练数据筛选;此外方法只在检索/浏览类任务上验证,推广到 SWE-bench 类软件工程任务与多智能体协作场景值得探索。
复现评估
复现条件中等偏上。数据全部公开:BrowseComp-Plus(MIT,HF: Tevatron/browsecomp-plus,747 训练/83 测试,附静态语料与索引),GAIA(CC BY 4.0,text-only 子集),xBench-DeepSearch(MIT),训练数据用 OpenResearcher 的 1K 深度研究 QA 对及其静态浏览器。实现基于开源框架 VeRL + Megatron(全异步 rollout),超参在附录 C 给得非常完整:$\tau^\pm=2$、$\beta=1.5$、$w_s=2.5$、$w_f$ 1.5→1.0 线性退火、$C=16384$、学习率 $10^{-6}$、非对称裁剪 0.20/0.28、每步 16 prompt×16 rollout,摘要 prompt 与格式门控在 B.1 全文给出。主要门槛是算力:论文用 8×8 NVIDIA B200(64 卡)训练 115 步,32B 模型复现成本极高,Qwen3-8B 在较小集群上可行。正文未附代码开源链接,轮次匹配与重缩放逻辑需自行实现,估计复现主结果需 1~2 周工程量。
论文图表
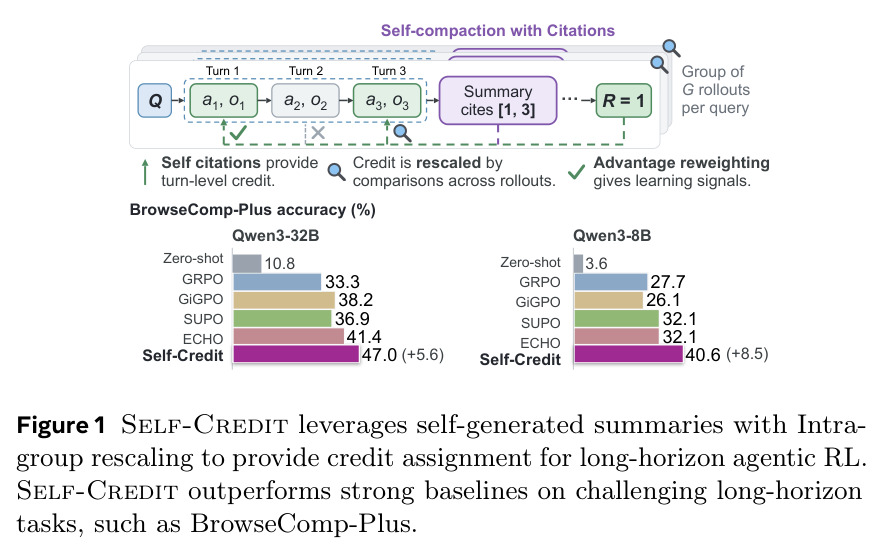
总览图:上半部分展示智能体在多轮交互中做带引用的自压缩(摘要引用 Turn 1、3),下半部分展示三个组件的流水线——自引用提供轮次信用、跨 rollout 比较进行重缩放、优势重加权产生学习信号;右侧柱状图给出 BrowseComp-Plus 主结果(Qwen3-8B 40.6、Qwen3-32B 47.0)。
一图看懂全文:三个组件如何串成一条从稀疏奖励到密集信号的流水线,以及最主要的性能数字,适合作为读者进入论文的第一站。
Qwen3-8B Self-Credit 模型在 BrowseComp-Plus 测试题(查找病毒热单 Mando)上的完整 rollout 示例第一部分:包括思考、search/open_page 调用、达到上下文阈值后的摘要及其引用行(the critical turns are: 1, 2, 3),并附引用与真实金标文档轮次的对照检查。
把抽象机制落到具体文本:读者可以看到摘要长什么样、引用行格式如何、引用是否真的命中了金标证据轮次,是理解自生成信用质量的最直观材料。
示例续篇:第一段第 3~5 轮的 open_page 调用,检索候选说唱歌手的出生日期、星座等证据文档。
与 Figure 5 连成完整轨迹,展示证据积累阶段的行为细节。
示例续篇:第一段的完整摘要(含对 Mozzy 父亲服刑信息不确定性的分析)与引用行,以及第二段从"系统提示+query+摘要"重新开始的上下文和新一轮 search。
展示压缩后上下文如何重组、摘要在多大程度保留了关键事实与待办事项,以及跨段行为如何衔接。
示例续篇:第二段中对 Mozzy 维基页的 open_page、对 Mando 歌曲的验证搜索,以及带置信度与解释的 finish 提交,答案正确(Mando)。
展示模型如何基于压缩后的摘要完成验证并提交最终答案,体现压缩不损失决策质量。
示例收尾:最终段强制生成的辅助摘要(引用 the critical turns are: 1, 2)与引用检查(引用命中金标轮次 1、2,另有一轮 3 也含金标),最终答案被 judge 判定为正确。
展示最终段摘要的辅助引用机制(不替换上下文),并再次印证引用与金标证据轮次的高度吻合。