面向长程 LLM 智能体的多尺度策略优化 Multiscale Policy Optimization for Long-Horizon LLM Agents
以轮次为宏观动作,同时做轮次级信用传播与 token 级优势细分的智能体 RL 方法
前置知识
GRPO(组相对策略优化)
一种无 critic 的 RL 后训练方法:对同一 prompt 采样一组(如 8-16 条)回答,用组内奖励的均值和方差做归一化,得到每条序列一个共享优势值,所有 token 共用这个分数进行策略梯度更新。优点是省去价值网络、实现简单,缺点是序列内所有 token 拿到完全相同的信用,无法区分哪些轮次或 token 真正贡献了成功。
GRPO 是本文最主要的对照基线,理解它「一条序列一个共享优势」的粒度缺陷,才能理解 MPO 为什么要按轮次和 token 两个尺度重新分配信用。
GAE(广义优势估计)
PPO 系方法中用学习到的价值函数 $V$ 估计优势的标准技术:先算每步 TD 残差 $\delta_t = r_t + V_{t+1} - V_t$,再用衰减系数 $\lambda$ 对未来残差做指数加权求和 $A_t = \sum_l (\lambda\gamma)^l \delta_{t+l}$,在偏差(依赖 critic 准确度)和方差(依赖真实回报长度)之间折中。$\lambda$ 越大,信用传播得越远但方差越大。
MPO 的 MAE 是把 GAE 分别应用到「轮次」和「token」两个时间轴上,不懂 GAE 就读不懂第 5.1、5.2 节的核心公式。
PPO 裁剪代理目标与重要性采样
PPO 用新旧策略的概率比 $\rho_t(\theta) = \pi_\theta(a_t|s_t)/\pi(a_t|s_t)$ 修正 off-policy 偏差,并通过 $\min(\rho A, \mathrm{clip}(\rho, 1-\epsilon, 1+\epsilon)A)$ 把每次更新的策略变化限制在小范围内,相当于对 TRPO 信任区域的一阶近似。比率的作用是校正「新策略偏离采集策略」带来的分布偏移。
MPO 的更新公式直接沿用裁剪代理结构,创新点在于把比率从 token 级换成整轮乘积比率 $\rho_t = \prod_i \rho_{t,i}$,并用 stop-gradient 保留 token 级梯度。
TRPO 策略改进界
TRPO 的核心理论:新旧策略回报差 $J(\pi') - J(\pi)$ 有下界 $\mathbb{E}[A_\pi] - C \cdot D_{TV}^2$,只要代理增益足以覆盖由策略分布偏移(TV 距离平方)造成的误差项,就能保证回报不下降。这类「代理目标 + 分布偏移惩罚项」的分析框架是推导改进界的标准工具。
本文的定理 1、2 完全套用这个框架,用来论证「轮次级代理比 token 级代理少付一份轮内分布偏移惩罚」,是方法设计动机的数学来源。
解释方差
评估价值函数拟合质量的指标:$1 - \mathrm{Var}(R - V)/\mathrm{Var}(R)$,越接近 1 说明 critic 对回报的预测越准。训练日志中常用它判断 critic 是否学到了有效信号,还是只输出了接近常数的值。
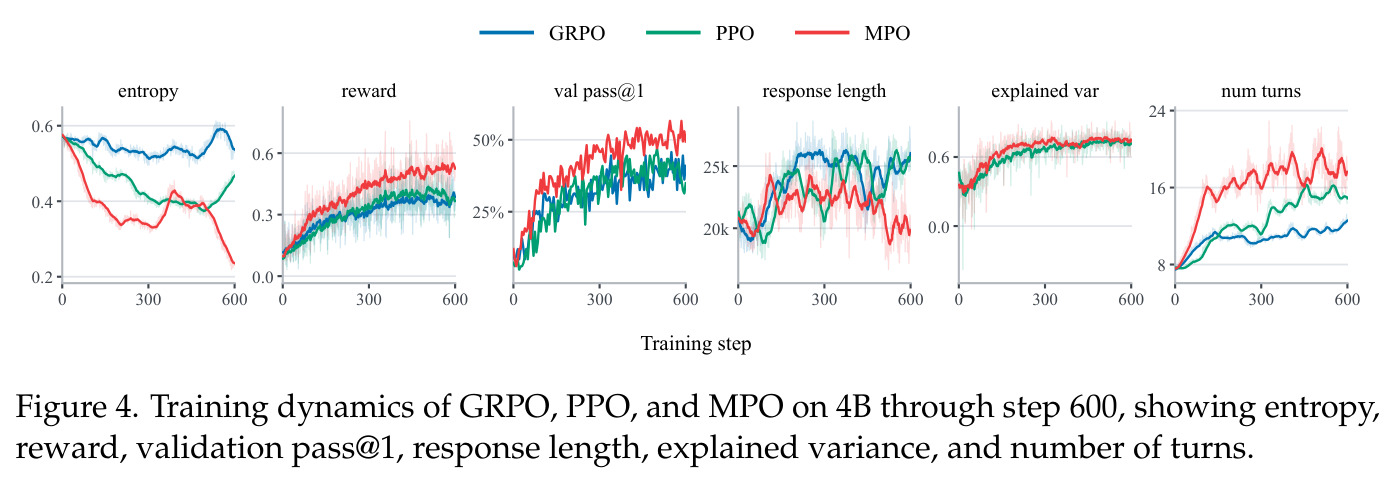
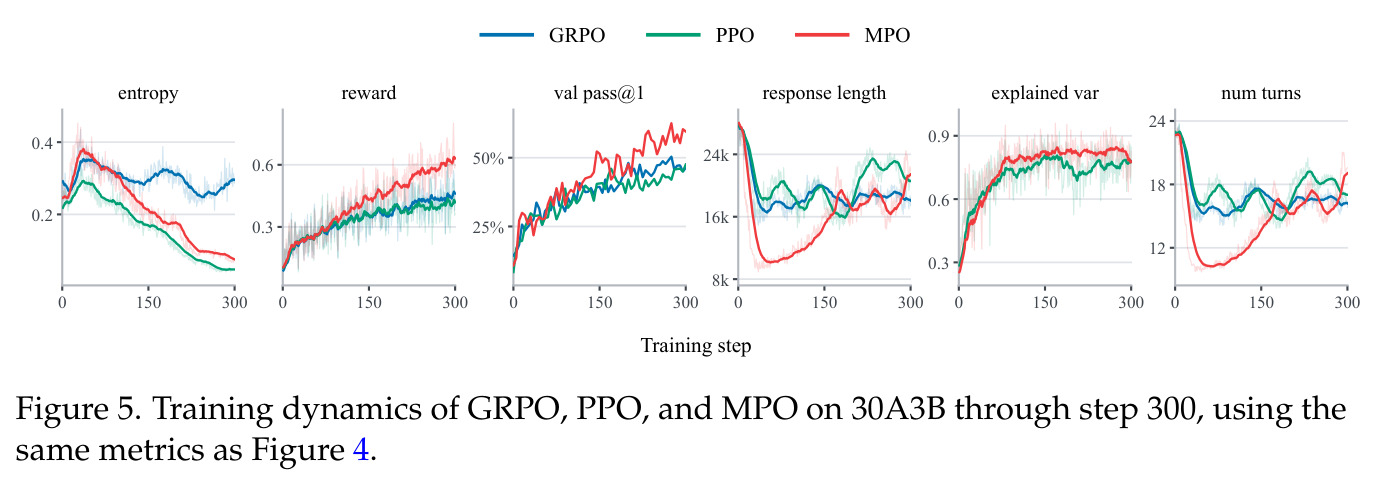
论文用解释方差对比 PPO 与 MPO 的 critic 拟合质量,发现 MPO 训练后期解释方差更高,并以此讨论轮次对齐的更新如何反过来帮助 critic 学习。
研究动机
长程 LLM 智能体(搜索、工具调用、自动化操作)以「完整的助手轮次」与环境交互——发出一次搜索、一次工具调用或最终回答——而策略本身又是逐 token 自回归生成的。任务奖励只在轨迹末尾给出一次,极端稀疏,于是强化学习面临两个尺度的信用分配难题。现有两类方法都存在尺度错配:GRPO、DAPO、GSPO 等无 critic 的组相对方法给每条序列只算一个共享优势,轮次之间、token 之间完全无差别;PPO、VC-PPO、VAPO、SAO 等 critic 系方法把每个 token 当作动作,在 token 序列上做 GAE,却从不显式区分「轮内的生成过程」和「轮间的环境交互」。作者用真实数据量化了这一错配:在一个搜索智能体运行的 8 个 checkpoint 批次、共 2,048 条轨迹、16,323 个轮次上,轮均值之差解释了 critic 加权的轨迹内价值方差的中位数 89.5%,且 93.8% 的轨迹中轮间方差大于轮内方差——价值结构天然长在轮次尺度上,而主流算法却在错误(或过粗)的尺度上分配信用。
本文的目标是本文的目标是为长程智能体 RL 建立一个同时在轮次和 token 两个尺度上工作的策略优化方法。具体拆成三件事:其一,从理论上回答「应该锚定在哪个尺度做优化」——推导轮次级策略改进界,并证明在同样的 KL 约束下,token 级代理目标会额外引入一份轮内分布偏移惩罚项;其二,设计一个能用单个 critic 实现、可稳定训练的多尺度优势估计器 MAE,让跨轮次的长期信用传播和轮内 token 的细分排序同时成立;其三,让策略更新的重要性校正与轮次级交互目标对齐(用整轮概率比率),同时不丢掉每个 token 自身的优势梯度,并在搜索、工具使用、自动化三类任务和 4B、30B-A3B 两个模型规模上验证相对于 GRPO、GSPO、PPO、VAPO、SAO 等强基线的一致增益。
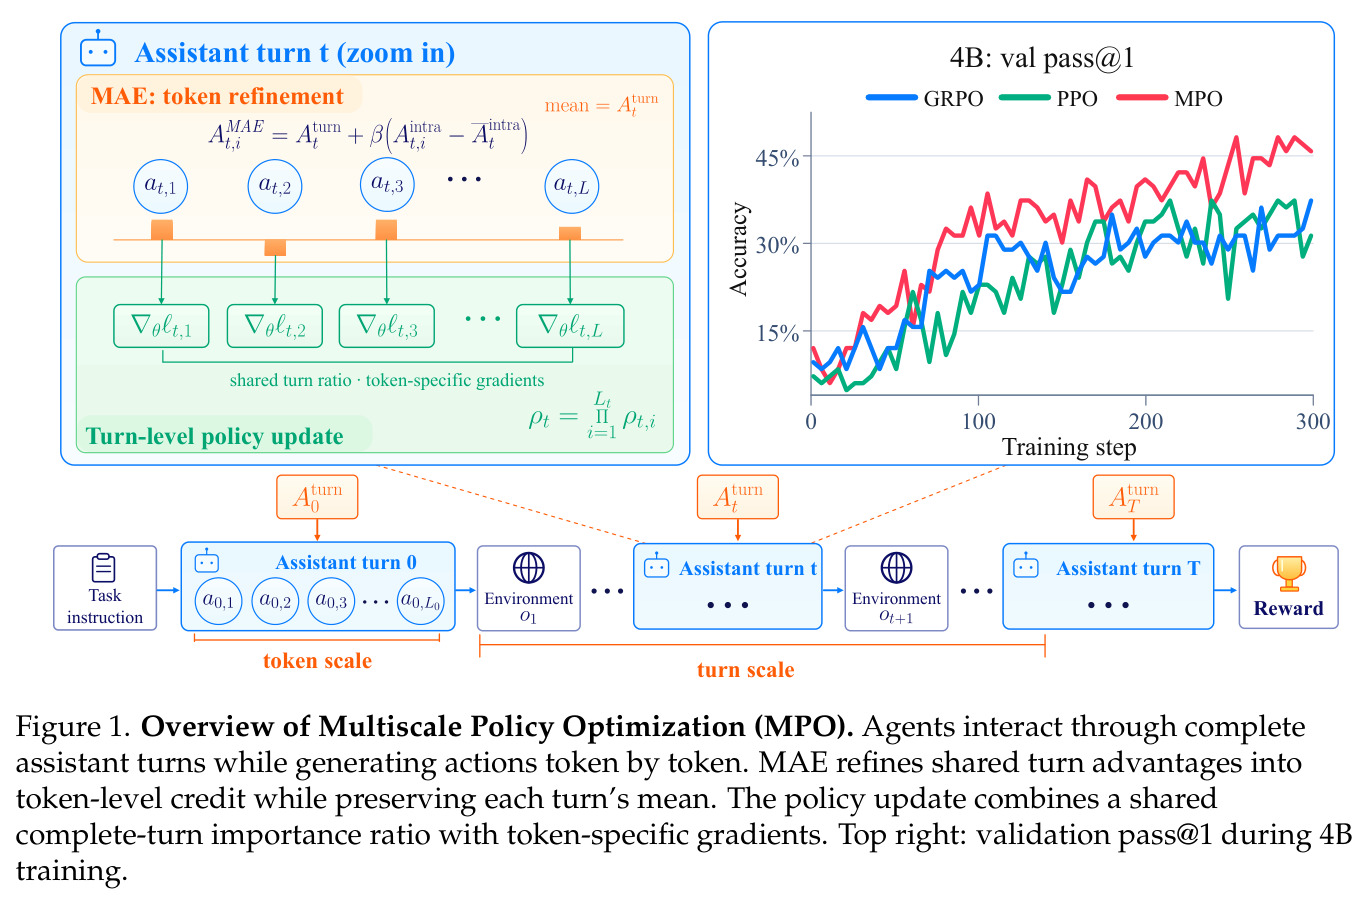
与已有工作不同的是,本文独特的切入点是把「轮次」当作显式的宏观动作,从而把一个 LLM 智能体同时视为马尔可夫决策过程(轮次时间轴)和自回归生成过程(token 时间轴),并证明两者共享同一个任务目标、可以在同一套策略参数下比较不同尺度的代理目标。以往工作要么整体压缩到序列级(GRPO 系),要么整体下钻到 token 级(PPO 系),没有人定量分析过两种代理目标的差距来自哪里。本文的关键观察是 Figure 2 揭示的经验结构:critic 的价值在轮内平稳、在轮边界跳变(失败轨迹 $\\Delta V=-0.27$,成功轨迹 $\\Delta V=+0.55$),据此提出「锚定轮次、细分 token」的分解——用轮级 GAE 传播跨轮信用,再用保均值的局部投影在轮内重新分配,最后用 stop-gradient 技巧让整轮比率控制前向加权、token 自身优势控制梯度方向,这套「两尺度、各自调参」的设计($\\lambda$ 按轮次计数、$\\lambda_{intra}$ 按 token 计数)在文献中是新的。
核心方法
直觉先行:智能体一次任务经历几十个轮次、上万 token,但 critic 的价值信号只在轮边界大跳变(Figure 2 中 $\\Delta V=-0.27$/$+0.55$)、轮内近乎平坦——「值多少钱」主要在轮次尺度流动,「哪个 token 写得好」只在轮内有意义。MPO 据此拆成两个尺度:信用传播走轮次尺度,token 细分走轮内尺度。技术上分三步。第一步,多尺度优势估计(MAE):用 critic 的逐 token 预测 $V_{t,i}$ 算 TD 残差 $\\delta_{t,i}=r_{t,i}+V_{t,i+1}-V_{t,i}$(轮边界约定 $V_{t,L_t+1}:=V_{t+1,1}$,终止后置零),轮内求和得轮级残差 $\\delta^{turn}_t=\\mathbb{1}_{t=T}R(\\tau)+V_{t+1,1}-V_{t,1}$,沿轮时间轴做 GAE 得共享优势 $A^{turn}_t$;再在轮内截断轨迹上用 $\\lambda_{intra}$ 算局部优势 $A^{intra}_{t,i}$。第二步,保均值投影:解最小二乘约束问题,闭式解 $A^{MAE}_{t,i}=A^{turn}_t+\\beta(A^{intra}_{t,i}-\\bar{A}^{intra}_t)$,轮均值被严格固定为轮级估计。第三步,轮级重要性校正:前向用整轮乘积比率 $\\rho_t=\\prod_i\\rho_{t,i}$ 加权与裁剪,但每个 token 经 stop-gradient 只让自身比率携带梯度,套 PPO 式裁剪代理损失更新;critic 按 $\\lambda_{critic}=1$ 直接回归终止回报。
核心创新有两个,都来自「两尺度必须解耦」这一理论结论。第一个是保均值的轮内投影。直接把局部 trace $A^{intra}$ 加到轮优势上会把均值偏移 $\\beta\\bar{A}^{intra}_t$,破坏轮级信用;MAE 把分配写成带等式约束的凸投影——每个轮次所有 token 的平均信用被严格固定为 $A^{turn}_t$(式 21),而 $\\beta$ 只控制 token 之间的相对差异幅度。这与 GRPO(整条序列一个值)和 PPO(token 级 GAE、不区分轮边界)的本质区别在于:轮均值承载任务级长期信用,轮内中心化承载局部排序信息,两者互不污染。第二个是带 stop-gradient 的轮级重要性比率 $\\tilde{\\rho}_{t,i}(\\theta) = \\rho_{t,i}(\\theta)\\,\\mathrm{sg}\\big[\\prod_{j\\neq i}\\rho_{t,j}(\\theta)\\big]$:前向传播中每个 token 拿到的是完整的整轮比率(等于 $\\rho_t$,校正整轮分布偏移、参与裁剪),但梯度只通过自己的 $\\log\\pi_\\theta(a_{t,i}|h_{t,i})$ 流动(式 24)。作者指出如果直接用可微的整轮比率乘所有优势,中心化修正会在未裁剪求和中被抵消(连乘比率对 $\\theta$ 的梯度相互耦合),这个 stop-gradient 构造让「轮级加权 + token 级梯度」同时成立——这是定理 2 结论(token 级代理多付 $2(T+1)A^{tok}_{max}L_{max}(L_{max}-1)\\alpha_T^2$ 的轮内分布偏移惩罚)在算法上的直接对应物。
方法步骤详情
流程八步。步骤 1,交互采样:生成轨迹 $\\tau=(o_0,a_0,\\ldots,o_T,a_T)$,$a_t$ 是完整助手轮次(工具调用/搜索/最终回答),仅最后 token 拿到奖励 $r_{T,L_T}=R(\\tau)$;critic 输出每个位置的 $V_{t,i}$。步骤 2,边界映射:$V_{t,L_t+1}:=V_{t+1,1}$($0\\le t\\le T$),真实终止后 $V_{T+1,1}:=0$。步骤 3,逐 token 算 $\\delta_{t,i}=r_{t,i}+V_{t,i+1}-V_{t,i}$。步骤 4,轮内求和得 $\\delta^{turn}_t$,递推 $A^{turn}_t=\\delta^{turn}_t+\\lambda A^{turn}_{t+1}$(每轮衰减一次,实验最优 $\\lambda=0.80$)。步骤 5,轮内局部 trace $A^{intra}_{t,i}=\\sum_{j=i}^{L_t}\\lambda_{intra}^{j-i}\\delta_{t,j}$(每 token 衰减一次,最优 0.95)。步骤 6,投影 $A^{MAE}_{t,i}=A^{turn}_t+\\beta(A^{intra}_{t,i}-\\bar{A}^{intra}_t)$(最优 $\\beta=1.0$),批归一化后冻结。步骤 7,更新:算 $\\rho_{t,i}(\\theta)$ 与 $\\rho_t(\\theta)$,按式 (23) 组装 stop-gradient 比率 $\\tilde{\\rho}_{t,i}$,最小化裁剪代理损失 (25)。步骤 8,critic 训练:$\\lambda_{critic}=1$ 回归 $R(\\tau)$。Search/Claw-Eval 训练 300 步、Automation Bench 200 步,每个模型每个任务一次独立运行。
技术新颖性
技术新颖性体现在四个层面。理论层面:首次在「轮次=宏观动作」的表述下推导轮级单调改进界(定理 1,$J(\\pi')-J(\\pi) \\ge S_M - 2A_{max}T(T+1)\\alpha_M^2$),并证明在相同 KL 预算下 token 代理目标存在额外的轮内分布偏移项(定理 2),把「为什么该在轮尺度做重要性校正」从工程直觉升级为有证明支撑的设计原则;KL 链式法则还给出统一预算的换算($D_{max}^{KL} \\le L_{max}\\delta$,token 界多付 $(T+1)(L_{max}-1)\\Delta$)。估计器层面:MAE 把多尺度信用分配写成单 critic 的最小二乘约束投影,闭式解无需迭代、严格保均值,且轮级 GAE 对轮长度和轮内 critic 预测不敏感(内部残差求和时相互抵消),这是一个可即插即用的估计器。更新规则层面:stop-gradient 组装的整轮比率 $\\tilde{\\rho}$ 是精巧的工程创新,解决了「可微整轮比率会抵消中心化修正」的具体矛盾。超参语义层面:$\\lambda$ 与 $\\lambda_{intra}$ 度量不同事件(每交互衰减一次 vs 每 token 衰减一次),$\\lambda=0.80$ 对应约 5 轮 trace、$\\lambda_{intra}=0.95$ 对应约 20 token,显式承认交互尺度和生成尺度需要不同的信用射程——消融也证实统一对待两者会掉分。
实验结果
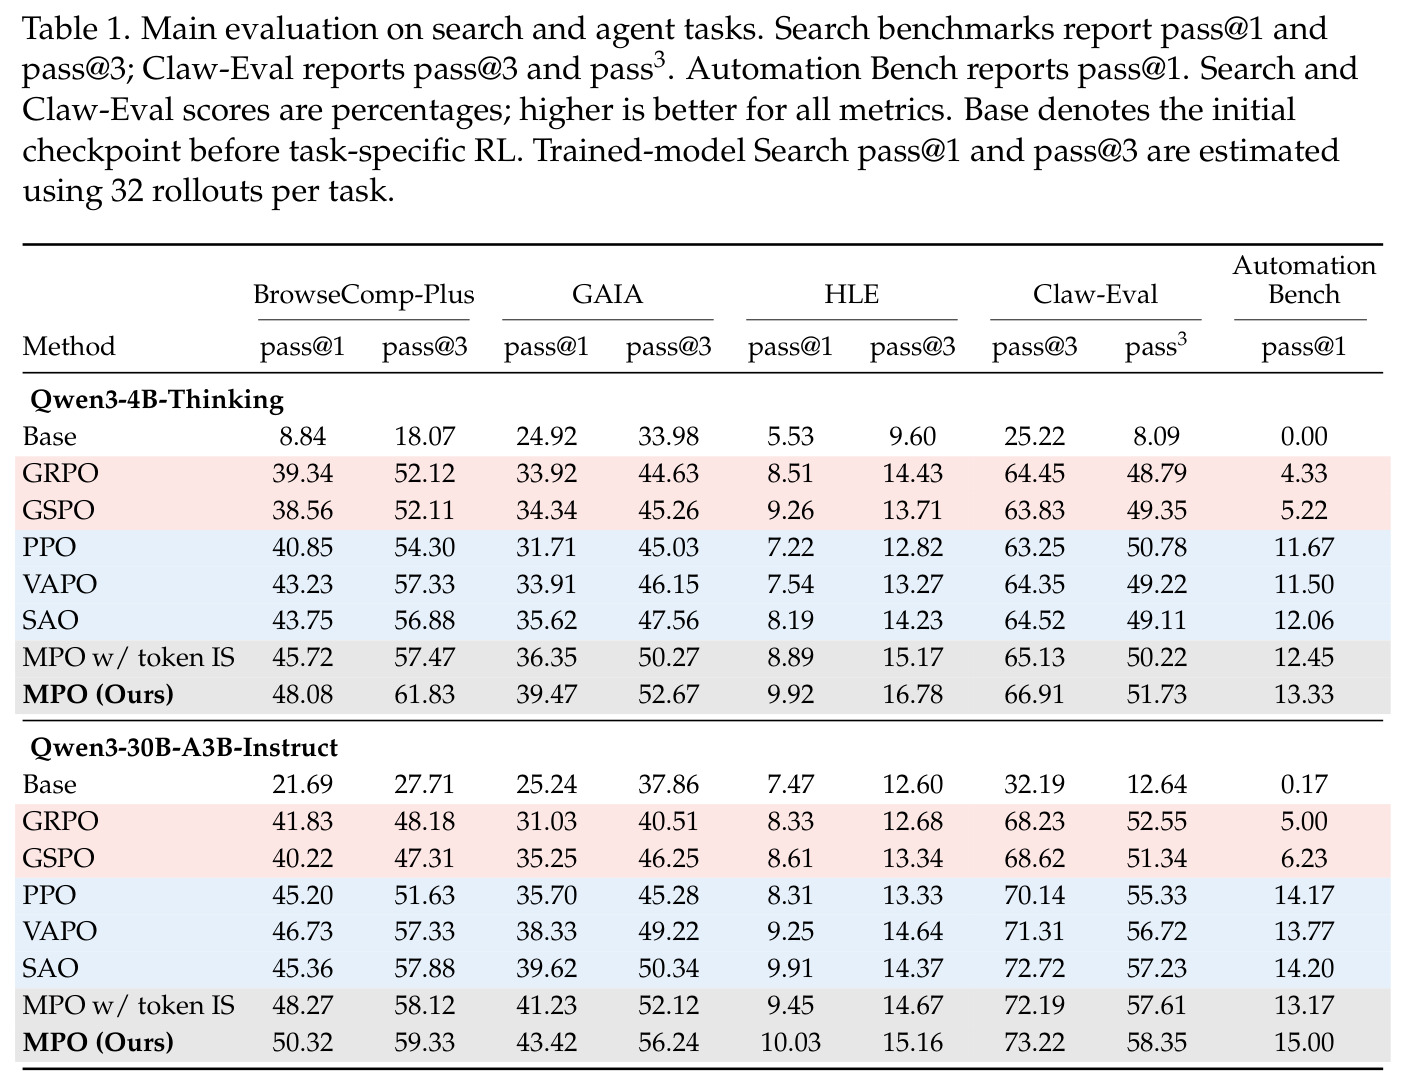
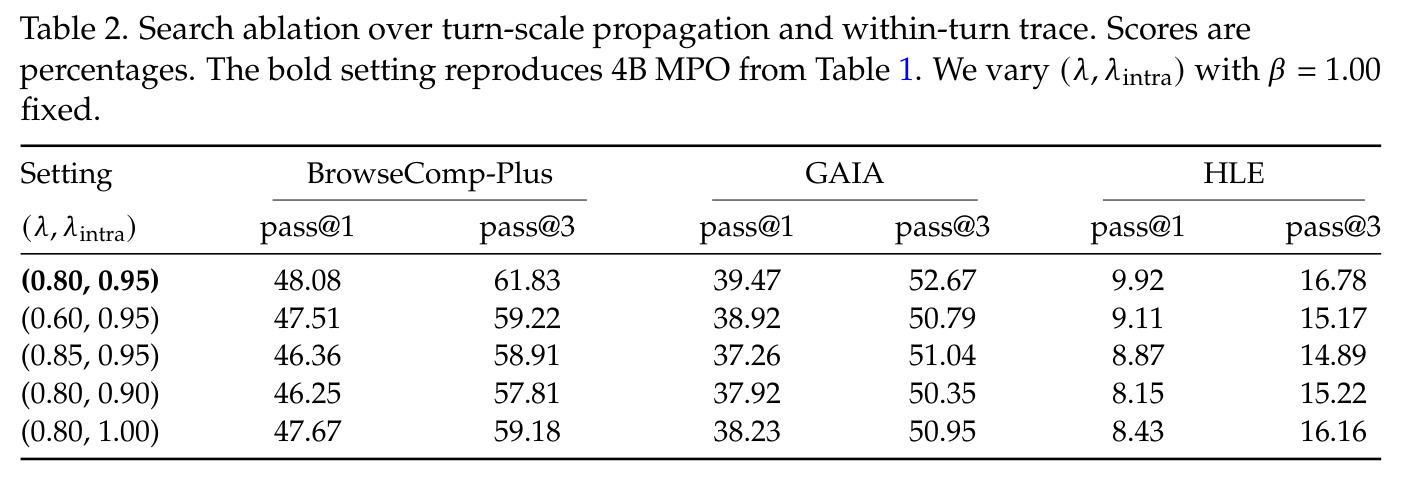
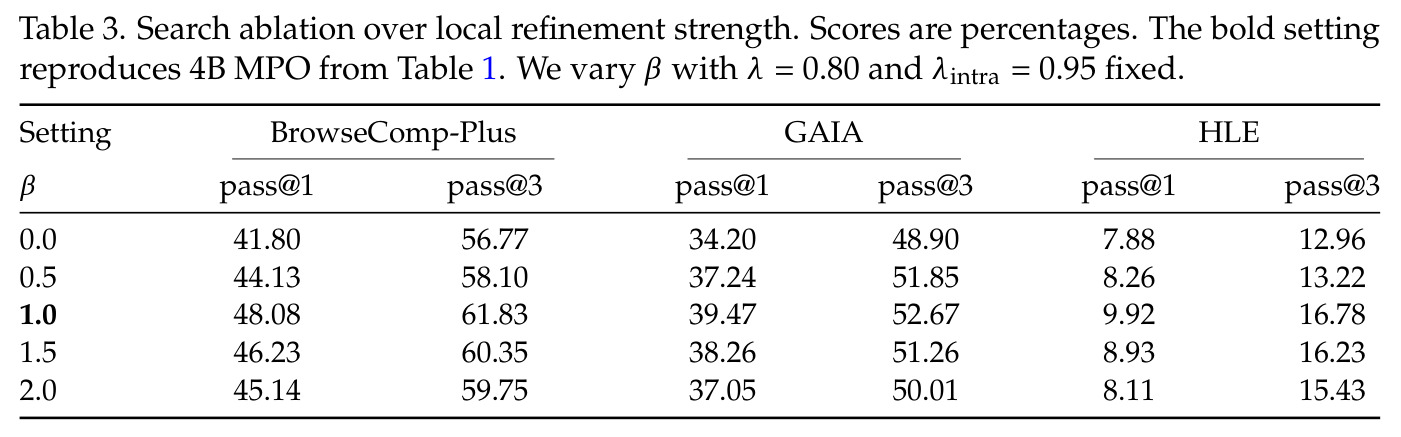
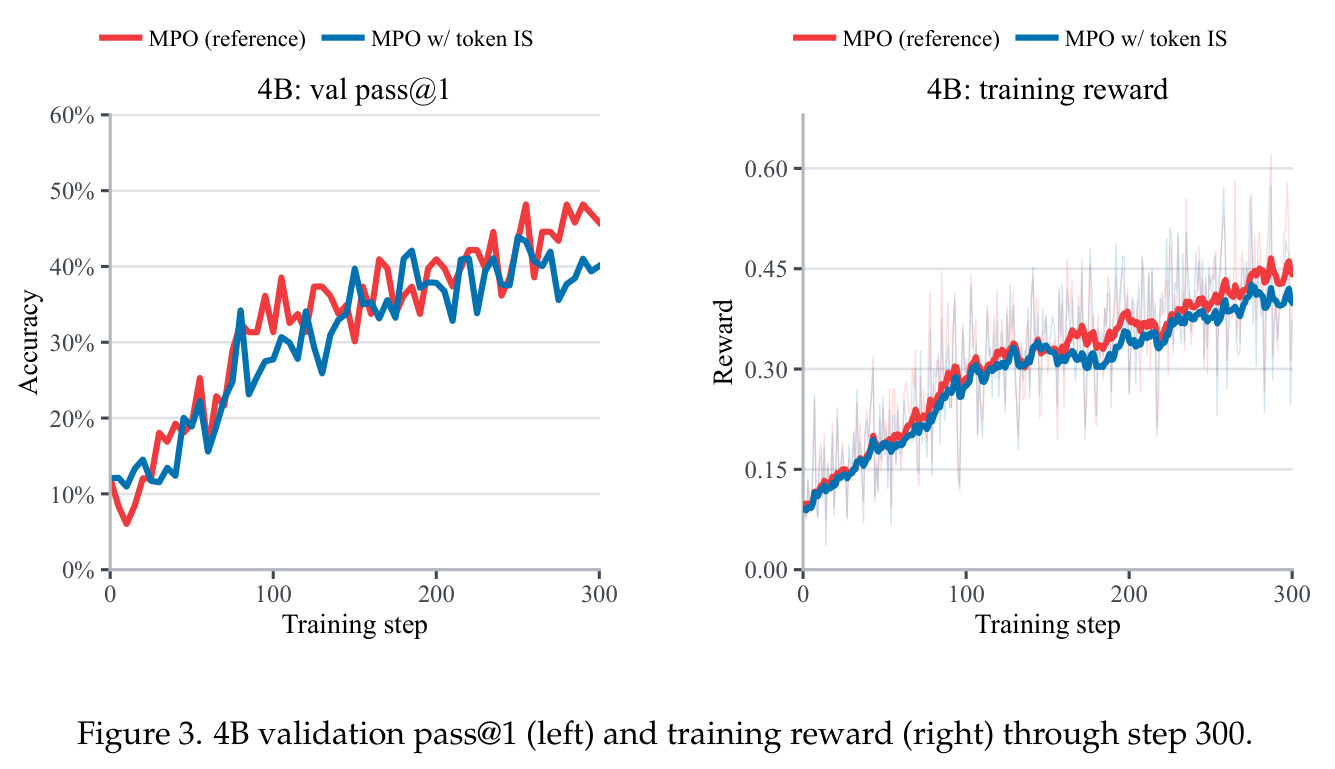
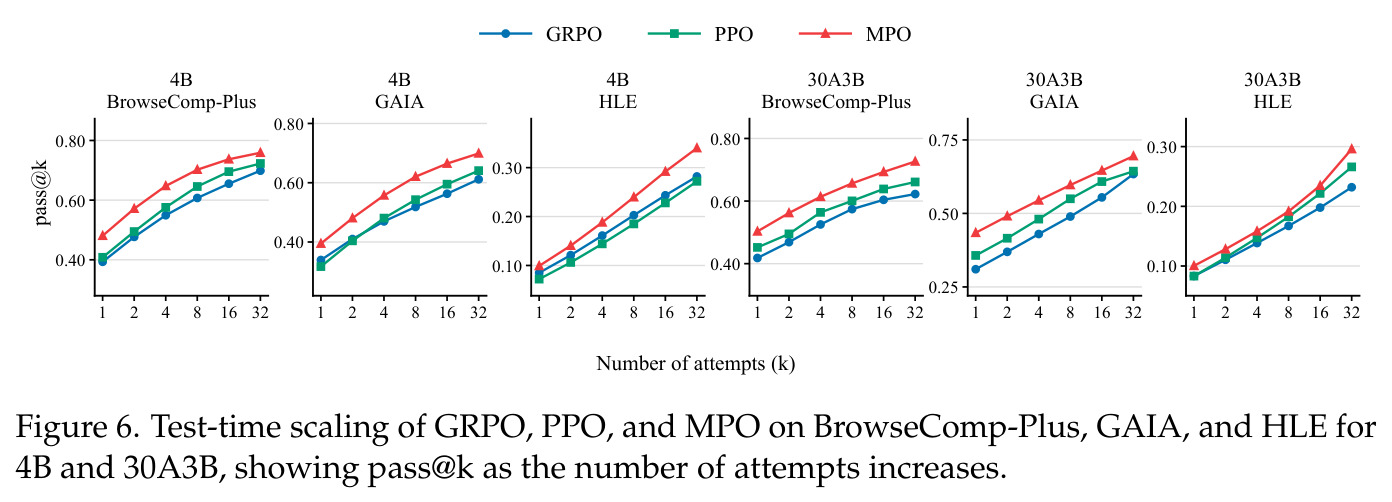
主实验(Table 1)在 Qwen3-4B-Thinking 与 Qwen3-30B-A3B-Instruct 上覆盖 Search(BrowseComp-Plus/GAIA/HLE)、Claw-Eval、Automation Bench,MPO 在全部 9 个指标第一。4B:BrowseComp-Plus pass@1 48.08(SAO 43.75,+4.33;GRPO 仅 39.34);GAIA 39.47(SAO 35.62,+3.85,pass@3 +5.11);HLE 9.92(GSPO 9.26,+0.66);Claw-Eval pass@3 66.91、pass3 51.73(+0.95);Automation Bench 13.33(SAO 12.06;Base 为 0.00)。30B:50.32(VAPO 46.73,+3.59)、43.42(+3.80,pass@3 +5.90)、10.03(+0.12)、pass3 58.35(+1.12)、15.00。组件消融:换回 token 级比率使 4B Search pass@1 降 2.36/3.12/1.03 点,但 MAE 单独仍全面胜 PPO,说明两组件贡献可叠加。测试时扩展(Figure 6):4B pass@32 达 75.90/69.90/34.00,比 GRPO/PPO 更强者高 3.61/5.82/5.80 点,增益随采样预算扩大。超参消融(Tables 2-3):$\\lambda=0.80$ 优于 0.60/0.85(0.85 掉 1.72/2.21/1.05),$\\lambda_{intra}=0.95$ 优于 0.90/1.00,$\\beta=1.0$ 最好——$\\beta=0$ 掉 6.28/5.27/2.04 点但仍胜 PPO(+0.95/2.49/0.66)。训练动态(Figures 4-5):MPO 后期 critic 解释方差高于 PPO/GRPO。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| BrowseComp-Plus(搜索,Qwen3-4B-Thinking) | pass@1 | 48.08 | 43.75(SAO,最强非 MPO 基线) | +4.33 个百分点 |
| GAIA(搜索,Qwen3-4B-Thinking) | pass@1 | 39.47 | 35.62(SAO) | +3.85 个百分点(pass@3 提升 5.11) |
| HLE(搜索,Qwen3-4B-Thinking) | pass@1 | 9.92 | 9.26(GSPO) | +0.66 个百分点 |
| Claw-Eval(Qwen3-4B-Thinking) | pass@3 / pass3 | 66.91 / 51.73 | 64.52 / 50.78(SAO / PPO) | +2.39 / +0.95 个百分点 |
| Automation Bench(Qwen3-4B-Thinking) | pass@1 | 13.33 | 12.06(SAO);Base 为 0.00 | +1.27 个百分点 |
| BrowseComp-Plus(Qwen3-30B-A3B-Instruct) | pass@1 | 50.32 | 46.73(VAPO) | +3.59 个百分点 |
| GAIA(Qwen3-30B-A3B-Instruct) | pass@1 | 43.42 | 39.62(SAO) | +3.80 个百分点(pass@3 提升 5.90) |
| HLE(Qwen3-30B-A3B-Instruct) | pass@1 | 10.03 | 9.91(SAO) | +0.12 个百分点(基本持平) |
| BrowseComp-Plus 4B 测试时扩展 | pass@32(32 次独立 rollout) | 75.90 | 72.29(GRPO/PPO 中更强者) | +3.61 个百分点(GAIA/HLE 分别 +5.82/+5.80) |
局限与改进
作者承认的局限:其一,解释方差的对比只是相关性解释——它是在各自策略的 rollout 上测量的,也受回报方差影响,无法隔离「轮次对齐更新使回报结构更易拟合」这一因果推断;其二,token 熵单独不能判定探索坍缩,他们用 pass@k 曲线间接回应了 PPO 熵骤降的问题。我自己的观察:HLE 上的增益很小(4B +0.66、30B 仅 +0.12),考虑到该基准绝对分值只有 9-10%,很可能落在评估噪声范围内;Automation Bench 上 Base 为 0、最强基线也只有 12-15%,天花板效应或地板效应都明显;正文所有训练与消融均为每设置单次运行('Each method has one run per model size'、'Each setting has one run'),没有多 seed 方差或置信区间,1-2 个点的差异难以统计确认;评估用 'best-performing checkpoint'(按性能挑 checkpoint 再离线评 5 次取均值)对基线和方法同样适用但天然偏乐观;理论分析假设固定轮数 $T+1$、精确优势和有界奖励,而实际使用 $\\lambda$ 截断的估计优势(附录 A.4 才做扩展),定理与实现之间仍有缝隙;此外三个超参($\\lambda$、$\\lambda_{intra}$、$\\beta$)的最优值来自 4B Search 单任务扫描,跨任务和模型规模的稳健性未验证。
独立分析的弱点
独立分析后我认为有五个值得注意的弱点。第一,实验统计功效不足:每个设置只有一次训练运行,Table 2、3 中相邻超参(如 $\\lambda$ 0.80 vs 0.85)的分差只有 1-2 个点,没有 seed 方差就无法排除随机波动,改进方向是每设置 3-5 个 seed 并报告均值±标准差。第二,轮次边界的定义依赖环境交互结构(一次工具调用/一次搜索为一轮),对于轮内嵌套工具调用、并行工具、流式观察等复杂 harness,宏动作边界如何切分并未讨论,改进方向是把边界检测显式化并做敏感性分析。第三,MAE 依赖一个在长轨迹上逐 token 预测价值的 critic,显存和计算开销显著高于 GRPO 系(30B-A3B 的 MoE 训练成本更甚),改进方向是研究 reward-model-free 的轮级优势估计(如用组内结果直接构造轮次信用)或低频/量化 critic。第四,超参敏感性:$\\beta$ 从 1.0 到 1.5 就全线掉分,$\\lambda$ 偏离 0.80 两侧都变差,暗示方法需要较细的调参;改进方向是按轨迹长度自适应设置 $\\lambda$/\\$\\lambda_{intra}$,或给出理论上的射程匹配规则(论文已暗示 5 轮 vs 20 token 的对应关系)。第五,HLE 增益微弱(+0.66/+0.12)说明当任务的知识门槛远高于策略优化可弥补的范围时,MPO 的信用重分配收益有限,改进方向是结合课程学习或检索增强来配对优化信号。
未来方向
作者在正文与附录中留下的延伸点包括:把轮级改进界扩展到估计轮优势(附录 A.4 已做初步处理)、完整刻画轮级 GAE 的估计误差只用边界 critic 误差表达(附录 A.5)、以及与异步智能体训练(SAO 一系)结合以提升吞吐。基于其成果可以自然延伸的方向:其一,自适应/可学习的 $\\lambda$、$\\lambda_{intra}$、$\\beta$——按轨迹的轮数与轮长度分布动态调整信用射程,甚至用元梯度学 $\\beta$;其二,把 MAE 推广到有中间奖励或密集过程奖励的场景,轮级残差不再只有终点一项,检验保均值投影是否仍然必要;其三,与风险敏感目标和探索多样化方法(论文引用的 risk-based objectives)结合,用轮级优势的方差项控制探索;其四,把两尺度框架搬到代码智能体和长程规划任务(SWE-bench 类),那里轮边界(一次编辑/一次测试执行)同样清晰;其五,理论方向:证明带批归一化优势和裁剪比率时的实际收敛性质,或把轮级信任区域直接约束进优化器(类似轮级 TRPO);其六,验证该框架在更大规模(>30B)与多模态智能体上的可扩展性,以及轮级重要性校正对 off-policy、异步数据陈旧度的容忍度是否真的优于 token 级比率。
复现评估
复现评估:论文未在正文提到开源代码或训练配置的完整发布(作者来自北大、IQuest Research、清华、人大、港大及独立研究者,联系邮箱为北大学生邮箱),因此复现主要靠公开组件自行搭建。可复用的部分:两个模型 Qwen3-4B-Thinking 和 Qwen3-30B-A3B-Instruct 均为开源权重;评测基准全部公开——BrowseComp-Plus 用 Lu et al. 的 held-out 设置,GAIA/HLE 用 WebThinker 的 text-only 子集,Claw-Eval 与 Automation Bench 沿用原始协议;方法本身公式完整(式 14-25),关键超参明确($\\epsilon$ 裁剪阈值、$\\lambda=0.80$、$\\lambda_{intra}=0.95$、$\\beta=1.0$、$\\lambda_{critic}=1$)。难度较高的部分:需要成熟的 agentic RL 基础设施(多轮 rollout 引擎、环境工具沙箱、critic 共享训练),Search 训练 300 步且每个任务每次评估要 32 条独立 rollout,整体算力估计在数百至数千 GPU 卡时的量级,30B-A3B 的 MoE 训练门槛更高;且每设置单次运行意味着复现者即使投入资源,也只能对比到与论文一致量级的结果而非精确数字。综合判断:对有小规模 RL 经验的团队,4B Search 一条流水线是可复现的(中等偏高难度),完整复现全部 9 指标和消融网格则需要可观的算力预算。
论文图表
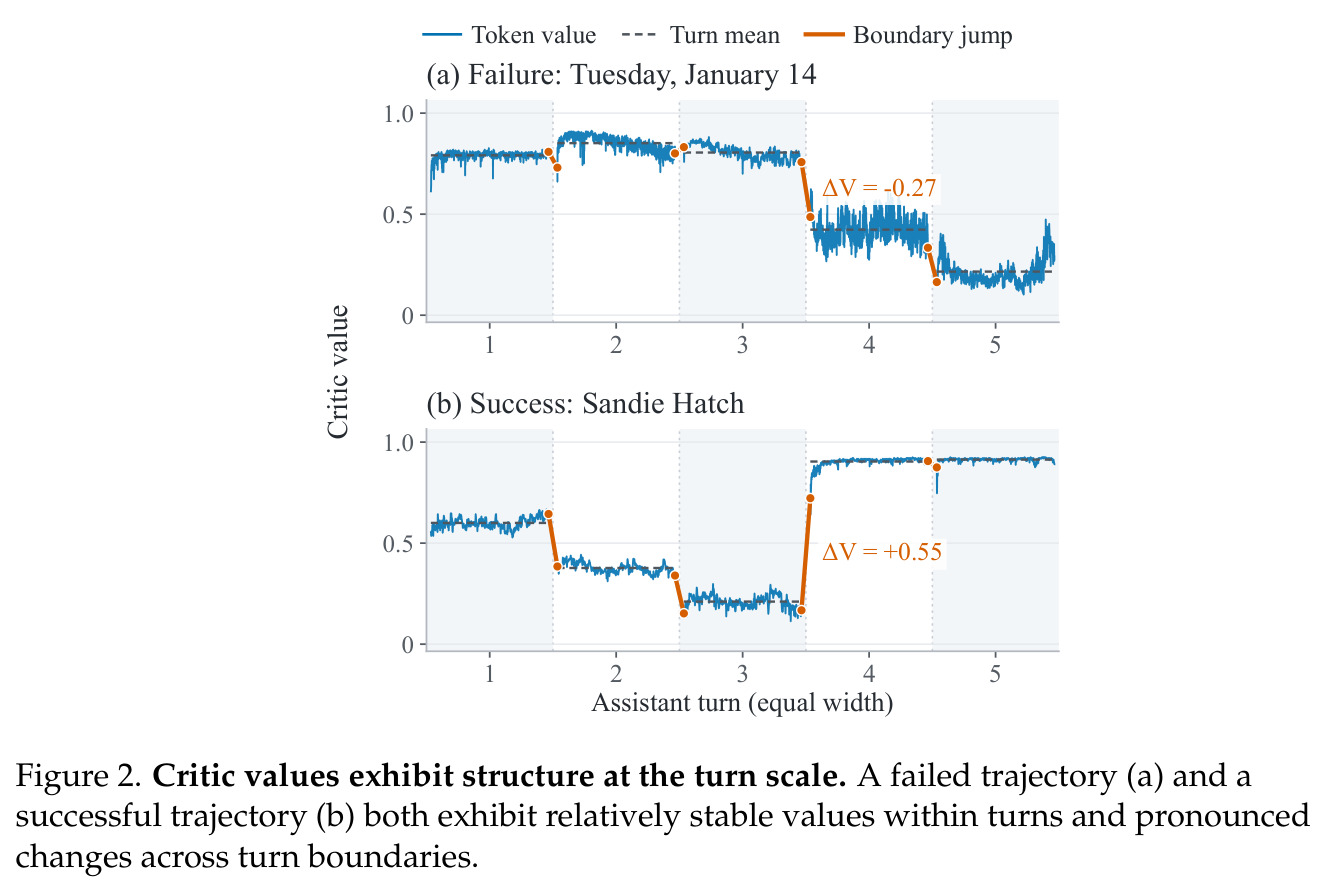
两条真实轨迹的 critic 逐 token 价值曲线:失败轨迹(Tuesday, January 14 任务)在某个轮边界价值跳降 $\Delta V=-0.27$,成功轨迹(Sandie Hatch 任务)在轮边界跳升 $\Delta V=+0.55$;两条轨迹都呈现轮内价值平稳、轮边界剧烈变化的形态。
这是全文的经验基石:它直观展示了「价值结构长在轮次尺度上」这一观察,配合正文统计(轮均值差解释 89.5% 的加权方差、93.8% 轨迹轮间方差占优),直接论证了为什么优化应该锚定轮次尺度。