面向长程智能体强化学习的树感知后验自蒸馏 Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
用前缀分支树把稀疏终局奖励蒸馏为有界后验教师,免Critic稳定长程智能体RL训练
前置知识
RLVR(可验证奖励强化学习)
用规则化、可验证的结果奖励(如答案正确性判 0/1)对大语言模型做后训练的范式,代表工作有 GRPO、DeepSeek-R1 等。奖励由验证器给出,无需训练奖励模型。本文聚焦 $R(\mathcal{H}_T)\in[0,1]$ 的二元/稀疏奖励设定,且不加参考策略 KL 惩罚($\beta_{KL}=0$)。
TreeOPSD 的唯一监督信号就是这种终局可验证奖励,全文都在讨论如何把它转化为稠密监督。
GRPO 与组相对优势
对每个 prompt 采样一组完整轨迹(如 $G=8$ 条),用组内均值和标准差把奖励标准化成优势 $A_k=(R_k-\text{mean})/\text{std}$,再广播到整条轨迹的所有 token 上做策略梯度,完全不需要值网络(Critic)。
GRPO 是本文的核心基线,其'把单一轨迹级优势广播到全轨迹'的做法正是论文要解决的稀疏信用问题。
信用分配与策略陈旧性
信用分配指把终局奖励归因到中间动作或轮次;策略陈旧性指在固定 rollout batch 上做顺序 mini-batch 更新时,当前策略 $\pi_\theta$ 逐渐偏离采样数据的行为策略 $\pi_{\theta_{old}}$,重要性采样比率和 PPO/GRPO 的 clip 是常用补救,但都不指明收敛终点。
这是论文的两大动机,Theorem 2 的三条性质(在策略切向精确、有界漂移消除、有限目标处符号反转)分别针对这两者。
策略镜像下降(PMD)与近端目标
把每步策略改进写成'线性改进项 $-$ KL 信赖域惩罚'的凸优化问题:$\max_Q \mathcal{J}(Q)$,其解是一个显式的目标分布,随后的策略更新等价于向该目标做 Bregman 投影。变分策略优化(如 MPO)继承了这一思路。
TreeOPSD 的两步解耦框架(先造目标、再追目标)和选择 Forward-KL 的理论依据直接来自这一脉的经典结论。
Odds 映射与 Bernoulli 后验
定义轮次的逐 token 平均对数似然比 $s_{\theta,i}=\frac{1}{L_i}\sum_j \log\frac{\pi_\theta(a_{i,j}|h_{i,j})}{\pi_{\theta_{old}}(a_{i,j}|h_{i,j})}$(即几何平均比率 $r_{\theta,i}=e^{s}$),把点对 $(r_{\theta,i},1)$ 用 sigmoid 归一化得 $p_{\theta,i}=r/(1+r)=\sigma(s)$,一个 log-odds 恰为 $s$ 的 Bernoulli 分布,从而绕开对未采样续写空间的难解配分函数。
这是把轮次级标量信用转成'分布匹配'问题的桥梁,也是消除轮长偏差(短工具调用 vs 长推理轮)的关键设计。
Initialize-then-expand rollout 树
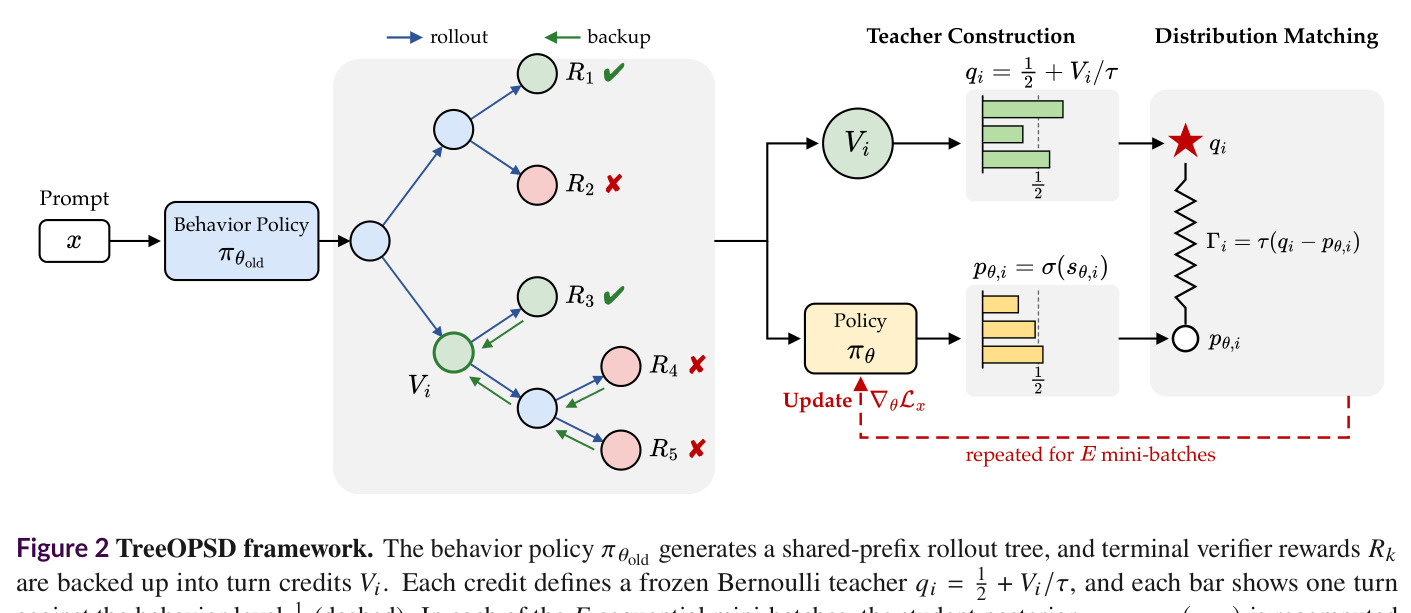
先用冻结行为策略采 $M$ 条完整轨迹,再从每条轨迹均匀抽 $N$ 个非终止锚点,从这些共享前缀续采新鲜终局后缀,共得 $K=M(N+1)$ 条终局轨迹;合并共享前缀即得 rollout 树。由于分支续采平均只有一半长度,其期望成本与 GRPO 采 $G$ 条完整轨迹相当($M(1+N/2)\approx G$)。
树结构让轮次信用'免费'可得:终局奖励经似然加权备份即得每个轮次的 $V_i$,无需 critic、PRM 或外部教师。
研究动机
在长程多轮智能体任务(如 Deep Research 需要数十轮“检索—推理—作答”交互)中,RLVR 只在轨迹终点给出 0/1 型结果奖励。GRPO 把轨迹级优势广播到整条 rollout,会过度奖励成功轨迹中的无用动作、惩罚失败轨迹中的关键步骤,中间轮次的监督极其稀疏且高方差。现有加密信用的方案各有代价:PPO 依赖学习值函数,训练难且易出现 value flattening;过程奖励模型 PRM 需要逐步过程标注,加折扣求和后易被 reward hacking;在线蒸馏 OPD 需要查询更强的外部教师,其扩展 OPSD 则依赖条件于参考答案等特权上下文的任务特定启发式,监督不稳定。另一方面,固定 rollout batch 上的顺序 mini-batch 更新引发策略陈旧:当前策略 $\pi_\theta$ 逐步偏离行为策略 $\pi_{\theta_{old}}$,重要性采样与裁剪只约束比率本身、保持采集时的固定信用,仍只给出上升方向而非有限目标,无法在过冲后停止或反向。
本文的目标是本文要在不引入值网络、步骤标注或外部教师的前提下同时解决两大瓶颈:其一,直接从稀疏终局奖励推导稠密且树一致的轮次级(turn-level)信用;其二,为顺序 mini-batch 更新指定一个有限的目标分布,使训练到达目标即停、过冲自动反向。量化目标是:在 HotpotQA 训练的多跳问答(评测 Hotpot/2Wiki/MuSiQue/Bamboogle 四个测试集)与 OpenResearcher 6,102 题训练的 Deep Research(封闭语料评测 BrowseComp-Plus,再迁移到 BrowseComp/GAIA/xbench 开放网络)两类设置下,在与 GRPO 相同的期望采样预算($G=8$ 对应 $M=4, N=2$)内,让 Qwen3-4B 与 Qwen3-30B-A3B-Thinking-2507 超越 GRPO、GSPO 与同树同信用的 TreePO 基线,并在更长时程的任务上放大优势。
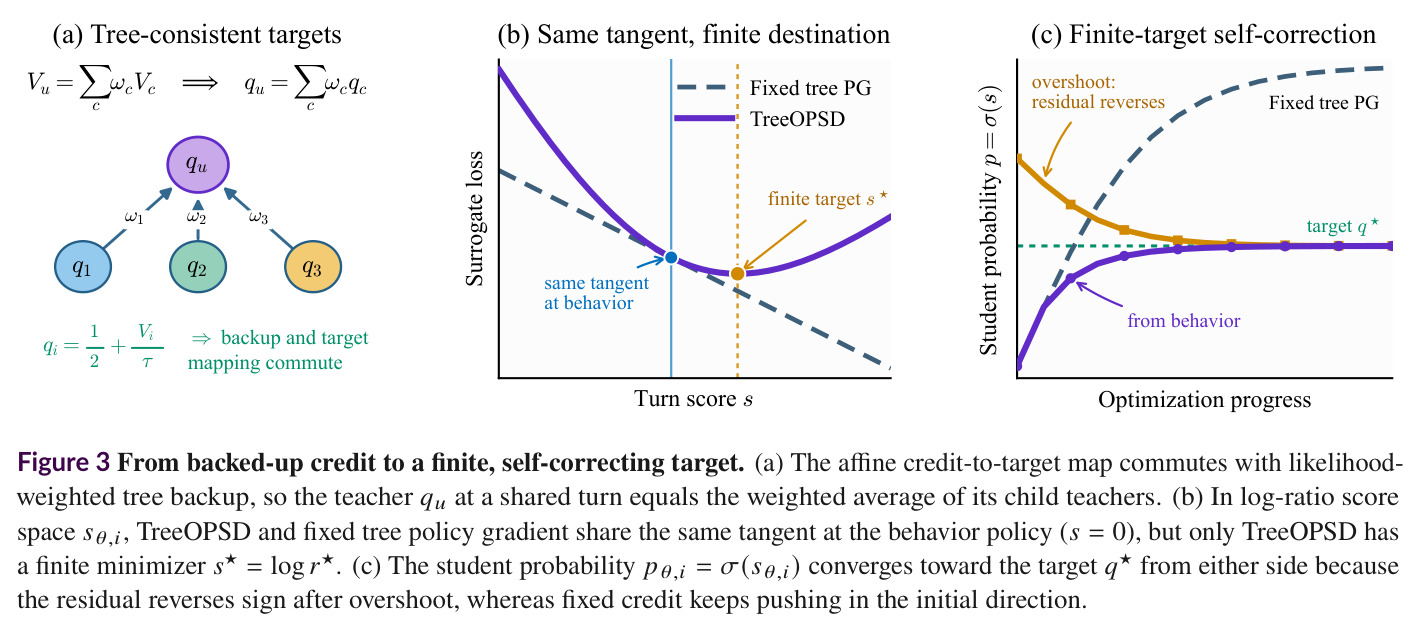
与已有工作不同的是,论文的独特切入点是把“造目标”与“追目标”解耦成两步。以往方法把信用分配与策略更新纠缠在一个线性策略梯度代理目标里,只提供初始上升方向;TreeOPSD 借鉴策略镜像下降(PMD)与变分策略优化,先围绕行为策略解一个 KL 信赖域正则的近邻改进问题,把备份信用 $V_i$ 经闭式仿射映射变成冻结的 Bernoulli 教师分布,再用 Forward-KL 散度把不断演化的学生策略投影到该教师上。三个关键洞察支撑该方案:多轮交互天然暴露离散的轮次前缀作为分支点,共享前缀分支能固定前置历史、隔离后续决策对终局结果的影响;以逐 token 平均似然比经 odds 映射得到的两点 Bernoulli 后验,绕开了对未采样续写空间的难解配分函数;仿射目标映射与树备份可交换(commute),保证信用在树上无损压缩。
核心方法
TreeOPSD 是免 Critic 的后验自蒸馏框架。直觉上把每个交互轮次视为树节点:行为策略先采 $M=4$ 条完整轨迹,再从每条均匀抽 $N=2$ 个锚点,从共享前缀续采终局后缀,得 $K=M(N+1)=12$ 条终局轨迹,合并共享前缀构成 rollout 树;分支续采期望成本约为完整 rollout 一半,与 GRPO 的 $G=8$ 预算匹配。终局奖励标准化为优势 $A_k$ 后,用似然权重递归备份成轮次信用 $V_i$,再经仿射映射变成冻结教师 $q_i=\frac{1}{2}+V_i/\tau$,温度 $\tau=\sqrt{K-1}/(\rho\sqrt{K})$、默认半径 $\rho=0.25$,保证 $q_i$ 落在 $[1/2-\rho,1/2+\rho]$。分布匹配阶段把 batch 切成 $E$ 个 mini-batch,每步重算学生的对数比分数 $s_{\theta,i}$、经 odds 映射得 $p_{\theta,i}=\sigma(s_{\theta,i})$,最小化 Forward-KL 损失把学生拉向教师,到达目标后梯度归零、过冲后残差自动反向。
核心创新是把轮次信用转成有限、有界、自纠正的目标分布,而非固定线性权重。与使用同树同信用、但全程固定上升系数 $V_i/L_x$ 的 TreePO 相比:在行为策略处,蒸馏损失的切向精确恢复树策略梯度 $g_x^{\text{tree}}$;此后每步上升权重变为 $\Gamma_i=V_i-\tau(p_{\theta,i}-\tfrac{1}{2})$——学生到达目标比率 $r_i^\star$ 时梯度归零,过冲后符号反转,该加性修正在 $r_{\theta,i}\in(0,\infty)$ 上一致有界且 Lipschitz,避免乘性重要性比率随轮长指数复合的方差爆炸。另一本质区别是轮次粒度建模:连乘 token 似然比会随轮长 $L_i$ 指数放大失配并带来长度偏差,论文改用逐 token 平均对数似然比(几何平均比率),并把 $(r_{\theta,i},1)$ 归一化为 Bernoulli 后验,log-odds 恰为 $s_{\theta,i}$,天然消除轮长偏差。
方法步骤详情
流程见 Algorithm 1,每轮分两阶段。目标构造阶段:冻结 $\pi_{\theta_{old}}$,采 $B$ 个 prompt 切成 $E$ 个 mini-batch;对每个 prompt 采 $M$ 条完整 rollout,再从每条的 $N$ 个锚点前缀续采终局后缀,合并共享前缀成树 $\mathcal{T}_x$;对 $K$ 条终局轨迹标准化奖励得 $A_k$,按似然权重递归备份出各节点 $V_i$,设冻结教师 $q_i=\frac{1}{2}+V_i/\tau$。分布匹配阶段:每个 block 重算当前策略下的对数比分数 $s_{\theta,i}$ 与后验 $p_{\theta,i}=\sigma(s_{\theta,i})$,给轮次 $i$ 每个 actor token 赋梯度权重 $\tau(p_{\theta,i}-q_i)/L_x$,prompt 平均后反传;观测 token 全程 mask。总损失即按 $L_i/L_x$ 加权的 Forward-KL 距离之和(式 13)。
技术新颖性
技术新颖性有三。其一,闭式有界教师:由 Samuelson 不等式,标准化优势被 $\sqrt{K-1}/\sqrt{K}$ 界住,凸树备份保持该界,故取 $\tau=\sqrt{K-1}/(\rho\sqrt{K})$ 即让目标比率 $r_i^\star$ 落在与深度无关的区间 $[(1-2\rho)/(1+2\rho),(1+2\rho)/(1-2\rho)]$,无需 ad-hoc 裁剪;论文还证明该仿射映射是唯一与凸树备份交换的对称半径校准映射(Theorem 1),匹配备份后的父教师等价于聚合全部后代叶子损失,实现无损信用压缩。其二,Forward-KL 有变分根源:由 Bregman/Fenchel–Young 对偶,教师与任一学生的近端目标间隙恰为 $\tau D_{KL}(Q_i^\star\|P_{\theta,i})$,故每步降蒸馏损失都单调提升树加权近端 RL 目标。其三,Theorem 2 给出在策略切向精确、有界漂移消除、有限目标处符号反转三条结构保证,把 PMD 的镜像投影思想首次落到树形智能体 RL 的轮次粒度。
实验结果
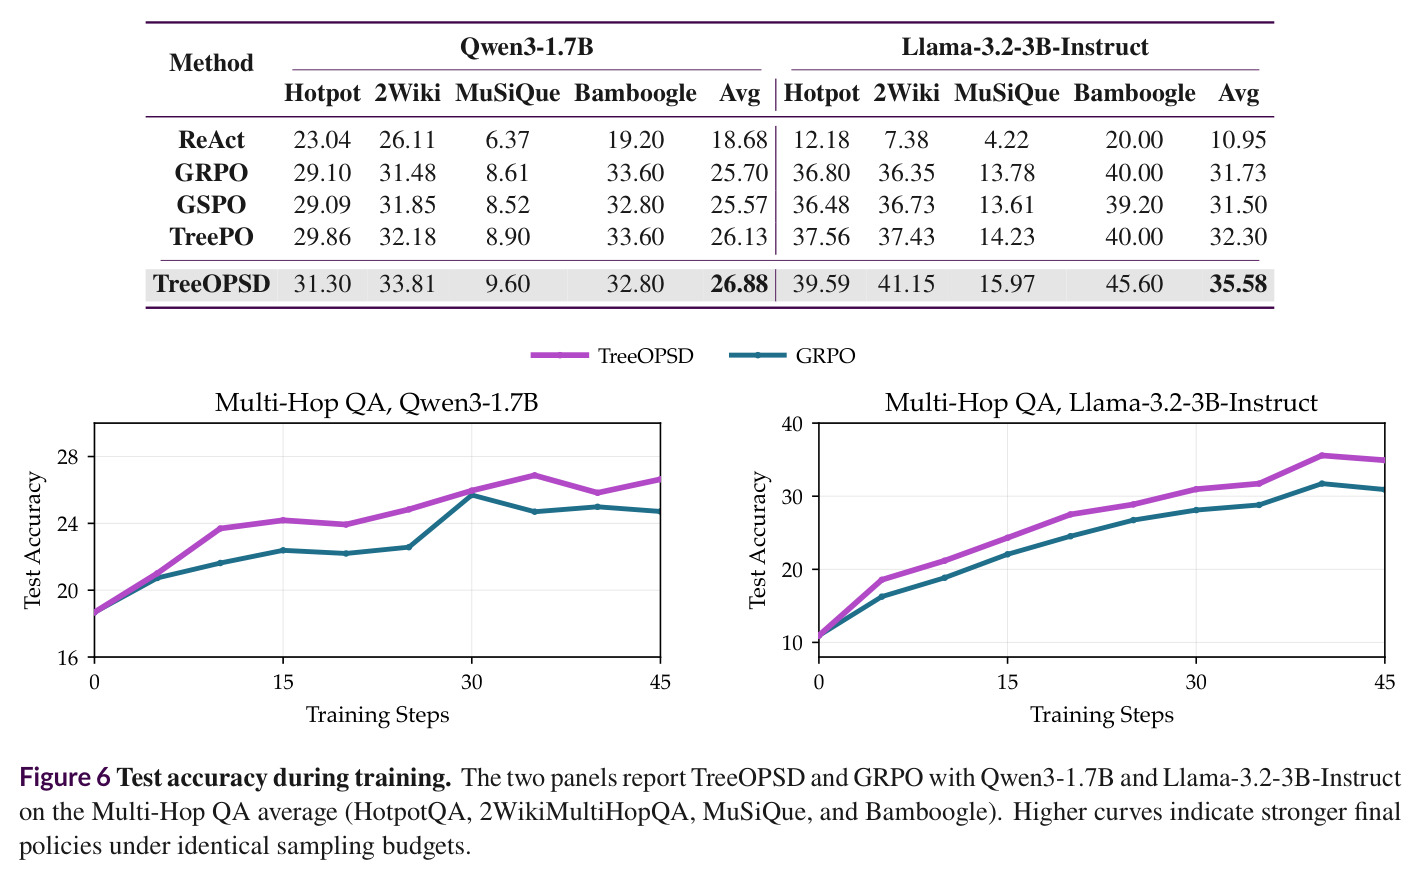
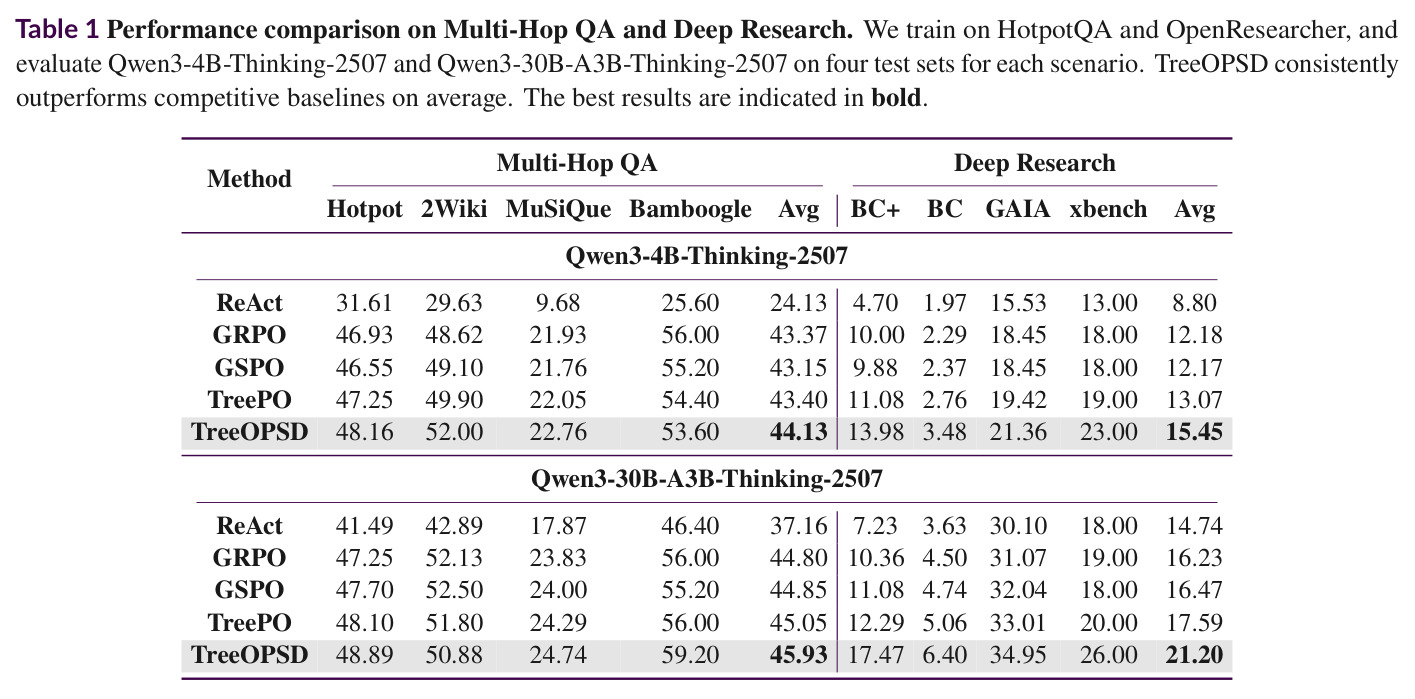
主实验(Table 1,EM)显示 TreeOPSD 在两规模均平均最优。Qwen3-4B:Multi-Hop QA 平均 44.13(GRPO 43.37);Deep Research 平均 15.45,显著高于 GRPO 12.18 与 TreePO 13.07,BrowseComp-Plus 达 13.98。Qwen3-30B-A3B:Multi-Hop QA 平均 45.93,Bamboogle 59.20;Deep Research 平均 21.20,比 GRPO 高 4.97 点、比 TreePO 高 3.61 点,其中 BrowseComp-Plus 17.47 对 10.36,开放迁移 BrowseComp 6.40、GAIA 34.95、xbench 26.00 全面领先。消融(Table 2a):$(4,2)$ 树最优(15.45),优于独立采样 $(8,0)$ 的 11.28 与 $(2,6)$ 的 14.97;半预算 $(2,2)$ 达 11.33。半径扫描(Table 2b)在默认 $\rho=0.25$ 达峰且波动平缓。Figure 4 显示差距随步数扩大。
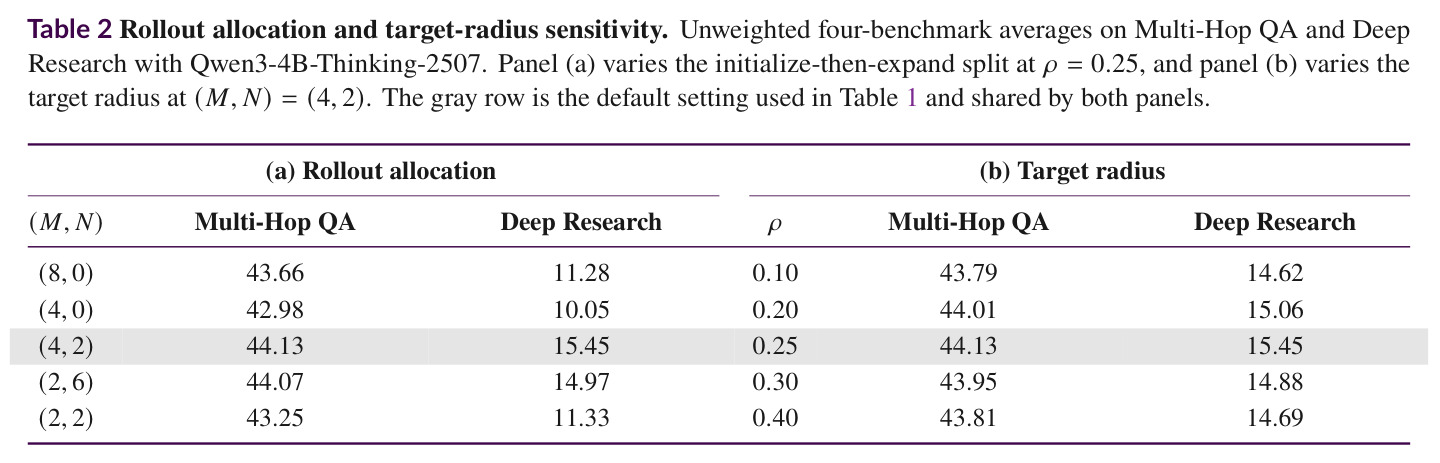
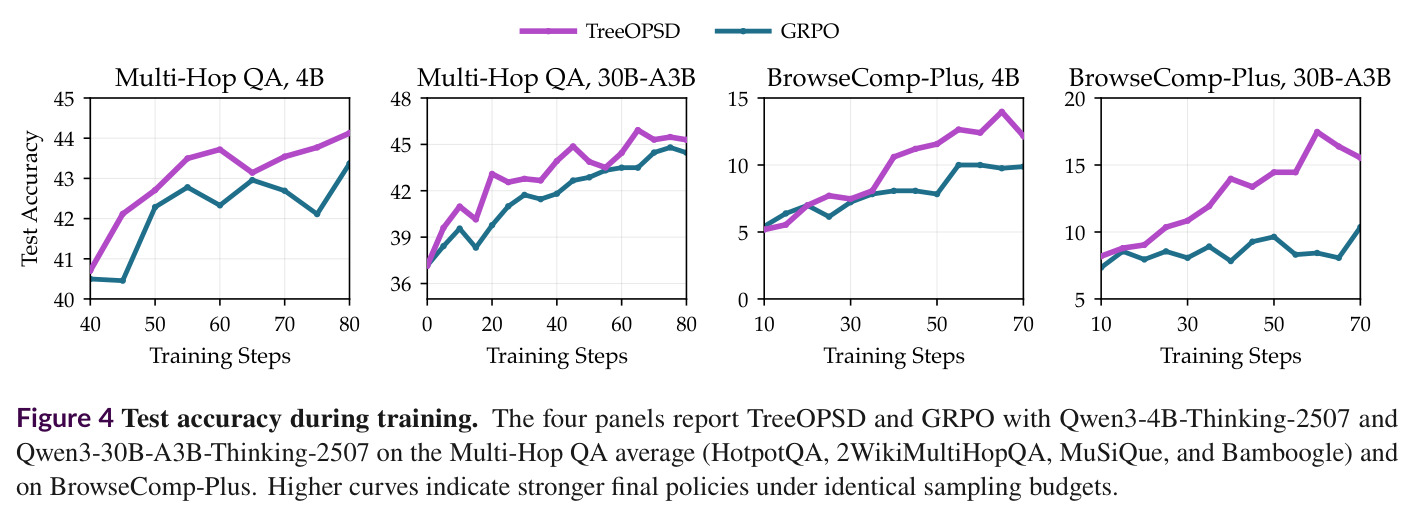
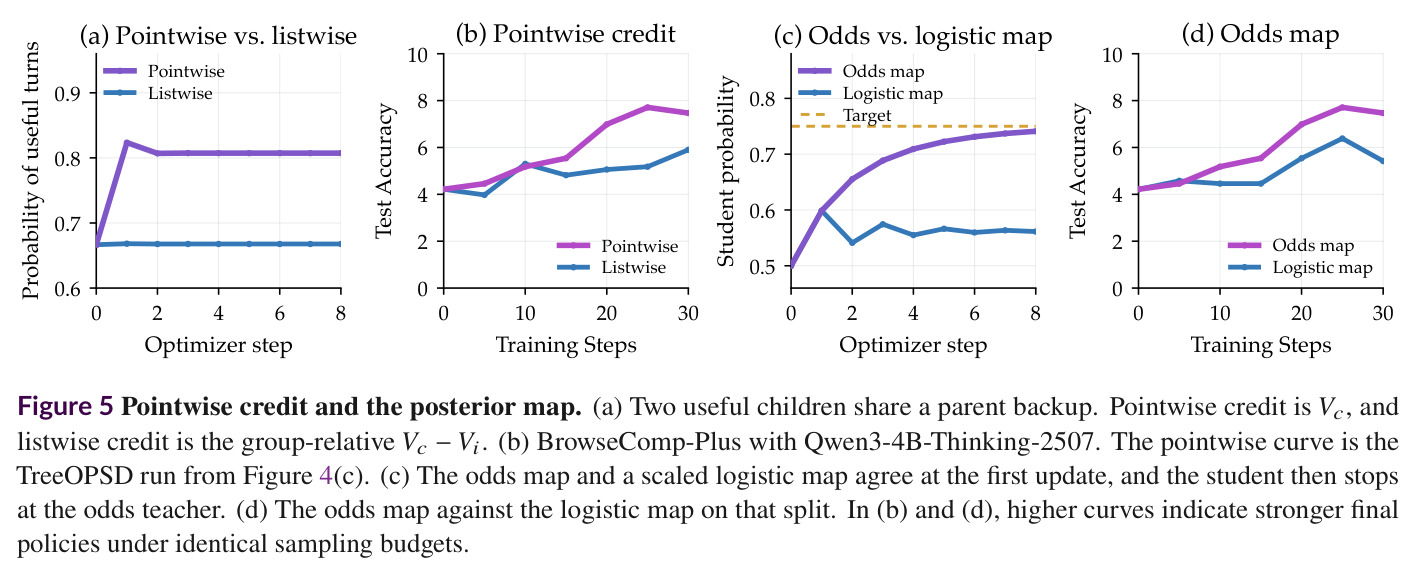
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Deep Research 四基准平均(Qwen3-30B-A3B-Thinking-2507) | Exact Match (EM) | 21.20 | GRPO 16.23 / TreePO 17.59 | +4.97(对 GRPO)/ +3.61(对 TreePO) |
| Deep Research 四基准平均(Qwen3-4B-Thinking-2507) | Exact Match (EM) | 15.45 | GRPO 12.18 / TreePO 13.07 | +3.27(对 GRPO) |
| Multi-Hop QA 四基准平均(Qwen3-30B-A3B-Thinking-2507) | Exact Match (EM) | 45.93 | GRPO 44.80 / TreePO 45.05 | +1.13(对 GRPO) |
| Multi-Hop QA 四基准平均(Qwen3-4B-Thinking-2507) | Exact Match (EM) | 44.13 | GRPO 43.37 / TreePO 43.40 | +0.76(对 GRPO) |
| BrowseComp-Plus 封闭语料检索(Qwen3-30B-A3B) | Exact Match (EM) | 17.47 | GRPO 10.36 | +7.11 |
局限与改进
局限可从作者交代与自身观察两方面看。作者将设定限制在规则化、二元/稀疏奖励且 $\beta_{KL}=0$ 的情形,未讨论参考策略惩罚或连续奖励;分支方法隐含“前缀+环境转移可复现”假设,即环境状态需由交互历史唯一确定,检索类封闭语料满足,但对有隐藏状态或强随机性的真实网页、API 工具环境,分支测得的差异会混淆环境噪声与轮次信用。实验层面:多跳问答上相对 GRPO 的提升较小(4B 仅 +0.76),主要增益集中在更长的 Deep Research 场景;评价以 EM 为主、每 5 步评测一次(Multi-Hop QA 至 80 步、BrowseComp-Plus 至 70 步),论文未报告方差与置信区间,也未与需要外部教师的 OPD/OPSD 直接对比。效率方面,$K=M(N+1)=12$ 条终局轨迹全部要打分,树备份与每步重算 $s_{\theta,i}$ 带来额外前向与显存开销,正文只给出“分支续采期望成本约一半 rollout”的粗略估计。理论上 Theorem 2 的漂移界是标量与参数级分析,深度网络加 Adam 下的非凸动力学仍无保证。
独立分析的弱点
独立弱点与改进方向:1) 可重放假设过强——真实网页/API 环境随机时共享前缀分支会混入环境噪声,可引入学习到的环境模型,或对随机转移做重要性加权与方差修正;2) 树的节点数与备份计算随时程增长,$K=12$ 条终局轨迹全部需要打分与存储,长时程任务内存压力大,可探索增量备份、锚点重要性采样或树剪枝;3) 教师半径 $\rho$ 全组统一,未按优势方差或备份深度自适应,极端成功/失败不平衡的组会浪费目标区间,可让 $\rho$ 逐 prompt 或逐深度动态校准;4) Bernoulli 两点后验丢弃了词表级分布信息,pointwise 信用下多个有用子分支虽可同时抬升,但仍受 $\rho$ 上限约束,可研究基于相对密度估计的多点教师并保持与凸备份的交换性;5) 缺少与 OPD/OPSD 外部教师法及代码智能体(SWE 类)多轮任务的对比,跨域泛化证据不足;6) 评测协议偏窄(仅 EM、每 5 步测一次),应补充 pass@k、轮次效率、方差与置信区间分析。
未来方向
作者指出 TreeOPSD 会激发更长时程的智能体行为(Deep Research 中交互轮次更多),在此基础上可延伸多个方向。其一,把框架推广到连续/稠密奖励与带参考 KL 惩罚的目标,验证仿射教师在大奖励动态范围下的稳健性。其二,混合范式:树信用提供轮次级有限目标,token 级再叠加轻量 critic 或 PRM 细化,兼取两类信号。其三,异步与持续 rollout 场景下研究教师冻结时长的最优折中,把陈旧性控制变成自适应调度。其四,把 odds 映射推广为多元相对密度比——4.3 节已证明 logistic 映射因不与备份交换而逊色,这提示“listwise 教师且保持交换性”的设计空间仍待系统刻画。其五,理论上把 Theorem 2 的收缩与漂移界从标量推广到深度网络与自适应优化器下的非凸情形。其六,rollout 树本身可用于推理期搜索与测试时扩展,训练期分支采样与推理期树规划(tree-of-thought 式解码)的结合值得探索。其七,在代码智能体、GUI 操作等更长时程环境中验证可扩展性。
复现评估
复现评估:论文由清华与腾讯完成,正文未附开源代码链接,复现需按 Algorithm 1 与附录(Appendix E 给出数据划分、奖励、训练设置与评估协议)自行实现。数据可得性好:训练用 HotpotQA 训练集与 OpenResearcher 6,102 题,评测集 HotpotQA 验证集、2Wiki、MuSiQue、Bamboogle、BrowseComp-Plus、BrowseComp、GAIA、xbench 全部公开;多跳任务还需本地 E5 检索服务加 Wikipedia dump。算力门槛较高:需跑 Qwen3-4B 与 Qwen3-30B-A3B 两个规模,每 prompt 生成 $K=12$ 条终局轨迹并维护前缀共享树,训练至 70–80 步且每 5 步全量评测,需多卡高端 GPU 与支持多轮 mask、树式前缀复用的长上下文框架。核心组件(平均 log-ratio、odds 映射、$\tau$ 校准、pointwise 备份)实现简单,整体复现难度中上,最大不确定性在分布式树采样与 KV cache 管理的工程细节。
论文图表
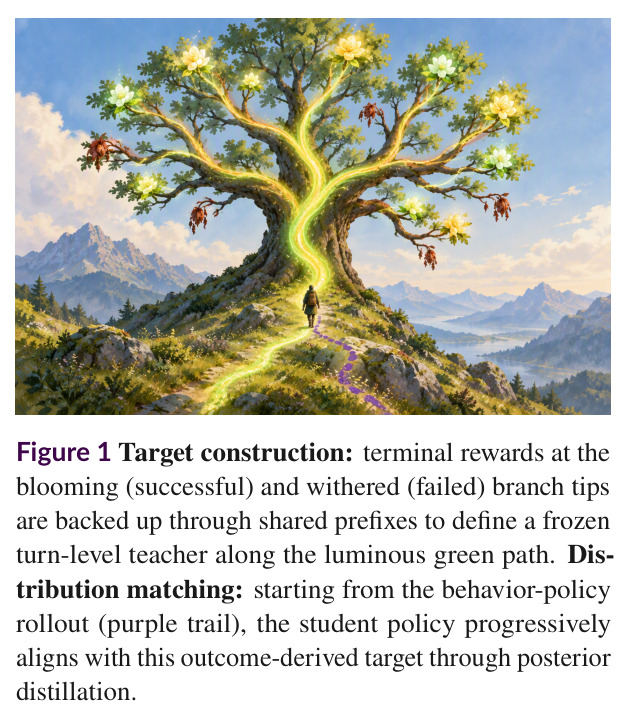
概念示意图,分左右两半。左半“目标构造”:一棵 rollout 树,成功(开花 blooming)与失败(枯萎 withered)分支终点的终局奖励沿共享前缀向上备份,在发光绿色路径的每个轮次上定义出冻结的教师目标 $q_i$;右半“分布匹配”:从行为策略 rollout(紫色轨迹)出发,学生策略通过后验蒸馏逐步对齐这个由结果推导出的目标。
一图讲清论文最核心的“目标构造 + 分布匹配”解耦思想:教师由终局奖励备份而来且全程冻结,学生负责追。是理解全文的入口,适合放在动机部分。