PAR:面向状态追踪长度泛化的进度对齐循环 PAR: Progress-Aligned Recurrence for Length Generalization in State Tracking
对齐循环迭代与任务进度并锚定状态范数,让循环语言模型实现16倍长度外推
前置知识
循环深度 Transformer(looped LM)
将预训练模型的中间层抽出、在深度方向反复复用同一组权重的架构:输入先经前导层(prelude)得到特征,再由共享核心层(core)迭代更新隐状态若干次,最后由输出层(coda)读出答案。迭代次数 $R$ 在测试时可加大,用同一组参数获得随问题难度增长的计算量,属于不生成中间文本的隐式推理。
PAR 的全部设计建立在“同一核心块被反复调用”这一前提上:迭代次数对应任务步数、状态在循环间传递。理解该架构才能理解深度-长度对应与范数锚定为何必要。
长度泛化(length generalization)
模型只训练短样本后能否在更长的同类问题上保持正确。本文用外推因子 $G = d_{50}/d_{train}$ 量化:准确率跌破“随机与100%中点”的首个测试深度与最大训练深度之比。例如训练深度 $\le 16$、测试到 256 仍正确则 $G=16$。
这是论文要解决的问题本身;swap-$S_5$ 的 16×、各基线的不足 2× 等核心数字全部以 $G$ 和长度倍数表述。
状态追踪与 swap-$S_5$ 任务
一组操作序列逐步更新某个状态,查询时须报告最终状态。swap-$S_5$ 中五个盒子各装一件物品,每个操作是恒等或 10 个对换之一,查询某个盒子的内容;五个查询全对才算整序列正确(full-state accuracy),随机水平 20%。$S_5$/$A_5$ 变体把操作换成一般置换或三循环。
它是实验载体:其“每步一个规范中间状态”的结构正是进度对齐目标可行的原因,也是与图可达性对比时论证方法适用边界的依据。
RMS 范数锚定
每次迭代后把每个 token 的循环状态缩放回其第一次迭代状态的均方根范数:$s_k \leftarrow s_k \cdot \mathrm{rms}(s_1)/\mathrm{rms}(s_k)$(参考项 stop-gradient),使步进映射尺度固定、权重块重复调用数百次仍计算同一个函数。
消融显示去掉它外推因子从 16× 跌到 2.2× 以下,是方法两大必要条件之一。
前缀自蒸馏与 EMA 教师
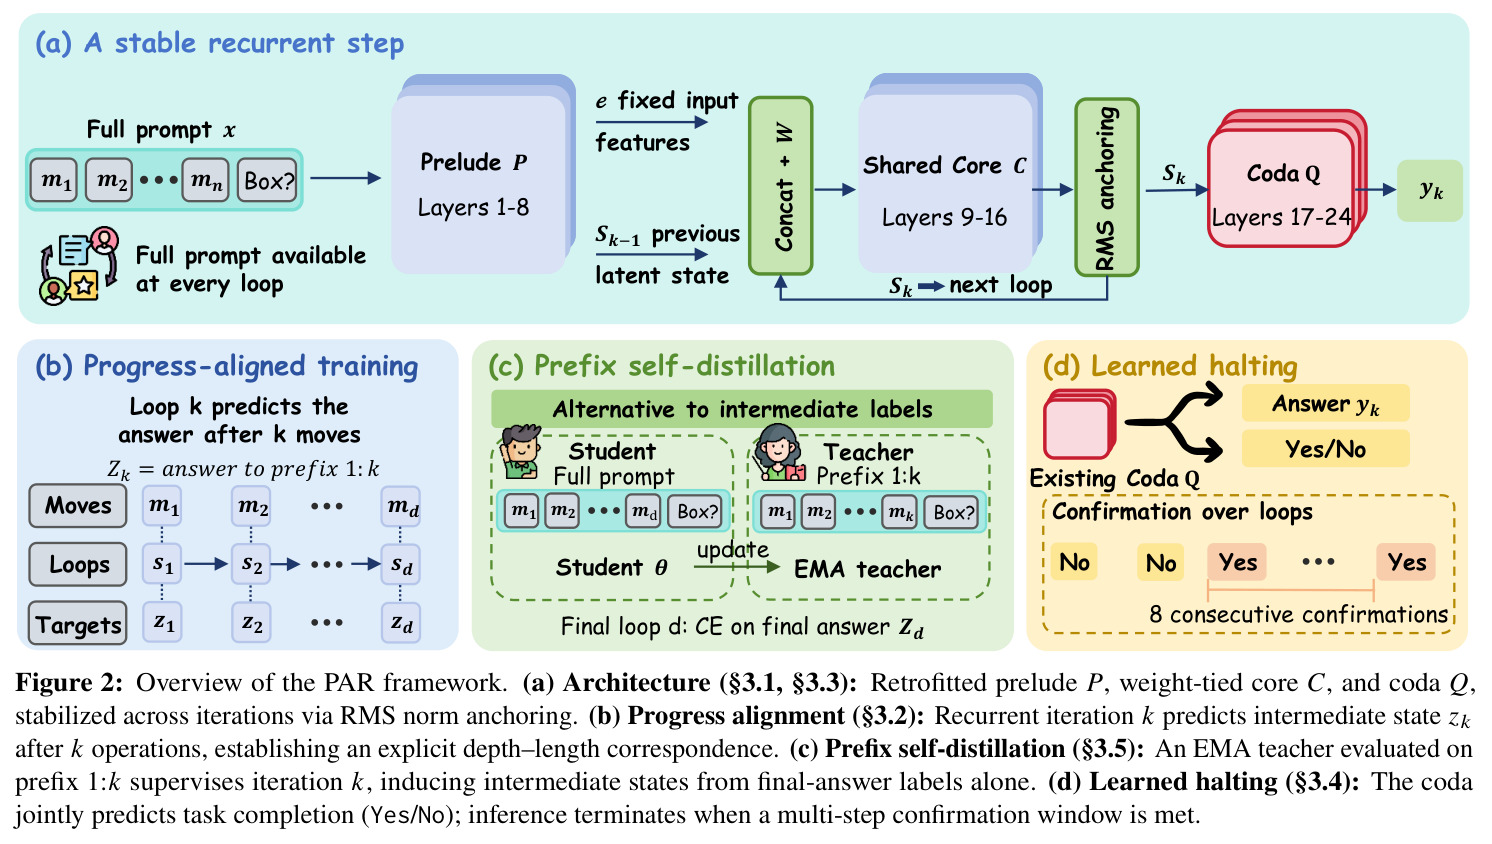
当没有逐步中间标签时,利用“前 $k$ 步操作构成答案为 $z_k$ 的合法更短问题”:让 EMA(指数滑动平均,衰减 0.99)教师在被截断的前缀上、于自身完成迭代处解码的答案分布,作为学生在完整输入上第 $k$ 次迭代的 KL 目标;全程只用最终答案监督。
这是把方法推广到没有合成器提供 $z_k$ 的真实数据的关键组件;Table 5 显示它是唯一在 16× 仍达 85% 的无标签配方。
交叉熵与 KL 散度
交叉熵 $\mathrm{CE}(q,y)=-\log q_y$ 衡量预测分布与正确标签的差距,PAR 用于每个迭代的答案预测;KL 散度 $D_{KL}(p\|q)=\sum_i p_i \log(p_i/q_i)$ 衡量两个分布差异,用于让学生迭代匹配教师在前缀上的答案分布。
两种损失分别对应主目标 $\mathcal{L}_{PAR}$ 与蒸馏目标,是读懂训练公式的前提。
研究动机
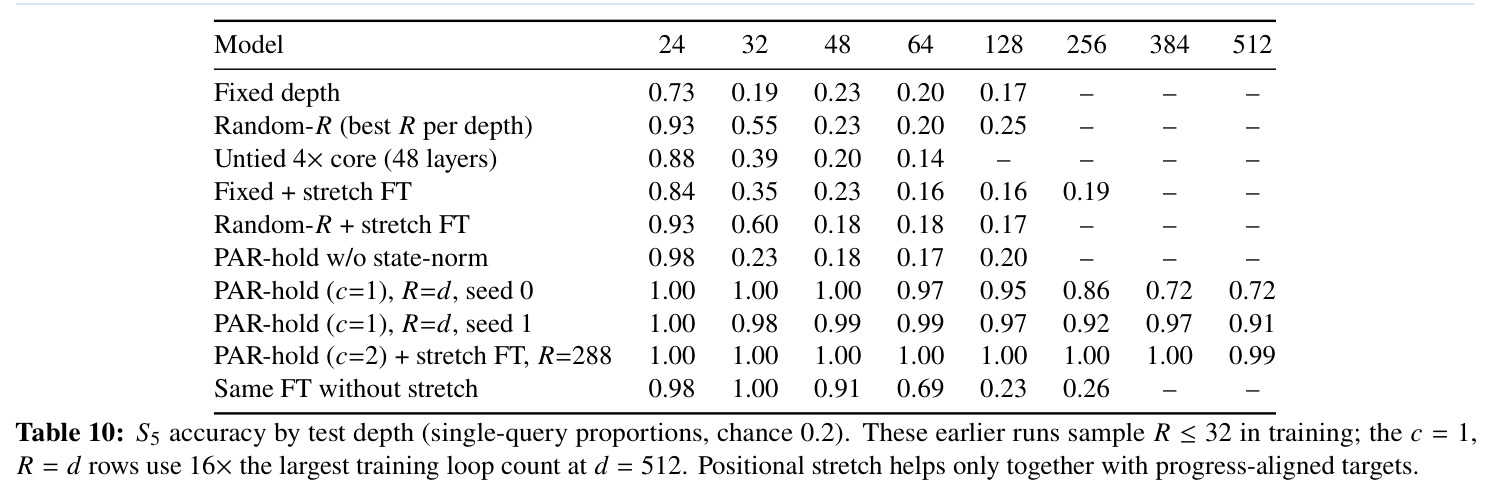
循环语言模型理论上可以在测试时增加迭代次数来处理更长的问题,但实践中“多跑几轮”并不会自动带来“解更长的题”的能力。论文用受控实验暴露了现有做法的两类失败:其一,最终答案监督不规定每次迭代该推进多远——Chen 在图可达性任务上发现让每个循环都预测最终答案会鼓励模型提前抢答、削弱外推;在本文 $S_5$ 上“每次循环都给 $z_d$”外推因子仅约 2.1×,“只在第 $d$ 次循环给 $z_d$”更是只有 1.48×。其二,重复调用同一权重会改变循环状态的尺度:没有范数锚定的进度目标在约 1.8× 就失准。更糟的是堆资源也无效——训练 $\le 16$ 操作的 $S_5$ 上,四倍深度(48 层)的解绑模型外推不足 1.76×,随机 $R$ 循环不足 1.95×,固定深度的 Qwen2.5 从 1.5B 到 7B 在 16× 处都接近 20% 的随机水平;显式思维链在训练范围内完美,但到 8× 时在 swap-$S_5$ 上崩溃到 0.8%。
本文的目标是本文的目标是让循环语言模型的额外迭代真正转化为解决更长问题的能力,把长度泛化形式化为建立深度-长度对应:第 $k$ 次迭代应持有前 $k$ 步操作后的中间状态 $z_k$,使迭代序号与任务阶段一一对应;同时用 RMS 范数锚定保持步进映射平稳,使同一权重块可被外推调用数百次而不漂移。量化目标是在 swap-$S_5$ 协议(训练 $\le 32$ 步)上实现 16× 外推——512 步处 full-state 准确率 95% 以上。此外还要解决两个配套问题:不依赖给定问题长度 $L$ 的自主停机(learned halting),以及在没有中间步标签的真实数据上也能诱导出对应关系(前缀自蒸馏),从而使方法不止于合成任务。
与已有工作不同的是,已有工作的切入点各有局限:Fan 等把循环次数与输入长度绑定但未定义每次迭代算什么;Shapiro 用每循环的中间监督让预训练模型做连续规则查找,但无锚定时外推约 1.8×;Chen 的逐步最终答案监督损害组合外推;RLT 靠 token 级反馈在 swap-$S_5$ 的 16× 处只有 55.7%。本文的独特之处有三:第一,把失败原因统一诊断为一对“孪生失败模式”——状态尺度漂移与未对齐的循环目标,并用受控消融证明两者缺一不可(Table 7 中第 1/2/5 行分别复现了 Chen、Fan、Shapiro 的配方,此前工作没做过这种隔离实验);第二,停机不需要 ACT 或 PonderNet 式的专用模块与 ponder 损失,复用现有输出头即可;第三,利用合成任务“前缀即合法短题”的结构,仅用最终答案标签经自蒸馏诱导出对应关系,把方法推向无中间标签的现实数据。
核心方法
PAR 的直觉是:让循环的第 $k$ 次迭代“值班”第 $k$ 步任务操作,并保证这个值班函数在迭代次数增加时保持不变。架构上,把 Qwen2.5-0.5B 的 24 层切成前导层 $P$(1–8 层)、权重绑定核心 $C$(9–16 层)与输出层 $Q$(17–24 层),核心按 $s_k = C(W[e; s_{k-1}])$ 迭代 $R$ 次,适配器 $W$ 初始化为 $[0|I]$,保证 $R{=}1$ 时与父模型等价。训练上,损失 $\mathcal{L}_{PAR} = \sum_{k \in K} \mathrm{CE}(Q(s_k), z_{\min(ck,d)})$,即第 $k$ 次迭代预测前 $k$ 步后的答案。稳定性上,每次迭代后执行 RMS 范数锚定 $s_k \leftarrow s_k \cdot \mathrm{rms}(s_1)/\mathrm{rms}(s_k)$;长 prompt 场景还需位置拉伸微调。推理上,输出层额外预测完成与否(Yes/No),配合“6 of 8”确认窗口自主停机;无中间标签时用前缀自蒸馏替代 $z_k$。
核心创新是把“深度-长度对应”当作可监督的训练目标,并识别出维持它需要的两个互补条件。已有方法要么只问最终答案——每次迭代都被要求输出 $z_d$,早期迭代被迫抢答、损失奖励不随 $d$ 缩放的捷径;要么给了中间目标却任由步进映射漂移——状态尺度随迭代变化,同一块权重重复应用时计算的已不是同一个函数。PAR 同时满足两者:进度对齐目标 $\mathrm{CE}(Q(s_k), z_{\min(k,d)})$ 给每次迭代定义明确职责,使所需迭代数随 $d/c$ 增长;RMS 范数锚定把状态幅度固定在第一次迭代的参考值上,让步进映射平稳可复用。消融证明缺一不可:只对齐进度不锚定时 $G \approx 1.8$;只锚定不进展对齐(每 $d$ 次迭代给 $z_d$)时最好种子 8×、其余 <4×,256 深度平均只有 26.8%;两者结合才在所有种子上达到 $G=16$。另一个亮点是把完成检测纳入对应关系本身:“是否完成”是迭代序号与问题的函数,因此可直接监督,无需额外参数。
方法步骤详情
第一步,改造模型:$e=P(x)$,$s_0=e$,核心迭代 $s_k=C(W[e;s_{k-1}])$,仅最后 8 次迭代回传梯度。第二步,进度对齐训练:对每个 $k$ 做 $\mathrm{CE}(Q(s_k),z_{\min(ck,d)})$($c{=}1$);默认 forced depth 取 $R=\lceil d/c\rceil$,hold 调度重尾采样、超出后持有 $z_d$。第三步,范数锚定:$s_k$ 缩放至 $\mathrm{rms}(s_1)$(stop-gradient 参考)。第四步(按需),位置拉伸:微调时位置索引乘 $s\sim U[1,s_{\max}]$。第五步,学习停机:$c_k\ge d$ 时对 Yes/No 做类平衡交叉熵;测试取首个 $P(\mathrm{Yes})>0.5$ 的 $R$,8 迭代内 6 个确认后读出。第六步(无标签),前缀自蒸馏:完成迭代对 $z_d$ 做 CE,早期迭代 KL 匹配 EMA 教师的前缀答案分布,配深度课程最佳。最后 AdamW($2\times10^{-5}$)、200 步预热、单 epoch 40 万样本。
技术新颖性
新颖性体现在四个层面。概念层面:首次把循环模型的长度外推形式化为“深度-长度对应”的建立,并指出状态漂移与目标未对齐这对孪生失败模式——此前的 retrofit(McLeish 等)、recurrent depth(Geiping 等)、per-loop 监督(Shapiro)各自观察到部分现象但未做此统一诊断。机制层面:RMS 锚定与位置拉伸分别消除随迭代和随绝对位置的漂移,使步进映射成为“平稳算子”;这与随机化位置编码改善序列泛化不同,此处是为了让深度方向的重复复合稳定。工程层面:零参数停机,复用现有 coda 头预测完成,不需要 ACT/PonderNet 的专用模块或 ponder 损失;“6 of 8”确认规则在鲁棒与灵敏之间折中,与 oracle 停机差距仅 1.6 个百分点以内。数据层面:前缀自蒸馏借鉴 mean-teacher 一致性,把“前缀即短题”的任务结构转化为训练信号;Table 9 显示 live student + 深度课程是最优教师配置($d{=}256$ 达 85%)。
实验结果
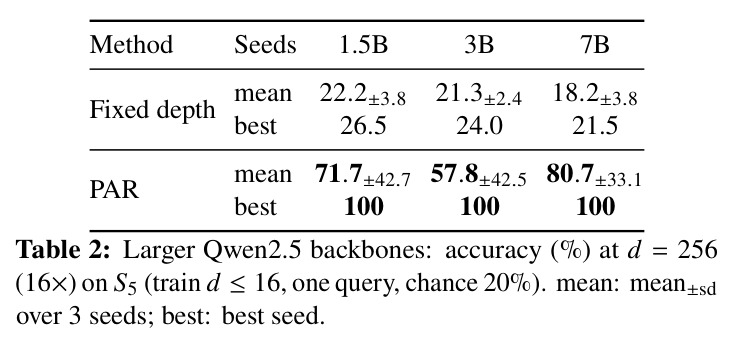
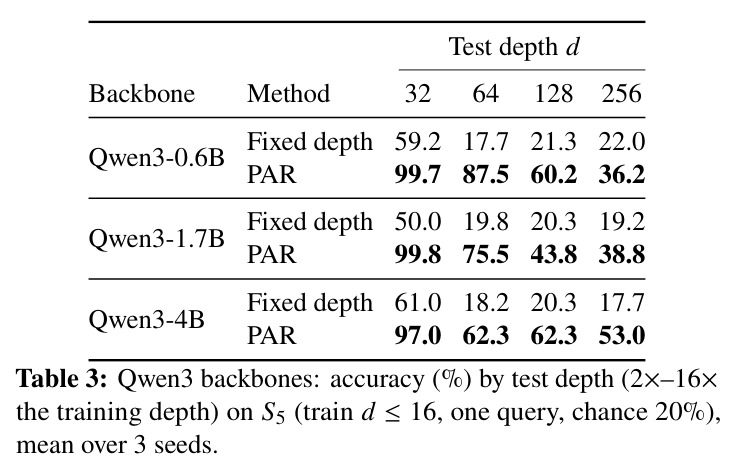
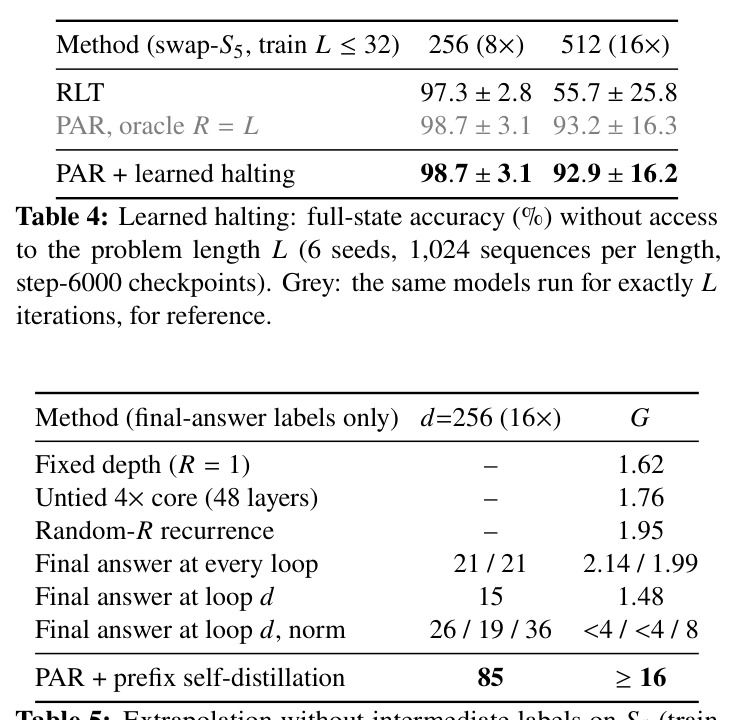
Table 1:swap-$S_5$ 上 PAR 在 512 步(16×)达 95.5±11.0%,6 种子均超 RLT 均值 55.7%,Transformer/CoT 仅 0.85%/0.8%;$S_5$/$A_5$ 上 2×/4×/8× 为 100/100/99.3%、$G{=}16$ 全种子成立,而各基线 $G$ 均不足 2。Table 2/3:Qwen2.5 1.5B–7B 最佳种子 16× 全 100%(固定深度≤26.5%;种子标准差 33–43);Qwen3 上 PAR 全面占优(4B 16× 处 53.0% vs 17.7%)。Table 4:“6 of 8”停机 92.9%,与 oracle 93.2% 仅差 0.3。Table 5:前缀自蒸馏是唯一成功的无标签配方(16× 处 85%、$G{\ge}16$,其他方案≤8×)。Table 6:规则链 $G{\ge}8$(64 步 94%)、图可达性全部<3.5×、BBH 任务 64 步 79%(基线≤21%)。消融:去锚定 $G{<}2.2$;位置拉伸把无标签 16× 拉至 99.7%;吸收态训练 16×<1%。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| swap-$S_5$(训练≤32步,16×=512步) | full-state 准确率 (%) | 95.5±11.0(8× 处 99.5±1.2) | RLT 55.7±25.8;Transformer 0.85;显式 CoT 0.8 | 较最强基线 RLT 提升 39.8 个百分点,且全部 6 个种子超过其均值 |
| $S_5$ 单查询(训练 d≤16,测试到 256) | 准确率 (%) 与外推因子 G | 2×/4×/8× 处 100/100/99.3,G=16(3 个种子全部) | 固定深度 G=1.62;48 层解绑核心 G=1.76;随机 R G=1.95;显式 CoT 2× 处仅 12% | 外推因子从不足 2× 提升到 16× |
| $A_5$(训练 d≤16) | 外推因子 G | 16(2 个种子全部) | 固定深度 G=1.32 | 约 12 倍提升 |
| 规则表链(Shapiro 基准,≤8→64) | 外推因子 G | PAR-hold ≥8(64 步处 94%),PAR 6.0 | 无锚定前缀目标 1.78;每循环最终答案 1.45 | 约 4.5 倍提升 |
| 图可达性(Chen 基准,≤5→24 跳) | 外推因子 G | PAR 2.6(各配方均<3.5×) | 最终答案@循环d 3.3;无锚定前缀 3.45 | 无优势:任务靠并行扩展前沿求解,无规范中间状态,超出方法适用范围 |
| BBH 风格自然语言换物(训练≤16步) | 准确率 (%) | 32 步 94–96%,64 步 79%(PAR-hold+位置拉伸) | 随机 R/固定深度+同拉伸:32 步≤67%,64 步≤21% | 64 步处提升约 58 个百分点 |
| 自主停机(swap-S5,不给长度 L) | full-state 准确率 (%),16× | 92.9±16.2(6 of 8 规则) | oracle R=L 93.2±16.3;单次迭代 77.8±25.7;8 连确认 90.3±16.4 | 与 oracle 仅差 0.3 个百分点 |
| 无中间标签($S_5$,仅最终答案,d=256) | 准确率 (%) | 85(前缀自蒸馏,G≥16) | 每循环最终答案 21;第 d 循环 15;加 norm 26/19/36 | 唯一在 16× 保持高准确率的无标签配方 |
局限与改进
作者明说的局限:实验限于中间状态良定义的算法化、模板化任务,开放式自然语言推理未触及;无顺序分解的任务(如图可达性)落在范围之外;缩放研究只在单查询 $S_5$ 上覆盖 Qwen2.5 至 7B、Qwen3 至 4B 各三个种子,而 learned halting、前缀自蒸馏与 swap-$S_5$ 协议只在 Qwen2.5-0.5B 上评估。我的补充观察:第一,大模型上种子方差极大(16× 处标准差 33–43 个点,Qwen2.5-3B 均值仅 57.8±42.5%),且准确率不随模型尺寸单调上升,Qwen3 系列无一在 16× 接近 0.5B 的 95.5%;第二,PAR-hold 本身只有 $G{=}16/12$、准确率 75/30%,一致性明显弱于 forced depth;第三,forced depth 训练需要知道真实步数 $d$,推理停机虽已解决,训练管线仍依赖任务结构知识;第四,位置拉伸是对绝对位置编码非平稳性的补救而非根治,部分种子微调后还出现轻微精度回退;第五,停机规则超参 $\tau{=}0.5, k{=}6, m{=}8$ 靠经验选择,跨任务迁移性未知。
独立分析的弱点
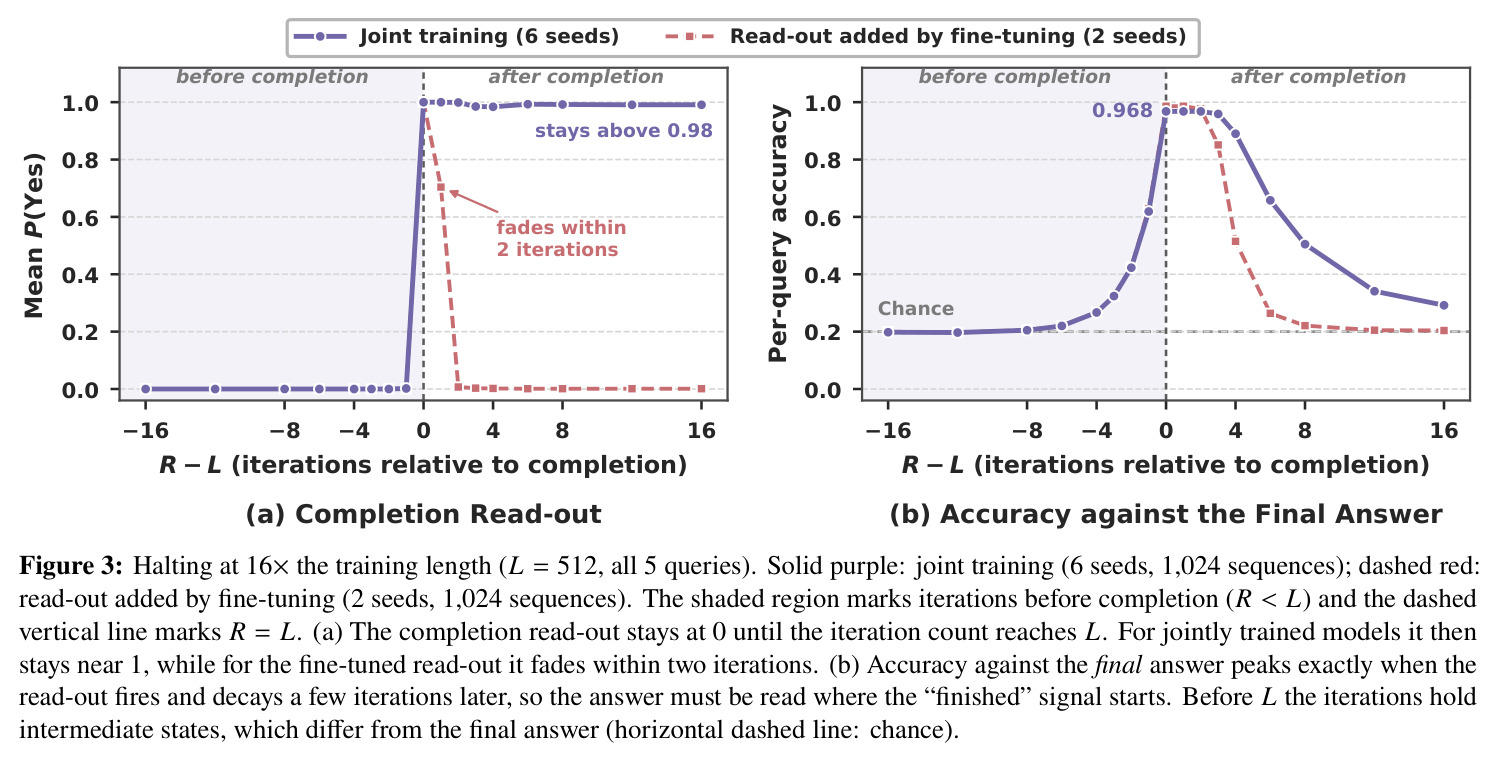
独立分析出的弱点及改进方向。其一,训练稳定性:最佳组合在 hold 调度与更大模型上都表现出剧烈种子间波动(PAR-hold 两种子 75/30%,Qwen2.5-3B 均值 57.8±42.5%),提示需要更稳定的优化策略,如更平滑的课程、多教师集成或对锚定参考做动量估计。其二,任务结构依赖:进度对齐要求 $z_k$ 可枚举,这把方法限死在合成/模板任务;可探索用弱监督(自然语言中间步骤、程序执行轨迹)近似 $z_k$。其三,停机窗口脆弱:Figure 3b 显示答案表示在完成后几个迭代内就衰减,若确认窗口内概率波动会延迟停机;可引入基于状态变化率或自一致性的软停机信号。其四,位置编码治标不治本:绝对位置编码导致长 prompt 非平稳、需额外微调;改用相对/旋转位置并验证其在深度复合下的平稳性可能更优雅。其五,成本对比缺失:16× 次核心调用的计算开销与显式 CoT 生成长度的权衡未量化;此外消融只在 $S_5$ 上做,swap-$S_5$ 与更大骨干上的组件必要性未被单独验证。
未来方向
作者提出的方向:把对应关系推广到开放式自然语言推理;刻画大骨干上种子方差的形成机制;稳定循环缩放。基于成果可延伸的方向:第一,把前缀自蒸馏与真实 CoT 数据结合,用模型自身轨迹的前缀构造蒸馏目标,把深度外推带到数学、代码执行等半结构化任务;第二,为可并行推进的任务重定义对应关系(如图可达性需要“迭代 $k$ 对应前沿大小 $k$”式的推广);第三,利用“每个迭代都可解码出中间答案”的特性做潜在推理的可视化与审计,回应隐式推理不如思维链透明的伦理顾虑;第四,理论层面分析 RMS 锚定下步进映射的稳定性与复合误差界,解释 16× 之外何时失效;第五,把确认窗口停机思想迁移到自适应计算时间文献,与 ACT、PonderNet、随机停机做系统对比;第六,探索步长 $c{>}1$ 与多查询设置的组合,验证每迭代多步推进的上限。
复现评估
论文未提及开源代码,但复现所需信息相当完整。数据全部合成:swap-$S_5$(训练≤32步、每长度 1024 条测试序列、五盒全对才算对)与 $S_5$/$A_5$(训练 d≤16、测试到 256)的生成规则明确,规则链与图可达性沿用公开基准。训练细节充分:AdamW 学习率 $2\times10^{-5}$(适配器 $10^{-4}$)、200 步预热、单 epoch 约 40 万样本、bf16+DeepSpeed ZeRO-2;0.5B 两张 RTX 4090/3090 即可,1.5B–7B 需八张 H200。超参齐备:停机 $\tau{=}0.5, k{=}6, m{=}8$,EMA 衰减 0.99,蒸馏迭代数 $n_k\in\{2,4\}$,位置拉伸 $s_{\max}$ 从 1 升到 8;报告 3–6 个种子的均值±标准差。难点在于位置拉伸微调依赖特定 checkpoint(step-5000/6000)且对种子敏感,教师配置需按 Table 9 逐一尝试,大模型与 hold 调度的种子方差意味着单次运行可能严重高估或低估效果。总体复现难度中等偏易,核心结果算力门槛低。
论文图表
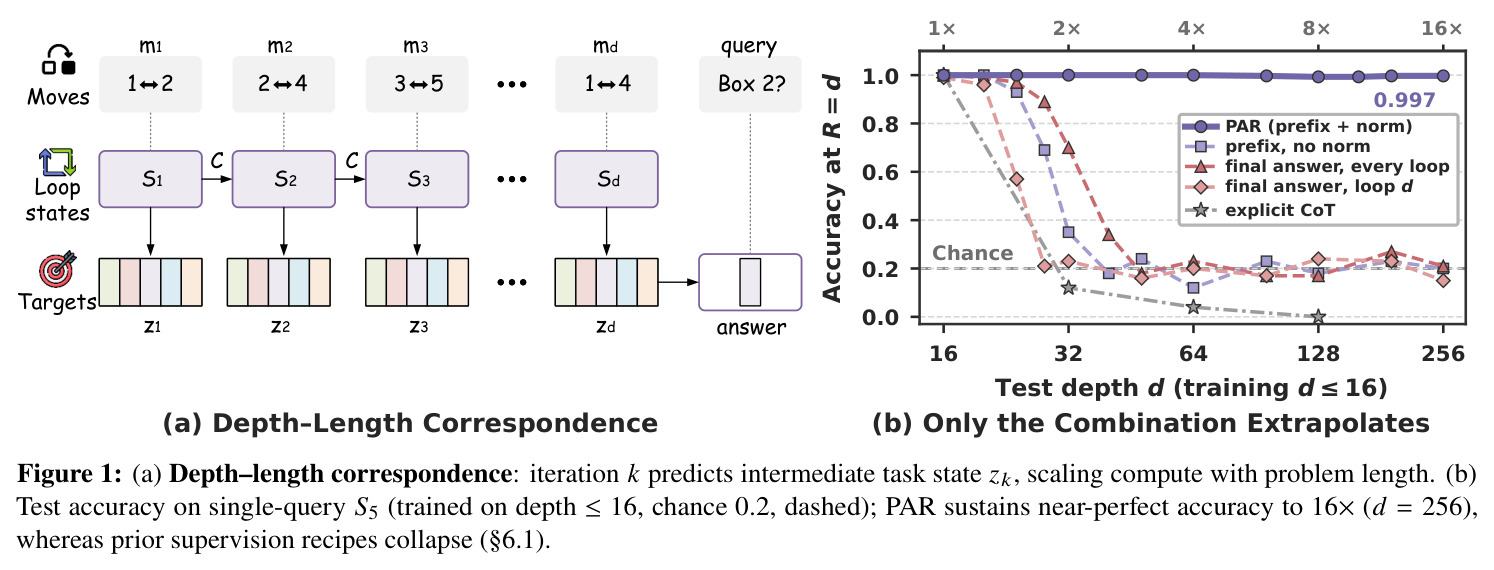
左图示意深度-长度对应:任务移动 $m_1..m_d$ 产生中间状态 $z_1..z_d$,循环状态 $S_1..S_d$ 依次与之对齐,使计算量随问题长度伸缩。右图为训练深度≤16 的单查询 $S_5$ 准确率曲线(随机水平 0.2 虚线):PAR(前缀+范数)在 16×(d=256)仍接近满分,而“每循环最终答案”“第 d 循环最终答案”“无范数前缀目标”与显式 CoT 都迅速跌到随机附近。
一张图同时给出方法的核心概念和最有冲击力的结果对比:只有“进度对齐+范数锚定”的组合能外推,任何一个组件缺席都崩溃。这是理解全文论点的入口。
汇总所有主对比:$S_5$(训练 d≤16)上 PAR 在 32/64/128 深度达 100/100/99.3%、G=16;$A_5$ 上 G=16;swap-$S_5$(训练 L≤32)上 PAR 在 256/512 步达 99.5±1.2/95.5±11.0,而 Transformer 仅 0.85、RLT 55.7±25.8、显式 CoT 0.8;固定深度、48 层解绑核心、随机 R 的 G 均不足 2。
论文的核心成绩单:所有基线对比与“16× 外推”这一头条结论都出自此表。
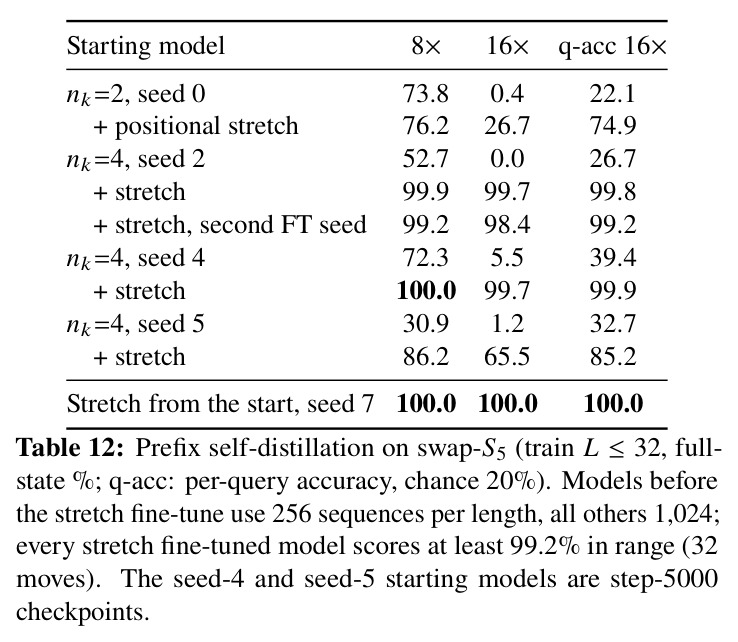
各无标签配方对比:固定深度/解绑核心/随机 R 的 G≤1.95;每循环最终答案 G=2.14/1.99;第 d 循环 1.48;加范数后 <4/<4/8;只有 PAR+前缀自蒸馏达 85%(d=256)、G≥16。
证明对应关系可以不经中间步标签、仅凭最终答案经自蒸馏诱导出来,是把方法推向真实数据的桥梁。
规则表链上 PAR-hold 达 G≥8(64 步 94%)、PAR 6.0,而无锚定前缀目标仅 1.78、每循环最终答案 1.45;图可达性上所有配方都不超过 3.5×(PAR 2.6),PAR-hold 甚至失败(预测多数类)。
划定方法的适用边界:有顺序分解的状态追踪受益,可并行求解的任务不行——这解释了方法为什么有效以及何时无效。
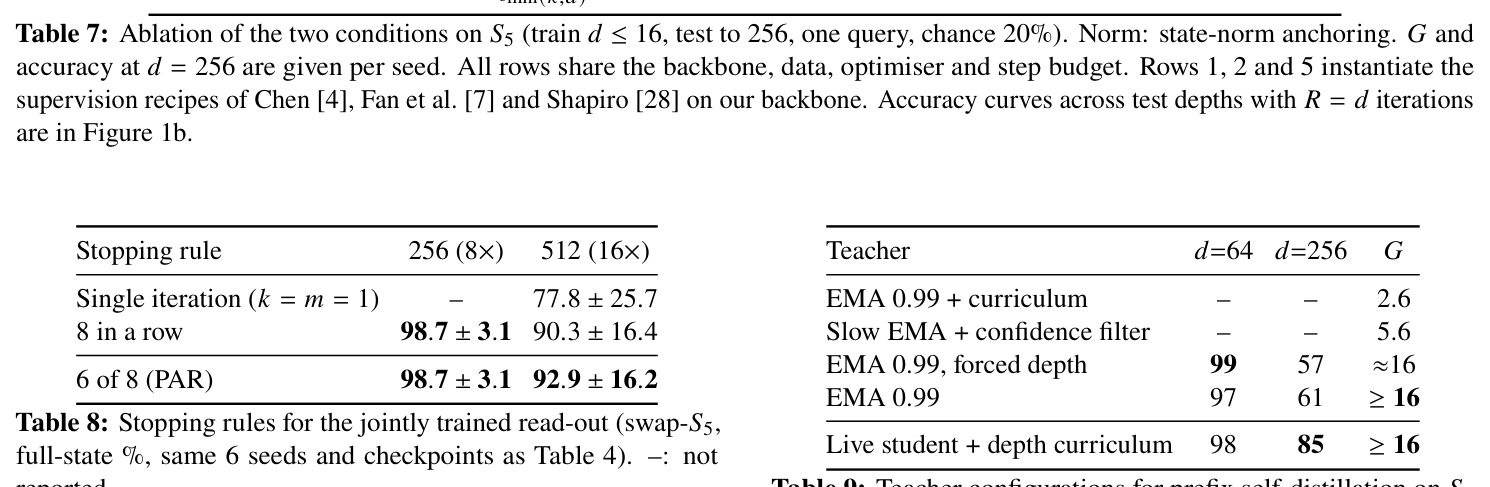
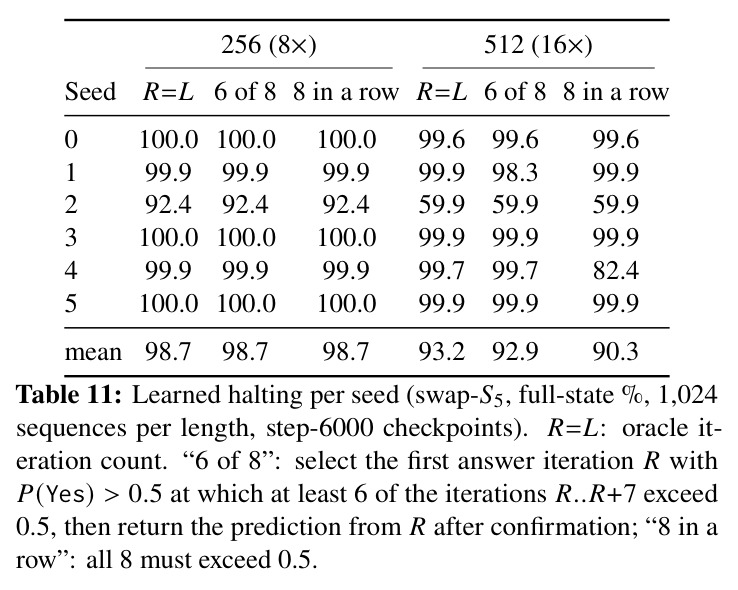
单次迭代判定 16× 处 77.8±25.7%,8 连确认 90.3±16.4%,“6 of 8” 92.9±16.2%——单次判定被瞬态概率尖峰导致提前停机,8 连过于保守延迟停机,6/8 折中最优、与 oracle 差 1.6 个百分点内。
停机规则的选型依据,说明确认窗口长度这一超参如何在鲁棒与灵敏之间权衡。
五种教师配置:EMA0.99+课程 G=2.6;慢 EMA+置信过滤 5.6;EMA 强制深度在 d=64/256 为 99/57、G≈16;EMA0.99 为 97/61、G≥16;live student+深度课程最佳 98/85、G≥16。
无标签管线的教师选型消融,直接决定 Table 5 中 85% 的结果能否复现。