循环回环Transformer(RLT) Recurrent Looped Transformer
并行编码器加逐token循环解码器,计算路径随序列增长,长度外推远超Transformer
前置知识
状态跟踪
指模型逐个读取输入符号时维护并更新一个内部状态的任务:奇偶校验每读一位就翻转奇偶位,S5 置换跟踪每读一个群元素就把当前置换与之复合。答案取决于全部历史,无法靠局部模式解决,是检验模型是否具备真正逐步计算能力的试金石。
本文的全部实验与理论动机都围绕状态跟踪展开:RLT 的设计目标就是让 Transformer 能在任意长度上执行逐步状态更新,六大算法任务全部属于这一类。
固定深度 Transformer 的表达力上限
Transformer 每个位置只经过固定数量的层,计算可归入复杂度类 $TC^0$。Merrill 等人(2024)证明:除非 $TC^0 = NC^1$(主流复杂性理论认为不成立),固定深度 Transformer 无法在任意长输入上求解 S5 置换复合这类需要线性深度计算的问题。
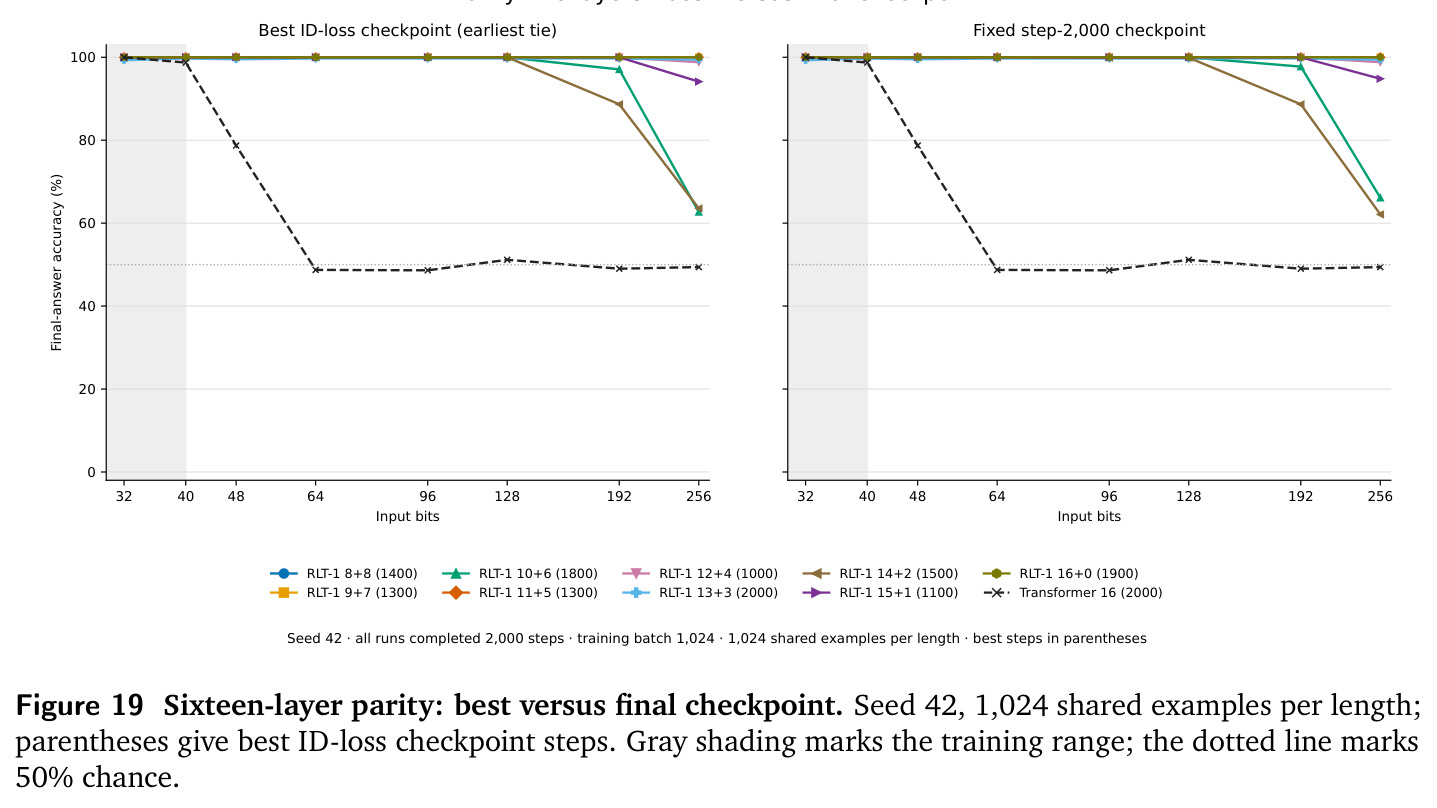
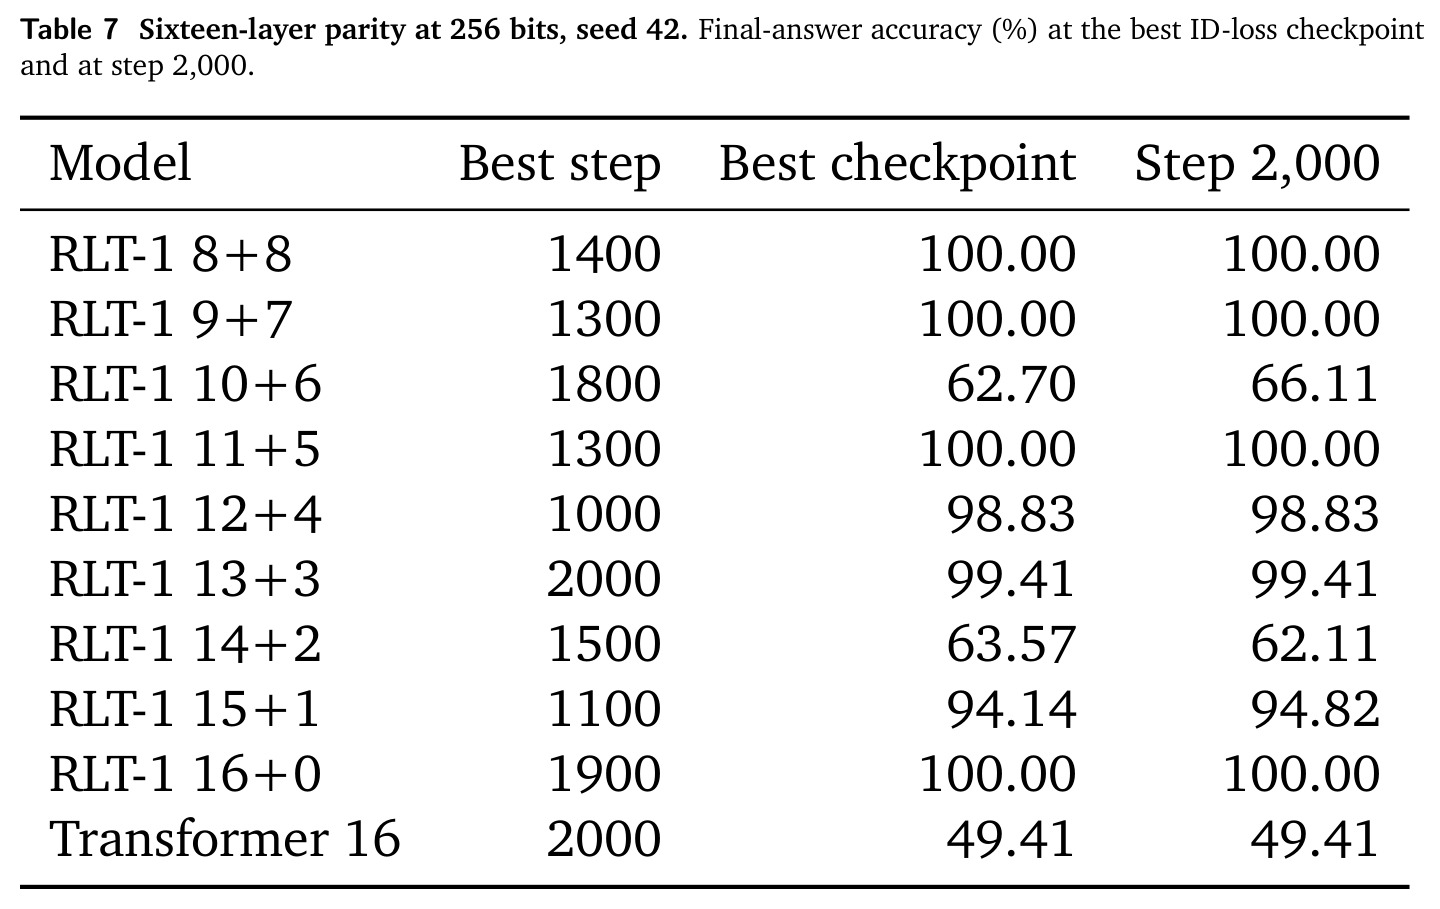
这解释了为什么 8 层基线 Transformer 在 256 比特奇偶校验上只有约 50% 准确率,也说明改进必须来自'计算路径随序列增长'这一结构性变化,而非加数据或调参。
KV 缓存与滑动窗口注意力(SWA)
自注意力需要每个位置的 Key/Value 投影,推理时将其缓存以避免重算。SWA 只保留最近 $W$ 个位置的 KV(本文 $W=8$),与读取全前缀的交叉注意力配合,形成'短程局部+长程全局'的混合记忆结构。
RLT 的完整状态 $H_t = (s_t, \mathcal{C}^D_t)$ 由最终输出 $s_t$ 和各层 SWA 缓存组成,理解缓存机制是理解状态定义、增量解码与提示-响应切分不变性的前提。
门控合并
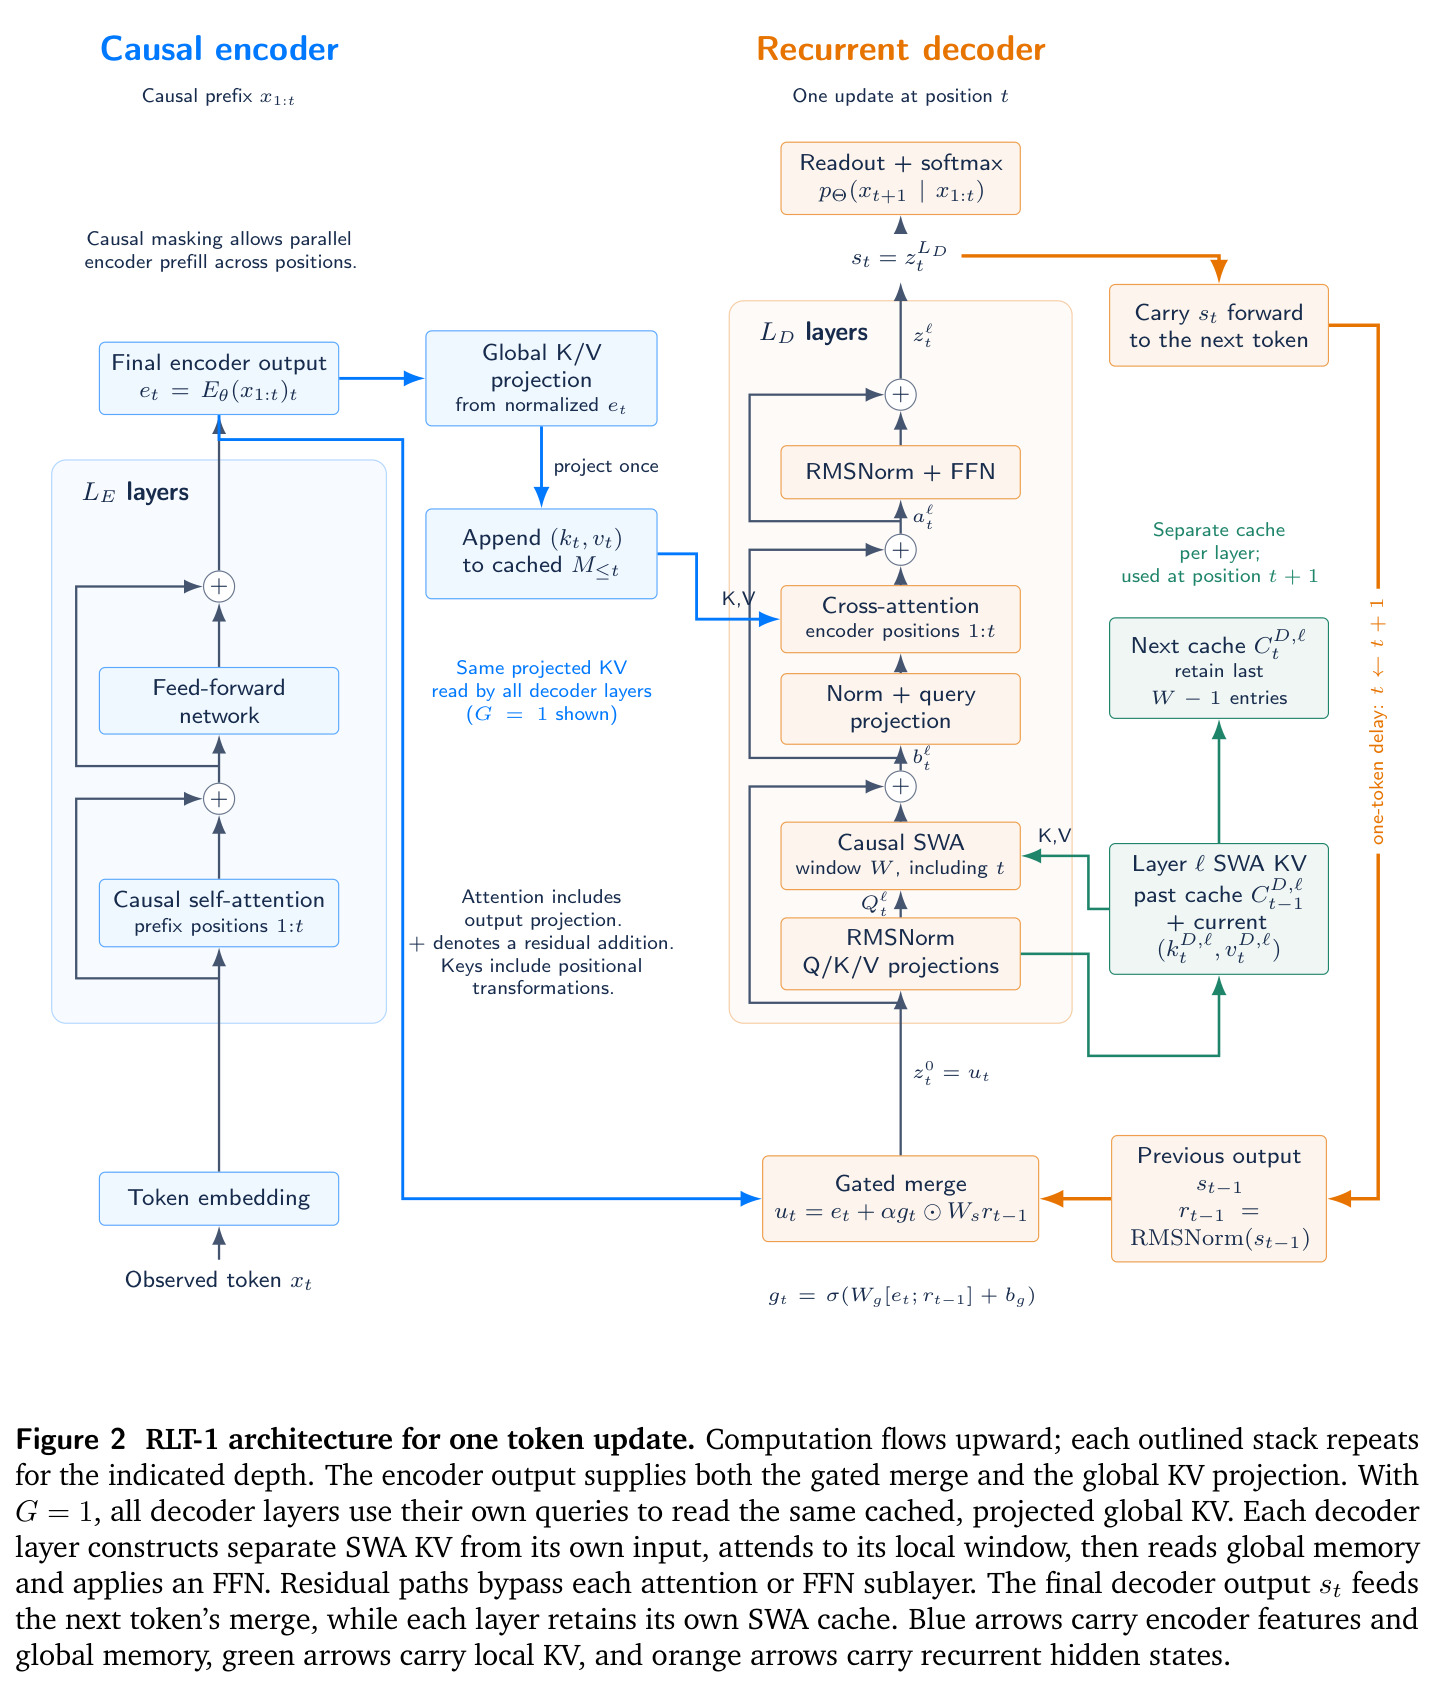
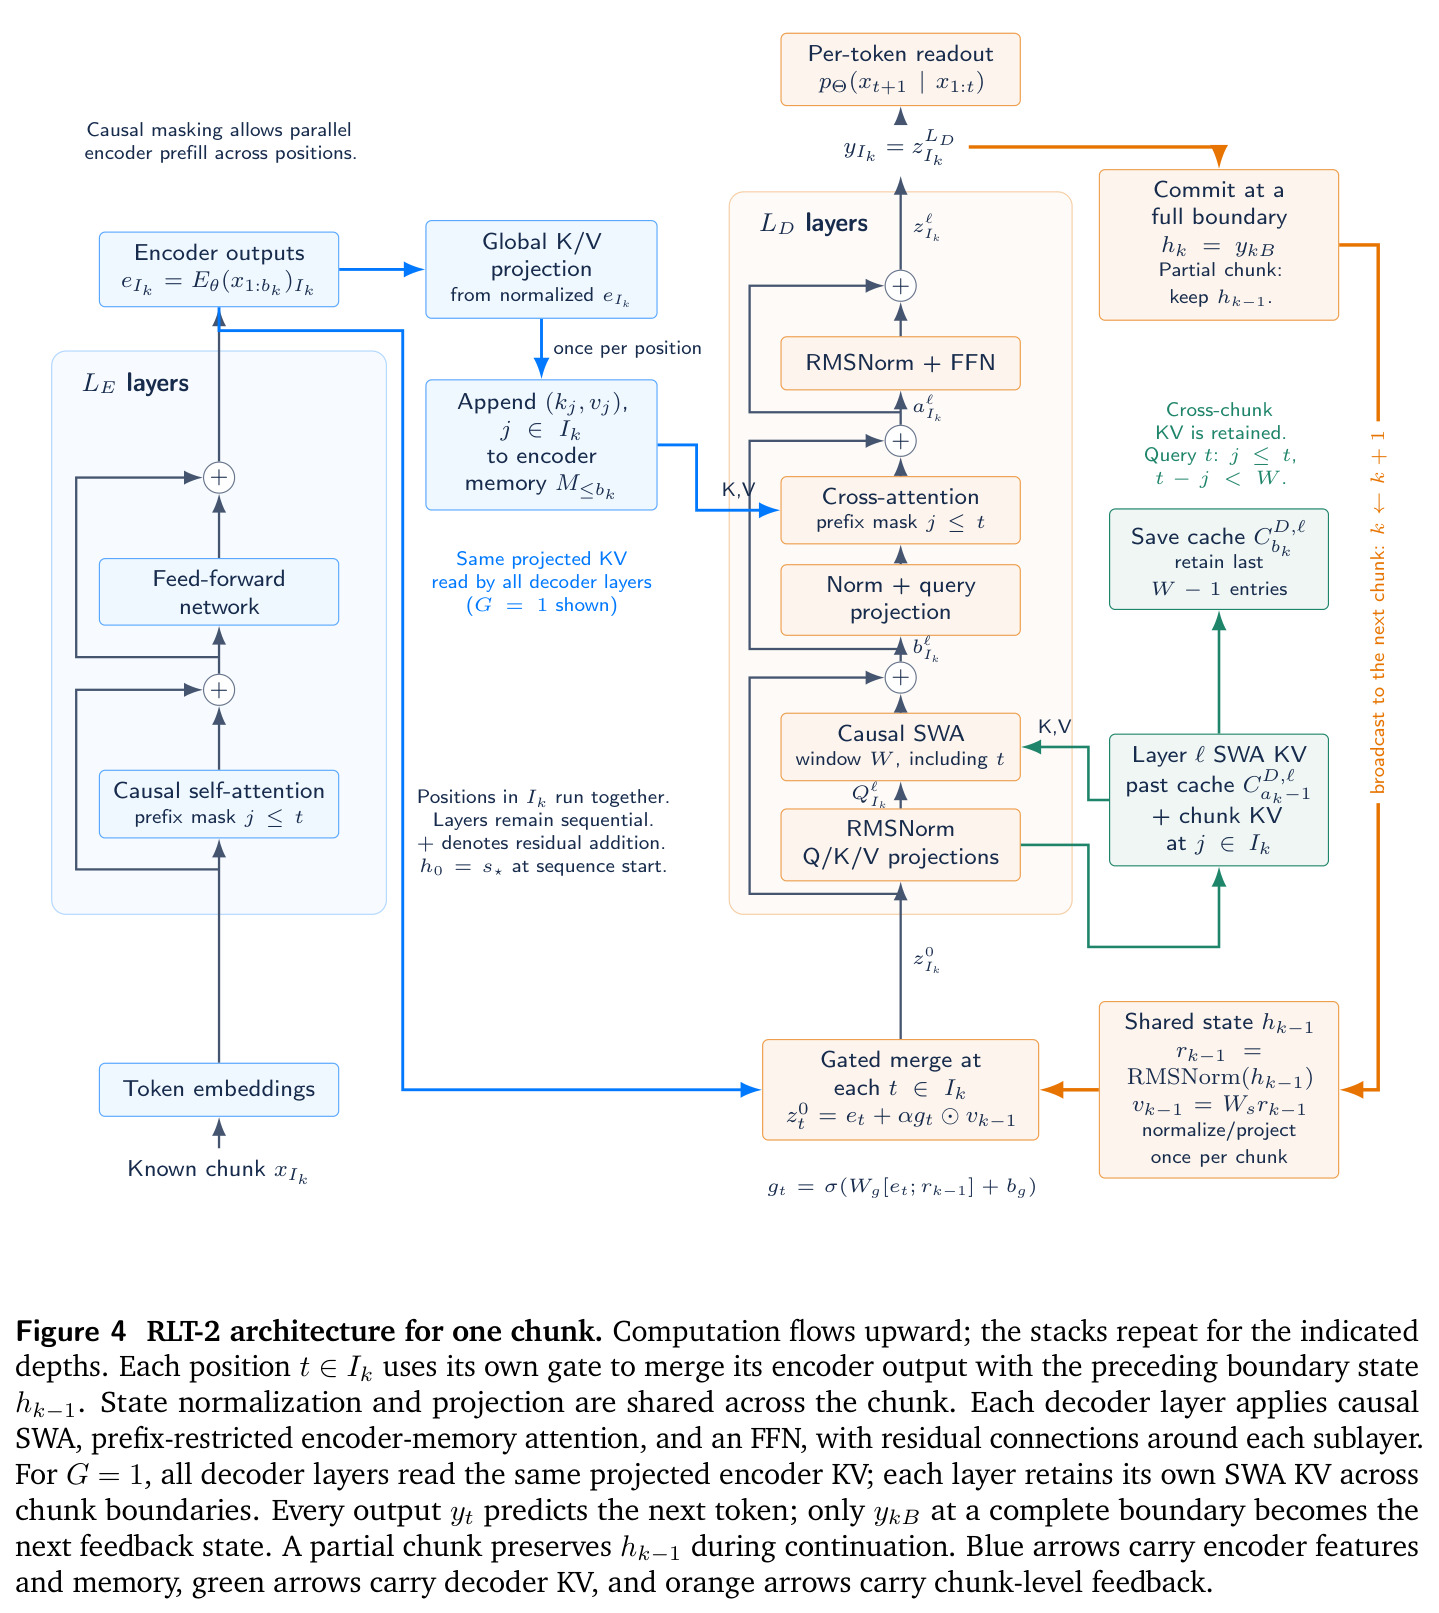
用可学习的门控制信息流混合比例:$g_t = \sigma(W_g[e_t; r_{t-1}] + b_g)$ 逐维决定保留多少反馈状态,合并为 $u_t = e_t + \alpha\, g_t \odot W_s r_{t-1}$,其中 $\alpha = 0.1$ 控制反馈整体尺度。该思路源自 LSTM/GRU 的门机制。
门控合并是 RLT 反馈回路的入口,消融实验显示去掉反馈后所有长度泛化收益消失,读懂这个公式才能理解状态如何在 token 之间流动。
BPTT 与 TBPTT
随时间反向传播(BPTT):对循环网络沿时间展开计算图再求梯度;截断版 TBPTT 只回传最近若干步,用内存换训练可行性。本文用 TBPTT 窗口 128 且覆盖全部训练序列,相当于完整 BPTT,梯度能穿过整个循环历史。
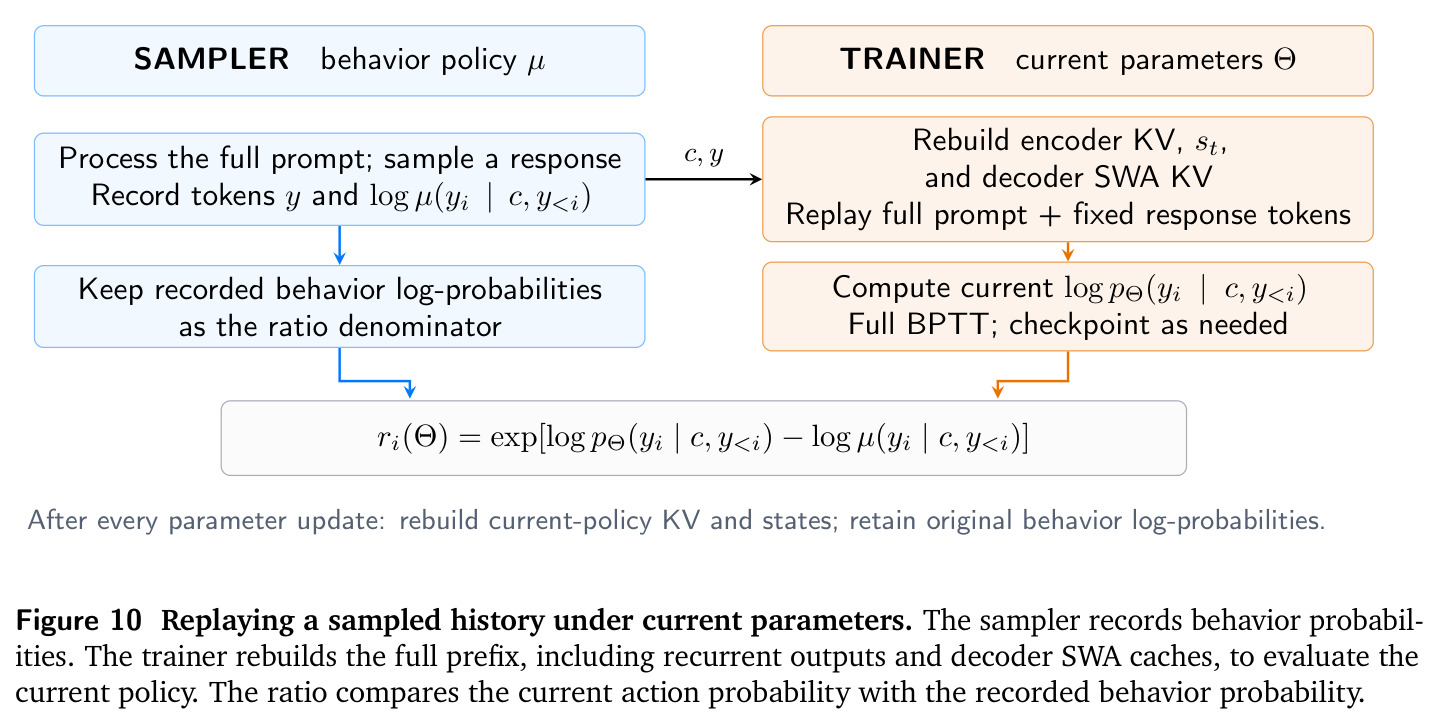
RLT 的循环依赖跨越整个解码器堆栈,反馈能否被学出来取决于梯度能否穿过长循环链,这是理解其训练设置与 RL 精确策略重放的关键。
长度泛化
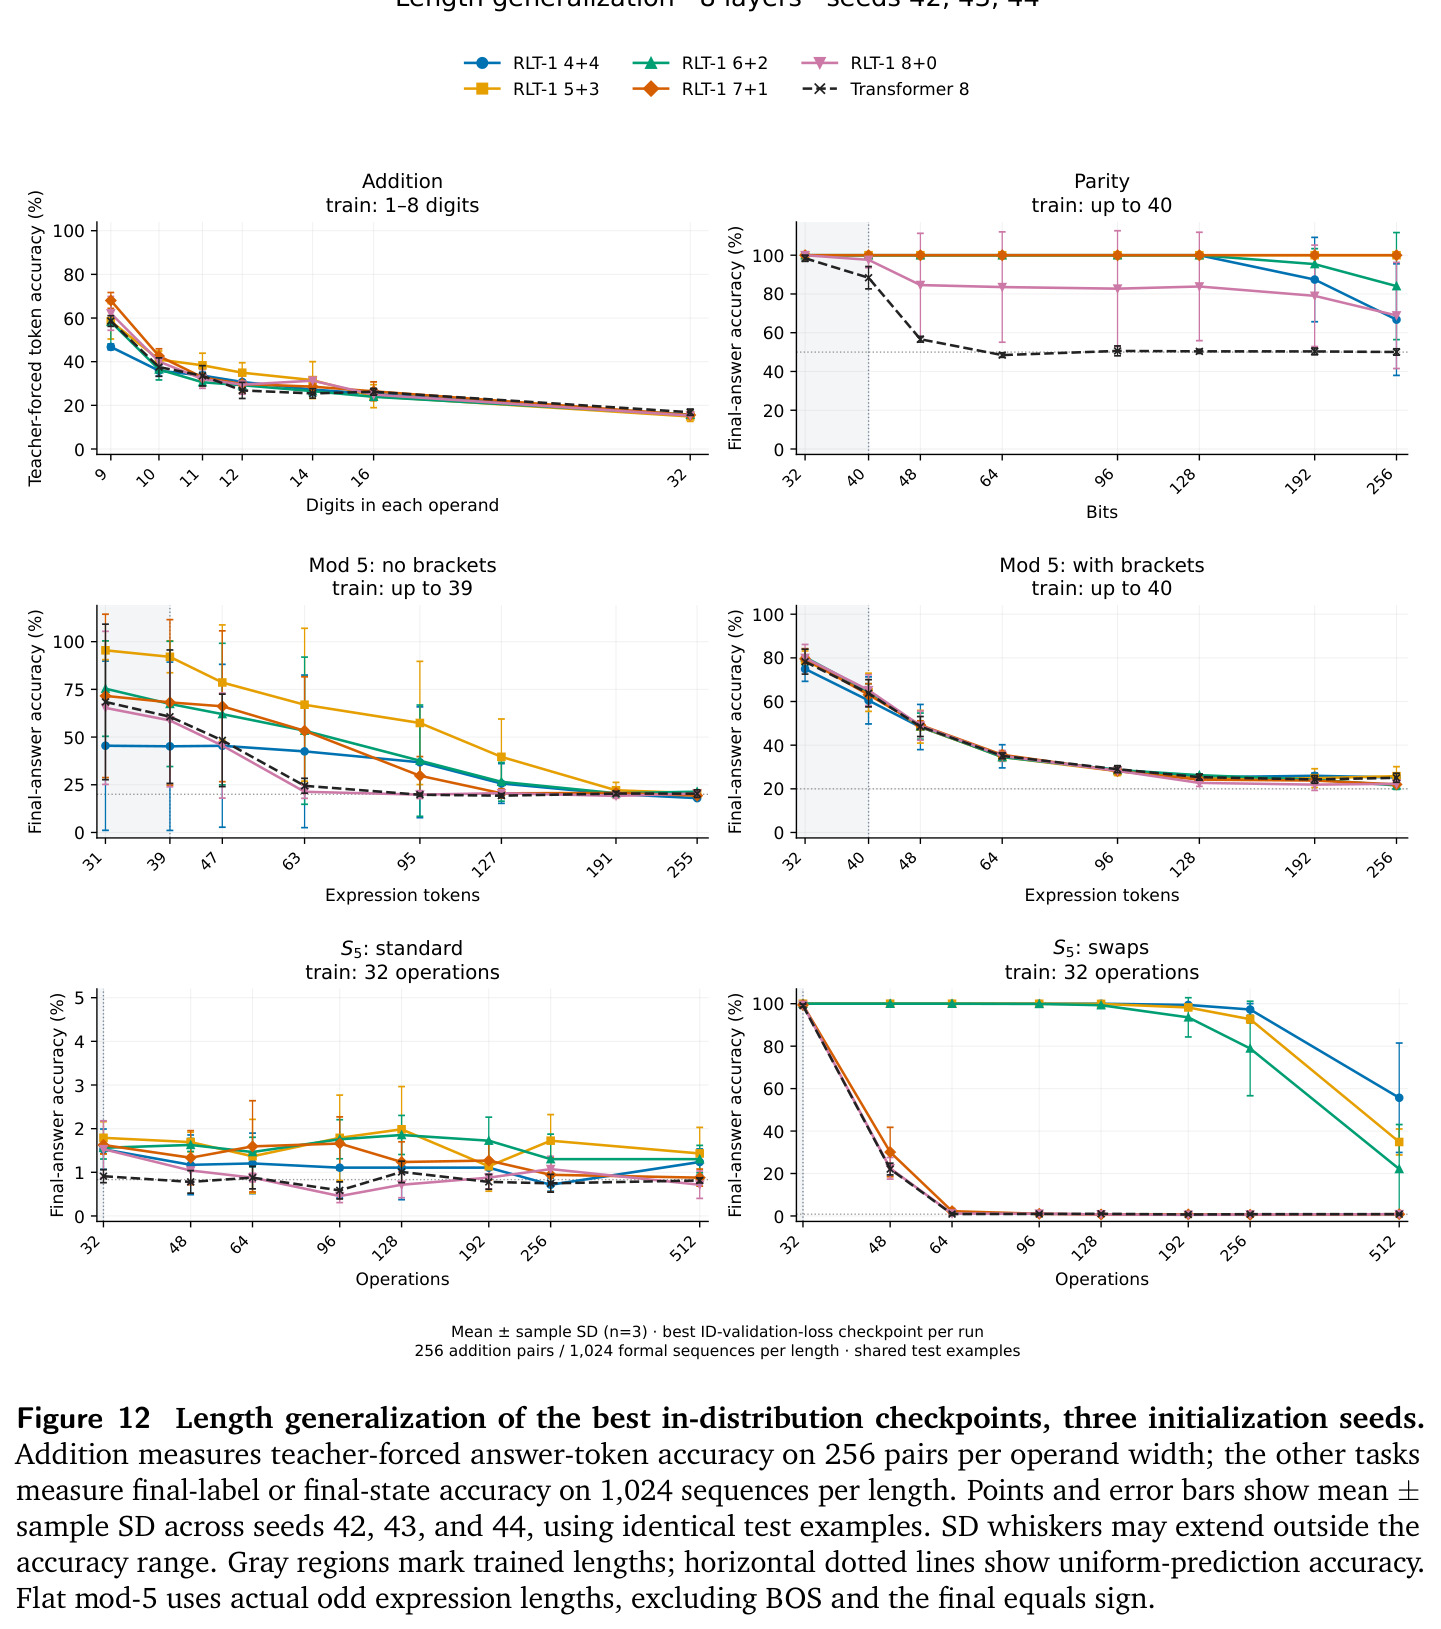
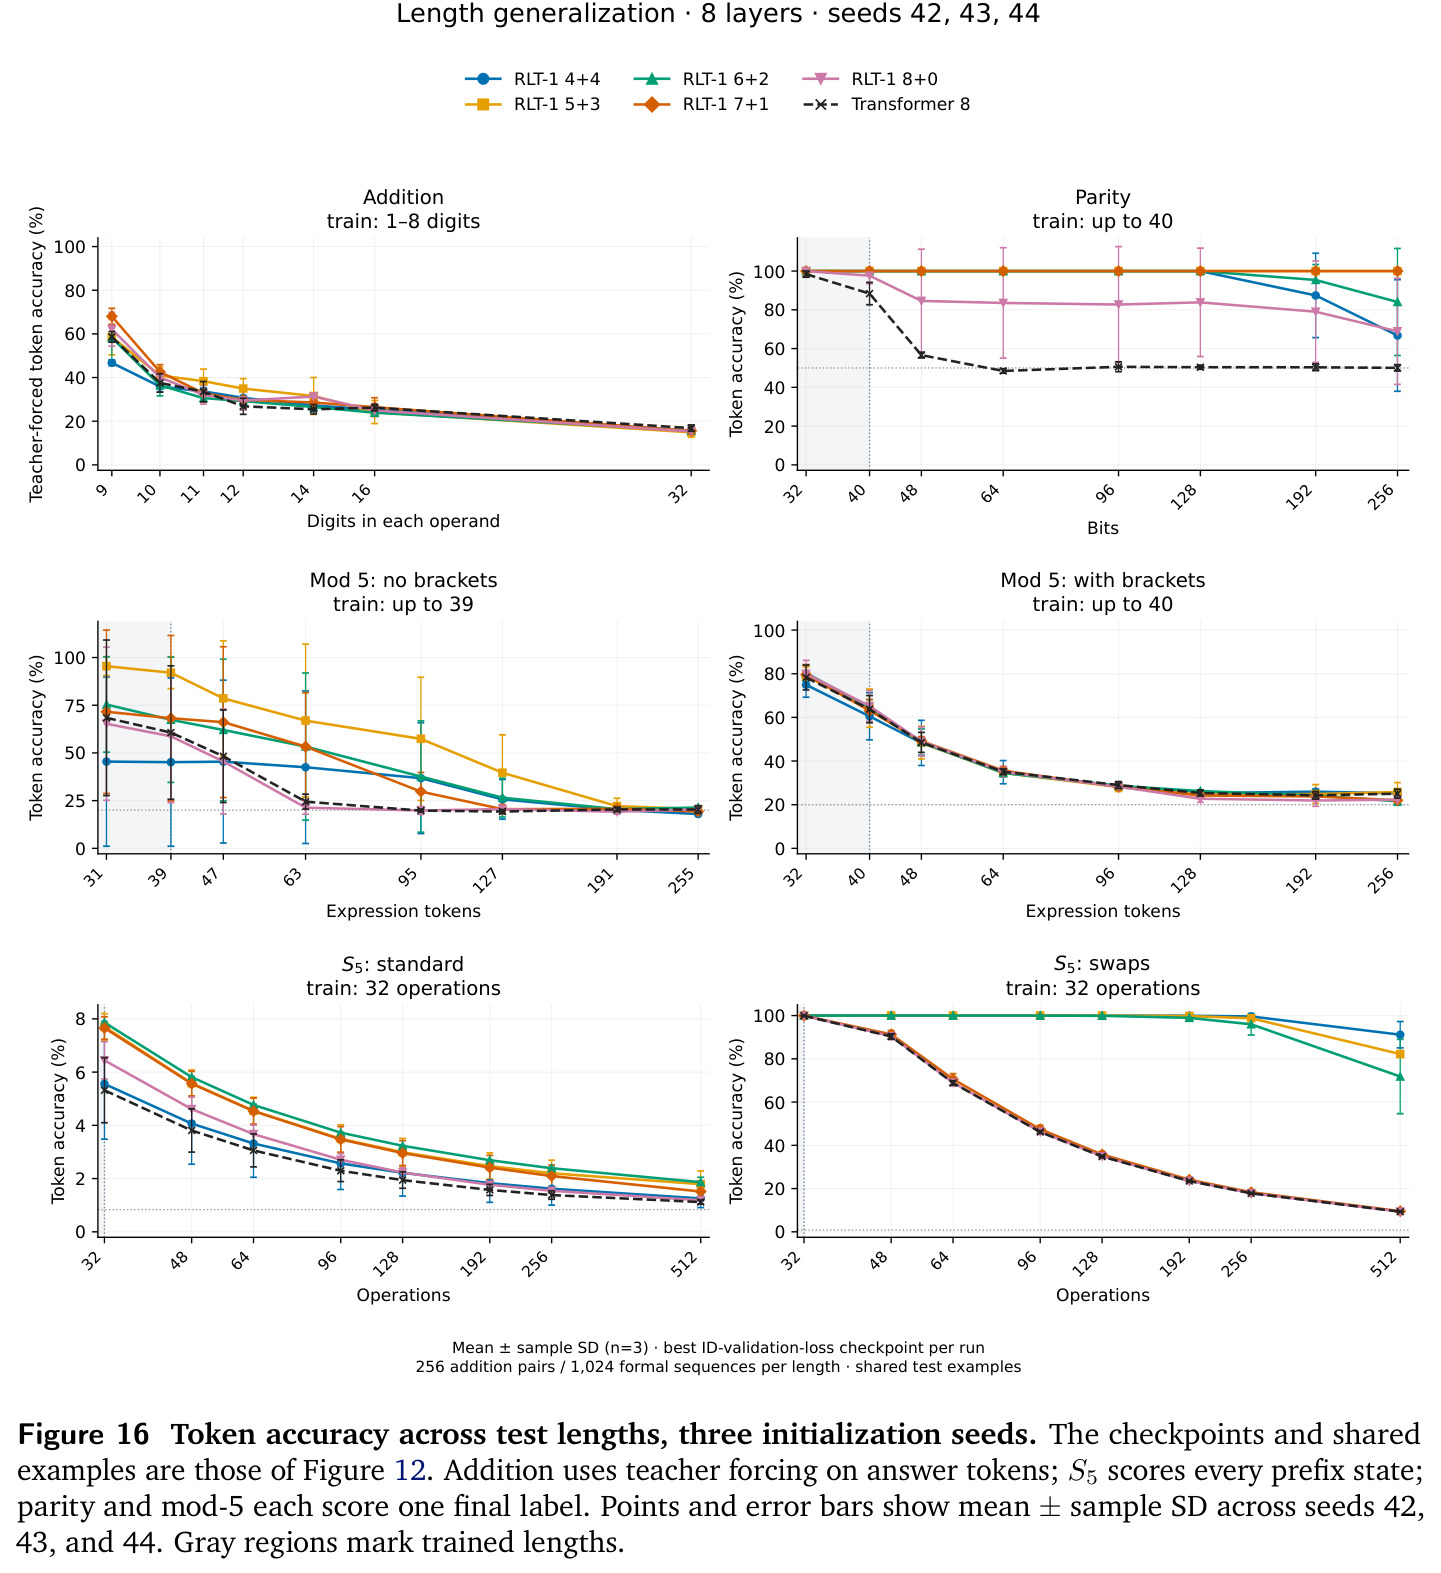
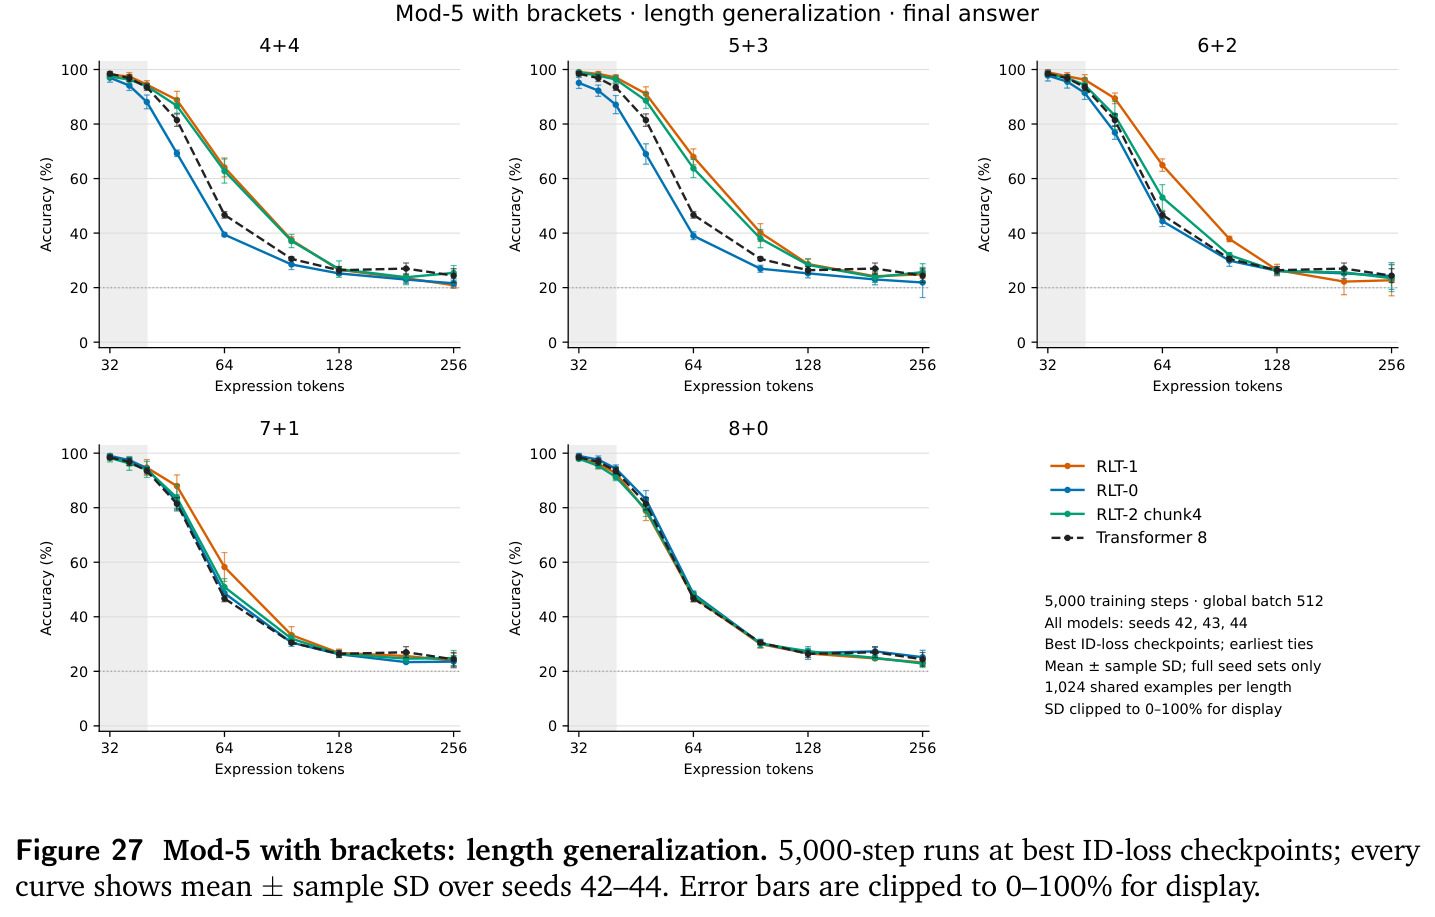
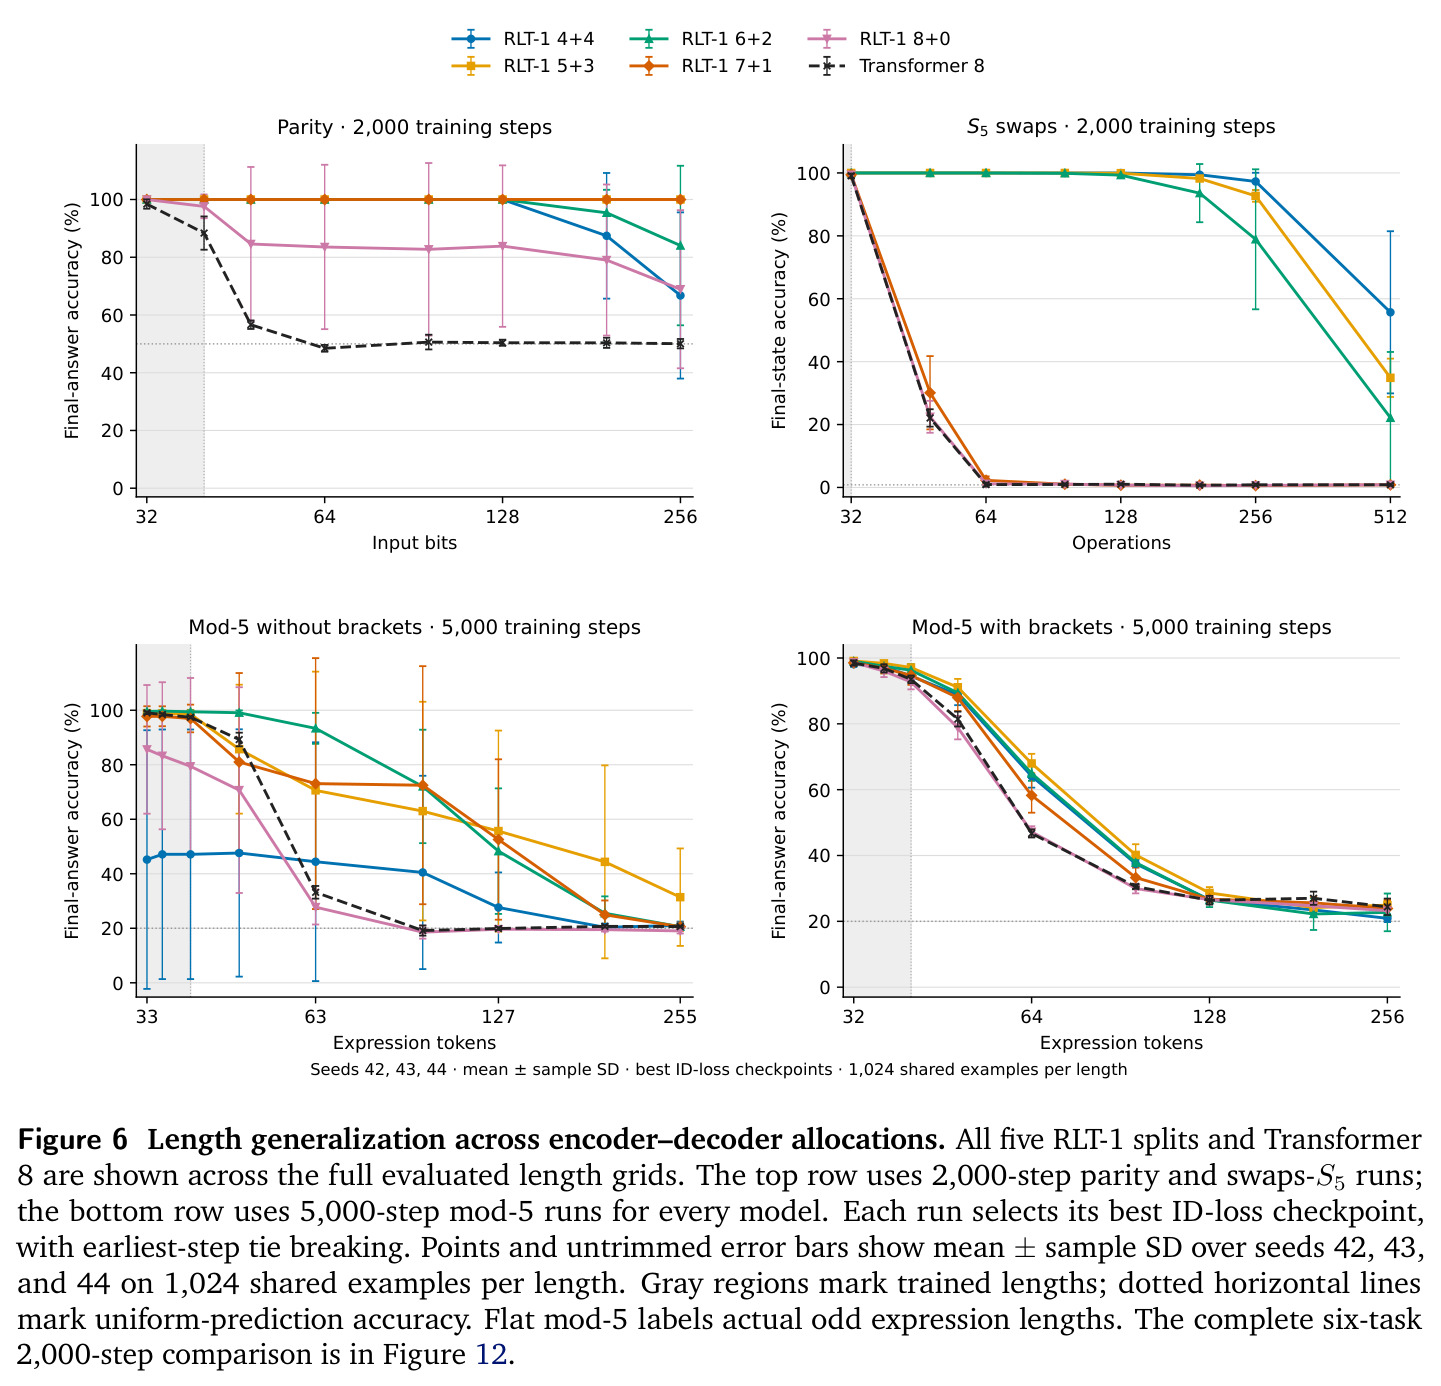
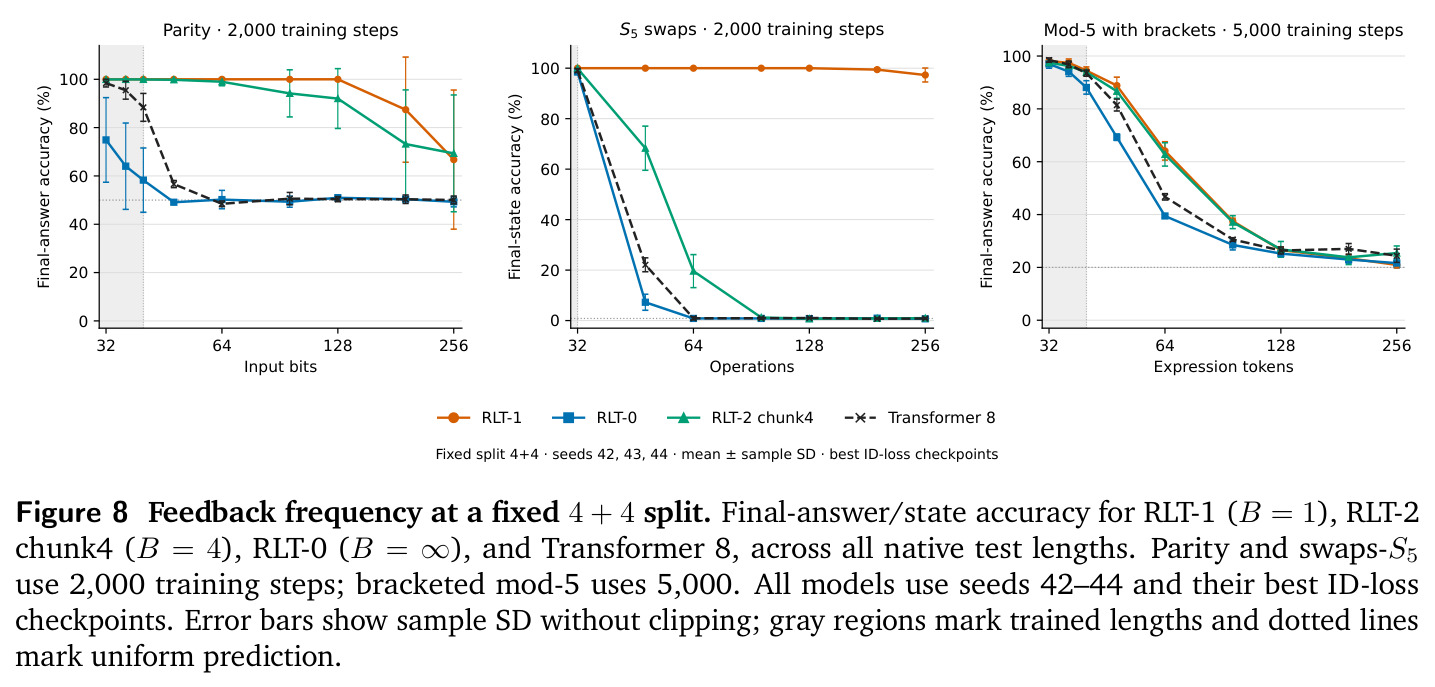
模型在短序列上训练后能否在更长序列上保持准确率。经典 Transformer 通常外推失败,因为它从未经历'计算路径超过层数'的情形;评测时按长度画准确率曲线,灰色区域标记训练长度,虚线标记均匀猜测参考线。
长度泛化曲线(如训练 3-40 比特、测试 256 比特)是本文的主实验设计,也是判断架构是否真正获得循环计算能力的核心标准。
研究动机
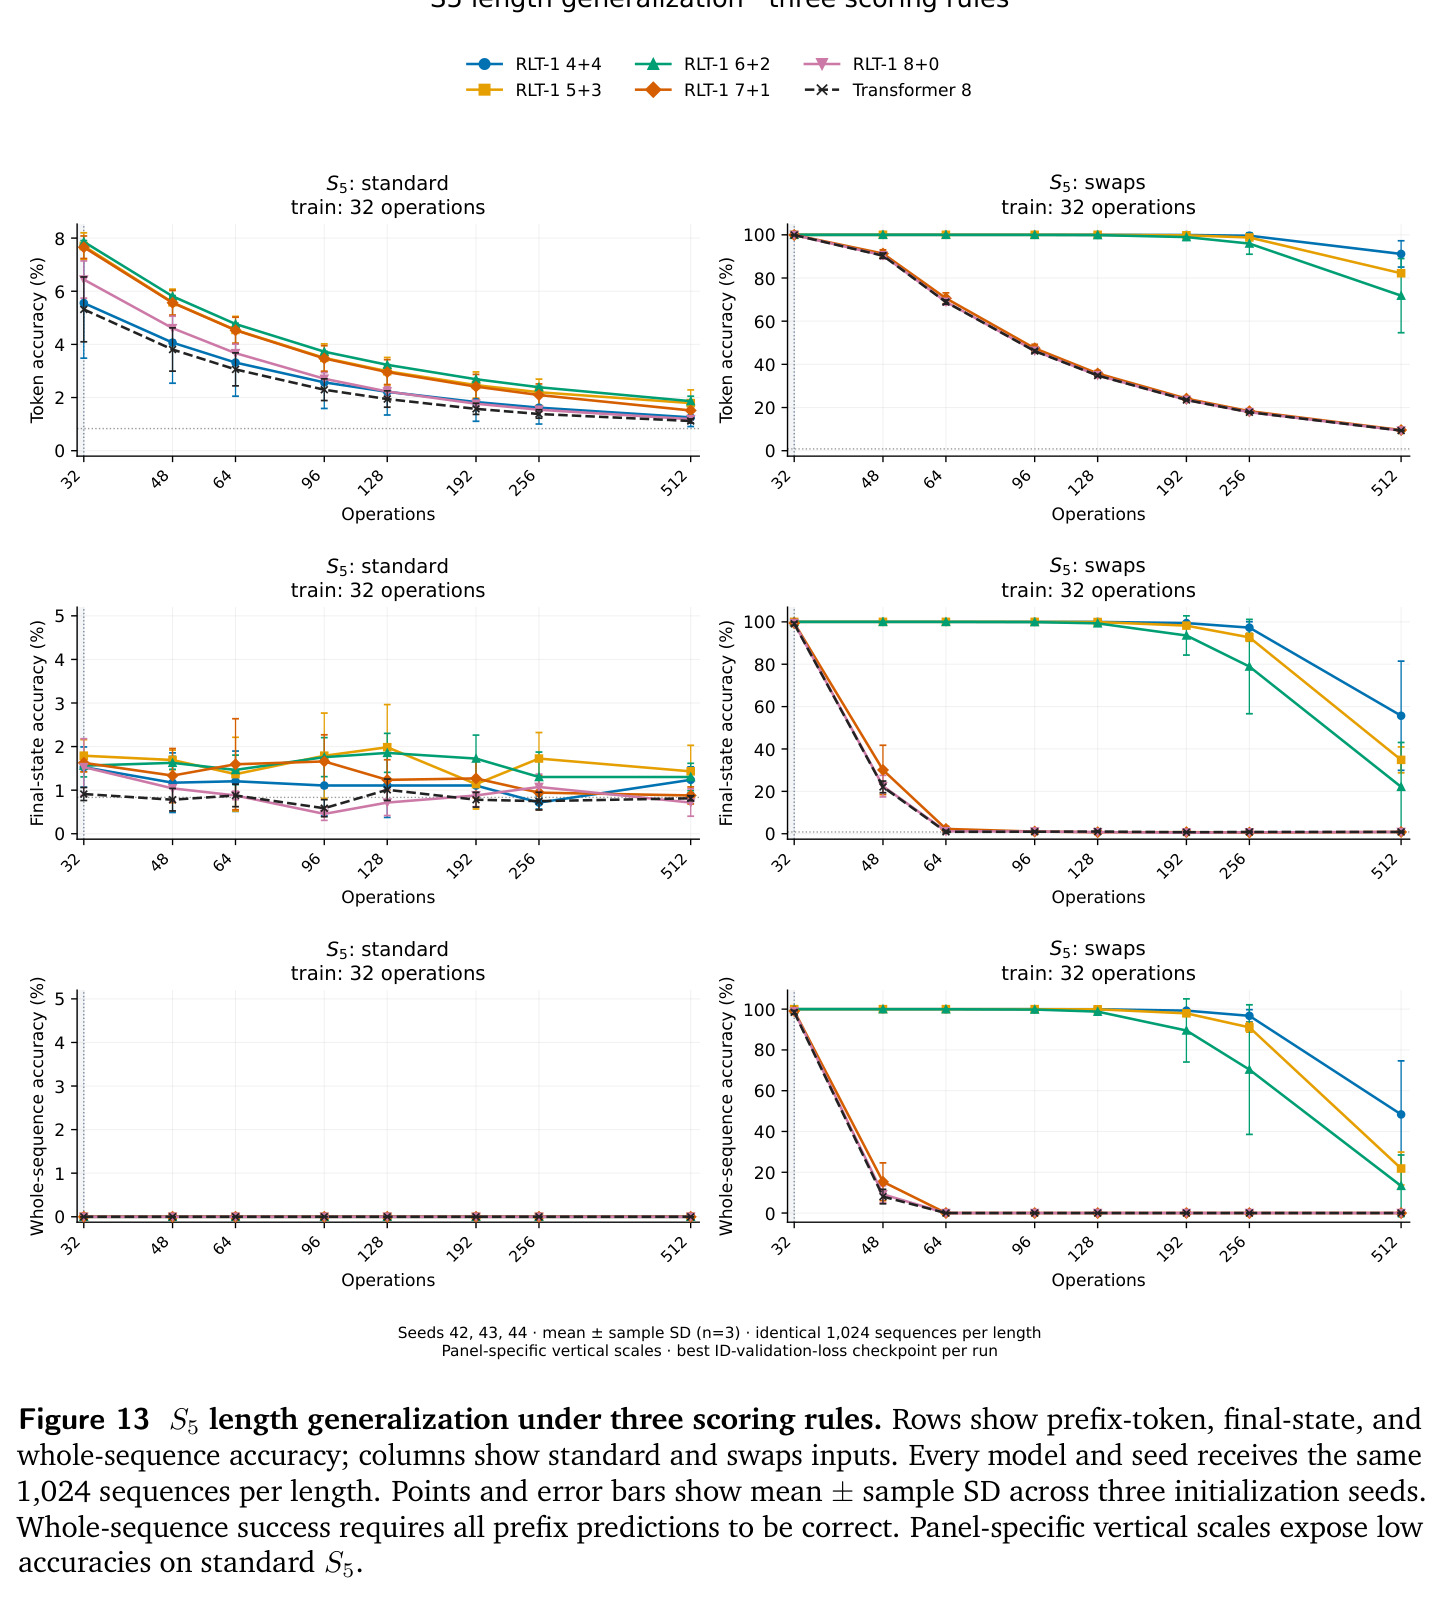
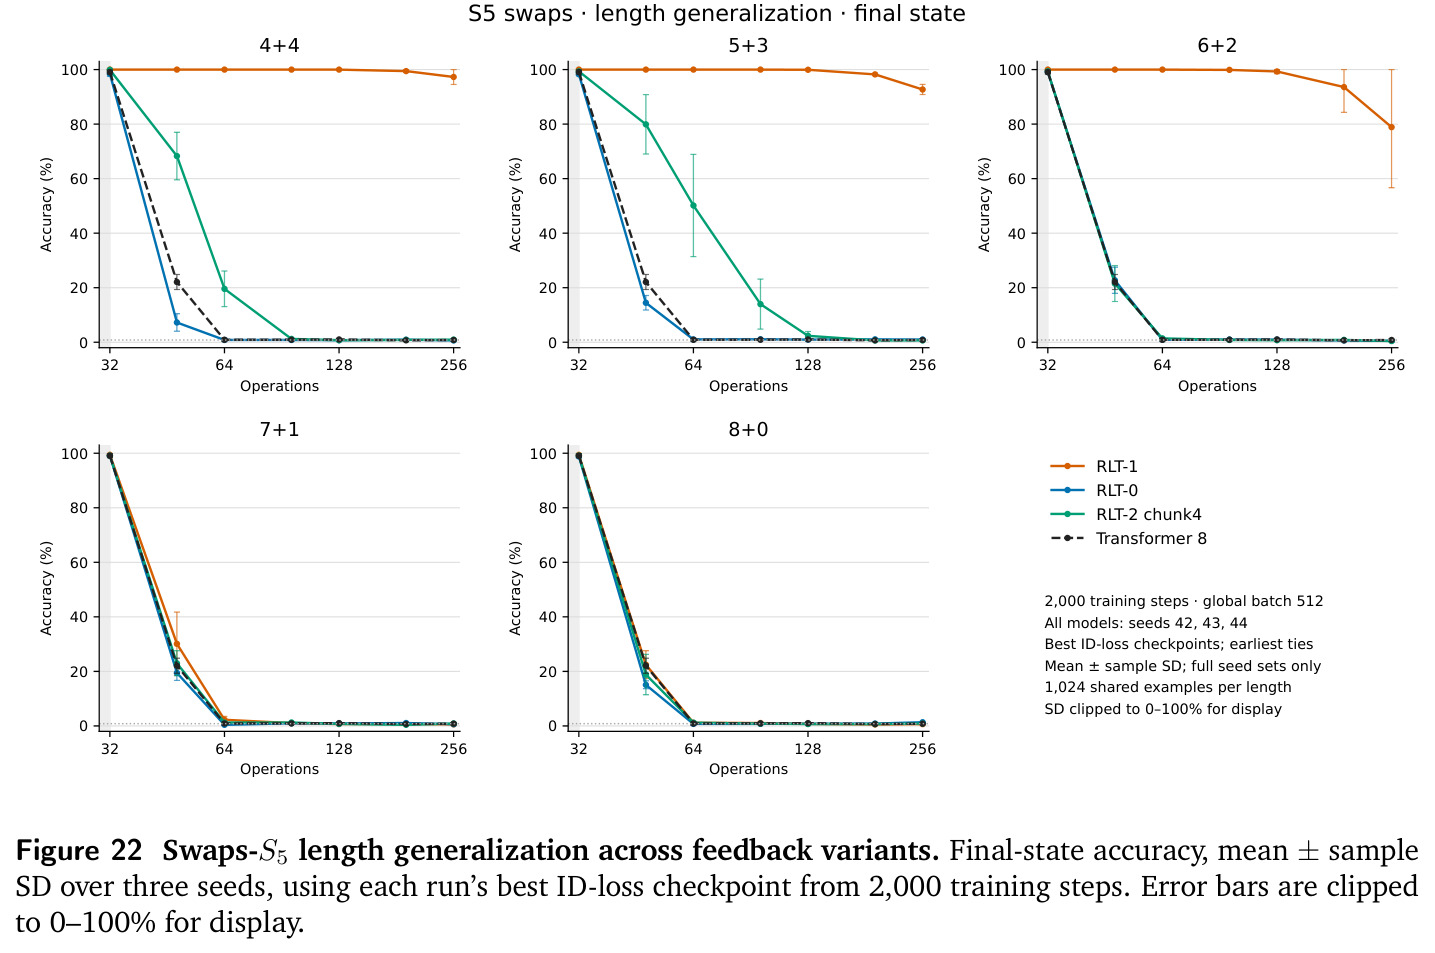
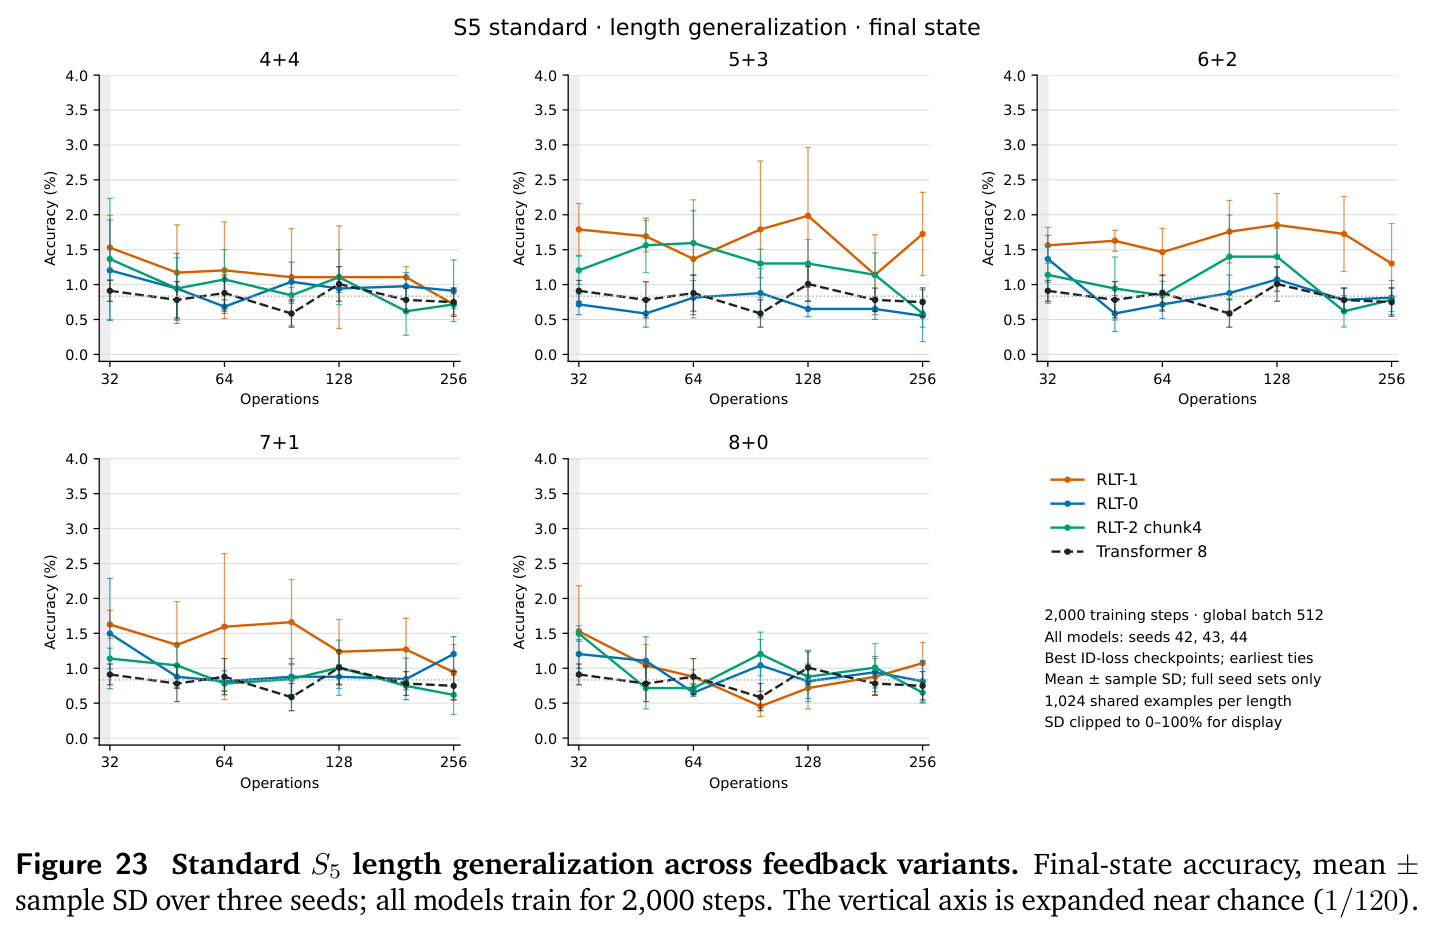
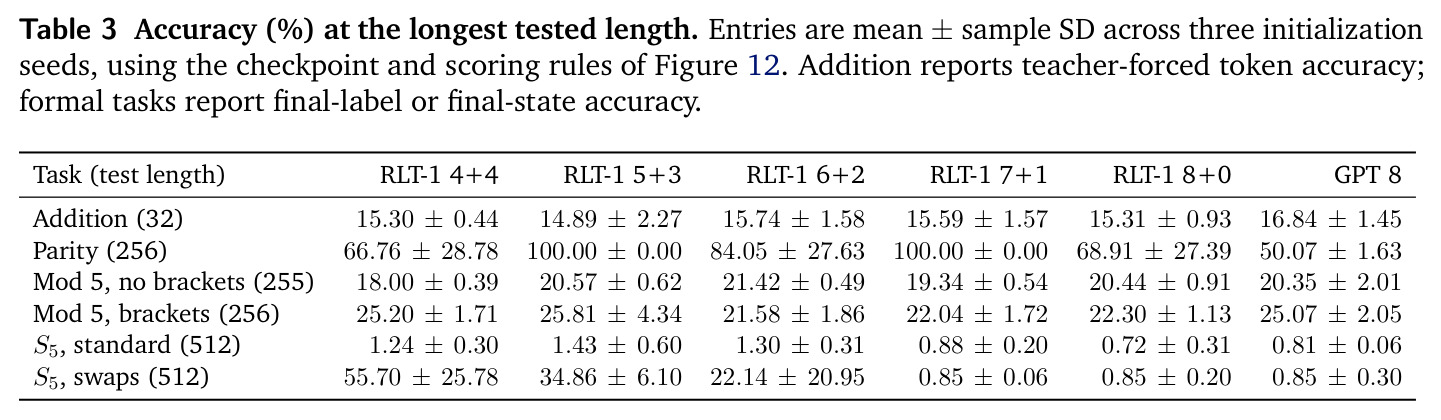
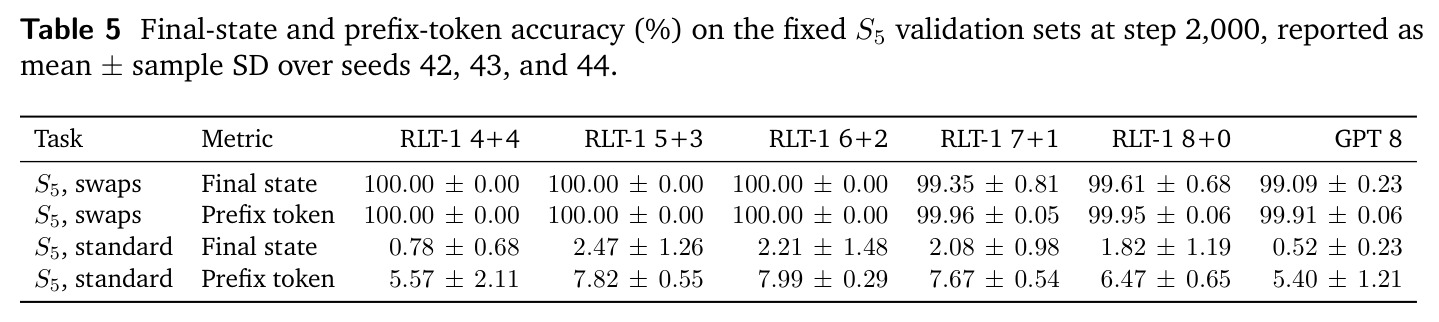
Transformer 每层对每个 token 的计算深度是固定的,与序列长度无关。但状态跟踪类任务(奇偶校验需要每读一位就累加异或,S5 置换跟踪需要每步复合一个群元素)要求每一步都发生状态更新。理论上,Merrill 等人(2024)证明除非复杂度类 $TC^0 = NC^1$,固定深度 Transformer 无法在任意长序列上跟踪 S5 置换复合。实践中问题同样严重:8 层 Transformer 在 3-40 比特上训练奇偶校验后,256 比特测试准确率仅 $50.07 \pm 1.63\%$(等于随机猜);在 32 步交换上训练、256 步测试时最终状态准确率只有 $0.85 \pm 0.30\%$,几乎与均匀猜测 $1/120$ 无异。现有模型把所有层并行铺开,任何 token 的计算路径都不会随上下文变长而加深,天然与'逐符号更新状态'的任务结构错配。
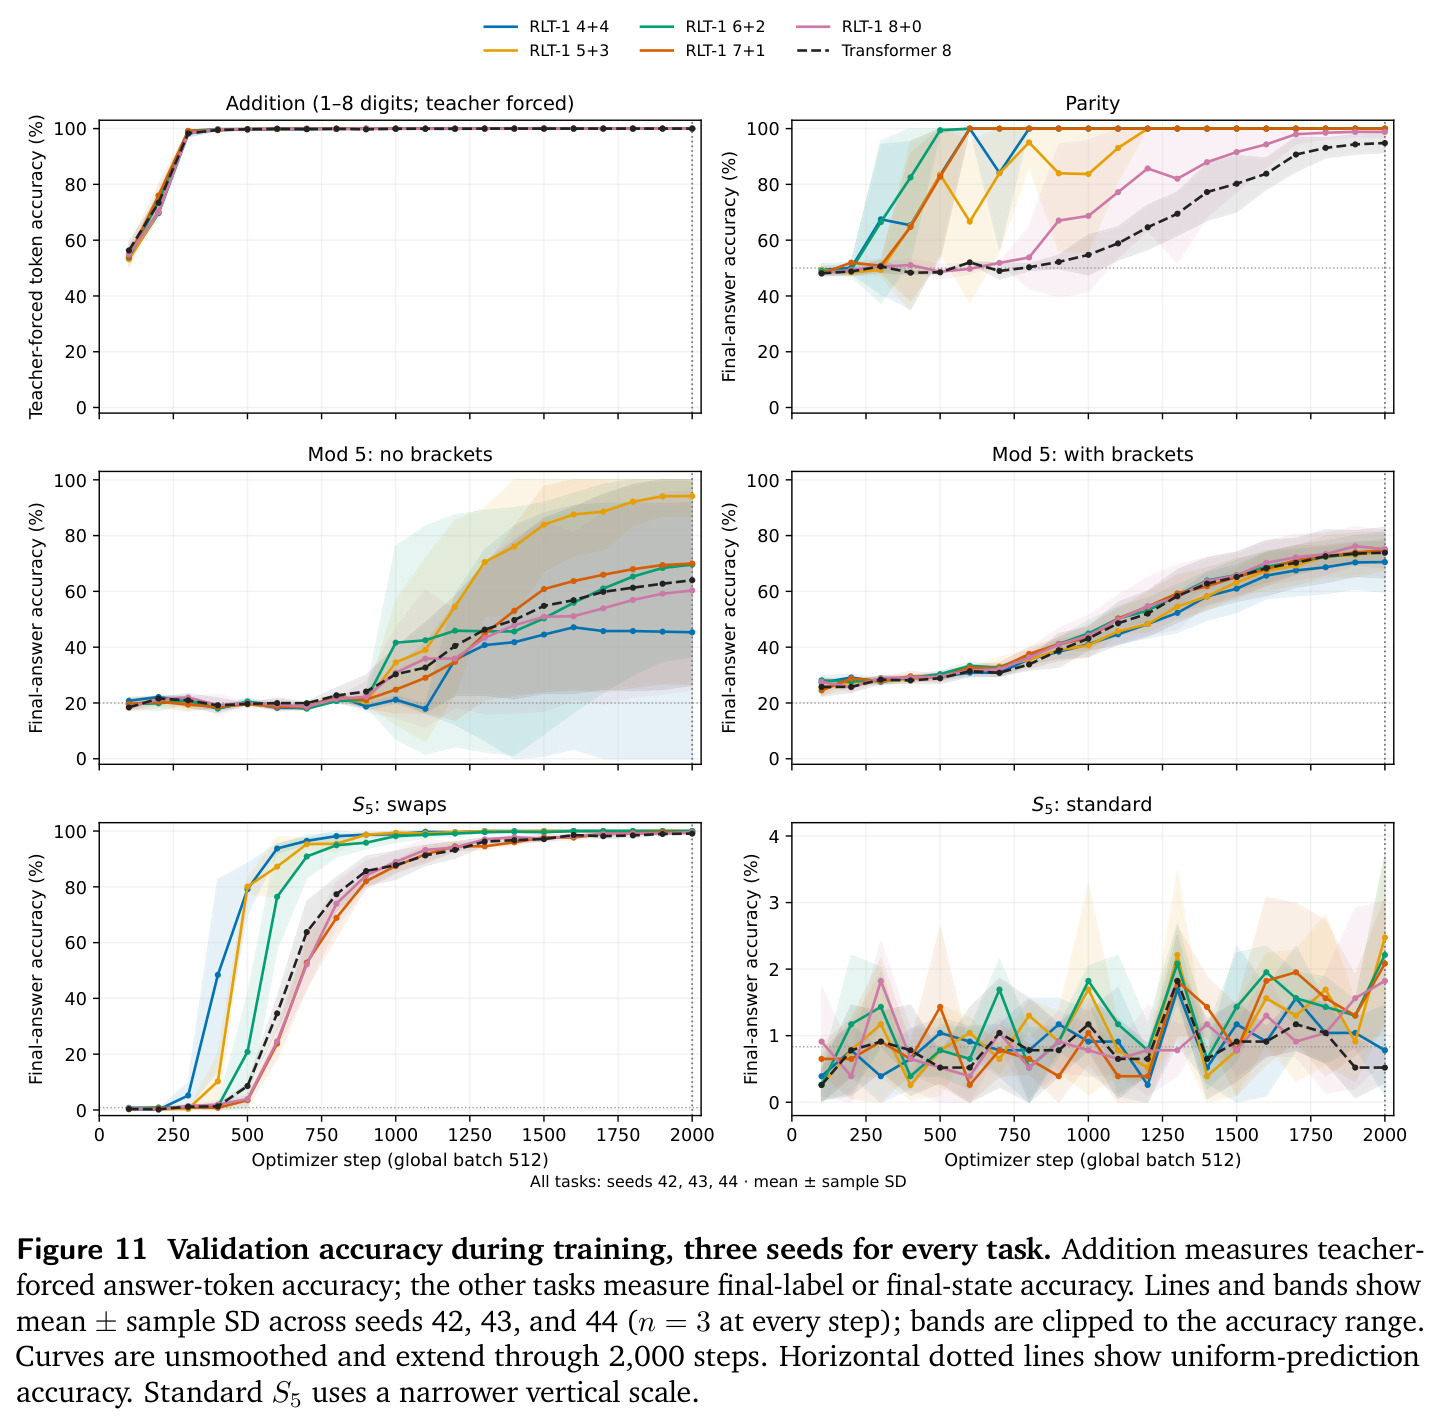
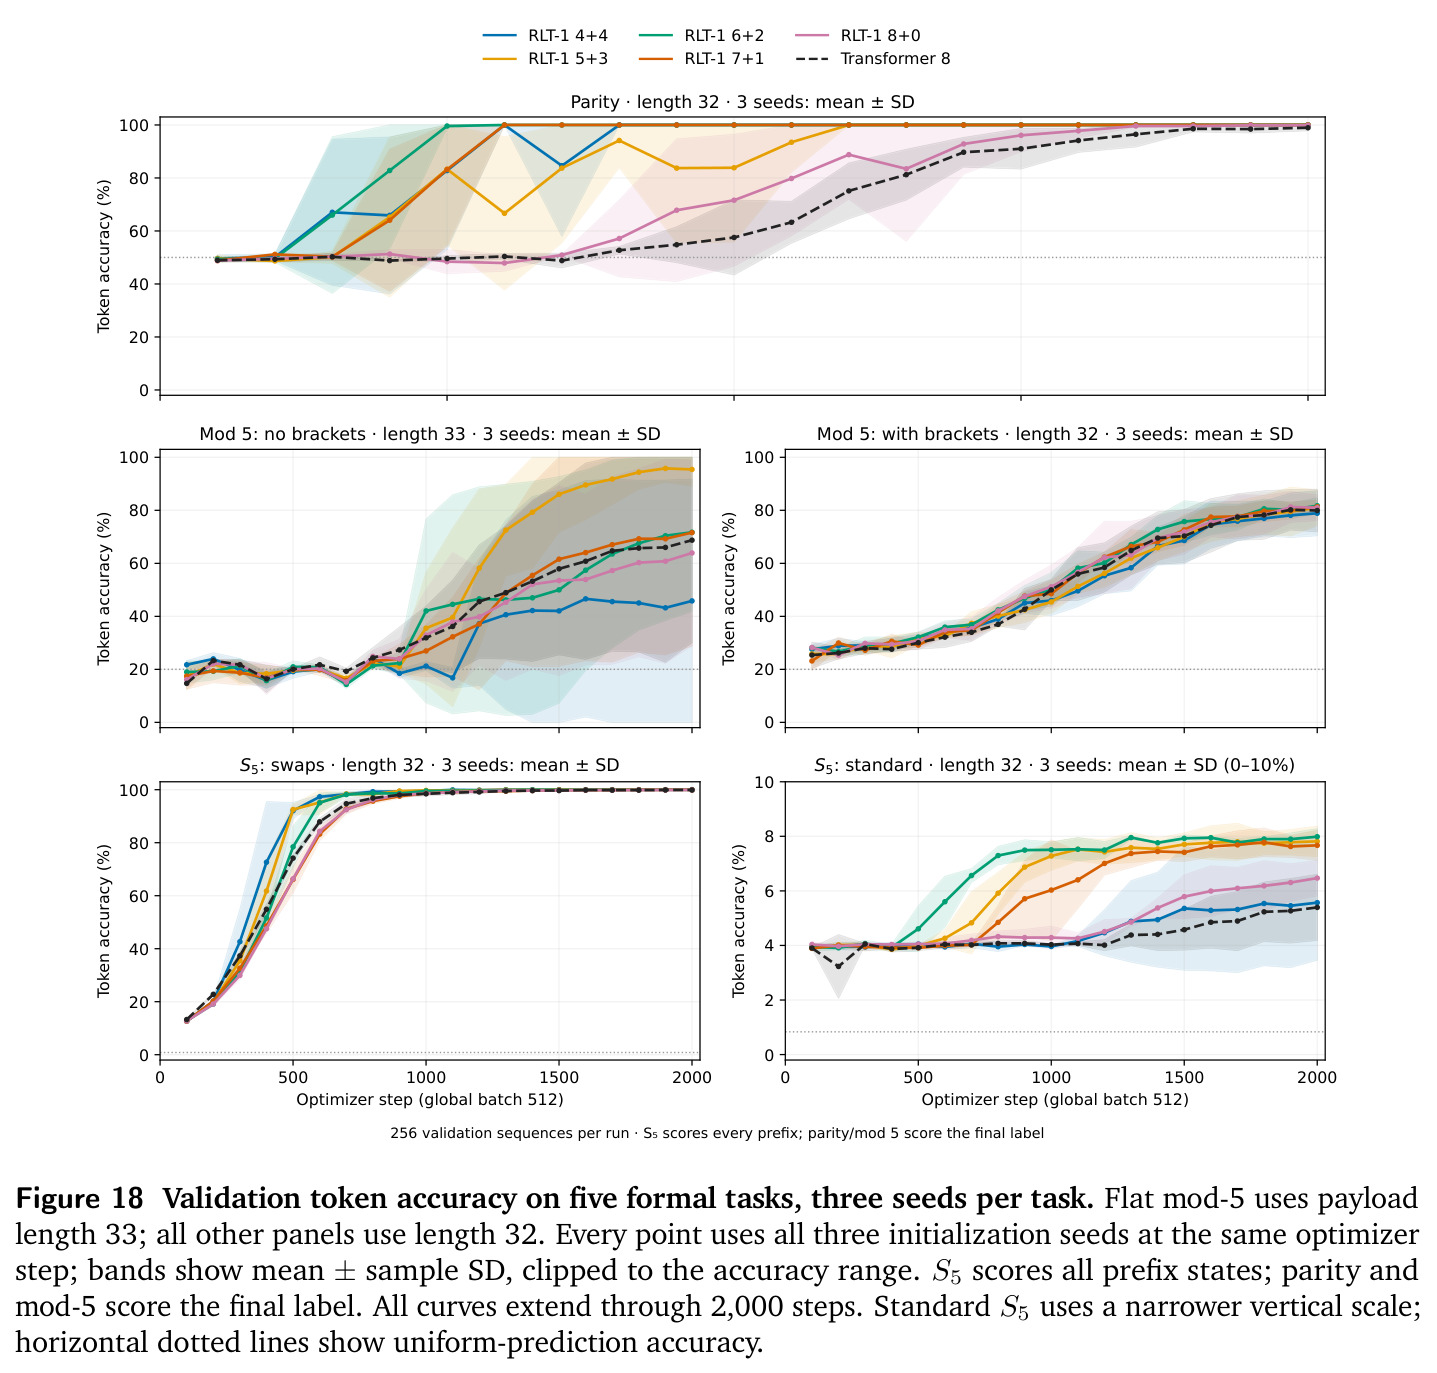
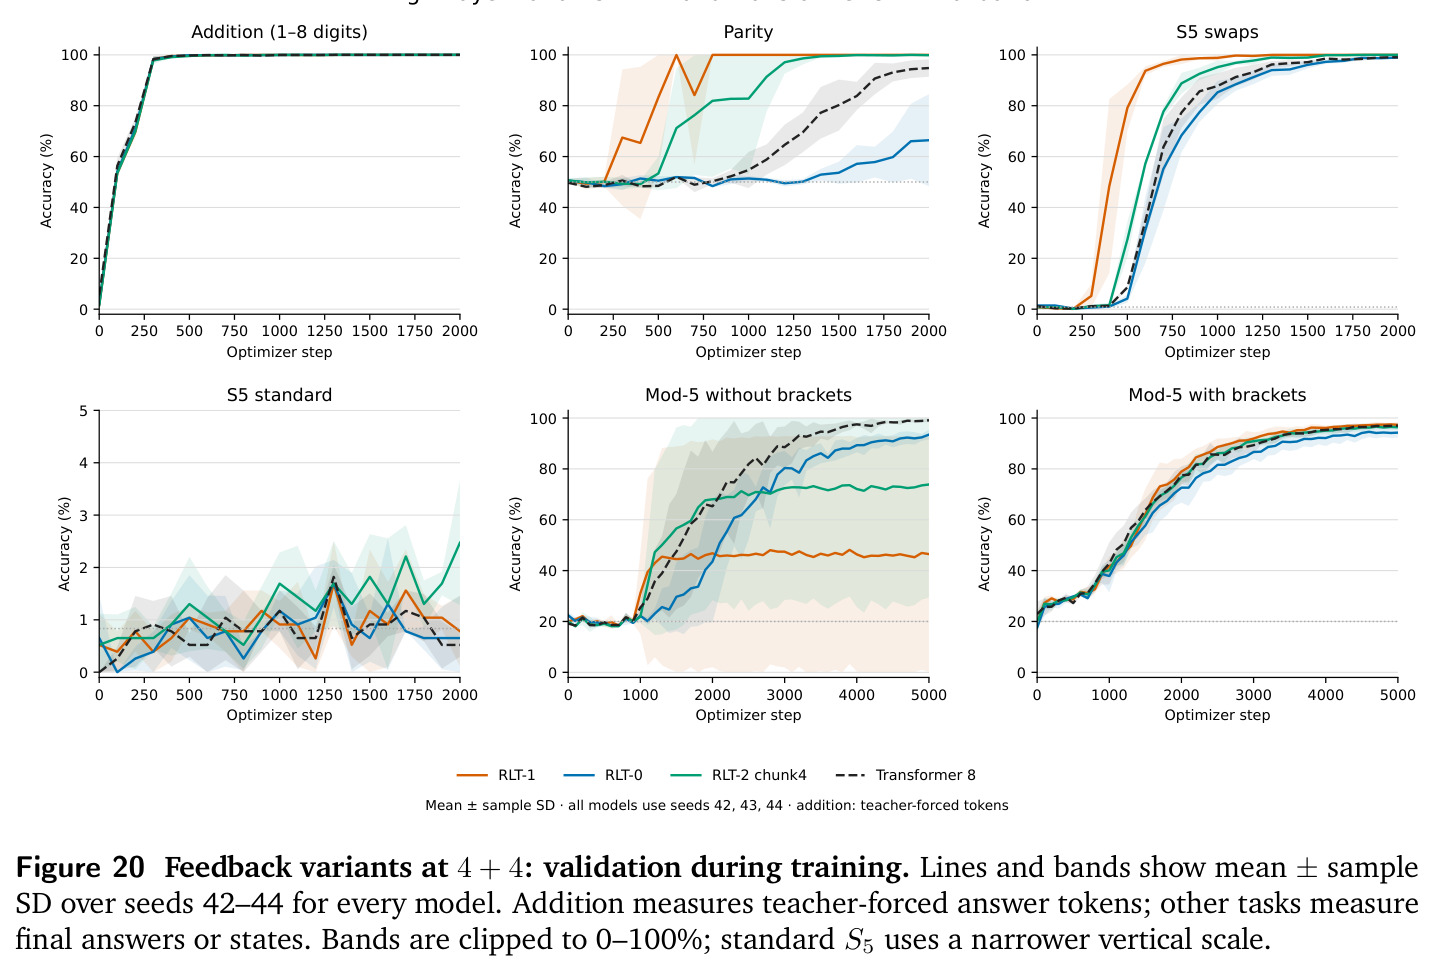
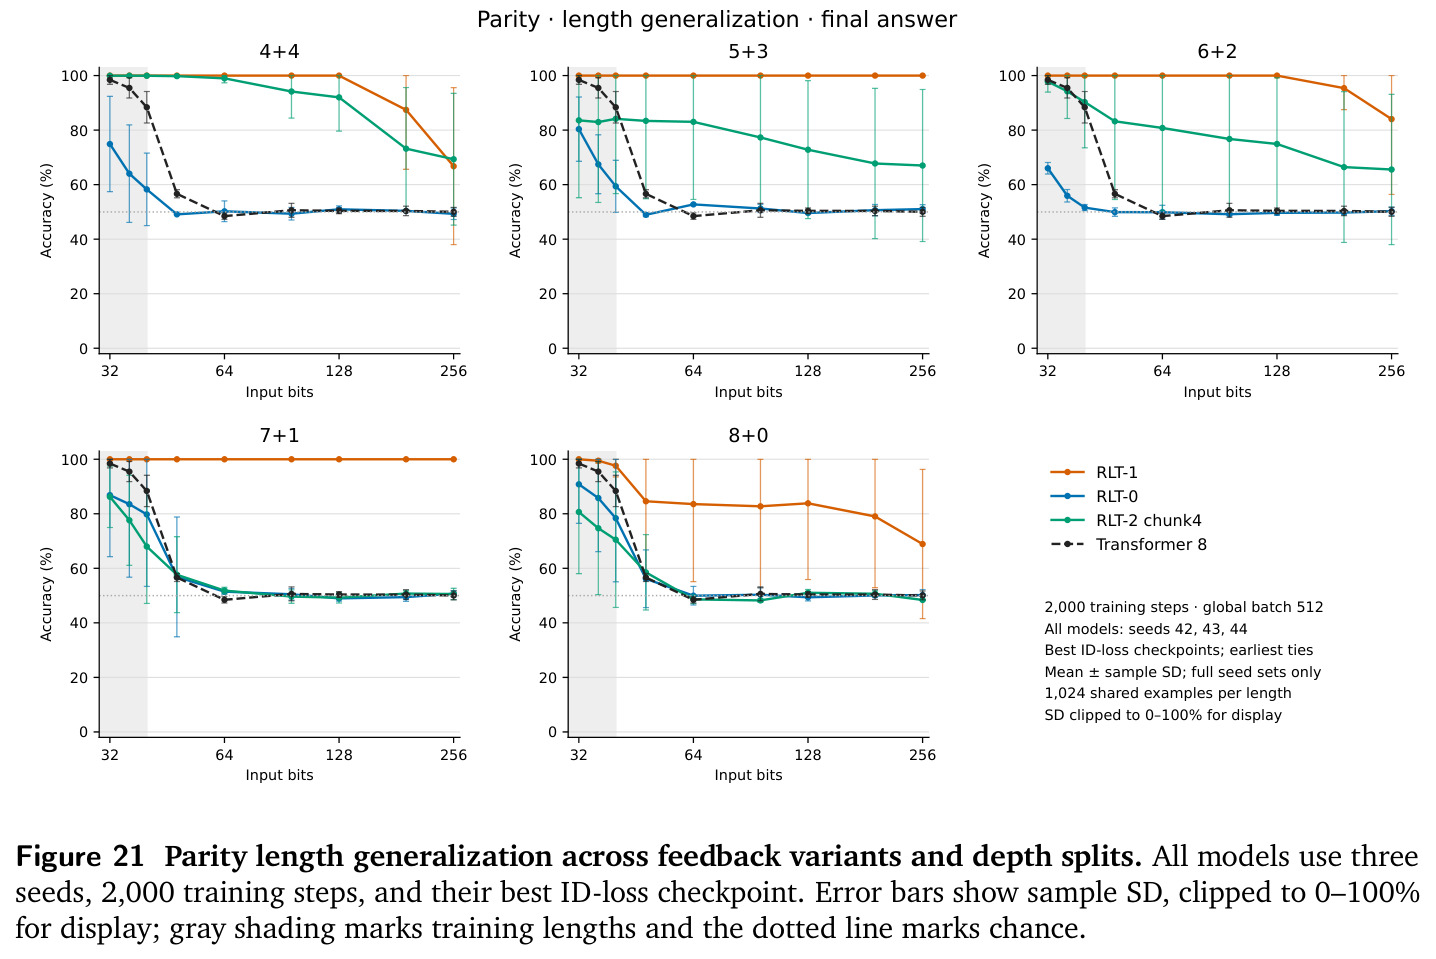
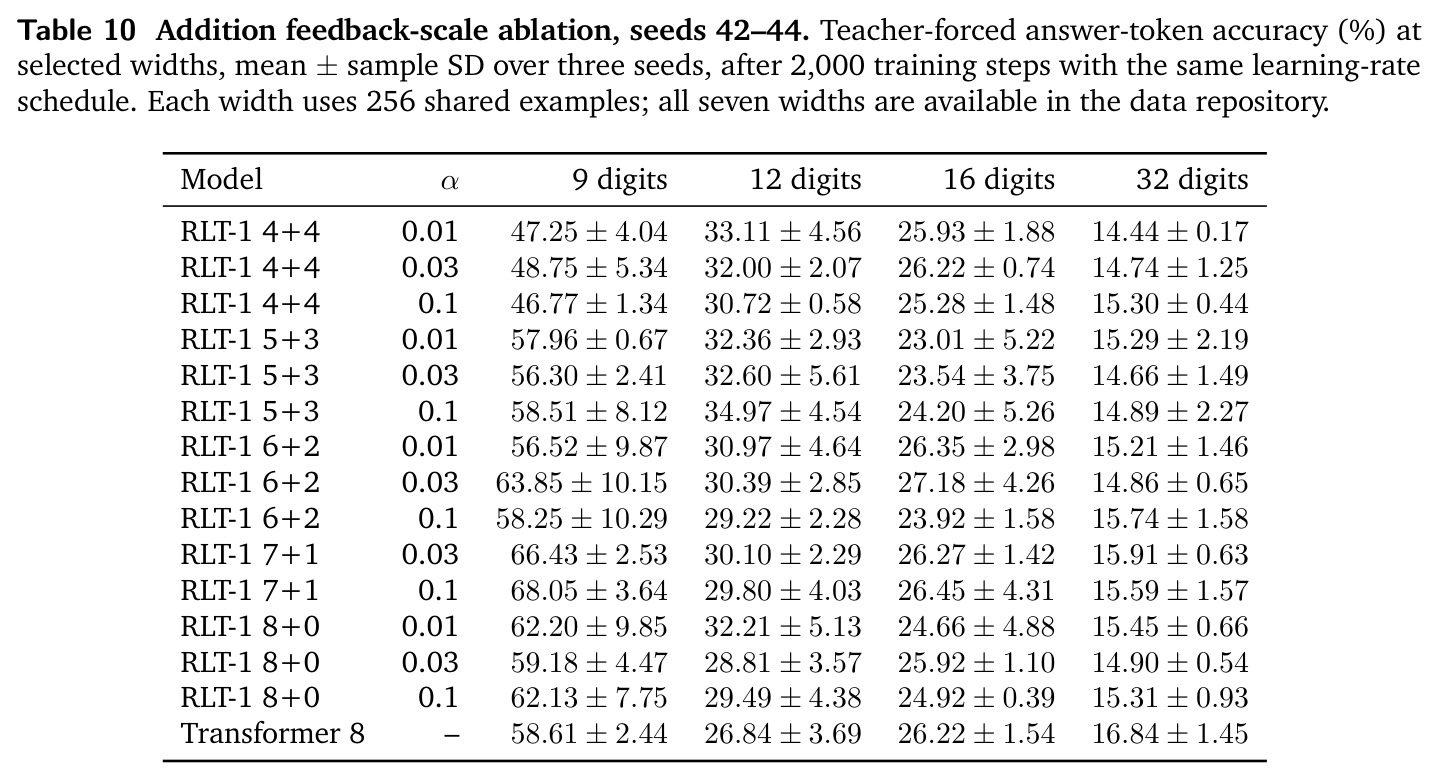
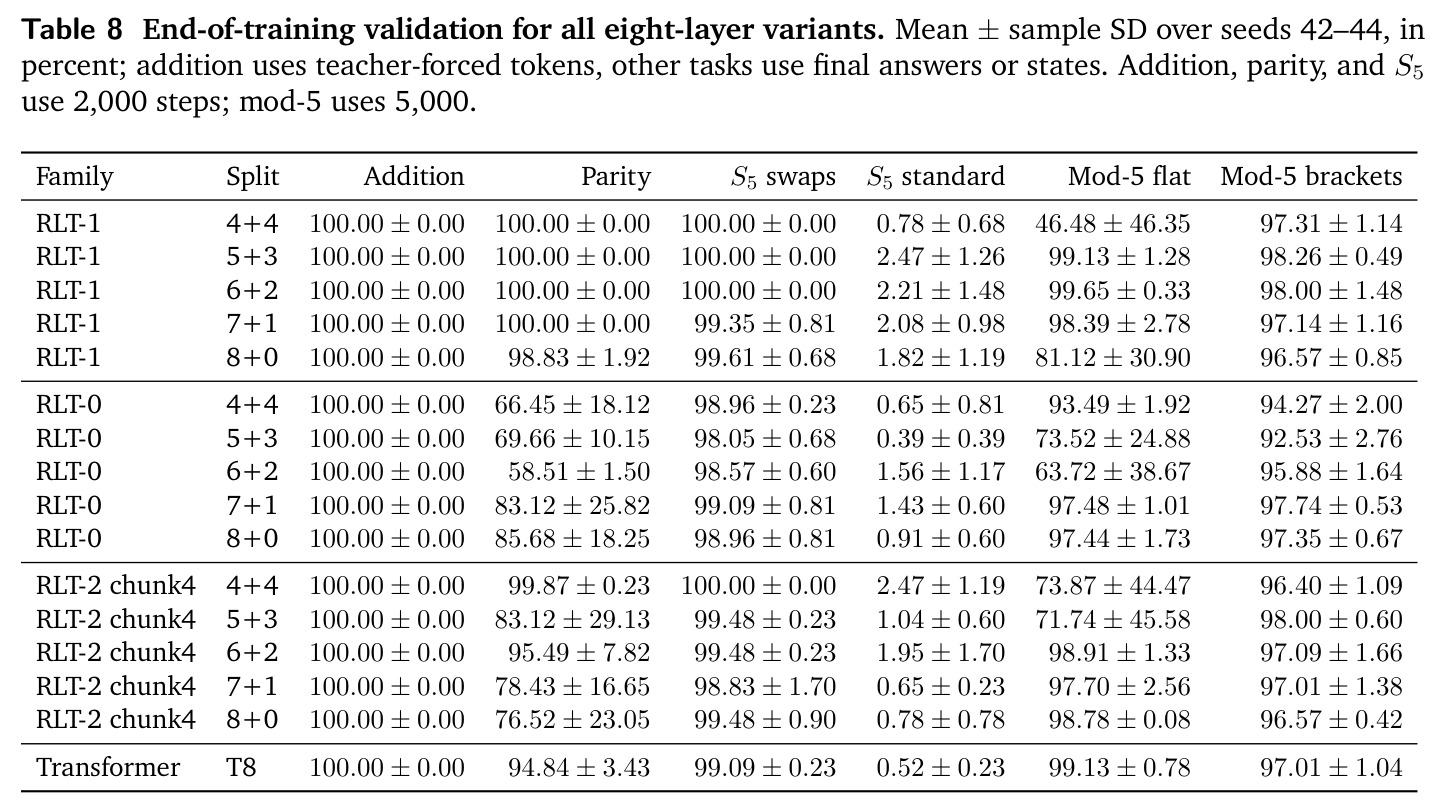
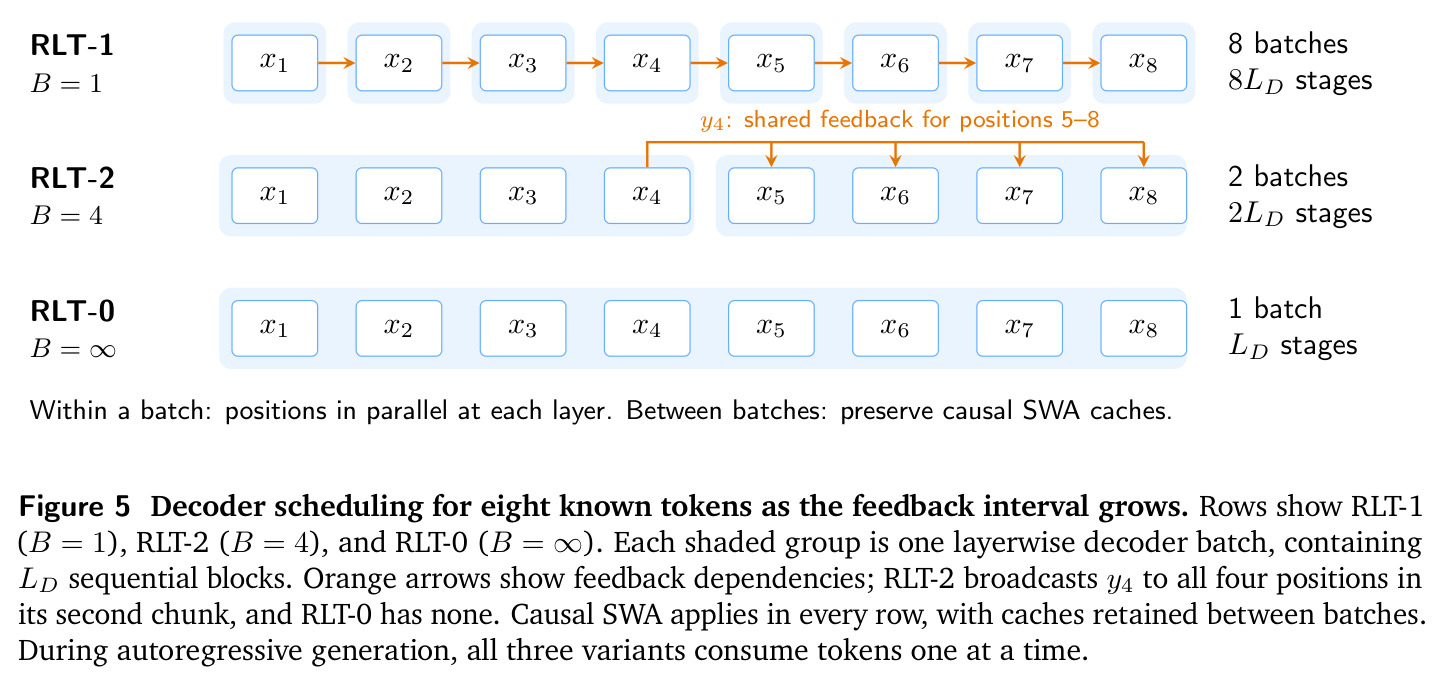
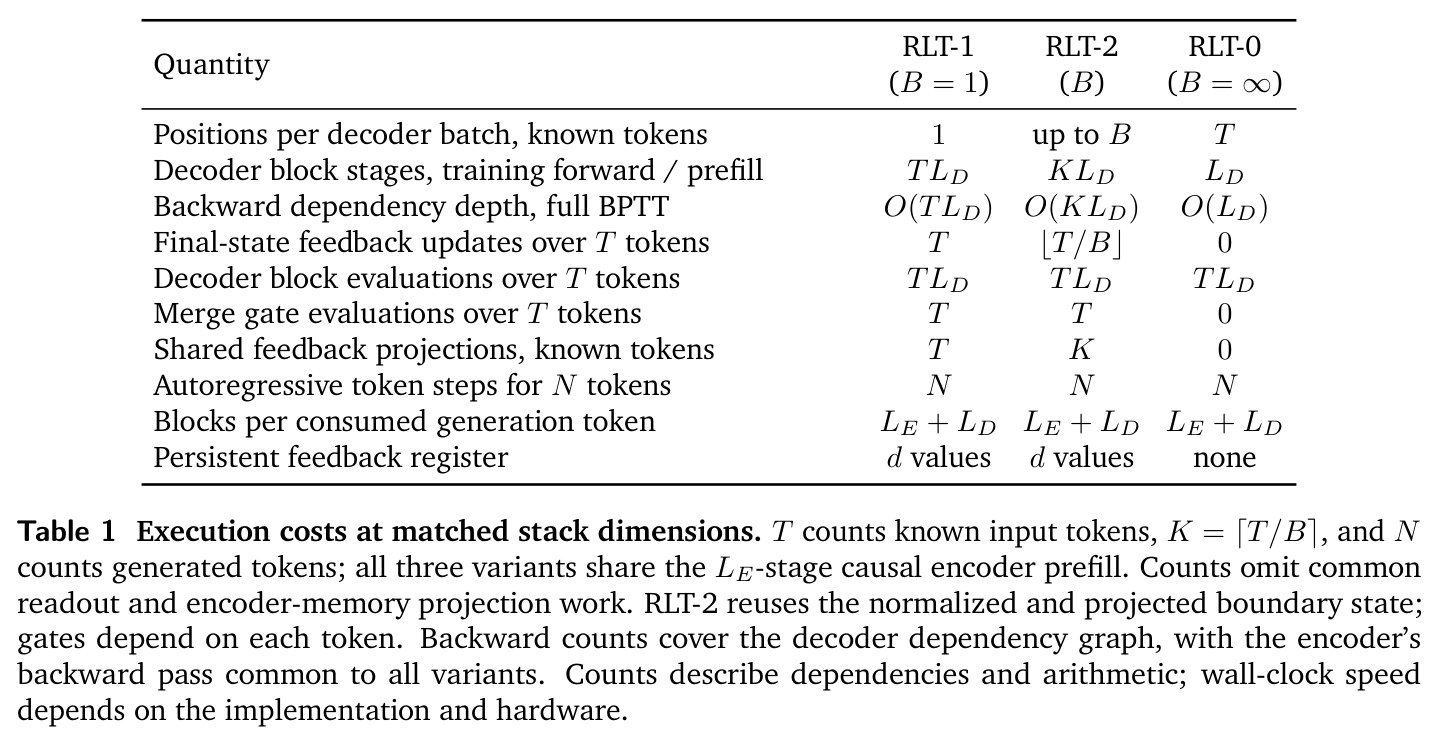
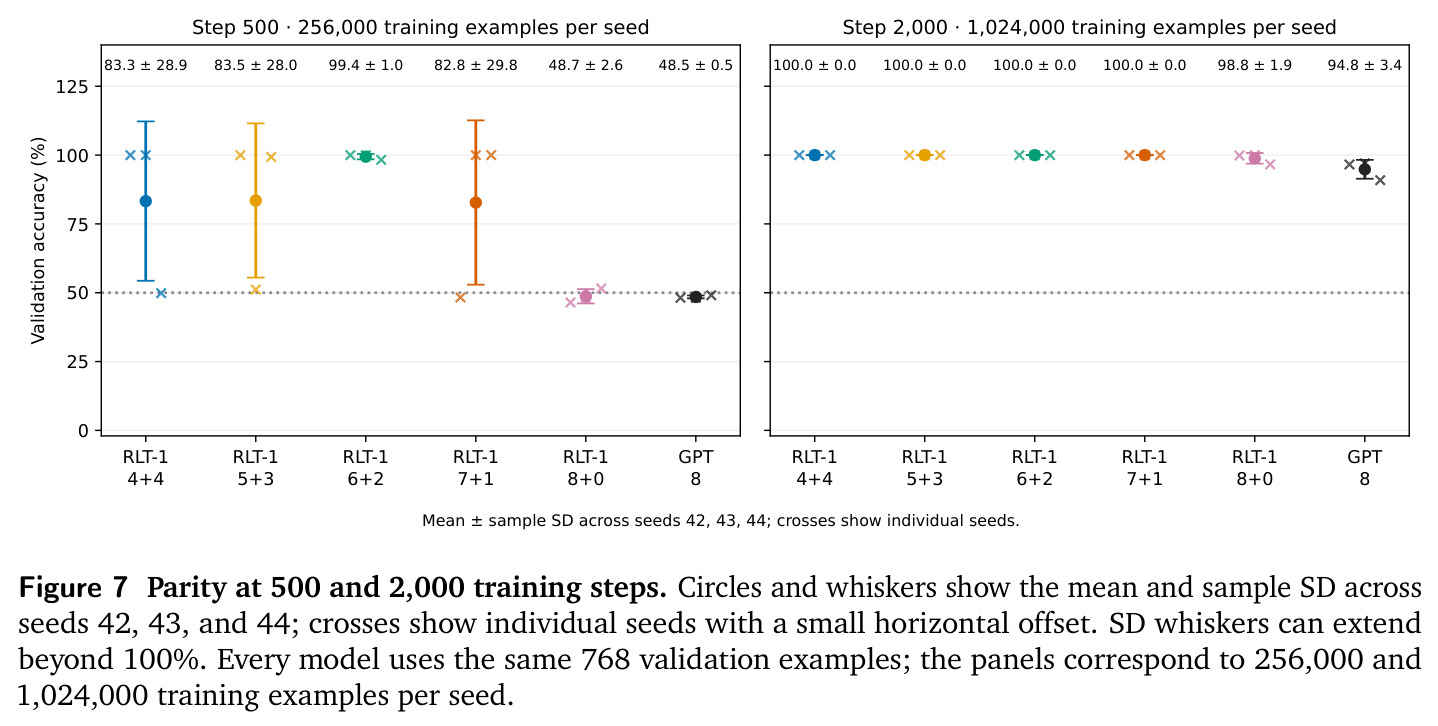
本文的目标是本文目标是设计一种每 token 计算代价固定、但计算路径随序列长度线性增长的 Transformer 架构,使其在算法状态跟踪任务上获得远超训练长度的泛化能力。具体而言,把 $L_E + L_D = 8$ 层拆分为并行因果编码器与逐 token 循环解码器,让解码器最终状态在 token 间反馈传递。作者还希望把两个新的架构自由度变成可控设计变量并系统消融:(1)编码器-解码器深度分配,测试 4+4、5+3、6+2、7+1、8+0 五种拆分;(2)反馈间隔 $B$,即相邻两次状态反馈之间的 token 数,对应 RLT-1($B=1$)、RLT-2($B=4$ 分块)、RLT-0($B=\infty$ 无反馈)三个共享参数的变体。通过 6 个算法任务、3 个随机种子(42/43/44)的对照实验,弄清长度泛化到底依赖哪些组件。
与已有工作不同的是,此前已有多种'跨 token 传递信息'的尝试,但反馈都不穿过完整解码器:Feedback Transformer 让后续 token 在每层注意一个跨层加权记忆;Recurrent Transformer 的反馈是逐层的持久 KV;Full-bandwidth Transformer 只把上一 token 顶层隐状态经门控线性单元注入下一 token 嵌入;T2MLR 在中间层之间反馈缓存表示;LRT 通过 KV 投影复用高层状态并用交错并行训练。另一条线 YOCO 与 DeepSeek-V4.1-Flash 做了编码器记忆复用与交叉解码,但没有真正的循环。RLT 的独特切入在于三点组合:反馈经过完整解码器(递归路径穿越 $t \cdot L_D$ 个解码块)、循环与并行编码器记忆彻底分离(全局记忆交叉注意力读取、短期状态用 SWA 缓存)、并把深度分配与反馈间隔当作显式设计变量系统研究,给出'哪些任务需要多少解码深度、多大反馈频率'的任务级结论。
核心方法
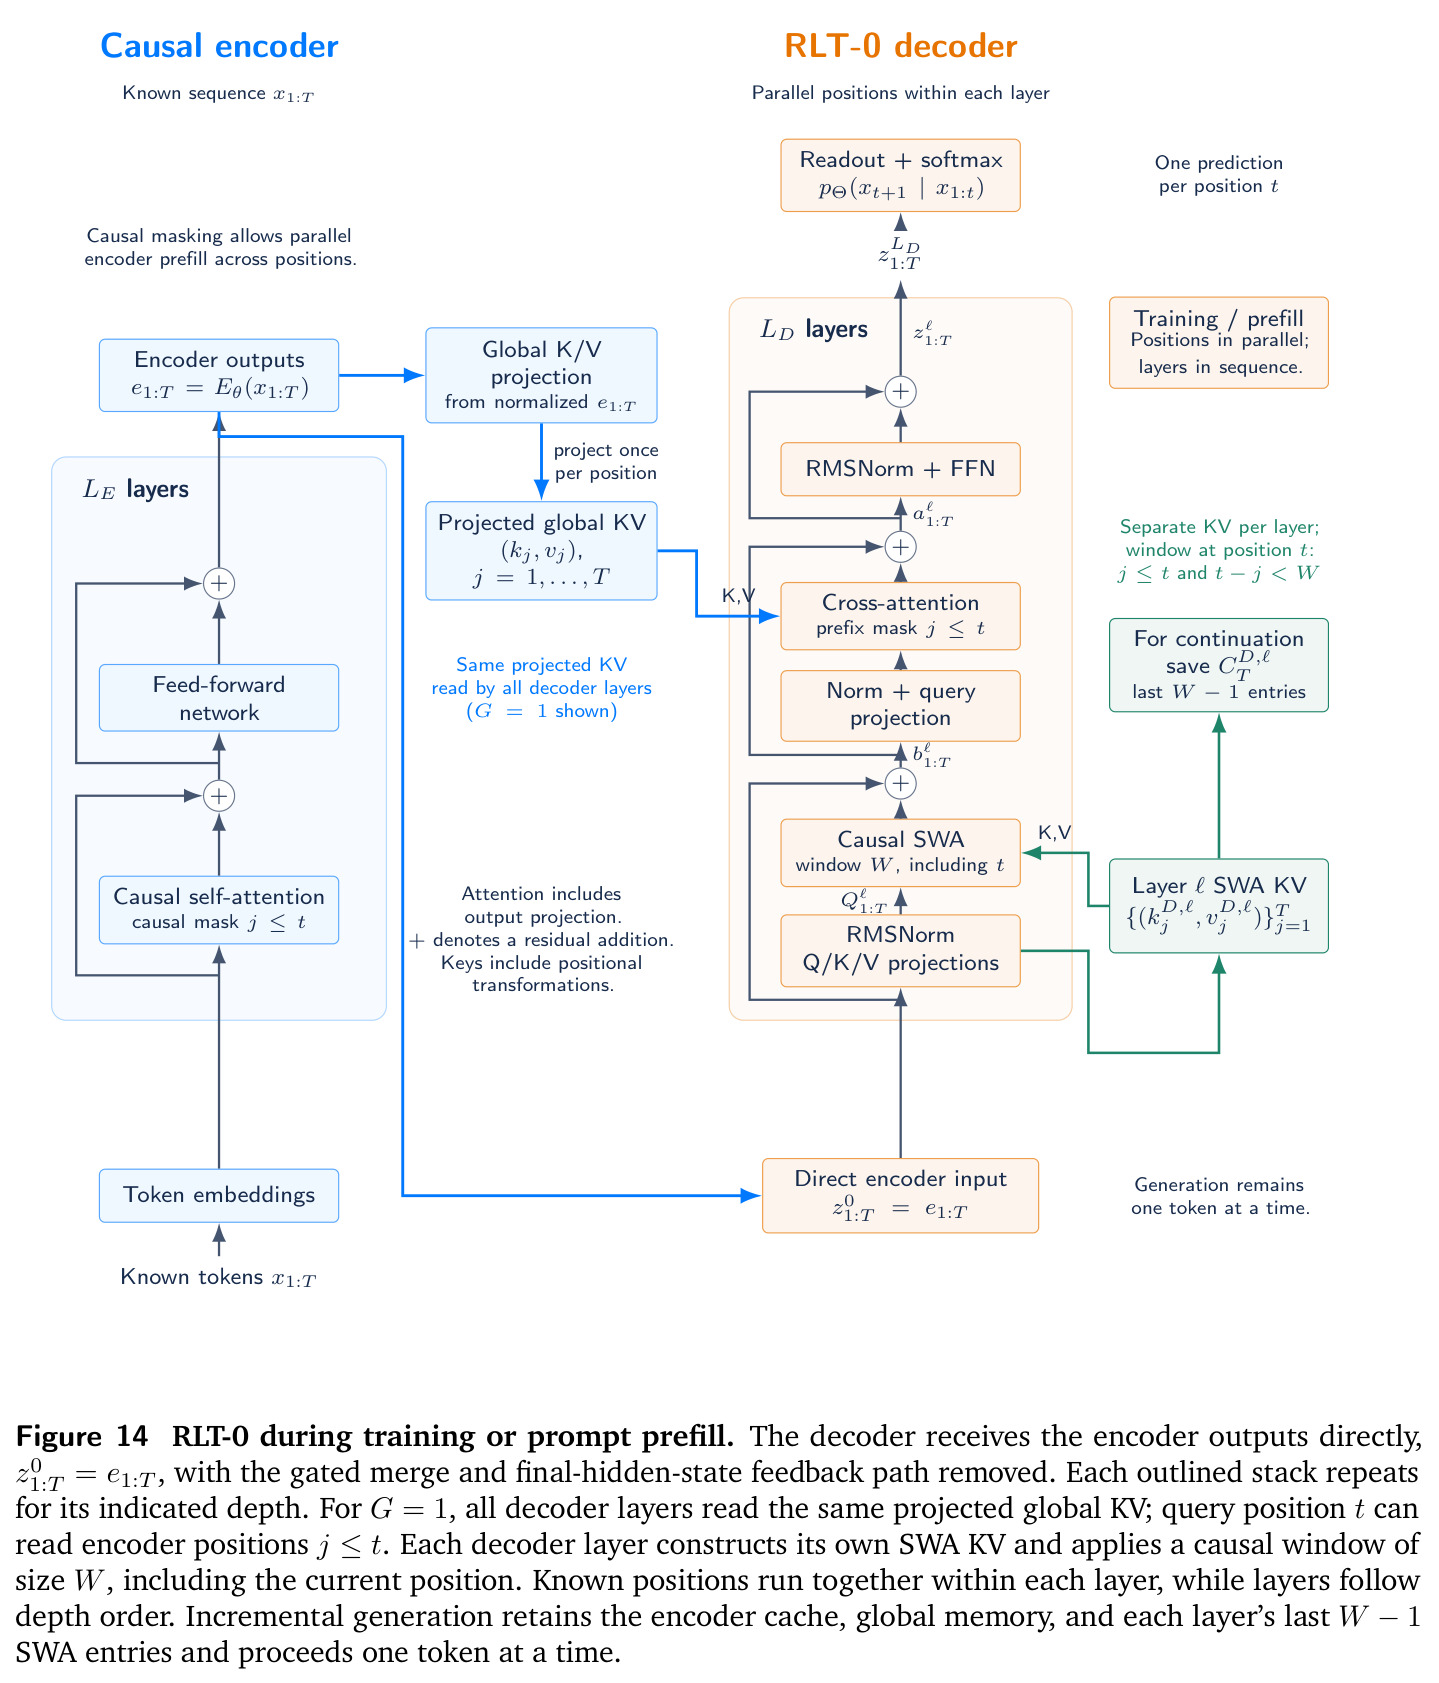
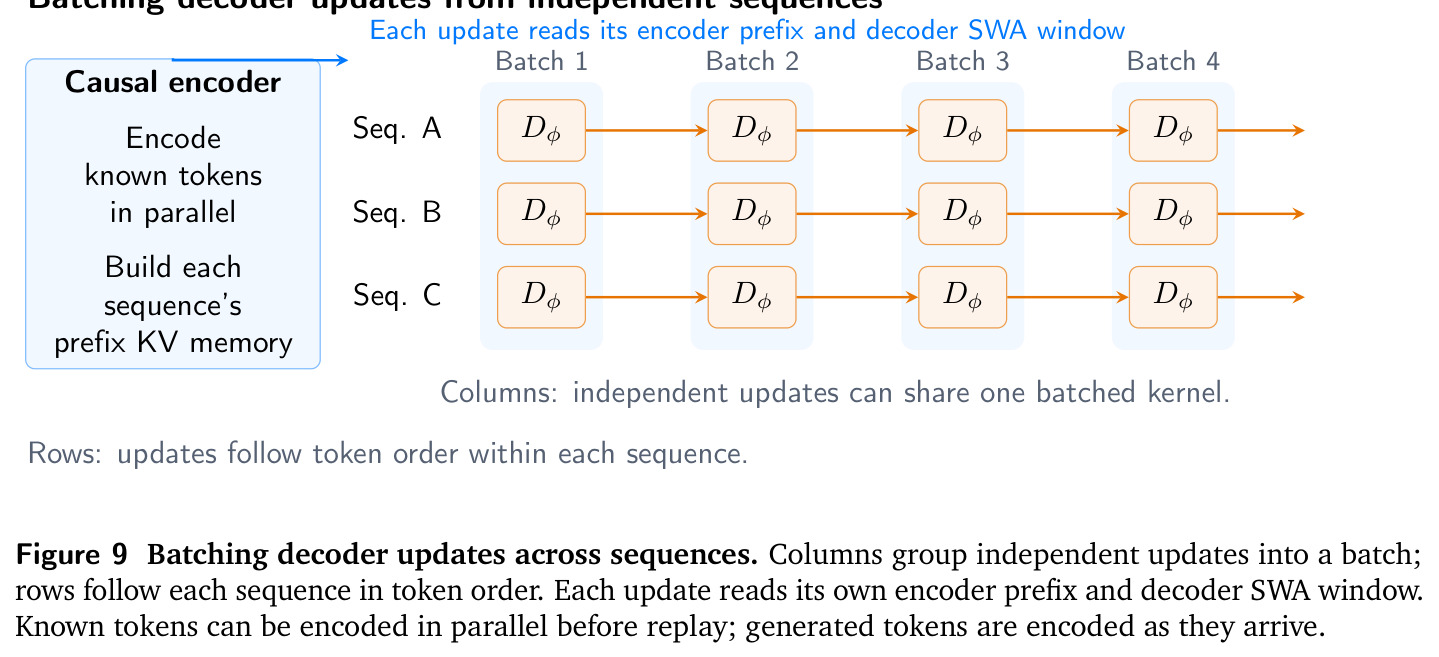
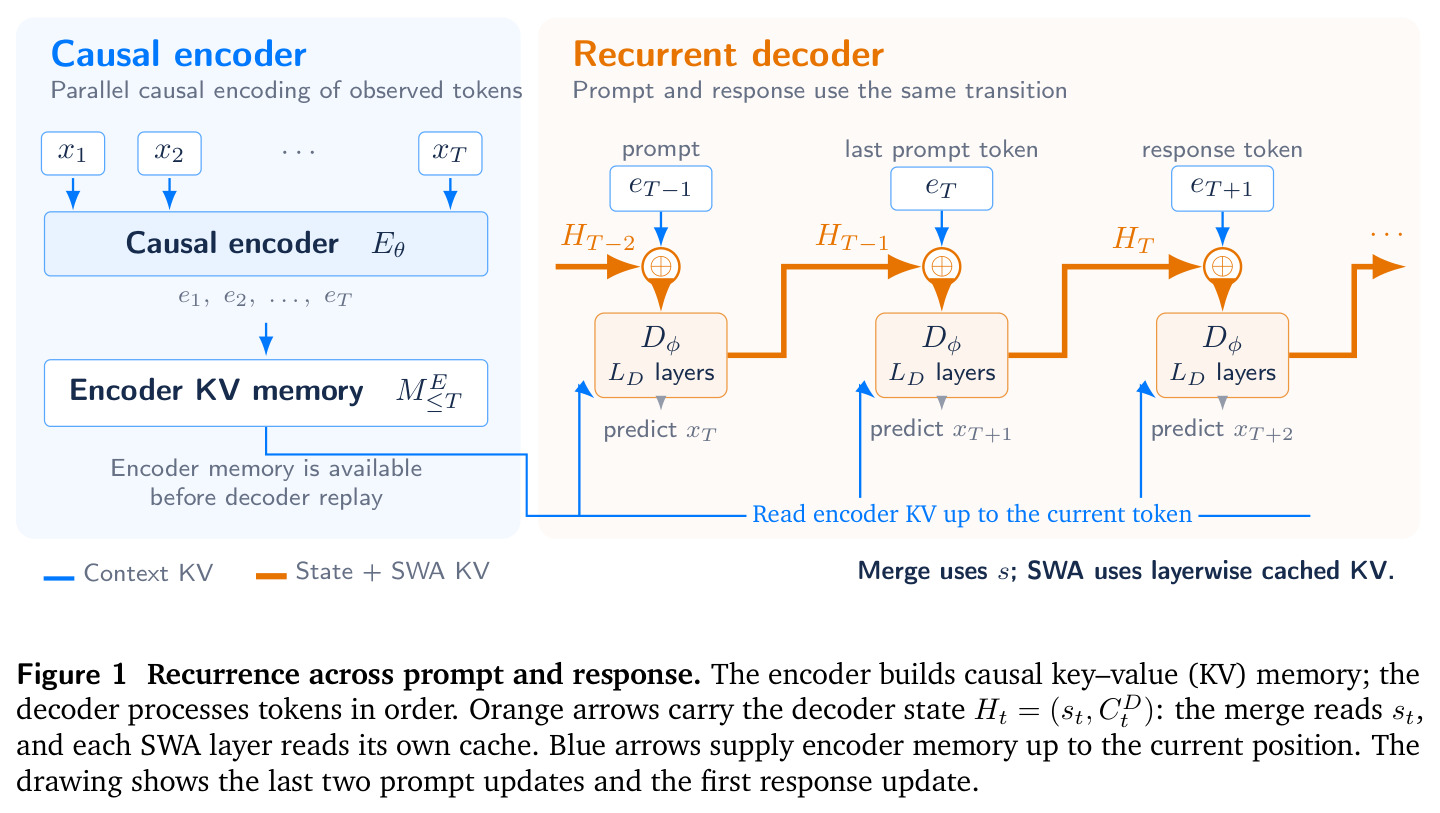
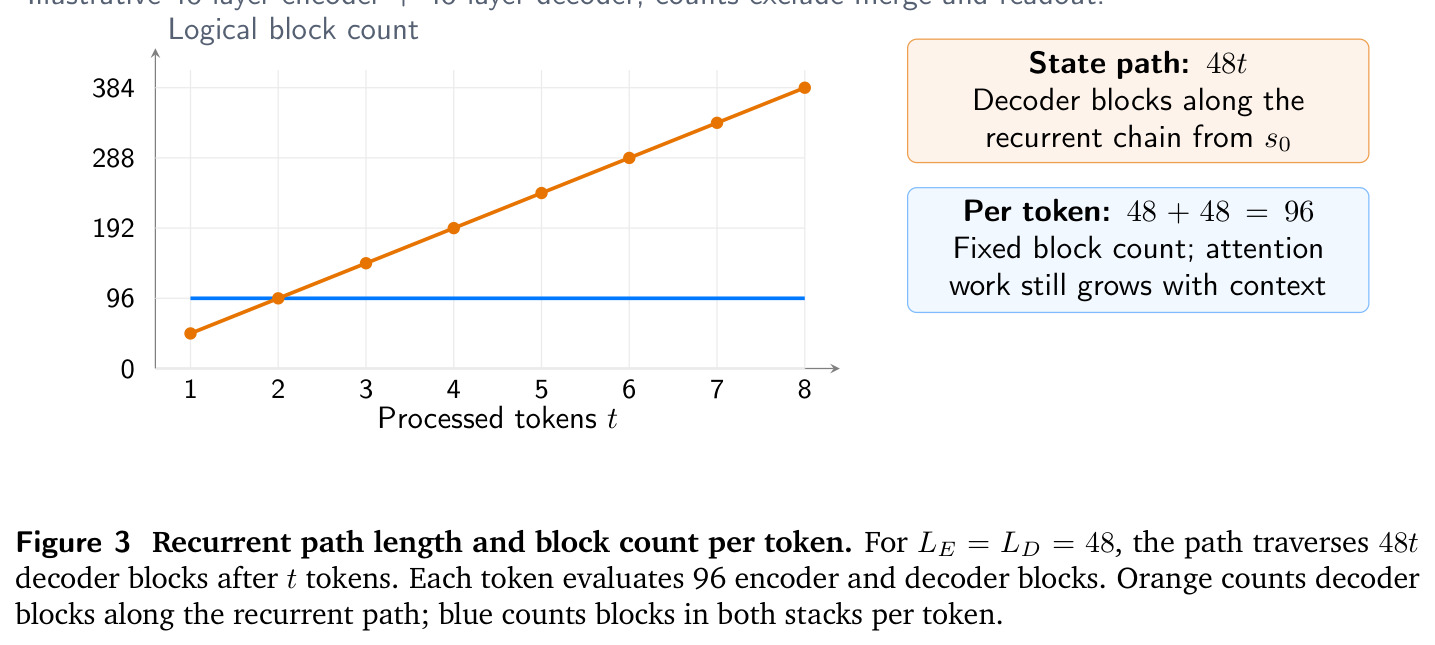
RLT 把 $L_E + L_D$ 层拆成两部分。因果编码器 $E_\theta$ 用因果掩码并行处理全部已知 token,产生表示 $e_t$ 与全局 KV 记忆 $M_{\le t}$。循环解码器 $D_\phi$ 逐 token 顺序执行:在每个位置 $t$,先用门控合并把编码器输出与上一 token 的最终解码器状态 $s_{t-1}$ 混合,$u_t = e_t + \alpha\, g_t \odot W_s \mathrm{RMSNorm}(s_{t-1})$,其中 $g_t$ 为 sigmoid 门、$\alpha = 0.1$ 控制反馈尺度;随后每个解码块依次做窗口 $W=8$ 的因果滑窗注意力、对编码器记忆的交叉注意力、FFN。完整状态 $H_t = (s_t, \mathcal{C}^D_t)$ 由最终输出与各层 SWA 缓存组成。直觉上,每个 token 的思考深度可随序列增长:处理 $t$ 个 token 后反馈路径经过 $t \cdot L_D$ 个解码块,而每 token 只评估 $L_E+L_D$ 块,单位代价不变、路径随序列加深。
核心创新是'逐 token 穿过全部解码层的反馈回路'。奇偶校验、置换复合这类任务每读一个符号就要更新一次状态,固定深度网络每个 token 的'思考预算'却恒定;RLT 把上一 token 的最终解码状态当作可学习的寄存器,经门控合并注入下一 token 的解码器输入,使有效深度随序列线性增长而不增加每 token 前向成本。与已有方法的本质区别有三:(1) 反馈跨越整个解码器堆栈,而非单层 KV(Recurrent Transformer)、顶层隐状态(Full-bandwidth)或中间层表示(T2MLR);(2) 循环与并行编码器记忆彻底分离,全局记忆用交叉注意力读取,短程信息由各层独立 SWA 缓存保存,二者不互相污染;(3) 反馈间隔 $B$ 只改计算图不改参数——RLT-1、RLT-2(每 4 token 一次)与 RLT-0 共用同一套权重,$B$ 可以当成超参数在训练阶段间调度,这是 Block-Recurrent Transformer 专用记忆状态库所不具备的性质。
方法步骤详情
流程分五步。(1) 编码:$x_{1:T}$ 经 $L_E$ 层编码器并行编码得 $e_{1:T}$ 与全局 KV 记忆 $M_{\le t}$。(2) 初始化 $H_0 = (s^\star, \emptyset)$。(3) 逐 token 转移:门控合并 $u_t = e_t + \alpha g_t \odot W_s r_{t-1}$ 后,每个解码块做滑窗自注意力($W=8$,读缓存 $\mathcal{C}^D_{t-1}$)、交叉注意力到 $M_{\le t}$、FFN;$s_t = z^{L_D}_t$,各层缓存保留最近 $W-1$ 个位置。(4) 读出 $p_\Theta(x_{t+1}|x_{1:t}) = \mathrm{softmax}(W_o\, \mathrm{RMSNorm}(s_t))$,采样后增量编码并追加 KV。(5) 训练:teacher forcing 交叉熵加完整 BPTT(TBPTT 128);RL 时重放历史重建状态。RLT-2 每 $B=4$ token 更新一次反馈、块内并行;RLT-0 无反馈,$z^0_t = e_t$。
技术新颖性
技术新颖性体现在架构正交性与可控性上。第一,反馈粒度可调且共享参数:$B$ 从 1 到 $\infty$ 只是计算图调度差异,同一权重可在预训练用大 $B$ 换并行、中训练与后训练退火到 $B=1$,实验测得 seed-42 CPU 上 chunk4 训练步速度是 RLT-1 的 2.27 倍、RLT-0 达 4.17-4.30 倍,为'并行-精度'权衡提供了工程抓手。第二,深度分配 $L_E/L_D$ 被显式当作设计轴并给出任务相关结论:奇偶校验偏爱 1-3 个解码层,置换跟踪则随解码深度单调提升,这类'反馈深度如何影响可跟踪任务'的分析是新的。第三,训练与推理一致:提示和响应走同一转移函数,附录 B 证明状态与下一 token 分布对提示-响应切分点不变,并给出预训练、SFT 与策略梯度下精确重放的条件。相比逐层反馈或顶层隐状态注入,穿过全解码器的反馈为长序列状态跟踪提供了严格更强的计算路径。
实验结果
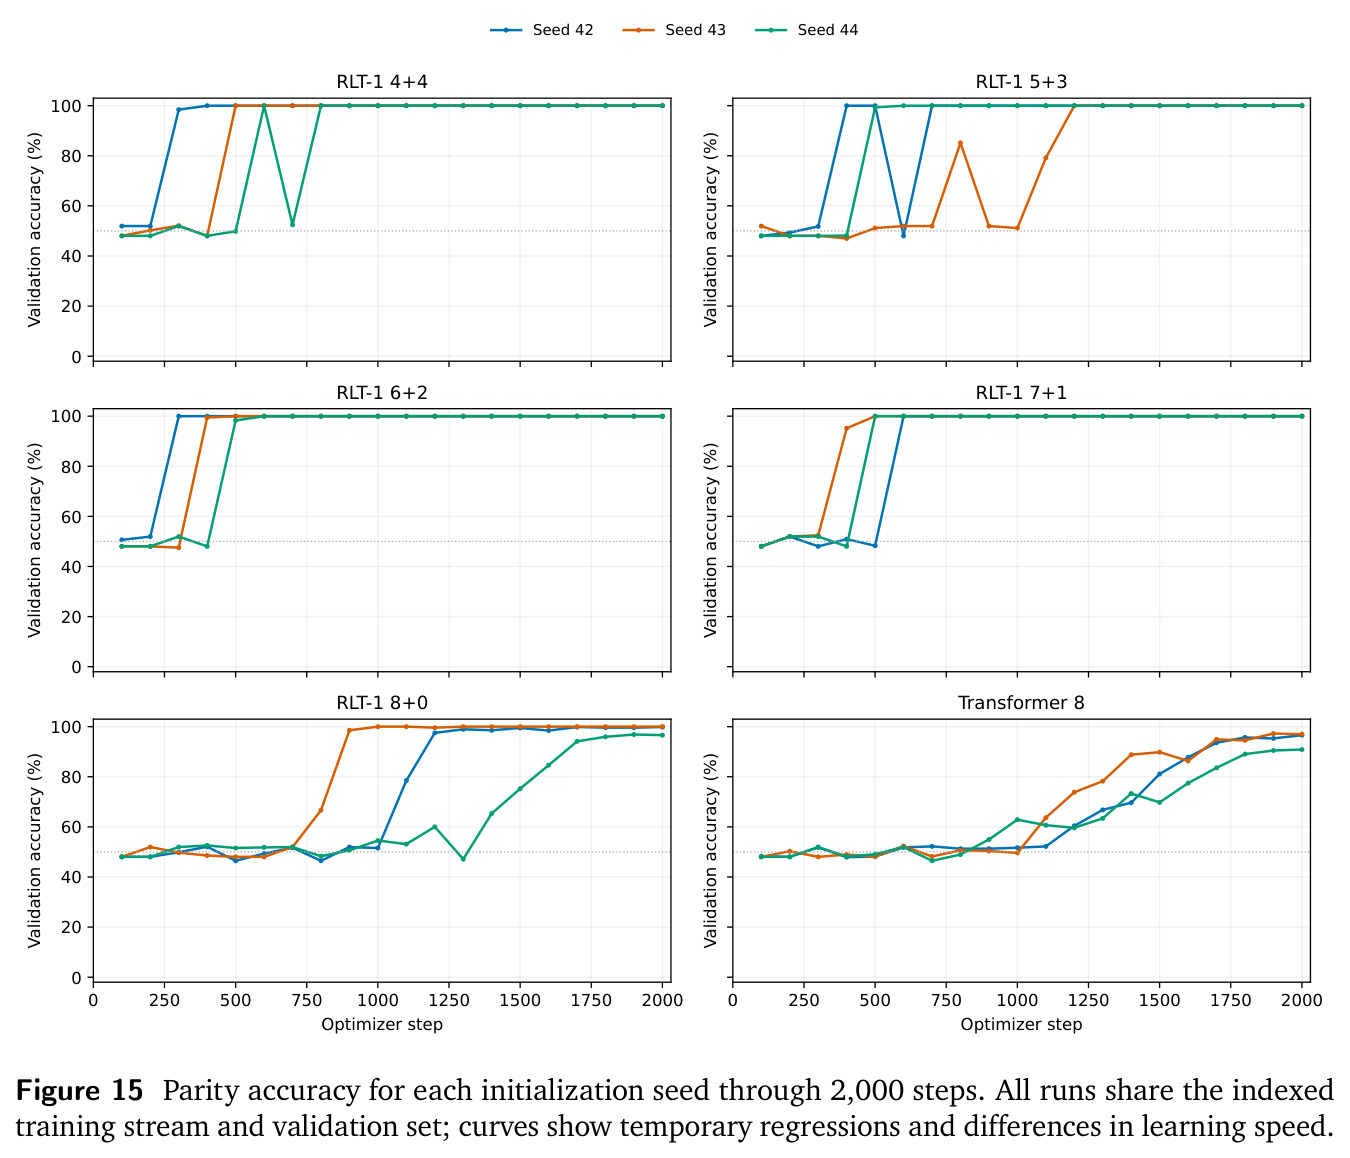
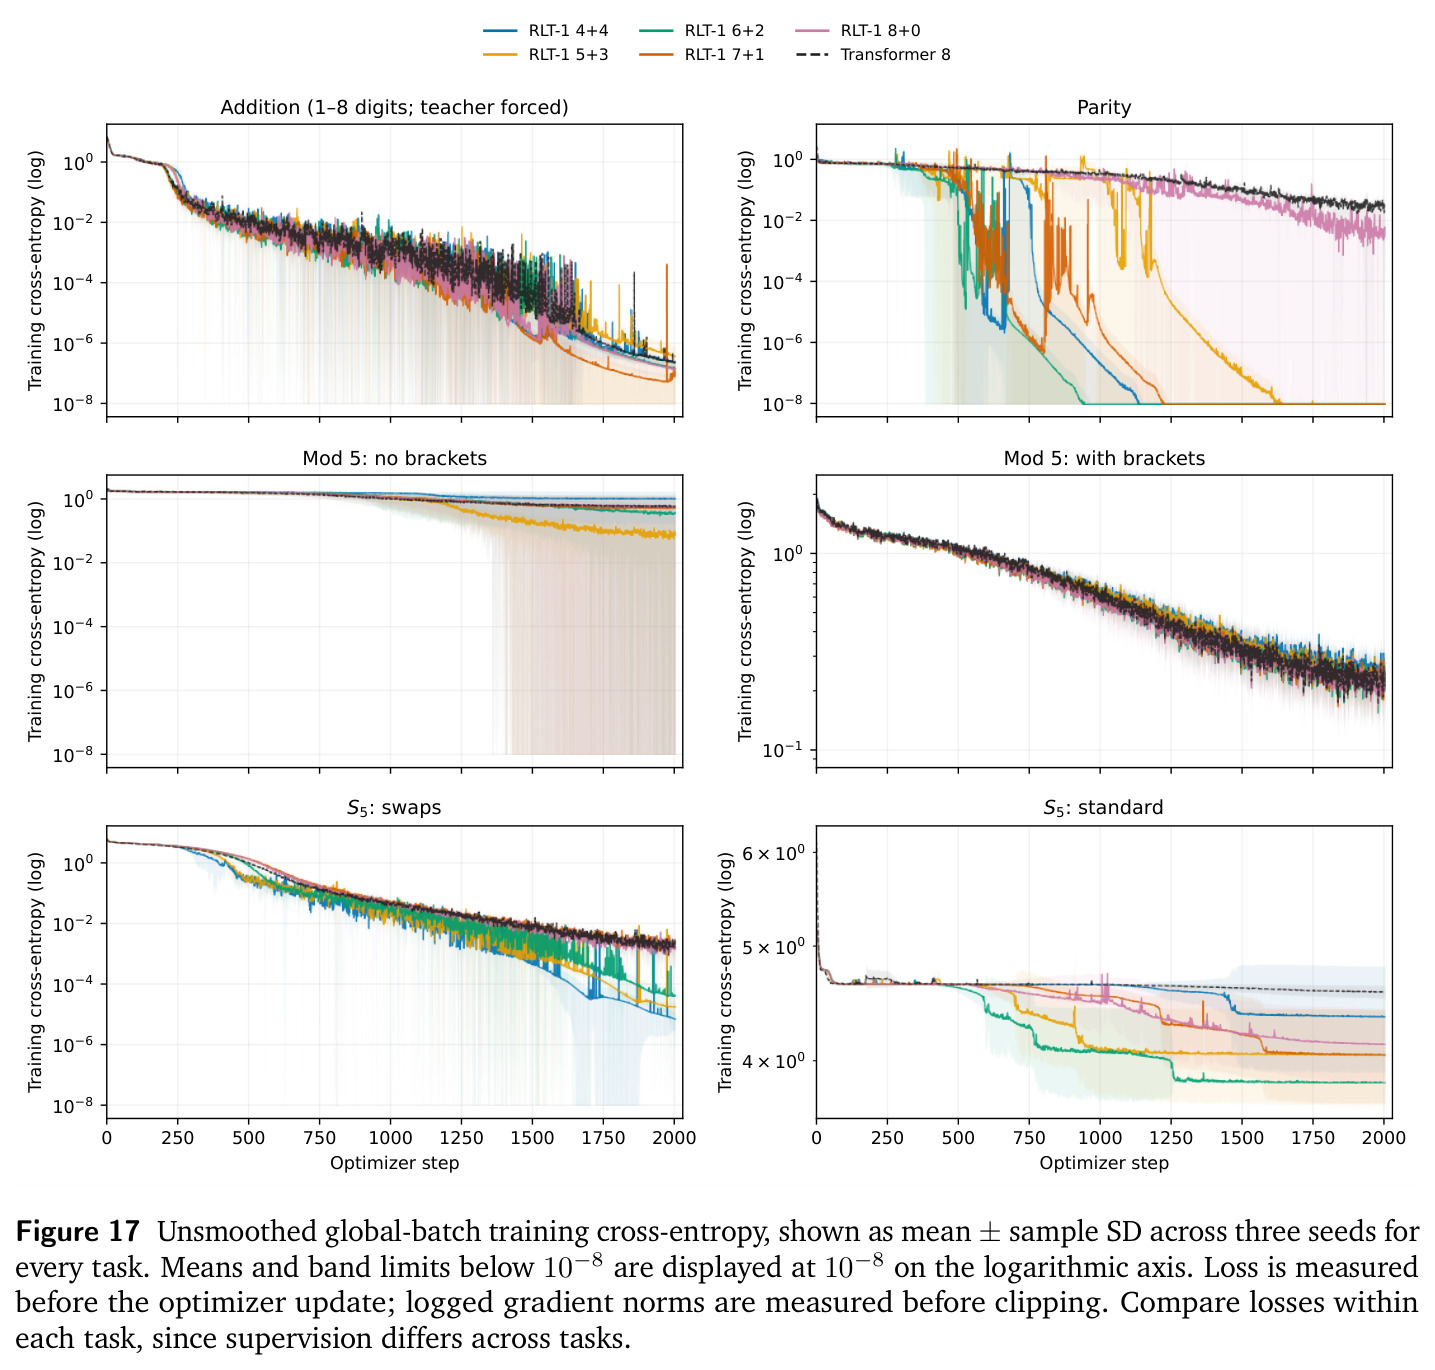
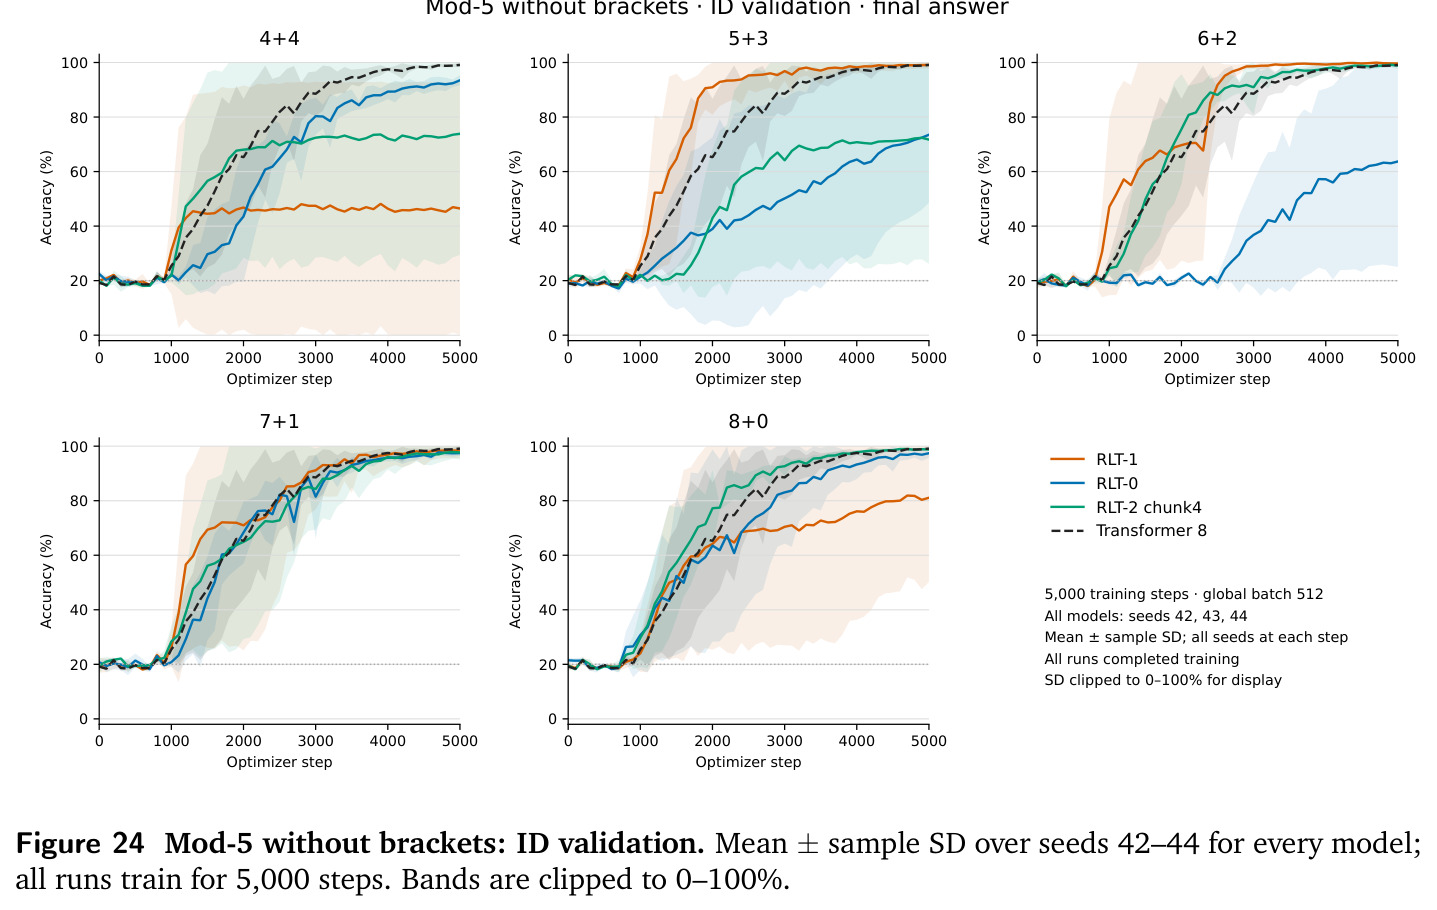
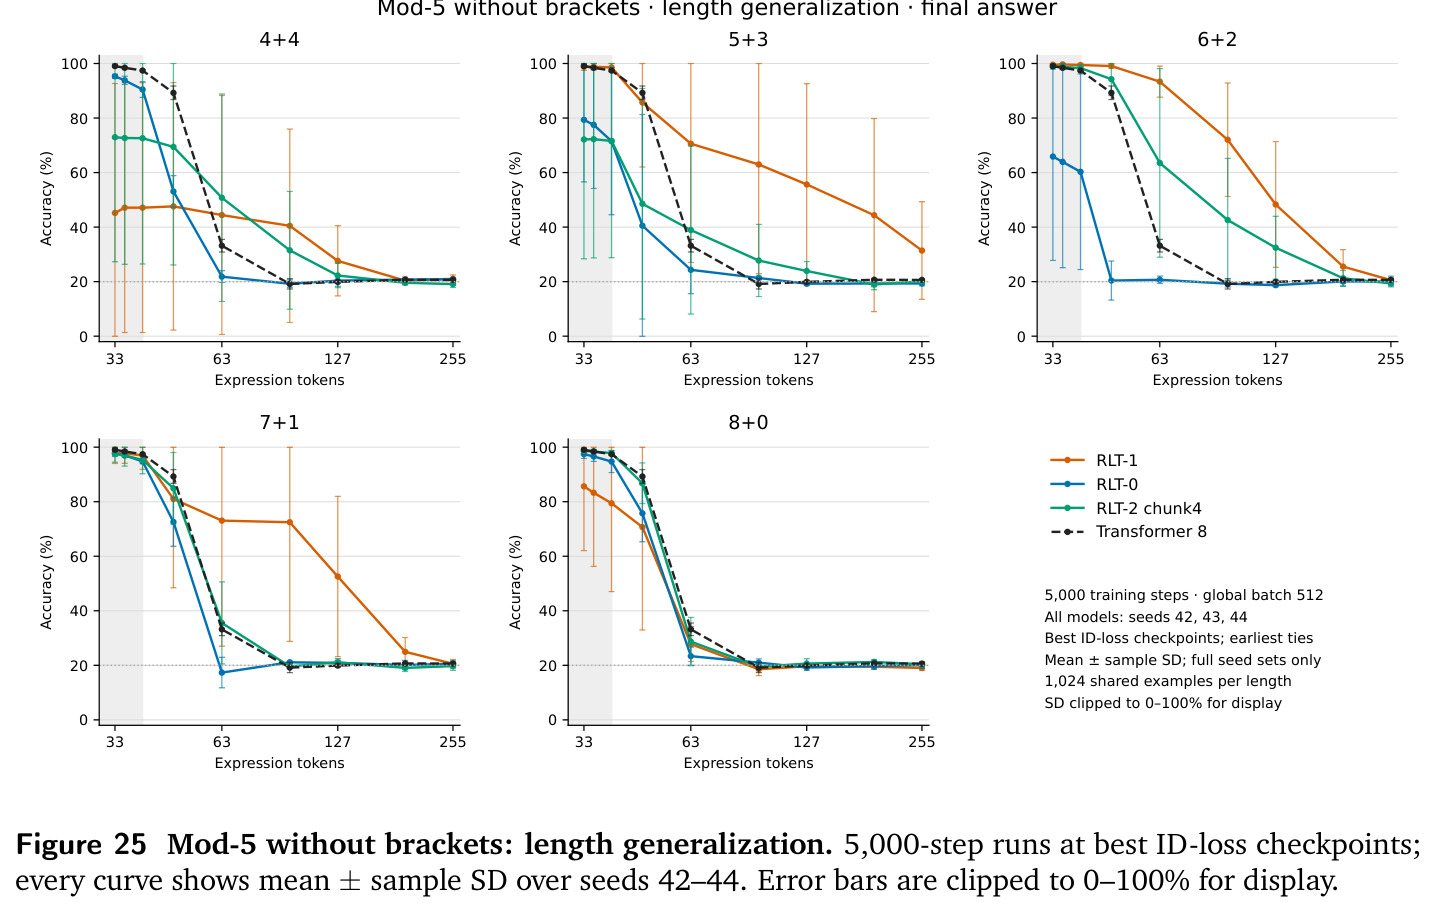
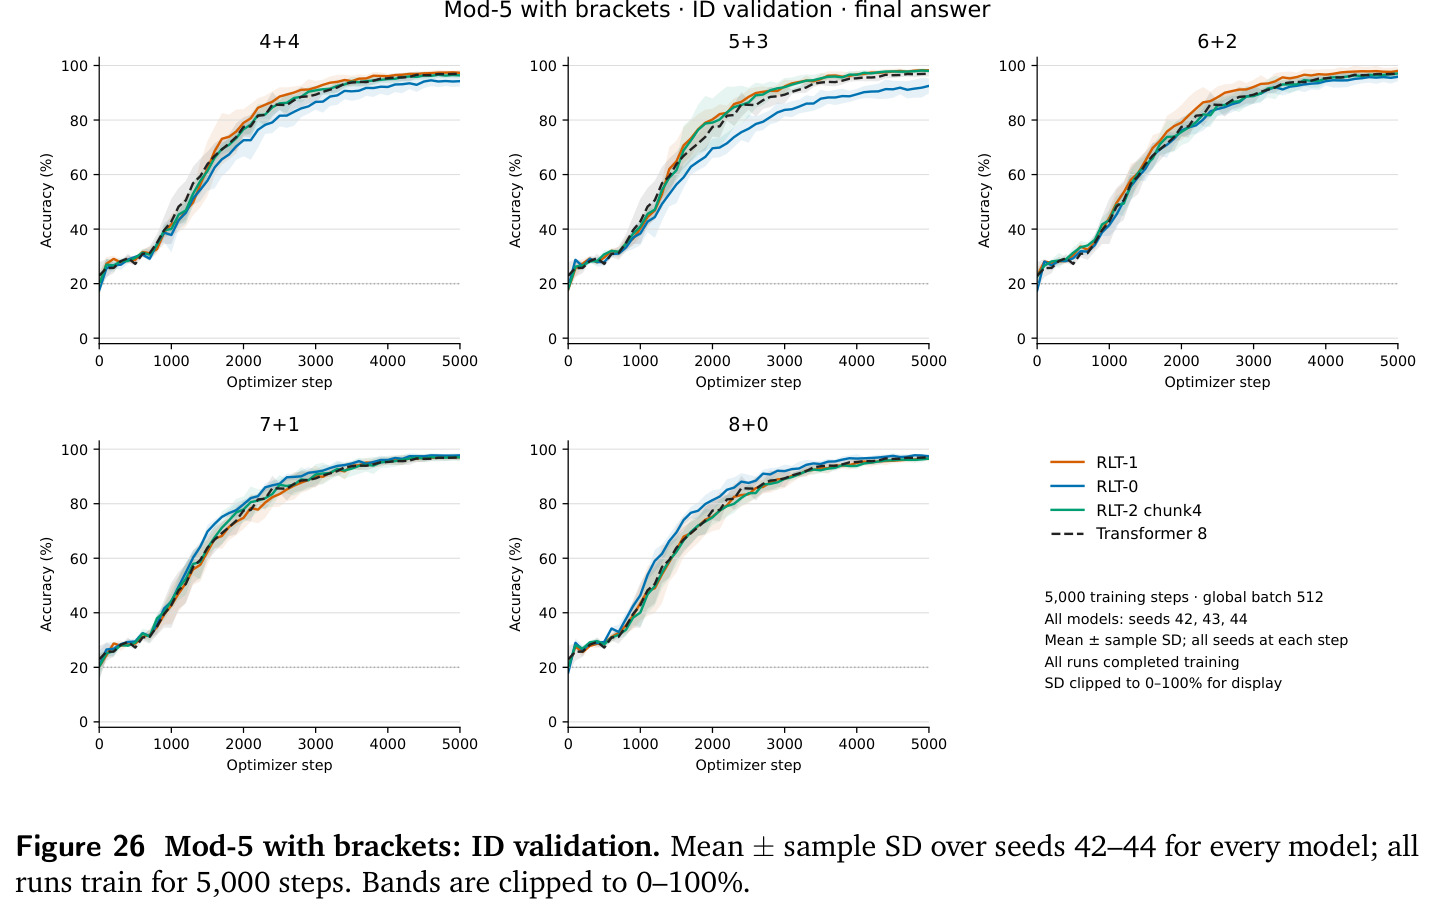
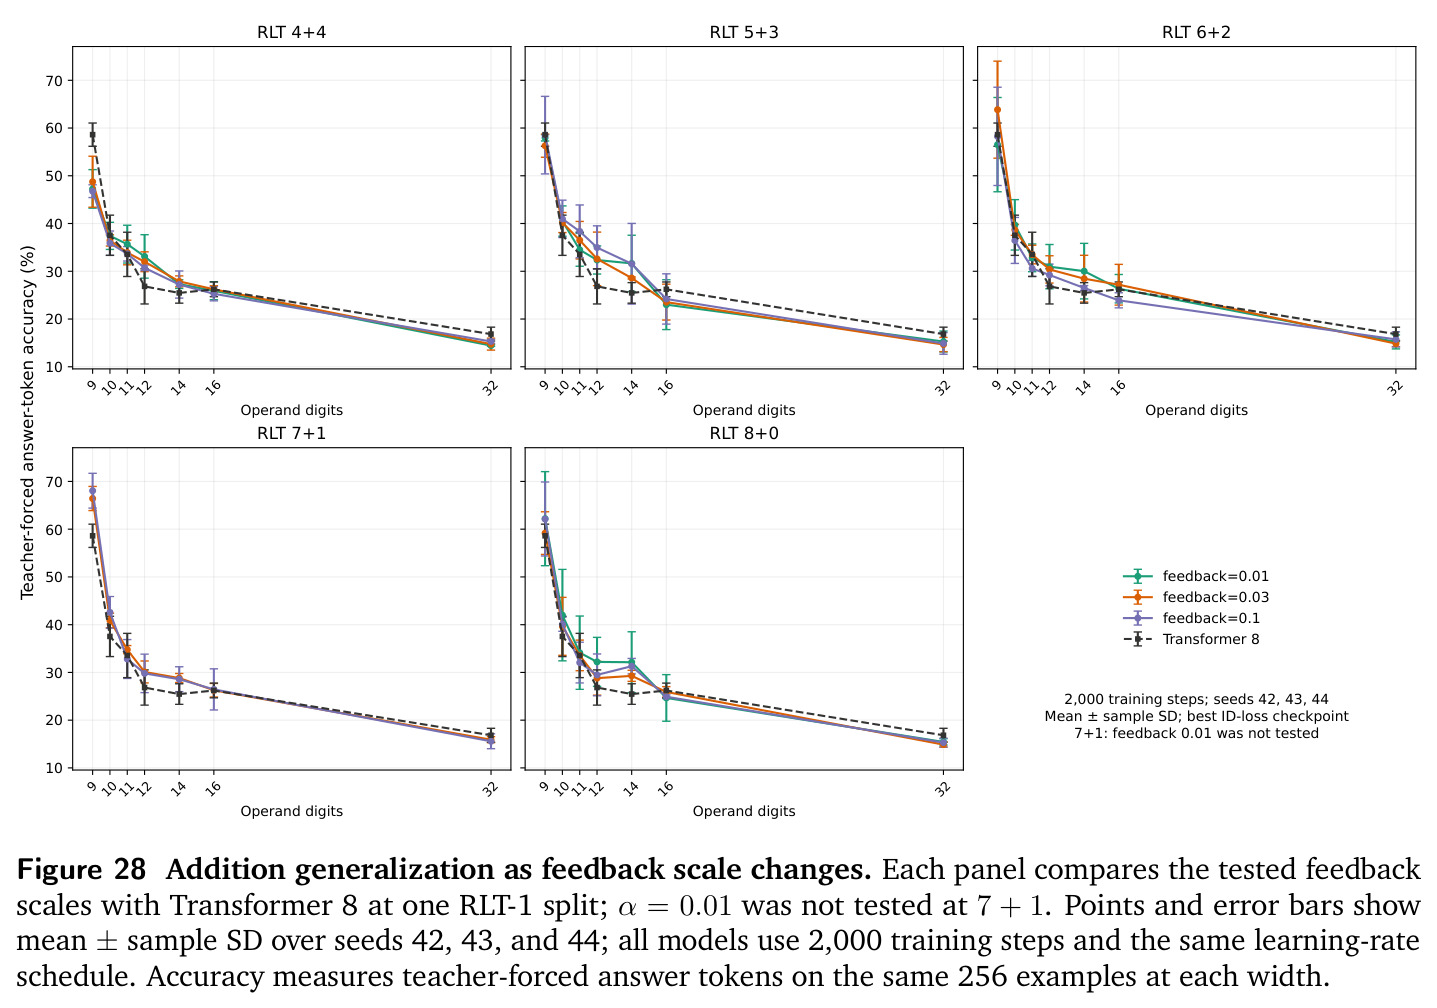
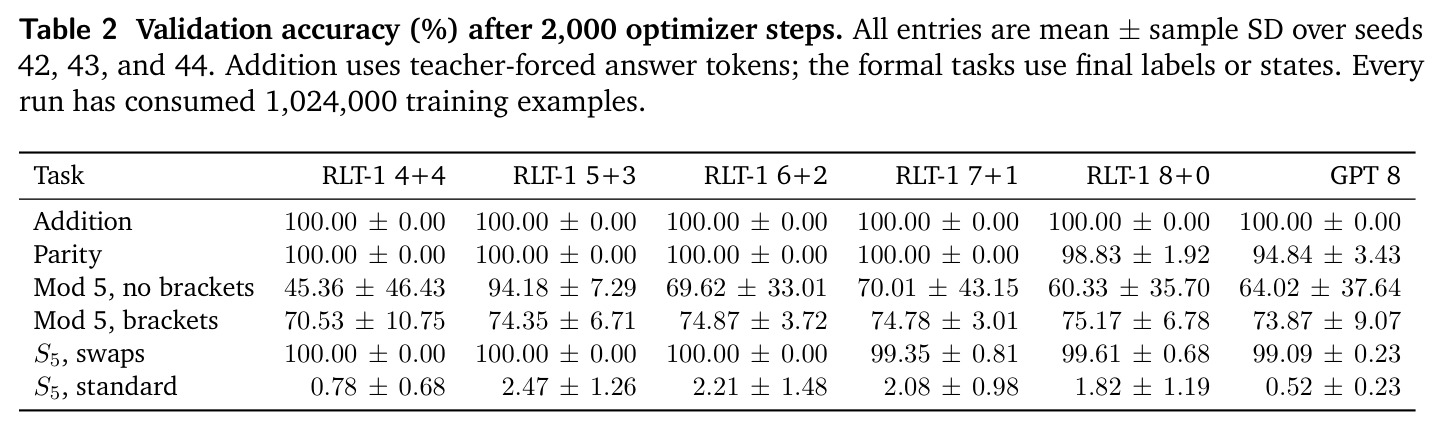
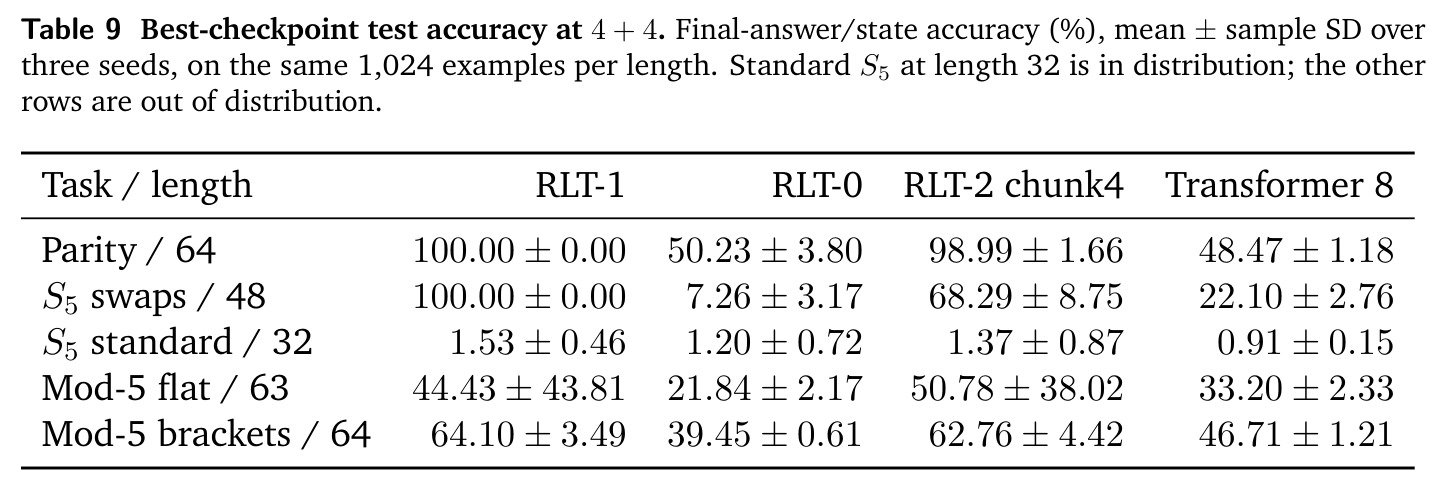
6 个算法任务、5 种层拆分、3 种子显示:奇偶校验仅训练 3-40 比特,5+3 与 7+1 在 256 比特达 $100 \pm 0\%$,Transformer 仅 $50.07 \pm 1.63\%$,500 步时 6+2 已达 $99.44\%$。交换 S5 训练 32 步、测试 256 步时 4+4 达 $97.30 \pm 2.76\%$,Transformer 仅 $0.85\%$,512 步仍达 $55.70\%$;准确率随解码深度从 1 层(随机)升至 4 层 97%。模 5 算术(5000 步):平坦表达式长度 63 上 6+2 达 $93.36\%$ 对 $33.20\%$;括号长度 64 上 5+3 达 $67.97\%$ 对 $46.71\%$。消融:RLT-0 使 64 比特奇偶跌至 $50.23\%$;$B=4$ 保住奇偶 $98.99\%$,却把 64 步交换 S5 砍到 $19.60\%$,置换跟踪依赖逐 token 反馈,奇偶分块鲁棒。反例:加法超出 8 位后全部模型崩溃(32 位仅 14.89%-16.84%),标准 S5 停在 $1/120$。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| 奇偶校验(训练 3-40 比特,测试 256 比特,2000 步) | 最终答案准确率(3 种子均值±样本SD) | RLT-1 5+3 / 7+1:100 ± 0% | 8 层 decoder-only Transformer:50.07 ± 1.63% | 提升约 49.9 个百分点,从随机猜到完全正确 |
| 交换 S5 状态跟踪(训练 32 步,测试 256 步 = 8 倍训练长度) | 最终状态准确率 | RLT-1 4+4:97.30 ± 2.76% | 8 层 Transformer:0.85 ± 0.30% | 提升约 96.5 个百分点;512 步时仍领先 54.9 个百分点(55.70% 对 0.85%) |
| 模 5 平坦算术(训练长度 3-39,测试长度 63,5000 步) | 最终答案准确率 | RLT-1 6+2:93.36 ± 5.69% | 8 层 Transformer:33.20 ± 2.33% | 提升约 60.2 个百分点 |
| 模 5 括号算术(训练长度 3-40,测试长度 64,5000 步) | 最终答案准确率 | RLT-1 5+3:67.97 ± 2.91% | 8 层 Transformer:46.71 ± 1.21% | 提升约 21.3 个百分点 |
| 64 比特奇偶校验(反馈间隔消融,B=4 分块并行) | 最终答案准确率 | RLT-2 chunk4:98.99 ± 1.66% | RLT-1(B=1):100 ± 0%;RLT-0(无反馈):50.23 ± 3.80% | 分块仅损失约 1 个百分点,换取 2.27 倍训练加速,验证 B 轴的并行-精度权衡 |
局限与改进
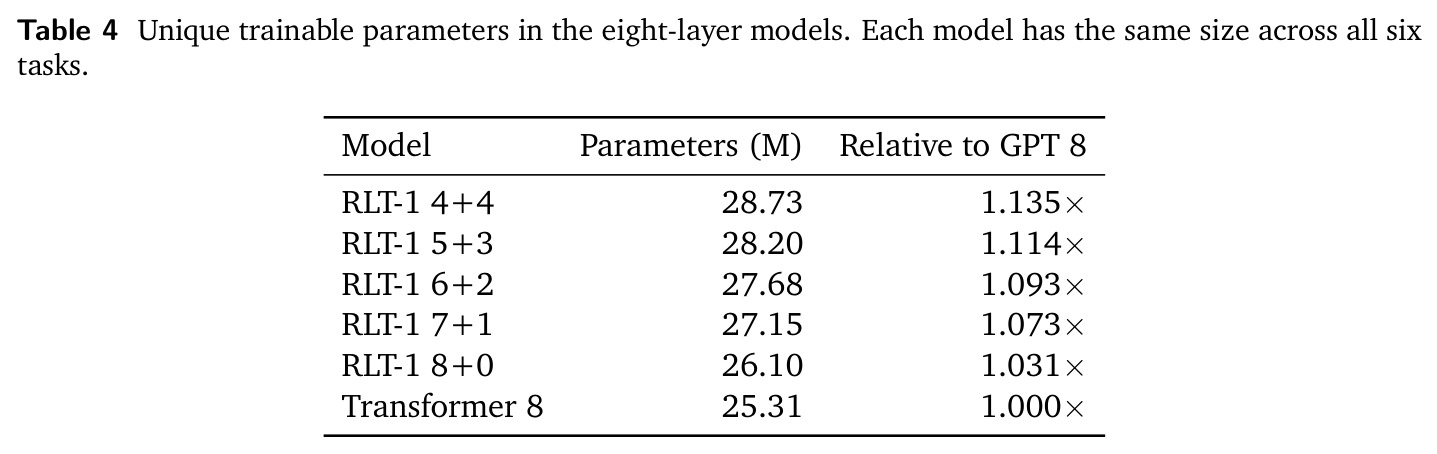
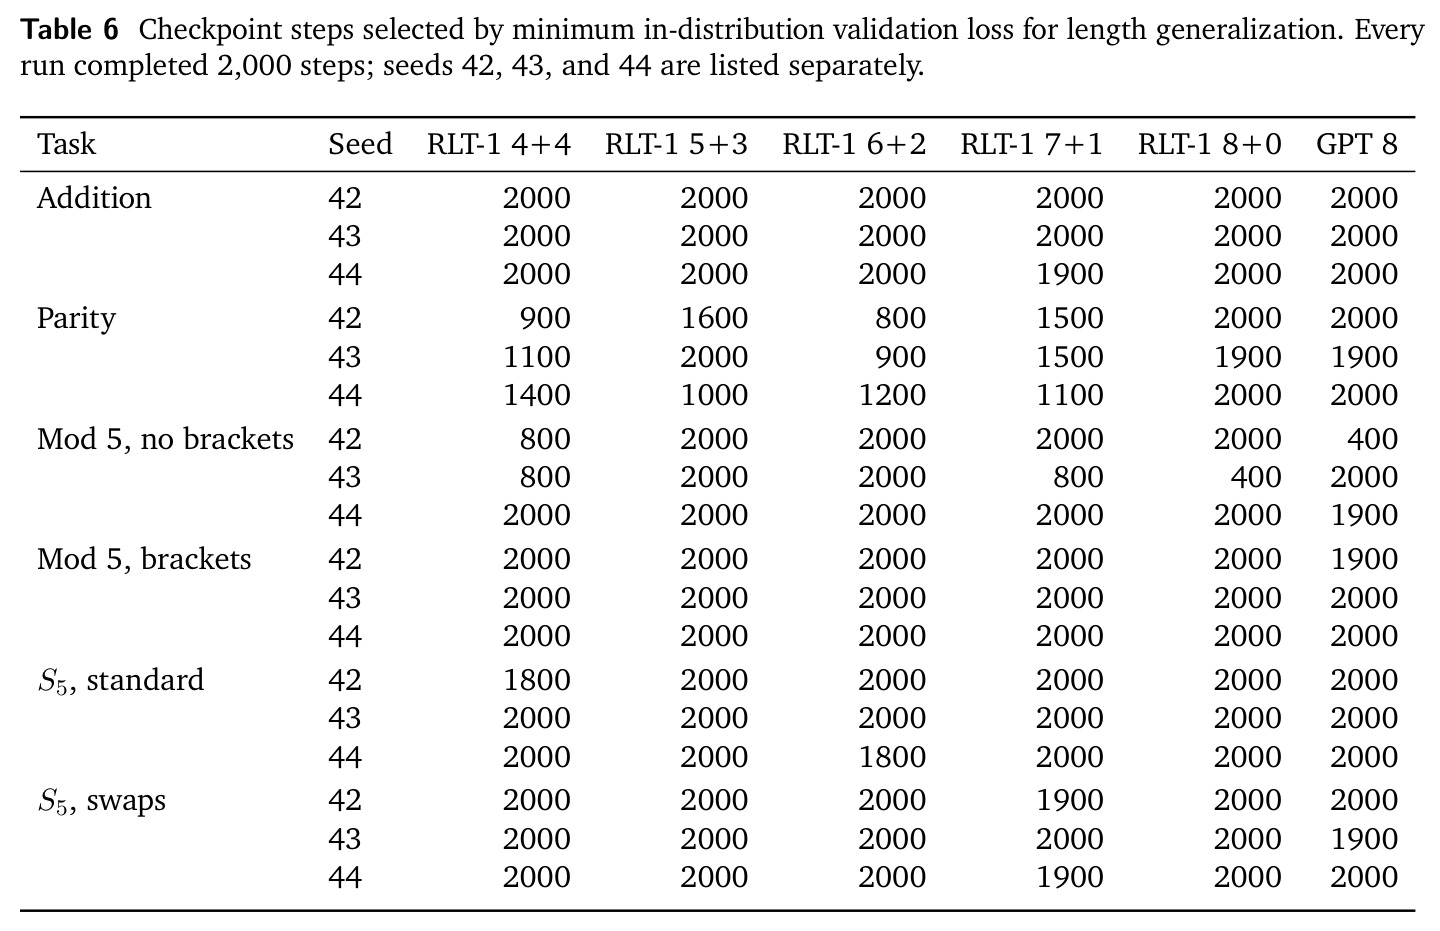
作者承认的局限:加法任务全部模型在超过训练宽度后崩溃(32 位数字准确率仅 14.89%-16.84%);标准 S5(全部 120 个置换)所有变体最终状态准确率都停在 $1/120$ 均匀参考附近,说明当前规模学不会一般置换复合;分块反馈对置换类任务伤害巨大(64 步从 100% 降到 $19.60 \pm 6.54\%$);实验只在监督算法任务上进行,RL 性能未评估,附录 D 只给出目标与重放条件。我补充的观察:模型很小(26.10-28.73M 参数、8 层、宽度 512)且在 4 线程 CPU FP32 上训练,结论能否扩展到语言建模规模存疑;RLT 与 Transformer 基线参数量(25.31M)和计算量都不严格对齐,部分对比不够公平;解码器预填需要 $T$ 步顺序执行,实际吞吐受限;平坦 mod-5 部分分配在种子间方差极大(512 步 $55.70 \pm 25.78\%$),稳定性存疑;此外准确率依赖'最小 ID 验证损失'选检查点,而测试分数不参与选择,这一协议虽合理但对算法任务的最优点可能与最终泛化点不一致。
独立分析的弱点
独立分析四个弱点。(1) 解码器顺序瓶颈:预填与训练都要 $T$ 步顺序执行解码块,长序列墙钟时间显著劣于全并行 Transformer,chunk4 也只有 2.27 倍加速;改进方向是作者暗示的 $B$ 调度(先大块预训练再退火到 $B=1$),或用 Jacobi 迭代近似逐 token 状态。(2) 任务覆盖窄:全部是合成算法任务,未见自然语言或代码上的长程状态跟踪;改进方向是在真实语料上预训练 RLT,再在长上下文基准上验证收益是否迁移。(3) 标准 S5 完全失败:120 个置换上无效,可能因为状态空间巨大而反馈寄存器只有 $d=512$ 维向量,带宽不足;改进方向是增大状态维度、引入结构化状态(群表示或矩阵状态)或外置记忆库。(4) 长程梯度风险:反馈路径是 $t$ 个转移 Jacobian 的乘积,虽有门控与 $\alpha=0.1$ 稳定化,256 以上长度的训练动态缺乏理论保证;改进方向是研究循环架构的残差缩放或归一化规则。另外建议报告与基线算力严格对齐后的对比。
未来方向
作者明确提出但未实验的方向:分阶段反馈调度——预训练用大 $B$ 换取并行,中训练与后训练把 $B$ 逐步降到 1;因为 $B$ 不改变参数,只需在训练阶段间切换计算图,实验部分的 chunk4 与 RLT-1 结果已分别验证两端可行性。可延伸的方向包括:(1) 在 RL 中利用其精确策略重放性质,测试数学推理、规划等需要长链计算的任务上的增益;(2) 把深度分配与反馈间隔的研究推广到更大模型与真实语言任务,检验'解码深度需求随任务状态空间增长'的规律是否迁移;(3) 与权重共享(Universal Transformer 式深度循环)正交组合,同时沿 token 和深度两个方向循环;(4) 理论侧刻画带门控反馈的 Transformer 的表达力边界,判断其是否绕开 $TC^0$ 限制或仍受其约束;(5) 用结构化或外置记忆增强反馈寄存器,攻克标准 S5 与更长程的组合任务;(6) 研究反馈路径上 Jacobian 乘积的稳定性条件,为更大规模训练提供设计准则。
复现评估
复现条件相当友好,属于少见的笔记本可复现研究。论文给出项目页 GitHub(yifanzhang-pro/recurrent-looped-tranformer),正文与附录披露全部关键细节:模型规格(8 层、宽度 512、FFN 1365、4 头、SWA 窗口 8、$G=1$、$\alpha=0.1$)、优化器(AdamW,$\beta=(0.9,0.95)$,权重衰减 0.1,梯度裁剪范数 1,学习率 $10^{-4}$ 预热 200 步后余弦退火至 $5\times10^{-6}$)、全局批量 512/微批 32、数据生成器与指标(附录 J)、3 个种子(42/43/44)与共享训练/测试流、按最小 ID 验证损失选检查点的协议。最惊人的是算力需求:全部训练在 4 线程 CPU FP32 上完成,单模型仅约 26M 参数,2000-5000 步即可复现主要曲线。风险点:分块训练与预填流程(附录 I)及精确策略重放(附录 D)实现较复杂且无开源实验验证,部分 mod-5 结果种子间 SD 超过 5 个百分点,复现时建议至少跑 3 个种子。
论文图表