面向数万次测试时迭代的循环原生注意力残差 Scaling to Tens of Thousands of Test-Time Iterations with Loop-Native Attention Residuals
用带衰减的注意力残差替换逐轮覆盖,让7M循环模型在两万次迭代中越算越准
前置知识
循环Transformer(Looped Transformer)
将同一个 Transformer 块 $f_\theta$ 反复应用 $T$ 次来处理复杂推理任务,每次迭代只增加计算深度而不增加参数量,测试时可以执行更多循环来投入更多计算,是测试时计算扩展(test-time compute scaling)的经典途径,代表工作包括 Universal Transformer、HRM 和 TRM。
本文研究对象就是循环 Transformer,其核心痛点是迭代加深后性能不升反降,理解循环结构才能明白 InfiLoop 究竟改进了哪个环节。
carry-last 规则(状态替换)
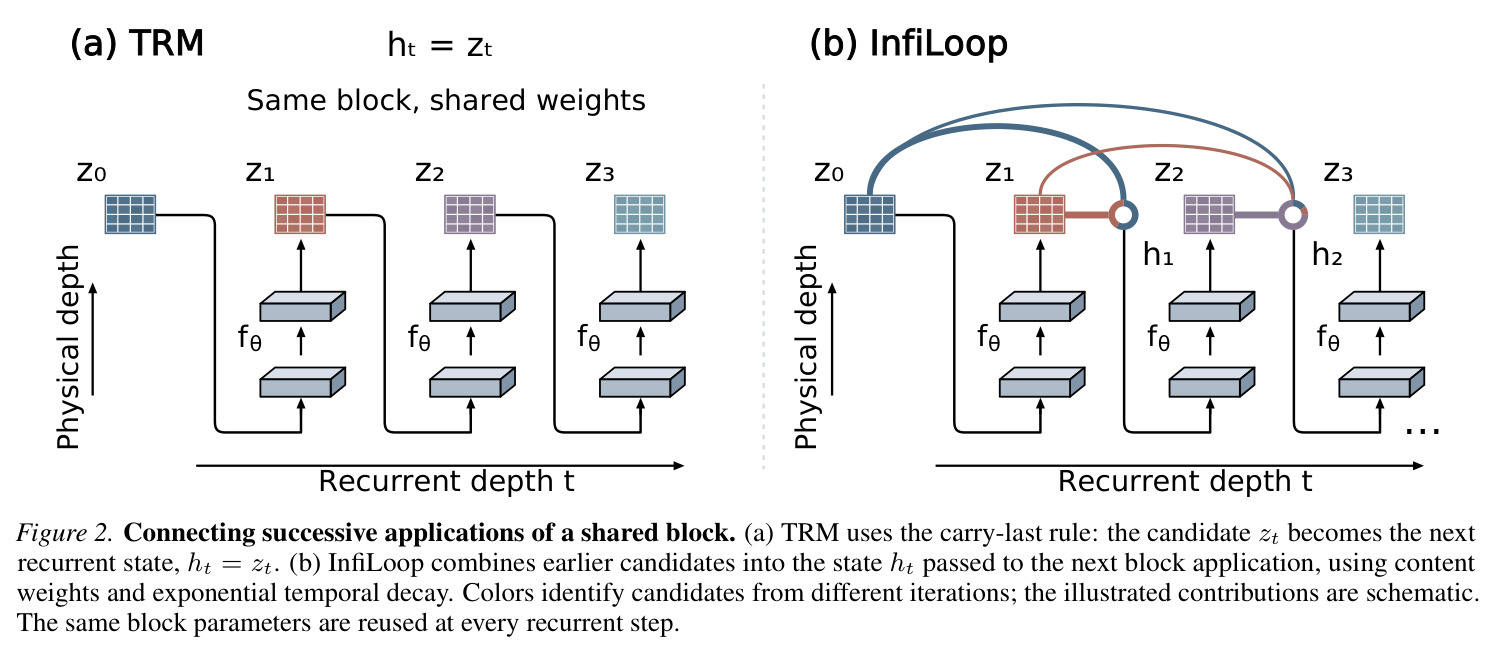
连接相邻两次循环最常见的方式:把本轮共享块的输出 $z_t$ 直接作为下一轮的递归状态,即 $h_t = z_t$。这样早期计算的信息只能通过最新状态间接保留,一次噪声更新就会覆盖正确的中间推理结果,且错误一旦经递归传播产生,后续循环很难再纠正。
carry-last 是论文诊断出的性能瓶颈,也是 InfiLoop 要替换的对象,是理解全文动机与实验设计的关键概念。
残差连接与深度之咒
残差连接把层的输入直接加到输出上($h + f(h)$),保证梯度和信息能跨层传播,Pre-LN/Post-LN 是标准实现。但标准深 Transformer 存在深度之咒(curse of depth):越深的层贡献越递减;循环结构共享同一个块,反复应用会放大这一限制,残差流随循环数不断增长。
InfiLoop 本质上是一种专为循环迭代设计的残差连接,需要对比它与 Pre-LN/Post-LN 及层缩放等已有稳定化手段的本质区别。
RMSNorm
一种只做缩放、不做均值中心化的归一化方法,将向量除以其均方根:$\mathrm{RMSNorm}(z) = z / \sqrt{\frac{1}{d}\sum_i z_i^2}$,广泛应用于现代 Transformer(如 LLaMA)。本文用它把候选状态标准化后再与伪查询做内积打分,使分数尺度稳定可比。
候选打分 $s_i = q^\top \mathrm{RMSNorm}(z_i)$ 是注意力残差聚合的输入,不了解 RMSNorm 就无法理解内容分数如何计算。
指数加权流式递归(online softmax / EMA)
当历史项的权重按同一几何因子衰减时,加权求和可以用递推式增量更新:只需维护一个加权状态向量和一个归一化标量,新项到来时历史累积乘以 $\beta$ 再加上新贡献。这与在线 softmax、指数滑动平均同源,把对全部历史 $O(T)$ 的存储压缩为 $O(1)$,且代数上精确等价、无近似。
InfiLoop 的常数内存性质完全来自这个递推技巧,是循环原生(loop-native)与精确等价两大卖点的技术基础。
深监督与 TRM 训练范式
Tiny Recursive Model(TRM)的训练方式:把推理过程分成多个监督段(segment),每段执行若干次共享块应用,只对段尾若干步回传梯度,并在多份增广数据上做监督。TRM 采用内环精化、外环更新上下文的嵌套循环结构,是 7M 参数级推理任务的强基线。
论文实验协议($H=3$ 外环、$L=6$ 内环、12 段、每段 21 次块应用、只回传最后 7 步)全部建立在深监督之上,是读懂实验设置的前提。
研究动机
循环 Transformer 靠反复应用共享块换取测试时计算,但常用的 carry-last 规则把每轮输出直接覆盖为下一轮状态,导致迭代越深性能越差。论文在 Sudoku-Extreme 上量化了这一现象:TRM 在 468 层有效深度达到 62.2% 的峰值后,1,872 层时跌回 58.1%;在第 36 到 72 次外环更新之间,它平均每题改动 77.0 个已填格子的预测,错误格子数不降反增 0.21,还把 20.9% 此前答对的格子改错;对齐到首次解出的时间点看,TRM 的状态变化率短暂降到 3% 后又回升到每步 10%,36 次更新后丢失了 19.7% 已解出的题目。已有的 FPRM 等方案用指数衰减、学习残差缩放或阻尼不动点来控制更新幅度,但都保留下一轮只看最新状态的结构,噪声更新依然会污染整条推理轨迹。
本文的目标是本文的目标是把循环推理的额外计算深度真正转化为推理能力:设计一种循环原生的残差连接,替代 carry-last 的状态替换规则,让模型学会保留哪些过去的计算、接受多少新的更新。具体而言,新连接要在每轮循环中对历次候选状态做内容感知的加权聚合,抑制不可靠的提案、保住有用的中间状态;同时聚合所需的持久内存必须与循环次数无关(每 token 只要 $O(d)$),从而支持上万次迭代而不爆显存;最终要在 Sudoku-Extreme、Maze-Hard、ARC-AGI 等基准上超过 TRM、FPRM 等递归推理模型,并验证加深迭代能持续带来精度提升——例如在 Sudoku-Extreme 上超过 20,000 有效步仍在变强。
与已有工作不同的是,以往对深循环退化的治理思路是控制更新幅度:用衰减、层缩放(如 FPRM 的学习残差缩放与阻尼不动点)约束每步更新对表示的影响,但连接结构不变,早期信息仍只能挤在最新状态里。本文换了更根本的视角:问题不在更新多强,而在信息如何跨循环组合。作者把 Kimi Team 2026 年提出的跨层 Attention Residuals 迁移到递归时间轴上,对历次循环输出做带可学习指数衰减的注意力聚合,并利用共享打分器与几何衰减的代数性质推出精确流式递归,把 Full Attention Residuals 的 $O(Td)$ 内存、$O(T^2 d)$ 计算降到 $O(d)$ 与 $O(Td)$,首次让带选择的跨循环聚合在常数内存下可行,且可直接套用到 TRM/HRM 这类嵌套循环架构的每条递归轴上。
核心方法
InfiLoop 的直觉是:循环推理器应该像人一样记住关键中间结论、丢弃噪声草稿,而不是每轮把整个推理状态推倒重来。为此它把相邻循环间的 carry-last 替换为一次小型注意力:维护对历次候选状态 $z_i$ 的加权汇总 $h_t$ 作为下一轮输入。技术上,每产生一个候选就用共享伪查询 $q$ 打分 $s_i = q^\top \mathrm{RMSNorm}(z_i)$,再乘可学习指数衰减 $\exp(-\lambda(t-i))$ 得到权重,归一化后聚合。由于历史分数不变、旧权重每步同乘 $\beta = e^{-\lambda}$,聚合可写成精确流式递归 $N_t = \beta N_{t-1} + e_t z_t$、$D_t = \beta D_{t-1} + e_t$、$h_t = N_t / D_t$,每 token 只需一个 $d$ 维向量加一个标量的持久内存,与循环数无关。模型沿用 TRM 的 7M 参数嵌套架构(2 层共享块、隐藏维 512、8 头、SwiGLU),在内、外两条循环轴上各挂一组打分-衰减参数(每轴 513 个参数)。
核心创新是循环原生注意力残差:把跨层 Attention Residuals 改造成跨迭代时刻的聚合并加上时间衰减。状态定义为 $h_t = \sum_{i=0}^{t} \alpha_{t,i}\, z_i$,$\alpha_{t,i} = \exp(s_i - \lambda(t-i)) / \sum_{j}\exp(s_j - \lambda(t-j))$,$s_i = q^\top \mathrm{RMSNorm}(z_i)$ 是候选产出那一刻一次性算好的内容分。与 carry-last 的本质区别在于早期计算不再只能通过最新状态间接存活,模型可显式选择保留哪一版推理;与 Full Attention Residuals 的区别在于共享查询并引入几何衰减,权重分解为 $\exp(s_i)\cdot\beta^{t-i}$,从而存在精确递推。代数上聚合等价于自适应残差更新 $h_t = h_{t-1} + \gamma_t (z_t - h_{t-1})$,步长 $\gamma_t = e_t/(\beta D_{t-1} + e_t) \in (0,1)$,让模型学会这轮更新值几分之几的信任。
方法步骤详情
第一步,候选生成:共享块 $f_\theta$ 在第 $t$ 轮以 $h_{t-1}$ 和输入 $x$ 为条件产出候选 $z_t = f_\theta(h_{t-1}; x)$。第二步,内容打分:计算 $s_t = q^\top \mathrm{RMSNorm}(z_t)$ 并令 $e_t = \exp(s_t)$,每个候选只在产出时打一次分。第三步,流式聚合:按 $N_t = \beta N_{t-1} + e_t z_t$、$D_t = \beta D_{t-1} + e_t$ 递推($\beta = e^{-\lambda}$,$N_0 = e_0 z_0$、$D_0 = e_0$ 保证 $h_0 = z_0$),输出 $h_t = N_t/D_t$ 交给下一轮,与显式求和代数等价。第四步,嵌套轴并行:内外环各维护独立的 $(q, \beta, N, D)$,每轴仅新增 513 个参数,聚合状态不随循环数增长。第五步,训练:基于 TRM 代码库与深监督,Sudoku 用 AdamW、学习率 $10^{-4}$、$H=3$ 外环、$L=6$ 内环、12 个深监督段,每段 21 次块应用、只回传最后 7 步梯度。
技术新颖性
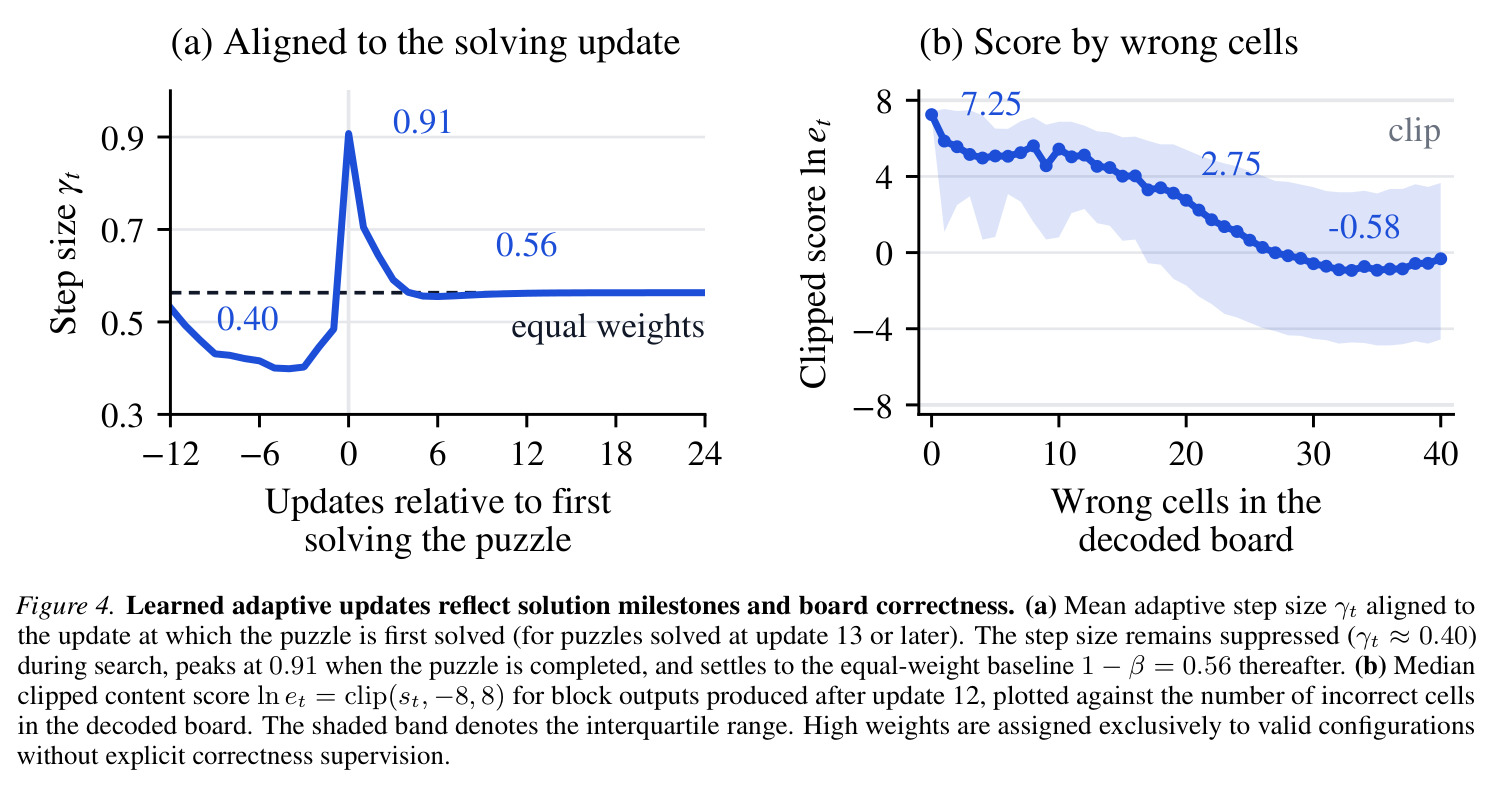
技术新颖性体现在三点。其一,连接结构层面:首次把对历史输出的注意力聚合成循环迭代之间的原生残差,取代广泛使用的状态替换规则;已有方法(FPRM 的预范数加学习残差缩放加阻尼不动点、各类层缩放)只在更新幅度上做文章。其二,复杂度层面:共享打分与几何衰减推出精确流式递归,相对 Full Attention Residuals,峰值持久内存从 $O(Td)$ 降到 $O(d)$,总聚合计算从 $O(T^2 d)$ 降到 $O(Td)$,且聚合状态保持在候选凸包内($\|h_t\| \le \max_i \|z_i\|$),天然抑制范数爆炸。其三,行为层面:打分器完全无监督,却在实验中涌现出自验证行为——搜索期把步长压在约 0.40、解出瞬间冲到 0.91、解后回落到等权基线 $1-\beta = 0.56$,内容分与棋盘正确性强相关(全对时中位 $\ln e_t = 7.25$,33 格错时为 $-0.58$),说明该连接真正学到了何时该写入状态。
实验结果
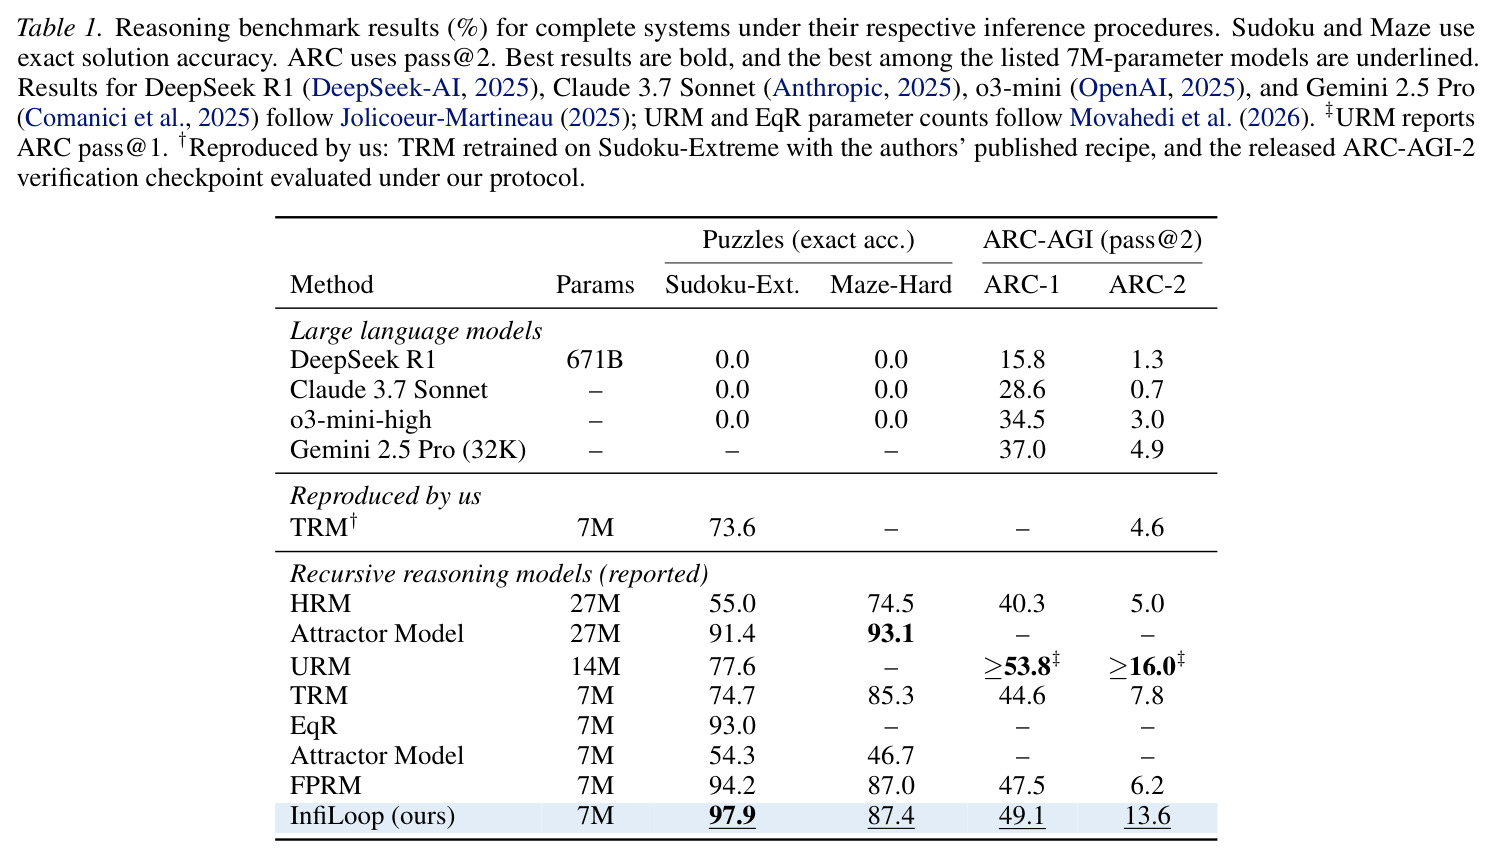
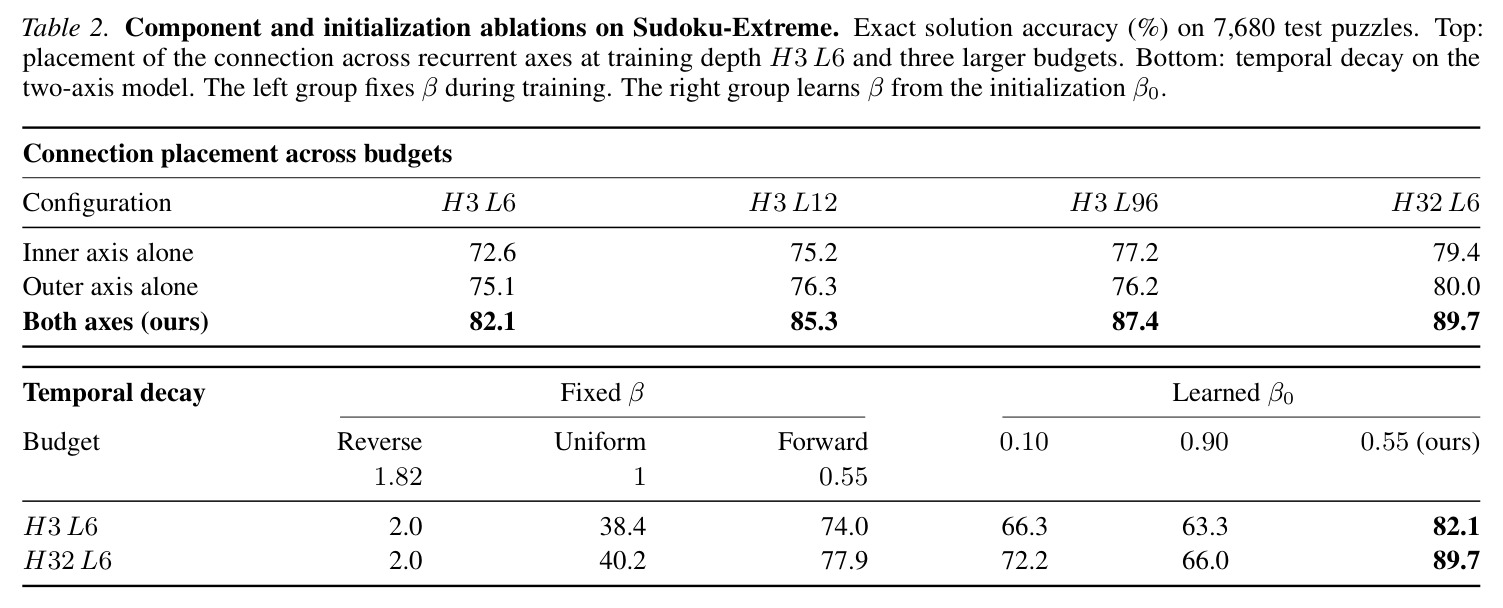
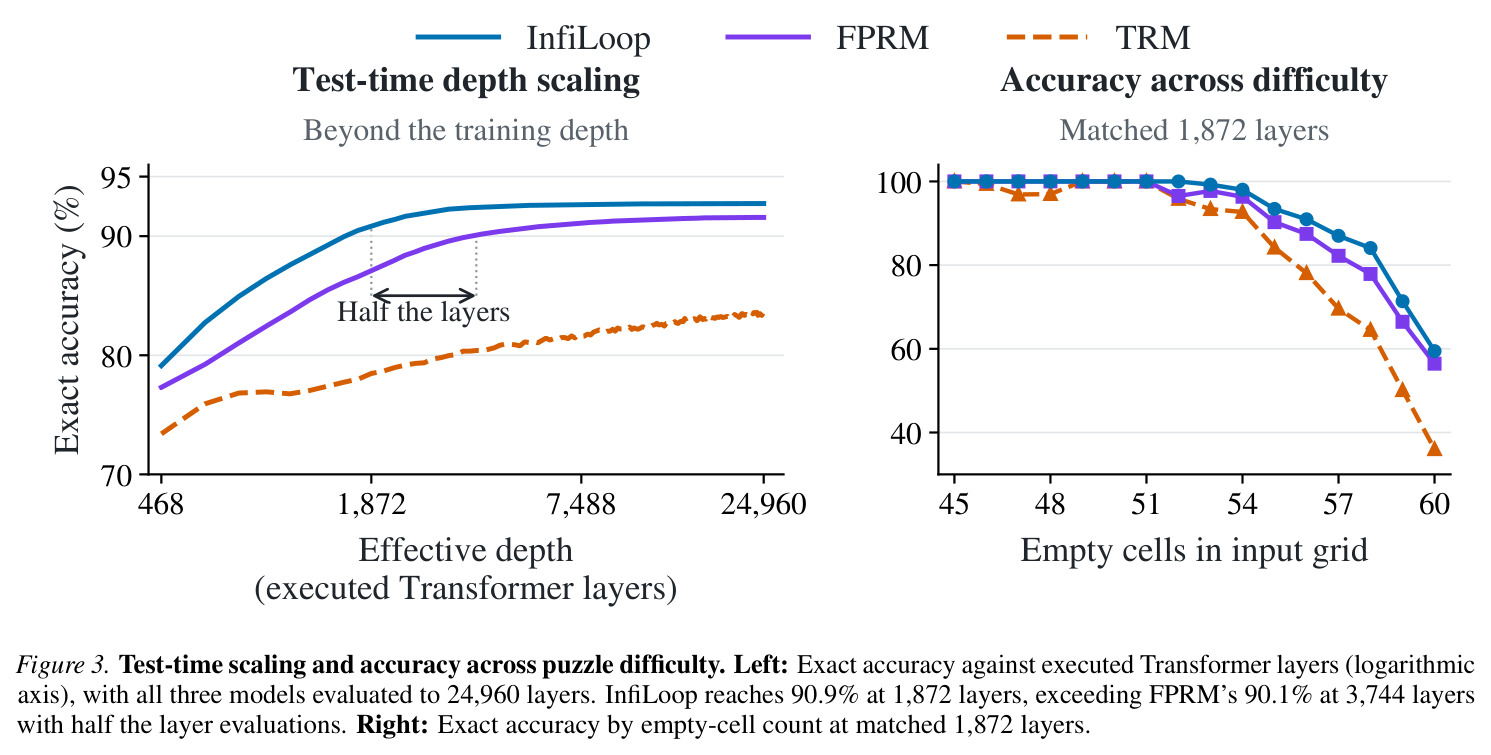
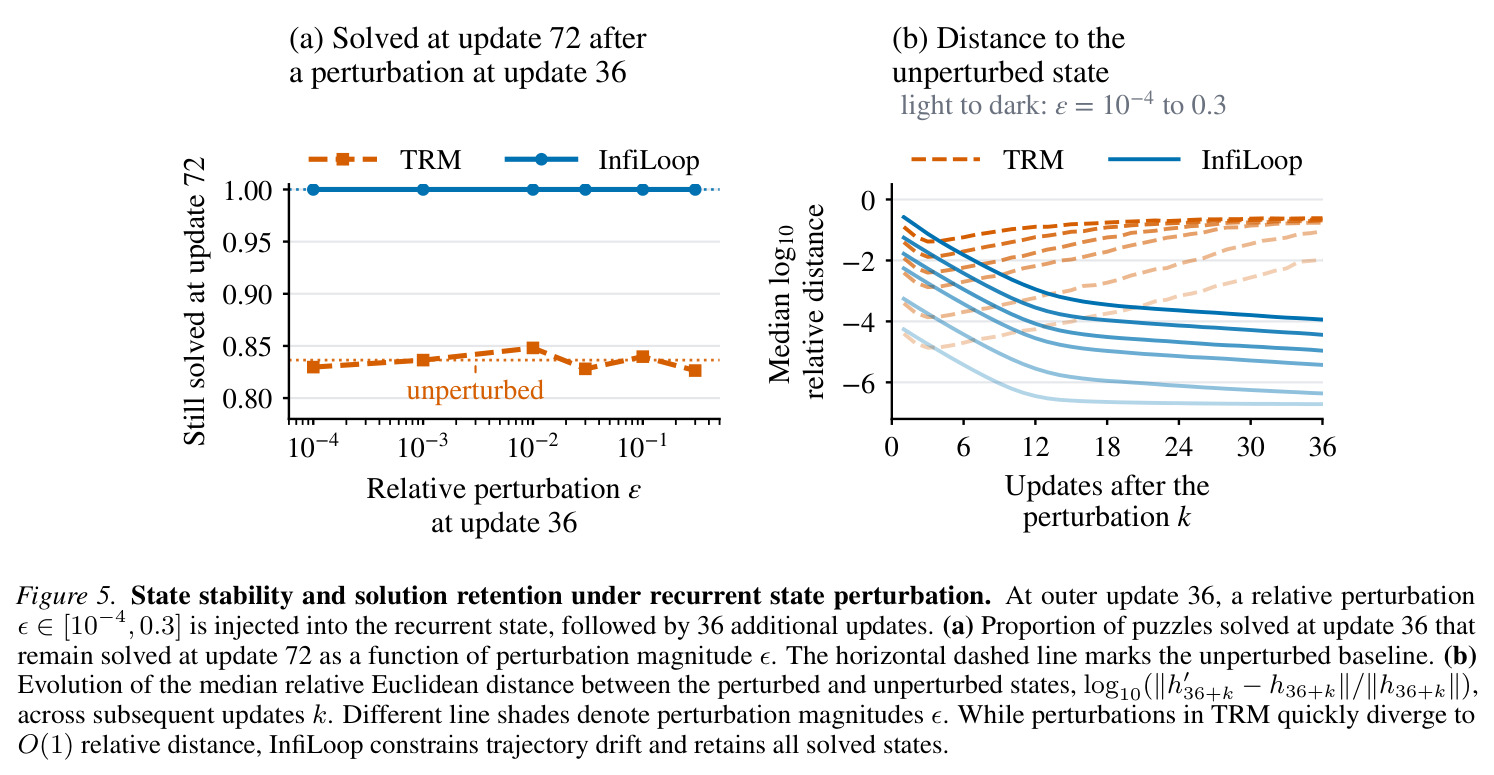
主实验(Table 1)显示 7M 参数的 InfiLoop 全面领先同级递归模型:Sudoku-Extreme 精确准确率 97.9%(FPRM 94.2%、TRM 74.7%),Maze-Hard 87.4%(TRM 85.3%),ARC-AGI-1 pass@2 49.1%(FPRM 47.5%),ARC-AGI-2 达 13.6%,约为 TRM 7.8% 的两倍,远超 671B 的 DeepSeek-R1(1.3%)与 Claude 3.7 Sonnet(0.7%)。深度扩展中,1,872 层达 90.9%,超过 FPRM 用 3,744 层才达到的 90.1%,算力减半;936 层的 86.5% 是 TRM 跑到 24,960 层(83.65%)也追不上的。按空格数分难度,60 空格最难档 InfiLoop 59.5% 对 FPRM 56.5%、TRM 36.0%。扰动实验注入 $\epsilon \in [10^{-4}, 0.3]$ 后 InfiLoop 保留 100% 已解题目,TRM 即使不扰动也丢 15–20%。消融显示双轴连接 82.1% 优于仅内轴 72.6%、仅外轴 75.1%;反向衰减 $\beta=1.82$ 仅 2.0%,均匀 38.4%,从 $\beta_0=0.55$ 学习后最优($H3L6$ 82.1%、$H32L6$ 89.7%)。
查看结构化数据
| 任务 | 指标 | 本文 | 基线 | 提升 |
|---|---|---|---|---|
| Sudoku-Extreme(422,786 道测试题) | 精确序列准确率 (%) | 97.9 | FPRM 94.2;TRM 74.7 | 较 FPRM +3.7pp,较 TRM +23.2pp |
| Maze-Hard(30×30 最短路迷宫) | 精确序列准确率 (%) | 87.4 | FPRM 87.0;TRM 85.3 | 较 FPRM +0.4pp,较 TRM +2.1pp |
| ARC-AGI-1 | pass@2 (%) | 49.1 | FPRM 47.5;TRM 44.6 | 较 FPRM +1.6pp,较 TRM +4.5pp |
| ARC-AGI-2 | pass@2 (%) | 13.6 | TRM 7.8;FPRM 6.2 | 较 TRM +5.8pp(约 1.74 倍),远超 671B DeepSeek-R1 的 1.3% |
| Sudoku-Extreme 测试时深度扩展 | 精确准确率 @ 执行层数 (%) | 1,872 层 90.9;936 层 86.5 | FPRM 需 3,744 层达 90.1;TRM 24,960 层仅 83.65 | 同等精度算力减半,优于深 13 倍的 TRM |
局限与改进
作者与读者都能看到的局限:第一,实验全部集中在 7M 参数的谜题级推理器和四个基准(Sudoku、Maze、ARC),未验证在真实语言推理或大模型内部循环中的可迁移性;ARC-AGI-2 虽近两倍于 TRM,但 13.6% 距离解决问题仍很远。第二,范数的均匀界需要候选范数有界(论文自己指出),衰减初始化也相当敏感,$\beta_0=0.10$ 和 $0.90$ 分别只有 66.3% 和 63.3%,工程上需要调参经验。第三,内容打分依赖模型自评估与任务可验证性之间的隐性对齐,在中间过程难以自动判分的开放任务上,是否还能涌现解出瞬间步长激增到 0.91 的动态并不确定。第四,测试时深度扩展是在固定样本上不重训进行的,尚无关于聚合收敛性、与深监督训练相互作用的系统理论分析;所有结论基于单次训练运行,缺少多种子方差报告。
独立分析的弱点
独立分析几处弱点:1) 对 $\beta_0$ 敏感——固定 $\beta$ 时均匀权重只有 38.4%,初始化偏离 0.55 会损失约 16–19 个百分点,改进方向是按层或按 token 自适应初始化,或用元学习确定衰减谱。2) 聚合状态被约束在候选凸包内($\|h_t\| \le \max_i \|z_i\|$)保证了稳定性,但也可能限制表示的探索空间,对需要状态大幅发散的任务(如长程规划)或许过紧,可探索带门控的更新或放宽凸包约束。3) 无监督打分器可能退化:消融显示去掉内容分会掉 6–7 个百分点,说明它承担关键功能;一旦内容分与正确性脱钩(分布外任务、对抗输入),聚合会系统性地偏向错误状态,可引入轻量验证器或一致性信号做正则。4) 评测集中在规则明确的拼图类数据,Sudoku 测试集虽大(422,786 题)但结构单一,建议补充代码生成、数学证明等中间步骤可校验的任务。5) 内外两轴各自独立打分聚合,轴间交互未建模,可尝试跨轴注意力或共享调度。
未来方向
可延伸的方向:作者已展示该连接可无差别套用到标准循环 Transformer 与 TRM/HRM 式嵌套架构,下一步自然是把 InfiLoop 引入语言模型的潜空间循环推理或与思维链结合,检验解出瞬间 $\gamma_t=0.91$ 这类自验证动态在开放任务上是否复现。理论上,聚合等价于自适应残差更新,可与不动点迭代、谱分析等工具结合,研究收敛条件与表达能力边界;$O(d)$ 流式递归也适合实现硬件友好的 fused kernel,把推理推到更长轨迹(论文已展示超过 20,000 有效步)。方法层面可探索:按 token 或按位置异构的衰减率 $\lambda$、跨内外环的联合打分、把内容分与外部验证器信号融合,以及在 ARC-AGI 等少样本任务上研究聚合记忆与测试时增广视图的协同。更长远看,学会决定保留哪一版推理这一机制,或可推广到 agent 的记忆管理与多轮自我修正场景。
复现评估
复现条件较好:代码已在 GitHub 开源(pixeli99/InfiLoop),实现基于公开的 TRM 代码库并沿用其深监督流程,论文给出完整训练配置:AdamW、峰值学习率 $10^{-4}$(Sudoku)或 $3\times10^{-4}$(Maze/ARC)、权重衰减 1.0、批大小 768、$H=3/L=6$、12–16 个深监督段、每段 21 次块应用只回传最后 7 步,Appendix A 提供超参与算力明细。数据全部公开:Sudoku-Extreme 训练集约 100 万样本(1,000 基础题×1,000 增广)、测试集 422,786 题,Maze-Hard 训练/测试各 1,000 样本,ARC-AGI-1/2 提供公共训练与评测集。模型仅 7M 参数,单机小规模算力即可复现;消融在 7,680 题随机抽样上进行,主表数字与协议描述清晰。主要不确定性在于随机种子与衰减初始化敏感性,建议按论文默认 $\beta_0=0.55$ 起步。总体属于中小成本、高确定性复现。
论文图表
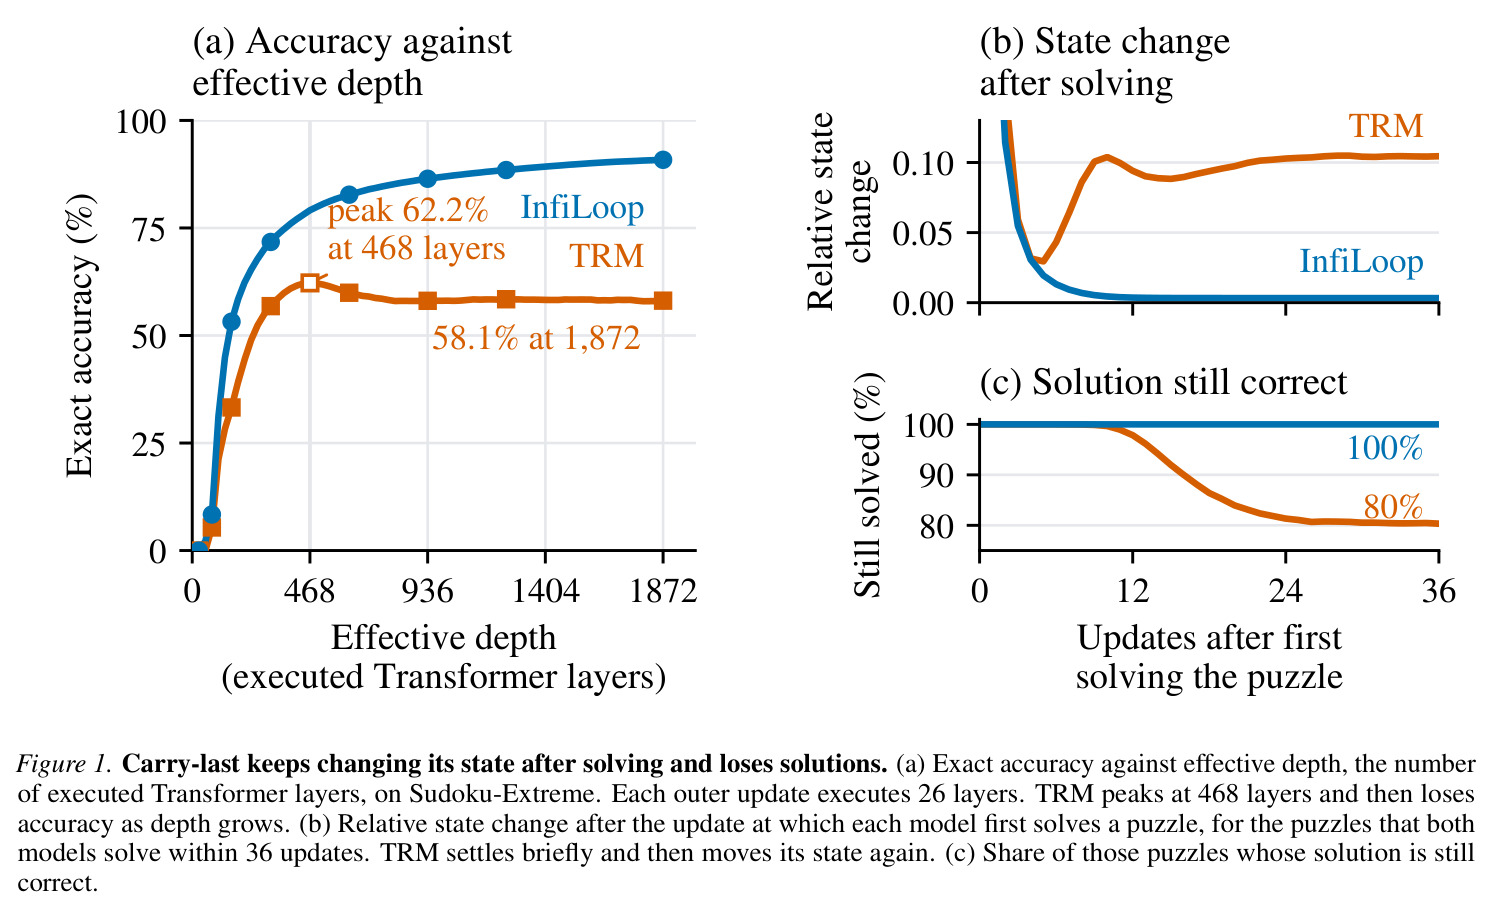
三个面板分别展示:(a) Sudoku-Extreme 上精确准确率对有效深度(每 26 层一次外环更新)——TRM 在 468 层达到 62.2% 峰值后跌至 1,872 层的 58.1%,InfiLoop 同区间持续升至 90.9%;(b) 对齐到各自首次解出那一步之后的状态相对变化——TRM 先降到 3% 又回升到每步约 10%,InfiLoop 降到 0.3%;(c) 这些题目中解仍保持正确的比例——TRM 9 次更新后开始丢解、36 次后丢 19.7%,InfiLoop 全部保持。
这张图是全文的问题陈述:用精度曲线加状态动力学直接展示 carry-last 在深循环下解出后又丢解的病灶,是引入 InfiLoop 的直接实验证据。